EDGAR:基于合成失败数据的扩散驱动高斯头像高效精修框架 EDGAR: Efficient Diffusion-Driven Gaussian Avatar Refinement via Synthetic Failure
用合成失败三元组训练一步扩散模型修复高斯头像伪影,并把改进蒸馏回3D表示
前置知识
3D Gaussian Splatting 与高斯头像
3DGS 用一组各向异性 3D 高斯椭球(属性含位置、缩放、旋转、不透明度、颜色)表示场景,以光栅化代替光线步进,渲染极快。用于人脸即高斯头像:一组可动画的高斯随表情变形,实时渲染照片级头部。但单目或少量图像训练时观测稀疏,未观测区域欠约束,易产生模糊、漂浮高斯、纹理拉伸等伪影。
EDGAR 的精修对象就是这类高斯头像的渲染结果,全文的失败模式、蒸馏回 3D 的优化目标(式 7 的 $R(G,v)$)都建立在 3DGS 表示之上。
SD-Turbo 与一步扩散蒸馏
SD-Turbo 是 Stable Diffusion 的步数蒸馏版,单次前向即可生成/修复图像,推理成本接近 GAN。本文以它为骨干:时间步固定 $\tau=250$,冻结注入时间步的残差块与文本条件的交叉注意力层,只训练自注意力层并给解码器加 LoRA。
理解哪些层被冻结、哪些被训练(式 1 的融合块、零初始化)是读懂 EDGAR 架构改动与效率来源的前提。
SDEdit 式精修及其缺陷
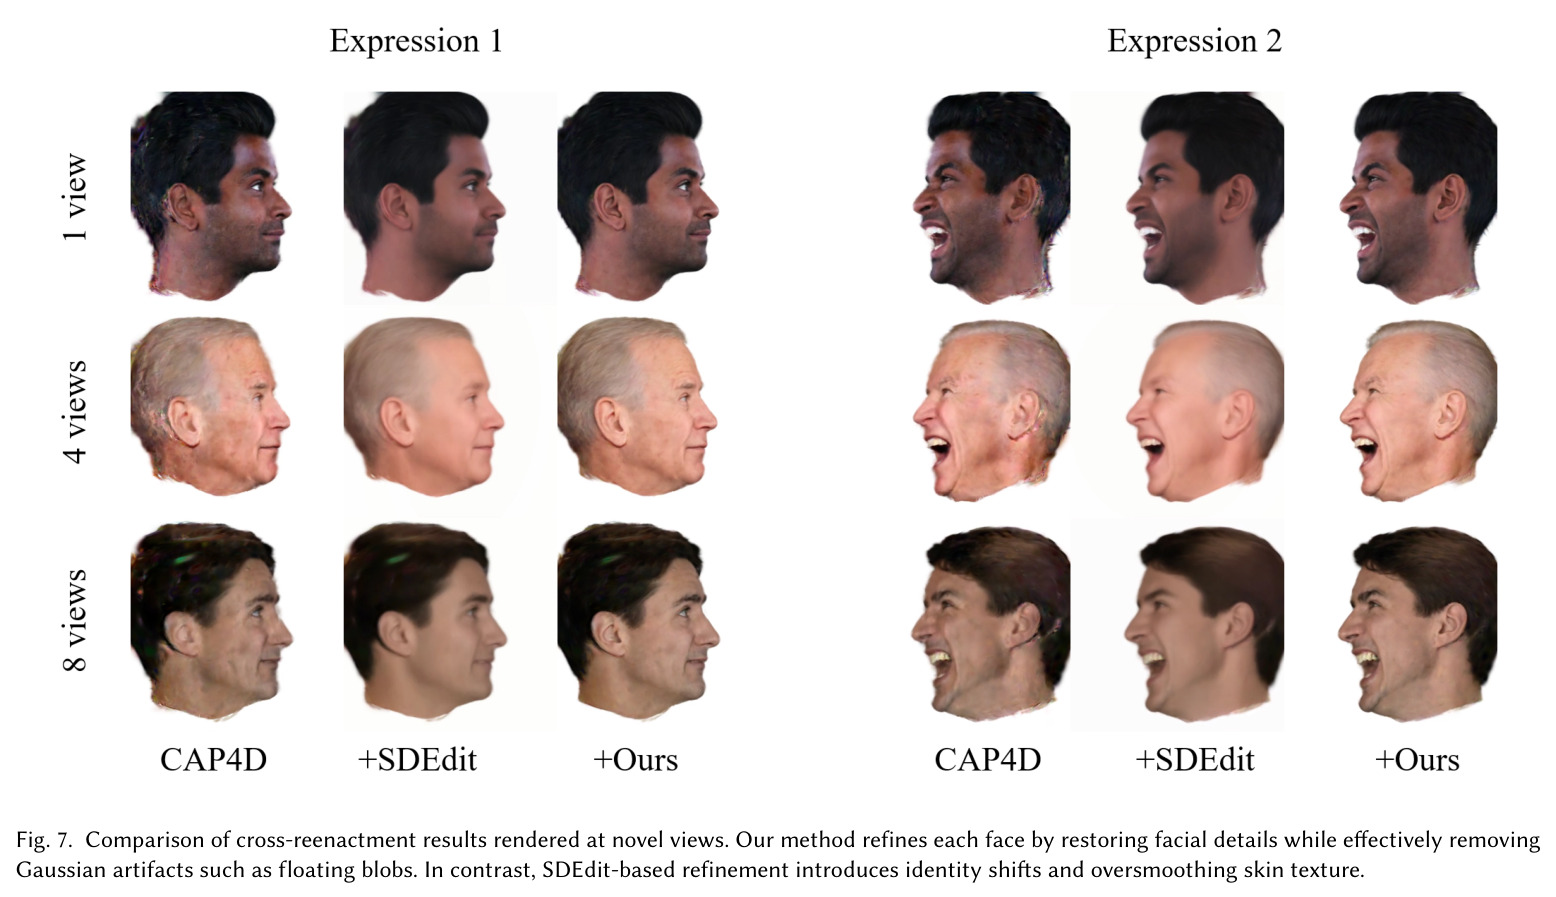
SDEdit 对输入图像加噪到中等强度再去噪,用预训练扩散先验「重画」图像。它无需配对数据、适合盲修复,但网络并不知道目标应该长什么样,随机噪声带来随机性:多次结果不一致、身份漂移、过度平滑,逐帧用于头像时会时序抖动。本文用它作为主要对比基线(同样 $ au=250$)。
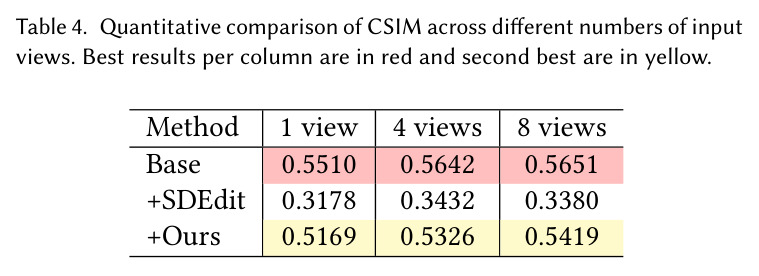
EDGAR 的动机正是克服 SDEdit 的身份丢失(CSIM 从 0.5651 跌至 0.3380)与不一致性,理解其缺陷才能理解参考条件化设计的针对性。
Sapiens 人体视觉基础模型
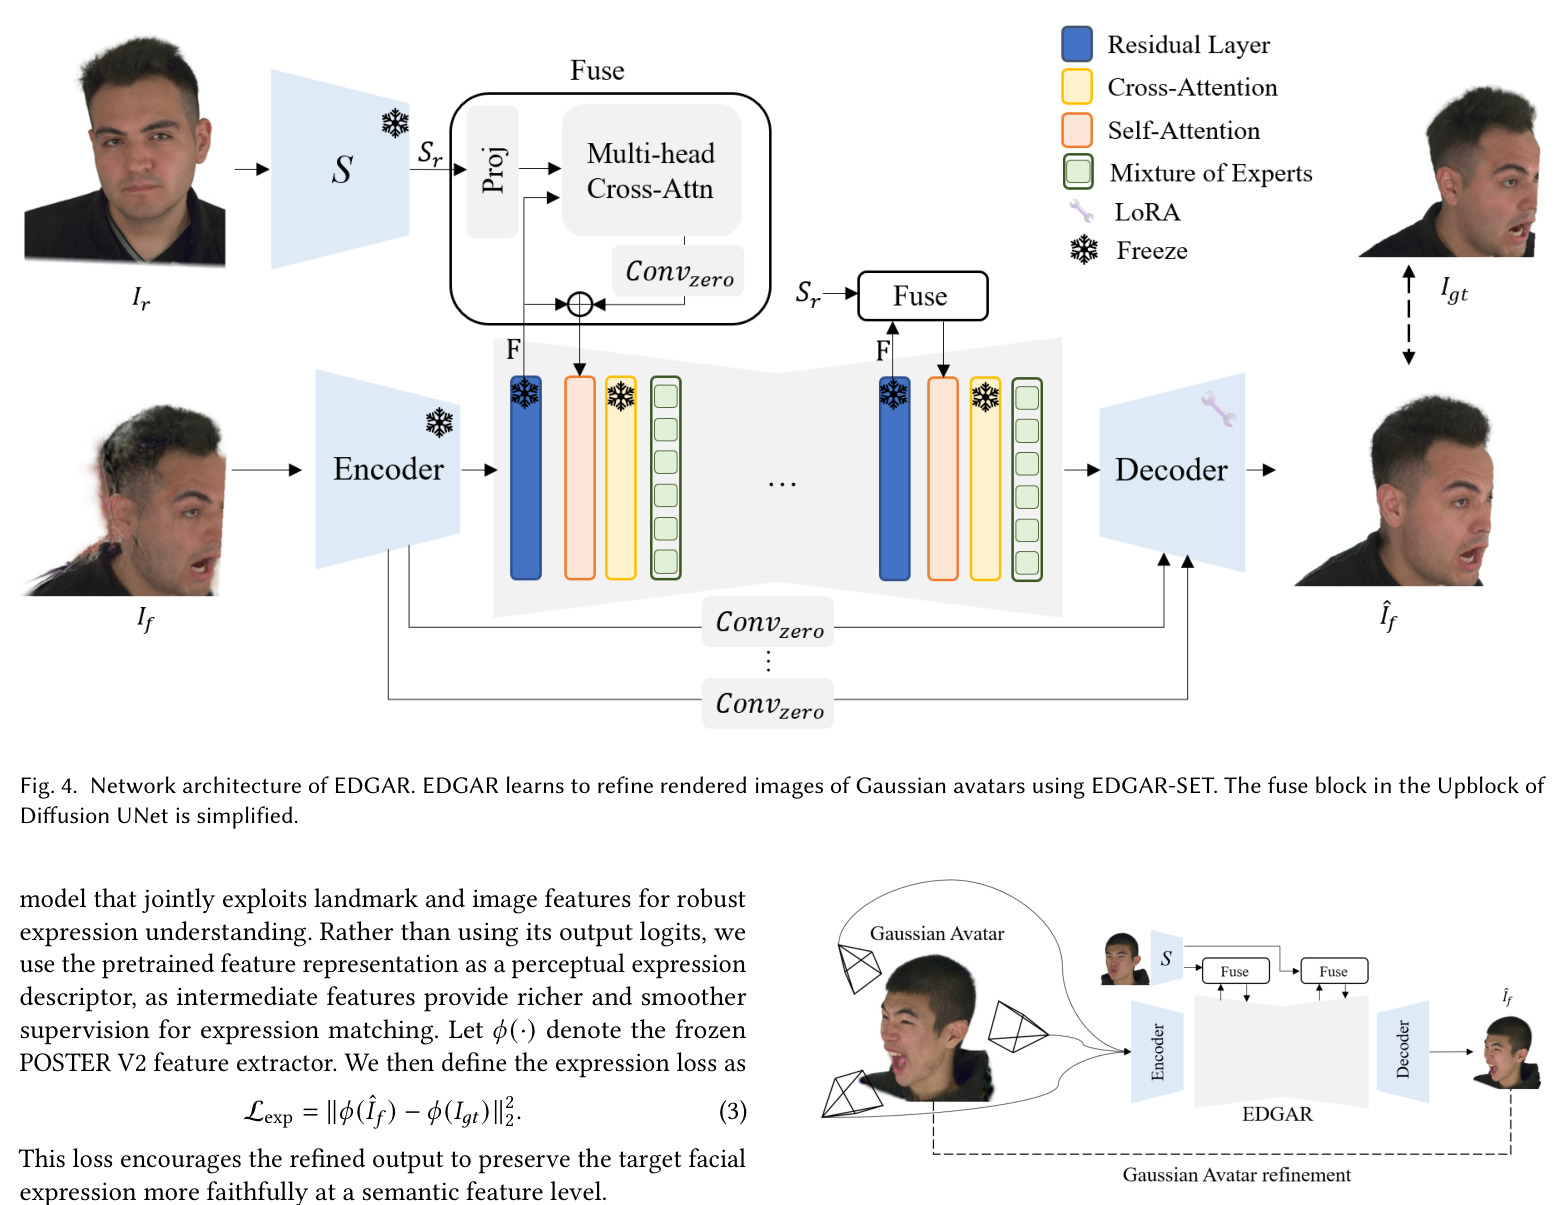
Meta 的 Sapiens 是大规模人体数据上自监督预训练的 ViT 基础模型,特征蕴含丰富人脸先验。EDGAR 把参考图 $I_r$ 过一遍冻结的 Sapiens 得到特征 $S_r$ 作为身份描述子,投影后注入扩散 UNet 交叉注意力作 key/value。
参考条件化是 EDGAR 保身份的核心机制,消融显示去掉参考特征是所有组件中性能下降最大的一项。
Mixture-of-Experts(MoE)
MoE 用轻量路由器按中间特征为每个样本选一个专家子网络,使不同退化分流到擅长它的专家,总计算量可控;需负载均衡损失 $\mathcal{L}_{lb}=E\sum_e \bar{p}_e\bar{l}_e$ 防止专家塌缩。本文在扩散 UNet 的自/交叉注意力后插路由器,从六个专家 MLP 中选一个。
EDGAR 需要同时处理从漂浮高斯到接近干净渲染的各种退化类型与严重度,MoE 是其应对多样退化的手段,也是消融实验的重要对象。
LPIPS 与自重演评估协议
LPIPS 用深度特征衡量感知相似度,越低越相似;它同时是本文的数据过滤工具(剔除不可恢复样本)。自重演指用本人驱动头像并与真值帧比,可算 PSNR/L1/LPIPS/CLIP;跨身份重演无真值,改用身份嵌入余弦相似度 CSIM 评价身份保持。
论文所有主表(Tables 1–4)和消融表都用这套指标与协议,理解它们才能正确解读数据过滤策略与各项实验结论。
研究动机
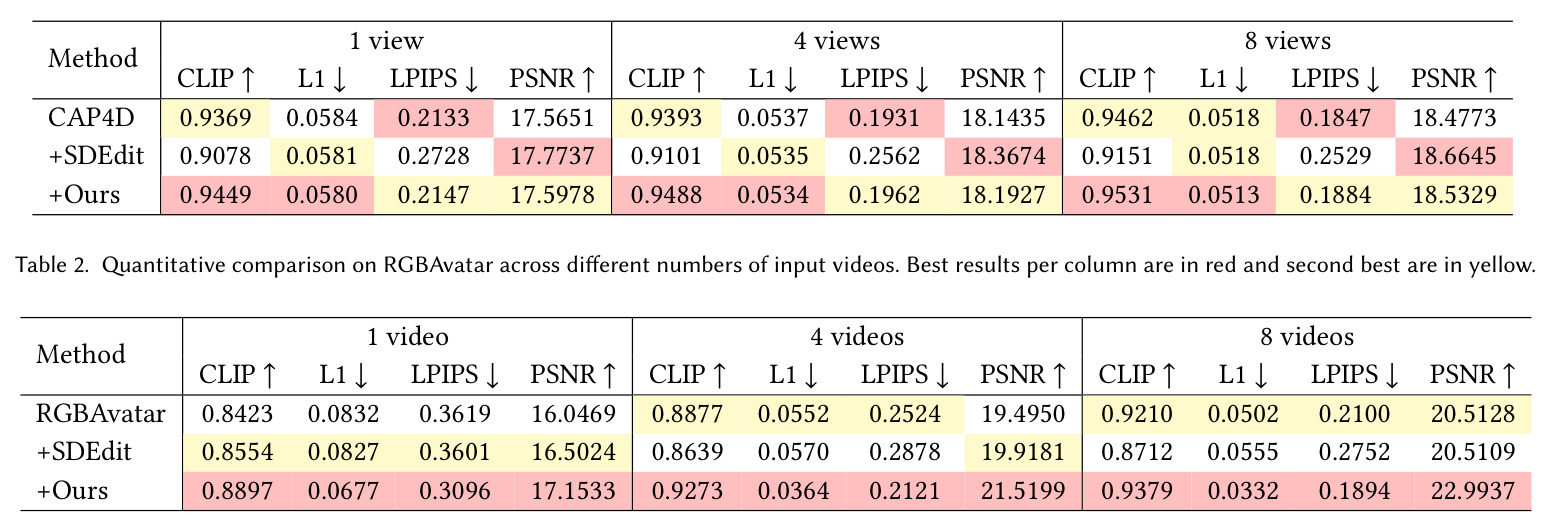
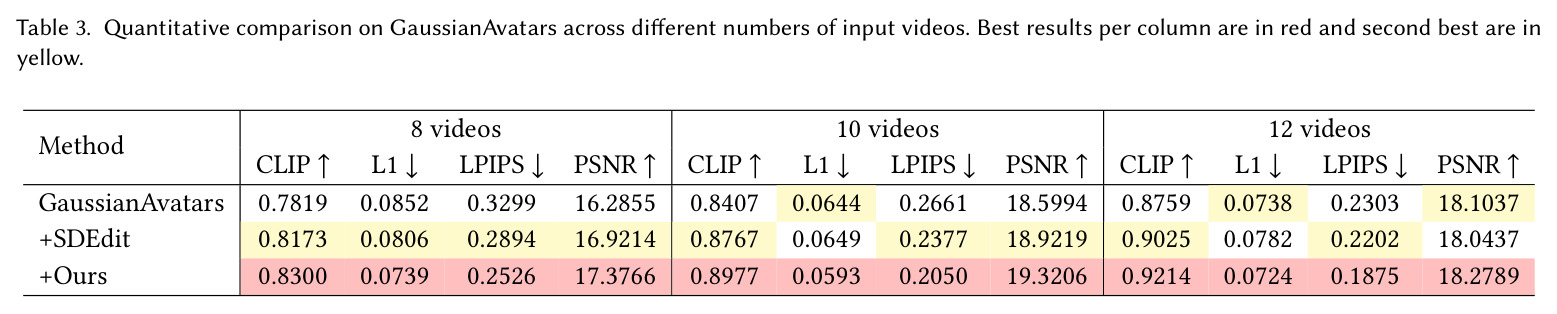
当高斯头像的输入从多相机阵列退化为单目视频或少量图像时,重建问题变得严重欠约束:模型必须在未观测区域凭空推断几何与纹理,于是在侧脸、张大嘴、挑眉等姿态下出现纹理拉伸、头发发丝漂浮、模糊、深度歧义等伪影。论文数据直观量化了这一痛点:RGBAvatar 用 1 段视频重建时 PSNR 仅 16.05 dB、LPIPS 高达 0.3619;GaussianAvatars 用 8 段视频重建时 PSNR 仅 16.29 dB、CLIP 相似度 0.7819;CAP4D 单图重建的 LPIPS 为 0.2133。而现有的补救手段主要是 SDEdit 式精修——对渲染结果加噪再去噪,但网络并不知道头像「应该长什么样」,随机噪声注入带来身份漂移与帧间不一致:论文实测 SDEdit 使跨身份重演的 CSIM 从 0.5651 暴跌到 0.3380,纹理过度平滑,且逐帧独立精修会造成时序抖动。因此,如何在保持身份保真与时序一致的前提下高效修复欠约束高斯头像,是一个悬而未决的问题。
本文的目标是本文的目标是构建一个与方法无关的通用「高斯头像精修器」:输入任意重建方法训出的高斯头像渲染帧(可能带模糊、漂浮高斯、错位等伪影)和一张同一对象的参考图,输出更清晰、更忠实于本人身份的图像;随后把这些 2D 精修结果作为伪真值反哺优化底层 3D 高斯参数,使改进被吸收进 3D 表示本身。作者设定了三个关键约束:其一,精修必须保持身份保真度,不能像 SDEdit 那样「换脸」;其二,必须保留唇、眼等微妙的面部表情动态;其三,最终头像必须保持原有高斯数量与渲染路径,即推理时零额外开销、FPS 变化在 2% 以内。此外框架需同时适用于单图(CAP4D)、单视频(RGBAvatar)和多视频(GaussianAvatars)三类重建管线,并在不同输入数量、大偏航、张嘴等极端条件下均有效。
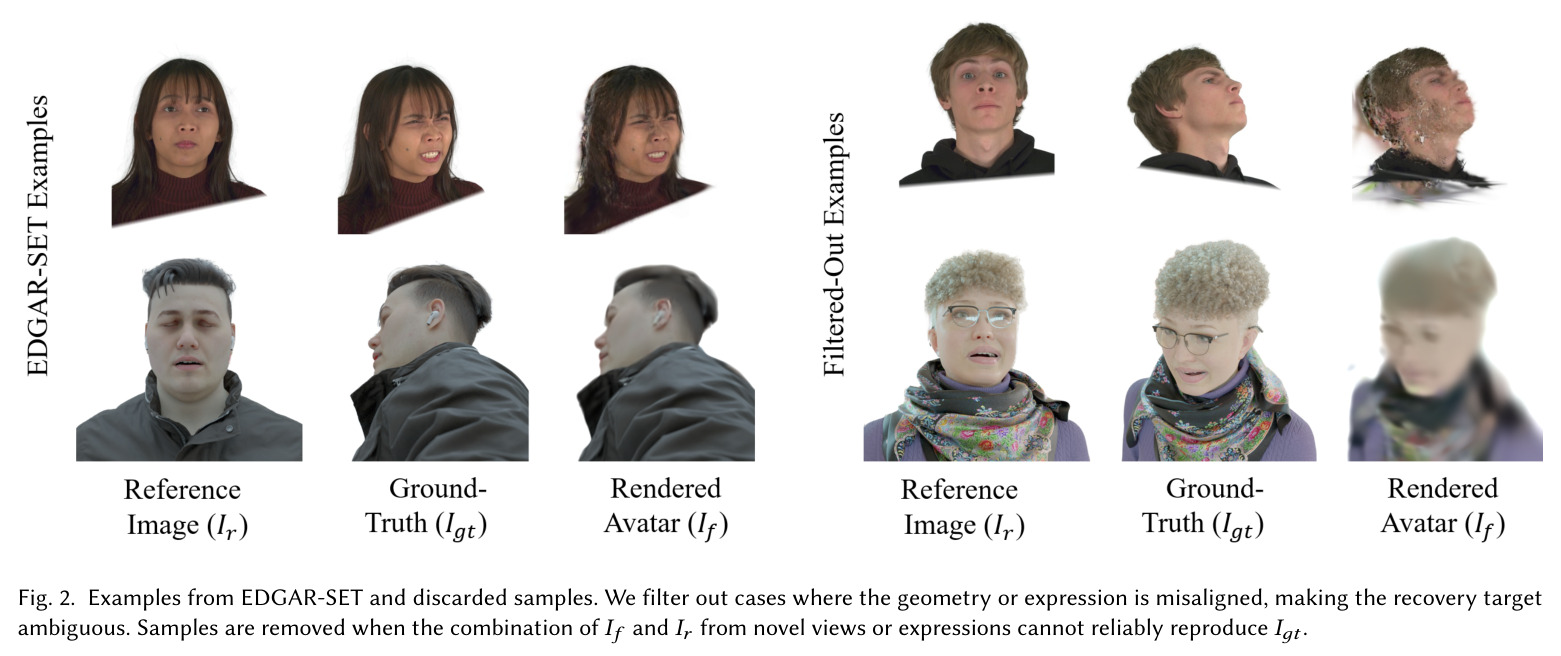
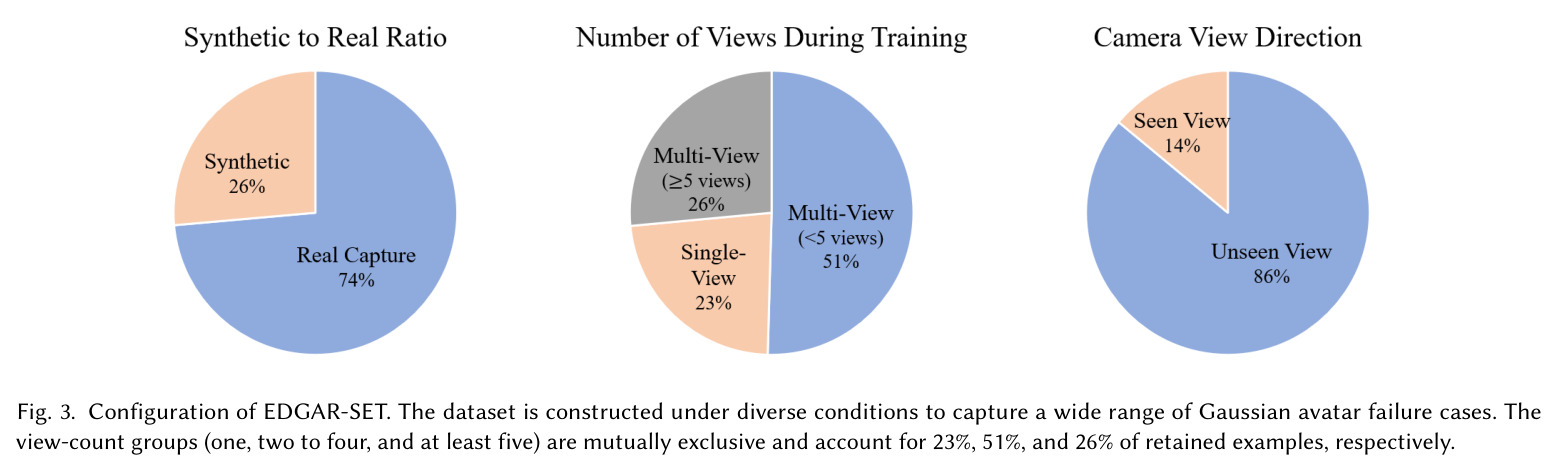
与已有工作不同的是,已有工作的切入角度要么是「盲修复」(SDEdit 加噪去噪,无身份先验、有随机性),要么是把单步扩散精修器与静态 NeRF/3DGS 优化耦合(Difix3D+,但面向静态场景而非可动画头像)。EDGAR 的独特之处有三:第一,它是第一个围绕「可恢复的高斯头像失败案例」构造配对训练数据的尝试——世界上并不存在现成的「坏头像 vs 真值渲染」数据集,作者用两条路径合成它:对 CAFCA 的 1500 个身份以不同视角数训练 3DGS,系统性制造漂浮高斯、模糊、几何错位等可控退化;对 NeRSemble 的 99 个身份用 RGBAvatar 以 1–4 视角重建,天然产生真实而严重的退化,二者混合构成 40 万张图像的 EDGAR-SET 三元组数据。第二,把人类基础模型 Sapiens 的身份特征与 POSTER V2 的表情特征作为条件与监督注入精修过程,专门回应头像任务的身份与表情保持需求。第三,通过共享 3D 高斯优化把 2D 改进一次性蒸馏回模型,避免逐帧扩散推理的开销。
核心方法
EDGAR 的整体思路是「先造失败、再学修复、最后蒸馏回 3D」。直觉上,一个见过大量「退化渲染 → 真值图像」配对、并且知道当事人长什么样(参考图)的模型,能学会补全高频细节、擦除漂浮高斯。技术路线分三步:第一步构造 EDGAR-SET 三元组数据集——失败图像 $I_f$、真值 $I_{gt}$、同身份另一视角/表情的参考图 $I_r$;真实部分用 NeRSemble 加 RGBAvatar 以 1–4 视角构造 99 个身份,合成部分用 CAFCA 加 3DGS 以 5 视角以上构造 1500 个身份,经 LPIPS 过滤(约一半配对被剔除)后共 40 万张 512×512 图像。第二步在 SD-Turbo 一步扩散骨干上训练条件精修网络:冻结残差块与交叉注意力层,只训练自注意力层并给解码器加零初始化 LoRA;用零初始化卷积把 Sapiens 参考特征以交叉注意力方式融合进来(式 (1));再加六专家 MoE 路由以应对不同退化类型与严重度。第三步对目标头像渲染 50 个视角、逐帧精修,把精修结果当伪真值,以 L1+SSIM 损失优化高斯参数 500 步(式 (7)),一次性完成且推理时零开销。
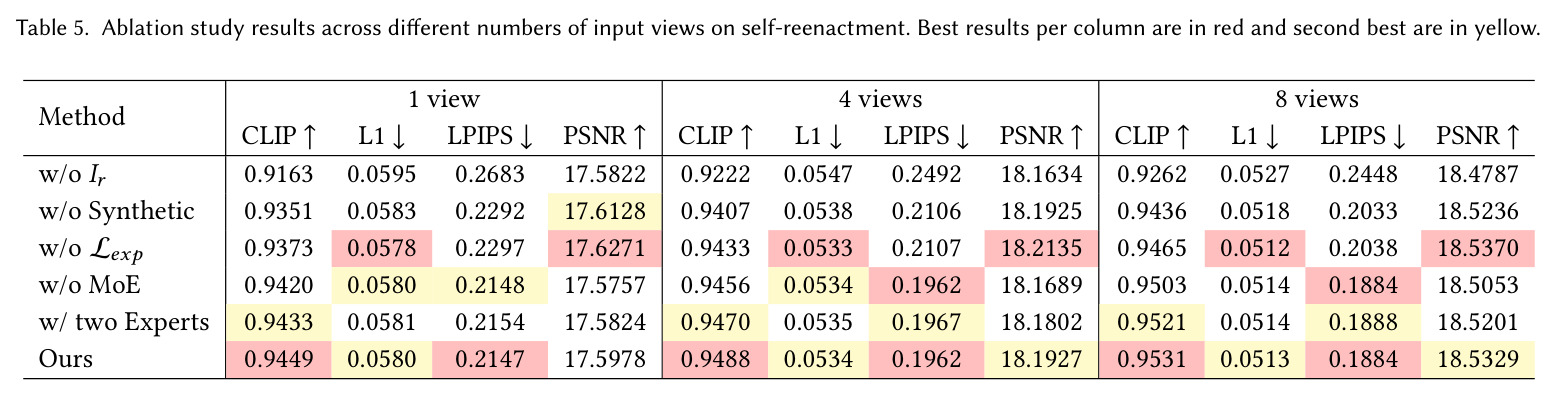
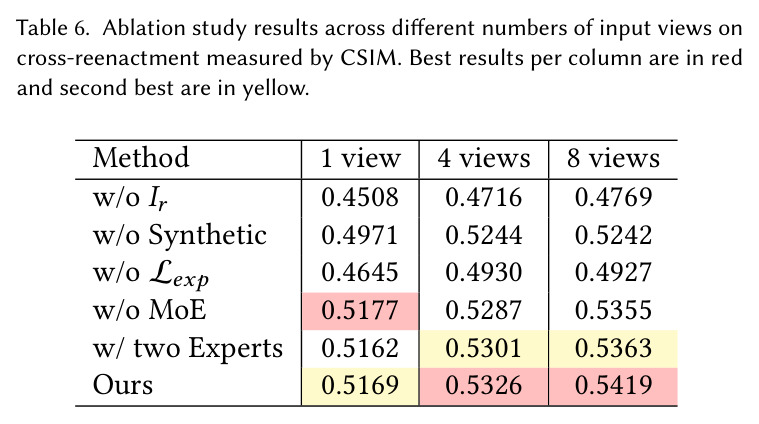
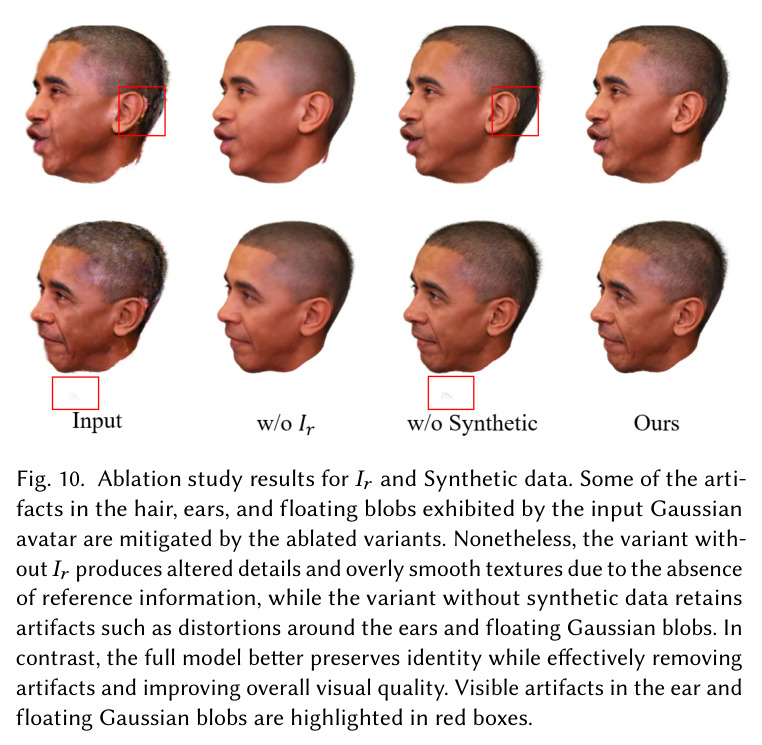
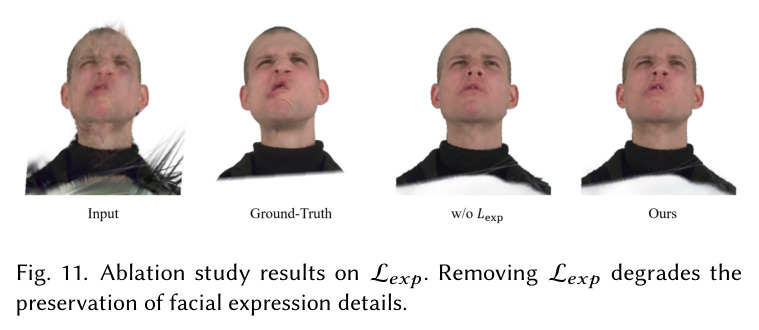
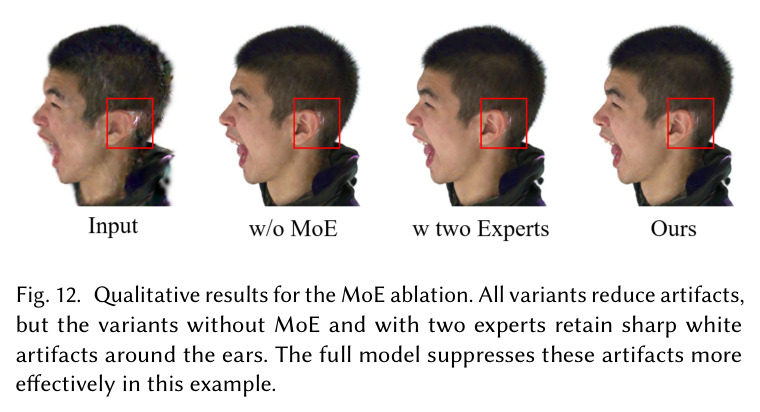
核心创新是「合成失败」的数据策略与「参考条件化+表情监督」的组合,与已有方法有四点本质区别。(1) SDEdit 只会「猜」,没有身份先验,实测 CSIM 从 0.5651 跌至 0.3380;EDGAR 显式告诉网络「这个人长什么样」——把 Sapiens 从参考图提取的特征 $S_r$ 作为交叉注意力的 key/value 注入 UNet,且所有新增层(投影、零卷积、LoRA、偏置)均零初始化,训练起点与原始 SD-Turbo 完全一致,预训练能力无损保留、随训练平滑过渡到精修网络。(2) 图像重建损失对唇形、眼睑等细微表情约束不足,EDGAR 额外用冻结的 POSTER V2 表征定义表情一致性损失 $\mathcal{L}_{exp}=\|\phi(\hat{I}_f)-\phi(I_{gt})\|_2^2$,取中间特征而非输出 logits,消融显示去掉它会使跨重演 CSIM 全面下降(如 1 视角 0.4645 vs 全模型 0.5169)。(3) 六专家 MoE 让不同退化类型/严重度分流到不同专家,消融的定性对比显示无 MoE 或仅两专家时耳边白色伪影残留更明显。(4) 与 Difix3D+ 处理静态场景不同,EDGAR 面向可动画头像,且通过共享 3D 高斯优化使跨视角改进天然一致、推理成本不变。
方法步骤详情
训练与应用分五个阶段。(1) 数据构造:在 RTX 3090 上用 RGBAvatar 在 NeRSemble(99 身份,1–4 视角,自重演)与 3DGS 在 CAFCA(1500 身份,≥5 视角,多表情/光照/机位)上重建头像;渲染退化帧 $I_f$ 与对应真值 $I_{gt}$,并从不同视角/表情采样一张真值帧作参考 $I_r$;用 LPIPS 过滤掉 $I_f$ 与 $I_{gt}$ 相似度过低(不可恢复)的样本,约一半配对被剔除,最终得到 40 万张 512×512 图像,视角数分组(1 / 2–4 / ≥5 视角)分别占 23%、51%、26%。输入为三元组,输出为过滤后的训练集。(2) 模型构建:以 SD-Turbo 为骨干(时间步 $\tau=250$,文本提示 "High resolution portrait."),冻结残差块与交叉注意力层,训练自注意力层、零初始化 LoRA 解码器与融合块——参考图经 Sapiens 编码为 $S_r$,按式 (1) 经零初始化卷积与 softmax 交叉注意力注入:$\mathrm{Fuse}(F,S_r)=\mathrm{Conv}_{zero}(\mathrm{softmax}(F\cdot\mathrm{Proj}(S_r)^\top/\sqrt{d}))\mathrm{Proj}(S_r)+F$;在自/交叉注意力后接轻量路由器,把特征派发给六个专家 MLP 之一。(3) 训练目标:图像项($\ell_2$ + LPIPS + Gram 矩阵风格损失,权重均 1.0)+ 表情项 $\mathcal{L}_{exp}$(权重 8.0)+ 负载均衡项 $\mathcal{L}_{lb}=E\sum_e \bar{p}_e\bar{l}_e$(权重 0.001),总损失见式 (6);40K 步、batch 4、梯度累积 2,学习率 1000 步线性升至 $2\times10^{-5}$ 后恒定,单卡 A6000 约 40 小时。(4) 头像精修:对目标高斯头像渲染 50 个视角,EDGAR 逐帧精修得到 $\hat{I}_f$(全程随机选定单张参考图)。(5) 蒸馏回 3D:以精修图为伪真值,用 $\lambda_{L1}=0.6$、$\lambda_{SSIM}=0.4$ 的损失优化高斯参数 500 步,不做高斯加密/分裂以保持高斯数量与渲染速度。
技术新颖性
从技术新颖性看:数据层面,「合成失败」思想本身不新(退化模拟常见于超分与修复),但把它用于可动画高斯头像、并与真实欠约束重建配对形成「真实严重退化 + 合成可控退化」的混合分布是本文首创;过滤策略(保留可恢复、剔除不可恢复)明确划定了模型能力边界,这也是标题中 Synthetic Failure 的含义。架构层面,单步扩散加参考特征注入借鉴了 Parmar et al. 2024 与 Sapiens 的已有组件,但零初始化保证平滑接入预训练模型的工程设计、以及用人体基础模型(而非通用 CLIP/DINOv2)做身份条件,是针对头像任务的适配;用 POSTER V2 中间特征而非 logits 作表情描述子也是经验性的新用法。训练层面,MoE 在图像精修扩散模型中并不常见,负载均衡沿用 Switch Transformer 式设计。系统层面,「2D 精修 → 伪真值 → 共享 3D 优化」的蒸馏思路与 Difix3D+ 同源,但 EDGAR 不做高斯加密/分裂以保证推理成本不变,并把表情一致性纳入监督。总体属于「已知组件的任务化重组」,单项创新中等,胜在问题定义清晰、数据构造完整与实证充分。
实验结果
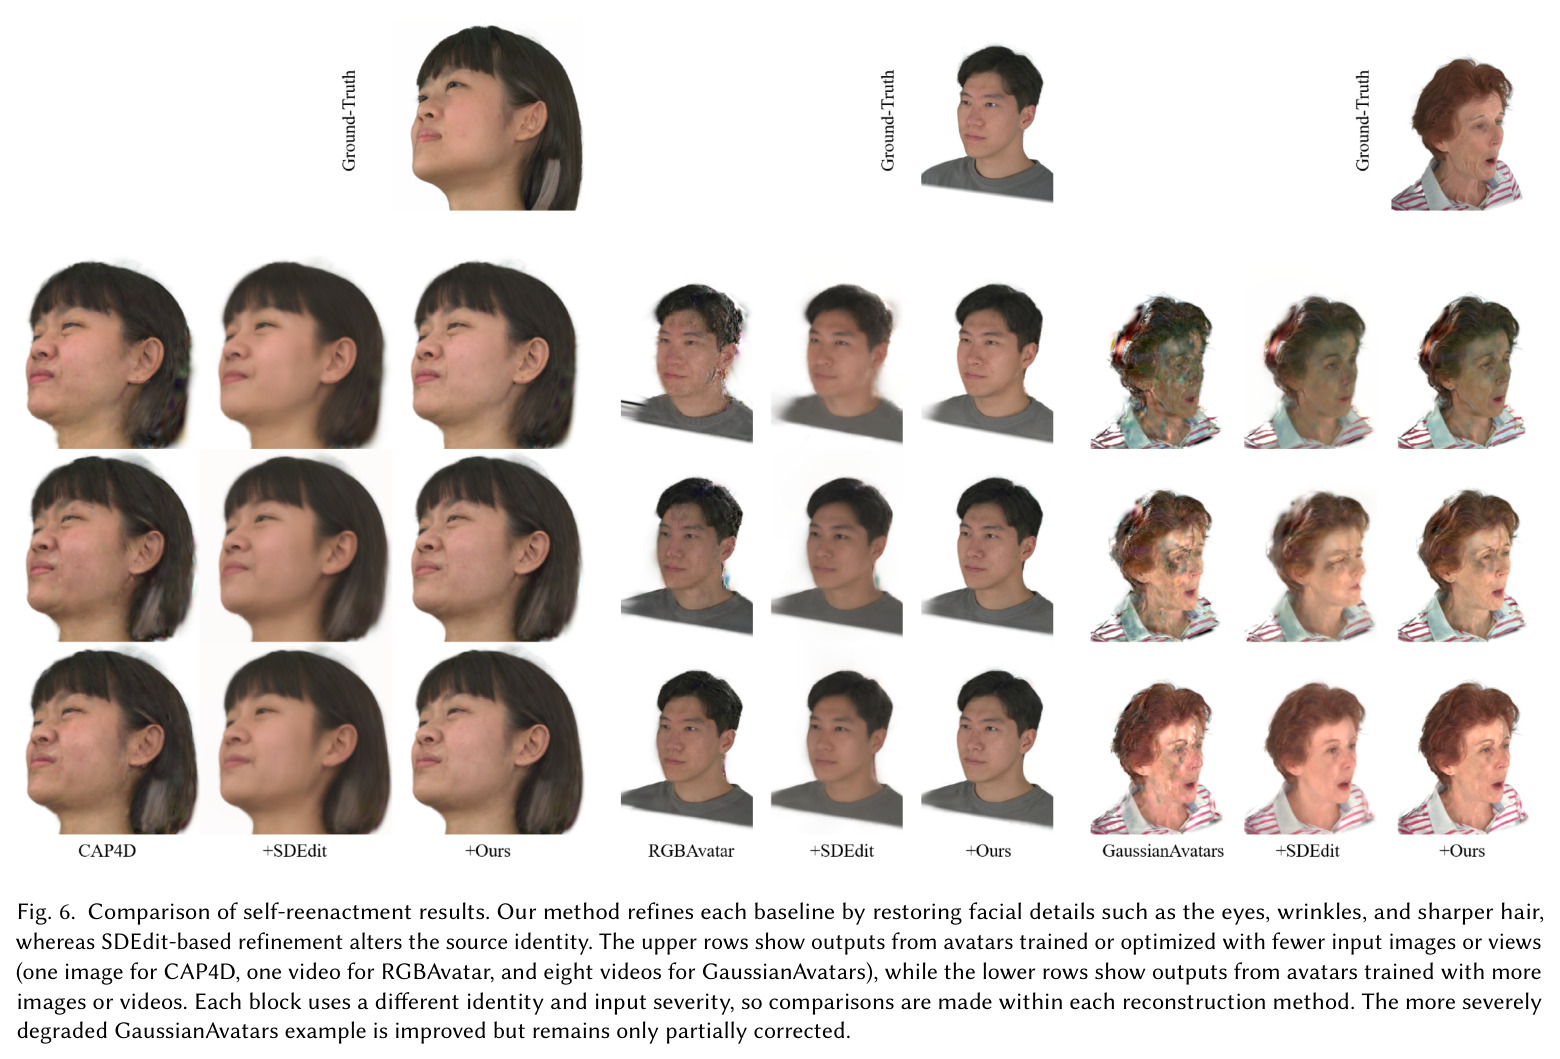
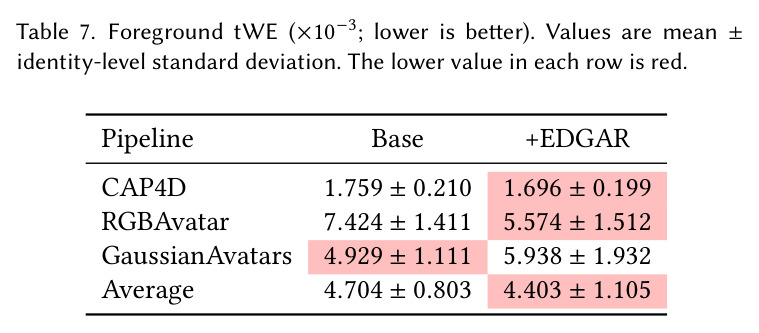
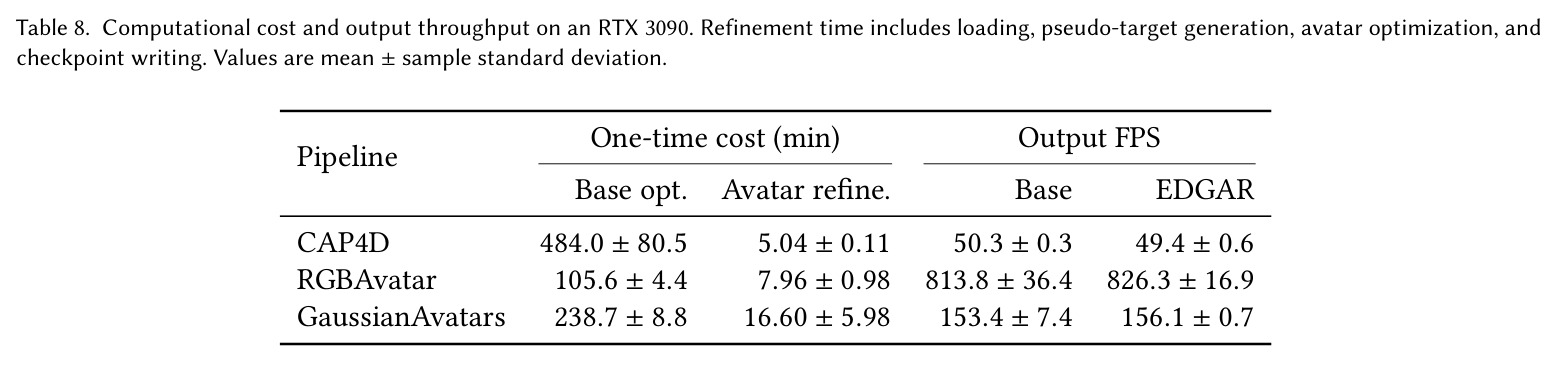
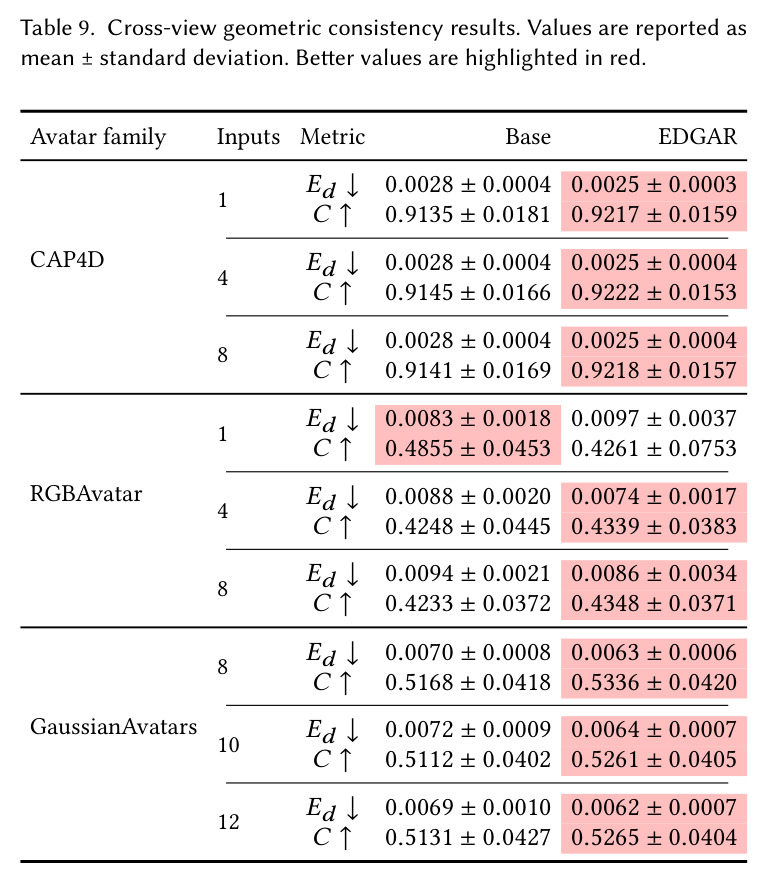
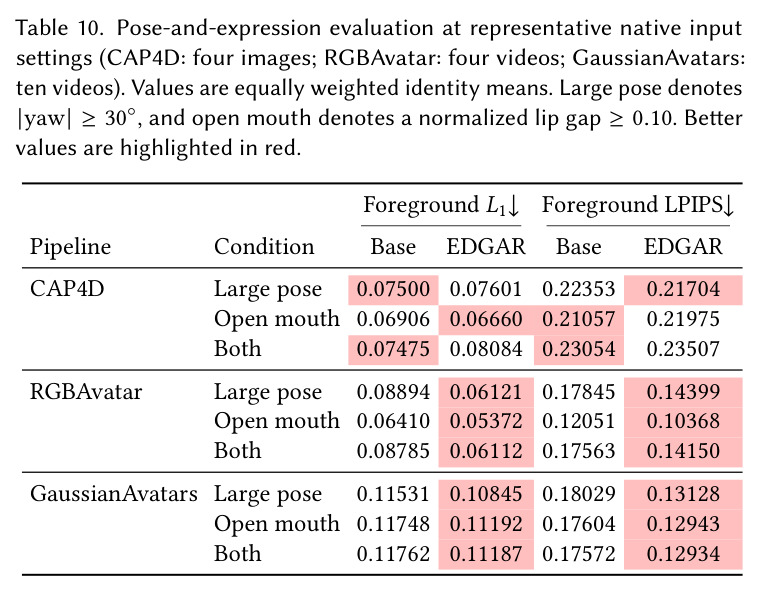
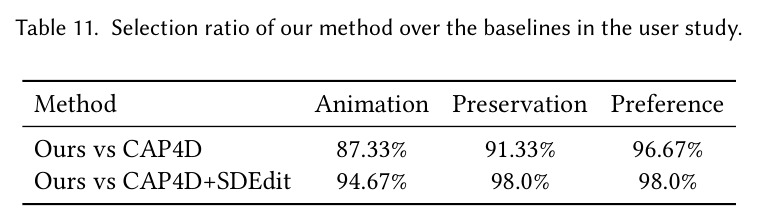
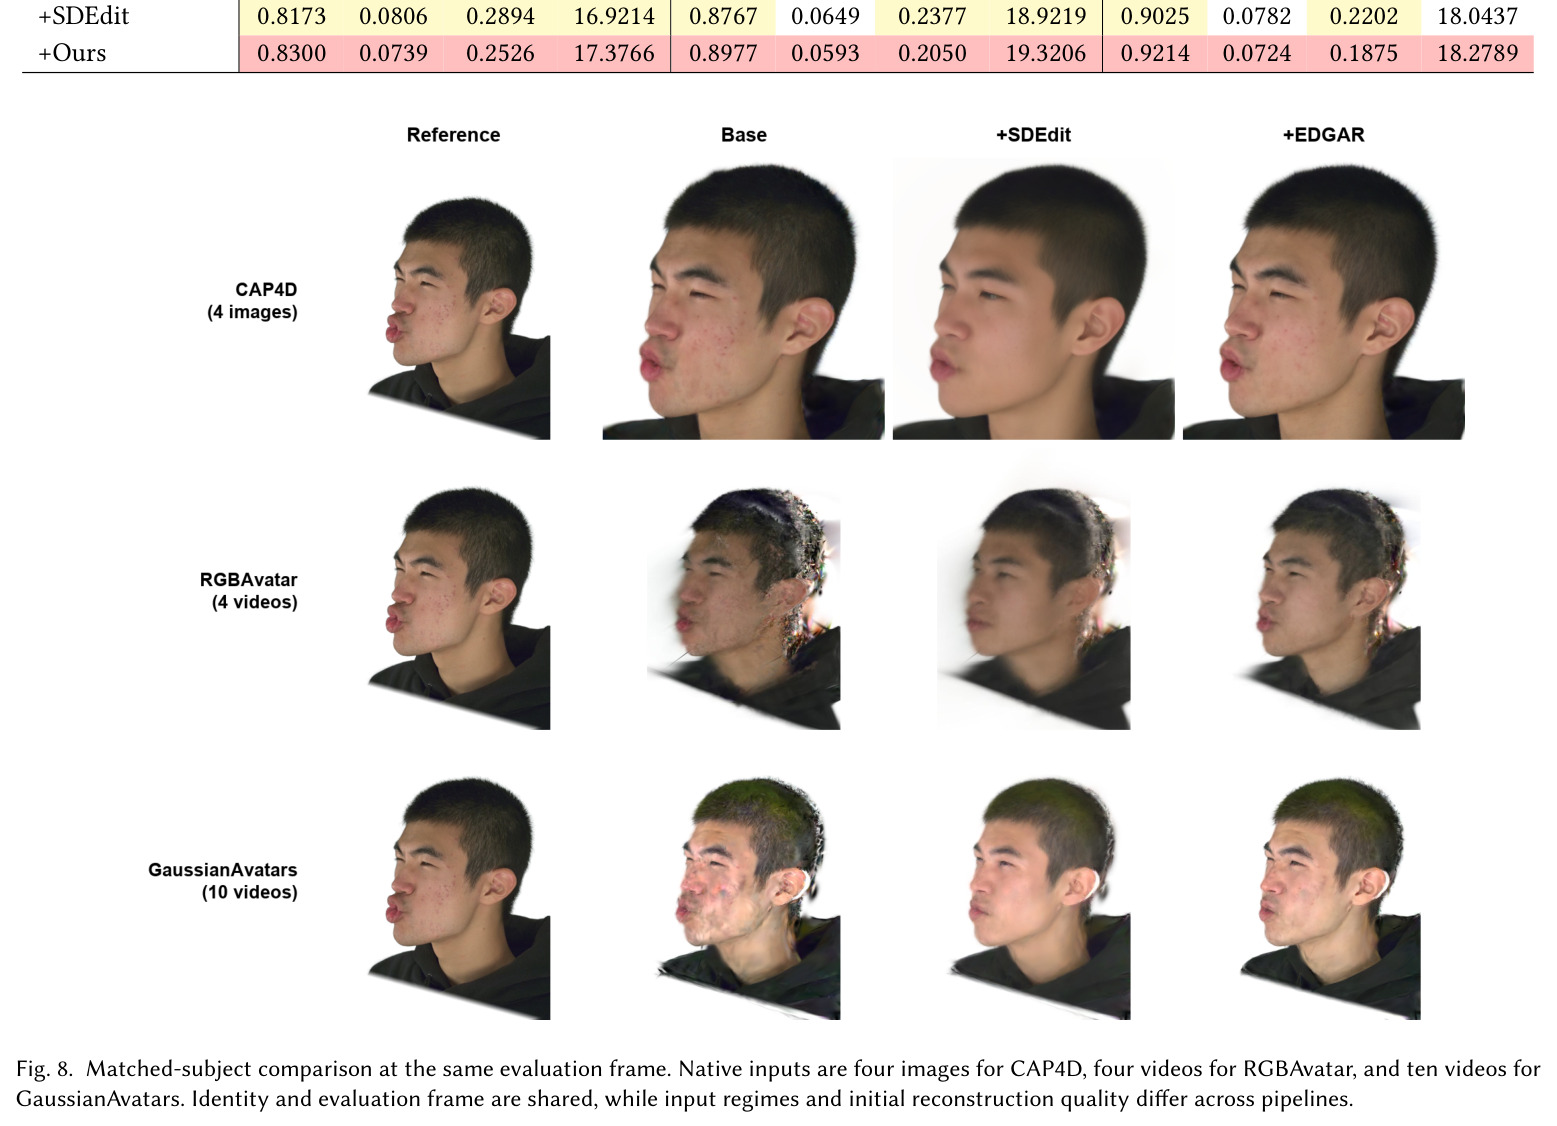
定量结果覆盖三条基线管线与五个维度。(1) 自重演重建质量:在 RGBAvatar 上 EDGAR 在全部输入数下包揽 CLIP/L1/LPIPS/PSNR 四项最优——1 视频时 PSNR 从 16.05 升至 17.15 dB、LPIPS 从 0.3619 降至 0.3096、CLIP 从 0.8423 升至 0.8897;8 视频时 PSNR 从 20.51 升至 22.99 dB、L1 从 0.0502 降至 0.0332。GaussianAvatars 同样全指标领先:8 视频时 CLIP 0.7819→0.8300、LPIPS 0.3299→0.2526、PSNR 16.29→17.38 dB。CAP4D 提升较温和(其基线质量已较高):各输入数下 CLIP 与 L1 最优(8 图 CLIP 0.9462→0.9531、L1 0.0518→0.0513),但基线保持最低 LPIPS(0.1847 vs 精修后 0.1884)、SDEdit 保持最高 PSNR。(2) 身份保持:跨身份重演 CSIM 上 EDGAR 仅轻微下降(8 视角 0.5651→0.5419,约 −4%),而 SDEdit 腰斩至 0.3380(−40%)。(3) 时序稳定:前景时序形变误差 tWE 上 CAP4D 1.759→1.696、RGBAvatar 7.424→5.574(改善约 25%),但 GaussianAvatars 反而 4.929→5.938 恶化,三管线均值 4.704→4.403。(4) 跨视角一致性与极端条件:带标定的对称相对深度不一致度 $E_d$ 与重投影覆盖率 $C$ 在 CAP4D 与 GaussianAvatars 的所有输入设置下均改善(如 CAP4D 1 输入 $C$ 0.9135→0.9217);大偏航(|yaw|≥30°)与张嘴(唇距/嘴宽≥0.10)子集上 RGBAvatar 的组合条件 L1 从 0.08785 降至 0.06112、LPIPS 从 0.17563 降至 0.14150,GaussianAvatars 亦全面改善,CAP4D 结果混合。(5) 成本与主观评价:一次完整精修仅 5.04/7.96/16.60 分钟(对比基础优化 484/105.6/238.7 分钟),输出 FPS 变化在 ±2% 内;15 名参与者的用户研究中,EDGAR 对 CAP4D 的动画质量/身份保持/总体偏好率达 87.33%/91.33%/96.67%,对 CAP4D+SDEdit 达 94.67%/98.0%/98.0%。消融实验证实参考图 $I_r$ 与合成数据是最大贡献项:去掉 $I_r$ 后 1 视角自重演 CLIP 从 0.9449 跌至 0.9163、跨重演 CSIM 跌至 0.4508;去掉合成拆分后 CSIM 降至 0.4971;去掉 $\mathcal{L}_{exp}$ 使 CSIM 降至 0.4645 且 CLIP/LPIPS 变差;MoE 影响最小但六专家在 CLIP 与 4/8 视角 CSIM 上最优。
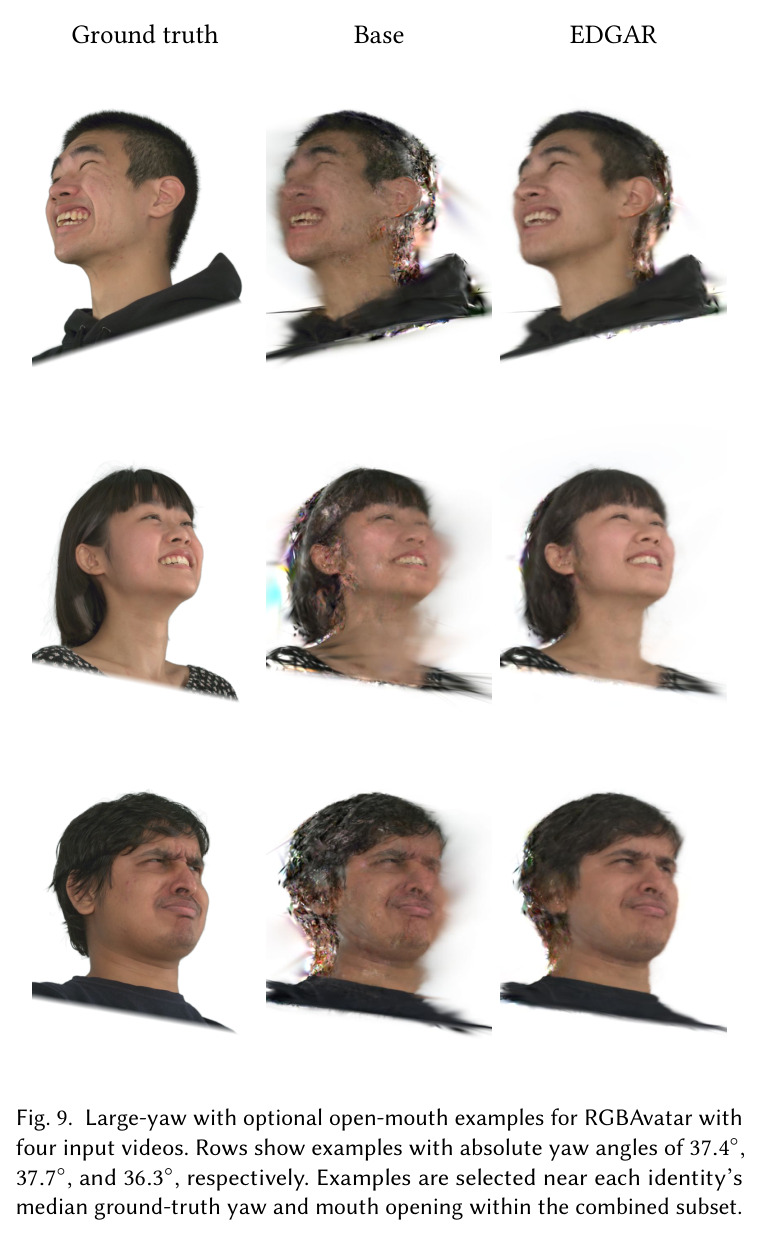
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RGBAvatar 单视频自重演(1 video) | PSNR / LPIPS / CLIP / L1 | 17.15 dB / 0.3096 / 0.8897 / 0.0677 | RGBAvatar 原始:16.05 dB / 0.3619 / 0.8423 / 0.0832 | PSNR +1.10 dB,LPIPS −14.3%,CLIP +5.6%,四指标全面领先 |
| RGBAvatar 8 视频自重演 | PSNR | 22.99 dB | 20.51 dB(+SDEdit 仅 20.51 dB) | +2.48 dB |
| GaussianAvatars 8 视频自重演 | CLIP-SIM / LPIPS / PSNR | 0.8300 / 0.2526 / 17.38 dB | GaussianAvatars 原始:0.7819 / 0.3299 / 16.29 dB | CLIP +6.1%,LPIPS −23.4%,PSNR +1.09 dB |
| CAP4D 8 图自重演 | CLIP-SIM / L1 / LPIPS | 0.9531 / 0.0513 / 0.1884 | CAP4D 原始:0.9462 / 0.0518 / 0.1847 | CLIP +0.7%、L1 −1%,LPIPS 略逊于基线(基线已接近上限) |
| 跨身份重演身份保持(8 视角,INSTA 测试集) | CSIM | 0.5419 | Base 0.5651;+SDEdit 0.3380 | 仅降 4.1%,而 SDEdit 降 40.2% |
| RGBAvatar 时序稳定(100 帧前景 tWE) | tWE (×10⁻³,越低越好) | 5.574 ± 1.512 | 7.424 ± 1.411 | −24.9%(但 GaussianAvatars 由 4.929 升至 5.938) |
| 一次完整头像精修耗时(RTX 3090) | 分钟(含加载、伪目标生成、500 步优化、保存) | 5.04–16.60 分钟 | 基础优化 105.6–484.0 分钟 | 仅占基础优化时间约 1%–7%,输出 FPS 变化 <2% |
| 用户研究(15 人、20 组随机对比) | 总体偏好率 | vs CAP4D 96.67%;vs CAP4D+SDEdit 98.0% | CAP4D / CAP4D+SDEdit | 动画、身份保持、偏好三项标准全面大幅领先 |
局限与改进
作者明确承认:EDGAR-SET 用 LPIPS 过滤掉了退化过重的样本,因此模型只学过「结构上可恢复」的退化,未观测区域的严重结构错误在精修后仍然残留——Figure 6 中 GaussianAvatars 的重度退化示例只是被部分修复;此外各视角独立精修产生的伪目标可能互相冲突,共享高斯表示会在冲突细节间取平均或保留视角相关错误。从数据看还有更多局限:时序上 GaussianAvatars 的 tWE 从 4.929 升至 5.938(恶化约 20%),说明空间保真的改善不必然带来时间稳定;跨身份重演 CSIM 从 0.5651 降至 0.5419,存在轻微但非零的身份漂移;口腔内部与半透明材质(头发、眼镜)仍然困难;对 CAP4D 这类高质量基线收益有限(LPIPS 甚至略升 0.1847→0.1884),方法上限受「可恢复」假设约束;训练与测试均在 512×512 的裁剪人脸域内进行,对野外头像、极端发型、躯干延伸未验证;跨数据集泛化只用了 6 个 INSTA 身份,规模偏小;用户研究也只针对 CAP4D 系对比,未覆盖另外两条管线。
独立分析的弱点
独立分析有五个弱点。(1) 「可恢复性」过滤是双刃剑:LPIPS 阈值把最需要修复的严重失败排除在训练分布之外,模型对灾难性退化(大洞、耳廓错位、整个漂浮的发块)无能为力——改进方向是引入几何监督(深度/法线一致性损失)或不确定性估计,让模型学会「标记不可恢复」并转交几何级修复,而非在 2D 上硬修。(2) 伪目标跨视角冲突:各视角独立精修后直接当真值,缺少多视角联合约束,高频细节容易被平均掉——可按 LPIPS 改善度做置信度加权筛选伪目标,或采用多视角一致的联合扩散精修。(3) 缺少显式时序监督:GaussianAvatars 的 tWE 恶化 20%,逐帧独立处理使嘴部、皱眉等动态区域不稳定——可在 3D 优化阶段加入光流一致性损失或短时窗判别器。(4) MoE 增益边际化:消融中六专家相对两专家/无 MoE 的提升很小(CSIM 差距 0.001–0.005 量级),路由可能退化为近似均匀分工——可用退化类型标签做监督路由,或换成按严重度分层的细粒度 LoRA 专家。(5) 分辨率与评测域受限:512×512、裁剪头像、以自重演为主,面向 VR 会议等真实应用还需全分辨率、牙齿/毛发细节与更大规模跨身份数据验证;CSIM 的轻微下降提示可补充 ArcFace 级别的显式身份保持损失。
未来方向
作者提出的方向:引入显式多视角约束与置信度感知的伪目标选择,减少跨视角不一致;加入显式时序监督与更好的动态面部区域建模,修复 tWE 在部分管线上的回退;攻克口腔内部与半透明外观。基于本文成果还可延伸:(1) 把精修循环嵌入重建过程本身(render-refine-optimize 交替迭代而非一次性 500 步微调),让欠约束区域在训练早期即被引导到正确解;(2) 换用更大的图像编辑基础模型(SDXL-Turbo、Flux 蒸馏版)或把分辨率提升到 1024,检验高频细节上限与身份保持的权衡;(3) 将 EDGAR-SET 的构造流程做成任意头像管线的即插即用「数据增强插件」,并把 MoE 专家与退化类别显式对齐以获得可解释路由;(4) 与 FLAME/3DMM 几何先验结合,对不可恢复的结构错误做几何级修复而非仅外观修复;(5) 扩展到全身高斯化身与重光照场景,检验 Sapiens 特征在更宽域上的泛化;(6) 补充对 RGBAvatar/GaussianAvatars 的大规模感知评测,以及 A/B 测试真实 VR 应用中的长时间会话表现。
复现评估
复现条件较好。代码已公开(论文摘要给出 EDGAR 链接);EDGAR-SET 依赖的 NeRSemble 与 CAFCA 均为公开数据集(NeRSemble 需签署使用协议申请访问),RGBAvatar、CAP4D、GaussianAvatars、Sapiens、POSTER V2、SD-Turbo 均有开源实现或权重。算力门槛适中:数据构造与头像精修在单卡 RTX 3090 完成,EDGAR 训练在单卡 A6000 上约 40 小时(40K 步、batch 4、梯度累积 2、512×512),精修一个头像仅需 5–17 分钟。论文给出完整超参:学习率 $2\times10^{-5}$ 线性预热 1000 步后恒定,$\lambda_{LPIPS}=\lambda_{Gram}=1.0$、$\lambda_{exp}=8.0$、$\lambda_{lb}=0.001$、$\lambda_{L1}=0.6$、$\lambda_{SSIM}=0.4$、$\tau=250$、六个专家、精修时渲染 50 视角并优化 500 步。真正的难点在工程串联:需复现三条基线头像管线、渲染并过滤 40 万量级图像,LPIPS 过滤的具体阈值等细节需自行调参;若只关心使用,直接用公开权重精修现有头像则难度很低。总体复现难度评为中等。
论文图表
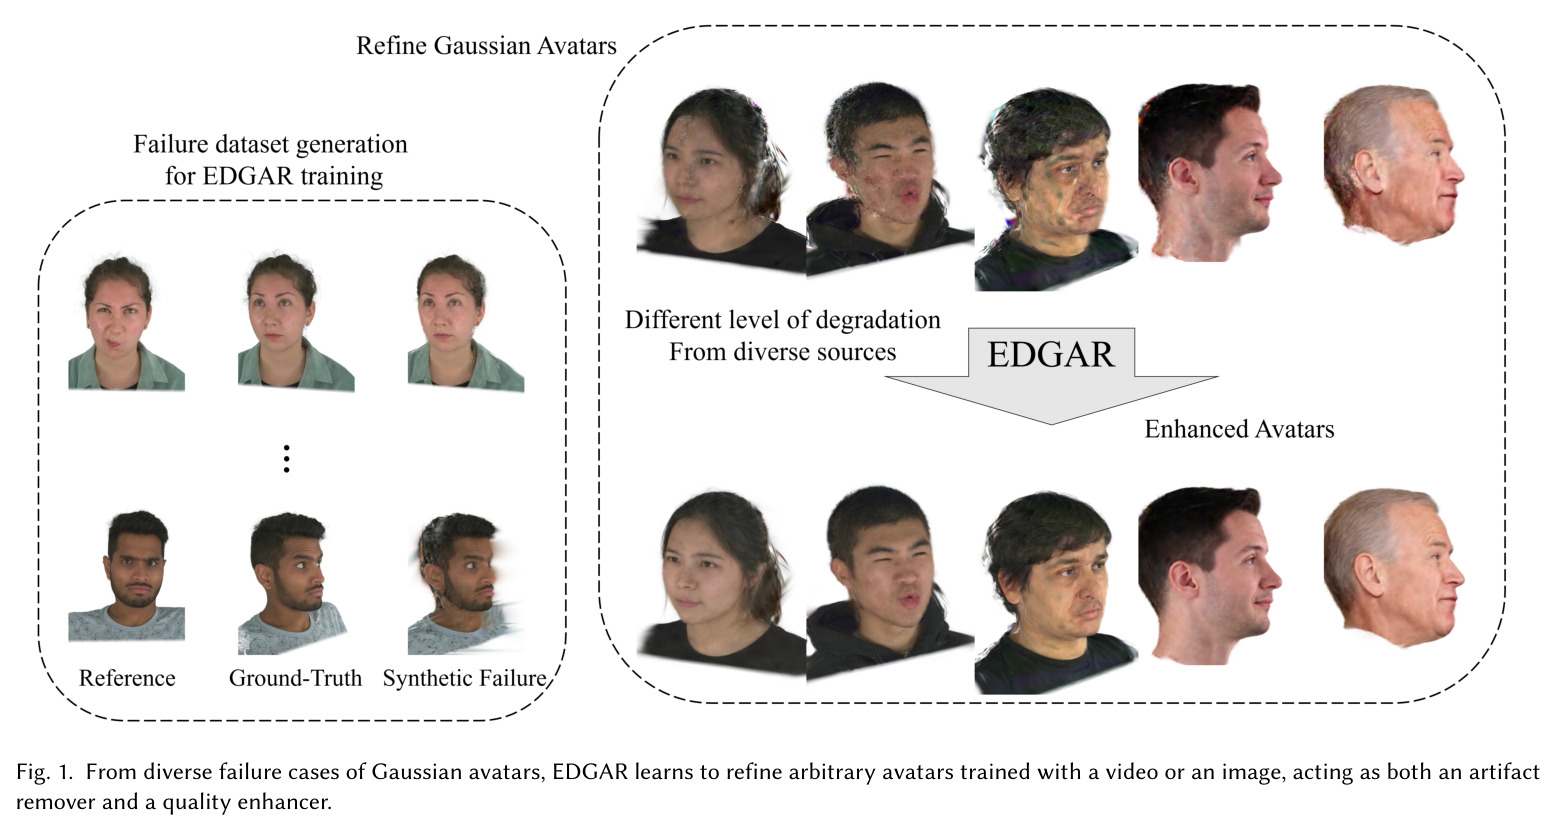
概述图:左侧展示 EDGAR-SET 三元组的构成(退化渲染、真值、参考图),右侧展示对单图/单视频/多视频训练的各类失败高斯头像的精修效果,EDGAR 同时充当伪影清除器与质量增强器。
一图概括全文问题(高斯头像失败案例)与解法(三元组学习 + 通用精修),是理解论文定位的最佳入口。
MoE 消融定性对比:无 MoE 与仅两专家的变体在耳区保留尖锐白色伪影,六专家全模型更有效地抑制了这些伪影。
MoE 是本文架构特色但定量增益小,此图给出其存在价值的直接视觉证据。
用户研究偏好率:vs CAP4D 动画 87.33%、身份保持 91.33%、总体偏好 96.67%;vs CAP4D+SDEdit 分别 94.67%、98.0%、98.0%。
提供感知层面的主观证据,说明定量指标改善确实转化为人类可感知的质量提升。