表象之下:我们谈论智能体进化时忽略了什么 Beneath the Surface: What We Overlook When We Talk About Agent Evolution
基准分数掩盖智能体进化的任务回归、成本与泛化流失,诊断驱动的AGE算法实现更可靠的自我改进。
前置知识
智能体框架与框架进化(Agent Harness Evolution)
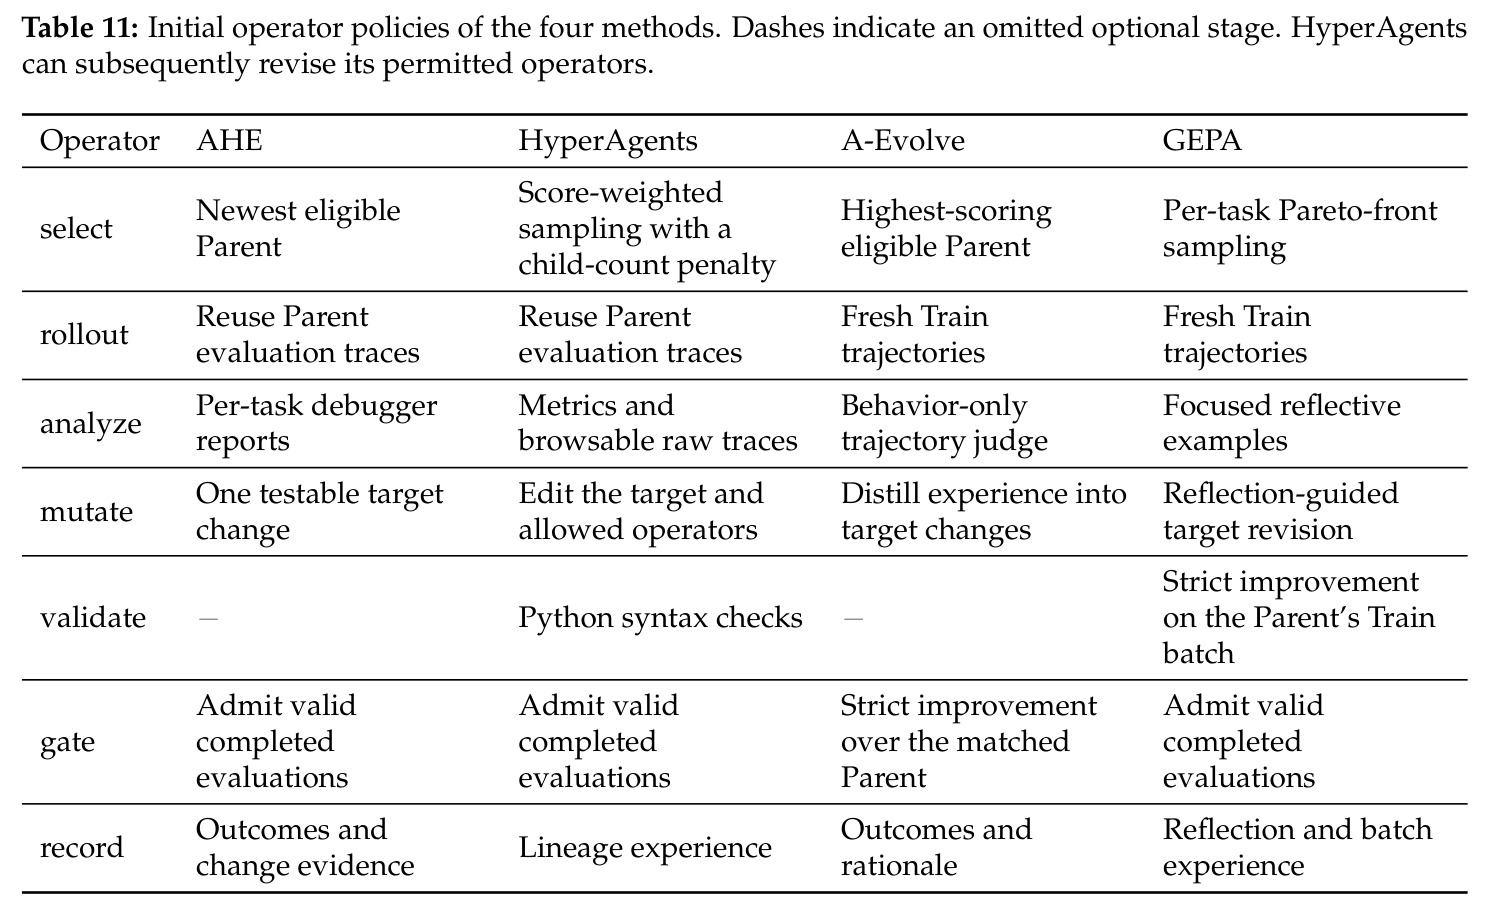
LLM 智能体被定义为冻结的模型 $M$ 加上框架 $H$,即 $A=(M,H)$。框架是包裹模型的外围系统:提示词、技能库、工具接口、编排逻辑甚至源代码,负责塑造模型看到的环境反馈并把输出转化为动作。框架进化指在不更新模型权重的前提下,用类似遗传搜索的循环(选父代→执行收集证据→诊断→变异提出候选→评估准入→归档)迭代修改框架本身。AHE、HyperAgents、A-Evolve、GEPA 都属于这一路线,被视作递归自我改进(RSI)的一种具体形式。
本文的全部实验都围绕『框架进化是否真的带来实用改进』展开,必须先理解这一范式才能看懂三个研究问题与七算子流程。
Avg@k 与 Pass@k
论文对每个任务重复执行 $k=8$ 次。可靠性 $\mathrm{Avg@k}=\frac{1}{Nk}\sum_{n}\sum_{i}Y_{ni}$ 对所有任务×次数的成功指示函数取平均,反映每次执行都成功的稳定程度;经验覆盖 $\mathrm{Pass@k}=\frac{1}{N}\sum_{n}\mathbb{I}[\max_{1\le i\le k}Y_{ni}=1]$ 只要 $k$ 次里成功一次即算覆盖。两者分别对应可靠性与覆盖面,是两个可以分道扬镳的指标。
论文的核心论点之一就是这两个指标必须分开报告——聚合提升会掩盖『新任务被解决、老任务开始失败』的对流现象。
任务周转(Task Turnover)
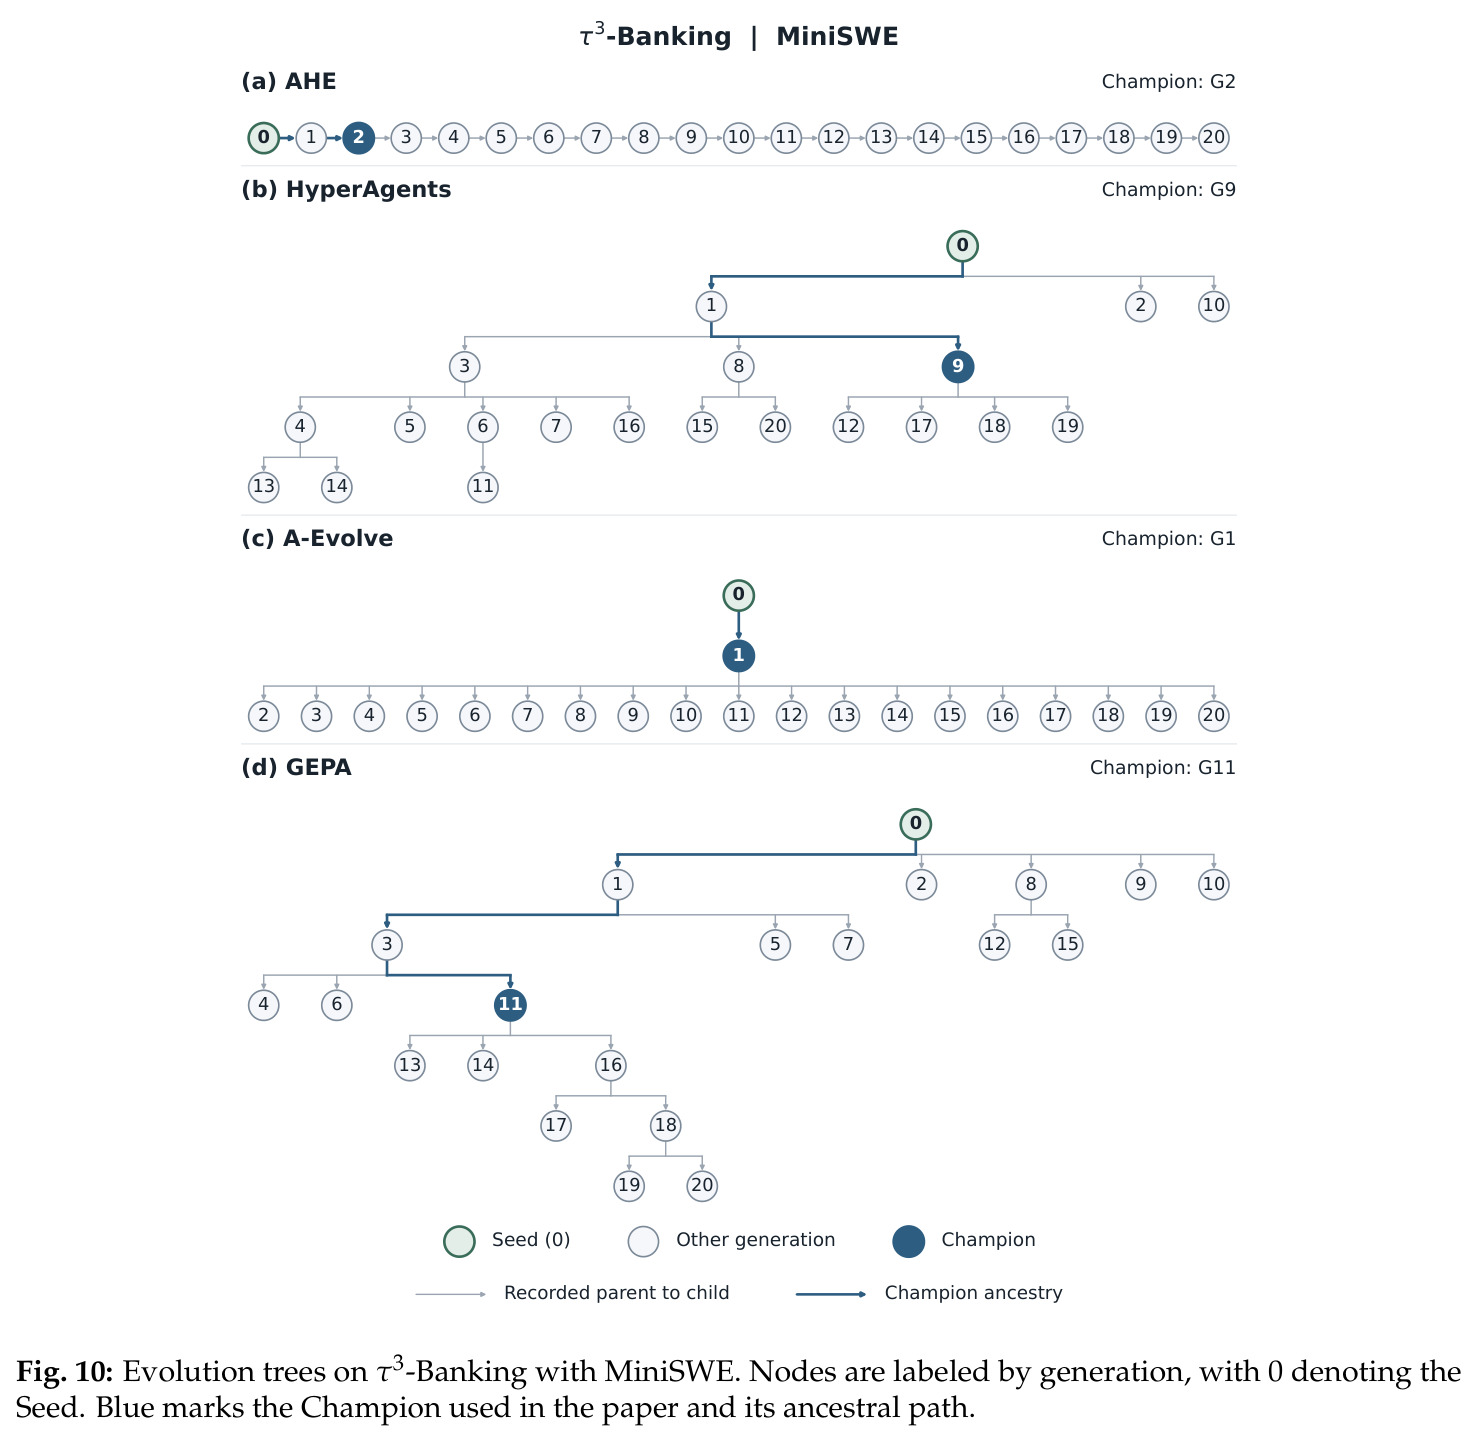
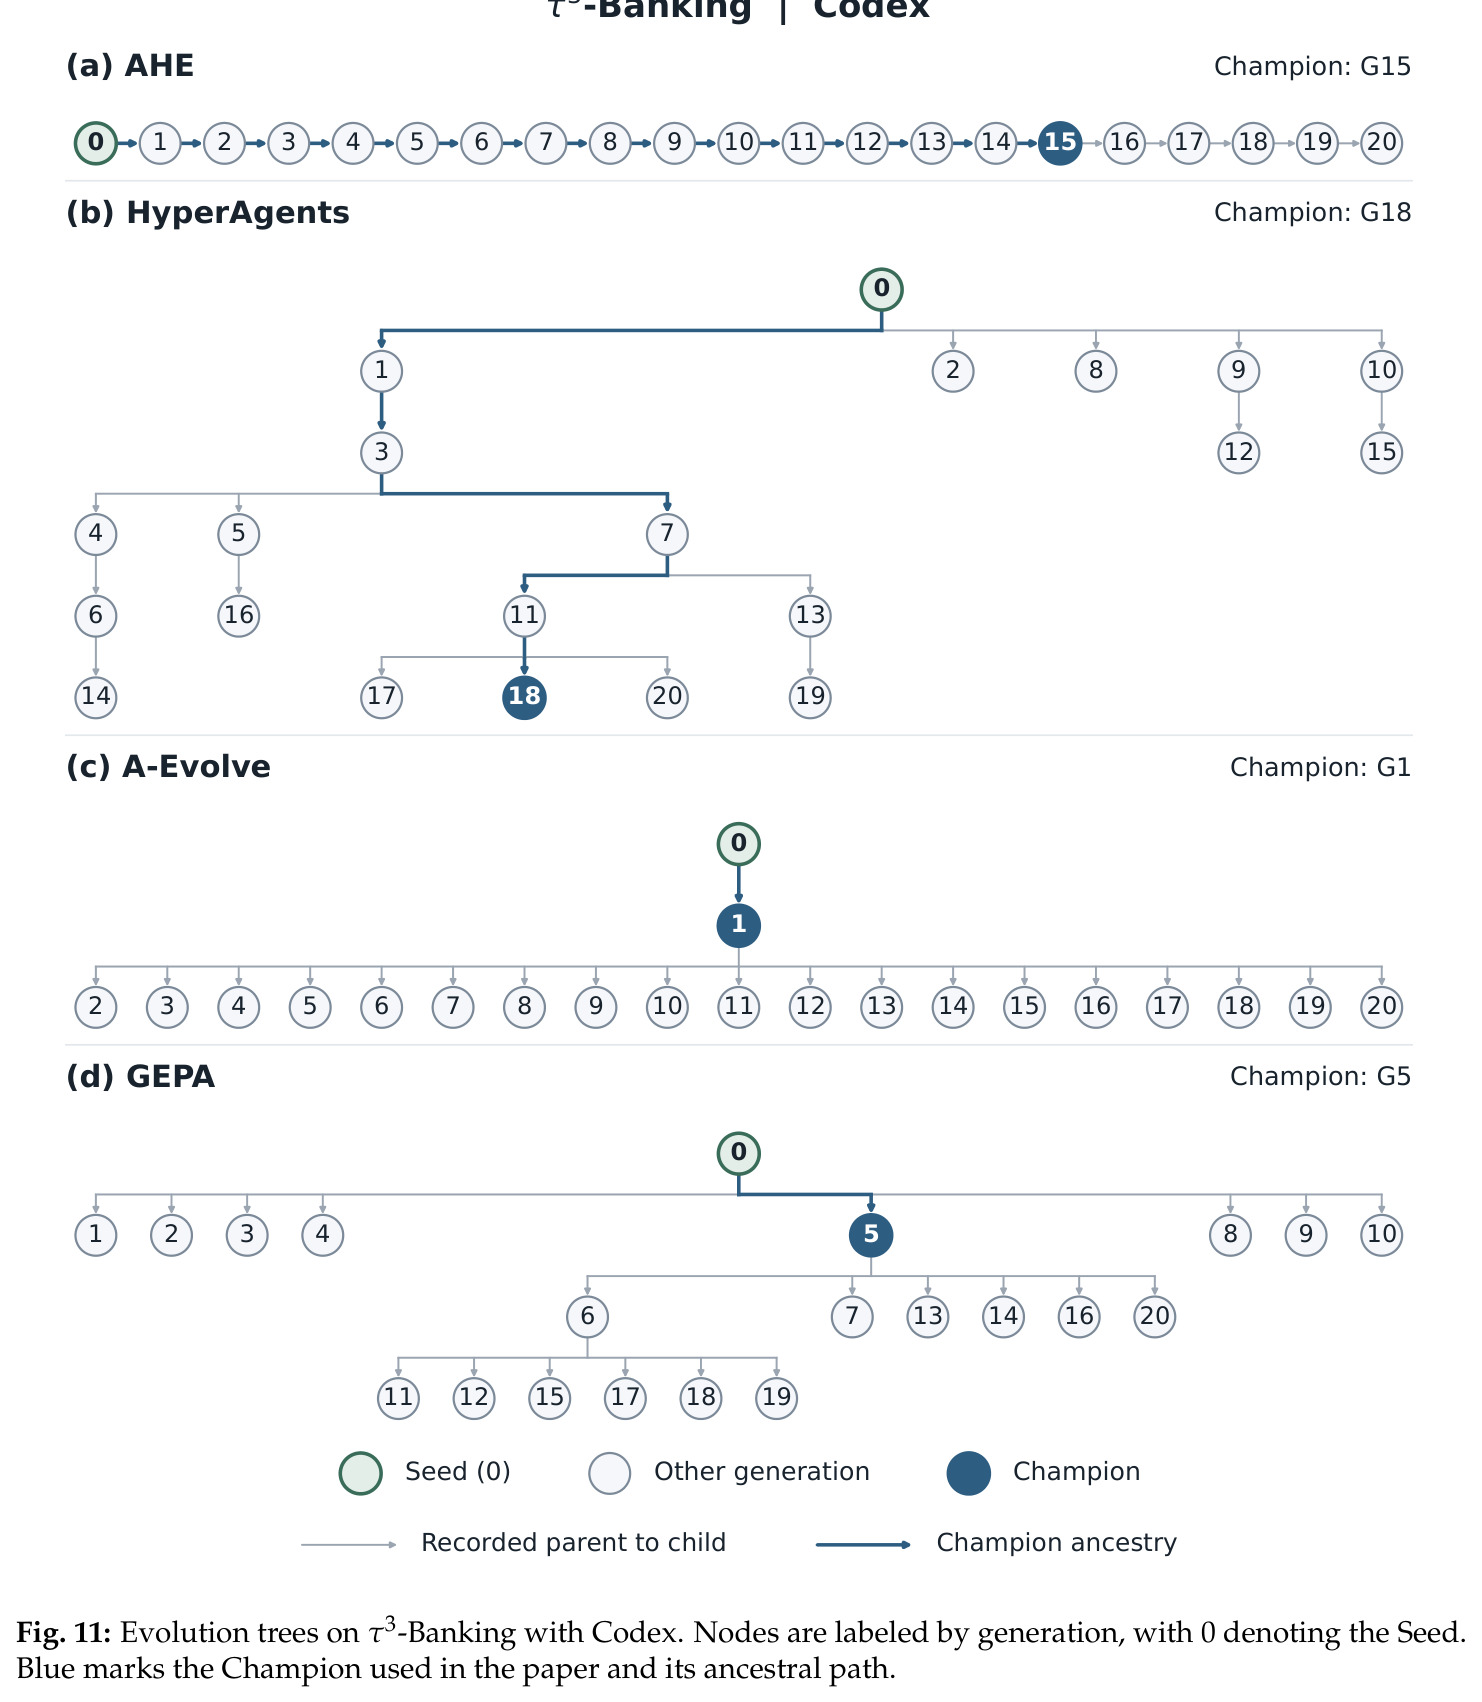
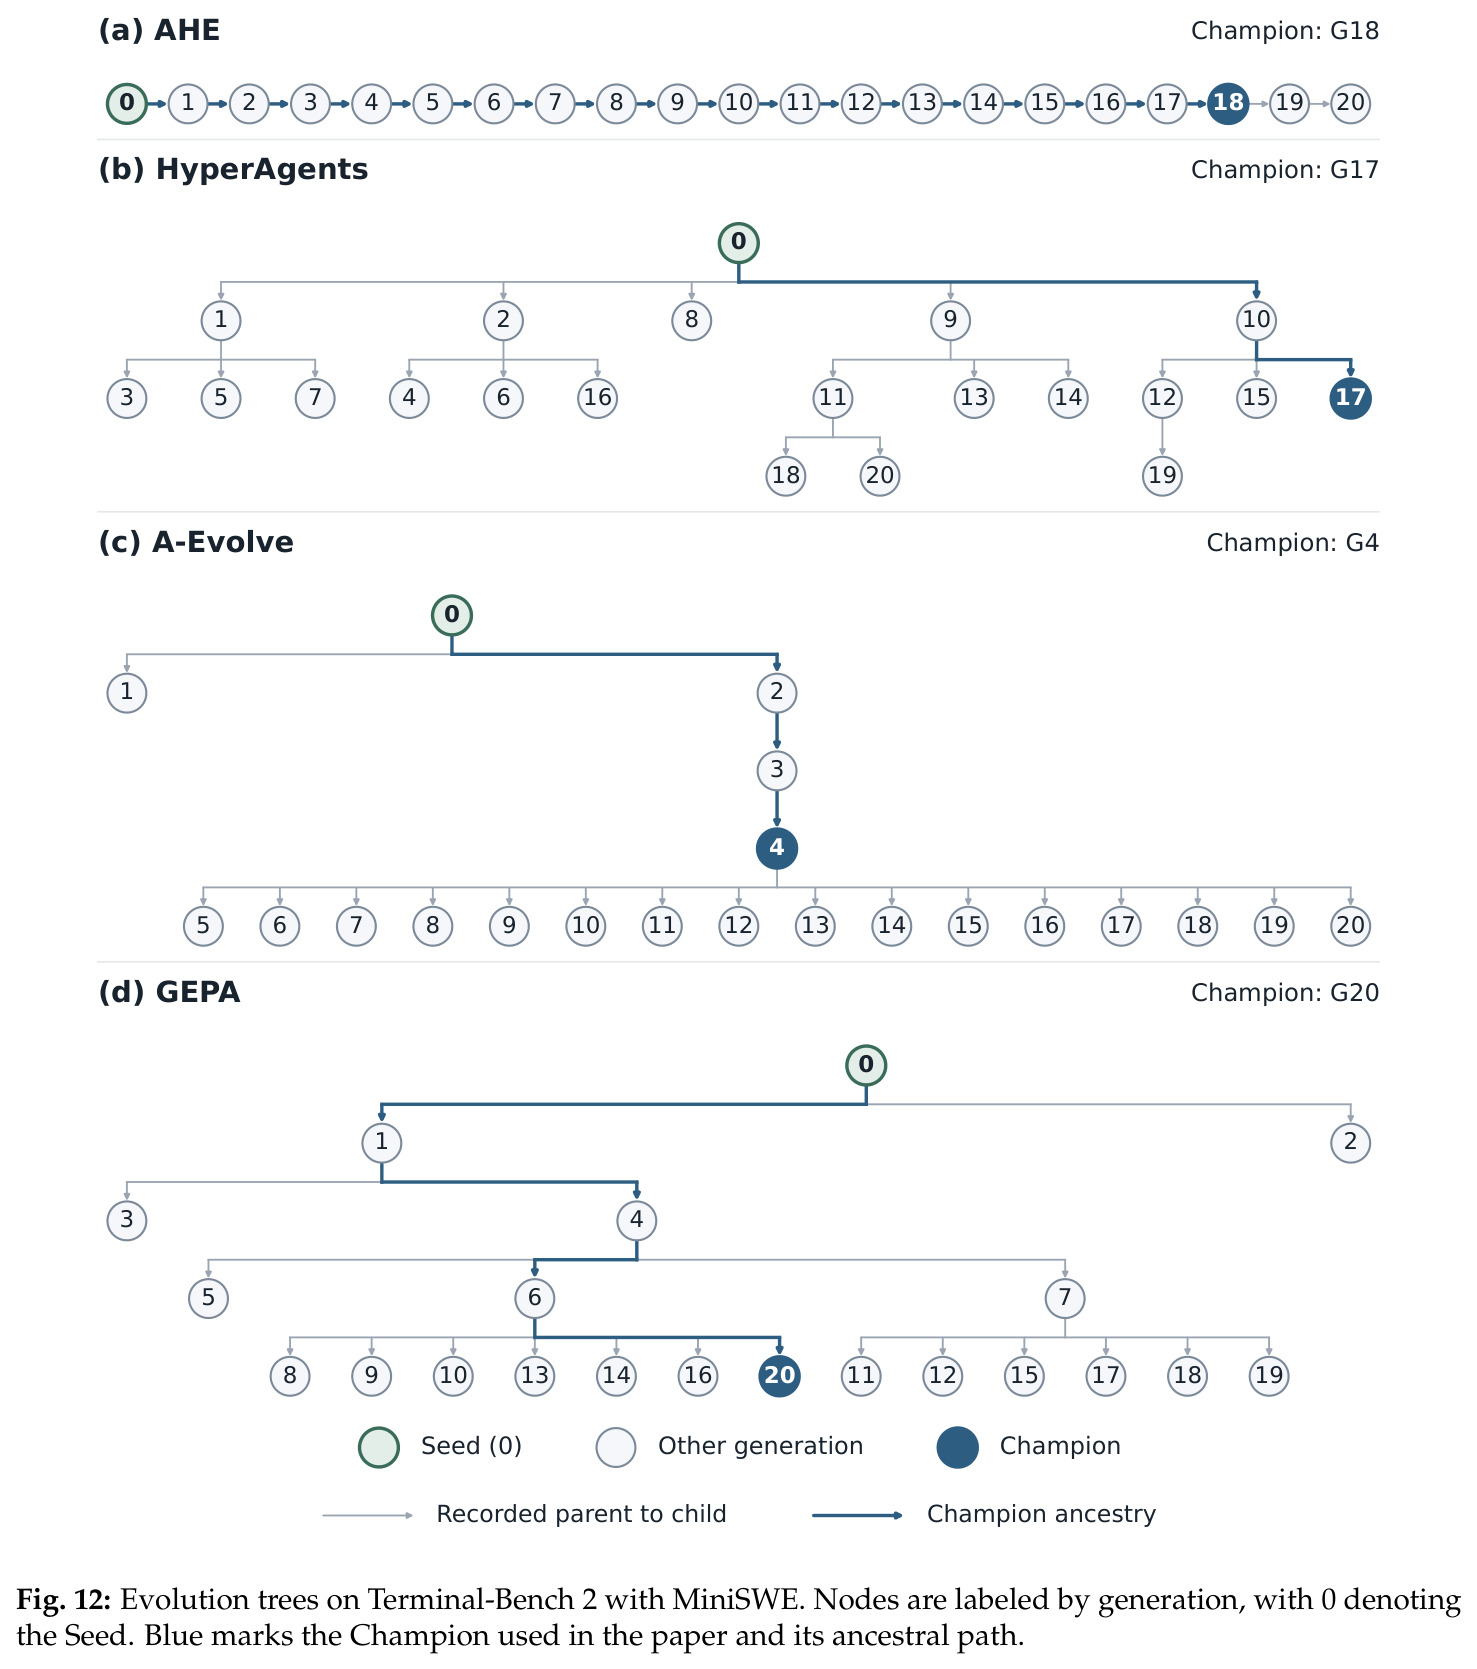
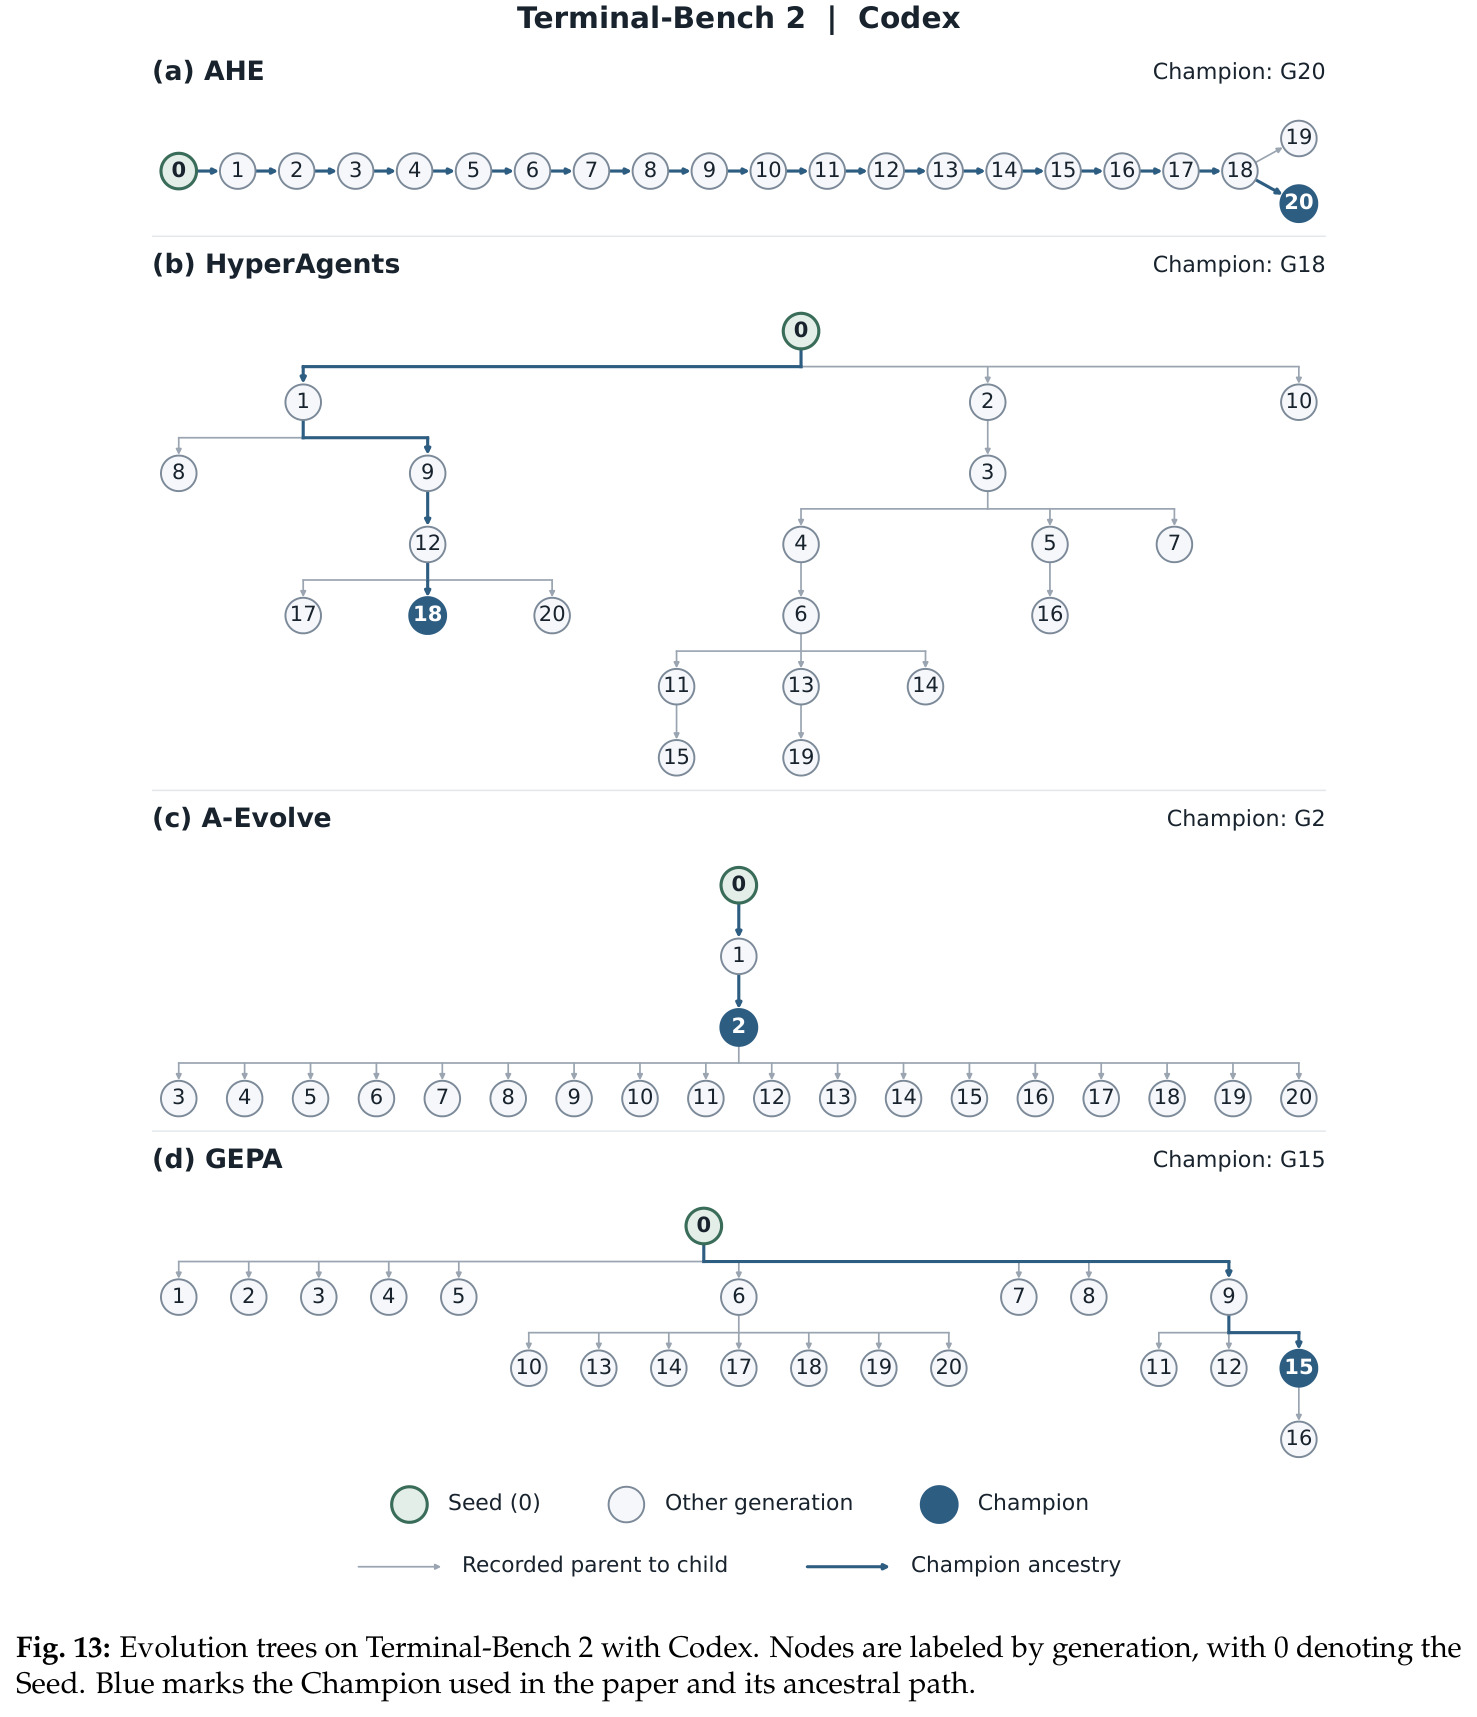
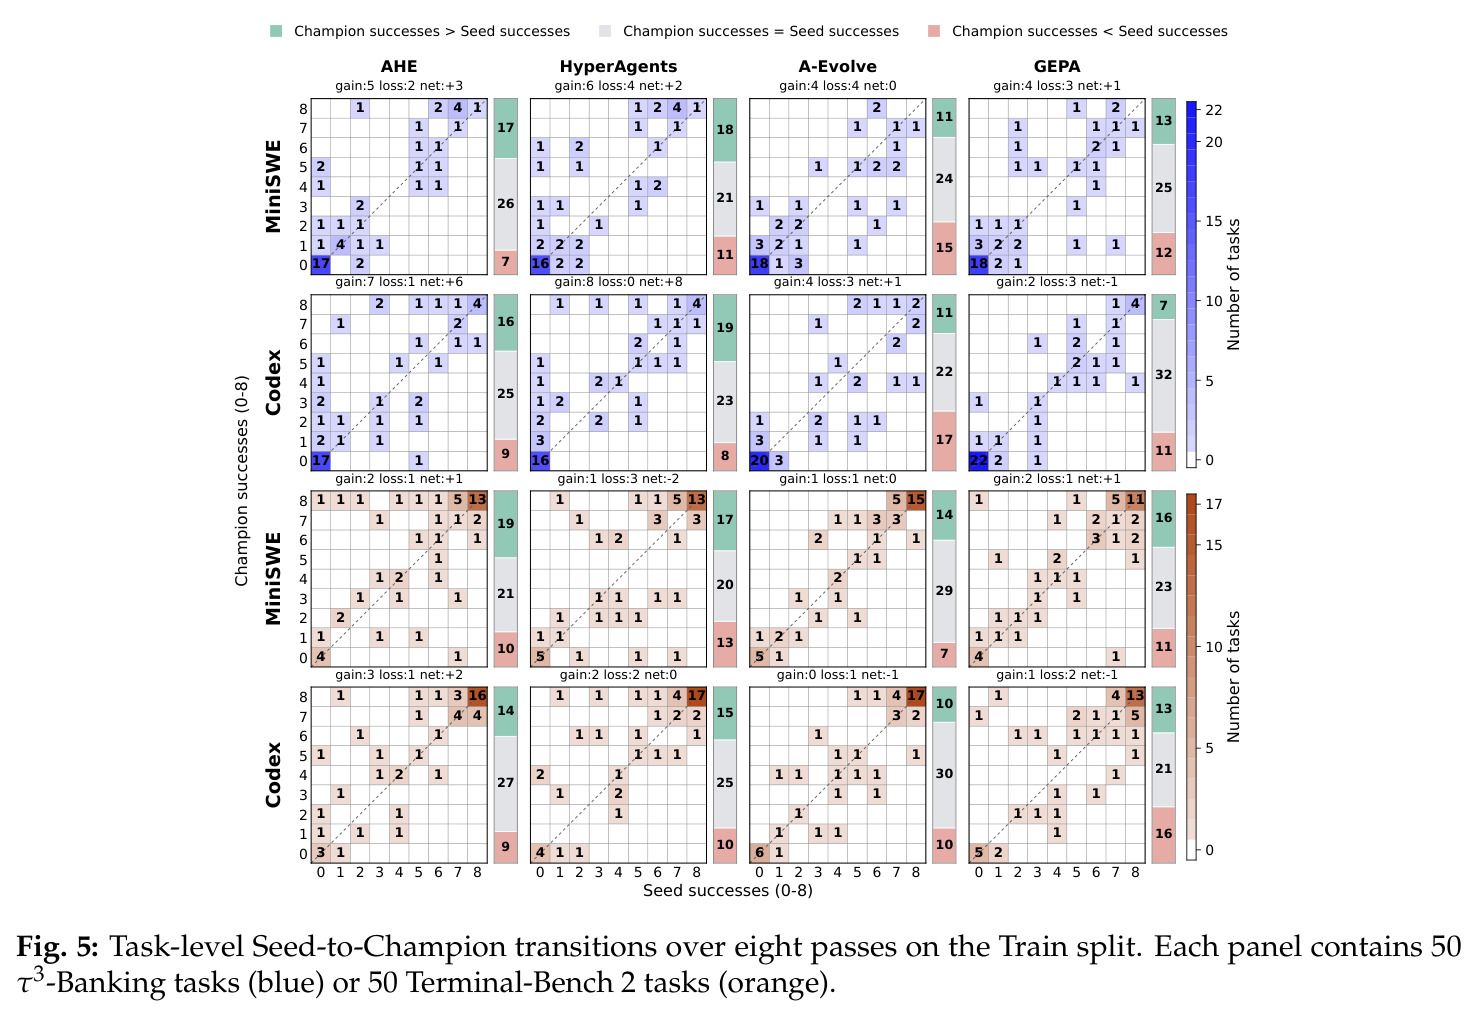
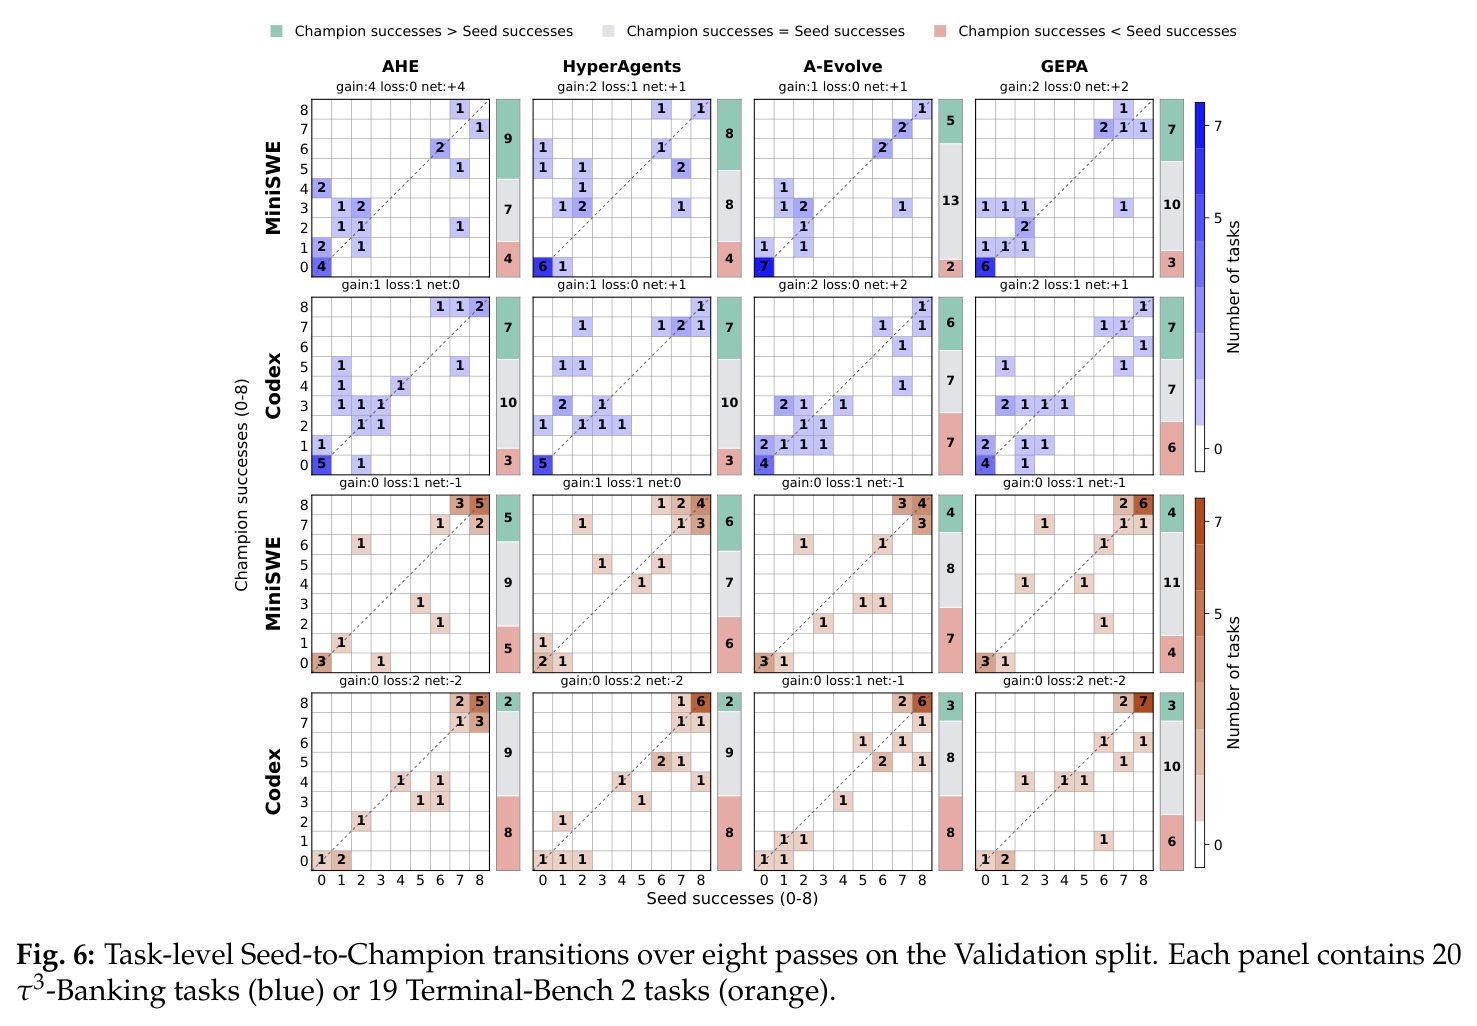
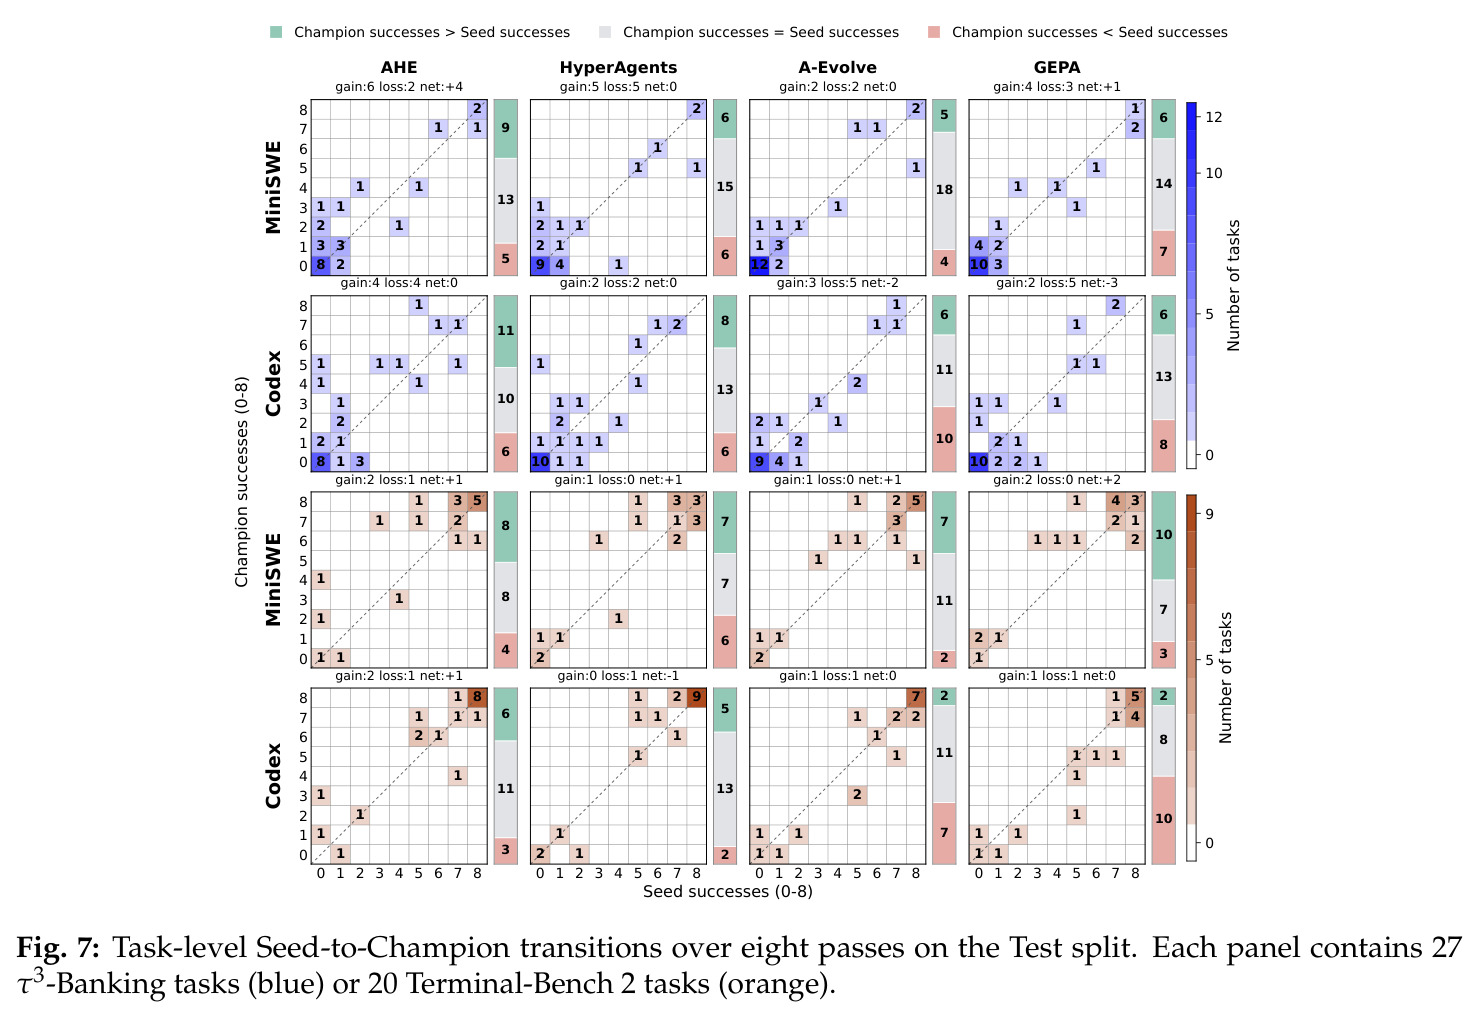
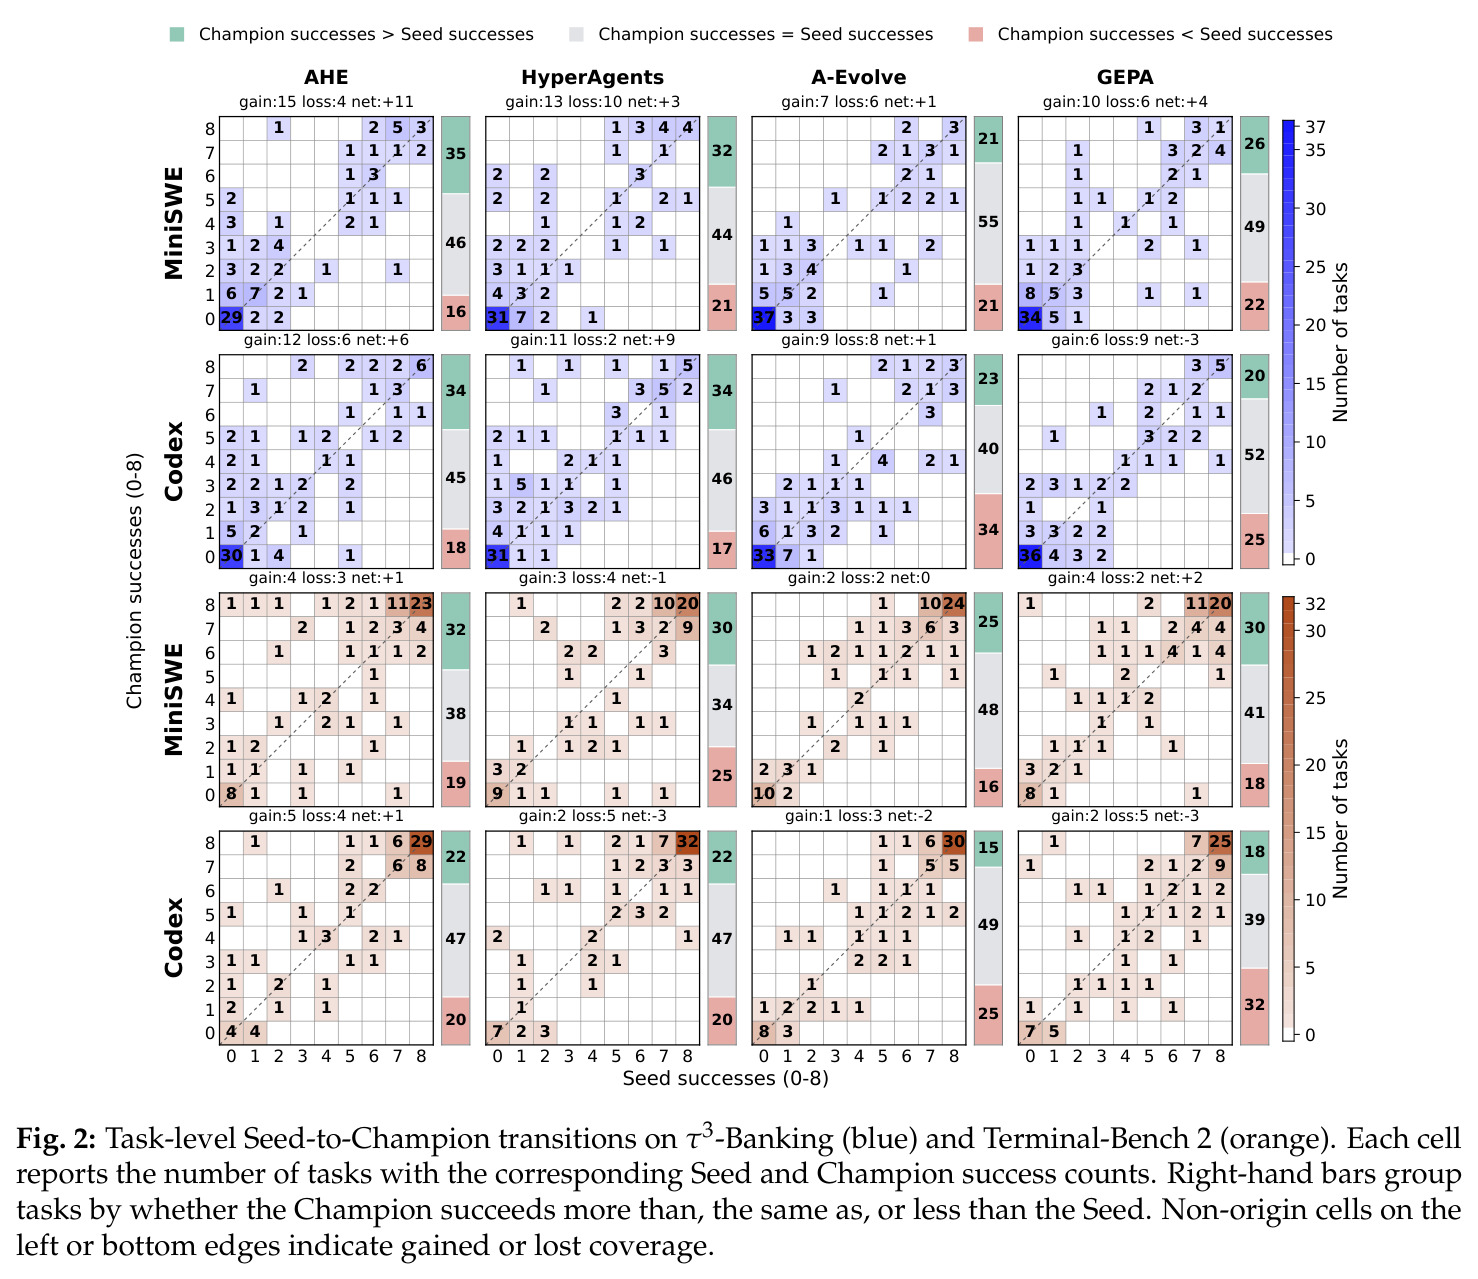
以初始智能体 Seed 为基准,统计最终 Champion 相对 Seed 新覆盖的任务数(gain)和丢失的任务数(loss)。论文发现全部 16 条进化谱系都同时存在新增覆盖与覆盖丢失,因此称『覆盖率是一个流量』而非单调增长的存量。周转把 Pass@k 拆解成方向性信息,能暴露聚合分数完全看不到的任务级回归。
理解周转才能读懂 Fig. 2 的转移矩阵,以及『可靠性 +5.2 但丢掉 10 个已覆盖任务』这类反直觉结论。
实现中心 vs 反思中心进化范式
论文把四种方法分两类:AHE 与 HyperAgents 是实现中心(implementation-centric)——直接编辑智能体的代码与工程组件;A-Evolve 与 GEPA 是反思中心(reflection-centric)——从执行轨迹蒸馏反思结论,转化为提示词、技能等持久化修改。同时搭配两种框架:MiniSWE 2.4.5 允许改内部源码,Codex 0.143.0 只允许改提示词/技能/配置等外层工件。
几乎所有结论都带有『范式×框架可编辑层级』的交叉维度差异(如反思中心在外层框架上测试集可靠性全部下降),不懂这个分类就无法理解结果的系统性。
七算子进化流程
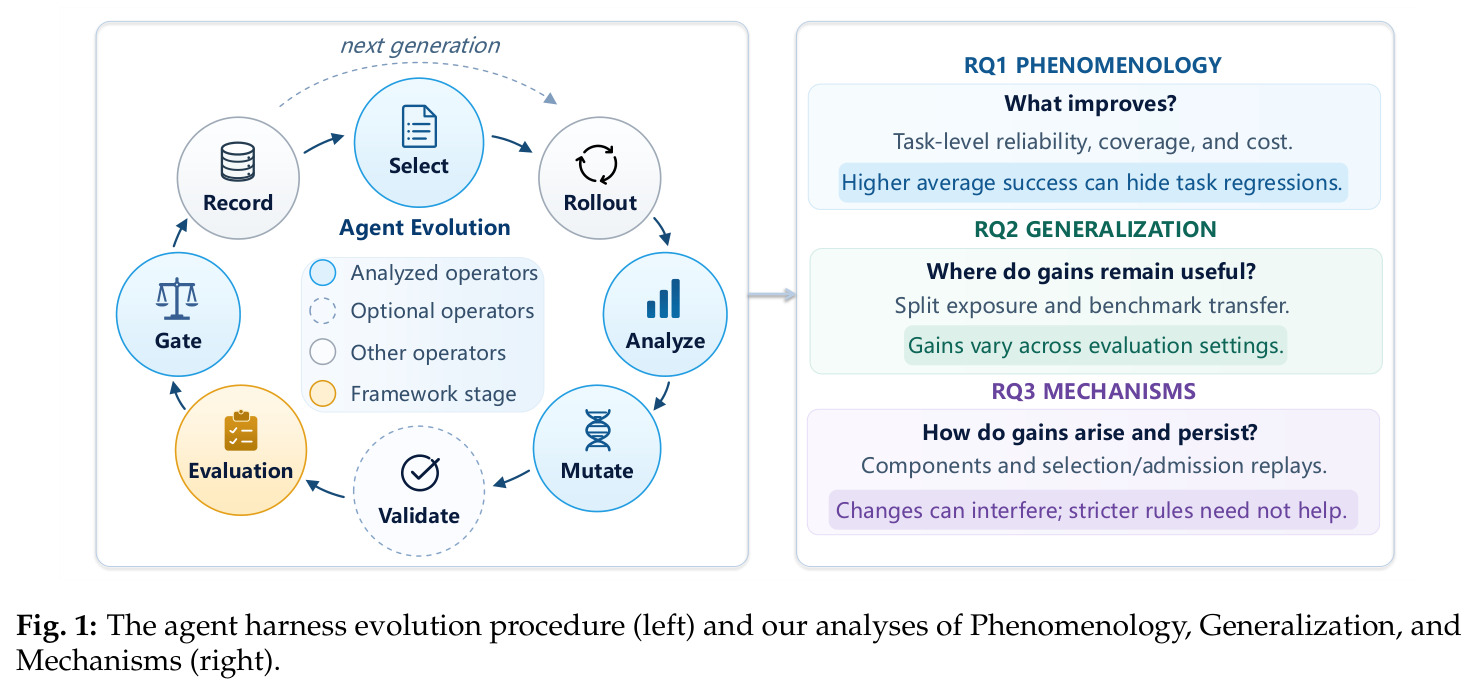
论文把每种进化方法抽象为七个可复用算子:select 选父代、rollout 收集执行证据、analyze 诊断轨迹、mutate 提出候选修改、validate(可选)校验提案、gate 决定是否准入、record 归档。机制分析聚焦 select、analyze、mutate、gate 四个算子,因为它们的决策决定了哪些父代被使用、证据如何引导修改、哪些候选被保留。
第 6 节的机制实验和第 7 节的 AGE 改进都逐个算子展开,这套术语是阅读后半部分的地图。
研究动机
近年 AHE、HyperAgents、A-Evolve、GEPA 等框架进化方法不断报告标准基准上的分数提升,让人以为递归自我改进(RSI)已接近实用。但论文指出:更高的总分并不等于更有用的智能体。总分在任务和尝试次数上取平均,新解出来的任务会掩盖同时丢掉的任务;每次执行的部署成本、以及超出引导进化任务范围的表现,完全不在分数里。以本文实测为例:16 条进化谱系中 11 条可靠性(Avg@8)提升、10 条覆盖(Pass@8)提升,但全部 16 条谱系都同时获得新任务并丢失旧任务;HyperAgents 在 τ3-Banking(MiniSWE)上可靠性 +5.2 分,却丢掉了 10 个 Seed 原本覆盖的任务;11 条可靠性提升的谱系里 8 条每次尝试的部署成本反而更高。只看单一聚合分数,会系统性偏向脆弱或昂贵的版本,把对进化所用任务的过拟合适当成普遍进步。
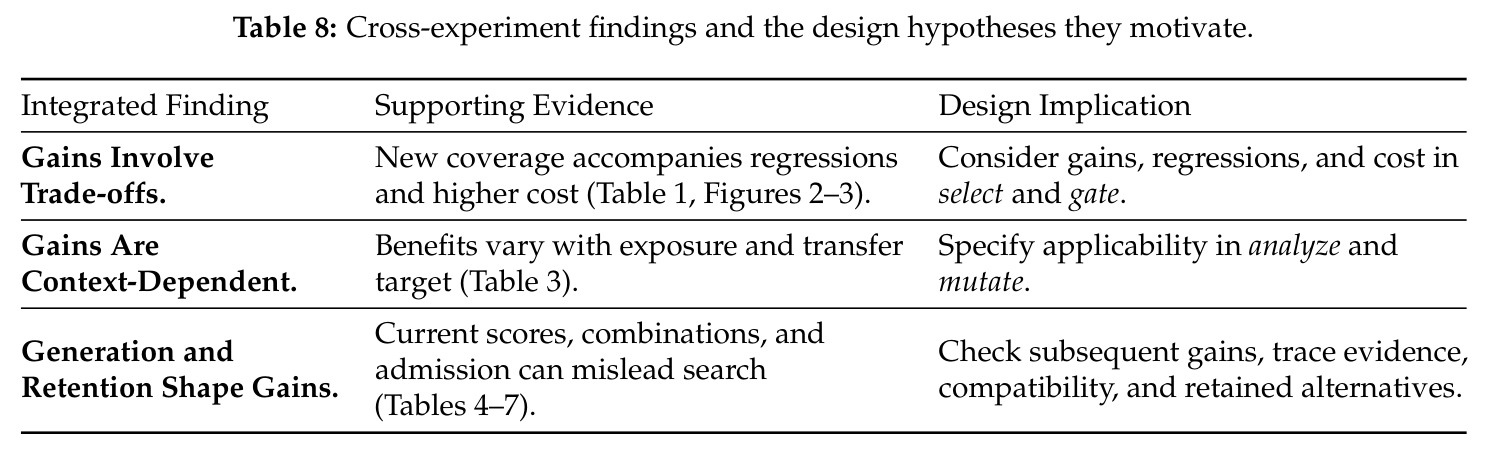
本文的目标是论文要系统回答三个研究问题:RQ1(现象学):智能体进化带来的是可靠、高效的改进,还是伴随任务覆盖取舍与隐性成本?RQ2(泛化):进化期间取得的增益,在部署到新环境或未见任务时能否存活?RQ3(机制):哪些进化算子负责有益修改的产生与保留?在回答之外,论文还给出一个建设性出口:把这些诊断结论转化为对 select、analyze、mutate、gate 四个算子的具体修订,形成 EvoAudit 诊断工作流,并组装成 Audit-Guided Evolution(AGE)算法,在两个基准×两种框架的全部四个设置上验证修订后的进化确实更可靠、覆盖更高、丢任务更少、成本可控。
与已有工作不同的是,已有工作要么提出新进化方法,要么笼统质疑评估。Kapoor 等强调智能体评估要计入成本、可复现性与超越聚合成功率的泛化;Wang 等发现在可比反馈与推理预算下,框架进化相对 test-time scaling 优势不一致、held-out 泛化有限——但这些都停留在『分数不可信』的宏观层面。本文的独特切入是把聚合分数拆解到任务级流转、成本-覆盖曲线与跨基准迁移三个维度,并进一步把诊断粒度落到具体算子决策上:用受控 Parent 扩展检验『当前分最高是否等于改进潜力最大』,用 Component 干预检验『变更之间是否兼容』,用冻结池准入重放检验『更严的准入是否真的保留更好的候选』。这使结论从『进化有坑』升级为『哪一步该用哪类证据』的可检验规则。
核心方法
论文分两段:先做大规模实证审计,再构造性改进。审计部分在统一流程下评估四种方法(实现中心的 AHE、HyperAgents,反思中心的 A-Evolve、GEPA),统一使用 GPT-5.4;每种方法跑两种框架——MiniSWE 2.4.5(可改内部源码)与 Codex 0.143.0(只能改提示词、技能等外层工件);任务为通用任务 τ3-Banking(97 题)与编码任务 Terminal-Bench 2(89 题),均分 Train/Validation/Test,进化只用 Train/Validation,Test 留给 Seed 与 Champion 报告评估,共 16 条谱系。RQ1 用 8 次重复执行比较 Avg@8、Pass@8、任务周转与部署成本 $C_{\mathrm{dep@k}}$;RQ2 用 split 分解与跨基准迁移(τ3→τ2-bench,TB2→DeepSWE v1.1);RQ3 用 Parent 扩展(4-Parent 池)、Component 干预(孤立组件 vs 组合 vs 通用提醒)与冻结池准入重放。第二段把发现写成四个算子修订装入 A-Evolve 得到 AGE,统一配置 20 代、每代 1 候选、种子 0。
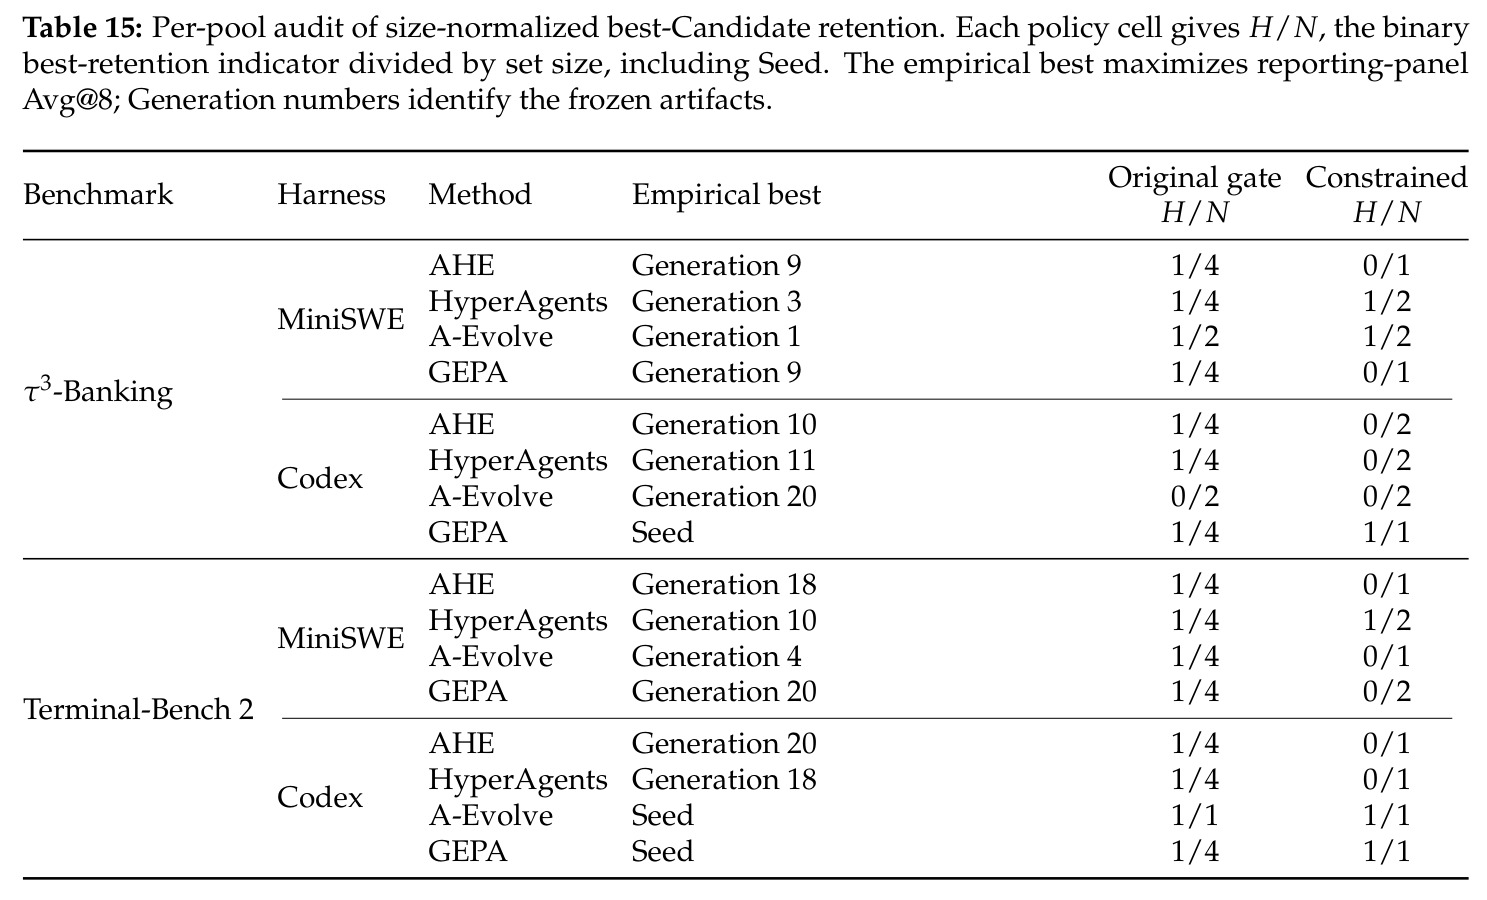
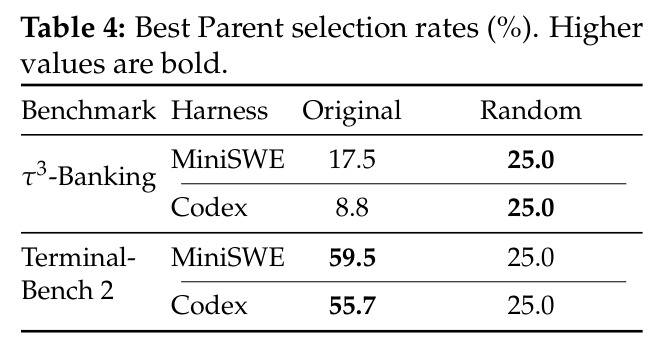
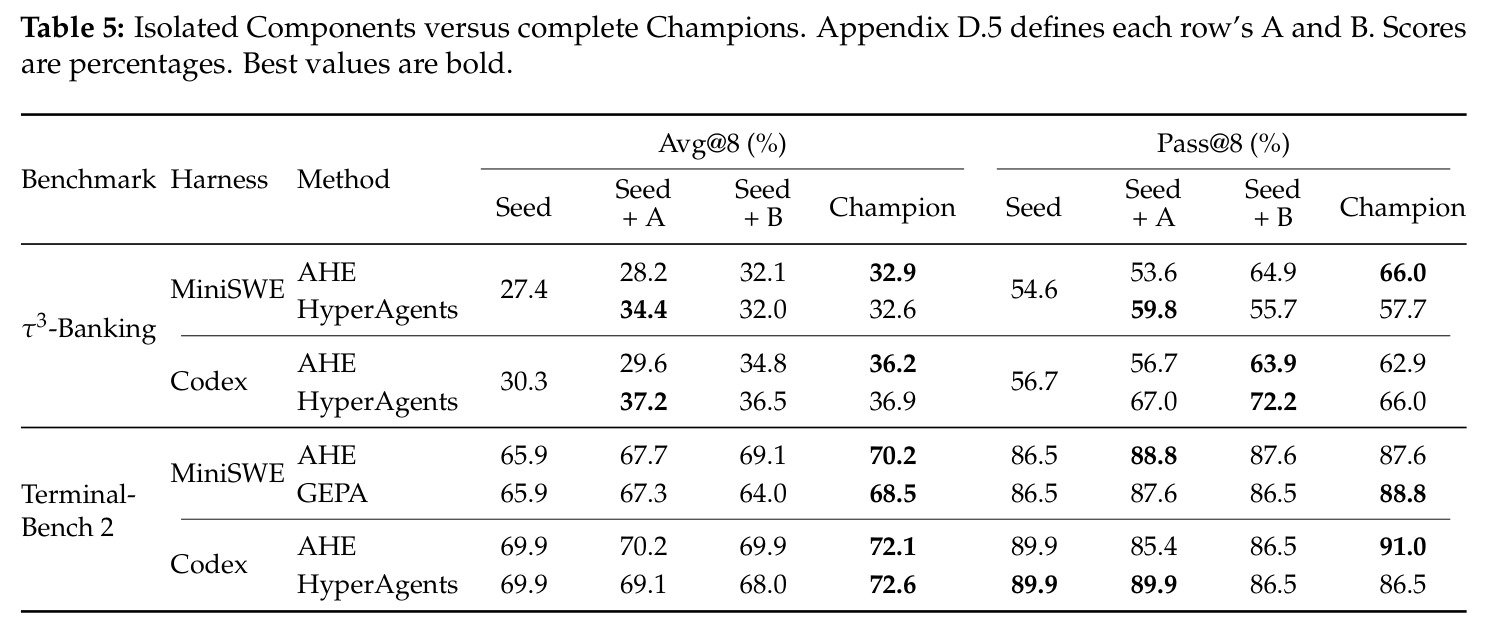
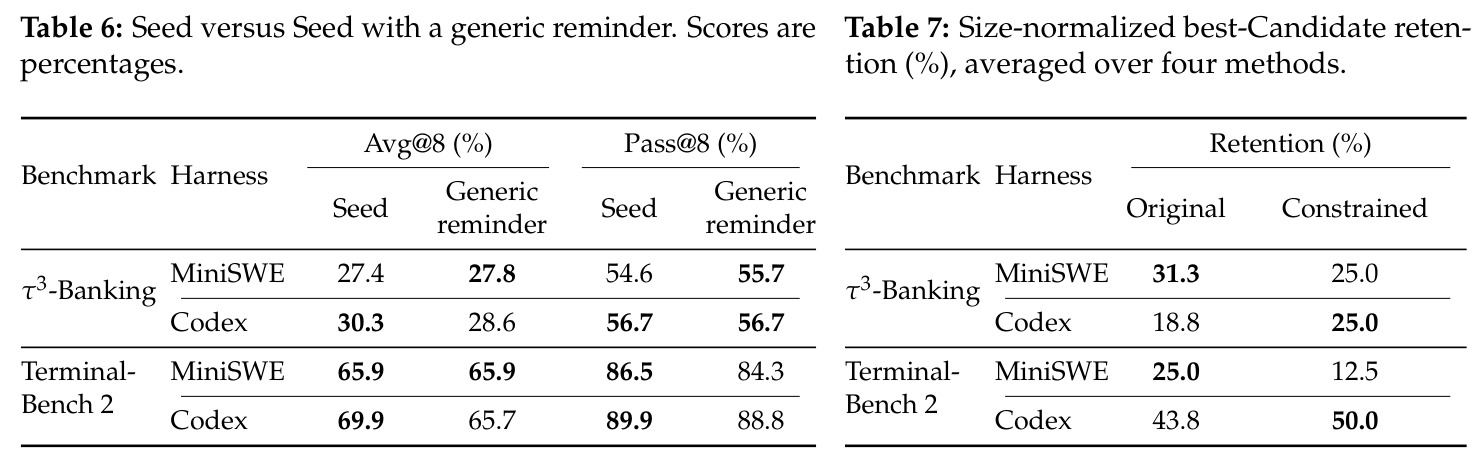
核心命题是『证据必须匹配决策』:当前性能、改进潜力、变更兼容性、保留质量是四个不同目标,同一个聚合分数无法同时服务它们。实验证据一一对应:select 上,原生选择规则在通用任务上挑中最佳 Parent 的概率(MiniSWE 17.5%、Codex 8.8%)甚至低于随机基线 25%,在编码任务上却超过 55%——当前分与后续增益的关系随领域反转;analyze 上,基于轨迹的具体变更在 16 例中 15 例胜过『记得检查工具、验证结果』之类的通用提醒;mutate 上,6/8 的完整组合优于任一孤立组件,有一个编码案例只有组合才超过 Seed——变更之间存在依赖与干扰;gate 上,要求『均分更高且回归≤0.05』的更严准入把含最佳候选的池从 15 个降到 6 个——更保守不等于更好。据此把每个决策改用其目标后果的直接证据来驱动,就是 AGE 的设计哲学。
方法步骤详情
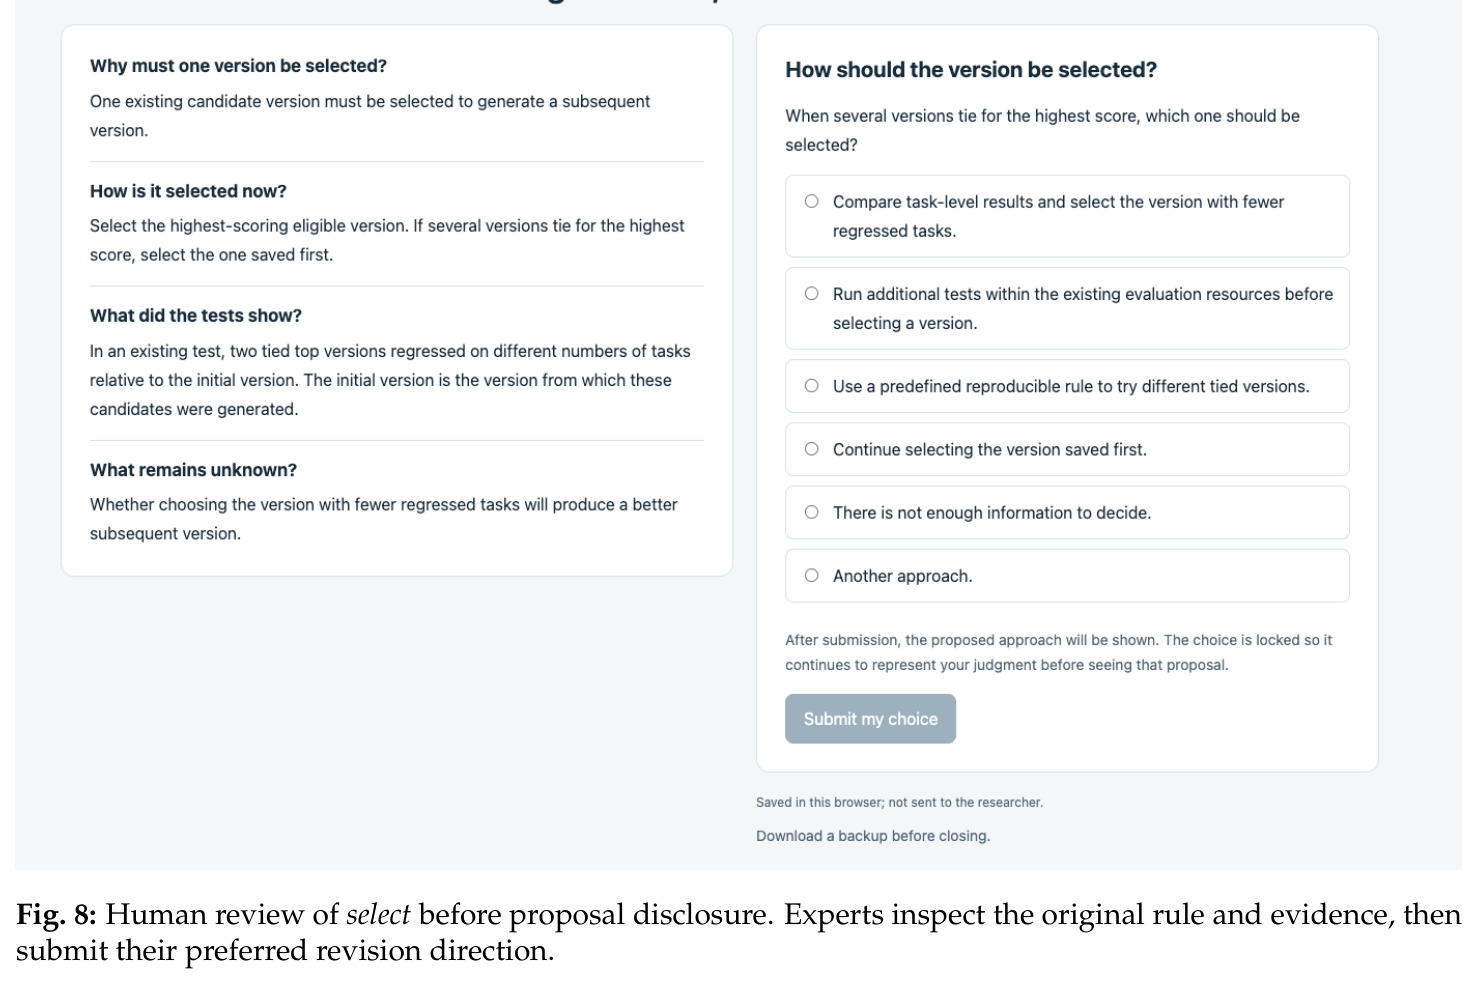
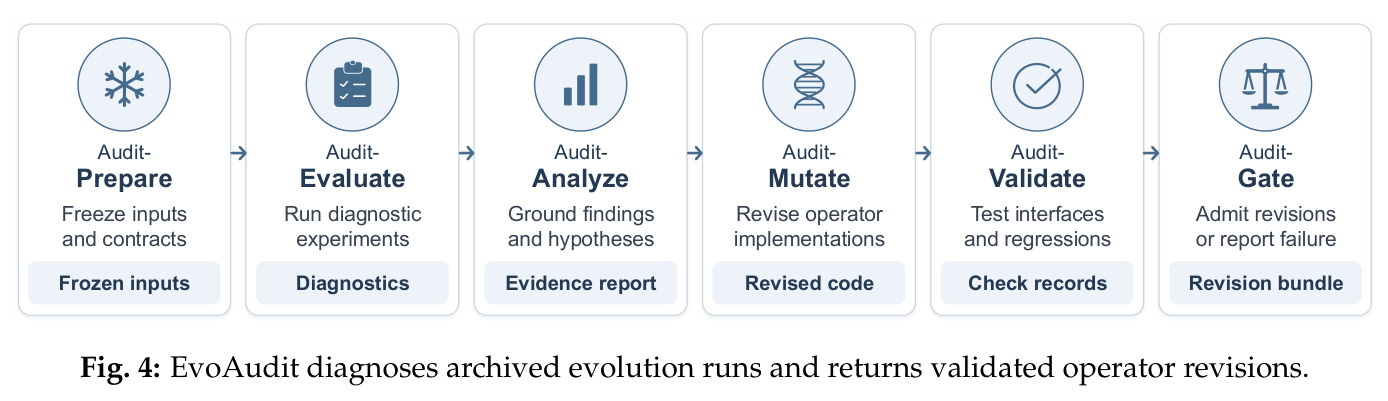
EvoAudit 六阶段:准备(冻结输入与契约)→评估(跑诊断实验)→分析(溯源为带证据的假设)→变异(修订算子实现)→验证(测接口与回归)→准入或报告失败。装入 A-Evolve 后四个修订为:① Select 回归感知平局裁决:保留最高分目标,仅对确切平局改用 $R(C)=\sum_{t\in D_{val}}\mathbb{I}[\bar{r}_t(C)<\bar{r}_t(A_0)]$,在平局集中选 Seed 相对回归最小者,无可比证据则回退均匀随机。② Analyze 行为接地诊断:收集当前及上一条谱系 rollout,轨迹渲染≤12000 字符,judge 输出 0–10 分(0–3 崩溃、4–6 部分进展、7–10 有检查支撑的完成)与 Observed/Inference 区分;证据包预算 τ3 30000、TB2 60000 字符。③ Mutate 依赖闭合变更:先写明观察行为、推断机制、替换行为、激活条件与预期取舍,检查受影响接口,做单一连贯干预并保留成功轨迹中的有用行为。④ Gate 分数优先、成本感知:$\mathrm{accept}(C,P)=\mathbb{I}[s(C)>s(P)\lor(s(C)=s(P)\land Q(C,P)\land c(C)<c(P))]$;canonical Validation 用 20/19 个任务,Champion 另做 8-pass 评估。
技术新颖性
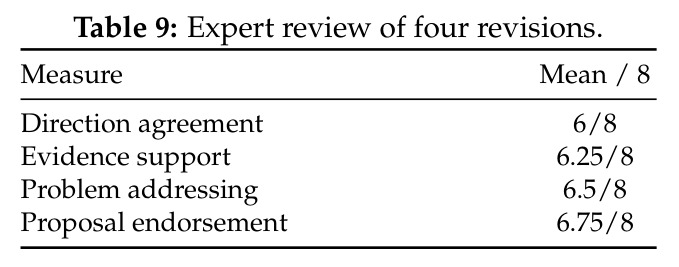
本文不提出新的进化搜索算法,新颖性在方法论层面:第一,把四种异构方法放进 RSIHub 的七算子共同坐标系(select/rollout/analyze/mutate/validate/gate/record),使性能差异可归因到具体算子决策,而不是把方法当黑箱整体比较;第二,每个诊断结论都必须写成『支持证据+预期效果+适用条件』的三元组,并由 8 位专家做四维盲评(方向一致 6/8、证据支持 6.25/8、问题针对 6.5/8、提案认可 6.75/8),避免自说自话;第三,AGE 的修订是保守的——只改决策的证据来源,不动 rollout、record、评估器、任务划分与编辑权限契约,从而能把四个设置上的一致改进归因于『决策证据的替换』本身。这种『审计→修订→复验』的闭环在智能体进化文献中是首次出现的完整范式。
实验结果
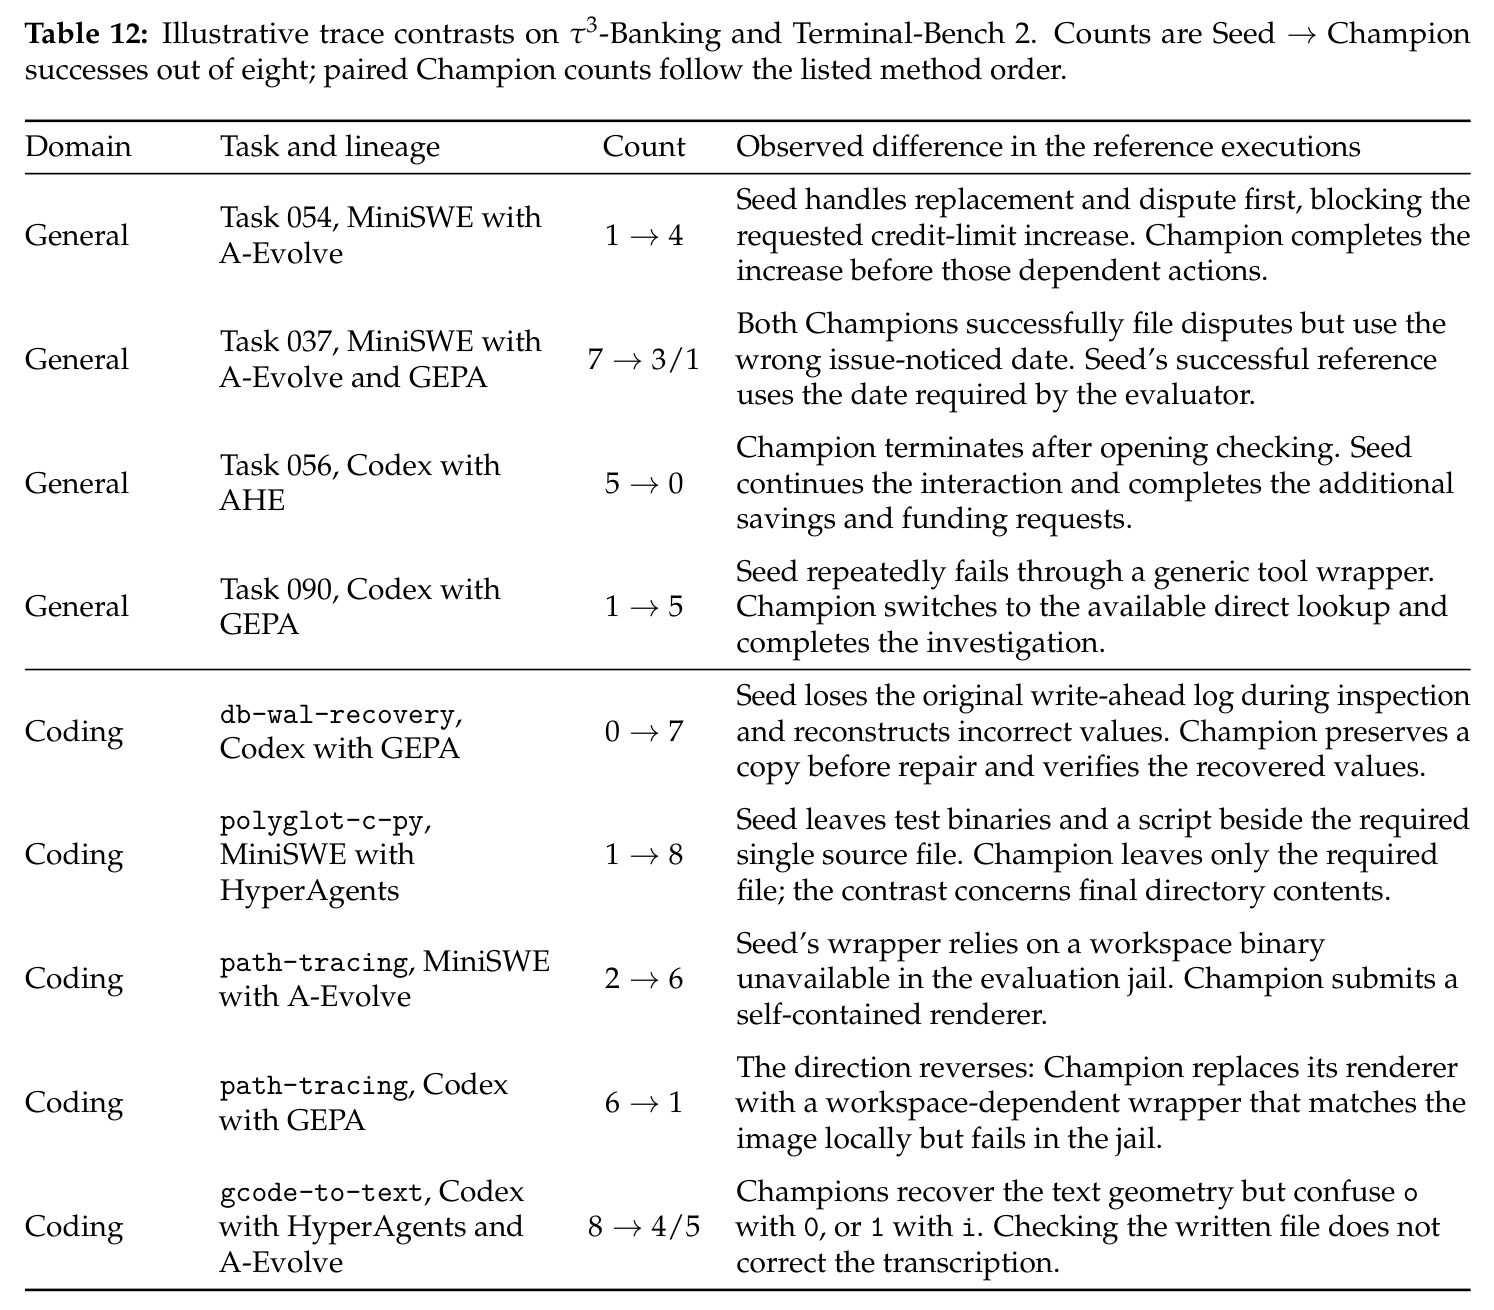
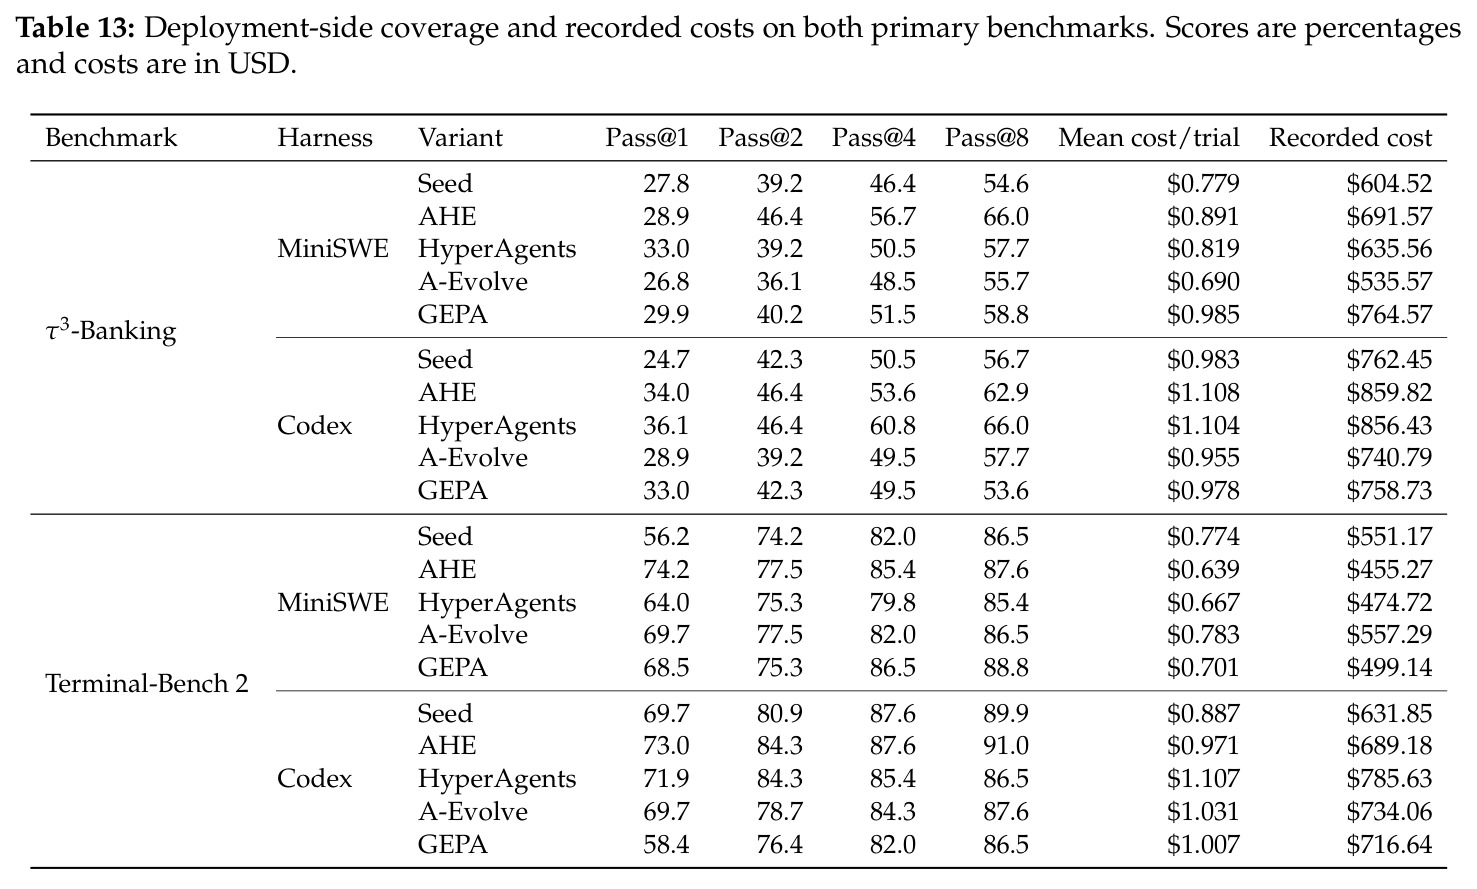
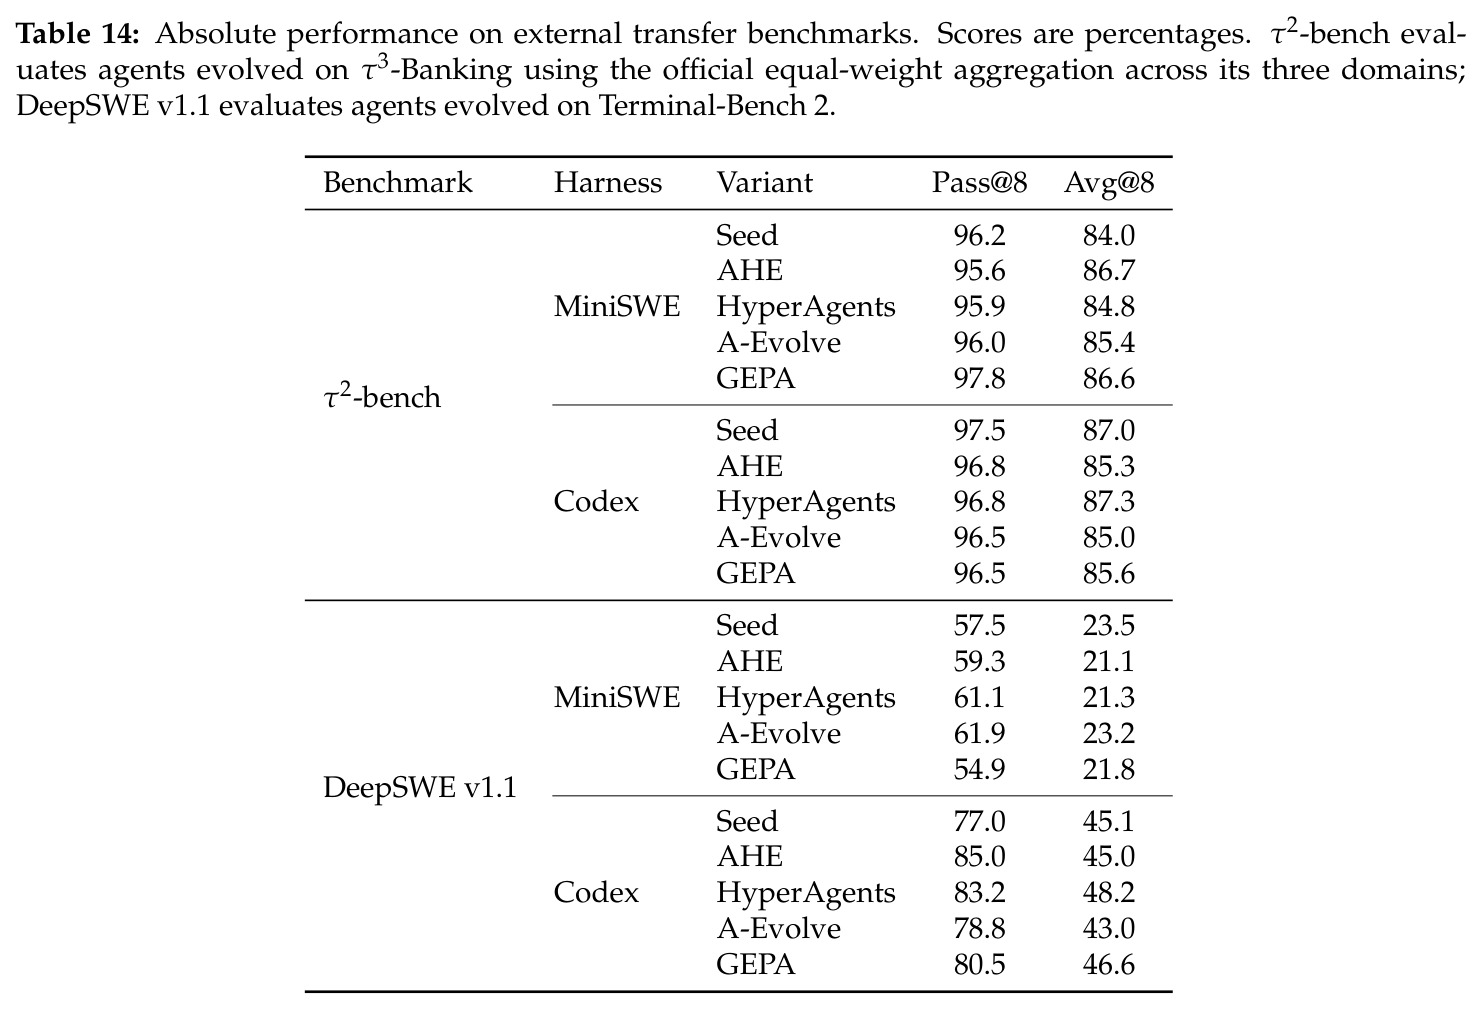
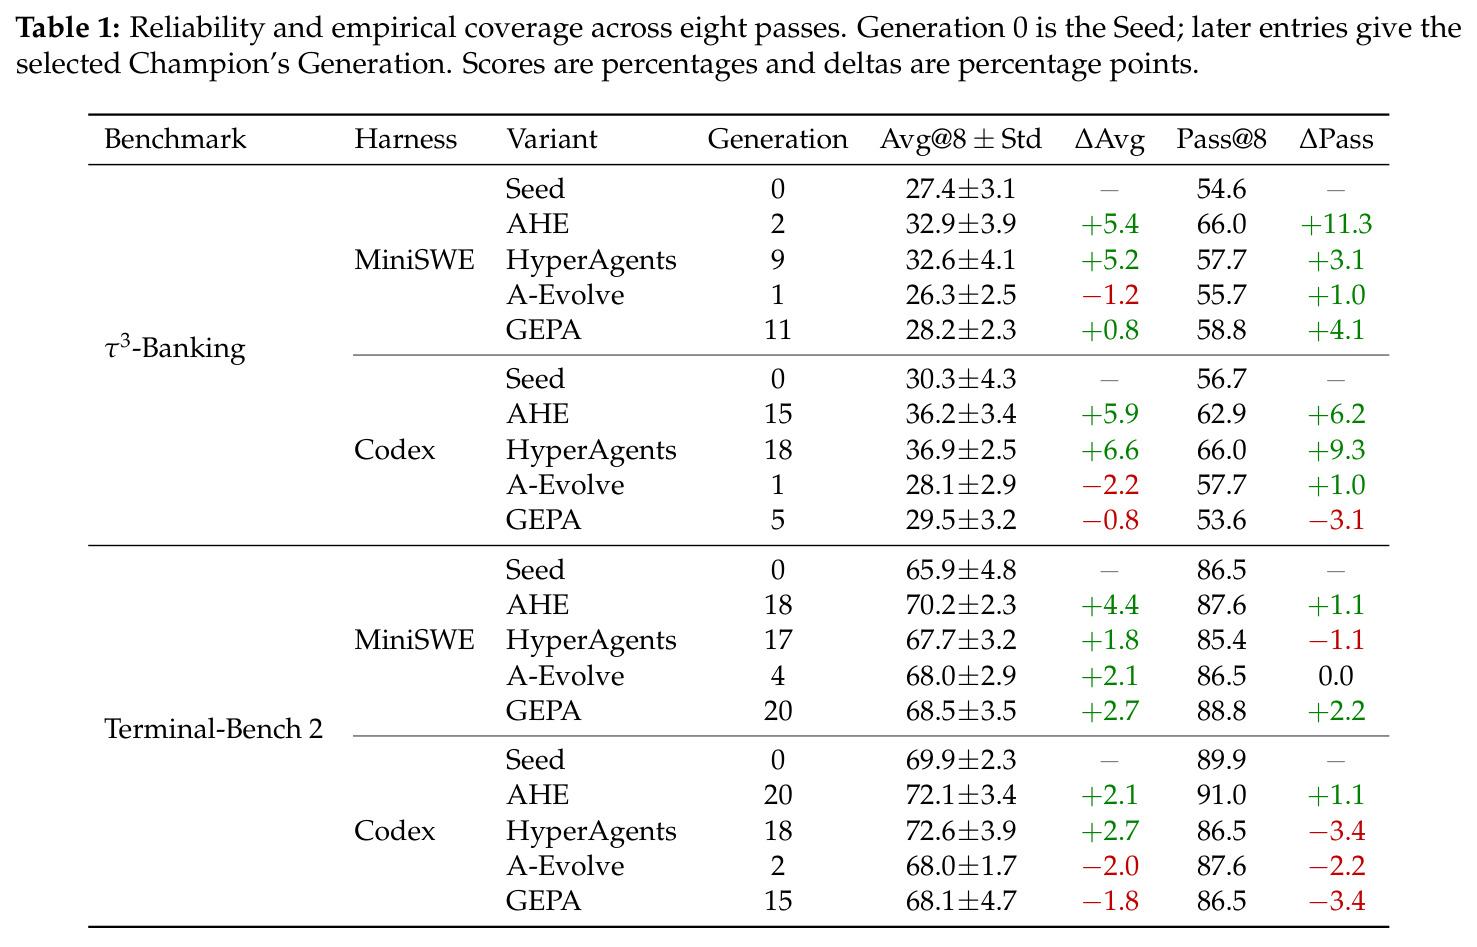
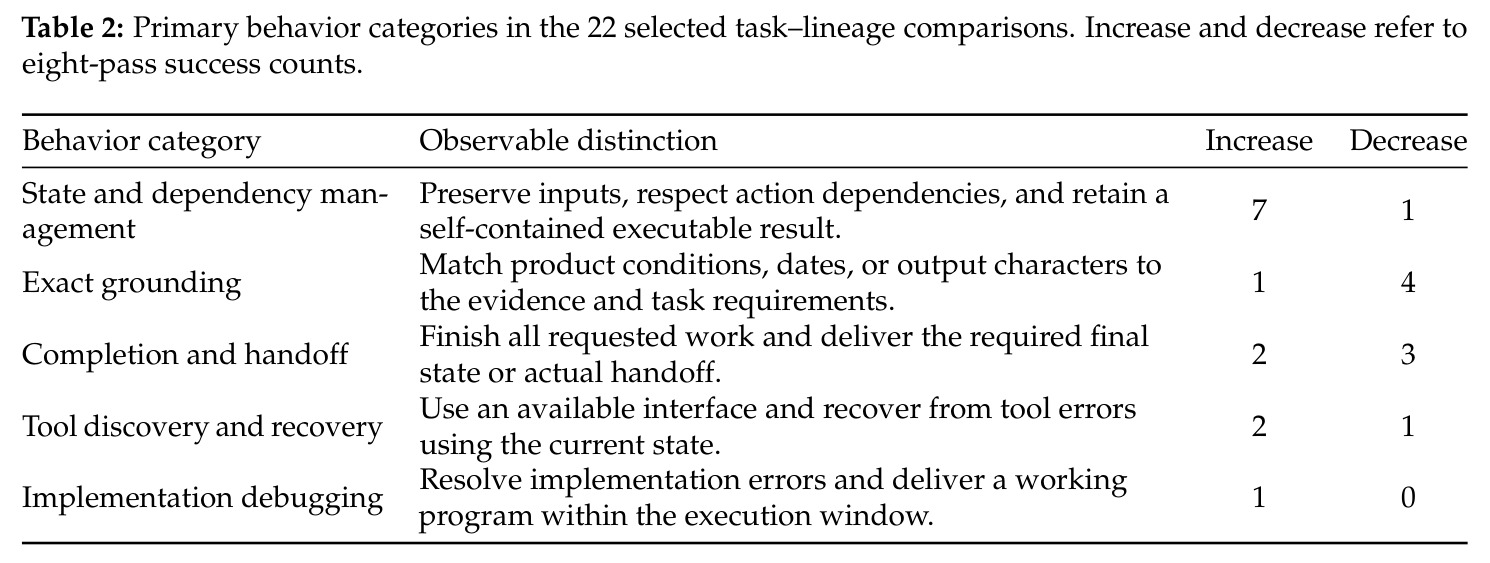
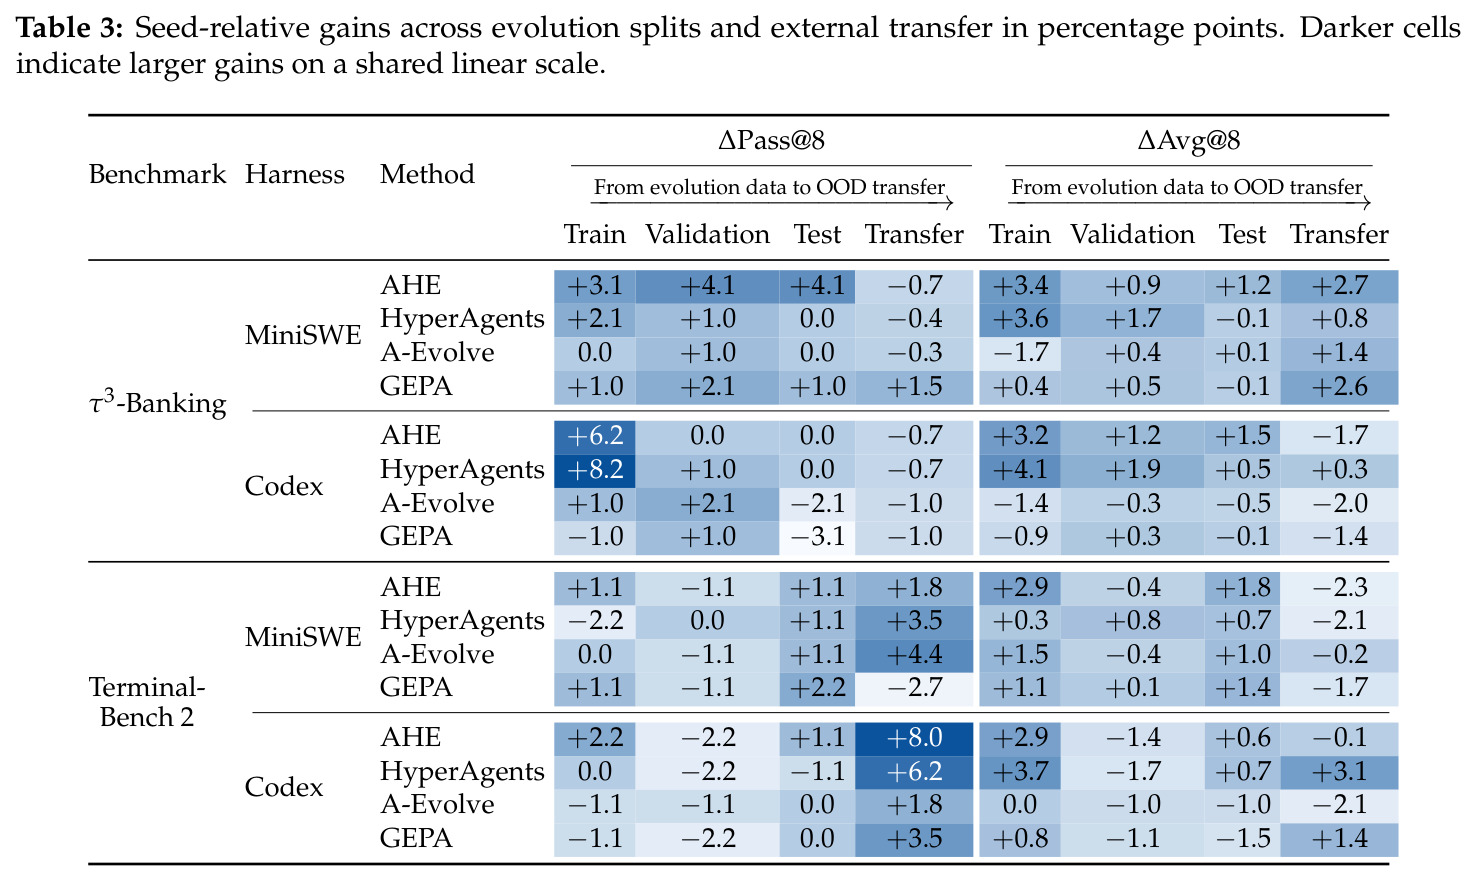
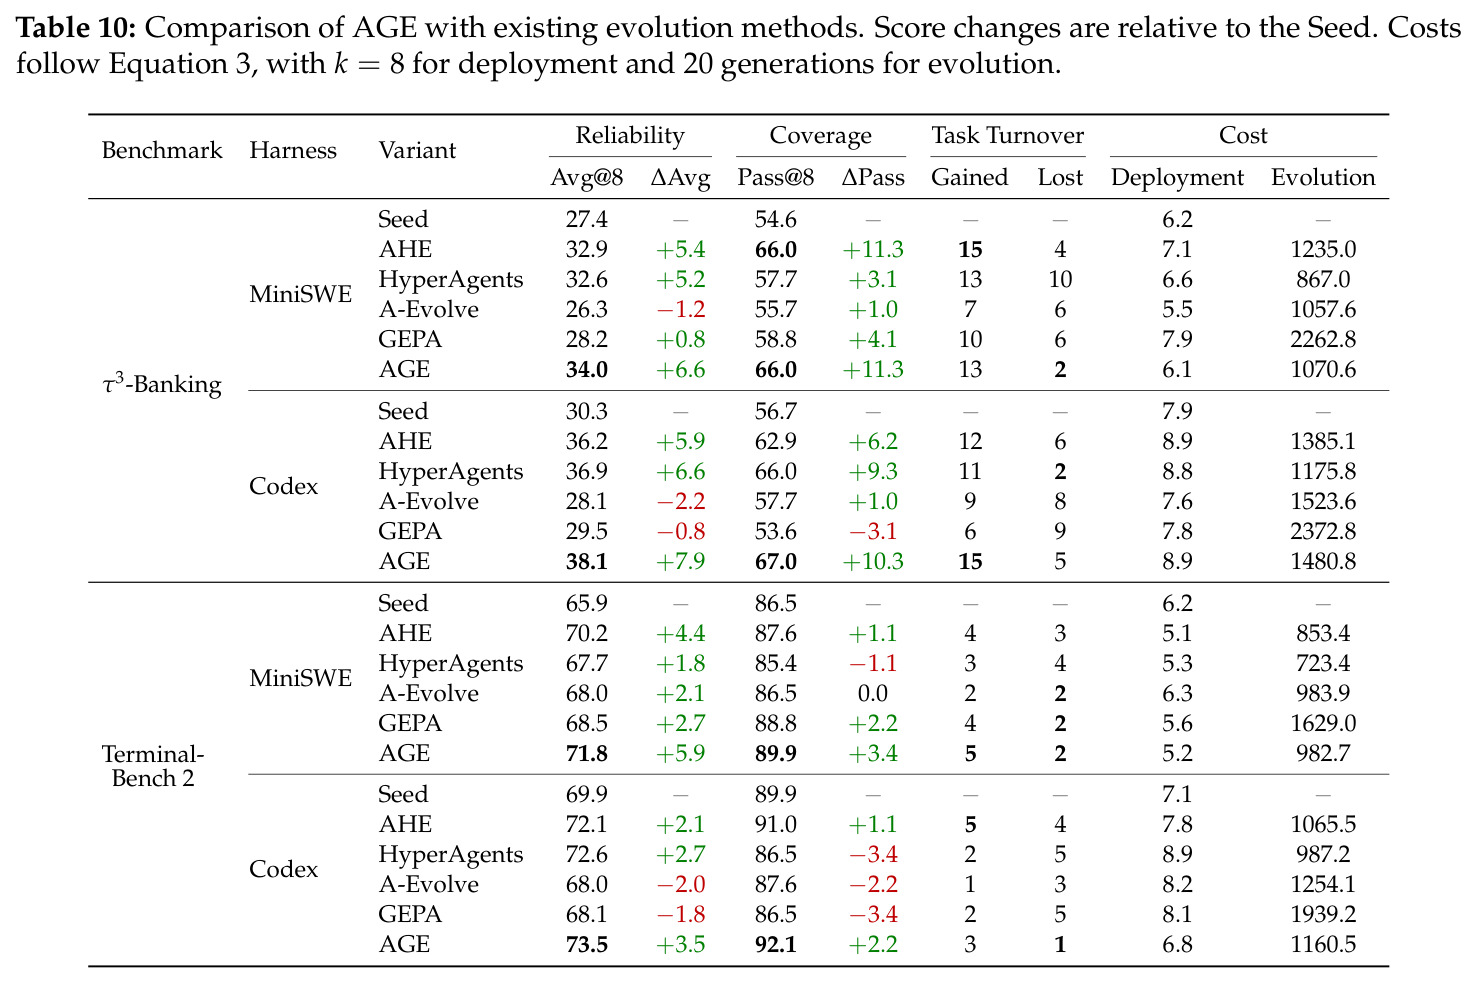
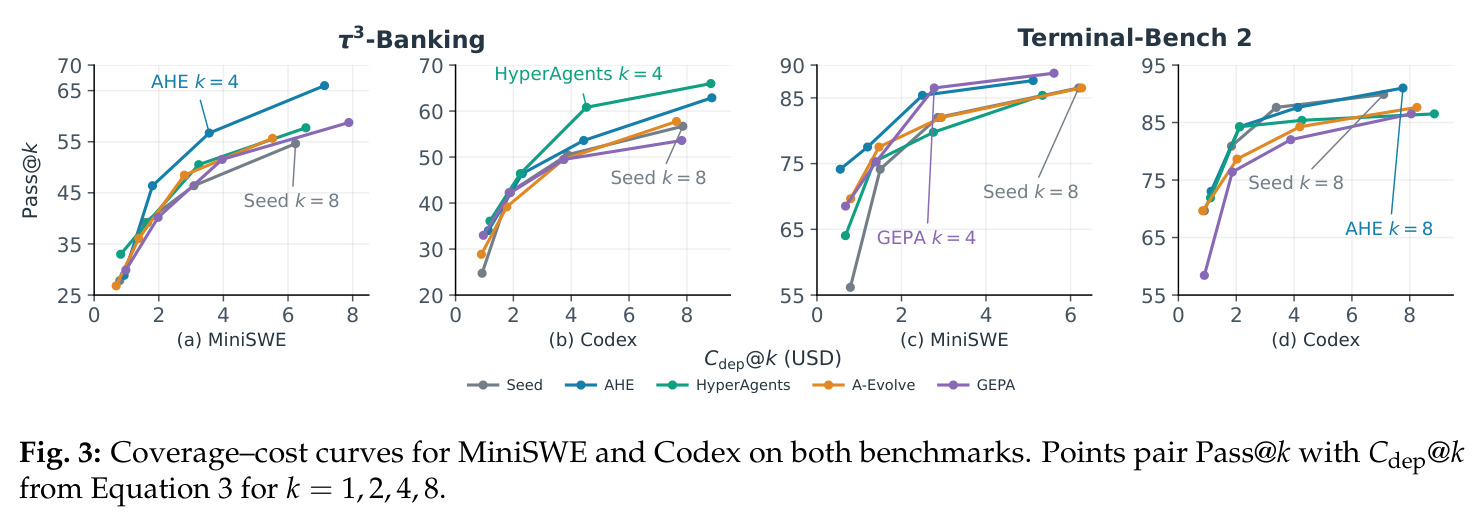
RQ1:16 条谱系中 11 条可靠性提升、10 条覆盖提升,4 个案例两指标方向相反;全部 16 个 Champion 都同时获得并丢失覆盖任务(Fig. 2),如 HyperAgents(τ3-MiniSWE)可靠性 +5.2 却丢失 10 个旧任务。行为归因(Table 2,22 个案例)显示成败集中在状态与依赖管理(增7/降1)、精确落地(增1/降4)等类别。成本上,11 条可靠性提升中 8 条单次尝试更贵,3 条更便宜者全是『可改源码+编码任务』组合;MiniSWE+AHE 在 τ3 上 4 次尝试覆盖 56.7%,超 Seed 8 次的 54.6% 且总成本更低(Fig. 3)。RQ2:Test 可靠性 10/16 提升(实现中心 7/8;反思中心在可改源码框架多数提升、外层框架全降);跨基准迁移选择性保留——通用目标 τ2-bench 上 8 例中 7 例覆盖下降,编码目标 DeepSWE 上 7 例上升(Table 3)。RQ3:select 在通用任务低于随机(17.5%/8.8% vs 25%)、编码任务高于随机(59.5%/55.7%);15/16 具体组件胜过通用提醒;6/8 Champion 优于任一孤立组件;更严准入使含最佳候选的池从 15 降到 6。AGE 在全部 4 个设置超过 A-Evolve(Table 10):τ3-MiniSWE 34.0(+6.6)/66.0(+11.3)、丢任务仅 2(A-Evolve 丢 6)、部署成本 6.1 低于 Seed 的 6.2;τ3-Codex 38.1(+7.9)/67.0(+10.3);TB2-MiniSWE 71.8(+5.9)/89.9(+3.4);TB2-Codex 73.5(+3.5)/92.1(+2.2)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| τ3-Banking(MiniSWE,通用任务) | Avg@8 可靠性(%) | AGE 34.0 | Seed 27.4;最强已有方法 AHE 32.9 | 相对 Seed +6.6,超最强已有方法 +1.1 |
| τ3-Banking(MiniSWE) | Pass@8 覆盖(%)与任务周转 | AGE 66.0(获得 13 / 丢失 2) | Seed 54.6;AHE 66.0(15/4)、A-Evolve 55.7(7/6) | +11.3,与 AHE 覆盖持平但任务丢失减半 |
| τ3-Banking(Codex) | Avg@8(%) | AGE 38.1 | Seed 30.3;最强已有方法 HyperAgents 36.9 | 相对 Seed +7.9 |
| Terminal-Bench 2(MiniSWE,编码任务) | Avg@8(%) | AGE 71.8 | Seed 65.9;最强已有方法 GEPA 68.5 | 相对 Seed +5.9 |
| Terminal-Bench 2(MiniSWE) | Pass@8(%)与任务周转 | AGE 89.9(获得 5 / 丢失 2) | Seed 86.5;A-Evolve 86.5(2/2) | +3.4,获得最多且丢失最少 |
| Terminal-Bench 2(Codex) | Avg@8(%) | AGE 73.5 | Seed 69.9;最强已有方法 HyperAgents 72.6 | 相对 Seed +3.5 |
| τ3-Banking(MiniSWE) | 部署成本 Cdep@8(美元) | AGE 6.1 | Seed 6.2;GEPA 7.9 | 可靠性 +6.6 的同时成本还略降 |
局限与改进
作者承认的局限:实验只覆盖两个基准、一个模型(GPT-5.4 高推理档)、两种框架,跨模型与更多任务域的外推未验证;$k=8$ 次重复下 Std@k 仍有 ±2–5 个百分点的波动,任务级周转对采样噪声敏感,作者也提醒 outcome flip 未必对应真实的能力获得/丢失;AGE 只相对 A-Evolve 一个参考方法验证,未与其他三种方法逐一消融。我自己的观察:①统计功效不足——select 实验每池仅 4 个 Parent、每个 3 分支,17.5%/8.8% 与 25% 的差距样本量太小,论文未做显著性检验;②τ3-MiniSWE 上 AGE 的部署成本优势(6.1 vs 6.2)非常微小,成本感知 gate 的实际收益有限;③行为 judge 的 0–10 分由 LLM 完成,其校准与偏差未评估;④迁移基准 τ2-bench/DeepSWE 与源基准的任务难度分布差异未量化,『覆盖在编码目标上升』可能是分布差异而非真泛化。
独立分析的弱点
独立分析的弱点:①周转指标噪声大——每个任务 8 次伯努利试验,±1 次成功就能翻转『获得/丢失』判定,Fig. 2 中大量计 1 的周转格子可能部分是噪声,改进方向是给周转配 bootstrap 置信区间或增加 pass 数;②决策证据与批评对象自相矛盾——Champion 用 8-pass 报告评估,而 Parent 选择与准入只看单次 canonical Validation,决策时的反馈宽度恰恰是论文批评的『窄于变更影响』,改进方向是准入也用廉价多次采样;③gate 的成本平局比较依赖 $Q$ 谓词(任务集哈希匹配、成本有限为正),API 价格或推理档位变动会破坏成本可比性,实际部署中记录成本波动大;④Component 干预只测了 8 个 Champion 的组件组合,『变更互相干扰』的一般性结论样本有限,值得扩展到更多谱系与三层以上依赖链;⑤专家评审仅 8 人、方向一致率 6/8,据此推进四个修订略显乐观,最好先做小规模消融再全量验证。
未来方向
作者提出的方向:保留感知的评估应成为框架进化的标准报告方式(增益、回归、成本分开呈现);为每个算子建立经过检验的决策规则(用匹配其目标的证据,而非复用同一聚合分数);为每项修改标注显式适用条件;EvoAudit 可扩展到 rollout、record 等其余算子与其他进化方法;跨域迁移的条件性有待系统刻画。基于本文成果可延伸:把『反馈宽度』形式化为理论量,刻画反馈覆盖与回归概率的关系;将同一审计范式迁移到模型权重更新——RL 后训练的 reward 同样窄于策略变更的影响,本文的 select/gate 诊断或可直接借用;构建公开的『进化审计基准』,把 Parent 池、Component 集与准入重放协议标准化,让新方法自带审计报告;在多智能体与长时程任务上检验周转现象是否更极端。
复现评估
复现条件较好。代码开源在 RSIHub(github.com/simple-agent-lab/RSIHub),提供可复用算子组合、共享评估与谱系追踪;四个基准(τ3-Banking、Terminal-Bench 2、τ2-bench、DeepSWE v1.1)均为公开基准;运行配置完全给定:20 代、每代 1 候选、搜索种子 0、GPT-5.4 high 推理档执行,诊断与变异用 GPT-5.4 xhigh 档(经 Harbor),canonical Validation 用 20(τ3)/19(TB2)个任务。主要门槛是 API 预算:论文报告单条谱系进化成本约 723–2373 美元,AGE 四个设置为 982.7–1480.8 美元,8-pass 报告评估另计(单次全量部署评估 5–9 美元×8 次)。此外 LLM 调用的非确定性会使任务级周转数字波动,附录 B 提供了稳定性检查,但独立复现周转级结论仍需多次运行取均值。总体属于『有 API 预算即可复现主表、周转级结论需谨慎对待』的中高难度。
论文图表