迈向实时全波形激光雷达Transformer:强度引导令牌缩减与物理感知增强 Towards Real-Time Full-Waveform LiDAR Transformers via Intensity-Guided Token Reduction and Physics-Aware Augmentation
利用FWL强度稀疏性剪枝合并令牌,实现首个实时FWL Transformer,加速8倍且F1提升9点
前置知识
全波形激光雷达(Full-Waveform LiDAR, FWL)
传统激光雷达对每个激光脉冲只记录最强的峰值回波,输出稀疏三维点云 $(x,y,z)$;FWL 则以直方图形式记录每个像素上完整的回波光强时间序列,数据格式为 $(u \times v \times t)$,其中 $u$、$v$ 是激光束的方位角与俯仰角,$t$ 是飞行时间(ToF)bin。玻璃的多径回波、雾雨的后向散射、弱反射信号都被完整保留,可支撑鬼影检测、去雾重建等传统点云无法完成的任务。
本文两个方法全部建立在 FWL 数据的强度稀疏性与逐射线波形结构之上,不懂数据格式就无法理解剪枝与增强的设计动机。
Vision Transformer 与 3D patch 令牌化
ViT 把输入划分成 patch,每个 patch 经卷积投影为一个令牌向量,再由多头自注意力建模令牌间关系。本文把 FWL 体数据 $V \in \mathbb{R}^{H \times W \times T}$ 划分为 $(8 \times 4 \times 20)$ 的 3D patch,用核与步长均为 patch 尺寸的 3D 卷积投影为 $E=240$ 维令牌,加 3D 位置编码后送入 6 层编码器。自注意力对令牌数是平方复杂度,令牌数量直接决定推理速度。
FWL-ToPM 的剪枝与合并作用在令牌序列上,令牌化方式决定了哪些内容可以被安全压缩。
令牌剪枝与合并
令牌剪枝按重要性打分删除部分令牌(如 DynamicViT 用 MLP 学习每个令牌去留),令牌合并则把相似令牌聚合成代表令牌(如 ToMe 按余弦相似度把 src 令牌并入 dst 令牌),两者都用于减少注意力计算的令牌数。现有方法为图像/视频设计,隐含假设信息在二维空间中广泛分布、令牌分布稠密均匀。
FWL-ToPM 是对这两类方法的物理改造,理解它们的默认假设才能看出本文改进的本质。
空间填充曲线与 Morton 序
空间填充曲线把高维网格映射为一维序列,同时尽量保持空间相邻性。Morton 序(Z-order)通过交错坐标比特实现:把三维坐标 $(x,y,z)$ 的二进制位逐一交错排成一维。本文用它把剪枝后稀疏、不规则的 3D patch 集合串成序列,使空间相近的高强度 patch 在序列中也相邻,从而可以等间隔采样出空间上分散分布的 dst 令牌。
合并步骤的 dst 令牌选择完全依赖这一序列化技巧,是方法中最巧妙的一环。
CutMix 与逐射线波形保持约束
CutMix 从图像 B 剪出矩形区域按混合比例 $\lambda$ 粘贴到图像 A,是强正则化手段。FWL 中每个像素直方图 $Q_{h,w}$ 对应一条从雷达原点出发的射线,整帧构成以雷达为顶点的锥形观测结构;任何增强若破坏单条射线的 T 轴波形或锥体几何,就等于制造物理上不存在的数据。FWLCutMix 与 FWLShiftMix 的全部约束都源于此。
这是理解 FWLAug 为什么不能直接套用图像或点云增强方法的关键。
研究动机
激光雷达是自动驾驶与机器人的核心传感器,但在雾、雨、玻璃、低反射率表面等条件下十分脆弱:传统 LiDAR 只记录每个脉冲的最强峰值,无法捕捉玻璃的多径回波与雾雨后向散射,会产生鬼影和噪声等虚假点,危害目标检测与 SLAM。全波形激光雷达(FWL)以直方图记录每个像素的完整回波波形,信息更丰富,但代价是数据量远超点云,且其中绝大部分是强度接近零的低强度背景。已有的 FWL Transformer 推理速度严重不足:Scheuble 等人的 Neural DSP 只有 1.97 FPS,Ikeda 等人的 FWL-MAE 也只有 6.54 FPS,远低于实时所需的 10 Hz。直接套用为图像设计的令牌缩减方法(DynamicViT、ToMe)效果不佳,因为它们假设信息在二维空间中广泛分布,会把 FWL 中稀疏但关键的高强度令牌也丢弃。另一方面,公开 FWL 数据极度稀缺——Ghost-FWL 是唯一有峰值级标注的公开数据集,玻璃、水面等少数类样本严重不足,模型容易过拟合多数类;而标准图像/点云增强会破坏每条射线的 ToF 波形结构和锥体几何,引入物理上不存在的畸变,无法直接使用。
本文的目标是本文目标是同时攻克 FWL Transformer 的实时性与泛化性两大瓶颈,并给出可量化指标:其一,设计面向 FWL 物理结构的令牌剪枝与合并机制 FWL-ToPM,使推理吞吐超过实时线(10 Hz),同时不降低甚至提升精度;其二,设计尊重 ToF 波形结构与锥体几何的增强框架 FWLAug,缓解玻璃等少数类样本不足,提升对未见场景的泛化能力;其三,构建一个完全在 Ghost-FWL 采集地点之外拍摄的分布外(OOD)测试集(500 帧、超过 300 个玻璃实例),用统一协议量化泛化。最终成果是首个实时 FWL Transformer:在 Ghost-FWL 鬼影检测基准上达到 53.2 FPS、F1-mean 0.592,相对此前最优方法同时取得约 8 倍加速和约 9 个点的 F1 提升。
与已有工作不同的是,本文的独特切入是用 FWL 的物理结构直接指导两处算法设计。其一,令牌缩减:现有剪枝/合并方法为相机图像设计,默认信息均匀铺满二维平面;但 FWL 数据在三维空间中高度稀疏——峰值只出现在少数位置,其余区域强度几乎为零。作者据此按 patch 最大强度剪掉最弱的 70% 令牌,并发现一个反直觉现象:在图像 Transformer 上激进剪枝会破坏训练,而在 FWL 上剪掉 70% 令牌反而稳定提升精度(F1 从 0.555 升到 0.591),因为低强度令牌本质上是稀释目标信号的噪声。其二,数据增强:此前没有任何专门为 FWL 设计的增强方法,现有 ToF 成像增强仅限于加噪和旋转。FWLAug 把「逐射线波形不变 + 锥体几何一致」作为硬约束,把增强明确定位为正则化手段而非严格光学仿真,用极低计算代价换取训练多样性。这两个切入点都来自对 FWL 数据物理特性的观察,而非对通用架构的暴力缩放。
核心方法
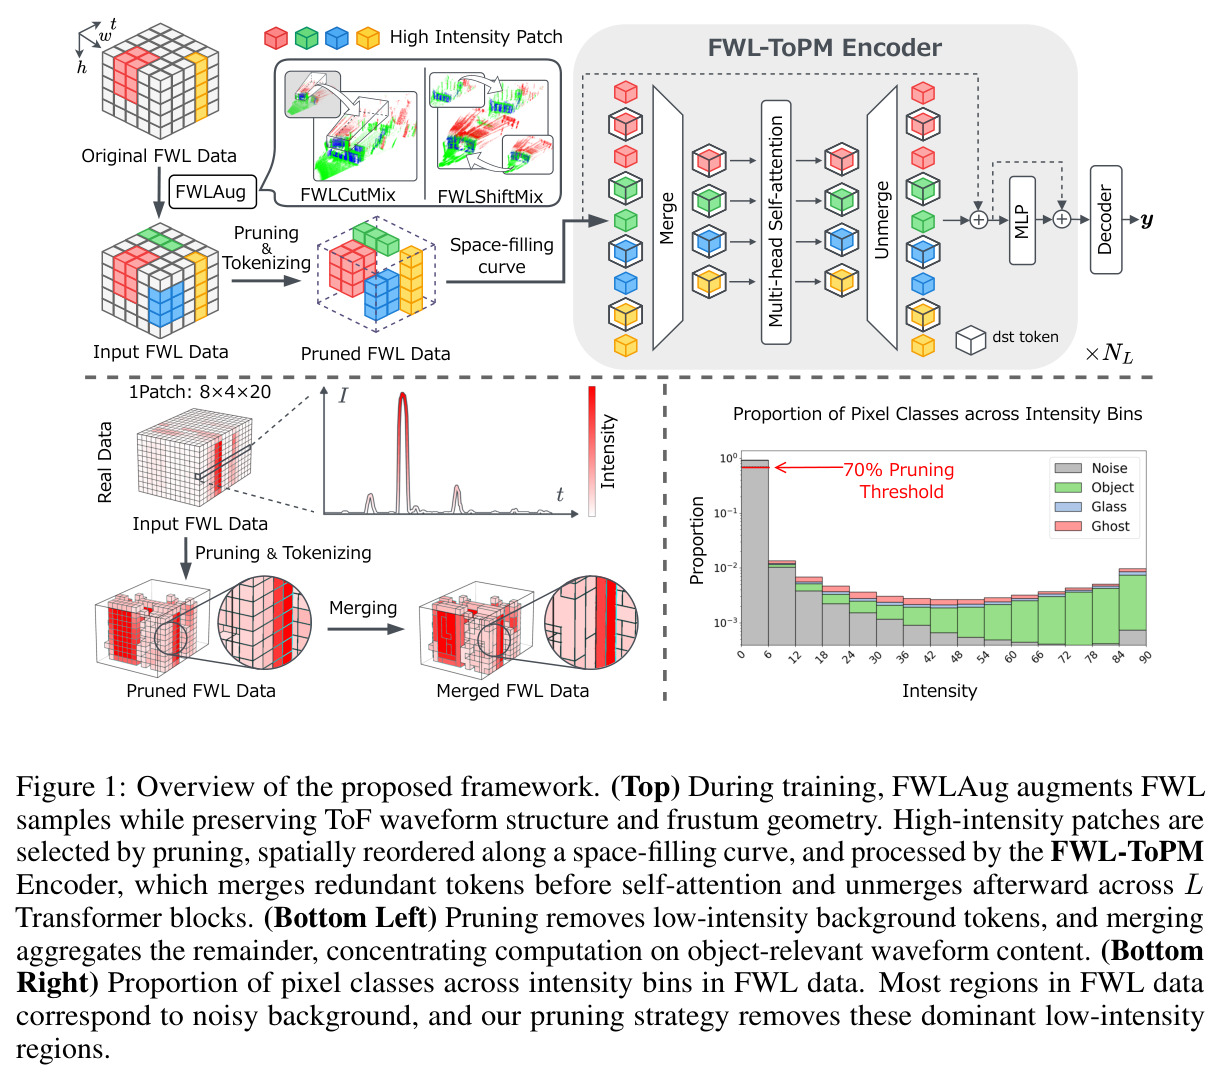
直觉上,FWL 数据像一张大部分区域是黑底、只有少数亮斑的照片:把算力平均摊在整张图上,绝大部分浪费在背景上。FWL-ToPM 的思路是「先扔掉黑底,再把剩下的亮斑打包压缩」。技术路线:输入 FWL 帧 $V \in \mathbb{R}^{H \times W \times T}$(实验中裁剪为 $168 \times 200 \times 300$),按 $(8 \times 4 \times 20)$ 划分 3D patch,用核与步长均为 patch 尺寸的 3D 卷积投影成 $E=240$ 维令牌并加位置编码;随后按 patch 内最大强度 $m_i$ 排序,剪掉最弱的 $\rho_{low}=0.7$ 比例背景令牌;剩余令牌沿 Morton 空间填充曲线排成一维,以 $\rho_d=0.1$ 比例等间隔选出 dst 令牌,src 令牌按特征余弦相似度归属,最相似的 $\rho_m=0.9$ 比例被平均合并;注意力后 unmerge 恢复令牌数以保持残差一致。编码器共 $N_L=6$ 块,末端每令牌接单层线性解码器,重排回原布局得到体素级 logits $y$。训练时叠加 FWLAug(FWLCutMix 与 FWLShiftMix 各以 0.5 概率选用)提升泛化。
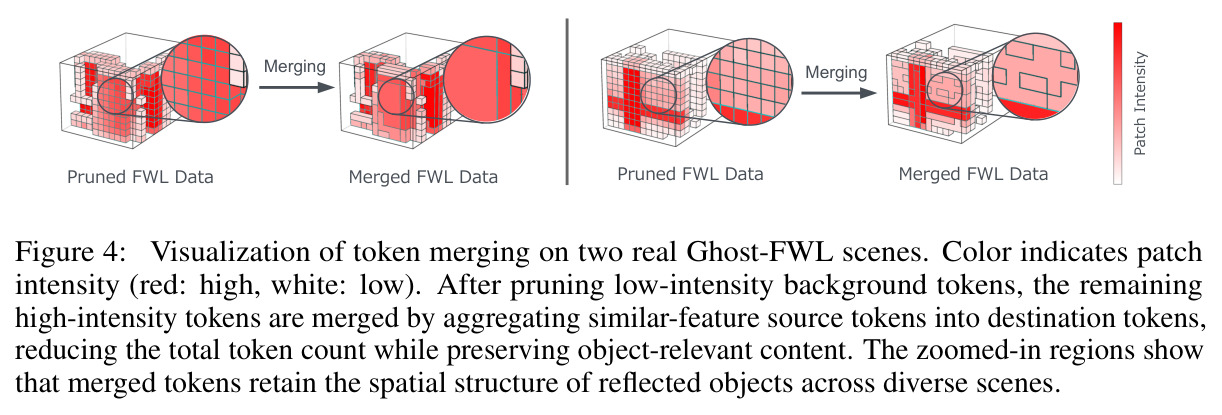
核心创新有两点。第一,强度引导剪枝:与 DynamicViT 用可学习 MLP 判断令牌去留不同,FWL-ToPM 用 patch 最大强度 $m_i$ 这一物理量直接打分,无需训练、不改任何权重。关键发现是 $\rho_{low}=0.7$(删除 70% 令牌)不仅不损害精度反而显著提升——F1 从不剪枝的 0.555 升到 0.591——与图像 Transformer 中激进剪枝导致训练不稳定的结论截然相反。本质原因是 FWL 中低强度令牌是噪声而非信息,删除后模型被迫聚焦承载目标反射的高强度令牌。第二,空间填充曲线上的合并:ToMe 等方法把 patch 网格划分为固定区域、每区域选一个 dst 令牌,隐含假设令牌分布稠密均匀;剪枝后的 $P_{high}$ 是稀疏不规则集合,很多区域为空,该方法直接失效。本文先把 $P_{high}$ 按 Morton 序串成一维(保持空间相近性),再等间隔采样 dst 令牌,保证合并目标在三维空间中分散分布。两个机制都不修改网络参数,可直接套用在预训练模型上做推理期加速。
方法步骤详情
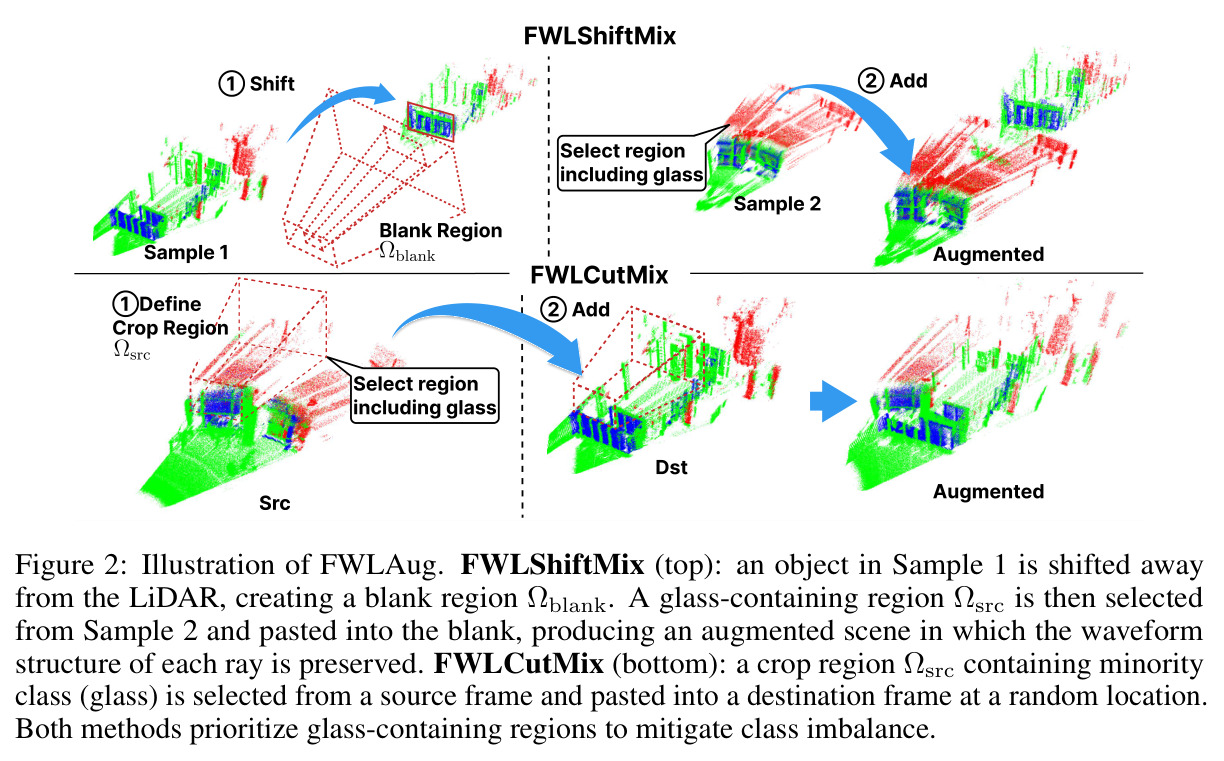
流程如下。预处理:Ghost-FWL 原始数据 $(512 \times 400 \times 700)$ 去掉顶底各 88 个天花板/地面 bin、前 25 个噪声 bin、后 375 个 bin,得到 $(336 \times 400 \times 300)$,再因显存取四分之一裁剪 $(168 \times 200 \times 300)$。步骤一(令牌化):patch 尺寸 $(8 \times 4 \times 20)$,3D 卷积投影为 $E=240$ 维令牌并加 3D 位置编码。步骤二(剪枝):计算 patch 最大强度 $m_i$ 升序排序,最弱的 $\rho_{low}=0.7$ 比例归入 $P_{low}$ 丢弃,只对 $P_{high}$ 令牌化进编码器;训练时损失跳过被剪区域,推理时这些区域直接预测为噪声。步骤三(合并):$P_{high}$ 沿 Morton 序排列,按 $\rho_d=0.1$ 等间隔选 dst 令牌,src 按余弦相似度归属,最相似的 $\rho_m=0.9$ 比例与 dst 平均合并;注意力后 unmerge 把 dst 特征复制回原位置。步骤四(解码):线性解码器输出类别 logits,重排回原布局得 $y$。FWLAug:FWLShiftMix 把峰值位置 $t^*_{h,w}=\arg\max_t Q_{h,w}(t)$ 经 ToF 几何转为 3D 点 $r_{h,w}$,沿射线方向平移 $r'_{h,w}=r_{h,w}+\Delta d\, u_{h,w}$($\Delta d \sim U(-3,15)$ 米),重投影回距离视图并把波形沿 T 轴平移,空出区域从另一场景粘贴含玻璃区域、整段波形原样复制;FWLCutMix 按 $\lambda$ 采样裁剪区域($\ell_H=\lfloor H\sqrt{1-\lambda}\rfloor$,$\ell_W=\lfloor W\sqrt{1-\lambda}\rfloor$),优先选含玻璃区域粘贴并保留整条 T 轴波形。训练用 focal loss、AdamW 学习率 $10^{-4}$、50 epoch。
技术新颖性
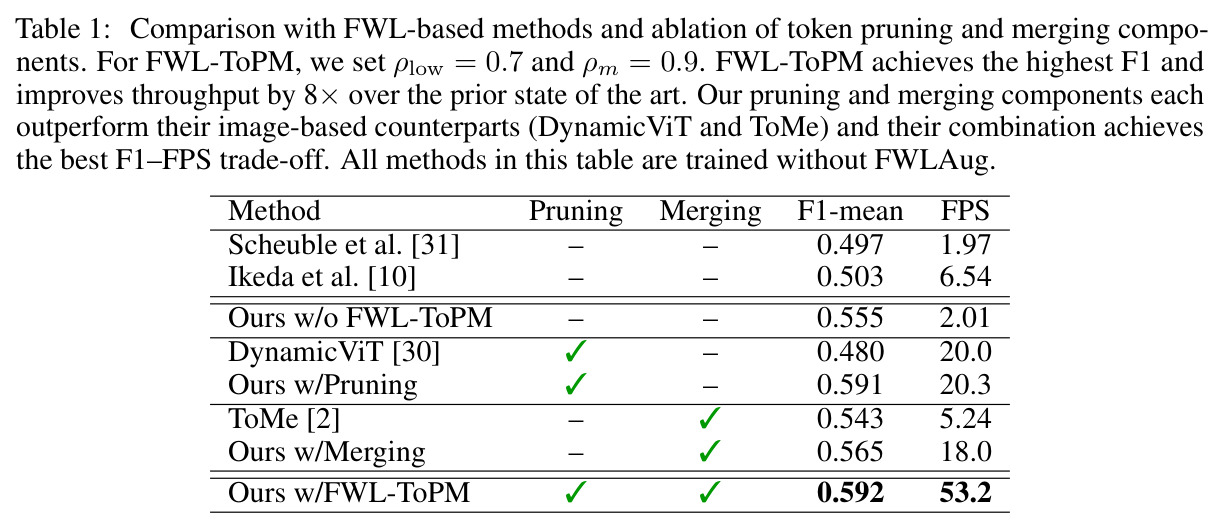
与已有技术的具体区别:其一,剪枝准则从「学习得到」变为「物理先验」。DynamicViT 需要额外训练 MLP 决策门,在 FWL 上只有 0.480 的 F1(低于不剪枝基线的 0.555),说明学习式准则在稀疏数据上失效;本文用强度这一物理量打分,零参数、即插即用,还带来 +3.6 个点的精度增益。其二,合并的 dst 采样从「固定网格划分」变为「曲线序列化」。ToMe 在 Ghost-FWL 上仅 5.24 FPS、F1 0.543,正是因为稠密假设在剪枝后的稀疏集合上崩溃;Morton 序方案让合并目标保持空间代表性,达到 18.0 FPS、F1 0.565。与 PTv3 的曲线序列化相比用途不同:PTv3 用它划分 patch 做局部注意力,本文用它为剪枝后的不规则令牌集合选择空间分散的 dst。其三,FWLAug 是首个 FWL 专用增强框架:图像 CutMix 与点云 Mix3D/PolarMix 都会破坏逐射线波形或锥体几何,ToF 成像的既有增强只有加噪和旋转;本文在两个硬约束下,分别设计了面向少数类(玻璃)的 FWLCutMix 和面向距离多样性的 FWLShiftMix,并证明两者作用互补。
实验结果
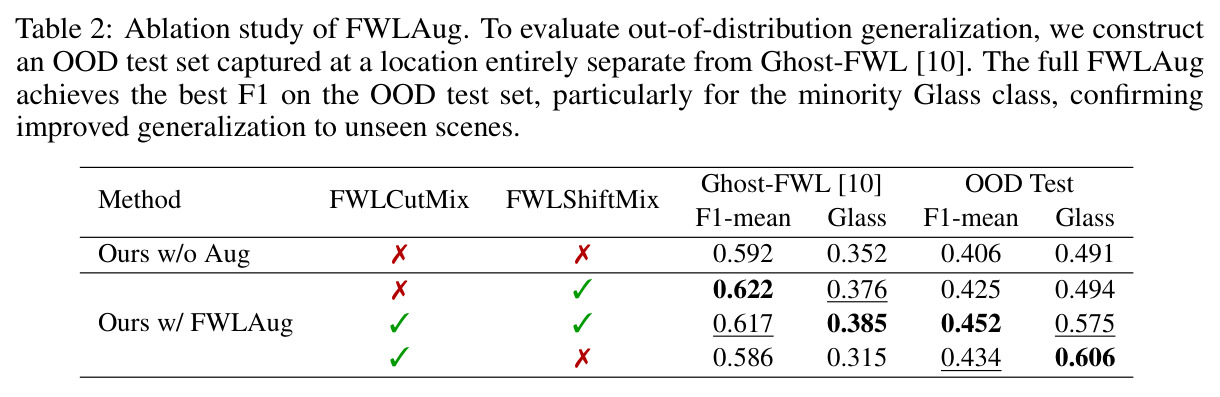
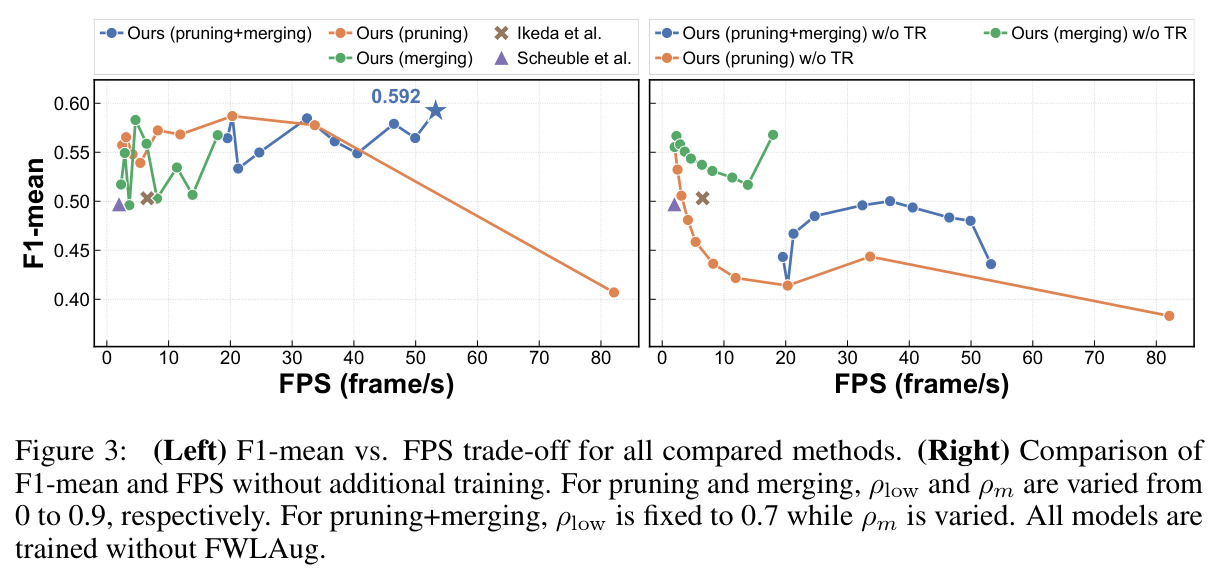
主实验(Table 1):FWL-ToPM 在 Ghost-FWL 上达到 F1-mean 0.592、53.2 FPS,对比此前最优的 Ikeda et al.(0.503、6.54 FPS)实现约 9 点 F1 提升和超过 8 倍加速,是首个实时(>10 Hz)FWL Transformer;对比 Scheuble et al.(0.497、1.97 FPS)优势更大。消融显示两组件互补:只剪枝($\rho_{low}=0.7$)0.591 @ 20.3 FPS,只合并($\rho_m=0.9$)0.565 @ 18.0 FPS,均优于基线 0.555 @ 2.01 FPS。与图像方法对比,本文剪枝显著优于 DynamicViT(0.480 @ 20.0 FPS),合并优于 ToMe(0.543 @ 5.24 FPS)。Figure 3 左图:只剪枝在 20 FPS 内维持 F1≈0.59,推到 80 FPS 时精度骤降;只合并精度稳但压缩有限;两者结合在 53.2 FPS 取得最佳平衡。右图验证免训练可用性:剪枝不加训练时精度随比例骤降,合并则在约 20 FPS 时 F1 仍保持 0.5 以上。FWLAug 消融(Table 2):无增强基线 OOD 为 0.406/玻璃 0.491;完整 FWLAug 把 OOD F1-mean 提到 0.452(+4.6 点),OOD 玻璃类 0.575(+8.4 点);只用 FWLShiftMix 域内收益更大(0.622),只用 FWLCutMix 域内玻璃降到 0.315 但 OOD 玻璃最高达 0.606,两者互补。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FWL 鬼影检测(Ghost-FWL) | F1-mean / FPS | 0.592 / 53.2 FPS(FWL-ToPM) | Ikeda et al. 0.503 / 6.54 FPS;Scheuble et al. 0.497 / 1.97 FPS | F1 +8.9 点,速度约 8 倍 |
| 剪枝组件对比 | F1-mean / FPS | 0.591 / 20.3 FPS($\rho_{low}=0.7$) | DynamicViT 0.480 / 20.0 FPS;无剪枝基线 0.555 / 2.01 FPS | 同速度下 F1 +11.1 点(对 DynamicViT) |
| 合并组件对比 | F1-mean / FPS | 0.565 / 18.0 FPS($\rho_m=0.9$) | ToMe 0.543 / 5.24 FPS | F1 +2.2 点且约 3.4 倍速 |
| OOD 泛化(500 帧新场景测试集) | F1-mean / 玻璃类 F1 | 0.452 / 0.575(完整 FWLAug) | 无增强基线 0.406 / 0.491 | F1-mean +4.6 点,玻璃类 +8.4 点 |
局限与改进
作者承认四点局限:一,剪枝把低强度区域当作背景,可能误删远距离目标、低反射物体或恶劣天气下的弱信号,且被剪区域在推理时一律预测为噪声,错误删除会直接造成漏检;$\rho_{low}$、$\rho_m$、$\rho_d$ 目前固定、不能按场景自适应。二,评测只用一个 Sony FWL 传感器平台,OOD 集的传感器、采集配置与标注协议都与 Ghost-FWL 相同,跨传感器泛化未验证。三,FWLAug 是正则化而非光学仿真:FWLShiftMix 不建模随距离的强度衰减,也不重算粘贴玻璃与移动后物体的光学交互,FWLCutMix 粘贴边界处反射路径不连续。四,效率评测只到模型级吞吐,未测含传感器输入与预处理的端到端延迟,也未在嵌入式平台部署。我的补充观察:为迁就对比方法的显存,所有方法只用四分之一帧($168 \times 200 \times 300$)训练评测,整帧($336 \times 400 \times 300$)下 53.2 FPS 是否保持论文未直接报告;F1 0.592 绝对值仍不高,域内玻璃类只有 0.385,任务本身远未解决。
独立分析的弱点
独立分析四个弱点。一,静态强度阈值在恶劣天气下系统性失效:雾雨后向散射会抬高背景强度(假背景剪不掉),远距离目标回波又会变弱(真信号被剪掉),固定 $\rho_{low}=0.7$ 无法区分。改进方向:用轻量网络按场景预测自适应比例,或以信噪比估计代替纯强度排序。二,被剪区域一律输出噪声标签会制造系统性盲区,对安全关键场景(如低反射黑色车辆近距离接近)是隐患。改进方向:为被剪区域保留一个极轻量的二级检测分支,或按不确定性触发局部回算。三,$\rho_m=0.9$ 和 $\rho_d=0.1$ 全局固定,可能过度合并玻璃边缘等细结构——而玻璃恰是本文最关心的少数类。改进方向:按令牌特征熵或局部密度动态调整合并率。四,FWLCutMix 单独使用时域内玻璃 F1 从 0.352 跌到 0.315,说明粘贴玻璃波形与周围场景的光学上下文不匹配会引入训练噪声。改进方向:为粘贴区域叠加随距离的强度衰减模型,或只在几何一致的位置粘贴。
未来方向
作者提出的方向:按场景与信号分布自适应确定 $\rho_{low}$、$\rho_m$、$\rho_d$;跨传感器、跨分辨率、跨天气的更广验证;把 FWLAug 向光学仿真推进(距离衰减、玻璃与物体的光学交互建模);系统级效率评测,包括传感器到决策的端到端延迟与嵌入式机器人平台部署。基于本文成果可延伸的方向:把 FWL-ToPM 与 FWL-MAE 自监督预训练结合——既然剪枝合并不修改权重,预训练骨干可无缝享受推理加速;把强度引导剪枝推广到 Neural DSP 式时空 Transformer 或其他体数据(事件相机、医学体素);利用公开的 OOD 测试集发展 FWL 领域泛化方法(元学习、风格不变表征);进一步利用 FWL 独有的多径回波信息攻克更难任务,如透过玻璃/水面的目标检测与雾中重建,把实时 FWL 感知推向真正的车载部署。
复现评估
复现条件较好。代码与 OOD 数据集通过项目页公开(https://keio-csg.github.io/FWL-ToPM),训练数据 Ghost-FWL 是目前唯一公开的峰值级标注 FWL 数据集,OOD 测试集(500 帧、300+ 玻璃实例)一并发布,评测协议(去除噪声类后的 F1-mean 加 FPS)清晰。算力需求低:模型很小($E=240$、6 层、6 头),单卡 RTX 6000 Ada、AdamW 学习率 $10^{-4}$、50 epoch 即可训练,普通实验室单卡可以复现。方法对实现细节的依赖集中在三处:Morton 序的具体实现、剪枝后损失掩码的处理、FWLShiftMix 的射线平移与重投影几何,正文均有描述,补充材料另有细节。主要门槛不在算法而在数据:FWL 传感器(本文用 Sony)并不普及,若要自采数据或做跨传感器实验需要硬件支持;好在免训练实验表明不重新训练也能获得可观加速,低算力用户可先验证推理期加速再决定是否完整复现训练。难度评估:中等偏低。
论文图表