EvoWorld:迈向生成式视频模型中的视线外世界演化 EvoWorld: Towards Out-of-Sight World Evolution in Generative Video Models
用 VLM 世界大脑加自回归渲染器,推演并渲染视线外的世界因果演化。
前置知识
流匹配(Flow Matching)
视频生成的主流训练范式:向干净潜变量 $z$ 加噪得 $x_\sigma=(1-\sigma)z+\sigma\epsilon$,训练 $v_\theta$ 预测速度场 $\epsilon-z$,损失 $\|v_\theta-(\epsilon-z)\|^2$,采样沿速度场积分去噪。
EvoWorld 渲染器的两阶段训练目标(论文式 (3) 与式 (5))本质就是"只对目标 token 施加流匹配损失、锚点 token 保持干净且零损失",理解这一目标是读懂其训练细节的前提。
分段自回归视频生成(Segment-Autoregressive)
将长视频切成若干时间片段(chunk/segment),段内保留全注意力双向去噪以保证画质,段间把上一段尾部的潜变量作为条件传给下一段,从而自回归地近乎无限延长视频。它兼顾了双向模型的单段质量与因果模型的长时程可扩展性,是当前交互式视频世界模型的主流架构。
EvoWorld 的渲染器就建立在这一范式上;"相机移开→事件注入→相机回访揭示后果"的三段式 rollout 完全靠分段自回归生成实现,事件恰好在段边界通过提示切换注入。
暴露偏差与在线自回归训练(Self-Forcing)
训练时模型总以真实数据为条件,推理时却要以自己生成的、带误差的历史为条件,误差会沿自回归链累积,称为暴露偏差。Self-Forcing 式方法在训练中让模型对自己的 rollout 输出继续去噪并计算损失,使训练条件分布与推理分布对齐,从而抑制误差累积。
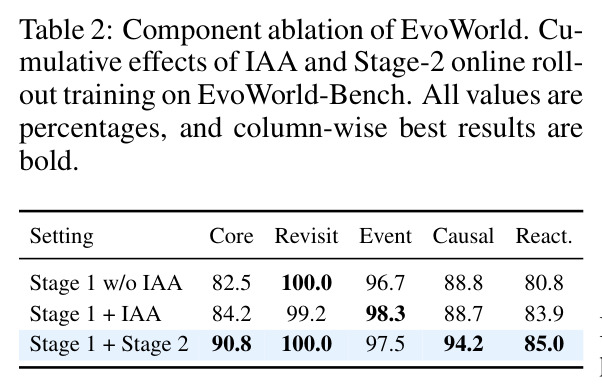
EvoWorld 第二阶段正是一跳(one-hop)在线 rollout 训练:75% 样本用当前模型自生成的前驱段尾部潜变量作时间锚点,仅这一步就把 Core Task Success 从 84.2% 提到 90.8%。
LoRA 低秩适配
冻结预训练大模型的全部权重,只为部分权重矩阵附加低秩分解 $\Delta W=BA$(秩 $r$ 远小于原维度)并只训练 $A,B$。参数量小、显存占用低、可与其他 LoRA 叠加使用,是大模型轻量微调的事实标准。
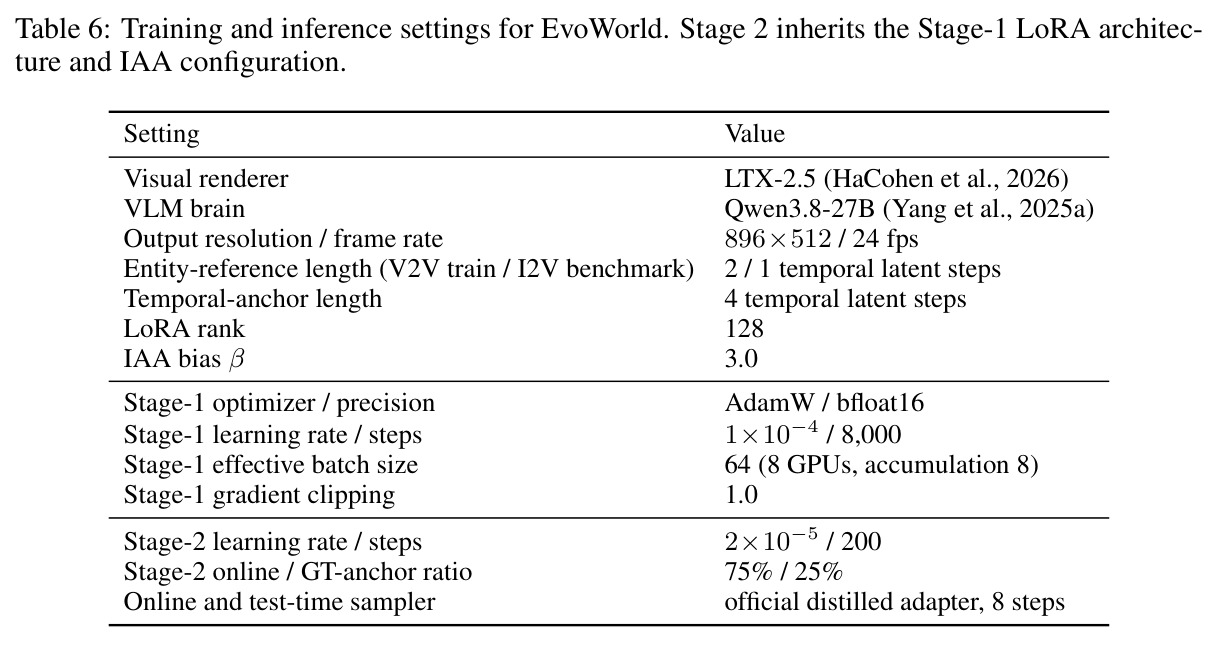
EvoWorld 只用 rank-128 LoRA 在 8 张 GPU 上微调 LTX-2.5 渲染器,推理时再与官方蒸馏 LoRA 叠加、8 步采样,说明整套方法训练开销小,这也是评估其可复现性的关键信息。
注意力偏置与 attention sink
在自注意力 pre-softmax 分数上叠加可加偏置以控制 token 间信息流,如因果掩码、相对位置偏置;“attention sink”指让某些 token 持续吸收大量注意力权重。IAA 把实体锚点设计成“软注意力汇”,仅对重访 query 加偏置 $\beta$。
读懂 IAA 的公式 $e^{A_{qk}}=\frac{Q_qK_k^\top}{\sqrt{d}}+M_{qk}+\beta\,\mathbb{1}\{q\in R\}\mathbb{1}\{k\in E\}$ 及其“只让重访 token 读实体锚点”的方向性设计,必须先掌握这一机制。
VLM 世界大脑(World Brain)
以视觉语言模型作为外部推理模块:持续观察生成结果、把实体、外观、场景、已发生事件维护成文字化的世界状态记录,并在此基础上推理未来状态转移。它把"推理"从像素生成过程中显式解耦出来,弥补扩散式视频模型只会渲染合理像素、不会对世界状态做因果推演的缺陷。
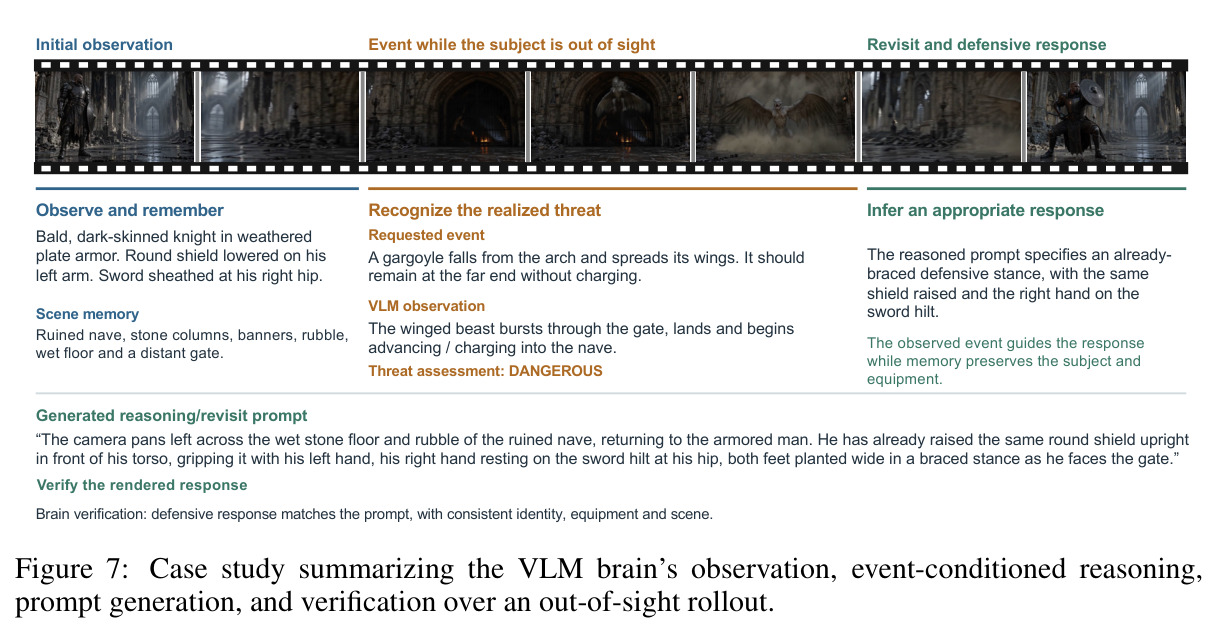
这是 EvoWorld 框架的灵魂:Qwen3.8-27B 大脑在每个段结束后感知并记录世界状态,事件发生后推理画面外主体的合理反应,并将其转写成具体的重访提示词 $\hat{p}$,渲染器只负责视觉实现。
研究动机
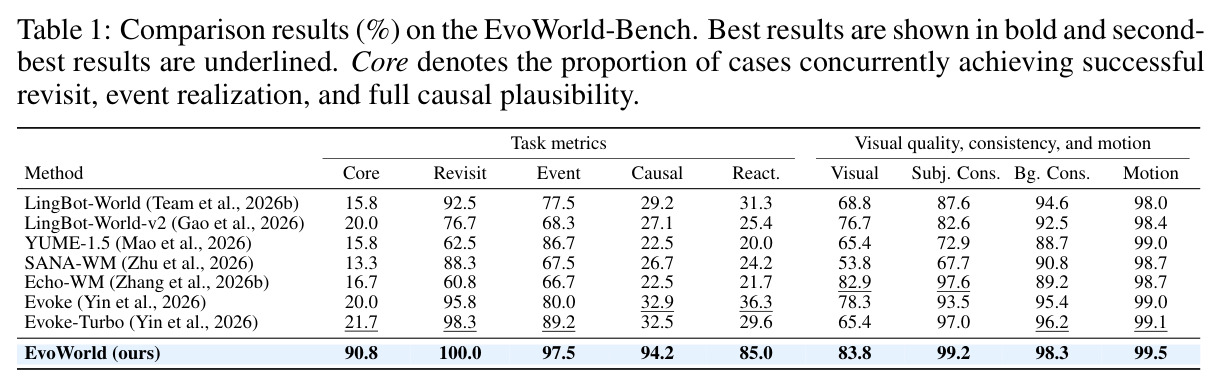
生成式视频模型正被当作视觉世界模拟器使用,但它们的核心能力是渲染合理的像素,而非推理世界应如何演化。当事件发生时(如一只野兽出现),模型不仅应画出野兽,还应推断附近人物会逃跑、躲避还是反击——现有扩散式视频模型没有维护世界状态、推理事件后果的显式机制,常产出画面合理但行为静止或因果不一致的结果。难点在主体处于画面外时被进一步放大:相机移开后主体不可见,其状态无法靠"恢复最后一次可见外观"得到,必须结合期间发生的事件来推断。论文 Fig. 1 的实测显示,HY-World 1.5、Echo-WM、LingBot-World、SANA-WM 等最近模型在"相机移开→事件发生→相机回访"测试中各种失败:事件或反应缺失、主体跟着相机走或被复制、外观与背景漂移、反应不合理。在 EvoWorld-Bench 上这些模型的 Core Task Success(需同时满足回访成功、事件实现、完全因果合理)仅 13.3%–21.7%;即便是较强的 Evoke-Turbo,回访成功率高达 98.3%、事件成功率 89.2%,Core 却只有 21.7%——会"回来看"和会"演事件"并不等于会"推演后果"。
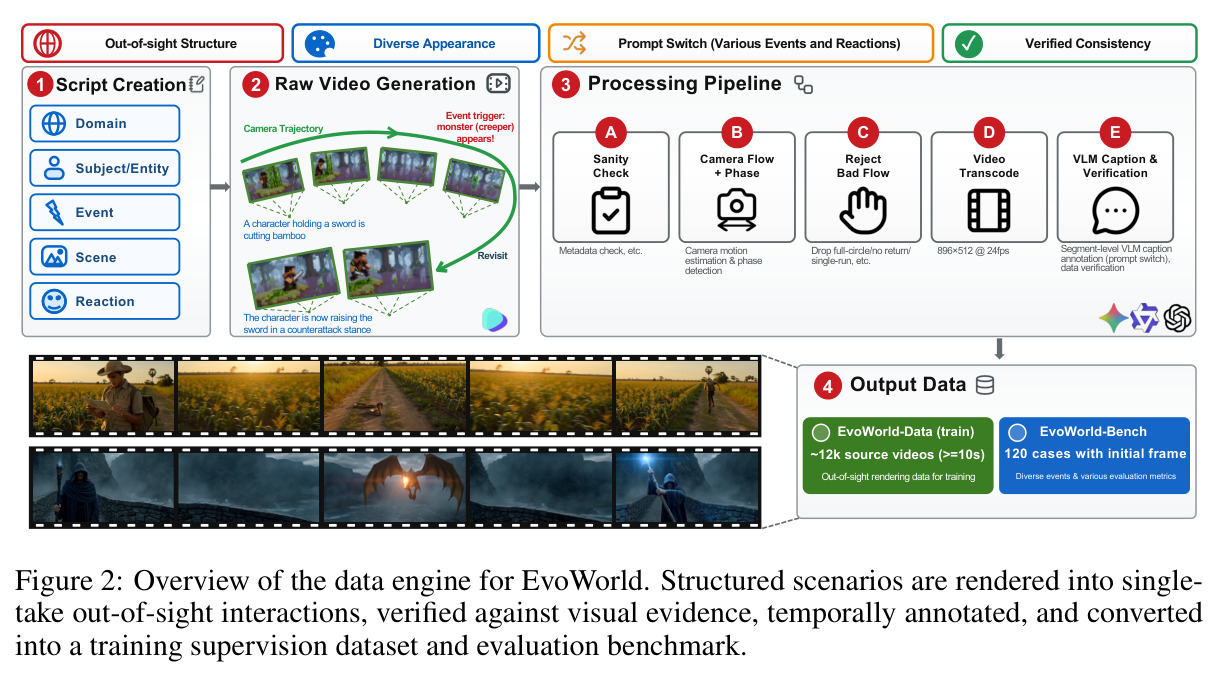
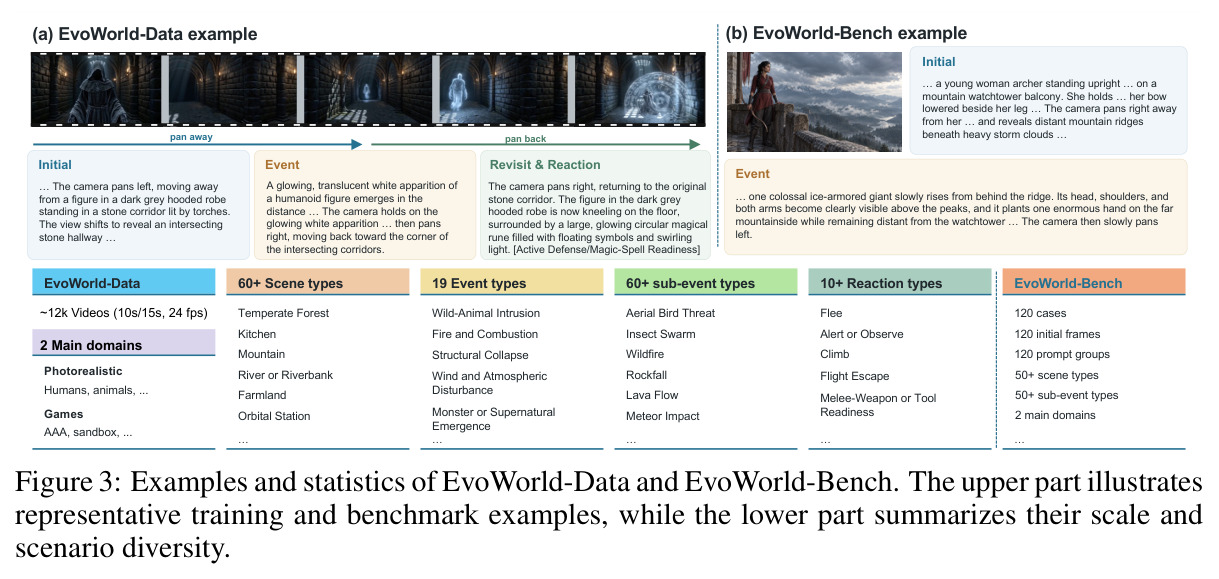
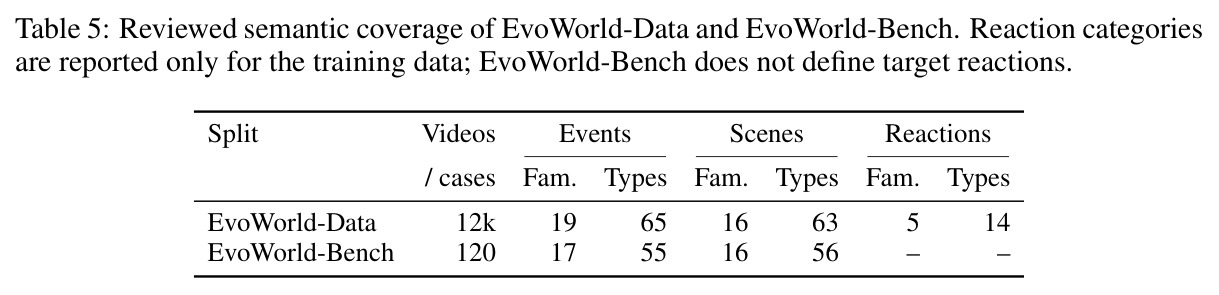
本文的目标是本文的目标是把"视线外因果演化"(Out-of-Sight Causal Evolution)定义成一个具体、可测量的新问题,并给出参考解法。任务要求模型:(1) 在 $p_{init}\to p_{event}$ 的 mid-rollout 提示切换后真实实例化所请求的事件;(2) 相机离开原区域后能回访并重新呈现主体与场景;(3) 回访时主体身份与核心外观不严重漂移、背景保持合理一致;(4) 揭示的事件后状态因果合理——主体的状态或行为随已实现的事件发生恰当改变,而评测只给"盲回访提示"、不预告具体反应,逼模型自行推理。为支撑这一问题,论文交付三件配套产物:受控生成训练集 EvoWorld-Data(约 12k 条不少于 10 秒的长视频,覆盖 19 个事件族/65 细类、16 个场景族/63 细类、5 个反应族/14 细类)、评测集 EvoWorld-Bench(120 例、120 组提示),以及 brain–renderer 协作的 EvoWorld 框架作为该问题的 baseline reference solution。
与已有工作不同的是,本文的独特切入是"世界状态推理与视觉渲染显式解耦"的脑-渲染器协作架构,以及对"离屏因果"而非"离屏持续"的关注。已有处理视线外动态的工作(ReMind、LiveWorld、Hybrid Memory 等)主要检验"观察间隙里活跃过程或运动是否继续",属于被动持续;本文问的是"主体离开视野后注入的新事件如何改变它、回访时如何呈现其因果后果",需要 mid-rollout 指令跟随、长程实体一致性、对已实现视觉历史的推理三者同时成立。已有长程记忆方案——循环状态空间、记忆检索/动态帧淘汰、3D 点云空间记忆——只保存或检索过去观测过的视觉状态,是必要但不充分条件。评测层面的差异同样关键:VBench 只测感知质量与短时程行为,不测"事件→回访→反应"因果链;EvoWorld-Bench 用盲回访协议避免把答案写进提示,从而第一次把"因果推理"变成视频世界模型的可量化指标。
核心方法
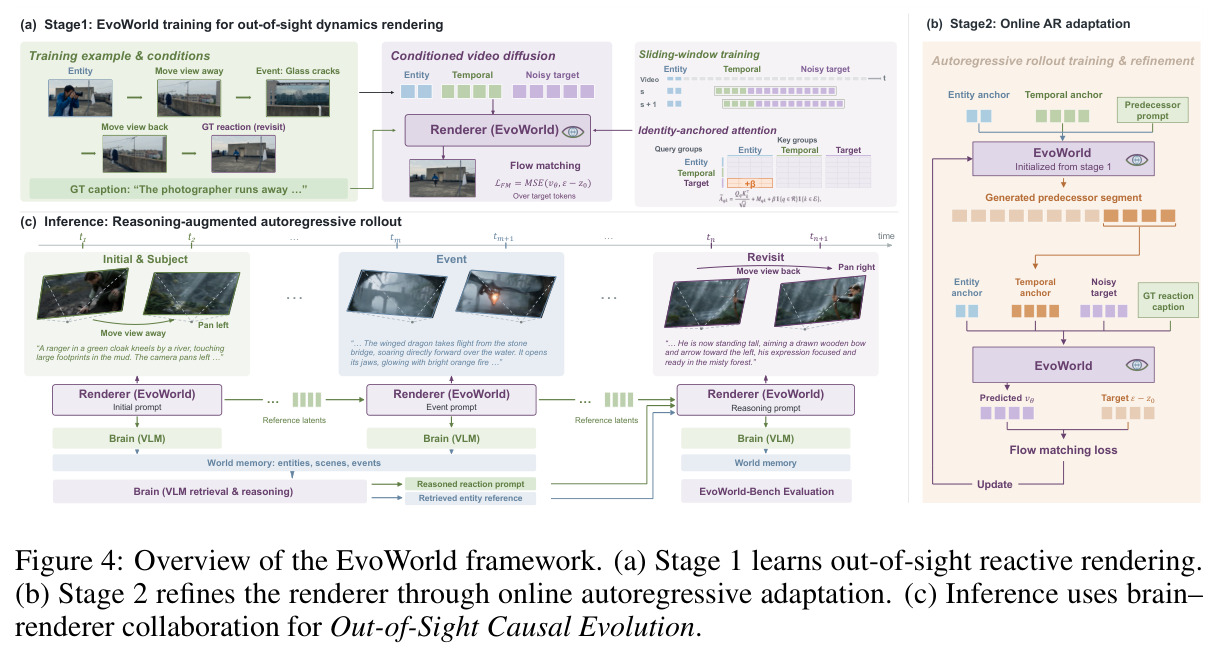
先说直觉:把“想”和“画”分开——扩散视频模型是好的画师却不是好的推演者,于是让 VLM 充当“世界大脑”负责观察、记录与因果推理,让分段自回归渲染器只负责把推出的状态画出来。技术上,渲染器从 LTX-2.5 初始化,大脑用 Qwen3.8-27B(vLLM 部署)。推理时每个段生成完毕后,大脑解码采样帧,识别实体、外观、场景与已实现事件并写入持久世界记忆;事件被渲染并观察后,大脑基于“实际发生的事件”(而非仅请求的提示)推理画面外主体的合理反应,转写成具体生成提示 $\hat{p}$;渲染器以该提示、检索的实体证据(entity anchor)与最近生成的潜变量(temporal anchor,取前 4 个时间潜变量步)为条件生成下一段。训练分两阶段:Stage 1 在干净真值窗口上学事件执行与条件反应渲染,配 Identity-Anchored Attention($\beta=3.0$);Stage 2 做 Self-Forcing 式在线自回归适配,缩小训练-推理差距。推理用官方蒸馏 LoRA 加 8 步采样,输出 896×512 @ 24fps。
核心创新是把世界状态推理显式外置给 VLM 大脑、与渲染解耦,再用一对互补锚点把推理结果可靠“画回去”。记忆层面:已有模型靠潜变量或 3D 空间记忆被动保存过去观测,本文大脑主动推理“未观测到的状态转移”,再以文字提示与视觉证据双通道传给渲染器——语义由提示决定,身份由实体 latents 保证。条件层面:entity anchor 承载长程身份,temporal anchor 取前 4 个时间潜变量步保证运动连续,前者跨长时身份缺口、后者桥接自回归边界;式 (2) 的 per-token timestep 使锚点恒处 timestep 0、零损失,仅监督目标 token。注意力层面:IAA 解决“实体锚点在上下文里但注意力被稀释”的问题,对重访 query 与实体 key 块的注意力分数加偏置 $+\beta\,\mathbb{1}\{q\in R\}\mathbb{1}\{k\in E\}$($\beta=3.0$,仅重访窗口启用),使长间隔离屏后主体保真回归。
方法步骤详情
第一步,数据构建:结构化元组(场景、主体、事件、反应、相机轨迹)组合,Gemini3.1-Pro 写成五拍单镜头脚本,Seedance 2.0/2.5 渲染 896×512@24fps,VLM 验证主体离场重现、事件与反应可见,产出约 12k 条长视频并标注审计。第二步,Stage 1:滑窗输入 $x_\sigma=[e|c|(1-\sigma)z+\sigma\epsilon]$,仅目标 token 由流匹配损失 $\mathcal{L}_{S1}$ 监督,重访窗口启用 IAA;rank-128 LoRA、8000 步、lr $1\times10^{-4}$、有效 batch 64。第三步,Stage 2:对“事件→回访”对做在线一跳 rollout,取前驱段尾部 4 个潜变量替换时间锚点,优化同型损失 $\mathcal{L}_{S2}$;75/25 在线/真值混合防遗忘,200 步、lr $2\times10^{-5}$。第四步,推理:初始帧编码为 1 个实体参考潜变量步,每段条件于前段尾部 4 个潜变量;大脑逐段感知记录,事件后推理生成重访提示,渲染器据此生成回访段。
技术新颖性
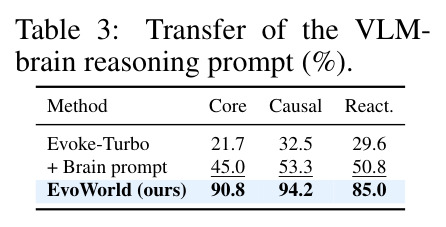
问题级:首次把“mid-rollout 事件注入+离屏主体因果演化+回访揭示”形式化为可评测问题,用盲回访协议与强/弱事件强度标签避免答案泄漏。架构级:brain–renderer 协作是系统级创新,Table 3 证明推理提示可迁移(Evoke-Turbo Core 21.7%→45.0%),不绑定单一渲染器。注意力级:IAA 是轻量的方向性软注意力汇,与流匹配目标无缝整合——锚点零损失,偏置仅作用于重访 query–实体 key 块,实现上在 LTX 掩码转 log 空间前乘 $e^{\beta}$ 即精确等价式 (1)。训练级:两阶段课程先在干净锚点上学能力、再在线 rollout 消暴露偏差,75/25 混合防止覆写 Stage 1 能力;一跳 rollout 而非整链重生成兼顾校正与可行性。数据级:EvoWorld-Data 是首个显式耦合 mid-rollout 事件注入与离屏主体演化的受控数据集,带段级提示与时相标注(离场/重现时刻、相机相位、事件与反应区间),每一环可独立审计。边界:$\beta$ 固定 3.0 未自适应,大脑依赖 prompt 工程而非可学习模块。
实验结果
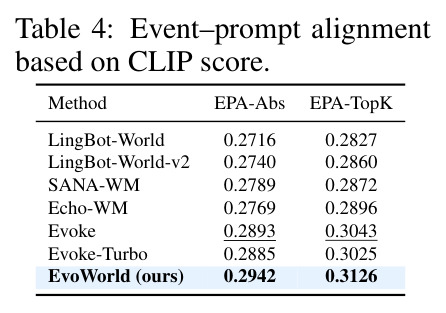
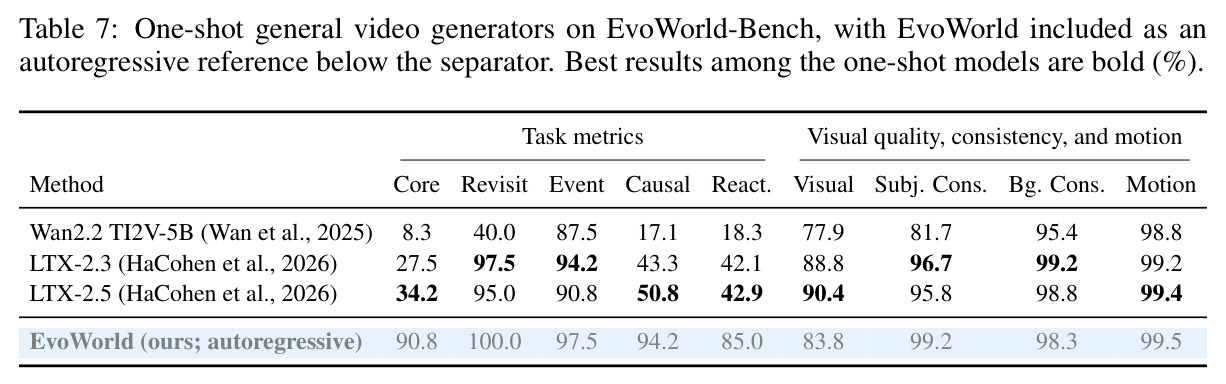
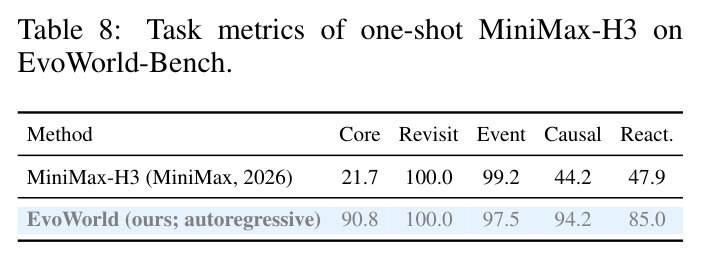
主实验(Table 1):EvoWorld Core 90.8%,超次优 Evoke-Turbo(21.7%)69.1 个百分点;Revisit/Event/Causal/React. 100.0/97.5/94.2/85.0 全场最佳。Evoke-Turbo 回访 98.3%、事件 89.2% 却难达完整因果链——局部成功不等于因果演化。组件消融(Table 2):IAA 使 Core 82.5→84.2;Stage 2 再提至 90.8/94.2。推理消融(Fig. 5):换盲提示后三指标降至 58.3/72.9/69.6,大脑贡献 +32.5 Core。提示迁移(Table 3):Evoke-Turbo 借大脑提示 Core 升至 45.0,仍远低于 90.8。CLIP(Table 4):EPA 0.2942/0.3126 均最高。One-shot(Table 7/8):LTX-2.5 Core 34.2;MiniMax-H3 Event 99.2 但 Causal 仅 44.2。定性(Fig. 6/7):基线幻觉实体、主体复制,EvoWorld 保身份连贯。
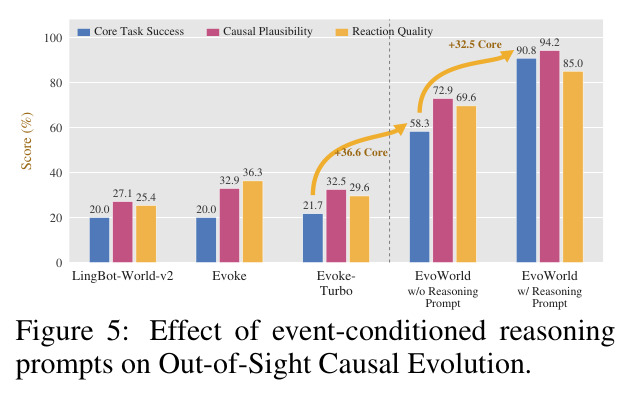
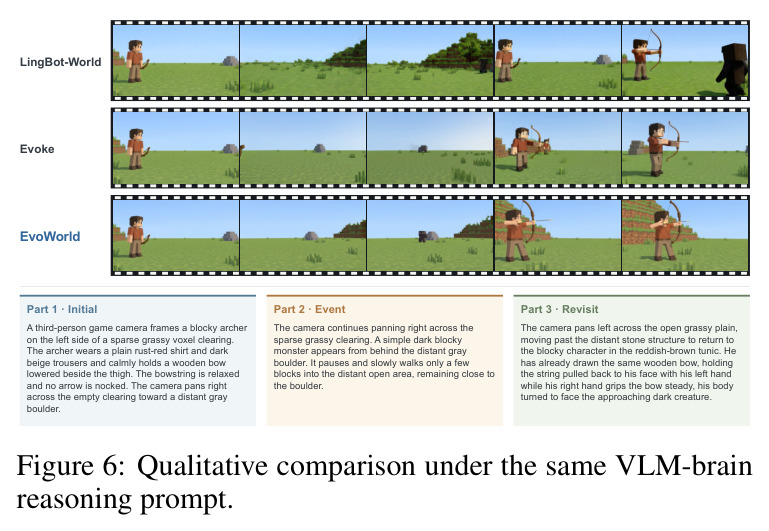
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视线外因果演化(EvoWorld-Bench 120 例,对比 7 个自回归世界模型) | Core Task Success (%) | 90.8 | 21.7(次优 Evoke-Turbo) | +69.1 个百分点 |
| 视线外因果演化(EvoWorld-Bench) | Causal Plausibility (%) | 94.2 | 32.9(次优 Evoke) | +61.3 个百分点 |
| 视线外因果演化(EvoWorld-Bench) | Reaction Quality (%) | 85.0 | 36.3(次优 Evoke) | +48.7 个百分点 |
| 视线外因果演化(EvoWorld-Bench) | Event Success (%) | 97.5 | 89.2(次优 Evoke-Turbo) | +8.3 个百分点 |
| 回访主体一致性(EvoWorld-Bench) | Subject Consistency (%) | 99.2 | 97.6(次优 Echo-WM) | +1.6 个百分点 |
| VLM 大脑推理提示迁移到 Evoke-Turbo(Table 3) | Core (%) | 45.0(Evoke-Turbo + Brain prompt) | 21.7(Evoke-Turbo 无大脑提示) | +23.3 个百分点(但仍低于 EvoWorld 的 90.8) |
| One-shot 单次生成对照(Table 7,事件在生成前已知) | Core (%) | 90.8(EvoWorld,自回归、事件盲注入) | 34.2(LTX-2.5,最强 one-shot) | +56.6 个百分点 |
局限与改进
作者承认的局限(Appendix G):当前只覆盖“单事件→单主体反应”的最小因果链,未处理多事件交互、早先反应改变后续条件、多主体随时间响应;相机轨迹以水平移开/移回为主,未评测垂直、深度、环绕或六自由度复合轨迹,而这些会显著加大场景对应、实体检索与回访一致性的难度。我的观察:(1) 评测判官是 VLM(Qwen3.8),与大脑同源,有自我偏好风险,且指标仅二值或 {0, 0.5, 1} 三级,粒度较粗;(2) 数据由 Seedance 2.0/2.5 生成、脚本由 Gemini3.1-Pro 撰写,部分增益可能来自生成模型自带的因果先验而非框架本身,闭源依赖也影响复现;(3) 基线默认无大脑推理,Table 3 部分弥补,但 45.0 对 90.8 的差距也可能含“基线未在同类数据上训练”的成分,缺严格数据对照;(4) 每段生成后调用 27B 级 VLM,延迟成本显著,非实时;(5) Bench 仅 120 例,子类目统计功效有限;(6) 受控 I2V 评测中实体参考被刻意构造为清晰初始帧,长程检索路径未真正受考验。
独立分析的弱点
(1) 单事件-单反应链:真实世界多事件并发、级联影响,当前框架的记忆与训练都未覆盖。改进方向:数据引擎生成多事件交错脚本,大脑记忆升级为事件图谱并引入优先级与时序推理,评测增设多事件 Core 指标。(2) 相机轨迹单一:实体检索隐含"曾看到清晰观测"假设,大位移或环绕运动下背景对应与主体重定位都会失效。改进方向:引入几何/3D 空间记忆辅助实体重定位,数据加入六自由度轨迹并评测检索鲁棒性。(3) 判官与大脑同源:都是 Qwen3.8,自评偏差不可忽略。改进方向:用异构判官(如 Gemini、GPT 系)交叉验证,并发布人工标注校准子集。(4) 逐段 VLM 调用的延迟与费用:不适合实时交互场景。改进方向:把大脑蒸馏成小型策略模型,或只在语义边界触发推理。(5) 数据闭环依赖闭源生成器:Seedance/Gemini 的水印、偏置与能力上限都会传导进训练分布。改进方向:开源数据管线或混合真实拍摄数据。(6) 反应力度校准只有强/弱两档:更细的因果强度建模(事件物理量级、与主体距离、主体能力画像)可让"因果合理性"判定更精细。
未来方向
作者提出的方向:把数据、推理记忆、训练流程与评测协议扩展到多事件、多反应的长时程世界演化;纳入垂直、深度、环绕等复杂相机运动乃至六自由度交互控制,检验框架在更一般交互相机下的稳健性。基于其成果可自然延伸的方向:(1) 把 prompt 工程式的大脑换成可训练的世界状态模块(可学习 memory token、或用强化学习优化反应策略),让"推理"本身可被端到端优化;(2) 与动作/文本交互控制结合(Matrix-Game 3.0、Zing-0.5 一类),研究"玩家触发事件 + NPC 离屏演化"的开放世界玩法;(3) 因果反事实评测:同一初始状态注入不同事件,检验模型是真因果推理还是背反应模板;(4) 用 EvoWorld 作为环境生成器训练具身智能体,离屏演化提供更真实的非马尔可夫环境动力学,形成"世界模型-智能体"训练闭环;(5) 实体锚点扩展到多主体、严重遮挡与外观变化(如受伤、换装)场景,研究检索的鲁棒性与身份更新机制。
复现评估
附录 A–F 对复现友好:数据构建全流程、完整评测协议(判官协议、打分标准与 Core 聚合公式)、训练超参(Table 6:rank-128 LoRA、8000 步 lr $1\times10^{-4}$、有效 batch 64、$\beta=3.0$;Stage 2 200 步 lr $2\times10^{-5}$、75/25 在线比例)、大脑协议与 Algorithm 1 伪代码齐备。算力门槛不高:8 张 GPU、LoRA 微调即可,推理用官方蒸馏 LoRA 加 8 步采样。障碍在依赖链:基座 LTX-2.5、大脑 Qwen3.8-27B、数据生成用 Seedance 与 Gemini3.1-Pro、Bench 54 张初始帧来自 GPT-Image-2,评测又依赖 VLM 判官;约 12k 条长视频的生成验证有不小的 API 成本。正文未见开源声明,Data/Bench 或需自行重建。综合:方法复现难度中等,完整结果复现中高(受闭源组件与数据可得性制约)。基线均用官方接口,HY-World 1.5、Matrix-Game 3.0、AlayaWorld 因协议不兼容未纳入。
论文图表
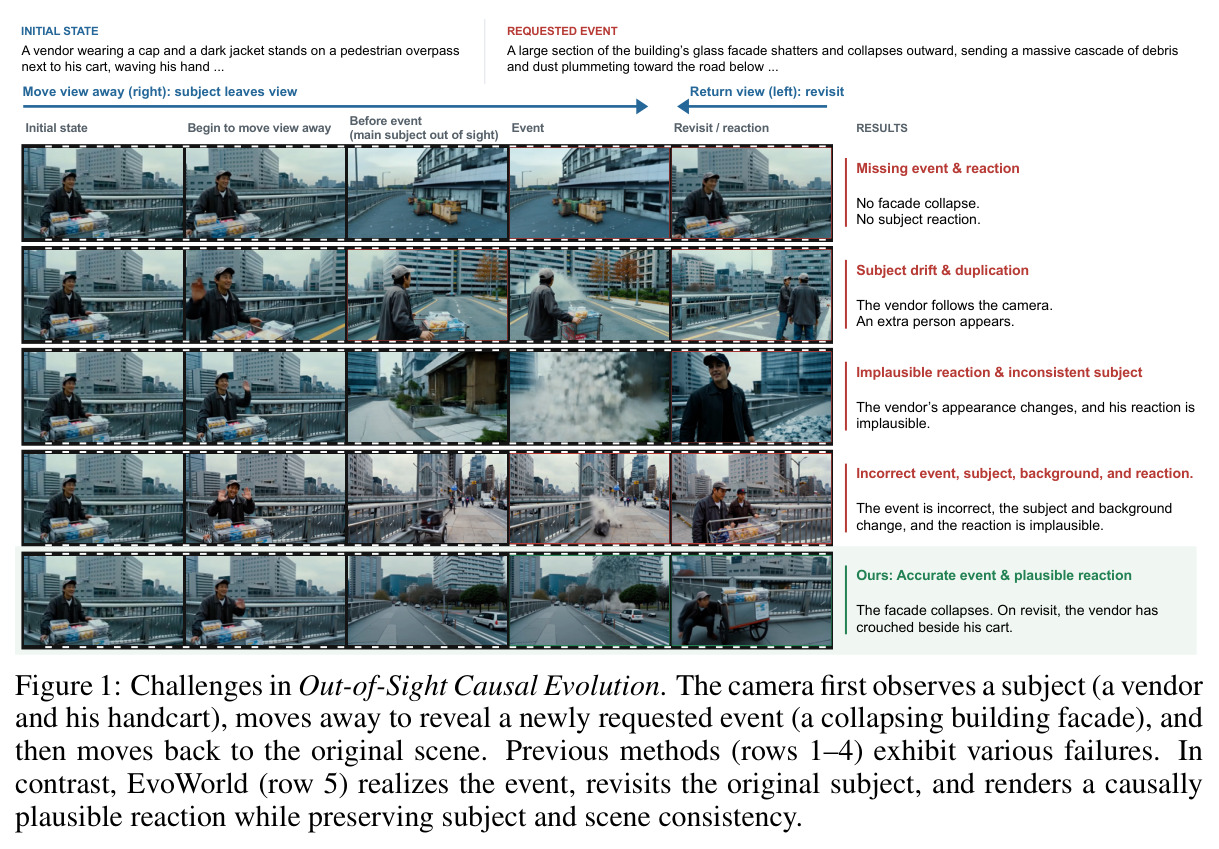
五行对比同一任务:相机先观察天桥上的小贩与手推车,右移揭露事件(建筑玻璃幕墙大面积坍塌坠向马路),再左移回访原场景。前四行是既有模型(HY-World 1.5、Echo-WM、LingBot-World、SANA-WM)的典型失败:事件与反应缺失、主体跟随相机漂移或凭空多出一个人、主体外观改变且反应不合理、事件/主体/背景/反应全错;第五行 EvoWorld 成功实现幕墙坍塌事件,且回访时小贩蹲在手推车旁、身份与场景保持一致。
这张图用一张图讲清了新问题的三个耦合挑战(跨相机运动的主场景一致性、mid-rollout 事件实现、因果反应渲染)以及现有模型的具体失败模式,是理解论文动机与任务定义的最佳入口。