面向LLM智能体记忆的FlyHash:实证验证与新应用 FlyHash for LLM Agent Memory: An Empirical Validation and a New Application
首次将果蝇嗅觉启发的FlyHash用于LLM智能体记忆检索:质量优势稳健,但资源优势不成立
前置知识
FlyHash(果蝇嗅觉哈希)
源自Dasgupta等人2017年对果蝇嗅觉回路的计算建模:气味信号先经稀疏随机投影,从约50个嗅觉感受器神经元扩展到约2000个Kenyon细胞,每个细胞只随机连接约5%–12%的输入通道、权重取±1;随后通过胜者通吃(winner-take-all)只保留激活值最大的约5%细胞置1、其余置0,得到高维稀疏二值码。这构成一种局部敏感哈希:相似输入的码海明距离更近。原论文证明在相同输出位数下,其保邻居结构能力优于SimHash。
本文全部实验围绕FlyHash展开,理解其'稀疏投影+胜者通吃'机制是读懂方法、协议修正与结果的前提。
SimHash(随机超平面哈希)
Charikar于2002年提出的经典LSH:取 $k \times d$ 的高斯随机矩阵 $W$,对输入向量 $x$ 计算 $\text{sign}(Wx)$,每个分量为独立阈值化的比特。输出恰为 $k$ 位,每位取1概率约1/2,码是'稠密'的。两向量夹角越小,码的海明距离越小。它是哈希检索领域最常用的基线,也是本文FlyHash的直接对比对象。
文中所有质量、存储、延迟对比均以SimHash为基线;不清楚它与FlyHash的结构差异(稠密k位 vs 稀疏m位k个激活),就无法理解k与m之辨这一方法论核心。
mAP@R 评估指标
对查询 $q$,以原始(未哈希)嵌入上精确欧氏距离的前 $R$ 个近邻为相关集,按哈希码海明距离排序后计算 $\text{AP}(q)=\frac{1}{R}\sum_{\ell=1}^{R}\text{Precision}(\ell)\cdot\text{Rel}(\ell)$,再对所有查询取平均。相比recall@k,它还奖励把真正近邻排得更靠前。BioHash(2020)将其确立为该领域标准指标,本文沿用。
论文所有质量结论均以mAP@R报告:主结果表、超参消融、HNSW系统对比、非循环标签基准全部基于该指标。
HNSW(分层可导航小世界图)
Malkov与Yashunin提出的图索引:在全精度(或轻量量化)向量上构建多层可导航图,查询时贪心遍历,实现亚线性查询时间与高召回。它是FAISS的IndexHNSW以及Milvus、Pinecone、Weaviate、pgvector等生产向量库的主流索引。代价是每条目存储更丰富的结构(近全精度向量+图边),内存开销高于短二进制码。
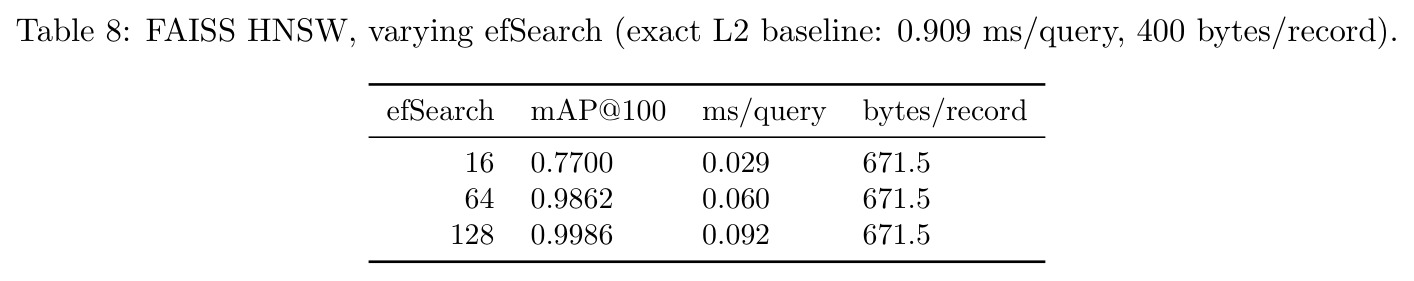
它是RQ2的核心系统基线:本文发现在日常规模下HNSW同时击败两种哈希方法的质量与延迟,这决定了哈希方案的真实适用边界。
匹配有效比特协议
比较两种哈希时'相同比特数'有三种不可互换的含义:(1)相同有效/激活比特数——两方法每次查询实际被海明比较的比特数 $k$;(2)相同物理存储字节——取决于稠密/位打包/稀疏索引等表示;(3)相同查询时资源预算。本文质量对比固定FlyHash池大小 $m=2000$、胜者数为 $k$,同时给SimHash恰好 $k$ 个输出位,使激活比特数相等。
这是全文方法论核心:作者指出k与m混淆是先前比较失真的根源,也是其复现一篇已发表结果时发现差异的起点。
研究动机
LLM智能体在长程、多轮交互中需要外部记忆:把事实、偏好、上下文嵌入成稠密向量,存入FAISS等索引,用近似最近邻检索(如Mem0式系统)。这套方案有效,但内存与计算随嵌入维度和记忆条数线性增长,促使人们寻找把嵌入压缩成短二进制码、同时保住邻居结构的哈希方案。果蝇嗅觉回路启发的FlyHash(Dasgupta等,2017)在SIFT、GloVe、MNIST等基准上,相同输出位数下的邻居结构保持能力优于SimHash,并有DenseFly、BioHash等后续改进。然而这条文献线存在两个被忽视的问题:其一,从未有人把FlyHash式哈希用于LLM智能体记忆检索——尽管智能体记忆恰是短小、众多、按相似度检索单元的场景,理论上是其天然用武之地;其二,该领域所有质量评估(包括原FlyHash论文)都用'按嵌入距离的最近邻'当相关性代理,这与嵌入自身构成循环,并未验证哈希是否真正保住了查询到记忆的相关性;此外不同工作对'相同比特数'的定义含混,跨论文比较结论可能系统性失真。
本文的目标是作者以工程实践者视角提出三个问题而非笼统主张。RQ1:在正确匹配有效比特数的协议下,FlyHash对SimHash的每比特检索质量优势,是否在能代表LLM智能体记忆的数据上稳健成立——要求跨越10个随机种子、四个数据集(两种模态);RQ2:质量优势能否转化为真实部署中的内存与延迟优势,特别是对比今天从业者默认的稠密向量索引HNSW;RQ3:在真实的、非循环的智能体记忆相关性标注(而非嵌入最近邻代理)下,优势是否依然成立。配套目标包括:交付一个可运行的端到端智能体记忆系统演示、一套表述精确到能防止混淆的匹配协议、超出原论文的统计验证(10种子、36配置超参扫描、配对显著性检验),以及诚实报告那些缩小而非美化headline结论的答案。
与已有工作不同的是,本文的独特切入有三层。第一是应用空白:作者检索了FlyHash及其后续(DenseFly、BioHash、FlyNN),没有工作把它接到LLM智能体记忆上,本文填的正是'新应用×严格验证'的交叉点,且明确声明实现本身不是贡献。第二是方法论缺口:作者在复现一篇已发表结果时发现差异,逐项排查后定位出一个此前未见记载的k-vs-m混淆陷阱——天真地把FlyHash总输出宽度 $m$ 当作扫描的'比特数'、同时固定胜者比例(如5%),会静默地让FlyHash的有效激活比特远少于名义值,系统性冤枉FlyHash;他们把正确协议(匹配激活比特 $k$)写成可防错的精确规则,并区分了质量parity与存储/资源parity两类不可混用的概念。第三是诚实性姿态:不同于只报告漂亮结果的工作,本文把'质量优势不等于资源优势'、'HNSW在日常规模全面胜出'这两个不利发现摆在同等显要位置,并用人物名锚定的非循环相关性标签弥补整个文献的评估缺陷。
核心方法
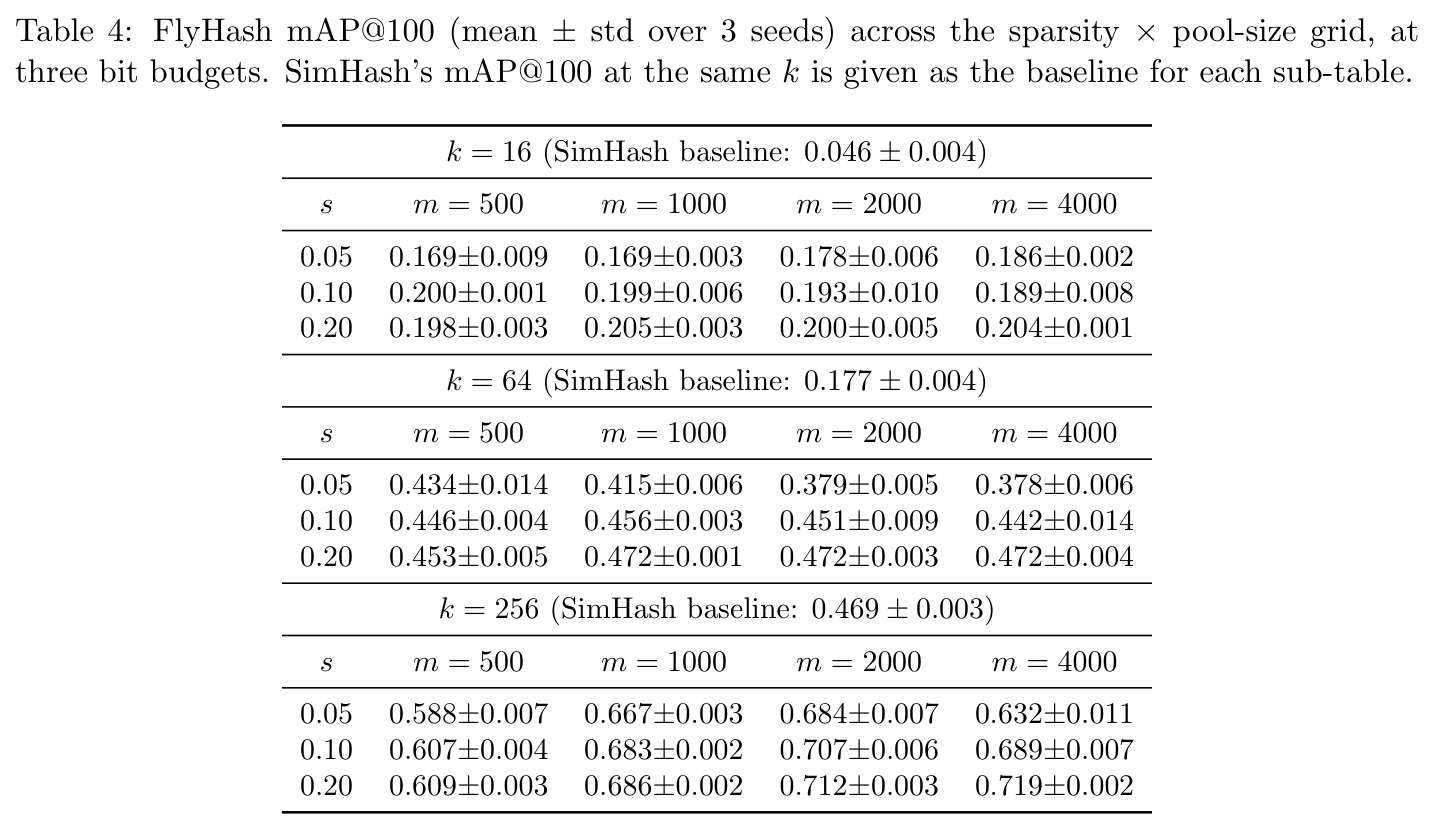
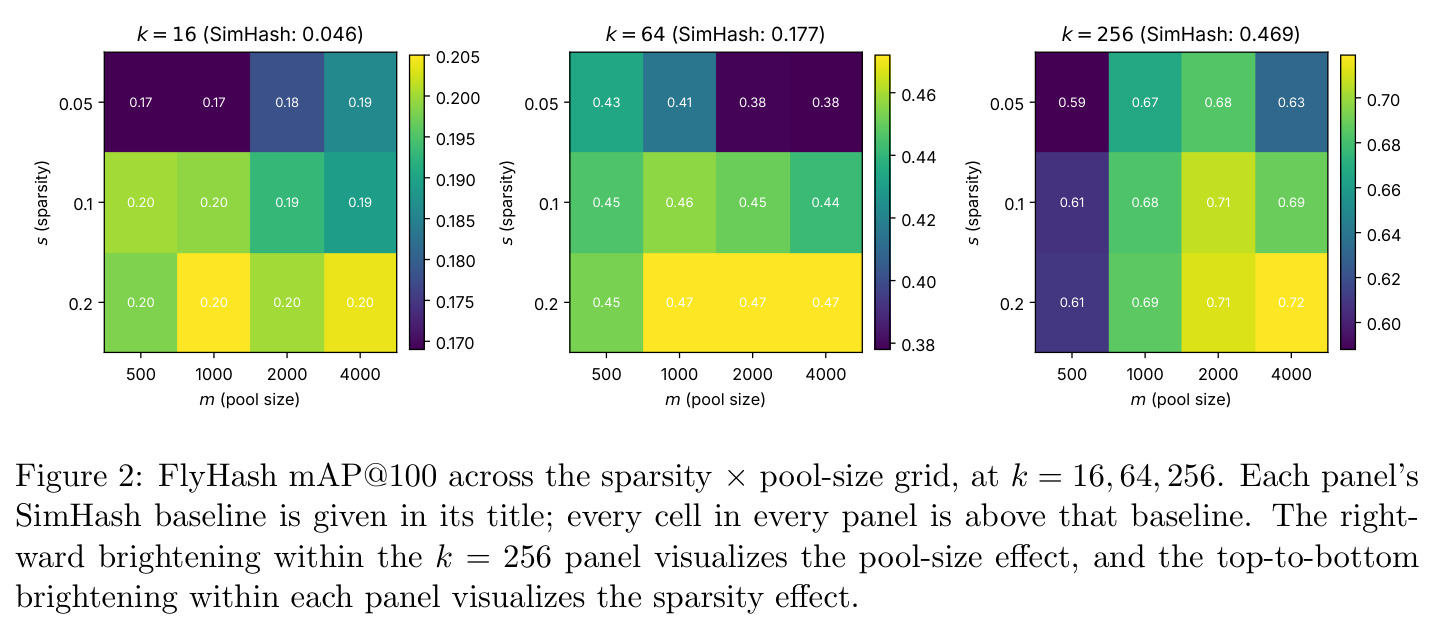
直觉类比来自果蝇:气味分子激活约50个嗅觉感受器神经元,信号被稀疏随机投影到约2000个Kenyon细胞——每个细胞只随机连接约5%–12%的输入通道、权重为±1——然后只有激活最强的约5%细胞'放电',形成稀疏二值码。这个'先升维稀释、再赢者通吃压缩'的过程是一种局部敏感哈希:语义相近的输入得到海明距离更小的码。技术路线上,FlyHash取稀疏投影矩阵 $P \in \mathbb{R}^{m \times d}$,每行随机连接 $\lceil s \cdot d \rceil$ 个输入维(本文 $s=0.10$,遵循生物连接率),权重均匀取 $\{-1,+1\}$;投影 $Px$ 经 $k$-胜者通吃输出 $h_{\text{fly}}(x)=\text{WTA}_k(Px) \in \{0,1\}^m$,恰有 $k$ 个1,$m$ 为池大小(默认2000)、$k$ 为比特预算。SimHash则是稠密高斯矩阵加 $\text{sign}(Wx)$ 输出 $k$ 位。评估用mAP@R:以原始嵌入精确欧氏前 $R$ 近邻为相关集,按海明距离排序计算平均精度。所有质量实验在匹配有效比特协议下进行:FlyHash固定 $m=2000$、胜者数 $k$,SimHash输出恰 $k$ 位,把哈希函数本身的质量与输出总宽度解耦。
核心创新是'匹配有效比特'(matched-active-bit)协议及围绕它建立的诚实评估框架。论文指出'相同比特数'至少有三种不可互换的含义:(1)相同激活/有效比特——每次查询实际被海明距离比较的比特数 $k$;(2)相同物理存储字节——取决于表示方式(稠密/位打包/稀疏索引);(3)相同查询时资源预算——可与存储不同。质量对比必须用(1),资源对比必须用(2)(3),混用即失真。作者通过复现一篇已发表结果发现差异,最终定位到k-vs-m混淆:天真做法把FlyHash总输出宽度 $m$ 设为扫描的'比特数'、同时固定胜者百分比,导致FlyHash在名义k=16时实际激活比特只有其中一小部分,而SimHash拿到全部名义比特——这种混淆静默且严重地不利于FlyHash。修正协议后,FlyHash的优势在全部数据集与种子上稳健成立。与已有工作的本质区别:原FlyHash论文及DenseFly、BioHash等后续从未明确这三种parity之别,也从未在非循环相关性标签上验证;本文把协议写成精确规则,并把质量结论与资源结论分开陈述,拒绝让前者暗示后者。
方法步骤详情
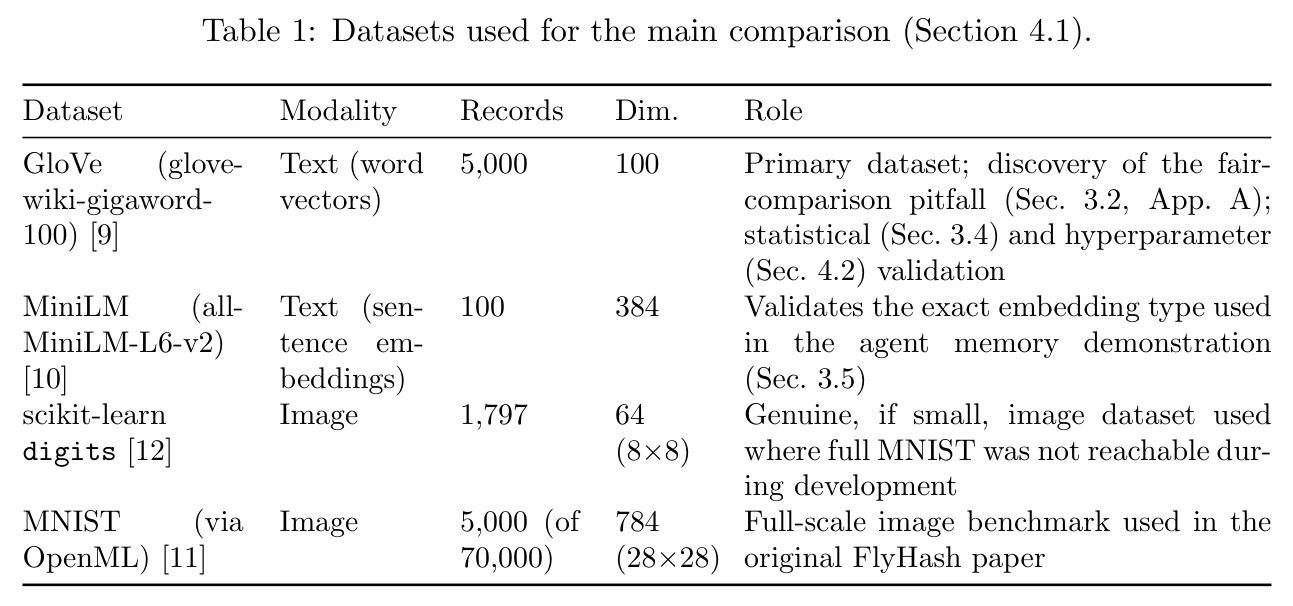
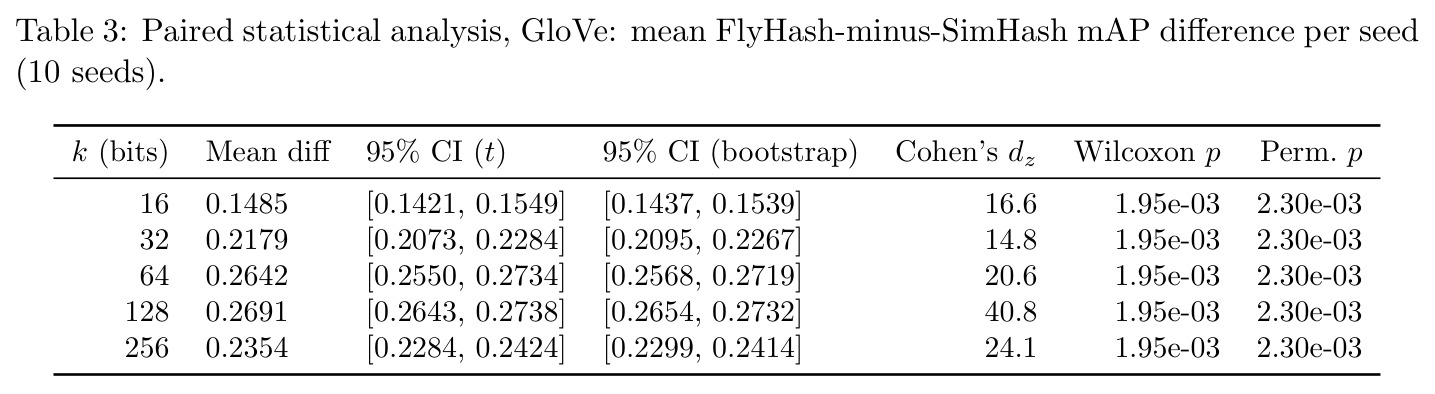
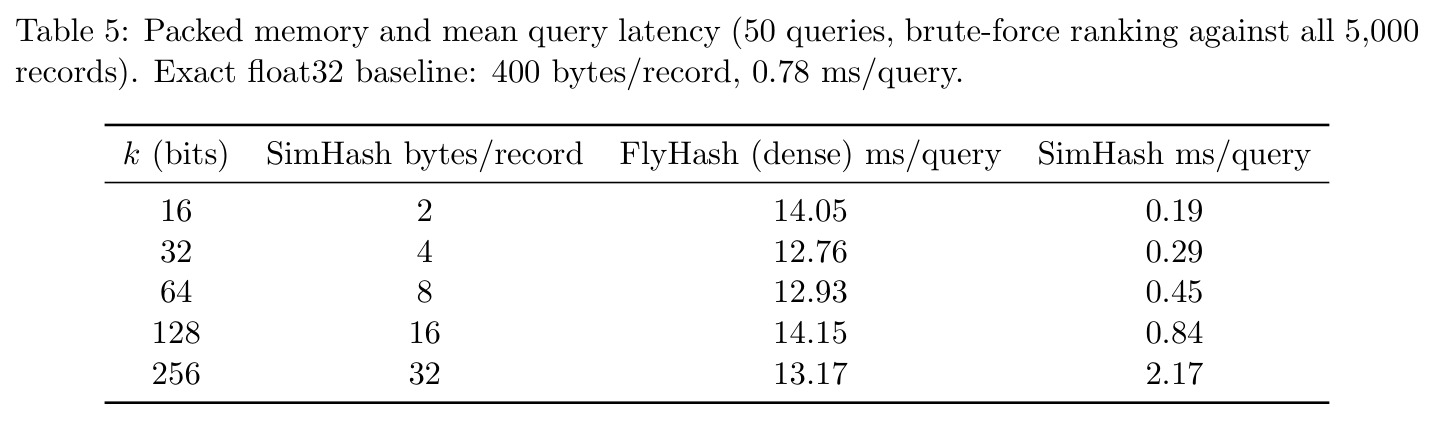
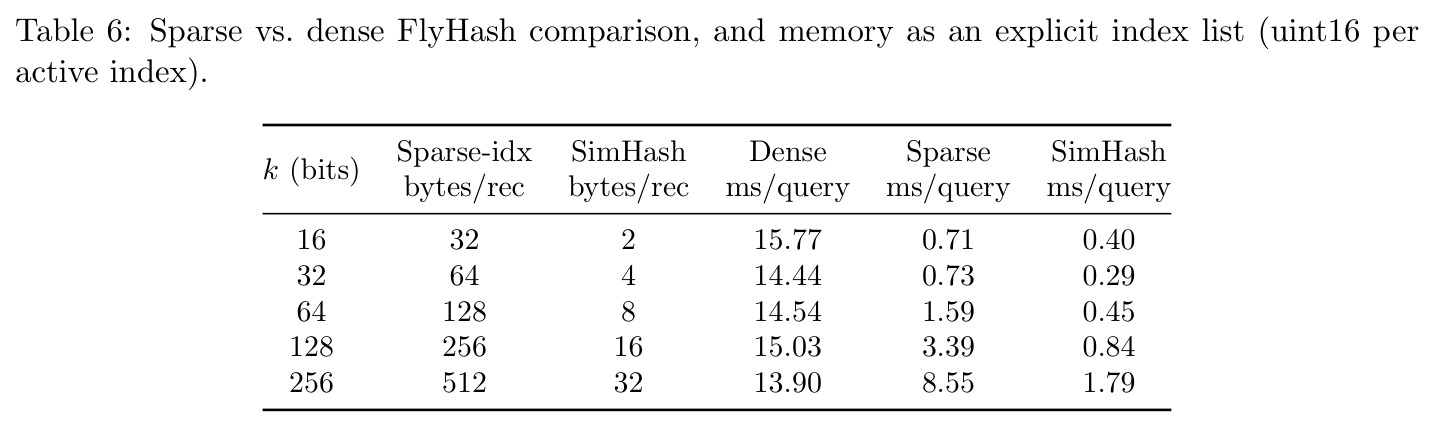
流程分五步。第一步,哈希计算:输入 $d$ 维向量(GloVe/MiniLM嵌入先L2归一化,MNIST/digits像素缩放到[0,1]);FlyHash用 $s=0.10$ 的±1稀疏矩阵投影到 $m=2000$ 维再取top-$k$置1;SimHash输出 $\text{sign}(Wx)$ 的 $k$ 位。第二步,质量评估:对四个数据集(GloVe 5000条/100维、MiniLM 100句/384维、digits 1797条/64维、MNIST 5000条/784维)在 $k \in \{16,32,64,128,256\}$ 下算mAP@R,重复10个随机种子(只换投影矩阵初始化、固定查询集),报告均值±标准差与'差距>2倍合并标准差'稳健判据。第三步,配对统计分析:同种子下两方法配对,报告均值差的t区间与bootstrap(10000次重采样)95%置信区间、Cohen's $d_z$、Wilcoxon符号秩与符号翻转置换检验;另做 $s \in \{0.05,0.10,0.20\} \times m \in \{500,...,4000\} \times k \in \{16,64,256\}$ 共36配置、3种子的超参扫描。第四步,资源测量:GloVe上测位打包存储与暴力查询延迟(50查询);利用两码均恰 $k$ 个激活位时海明距离 $=2k-2|A \cap B|$ 的性质,把稠密比较换成激活索引集的稀疏-稀疏乘积;再对比FAISS HNSW(M=32,efConstruction=200)。第五步,端到端验证:remember/recall文本接口包装MiniLM嵌入+FlyHash存储,接入LLM工具调用循环;并构造150个人物×10条事实×3-4种改述=6000条记忆、150个查询的非循环标签基准(相关集由人名锚定构造固定),用TF-IDF+SVD(256维)嵌入、10种子重测。
技术新颖性
技术新颖性不在算法——FlyHash是2017年的已知算法,作者明言实现并非贡献(PyPI已有通用包)——而在四点组合。其一,应用首个:把FlyHash引入LLM智能体记忆检索并给出可用系统,验证完整流水线(嵌入→哈希→海明排序→LLM工具调用)。其二,协议修正:k-vs-m混淆是此前文献未记载的方法学陷阱,本文的匹配有效比特协议可防止同类错误,且经复现差异调查(附录A,含被排除的假设)验证;这一协议对任何稀疏编码类哈希的评估都有普适价值。其三,验证深度:10种子×4数据集×2模态、36配置超参扫描、配对t/bootstrap/Wilcoxon/置换检验的统计强度远超原论文的单次评估;作者强调配对分析(同一批种子)严格强于仅比较边缘方差的稳健启发式。其四,评估升级:构造基于人物名的非循环相关性标签(标签由构造固定、不依赖嵌入距离),突破该文献全部依赖嵌入最近邻代理的循环评估;同时多角度资源分析(稠密/稀疏/HNSW三档)主动报告不利结果,这种'质量-资源分离陈述'是本文对评估方法学的独立贡献。
实验结果
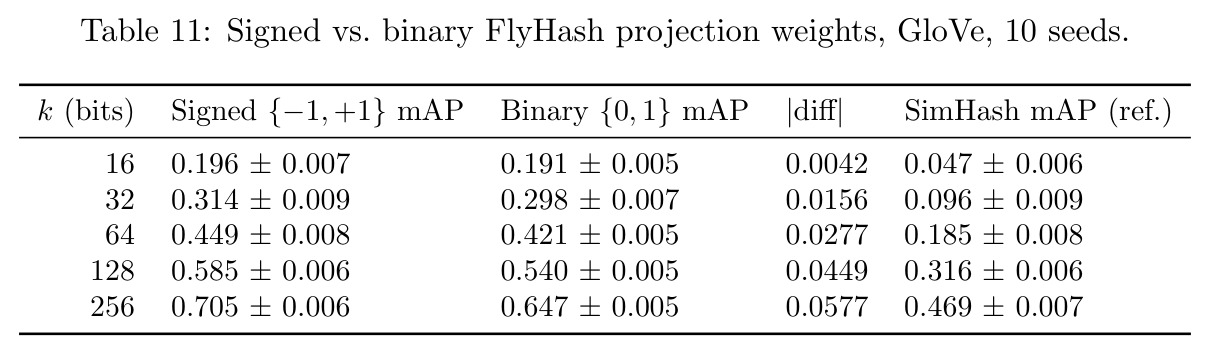
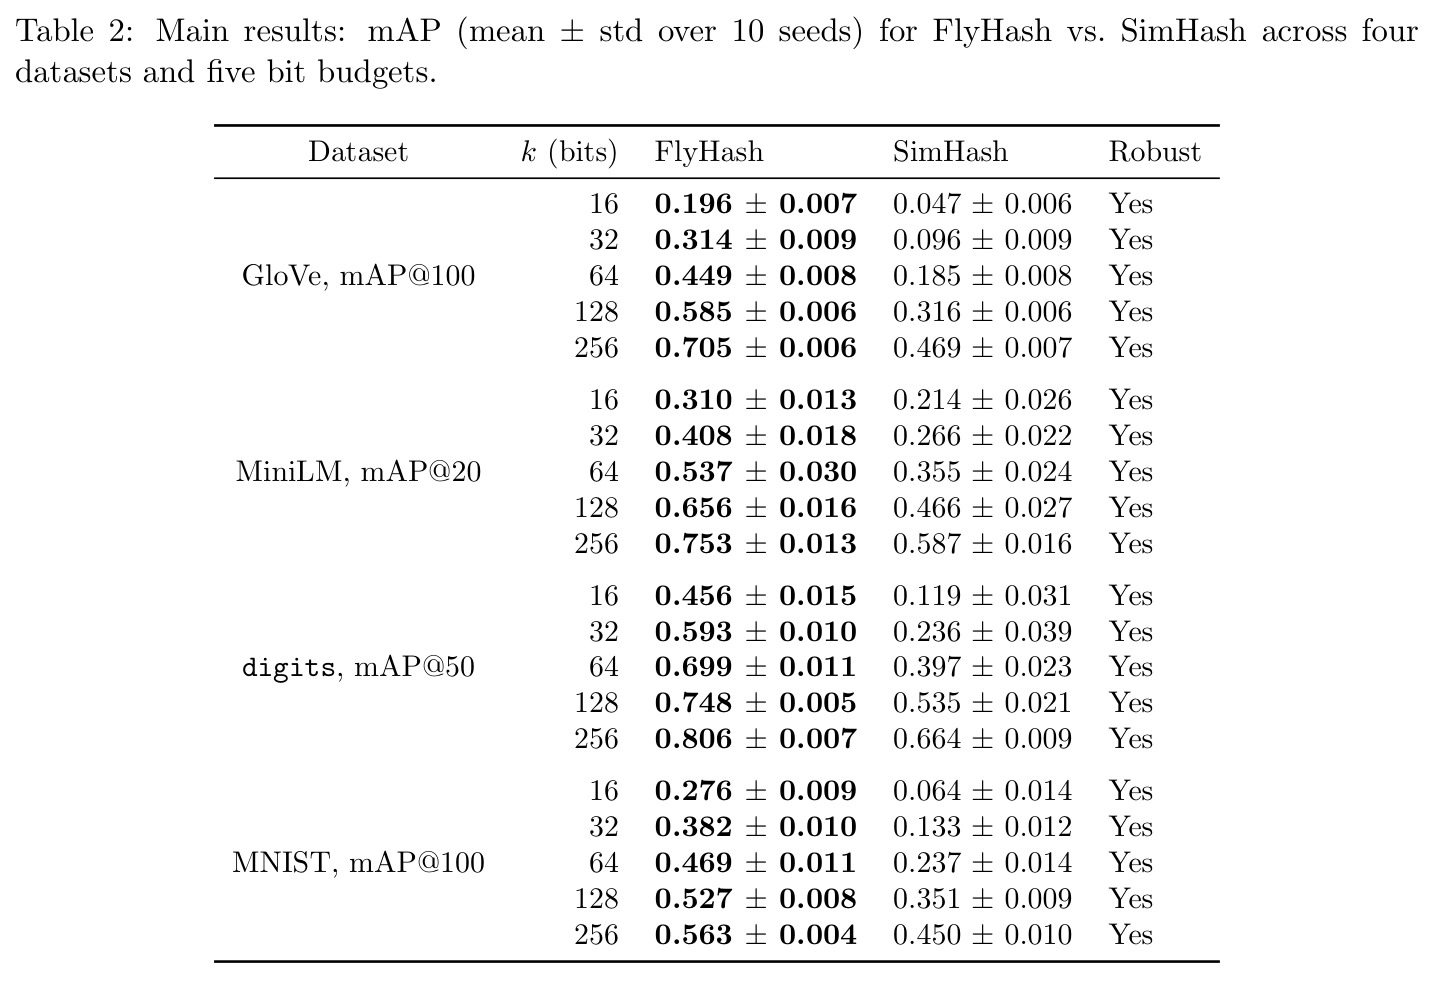
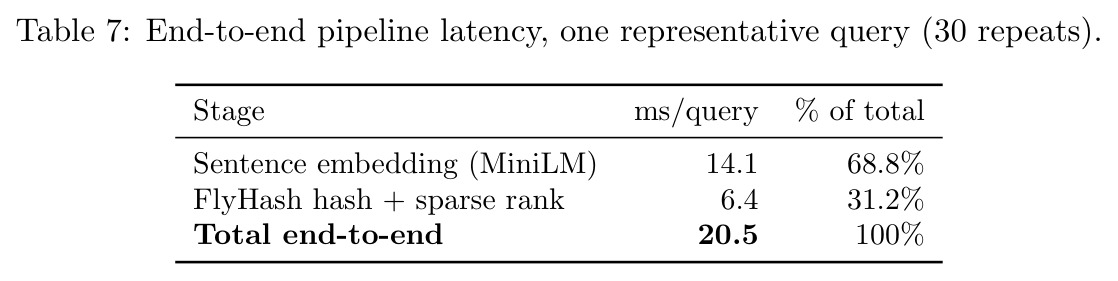
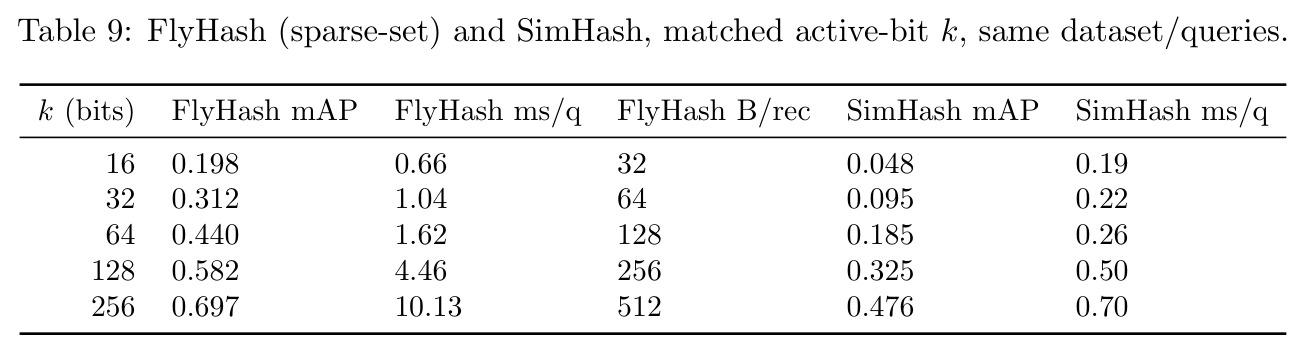
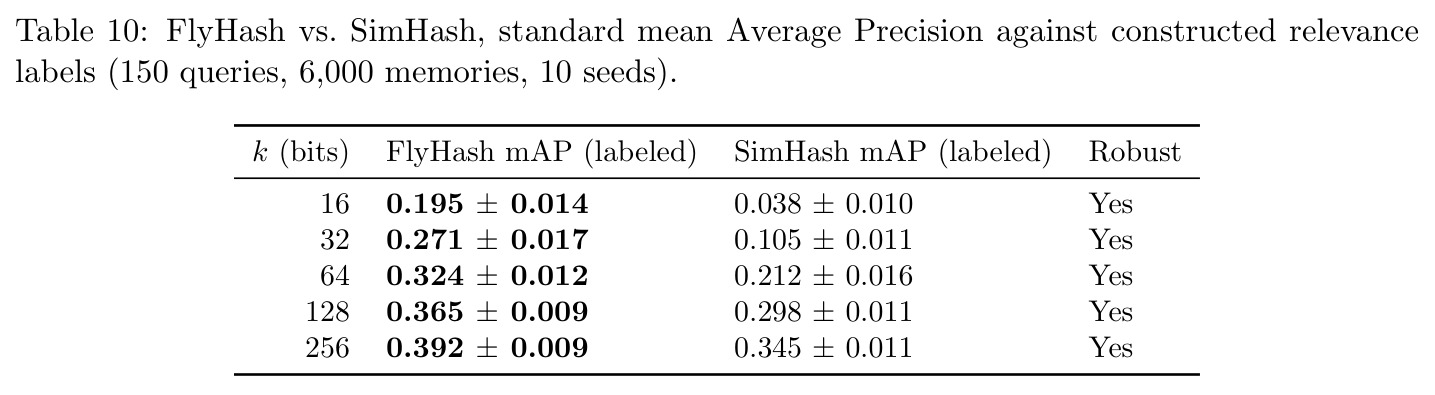
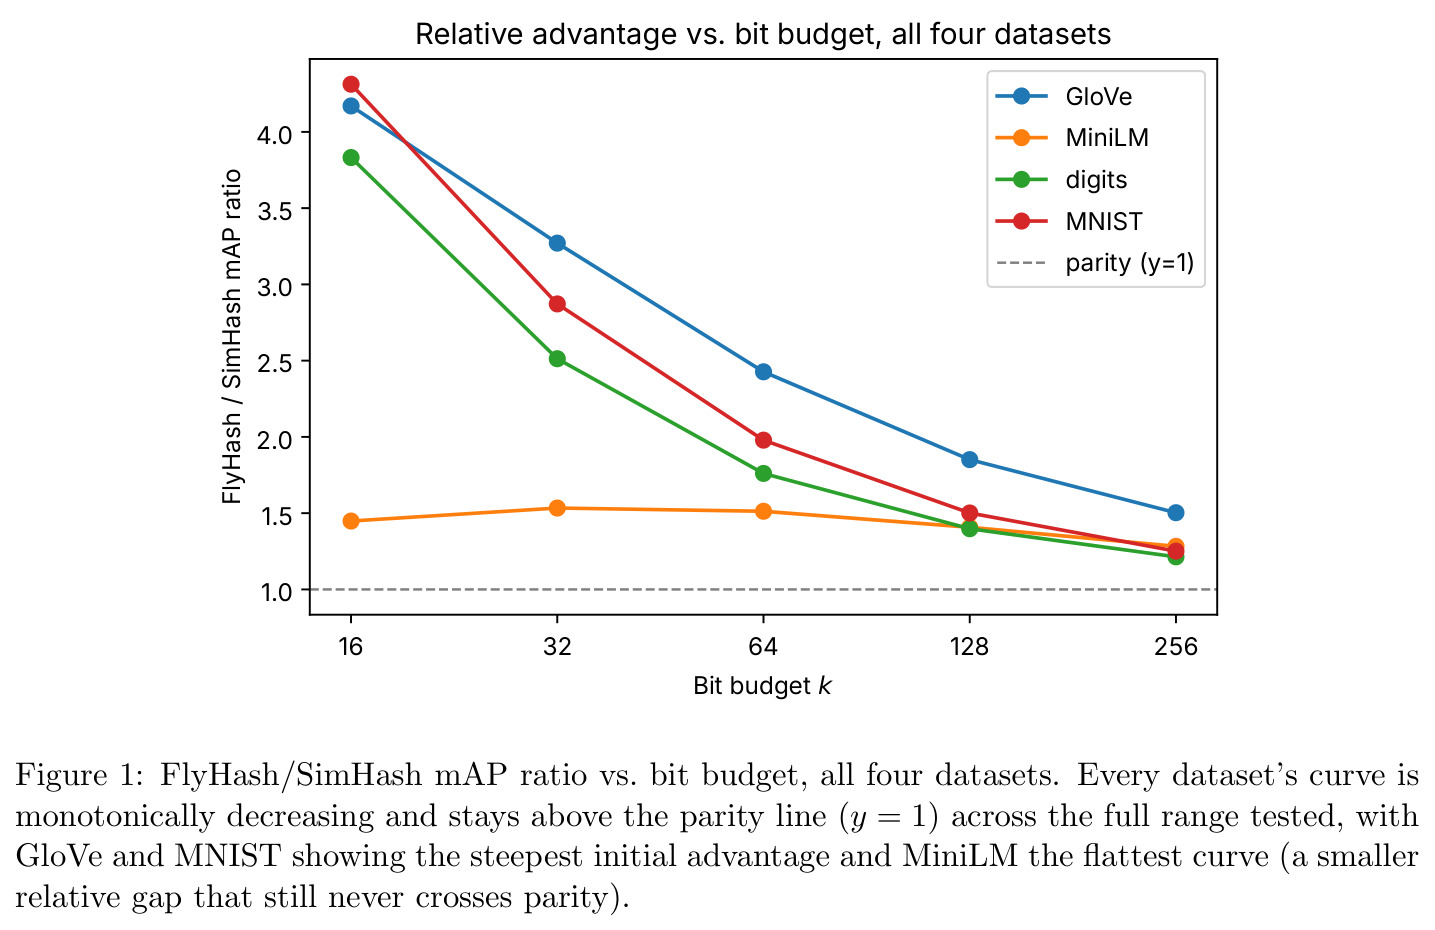
三个问题的答案形态各异。RQ1(质量):修正协议下,FlyHash在4数据集×5比特预算全部20组对比中击败SimHash且全部判稳健;10种子配对分析中Wilcoxon与置换检验p值均为 $1/2^{10} \approx 0.00195$(n=10分辨率下限,全部种子获胜),Cohen's $d_z$ 达14.8–40.8。具体:GloVe mAP@100上k=16为0.196±0.007 vs 0.047±0.006(4.2倍),k=256为0.705 vs 0.469(1.5倍);MiniLM mAP@20为0.310 vs 0.214到0.753 vs 0.587;digits mAP@50为0.456 vs 0.119到0.806 vs 0.664;MNIST mAP@100为0.276 vs 0.064到0.563 vs 0.450。相对优势随 $k$ 增大单调缩小;36个超参配置无一逆转结论。RQ2(资源):质量优势不自动转化为资源优势——稠密表示下FlyHash码恒约250字节/条、约13 ms/查询,比SimHash(k=16时2字节、0.19 ms)慢10–70倍;稀疏集比较(利用 $2k-2|A \cap B|$)快10–22倍但仍慢2–5倍、存储大16倍;HNSW在5000条规模下efSearch=64即mAP@100=0.9862、0.060 ms、671.5字节/条,质量与延迟同时碾压两种哈希(FlyHash最佳k=256仅0.697、10.13 ms)。端到端20.5 ms/查询中嵌入占14.1 ms(68.8%)、哈希+排序仅6.4 ms。RQ3(非循环标签):6000条记忆、150查询的人物化基准上FlyHash依然全预算稳健获胜(k=16为0.195±0.014 vs 0.038±0.010;k=256为0.392 vs 0.345),首次在无嵌入相似性代理条件下证实其优势。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GloVe词向量检索(10种子) | mAP@100 | FlyHash:k=16为0.196±0.007,k=256为0.705±0.006 | SimHash:k=16为0.047±0.006,k=256为0.469±0.007 | 4.2倍(k=16)至1.5倍(k=256),全部20组配对p=0.00195 |
| MiniLM句子嵌入检索(10种子) | mAP@20 | FlyHash:k=16为0.310±0.013,k=256为0.753±0.013 | SimHash:k=16为0.214±0.026,k=256为0.587±0.016 | 1.45倍(k=16)至1.28倍(k=256) |
| MNIST图像检索(10种子) | mAP@100 | FlyHash:k=16为0.276±0.009,k=256为0.563±0.004 | SimHash:k=16为0.064±0.014,k=256为0.450±0.010 | 4.3倍(k=16)至1.25倍(k=256) |
| GloVe暴力扫描查询延迟 | ms/查询(50查询均值) | FlyHash稠密约13 ms;稀疏集比较0.71–8.55 ms | SimHash 0.19–2.17 ms(位打包2–32字节/条) | 负改进:稀疏化后仍慢2–5倍,存储大16倍(诚实报告) |
| 系统级对比 vs HNSW(GloVe 5000条) | mAP@100 与 ms/查询 | FlyHash稀疏集最佳k=256:0.697 / 10.13 ms,512字节/条 | FAISS HNSW efSearch=64:0.9862 / 0.060 ms,671.5字节/条 | HNSW质量与延迟全面胜出;哈希仅存储更小(约1.3–21倍) |
| 非循环标签智能体记忆基准(6000记忆/150查询) | mAP(10种子) | FlyHash:k=16为0.195±0.014,k=256为0.392±0.009 | SimHash:k=16为0.038±0.010,k=256为0.345±0.011 | 5.1倍(k=16)至1.14倍(k=256),全部判稳健 |
局限与改进
作者坦承的局限:稀疏集比较只收复了大部分速度差距,内存劣势仍在;真正亚线性的索引(带状/多探针LSH等)未建成——他们自己尝试的倒排索引在测试规模下并非亚线性;HNSW对比仅单一数据集(GloVe 5000条)单一配置(M=32),未扫描规模与存储预算,而HNSW相对优势会随预算收紧而缩小甚至反转;未纳入原论文的SIFT1M(刻意取舍);未实现DenseFly稠密化与BioHash学习投影(文献报告均优于本文评估的plain FlyHash);未对比PQ/RaBitQ等量化家族(文献显示其每比特精度普遍优于哈希);MiniLM真实文本语料仅100句(为避免重复嵌入伪影);端到端延迟只是单机单查询30次重复的数据点;标签基准用模板合成文本+TF-IDF+SVD替身嵌入,真实部署更可能按会话/用户ID切分记忆而非靠文本中的名字消歧。我的补充观察:非循环基准的'相关集'完全由模板改述定义,在TF-IDF+SVD表征下实际考验的是词汇重叠与人名匹配而非深层语义,结论向真实句向量嵌入的外推有限;此外FlyHash查询需先计算 $Px$ 投影($O(sdm)$),论文把哈希与排序合并报告为6.4 ms,未拆分投影与比较的占比,读者难以判断延迟瓶颈所在。
独立分析的弱点
独立分析四点。第一,标签基准的构造性偏置:150个人物、每条事实3-4条模板改述,查询与答案共享人名和句式骨架,在TF-IDF+SVD表征下任务退化为'人名+词汇重叠匹配',与真实智能体记忆(自由文本、跨会话、按用户隔离)分布差异大——真实系统几乎不会靠全文检索人名来消歧;改进方向是用真实对话日志+真句向量嵌入重跑,或按用户ID分库后测库内检索。第二,规模单一:HNSW对比只在5000条上做,而哈希的相对价值随语料变化——语料增大时HNSW的内存开销(671.5字节/条)累积,极小语料时暴力扫描即可;改进方向是扫描 $10^3$–$10^6$ 条规模曲线,找出哈希与HNSW的交叉点,才能划清结论边界。第三,延迟核算不透明:SimHash查询只需 $k \times d$ 次乘加,FlyHash需先算稀疏投影 $Px$ 再比较激活集;论文把哈希计算与排序合并为6.4 ms报告,未分阶段计时,无法判断瓶颈在投影还是集合求交;改进方向是分阶段报告。第四,缺量化基线:在哈希仅存的利基——极端每条存储预算——里,RaBitQ等1比特/维量化方法据文献精度更高,不对比就难以论证FlyHash是该利基的正确工具;改进方向是加入PQ/OPQ/RaBitQ同预算对比。
未来方向
作者提出的方向:(1)对激活索引列表做delta编码、变长或熵编码,并探索以质量换存储的池大小缩减,缩小剩余约16倍的存储差距;(2)构建真正亚线性的哈希索引(带状或多探针LSH),此前倒排索引尝试已证实在测试规模不亚线性;(3)哈希与HNSW的组合架构——FlyHash码做廉价预筛、HNSW重排(类比FAISS量化+图索引);(4)把HNSW对比扩展到多规模、多配置、多存储预算;(5)实现DenseFly稠密化或BioHash学习投影并接入智能体记忆;(6)与PQ/RaBitQ量化家族正面对比;(7)更大更多样的真实文本语料;(8)多种子、扫语料规模与硬件的系统级基准。基于本文成果可延伸:把非循环标签基准方法论推广到真实用户记忆与真实句向量嵌入;将匹配有效比特协议作为评估规范应用于其他神经启发哈希(如BioHash、DenseFly)以杜绝同类混淆;探索FlyHash在结构化/分层记忆检索(论文引用的Hu 2026、Cao 2026方向)中充当底层压缩层的角色;以及利用'嵌入占端到端延迟68.8%'的发现,优先优化嵌入侧(蒸馏小模型、缓存、批处理)而非哈希侧。
复现评估
复现条件非常好。代码、数据、演示全开源:GitHub仓库加Zenodo存档(DOI 10.5281/zenodo.23903302,解析到最新版),含离线演示、测试和REPRODUCING.md——后者把论文每张表映射到具体复现命令。四个数据集均公开且程序化加载(gensim下载GloVe、sentence-transformers下载MiniLM、sklearn内置digits、OpenML取MNIST),非循环标签基准以JSONL发布(datasets/agent_memory_v1,6000条记忆+150查询+标签)。全流程在消费级CPU硬件上运行(端到端单查询20.5 ms即为佐证),无GPU需求,最大数据集仅5000条,36配置超参扫描也是小规模计算,普通笔记本数小时内可复现主结果。风险点:部分数据需联网下载(作者提到开发时MNIST一度不可达、曾以sklearn digits替代,MiniLM语料也受网络限制而只用100句);端到端演示需接一个通用LLM做工具调用。总体复现难度低,甚至适合作为哈希检索与智能体记忆的入门实践项目;论文对陷阱(k-vs-m混淆、重复嵌入伪影、未命名人名版本基准的病态设计)的完整记录进一步降低了踩坑成本。
论文图表