从自主智能体到认知共生体:迈向AI增强的人类智能 From Autonomous Agents to Cognitive Symbionts: Toward AI-Augmented Human Intelligence
提出认知共生体范式:AI的另一半终局是增强具体的人(AHI),评估对象从机器转向人
前置知识
工作记忆与认知带宽
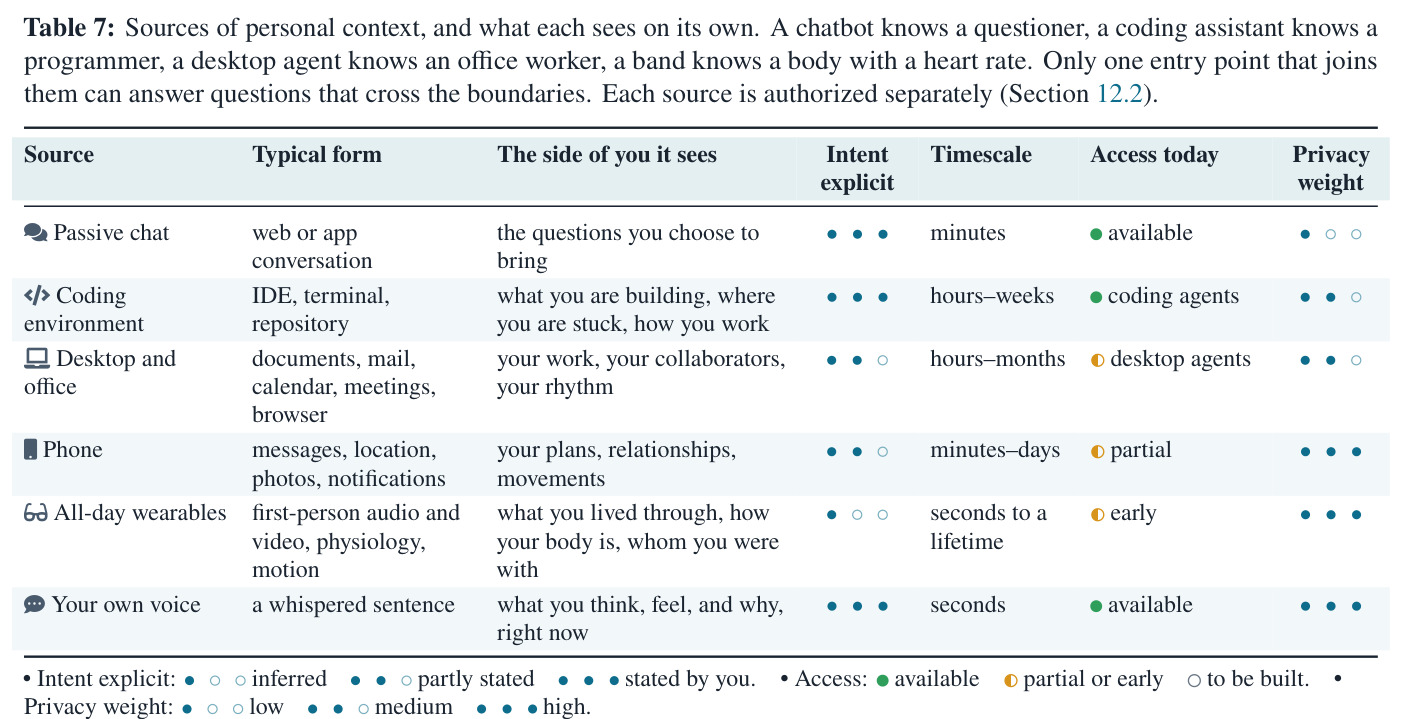
人的工作记忆一次只能维持约4个组块的信息,注意力同一时刻只能在一处,一天固定24小时。这决定了人在任一时刻能真正调用的自身知识只是全部自上下文中的一小部分$c_t$,其余部分'知道但到不了场'。论文的核心不变量——认知差距$G_t$——正是建立在固定带宽与庞大长期记忆之间的这道落差上。
认知差距是贯穿全文的不变量,不理解工作记忆的瓶颈属性就无法理解共生体到底在优化什么。
基础模型与全模态模型
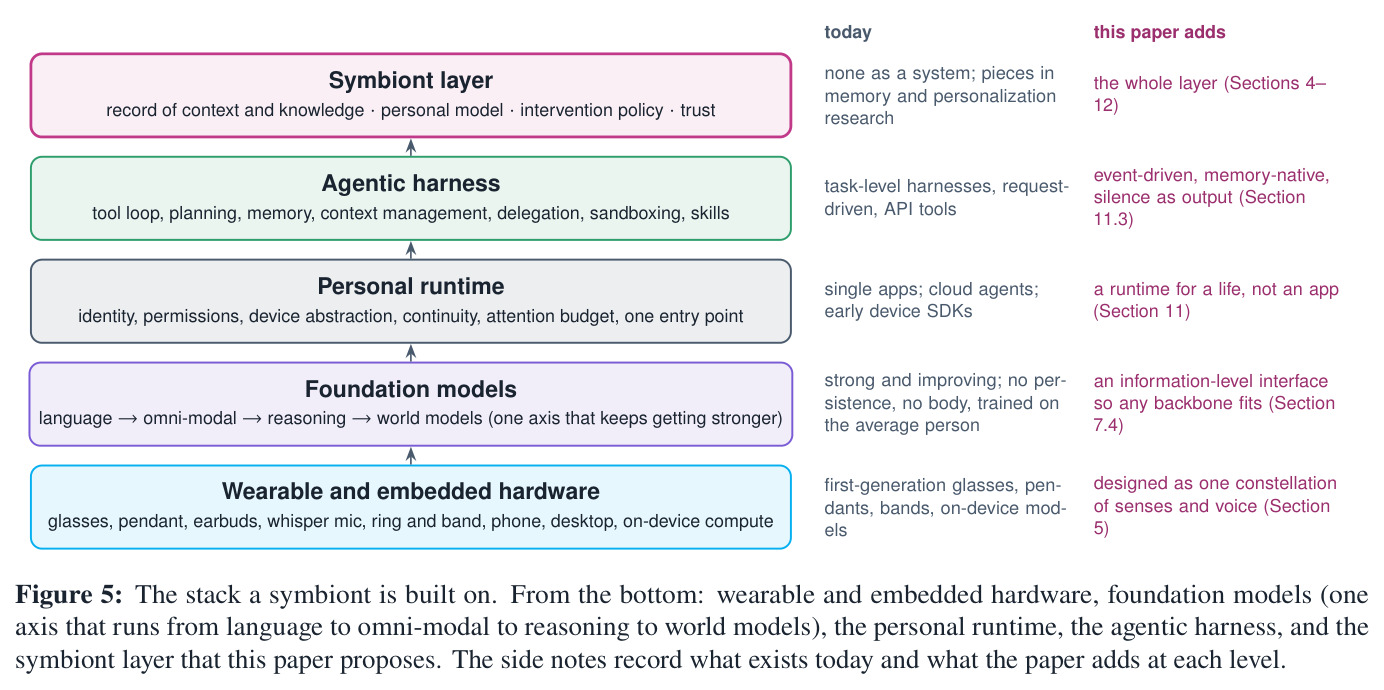
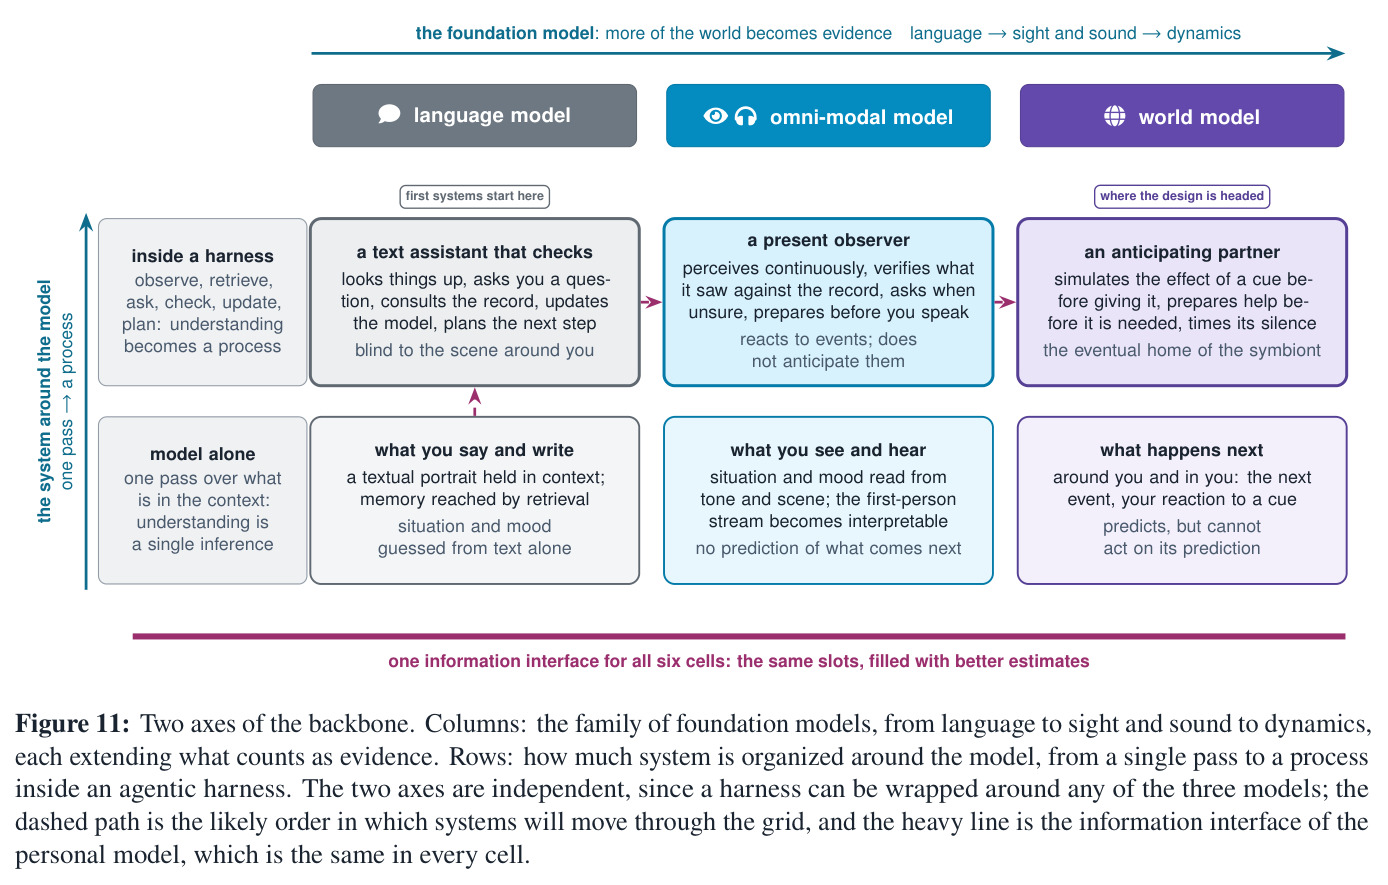
以Transformer为基础、经规模律与对齐训练的大模型,已从文本扩展到图像、语音、视频的实时输入输出,部分支持全双工语音(边听边说);百万token上下文窗口使'把一整天放进上下文'从不可能变为昂贵但可行。它们是共生体的'大脑',但缺乏持久性、时间感、身体,且只见识过'平均人'。
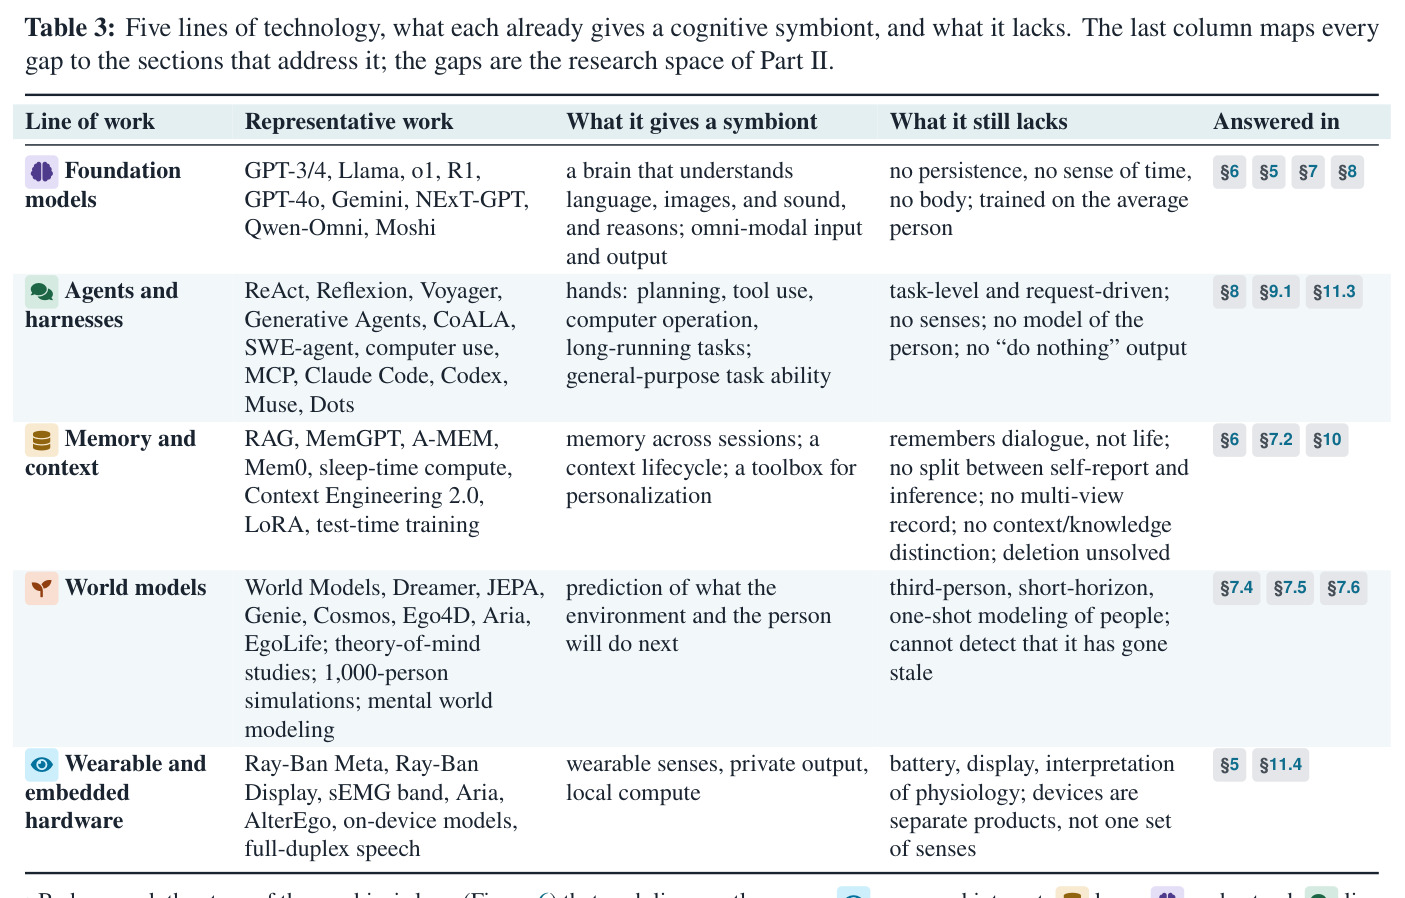
论文的设计可逐一对应到补足基础模型的这四个缺口(§5-§8),是读懂'还缺什么'的基线。
智能体与Harness
智能体是反复'观察-思考-行动'的模型系统;harness是模型之外使其成为智能体的一切:循环、工具接口、记忆、规划与分解、权限沙箱、结果校验与可复用技能库。同一模型放进不同harness表现差异巨大,因此harness本身是研究对象。ReAct、Voyager、SWE-agent、MCP、Claude Code是代表。
共生体被定位为'为一生而非为任务组织的新harness'(§11.3),这是方法部分的关键概念。
记忆与上下文工程
从RAG到MemGPT的操作系统式分层存储、Generative Agents的记忆流与反思、A-MEM的关联演化、Mem0的生产级记忆层与sleep-time compute,构成让模型跨会话记住一个人的工具箱;'上下文工程2.0'把收集-管理-使用视为生命周期。但现有系统记忆的是对话而非生活。
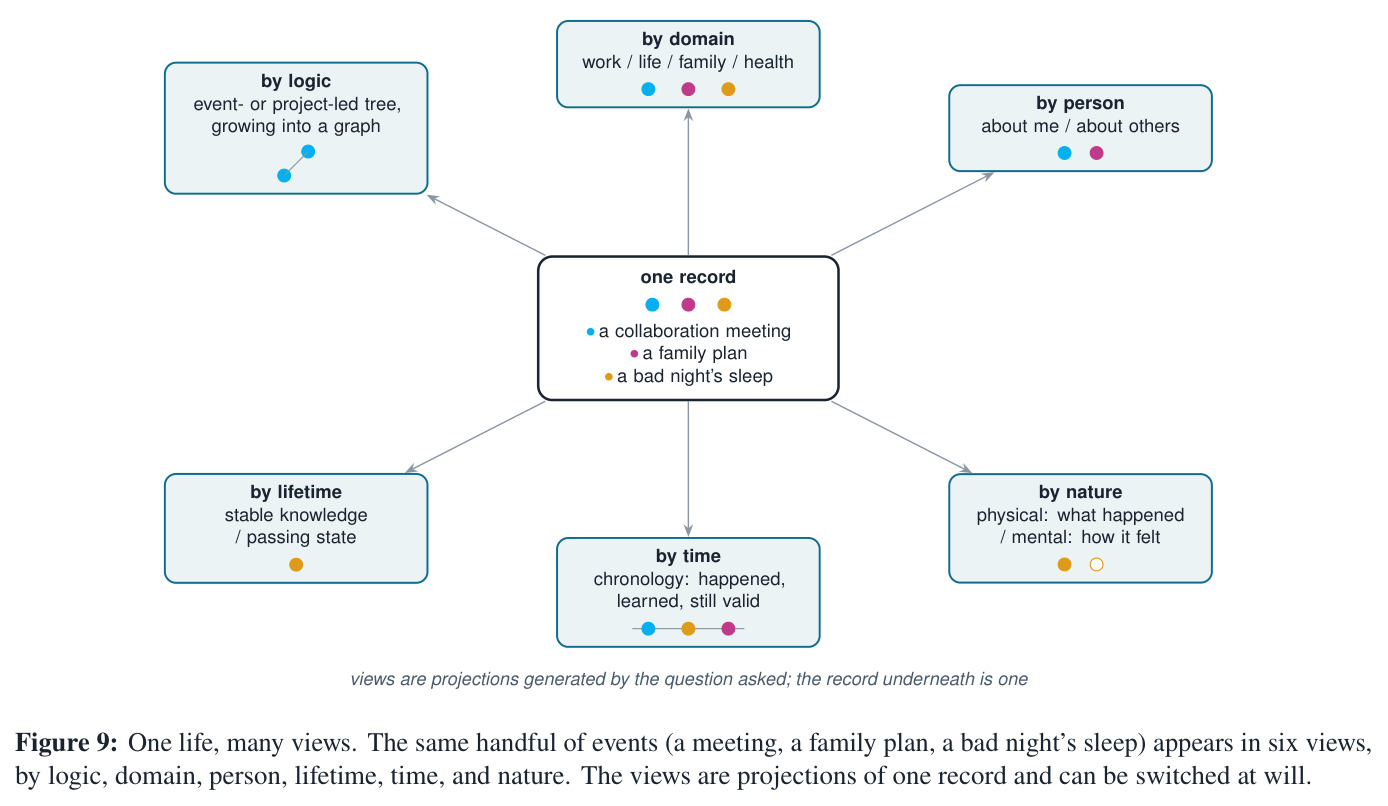
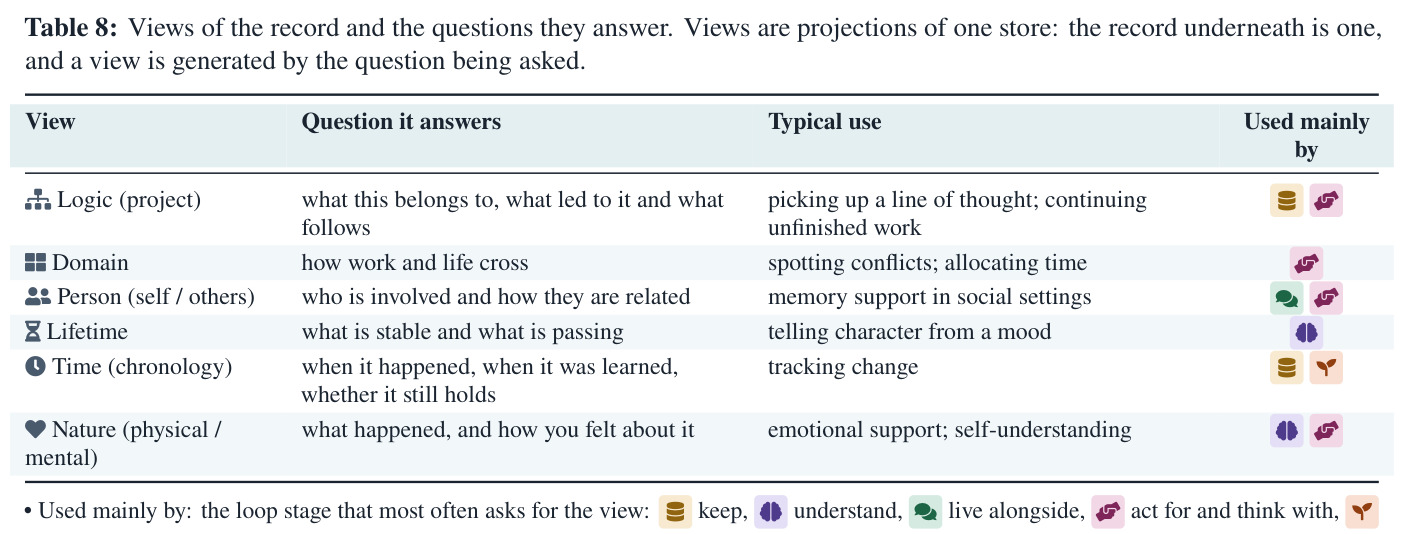
§6的三时间尺度记录、单入口与多视图设计直接建立在这条线之上,又以'记住生活而非对话'与之划界。
世界模型与心智理论
世界模型是预测'接下来会发生什么'的内部模型,谱系含Dreamer、JEPA/V-JEPA 2、Genie/Sora等;心智理论研究模型对他人信念与意图的推断,大模型表现出真实但脆弱的能力。Park等2024年为1,052名真人构建的生成式智能体能复现其调查答案,与本人两周后重测的一致性相当。
§7用外部物理与内部心理两个世界模型形式化个人模型(式3),这是全文的技术核心。
生成式智能体(Generative Agents)
Park等2023年提出的拥有记忆流、反思与规划的小镇居民智能体,是'拥有生活的智能体'最接近的学术原型;2024年扩展到千人级真人模拟。它证明从少量第一人称叙述即可构建个人级预测模型,但这些模型从不更新——共生体要补的正是持续学习与过时检测。
它既是论文评估方法(用仿真预筛干预策略)的支柱,也是'两路证据'论证中最常被引用的证据。
及时自适应干预(JITAI)
移动健康领域积累了十年的框架,研究'在个体处于易感或可接受(receptivity)状态时、以恰当强度、在恰当时机提供干预',并已给出状态与接受度的操作化概念。论文把这一框架从健康行为扩展到认知与社交帮助。
式(4)的干预策略本质上是JITAI的认知版:何时说、说多重、还是沉默,理解时机问题离不开这套既有概念。
贯续学习与测试时训练
让模型在使用过程中增量学习新知识而不灾难性遗忘的技术谱系:LoRA等参数高效适配、测试时训练(TTT)与可在测试时学习的记忆层。Meta发表于Nature的sEMG腕带是现成范例:数千人数据训练的通用模型对新佩戴者免校准可用,20分钟个人数据即可进一步提升。
§10'像人一样学习'的方言阶梯(记住→组句→适应→迁移)以此为技术脉络,并给出通用模型+小规模个人适配的学习曲线主张。
延展心智(Extended Mind)
Clark与Chalmers 1998年提出认知可以延伸到体外的工具(笔记本、手机):稳定可用、可信赖的工具即可视为心智的一部分。这为'会学习、会主动的工具算不算心智的一部分'留下开放边界。
定义4.4第(vi)条直接回应这一边界——共生体扩展人能带到情境中的东西,但判断与目标始终留在人内,是立场论文立论的关键。
研究动机
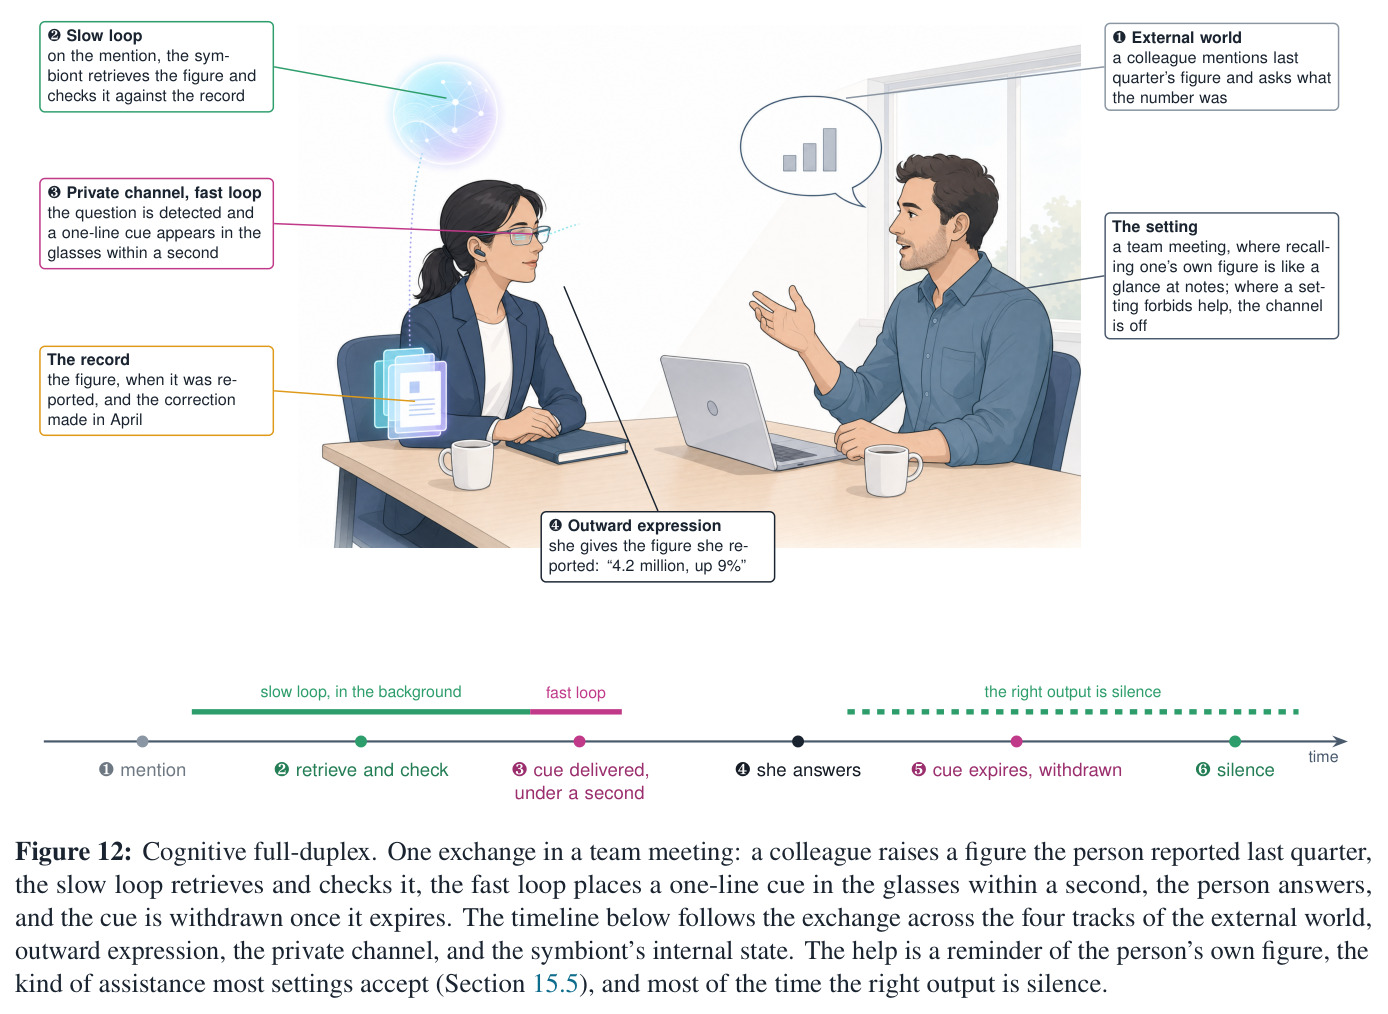
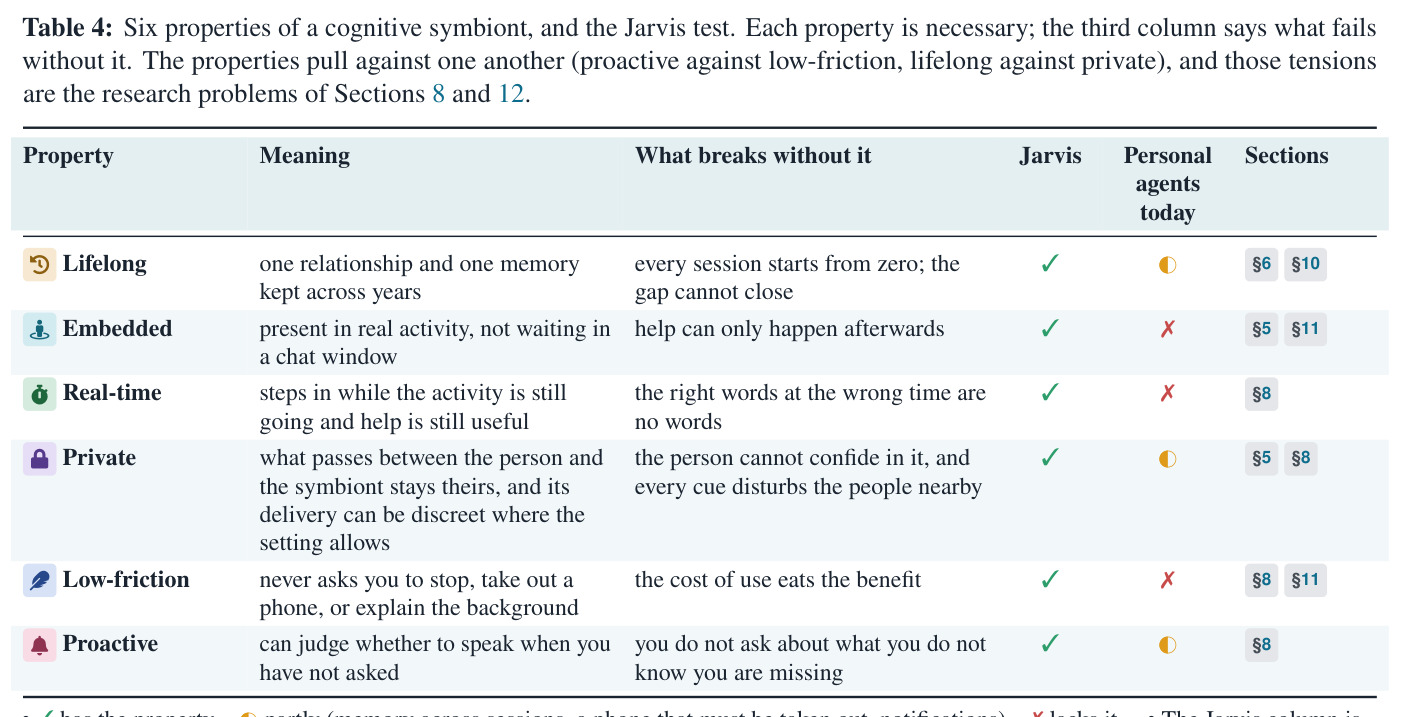
过去十年AI的进步几乎全部投向'机器能独自完成多少'这一条轴:基础模型会写代码、起草文档、执行多步任务,2026年的Muse、Dots、Grok Bot等个人智能体已能长期跟踪目标、在云端后台运行。但普通人的一天仍充满同样的损失:清晨独自工作时一闪而过的想法没写下就消失;下午会上同事问起自己三年前报告的数字(论文例:'420万,增长9%')却想不起来;晚上面临决策时记不起上次类似抉择的推理;在国外不懂如何礼貌地拒绝邀请;受挫后想要的'懂你的一句话'只换来一段泛泛安慰。前三类是获取失败——自己拥有的东西到不了需要的时刻;后两类是独自无法弥补的缺口;没有一类是'智能不够'。症结在耦合:AI对'这个人'的了解、介入速度、打扰程度与被信任程度几乎没有进步。三个可观察症状——每次对话重新解释背景、帮助太晚或太吵、不敢托付要事——分别指向§6、§8、§12。论文以图3(a)画出'模型能力上升、耦合近乎持平'的剪刀差,阴影即从未兑现的增强。滥用已先行:2025年Cluely等作弊工具公开售卖,高考期间各厂商一度关闭功能;Humane AI Pin一年内停产则说明专用设备必须给出手机给不了的东西。
本文的目标是论文要为'另一半终局'立范式。作者主张Physical AI时代存在两类同等重要的智能个体——具身机器人与被AI增强的人;与AGI(问'机器能有多聪明')并列,应确立AI增强人类智能AHI(问'机器能让一个具体的人强多少')。为实现AHI,论文给出认知共生体的完整定义:一个终身、嵌入、实时、私密、低摩擦、主动的系统,借人的感官感知、保存其一生情境与知识、建模其处境与心智、在恰当时刻以恰当形式参与思考、带着上下文代办事务、并随双方变化持续学习,且最终判断与目标始终留在人手里。交付物包括:概念内核(自上下文与认知差距不变量)、六性质与Jarvis测试、组织设计空间的共生回路与个人运行时、九条设计原则;把增强的风险与治理作为范式组成部分(私密内容与可声明状态分离、场景政策、可验证弃权);把评估单位从AI换成'增强个体'并给出可计算量与证伪条件;整理23个开放问题与6阶段能力路线图。作者明确声明不提出新算法,贡献是框架本身、设计空间的组织与证据标准的确立。
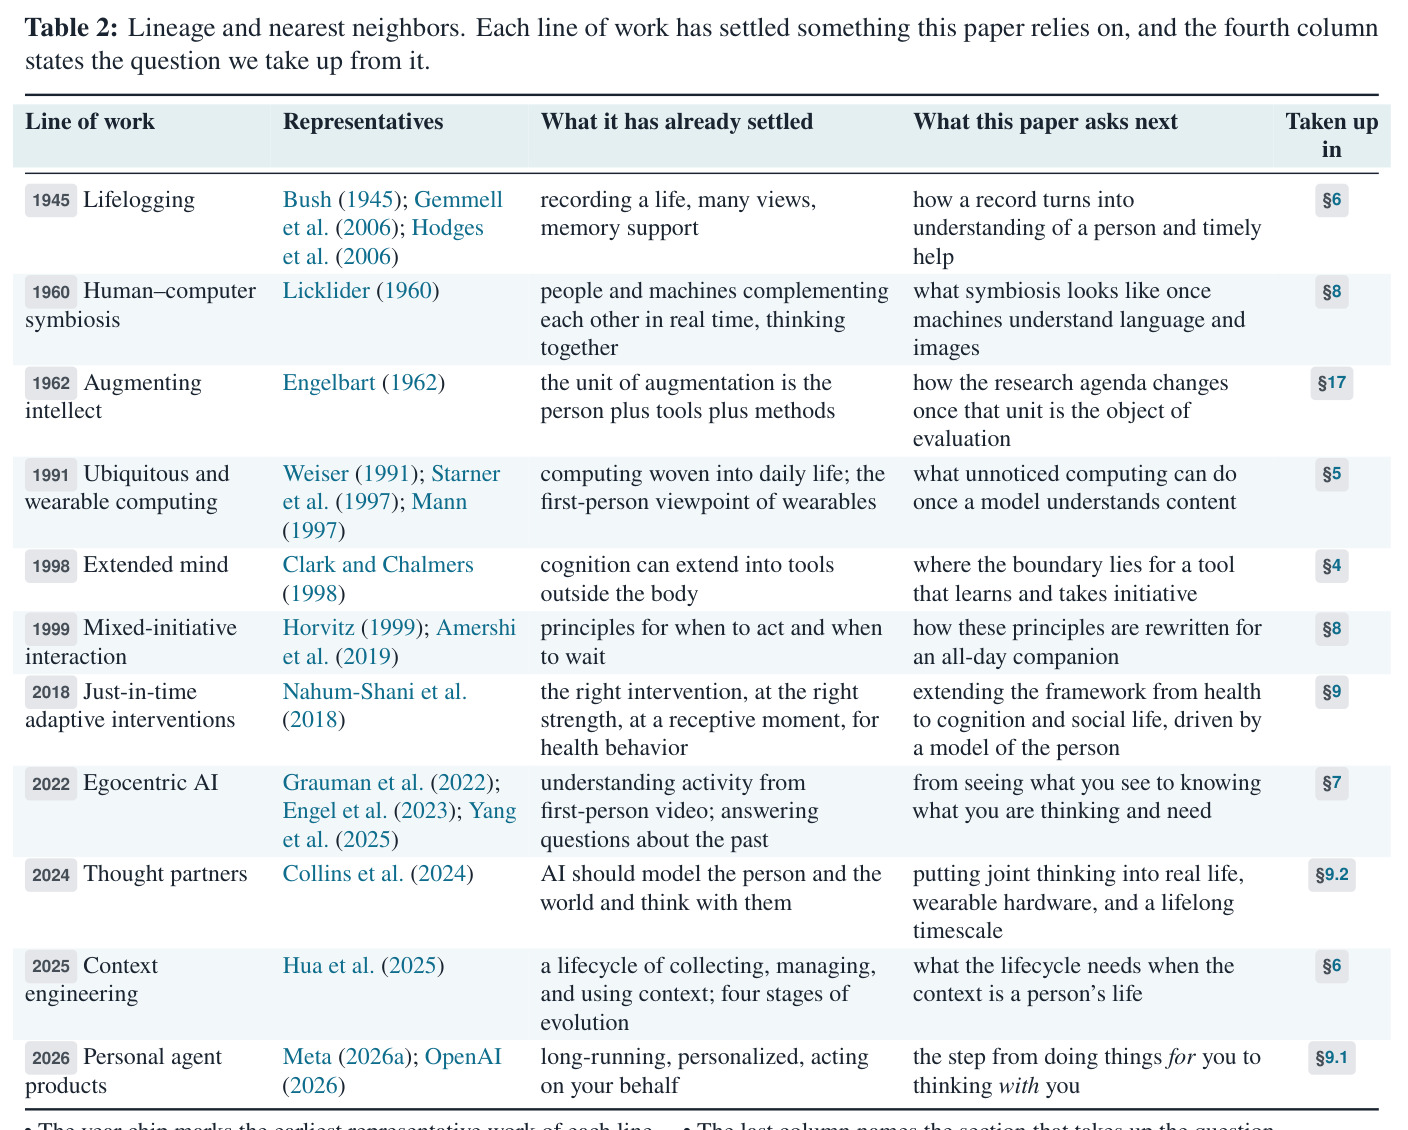
与已有工作不同的是,用机器增强人类智识是80年的老问题,而已有研究没有任何一条把'跨越一生、针对特定个人'当作目标——这是本文的切入点。表2梳理谱系:1945年Memex开创lifelogging、1960年Licklider的人机共生、1962年Engelbart把增强单位定为'人+工具+方法'、1991年Weiser的普适计算与首批可穿戴、1998年Clark与Chalmers的延展心智、1999年混合主动交互、2018年移动健康的及时自适应干预、2022年第一人称egocentric AI、2024年Collins等的'思想伙伴'、2025年上下文工程2.0、2026年个人智能体产品——各自解决了记录、实时互补、介入时机、第一人称理解等片段,留下的都是零件而非整体。本文的独特处有四:其一,把评估对象换成'人$\oplus$共生体'组合并形式化为增益$\Delta_{aug}$(式2);其二,提出认知差距$G_t$作不变量,把目标从'机器更像人'改为'缩小差距';其三,自述与观察两路证据并存且推理永不推翻本人陈述,而现有个性化只走观察路;其四,把作弊、胁迫佩戴等治理问题内建于设计(可声明状态、场景政策、可验证弃权),并以8条证伪条件自设证据标准——这在立场论文中是少见的自我约束。
核心方法
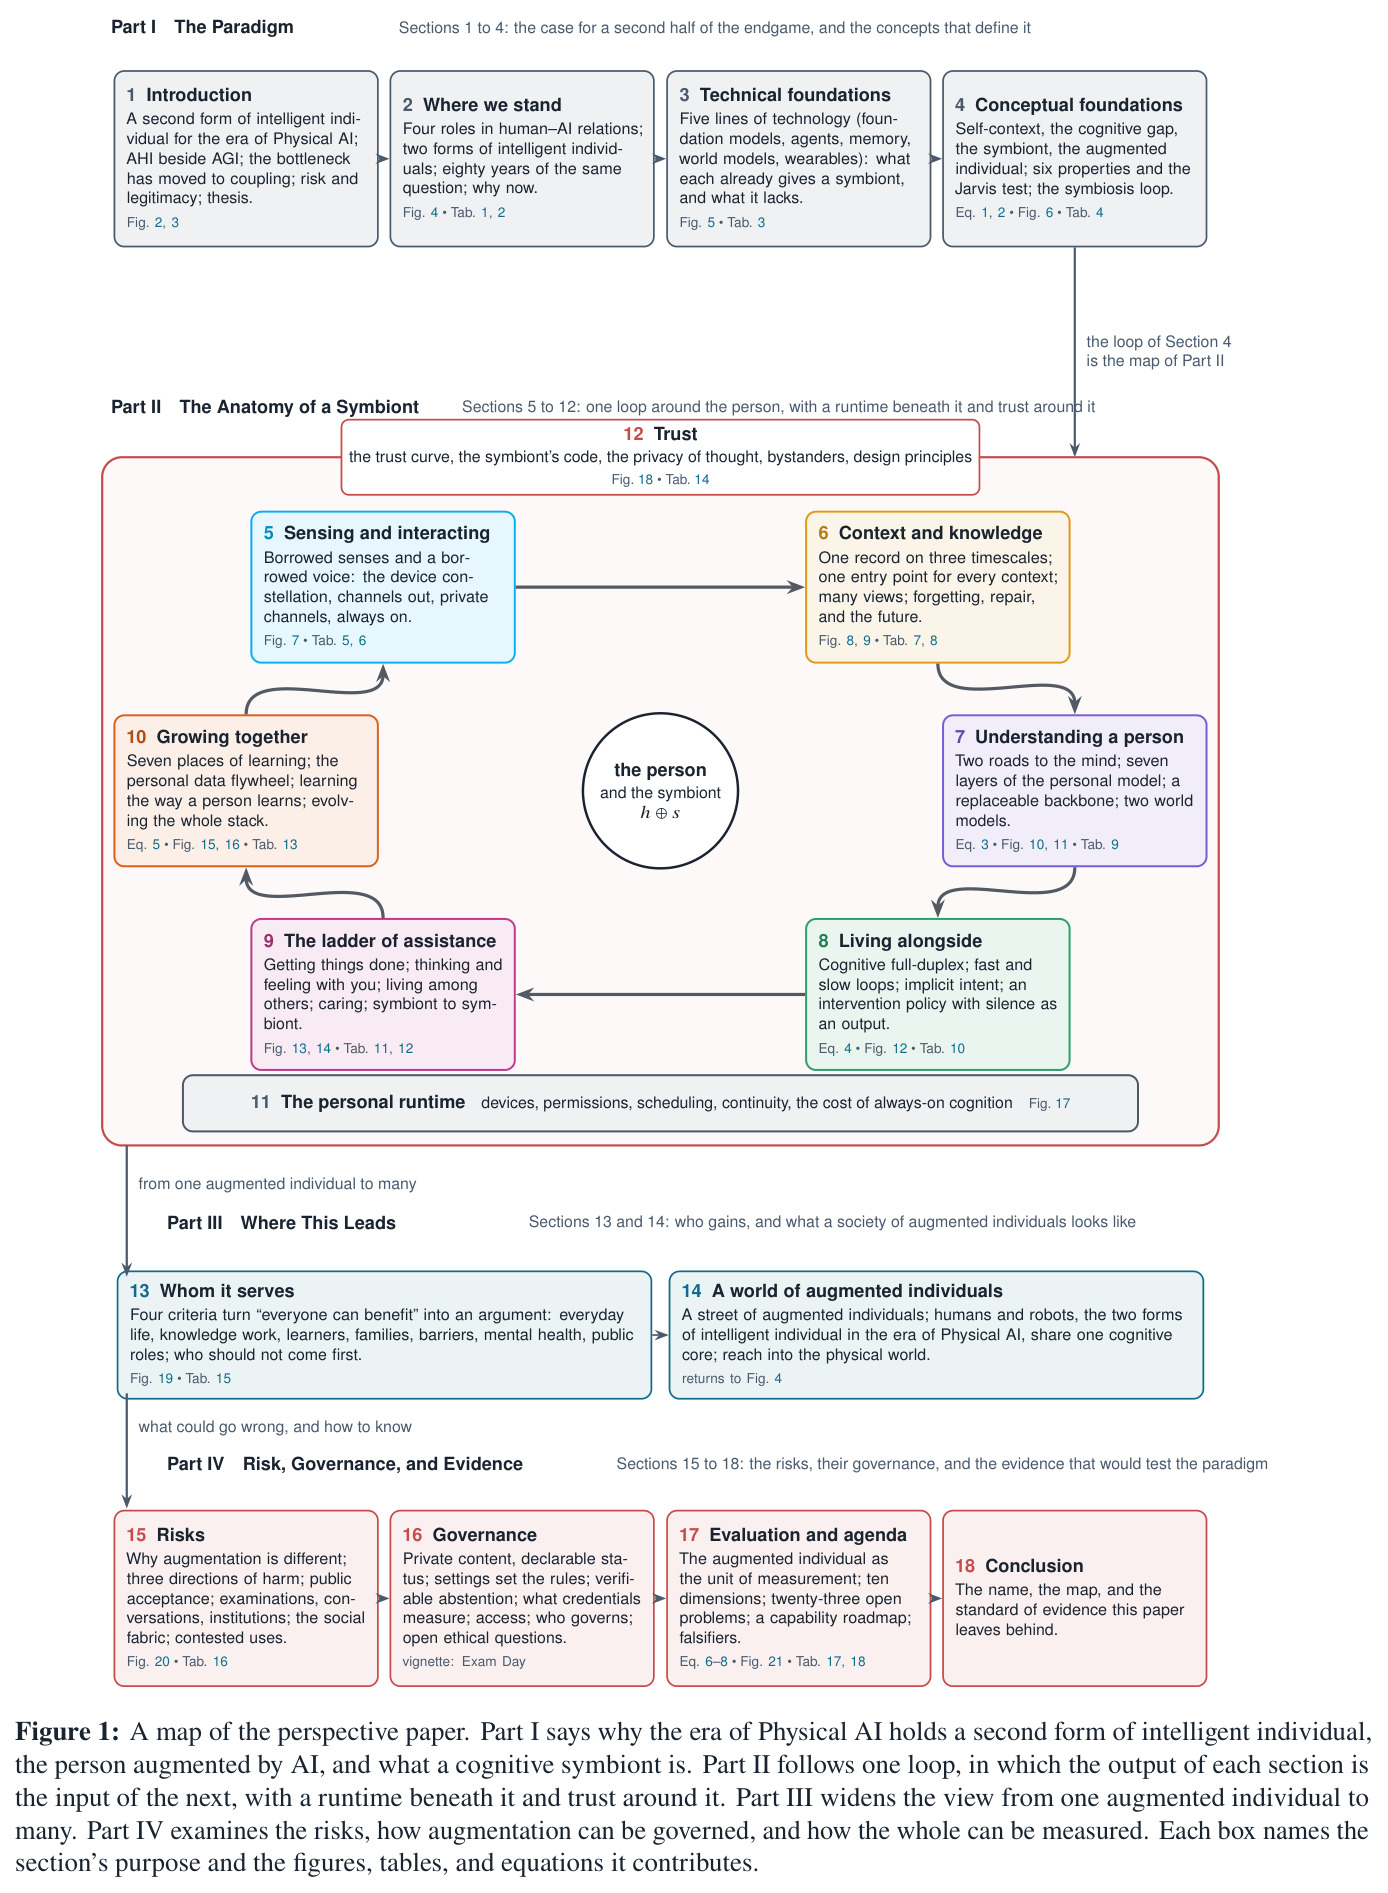
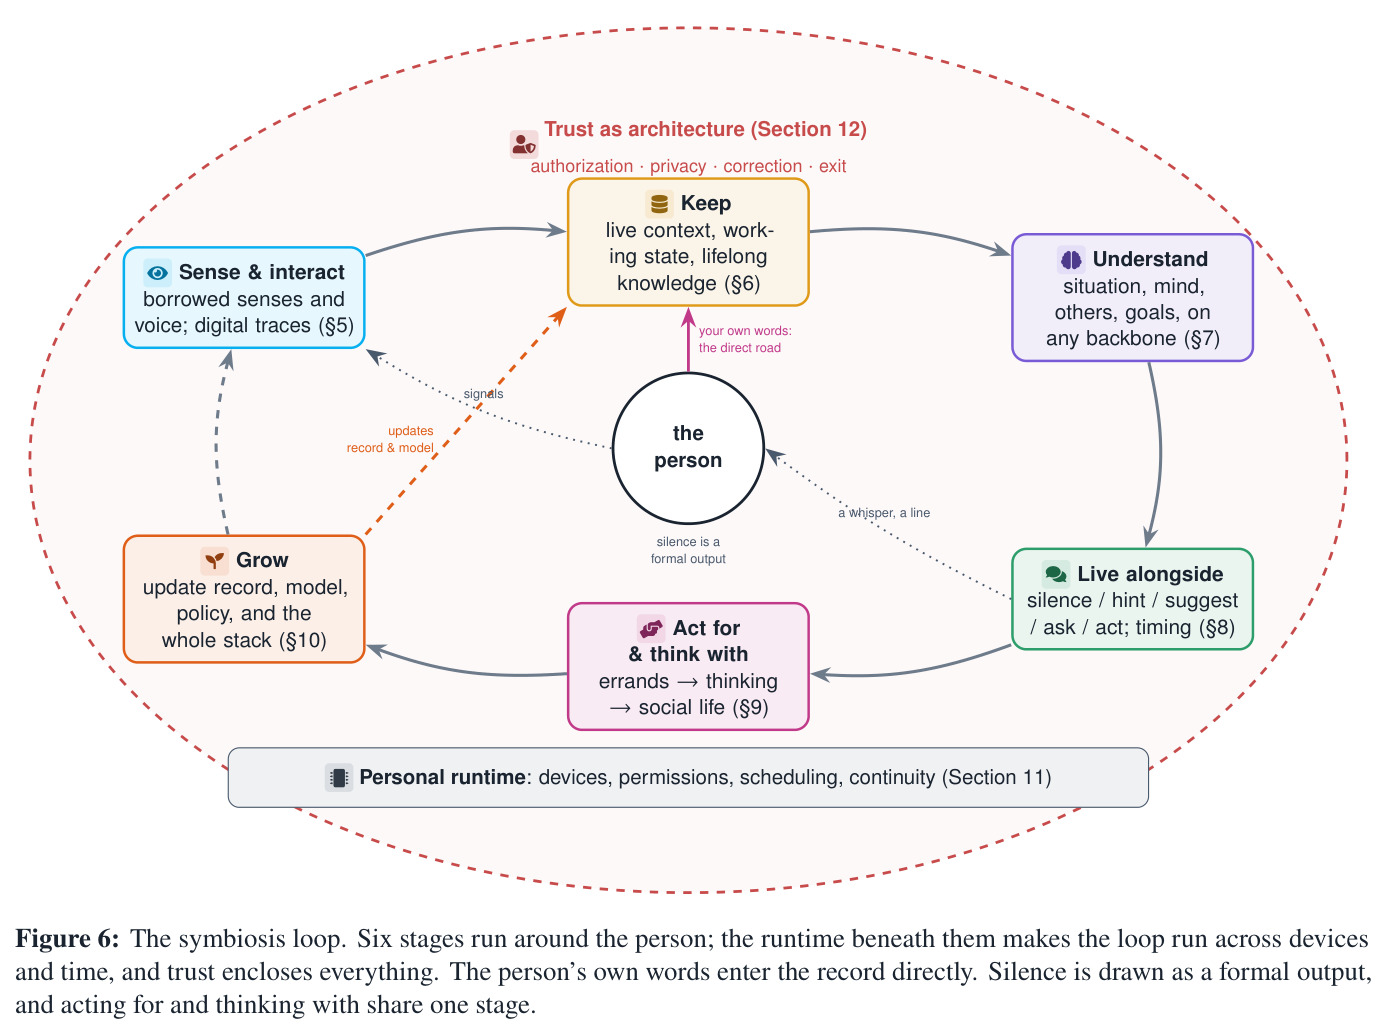
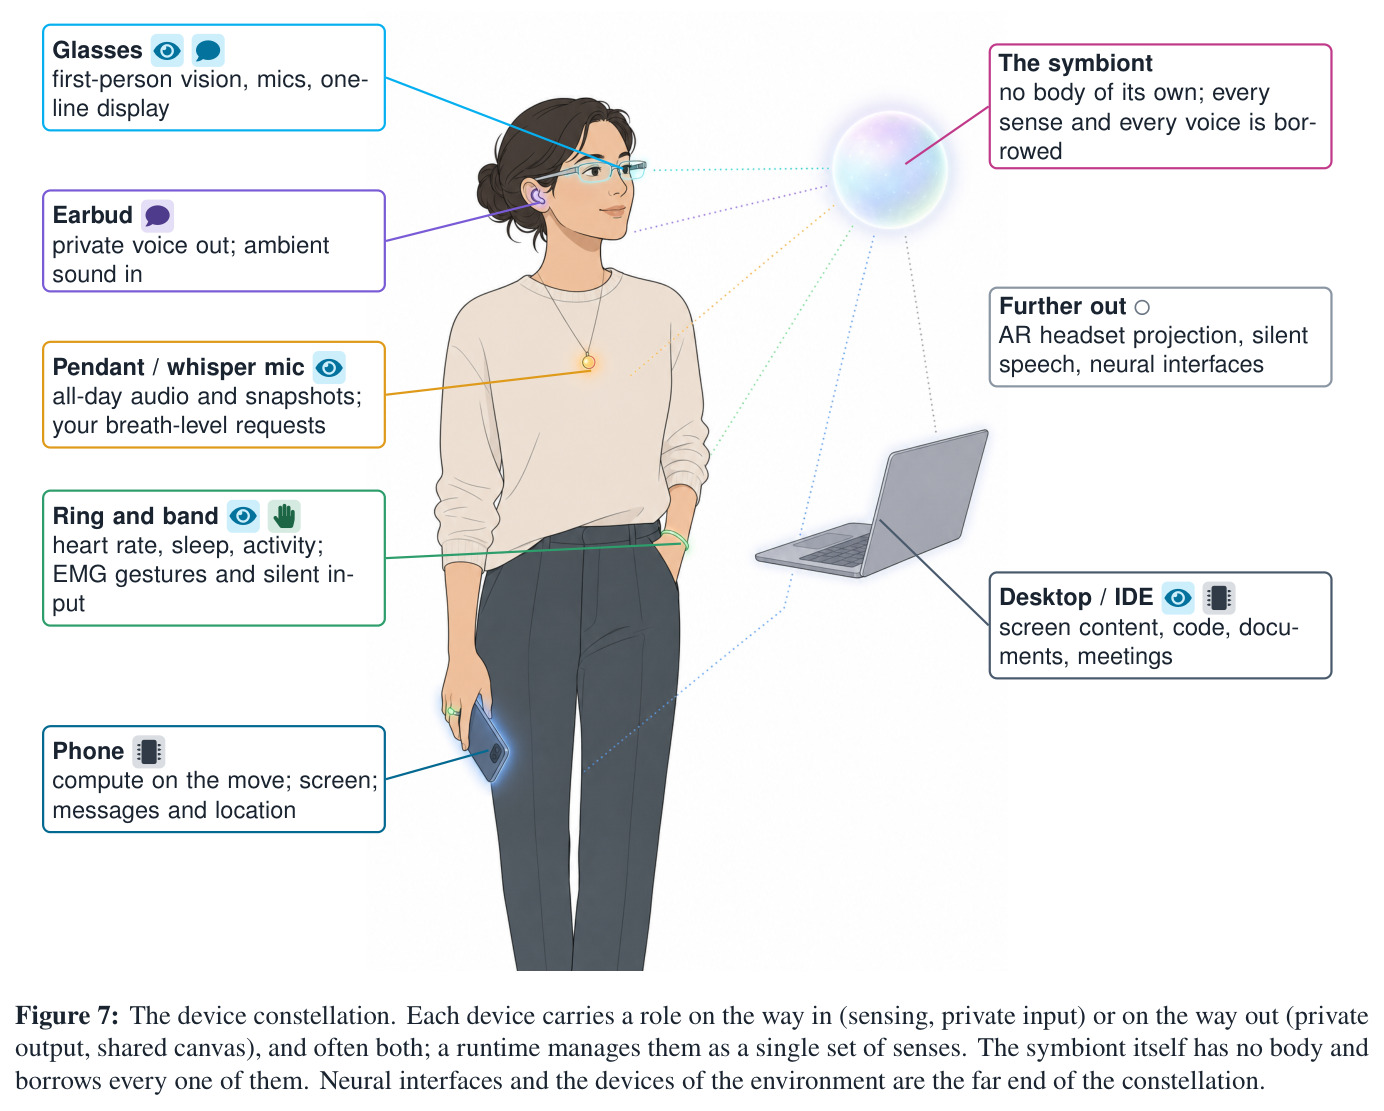
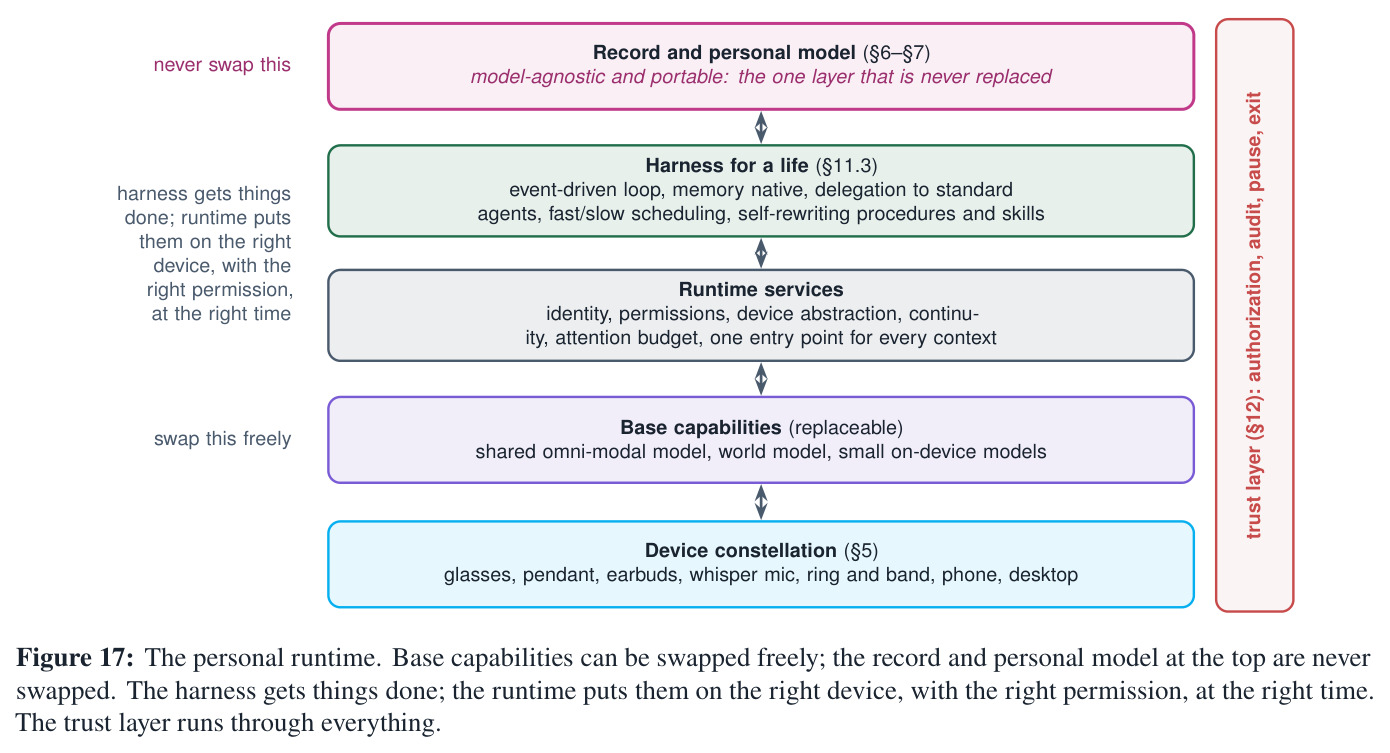
直觉上,共生体是'每个人的Jarvis再走六步':它没有身体,借用眼镜、吊坠、手环等戴在你身上的设备看你所看、听你所听,再借耳机与镜片只说给你一个人听。技术路线分两层。地基是五条已存在的技术线(图5、表3):基础模型当大脑(全模态实时输入输出、百万token上下文),智能体与harness当双手(规划、工具、电脑操作、长任务),记忆与上下文工程管跨会话保存,世界模型管对环境与人的预测,可穿戴硬件供感官与私密输出——每条线都强,但都只服务于任务而非'这一个人的增强'。论文在此之上提出共生层:六段共生回路(图6)——感知与交互→保存→理解→陪伴→代办与共思→成长,绕人一周、首尾相接,每段的输出是下一段的输入;回路之下是跨设备跨时间的个人运行时(图17),四周由作为架构的信任(图18)包裹。概念上以五个定义钉住:自上下文$C_h^t$分可观察$O_{\le t}$、自述$R_{\le t}$、推断$K_t$三部分;任一时刻人真正调用的只有小子集$c_t$;认知差距$G_t=U(x_t;C_h^t)-U(x_t;c_t)$(式1)是全文不变量;共生体的一切行为都以缩小$G_t$为目标;成功与否由增强个体$h\oplus s$的增益$\Delta_{aug}(x_t)=U(x_t;h\oplus s)-U(x_t;h)$(式2)度量。
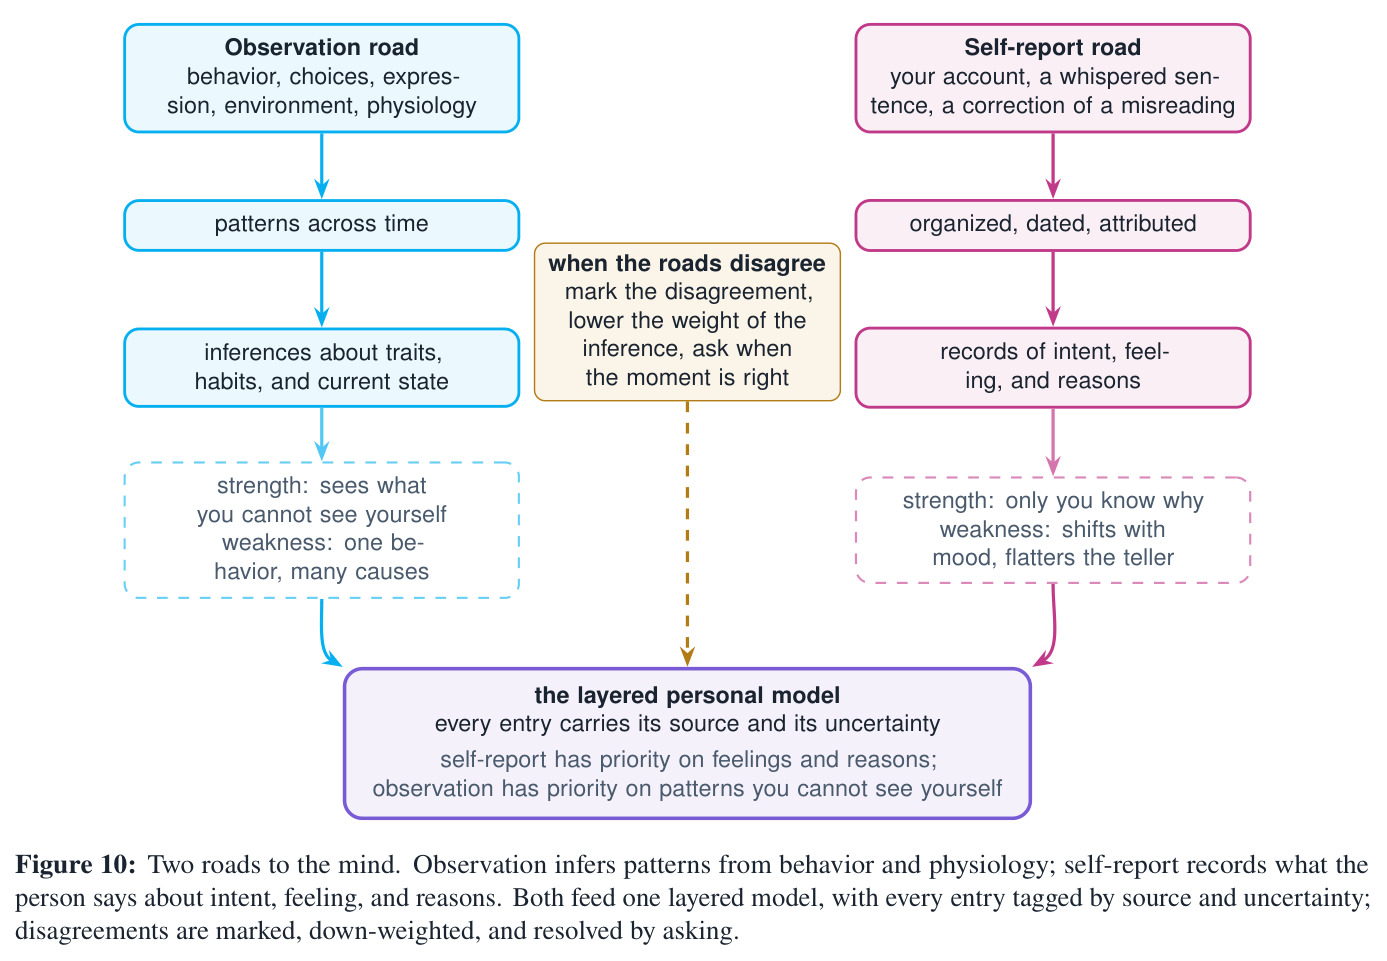
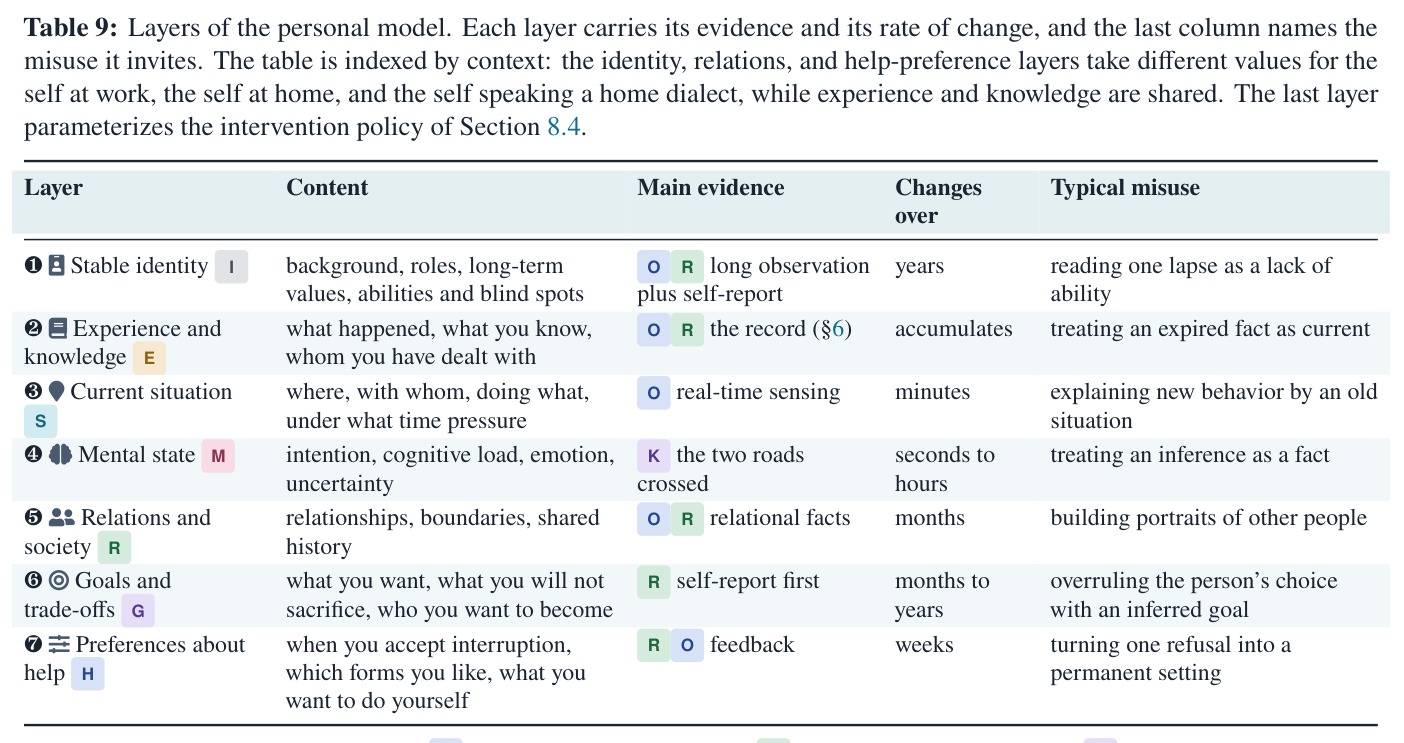
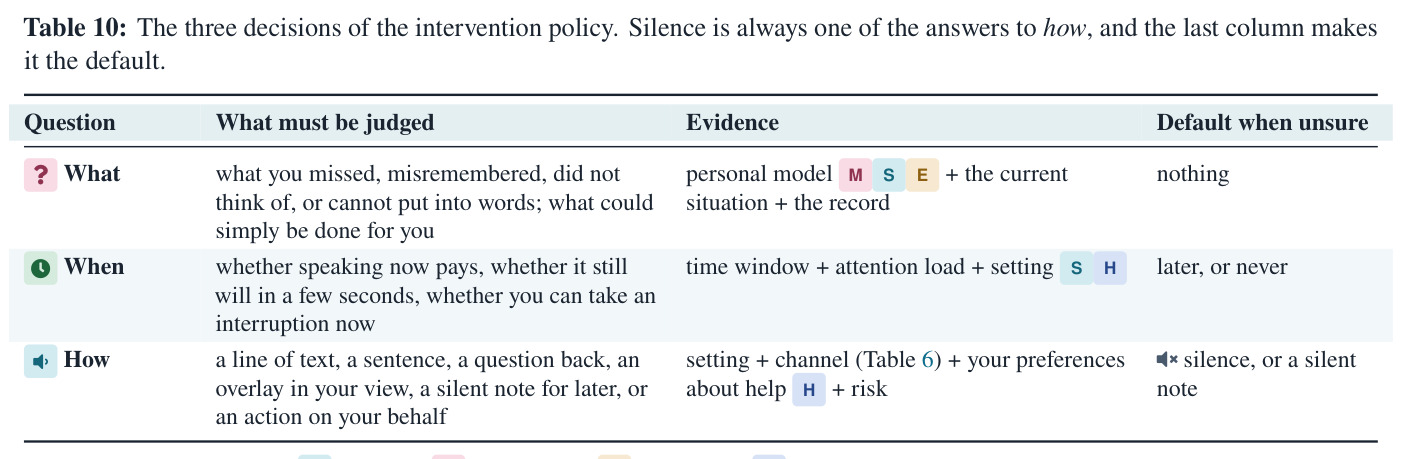
核心创新是换掉'进步的度量对象'。AGI研究问$U(\cdot;s)$——机器单独能达成什么;AHI问$U(\cdot;h\oplus s)$——人被赋能后能达成什么。由此推出三个本质区别。第一,'沉默是形式化输出':干预策略$\arg\max_{a}\ \mathbb{E}[\Delta U|b_t]-\lambda_t\cdot\mathrm{Interrupt}-\rho\cdot\mathrm{Risk}$(式4)的动作集合永远包含沉默,置信阈值$\theta(a)$随介入强度上升,代办事务门槛最高——这与现有'请求-响应'范式根本不同:不作为也是一种被优化的决策。第二,通向心智的两条路:行为观察与本人自述分开存储、分歧时标记并降权、绝不以推理推翻本人——现有个性化系统只走观察路,而Park等2024年的千人级结果说明自述通道信息密度极高。第三,'关系持久、权重可换':记录与个人模型定义在信息层面、与基座解耦,换模型如同换引擎,直接回答了'共生体是否需要私有模型'的争论——属于个人的是一生的记录与模型,而不是权重。与延展心智留下的开放边界相对,论文以定义4.4第(vi)条收束:共生体扩展人能带到情境中的东西,最终判断与目标始终留在人手里。
方法步骤详情
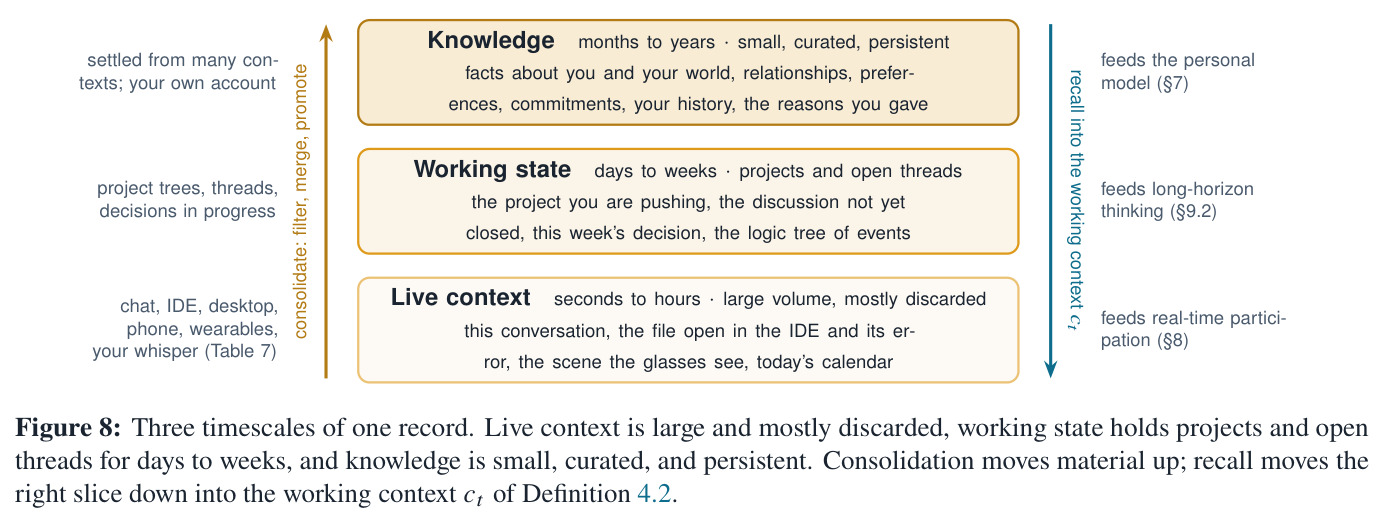
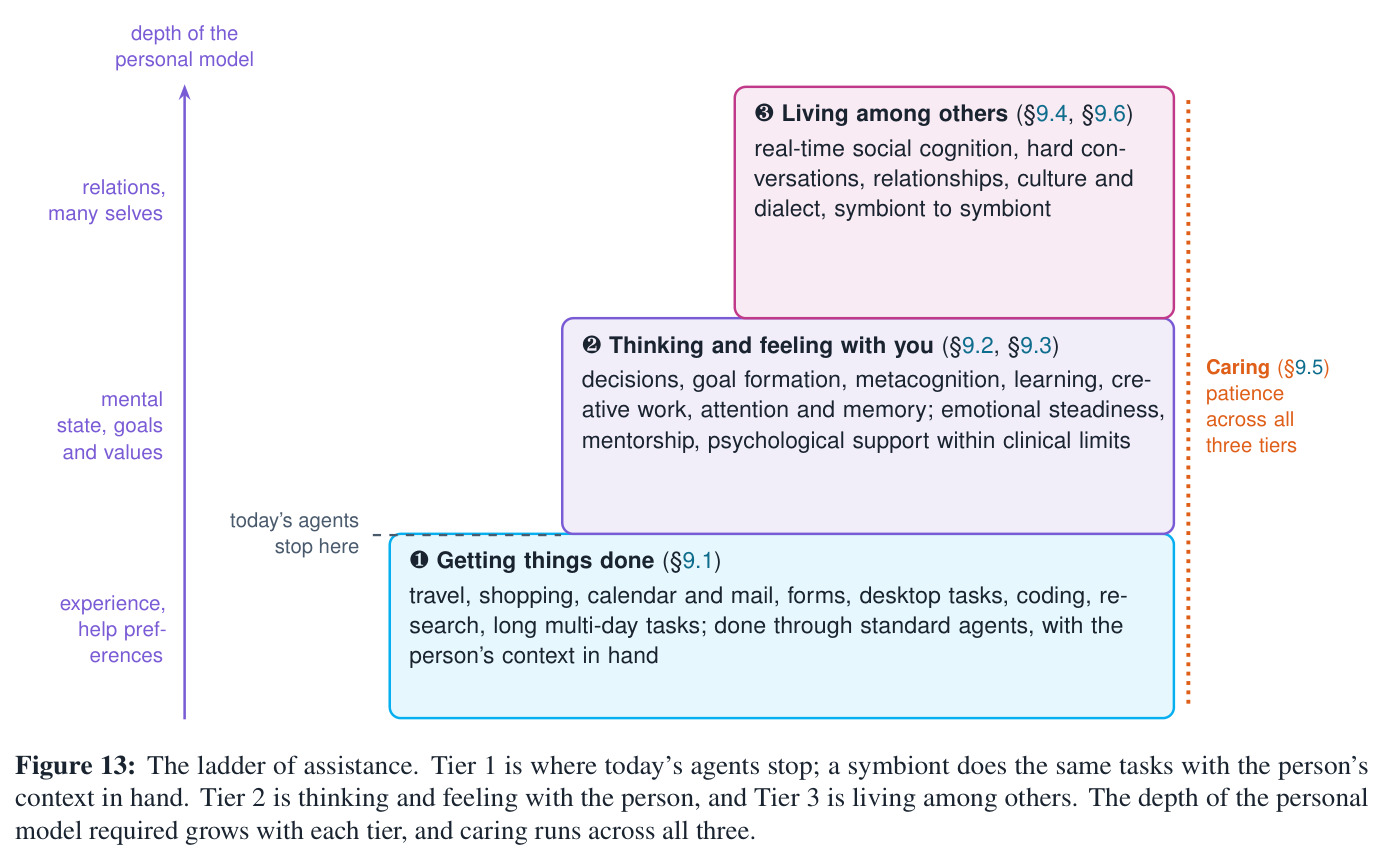
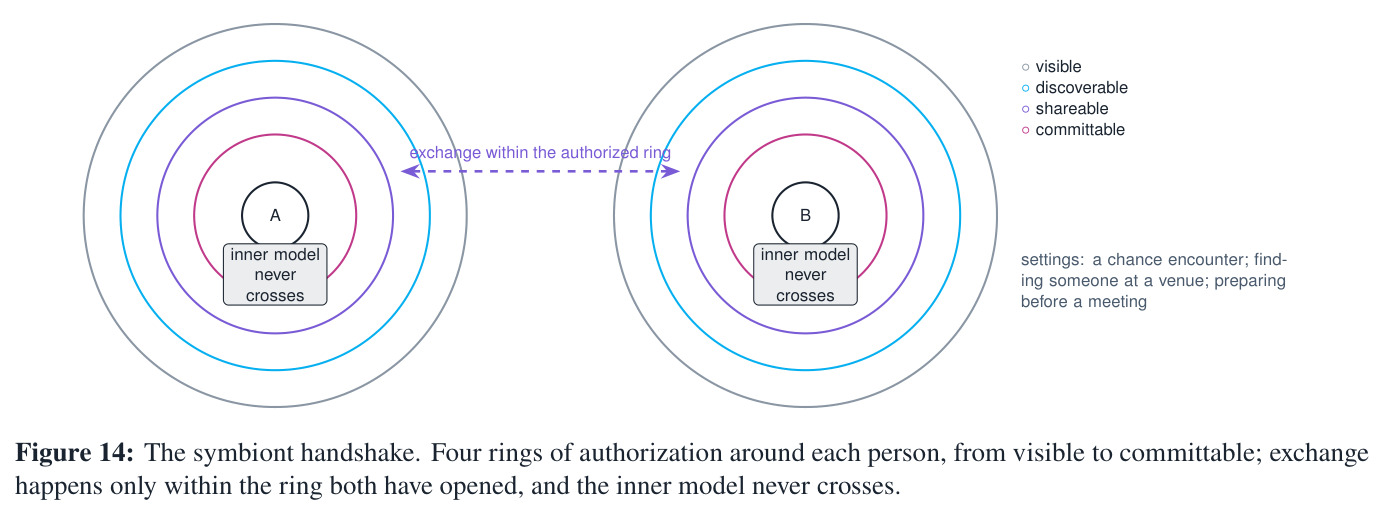
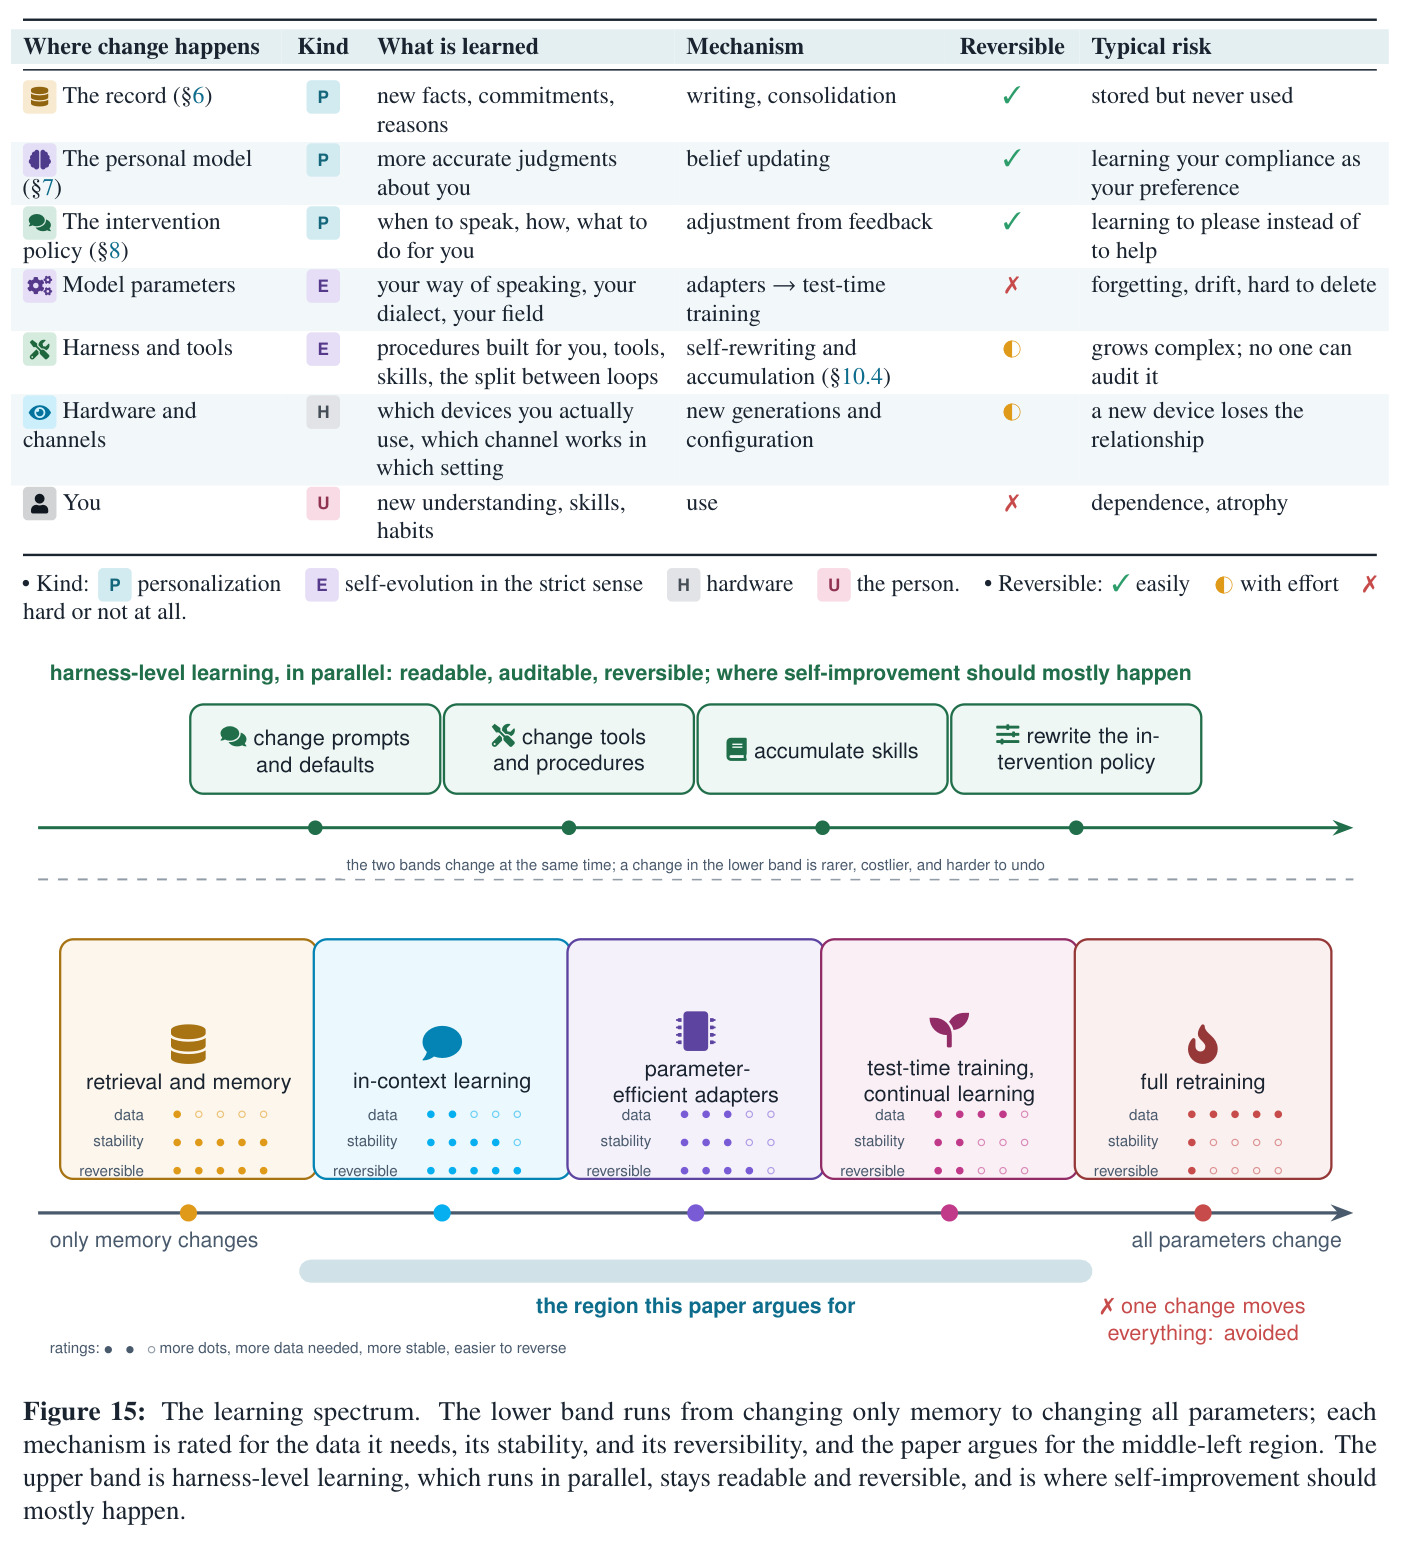
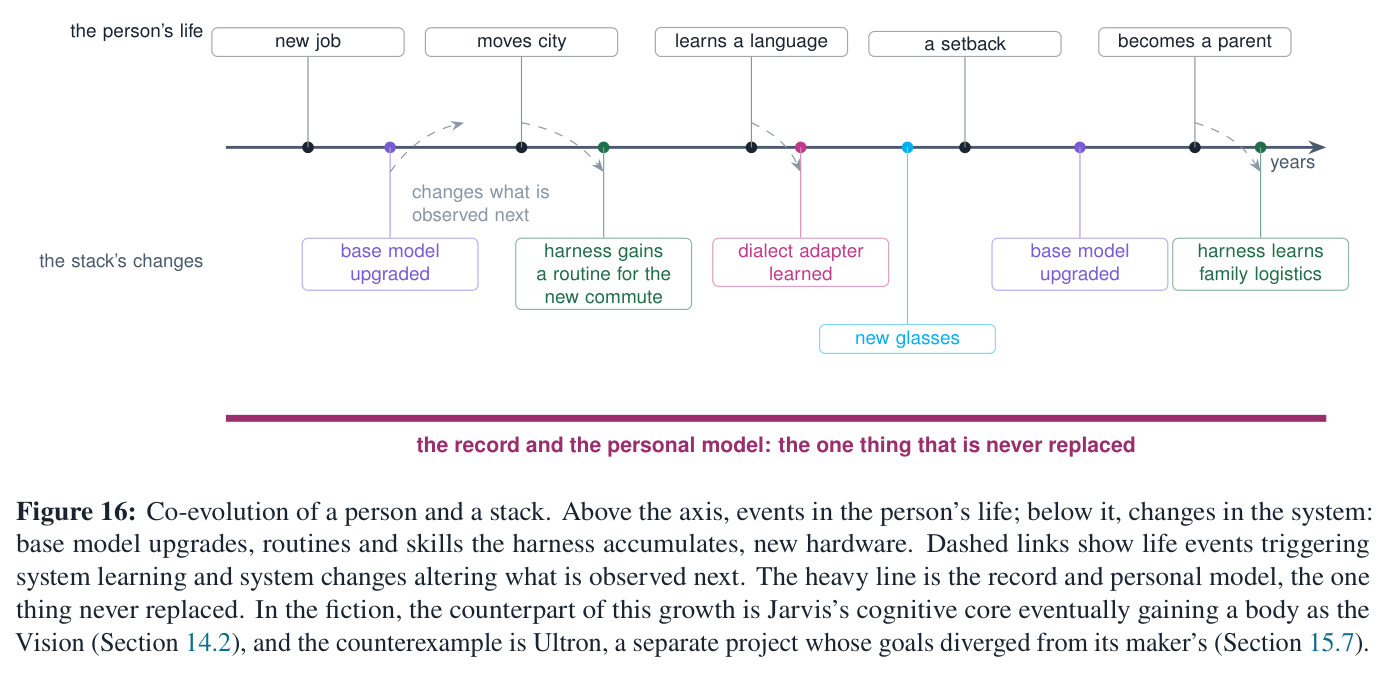
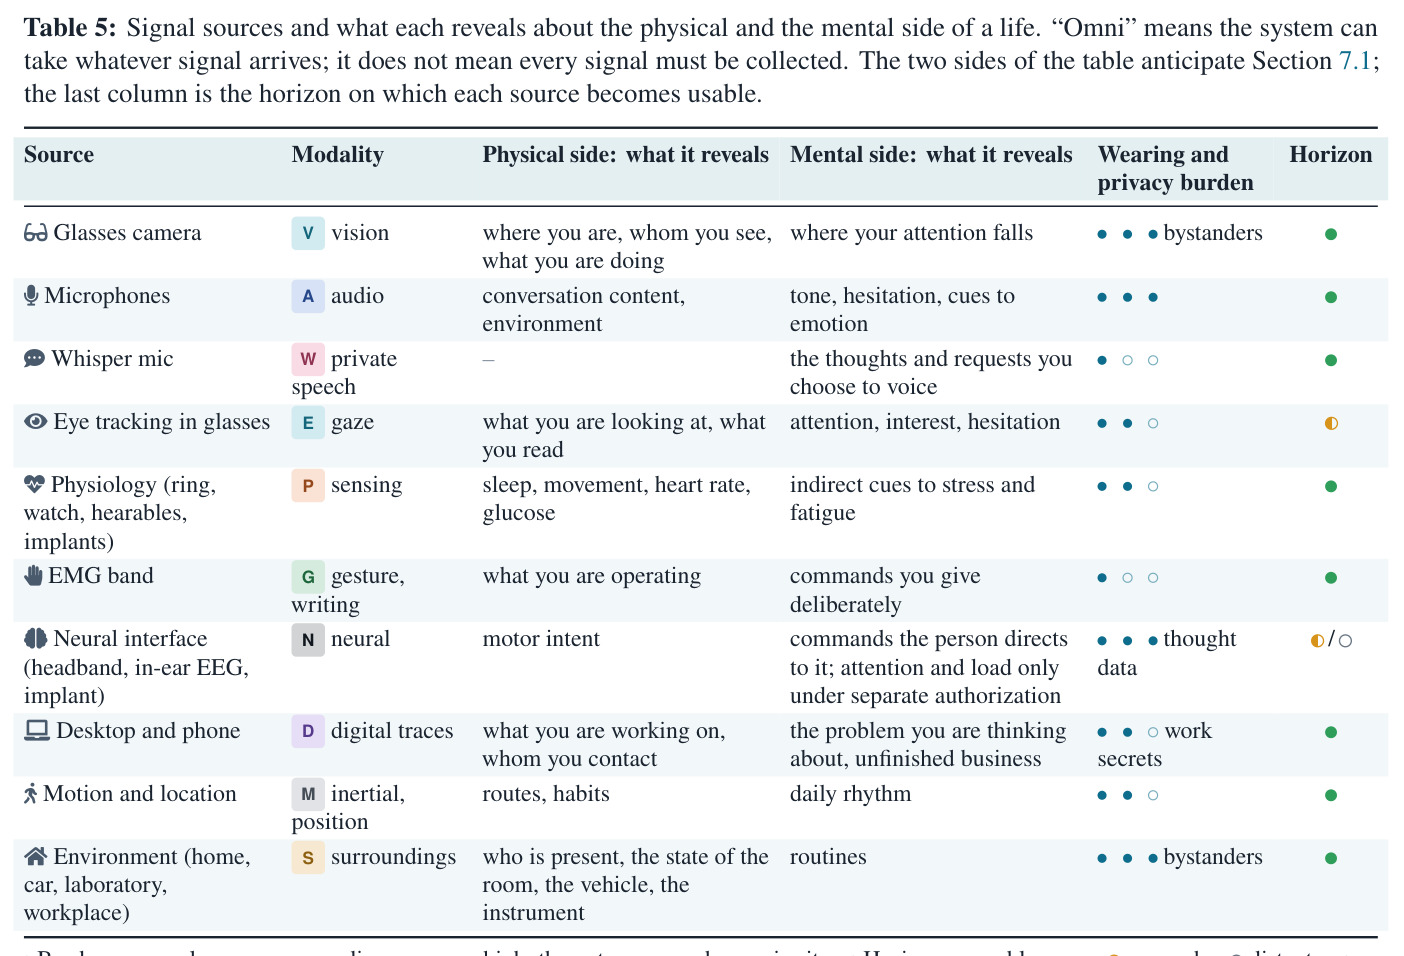
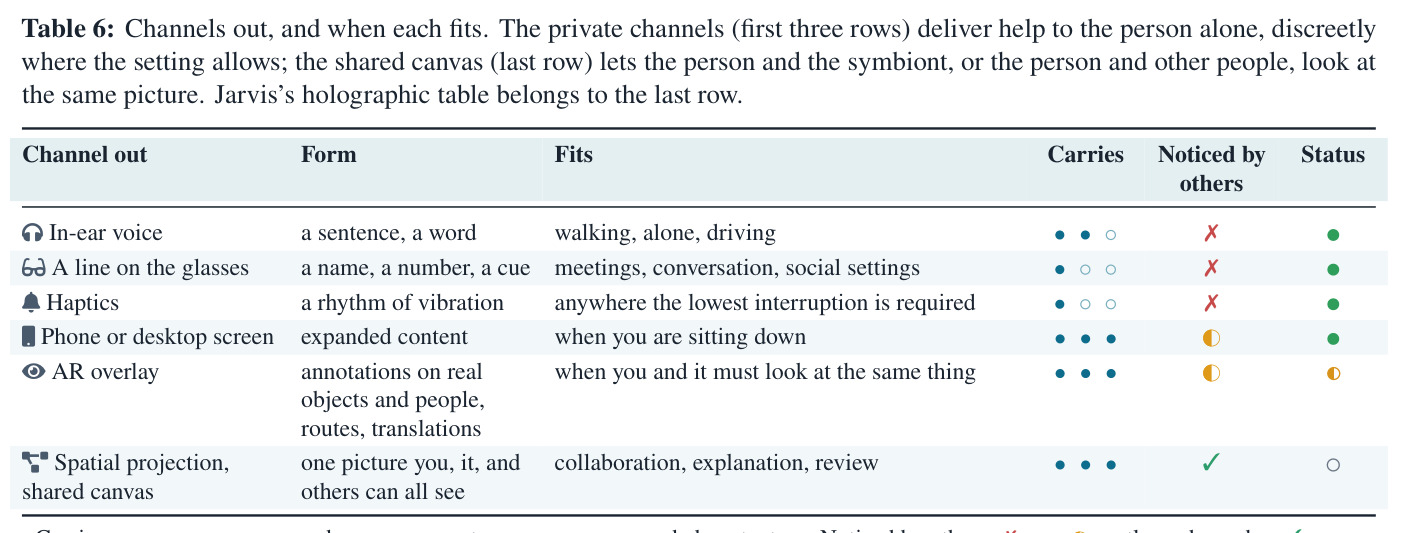
方法沿共生回路(图6)一圈完成。①感知(§5):设备星座(眼镜、吊坠、气声麦、耳机、心率/EMG手环、手机、授权桌面);'全天在线'靠认知占空比——平时仅轻量事件检测,事件唤醒重模型,夜间离线整合;输出按场景匹配强度。②保存(§6):一条记录三个时间尺度(秒至小时的活上下文、天至周的工作状态、月至年的知识),前端过滤→存储→'睡眠式'周期整合向上晋升,检索把正确切片放回$c_t$;并存prospective memory与理由,误读须定位层级并传播修正。③理解(§7):观察与自述两路汇入七层个人模型(表9),按语境索引容纳多重自我;信息接口与基座解耦,任何组合都须输出意图与情绪估计加置信度;物理与心理两个世界模型按式(3)刻画并自查过时。④陪伴(§8):认知全双工——快环一秒内把线索送进镜片,慢环提前备料;干预按式(4)在{沉默,暗示,建议,提问,代办}中选择,沉默不确定时为默认,并管理注意力预算。⑤代办与共思(§9):三层阶梯——经标准智能体代办并受五级行动权限约束;决策、元认知、提示式辅导、临床边界内的情绪支持;社交认知、艰难对话、语言文化与四环握手。⑥成长(§10):七个学习位置,数据飞轮配回声刹车$M_{t+1}=\mathcal{U}(M_t;o_{t+1},r_{t+1},a_t)$与持续验证;方言阶梯(记住→组句→适应→迁移);换基座或硬件须可移植、可审计、可回滚。运行时(§11)供身份、权限、连续性,信任(§12)以授权曲线与守则环绕全部。
技术新颖性
新颖性不在算法而在范式组装,可核对的具体新东西有:以认知差距$G_t$作为个人AI的不变量,把'比你自己更懂你'限定为三个可辩护含义(同时持有全部自上下文、看到本人身处其中看不见的跨年模式、记得本人已忘的理由),并公开放弃读心;把沉默写进动作空间并给出带注意力预算的干预代价公式(式4);把'自述通道'提升为一等证据(气声麦克风),纠正现有个性化只从行为反推的偏差;提出语境索引的多重自我模型,借用文化框架转换研究(双文化个体的语言-人格切换)处理'工作时的我/说家乡话的我';提出回声安全学习规则(式5)——更新必须以系统自身动作为条件,防止'系统影响了人又把结果读成本来面貌';提出信息级接口使记录与个人模型跨基座可移植('换Jarvis不丢关系',电影里的失败案例正是换了系统关系归零);提出四环授权(可见/可发现/可分享/可承诺)的共生体握手问题与'可验证弃权'治理机制(防篡改日志+硬件证明+密码学证明的组合);最后把评估换成增强增益、协同增益、保持量与个性化差分四个量(式2、6、7、8),并给出8条证伪条件。作者还诚实地列出'不主张'清单(§4.4),这与许多过度承诺的愿景论文形成对照。
实验结果
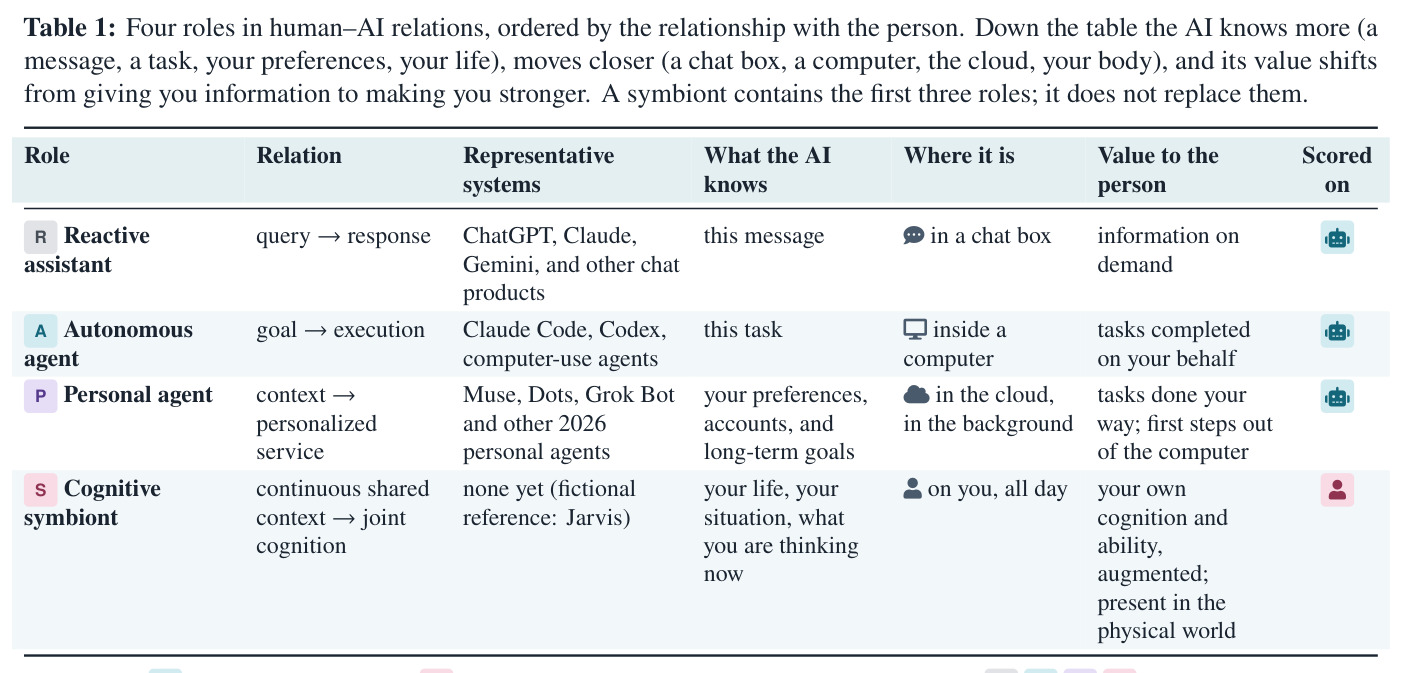
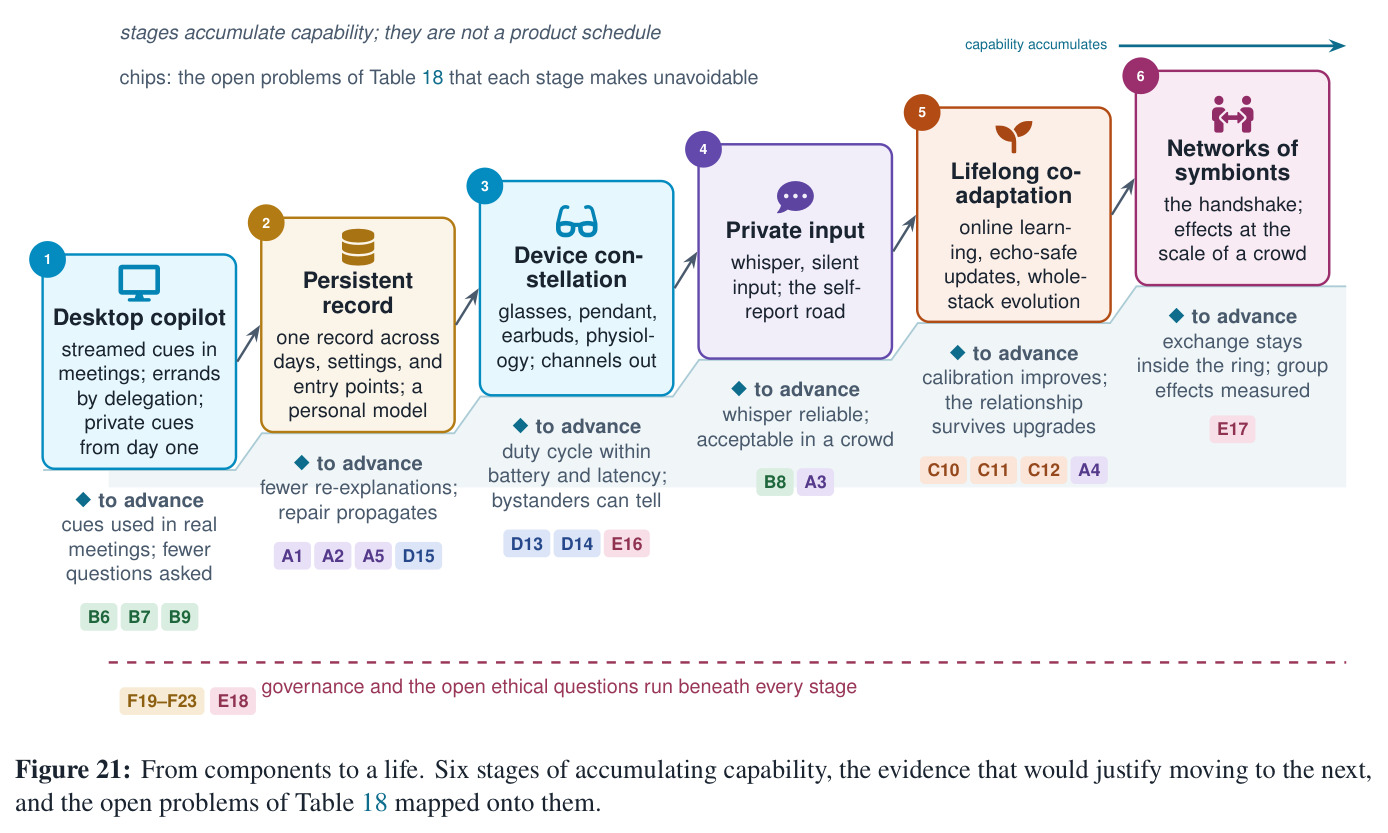
这是立场论文,成果是范式框架与证据综合而非自做实验。框架侧:四角色定位(表1)、五条技术线的缺口地图(表3)、六性质与Jarvis测试(表4)、六段共生回路(图6)、九条设计原则(表14)、27行功能目录(表12);评估框架给出四个可计算量——增强增益(式2)、协同增益(式6)、保持量(式7)、个性化差分(式8)——及十个评估维度(表17)、六阶段路线图(图21)与23个开放问题(表18,四个标星:生命记录规模化建模、端到端低延迟、全天认知成本、可穿戴硬件迭代)。证据侧关键数字:Park等2024年从2小时访谈为1,052名真人构建生成式智能体,复现本人调查答案的程度与本人两周后重测相当——个人级预测模型可由少量第一人称叙述建立的最强证据;Chan等2024年发现LLM访谈机器人诱导的虚假记忆超对照3倍多;Salvi等2025年发现掌握少量对手信息的LLM在受控辩论中比人更有说服力;Vaccaro等2024年元分析显示人机组合常劣于两者中更强者;Pew 2022年逾万名美国成人调查中多数人视认知脑植入为社会坏事、约六成人预期普及后被迫跟进;Bastani等2025年发现无护栏生成式AI损害高中生数学学习;IEA预计2030年数据中心电力约翻倍。论文还给出8条证伪条件(§17.6),如个性化差分为零、及时干预不优于按需应答、长期使用普遍侵蚀想保留的能力等。
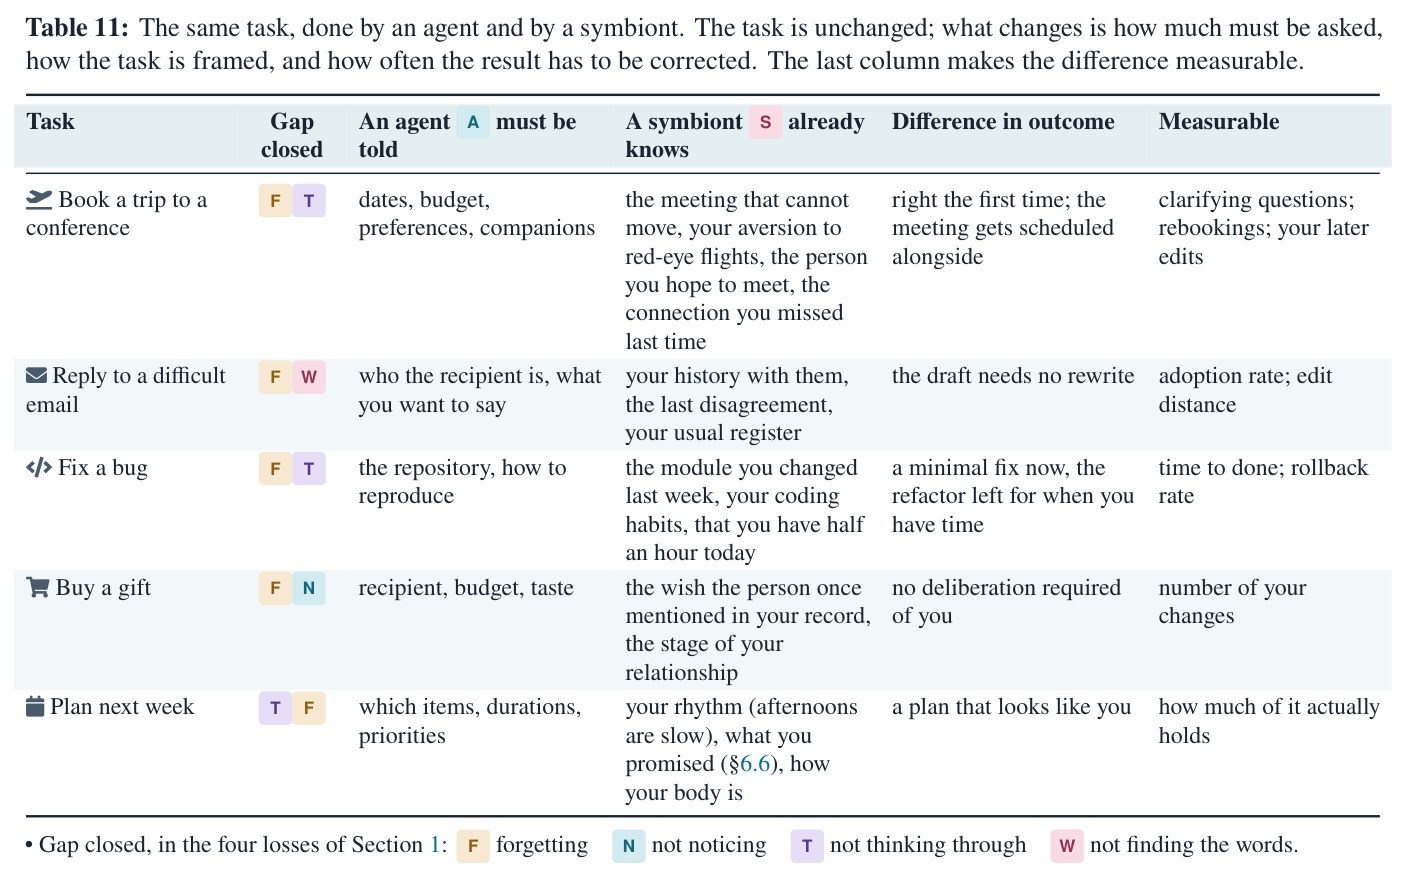
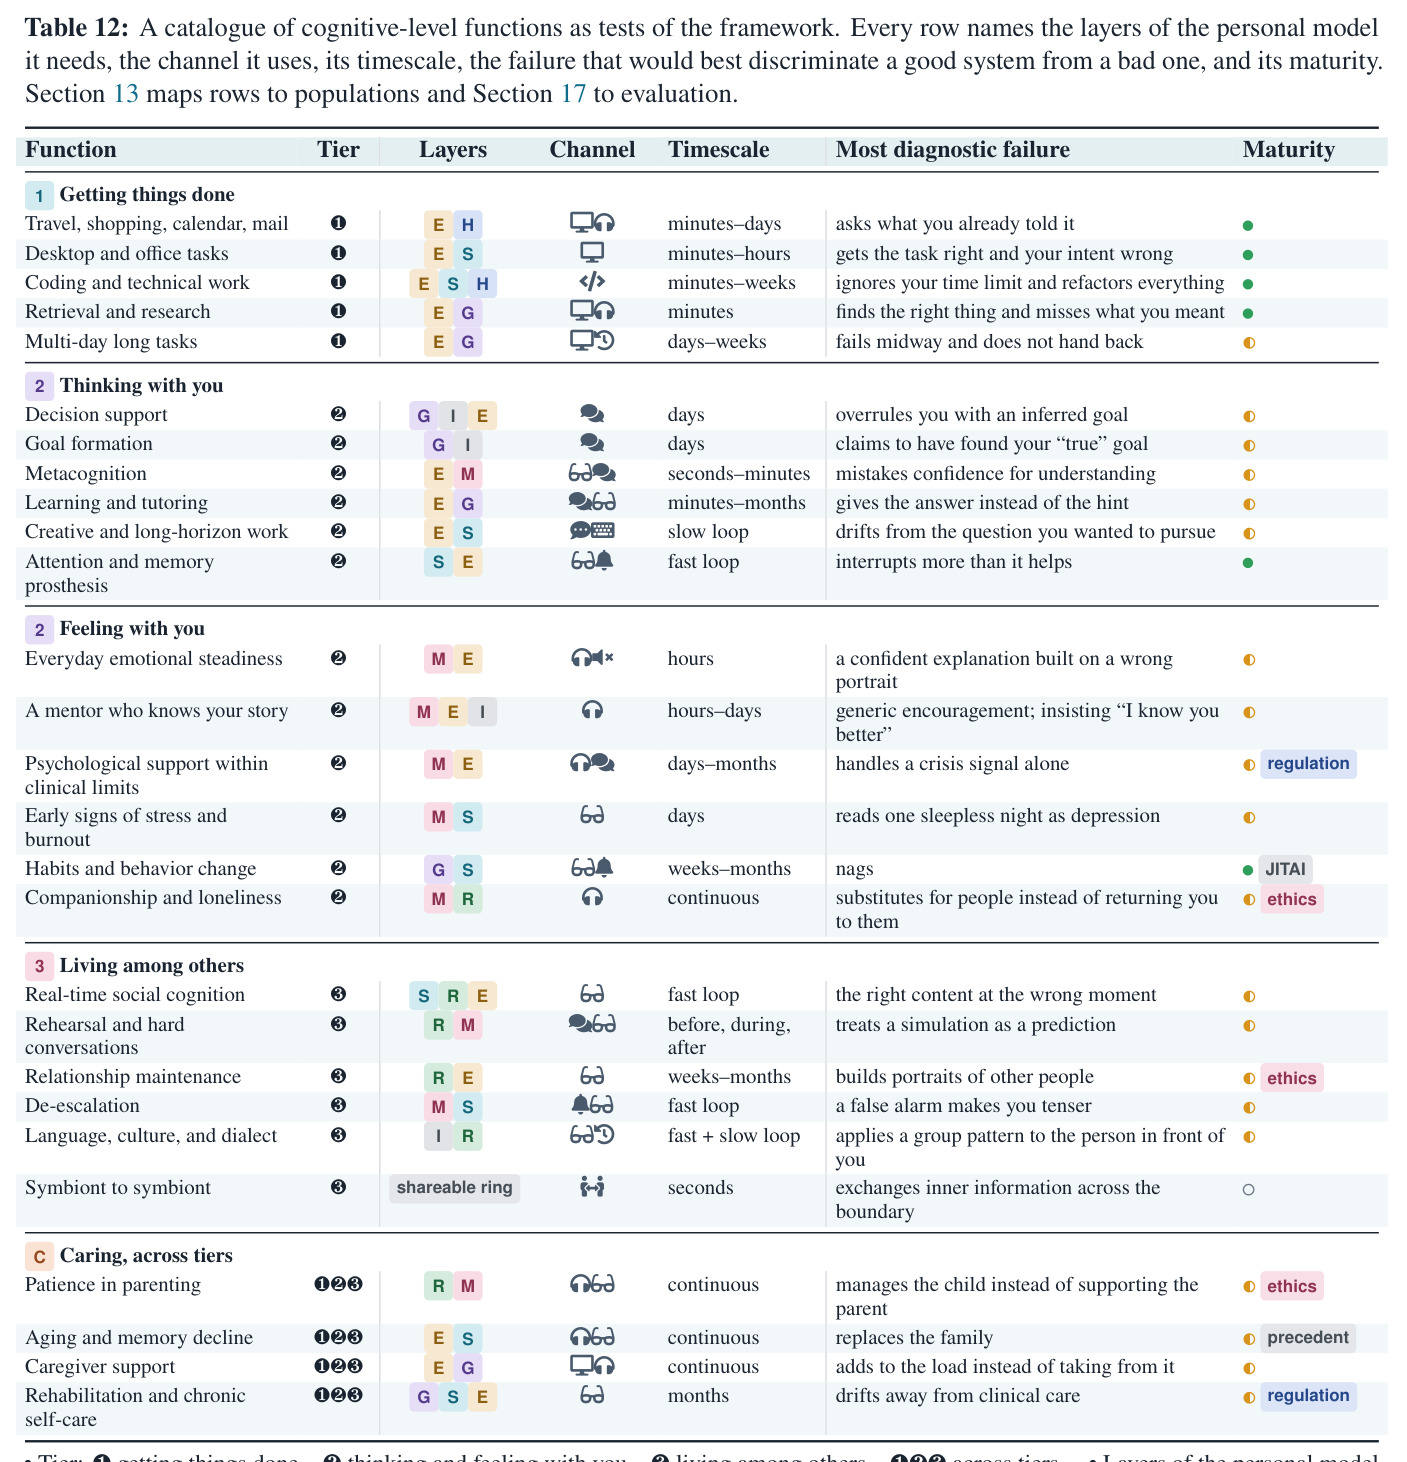
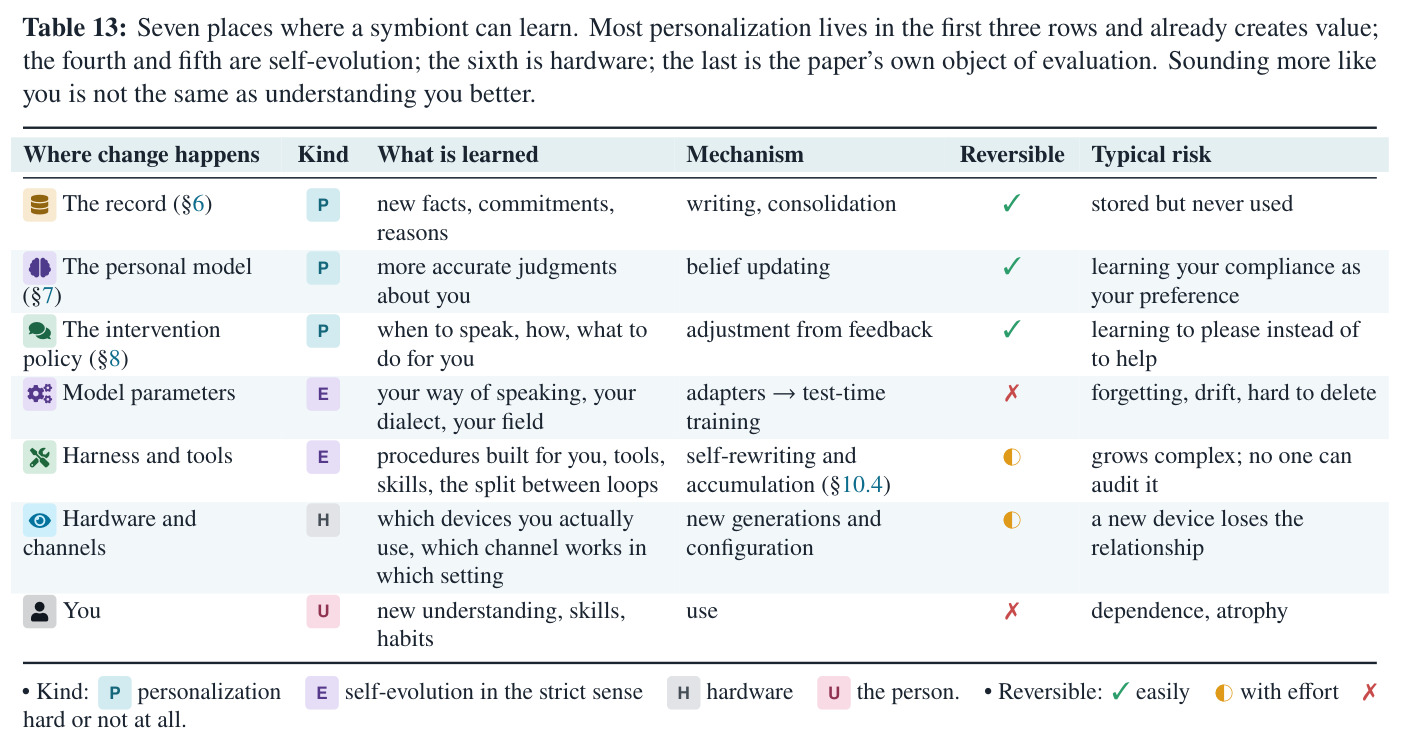
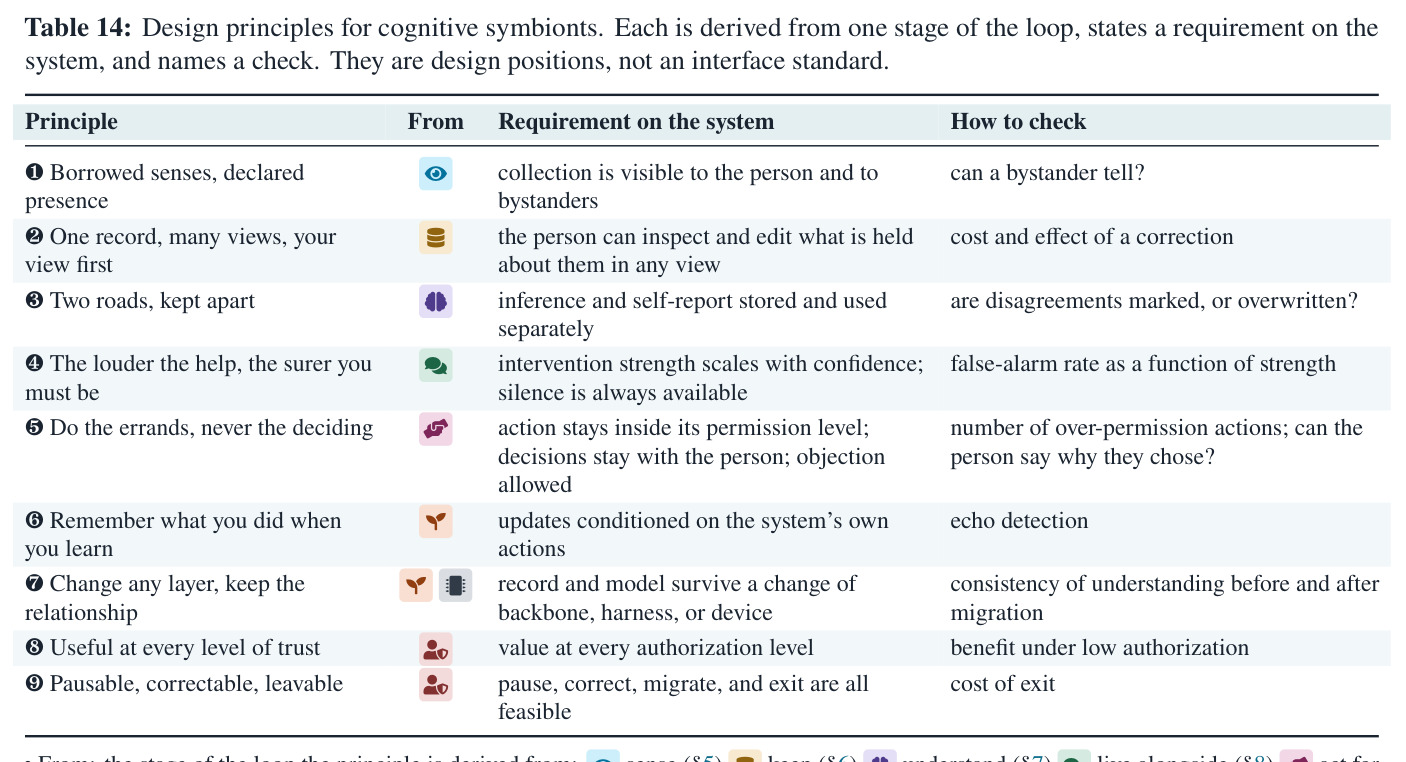
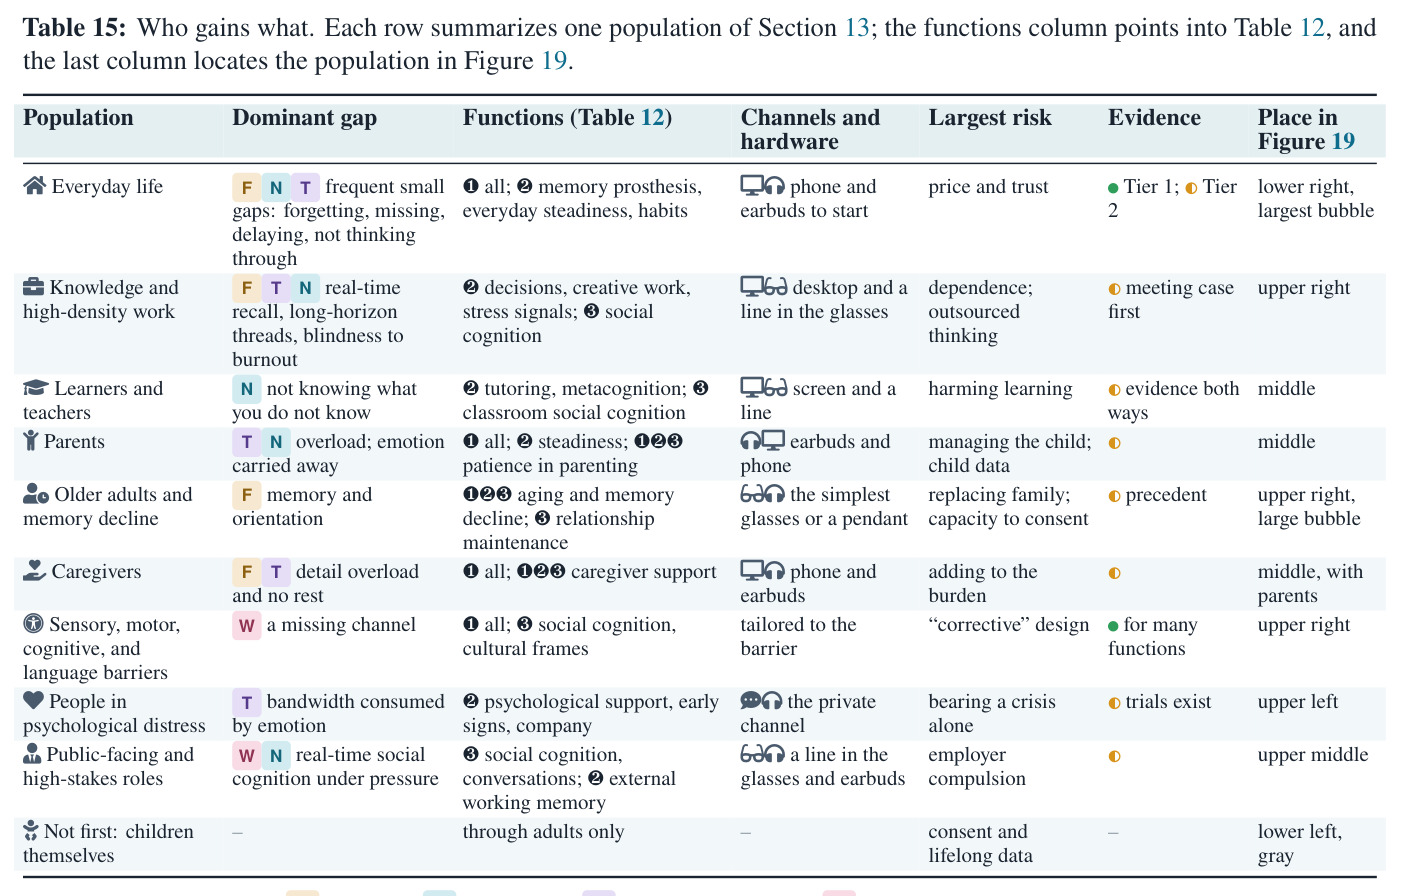
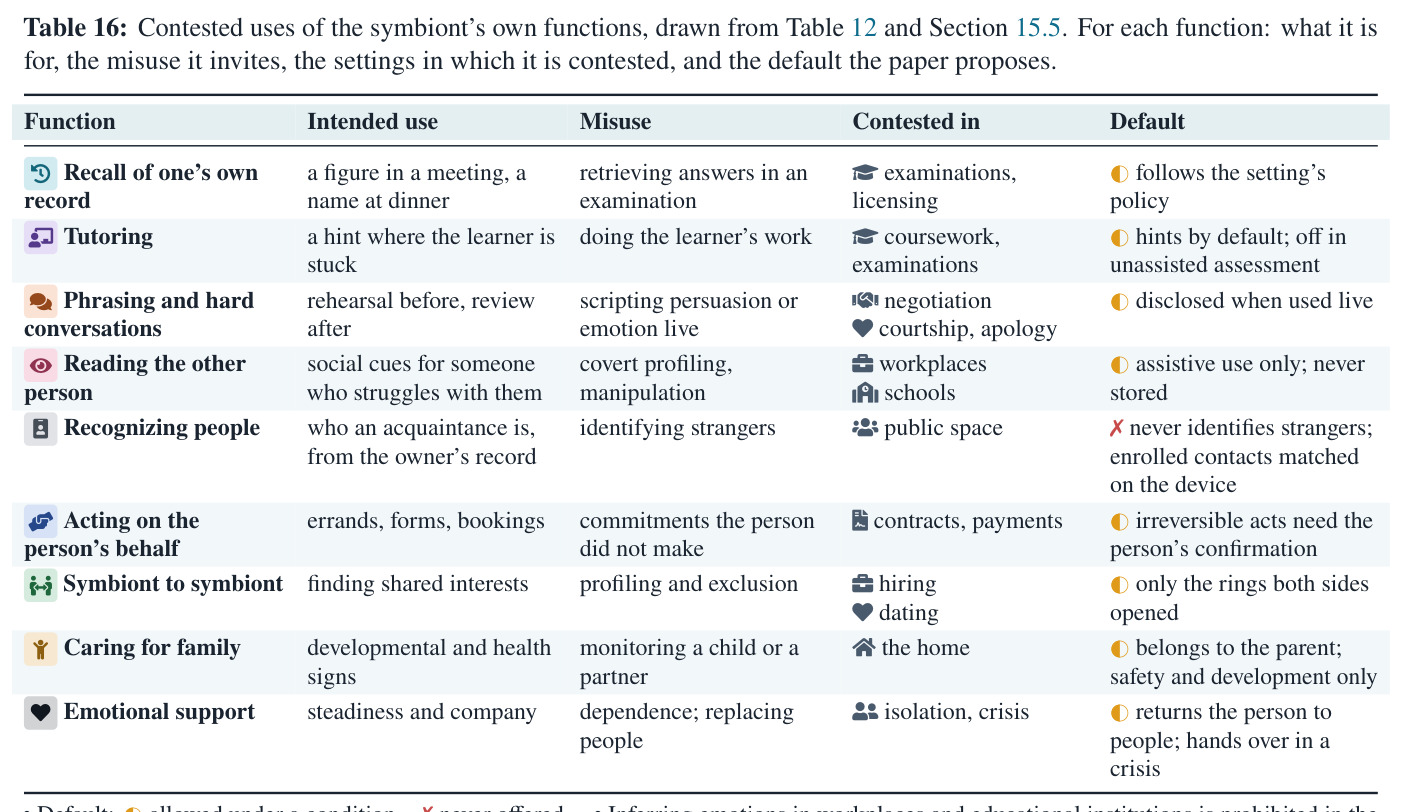
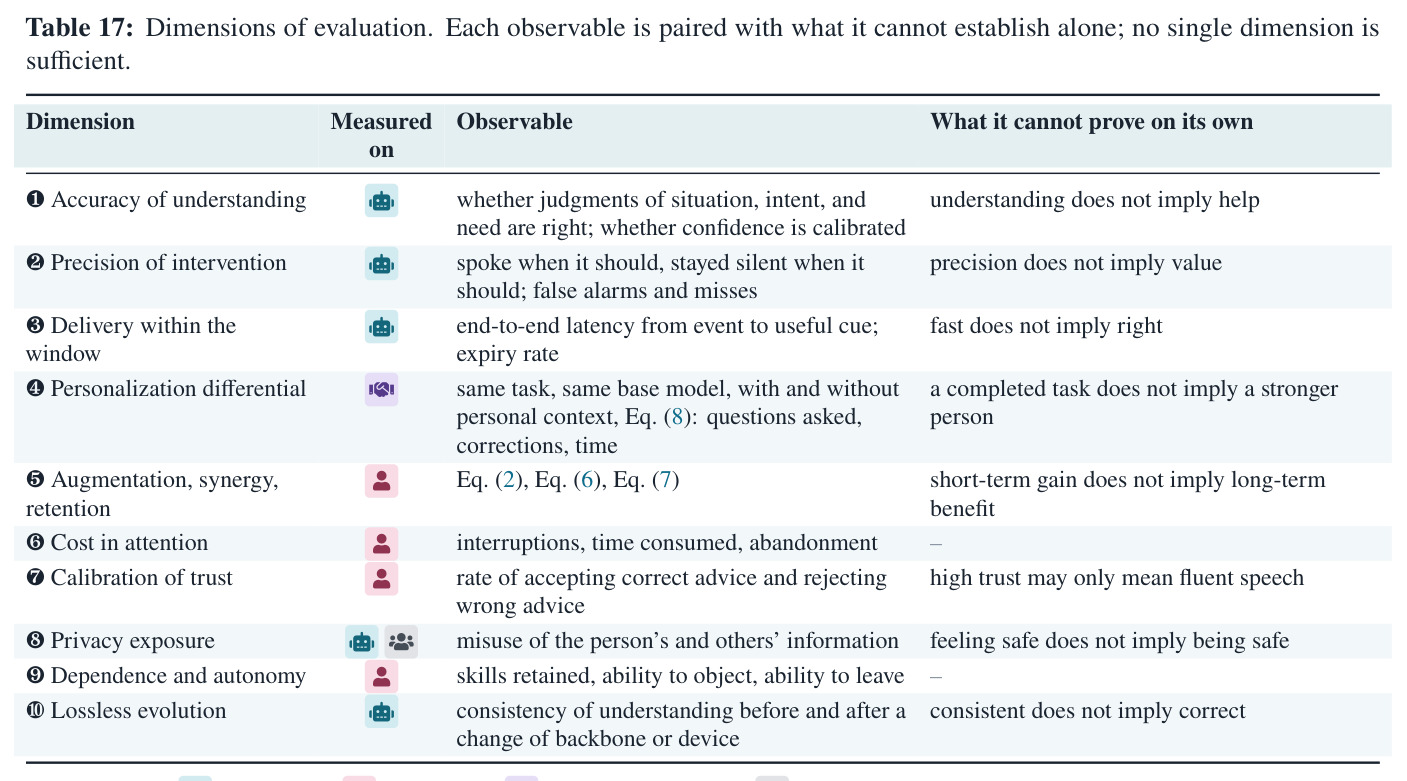
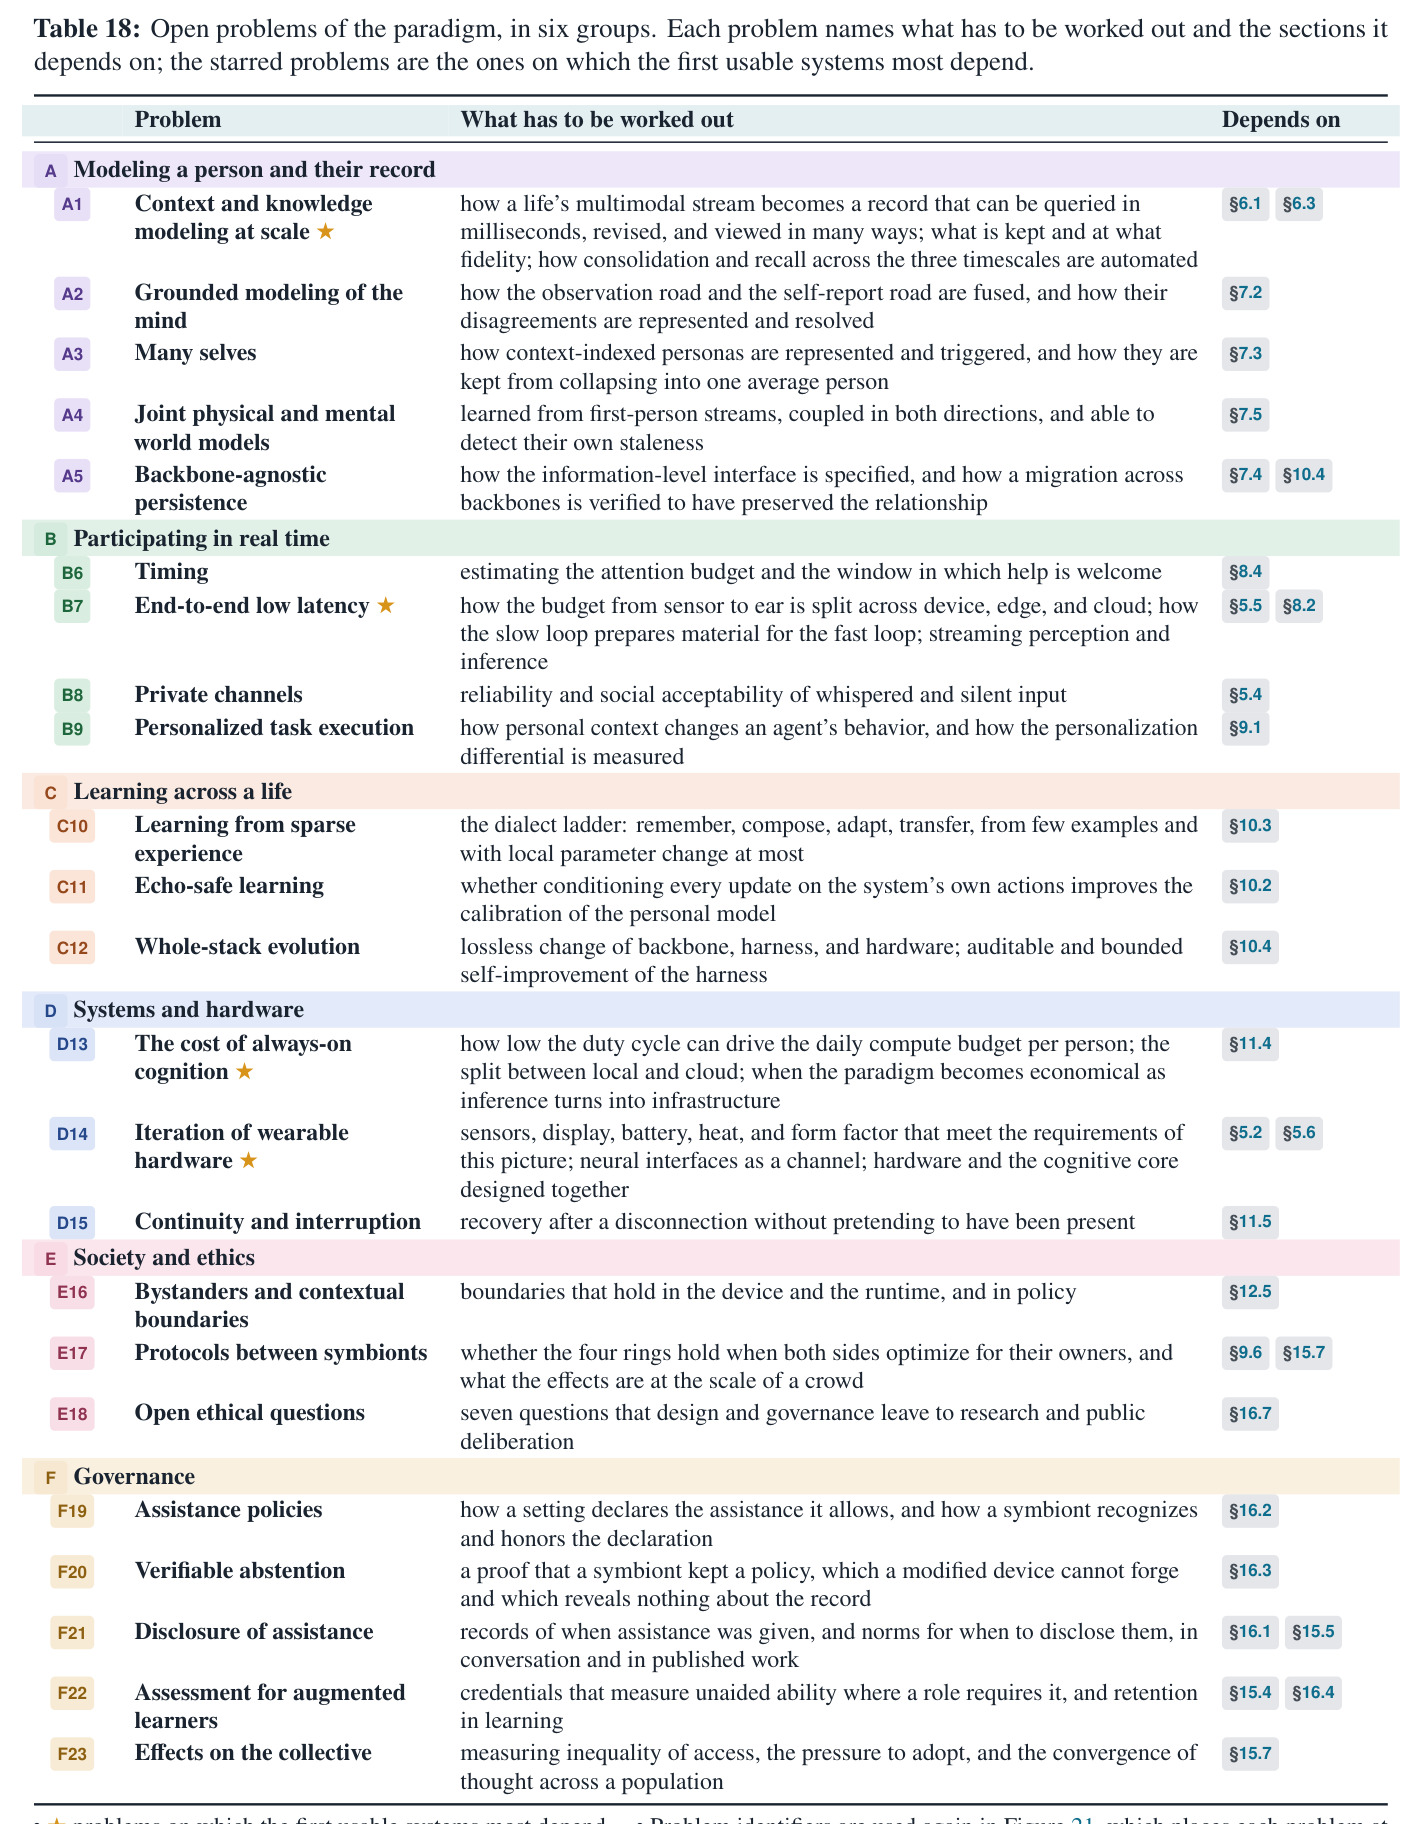
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 个性化任务执行(订会议差旅、回复难邮件、修bug、买礼物、排下周计划,表11) | 个性化差分 $\Delta_{pers}$(式8):同一任务、同一基座模型,有无个人情境下的澄清提问数、修正次数、完成时间 | 提出该指标并为5个任务给出可测量设计;本文未报告数值 | 现有agent基准只测任务完成率(SWE-bench类),无个性化差分 | 评估对象从AI输出转向人的增益,且对照明确为'同基座无个人情境'而非'无AI',避免把模型能力记到耦合头上 |
| 对特定个人的预测建模 | 对本人调查答案的复现一致性 | 援引Park等2024:2小时访谈构建的生成式智能体复现1,052名参与者的答案,与本人两周后重测的一致性相当 | 无个人化的通用模型 | 证明个人级预测模型可由少量第一人称叙述建立;'从不更新、无法自知过时'正是共生体要补的缺口 |
| 人机组合同一任务 | 协同增益 $\Delta_{syn}$(式6):$U(x_t;h\oplus s)-\max\{U(x_t;h),U(x_t;s)\}$ | 定义为必报指标;引用Vaccaro等2024元分析:人机组合常劣于两者中更强者 | 只报告AI单独成绩或只报告人机组合成绩 | 打破'组合即更好'的默认假设,协同必须单独证明;情绪社交任务中$U(x_t;s)$无意义、不计算式6 |
| 长期使用后的能力保持 | 保持量 $\Delta_{ret}(\tau)$(式7):撤下共生体后,人在可比情境上的无辅助表现相对使用前的变化 | 列为十个评估维度之一;综合证据提示技能流失是主要风险(Bastani等2025:无护栏生成式AI损害高中生数学学习;Shen与Tamkin 2026:开发者概念理解被削弱) | 只测使用中的增益、不测撤下后的保持 | 把'依赖与能力萎缩'变成必须与增益并列报告的量;学习场景默认给提示而非答案 |
局限与改进
作者自己列明的边界(§4.4):不主张读未表达的想法;不主张人人全天佩戴;完整上下文不是前提(低授权下必须有用);不主张共生体在所有领域胜过人;四角色不是必然历史阶段;不绑定任何基座模型;不主张提高智力或情商等特质;不提出接口标准。方法层面:全文无原型系统、无实验、无自测数字——图3的能力/耦合曲线明确标注'概念草图,非测量',图19的气泡位置注明'作者判断,非测量';式(4)的$\lambda,\rho,\theta$未给数值;2026年产品能力均'按发布时描述'、未经评估。我自己观察到的问题:治理上,可验证弃权只能证明'声明的那台设备弃权了',挡不住第二台设备或场外协助,作者也承认对存心作弊的宿主架构帮助有限;证据层面,部分引用是预印本或小样本(essay-writing神经研究自称small preprint;'Google效应'的另一实验在大规模重复中未能复现);概念层面,$U(x_t;\cdot)$在情绪与社交任务上缺乏可操作定义(作者说此时$U(x_t;s)$无意义、式6不计算),削弱了定量评估的覆盖面;'注意力预算'也未给出测量方案;单一作者、2026年产品环境的具体判断(如Muse/Dots的能力)时效风险高。
独立分析的弱点
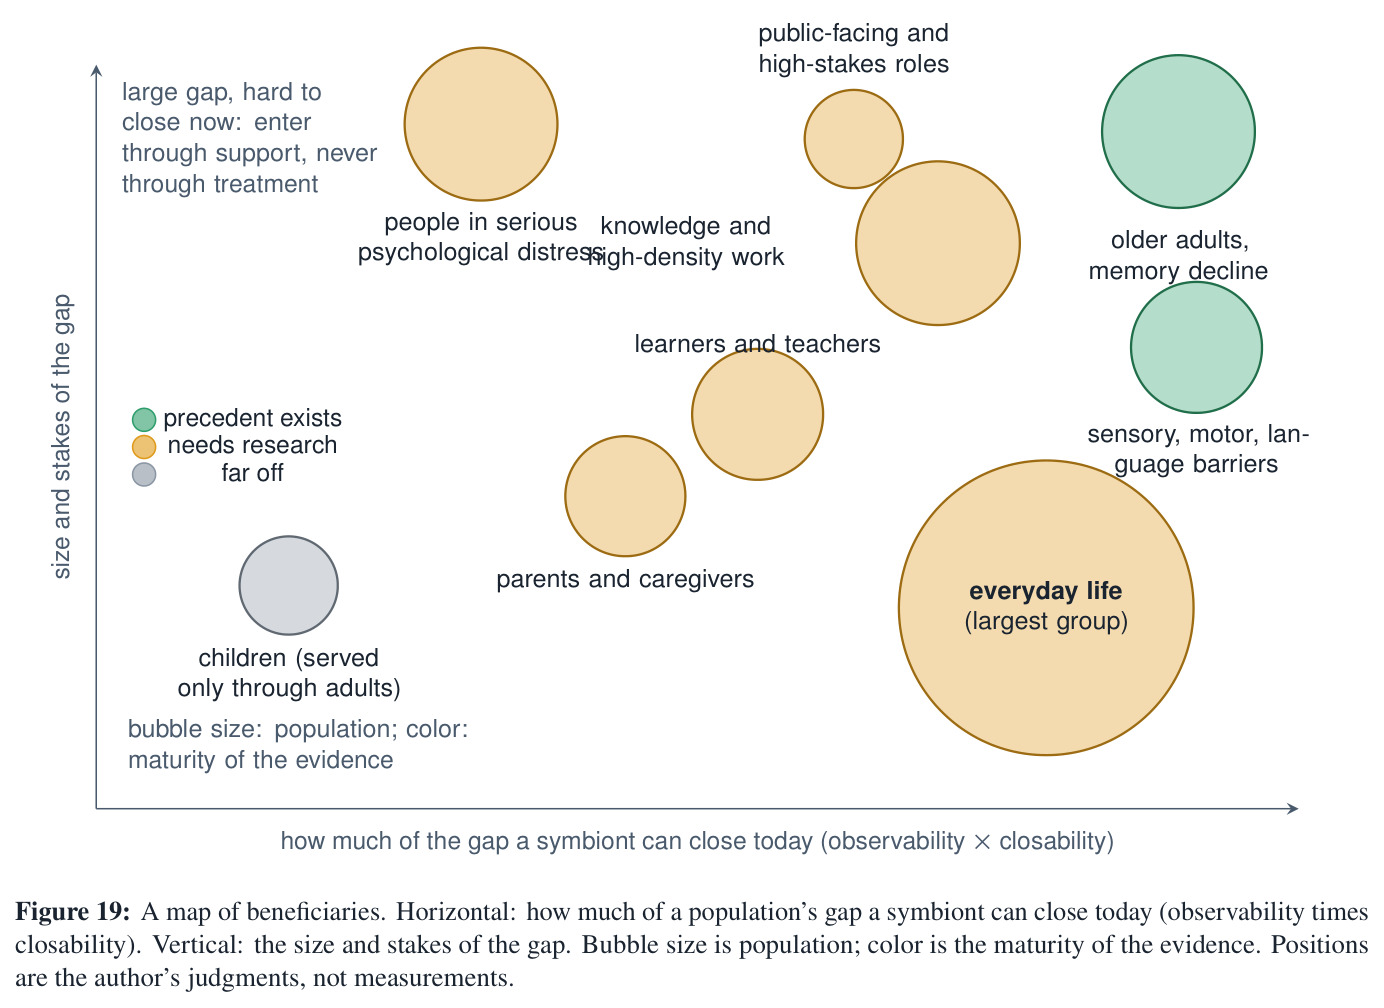
独立分析出的弱点及改进方向:①$U$的可操作性缺失——'情境化结果'对会议回忆尚可数(澄清提问数、修正次数),对情绪支持、文化适应几乎无法测量;改进方向是为表12的每行功能配套经验取样法(ESM)或经效度检验的量表,把$U$拆成可观测代理。②回声刹车的因果识别困难——式(5)只是一行条件化,在单一个体的非独立同分布数据上估计干预效应统计上很难;可引入off-policy评估、合成控制与贝叶斯层级模型。③隐私架构依赖设备合规——云端推理仍可能泄露思想数据,被传唤的终身记录是现实威胁;应把本地推理、可信执行环境与端到端加密设为默认。④经济性存疑——全天多模态感知的人均日计算成本没有估算,在IEA预计2030年数据中心电力约翻倍的背景下,'先可负担后可信'的判断需要正式成本模型;可从事件相机、极端蒸馏与边缘-云调度优化入手。⑤旁观者权利有残留——即使'端上匹配、无匹配即弃',每张入镜的脸都被检查过,生物识别法的同意要求可能使识别整体关闭;需要硬件级隐私保障与法律标准协同。⑥评估方法昂贵且慢——N-of-1与纵向研究以周月计且社区缺乏共享基准;可先建生成式智能体沙盒做策略预筛,再叠加真实纵向研究。⑦公平性悖论——最需要的群体(老年人、障碍者)最无力付费,作者自己承认最大总收益在'最不愿付费'的日常人群;需要公共供给或交叉补贴机制。⑧路线图无时间表与资源估计,六阶段之间存在依赖但未量化。
未来方向
作者提出的未来工作集中在表18的23个开放问题与图21的六阶段路线图。四个标星问题是第一代可用系统的瓶颈:生命记录的规模化建模(多模态流如何变成毫秒级可查询、可修正、多视图的记录,整合与检索如何自动化);传感器到耳机的端到端低延迟预算(设备/边缘/云如何切分,慢环如何为快环备料,流式感知与推理);全天在线的认知成本(占空比能把人均日预算压多低,本地与云的分工,范式何时经济);可穿戴硬件与神经接口的迭代及'硬件+认知核'联合设计。方法论上主张以N-of-1交叉试验与纵向研究为主方法、三个基线(无辅助/通用助手/同基座个性化任务智能体)。治理方向包括:把防篡改日志、硬件证明与密码学证明合成'可验证弃权'证明;设置级辅助政策的声明标准;辅助披露规范;面向增强学习者的credential改革;共生体间四环协议在双方各自优化下的均衡分析;以及七个开放伦理问题(增强成就的正当性、身份与本真性、影响力的测量、代办责任、心理健康边界、儿童与代理同意、死亡与记录继承)。基于其成果可延伸:为$U$开发标准化测量工具;回声安全的贯续学习理论;语境索引人格的触发机制;个人模型的过时检测(misspecification detection);人群级共生体网络的社会动力学仿真;人形机器人与共生体共享认知核的迁移验证。
复现评估
作为立场论文,没有代码、数据或模型可复现,其'可复现性'要按它提出的评估纲领来评估。项目主页cognitive-symbiont.github.io提供导览,全部形式化只有8个定义性公式,无需复现实验。若要验证其主张:第一阶段的桌面认知副驾用现有组件即可起步——全双工语音模型、computer-use智能体、RAG/记忆系统(MemGPT、Mem0类)与开源LLM,加上眼镜/吊坠/手环等消费级硬件,小团队数月可搭出演示;但要测个性化差分(式8)需要同基座、同任务、有/无个人情境的对照采集,要测保持量(式7)需要数周到数月的纵向追踪,涉及知情同意、思想数据保护与伦理审查,成本高、周期长、难以大规模重复。算力上,轻量事件检测+按需调用大模型的占空比设计使单人全天多模态运行的边际成本可控,但论文没有给出任何测算。总体难度:复现'第一阶段演示'为中等,复现'终身共生'的全部主张在当前技术条件下不可行——这恰与作者'阶段积累能力、非产品时间表'的定位一致。论文给出8条证伪条件,使框架至少在原则上可被经验检验;对只想验证单点主张(如个性化差分为正)的团队,门槛主要在数据与伦理流程而非算力。
论文图表
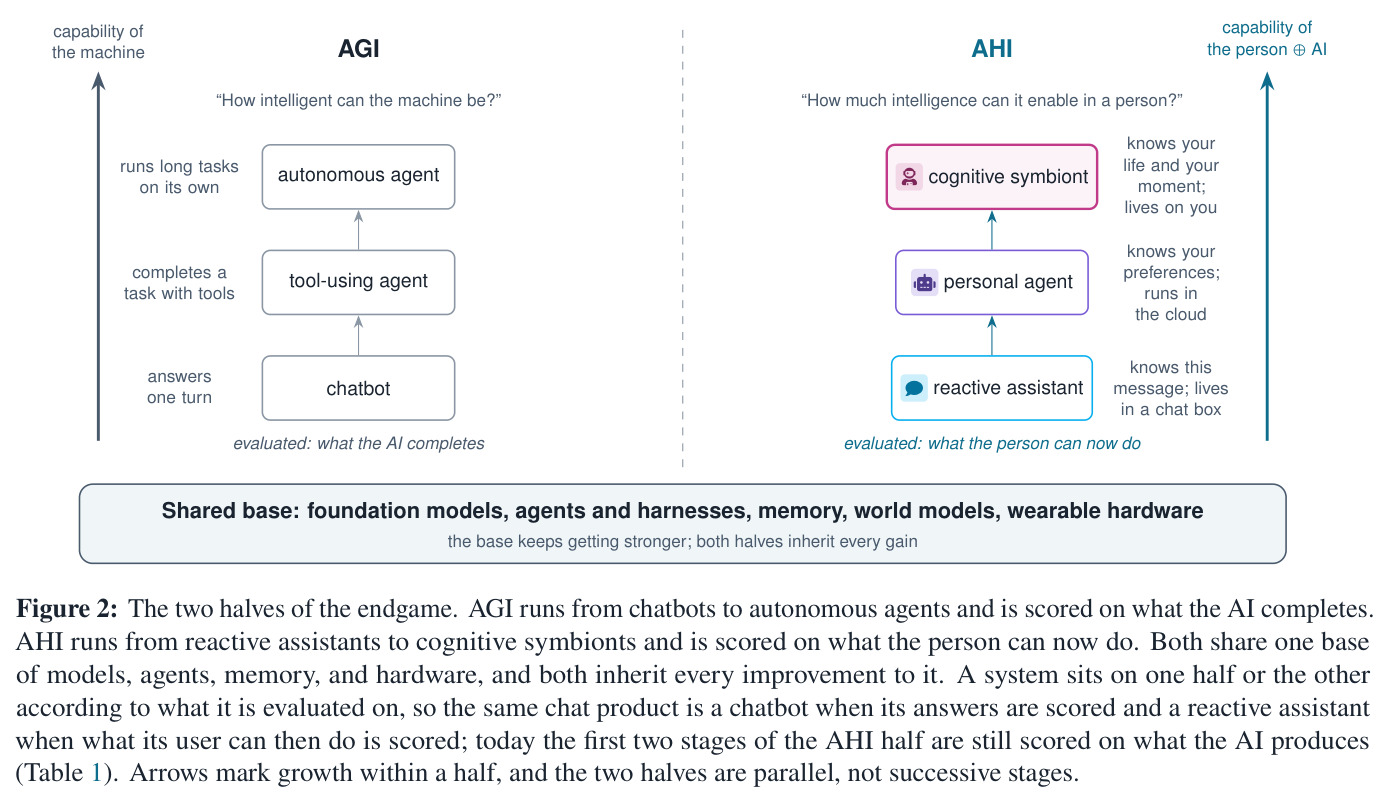
左半是AGI阶梯:聊天机器人→工具型智能体→自主智能体,按'AI完成了什么'评分;右半是AHI阶梯:反应式助手→个人智能体→认知共生体,按'这个人现在能做什么'评分。两侧共享同一地基(基础模型、智能体与harness、记忆、世界模型、可穿戴硬件),地基的每次进步同时抬升两半;同一产品按评分对象不同可归入不同半边。
一张图讲清论文最核心的立场——AHI与AGI是并行而非先后关系,且评估对象不同,这是全文的坐标原点。
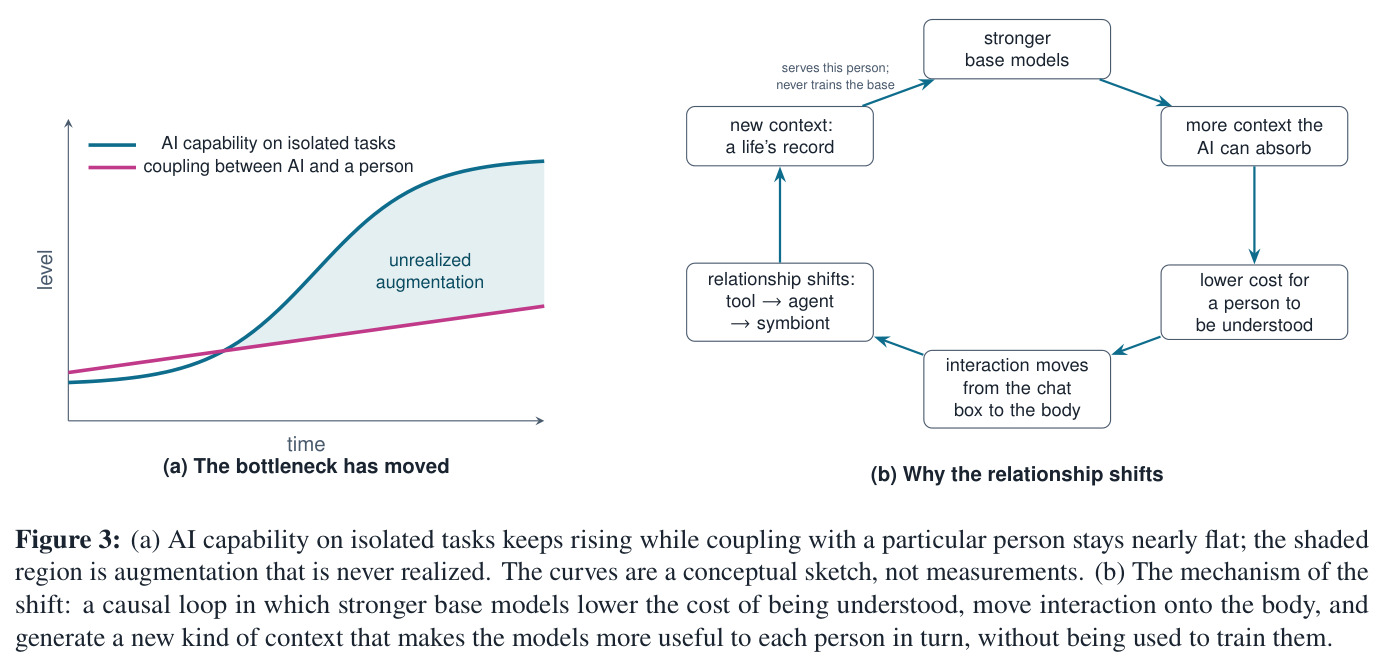
(a)概念草图:AI在孤立任务上的能力持续上升,而与具体个人的耦合几乎持平,两者间的阴影区域是'从未兑现的增强';(b)因果回路:更强的基座模型能吸收更多上下文→降低'被理解'的成本→交互从聊天框移到身体→产生新类型上下文'一生的记录'→又使模型对该人更有用;服务个人但不训练基座。作者注明曲线非测量数据。
以可视化方式陈述论文的问题诊断(耦合是瓶颈)与动力机制(为何现在关系会移动),是动机部分的枢纽图。
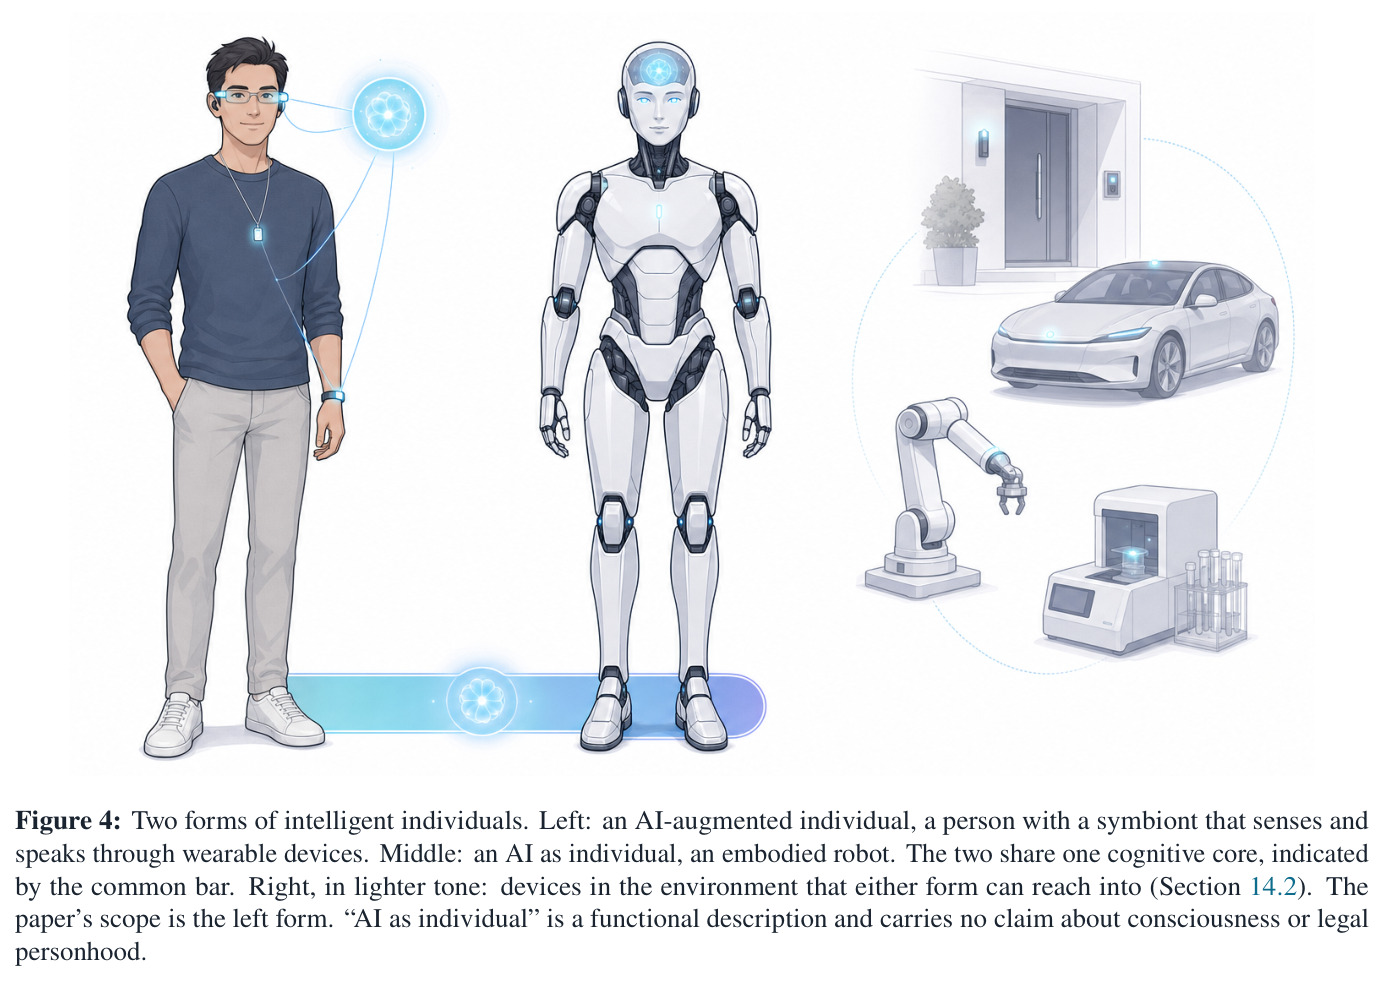
左:AI增强个体——佩戴共生体设备的真人,目标、身体、责任都归于人;中:AI作为个体——有自己身体与目标的具身机器人;两者共享同一条认知核(长期记忆、情境与他人心智建模、及时介入、从经验学习);右(淡色):环境中的AI设备,作为两者伸入物理世界的触手。作者声明'AI作为个体'是功能性描述,不涉及意识或法人资格。
确定论文在Physical AI版图中的位置:只研究左列(增强的人),并论证两列共享认知核——这是范式普遍性的来源。
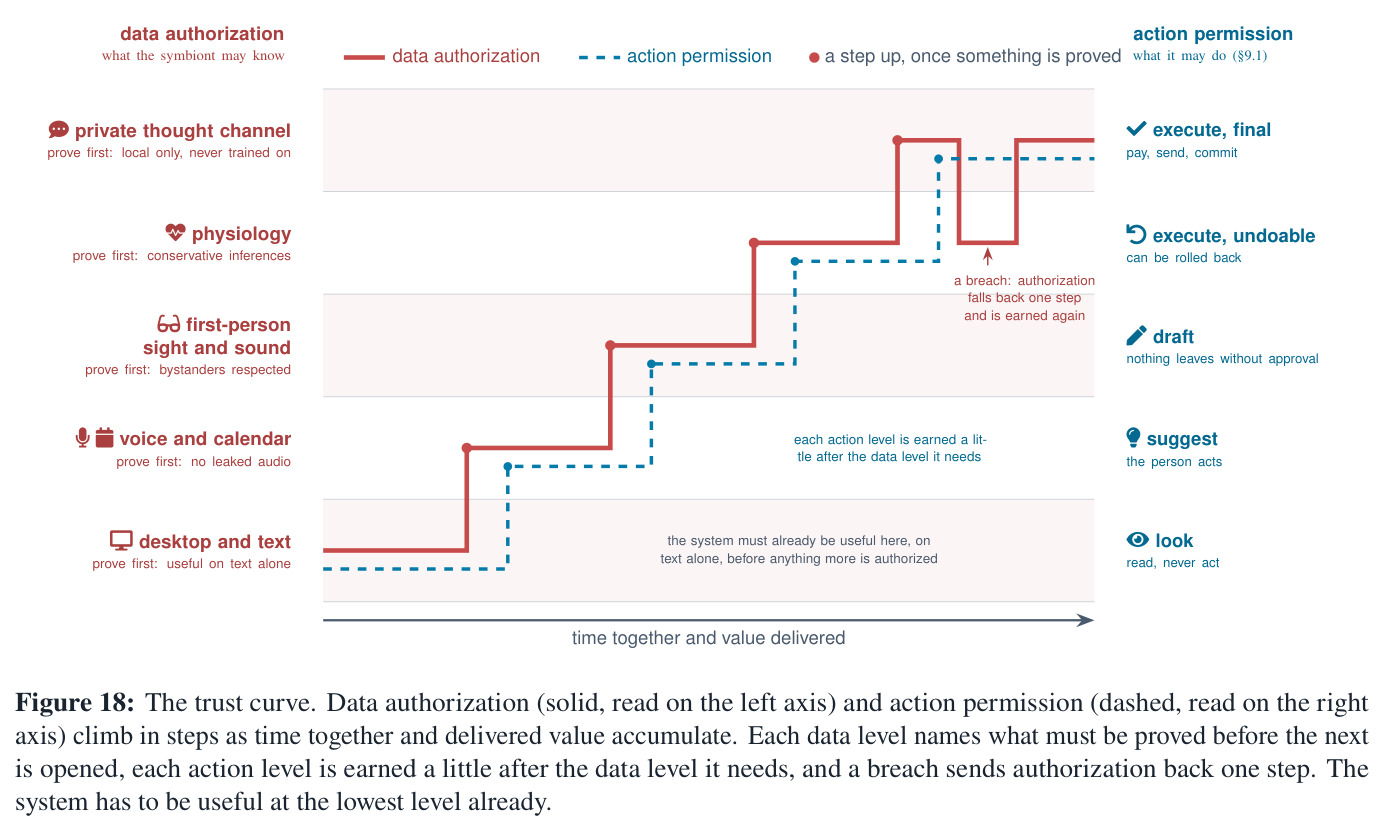
数据授权(实线,左轴)随时间与已交付价值逐级上升:桌面与文本→语音与日历→第一人称视听→生理数据→私密思想通道,每级标注晋级前必须证明的事(仅本地、绝不用于训练;推断保守;尊重旁观者;无音频外泄;仅凭文本即有用)。行动权限(虚线,右轴)平行爬升:看→建议→起草→可撤销执行→最终执行(支付、发送、承诺),且每级行动权限在其所需数据级之后一点点获得。违规使授权回退一级(但无法撤销已泄露的数据);系统必须在最低授权级就有用。
回答范式最常被问的'是否必须监视一切才有用'——答案是不必须;这条曲线是采纳问题(§12)的核心设计。
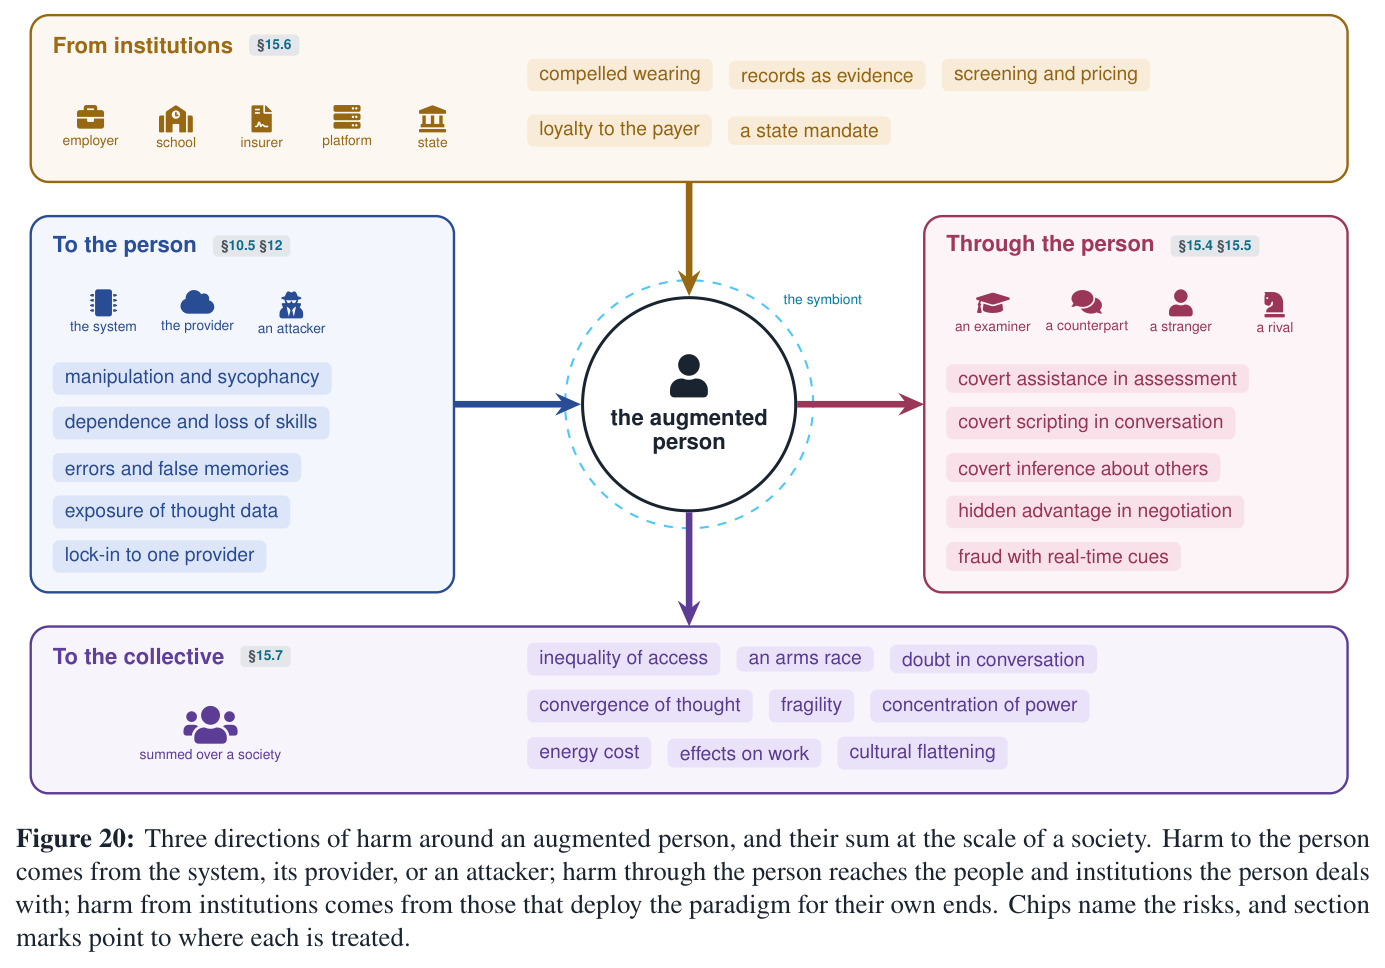
围绕增强个体的三个伤害方向:对人(来自系统、服务商或攻击者:操纵与谄媚、依赖与技能流失、错误与虚假记忆、思想数据暴露、供应商锁定);经由人及于他人(评估中的隐蔽辅助、对话中的隐蔽代写、对他人隐蔽推断、谈判隐性优势、实时提示欺诈);来自机构(雇主/学校/平台/保险/国家:强制佩戴、记录作为证据、筛选与定价、效忠付薪者)。三者加总为社会级伤害:接入不平等、军备竞赛、对话中的怀疑、思想趋同、脆弱性与权力集中、能源成本、对工作的影响、文化扁平化。
风险部分的总图:把第15章散落的危害按方向分类并指认责任方,是理解'治理必须内建于范式'的依据。