StepX-OPD:重新思考扩散模型中的多教师在线策略蒸馏 StepX-OPD: Rethinking Multi-Teacher On-Policy Distillation in Diffusion Models
把多教师能力整合与少步蒸馏合并为单阶段训练,四步模型反超四十步且省约37%算力。
前置知识
Rectified Flow(修正流)/Flow Matching
一种生成建模框架:用线性路径 $z_t=(1-t)x_0+t\epsilon$ 把干净数据 $x_0$ 与高斯噪声 $\epsilon$ 连接($t=1$ 为纯噪声、$t=0$ 为干净图像),训练速度场 $v_\theta$ 回归目标速度 $\epsilon-x_0$,采样时沿时间网格 $1=\sigma_0>\dots>\sigma_N=0$ 做确定性 Euler 更新 $z_{\sigma_{i+1}}=z_{\sigma_i}+(\sigma_{i+1}-\sigma_i)v_\theta$。SD3.5 与 FLUX 都是训练在该框架上的大模型。
全文的记号、rollout 网格、以及"低噪端/干净端"的几何直觉都建立在该框架上,不熟悉它就无法理解监管点的构造方式。
在线策略蒸馏(On-Policy Distillation, OPD)
源自 LLM 蒸馏的思想:教师不在离线数据或教师自己的轨迹上、而在学生自己生成的状态上提供监督,从而覆盖学生真正会访问的分布。在连续扩散中,DiffusionOPD 把每一步建模为共享协方差的高斯条件转移,并证明每步的条件转移反向 KL 可化为加权速度 MSE:$\mathcal{D}_{KL}(q_{\theta,i}\|p_{\phi,i})=\omega_i\|v_\theta(z_{\sigma_i},\sigma_i)-v_\phi(z_{\sigma_i},\sigma_i)\|^2$。
本文保留"在学生访问的状态上监督"这一 OPD 内核,但把它搬进 4 步轨迹并用多教师路由,理解 OPD 才能看清方法的定位与差异。
分布匹配蒸馏(DMD 与 TDM)
DMD 在干净分布端最小化反向 KL $\mathcal{D}_{KL}(q^{clean}_\theta\|p^{clean}_\phi)$,用"真实分数 $s_\phi$ 减 fake 分数 $s_\psi$"之差作为梯度,并训练一个 fake 网络;TDM 把这种边际匹配推广到学生轨迹的中间时刻,按时间权重匹配每个 rollout 节点附近的轨迹边际分布。二者都可由反向 KL 视角统一解释。
StepX-OPD 的分布匹配主干就是 TDM(含 fake 速度与伪 Huber 损失),其理论定理 A.3 也正是把 TDM 的边际匹配与 OPD 的速度匹配统一进同一个反向 KL 分解。
无分类器引导(CFG)
扩散模型训练时同时见条件与无条件输入,采样时用 $v^{cfg}=v_u+w(v_c-v_u)$ 合成速度,$w$ 为引导强度。蒸馏中教师给出的监督目标是 CFG 合成后的速度;FLUX.1-dev 把引导蒸馏进 guidance embedding,推理时禁用显式 CFG。
论文中专家提供的速度目标都是 CFG 合成速度(式 10),且评估协议里 40 步与 4 步使用不同引导尺度(4.5/1.0),都需 CFG 背景才能理解。
LoRA 低秩适配器
在冻结权重旁训练低秩增量矩阵的参数高效微调方法,只更新极少量参数即可改变模型行为,多个适配器还能在权重空间相加合并(权重 soup)。本文的学生与 fake 网络均为 rank-32 LoRA,冻结专家则是前作公开发布的单奖励 LoRA 适配器,初始化阶段将多个适配器增量按系数相加。
训练成本能压到约 72.7 GPU 小时、以及"从已发布适配器初始化"的一系列消融(Table 5/7/9/15),全部以 LoRA 为基础。
研究动机
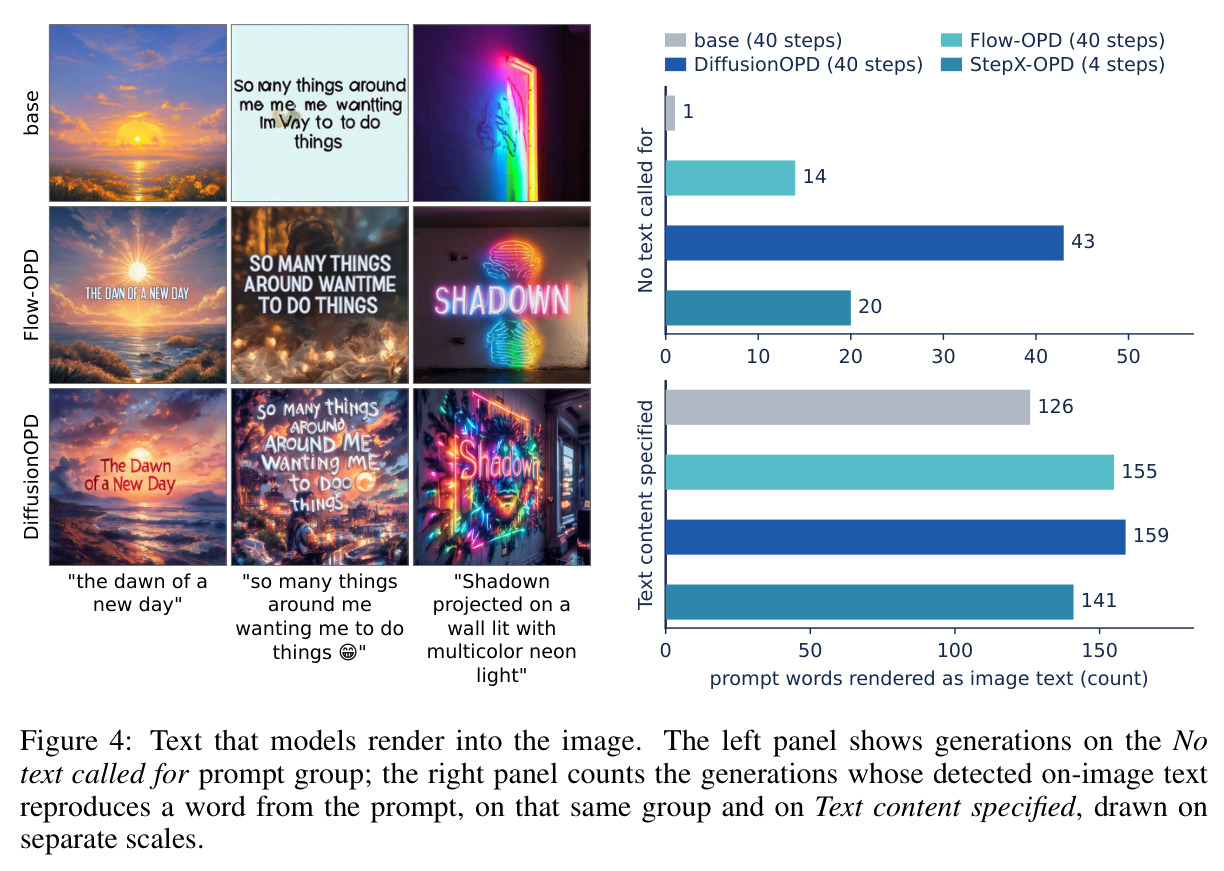
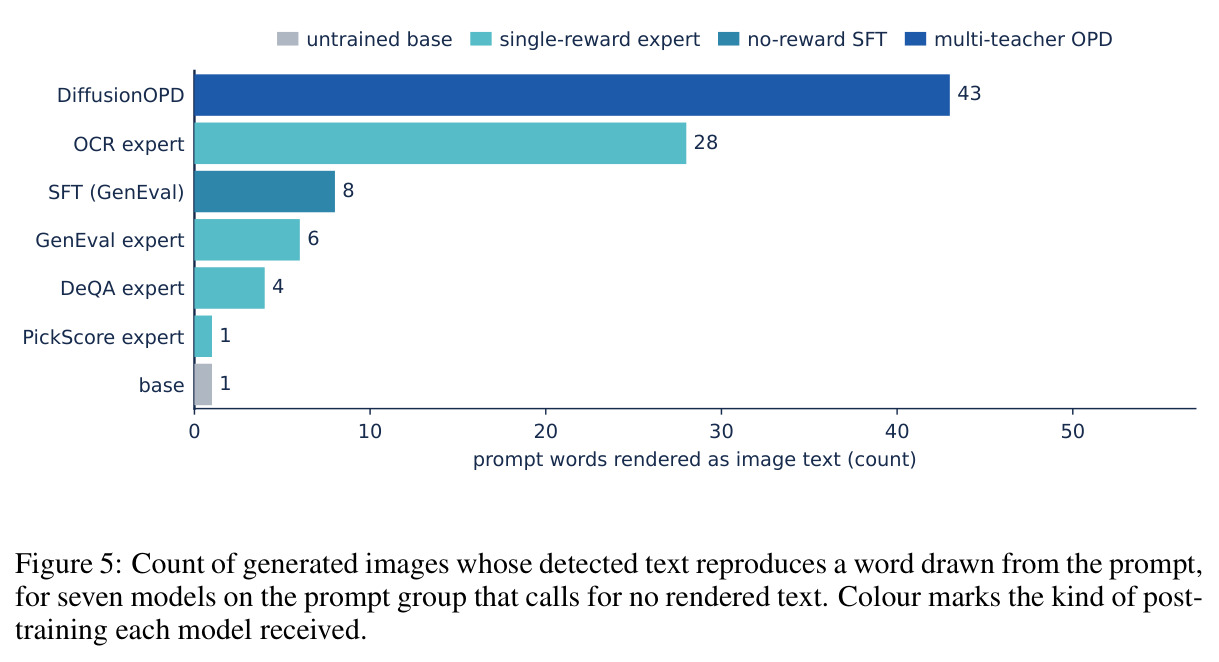
一个可部署的文生图扩散模型必须同时满足两类需求:能力上要兼顾指令遵循、文字渲染与人类偏好,推理上要用尽量少的采样步数。现有范式把这两件事拆成串行的两个后训练阶段:先用多教师在线策略蒸馏(OPD)在完整步数(40-80 步)下把各领域能力整合进一个全步模型,再把该模型当作固定教师做步数蒸馏,压缩到 4 步。这条流水线有两个被实测证实的代价。其一是训练时长:步数蒸馏必须等全步能力模型训完才能开始,图 1 显示 SD3.5-Medium 上串行 DiffusionOPD+TDM 约需 115.7 GPU 小时(其中 TDM 阶段占 25.6),而 Flow-OPD 因需先用单奖励 GRPO 训练各领域教师,阶段成本高达约 1.63k GPU 小时。其二是能力损耗:论文在统一协议下测出,每一个被评估的全步能力模型压缩后综合分都下降——SD3.5-Medium 上 DiffusionOPD 从 40 步的 0.9022 掉到 4 步的 0.8403(GenEval 0.945→0.838、OCR 0.930→0.833),Flow-OPD 从 0.8788 掉到 0.8345;FLUX.1-dev 上同样如此。此外,能力整合还带来一个此前未被量化的副作用:在完全没要求文字的提示上,模型会把提示词"写"进图片——SD3.5-Medium 的"提示词复现"图像数从 base 的 21 张暴涨到 DiffusionOPD 的 218 张。
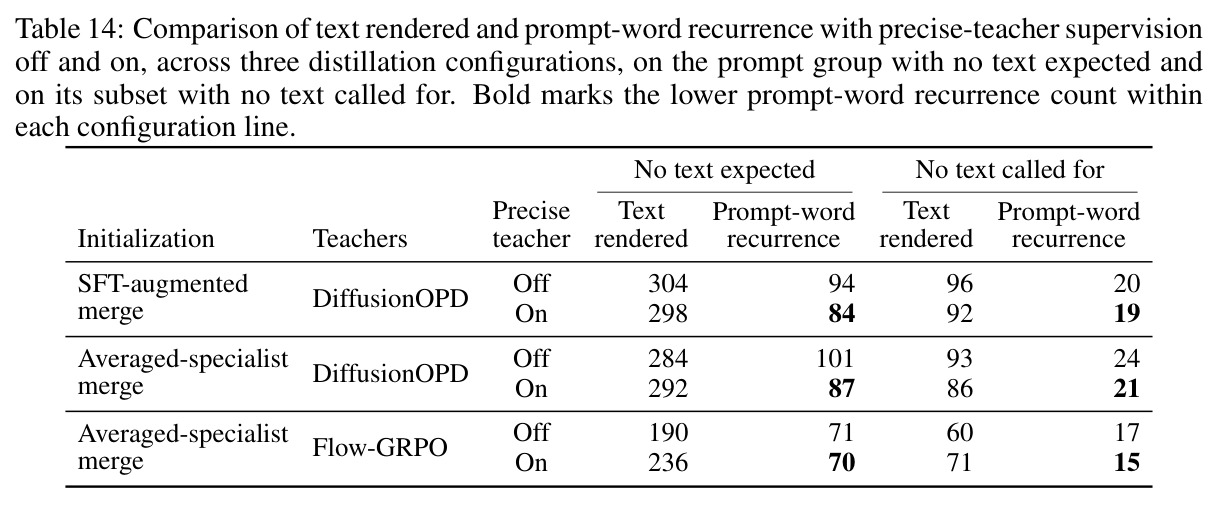
本文的目标是本文的目标是把"能力整合"与"步数压缩"合并成一个训练阶段:让单个学生在学习 4 步采样的同时,直接从多个冻结专家那里获得全部能力监督,具体包括三点:(1)取消中间全步模型,显著缩短训练——在 SD3.5-Medium 上相比串行 DiffusionOPD+TDM 节省约 37% 的 GPU 小时(约 72.7 对 115.7);(2)避免能力在"全步→少步"交接时流失,使 4 步模型在 GenEval、OCR、DeQA、PickScore 及归一化 Average 上超过串行流水线的 4 步结果,并反超 40 步的 Flow-OPD(0.8901 对 0.8788);(3)量化"提示词复现"这一副作用,并给出降低它的变体——精确教师目标,把复现计数从 94 降到 84。
与已有工作不同的是,已有工作都把教师能力当作步数蒸馏的既定输入:DMD/DMD2 与 TDM 压缩一个能力已固定的教师;CDM 只是把固定锚点换成动态采样,仍用单一教师;Qwen-Image-Flash 事先把基础教师与强化学习教师混合成固定目标;DiffusionOPD、Flow-OPD、DanceOPD 虽引入在线策略与多教师路由,却都在全步数下进行。没有人问过:全步模型上整合好的能力,压缩到 4 步后还剩多少?本文第一个用统一协议直接测量了这种"交接损耗",并用一个反向 KL 分解把 TDM 的轨迹边际匹配与 OPD 的条件转移匹配统一到同一框架——分解式中的权重 $w_b(t)=(t_i-t)\frac{1-t}{t}$ 在低噪端随 $t\to 0$ 无界增长,说明 KL 损耗集中在靠近干净图像的一端,这为"在学生自己的 4 步轨迹上直接做低噪速度回归"提供了理论依据。同时,作者首次给出"提示词复现"的量化协议,指出它是能力整合的普遍副作用而非个例。
核心方法
直觉上,过去的做法是"先培养一位全能的慢速老师,再让他带出一个快手徒弟",徒弟学到的本事总会打折扣;StepX-OPD 则是"让快手徒弟直接同时拜多位师傅",师傅们不教慢动作,而是在徒弟自己的 4 步快节奏里、在徒弟实际到达的状态上纠正他。技术路线以轨迹分布匹配 TDM 为骨架:训练时学生沿一条每个训练步都随机重抽的 4 步网格做 Euler rollout;在被选中线段的内部,用两个已访问节点插值构造"监管状态"(可证明等价于精确的 Euler 子步),再做矩匹配的精确高斯再加噪得到监督点 $z_\tau$;每个 mini-batch 按其训练数据源(指令遵循/文字渲染/美学偏好)经静态查找表路由到对应的冻结专家,专家在监督点上给出 CFG 合成的速度目标;总损失为 TDM 分布匹配项加上门控的低噪速度回归项,后者由反向 KL 分解中"低噪端权重发散"的理论结果直接驱动。整个过程没有中间全步模型,一次训练同时完成能力整合与 4 步压缩。
核心创新是"阶段融合 + 按源路由 + 低噪速度监督"三件事在同一目标里的统一,本质区别在于监督发生在哪个状态分布上:串行范式中,能力整合发生在全步模型的状态分布上,步数蒸馏发生在少步 rollout 的状态分布上,两个分布并不重合,能力因此交接流失(每个全步模型压缩后都掉分);StepX-OPD 让冻结专家直接在学生当前 4 步 rollout 访问的状态上提供目标,使"学到什么能力"与"如何走 4 步轨迹"在同一组状态上耦合。路由机制保证能力不串味:一个 mini-batch 只来自一个训练源,静态查找表把它整体送给对应专家,避免多教师速度场平均造成的目标模糊(消融显示均匀平均使 OCR 从 0.8986 跌至 0.6738)。理论上,定理 A.3 把 TDM 的边际匹配与 OPD 的速度匹配放进同一个反向 KL 分解:$\mathcal{D}_{KL}(q_b\|p_b)=\mathbb{E}_T\mathcal{D}_{KL}(q_T\|p_T)+\mathbb{E}\,w_b(T)\|v_q(Z_T,T)-v_p(Z_T,T)\|^2$,其中权重 $w_b(t)=(t_i-t)\frac{1-t}{t}$ 在 $t\to 0$ 时无界增长,于是作者在低噪端额外加一个速度 MSE 回归,告诉学生"落在哪个分布"之外还要"朝哪个方向走"。
方法步骤详情
完整流程见 Alg. 1。(1) 抽取训练源 $d\in\{$GenEval, OCR, PickScore$\}$ 并取一个同源 mini-batch;前 200 步 warmup 中目标 $v_{tgt}$ 为冻结的初始学生(自蒸馏),之后由静态查找表 $r$ 把 $d$ 路由到对应专家 $v_{te}^{r(d)}$。(2) 每个训练步重抽随机 rollout 网格 $1=\sigma_0>\dots>\sigma_4=0$(段数固定、两端钉死、内部节点随机,所有并行进程共享同一抽样以保证梯度一致),学生用 Euler 更新 $z_{\sigma_{i+1}}=z_{\sigma_i}+(\sigma_{i+1}-\sigma_i)v_\theta$ 走完 4 步。(3) 均匀选一段 $[\sigma_\ell,\sigma_u]$,在其内均匀抽 $\tau_{base}$,对两端状态插值 $x_{base}=\gamma z_{start}+(1-\gamma)\,\mathrm{sg}[z_{end}]$,其中 $\gamma=\frac{\tau_{base}-\sigma_\ell}{\sigma_u-\sigma_\ell}$;$\mathrm{sg}$ 为 stop-gradient,Lemma A.1 证明 $x_{base}$ 恰是从 $z_{start}$ 出发到 $\tau_{base}$ 的精确 Euler 子步。(4) 在 $[\tau_{base},\sigma_u]$ 内抽监督时刻 $\tau$,用矩匹配的前向 SDE 转移精确再加噪:$z_\tau=\kappa x_{base}+\beta\epsilon$,其中 $\kappa=\alpha_\tau/\alpha_{\tau_{base}}$、$\beta=\sqrt{\max(\sigma_\tau^2-(\kappa\sigma_{\tau_{base}})^2,0)}$,使 $z_\tau$ 精确携带 $x_{base}$ 的条件分布。(5) 按默认 TDM 更新 fake 速度 $v_\psi$;路由专家在该点做条件/无条件两次前向并 CFG 合成目标 $v^{cfg}_{tgt}=v_{tgt}(z_\tau,\tau,\varnothing)+w[v_{tgt}(z_\tau,\tau,c)-v_{tgt}(z_\tau,\tau,\varnothing)]$。(6) TDM 项用伪 Huber 损失:$\mathcal{L}_{TDM}=\rho(z_{end}-\mathrm{sg}[z_{end}-\tau\Delta_\tau])$,其中 $\Delta_\tau=v^{cfg}_{tgt}-v_\psi(z_\tau,\tau,c)$。(7) 低噪速度回归:当训练步 $s\ge s_v=500$ 且 batch 平均时刻 $\bar{\tau}\le\tau_v=0.5$ 时,$\mathcal{L}_v=\frac{1}{N_{elt}}\sum_j\|v^{stu}_\theta(z_{\tau_j},\tau_j,c)-\mathrm{sg}[v^{cfg}_{tgt,j}]\|^2$,权重 $w_v=0.5$。(8) 总目标 $\mathcal{L}_{total}=\mathcal{L}_{TDM}(v^{cfg}_{tgt})+w_v g_v\mathcal{L}_v$。训练用 8 块 NVIDIA H800(FSDP)、全局 batch 256、rank-32 LoRA 学生与 fake 适配器,学习率分别为 $2\times 10^{-6}$ 与 $1\times 10^{-5}$,200 步优化器 warmup。
技术新颖性
与最接近工作的差异:(1) 相对 DiffusionOPD、Flow-OPD、DanceOPD,监督从全步状态分布搬到学生自己的 4 步 rollout,并把"选哪个教师"与"训练数据源"绑定——Flow-OPD 的任务路由发生在教师合并阶段,DanceOPD 虽按样本路由速度场但在全步 MSE 下进行,而本文在少步轨迹上按 mini-batch 源路由,静态查找表不需要任何进程间通信,数据并行完全友好。(2) 相对 CDM,随机网格内的监管点不是从单点速度外推,而是用两个已访问节点插值,论文证明二者计算的是同一个量(精确 Euler 子步),但插值路线不需要 rollout 之外的额外速度评估;再加噪系数由矩匹配精确导出,监管点携带的正是 rollout 的真实条件分布。(3) 相对 DMD/TDM,教师分数不再是单一固定教师,而是按源路由的 CFG 合成专家速度,并新增了由反向 KL 分解直接推导出的低噪门控速度回归。(4) 副作用量化本身也是贡献:提示词复现计数、四个提示分层、slogan/描述语域测试构成了一套可复用的测量协议。
实验结果
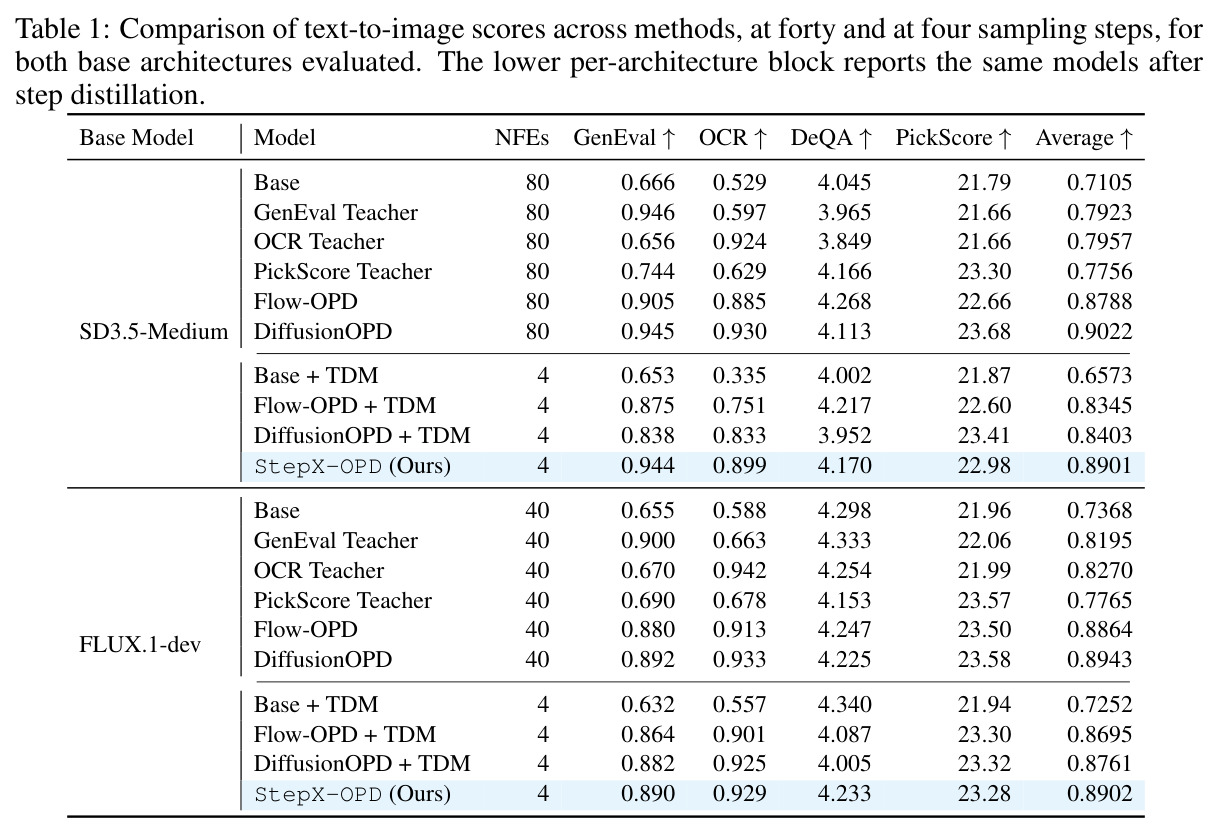
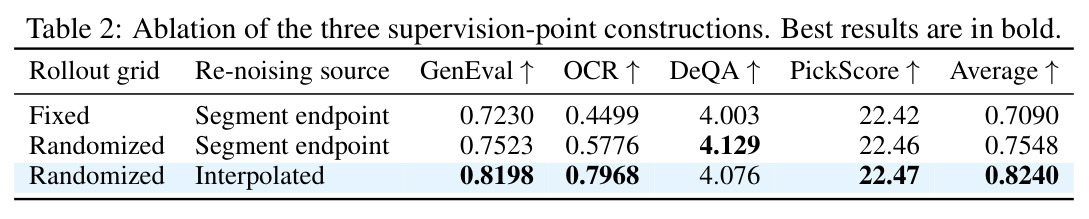
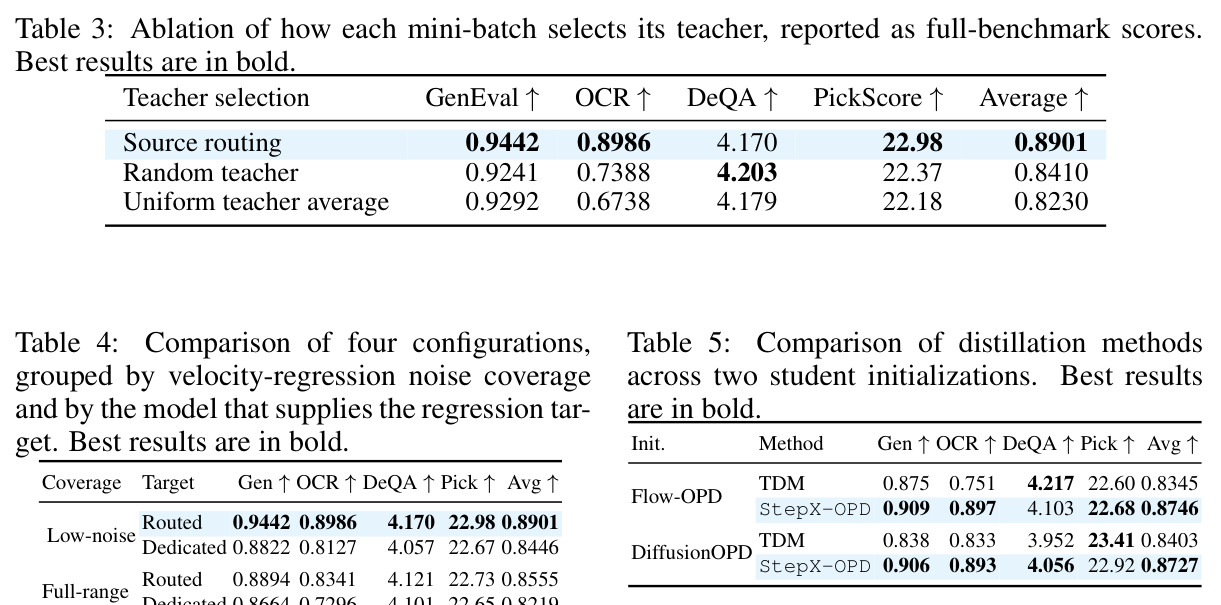
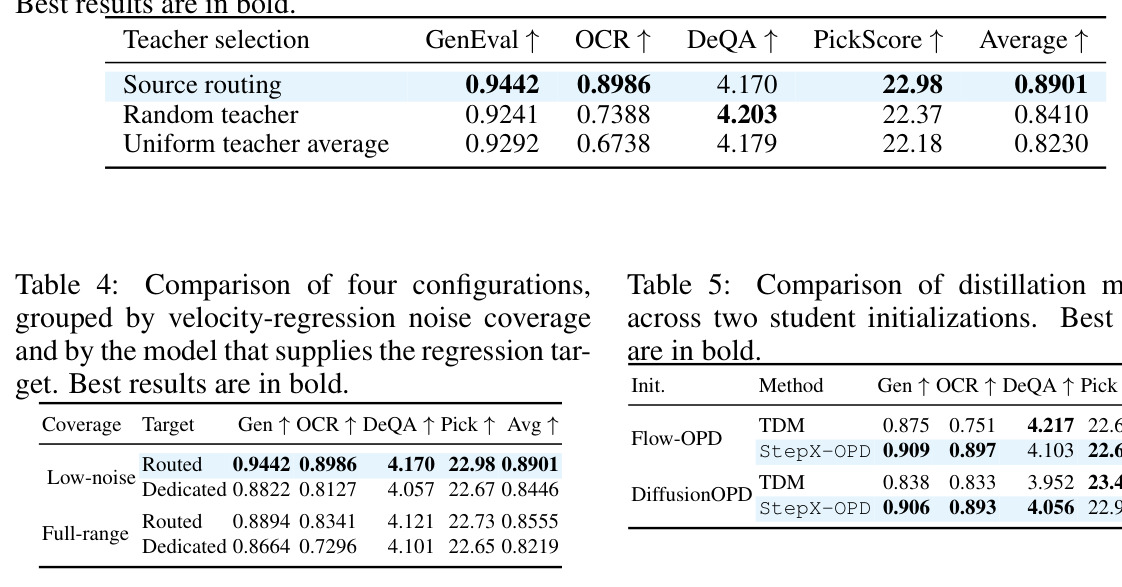
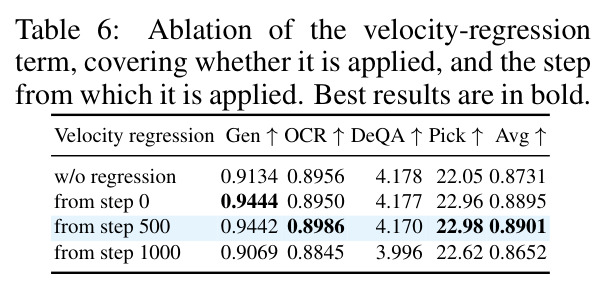
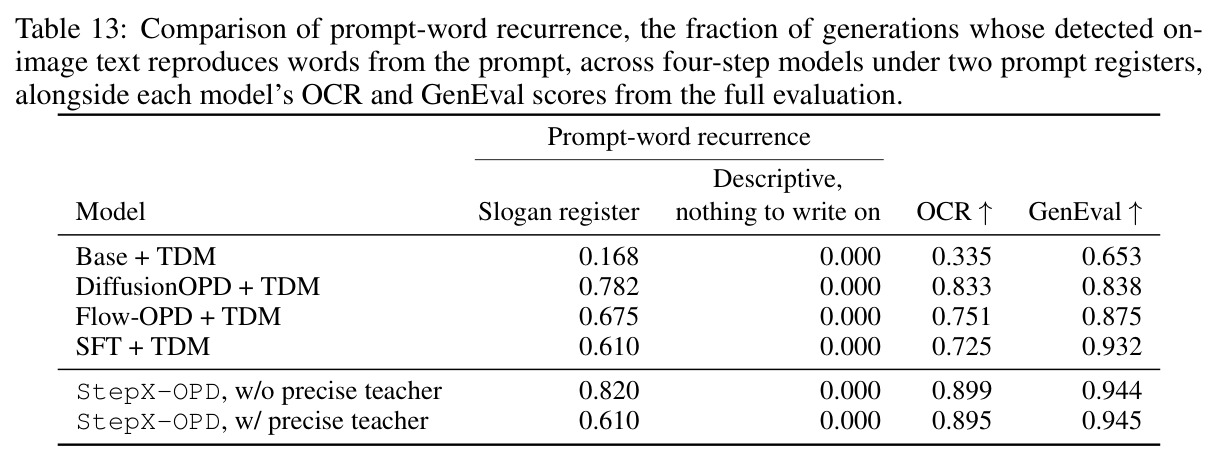
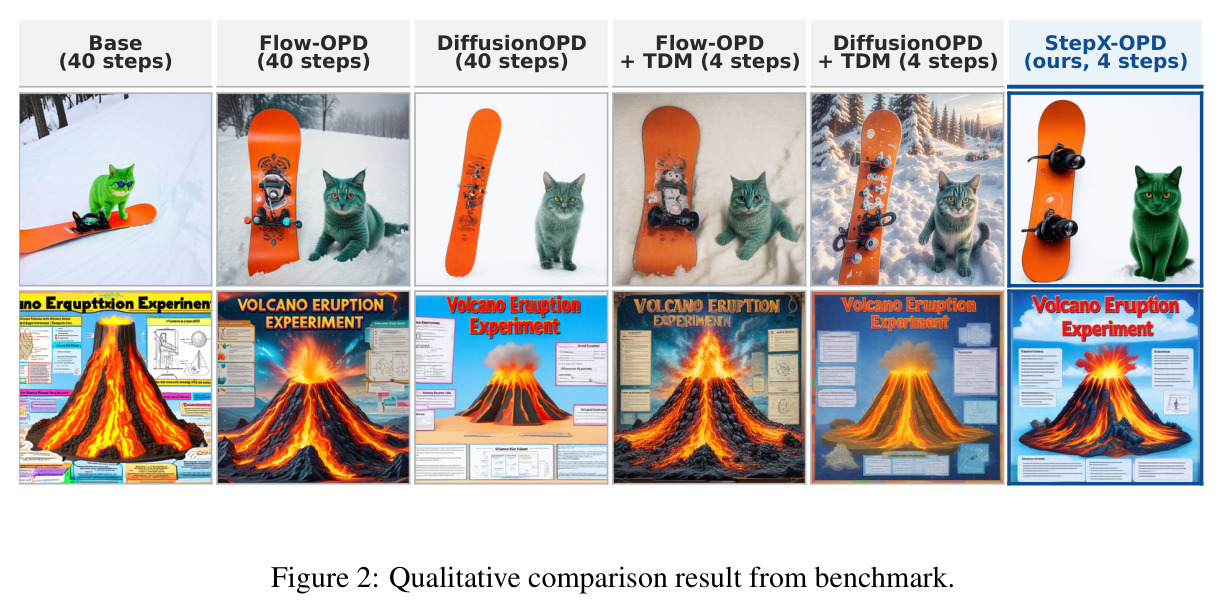
主结果(Table 1):SD3.5-Medium 上 StepX-OPD 四步 Average 为 0.8901(GenEval 0.944、OCR 0.899、DeQA 4.170、PickScore 22.98),比最好的四步串行基线 DiffusionOPD+TDM(0.8403)高 0.0498,比 Flow-OPD+TDM(0.8345)高 0.0556,并反超 40 步 Flow-OPD(0.8788),接近 40 步 DiffusionOPD(0.9022);FLUX.1-dev 上四步 Average 0.8902,高于 DiffusionOPD+TDM 的 0.8761 与 Flow-OPD+TDM 的 0.8695,也超过 40 步 Flow-OPD(0.8864),略低于 40 步 DiffusionOPD(0.8943)。Table 8 补充指标显示 SD3.5-Medium 上 StepX-OPD 的 UnifiedReward 3.894 为四步最佳,Aesthetic 5.772 略低于 DiffusionOPD+TDM 的 5.893,HPSv2.1 持平(0.307)。成本上(图 1),单阶段训练约 72.7 GPU 小时,比串行 DiffusionOPD+TDM 的约 115.7 少约 37%。消融方面:Table 2 显示监管点构造从固定网格端点→随机网格端点→随机网格插值再加噪,Average 依次为 0.7090→0.7548→0.8240,OCR 为 0.4499→0.5776→0.7968;Table 3 显示按源路由(0.8901)优于随机教师(0.8410)与三教师速度均匀平均(0.8230),OCR 差距最大(0.8986 对 0.7388 与 0.6738);Table 4 显示低噪回归用路由专家目标(0.8901)明显优于专门质量教师(0.8446),全范围覆盖(0.8555)不如低噪覆盖;Table 6 显示回归项从第 500 步开启最优(0.8901),不开启(0.8731)或第 1000 步才开启(0.8652)更差;Table 9 显示 SFT 增广初始化配 DiffusionOPD 教师为最佳组合;图 13 显示 $w_v$ 在 0 到 2 范围内 Average 仅在 0.8892-0.8908 之间波动,对该权重不敏感。副作用方面(Table 11):在"无需文字"的提示组上,SD3.5-Medium base 复现提示词 21 张、DiffusionOPD 218 张、StepX-OPD 94 张,开启精确教师后降到 84(Table 14),slogan 语域复现率从 0.820 降到 0.610(Table 13)。定性上(图 2),StepX-OPD 是六个模型中唯一正确拼出海报标题的模型。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SD3.5-Medium 四步文生图综合能力 | Average(GenEval+OCR+DeQA/5+PickScore/26) | 0.8901 | DiffusionOPD+TDM 0.8403;Flow-OPD+TDM 0.8345 | +0.0498(对次优四步基线),并超过 40 步 Flow-OPD 0.8788 |
| FLUX.1-dev 四步文生图综合能力 | Average | 0.8902 | DiffusionOPD+TDM 0.8761;Flow-OPD+TDM 0.8695 | +0.0141,并超过 40 步 Flow-OPD 0.8864 |
| 提示词遵循(SD3.5-Medium,4 步) | GenEval | 0.944 | DiffusionOPD+TDM 0.838;Base+TDM 0.653 | +0.106,与 40 步 DiffusionOPD 的 0.945 持平 |
| 文字渲染(SD3.5-Medium,4 步) | OCR 准确率(PaddleOCR 归一化匹配) | 0.899 | DiffusionOPD+TDM 0.833;Flow-OPD+TDM 0.751 | +0.066 |
| 训练成本(SD3.5-Medium) | GPU 小时 | 约 72.7 | 串行 DiffusionOPD+TDM 约 115.7 | 约减少 37% |
| 非文字提示的提示词复现(4 步,slogan 语域) | 复现率(占比) | 0.820;开精确教师后 0.610 | DiffusionOPD+TDM 0.782;SFT+TDM 0.610 | 开精确教师后与最优基线持平,但不开则高于基线 |
局限与改进
作者承认的:精确教师只是缓解而非根治提示词复现——"无需文字"组的复现数仍从 base 的 21 涨到 94,精确教师仅降到 84;slogan 语域上即便开启精确教师也有 0.610 的复现率;该变体还带来每步 4.33 秒、约 4.8% 的额外训练开销。FLUX.1-dev 上未追平 40 步 DiffusionOPD(0.8902 对 0.8943)。评估只在 512×512 分辨率与 4 步设置下进行。我的补充观察:理论分解依赖较强假设(A3 的教师一致性把含 CFG 的教师场直接当作分布诱导速度场 $v_p$,以及 $R_b=0$ 的自洽假设),实际训练中这些条件只近似成立;方法依赖前作公开发布的专家适配器(DiffusionOPD、Flow-OPD、Flow-GRPO 教师),能力集合受制于可得教师;Average 的归一化(PickScore 除以 26、DeQA 除以 5)与图 1 的轴归一化会掩盖单项指标的绝对水平;提示词复现的判定规则(相邻内容词对或 6 字符连续子串)可能漏掉改写或乱码文本;40 步与 4 步模型使用不同引导尺度(4.5 对 1.0),"压缩损耗"的测量混合了引导强度差异;论文未报告多随机种子的方差。
独立分析的弱点
(1) 教师生态封闭且静态:路由表只覆盖 GenEval/OCR/PickScore 三个源,新增能力(如中文文字渲染、风格控制)需要训练新专家适配器并重新设计初始化 soup,改进方向是学习式软路由(由学生状态预测专家混合权重)或对专家增量做持续合并。(2) 提示词复现的治理是补丁式的:精确教师对短 rollout 上的引导速度取平均,只把 slogan 复现率从 0.820 压到 0.610,且根因(OCR 奖励与能力整合的相互作用)未被解释;改进方向是把复现率作为正则项直接进损失(训练时用 OCR 检测器惩罚检测结果与提示词的重叠),或构造显式的"无文字"负例训练源。(3) 优化稳定性对调度敏感:速度回归从第 0 步与第 500 步开启结果接近(0.8895 对 0.8901),但第 1000 步才开启掉到 0.8652;源采样比例在 fresh-LoRA 与 merged-init 两种学生下最优值相反(1:2:1 对 1:1:1),说明超参之间存在复杂耦合,改进方向是自适应损失加权与按验证分数的源重加权。(4) 只验证了 4 步与 512×512:更激进的 1-2 步学生、更高分辨率、视频扩散上的有效性未知,可在 DMD2 式单步设置与多分辨率数据上复测。(5) Average 的轴归一化使跨方法比较依赖指标选择,缺少人类评估与更细粒度的失败模式分析。
未来方向
作者方向:把精确教师目标以更低成本集成(如缓存平均速度或将其蒸馏为单次前向);进一步压低提示词复现,弄清 OCR 奖励与复现行为之间的因果链;在更多骨干模型上验证阶段融合的普适性。基于其成果可延伸的:把静态源路由升级为对状态的软路由/门控混合专家,统一 DanceOPD 的逐样本路由与本文的逐 batch 路由;把该框架与强化学习后训练(Flow-GRPO 教师,Table 9 已初步验证)组合,实现"少步 + 偏好对齐"一步到位;将反向 KL 分解推广到含对抗损失(DMD2)或矩匹配(MM)的目标族,为更多蒸馏损失提供统一的权重结构解释;研究复现现象在其他能力(非 OCR 奖励)整合下是否同样出现;并扩展到视频生成的时间步蒸馏。
复现评估
论文给出 GitHub、HuggingFace 与项目页链接(正文为占位,实际开放程度需确认);学生与 fake 网络均为 rank-32 LoRA,冻结专家直接复用 DiffusionOPD 等前作公开发布的适配器,训练提示集沿用 Flow-GRPO/DiffusionOPD 的划分,评测协议完全公开(GenEval 官方检测器、PaddleOCR 归一化匹配、PickScore 除以 26、Average 公式,以及各基准图像数量:GenEval 8848、OCR 4072、PickScore 8192、DeQA 等 750 张)。算力门槛中等:8 块 H800、全局 batch 256、约 72.7 GPU 小时,单节点一天内可完成,但对没有 H800 级集群的团队仍不轻;理论部分(附录 A)只依赖高斯核运算与广义 de Bruijn 恒等式,易于核验。总体复现难度中等偏上:关键是拿到三个冻结专家适配器、复刻随机网格的多进程一致性以及伪 Huber 的 TDM 项实现;若只想验证消融趋势,LoRA 加单节点多卡即可。
论文图表
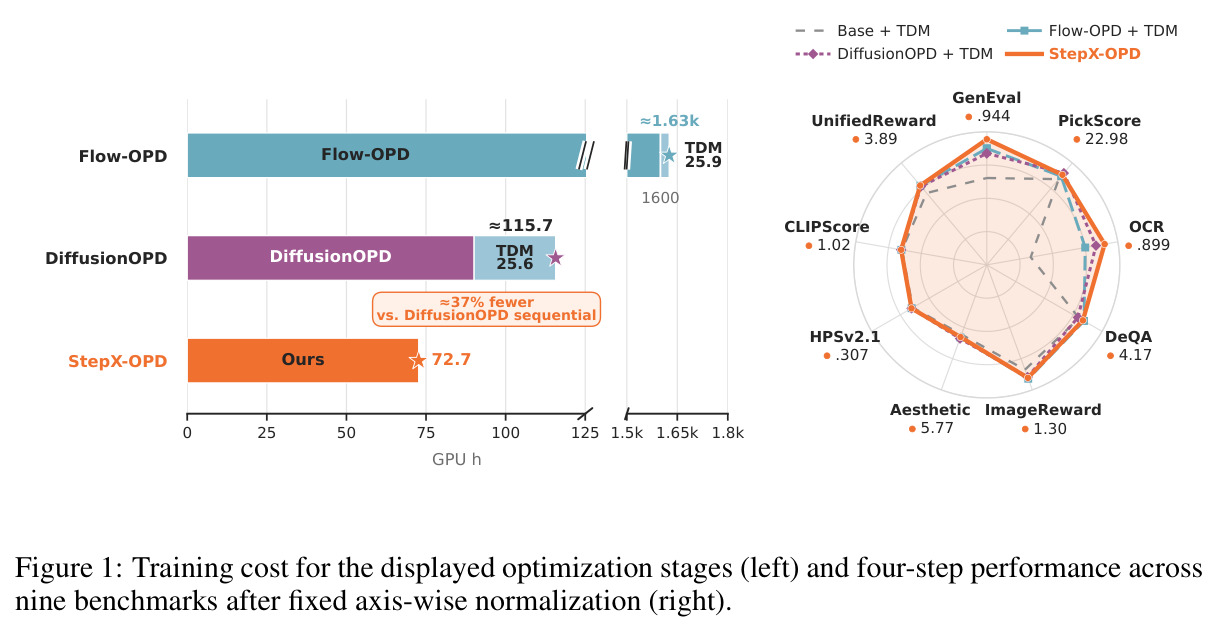
左图对比各优化阶段的训练成本:Flow-OPD 阶段约 1.63k GPU 小时(含单奖励 GRPO 专家训练),其后 TDM 阶段 25.9 小时;DiffusionOPD 加 TDM 25.6 共约 115.7 小时;StepX-OPD 单阶段仅约 72.7 小时,相比串行 DiffusionOPD 流水线少约 37%。右图是四个四步模型在九个基准上的轴归一化表现,StepX-OPD 综合最高。
一张图同时给出"串行两阶段更贵"与"单阶段四步更强"这两个核心论点,是合并两阶段这一主张的最直接证据。