Reviso:并非所有视觉证据都值得同等关注——优先级引导的主动式视频描述框架 Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
构建上下文-焦点-观测点计划,让模型学会先判断该看什么再主动取证的视频描述框架
前置知识
视频描述
视频描述要求模型把一段视频的视觉内容转写成自然语言。与图像描述不同,视频有时间维度,涉及动作顺序、事件因果和状态变化,主流做法是把视频均匀采样成帧序列后送入多模态大模型。评测常用原子事实分解:把参考描述和生成描述各自拆成不可再分的事实单元,再计算精确率与召回率。
本文的核心评测指标(DREAM-1K、MCTS-VCB 的 P/R/F1)全部建立在事实级匹配之上,理解这套评测方式才能读懂实验表格。
主动感知与视频智能体
传统视频模型一次性看完所有采样帧就直接作答;主动感知则让模型像人一样多轮观察:先粗看全局,判断哪里重要,再带着目标回头细看特定片段或调用工具(高帧率重访、裁剪、OCR)。每轮观察结果会更新模型对任务的理解,形成「计划-观察-更新」的闭环。
Reviso 整个推理流程就是这种闭环,它的独特之处是把闭环用在了没有外部提问的开放式描述任务上。
GRPO(组相对策略优化)
一种在线强化学习算法:对同一输入采样一组轨迹,用组内奖励的相对优势代替价值网络来估计基线,省去 critic 模型。它常与可验证奖励结合,用来训练大语言模型的推理与工具调用行为,是 DeepSeek-R1 等工作的核心训练手段。
Reviso 的第二阶段训练就是 GRPO,并为其量身设计了三个奖励(KFR/PAR/UTCP),这是本文方法层最重要的贡献之一。
事实原子分解与 F1 匹配
把一条描述拆成最小语义单元,例如「厨师把番茄切片」可拆出主体、动作、对象。两句话各拆成事实集合后做一对一语义匹配:精确率衡量生成事实中多少站得住,召回率衡量参考事实覆盖了多少,F1 综合二者,天然抑制幻觉与漏报。
论文的 KFR 和 PAR 两个奖励都直接建立在这套匹配机制上,是读懂奖励设计公式 $R_{KFR} = F_1(\hat{F}(c), F_V)$ 的前提。
SFT 与 LoRA 微调
监督微调(SFT)用人工构造的高质量轨迹直接教模型学会输出格式与操作流程;LoRA 冻结原始权重、只训练低秩增量矩阵,大幅降低显存与算力需求,适合在 9B 级模型上做完整流程的行为克隆。
Reviso 先用 LoRA 在约 1 万条验证过的教师轨迹上做 SFT 打底,再用 GRPO 强化(视觉编码器冻结、其余参数全量更新),两阶段缺一不可。
研究动机
当前多模态大模型虽然能生成越来越详细的视频描述,但详细并不等于关键信息覆盖。论文观察到,模型经常把注意力花在次要细节上却遗漏关键事件与全局语境,在含复杂动作序列、细微交互或细粒度视觉线索的视频上尤其严重——案例中 Qwen3.5-9B 把篮球视频里球员的口部动作误读成「庆祝胜利」,实际上比赛还剩 1 分 45 秒。更麻烦的是,单纯增加均匀采样的帧率并不能稳定解决问题:在 DREAM-1K 上把采样率从 2 FPS 提到 10 FPS,Qwen3.5-9B 和 GPT-6 Astra 的 F1 反而下降,只有 Molmo2-8B、Qwen3.8-27B 等少数模型持续受益。已有的智能体方法要么面向有明确问题的问答任务(如 VideoAgent、VideoTree、VideoZoomer),要么只从最终描述学习而不学观测过程本身(如 Omni-Detective),开放式描述场景下「该看什么、怎么看」仍是空白。
本文的目标是论文的目标是让视频描述模型学会两件事:一是识别每条视频中真正重要的信息,把重要性判断转化为具体的观测目标;二是掌握主动取证能力,选择合适的时间片段、帧率和工具(高帧率重访、图像裁剪、OCR 等)去验证和补全这些目标,最终把全局语境与局部证据融合成事实准确的字幕。作者希望这一「优先级引导的主动观测」策略被显式训练出来而不是靠提示词启发,并在固定帧预算(所有方法统一最多 128 帧)下超越均匀采样的直接描述方式,同时让生成的字幕在下游视频问答中更有用。
与已有工作不同的是,论文的独特切入是把开放式视频描述重新表述为一个自驱动的主动感知问题:没有外部提问时,模型必须自己判断「什么值得看」。为此作者提出层次化的 Context–Focus–Points(CFP)观测计划——先识别场景语境,再按语境排出观测重点,最后把重点落实为带工具的具体观测点,并随证据积累动态更新计划。与以往工作最关键的差别在学习信号的来源:Reviso 不仅用最终字幕做奖励,还通过验证引导的流水线保留完整的「计划→工具调用→证据→字幕」轨迹做监督,并专门设计奖励去嘉奖「初始计划找对了观测目标」,这是已有描述方法或视频智能体都没有覆盖的维度。
核心方法
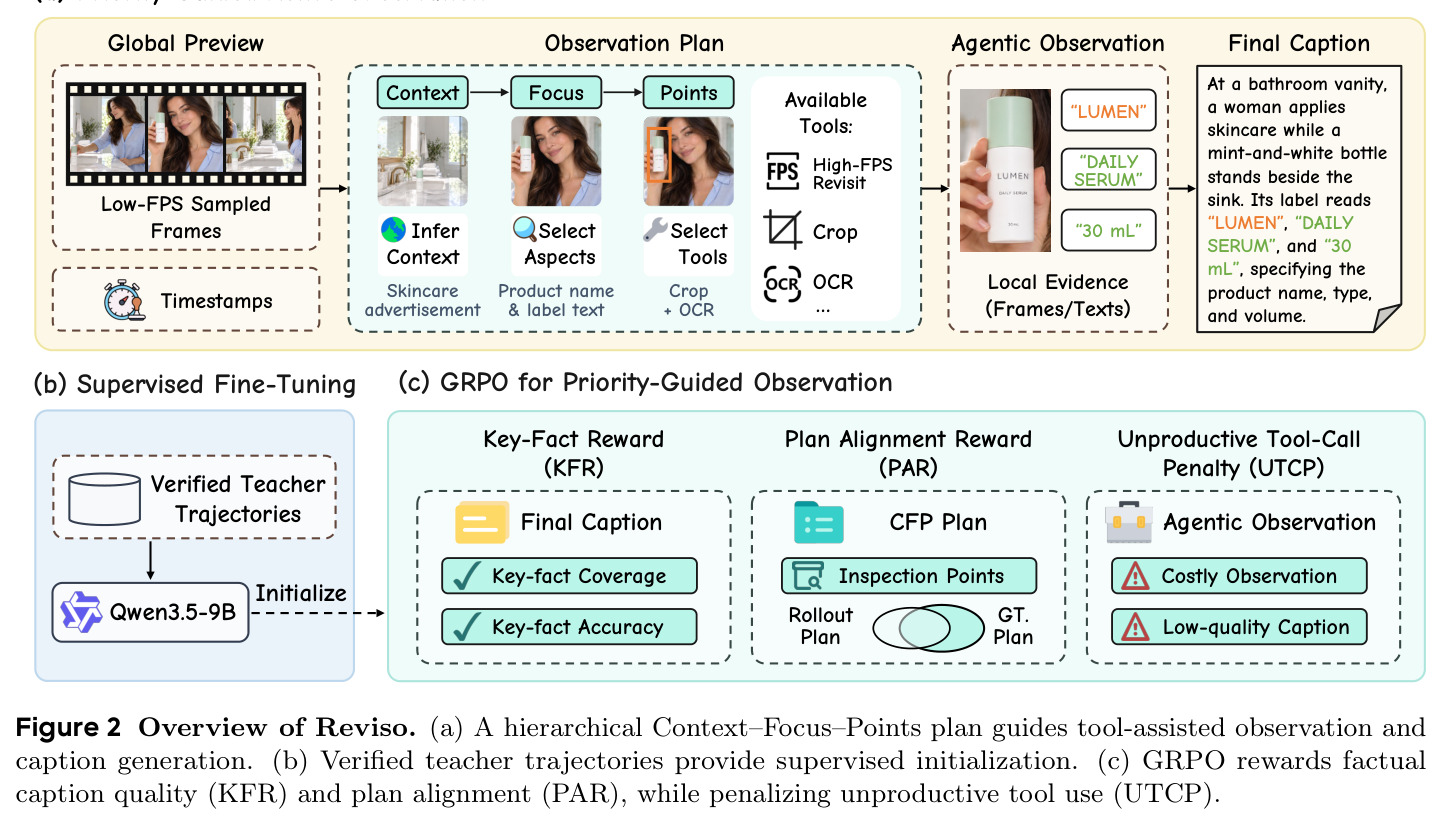
Reviso 的整体思路是「先规划、再取证、后成文」,像侦探办案而不是流水线读帧。推理时模型先以低帧率浏览全片获得全局预览,据此生成层次化 CFP 观测计划:Context 层识别场景类型与主要活动,Focus 层按语境排出优先关注的方面(教学视频看动作顺序、广告看产品名与标签文字、体育看比分与比赛状态),Points 层把每个重点翻译成带工具的具体观测点。随后模型多轮执行「选目标→调工具→解读证据→更新计划」的循环,用高帧率重访、裁剪、OCR 收集局部证据,最后融合全局语境与局部证据生成字幕。训练分两阶段:先用验证引导流水线构造 1 万条通过事实校验的教师轨迹做 LoRA SFT(2 个 epoch),再在 2 万条无重叠样本上跑 200 步 GRPO,总奖励为 $R(\tau_i; G) = \alpha R_{KFR}(\tau_i) + \beta R_{PAR}(\tau_i) - \mu P_{UTCP}(\tau_i; G)$,分别约束字幕事实质量、计划对齐与观测成本。
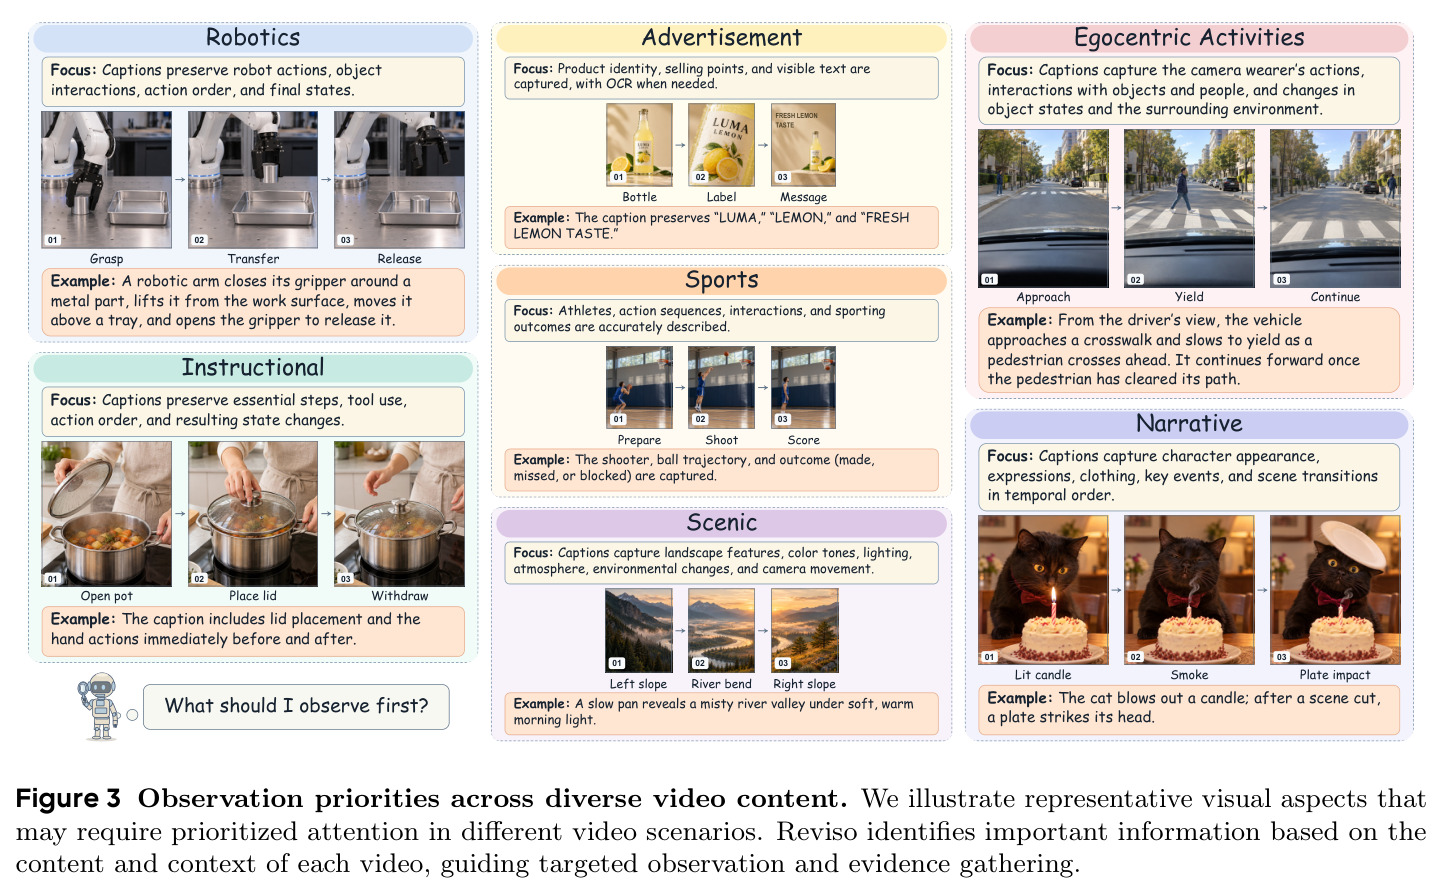
核心创新是把「看什么」变成可训练的目标。论文主张并非所有视觉证据都值得同等关注,重要信息高度依赖视频内容与语境:烹饪教程优先看手部动作及顺序,影视剧看人物表情与服装,广告看产品名和标签文字(需要 OCR),体育看比分与比赛状态。为此 Reviso 用 CFP 计划显式建模这一优先级,并设计两个针对性奖励:Plan Alignment Reward 把初始计划中提取的观测目标集合 $P(p_0)$ 与参考观测目标集合 $U_V$(全局预览无法解答、但明确需要进一步检查的关键信息)做一对一语义匹配,用 $R_{PAR} = F_1(P(p_0), U_V)$ 直接奖励「计划找得准」;Unproductive Tool-Call Penalty 只在组内至少一条轨迹的 KFR 达到阈值 $\tau_q$ 时才激活,惩罚量 $P_{UTCP} = g(G)\,(1 - R_{KFR})\,b_i$ 满足「同成本下质量越低罚越重、同质量下成本越高罚越重」,既压制乱调工具刷分又保留探索空间。
方法步骤详情
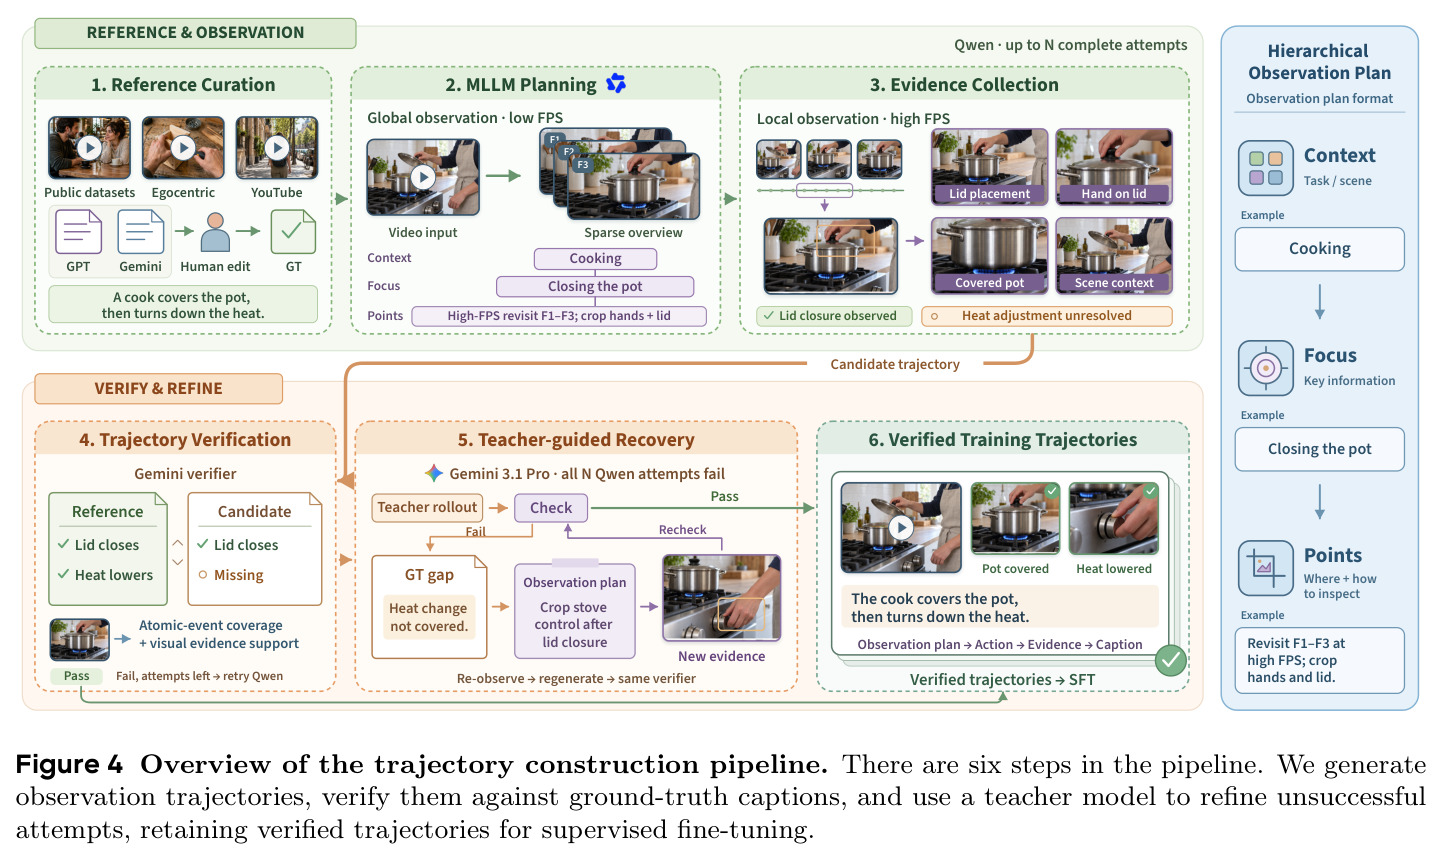
数据流水线分六步:(1) 参考字幕策展——从 LLaVA-Video-178K、Vript、Ego4D 和 YouTube 收集视频与描述,用 GPT-6 Astra 和 Gemini 3.1 Pro 生成候选,人工合并纠错成真值字幕;(2) 学生规划观测——Qwen3.8-27B 看低帧率预览生成 CFP 计划,按计划高帧率重访、裁剪、OCR 产出候选轨迹;(3) 轨迹验证——Gemini 3.1 Pro 把真值与候选字幕拆成原子事实,核对一致性、覆盖率及证据支撑;(4) 失败重试——Qwen3.8-27B 重跑完整流程,每个视频最多 N 次;(5) 教师补救——全败后 Gemini 3.1 Pro 亲自生成,仍失败则按验证反馈修订计划再生成;(6) 保留通过验证的轨迹(计划、工具动作、证据、字幕)共 1 万条做 SFT,另备 2 万条无重叠视频做 GRPO。训练先 LoRA SFT 两个 epoch,再 GRPO 200 步在线采样,视觉编码器冻结、其余参数全量更新,组内算相对优势后更新策略。
技术新颖性
技术新颖性体现在三个层面。学习信号上,已有视频智能体(Omni-Detective、OmniFysics-Agent)只用最终描述训练 captioner,Reviso 首次把经过事实验证的完整观测轨迹(计划、工具调用、中间解读、计划更新)作为 SFT 监督,让模型学会观测行为本身;奖励设计上,KFR 与 CapRL++/CuRe 的事实奖励同源,但 PAR 把奖励信号前移到工具执行之前的计划阶段,直接奖励「提出正确的观测目标」,而 UTCP 的组级门控——只有组内存在达标轨迹才启用成本惩罚——是成本控制与探索保留之间的优雅折中;流程上,「学生重试+教师补救+反馈修订」的验证闭环保证每条训练轨迹同时满足事实正确、覆盖完整、证据支撑三项约束,比单纯蒸馏教师输出更可靠。消融也支持这一判断:去掉 PAR 后 CaReBench 物体 F1 从 33.9 跌到 29.7(掉 4.2 点),是三个奖励中影响最大的一个。
实验结果
四个描述基准上 Reviso(骨干 Qwen3.5-9B)均为开源最佳:DREAM-1K 精度 42.3,F1 39.5 较骨干 35.1 提升 4.4 点;MCTS-VCB 提升最大,F1 60.9 超骨干 15.4 点;CaReBench 动作/物体 F1 34.3/33.9,超骨干 9.1 和 6.7 点;VDC TP 分 2.95。消融:SFT-only 把指标从 35.1/25.2/27.2 提至 37.6/30.7/30.1,去工具变体(35.3/24.8/27.4)几乎退回基线,证明收益来自主动观测;完整 GRPO 达 39.5/34.3/33.9,去 PAR 损失最大(物体 F1 掉 4.2 点)。Caption-to-QA 仅凭字幕答题,Reviso 在 LVBench 得 52.0(+4.9)、MMVU 72.7(+2.1),四项全最佳。工具增益随视频变长而增大,24–27 秒组约 10 个百分点;10 FPS 均匀采样使部分模型反而下降,Reviso 的 39.5 超过所有直接采样配置;案例中靠记分牌 OCR 纠正骨干的「庆祝胜利」误读。
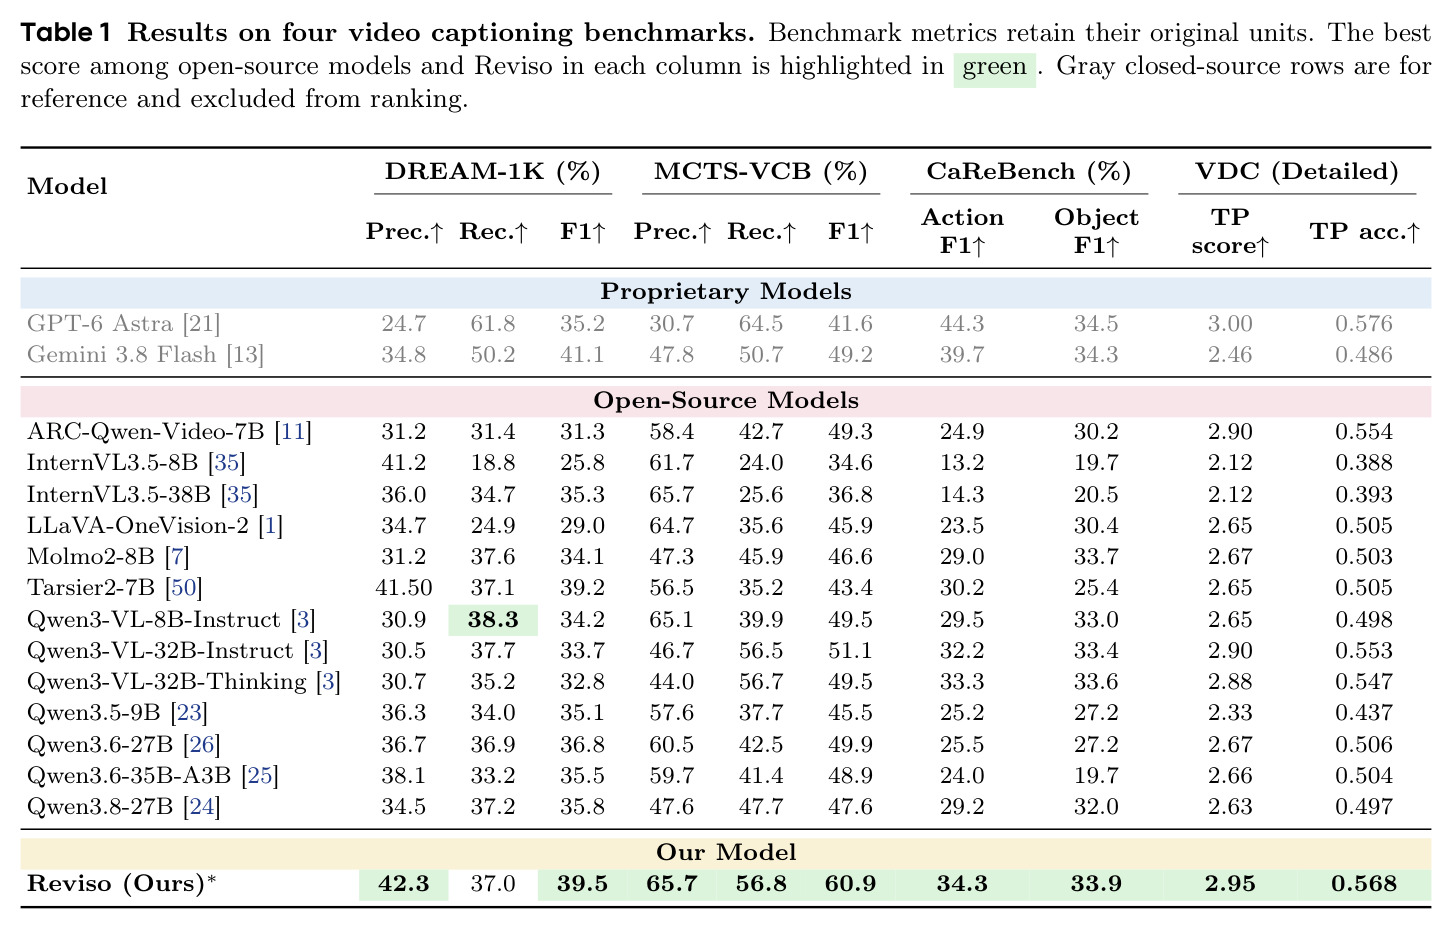
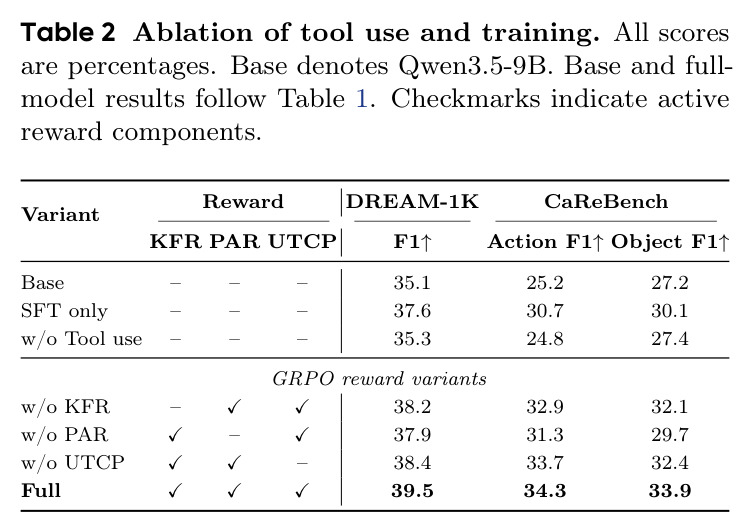
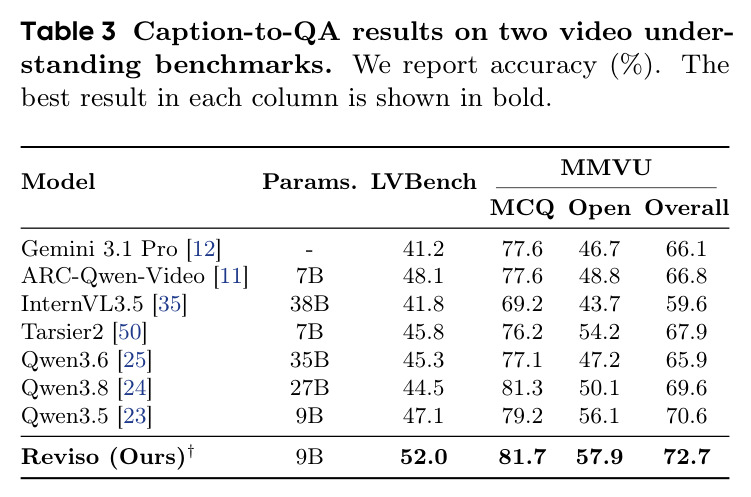
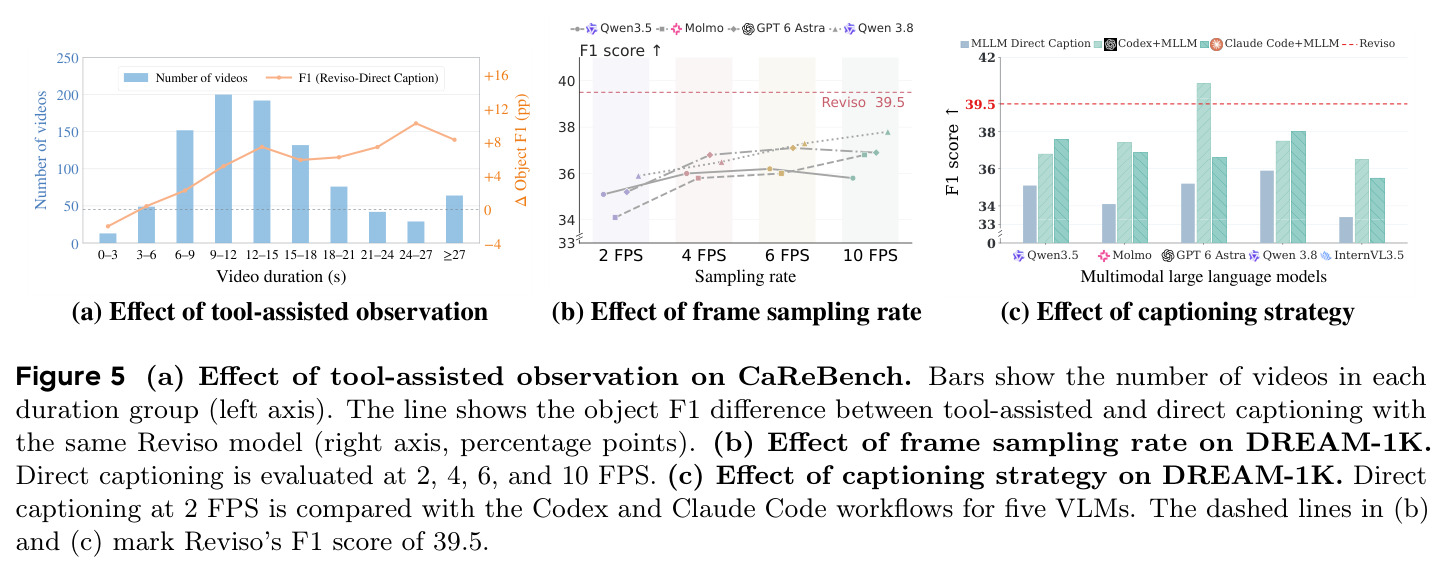
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 视频描述 DREAM-1K | F1 (%) | 39.5 | Qwen3.5-9B 骨干 35.1 | +4.4 个百分点 |
| 视频描述 MCTS-VCB | F1 (%) | 60.9 | Qwen3.5-9B 骨干 45.5 | +15.4 个百分点 |
| 细粒度描述 CaReBench | Action F1 (%) | 34.3 | Qwen3.5-9B 骨干 25.2 | +9.1 个百分点 |
| 细粒度描述 CaReBench | Object F1 (%) | 33.9 | Qwen3.5-9B 骨干 27.2 | +6.7 个百分点 |
| 详细描述 VDC (Detailed) | TP score / TP acc. | 2.95 / 0.568 | Qwen3.5-9B 2.33 / 0.437 | +0.62 / +0.131 |
| 字幕驱动问答 LVBench | 准确率 (%) | 52.0 | Qwen3.5-9B 47.1 | +4.9 个百分点 |
| 字幕驱动问答 MMVU | Overall 准确率 (%) | 72.7 | Qwen3.5-9B 70.6 | +2.1 个百分点 |
局限与改进
作者承认或可以合理推断的局限:其一,训练成本不对称——流水线依赖 GPT-6 Astra、Gemini 3.1 Pro 等闭源旗舰做教师和验证器,还需要人工标注真值字幕,普通团队难以复刻;其二,推理时多轮工具调用带来额外延迟,论文虽用 UTCP 约束成本,但未报告与直接描述相比的延迟和平均调用次数统计;其三,帧预算固定 128 帧,分析实验中视频按秒分组最长约 27 秒,分钟级以上长视频和流式场景未验证;其四,PAR 需要构造参考观测目标集合 $U_V$,这一监督信号完全来自同一条数据流水线,质量上限受教师与验证器能力约束;其五,结果只在 9B 骨干上报告,观测策略能否迁移到更大或更小模型未探讨。我自己的观察:Caption-to-QA 用 Gemini 3.1 Pro 读字幕答题,评分器与训练教师同源,可能存在有利偏差;事实 F1 奖励也不直接衡量时序因果与语言流畅性,模型可能写出事实正确但叙述生硬的字幕。
独立分析的弱点
独立分析几处弱点:(1) UTCP 的组级门控依赖「组内至少一条轨迹 $R_{KFR} \geq \tau_q$」,但阈值 $\tau_q$ 的取值方法、对极难样本(所有轨迹都达不到阈值、惩罚永不激活)的适用性没有讨论,改进方向是让阈值随视频难度自适应;(2) 三个奖励都建立在「语义匹配的事实分解」上,匹配本身应由 LLM 完成,奖励噪声会直接传入策略梯度,论文未做匹配器一致性分析,可引入多匹配器集成或人工抽检校准;(3) 工具集合固定为重访/裁剪/OCR,缺乏音频转录、跨镜头目标追踪等手段,对以声音为主导的内容(演唱会、访谈)可能失效;(4) 验证器与教师同为 Gemini 3.1 Pro,验证偏差可能让学生学到教师偏好而非客观事实,改进方向是异构验证器交叉验证;(5) 计划更新机制只有定性描述,缺少「计划更新次数与最终质量」的定量分析,可把计划编辑显式建模为结构化可学习动作并单独奖励。
未来方向
作者展望与可延伸方向:作者强调优先级引导主动观测范式的潜力,暗示可推广到更广的视频理解任务。自然的延伸包括:(1) 把观测策略蒸馏到更小模型,或与骨干预训练联合训练以摊薄推理成本;(2) 用开源大模型集成自举替代闭源教师,消除验证偏差并降低成本;(3) 扩展到分钟级长视频与流式描述,需要引入记忆机制和增量式计划更新;(4) 把 CFP 计划作为中间表示喂给视频生成模型,构造可控的文生视频条件;(5) 工具面扩展到音频转录、目标跟踪、深度估计乃至外部知识检索;(6) 奖励设计上加入时序因果一致性奖励和「每条事实必须绑定支撑证据」的归因约束,进一步压制幻觉;(7) 探索观测策略的跨任务迁移——视频问答、异常检测、具身导航都可能复用「先排优先级再取证」的框架。
复现评估
复现难度中等偏上。论文未提及开源代码或数据。可复用的公开部分:骨干 Qwen3.5-9B、数据源(LLaVA-Video-178K、Vript、Ego4D)、四个评测基准(DREAM-1K、MCTS-VCB、CaReBench、VDC)和下游问答基准(LVBench、MMVU)。难以复刻的部分:(1) 人工标注的真值字幕(GPT/Gemini 生成加人工编辑);(2) 轨迹构造需要 GPT-6 Astra 与 Gemini 3.1 Pro 的 API 预算,1 万条验证轨迹外加失败重试与教师补救,调用量可观;(3) GRPO 需要在 9B 模型上在线采样轨迹组并维护工具环境(裁剪、OCR、重访),工程复杂度高,估计需要多卡 A100 级别训练数天。复现建议:先小规模构造轨迹验证 SFT 收益(Table 2 显示 SFT-only 已有约 +2.5 F1),再逐步叠加 RL;工具环境可自行实现,论文描述足够具体。
论文图表
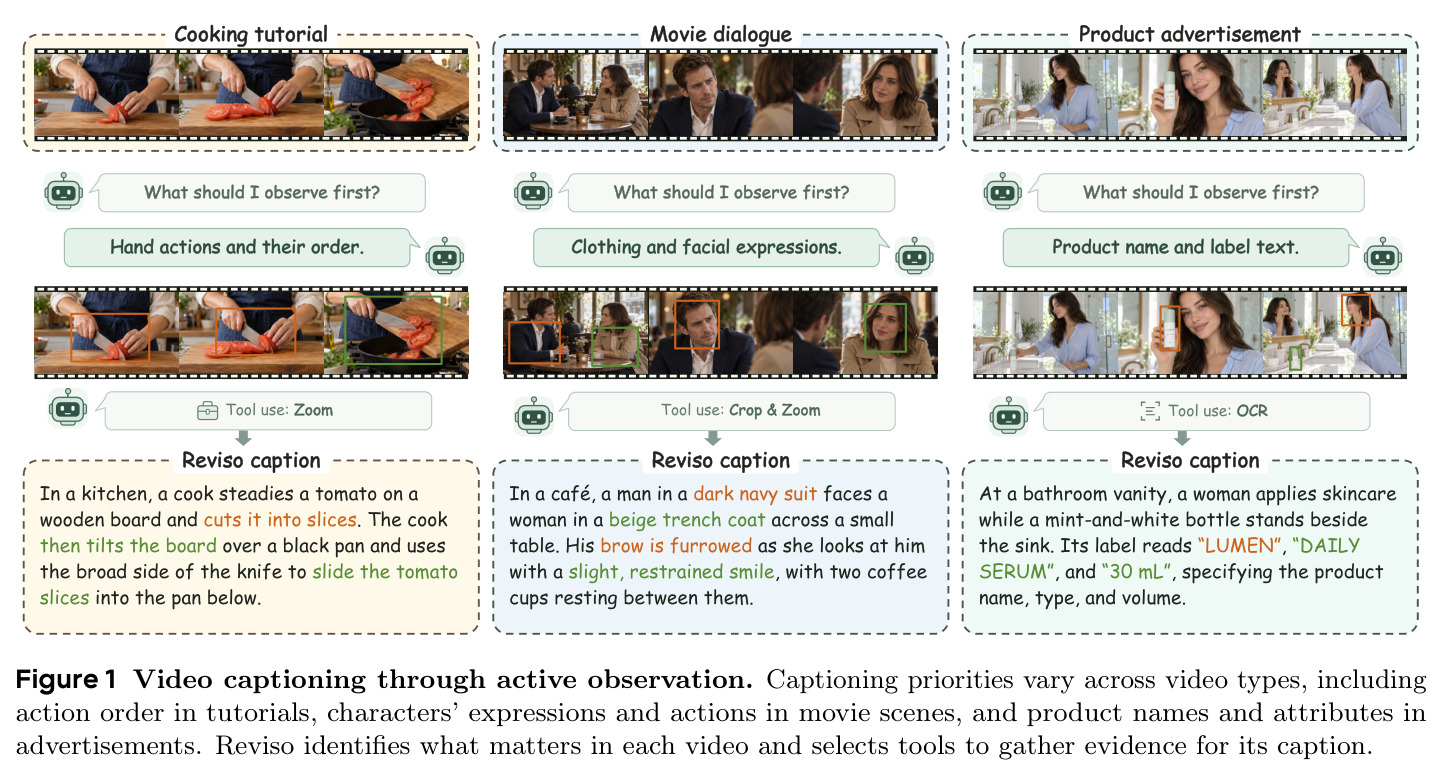
用烹饪教程、电影对白、产品广告三类视频展示「观测优先级因内容而异」:教程先看手部动作及顺序(用放大工具),影视剧看服装与表情(裁剪加放大),广告则用 OCR 读出瓶身标签「LUMEN」「DAILY SERUM」「30 mL」,每列都给出 Reviso 据此生成的字幕示例。
一图点明论文的核心论点——不是所有视觉证据都值得同等关注,重要性取决于视频类型,这是全文动机的直观版本。
篮球视频案例对比:Qwen3.5-9B 误写球员「庆祝赢得比赛」;Reviso 先重访 2.069–3.504 秒片段确认进球有效,再在 3.000–5.038 秒对记分牌裁剪加 OCR,得到 DEN 得分 71→74、74–72 领先、第四节剩 1:45 的证据,最终字幕准确描述「比赛仍在进行」。图中用红/绿/蓝标注错误事实、核心正确事实与细粒度细节。
具体展示「规划→取证→证据支撑的字幕」如何消除幻觉,是理解方法实际工作方式的最佳案例。