PhotoGuider:构图感知的图像裁剪与 360° 取景及可解释摄影评估 PhotoGuider: Composition-Aware Cropping and 360^{circ} View Framing with Explainable Photographic Assessments
四个可解释摄影令牌统一驱动360°方向选择、裁剪排序、门控精修与量化解释
前置知识
mIoU 与 BDE(裁剪评价指标)
mIoU(平均交并比)衡量算法裁剪框与人工标注框的重叠程度:IoU 等于两框交集面积除以并集面积,对所有测试图取平均,越接近 1 越好。BDE(边界位移误差)计算预测框四条边与参考框对应边的平均像素距离,对边缘对齐更敏感,越低越好。两者互补:IoU 看整体重合,BDE 看边界精度。
本文在 FCDB/FLMS 上的全部量化对比、消融表格都以这两个指标报告,是读懂实验部分的前提。
视觉基础模型(SAM / DINOv3 / CLIP 等)
SAM 是可提示分割大模型,把图像切成对象级掩码;DINOv3 是自监督 ViT,其注意力图天然指向视觉焦点;InSPyReNet 提供显著性主体轮廓;CLIP 靠图文对齐把「三分法构图」「引导线」等自然语言变成可计算相似度;LAION 与 FGAesQ 是两个学习型美学评分器。本文用这六个模型提取 60 维特征。
四个摄影令牌的全部特征都来自这些模型,理解各自分工才能理解令牌定义与失效场景。
LightGBM 与梯度提升树
LightGBM 是基于决策树的梯度提升框架,在中小规模表格数据上常优于深度网络,训练快、参数少,支持回归与 LambdaRank 排序目标,还能做保形(isotonic)概率校准。树模型配合 TreeSHAP 可精确分解每个特征对预测的贡献。
本文排序器与六道精修门控全部由 LightGBM 实现,整个决策层仅约 6.3 万参数,这是其可解释性与防过拟合主张的技术基础。
TreeSHAP 特征归因
SHAP 值把一次预测的输出分解为各特征的加性贡献,满足 $\sum_j \phi_j = f(x) - \mathbb{E}[f]$;TreeSHAP 利用树结构在多项式时间内精确计算。本文把 60 维特征按四个令牌分组,把特征级归因聚合为 S/C/I/A 四个令牌分数,并映射为相对训练参考分布的百分位。
论文里「每个令牌得分」与解释中引用的归因列表都来自 TreeSHAP 分解,是整个解释机制能被核对的数学核心。
行列式点过程(DPP)
DPP 是从候选集中抽取「既高质量又互相多样」子集的概率模型:核矩阵的行列式同时编码子集质量与两两相似度,行列式越大表示候选整体越强且彼此不相似,通常用贪心 MAP 近似求解。本文的质量项 $q_{dpp}(c) = q_{LGBM}(c) + \lambda_{vs} s_{sal}(c)\cdot\max(0, 1-\lambda_a\log\frac{asp(c)}{asp^*})$ 还惩罚宽高比偏离。
本文用它从约 300 个候选框中选 10 个进入排序,避免候选全部挤在同一主体附近,直接影响排序质量。
研究动机
传统图像裁剪有一个隐含假设:值得保留的构图已经在照片里,算法只需回答「在哪里裁」。但在 360° 全景场景中这个前提不成立——取景方向本身是必须先解决的决策:先决定朝哪里看,才有画面可裁。现有 2D 裁剪方法(端到端回归、生成-排序、MLLM 裁剪器)都以预先拍好的照片为输入,目标函数固定,打分证据难以检查;而 MLLM 生成的自由文本解释缺乏与可测量图像属性的核对,存在幻觉与不可信问题。已有的 360° 视角选择工作大多依赖显著性,但已有研究指出仅凭显著性不足以支撑美学视角选择,且现有视角分数要么缺乏可解释性,要么把取景目标与相机位姿目标混为一谈。更深一层,摄影师裁剪时实际在回答四个相互独立的问题——主体是什么、放在哪里、关键元素是否被切掉、整体是否好看——现有方法通常把它们压缩进单一黑盒分数,容易出现「主体选对了但位置很差」这类单因素失败却无从诊断。
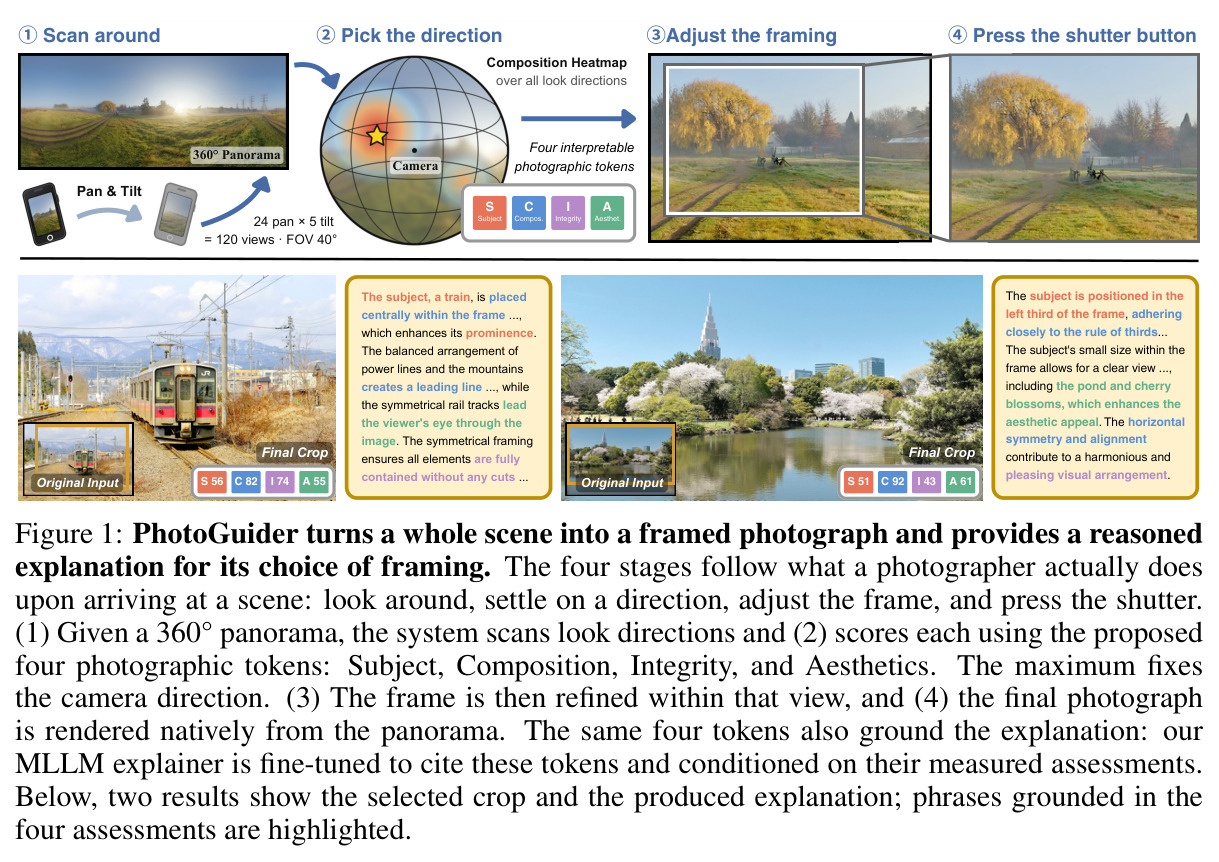
本文的目标是本文要构建一个「先测量、后取景」(measure-then-frame)的自动摄影取景系统:给定一整幅 360° 全景,自动发现最佳观看方向、在该方向的工作视角内生成并精修裁剪框、输出 pan/tilt/视场角/宽高比等相机参数以便从全景原生重渲染成片,并给出有量化依据的构图解释。具体目标包括:(1) 设计一套构图感知的共享特征,按 Subject/Composition/Integrity/Aesthetics 四个摄影令牌分组(共 60 维),让方向选择、候选排序、精修门控、解释生成全部复用同一组测量;(2) 把 MLLM 限制在「有限顾问」角色,决策由仅约 6.3 万参数的紧凑可解释模型完成;(3) 在 FCDB(348 张测试图)与 FLMS(500 张)两个标准基准上用同一 checkpoint 取得最高平均 mIoU;(4) 在 120 名参与者、100 个全景场景的盲评中以 53.2% 的第一名偏好率显著超过端到端与 MLLM 基线。
与已有工作不同的是,本文的独特切入有四点。第一,把「方向选择」显式建模为取景的前置决策:2D 裁剪器默认画面已存在,而 PhotoGuider 在 24 pan × 5 tilt 共 120 个全景视角上用与裁剪完全相同的特征打分,先选方向再取景,衔接了 360° 视角选择与 2D 裁剪两条原本分离的研究线。第二,反转大模型与决策层的关系:主流 MLLM 裁剪器让大模型直接打分或回归框,本文用小容量加性模型/LightGBM 做决策(防过拟合、天然可归因),MLLM 只做「不打分、不决策」的顾问,其提案必须经过冻结排序器的显著分数差检验才能被采纳。第三,一套测量三处复用:同一 60 维特征同时支撑方向打分、排序门控与解释锚定,可解释性既是结构性的(加性分解)又是事后精确的(TreeSHAP),而非对黑盒的事后近似。第四,解释以测量值条件化生成,训练草稿经四道蒸馏过滤器对照物理测量清洗,使数值声明可被规则检测器独立核对。
核心方法
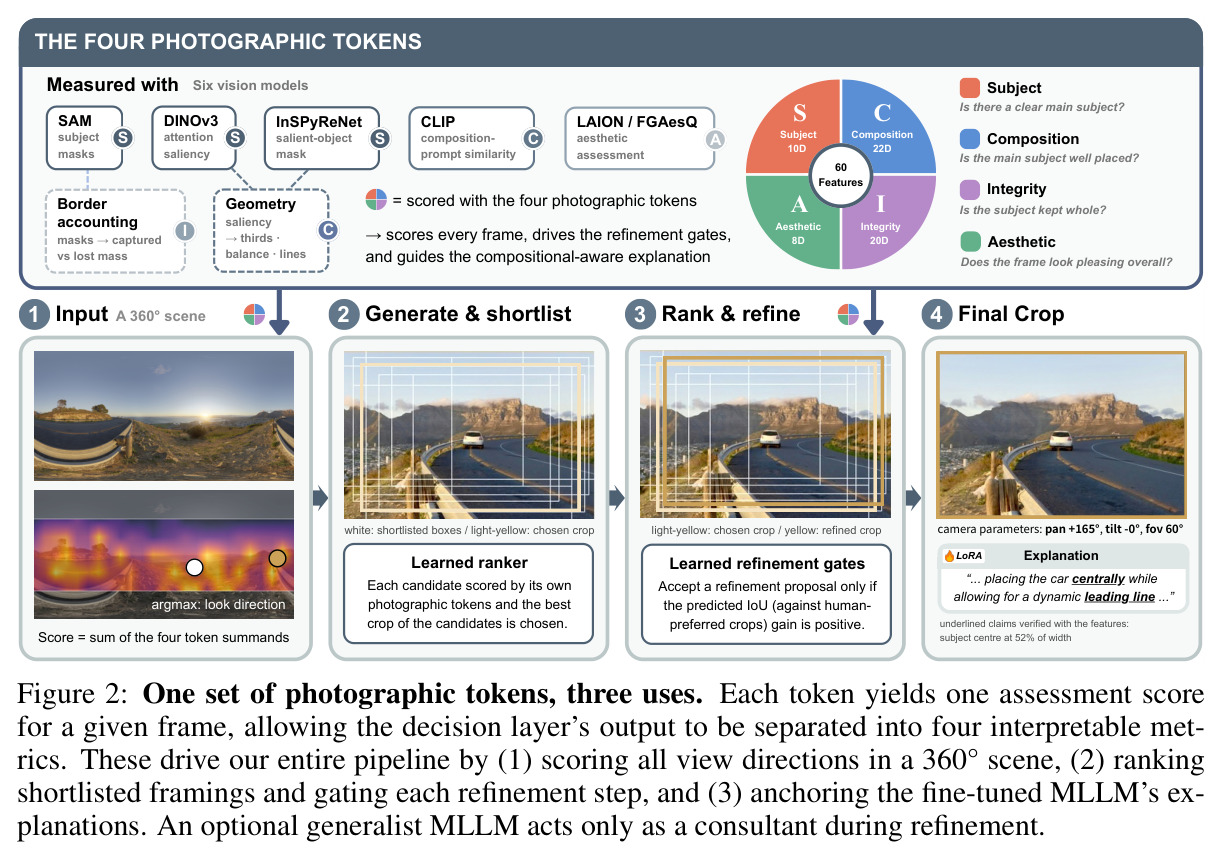
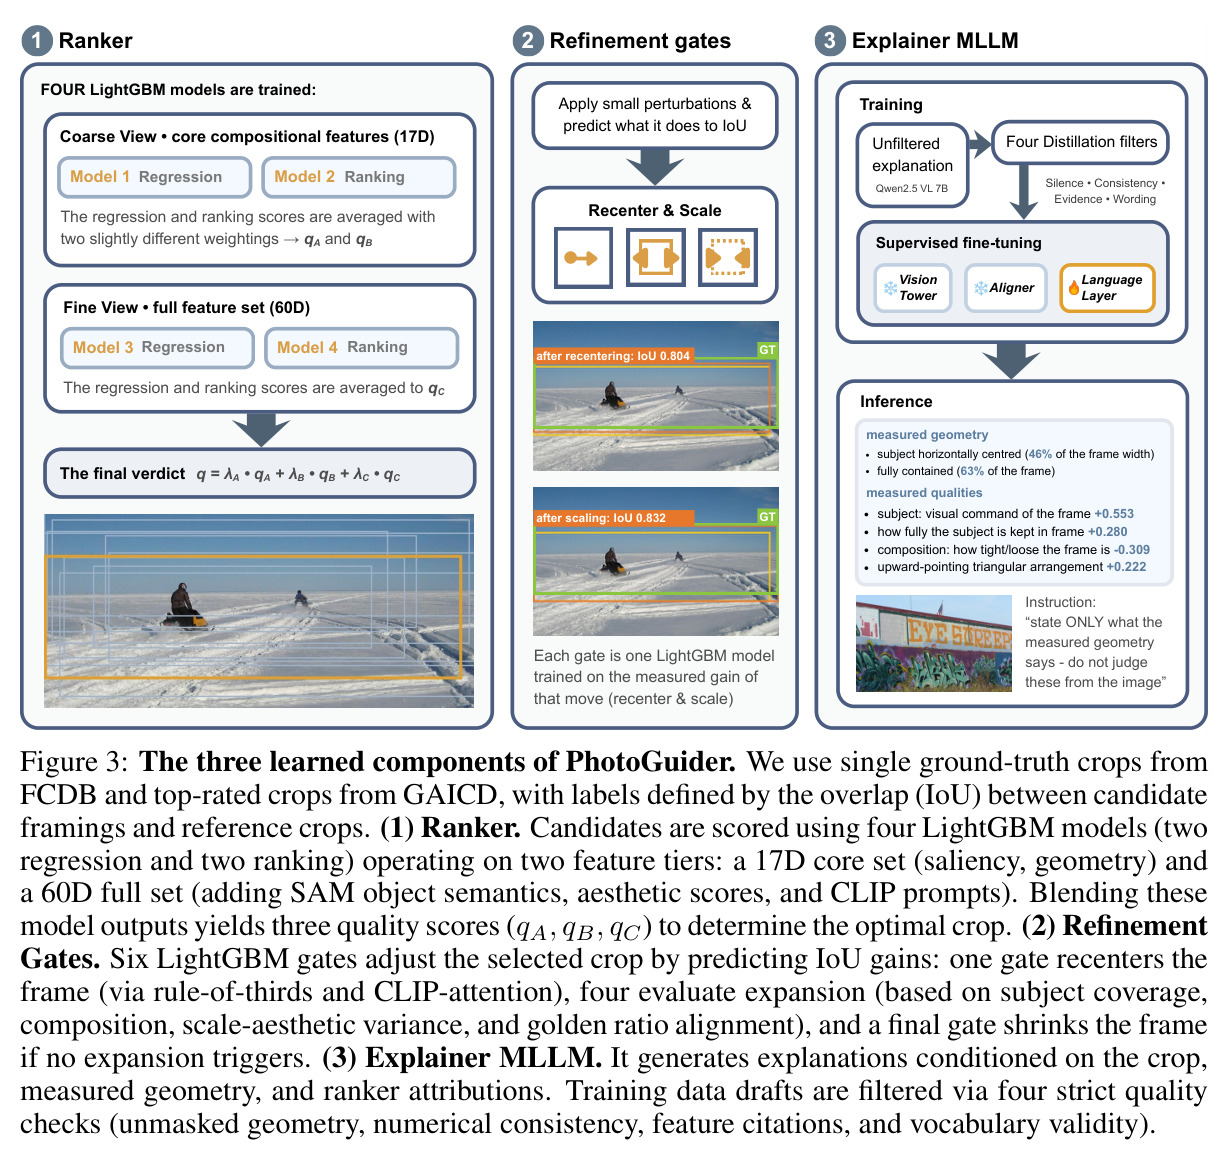
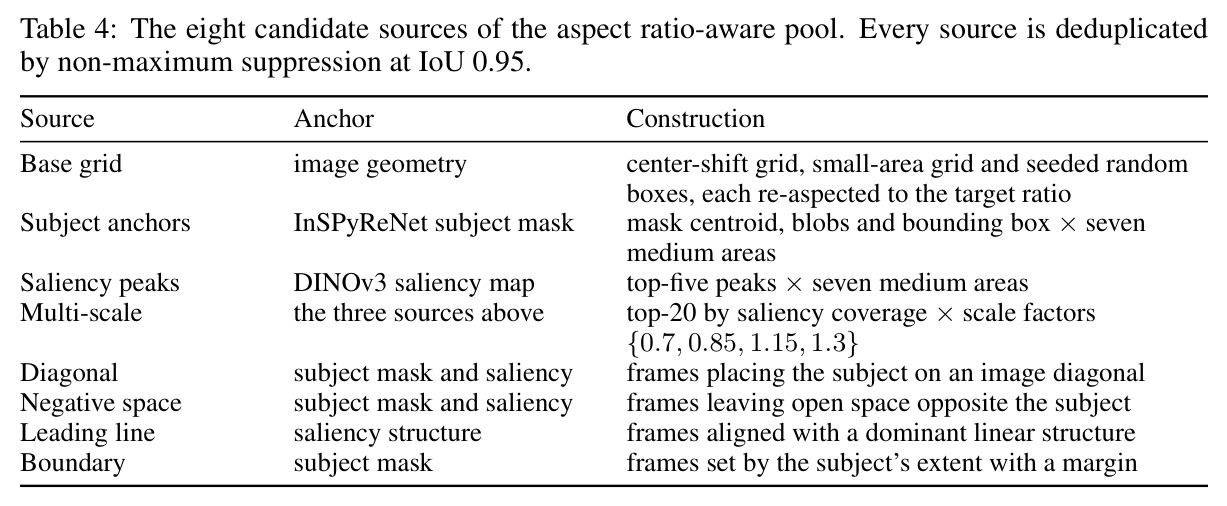
直觉上,PhotoGuider 模拟摄影师到达场景后的四个动作:环顾四周、选定方向、调整画框、按下快门,并请一位「第二双眼睛」把关。技术路线分四个阶段。Stage (a):在全景上按 24 pan × 5 tilt 的重叠网格重投影出 120 个 FOV 40° 的透视视角,对每个视角提取与 2D 裁剪完全相同的 60 维特征,用令牌分组的加性神经网络视角打分器(约 4 万参数,在 GAICD 上以同图成对排序损失训练)选出得分最高的方向。Stage (b):把该方向重投影为更宽的工作视角,由八种来源生成约 300 个候选框,行列式点过程(DPP)兼顾质量与多样性选出 10 个,前 3 个送入由四个 LightGBM 模型混合的排序器 $q = \lambda_A q_A + \lambda_B q_B + \lambda_C q_C$。Stage (c):六道 LightGBM 门控依次尝试 recenter/expand/shrink,每一步只在预测 IoU 增益超过阈值时执行。(b)+(c) 构成不需要 MLLM 的 fast 模式;full 模式再加入 Stage (d),由 Venus MLLM 作为顾问提案候选框。最后,QLoRA 微调的 Qwen2.5-VL-7B 依据注入的测量值生成解释,裁剪框经针孔模型转换为相机参数并从全景原生重渲染。
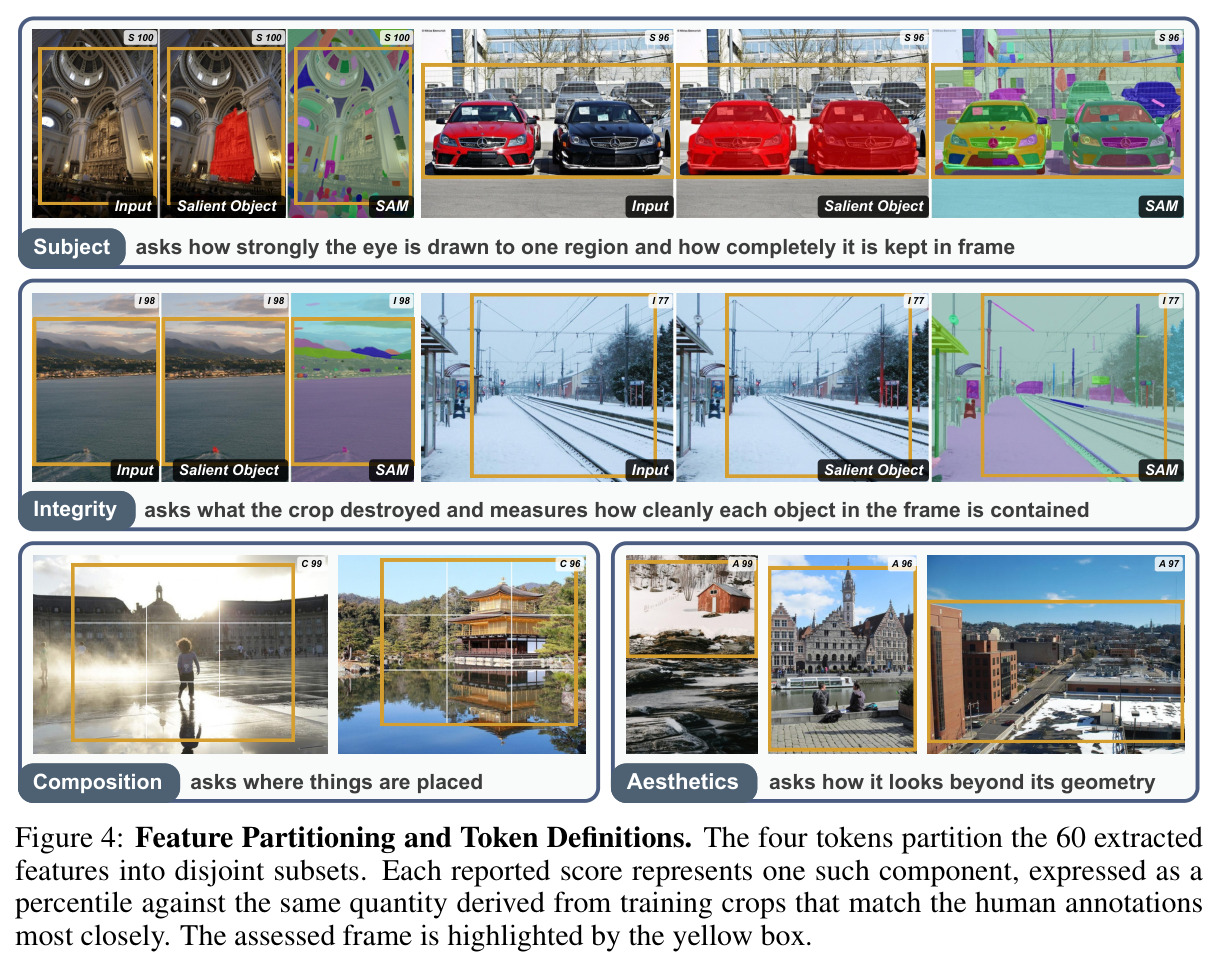
核心创新是「一套测量、三处复用」的架构与 MLLM 角色的重新划分。60 维特征按四个互斥令牌分组——Subject(10 维:DINOv3 注意力、InSPyReNet 显著性、SAM 对象掩码)、Composition(22 维:显著性几何的三分法/对称/三角形/平衡、SAM 对象与三分结构对齐、CLIP 八条构图提示相似度)、Integrity(20 维:全部来自 SAM,编码器统计信息量与裁剪内外对比、解码器对象数/边界干净度/景深分层)、Aesthetics(8 维:LAION 与 FGAesQ 美学分、饱和度、主体-背景色度对比)。同一组特征 (1) 给 120 个全景方向打分(加性分解让每个方向的得分直接归因到四个令牌);(2) 驱动 LightGBM 排序与六道精修门控;(3) 作为解释的条件输入与 TreeSHAP 归因来源。与已有方法的本质区别:端到端裁剪器的打分证据封闭在固定目标函数里难以检查,MLLM 裁剪器让大模型直接决策;PhotoGuider 反其道而行,决策层只有约 6.3 万参数(毫秒级 CPU 推理、防过拟合、可精确归因),MLLM 被降级为有界顾问——自一致性中位数聚合提案、孪生候选仅在显著加分时被采纳、最终有界让步插值 $\hat{x}_b = (1-\lambda_c)x_b + \lambda_c \tilde{v}_c$。
方法步骤详情
完整流程分八步。(1) 特征提取:SAM、DINOv3、InSPyReNet、CLIP、LAION、FGAesQ 六个模型为每个视角/裁剪框产出 60 维特征,归入 S/C/I/A 四组。(2) 方向选择:24 pan × 5 tilt 网格重投影,逐视角提取特征,令牌分组加性网络输出总分并取 argmax,得到最优观看方向。(3) 候选生成:在工作视角内由基础网格、主体与显著性锚点、多尺度细化及对角线/负空间/引导线/边界四种构图先验生成约 300 个框,按 DPP 打分 $q_{dpp}(c) = q_{LGBM}(c) + \lambda_{vs} s_{sal}(c)\cdot\max(0, 1 - \lambda_a \log\frac{asp(c)}{asp^*})$ 选出 10 个多样候选,前 3 名进入排序。(4) 排序:17D 核心集与 60D 全集两对「回归+排序」LightGBM,混合为 $q = 0.4q_A + 0.4q_B + 0.2q_C$ 后取 argmax。(5) 门控精修:recenter 把中心向三分点与 CLIP 注意力目标的加权混合移动 $\beta = 0.20$;四个扩展门(主体覆盖、CLIP 宽紧响应、美学增量、黄金点增量)在尺度集 {1.1, 1.3, 1.5, 2.0} 上评估,预测 IoU 增益超过阈值才触发;无扩展时收缩门按 SAM 嵌入与全图相似度决定是否收紧。(6) MLLM 顾问(full 模式):Venus 共 10 次解码取坐标中位数作提案,与候选 IoU ≥ 0.5 时生成孪生候选,冻结排序器仅在显著分数差时切换,最终有界插值。(7) 把裁剪框经针孔模型转换为 pan/tilt/FOV/宽高比,从全景原生重渲染成片。(8) 解释生成:微调后的 Qwen2.5-VL-7B 接收图像、裁剪、令牌分数、几何测量与归因列表,输出引用测量的构图解释。
技术新颖性
技术新颖性体现在四个层面。(1) 任务层面:据作者所知,这是首个把 360° 场景中基于构图的方向选择、精细取景、相机参数输出与测量条件化解释整合为一个系统的工作,此前的 360° 方法(相机路径、snap 角度、美学奖励导航)要么缺可解释性,要么把取景与位姿目标混在一起。(2) 决策层设计:与端到端神经网络回归裁剪框不同,排序与门控全部用 LightGBM(合计约 6.3 万参数),视角打分用带成对项的神经加性模型,特征贡献是结构性的;TreeSHAP 对占 0.88 权重的未校准头是精确分解,仅 0.12 权重的保形校准头用割线近似。(3) Δ 信号的使用:扩展门控不读静态美学分数,而读「扩大画框后分数如何变化」与「主体到黄金分割点距离的变化」,作者假设这种变化量特征有助于跨数据集迁移。(4) 训练数据构造:解释器采用类似拒绝采样的蒸馏——Qwen2.5-VL-7B 起草,经 Silence/Consistency/Evidence/Wording 四道过滤器对照物理测量清洗后才交给学生模型,把幻觉治理内建进数据管线。
实验结果
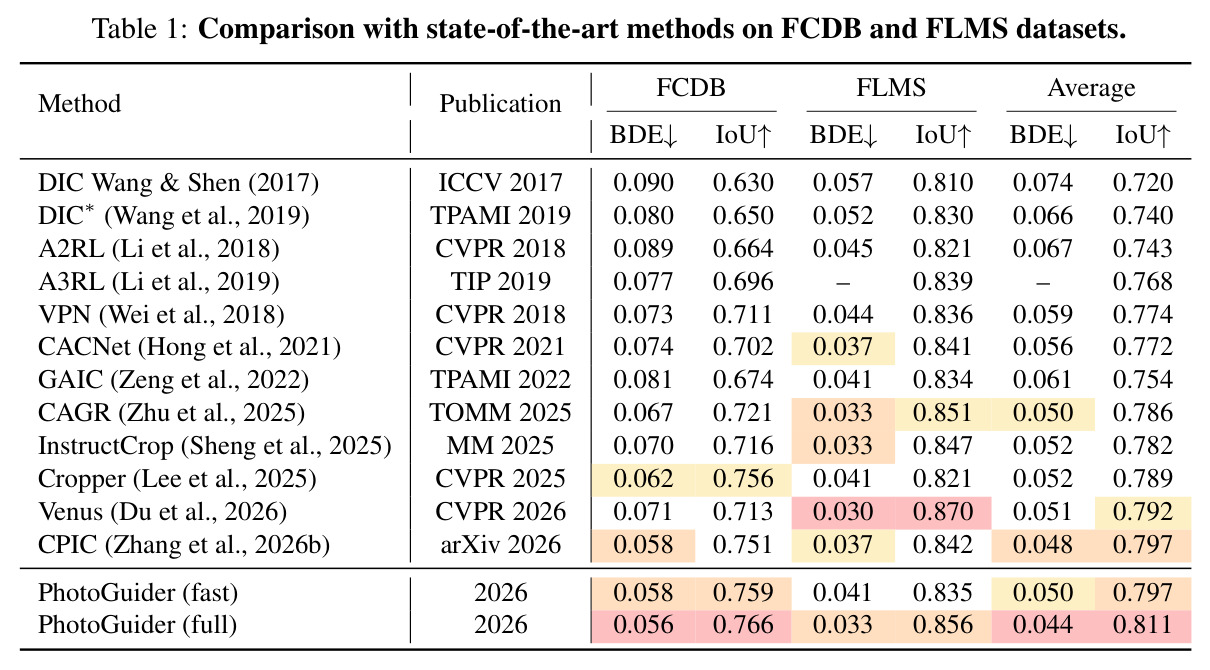
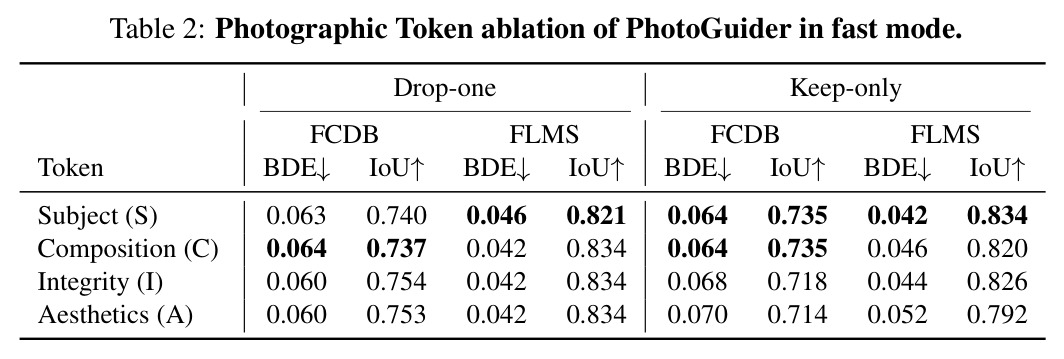
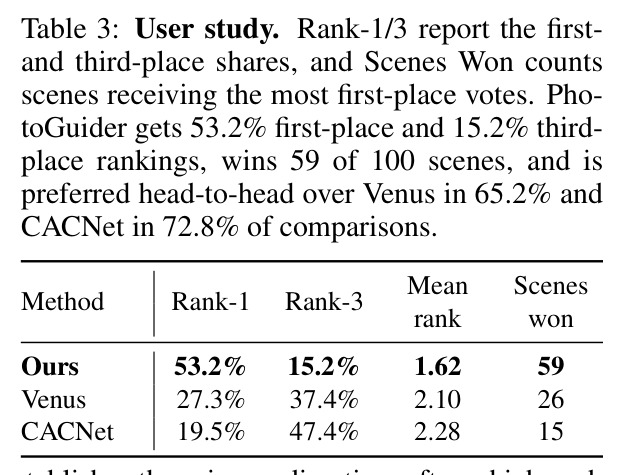
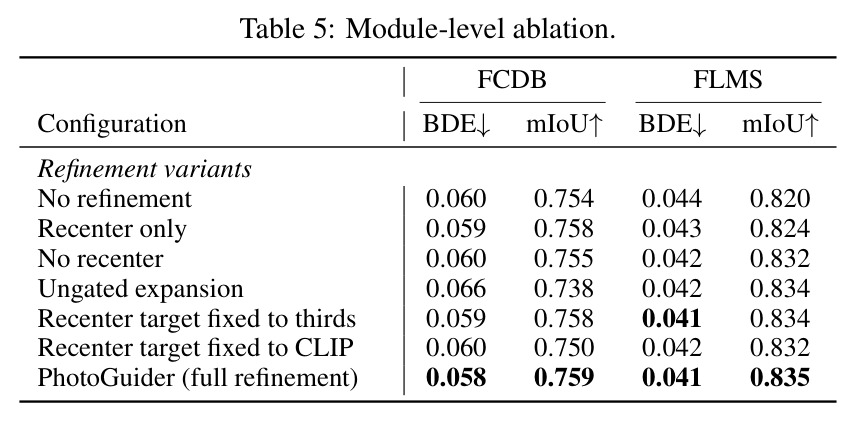
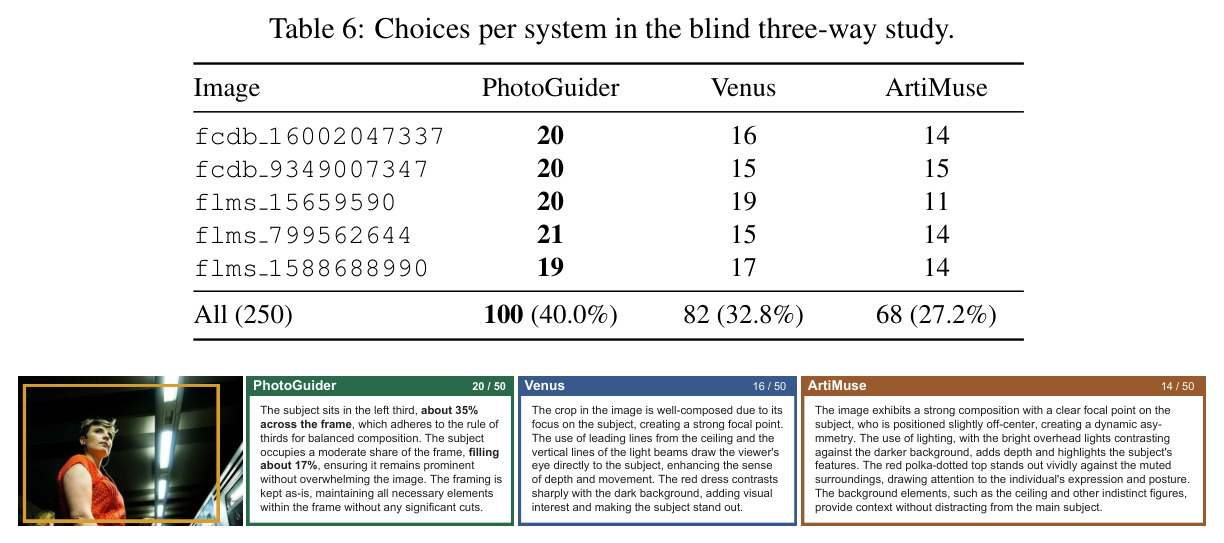
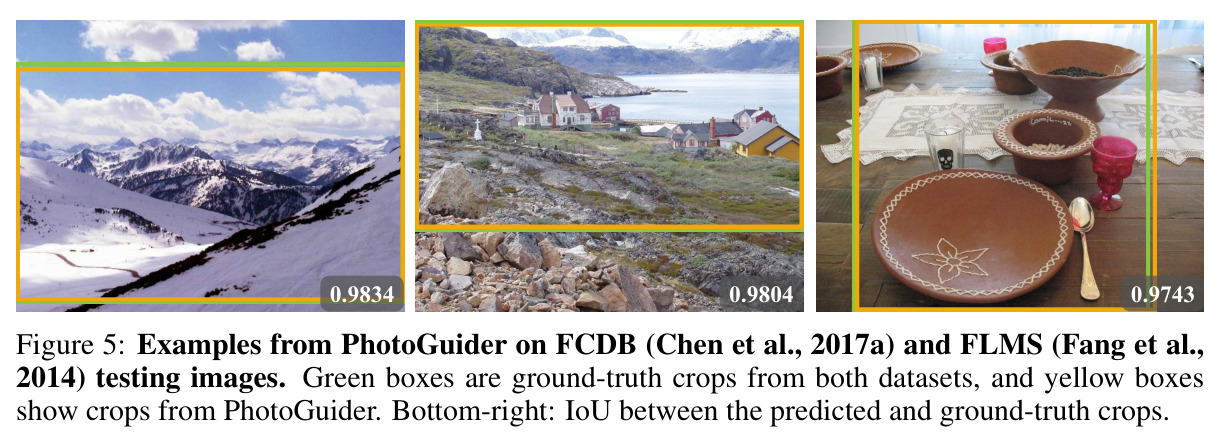
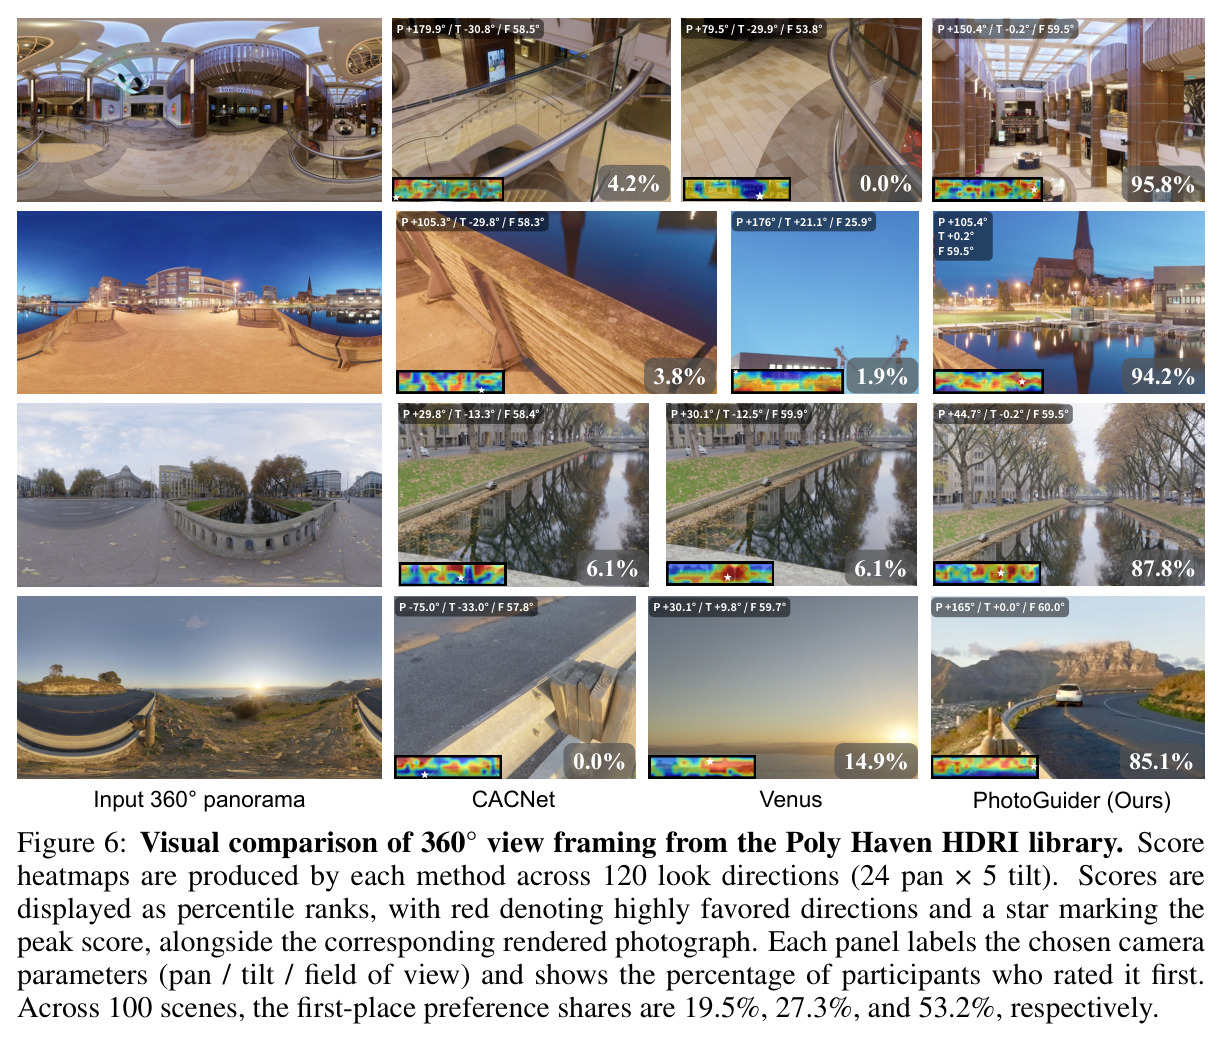
量化结果集中在四组实验。(1) 2D 裁剪基准:同一 checkpoint 同时评测 FCDB(348 张)与 FLMS(500 张),不做数据集专属重训。PhotoGuider full 在 FCDB 取得 BDE 0.056 / IoU 0.766,FLMS 取得 0.033 / 0.856,双基准平均 0.044 / 0.811,是所有方法中平均 mIoU 最高、平均 BDE 最低者,超过 Venus(0.051/0.792)、CPIC(0.048/0.797);不含 MLLM 的 fast 模式平均已达 0.050/0.797。(2) 令牌消融:keep-only 时 Subject 与 Composition 单独最强(FCDB IoU 0.735),Aesthetics 单独最弱(0.714/0.792),四令牌合用最佳(0.759/0.835);作者解释 Integrity/Aesthetics 排序权重低是因为候选预筛已压低其方差(64% 的 FCDB 短名单帧主体捕获率超过 0.95),它们实际在下游门控与解释中发挥作用。(3) 模块消融:完整精修把 mIoU 从 0.754/0.820 提升到 0.759/0.835,而去掉门控的盲目扩展在 FCDB 反而降到 0.738,证明门控必要性。(4) 人类评估:解释矛盾率从微调前的 6.31% 降到 1.55%;50 人三方解释盲评(250 票)中 PhotoGuider 获 40.0%(Venus 32.8%、ArtiMuse 27.2%);120 人、100 个全景、4820 次排序的 360° 盲评中第一名偏好率 53.2%(Venus 27.3%、CACNet 19.5%),平均排名 1.62,59/100 场景夺冠,两两比较胜 Venus 65.2%、胜 CACNet 72.8%,Friedman 检验 $\chi^2 = 43.4$($p < 10^{-9}$),bootstrap 95% CI [48.8%, 57.6%] 远超 33.3% 随机线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| FCDB 定比例裁剪(348 张) | IoU(越高越好) | 0.766 | Cropper 0.756 / Venus 0.713 | +0.010 / +0.053 |
| FCDB 定比例裁剪 | BDE(越低越好) | 0.056 | Cropper 0.062 / CAGR 0.067 | 降低 0.006 / 0.011 |
| FLMS 自由裁剪(500 张) | IoU | 0.856 | Venus 0.870 | -0.014(单基准略低于 Venus,平均占优) |
| 双基准平均(FCDB+FLMS) | mIoU / BDE | 0.811 / 0.044 | Venus 0.792 / 0.051;CPIC 0.797 / 0.048 | mIoU +0.014,BDE 降低 0.004(相对 Venus) |
| 360° 取景盲评(120 人 × 100 全景) | 第一名偏好率 | 53.2%(平均排名 1.62,59/100 场景夺冠) | Venus 27.3% / CACNet 19.5% | +25.9 / +33.7 个百分点(统计显著 p < 10^-9) |
| 构图解释盲评(50 人 × 5 图) | 选择份额 | 40.0% | Venus 32.8% / ArtiMuse 27.2% | +7.2 / +12.8 个百分点 |
| 解释事实一致性(规则检测器) | 矛盾率 | 1.55%(微调后) | Qwen2.5-VL-7B 微调前 6.31% | 降低 4.76 个百分点 |
局限与改进
作者承认两点局限:精修使用离散步长比例(中心每次移动固定比例 $\beta$、缩放限定在 4 个离散尺度因子),对落在采样区间之间的理想构图只能近似;方向选择采用单一 argmax,即使场景存在多个强构图区域也只返回一帧,无法表达用户偏好。我的补充观察:(1) FLMS 上 IoU 0.856 略低于 Venus 的 0.870,说明自由裁剪场景下 MLLM 的整体构图判断仍有优势,PhotoGuider 的优势主要在「双基准平均」而非全面占优;(2) 特征管线级联依赖六个视觉基础模型,SAM 或 InSPyReNet 在夜景、雨雾全景上失效时会同时拖垮 S/I/A 三组特征,而评测用的全景库恰好包含夜景与黄金时刻场景;(3) 训练数据(FCDB 单一 GT 裁剪 + GAICD 高分裁剪)定义了单一「人类偏好」,与摄影取景的多解本质存在张力;(4) 解释中的「锚定句子」只约束对应语句,其余语句仍自由生成,整段解释并不保证无幻觉;(5) 360° 用户研究仅覆盖 100 个 CC0 全景(30 城市/25 室内/25 自然/15 黄金时刻/5 夜景),规模与多样性有限。
独立分析的弱点
独立分析的弱点与改进方向:(1) 离散步长精修——recenter 每次只向目标移动 $\beta = 0.20$、扩展/收缩各只有 4 个离散尺度,面对需要严格三分对齐或精确留白的构图可能过冲或欠冲;改进方向是作者提到的连续精修,或加一个轻量回归头直接预测连续的 $(\Delta x, \Delta y, \Delta\mathrm{scale})$。(2) 单一 argmax 方向——摄影实践中「一景多机位」是常态(日落与建筑立面可能同时成立),单帧输出浪费了全景信息;改进方向是 top-k 方向生成组照,或接受文本偏好输入(「拍特写」「拍大场面」)做条件化方向选择。(3) 特征级联脆弱性——显著性/分割模型在低光、雨雾全景上失败时 S/I/A 特征同时失真且无降级机制;改进方向是为每个特征估计置信度并在门控中降权。(4) 候选生成偏置——约 300 个候选全部锚定于主体与显著性,对无明确主体的氛围场景(空景、抽象纹理、纯光影)覆盖不足;改进方向是增加无锚定的构图先验候选或学习式候选生成。(5) 评测以单一 GT 框的 IoU 为准,会惩罚合理的异构构图;可引入多参照或多解性感知指标。
未来方向
作者提出的方向:以连续精修取代离散步长、允许用户引导的视角选择。基于本文成果还可延伸:(1) 实时取景器辅助——决策层已在 CPU 上毫秒级运行,若把特征提取压缩到端侧算力,四令牌分数可成为相机/手机取景器里的实时构图提示(结合 IMU 建议「向左移 5° 构图更好」);(2) 从单帧到轨迹——把方向打分器从 argmax 扩展为时间平滑的轨迹优化,服务 360° 视频导览与 VR 场景;(3) 接地评估协议——「规则检测器测矛盾率 + 蒸馏过滤器清洗训练数据」可推广为 MLLM 视觉声明接地性的通用评估与训练范式;(4) 摄影教学反馈——四令牌天然对应摄影课程的四个检查点,可输出「哪条构图规则被违反、如何改进」的结构化讲评;(5) 扩展到视频重取景与多帧组照推荐,用同一组 60 维特征保持跨帧一致的构图语言。
复现评估
复现评估:开源情况较好——作者承诺以 Apache-2.0 发布照片与全景两条推理入口(--mode fast|full、--explain)、训练好的决策层、QLoRA 适配器(记录 SHA-256)、特征缓存与全景演示素材;train.py --verify 可确定性重训 13 个决策层模型并逐字节比对,reproduce.py 从缓存复现 Table 1 的四项结果(容差 5×10⁻⁴)。依赖较多:需自行获取 SAM、DINOv3、InSPyReNet、CLIP、LAION 美学头、FGAesQ 六个基础模型,full 模式还需 4-bit 量化的 Venus;训练解释器用 Qwen2.5-VL-7B + QLoRA(仅 40.4M 可训练参数、占总量 0.8%,序列长度 3072),单张消费级 GPU 即可完成。决策层训练数据很小(FCDB train 1395 张 + GAICD 1000 张),LightGBM 训练分钟级即可收敛。360° 用户研究若要复刻需重新招募 120 名参与者,但论文完整报告了 Friedman/Wilcoxon/bootstrap 统计量便于对照。综合判断:组件多、环境搭建繁琐,但有确定性脚本与缓存兜底,复现难度中低,普通单 GPU 工作站足够。
论文图表
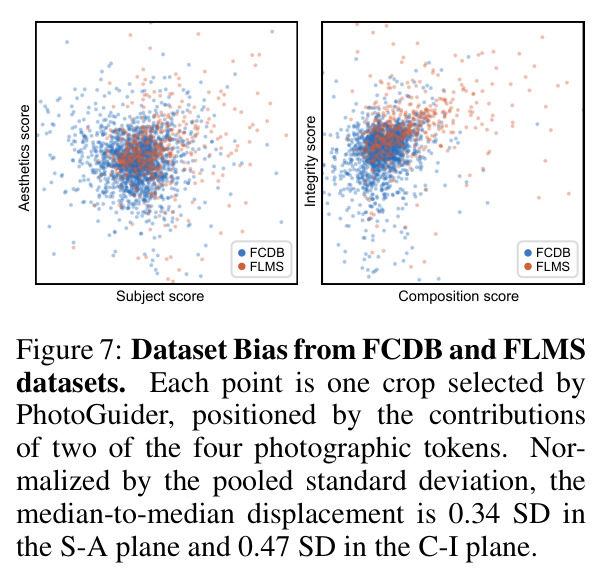
散点图展示 PhotoGuider 在 FCDB 与 FLMS 上选出的裁剪在令牌归因平面上的分布差异:按合并标准差归一化后,中位数偏移在 Subject-Aesthetics 平面为 0.34 SD,在 Composition-Integrity 平面为 0.47 SD,说明两个数据集对四令牌的相对权重偏好不同。
揭示了「人类偏好随数据集变化」这一深层问题,既是令牌设计灵活性的证据,也暴露了评测基准本身的数据偏差,对理解跨数据集泛化与结果解读很关键。
三个系统对同一裁剪的解释对比与 50 名参与者的投票数(PhotoGuider 20/50、Venus 16/50、ArtiMuse 14/50):PhotoGuider 给出「主体位于左侧三分线、约占画面宽度 35%」「填充约 17%」等具体测量;Venus 是模板化的全正面评价,无位置与占比;ArtiMuse 把纯红色上衣误描述为「波点」并以此论证构图好。
用真实文本对照解释了为什么测量条件化解释更受信任:具体数字可核对、模板化与幻觉一眼可辨,是理解解释质量评估结论的关键证据。