TRIO:面向检索增强生成的任务精炼与个体化优化 TRIO: Task Refinement with Individual Optimization for Retrieval-Augmented Generation
三智能体分工微调RAG流水线,8B模型五基准平均EM超次优6.45%
前置知识
RAG(检索增强生成)
让 LLM 在回答前先从外部语料检索相关文档、把检索结果拼进上下文再生成答案的框架,典型流程分检索与生成两步。它能缓解模型知识过时与私有知识缺失的问题,但检索查询构造不当会召回大量无关或有偏文档,上下文过长反而加重推理负担、诱发幻觉。
本文的全部设计都围绕改造 RAG 的检索与生成两个阶段展开,不熟悉 RAG 就无法理解三个智能体各自优化的对象和奖励信号的来源。
GRPO(Group Relative Policy Optimization)
一种强化学习算法:对同一提示采样一组回答,以组内相对优势(按奖励归一化)作为策略梯度信号,省去额外训练价值网络,训练开销低于 PPO。被广泛用于 R1 式推理训练,Search-R1、R1-Searcher 等推理式 RAG 方法也基于它构建。
TRIO 的答案智能体与查询扩展智能体都用 GRPO 训练,理解它才能明白论文中的奖励函数(Eq. 4、5、7)如何真正作用于模型参数更新。
基于结果的奖励与 EM/F1/PR 指标
RLVR 思路:奖励只看最终答案对不对,不评判推理过程。EM(精确匹配)要求预测与金标完全一致,取值 0 或 1;F1 是预测与金标词级重叠的调和平均,$F1 = 2 \cdot IN(y, y^*) / (PN(y) + PN(y^*))$;PR(精确率)$PR = IN(y, y^*) / PN(y)$ 衡量预测答案中有多大比例命中金标词。
本文所有奖励函数 $R_{a1}$、$R_{a2}$、$R_q$ 都由 EM/F1/PR 组合而成,不懂这些指标就无法读懂奖励设计的细节和动机。
监督微调(SFT)与测试时标注
SFT 用带标签数据直接以交叉熵损失训练模型模仿目标输出。测试时标注指不靠人工、而是在推理阶段多次采样模型输出并用一致性作为标签来源:例如对同一样本随机采样 16 次,全部答对记为正例、全部答错记为负例,可以低成本获得高置信度的监督信号。
TRIO 的判断智能体正是用「16 次采样全对/全错」的测试时标注来生成训练标签再做 SFT 的,这是其训练数据的唯一来源,也是监督信号可靠性的关键。
多跳问答(Multi-hop QA)
需要串联多个事实才能作答的任务,例如「某人物父亲的出生地在哪里」要先查出父亲身份、再查其出生地。HotpotQA、2Wiki、Musique、Bamboogle 是常用基准,通常需要多轮检索逐步收集证据,检索过早停止会导致证据不全。
本文的训练数据构造与评测几乎全部在多跳 QA 数据集上进行,检索轮数的自适应停止机制正是为这类需要多步取证的问题设计。
研究动机
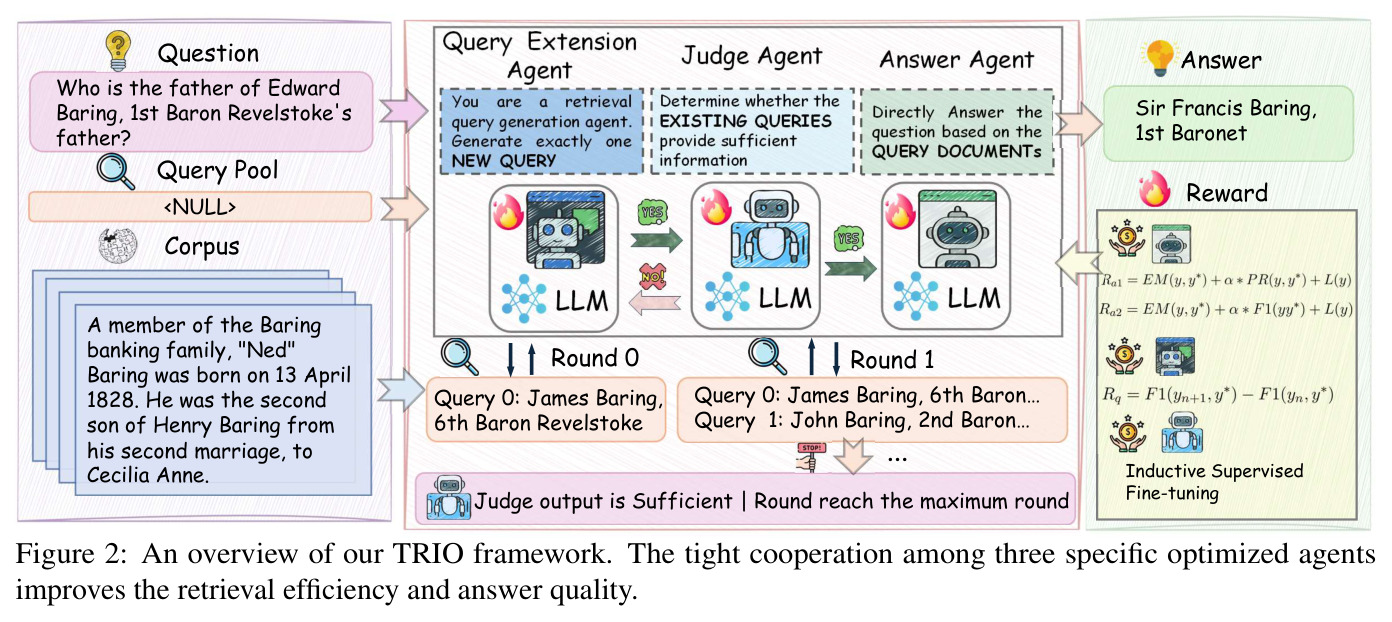
RAG 通过外部检索缓解 LLM 的知识过时与幻觉,但在两个环节存在系统性缺陷。其一是检索阶段的知识获取低效:系统难以准确识别缺失知识并生成有效查询,例如问「Edward Baring, 1st Baron Revelstoke 的父亲是谁」这类人物关系问题时,模糊的原始查询可能召回大量无关甚至有偏的文档(如不加区分地返回 Baring 家族其他成员的生平),既浪费上下文窗口又加重推理负担。其二是生成阶段的知识利用不足:即便相关文档已召回,单一模型也可能无法恰当利用上下文而继续产生幻觉,这在医疗、法律等知识密集的敏感私有领域后果严重。现有优化要么只调整流水线形态(分支法 SuRe、迭代循环 IRCoT/Iter-RetGen、Self-RAG),要么用 RL 微调单一骨干同时承担查询生成与作答(Search-R1、R1-Searcher),后者把两阶段任务压在一个模型上,模型固有偏见被继承,查询质量与回答鲁棒性相互拖累;而已有多智能体 RAG(如 DRAG)各角色共享同一骨干、缺乏针对性微调,五基准平均 EM 仅 0.2490。
本文的目标是本文目标是构建一个高效、可靠的多智能体 RAG 系统:把流水线拆解为检索查询生成、证据充分性判断、答案生成三个子任务,由三个分别针对子任务微调的专家智能体承担,并在迭代检索循环中紧密协作——查询扩展智能体定位知识缺口并生成精准新查询,判断智能体动态决定何时停止检索、转入作答,答案智能体仅基于确认充分的上下文生成最终回答。可量化的目标包括:在 HotpotQA、2Wiki、NQ、Musique、Bamboogle 五个基准上以精确匹配(EM)为指标全面超越 Search-R1、R1-Searcher 等推理式 RAG 与 DRAG 等多智能体基线(最终平均 EM 0.4294,较次优提升 6.45%);同时把推理开销压到接近轻量方法的水平(每百条查询约 80 秒),使框架可直接迁移到真实 RAG 部署场景。
与已有工作不同的是,本文切入的独特角度是「分工 + 个体优化 + 跨智能体监督耦合」三位一体。已有工作的盲区在于:多智能体 RAG 共享同一骨干而不做针对性调整,RL 式 RAG 用单一模型单一奖励包打天下。TRIO 抓住两个被忽视的点:第一,每个智能体的训练监督信号应当来自流水线中的下游消费者——查询扩展智能体的奖励定义为答案 F1 增量 $R_q = F1(y_{n+1}, y^*) - F1(y_n, y^*)$,判断智能体的标签由答案智能体 16 次采样的全对/全错决定,使各智能体的优化目标天然对齐而非各自为政;第二,用两阶段混合奖励(先在 top-3 chunk 上学 EM+精确率,再在 top-5 chunk 上学 EM+F1)对抗单奖励的过拟合,实验显示单奖励版本在域外数据平均下降 17.03%。这种「以最终答案质量定义每个环节好坏」的训练哲学,是既有单模型或多智能体方法都没有做到的。
核心方法
直觉上,TRIO 把 RAG 流水线变成一个三人小组:情报员(查询扩展智能体)负责把模糊问题改写成精准检索词,审查官(判断智能体)评估现有证据是否足够,答题主笔(答案智能体)只依据确认充分的证据写答案。技术上,三个智能体从同一骨干(Llama3.1-8B-Instruct 或 Qwen3-4B-Instruct)出发,用不同策略分别微调:答案智能体采用两阶段 GRPO 强化学习,查询扩展智能体用 GRPO 配合答案质量增量奖励,判断智能体用带测试时标注的监督微调。推理时形成闭环:从初始检索(E5-base-v2 检索器 + Wikipedia 2018 语料,外部证据上限 20 个 chunk)出发,每轮由查询智能体针对知识缺口生成新查询并取 top-5 chunk,判断智能体评估累积信息是否充分,最多迭代 3 轮;一旦判定充分或达轮数上限,答案智能体仅基于当前上下文直接作答。由于查询与判断智能体只供应严格必要的证据,答案智能体免于处理海量无关上下文,输出高度精炼,这也是其推理速度快于推理式 RAG 的原因。
核心创新是「个体优化 + 跨智能体监督耦合」,与已有方法的本质区别在监督信号来源与奖励设计粒度。Search-R1、R1-Searcher 用单一模型和单一奖励贯穿全程,TRIO 则为每个子任务定制奖励:答案智能体的奖励 $R_{a1} = EM(y, y^*) + \alpha \cdot PR(y, y^*) + L(y)$(第一阶段,top-3 chunk)与 $R_{a2} = EM + \alpha \cdot F1 + L(y)$(第二阶段,top-5 chunk),其中 $L(y)$ 在答案长度超过阈值 $l$ 时取 $-1$、否则取 $0$,用于压制冗余解释;查询扩展智能体的奖励 $R_q = F1(y_{n+1}, y^*) - F1(y_n, y^*)$ 直接量化一条新查询带来的答案改善;判断智能体沿用测试时标注——让答案智能体采样 16 次,全对标记「信息充分」、全错标记「信息不足」,再据此监督微调。整个系统中查询的好坏由答案定义、判断的标签由答案定义,各环节优化目标与最终答案质量严格对齐,这是「紧密耦合」的根源,也是共享骨干、各自为政的多智能体方法做不到的。
方法步骤详情
训练遵循 Algorithm 1 七步级联:(1) 从问题集划分难题子集 Q1 与普通题 Q2;(2) 在 Q1 上运行检索辩论流水线(DRAG 式,最多 3 轮),每轮保存查询池与 chunk 快照作样本,并改变查询与 chunk 数量生成多样本,构成 T1;(3) 在 T1 上两阶段 GRPO 训练答案智能体 $A_g$:先用 top-3 chunk、奖励 $R_{a1}$(EM + 精确率 + 长度惩罚),学会利用已有信息、减少幻觉;再用 top-5 chunk、奖励 $R_{a2}$(EM + F1 + 长度惩罚),学习在丰富上下文中定位关键证据,训练题取自 HotpotQA 与 2Wiki 训练集的中等及困难题;(4) 对 Q2 用原始问题单轮检索构建 T2;(5) 在 T2 上 GRPO 训练查询扩展智能体 $A_q$,奖励为答案 F1 增量 $R_q$;(6) 用 $A_q$ 对 T2 每题检索并让答案智能体采样 16 个答案,构造判断训练集 T3;(7) 在 T3 上监督微调得到判断智能体 $A_j$。推理时闭环:检索→判断→不充分则扩展查询再检索,最多 3 轮,充分后直接作答。
技术新颖性
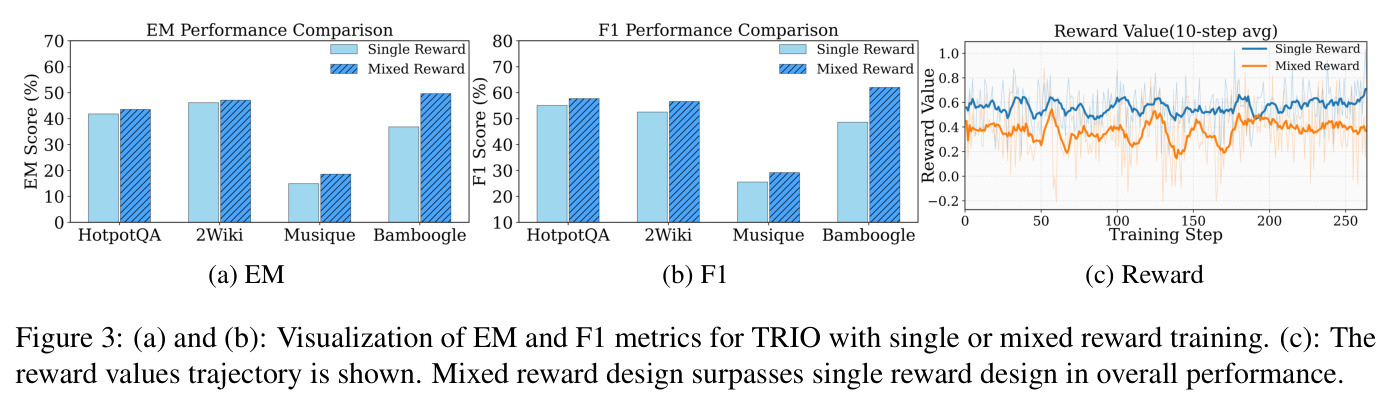
技术新颖性集中在三点。其一,差分奖励设计:$R_q = F1(y_{n+1}, y^*) - F1(y_n, y^*)$ 以加入新 chunk 前后的答案 F1 之差度量单条查询的边际价值,解决了「单条查询质量缺乏明确判断信号」这一老问题,而以往方法只能靠启发式规则或端到端奖励间接优化查询。其二,两阶段混合奖励:Figure 3 显示只用单一奖励 $R_{a2}$ 训练时,域内两数据集平均降 5.9%、域外两数据集平均降 17.03%,且其训练奖励值反而更高——典型的过拟合训练分布特征,混合奖励以略低的训练奖励换取更强的泛化。其三,级联耦合的训练协议:答案智能体先练好才能为查询智能体提供可靠奖励,查询智能体练好才能为判断智能体生成标注数据,三者数据生成互相依赖。消融证明这种设计的必要性:换回基础骨干后,Musique 上 EM 分别下降 26.93%(去查询优化)、14.22%(去判断优化)、43.40%(去答案优化)。
实验结果
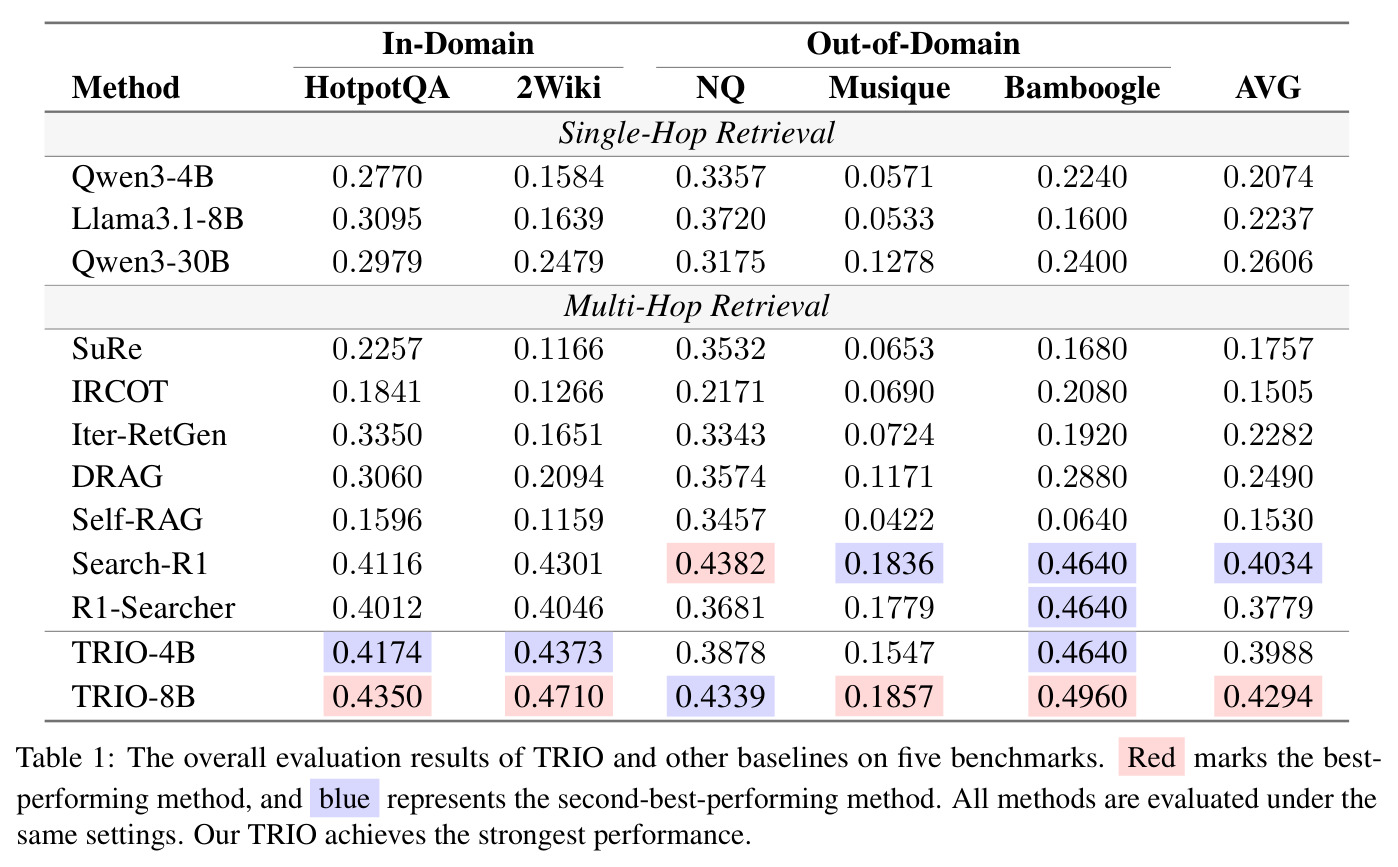
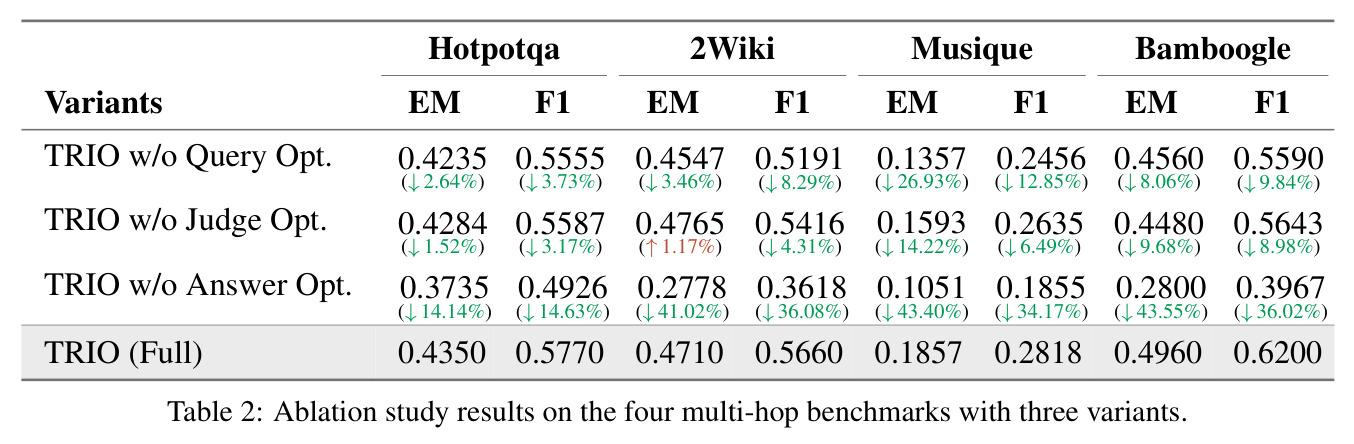
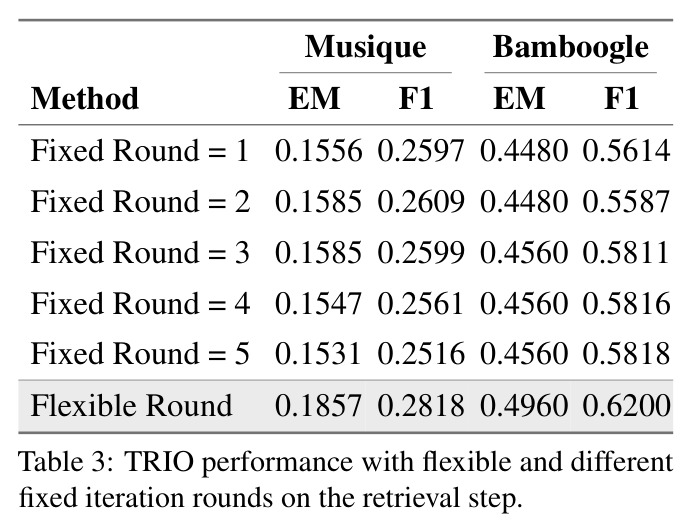
主实验(Table 1):TRIO-8B 在 HotpotQA 0.4350、2Wiki 0.4710、NQ 0.4339、Musique 0.1857、Bamboogle 0.4960,五基准平均 EM 0.4294,四个基准第一,平均较次优 Search-R1(0.4034)提升 6.45%,比多智能体基线 DRAG(0.2490)高 72.45%;TRIO-4B 平均 0.3988,域内超基线、域外回落(Musique 0.1547),作者视作规模定律体现;NQ 上 TRIO-8B 实际低于 Search-R1(0.4382),是唯一未夺魁的基准。消融(Table 2):去掉答案优化掉分最狠,2Wiki EM 从 0.4710 跌至 0.2778(-41.02%)、Bamboogle EM -43.55%;去掉查询优化 Musique EM -26.93%;去掉判断优化域外损失大于域内(Musique EM -14.22%),但 2Wiki EM 反升 1.17%,提示判断智能体 SFT 过拟合。检索轮数(Table 3):固定 1-5 轮全面劣于自适应停止(上限 3 轮),Musique EM 0.1857 对固定轮最高 0.1585,Bamboogle 0.4960 对 0.4560。效率(Table 4,两张 L40S):TRIO-4B 每百查询 45.6 秒,约为 Search-R1(90.1 秒)一半且达其约 98% 性能,TRIO-8B 79.9 秒且成绩更高,DRAG 需 695.8 秒。奖励消融(Figure 3):单奖励域内平均 -5.9%、域外 -17.03%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 域内多跳QA(HotpotQA / 2Wiki) | EM | TRIO-8B 0.4350 / 0.4710 | Search-R1 0.4116 / 0.4301 | +5.7% / +9.5% |
| 域外QA(Musique / Bamboogle) | EM | TRIO-8B 0.1857 / 0.4960 | Search-R1 0.1836 / 0.4640 | +1.1% / +6.9% |
| 五基准平均 | EM | TRIO-8B 0.4294 | Search-R1 0.4034;R1-Searcher 0.3779;DRAG 0.2490 | 较次优 +6.45%,较 DRAG +72.45% |
| 推理效率(每100条查询) | 秒 | TRIO-4B 45.6s;TRIO-8B 79.9s | Search-R1 90.1s;DRAG 695.8s | TRIO-4B 约一半时间达 Search-R1 98% 性能 |
| 检索轮数策略(Musique / Bamboogle) | EM | 自适应轮数(上限3轮)0.1857 / 0.4960 | 固定5轮 0.1531 / 0.4560 | +21.3% / +8.8% |
局限与改进
作者承认的局限:评估仅覆盖短答案 QA,未验证实时网页搜索与长文本生成;自适应循环在需要长篇回答或长检索链的任务上可能失效,因为误差与无关证据会跨检索轮累积;实时网络的文档可用性变化与异构网页结构会带来额外挑战。我的补充观察:(1) 五个基准中 NQ 是唯一 TRIO-8B 落后于 Search-R1 的(0.4339 对 0.4382),优势并非全面;(2) 判断智能体的 16 次采样标注丢弃了「部分对部分错」的边界样本,且消融显示其 SFT 在域内基准(2Wiki EM +1.17%)有过拟合迹象,泛化能力存疑;(3) 系统耦合在 E5-base-v2 与 Wikipedia 2018 dump 上,未测与更强检索器或更新语料的组合,检索器的召回上限会直接封顶整体性能;(4) 训练顺序级联(答案→查询→判断)使管线脆弱,上游智能体的退化会污染下游训练数据;(5) 轮数上限 3、长度阈值 $l$、奖励权重 $\alpha$ 等超参依赖逐数据集调优,迁移成本不低。
独立分析的弱点
独立分析出五个弱点。其一,判断智能体是泛化短板:消融中去掉其优化在 2Wiki 上 EM 反而升 1.17%,域外却大跌 14.22%,说明 SFT 学到的更多是训练分布的「充分性先验」而非通用判断力,改进方向是引入跨域多样性数据或改用 RL 训练停止策略。其二,测试时标注浪费边界信息:16 次采样全对/全错的硬标签直接丢弃「8 对 8 错」这类不确定样本,改进方向是按正确率构造软标签或加权样本。其三,差分奖励 $R_q$ 依赖答案智能体质量,答案弱时奖励信号噪声大且训练顺序不可交换,改进方向是两智能体交替迭代训练或引入保守的奖励基线。其四,小模型域外退化明显(TRIO-4B 在 Musique 仅 0.1547),可尝试蒸馏或 LoRA 共享底层缓解容量瓶颈。其五,最多 3 轮的启发式上限可能截断 5 跳以上的复杂多跳问题,宜按问题复杂度自适应放宽。
未来方向
作者提出的方向:校准检索停止决策、在动态真实语料中评估误差累积等失败模式、扩展到实时网页搜索与长文本生成。基于本文成果还可延伸:把 TRIO 协议迁移到代码检索、医学问答、Agent 工具检索等其他「检索—判断—生成」分解场景;将三个智能体的奖励统一进多目标联合优化(如联合策略梯度),消除级联训练的顺序依赖;为判断智能体引入 conformal prediction 等不确定性校准,输出带置信度的停止决策;在增量更新的语料上研究检索时效性问题;进一步压缩智能体间通信与输出 token 数,把每百查询约 80 秒的延迟推向交互式应用可接受的量级。
复现评估
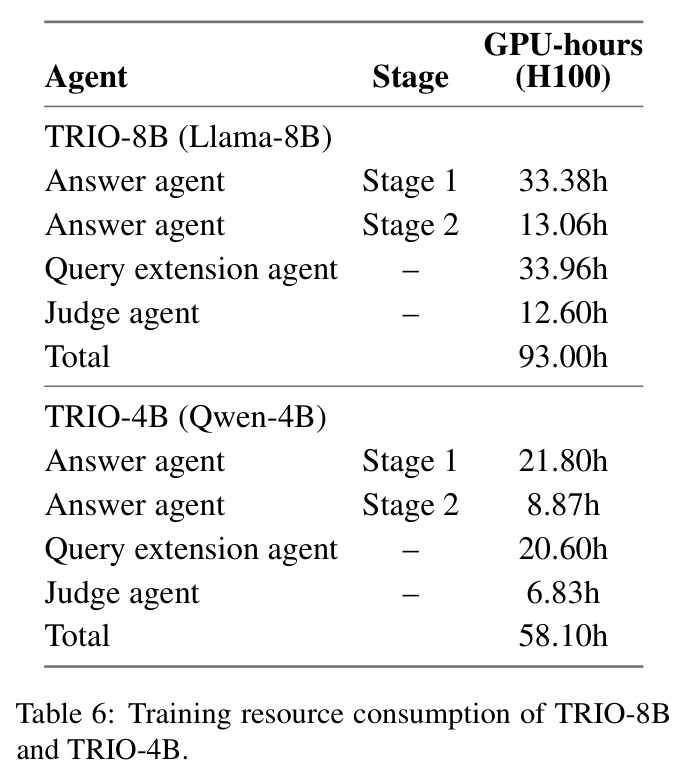
复现条件较好。代码开源在 github.com/yingtaoren/TRIO,三个智能体的训练后模型权重均已发布;数据全部公开(HotpotQA/2Wiki 训练集构造训练样本,五个基准评测),检索器 E5-base-v2、语料 Wikipedia 2018 dump、评测框架 FlashRAG 均为社区标准件。算力方面:推理只需两张 L40S GPU(论文效率实验即在此配置);训练涉及对 4B/8B 模型做 GRPO 与 SFT,估计需要 4-8 张 A100/H100 级显卡,论文未报告训练时长。复现难度中等偏高:只复现推理评测很简单(下载权重 + FlashRAG 跑评测即可);完整复现训练管线的门槛在于多阶段顺序依赖(答案→查询→判断)、DRAG 式辩论数据生成的耗时、以及 $\alpha$、长度阈值 $l$、每题 16 次采样、辩论 3 轮上限等超参细节。
论文图表
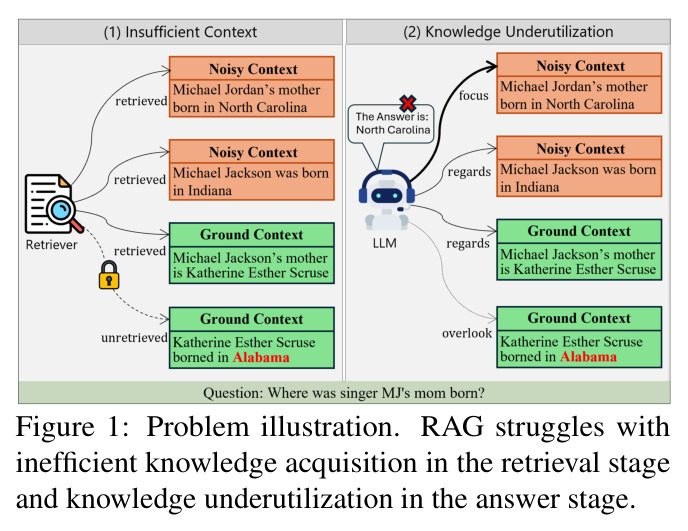
以「Edward Baring, 1st Baron Revelstoke 的父亲是谁」为例,展示 RAG 的两大痛点:检索阶段因查询低效而获取无关知识(返回 Baring 家族其他成员信息),生成阶段即便有相关上下文也可能利用不足或产生幻觉。
一图讲清论文要解决的两个核心问题——检索低效与知识利用不足,是理解三个智能体分工动机的起点。