金融文档识别的以人为中心、风险受限评估框架:证据链、关键错误与选择性自动化 Human-Centred, Risk-Constrained Evaluation of Financial Document Recognition: Evidence, Critical Errors, and Selective Automation
主张金融OCR应按证据恢复评估,用非补偿门控与损失敏感路由取代单一字符错误率
前置知识
CER/WER(字符/词错误率)
基于 Levenshtein 编辑距离的序列级指标:对参考串 $y$ 与假设串 $\hat{y}$,计算最小替换数 $S$、删除数 $D$、插入数 $I$,则 $\mathrm{CER} = \frac{S_c + D_c + I_c}{N_c}$,$\mathrm{WER} = \frac{S_w + D_w + I_w}{N_w}$,其中 $N_c$、$N_w$ 为参考字符数与词数。语料级可做微平均(总编辑量除以总参考量)或宏平均(逐文档 CER 的算术平均),两者对长文档的权重不同。
这是金融 OCR 行业默认报告的质量指标,也是本文批判的靶子:它把所有字符替换一视同仁,无法区分叙述段落中的错字与金额错一位、丢负号、借贷互换这类致命错误。理解它的计算方式与平均策略,才能看懂论文为何要另建分层质量模型。
补偿性掩盖与非补偿性门控
加权算术平均分 $S = \sum_{k=1}^{K} w_k q_k$($w_k > 0$,$\sum w_k = 1$)是补偿性的:某一维度上的完全失败可以被其他维度的高分稀释。非补偿性评估则为每个关键维度设独立上限,验收规则形如 $\mathrm{Pass}(s) = I\{Q_{aggregate} \ge \tau\} \prod_{g \in G} I\{U_g(s) \le \eta_g\}$,任何一项关键门控失败即整体不可接受。
命题 1(补偿性掩盖)是全文的理论核心:作者构造性地证明存在系统 A 总分更高但在关键维度得 0 分。理解补偿与非补偿之分,才能明白为什么高平均 OCR 准确率不能作为金融可靠性的证据。
稀有事件的置信上界(Clopper–Pearson 与三次法则)
$n$ 次独立二项试验中观察到 0 个错误时,真实错误率 $p$ 的单侧 $(1-\alpha)$ 精确置信上界为 $U = 1 - \alpha^{1/n}$;近似 95% 上界即“三次法则” $3/n$。要证明 $p \le \eta$,所需样本量为 $n \ge \frac{\log \alpha}{\log(1-\eta)}$。
命题 2 用它证明“零观察错误 ≠ 零风险”:样本不足时上界可能远超业务容忍度。这直接决定金融关键字段验收的样本量设计(例如 95% 置信下界定 $10^{-3}$ 约需 2,995 个独立关键实例),也解释了为何门控必须用置信上界而非点估计。
选择性预测与风险–覆盖曲线
让系统输出置信分 $c(x)$,仅在 $c(x) \ge t$ 时自动接受,其余路由到人工。覆盖率 $\mathrm{Cov}(t) = P(c(X) \ge t)$,选择性风险 $\mathrm{Risk}(t) = E[\ell(X, \hat{Y}) \mid c(X) \ge t]$。常规做法是绘制风险–覆盖率曲线并报告数值积分规则明确的曲线下面积;覆盖率随阈值单调不增,但风险未必单调。
论文把“哪些文档自动处理、哪些转人工”形式化为带约束的选择性预测问题(第 8.4 节的目标函数 $J(t)$ 与可行性判定),并强调选择性准确率离开覆盖率就没有意义。掌握这套语言是读懂路由模型的前提。
置信度校准(Brier 分数与 ECE)
校准衡量置信分是否忠实反映真实正确概率。Brier 分数 $\mathrm{BS} = \frac{1}{N}\sum_{i=1}^{N}(p_i - y_i)^2$;期望校准误差按预测置信度分箱 $B_m$ 计算 $\mathrm{ECE} = \sum_{m=1}^{M} \frac{|B_m|}{N} |\mathrm{acc}(B_m) - \mathrm{conf}(B_m)|$,并配可靠性图。ECE 依赖分箱策略,且可能掩盖子群失准。
金融场景中置信分要直接支撑弃权、升级与人工审核决策。论文要求在操作决策单元(token/字段/表格/文档)上评估校准,并按关键性类别与文档类别分别报告——校准失准会让路由策略整体失效,因此这是门控可信的前提。
证据溯源(Evidence Grounding)
要求每个抽取字段附带支持它的图像区域(多边形坐标)与逐字转录,并区分三层表示:视觉转录(图像上可见的字符,保留标点、符号、分隔符)、确定性规范化后的类型化规范值(如 '1.250,00 EUR' 按声明区域设置规范为小数金额与 ISO 币种)、业务解释(借方/贷方/含税/期末余额等语义角色)。无可见支持的值必须标注为缺失、无法辨认或推断。
这是全文的核心抽象:把金融 OCR 从“转录引擎”重新定义为“证据恢复系统”。分层质量模型、门控、证据包与审核界面都建立在“可见证据 / 规范化 / 业务解释相分离”这一表示之上,评估者借此区分识别错误、极性规范化错误与表关联错误。
研究动机
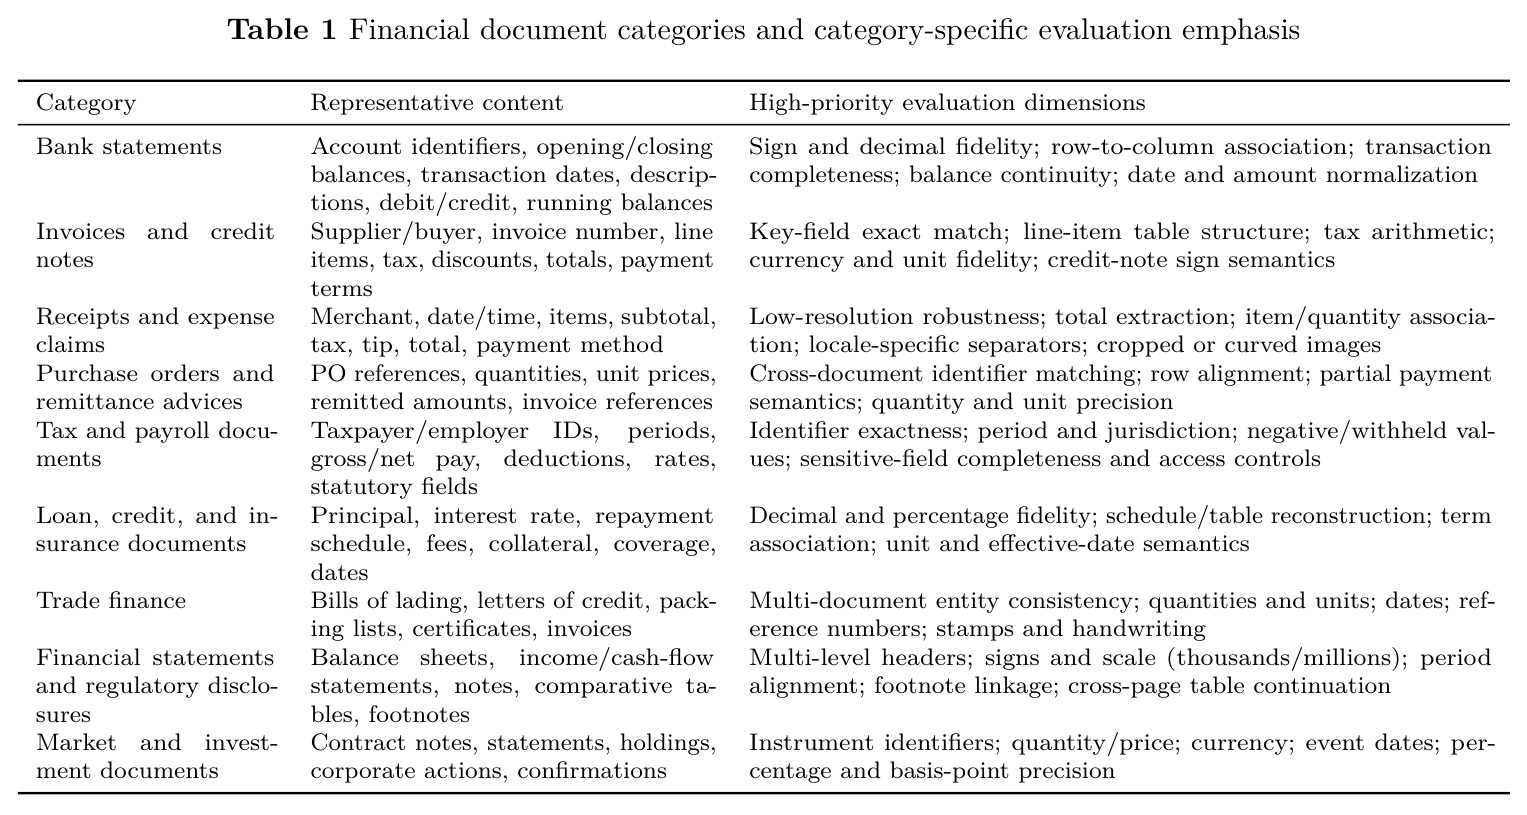
金融机构与企业的日常流程建立在 OCR 之上,而金融文档的内容既视觉异质又后果重大:银行流水含交易日期、描述、借贷两列、余额、账号标识与滚动余额关系;发票含供应商身份、税号、行项目、税率、折扣、币种、付款条款与应付总额;财报混合叙述性披露、多级表头、脚注、单位、比较期间与括号表示的负数。行业惯例是用单一字符错误率(CER)或词错误率(WER)报告质量,但编辑距离把所有替换一视同仁,而错误的运营后果取决于其语义角色:叙述段落里错一个字母,与把 '1,250.00' 读成 '12,500.00'、丢掉负号、把数值从借方列挪到贷方列、或把税额关联到错误发票,完全是不同量级的问题。此外没有一个公开数据集覆盖完整的金融 OCR 问题:OmniDocBench、OCRBench、OCRBench v2、MMLongBench-Doc 等通用基准覆盖版面、视觉文本与长上下文证据,但不提供金融工作流的风险标签或人工审核结果;纯文本的金融推理集不是 OCR 测试集,纯表格集也测不出文档级字段关联与运营可靠性。
本文的目标是本文要建立一套“以人为中心、风险受限”的金融文档识别评估框架,把系统视为证据恢复系统而非文本转录引擎。具体目标包括七项方法论贡献:定义带证据链接的类型化金融事实表示,将可见证据、确定性规范化与业务解释分离;定义分层质量向量与风险泛函,保留诊断信息而不把错误坍缩为词面分数;用预设的关键字段约束与不确定性上界形式化非补偿性验收门控,防止强聚合分掩盖金额、标识符、符号、期间或实体关联上的失败;把选择性自动化建模为考虑残余风险、人工审核容量与审核成本的受限路由问题;规定审核者核实、纠正或升级所需的证据与解释包;给出标注、抽样、统计报告与可复现性协议;并把框架翻译成含版本化接口、失效安全状态、分阶段发布、审计事件与再认证的生产控制面蓝图。作者明确声明这是理论与方法学贡献,不提出新模型、数据集或实证性能结果。
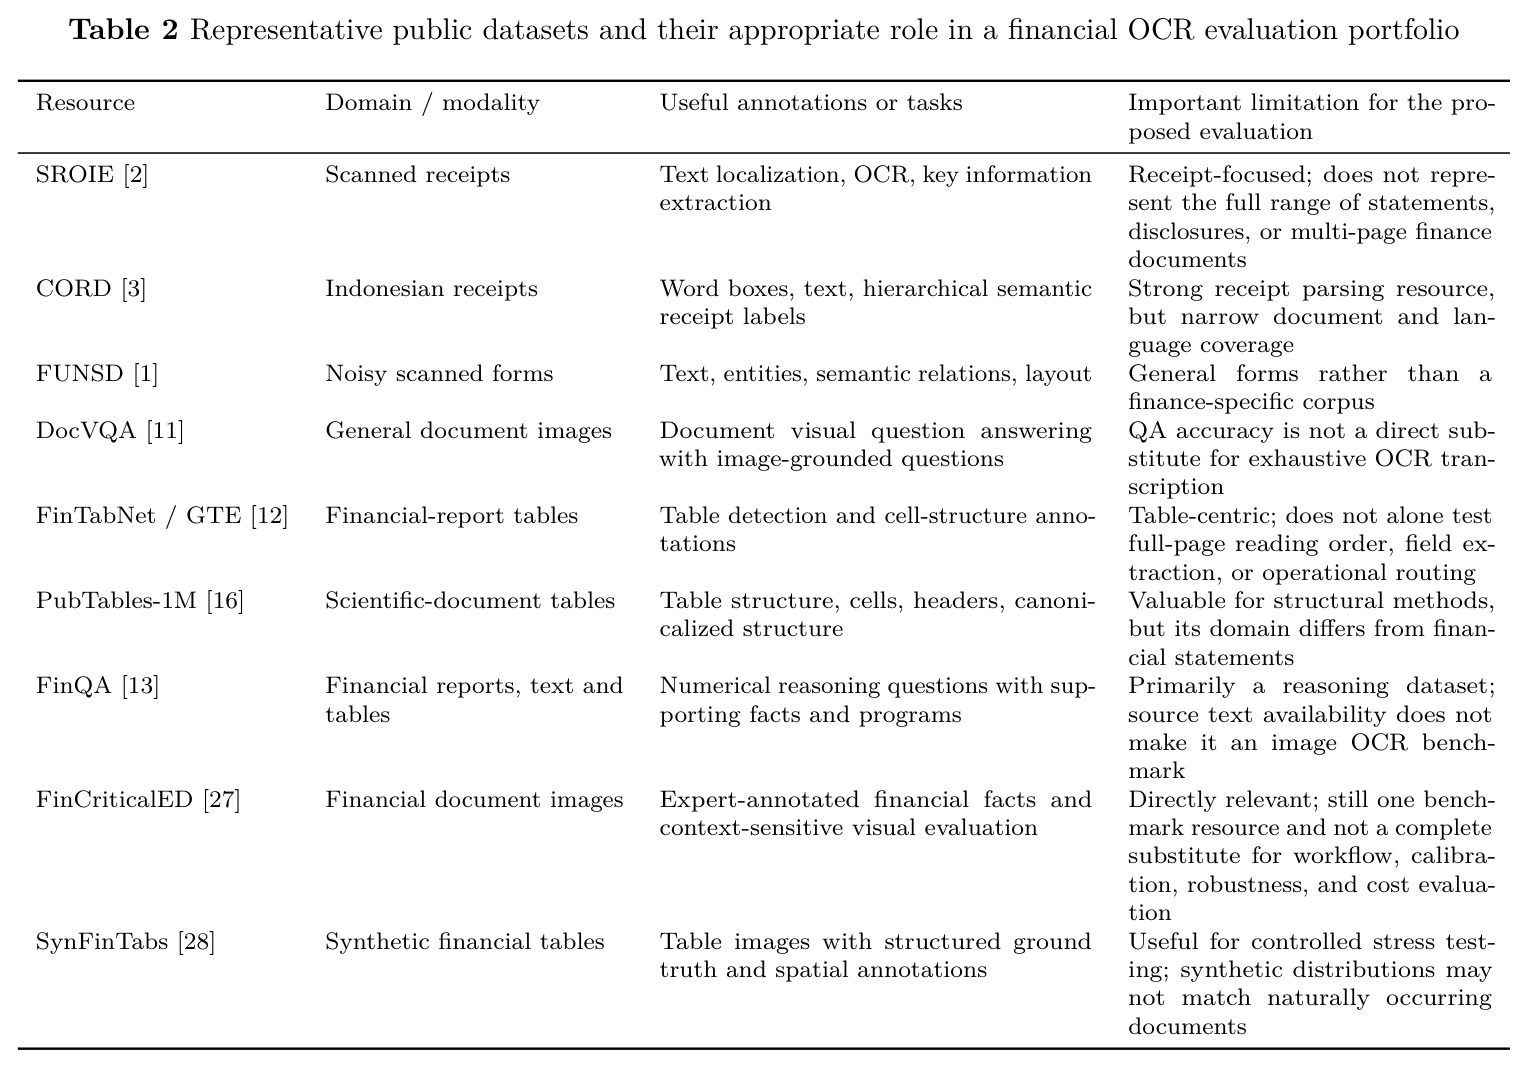
与已有工作不同的是,本文的独特切入是补上现有工作缺失的“形式化治理层”。现有文档 AI 基准(OCRBench/v2、OmniDocBench、MMLongBench-Doc)评测通用任务,表格资源(FinTabNet/GTE、PubTables-1M、SynFinTabs)聚焦结构还原,而与金融最相关的 FinCriticalED 虽已证明事实级视觉评测优于词面相似度,但仍是单一基准资源,不覆盖工作流、校准、鲁棒性与成本评估。本文不与之竞争,而是给出关键性估计量(文档优先与字段优先两种总体估计量)、单侧置信上界、聚类抽样、选择性路由、审核者产出估计量与运营约束的数学定义,并用四个命题奠定理论基础。另一处独特性是把人工审核本身变成可测对象:评估应区分“机器错误被审核者纠正”“机器错误被审核者误接受”“正确输出被不必要地修改”“歧义升级待裁决”四类结果,而不是把“存在人工检查点”默认为安全性的充分证据。
核心方法
直觉上,一份金融文档的价值不在字符本身,而在“哪些数字支撑哪些业务动作”,所以评估单元应是从图像可见区域锚定的类型化事实。技术路线分五步。第一步定义证据锚定标注(定义 1):每个字段记录精确可见原文片段、逐字转录、声明规范化规则下的类型化规范值、语义角色与单位,以及缺失/无法辨认/歧义/不适用四类显式状态,规范化不得静默修复不确定源文本。第二步统一输出契约:OCR 管线、版面感知模型与免 OCR 模型经适配器输出检测区间、多边形、阅读顺序、表/单元格 ID、类型化字段值、币种/单位/符号/日期解释、置信度(缺失须报“不可用”而非补 0)与弃权状态,免 OCR 模型也必须给出视觉证据引用。第三步计算十维分层质量向量 $Q(s) = (Q_{det}, Q_{txt}, Q_{lay}, Q_{tab}, Q_{fld}, Q_{fact}, Q_{evd}, Q_{cal}, Q_{rob}, Q_{ops})$。第四步按工作流把字段划入 C0(装饰性)至 C4(安全/合规/法律攸关)五级关键性并设门控。第五步把选择性自动化建模为带约束路由,配合防泄漏划分、统计报告协议与四级部署决策。
核心创新是“非补偿性验收 + 零错误统计上界 + 损失敏感路由”的组合。其一,加权损失 $L_{crit} = \frac{\sum_f w_f e_f}{\sum_f w_f}$ 只用于排序监控,验收由门控乘积决定:$\mathrm{Pass}(s) = I\{Q_{aggregate} \ge \tau\} \prod_{g \in G} I\{U_g(s; \alpha_g) \le \eta_g\}$,其中 $U_g$ 是错误率的单侧置信上界而非点估计——即使零观察错误,上界 $U = 1 - \alpha^{1/n}$ 也不为零(命题 2)。其二,关键金融事实是七元组 $f = (entity, attribute, value, unit, period, polarity, evidence)$,所有分量一致才算正确,天然捕捉金额量级错配、日期期间漂移、借贷极性反转、报告实体错误与脚注脱钩。其三,是否自动化由决策单元的校准置信 $c_s(X)$ 与预期损失决定而非固定阈值:审核更优当且仅当 $q < 1 - r_H - c/L$(命题 3),并在门控约束与审核率上限 $B$ 下最小化目标 $J(t)$;无可行阈值即不具备自主处理资格,且不得在观察测试错误后放宽阈值。
方法步骤详情
步骤一(真值工程):按文档/区域/字段三级标注,字段级含 verbatim_text、canonical_value、单位、period、polarity、entity_key、evidence_polygon、criticality 与裁决状态;关键字段独立双标注并裁决分歧(分为标注员错误、证据歧义、schema 歧义、源文档不一致四类),不可裁决字段标注显式“歧义”状态。步骤二(质量测量):文本层报微/宏平均 CER/WER;定位层在 $IoU = \frac{|P \cap G|}{|P \cup G|}$ 阈值下报查准/查全/F1;版面层对阅读顺序先序关系算成对 F1;表格层报单元格 F1、行列边界与表头关联;字段层用 $M_f = I\{\mathrm{canon}(\hat{v}_f) = \mathrm{canon}(v^*_f)\}$ 做类型化精确匹配(金额用十进制算术);事实层要求七元组全对,并报证据覆盖率与查准率、Brier/ECE 及校准切片。步骤三(风险层):报关键错误率 $\mathrm{FCR}_{crit} = \frac{\sum_f H_f I\{\hat{f} \neq f^*\}}{\sum_f H_f}$(缺失、多余、错关联、无证据支持均计错),配发票总额、滚动余额等一致性校验器并区分源不一致与系统不一致。步骤四(验收与路由):用公式 (21) 判资格,在校准集求满足约束的阈值,封存测试集一次性评估。步骤五(统计与运营):分层估计 $\hat{\theta}_{strat} = \sum_h \pi_h \hat{\theta}_h$、文档级配对 bootstrap、稀有事件 $3/n$ 与 Clopper–Pearson 界、Holm 校正;运营层报 p50–p99 延迟与单位成功成本 $C_{success}$。步骤六(部署):影子模式→人工辅助→受限自动化→限定范围生产,配控制面、幂等接口、失效关闭与再认证。
技术新颖性
技术新颖性集中在四个形式化命题与一套可执行规范。命题 1(补偿性掩盖)构造性证明:对任意权重 $w_k > 0$、$\sum_k w_k = 1$ 的加权分数,存在系统 A(非关键维全 1、关键维 0,$S(A) = 1 - w_j$)与系统 B(各维均为 $b < 1 - w_j$),使 $S(A) > S(B)$ 但 $q_j(A) = 0 < b$——复合分数不能认证安全约束,只能在可行性确立后用于排序。命题 2 给出零观察错误的 Clopper–Pearson 上界 $U = 1 - \alpha^{1/n}$ 与样本量下界 $n \ge \frac{\log\alpha}{\log(1-\eta)}$,并警告把同一流水的多页当独立试验会低估不确定性。命题 3 的审核条件 $q < 1 - r_H - c/L$ 显式指出通用置信阈值不跨字段最优,右端非正时审核在任何质量水平下都不占优。命题 4 证明覆盖率 $\gamma(t)$ 随阈值单调不增而选择性风险不必单调,纠正“阈值越高越安全”的直觉。此外,文档优先估计量 $R_P(s) = E_X[\frac{\sum_i w_i \ell_i}{\sum_i w_i}]$(每文档贡献一个归一化损失)与字段优先估计量的显式区分、审核者误接受率/误纠正率作为估计量,都是文献中少见的系统化处理;与 FinCriticalED 等基准论文互补——那是资源,本文是治理层。
实验结果
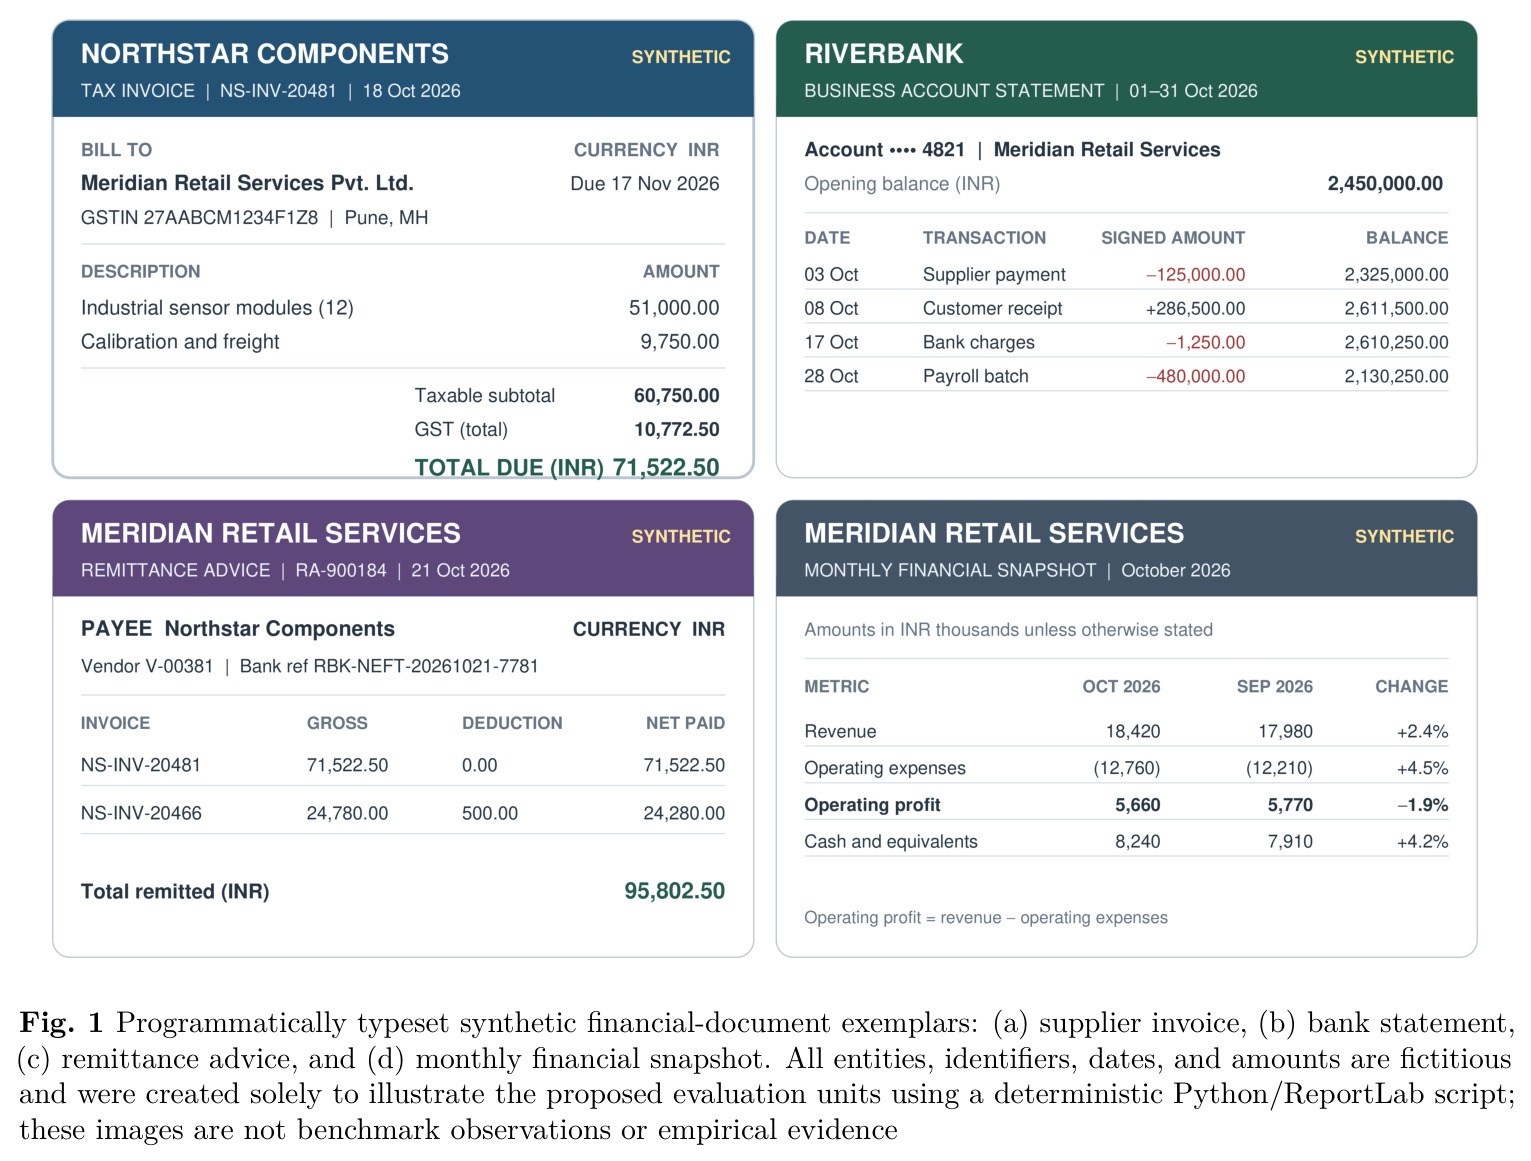
必须首先强调:本文是纯理论/方法论贡献,作者明确声明不提出新模型、数据集或实证性能结果,所有数值示例均为合成演示。核心“发现”是四条数学结论与两个合成推演。命题 1 证明任意加权平均都存在补偿性掩盖:系统 A 各非关键维取 1、关键维取 0 得分 $1 - w_j$,系统 B 各维取 $b < 1 - w_j$,A 总分更高却在关键维为 0。命题 2 证明 $n$ 次独立试验零错误时的单侧 $(1-\alpha)$ 上界为 $U = 1 - \alpha^{1/n}$:要证明错误率 $\le 10^{-3}$(95% 置信)约需 2,995 个独立关键实例,近似 95% 界即三次法则 $3/n$。命题 3 给出损失敏感审核条件 $q < 1 - r_H - c/L$($q$ 为字段正确概率,$L$ 错误损失,$c$ 审核成本,$r_H$ 审核后残余错误率),右端非正时审核在任何 $q$ 下都不占优。命题 4 证明覆盖率单调不增而选择性风险不必单调。合成决策示例演示门控逻辑:系统 A 总分更高但符号错误置信上界超限,按公式 (21) 不具备自动处理资格;系统 B 总分较低但全部门控通过。端到端路由示例中,系统把工资借方“(480,000.00)”读成正数,词面接近但规范极性错误,滚动余额校验器独立报警,策略引擎记录 C3/C4 门控失败并附源裁剪图转人工,下游过账在门控解决前保持禁用。
局限与改进
作者承认的局限:其一,框架纯属理论方法学,未经实证验证——未发布基准数据集、经标注员验证的标注手册、软件实现或审核者绩效测量数据,人工审核估计量只是设计规格,需真正的人类评估研究;其二,风险权重与关键性等级依赖具体工作流(同一日期在搜索索引中是 C2,决定申报截止时是 C4),不存在普适权重,分数不构成监管合规认证;其三,一致性校验器在特殊会计处理(舍入、冲销、辖区惯例)下可能失效,须限定范围并版本化;其四,基准数据未必代表未来部署分布,模板与时间保留集只能缓解;其五,校准可能在模型或分布变化后恶化;其六,OCR 基准无法证明下游金融操作合法或恰当,人工授权与交易控制在指标层之外。我的补充观察:框架参数负担很重——$\eta_g$、$L$、$c$、$r_H$、$\lambda$、审核容量 $B$ 都需要组织级风险政策设定,缺乏这种治理能力的团队难以落地,论文虽引用共形风险控制文献却未给出数据驱动的阈值估计方法;审核成本模型假设单一 $r_H$,审核者异质性、相关错误与排队延迟仅被顺带提及而未建模;也没有案例研究展示真实机构落地的成本、周期或组织阻力。
独立分析的弱点
第一个弱点是“规范有余、工具为零”:论文给出 33 个公式、完整标注 schema 与控制面设计,却没有参考实现,落地团队要自行编写评估器、门控引擎与审计日志;最直接的改进是发布开源评估 harness(指标服务、门控引擎、可复现性卡生成器),把框架变成可安装的工具。第二个弱点是损失参数不可观测:$L$(错误损失)、$c$(审核成本)、$r_H$(审核后残余错误率)在实践中难以估计,改进方向是用历史审核日志做层次贝叶斯估计,或按论文已引用的共形风险控制给出分布无关的阈值校准,替代手工设定的 $\eta_g$。第三个弱点是审核者建模过简:假设同质残余错误率 $r_H$ 与独立试验,忽略异质技能、相关错误与排队延迟(作者自己承认),可扩展为排队论模型并按审核者技能分层评估。第四个弱点是估计量选择缺乏指引:文档优先与字段优先估计量回答不同问题,论文只要求“标注清楚”,可给出按下游消费者(人看报表还是系统过账)选择的决策树。第五个弱点是跨文档一致性只有校验公式而未定义指标与误差归因(发票-采购单-汇款-流水三方核对是金融刚需),是最值得补的实证方向。
未来方向
作者第 16 节列出六个可检验的实证问题:(i) 关键性加权评估是否比词面误差更能预测下游纠正成本;(ii) 哪种证据溯源协议能同时可靠地适用于依赖 OCR 与免 OCR 的模型;(iii) token 级与字段级置信分对关键金融错误的预测力如何;(iv) 现实聚类结构下界定稀有关键错误需要多大样本量;(v) 发票、采购单、汇款通知与银行流水的跨文档一致性如何评测;(vi) 公共基准 schema 能否在不抹除本地惯例的前提下支持多语言与多辖区金融格式。基于论文成果还可延伸:把命题 3 的损失敏感条件与共形预测结合,得到有限样本、分布无关的自动接受阈值;把 C0–C4 关键性分级与会计准则的重要性水平(materiality)对齐,形成行业模板库;为免 OCR 大模型设计“证据引用率”探针,量化幻觉率与证据覆盖率的互动;按第 9 节规范实例化一个开源金融 OCR 基准(含模板、机构、时间三维保留集),检验风险感知指标与真实事故率、纠正成本的相关性;以及在多审核者、多班次的真实运营中测量论文提出的审核者估计量。
复现评估
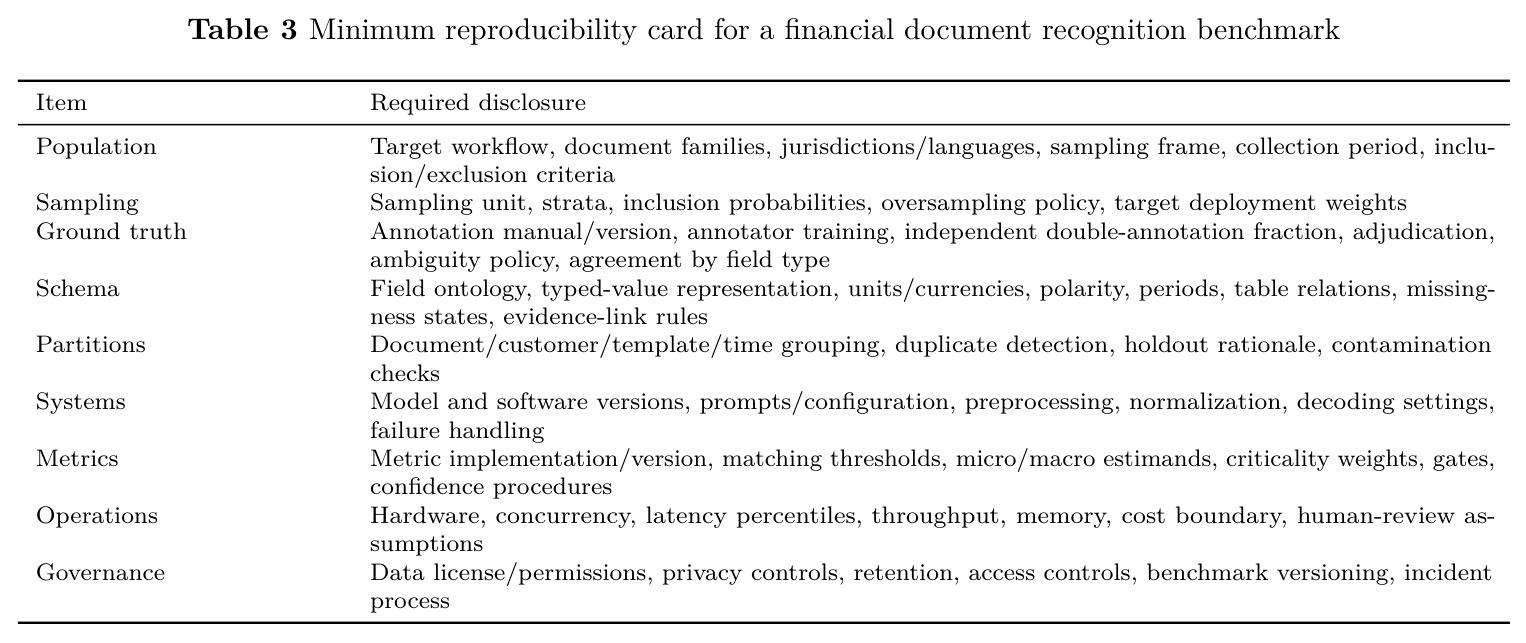
复现性要分两层看。规范层:论文以自身第 9.3 节与表 3 的标准衡量执行得较好——四张合成示例图由确定性 Python/ReportLab 脚本生成,图像文件与脚本随 arXiv 源码档案发布,全部公式、标注 schema、防泄漏划分规则与统计方法均完整给出,零算力即可核验。实证层:无可复现实验——没有数据集、没有系统评测、没有人类审核研究;“复现本文”实际上是“按规范实现一套评估系统”,工作量集中在真值工程(双标注、裁决、歧义状态管理、跨划分防泄漏)与组织级风险参数设定,而非计算资源。对研究者的可行路径:先从表 4 记分卡中挑选字段/事实/风险/证据四个关键维度子集,用 SROIE、CORD、FUNSD、FinTabNet/GTE、SynFinTabs 等公开资源做组件诊断(注意各自许可证与隐私条款),企业侧再按表 3 卡片补齐披露项并封存测试集。综合难度评级中等偏高:代码不难写,难在标注一致性的制度化与风险政策的组织落地。
论文图表
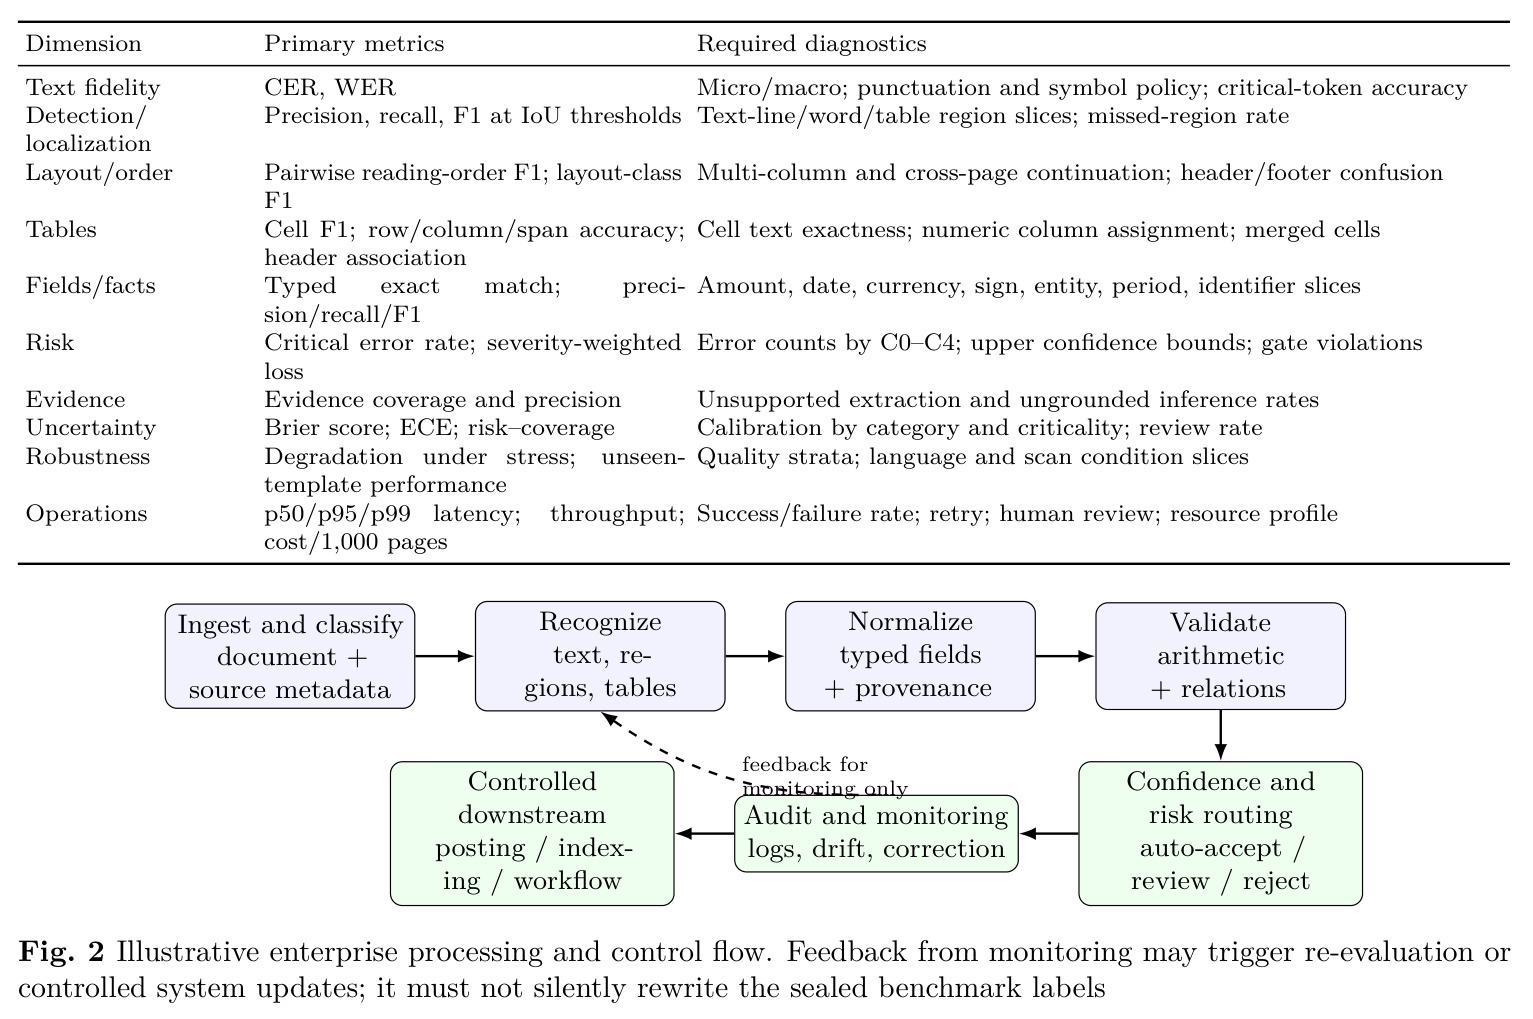
企业记分卡的十个维度、主指标与必报诊断:文本保真(CER/WER,微/宏平均、标点符号政策、关键 token 准确率);检测与定位(预设 IoU 下的查准/查全/F1,文本行/词/表区域切片、漏检率);版面与顺序(成对阅读顺序 F1,多栏与跨页延续、页眉页脚混淆);表格(单元格 F1、行列/跨度准确率、单元格文本精确性、数值列归属、合并单元格);字段与事实(类型化精确匹配、金额/日期/币种/符号/实体/期间/标识符切片);风险(关键错误率、严重度加权损失,C0–C4 错误计数、置信上界、门控违规);证据(证据覆盖率与查准率,无支持抽取与无证据推断率);不确定性(Brier、ECE、风险–覆盖,按类别与关键性校准、审核率);鲁棒性(压力退化、未见模板性能,语言与扫描条件切片);运营(p50/p95/p99 延迟、吞吐、每千页成本,成功/失败率、重试、人工审核、资源画像)。
它是第 5–12 节所有质量层的落地汇总,等于给实现者一张“该算什么指标、报什么切片”的完整规格表;任何按本文框架搭建评估系统的人都应以此为验收清单,也与四级部署决策直接挂钩。