SWE-Trail:面向编码智能体训练的历史引导轨迹采集 SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
历史引导轨迹采集:只定投入位置、不进智能体上下文,解决率提升2.33点
前置知识
编码智能体与轨迹(Trajectory)
编码智能体是在真实代码仓库里通过多轮「思考—调用工具—观察反馈」定位并修复 issue 的 LLM 系统,常运行在 OpenHands 等脚手架上。一条轨迹(trajectory/rollout)记录从阅读 issue 到产出补丁的全部推理、动作与观察序列,可直接作为监督微调的训练样本。
本文研究的正是「轨迹如何被采集才更有训练价值」,先理解轨迹的结构与用途才能读懂采集机制的设计动机。
SWE-bench 与解决率(Resolution)
SWE-bench 系列基准给出真实仓库的 issue 与配套测试用例,模型提交补丁后由测试判定成败,解决率即通过全部测试的任务占比,是编码智能体的标准评测指标。论文使用 Multilingual(300 题)与 Pro(731 题)两个变体。
论文用固定学生模型在两个基准上的解决率差异来衡量不同采集方式的下游训练价值,所有结论都建立在这个指标上。
拒绝采样与 SeedBank
后训练中常见的数据构造范式:对每个任务独立采样多条轨迹,再按测试通过或评委打分筛选保留。SeedBank 是论文中每 issue 独立采样 5 条的基线数据池,也是 SWE-Gym、SWE-TRACE、SWE-Lego 等事后加工方法共用的原料。
理解独立采样范式及其冗余问题,才能看出历史引导采集相对于事后筛选的本质差异。
检查点恢复与沙箱并行执行
在容器化沙箱中保存对话状态与仓库工作区快照,可从同一检查点克隆出多个隔离环境,分别执行不同的候选动作序列后再比较结果。这是让「短暂对照实验」在智能体采集中成立的工程前提。
SWE-Trail 在线阶段的核心动作就是从同一检查点并行执行两条候选路线,再按仓库证据择优保留。
训练-测试不一致(Train-Test Mismatch)
若训练轨迹中的推理是在看到某辅助信息(如经验建议)之后产生的,而测试时模型没有这些信息,那么模型学到的决策就依赖了测试时不存在的前提,迁移到新任务时会受损,下游性能反而下降。
这是本文坚持历史不进入智能体上下文的核心理由,也直接解释了 SWE-Exp 基线掉点 1.33/2.78 的反常现象。
研究动机
当前构造编码智能体训练数据的主流做法是:对每个 issue 独立采样多条轨迹,再用测试通过与否或评委打分筛选保留,各次采集之间互不通信。论文基于 SeedBank 的 300 个 SWE-rebench V2 issue、每题 5 次独立尝试量化了这种冗余:期望解决的 issue 数从 k=1 的 58.4 增至 k=2 的 71.5(+13.1),继续增加到 k=3、4、5 时仅分别再增 8.0、5.1、3.4,边际收益迅速衰减;补丁目标文件的覆盖率在第一次尝试就已很高——stable-solved 历史达 90.0%、mixed 达 73.2%、never-solved 达 80.1%。更能说明问题的是失败尝试的盲目重复:全失败 issue 中,失败轨迹修改文件的成对 Jaccard 重叠均值达 0.841,198 个可计算 issue 里有 93 个重叠为 1.0——独立采样在反复失败时并不会自动把精力转向新的修复目标,后期尝试大部分是重复劳动。
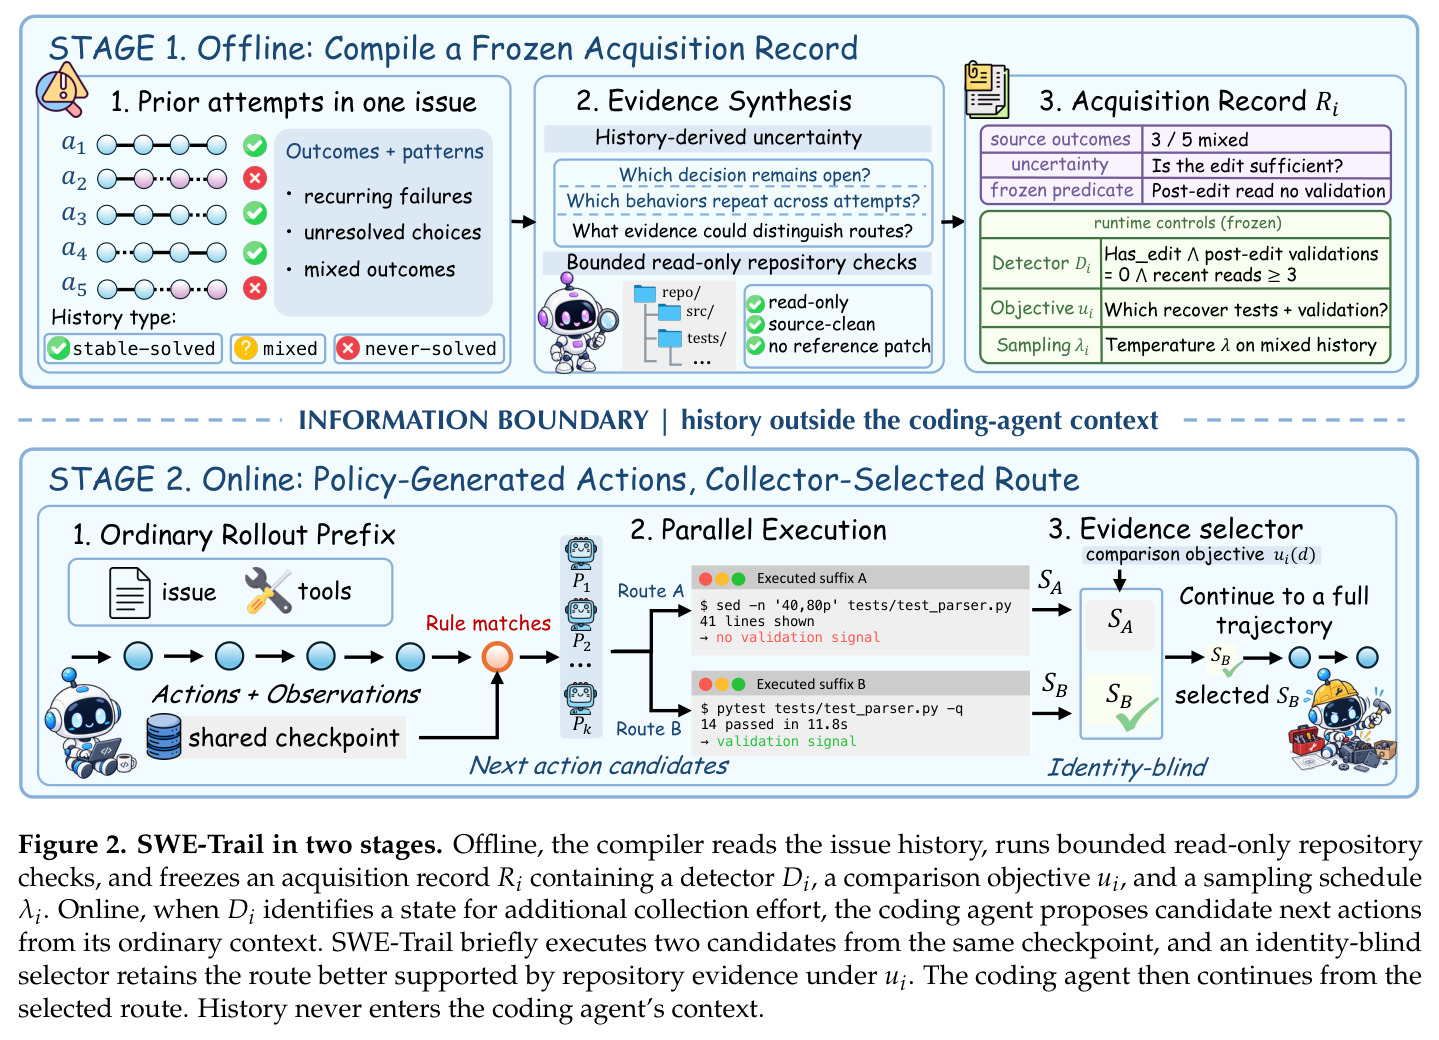
本文的目标是本文的目标是把同 issue 先前尝试(历史 $H_i$)蕴含的分配信号用于新一轮采集:由历史判断哪些状态值得再投入精力、在那些状态应该比较什么证据,但严格保证历史本身不进入编码智能体的上下文。智能体仍然只凭 issue 与仓库快照构成的普通上下文自主推理和选择动作,使训练记录保持与测试时相同的决策条件,规避训练-测试不一致。评估目标是回答一个受控问题:在 issue 集合、轨迹数量(每条件 1500 条)、学生模型(124B Ling-3.0-flash-base)与训练协议(3 次独立 SFT)完全固定的前提下,历史引导采集能否提高学生在 SWE-bench Multilingual(300 题)与 SWE-bench Pro(731 题)上的解决率,并进一步拆分出历史本身、检测位置、保留策略各自的贡献。
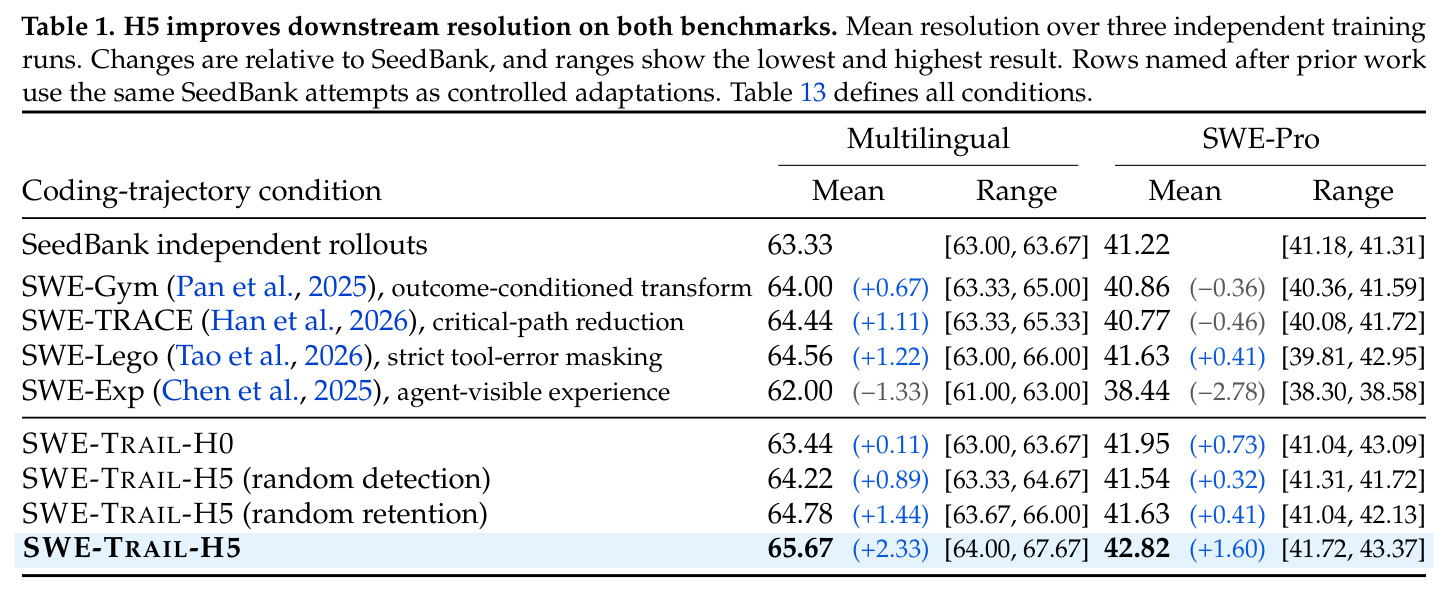
与已有工作不同的是,已有工作分两类。第一类是事后加工:SWE-Gym 按结果筛选、SWE-TRACE 做关键路径缩减、SWE-Lego 做工具报错掩码,它们只在轨迹采完后修剪或掩码,同一 issue 的轨迹仍是独立生成,无法改变采集精力的投向。第二类是把经验写进智能体上下文:SWE-Exp 在采集时给智能体一条由历史编译的建议消息,虽有助于当次解题,但训练出的模型会依赖测试时不存在的建议——实验中它反而比独立采样低 1.33 与 2.78 个百分点。SWE-Trail 的独特切入是设立信息边界:历史由采集器离线编译成检测器 $D_i$ 与比较目标 $u_i(d)$,只在检测到值得投入的状态时,由采集器从同一检查点短暂并行执行候选动作并按仓库证据择优,智能体全程不知情。这把「历史决定花力气的地方」与「智能体决定生成什么」解耦成两个角色,构成介于事后筛选与经验注入之间的第三条路线。
核心方法
SWE-Trail 的直觉是:先前尝试最有价值的不是内容本身,而是它们暴露的分歧点与重复失败模式——相似状态下成功与失败轨迹做出不同选择,说明该状态值得再多比较几条路。方法分两阶段。离线阶段,编译器读取 issue 与仓库快照 $x_i$ 及历史 $H_i$(全程不见参考补丁),抽取分配信号并做有界只读仓库检查,冻结一份采集记录 $R_i$:包含识别值得投入状态的检测器 $D_i$、该状态下的局部比较目标 $u_i(d)$、以及候选生成温度计划 $\lambda_i$(mixed 与 never-solved 历史用更高温度鼓励多样候选)。在线阶段,GLM-5.1 加 OpenHands 脚手架按普通方式 rollout;一旦 $D_i$ 匹配当前状态,智能体从普通上下文采样候选下一步动作,采集器从同一检查点恢复两个隔离工作区各短暂执行一条候选,把两条执行后缀乱序交给身份盲选择器,保留更符合 $u_i(d)$ 的路线,智能体从选中路线继续直到 rollout 结束。每条轨迹至多一次比较,避免膨胀成多级搜索树。
核心创新是信息边界原则:历史只决定采集预算花在哪里(where),智能体自己决定生成什么。与经验注入方法不同,$R_i$、$u_i(d)$ 与历史从不出现在智能体上下文中,训练记录只含智能体在普通上下文里产生的推理与动作,不做任何重写,剔除未选后缀与私有采集事件后仍是一条连续轨迹,监督信号与测试时决策条件一致。与事后筛选的本质区别在于:SWE-Trail 的比较产生新的执行证据——从同一检查点真实运行两条候选路线并观察结果,而非对已完成轨迹打分或修剪;且比较发生在历史指出的高价值状态(例如编辑后只继续阅读、不运行测试)。消融实验显示两个决策缺一不可:随机选比较位置使 Multilingual 从 65.67 掉到 64.22(-1.44),随机保留路线掉到 64.78(-0.89),都显著低于完整 H5。
方法步骤详情
离线编译:输入 $(x_i, H_i)$。先从历史抽取分配信号——成功尝试反复支持的决策、修复路线间的分歧、重复失败模式;再针对遗留疑问做有界只读仓库检查(不改源码、不见参考补丁);把证据、检查结果与未决问题写入私有记录 $R_i$;据 $R_i$ 定义检测器规则(基于动作与观察序列匹配而非固定步号,如「有编辑 ∧ 之后连续读取 ≥3 次 ∧ 无验证」)、每状态的比较目标 $u_i(d)$ 与温度计划 $\lambda_i$;最后将规则回放到已有尝试上做准入校验,证据不足的状态被丢弃,通过后整轮冻结。在线采集:每次新观察后运行时检查 $D_i$;命中时先按普通温度采出默认候选,其余按 $\lambda_i$ 生成;合并等价提案,据 $R_i$ 与 $u_i(d)$ 从短名单选至多一个可执行替代项,无合适替代则按默认继续;否则从同一检查点恢复两个隔离工作区、同一短地平线并行执行得两条后缀;后缀乱序交身份盲选择器,$R_i$ 仅作背景,证据明确偏向一方才替换默认;智能体只在选中工作区继续完成轨迹;导出时保留选中路线原样,删除未选后缀与私有事件。
技术新颖性
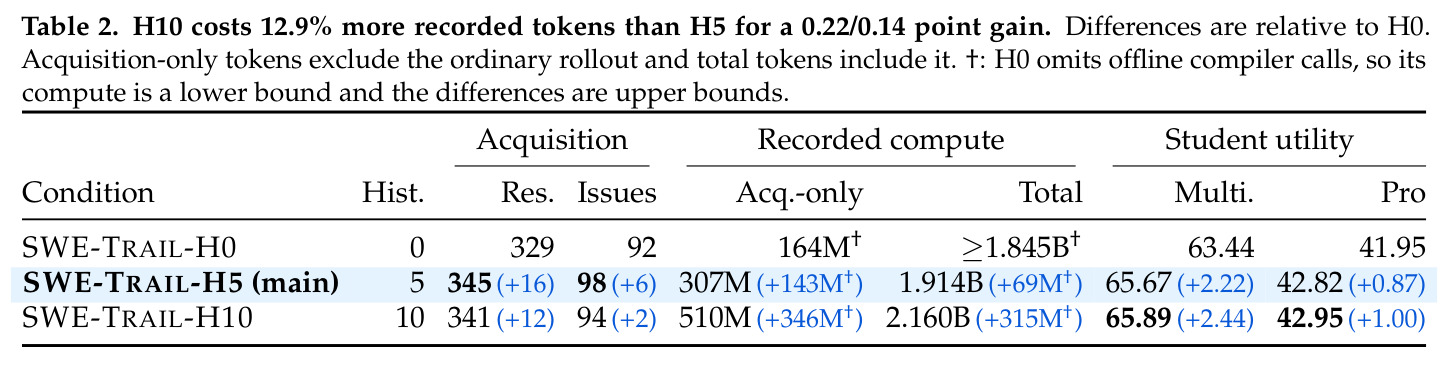
技术新颖性有三点。其一,历史到采集的编译:把轨迹级证据压缩为可冻结、可准入校验的谓词式检测器与局部比较目标,而不是把经验文本塞进 prompt;规则匹配动作与观察序列,使新 rollout 走不同路径也能命中同类状态,解决了「历史经验如何泛化到不同执行顺序」的问题。其二,有界对照式采集干预:不同于树搜索在同一解题过程中展开多层分支,SWE-Trail 每条轨迹只做一次、短地平线的对照实验,既获得真实执行证据,又把开销控制到 H5 相对 H0 至多 3.7% 的额外 token,普通 rollout 反而少用 4.4% 的 token。其三,训练记录完整性:智能体原始推理与动作原样保留、私有信息零泄漏,并有导出检查保证,产出的数据可直接用于 SFT 而无需二次清洗——这与 SWE-Exp 那类「事后删掉建议也去不掉其对生成过程影响」的方案形成鲜明对比。
实验结果
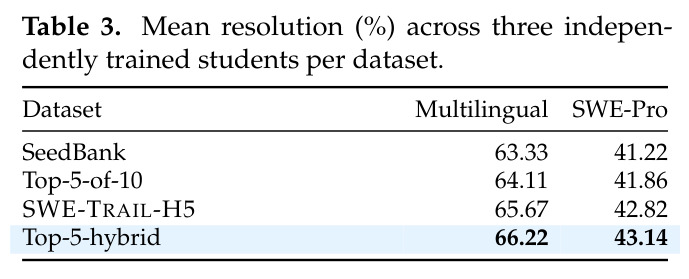
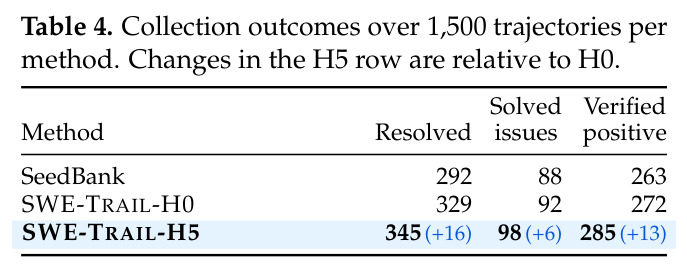
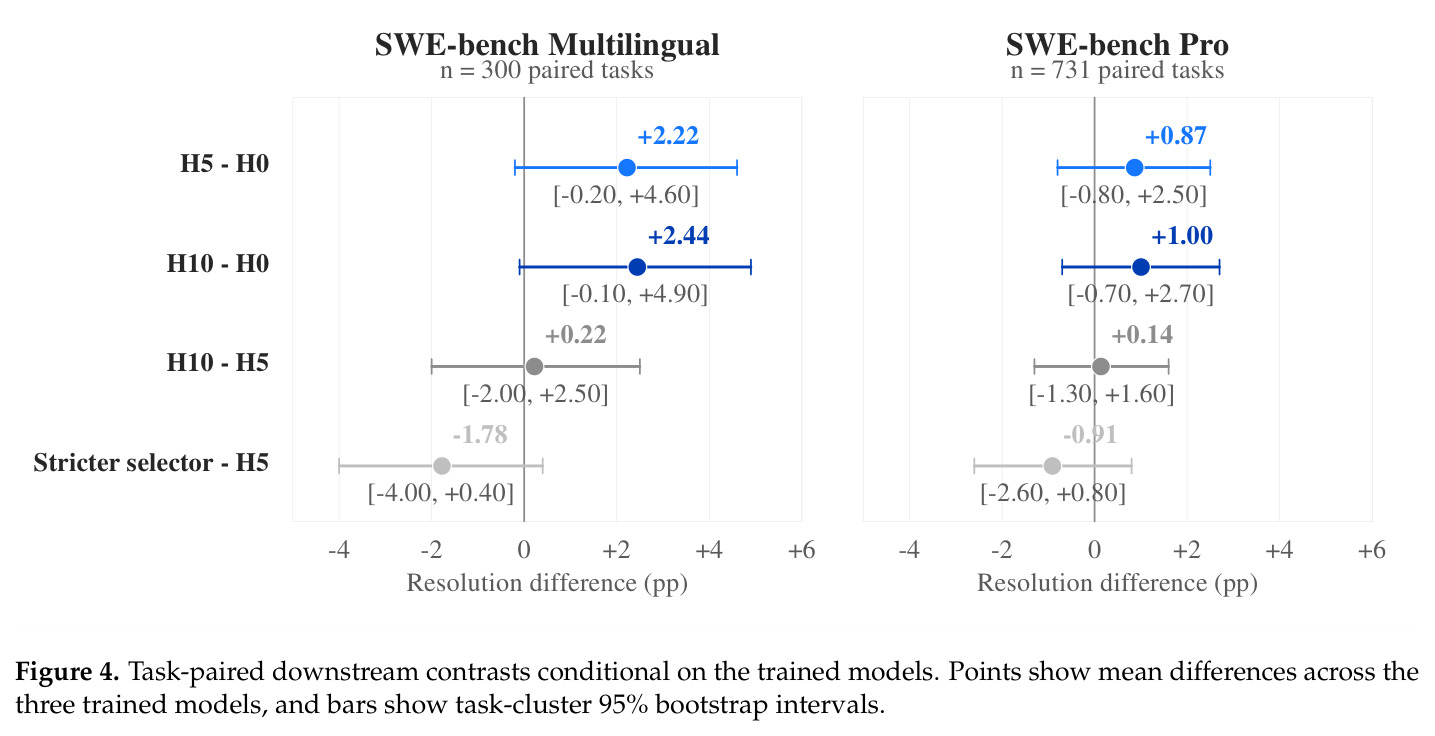
实验固定 300 个 issue、每条件 1500 条轨迹(GLM-5.1 采集),124B 学生做 3 次独立全参数 SFT。H5 在 Multilingual 达 65.67,较 SeedBank 63.33 提升 2.33 点;Pro 达 42.82,较 41.22 提升 1.60 点(置换检验 p=0.05)。无历史的 H0 仅 +0.11/+0.73,虽然解出轨迹 329 条多于 SeedBank 的 292 条,学生却几乎不涨,说明采集成功不等于训练价值;经验注入基线 SWE-Exp 反而 -1.33/-2.78,印证建议进上下文引发训练-测试不一致。随机化检测点或保留路线分别使 Multilingual 掉 1.44 与 0.89 点,两个决策缺一不可。H10 较 H5 仅 +0.22/+0.14,采集专用 token 却从 307M 增至 510M,历史规模收益递减。增益跨学生成立:Qwen3-14B-Base 上较 SeedBank +3.11/+2.42。纯选择法 Top-5-of-10 低于 H5 1.56/0.96 点,而 Top-5-hybrid 达 66.22/43.14、反超 0.56/0.32 点,二者互补。增益集中于 mixed 历史:51/300 issue 贡献 16 条新增解出轨迹中的 13 条。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SWE-bench Multilingual(300 题,124B 学生) | 平均解决率 %(3 次训练均值) | 65.67(SWE-TRAIL-H5) | 63.33(SeedBank 独立采样) | +2.33 个百分点;较无历史对照 H0(63.44)+2.22 |
| SWE-bench Pro(731 题,124B 学生) | 平均解决率 %(3 次训练均值) | 42.82(SWE-TRAIL-H5) | 41.22(SeedBank 独立采样) | +1.60 个百分点;较 H0(41.95)+0.87 |
| SWE-bench Multilingual(Qwen3-14B-Base 学生) | 平均解决率 % | SWE-TRAIL-H5 | SeedBank 独立采样 | +3.11 个百分点;较 H0 +1.67 |
| SWE-bench Pro(Qwen3-14B-Base 学生) | 平均解决率 % | SWE-TRAIL-H5 | SeedBank 独立采样 | +2.42 个百分点;较 H0 +1.60 |
| SWE-bench Multilingual / Pro(124B 学生,vs 事后选择法) | 平均解决率 % | 65.67 / 42.82(SWE-TRAIL-H5) | 64.11 / 41.86(Top-5-of-10,10 条选 5) | +1.56 / +0.96 个百分点;Top-5-hybrid 达 66.22/43.14,反超 H5 +0.56/+0.32 |
局限与改进
首先是统计强度:H5 相对 H0 的提升点估计为正(Multilingual +2.22、Pro +0.87),但任务配对 bootstrap 的 95% 置信区间为 [-0.2, 4.6] 与 [-0.8, 2.5],均包含 0;置换检验 p=0.05 恰在显著性边缘;随机保留在 Multilingual 上达到 64.78,运行区间与 H5 重叠,部分增益的解释仍需谨慎。其次是设置单一:只用了 GLM-5.1 一种采集模型、OpenHands 一种脚手架,历史在每轮采集内固定不更新,每个 issue 使用相同采集预算;数据规模也小(300 issue、1500 条轨迹),2.33 点约等于在 300 题基准上多解 7 题。再次是方法前提:依赖支持检查点恢复的沙箱环境,检测器与编译质量依赖很强的 LLM(准入审计用了 GPT-5.6-Sol 与 GLM-5.1 双模型),扩展到代码之外尚属设想。
独立分析的弱点
独立分析几个弱点。其一,历史静态:一轮采集内 $R_i$ 冻结,新 rollout 的结果不回馈更新检测器,若编译出的规则对某 issue 长期无效,预算会被反复浪费;改进方向是滚动更新历史并在线再编译。其二,预算均匀:每 issue 固定 5 条轨迹,而增益集中在 51 个 mixed issue(贡献 16 条新增解出轨迹中的 13 条),按历史类型或不确定度自适应分配预算会更划算。其三,候选利用率低:约 90% 的比较点能采出至少 2 个不同动作,但替代路线只在约 37.4% 的完成比较中被保留,近三分之二的比较只是确认默认路线本就更优,可研究更多样的候选提案策略(作者在附录 G.1 的回放审计中也指出此点)。其四,检测器精确率未被系统量化:误报会把预算花在不值得的状态,论文只报告了准入校验,缺少对实际命中状态的审计。其五,每条轨迹只允许一次比较,同一 rollout 后续经过其他检测状态的机会被全部放弃。
未来方向
作者提出的方向:更换采集模型与脚手架以验证普适性;跨轮更新历史、按 issue 差异化分配采集预算;测试更多样的候选提案;把方法推广到支持状态恢复与反馈比较的其他环境,网页导航被点名。基于本文成果可延伸的工作包括:把 SWE-Trail 与事后选择组合成标准数据管线(Top-5-hybrid 已显示互补性,66.22/43.14 反超 H5);用检测器状态作为过程监督或 RL 奖励信号,把「值得比较的状态」用于训练时的信用分配;研究历史规模与收益的定量关系——5 次到 10 次尝试的增益从 +2.22 骤降到 +0.22,暗示存在收益递减曲线,值得建模以指导采集预算规划;以及探索增量式编译以摊薄离线开销,让 H5 级别的质量以更低 token 成本获得。
复现评估
复现门槛偏高。数据侧:采集 issue 来自 SWE-rebench V2(附录 C 核查与评测基准无仓库重叠),评测用公开的 SWE-bench Multilingual(300 题)与 SWE-bench Pro(731 题);附录 B 给出算法与准入检查,附录 F.5 给运行时设置与导出检查,附录 H.1 有端到端案例,细节披露较充分。算力与模型侧:124B 学生全参数 SFT 需要 128 张 H800;采集用 GLM-5.1,H5/H0 的采集专用 token 分别约 307M/164M、记录总量约 1.9B/1.85B;历史审计依赖 GPT-5.6-Sol 与 GLM-5.1 双模型,均为大规模商业模型。正文未声明开源代码或数据;即便按附录自建,沙箱检查点恢复、并行执行、身份盲比较等工程实现的工作量也不小,属于「可复现但昂贵」的类型,小团队建议先以少量 issue 验证 H5 与 H0 的差距再决定是否放大规模。
论文图表
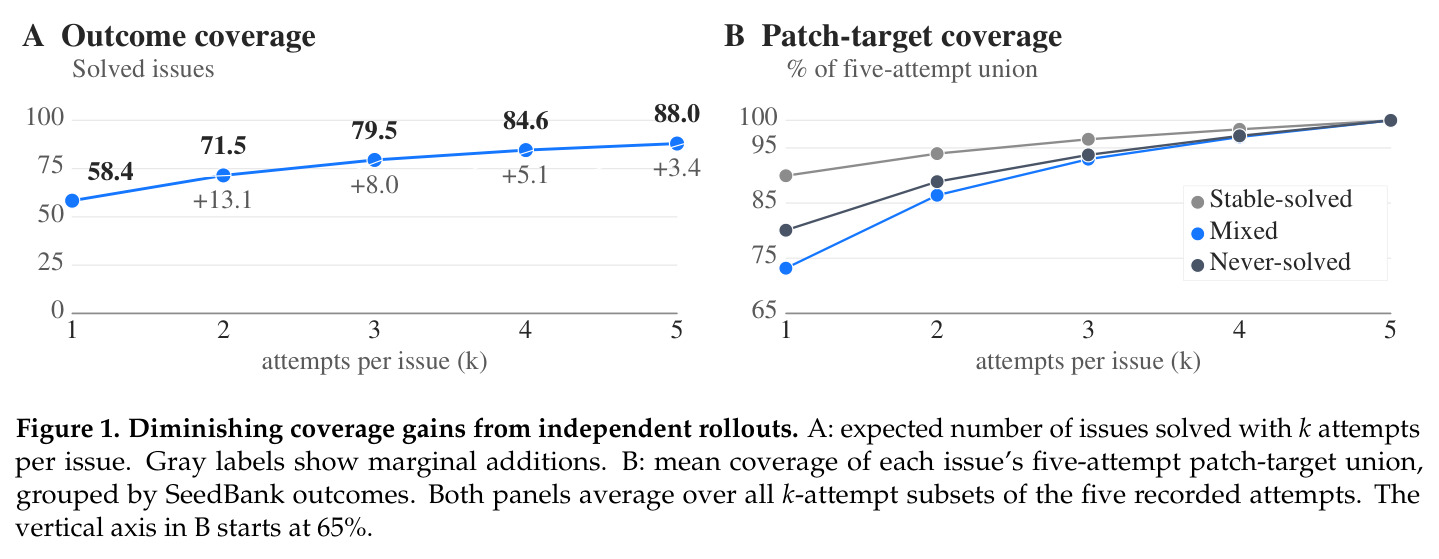
A 图:每 issue 用 k 次尝试时期望解决的 issue 数,k=1 为 58.4,k=2/3/4/5 的边际增量依次为 +13.1/+8.0/+5.1/+3.4,呈明显收益递减。B 图:按历史类型(stable-solved/mixed/never-solved)统计 k 次尝试对五次尝试并集补丁目标文件的覆盖率,1 次尝试已覆盖 90.0%/73.2%/80.1%,后续尝试新增覆盖越来越少。
这是全文动机的实证基础:量化了独立采样的冗余,说明后续采集应当利用历史重新分配精力,而不是继续盲目重复。