ODE 策略:通过动作的动力学而非动作本身学习机器人控制 ODE Policy: Robot Learning via Action Dynamics, Not Actions
用神经 ODE 学习动作的向量场,每个动作由前一个动作积分而来,策略天然连续、高效、平滑。
前置知识
神经常微分方程(Neural ODE)
用一个神经网络参数化连续状态的导数 $\dot{x}(t) = g_\phi(x(t), t)$,轨迹通过数值求解器从 $t_0$ 积分到 $t_1$ 得到;损失对积分结果求梯度时,可以直接穿过求解器步反传,也可以用常数内存的伴随方法反向积分。网络只定义局部变化率,轨迹的连续性与平滑性由积分天然保证。
本文的核心就是把动作本身当作 Neural ODE 的状态:训练时在动作块上积分并监督路径,推理时每个动作从上一个动作单步积分而来。不理解 Neural ODE 的积分、求导机制,就无法理解其路径损失为何不需要动作导数标签、以及伴随方法为何可以避开。
动作分块(Action Chunking)
策略每次处理观测后一次性预测未来 $H$ 个动作并开环执行,由 ACT 与 Diffusion Policy 推广,现已是 π0、GR00T 等大型基础模型的标准配置。研究表明分块能缓解行为克隆的复合误差,开环整块执行常优于逐步闭环更新;但独立预测的块在边界处互不一致,常需时间集成或条件化上一块的已执行动作来缓解。
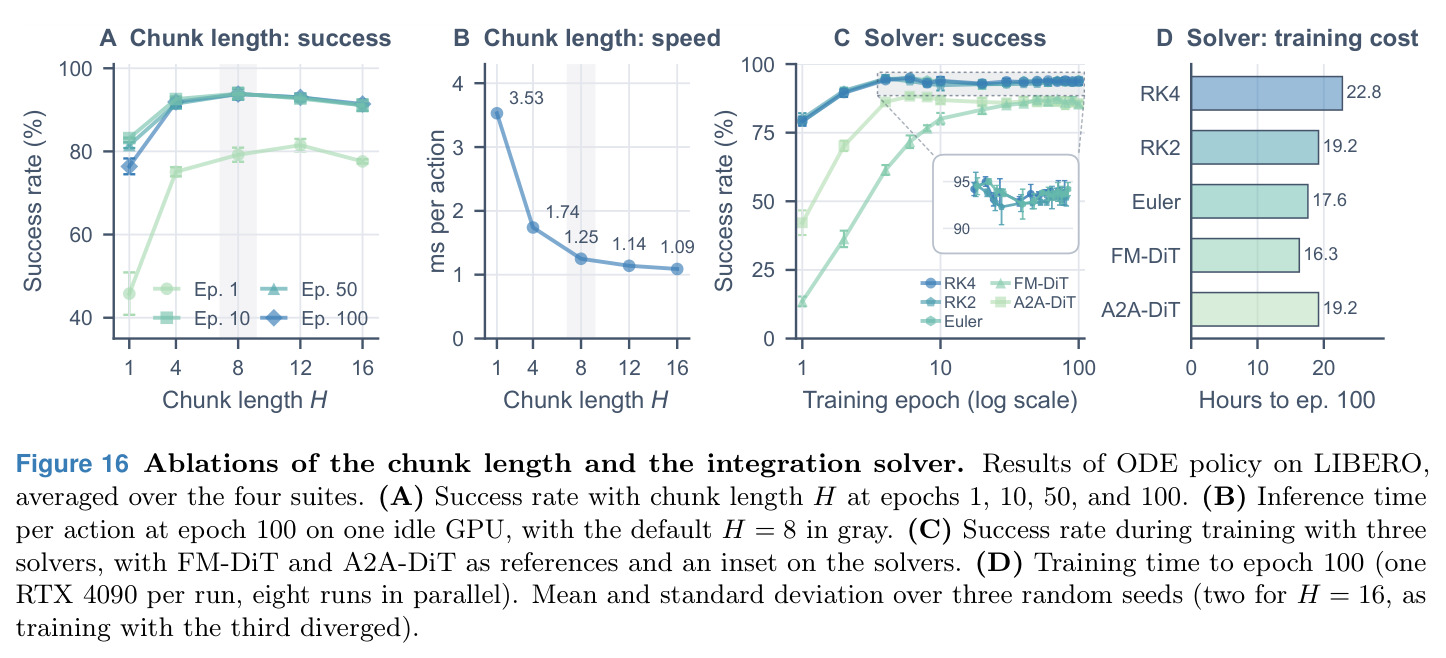
ODE policy 以块为积分与监督单元(默认 $H=8$),消融显示 $H=1$ 只能到 76.4% 而 $H=8$ 最佳;推理时 seamless chunking 从上一块最后一个动作继续积分。理解分块范式才能理解其训练损失设计和推理流程。
流匹配与扩散策略
生成式策略从噪声源出发,学习一个向量场把源样本沿生成时间 $\tau \in [0,1]$ 搬运到目标动作块,需要多次网络评估逐步去噪;流匹配是扩散的确定性推广,是当前 VLA 动作头的主流选择。关键在于 $\tau$ 是无物理意义的生成时间,中间样本不是机器人可占据的状态。
本文所有核心基线(FM-DiT、FM-UNet、DDPM-DiT、DDPM-UNet)都是流匹配或扩散策略,论文反复对比“沿生成时间积分”与“沿机器人物理时间积分”的本质区别,推理速度、平滑性与学习效率的数字都以此为参照。
向量场与数值积分(Euler/RK4)
向量场为状态空间每一点指定速度 $f(a)$,ODE 的解是从起点沿场“顺流而下”的积分曲线;数值方法用 Euler(单步前向)、RK2/RK4(多次场评估的龙格-库塔法)近似积分,精度与计算量递增。Euler 每步 $\hat{a} \leftarrow \hat{a} + f_\theta(\hat{a}) \cdot \Delta t$。
ODE policy 的策略网络 $f_\theta$ 本身就是一个 FiLM-MLP 向量场,训练用 RK4 积分 $H=8$ 步、推理逐动作单步积分。消融证明 Euler 与 RK4 成功率差不到一个点——收益来自 ODE 形式而非求解器精度,这是理解本文贡献边界的关键。
VLA 与 WAM
VLA(视觉-语言-动作模型)在大规模视觉-语言主干上加动作专家,按语言指令执行操作,代表有 π0.5、GR00T N1.7;WAM(世界动作模型)同时建模环境演化与动作序列,代表有 ImageWAM。二者的动作头传统上都是流匹配专家,通常占数亿参数且需多步去噪。
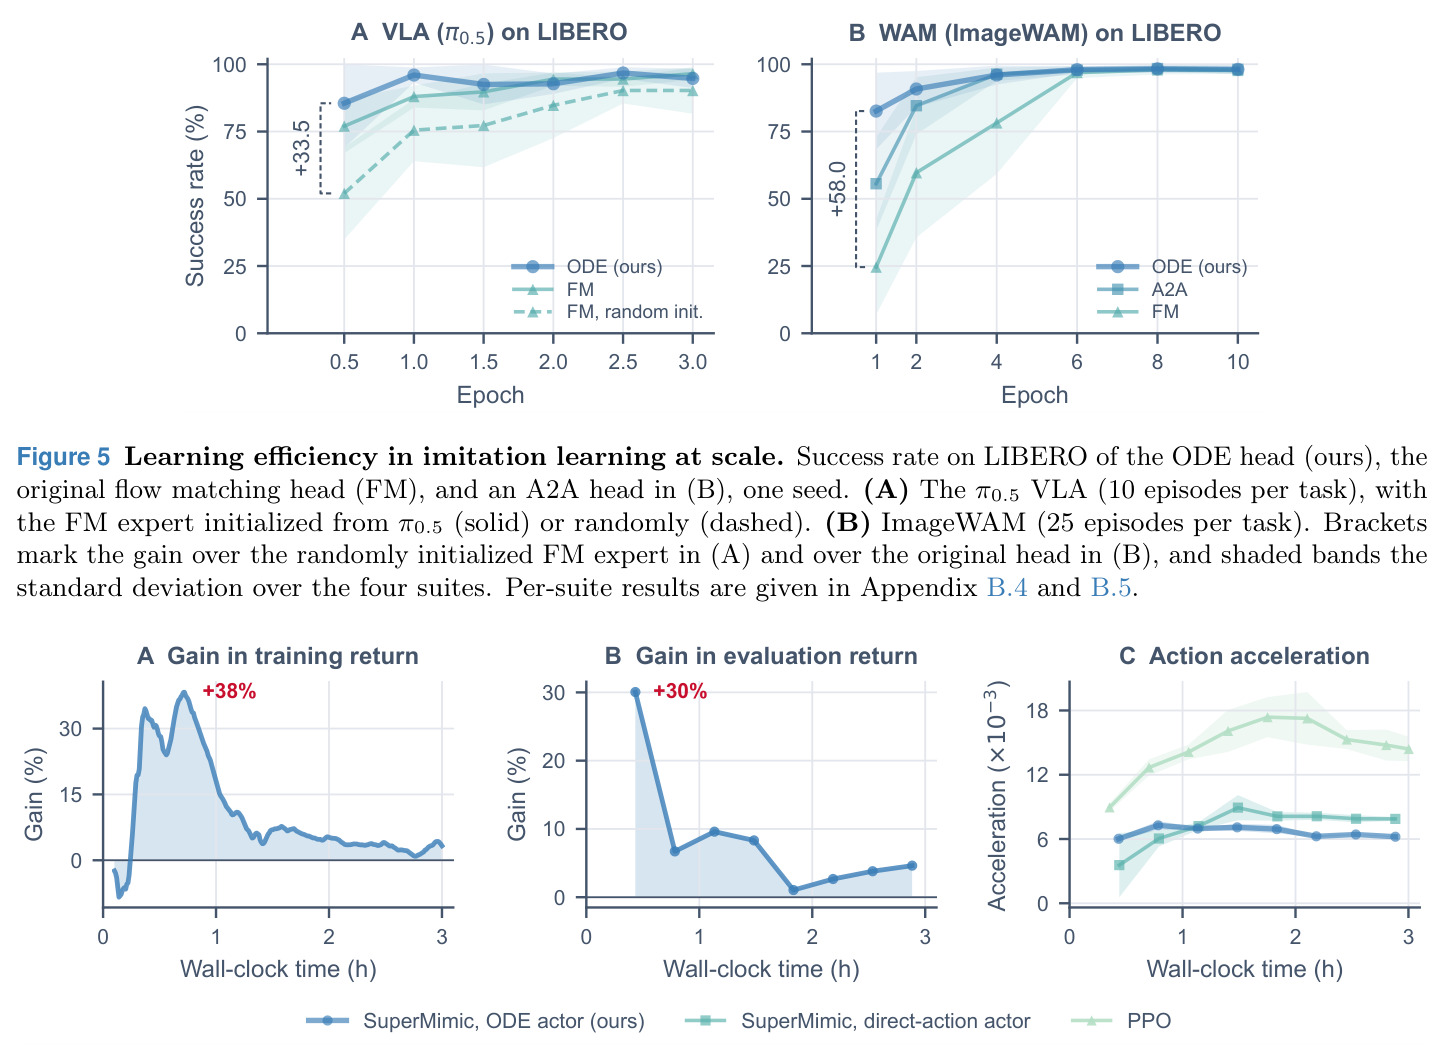
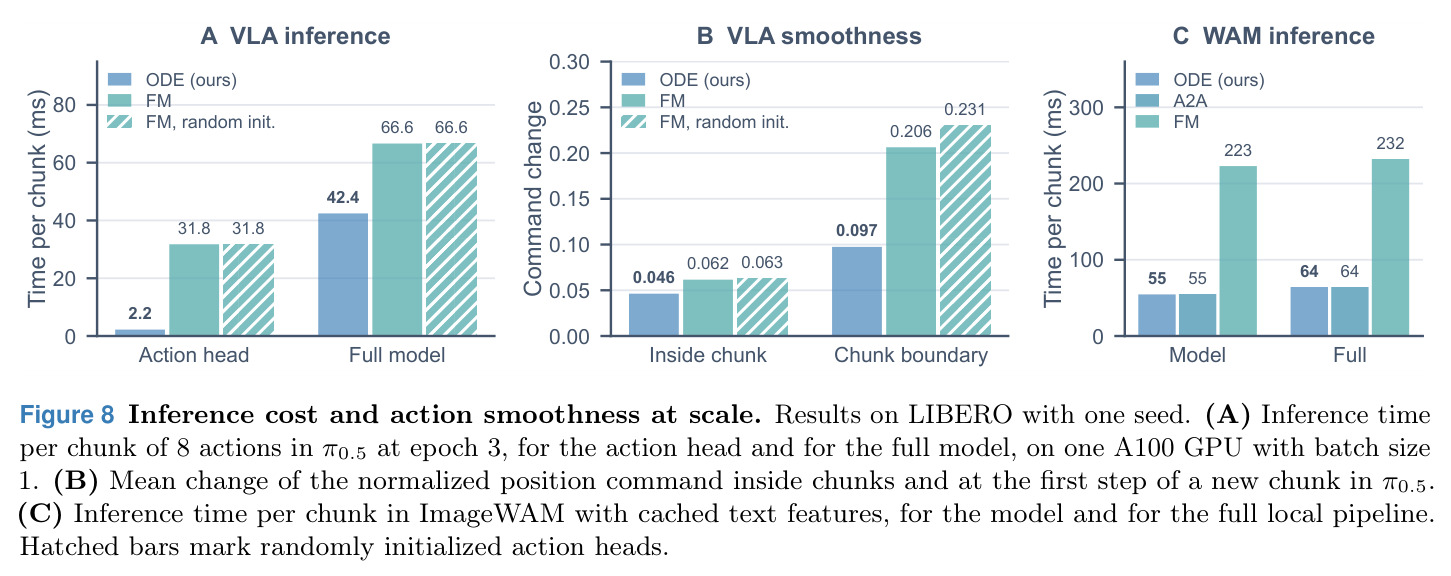
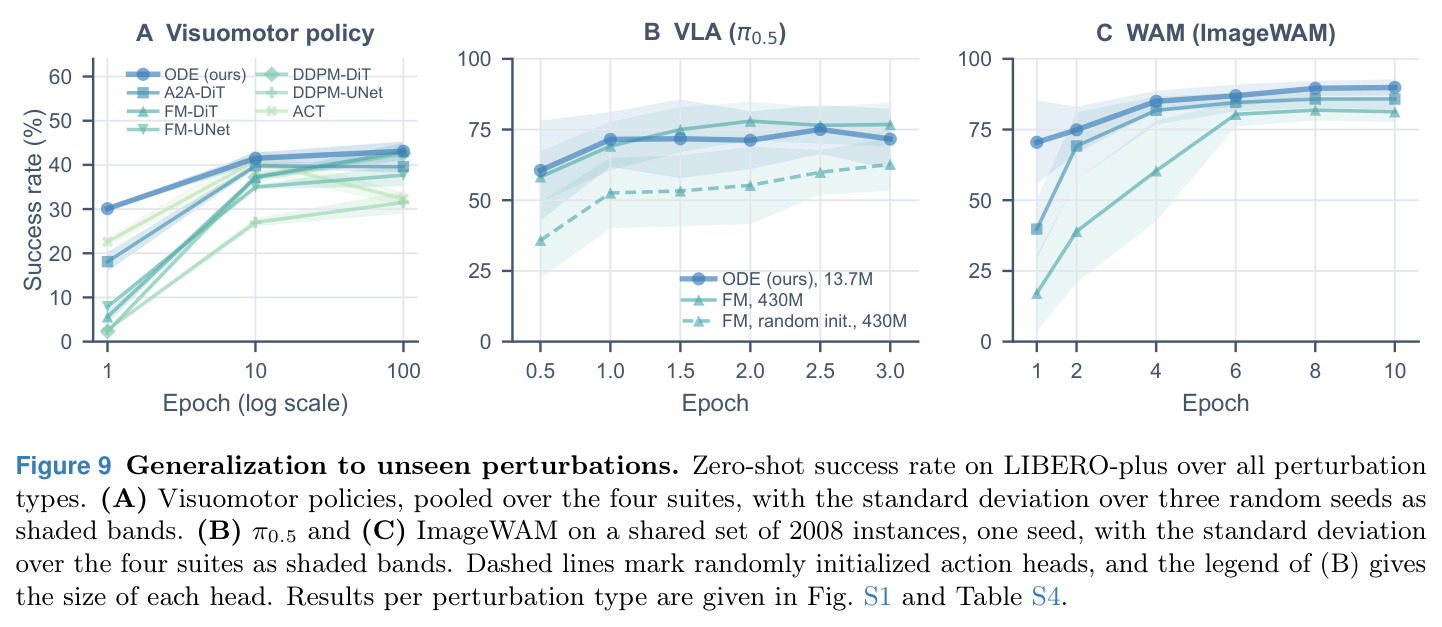
本文验证 ODE policy 可以即插即换地为 VLA/WAM 提供动作头:在 π0.5 中用 13.7M 参数(约 3%)的随机初始化 ODE 头替换 430M 流匹配专家,仍一 epoch 达 96.0%。这是“收益可扩展到大模型”结论的核心证据。
模型基强化学习与 SuperMimic
模型基 RL 先学一个可微世界模型,训练 actor 时把奖励沿短想象 rollout 反传解析梯度;SuperMimic 用该范式训练人形机器人全身跟踪人类动捕片段(LAFAN1 的 40 个片段),比先进运动跟踪器省 1000 倍以上 GPU 时,其 actor 是从状态到动作的直接映射。
本文把同一个向量场不加修改地用作 SuperMimic 的 actor($H=1$、每步一次 Euler 积分),证明范式可从模仿学习无缝迁移到强化学习,且因 $\partial \hat{a}_t / \partial \hat{a}_{t-1}$ 含恒等项,梯度沿动作链无衰减地到达早期动作。
研究动机
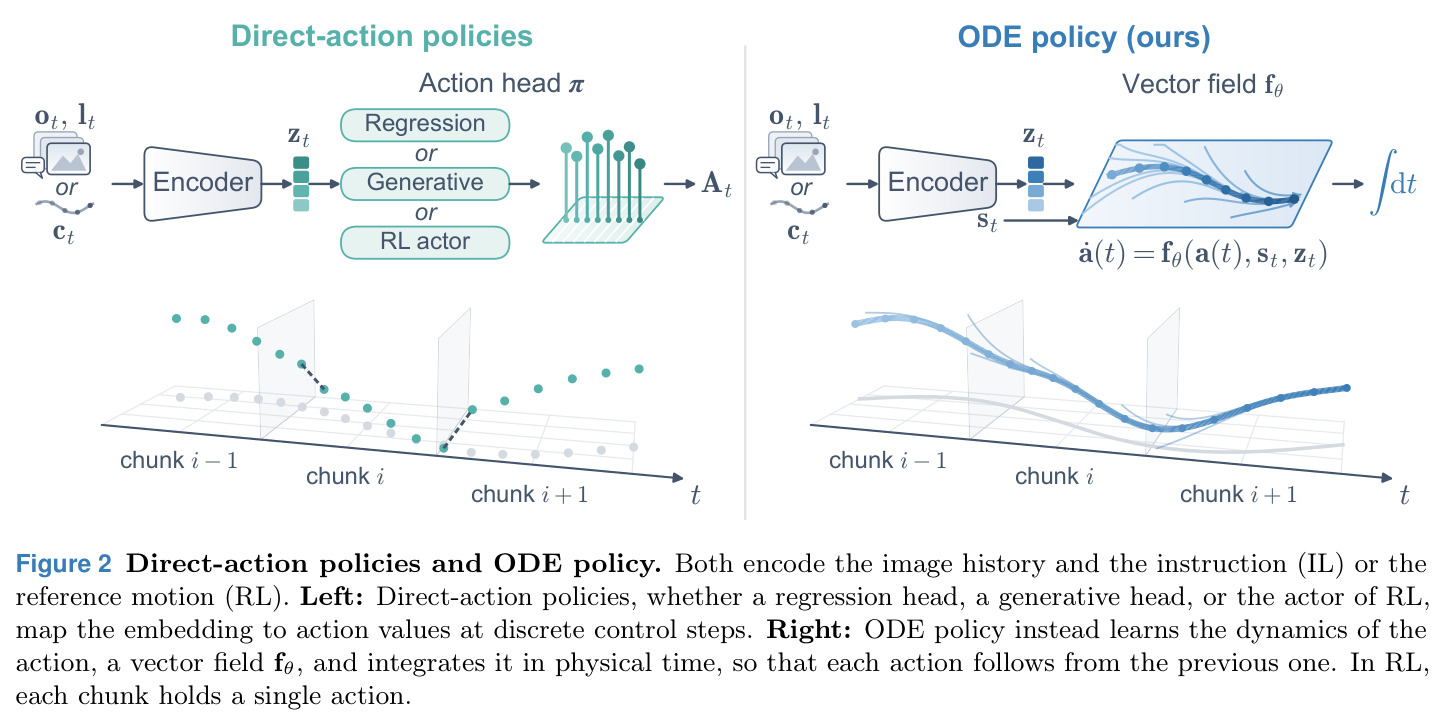
现有机器人策略——无论模仿学习(IL)还是强化学习(RL)——几乎都遵循“直接动作”范式:编码观测历史与本体状态后,在每个离散控制步直接输出动作数值,动作之间的任何关系(尤其是物理运动的连续性)只能靠数据隐式学习。这带来三类具体问题。其一,连续性缺失:人类遥操作产生的演示本质是连续动作轨迹按控制频率的采样,而网络把块内、块间的动作当作独立数值预测,块边界处指令跳变(如 π0 团队报告的边界不连续),RL 中动作高频振荡浪费控制量、磨损执行器、加剧 sim-to-real 差距。其二,执行低效:生成式动作头(扩散/流匹配)每块需要多次网络评估,扩散策略在 20 Hz 控制器下甚至超出单块 400 ms 的预算,且必须整块生成完才能执行第一个动作,无法流式响应新观测。其三,学习低效:LIBERO 上流匹配/扩散策略训练一个 epoch 后几乎还没学会(最佳基线 ACT 一 epoch 仅 43.2%),需要上百 epoch 才收敛;而机器人数据在本体、质量、控制接口上高度异构,无法像互联网文本那样无限扩展,对数据、参数与训练时间的高需求成为规模化瓶颈。
本文的目标是作者的目标是构造一种在学习、数据、参数与执行四个维度都高效的机器人策略范式。核心洞察是:机器人是宏观经典系统,随时间连续运动;指挥它的动作(尤其人类遥操作指令)本身也基本连续,演示不过是连续动作轨迹的采样。既然如此,与其让网络从数据中隐式学习连续性,不如把“动作如何随机器人物理时间演化”显式建模。具体目标包括:同一公式不加修改地充当三种角色——视觉运动策略、VLA/WAM 的动作头、RL 的 actor;IL 中以短动作块为积分单元做监督,从而规避全轨迹积分的漂移与昂贵的伴随方法;推理时每个动作从上一个动作积分而来,使执行轨迹“由构造保证连续”,块边界无跳变、支持流式执行、积分步长成为部署期自由参数;同时保留多模态行为能力。验证标准是与 14 个先进基线在 LIBERO/LIBERO-plus、π0.5、ImageWAM、SuperMimic 以及单臂/双臂/灵巧手/人形四类真机的 14 个任务上对比,且所有方法共享相同的骨干、数据与训练日程。
与已有工作不同的是,本文的独特切入是把 ODE 的建模对象从“系统状态”或“生成时间”换成“动作本身”,并给出三条与以往工作本质不同的设计。第一,与传统动力学建模仿不同于:动力学运动基元(DMP)、稳定动力系统、神经动态策略等预先固定向量场形式或强迫其收敛到吸引子,每个模型只能表达朝向少数吸引子的动作;本文让网络本身就是任意向量场,不加结构约束,一个场覆盖大规模多任务。第二,与生成式策略不同:扩散/流匹配沿生成时间 $\tau \in [0,1]$ 积分,中间点无物理意义且每块独立重新生成;streaming flow policy 虽把流时间对齐执行时间,但仍是回归演示推导出的速度标签并按缩放时间段重新生成每块;Chronos 把物理时间作为输入但动作仍按固定速率生成。本文沿物理时间积分、只监督积分路径(无需速度标签)、每块从前块末端无缝续接。第三,结构性的新可能:因为场以当前动作为输入,可以设计直接动作策略没有对应物的收缩扰动训练;模态选择也只需随机化积分的出发方向,无需多步生成采样。
核心方法
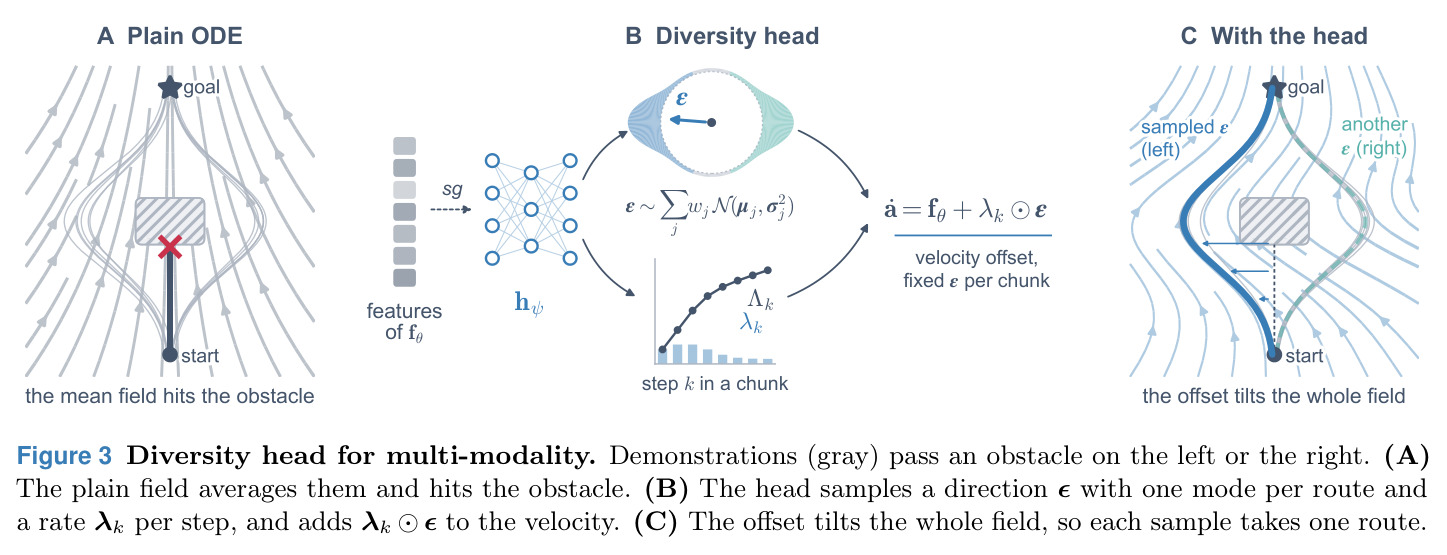
直觉来自神经科学:运动皮层通过动力学而非编码目标产生运动,人类伸手也接近最小急动度轨迹——动作的“变化规律”比动作数值更本质。据此,ODE policy 把策略定义为动作对物理时间的导数场 $\dot{a}(t) = f_\theta(a(t), s_t, z_t)$,$z_t$ 编码图像历史与语言指令,$s_t$ 是本体状态(直接进场而非并入条件)。训练时(IL)从演示动作 $a_{t-1}$(以概率 $p$ 加收缩扰动 $\delta \sim \mathcal{N}(0, \mathrm{diag}(\sigma_\delta^2))$)出发,用 RK4 对块内 $H=8$ 步积分,以路径损失 $\mathcal{L}_{\text{path}} = \frac{1}{H}\sum_{k=0}^{H-1}\|\hat{a}_{t+k} - a_{t+k}\|^2$ 监督整条积分路径,梯度直接穿过求解器反传、无需伴随方法。推理时每个动作由前一个动作单步积分而来并立即下发(流式执行),块间 seamless 衔接;可选多样性头 $h_\psi$ 输出方向偏移 $\epsilon$ 与逐步速率 $\lambda_k$ 把场“倾斜”向某个模态。RL 时 $H=1$,actor 每步做一次 Euler 积分,世界模型、critic 与算法全部不变。
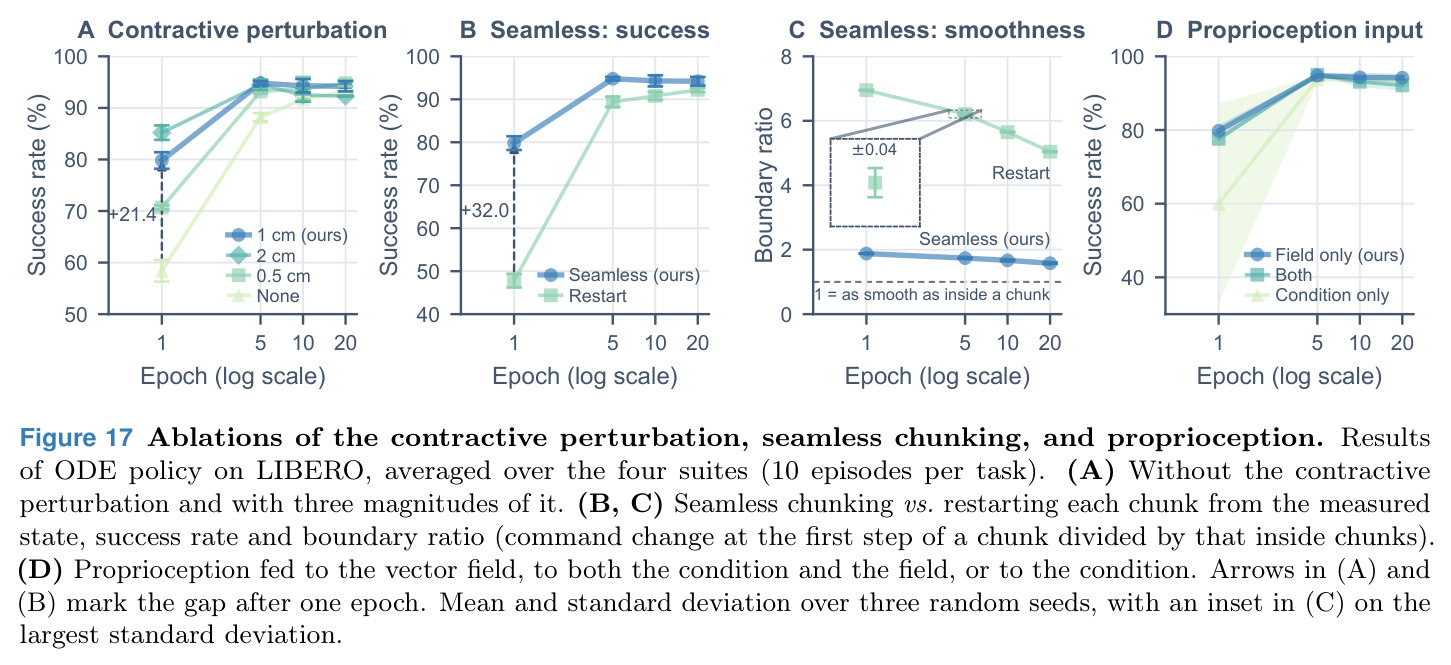
核心创新是“学动作的动力学,而不是动作的数值”——把动作连续性从数据的隐式统计量变成模型的构造保证。与直接动作策略的本质区别有三。其一,块内所有动作由同一个向量场沿路径积分生成:$\hat{a}_{t+k} = \hat{a}_{t+k-1} + \int_{t+k-1}^{t+k} f_\theta(a(t'), s_t, z_t)\, dt'$,每步变化取决于动作当前到达的位置;传统策略则把 $H$ 个动作当作独立输出,连续性须从数据学。其二,积分的状态是发给低层控制器的期望动作而非量测状态(低层控制器跟踪有滞后),推理时 seamless chunking 从上一块最后一个期望动作继续积分,执行轨迹成为每 $H$ 步刷新条件的单一积分曲线——消融显示改回从量测状态重启后一 epoch 成功率从 79.8% 跌到 47.8%,边界跳变 3–4 倍。其三,场以动作为输入,使收缩扰动成为可能:训练时扰动段起点,要求路径按 $\rho^{k+1}$ 几何衰减收回示范,教会场把偏离状态拉回,形成局部收缩;这是不以指令动作为输入的直接动作策略没有对应物的鲁棒化手段。多模态则由“随机化场的出发方向”实现:一个每块固定的偏移 $\lambda_k \odot \epsilon$ 即可把整条积分曲线推向另一条路线,无需多步生成采样。
方法步骤详情
训练(Algorithm 1):取示范段 $(c_t, s_t, a_{t-1:t+H-1})$,以概率 $p$ 给起点加扰动 $\hat{a}_{t-1} = a_{t-1} + \delta$,从 $\hat{a}_{t-1}$ 用 RK4 对场积分 $H=8$ 步得路径 $\hat{A}_t$,计算收缩扰动损失 $\mathcal{L}_{\delta\text{path}} = \frac{1}{H}\sum_{k}\|\hat{a}_{t+k}(a_{t-1}+\delta) - (a_{t+k} + \rho^{k+1}\delta)\|^2$,加上多样性损失后在小批上联合最小化。多样性损失:头 $h_\psi$ 从场特征(梯度截断)读出 $K=12$ 分量高斯混合,采样方向 $\epsilon$ 与速率 $\lambda_k$,按 $\dot{a} = f_\theta + \lambda_k \odot \epsilon$ 积分;用示范对朴素路径的偏离 $e_k = \mathrm{sg}(a_{t+k} - \hat{a}_{t+k})$ 的闭式最优偏移 $\epsilon^* = \sum_k \Lambda_k \odot e_k \oslash \sum_k \Lambda_k \odot \Lambda_k$ 做高斯负对似然监督,两端 detach、不干扰 $f_\theta$ 的梯度。推理(Algorithm 2):每个决策步编码一次 $z_t$,对 $k=0..H-1$ 循环执行 $\hat{a} \leftarrow \mathrm{Step}(f_\theta, \hat{a}, s_t, z_t)$ 单步积分并立即发送控制器(流式),下一块从当前 $\hat{a}$ 无缝续接。RL:$H=1$,每控制步 $\hat{a}_t = \hat{a}_{t-1} + f_\theta(\hat{a}_{t-1}, s_t, z_t)$ 单 Euler 步,$z_t$ 嵌入参考运动,场经此步接受 RL 梯度;LIBERO 上二值夹爪由独立 0.27M 分类头预测。
技术新颖性
新颖性有四层。第一,问题重构:从“策略 = 观测到动作值的映射”变为“策略 = 动作空间的向量场”,积分时间从无物理意义的生成维度变为机器人物理时间;该思想与运动皮层通过动力学展开运动的神经科学观点呼应,但工程上首次在不加结构约束下把它统一到大规模多任务、VLA/WAM 动作头与 RL actor。第二,训练设计:以块为积分单元,同时规避全轨迹积分的误差累积与伴随方法的额外积分开销;路径监督而非速度回归,区别于 streaming flow policy(需从演示推导速度标签、会放大噪声抖动);收缩扰动利用“场以指令动作为输入”的结构差异实现示范流形附近的局部收缩,不增加数据或推理成本(一 epoch 58.4%→79.8%)。第三,推理设计:seamless chunking 加逐步流式发送,使同一模型兼得单次前向的速度(5.7 ms/块)与生成式策略的质量,且积分步长成为部署期自由参数——20 Hz 模型不重训即可 40/80 Hz 执行(93.3%/92.5%)。第四,消融证明收益来自 ODE 形式而非容量或求解器:1.5M 模型(92.5%@ep10)超过 48M FM-DiT(至多 87.5%),Euler 与 RK4 成功率差不到一个点。
实验结果
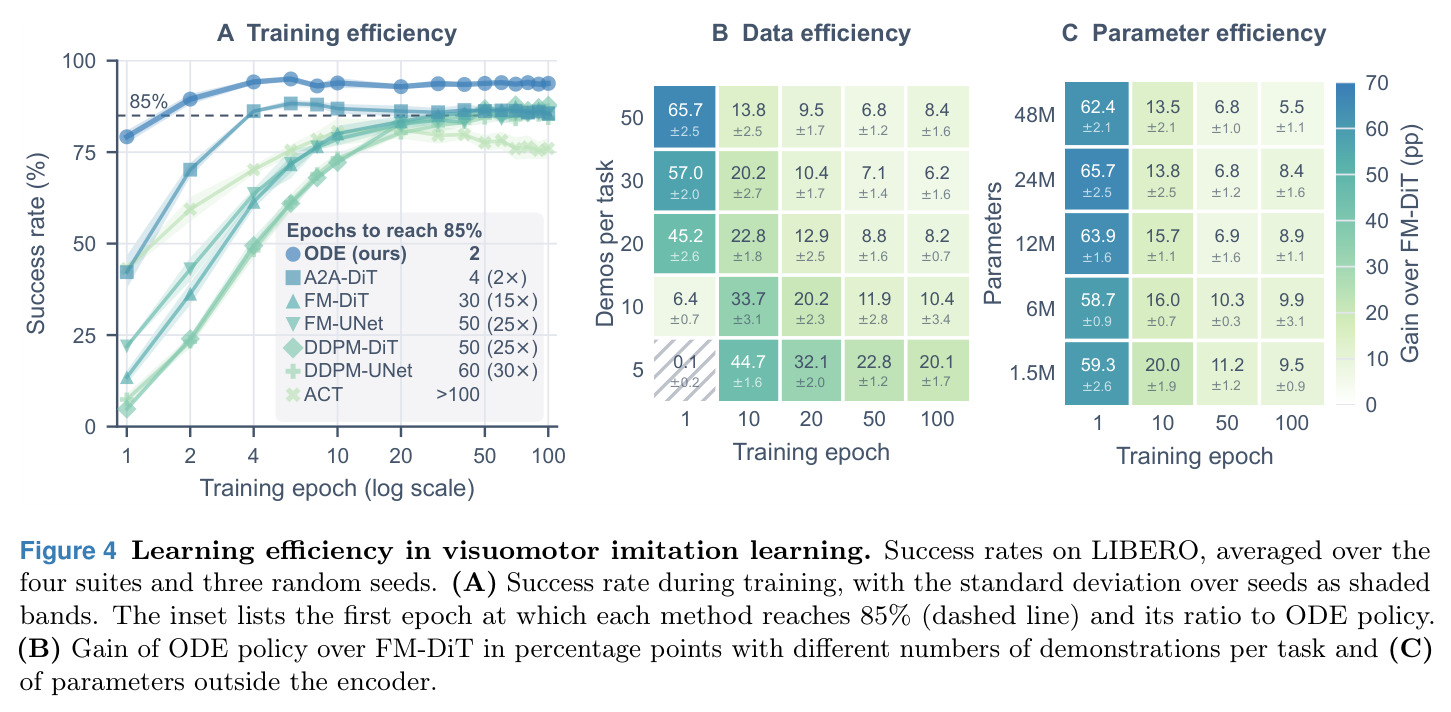
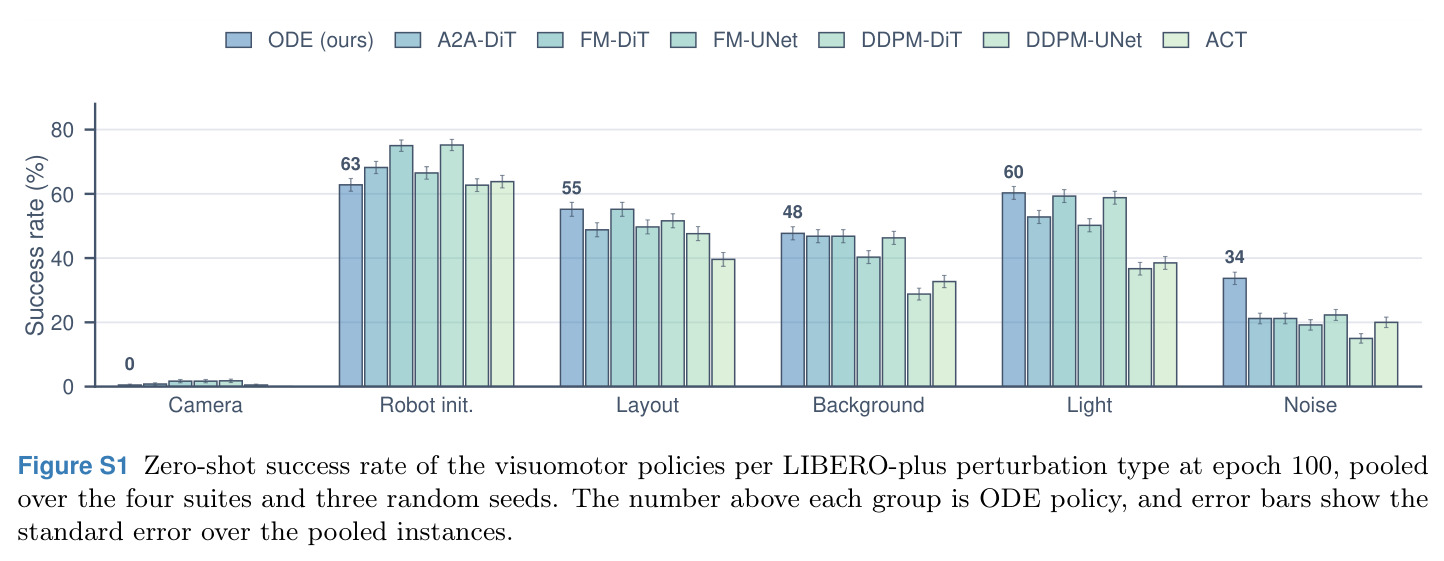
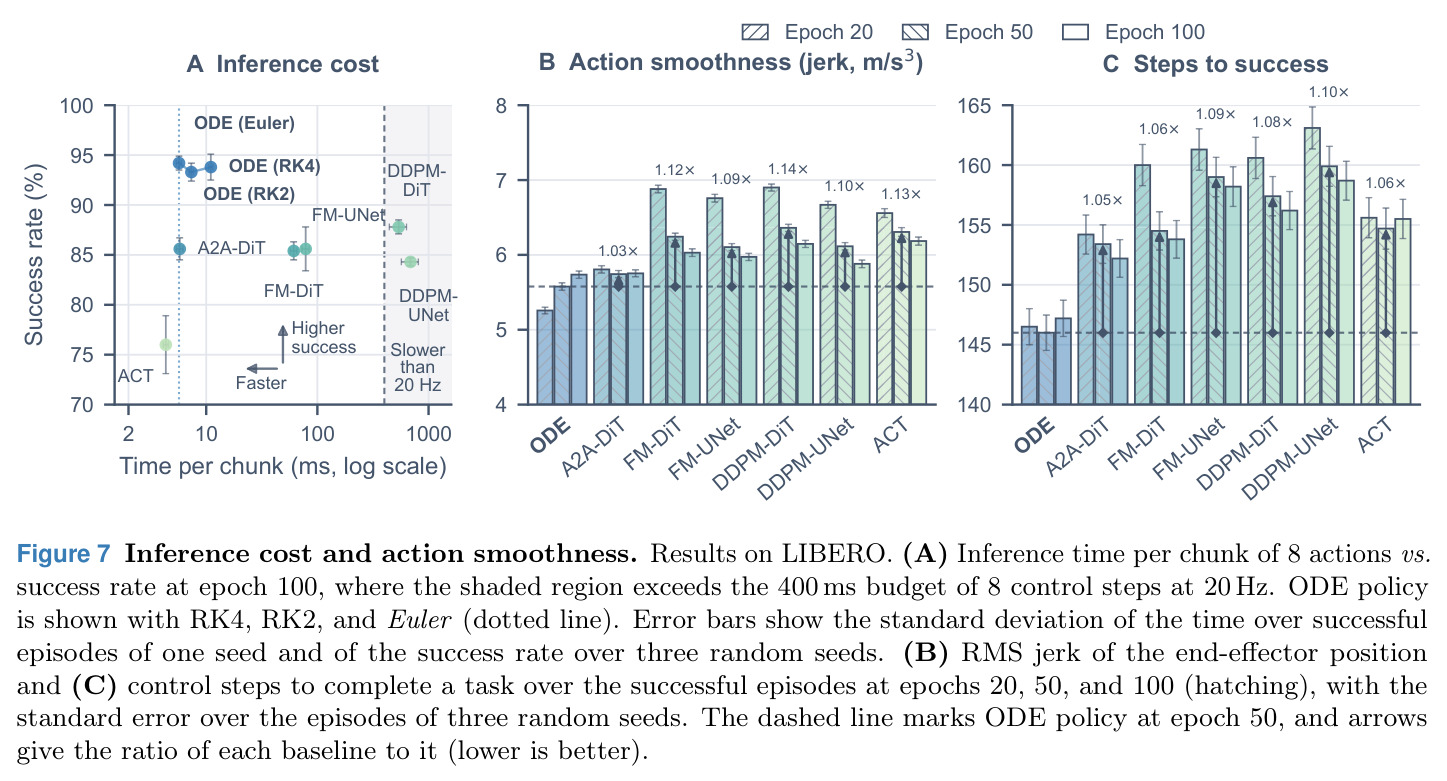
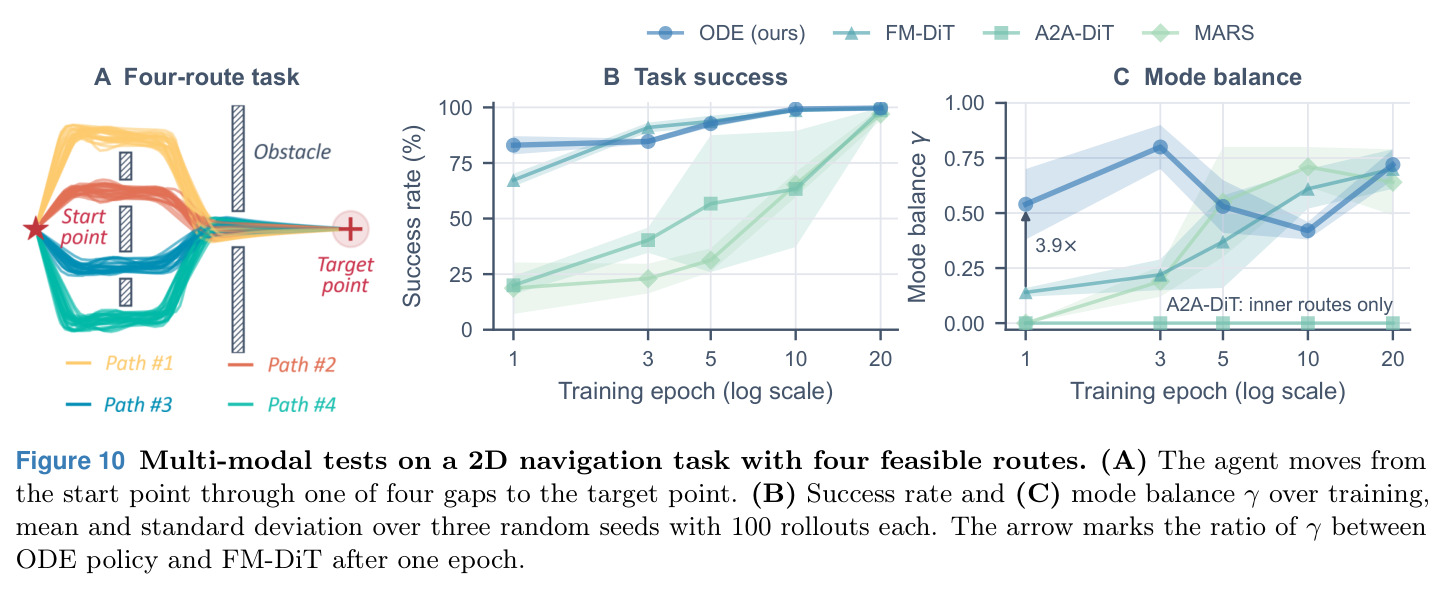
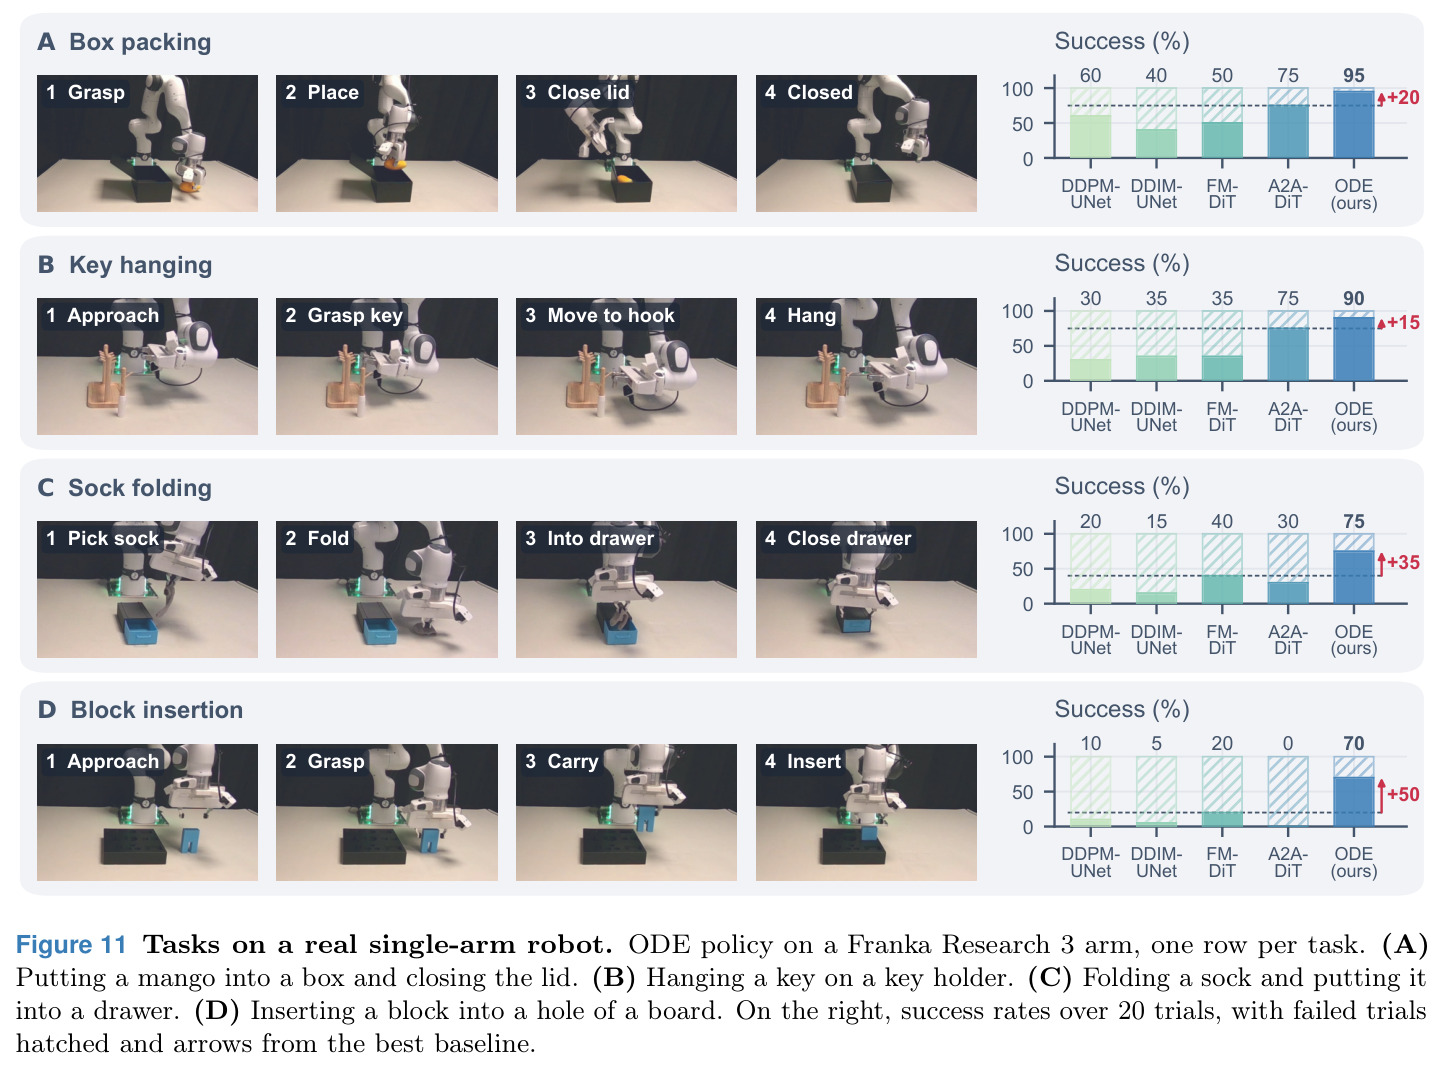
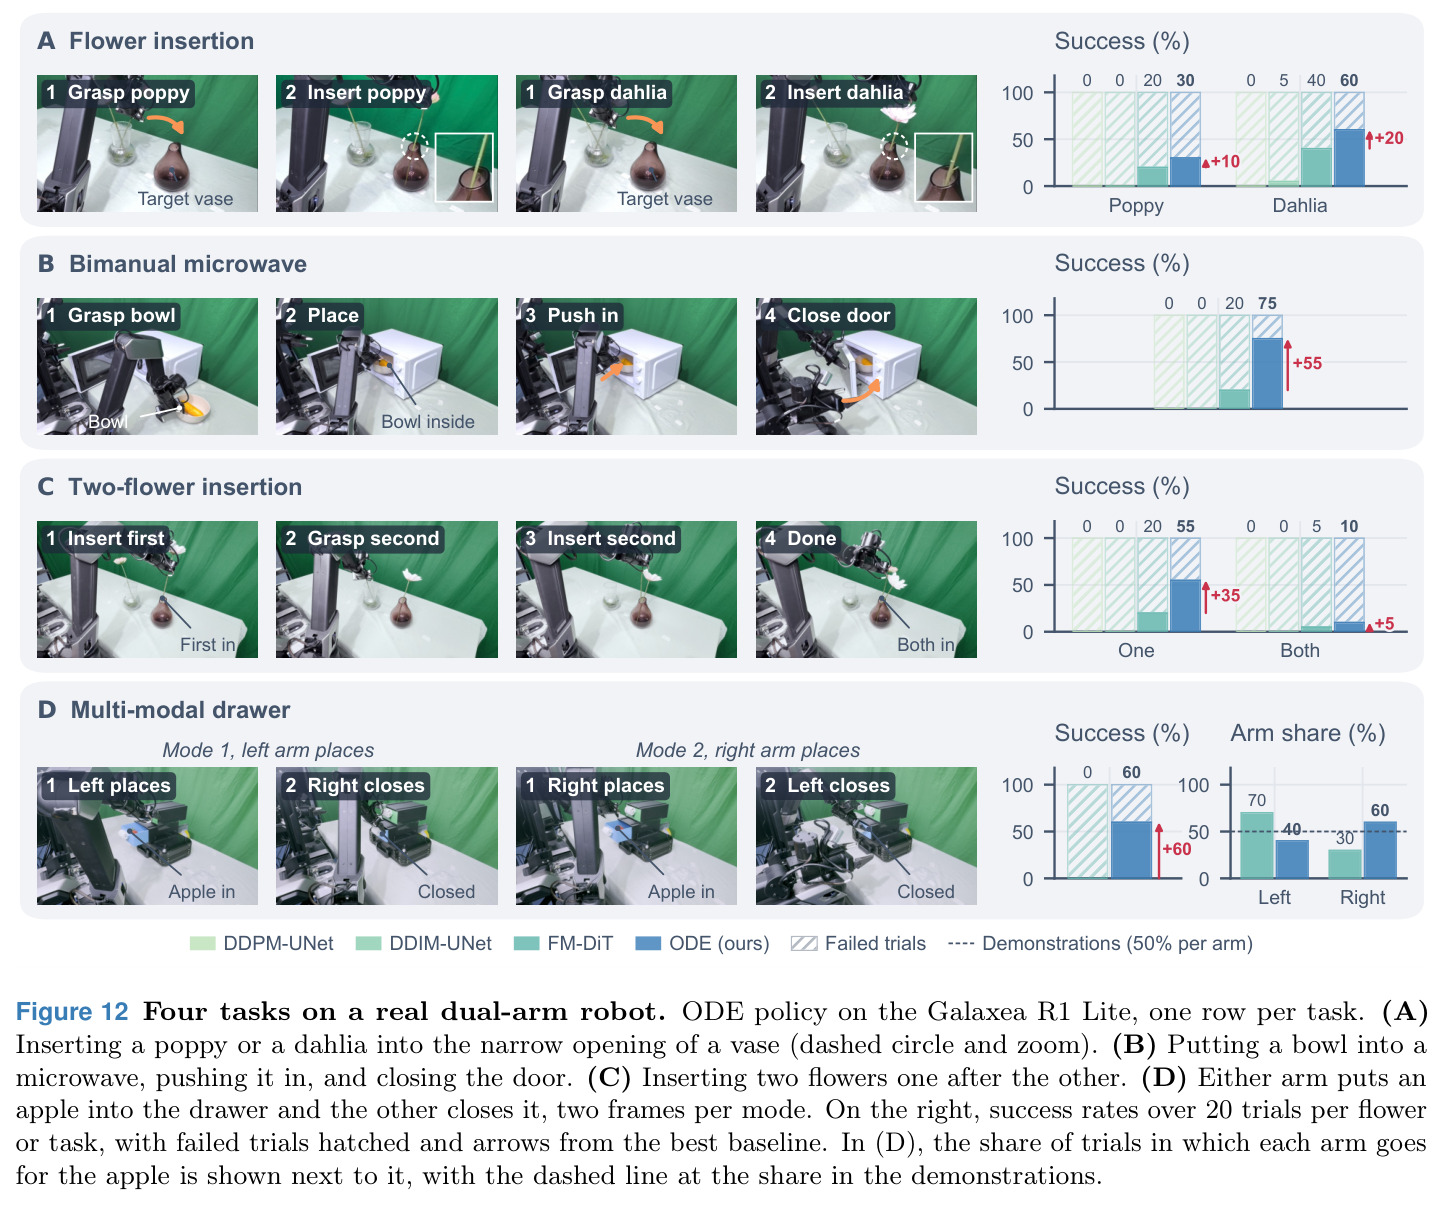
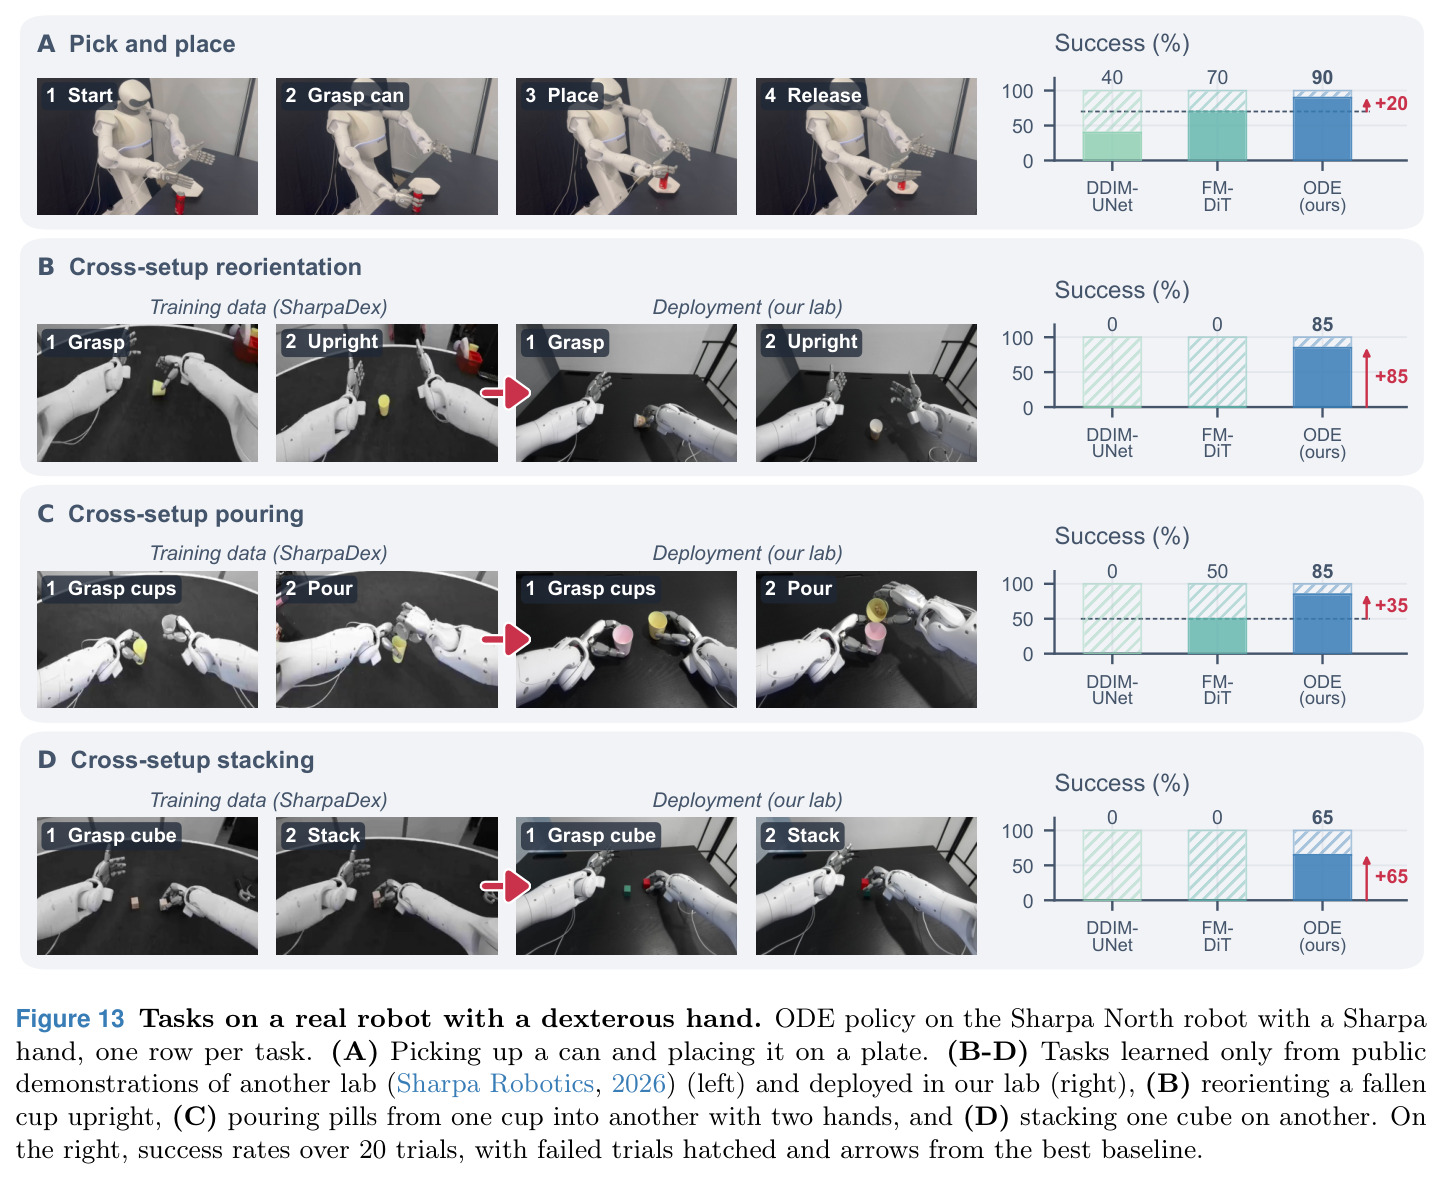
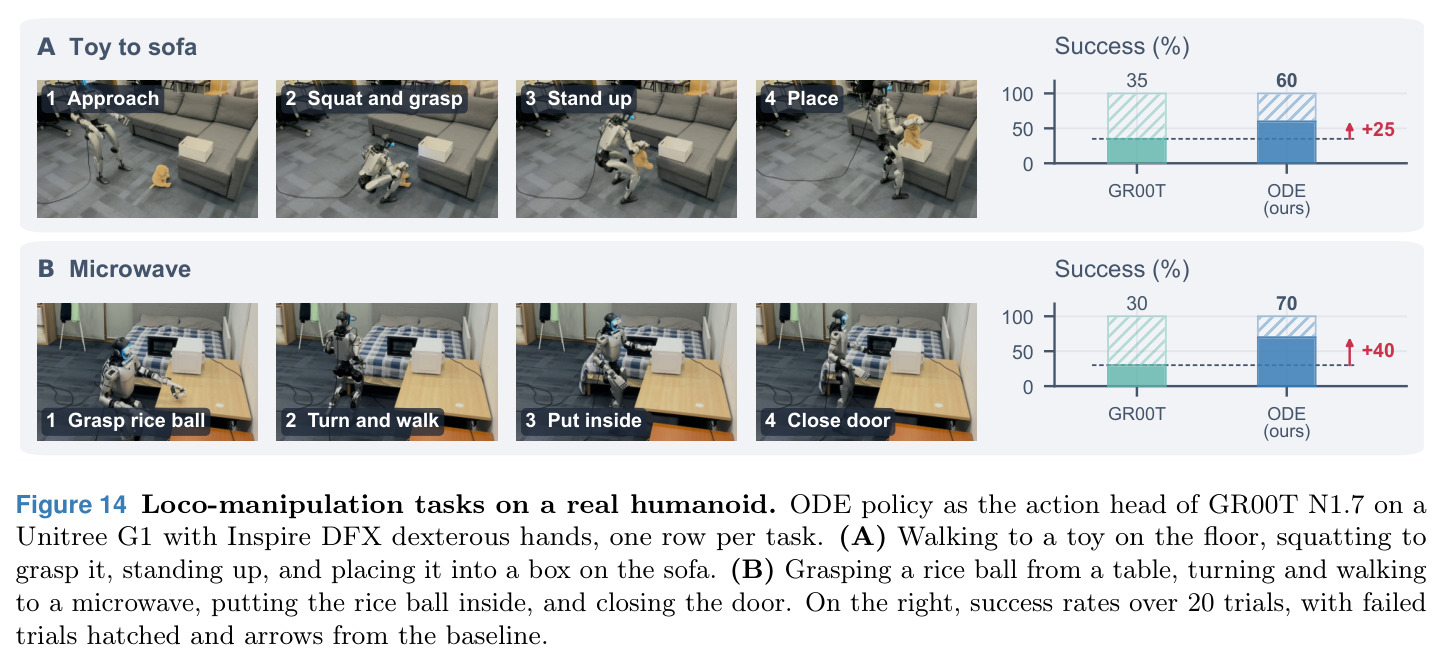
学习效率(Fig. 4):LIBERO 四套件三种子,一 epoch 即 79.2%(最佳基线 ACT 43.2%),2 epoch 过 85%(早于流/扩散一个数量级),100 epoch 93.8%;20 条演示/任务达 87.7%,超 FM-DiT 全量 50 条的 85.4%;1.5M 参数模型 92.5%@ep10 超 48M FM-DiT 上限 87.5%。规模化(Fig. 5):π0.5 中 13.7M 随机初始化 ODE 头(约原 430M 专家的 3%)一 epoch 96.0% vs 随机初始化 FM 专家 75.5%;ImageWAM(4.5B 参数)一 epoch 82.6% vs 原 FM 头 24.6%。推理与平滑(Fig. 7/8/15):8 动作块 5.7 ms,比 FM-DiT 快 10.8 倍、比 DDPM 快约百倍(后者超 20 Hz 的 400 ms 预算);π0.5 头快约 14 倍、省全模型约三分之一时间,边界指令变化减半;真机块生成快 3.5–27 倍,多数任务比人类演示更平滑(单臂边界加速度 3.6/1.1/2.5/2.2 rad/s²,扩散/流基线 8.3–26.0)。RL(Fig. 6):SuperMimic 换 ODE actor 后 0.75 h 训练回报 0.630±0.007 vs 0.460±0.008(+37%),0.4 h 评测回报领先 30%,最终 0.885 vs 0.845(PPO 仅 0.452);动作加速度低 21%、不到 PPO 一半,源于首动作相对梯度范数从 0.57 升至 1.0–1.1。泛化(Fig. 9):LIBERO-plus 零样本一 epoch 30.1%(ACT 22.6%),ImageWAM 一 epoch 70.5% vs 17.1%。多模态(Fig. 10):四路导航一 epoch 模式平衡 $\gamma$ 为 FM-DiT 的 3.9 倍。真机(Fig. 11–14):单臂 Franka FR3 四任务 95/90/75/70% 全部最高(+20/+15/+35/+50 pp);双臂微波炉 75% vs 20%(仅 34 条演示),插花 60% vs 40%;灵巧手跨实验室 SharpaDex 迁移 85%/85%/65%(FM-DiT 0/50/0%,DDIM 全 0);人形 GR00T N1.7 两任务 60%/70% vs 35%/30%。延伸(Fig. 19):只用量测姿态训练时把场速度喂给 PD 阻尼项,LIBERO-Long 51%→72%(FM-DiT 24%),成功 episode 305→253 步,但 Spatial 90%→80%;同一模型改积分方式即可 40/80 Hz 执行(93.3%/92.5%)。
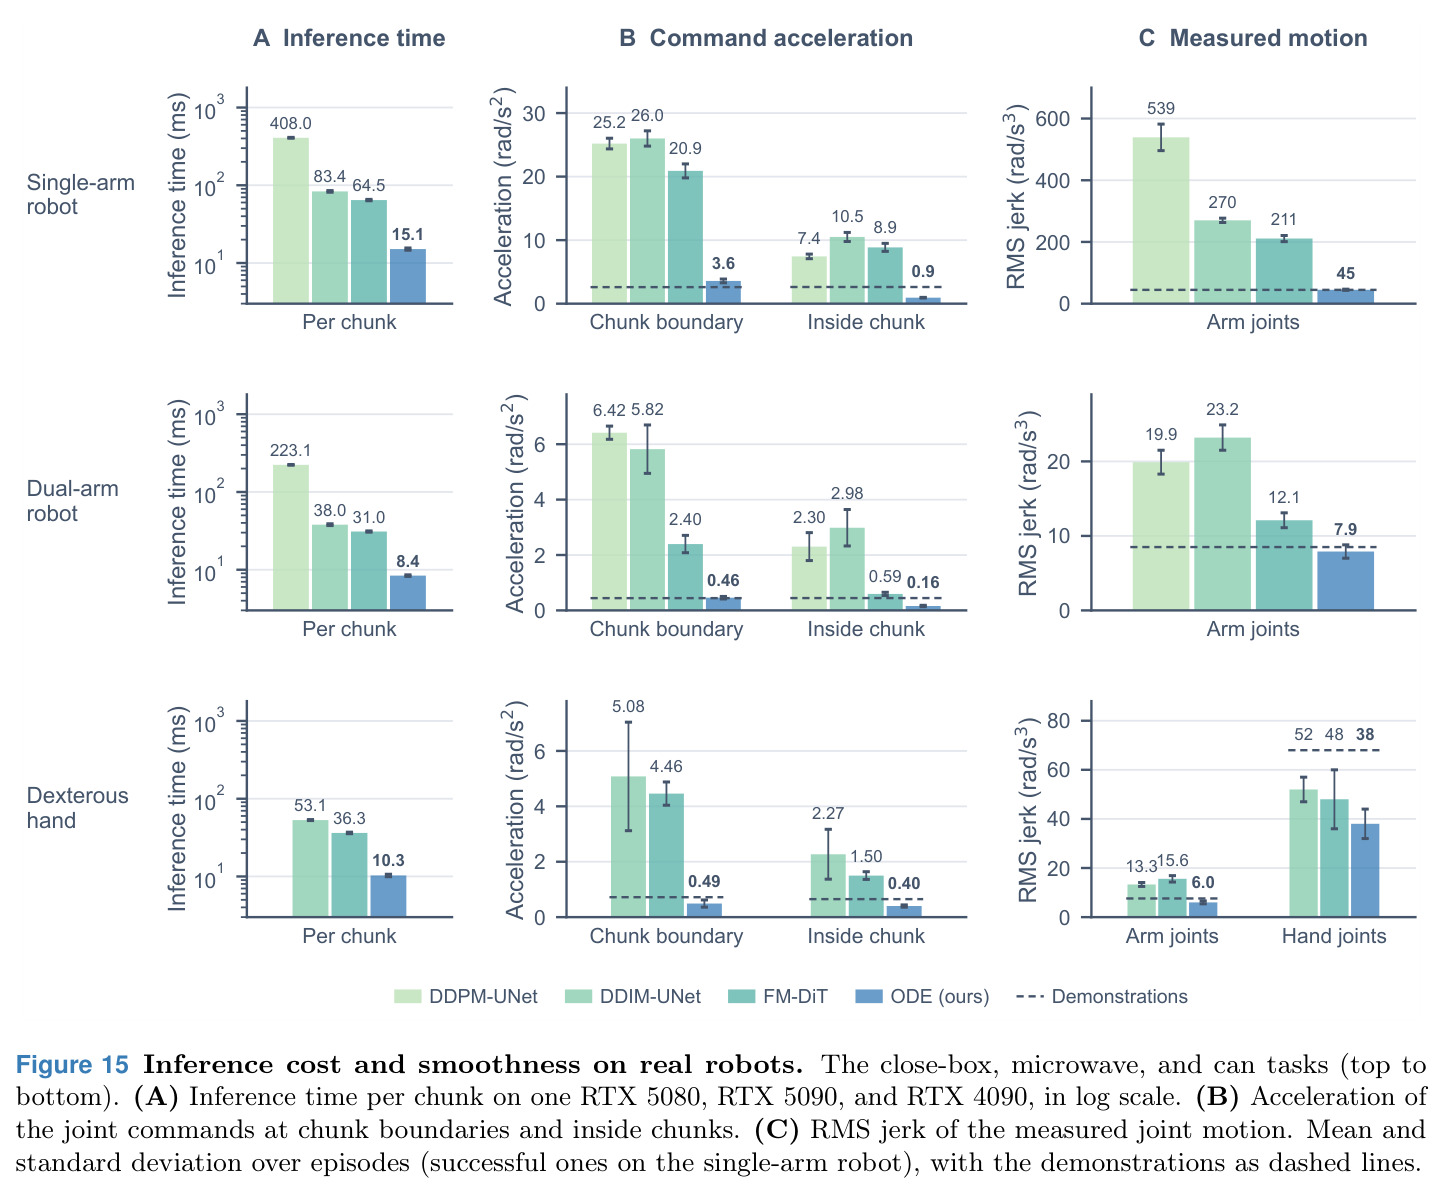
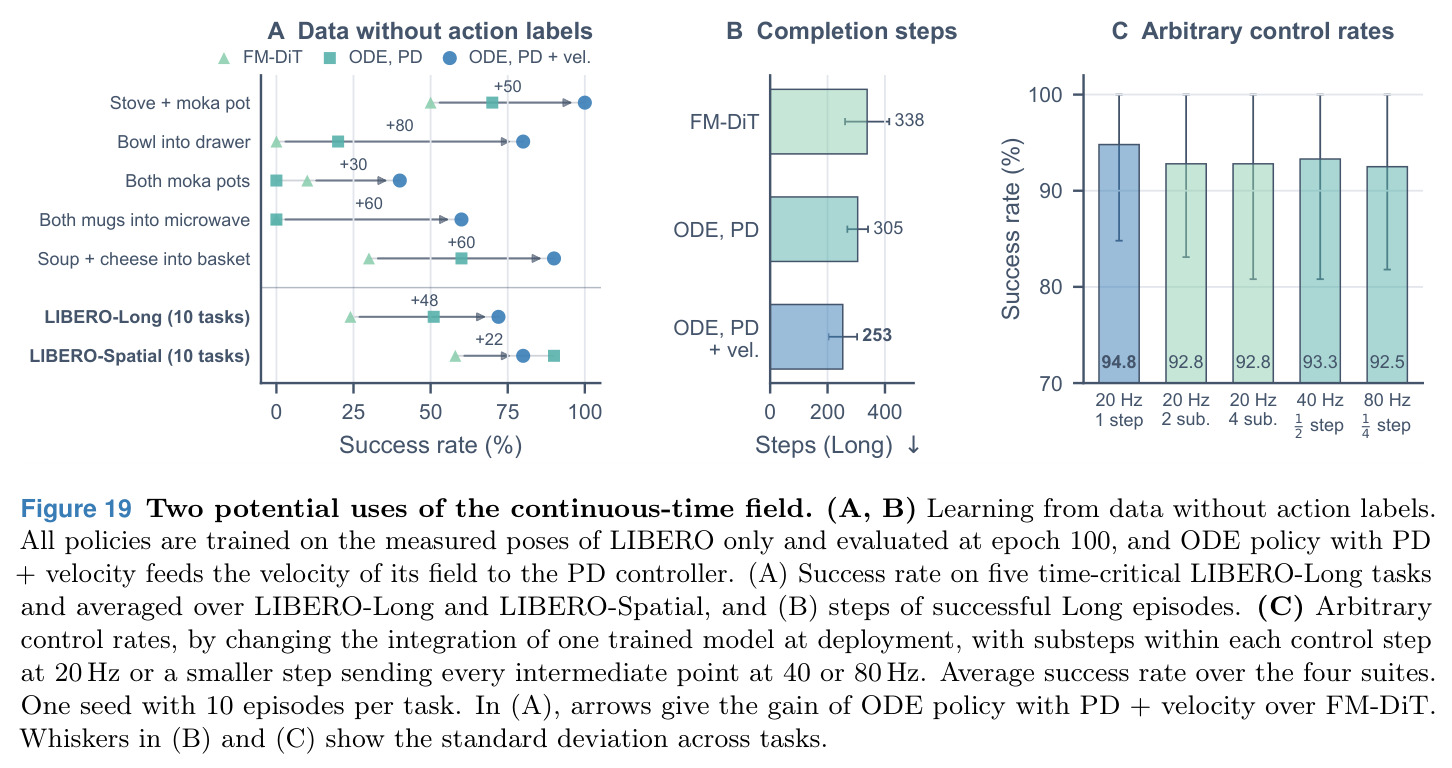
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LIBERO 视觉运动模仿学习(4 套件,3 种子) | 训练 1 epoch 后成功率 | 79.2% | 最佳基线 ACT 43.2%(流/扩散策略近乎 0) | +36.0 pp(约 1.8×) |
| LIBERO 视觉运动模仿学习 | 训练 100 epoch 后成功率 | 93.8% | FM-DiT / DDPM 等生成式基线(全程被领先) | 全程领先,最终收敛点更高 |
| π0.5 VLA 动作头(LIBERO) | 1 epoch 成功率 | 96.0%(13.7M 随机初始化头) | 随机初始化 FM 专家 75.5%(430M) | +20.5 pp,参数约 3% |
| ImageWAM 动作头(LIBERO) | 1 epoch 成功率 | 82.6% | 原始流匹配头 24.6%(A2A 居中) | +58.0 pp |
| LIBERO-plus 零样本泛化(ImageWAM) | 1 epoch 成功率(2008 实例) | 70.5% | 原始头 17.1% | +53.4 pp |
| SuperMimic 人形运动跟踪(RL,40 条 LAFAN1) | 0.75 h 训练回报 | 0.630±0.007 | 原直接动作 actor 0.460±0.008 | +37% |
| SuperMimic 人形运动跟踪(RL) | 3 h 后全部片段评测回报 | 0.885±0.007 | 原 actor 0.845±0.009;PPO 仅 0.452±0.021 | +0.040(对 PPO 近 2×) |
| LIBERO 推理速度 | 每 8 动作块生成时间 | 5.7 ms(Euler) | FM-DiT 10.8× 慢;DDPM 约 100× 慢(超 400 ms 预算) | 10.8×–100× 加速 |
| 真实单臂 Franka FR3 四任务(装箱/挂钥匙/叠袜/插块) | 成功率(20 次试验,40 演示、50 epoch) | 95% / 90% / 75% / 70% | 最佳基线 75% / 75% / 40% / 20% | +20 / +15 / +35 / +50 pp |
| 真实双臂 Galaxea R1 Lite 微波炉任务 | 成功率(34 条演示) | 75% | FM-DiT 20%(扩散策略 0%) | +55 pp |
| 灵巧手 Sharpa 跨实验室迁移(SharpaDex 数据,翻转杯子/倒药丸/叠方块) | 成功率 | 85% / 85% / 65% | FM-DiT 0% / 50% / 0%;DDIM-UNet 全 0% | 最高 +85 pp |
| 人形 Unitree G1 loco-manipulation(GR00T N1.7 动作头) | 成功率(玩具入箱 / 微波炉) | 60% / 70% | GR00T 原头 35% / 30% | +25 / +40 pp |
| 2D 四路导航多模态任务 | 模式平衡 γ(1 epoch) | 3.9× FM-DiT,且成功率更高 | FM-DiT(A2A-DiT γ=0 只学内侧两路) | 3.9× |
| LIBERO 量测姿态训练 + 速度反馈执行 | LIBERO-Long 成功率 | 72%(ODE PD+速度) | ODE PD 51%;FM-DiT 24% | +21 pp |
局限与改进
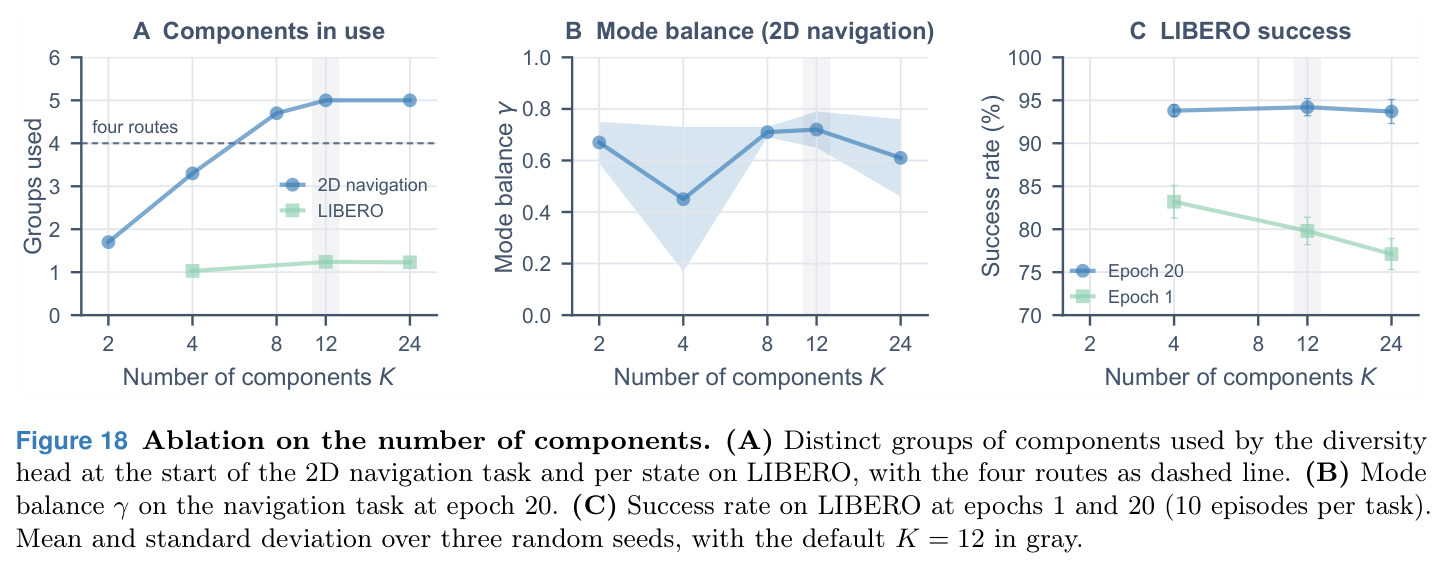
作者承认的局限:第一,ODE 天然描述连续信号,二值夹爪不适合放进场里——把夹爪作为场的附加状态积分并在执行时取符号,成功率从 79.2%/95.0%/92.8%(epoch 1/5/10)降到 74.5%/91.8%/92.2%,主要输在需反复抓放的 LIBERO-Long(仍超所有基线);第二,在动作本身应跳变的场景(早期无模型 RL 实验)收益很小甚至有害,因为连续性也平滑了探索;第三,用场速度加速执行存在速度-精度权衡,LIBERO-Spatial 从 90% 降到 80%,速度需按任务相位调制。我自己的观察:其一,方法假设低层控制器能较好跟踪期望动作、且演示本身连续,对本质离散或接触突变信号只能靠独立分类头规避而非解决;其二,块内 $z_t$、$s_t$ 固定,观测更新频率受 $H=8$ 限制,高频视觉闭环任务(动态目标、避障)未验证;其三,RK4 训练到 100 epoch 需 22.8 h vs FM-DiT 16.3 h,存在训练时间换学习速度的成本(Euler 可降到相当);其四,LIBERO-plus 中相机位姿变化击败所有方法,ODE 形式不解决视觉鲁棒性;其五,多模态依赖分量数 $K$(K=4 分不开四条路)等超参,真机多模态只验证了双臂角色分配一种情形。
独立分析的弱点
弱点一:离散/不连续动作建模弱,夹爪并入场导致反复抓放任务掉点(79.2%→74.5%@ep1);改进:引入学习型事件函数或带跳跃项的神经 ODE,让场在抓取/释放事件处允许受控跳变。弱点二:速度反哺控制器伤精度任务(Spatial 90%→80%);改进:对场输出乘以任务相位相关的标量 $\alpha(t)$,自由空间快、接近接触慢,由接触预测头给出,向量场框架下天然可表达。弱点三:块内观测冻结、闭环频率受限;改进:缩短块长(H=4 仍超 91%)或块内对新观测插值刷新条件、异步更新 $z_t$。弱点四:RK4 训练开销(22.8 h vs FM-DiT 16.3 h);改进:默认 Euler/RK2 训练(成功率差 <1 点)、部署按需升级求解器,或自适应步长把算力集中于接触段。弱点五:多模态超参敏感,K=4 时导航任务 $\gamma$ 跨种子方差大;改进:用 Dirichlet 过程让分量数自动增长,或先聚类演示模态再定 K。弱点六:无模型 RL 中探索被平滑甚至有害;改进:仅对奖励本就惩罚动作变化的任务启用 ODE actor,或在场的初始方向注入可控噪声并配合熵正则。弱点七:块间条件固定意味着纠错周期为 H 步,长程误差仍会累积(双花插入第二支全方法都难);改进:按块间置信度自适应提前重规划。
未来方向
作者提出的方向:其一,把场速度喂给 PD 控制器阻尼项,使策略能从只有量测姿态的数据(UMI 手持采集、人类视频)学习并保持演示节奏——Long 51%→72%、成功 episode 305→253 步,且速度可按任务相位调制(自由空间快、接触附近慢),向量场表达自然而直接动作策略很难;其二,积分步长成为部署期参数,一个模型服务不同频率的低层控制器(40/80 Hz 达 93.3%/92.5%),甚至在线自适应细化接触附近的步长;其三,用学习型事件函数与跳跃项纳入不连续动力学;其四,“动作为展开的意图”——策略或许只需在模态分叉等少数关键点做离散决策,其余交给学到的动力学展开。基于成果可延伸:跨本体、跨控制频率的统一基础策略(结合跨实验室 SharpaDex 迁移 85%/85%/65% 对基线至多 50%,指向一次训练、多机部署);与 WAM 世界预测结合,让场条件于想象出的未来状态实现模型预测式平滑规划;把收缩扰动推广为示范流形上可学习的收缩率(逐任务 Lyapunov 式设计);RL 中在场初始方向注入可控噪声以兼得探索与平滑;系统层面,ODE 头使动作生成从 VLA 推理瓶颈变为可忽略(π0.5 省约三分之一全模型时间),可把算力重新分配给 VLM 主干做更高频重规划或蒸馏进边缘设备。
复现评估
论文首页标注 Project Page 与 Code 链接,代码开源。仿真部分门槛低:LIBERO、LIBERO-plus、LAFAN1、SharpaDex 均公开,基线 FM-DiT/DDPM/A2A-DiT/ACT/π0.5/ImageWAM/GR00T N1.7/SuperMimic 大多有公开实现;LIBERO 单次训练在一张 RTX 4090 上到 100 epoch 约 16.3–22.8 小时(可八跑并行),RL 仅 3 小时单 GPU,三种子完全可承受。真机部分门槛较高:需 Franka Research 3、Galaxea R1 Lite、Sharpa North、Unitree G1 四类硬件,每任务自采 34–90 条遥操作演示,推理用 RTX 5080/5090/4090;不过单臂部分(40 条演示、50 epoch)在拥有单臂与遥操设备的普通实验室即可复验,灵巧手跨设置迁移还可直接用公开 SharpaDex 数据。关键实现细节较全:H=8、RK4、K=12、FiLM-MLP 场、扰动幅度与收缩率 $\rho$、π0.5 中 13.7M 头结构、GR00T 上 5M 场与 H=16 Euler 等,附录含全部基线设置与训练日程。综合:仿真复现难度入门级,真机复现难度进阶级,主要成本在硬件与演示采集而非算法调参。
论文图表
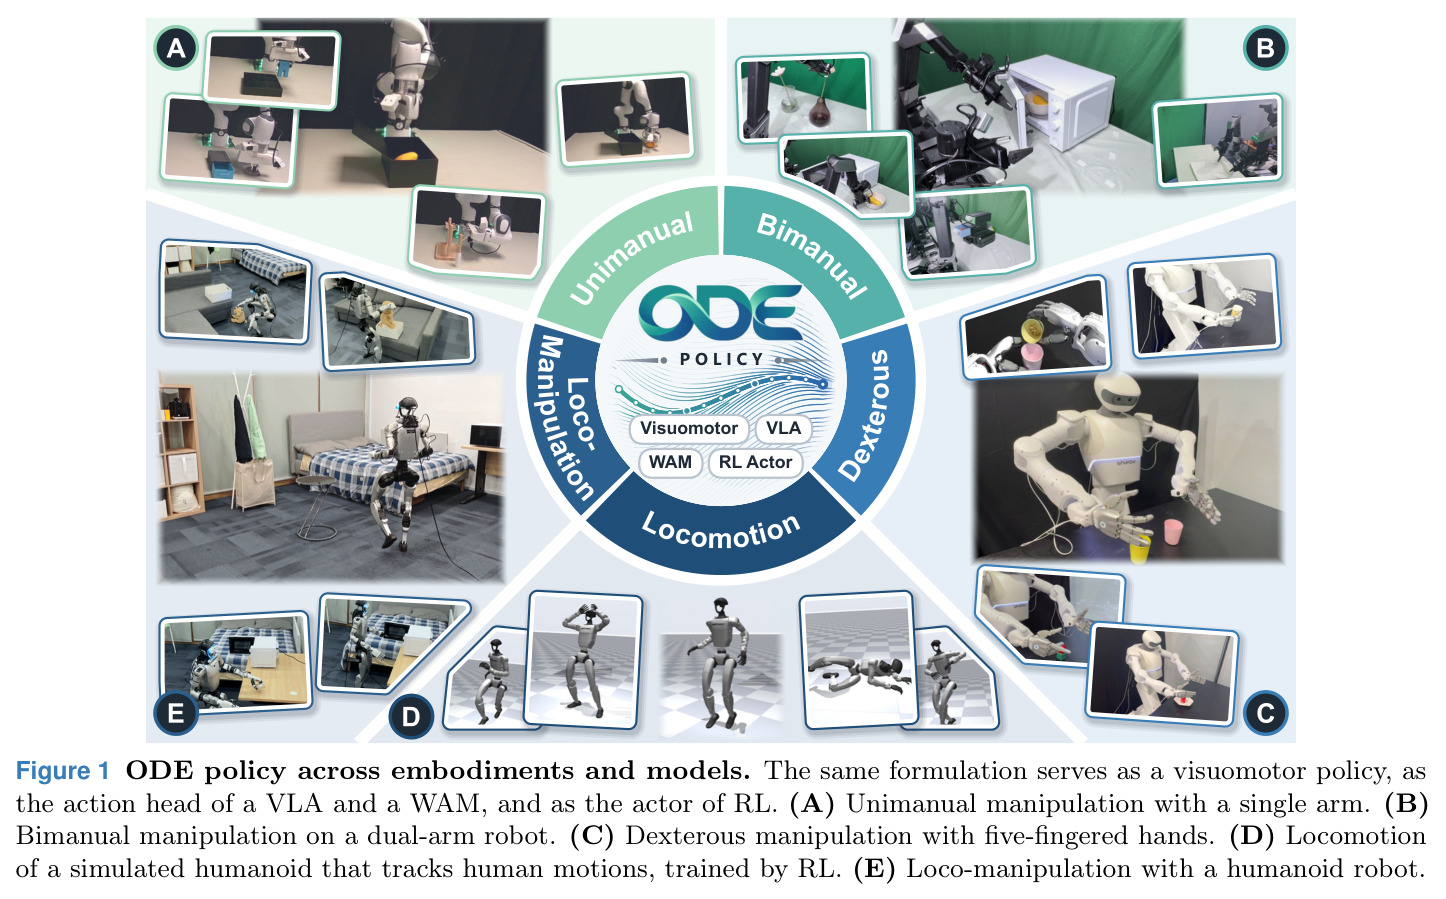
展示 ODE policy 的统一形态在五类场景中的应用照片:(A) 单臂灵巧操作、(B) 双臂机器人操作、(C) 五指灵巧手操作、(D) 强化学习训练的仿真人形跟踪人体运动、(E) 人形机器人 loco-manipulation。同一个公式无需修改地充当视觉运动策略、VLA/WAM 的动作头和 RL 的 actor。
一图总览论文的研究范围与最大卖点——统一性与跨本体泛化,帮助读者在进入技术细节前理解“一个场,五种形态”的整体图景。