基于教学视频的LLM智能体非参数化持续学习:TAL教程书记忆范式 Can Large Language Model Agents Learn by Watching Tutorial Videos?
无需参数更新,TAL把教学视频固化成教程书记忆并用TOC检索,让冻结LLM持续学习
前置知识
非参数化持续学习
指不修改模型权重、而是把新知识写入外部存储来让智能体持续变强的学习范式。模型参数 $\theta$ 全程冻结($\theta_{t+1}=\theta_t$),能力增长来自记忆的写入与精炼。典型代表包括 RAG 的语料更新、技能库的扩充、以及基于案例推理(CBR)的经验积累,与依赖梯度下降的参数化微调相对。
本文的全部设计都建立在'参数不能动'这一约束上,理解这个范式才能明白为什么要用记忆而非微调来承载学习。
RAG(检索增强生成)
把外部文档切块、用嵌入向量或 BM25 等方式按语义相似度检索 top-k 片段,拼进提示词后再让冻结的 LLM 生成答案。知识存于外部语料,更新靠增删文档,不需要训练模型。本文的 Transcript-RAG 和 Video-RAG 基线即此思路,直接检索视频字幕或帧描述。
RAG 是本文最重要的对照系:TAL 的 TOC 检索正是针对'嵌入相似度不等于任务相关性'这一 RAG 痛点设计的。
基于案例的推理(CBR)与经验记忆
把智能体自身过往的交互轨迹(做了什么、成败如何)存成案例,遇到新问题时检索相似案例辅助决策,代表系统如 Memento。它记录的是'发生了什么'而非'为什么、怎么做',在新场景中解释性指导有限,效果依赖案例覆盖度和模型从原始轨迹推理的能力。
TAL 在 Fig.1 中把自己与 CBR 明确对立:教程书存的是人类讲解的通用知识,而非智能体自己的 episodic 轨迹,这是理解本文定位的关键。
对抗式生成与 propose-and-verify
让两个角色互相施压以改进系统:一方专门生成让对方失败的输入(如出难题),另一方被迫补强。本文用两层对抗——出题器与冻结模型对抗挖知识缺口;记忆改写器被题库验证,候选改写只有严格提分才被接受(propose-and-verify),从而保证每次更新单调不减。
两阶段对抗式固化是 TAL 的核心引擎,理解它才能看懂记忆是如何被'失败驱动'地定向精炼的。
信息瓶颈原理(Information Bottleneck)
一种表示学习目标:寻找压缩输入 $X$ 同时保留对目标 $Y$ 的预测信息的表示 $M$,形式为 $\min_M I(M;X)-\beta I(M;Y)$,其中 $I$ 是互信息。压缩项防止表示变成对输入的无选择编码,预测项保证它对下游任务有用。
作者用它解释教程书设计:记忆既要压缩视频(不能全文照抄)又要保持可答题性,这正是 Stage I/II 分工的理论对应物。
研究动机
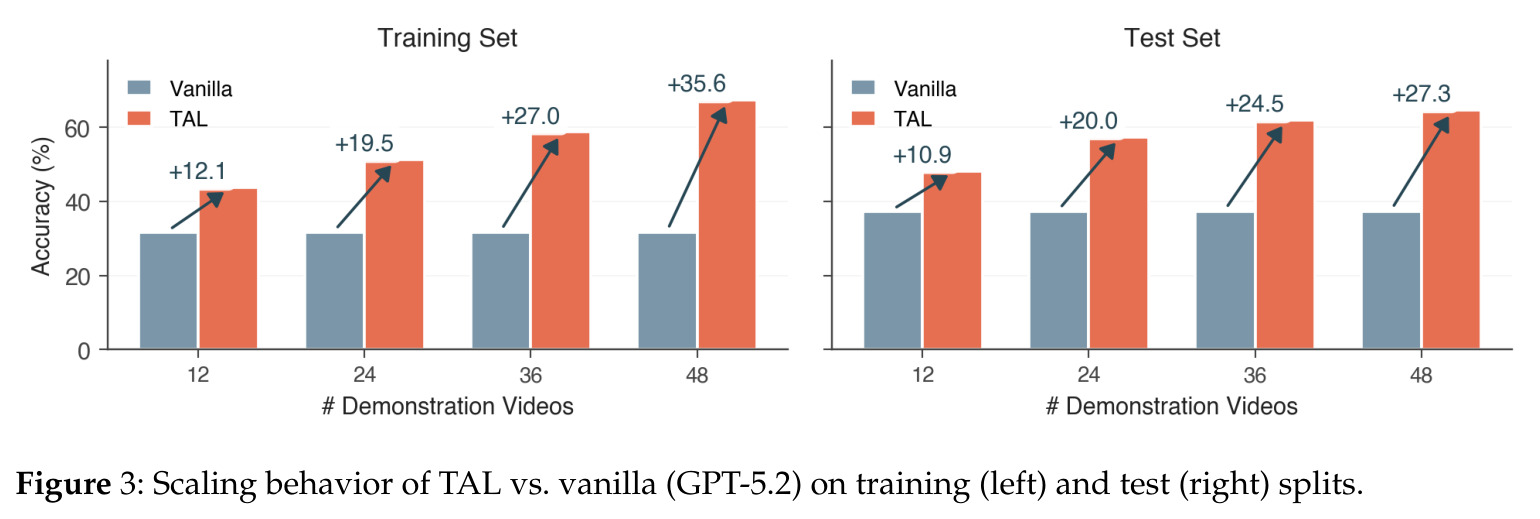
大语言模型的能力在预训练结束后即被冻结,部署后的持续改进只能依赖重复微调,而大规模参数更新的成本高到不可行。与此同时,互联网上每天有数百万条教学视频被上传,这些自带'演示+讲解'的多模态教学资源是现成的、无需人工策展的知识来源,但当前的 LLM 智能体没有任何机制能把它们转化为可复用知识。现有两条非参数化路线各有硬伤:一是 RAG 和 agent skills,依赖人工为智能体策展的文档或 markdown 工作流,无法随开放世界的教学供给自然扩展;二是基于案例的推理(CBR,如 Memento),只存智能体自身轨迹这类'发生了什么'的记录,在新场景中缺乏'为什么、怎么做'的解释性指导,效果高度依赖案例覆盖度。具体到本文的 VidLearn 场景:四个主流模型直接回答多模态象棋问题的准确率只有 31.61%-47.70%,开启思考模式的 CoT 推理反而常常更差(GPT-5.2 从 37.27% 降到 30.91%),说明瓶颈不在推理深度,而在模型根本接触不到正确的教学知识。
本文的目标是本文的目标是让参数完全冻结($\theta_{t+1}=\theta_t=\theta$)的 LLM 智能体,从连续到来的教学视频流 $D=\{v_t\}_{t=1}^T$ 中持续积累可复用的结构化知识,并在下游多模态 QA 和实际任务中调用,全程零梯度更新。可衡量的目标包括:在自建的 VidLearn 基准(72 个国际象棋教学视频、覆盖 12 个经典开局、48 个训练视频加 24 个 held-out 视频衍生的 110 道人工校验测试题)上,训练集相对 vanilla 模型最高提升 112.72%(GPT-5.2)、测试集最高提升 91.42%(Kimi K2.5);性能随消费视频数量单调上升,呈现类人学习曲线;学到的教程书记忆可跨模型迁移(GPT-5.2 构建的记忆被 Kimi、Gemini、Claude 直接消费);在第二个领域(Adobe Photoshop 2026 软件教程)验证泛化,held-out 准确率 49.7%、超最强基线 10.9 个百分点;并把记忆优势转化为真实对弈中开局阶段的决策优势(Stockfish 评估下 69% 的对局占优)。
与已有工作不同的是,本文的独特切入是把'教学视频'——而非人工策展文档或智能体自身经验轨迹——当作持续学习的信号源。视频天然存在于互联网规模、无需为智能体专门制作,且与 RAG 语料和 CBR 案例不同,它同时提供'演示了什么'和'为什么、怎么做'的配对解释,是带推理指导的知识而非裸事实。方法上有两个被前人忽视的点:其一,用两阶段对抗过程定位模型知识缺口——出题器专门生成'有视频证据支撑但冻结模型答不出'的难题(保留条件 $\delta_t(q)=\mathbb{1}[d_t(q)>\epsilon_d]\rho_t(q)$),把失败变成有针对性的记忆改写,而不是盲目压缩全部视频内容;其二,检索不用嵌入相似度,而是 TOC(目录)树上的推理式检索,让'找哪章'成为模型推理链的一部分,消除语义相似度与任务相关性之间的错配。作者还用信息瓶颈目标 $\min_{M_t} I(M_t;V_t)-\beta I(M_t;Y_t)$ 给出理论视角:记忆既要压缩视频又要保持对下游答案的预测性。
核心方法
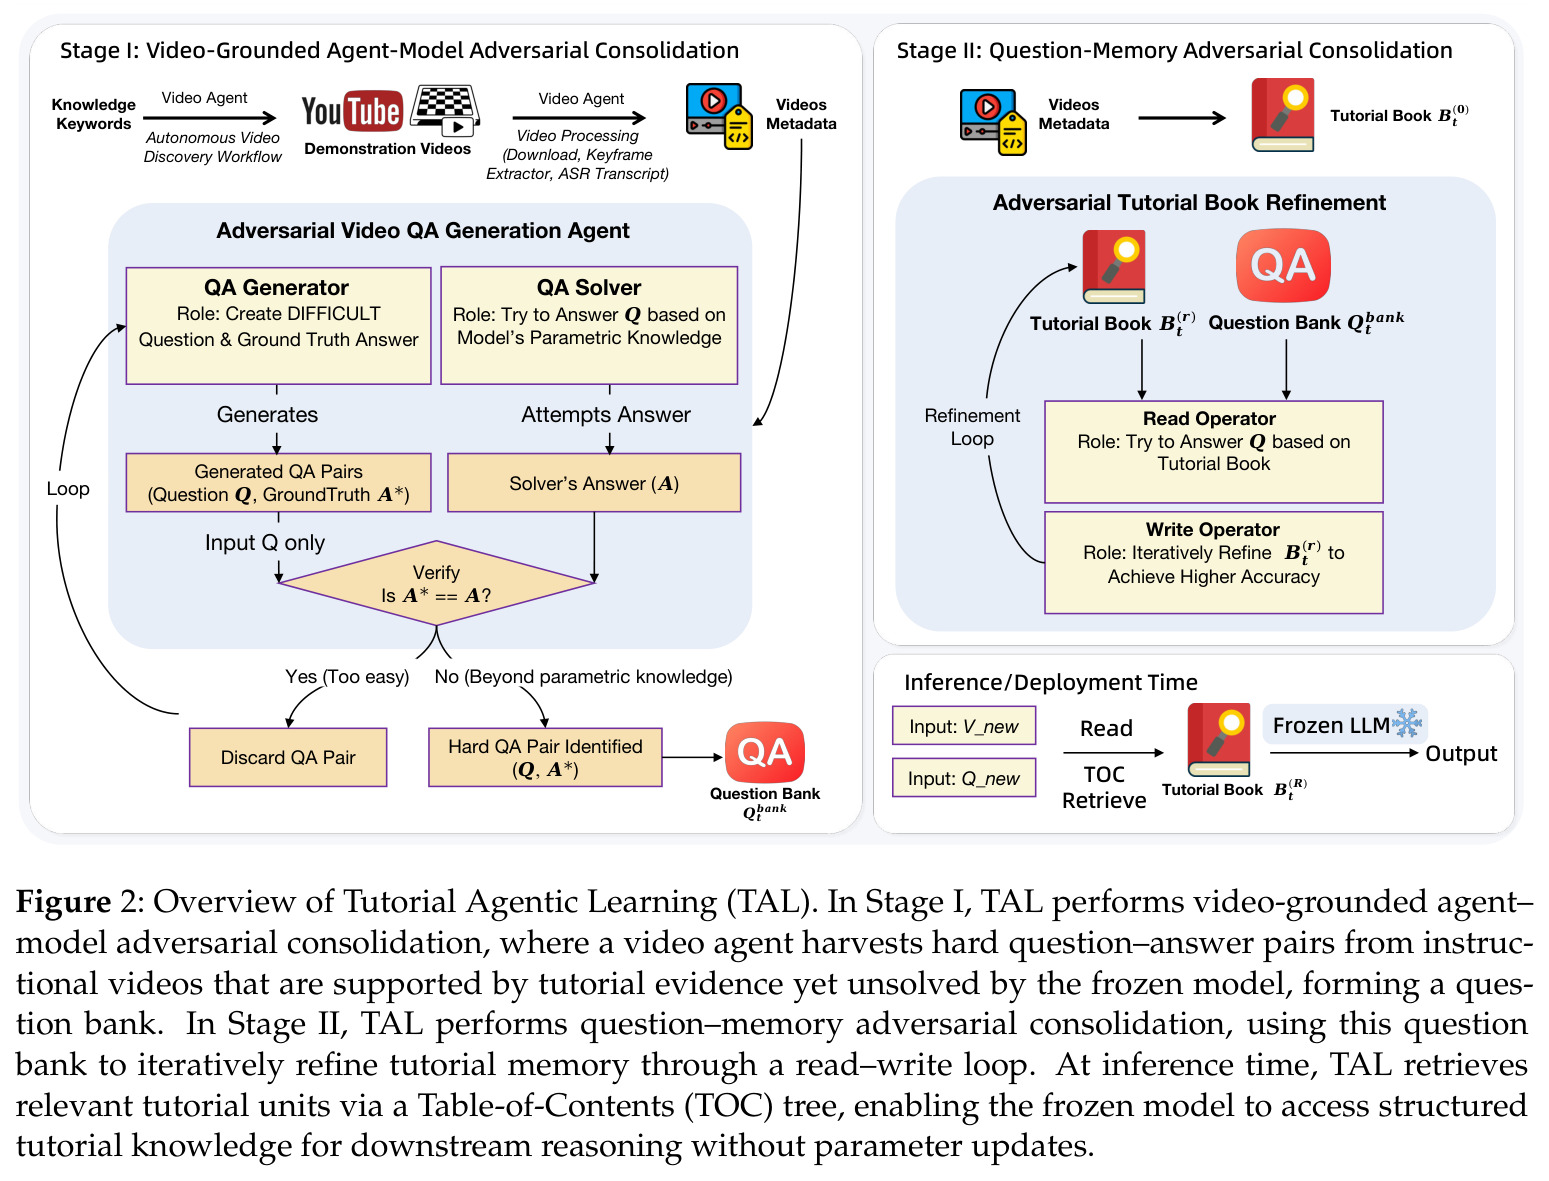
直觉上,TAL 让智能体像人类学习者:看教学视频时把内容整理成一本结构化的'教程书'(tutorialbook),日后解题先翻目录找到相关章节、再展开细读,而不是把整本书背进脑子里(参数更新),也不是只收藏自己踩过的坑(案例记忆)。技术路线是把学习基底从参数空间转移到外部章节记忆 $B_t^{(r)}=\{(k_j, z_j^{(r)})\}_{j=1}^{N^{(r)}}$,其中 $k_j$ 是章节检索键(类别、标题、简短摘要),$z_j^{(r)}$ 是教科书式章节(概览、主题小节、要点总结)。学习通过两阶段对抗式固化完成:Stage I 由视频智能体从每个视频抽时间戳对齐的证据片段生成 QA 对,用冻结模型在空上下文作答来测难度,只保留难题(48 个视频共收 174 道 QA 组成题库);Stage II 用读-写循环精炼记忆——用当前记忆答题、失败集指导 LLM 编辑器改写相关章节、候选记忆只有在题库上严格提分才被接受,保证单调改进。推理时通过 TOC 树做 top-k 章节检索并聚合内容作答。整个循环没有任何梯度下降,是纯粹的非参数化学习,且同一本教程书可被多个模型共享。
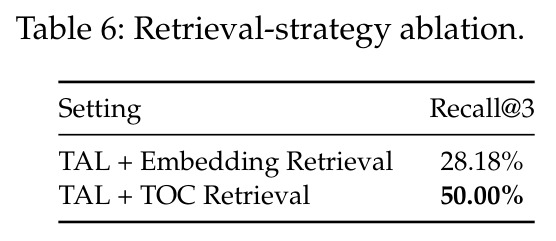
核心创新有三层。第一是学习基底的转移:RAG 存人工文档、CBR 存'发生了什么'的经验轨迹,TAL 存的是从人类教学视频中固化出的'why+how'教科书结构,可增量精炼、可跨模型复用。第二是两阶段对抗式固化:Stage I 是智能体-模型对抗,出题器通过反思性修订最大化难题收获目标 $J_t^{harvest}(\phi)=\mathbb{E}_{e,q}[d_t(q)\rho_t(q)]$,专门挖参数知识之外的缺口;Stage II 是问题-记忆对抗,记忆被题库反复测试,失败集 $\mathcal{F}_t^{(r)}$ 指定改写目标,propose-and-verify 机制(候选改写须在题库上严格提分才接受)带来单调改进并防止破坏已正确内容,形式上对应带邻近惩罚 $\gamma\mathcal{C}(B_t^{(r)},B_t^{(r-1)})$ 的镜像下降。第三是 TOC 推理式检索:模型读目录选章节,把'找哪章'纳入推理链而非向量相似度,消融显示其 Recall@3 达 50.00%,比嵌入检索的 28.18% 高 21.82 个百分点。
方法步骤详情
流程分五步。第一步视频解析:给定 YouTube 链接,下载、抽关键帧、ASR 转录并按时间戳对齐证据片段 $e=(\tau,W_\tau,I_\tau)$,即时间锚点、±10 秒字幕窗口和视频帧。第二步 Stage I 对抗出题:每视频最多 3 轮,每轮切 20 个事件各出一题;冻结模型空上下文作答得难度 $d_t(q)=\ell(f_\theta(x_q,c_0),a^\star_q)$,独立 LLM judge 校验题目锚定于 $\tau$ 处讲师内容且非纯感知题;只保留答错且通过校验的 QA,每视频上限 60 题,48 视频共收 174 道。第三步 Stage II 记忆精炼:用证据片段初始化 $B_t^{(0)}$,最多 3 轮读-写循环——Read 算子用当前记忆答题库得失败集,Write 算子让 LLM 编辑器改写失败涉及章节,候选 $B_t^{(r+1)}$ 须严格提分才接受,验证集早停。第四步 TOC 推理:教程书为卷-部-章目录树,LLM 读目录选 top-3 章节,聚合全文作答 $\hat{y}=f_\theta(x,\mathrm{Read}(x,B_t^{(R)}))$。第五步跨模型部署:GPT-5.2 构建的教程书可被 Kimi、Gemini、Claude 直接消费。
技术新颖性
与已有技术的区别:相比 VideoRAG 只服务于'当下这支视频的理解',TAL 把视频转化为跨任务复用的外部知识结构;相比 mem0、ReasoningBank 消费智能体自身交互经验,TAL 消费人类教学视频这种互联网规模教育资源,记忆是结构化章节而非扁平条目;相比 agent skills 无需人工编写工作流;相比 Reflexion/Self-Refine 只用失败改进单条轨迹,TAL 把失败转化为持久知识库的定向编辑。理论上,作者将其解释为信息瓶颈目标 $\min_{M_t} I(M_t;V_t)-\beta I(M_t;Y_t)$ 的可操作化:Stage I 最大化难题收获对应保证预测性 $I(M_t;Y_t)$,Stage II 的 propose-and-verify 与邻近惩罚对应控制压缩项与记忆漂移,构成非梯度 minimax 结构 $\min_{B_t^{(R)}}\max_\phi\ J_t^{harvest}(\phi)+\lambda\mathcal{L}_t^{mem}(B_t^{(R)})$。VidLearn 也是首个'从视频学知识'的多模态 QA 基准。
实验结果
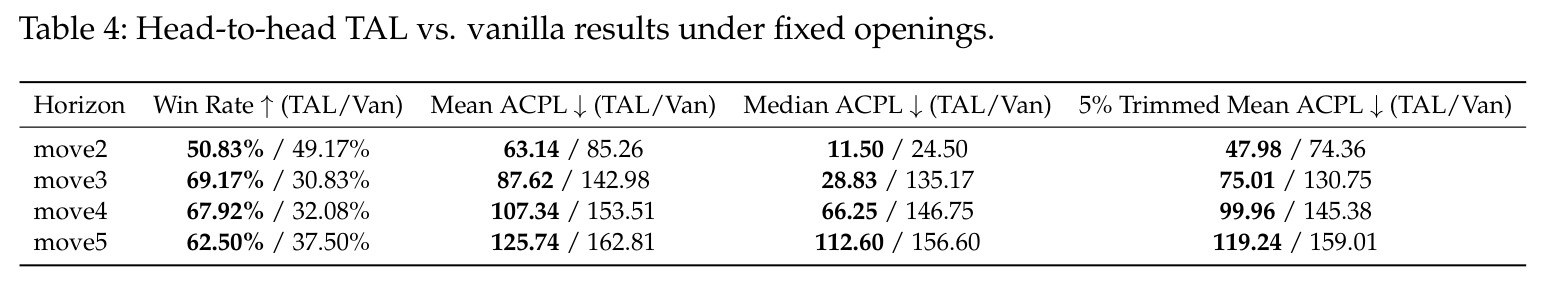
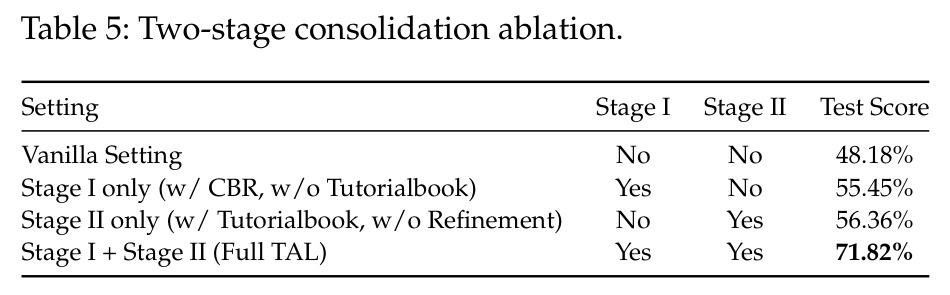
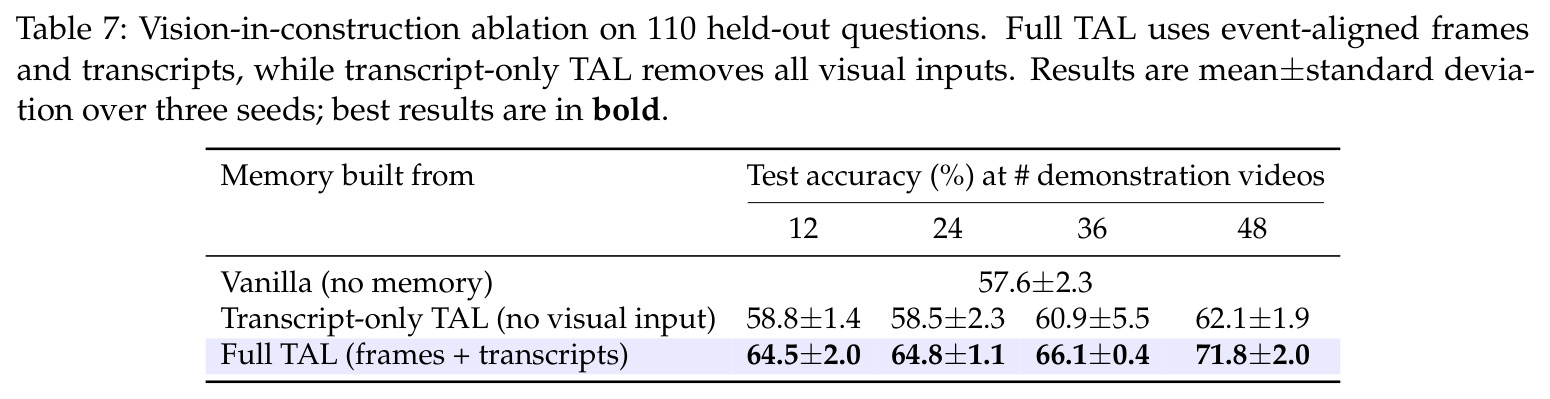
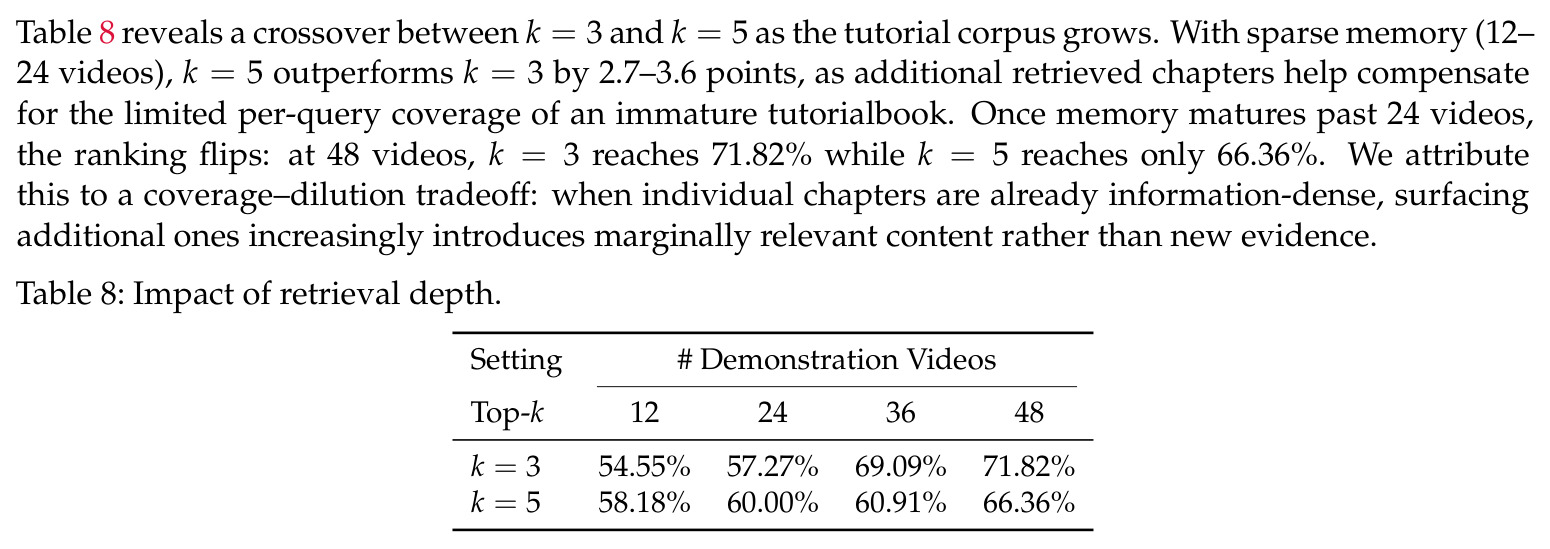
主实验(Table 1):48 视频时 TAL(Gemini 3 Flash) 训练 81.61%、测试 71.82%,vanilla 仅 47.70%/48.18%;最大相对提升训练 112.72%(GPT-5.2)、测试 91.42%(Kimi K2.5)。扩展行为是关键:Transcript-RAG 测试集随语料增大不稳定甚至退化(GPT-5.2 下从 42.73% 降到 37.27%),TAL 单调上升,说明字幕检索越扩越噪、结构化记忆才能累积知识。对齐比较(Table 2,三种子):48 视频 TAL 训练 84.1±1.4、测试 71.8±2.0,全面高于 Transcript-RAG、Video-RAG 变体、mem0、ReasoningBank,八设置全部第一;教程记忆 105,703 tokens,比 RAG 的 598,027 tokens 压缩 82.32% 仍更准。跨域(Table 3,Photoshop 2026):16 视频训练 98.7%,held-out 49.7%、超最强基线 10.9 点。对弈(Table 4):move3 胜率 69.17% 对 30.83%,ACPL 87.62 对 142.98。消融(Table 5-8):Full 71.82% 对 Stage I only 55.45%、Stage II only 56.36%(超加性预测 8.2 点);TOC Recall@3 50.0% 对嵌入 28.18%;视觉贡献约 9.7 点。
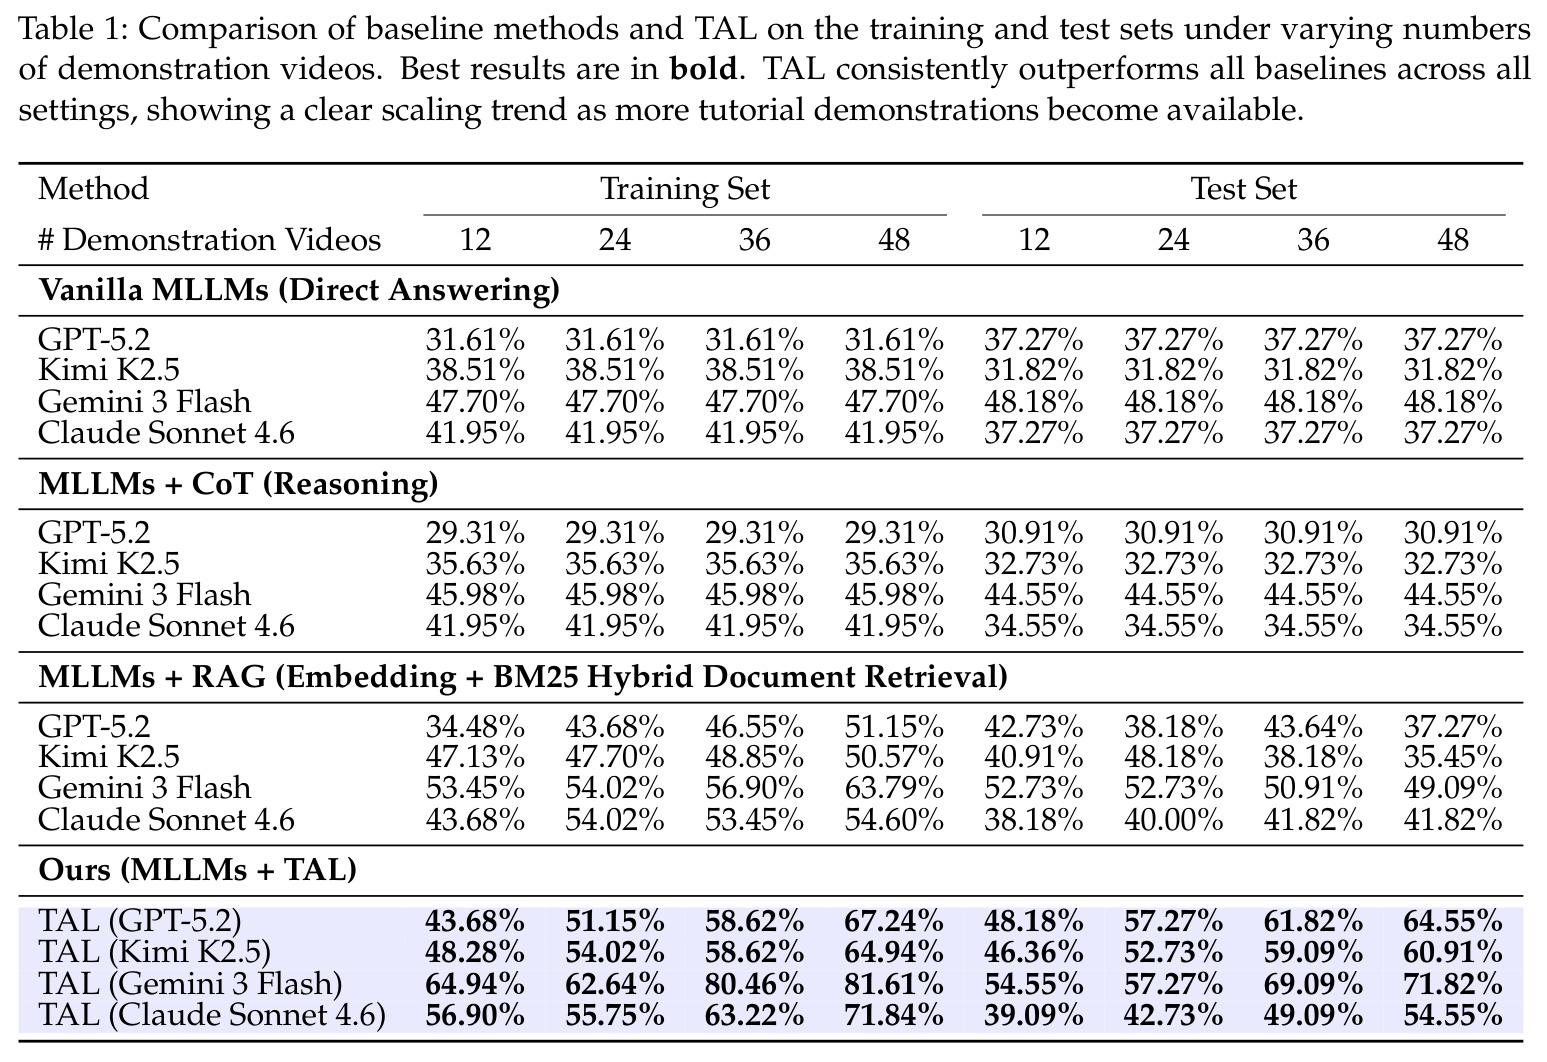
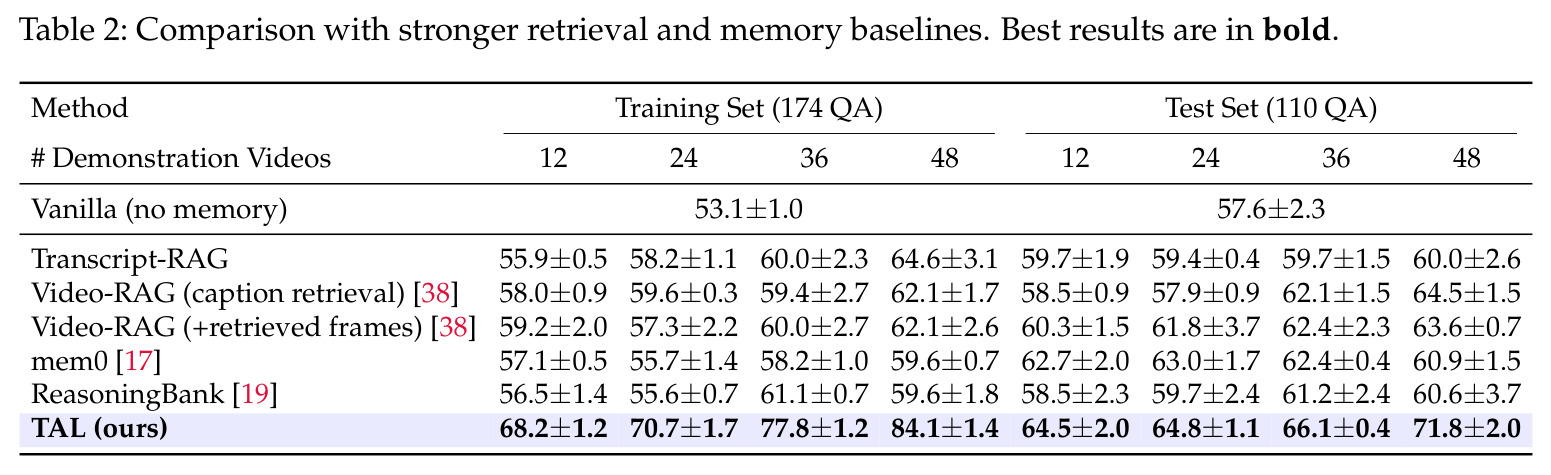
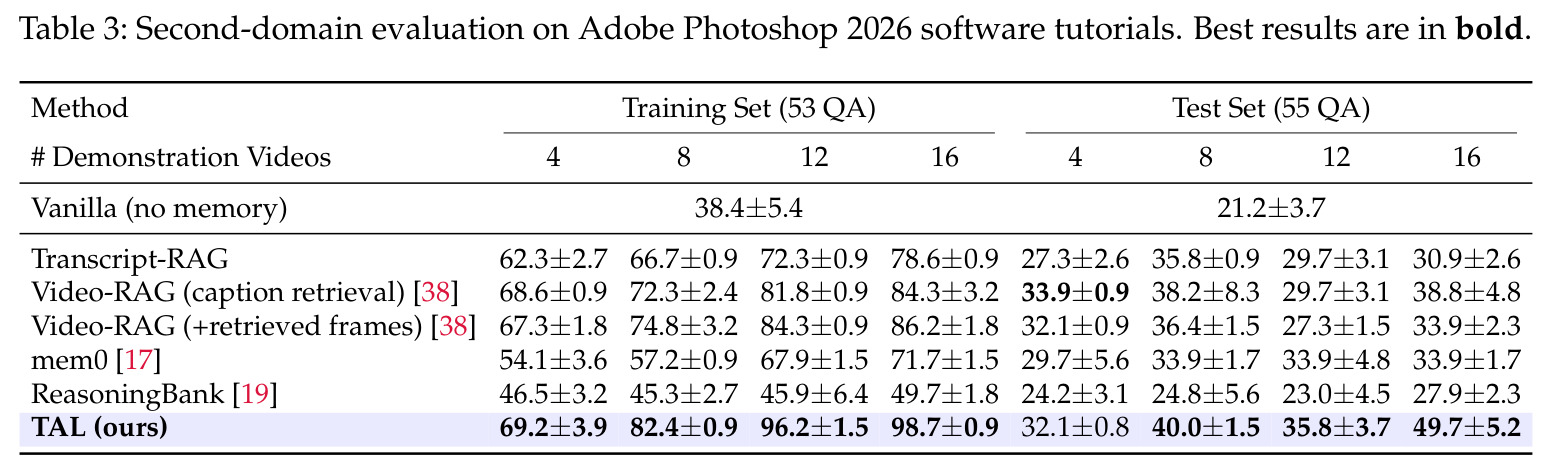
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| VidLearn 象棋多模态 QA(训练集 174 QA,48 视频) | 准确率 | TAL(Gemini 3 Flash) 81.61%;TAL(GPT-5.2) 67.24% | vanilla Gemini 3 Flash 47.70%;最强非 TAL 基线(Gemini-3.5-Flash Transcript-RAG)64.6±3.1 | 相对 vanilla 最高 +112.72%(GPT-5.2);对最强基线 +19.5 点(84.1±1.4 vs 64.6±3.1) |
| VidLearn 象棋多模态 QA(held-out 110 QA,24 个未见视频) | 准确率 | TAL(Gemini 3 Flash) 71.82%;Gemini-3.5-Flash 下 71.8±2.0 | vanilla 48.18%;Video-RAG(+frames) 64.5±1.5 | 相对 vanilla 最高 +91.42%(Kimi K2.5);对最强基线 +7.3 点 |
| Photoshop 2026 软件教程 QA(held-out 55 QA) | 准确率 | 49.7±5.2(16 训练视频) | Video-RAG(caption) 38.8±4.8;vanilla 21.2±3.7 | +10.9 个百分点 |
| 真实对弈开局阶段(12 开局×20 局,换色协议) | Stockfish 胜率 / ACPL | TAL move3 胜率 69.17%,ACPL 87.62 | vanilla GPT-5.2 胜率 30.83%,ACPL 142.98 | 胜率 +38.34 点,ACPL 降低 55.36 |
| 检索策略消融(12 开局分类) | Recall@3 | TOC 检索 50.00% | text-embedding-3-small 密集检索 28.18% | +21.82 点 |
局限与改进
作者可观察到的局限:VidLearn 规模不大——72 个视频、110 道 held-out 测试题,主域仅国际象棋,第二域也只有 28 视频 108 题;训练 QA 由模型生成(仅测试集人工校验),题库质量受生成器约束;对弈只在开局阶段(move2-5)评估,中残局未测。我的独立观察:其一,held-out 与训练准确率差距明显(84.1% 对 71.8%),记忆精炼可能部分过拟合 174 道题库;其二,跨模型增益不均匀,Claude Sonnet 4.6 测试集只从 37.27% 升到 54.55%,而 Gemini 3 Flash 升到 71.82%,教程书收益依赖基座既有领域知识;其三,Stage I 每视频上限 60 题、Stage II 最多 3 轮,长视频长尾知识可能未覆盖;其四,教程书是静态快照,没有处理视频间知识冲突或知识过时(软件版本更新)的生命周期机制;其五,论文未报告构建教程书的 API 成本与延迟,每视频多轮出题、判卷、改写调用量不小,部署经济性存疑。
独立分析的弱点
第一,出题器与 judge 都是 LLM,出题和训练集评分都用同一模型(GPT-5.2),存在'自己出题自己考'的循环,grounding 判断可能有系统性偏差;改进:引入人类标注校准子集、多模型交叉 judge,或在规则可验证域用引擎验证答案替代 LLM 判卷。第二,propose-and-verify 以 174 道题库为唯一接受标准,容易把记忆推向'答对这 174 题'而非'覆盖该开局知识',训练 84.1% 对 held-out 71.8% 的差距是直接证据;改进:题库划分改写目标集与早停验证集,或按开局分层采样。第三,TOC 检索每次推理都要读入全部目录,章节数随视频增长会推高上下文与延迟,且 50% 的 Recall@3 意味着近半查询检索不到正确开局章节;改进:TOC 与嵌入检索混合、目录层级剪枝、先路由卷级再展开。第四,视觉输入只用单帧锚点,对连续变着演示等时序内容表达力有限;改进:用短片段级证据。第五,评估全是选择题,排除效应可能虚高真实能力;改进:增加生成式答案与引擎自动评分。第六,教程书无版本管理与冲突消解,知识过时会静默出错;改进:引入置信度标注与过时淘汰。
未来方向
作者把教学视频定位为参数更新无关持续学习的可扩展资源,暗示了更大规模视频流的持续消费。基于成果可延伸的方向:一是记忆生命周期管理——为教程书引入版本控制、冲突检测与过时淘汰,尤其软件教程这类随版本演化的领域;二是混合检索——TOC 推理检索与嵌入检索互补(Table 6 显示两者差 21.82 点,但也意味着各有盲区),以及随章节规模增长的层级检索优化;三是把陈述性教程知识与程序性技能库结合,让'知道怎么走'进一步变成'会执行'的闭环;四是跨域记忆组合与迁移,检验棋类教程书与软件教程书能否共享结构;五是把人类反馈引入 Stage II 的改写验证,缓解 LLM judge 偏差;六是把评估从开局 QA 扩展到完整对局和更长多步推理;七是成本工程——增量构建、题库缓存与共享,把单视频固化成本降到能随每日数百万条新教学视频扩展的水平。
复现评估
复现评估:正文未明确给出开源仓库声明(附录 A.1 提供实现细节),这是复现的首要门槛。数据方面,VidLearn 由 YouTube 搜索按开局名收集 72 个视频,链接可复现但需自行处理下载、关键帧抽取与 ASR,且存在视频下架风险;110 道测试题经人工校验但标注协议未完全展开。算力方面非常友好:全程无梯度训练,只需商业 LLM API(GPT-5.2、Kimi K2.5、Gemini 3 Flash、Claude Sonnet 4.6、Gemini-3.5-Flash),成本集中在 Stage I(每视频 ≤3 轮×20 事件出题+judge+难度测试)、Stage II(每轮 174 题全量打分+章节改写)与评估调用,无训练 GPU 需求。超参数齐全:3 轮 harvest、每轮 20 事件、60 题上限、3 轮精炼、top-3 检索、温度 0.7。基线中 VideoRAG、mem0、ReasoningBank 均开源。总体难度中等:流程清晰、无训练基础设施,主要不确定性在 LLM 生成 QA 的随机性与 judge 行为,建议固定种子并保留中间产物以对齐结果。
论文图表
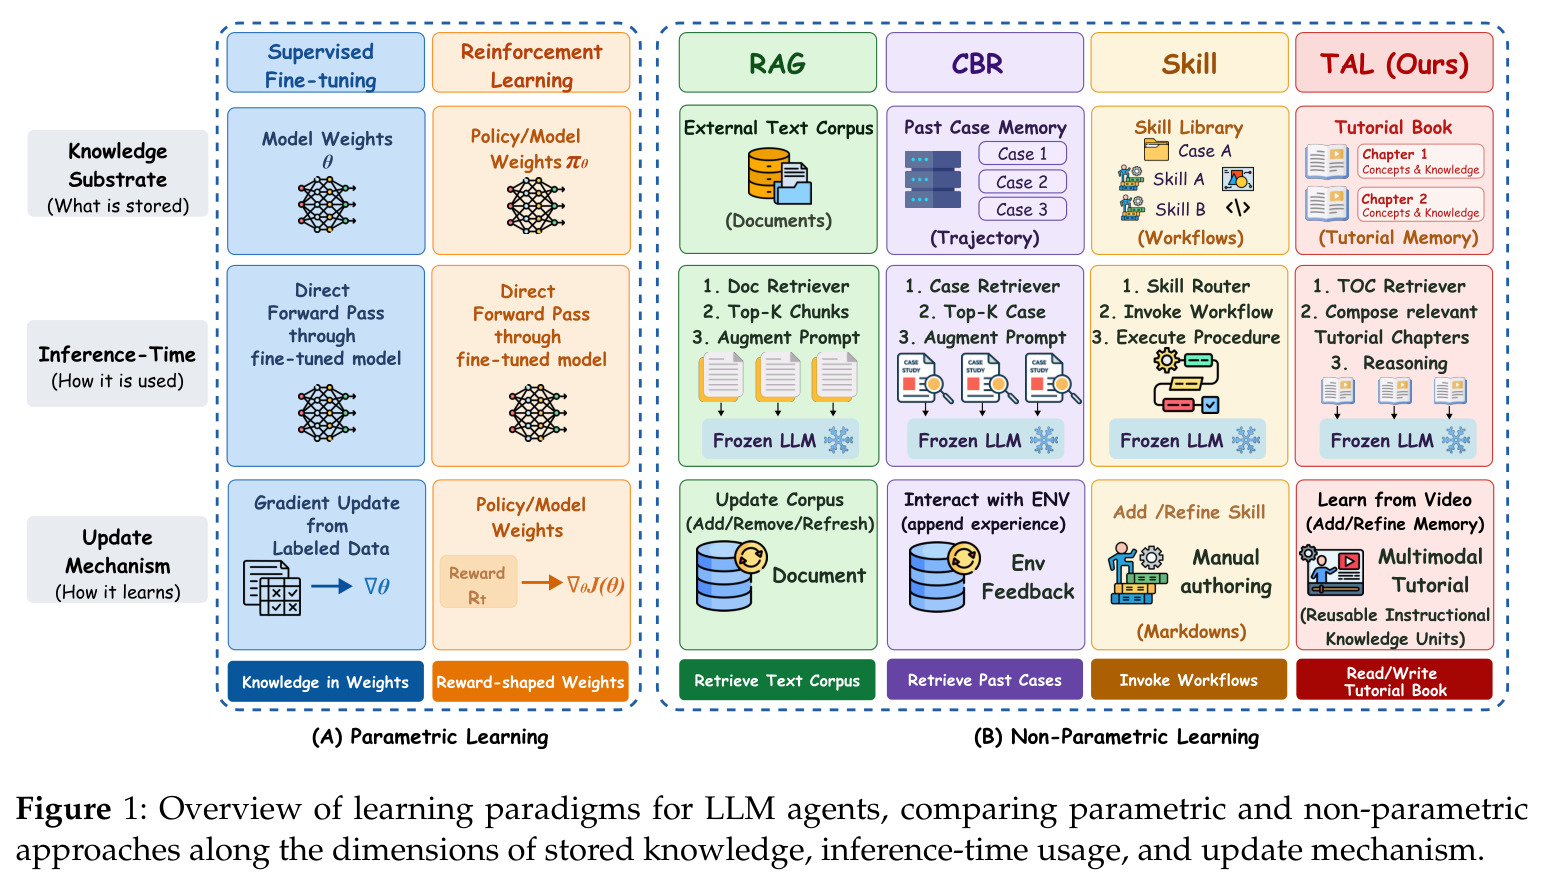
对比矩阵:参数式(监督微调、强化学习,知识存权重、前向推理、梯度更新)与非参数式(RAG 存外部语料、CBR 存过往案例、技能库存工作流、TAL 存教程书)在'存什么、推理时怎么用、怎么更新'三个维度上的差异。TAL 一列显示:知识基底是教程书,推理时用 TOC 检索器组合相关章节,更新机制是从多模态教学视频读/写教程书。
一图定位本文在 LLM 智能体学习版图中的位置——它是理解 TAL 与 RAG/CBR/技能库本质区别的最快入口,也是全文叙事的纲领。