「PRISM」并非万能:跨主题重名冲突与科学论文检索 "PRISM" Is Not All You Need: Cross-Topic Name Collisions and Scientific Paper Retrieval
AI论文标题跨主题重名六年增长4.33倍,研究线索可消歧但同主题对手最难区分
前置知识
BM25 词法检索
经典稀疏检索打分函数:用逆文档频率加权查询词并做文档长度归一化,$\text{score}\propto\sum_{t\in q}\mathrm{IDF}(t)\cdot \mathrm{tf}$。本文用 $k_1=1.2$、$b=0.75$ 配置,在全库与精确名候选两个范围作为词法基线。
论文的头部数字(同名目标 59.4% 对唯一名 85.1%)全部由 BM25 产生,读懂消歧实验前必须知道它按词面匹配、对共享短标题天然敏感。
稠密句子检索(MiniLM / E5)
把标题或摘要编码为向量后按余弦相似度排序。all-MiniLM-L6-v2 输出 384 维向量(256 wordpiece 上限),E5-base-v2 输出 768 维并要求查询加 query: 前缀、文档加 passage: 前缀。二者代表与词法完全不同的语义匹配方式。
论文用三类排序器(词法、稠密、语言模型)交叉验证,稠密检索在全库检索中的意外失败(仅 24.4%)是理解候选范围与索引字段影响的关键。
Zipf 词频带
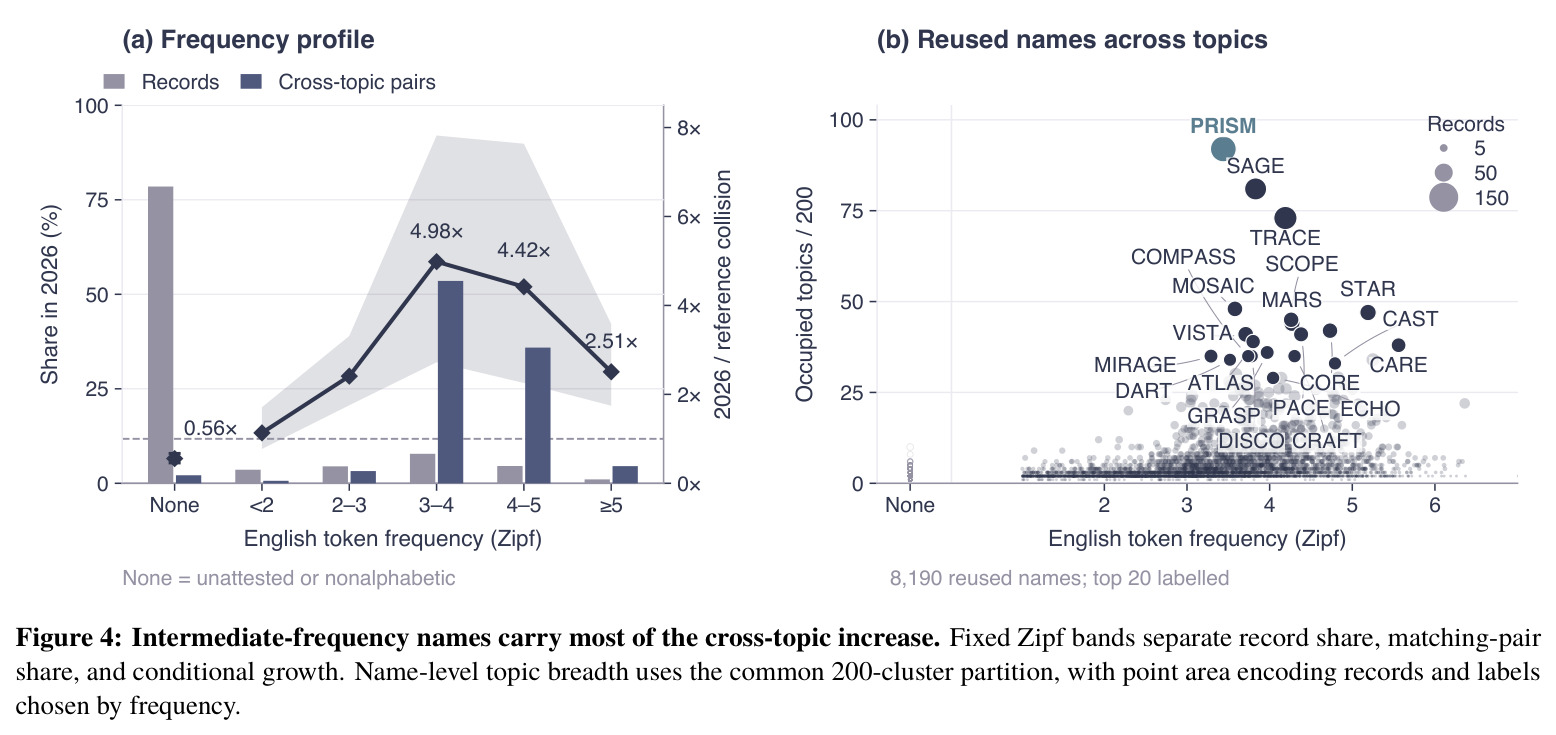
用 $z=\log_{10}f+9$ 把英文词频 $f$ 映射为 Zipf 值,每增加 1 个单位表示频率高 10 倍。本文以 2、3、4、5 为边界把标题标签划入固定频段,$3\le z<5$ 大约对应每百万 token 出现 1 到不到 100 次的\"中频词\"。
论文最重要的机制发现——98.0% 的跨主题碰撞净增长来自中频词带——完全建立在这种固定频段分解上。
语义主题划分(MiniBatchKMeans 聚类)
把每条摘要中自身标题标签遮蔽后用 MiniLM 编码,再用 MiniBatchKMeans 聚成 100/200/400 簇;同簇对视为同主题,跨簇的同名对计入跨主题碰撞。论文另用 MPNet 重编码全部摘要以验证结论不依赖单一编码器。
"跨主题 vs 主题内"这一核心对比的定义完全由该聚类决定,两个编码器的一致性(同主题对 Jaccard 仅 0.301)也直接影响结果的解读。
名字组配对 Bootstrap
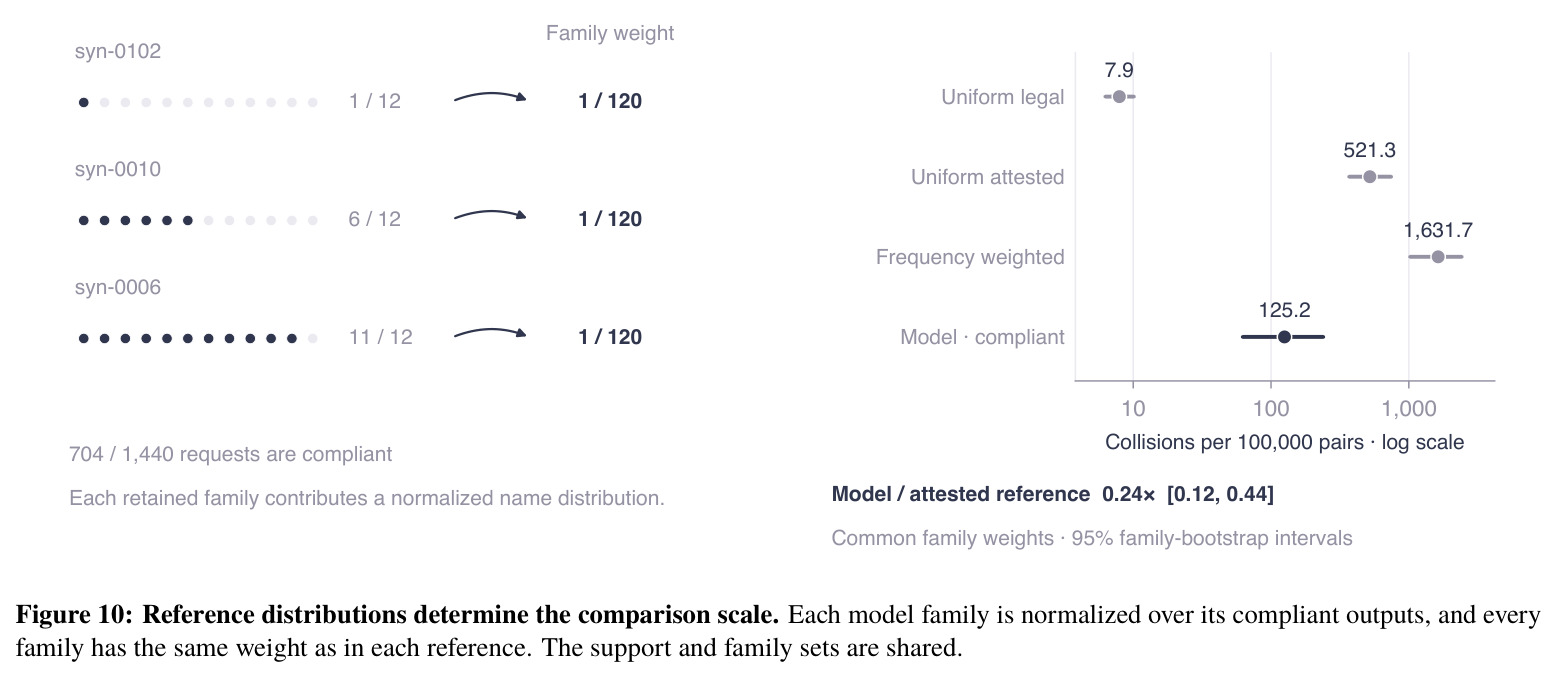
以完整重名组为单元有放回抽取 2,000 次,重算分子分母得到 95% 百分位区间;同一组的目标与其候选群、配对的唯一名对照始终绑在同一次抽取中,保留组内相关性。
论文几乎每个数字都附带这种区间,且作者明确指出按目标独立重采样会丢弃同组共享候选群的依赖,理解它是读懂所有置信区间的的前提。
Listwise LLM 重排
把查询与全部候选标题放入同一个提示,给每个候选一个不透明 ID,要求语言模型输出包含每个 ID 恰好一次的 JSON 排序;非法输出在所有指标上记零分。本文用 DeepSeek-Flash(温度 0)对 1,400 个同名查询做全组排序。
这是标题-only 条件下的最强成绩(Top-1 89.2%)的来源,也是论文"上下文排序"这一层的代表方法。
研究动机
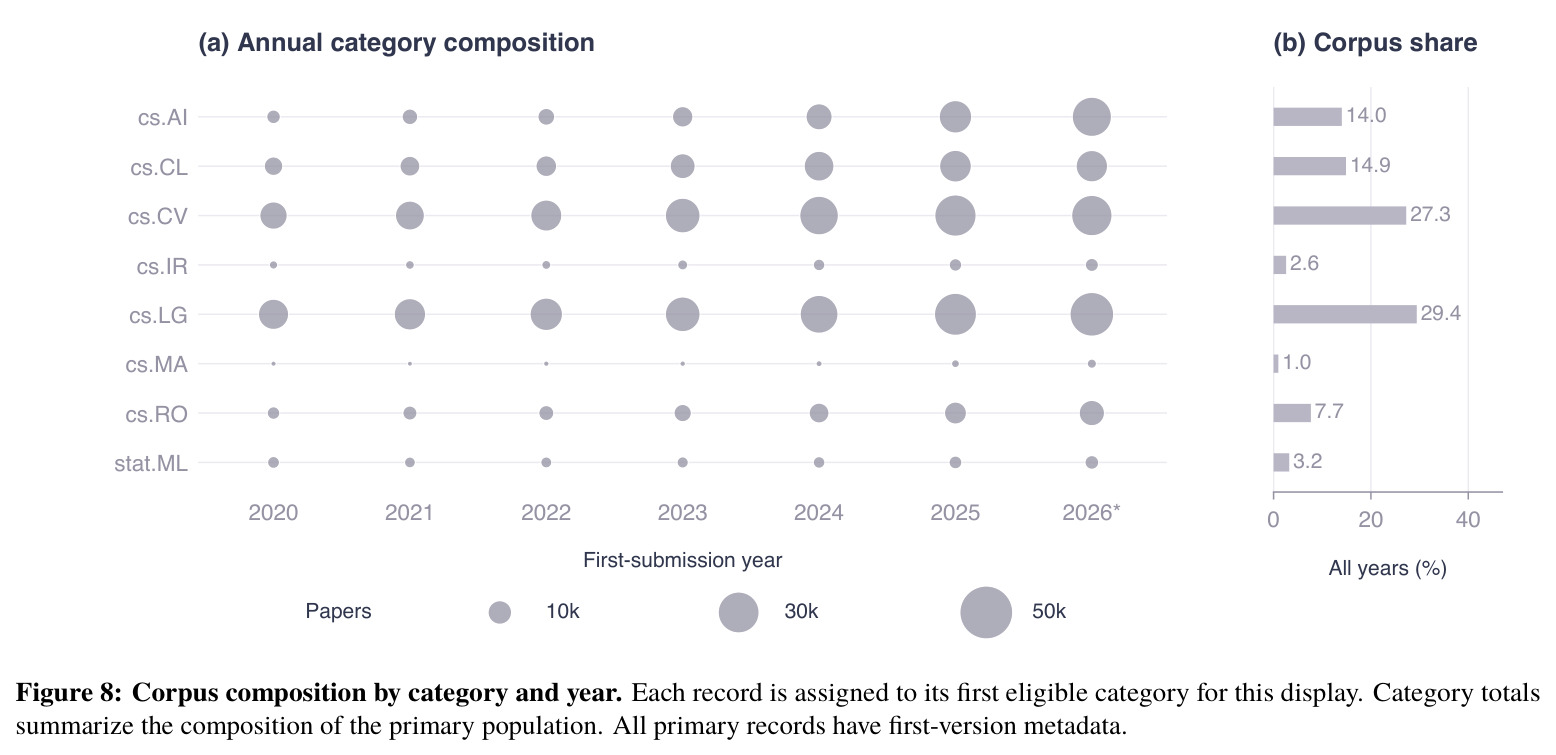
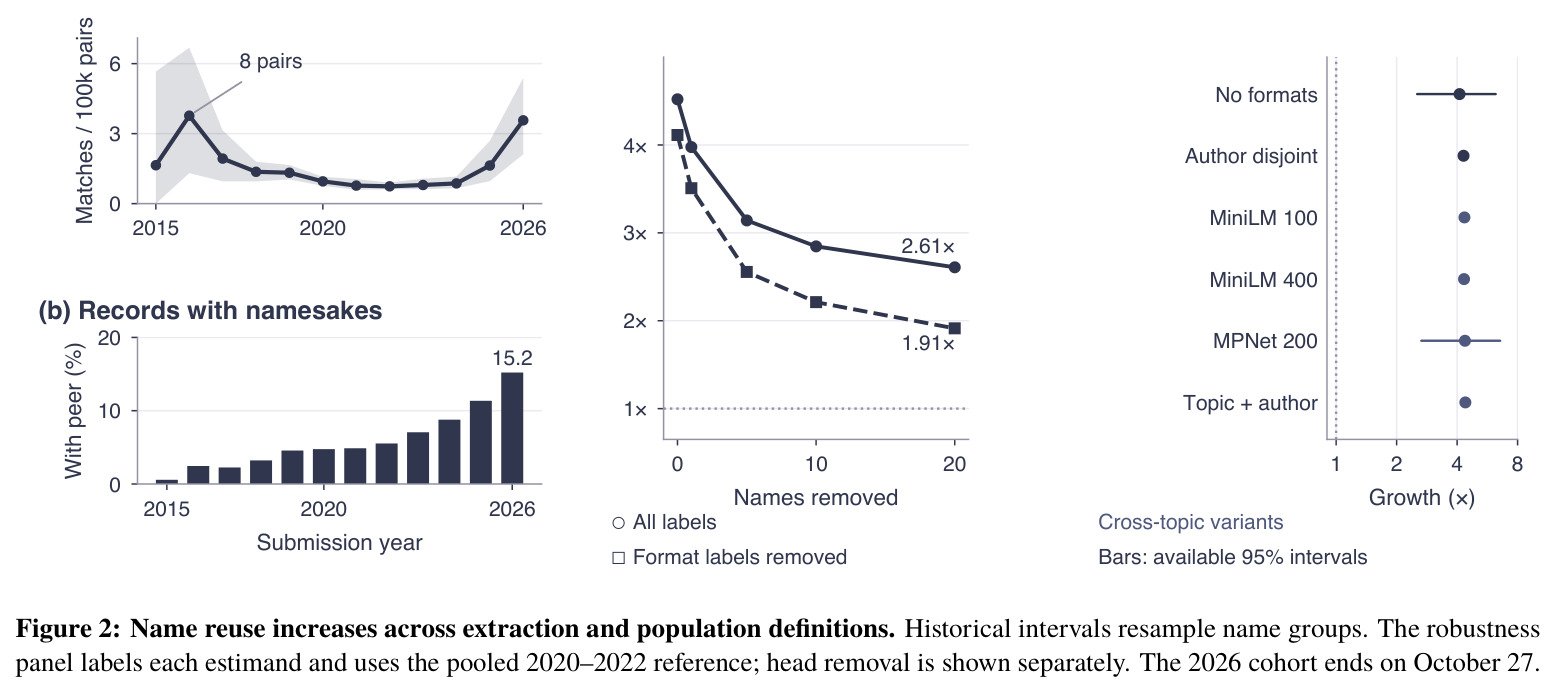
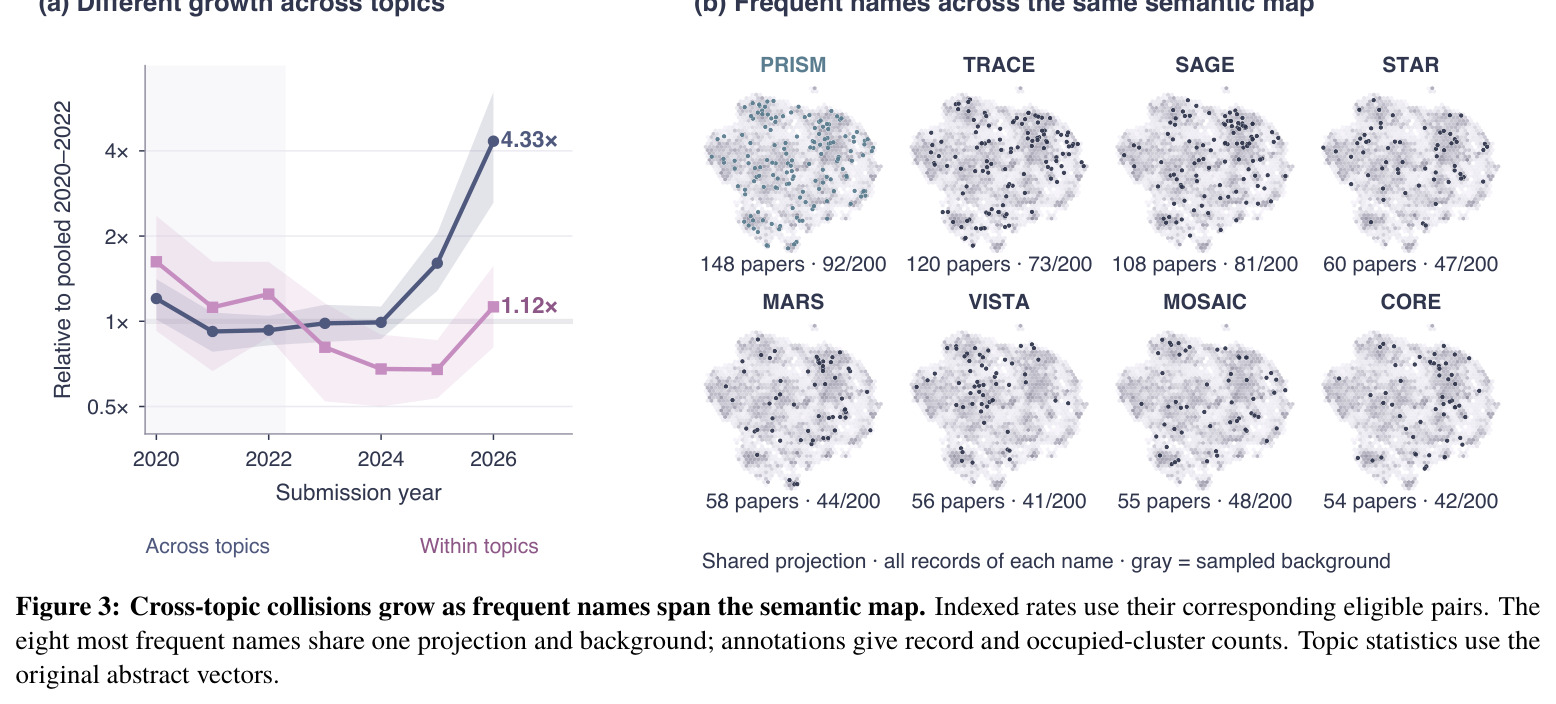
有记忆点的名字方便传播,但同一字符串正被越来越多互不相关的研究复用:PRISM 可以是空间世界模型、病理编码器或安全框架,TRACE 既能重建表格也能归因模型输出,读者只能靠上下文猜论文身份。作者在 564,861 条 AI 相关 arXiv 记录(首提交 2020–2026-10-27,另有 93,165 条 2015–2019 扩展)上量化这一趋势:2026 年标题标签碰撞率是 2020–2022 合并参照的 4.52 倍 [2.59, 7.09];在 144,523 条非格式标签记录、200 簇语义划分下,跨主题碰撞增长 4.33 倍 [2.62, 6.47] 而主题内仅 1.12 倍。受影响人群庞大:28,152 篇论文(占命名记录 19.5%)至少有一个重名者,受影响论文平均面对 8.33 个同名同伴;2026 年 15.2% 的记录有同年同名者。当标题成为检索系统的主键时,跨领域重名使"按名字找论文"成为一个带 25.7 个百分点识别赤字的病态任务。
本文的目标是本文目标有三层。第一,建立版本感知的命名趋同测量:用首版本元数据定义记录身份,把"重名"分解为跨主题与主题内两个条件碰撞速率,回答名字是否正在连接不同的研究领域。第二,把"一个名字能多精确地识别论文"与"给定研究线索后还剩多少歧义"分离成受控检索评测:固定候选集合、统一查询构造规则、元数据匹配对照,用词法(BM25)、稠密(MiniLM/E5)与语言模型(DeepSeek-Flash listwise)三类排序器分别度量,并进一步用索引字段(标题 vs 标题+摘要)区分证据量的作用。第三,定位增长来源:用测量前预定的固定 Zipf 词频带找出哪一层词汇承载增长,用源链接案例(PRISM/TRACE/SAGE 的拼写与谱系、AutoInit 同主题配对)把总体数字落到可检验的具体研究对象上,最终交付可携带评测集合与本地查询演示。
与已有工作不同的是,以往工作停留在描述层面:Zhang et al. 2017 做学术缩写的分析、生成与排序,Barnett 与 Doubleday 2020 记录生物医学文献缩写增长,Nature Methods 2024 讨论命名的记忆性与唯一性,但都没回答"重名到底损害了多少检索精度、什么线索能补救"。本文的独特切入有四点。(1) 速率化:用碰撞率 $C_t=\sum_a n_t(a)(n_t(a)-1)/(N_t(N_t-1))$ 及其跨主题条件化版本(Equation 3)使不同规模的年份可比,把"重名变多"分解为跨主题趋同与主题内复用两条轨迹。(2) 词汇层定位:固定 Zipf 频段在测量前预定,避免事后分类的循环论证。(3) 因素分离:候选竞争(全库 vs 精确名组)、文档字段(标题 vs 标题+摘要)、排序函数(词法/稠密/LM)三维显式化,配对唯一名对照隔离目标自身差异。(4) 源链接地面真相:案例与总体统计互证,而非只给聚合数字。
核心方法
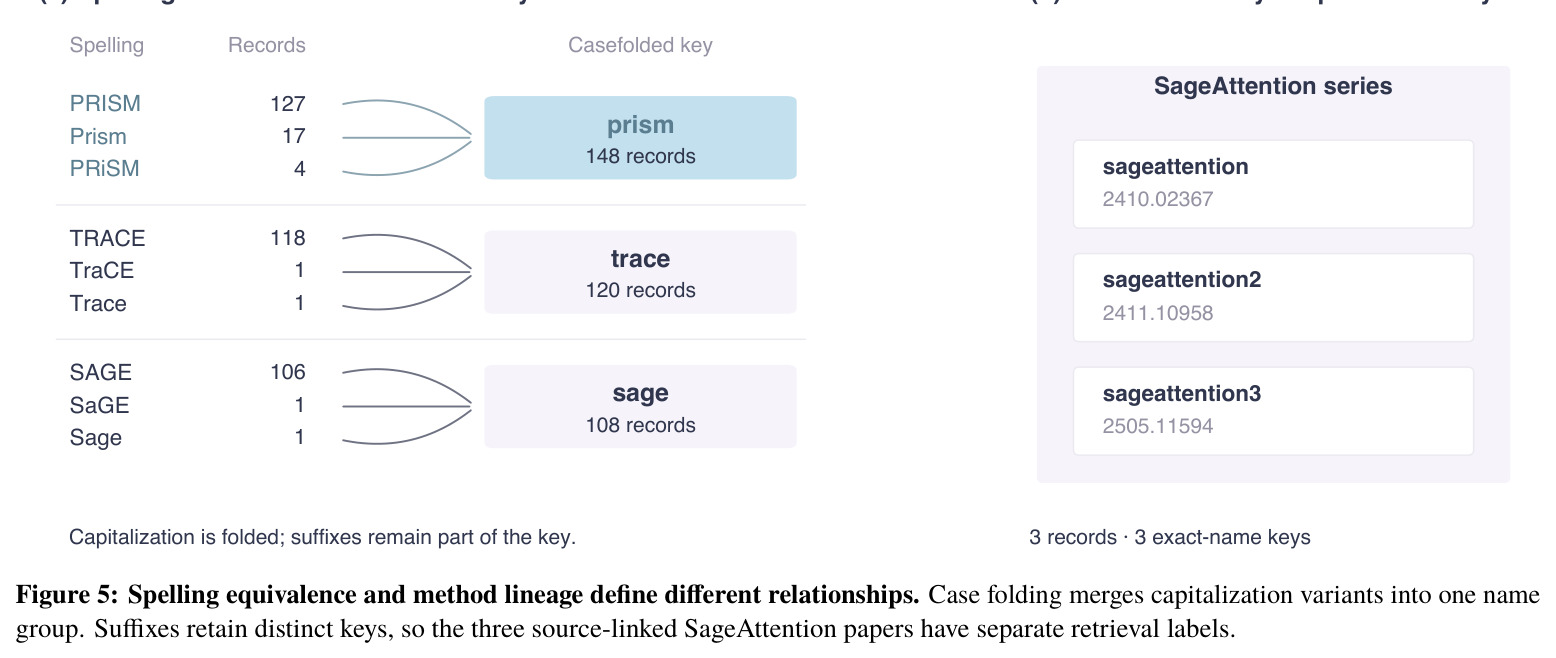
直觉:一个名字定义了一个候选集合,重名的代价应当在该集合内外分别测量。技术路线分四步。第一步构建版本感知语料:以 Cornell version-309 快照加官方更新为源,每条带 cs.AI/LG/CL/CV/IR/RO/MA 或 stat.ML 标签的 arXiv ID 入库一次并保留首版本标题与摘要,共 564,861 条主记录与 93,165 条 2015–2019 扩展。第二步测量:以“前导 token+冒号”规则提取标题标签,Unicode 规范化加大小写折叠定义比较键;按 Equation 1–3 计算碰撞率 $C_t$、平均同伴数 $B_t=(N_t-1)C_t$ 与跨主题/主题内条件速率(每 10 万合格对),参考期合并 2020–2022,用 2,000 次名字组重采样给 95% 区间。第三步词汇分解:用 wordfreq 3.1.1 的 $z=\log_{10}f+9$ 固定频段做加性贡献分解。第四步检索评测:1,400 同名目标加 1,400 匹配唯一名对照,三档查询、两类候选范围与四类排序器。
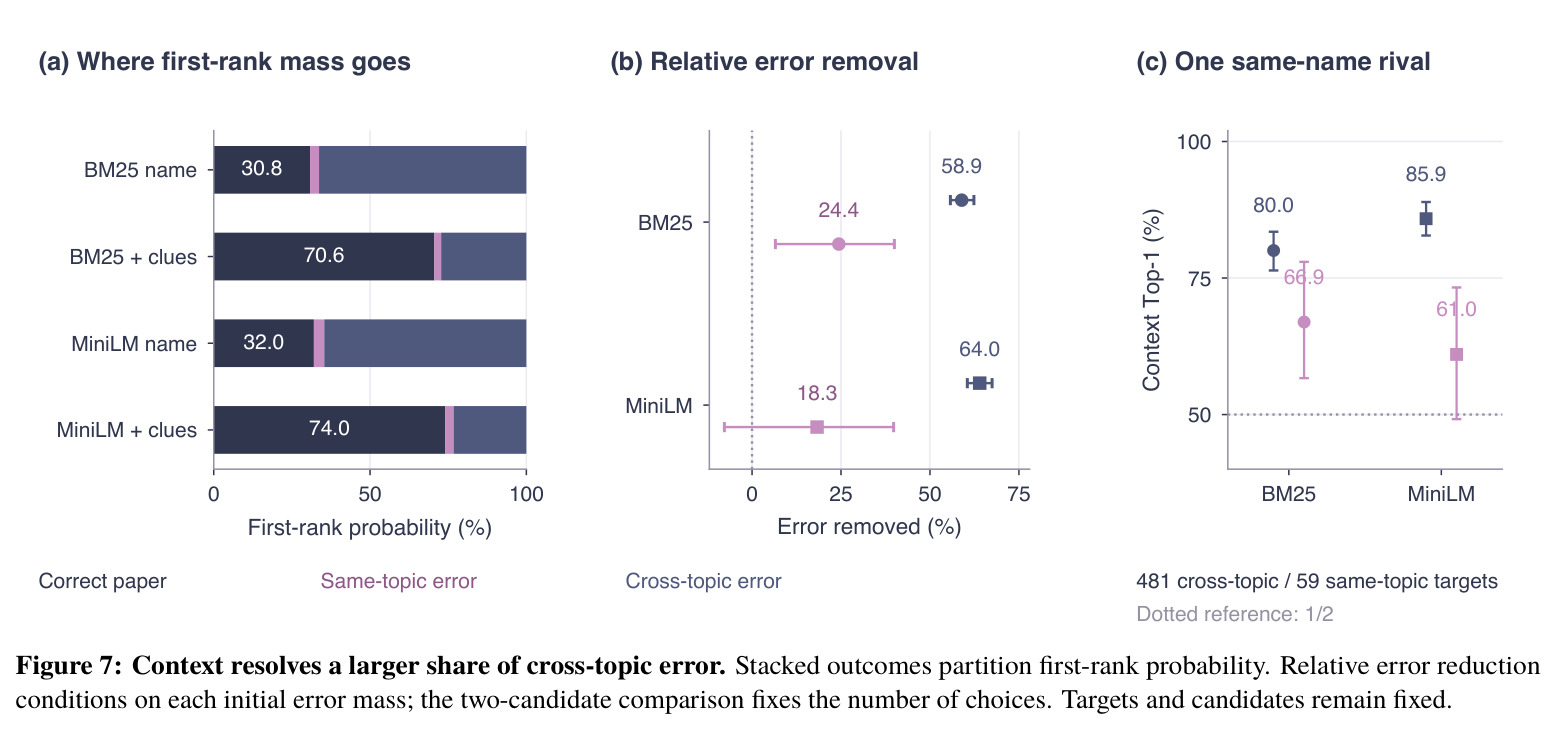
核心创新是把重名之害操作化为一个受控识别任务,并用三层设计排除混淆。(1) 固定候选:exact-name candidate retrieval 冻结每个查询的竞争集合(该名字的全部观测记录),把“在同名者中选择”与“在全库中发现”分离成两个可分别报告的任务。(2) 同规则线索:查询词由跨全库的 tf-idf 规则 $(1+\log \mathrm{tf})\log\frac{N+1}{\mathrm{df}+1}$ 自动选取 3 个至少 4 字符的字母词,剔除目标标签与冻结停用词,选词与候选组无关,同名与唯一名目标接受同等线索供给。(3) 配对对照:唯一名目标按年份、首类别、标题长度区间匹配,区间用完整名字组重采样保留组内相关性。在此之上定义相对错误消除率 $R_g=\frac{E_g(\text{name})-E_g(\text{name+context})}{E_g(\text{name})}$,把上下文收益按跨主题与主题内两类错误分解。与已有工作的本质区别:不是报道重名数量上升,而是量化同一规则线索在同名集合内的恢复量、残差缺口及其对手类型。
方法步骤详情
完整流程:(1) 语料入库:每条合格 arXiv ID 入库一次,保留首版本元数据。(2) 标签提取:匹配前导 token 加冒号,冻结停用词表剔除通用词,大小写折叠定义比较键、后缀保留在键内。(3) 碰撞统计:Equation 1 计算每 10 万合格对碰撞率 $C_t$,Equation 2 给平均同伴数 $B_t=(N_t-1)C_t$,Equation 3 计算跨主题条件速率(分子分母同剔同主题对);2,000 次名字组重采样给区间。(4) 稳健性:作者不相交过滤保留 4.40 倍,移除格式标签与前 20 高频名剩 1.91 倍,MPNet 重编码重聚类得 4.38 倍。(5) 词汇分解:各固定频段的条件碰撞率加对全库速率的加性贡献。(6) 检索评测:BM25($k_1=1.2$、$b=0.75$)、MiniLM、E5、DeepSeek-Flash listwise(温度 0、无效输出记零);Top-1/Top-10/MRR 用并列平均,缺失查询记零分。(7) 首名概率分解 $A+E_{\text{same}}+E_{\text{cross}}=1$ 并计算相对错误消除率。
技术新颖性
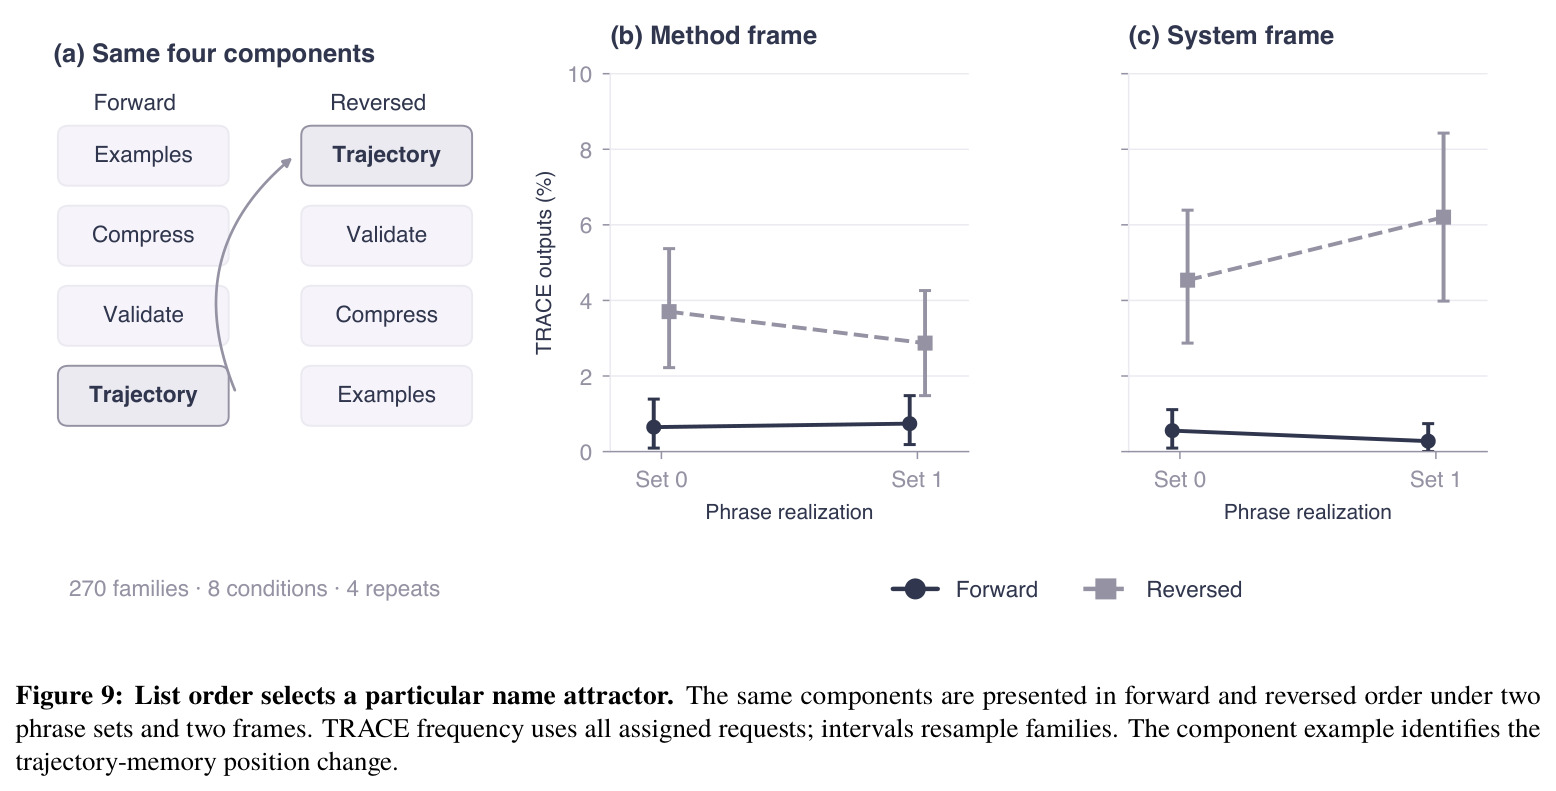
技术新颖性有五点。(1) 速率化与条件化:Equation 3 把跨主题碰撞率定义在不同主题对的合格集合上,主题规模变化同时进入分子分母而被抵消,这是文献计量学中少见的严谨处理。(2) 频段分解的可加性:由于匹配标签总是落在同一固定 Zipf 频段,各段对全库速率的贡献恰好可加,从而可以把 98.0% [92.7, 101.2] 的净增长归属到 Zipf [3,5) 段。(3) 评测设计的三维显式化:Table 1 的候选范围×索引字段×排序函数网格让\"找到论文\"与\"在同名者中选择\"成为两个分别测量的任务,而不是混在一个检索分数里。(4) 名字组配对 bootstrap:按组重采样并保留配对对照,独立重采样会丢弃同组目标共享候选群的依赖。(5) 源链接案例与受控实验:附录 B 用 8,640 请求的交叉设计(措辞集×列表顺序×描述框架)证明 LLM 命名存在列表顺序驱动的 TRACE 吸引子(21/864 到 185/864,Holm 调整后 $p=0.000060$),为命名趋同提供了一个模型侧成因,而不只是描述现象。
实验结果
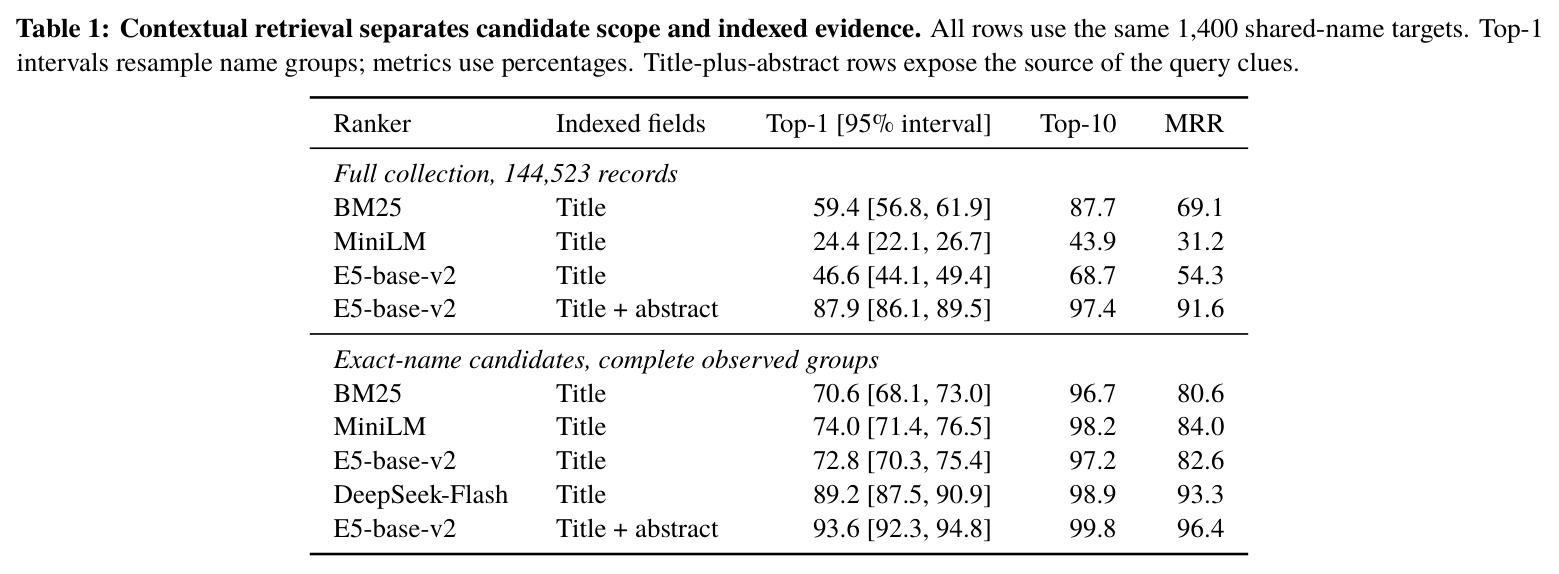
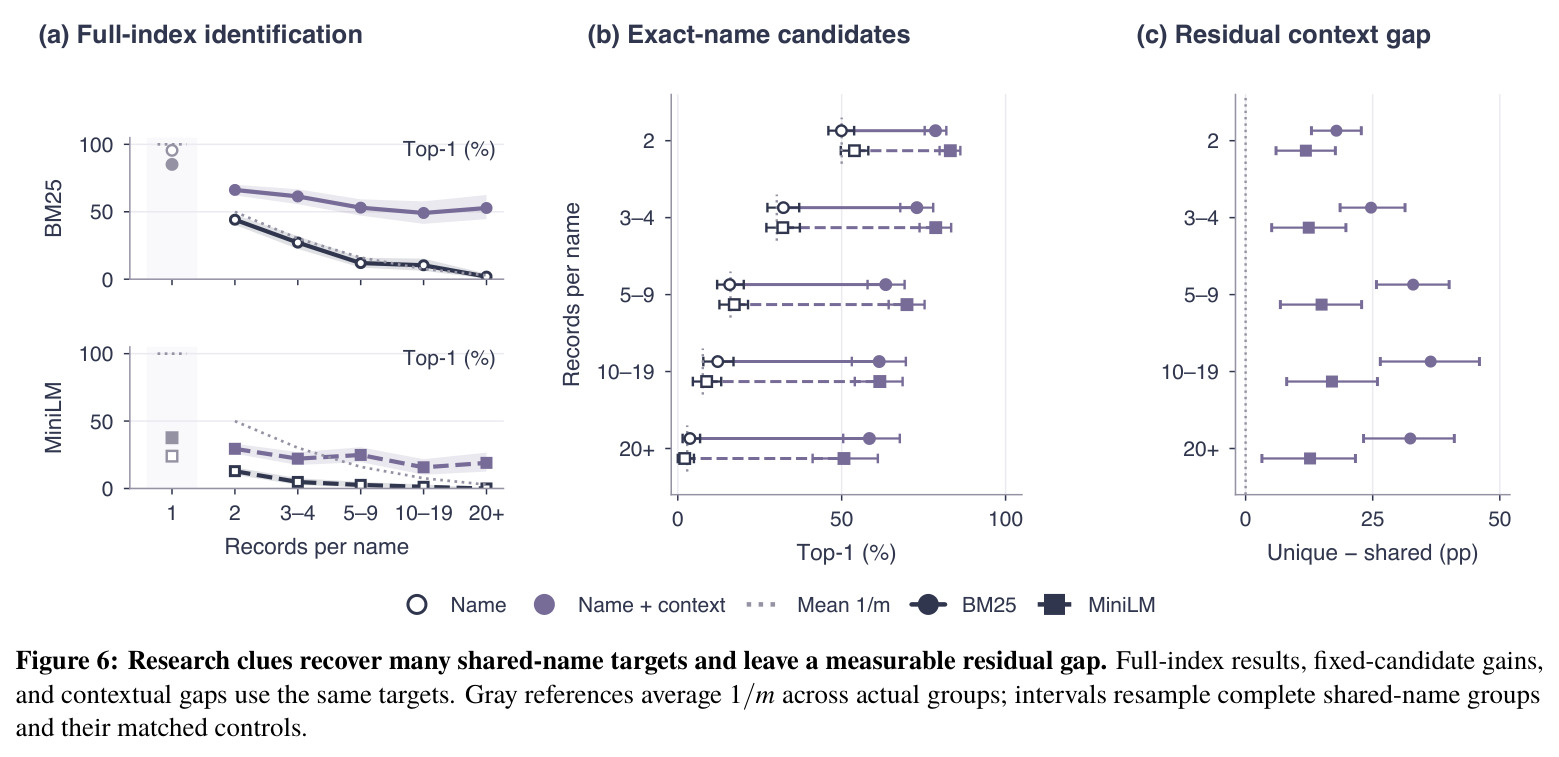
测量:2026 年碰撞率为参照的 4.52 倍 [2.59, 7.09];200 簇划分下跨主题 4.33 [2.62, 6.47] 对主题内 1.12 [0.81, 1.57],稳健性检验(作者过滤、去头部名、换编码器)后仍 1.91–4.38 倍。词汇分解:Zipf [3,5) 段占 12.4% 记录、89.4% 跨主题配对、98.0% 净增长。语义覆盖:PRISM/TRACE/SAGE 占 200 簇中的 92/73/81 簇;固定体量检验(差 [-0.21, 0.03])表明增长来自复用本就广覆盖的词。检索:全库 BM25 同名 59.4% 对唯一名 85.1%(差 25.7 pp);候选内加 3 词后 BM25 30.8%→70.6%、MiniLM 32.0%→74.0%;BM25 消除 58.9% 跨主题错误但仅 24.4% 同主题错误,两候选固定对比 80.0% 对 66.9%(稠密 85.9% 对 61.0%);AutoInit 案例标题排序器全选错;候选内最强 DeepSeek 89.2%、E5 题+摘 93.6%,残差缺口降至 6.9 pp。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨主题名字碰撞增长(2026 对 2020–2022 合并参照,200 簇划分,144,523 条记录) | 碰撞率增长倍数(每 10 万合格对) | 跨主题 4.33 [2.62, 6.47] | 主题内 1.12 [0.81, 1.57] | 跨主题增速约为主题内的 3.9 倍 |
| 全库标题检索:同名目标识别(1,400 同名目标) | Top-1 (%) | BM25 59.4 [56.8, 61.9] | 元数据匹配唯一名对照 BM25 85.1 | 识别赤字 25.7 pp [22.5, 28.7] |
| 精确名候选内排序:仅名字查询 | Top-1 (%) | BM25 30.8 / MiniLM 32.0 | 组内均匀选择(大组实测 2.9%,理论 $1/m$) | 加 3 词上下文后 BM25 +39.8 pp、MiniLM +42.0 pp |
| 精确名候选内排序:名字+上下文,标题-only 证据 | Top-1 (%) | DeepSeek-Flash listwise 89.2 [87.5, 90.9] | E5 72.8 / MiniLM 74.0 / BM25 70.6 | 较最强稠密基线 +15.2 pp,MRR 0.933 |
| 全库检索:标题+摘要字段,同名目标 | Top-1 (%) | E5-base-v2 87.9 [86.1, 89.5] | E5 标题-only 46.6 / BM25 59.4 | 残差缺口从 25.7 pp 降至 6.9 pp [4.8, 9.0] |
| 精确名候选内排序:标题+摘要字段 | Top-1 (%) | E5-base-v2 93.6 [92.3, 94.8] | DeepSeek 标题-only 89.2 | +4.4 pp,Top-10 99.8%,MRR 96.4 |
| 上下文对两类错误的消除(同名目标) | 相对错误消除率 $R_g$ (%) | 跨主题:BM25 58.9 [55.7, 62.4]、MiniLM 64.0 [60.5, 67.5] | 同主题:BM25 24.4 [6.6, 40.0]、MiniLM 18.3 [-7.8, 39.8] | 跨主题错误消除率高出 34.5 与 45.7 pp |
局限与改进
作者承认的局限:查询线索由固定 tf-idf 规则自动生成 3 词,只代表理想化的读者线索;评测限于标题与摘要字段;主题划分依赖无监督聚类(两编码器同主题对 Jaccard 仅 0.301、ARI 0.318);2026 群体截至 10 月 27 日不完整(截断后对 2022 比值 4.83 仍上升);附录 E 写作风格关联是探索性的(OR 0.87 [0.84, 0.91],加入词类后 0.96 跨 1),真实 LLM 使用不可观察。我的补充:(1) 小组分析功效有限——同主题两候选组仅 59 个目标,多个区间跨零(如 MiniLM 同主题消除 18.3% [-7.8, 39.8]);(2) tf-idf 词接近最优线索,可能高估真实用户可恢复的身份量;(3) LM 排序仅测 DeepSeek-Flash 一个模型,缺成本-延迟与策略比较;(4) 语料限于 8 个 AI 类别,外推未验证;(5) 增长倍数依赖参照期(对 2020 为 3.74、对 2022 为 4.81)。
独立分析的弱点
独立分析的弱点与改进方向。(1) 线索供给的现实性缺口:真实用户不会输入 tf-idf 最优词,可扩展到多种线索形式(任务描述、方法组件、数据集名、作者与年份)并测量多少字的线索够用。(2) 同主题消歧接近上限:AutoInit 案例显示名字与研究目标都共享时标题线索失效,DeepSeek 也只是恰好恢复;更根本的方案是在界面强制展示稳定标识符(arXiv ID/DOI)与谱系链接,而非依赖文本排序。(3) 主题划分噪声:两个编码器一致性不高,4.33 对 1.12 的对比可能受聚类分辨率影响,可用 arXiv 官方分类树做粗粒度交叉验证或人工标注子样本。(4) 干预建议未经实验验证:投稿系统的信息性碰撞提示、描述性后缀的有效性都只是建议,需要 A/B 测试或用户研究量化其对命名决策的影响。(5) 单点 LM 排序:89.2% 的成绩无法回答成本与稳健性问题,本文只记录了 2 个无效输出,失败模式分析不足。(6) 组大小分层功效:至少 20 条的大组样本很少,52.8% 这类数字区间较宽,宜扩充目标规模或做分层加权汇总。
未来方向
作者提出的方向:给作者的名字检查工具(提交接口显示现有精确名记录与研究上下文的信息性碰撞提示)、版本感知存储(记录名字何时引入及后继关系)、面向搜索系统暴露同名候选集并用研究上下文排序、最终保留可验证标识符;以及评估描述性后缀区分相关发布的效果。基于成果可延伸的研究:(1) 用预留的组级 dev/eval 划分训练专门的消歧检索器或重排器,把 6.9 pp 残差当作优化目标;(2) 时间建模:利用版本历史与名字首现时间预测未来碰撞热点词汇,为命名建议提供前瞻信号;(3) 跨领域扩展:检验生物医学(基因/药物缩写)与化学的重名是否同样集中于中频词汇带;(4) 多语言标题的碰撞与检索;(5) 系统化审计 LLM 命名行为:附录 B 的 TRACE 吸引子提示可做更大规模的命名先验研究,考察顺序、框架与词频如何驱动名称选择;(6) 因果检验 LLM 辅助写作与命名趋同:附录 E 的负关联(OR 0.87)需要更强的识别策略,如作者级固定效应或断点设计。
复现评估
复现条件非常好。配套 artifact 公开固定语料(144,523 条标题记录)、8,190 个复用名字的测量、候选组、冻结查询、主题错误标签与 60,200 条评分结果(36,400 原始基线加 23,800 扩展),发行包内置论文副本使链接解压后仍可用。关键组件全部版本锁定:Cornell version-309 快照、wordfreq 3.1.1、E5 与 MPNet 的具体 revision、KMeans/UMAP 种子与参数、BM25 $k_1=1.2$、$b=0.75$。LM 排序导出完整提示、种子排列、响应、用量与失败状态,1,400 请求成本仅 0.193195 美元。无需训练,算力为 CPU 级编码加 2,000 次 bootstrap;BM25 与 E5 独立入口可从导出语料重建全部排名。难点仅在名字组配对 bootstrap 的权重实现与并列处理容差(BM25 $10^{-10}$、MiniLM $10^{-6}$),总体属于下载即评级别,难度低。
论文图表
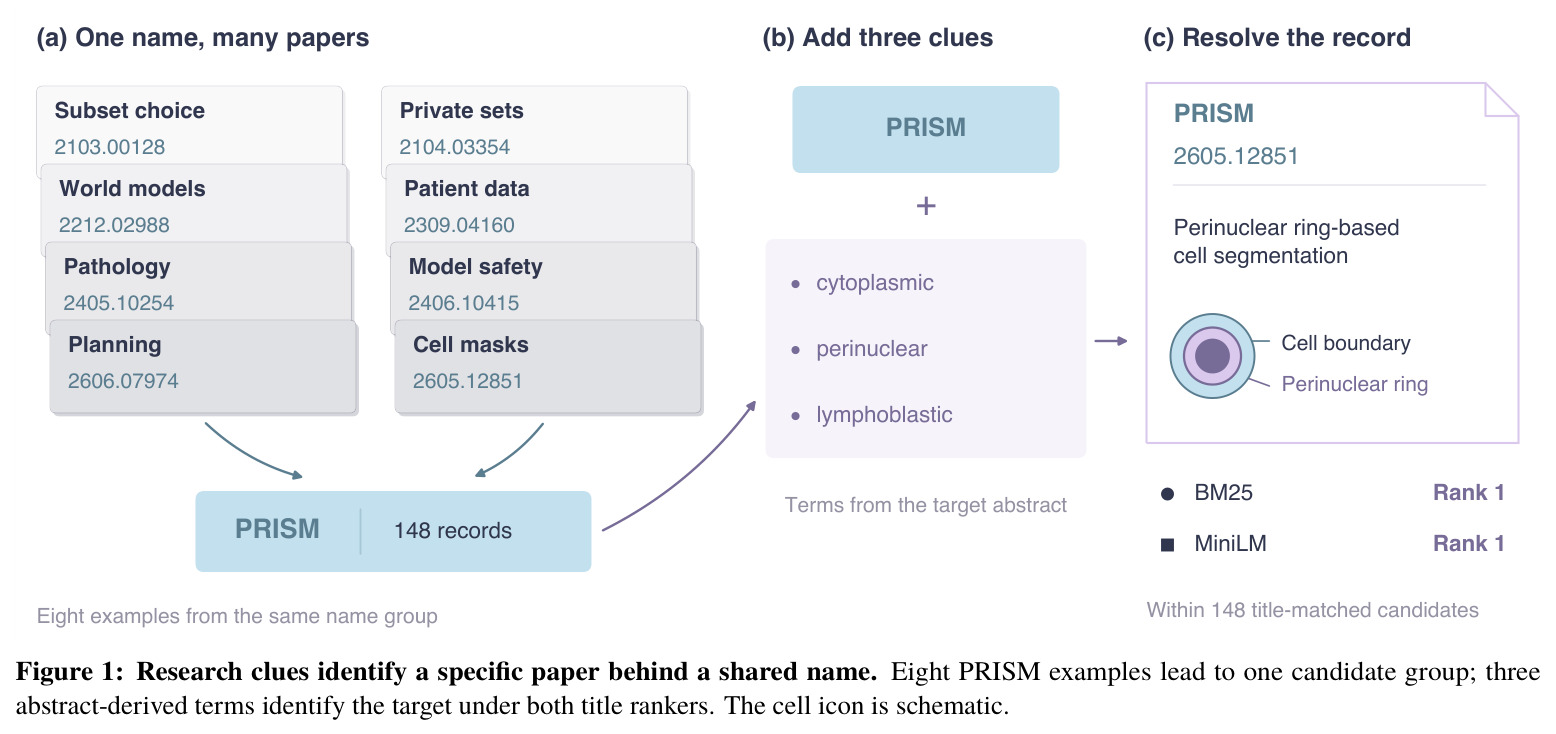
Teaser 图:左侧展示 PRISM 名字组的 8 个不同领域例子(子模选择 2103.00128、世界模型 2212.02988、病理 2405.10254、患者数据 2309.04160、模型安全 2406.10415、规划 2606.07974、细胞分割 2605.12851 等,共 148 条记录);右侧显示从目标摘要选出的 3 个词(cytoplasmic、perinuclear、lymphoblastic)使 BM25 与 MiniLM 都在 148 条候选内把目标细胞分割论文排到第一。
一图讲清论文研究的任务与现象:同一名字连接多个领域,而少量研究线索即可恢复具体论文,是全文的导引。