TurnTurk-GPT:面向土耳其语的文本话轮结束预测 TurnTurk-GPT: Text-Based Turn-Taking Prediction for Turkish
微调土耳其语GPT-2预测话轮结束,胜过多语言检测器,但优势依赖说话者熟悉度
前置知识
话轮转换
对话中说话权在双方之间交替的现象,话轮之间的间隙与重叠通常只有几百毫秒。早期系统用固定静音阈值判断话是否说完,容易对停顿者过早插话、对语速快的人反应迟钝;连续预测方法则在每一时刻估计未来的语音活动。
本文的任务定义与相关工作的脉络都建立在这个概念上,理解它才能明白为什么要做词级的文本端点预测。
TurnGPT 目标
在预训练 transformer 语言模型词表中加入话轮转移标记 $\langle\text{ts}\rangle$,用因果语言建模损失 $\mathcal{L}=-\sum_i \log p(x_i|x_{<i})$ 继续训练;自回归结构保证每个词处 $\langle\text{ts}\rangle$ 的概率只依赖前文,可随识别词流增量计算。
TurnTurk-GPT 的模型结构、序列化方式与打分公式(词得分取最后一个子词位置的 $P(\langle\text{ts}\rangle)$)完全沿用这一公式化。
平均精度 AP 与嵌套阈值
AP 是精确率-召回率曲线下的排序综合指标,衡量全部阈值范围内的整体质量,本文中随机预测仅 0.037。嵌套阈值指在每个测试折上,运行阈值取自其余折上选出的值,避免阈值调参泄漏到测试数据。
AP 是本文主指标,嵌套协议是其结论可信度的关键,正文所有结果表都围绕它们展开。
录音级配对聚类自助检验
以整段录音为重采样单元做 2,000 次自助抽样(每次抽 6 段录音并包含其全部决策点),统计量取 2.5 与 97.5 百分位作为置信区间;配对比较让两个系统在完全相同的重采样样本上对比。它刻画的是对话间方差而非单个决策点方差。
论文所有显著与不显著的判断都来自该方法,不理解它就无法把握显著性结论的适用边界。
黏着语与动词后置
黏着语通过在词根上串联后缀表达语法信息;土耳其语中时态、语气、疑问标记集中在子句末尾动词的后缀上,句子完成与否的线索因此浓缩在句末一个词的内部,与英语依赖语序和功能词的模式差别很大。
这直接解释了论文最核心的发现——话轮末线索藏在末词后缀里,词干化与分词器消融实验都由此设计。
零样本换行基线
不做任何微调,把话轮用换行符拼接成文本喂给预训练语言模型,读取每个词后的 $P(\text{newline})$ 作为话轮结束概率。直觉是预训练语料中换行更常出现在完整句之后,因此换行概率已隐式估计了句法与词法完成度。
它是本文最强的基线之一(AP 0.130,超过 LiveKit 检测器),也是作者建议所有土耳其语后续研究必须报告的对照。
研究动机
语音对话系统必须在几百毫秒的时间尺度上判断用户是否说完:回应太早会打断用户,太晚则造成不自然的停顿。传统方案依赖固定静音阈值,会对说话中途停顿的用户过早插话,对话轮间隙极短的用户反应迟钝。文本型预测器和评测基准几乎全部面向英语,多语言研究也只覆盖英语、汉语、日语,土耳其语几乎没有被认真研究。土耳其语是黏着语且动词后置,时态、语气、疑问等信息以后缀形式集中在句末动词上,话轮结束线索的分布可能与英语截然不同。被广泛部署的 LiveKit 多语言端点检测器虽在模型卡中列出土耳其语,但从未有工作在真实土耳其语对话上公开报告其表现;土耳其语开放语料也只包含朗读或单人录音,缺少带分声道音频与对齐转写的自发双人对话。
本文的目标是本文的目标是构建并严格评测第一个面向土耳其语的文本话轮转换预测模型 TurnTurk-GPT。具体包含三点:其一,在 124M 参数的单语土耳其语 GPT-2 骨干上,用 TurnGPT 目标在合成对话与真实对话的四种数据组合(S 仅合成、R 仅真实、SR 混合、S2R 合成预训练后真实微调)下训练模型,两个语料分别是 1,625 段对话、123,397 词的 Syn-TurnTurk 和 6 段双人视频通话、15,531 词的 Real-TurnTurk;其二,为土耳其语定义一套完整评测协议——词级决策点、平均精度(AP)、录音不相交与说话者不相交两种划分、嵌套阈值选择以及配对聚类自助显著性检验;其三,将微调模型与规则基线、零样本语言模型和已部署的多语言检测器在同一决策点集合上公平对比,并精确定位模型在哪些条件下真正胜出。
与已有工作不同的是,本文的独特切入角度有三。第一,它是首个在真实土耳其语对话上、以录音不相交和说话者不相交两种划分评测已部署多语言端点检测器的工作,填补了生产系统宣称支持某语言与实测表现之间的空白。第二,它把零样本语言模型提升为严肃基线:直接读取骨干模型的换行概率 $P(\text{newline})$,发现这种无需任何训练的读法(AP 0.130)就能超过多语言检测器(0.100),据此建议未来土耳其语研究必须报告该基线,否则可能把改进高估约两倍。第三,它不满足于整体 AP 排名,而是通过词干消融、分词器替换、停顿时刻子集评测和固定召回率下的运行点分析,逐一回答信号来自哪里(动词后置的后缀)、合成数据的真实价值是什么(校准而非 AP)、统计显著与实践收益为何错位。
核心方法
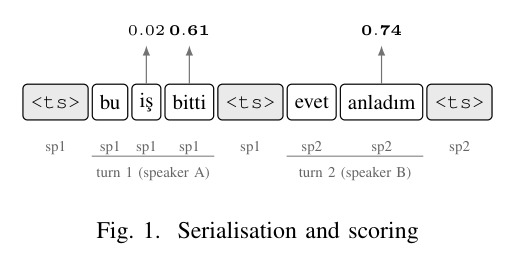
整体思路沿袭 TurnGPT:把用户是否说完转化为语言模型内部的 token 级预测。在 turkish-gpt2(124M 参数)词表中加入一个话轮转移标记 $\langle\text{ts}\rangle$ 和两个说话者标记,整段对话按话轮序列化,每个话轮以 $\langle\text{ts}\rangle$ 结尾且开头补一个 $\langle\text{ts}\rangle$,说话者身份通过 token_type_ids 提供。训练使用标准因果语言建模损失 $\mathcal{L}=-\sum_i \log p(x_i|x_{<i})$,因此每个位置的话轮结束概率只依赖前文,推理时可随识别词流增量计算。一个词的话轮结束得分为其最后一个子词位置上的 $P(\langle\text{ts}\rangle)$。输入统一为小写、去标点的词序列,以模拟流式语音识别在决策时刻的输出形态。训练配置共四种:S 仅合成数据、R 仅真实数据、SR 两阶段混合、S2R 先合成预训练再真实微调,每配置三个随机种子取平均。
核心创新不是模型结构——结构上它就是 TurnGPT 换了土耳其语骨干——而是公式化与语言特性的精确咬合。由于土耳其语动词后置,完成度信息集中在一个词内部的后缀上,因此取最后一个子词位置的 $P(\langle\text{ts}\rangle)$ 恰好能在词粒度捕捉该线索:词干消融证实删除话轮末词的后缀使 S2R 的 AP 从 0.148 跌至 0.083(降 44%),而删除句中随机词只降 2.2%。第二个关键设计是把已部署系统拉回同一协议:LiveKit 检测器按发布形态、用其自有框架与归一化(小写、去标点、输入当前话轮到被评分词为止)评测,保证对比公平。第三个设计是新增零样本换行概率读法作为下界基线,把任务微调的真实贡献从语言模型的固有知识中分离出来。
方法步骤详情
第一步数据准备:真实话轮由逐说话人声道的声音活动推导,同说话人连续段合并为持话轮、对方声道不切分;930 个话轮内停顿中 633 个可归因到具体词(中位时长 0.50 秒,297 个超过 0.5 秒),全程作为困难负例。第二步模型改造:向 124M 的 turkish-gpt2 词表添加 $\langle\text{ts}\rangle$ 与说话者标记,新增嵌入用现有嵌入均值初始化。第三步训练:AdamW、权重衰减 0.01、线性调度加 10% 预热、梯度裁剪 1.0、混合精度;窗口 256 token、一半重叠;开发集取每段训练对话最后 12% 窗口并丢弃相邻窗口防泄漏,每 20 步(含合成的阶段 50 步)查验证损失、patience 5,合成阶段另留 5% 对话早停。第四步评测:15,522 个词全部作决策点(578 个正例),AP 为主指标;录音不相交用留一录音法,说话者不相交则训练集缩至两三段录音;阈值在其余折上嵌套选择;2,000 次自助重采样按录音整簇抽取,区间取 2.5/97.5 百分位,配对比较用相同样本。评测时每位置只打分一次,至少给 32 token 左上下文。
技术新颖性
技术新颖性集中在评测方法学与语言特异性分析,而非模型结构本身。具体包括:(1)为低资源对话任务建立录音级聚类自助加嵌套阈值的显著性协议,并证明统计显著与实践收益可以错位——S2R 对零样本基线 +0.019 AP 显著,但在 70% 召回率下两者假警报几乎相同(每命中 9.6 对 9.3 次);(2)提出并论证零样本换行基线:土耳其语预训练语料中换行与完整句高度相关,使未微调模型就有 0.130 AP,超过部署的多语言检测器,作者据此建议所有后续研究必须报告该基线;(3)用受控消融链定位信号来源:话轮末词词干化(AP 降 32%–44%)、换用英语 GPT-2 分词器(土耳其语被切成 2.94 token/词,R 的 AP 从 0.116 崩到 0.042)、停顿子集评测(纯文本接近随机 0.477),每个结论都附带量化证据而非定性猜测。
实验结果
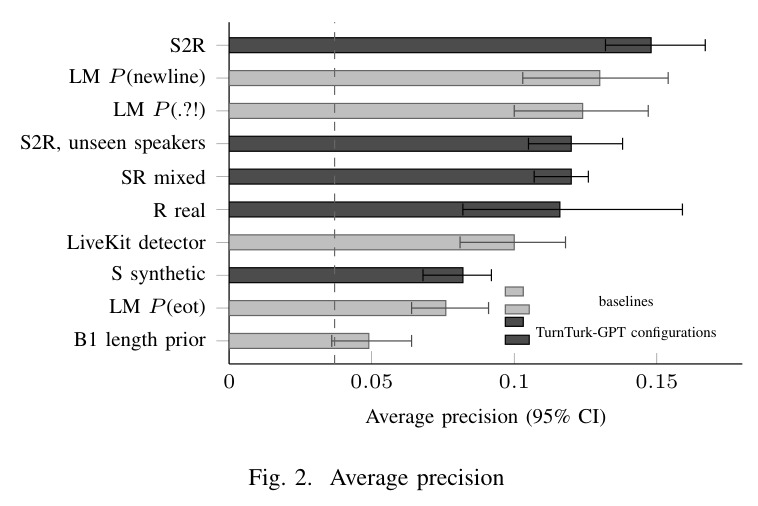
主实验(录音不相交,AP):随机基线 0.037,LiveKit 0.100,零样本换行读法 0.130,S2R 最好(0.148,F1 0.219),S 最弱(0.082)。配对检验:S2R 比 LiveKit 高 +0.048(显著)、比零样本高 +0.019(显著)。说话者不相交时 S2R 降至 0.120:对 LiveKit 仍 +0.020(显著),对零样本 −0.010(不显著),学到的是部分说话者特异信息。固定召回分析:70% 召回下 S2R 精度 0.095、每命中 9.6 次假警报,与零样本(0.097、9.3)几乎持平,均优于 LiveKit(0.059、16.0);LiveKit 在推荐阈值 0.0045 下停顿词假警报率 85.5%。停顿子集上零样本 AP 0.590、LiveKit 0.530,随机即 0.477,纯文本几乎无法区分说完与停顿。合成数据单独训练最弱且停顿假警报 33.5%,主要价值是把 70% 召回阈值从 R 的 0.00000 提到 0.016。消融:英语分词器使 R 的 AP 从 0.116 降到 0.042,词干化确认线索在末词后缀。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 真实对话话轮末预测(录音不相交划分) | 平均精度 AP | 0.148(S2R,95% CI [0.132,0.167]) | LiveKit 多语言检测器 0.100;零样本换行基线 0.130 | 对 LiveKit +0.048、对零样本 +0.019,配对聚类自助检验均显著 |
| 真实对话话轮末预测(说话者不相交划分) | 平均精度 AP | 0.120(S2R) | LiveKit 0.100;零样本换行基线(约 0.130) | 对 LiveKit +0.020 显著;对零样本 −0.010 不显著 |
| 部署级运行点(70% 召回率) | 每正确检测的假警报数 | 9.6 次(精度 0.095,S2R) | LiveKit 16.0 次(精度 0.059);零样本 9.3 次(精度 0.097) | 较 LiveKit 约少 6 次假警报;与零样本持平 |
| 停顿时刻二分类(578 个真轮末 vs 633 个话轮内停顿) | 平均精度 AP | 纯文本系统接近随机水平 | 随机预测 AP 0.477 | 无实质提升:LM P(newline) 0.590、LiveKit 0.530 |
| 阈值校准(部署可用性) | 达到 70% 召回所需的阈值 | 0.016(S2R) | 仅真实数据 R 为 0.00000(低于数值精度,无法设固定阈值) | 合成预训练的主要收益是校准而非 AP |
局限与改进
作者明确承认并经我补充的局限:其一,真实语料只有 6 段对话、6 个说话人,说话者不相交划分下训练集只剩两三段录音,模型学到的主要是说话者熟悉度而非通用话轮规律——对零样本基线的优势在该划分上完全消失(−0.010,不显著);其二,评测在最终转写文本上离线完成,未覆盖流式识别的部分假设、识别错误与端到端延迟;其三,正例标签来自声音活动的话轮移交点,与适合回应的位置并不等同——有些话轮末不需要回应,有些话轮内停顿其实是在等附和;其四,绝对精度很低(70% 召回时约 0.095,90% 召回时 0.059),每正确检测伴随约 10–16 次假警报,作者自己也判断文本预测只适合辅助而非替代静音端点检测;其五,F1 最高仅 0.219,正例占比 3.7% 的极端不平衡使所有阈值都偏向高假警报。
独立分析的弱点
独立分析可见的弱点:第一,数据规模是根本瓶颈,6 段对话无法支撑说话者泛化,改进方向是按同一协议开源采集更多说话人的双人对话,或探索从其他语言的话轮语料做跨语种迁移。第二,合成语料的生成方式与任务错配:每个合成话轮都是短而完整的规范句(平均 8.7 词,真实为 26.9 词),缺少真实对话中的句中停顿、自我修复与被打断后续接,导致 S 单独训练只有 0.082 AP 且停顿假警报 33.5%;改进方向是让生成器显式产出带停顿续接的长话轮、跨话轮的句子与不完整句。第三,AP 优势集中在低召回高置信区间:90% 召回点上零样本模型反而略好(精度 0.062 对 0.059),微调的排序头部收益可能被单一 AP 高估,应强制报告匹配召回下的运行点。第四,判定只用单点 $P(\langle\text{ts}\rangle)$ 阈值,未融合韵律与视觉线索,而语料本身具备分声道音频与人脸特征,多模态融合是被明确搁置却唾手可得的改进。第五,未测流式转写,识别噪声对得分的影响完全未知。
未来方向
作者提出的方向有三:扩大说话人规模并继续用说话者不相交划分度量泛化,同时填补土耳其语开放对话语料的空白;改造合成数据生成器,使其复现真实对话的停顿、修复与续接,让合成语料不止于校准价值;利用 Real-TurnTurk 的分声道音频与人脸特征加入韵律与视觉线索,专门攻克停顿歧义。基于本文成果可延伸的方向:把零样本换行基线推广为低资源语言的默认评测项,检验换行约等于完整句的假设在其他黏着语(日语、芬兰语、匈牙利语)是否同样成立;在流式识别的部分假设与延迟约束下重评全部系统;用 VAP 类声学模型与文本模型互补融合,因为停顿实验已证明纯文本存在 0.477 随机线附近的上限;此外可研究 token 级打分与语义完整性模型的组合,以及在部署中用韵律停顿检测先过滤决策点、再由文本模型打分的级联方案。
复现评估
复现条件良好。模型与两个数据集均在 Hugging Face 公开:模型 tugrulbayrak/TurnTurk-Gpt,数据集 Syn-TurnTurk 与 Real-TurnTurk;论文完整给出协议细节(词级决策点定义、嵌套阈值、2,000 次录音级聚类自助、2.5/97.5 百分位区间)与全部训练超参(AdamW、权重衰减 0.01、10% 预热、梯度裁剪 1.0、混合精度、256 token 半重叠窗口、早停 patience 5、嵌入均值初始化)。骨干仅 124M 参数,单张消费级 GPU 即可完成四种配置各三个种子的训练;LiveKit 检测器按发布形态用其自有推理代码评测,依赖明确。主要门槛是 Real-TurnTurk 仅 6 段录音:复现者能对齐论文数字,但很难在此基础上得出统计上更强的新结论,除非自行采集更多对话;此外早停与阈值协议较繁琐,实现细节稍有出入就会影响嵌套阈值的结果。
论文图表
对比两个语料的规模与结构:Syn-TurnTurk 有 1,625 段对话、14,185 个话轮、123,397 词、平均每话轮 8.7 词;Real-TurnTurk 有 6 段录音、578 个话轮、15,531 词、平均每话轮 26.9 词。
说明两个语料描述的是不同现象——合成话轮短而完整,真实话轮长且含句中停顿与附和——这为后续合成数据只提供弱训练信号、主要改善校准的结论埋下伏笔。
录音不相交划分下全部系统的 AP、95% CI、AUC、F1 与停顿假警报率 PP:S2R 以 AP 0.148、F1 0.219 居首但 PP 为 13.1%;零样本换行读法 AP 0.130;LiveKit 0.100;仅合成数据的 S 是唯一 PP 高达 33.5% 的系统;随机基线 AP 0.037、长度先验 0.049。
论文主表,几乎所有定量结论都引用它;AP 与 PP 并排呈现正是为了展示排名优势与停顿假警报之间的错位。
配对聚类自助比较的差值与显著性:录音不相交下 S2R−LiveKit +0.048、S2R−LM newline +0.019、LiveKit−LM newline −0.029 均显著;说话者不相交下 S2R−LiveKit +0.020 显著而 S2R−LM newline −0.010 不显著,划分间差 −0.028 显著;训练配置中仅 S2R−SR(+0.028)显著,S2R−R(+0.032)与 SR−R(+0.004)不显著。
论文唯一的统计检验汇总表:说话者特异学习、合成数据仅改善校准、统计显著不等于实践收益这三个核心论断全部由它支撑。
阈值分别设为达到 70% 与 90% 召回时的精度、每正确检测假警报数与停顿假警报率:70% 召回下 S2R 为 0.095/9.6/51.7%,说话者不相交 S2R 为 0.081/11.3/57.2%,零样本换行 0.097/9.3/50.9%,LiveKit 仅 0.059/16.0/65.4%;90% 召回下所有系统的假警报进一步恶化到每命中 15–22 次。
揭示部署关心的召回水平上微调模型与零样本模型几乎等价、与 LiveKit 的差距才是实质收益,纠正了只看 AP 对微调贡献的高估。
仅在最易误判的停顿时刻(578 个真话轮末对 633 个话轮内停顿,随机预测 AP 0.477)评测:LM P(newline) 达 AP 0.590、AUC 0.630,LiveKit 检测器仅 AP 0.530、AUC 0.537。
证明当说话者停顿时纯文本信息接近随机水平,是文本预测只能辅助而非替代静音端点检测这一结论的直接证据。
词干消融结果:把话轮末词截断到前 4 个字符(去除后缀)使 R 的 AP 从 0.116 降至 0.079(−32%)、S2R 从 0.148 降至 0.083(−44%);而截断句中一个随机词几乎无影响(R +0%、S2R −2%)。
定位话轮末信号来源的核心证据:线索集中在末词(通常为动词)的后缀中,把土耳其语动词后置的语言学特性与模型行为直接联系起来。