DAMI:面向门控线性注意力长上下文检索的双轴记忆初始化 DAMI: Dual-Axis Memory Initialization for Enhanced Long-Context Retrieval in Gated Linear Attention
双轴联合初始化门控记忆参数,使五种线性循环架构的长上下文检索平均提升5.3–16.7个百分点
前置知识
线性注意力与门控递归(Linear Attention / Gated Recurrence)
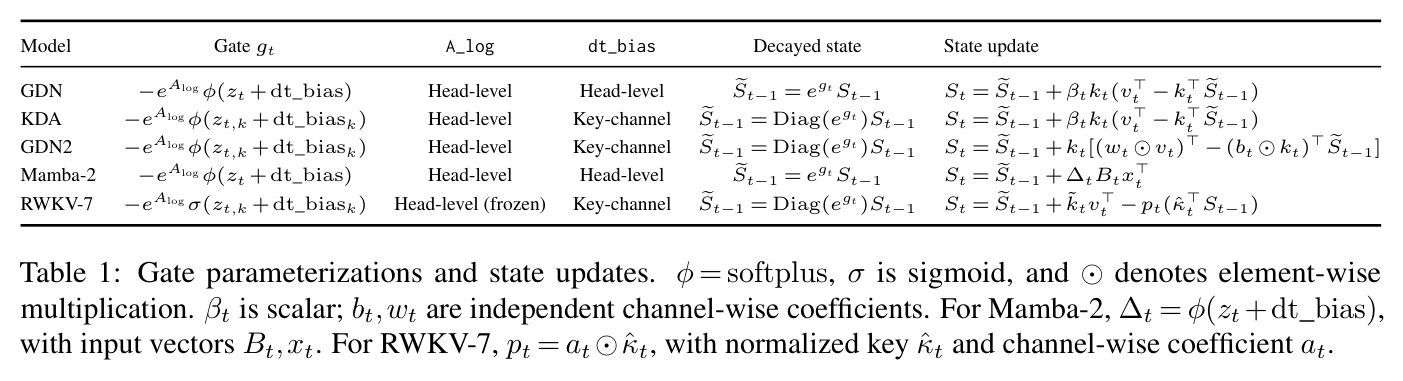
线性注意力用固定大小的递归状态 $S_t\in\mathbb{R}^{d_k\times d_v}$ 压缩全部历史,避免 softmax 注意力的二次开销与线性增长的 KV 缓存。Gated DeltaNet(GDN)等门控变体先衰减再写入:$\tilde{S}_{t-1}=\exp(g_t)S_{t-1}$,$S_t=\tilde{S}_{t-1}+\beta_t k_t(v_t^\top-k_t^\top\tilde{S}_{t-1})$,衰减门 $g_t$ 由可学习参数 $A_{\log}$、$dt\_bias$ 与输入激活共同决定。
本文的全部操作对象就是这些门控递归中的记忆参数,理解状态更新与衰减门的地位是读懂动机和方法的前提。
记忆时间尺度(Timescale / e-folding time)
保留因子 $D_{\ell,h}(s)$ 度量 $s$ 个 token 后初始贡献的剩余比例;当单步衰减近似恒定时 $D(s)\approx\exp(-s/\tau)$,$\tau$ 即 e-folding 时间——经过 $\tau$ 个 token 后约剩 $1/e$。$\tau$ 大代表长记忆、$\tau$ 小代表短记忆;指数混合 $K(s)=\sum_h c_h e^{-s/\tau_h}$ 可逼近文本依赖的幂律衰减 $s^{-\beta}$。
DAMI 的第一个轴就是给每个头分配几何分布的目标时间尺度,这个概念直接定义了方法要匹配的行为量。
RULER / NIAH 长上下文检索评测
大海捞针(Needle-in-a-Haystack)评测把关键信息埋入长干扰文本中再就其提问,检验模型能否把正确证据与查询关联。RULER 是其标准化套件,含单键 NIAH-1/2 与多键 MK-NIAH 变体,按 1K–8K 上下文长度评分。本文使用固定 500 预生成样本/设置的 RULER 风格子集,指标为答案包含准确率(answer-containment accuracy)。
论文的主要实验指标与'近期对偏好'(recent-pair bias)现象都建立在这类评测上,理解其构成才能正确解读数值。
LSUV 数据驱动初始化
LSUV(Layer-Sequential Unit-Variance)是一种数据驱动初始化:逐层用一小批真实样本做无梯度前向传播,依据激活统计量(如方差)直接调整该层参数。DAMI 借用其'逐层前向+经验统计匹配'的框架,但匹配目标从单位方差换成记忆行为目标(输入敏感度与时间尺度)。
DAMI 的校准流程是 LSUV 思想向记忆行为的迁移,理解 LSUV 才能明白为什么校准要从实际激活出发而不是纯解析设定。
Softplus/Sigmoid 的输入敏感度
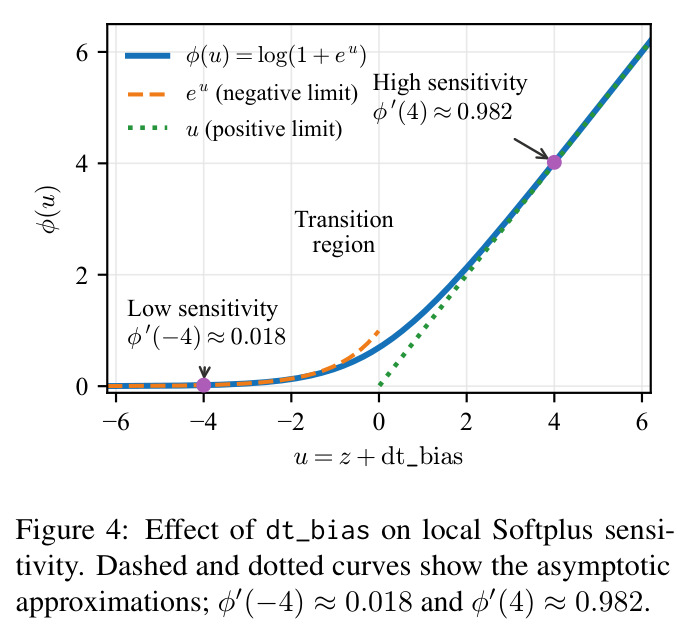
GDN 门为 $g_t=-\exp(A_{\log})\,\phi(z+dt\_bias)$,$\phi=\mathrm{softplus}$,其导数是 sigmoid $\sigma$。$dt\_bias$ 平移工作点:负区域斜率趋 0($\phi'(-4)\approx0.018$,门几乎不响应输入),正区域趋 1($\phi'(4)\approx0.982$)。均值敏感度定义为 $S=\mathbb{E}_z[\sigma(z+dt\_bias)]$,它同时决定输入响应强度与平均衰减速度。
敏感度轴的数学基础:$dt\_bias$ 一人分饰两角(敏感度+平均衰减),这正是两个参数必须联合校准的根源。
研究动机
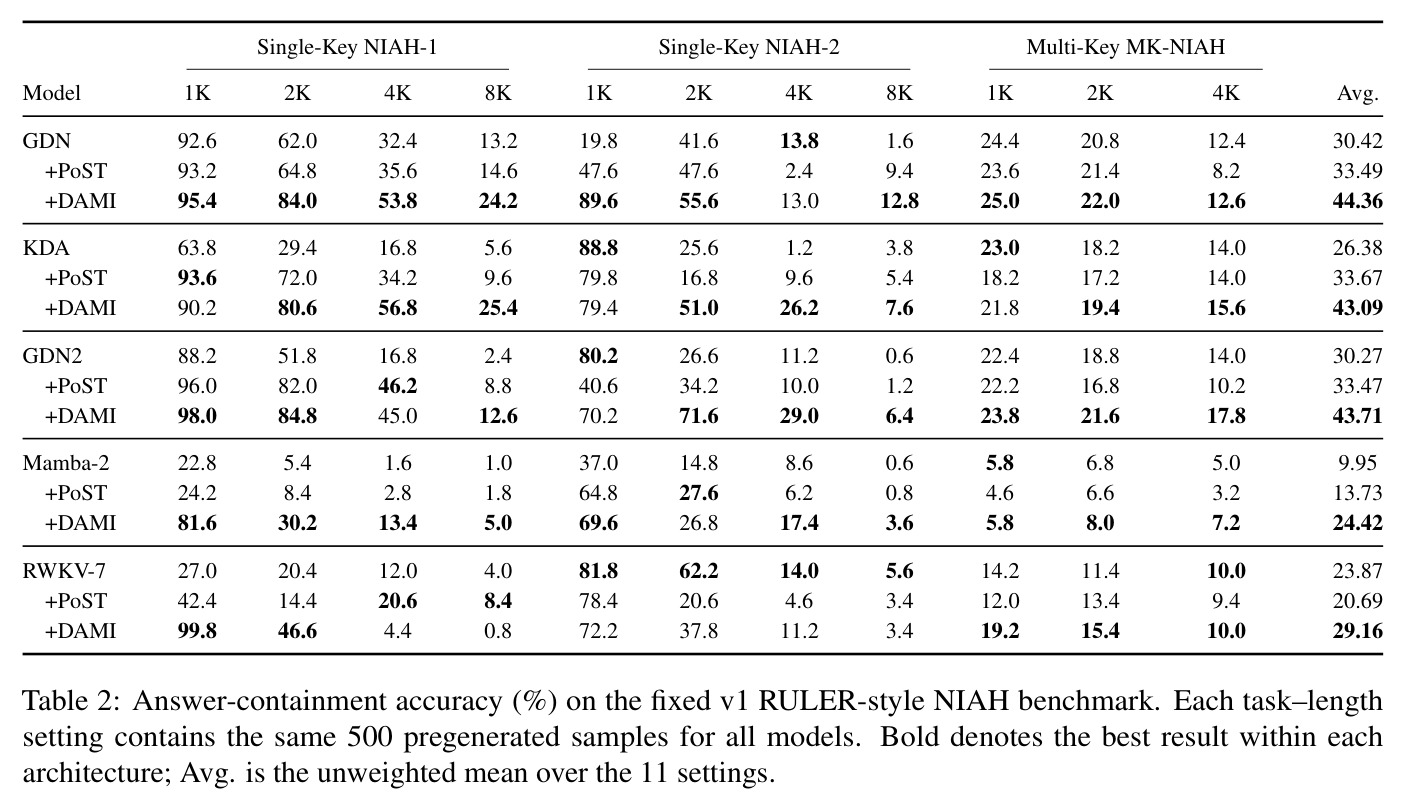
线性注意力和门控递归把历史压缩进固定大小的状态,长上下文检索天然受有限记忆容量制约。在 GDN 这类门控递归中,记忆保留由衰减门 $g_{t,\ell,h}=-\exp(A_{\log,\ell,h})\cdot\mathrm{softplus}(z_{t,\ell,h}+dt\_bias_{\ell,h})$ 决定,而原生初始化非常粗糙:$\exp(A_{\log})$ 在 $[0,16)$ 均匀采样后取对数,$dt\_bias$ 从 $[10^{-3},10^{-1}]$ 对数均匀采样并经逆 Softplus 变换,所有层共用同一规则、完全不看输入统计。后果是显著的“近期对偏好”:模型只记得最近的证据-查询对,远处信息被冲掉。在约 100M 参数、5B token 训练的模型上,Random 初始化的 RULER 风格 NIAH 平均准确率仅为 GDN 30.42%、KDA 26.38%、GDN2 30.27%、Mamba-2 9.95%、RWKV-7 23.87%,且 8K 上下文时 NIAH-1 几乎失效(GDN 13.2%、GDN2 2.4%、Mamba-2 1.0%)。
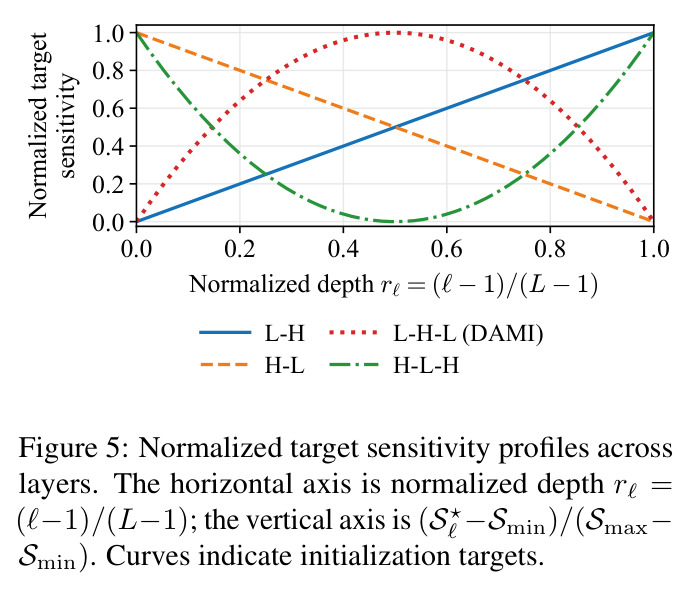
本文的目标是本文的目标是在训练开始之前、不增加任何可训练参数、不改动状态更新算子的前提下,通过结构化初始化直接改善门控线性模型的记忆行为。具体包括三点:(1) 为每个头设定几何分布的目标时间尺度 $\tau_h$,覆盖 1 到 4096 token 的检索距离,让不同头分工负责远近不同的记忆,扩大整体覆盖范围;(2) 为每层设定输入敏感度目标,采用低-高-低剖面(GDN 族端点约 0.25、中层峰值约 0.748),兼顾早期层的稳定、中间层的内容自适应与后期层的长期保留;(3) 从真实激活出发联合校准 $A_{\log}$ 与 $dt\_bias$ 两个参数,使上述行为目标真正落地,并在 GDN、KDA、GDN2、Mamba-2、RWKV-7 五种架构上验证其通用性。
与已有工作不同的是,已有工作要么改算子(Delta 规则、KDA、GDN2 等),要么训练后处理扩展感受野(DeciMamba、LongMamba 的过滤/训练-free 放大),要么只做单一维度的谱初始化(PoST 的几何衰减谱加位置自适应缩放;Chrono/LRU 只针对时间尺度且不看输入数据)。本文的关键洞察是一条被忽视的经验观察:训练之后 GDN 的记忆参数与初始值高度相关(Pearson 相关:Random 下 $A_{\log}$ 0.926、$dt\_bias$ 0.939;PoST 0.989/0.949;DAMI 0.985/0.871),说明初始化的结构会“穿过训练”保留下来。既然如此,与其改算子或改训练流程,不如把初始化本身当作协调记忆行为的设计入口;而且衰减同时依赖 $A_{\log}$、$dt\_bias$ 与激活三者,必须联合校准,这正是 PoST 等只管衰减谱的方法留下的空白。
核心方法
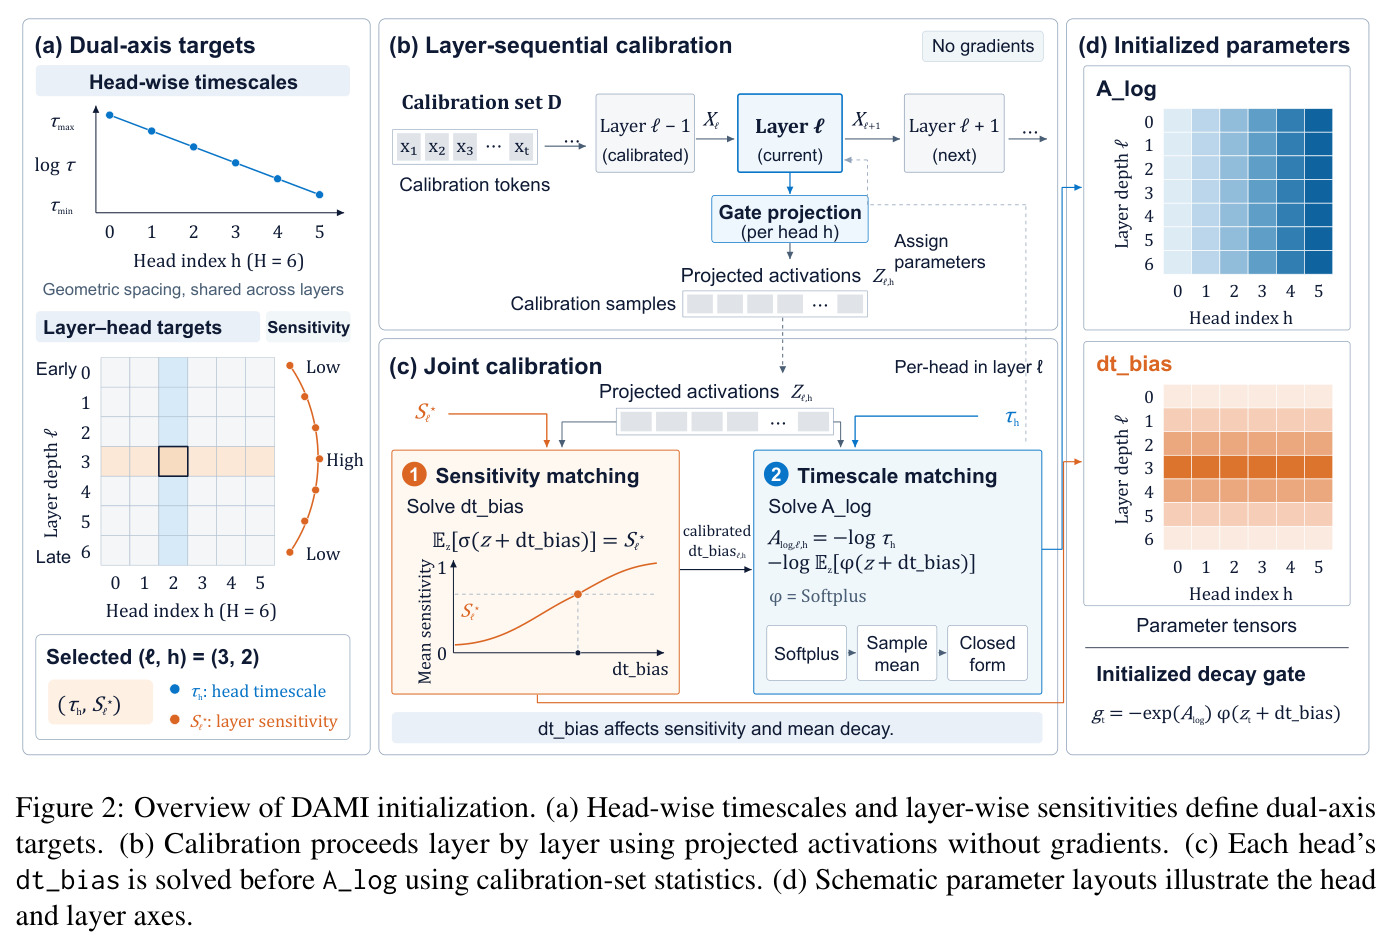
DAMI 的直觉是:检索距离千差万别,单一时间尺度的记忆必然顾此失彼;而多头输出经输出投影拼接的结构 $K_\ell(s)=\sum_{h}c_{\ell,h}e^{-s/\tau_{\ell,h}}$ 恰好是指数混合的对应物,可以逼近文本依赖的幂律衰减 $s^{-\beta}\approx\sum_h w_h e^{-\lambda_h s}$。技术路线是“双轴目标+数据驱动校准”:横轴(头)按几何间隔分配时间尺度,$\lambda_h=\lambda_{\min}(\lambda_{\max}/\lambda_{\min})^{h/(H-1)}$、$\tau_h=\lambda_h^{-1}$,6 头覆盖 1–4096 token(目标 $\{4096, 776.05, 147.03, 27.86, 5.28, 1\}$),所有层共享;纵轴(层)设定低-高-低敏感度目标 $S_\ell^\star$,同层各头共享。随后按 LSUV 方式用小校准集逐层前向(无梯度),逐头解出 $dt\_bias$ 与 $A_{\log}$,再用校准后的输出喂给下一层。
核心创新是识别衰减门中两个参数的耦合性并给出联合解。在 $g_t=-\exp(A_{\log})\phi(z+dt\_bias)$ 中,$dt\_bias$ 一箭双雕:$\phi$ 的均值决定平均衰减速度,$\phi$ 的导数 $\sigma$ 决定输入敏感度,因此两个参数不能独立设定。DAMI 把问题解耦成两步求解:先用二分法解 $dt\_bias$ 使 $\mathbb{E}_z[\sigma(z+dt\_bias)]=S_\ell^\star$(只负责敏感度目标),再令 $A_{\log,\ell,h}=-\log\tau_h-\log\,\mathbb{E}_{z\sim Z_{\ell,h}}[\phi(z+dt\_bias_{\ell,h})]$,其中第二项补偿 bias 对平均衰减的影响,把有效 e-folding 时间精确钉在目标 $\tau_h$ 上。与 PoST、Chrono/LRU 等只管衰减谱、不看输入数据的方法的本质区别在于:DAMI 的目标是从真实激活校准的,且同时约束“记多久”与“对输入多敏感”两个行为维度。
方法步骤详情
完整流程:(1) 定目标:6 头几何时间尺度 $\{4096, 776.05, 147.03, 27.86, 5.28, 1\}$ token,18 层低-高-低敏感度剖面(端点 0.25、峰值 0.748);(2) 逐层校准:将校准 token 依次前向通过已初始化的第 $1\ldots\ell-1$ 层,在第 $\ell$ 层收集门投影激活 $Z_{\ell,h}$(全程无梯度);(3) 解 $dt\_bias$:对每头二分求解 $\frac{1}{|Z_{\ell,h}|}\sum_z\sigma(z+dt\_bias_{\ell,h})=S_\ell^\star$,单调性保证二分收敛;(4) 解 $A_{\log}$:按 $A_{\log,\ell,h}=-\log\tau_h-\log\,\mathbb{E}_z[\phi(z+dt\_bias_{\ell,h})]$ 计算,使有效时间尺度等于 $\tau_h$;(5) 校准后的输出继续喂给 $\ell+1$ 层,输出投影保持原生初始化。架构适配:KDA/GDN2 保留 key 通道 $dt\_bias$,用标准差 0.03 的中心化扰动对齐头内均值;Mamba-2 把层乘子重采样到 42 层并归一化几何均值;RWKV-7 用 160 个冻结头-层缩放值,安排 0.25-0.75-0.25 均值 sigmoid 响应剖面与 8 头 4096→1 几何阶梯。
技术新颖性
新颖性体现在四个层面。一是首次在 GDN 上系统实证“初始化-训练后参数持久性”(三种初始化下相关性 0.871–0.989),为“初始化即设计”提供动机证据;二是把初始化的目标从传统的“设定方差/数值范围”升级为“设定记忆行为目标并用真实激活联合求解”,这是 LSUV 思想向记忆行为的迁移,但匹配对象不是激活方差而是指数衰减包络与 Softplus 敏感度;三是双轴正交设计——时间尺度轴解决“记多久”(对应证据-查询距离覆盖),敏感度轴解决“多容易响应新输入”(对应深度依赖的写入/更新行为),两轴在概念上解耦、却在 Softplus 耦合的参数上联合实现;四是架构无关性:同一框架仅靠少量架构特定适配就覆盖 GDN/KDA/GDN2/Mamba-2/RWKV-7 五种门控递归,零新增参数、零算子改动,可作为即插即用的训练前配置。
实验结果
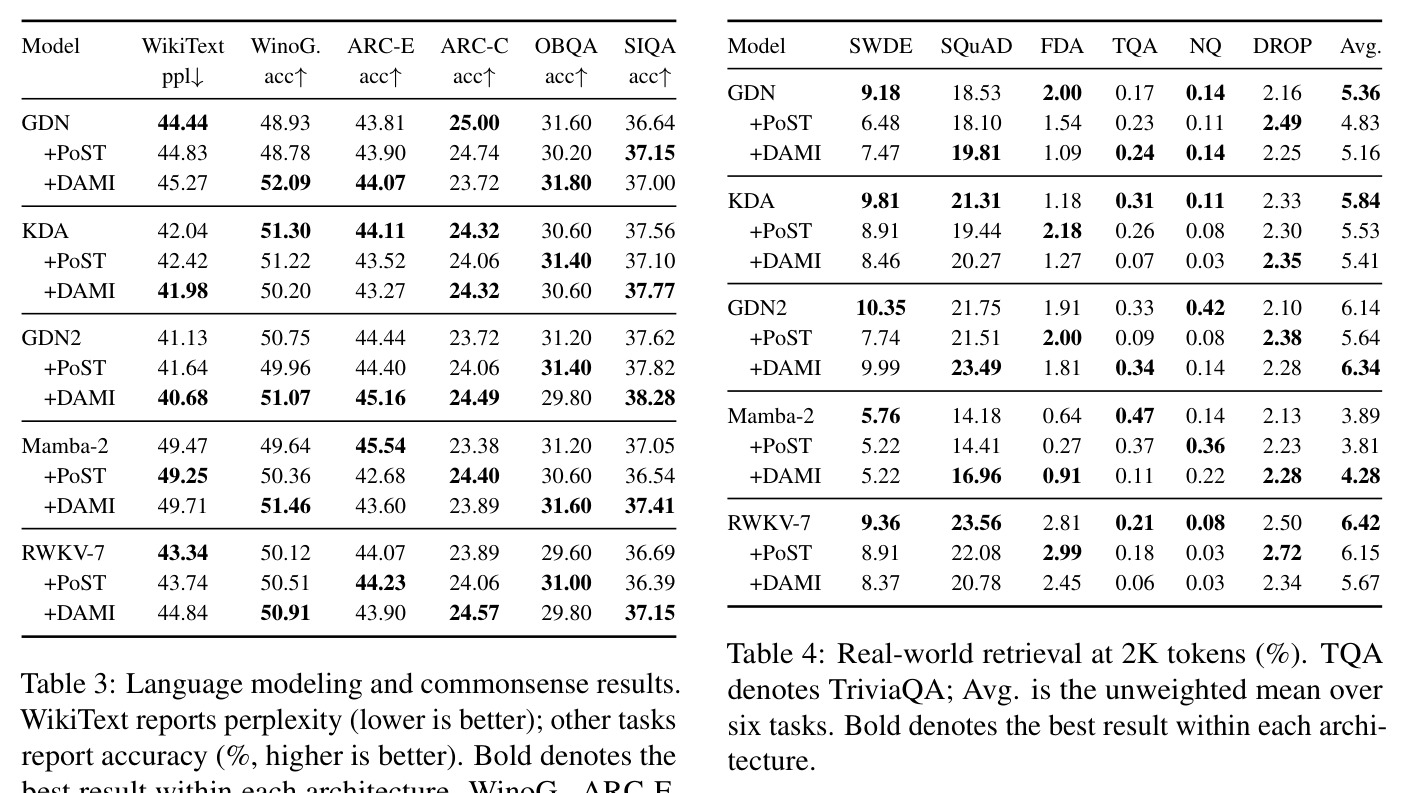
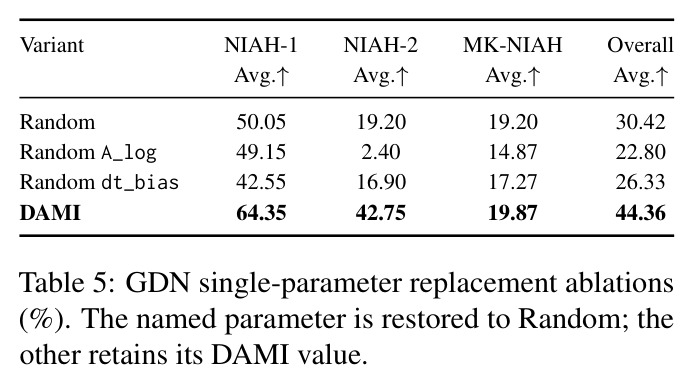
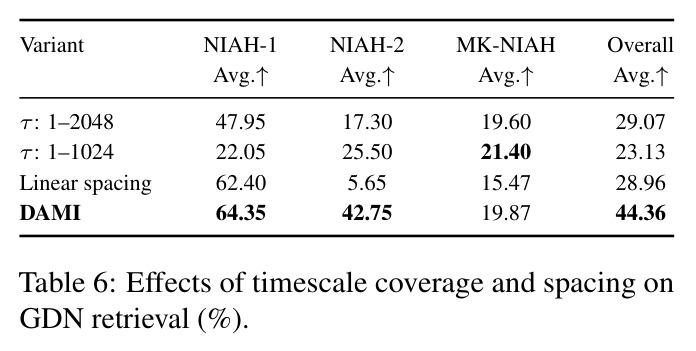
主实验(Table 2,11 个 RULER 设置平均):GDN 达 44.36 vs Random 30.42(+13.95pp)vs PoST 33.49(+10.87pp);KDA 43.09 vs 26.38(+16.71pp);GDN2 43.71 vs 30.27(+13.44pp);Mamba-2 24.42 vs 9.95(+14.47pp);RWKV-7 29.16 vs 23.87(+5.29pp)。DAMI 在全部 5 个架构平均最优,42/55 个任务-长度组合最优。8K 上下文外推显著:GDN NIAH-1 13.2→24.2,KDA 5.6→25.4,GDN2 2.4→12.6,Mamba-2 1.0→5.0。通用能力持平(Table 3):GDN WikiText ppl 44.44→45.27,Mamba-2/RWKV-7 的 WinoGrande 分别 +1.82/+0.79。2K 真实检索持平(Table 4):Mamba-2 平均 3.89→4.28。消融证明联合必要性(Table 5):只随机化 $A_{\log}$ → 22.80,只随机化 $dt\_bias$ → 26.33,完整 DAMI 44.36。覆盖与形状均关键(Table 6):$\tau$ 限 1–2048/1–1024 掉到 29.07/23.13,线性间隔 NIAH-2 崩至 5.65;敏感度剖面(Table 7)低-高-低 44.36,L-H/H-L/H-L-H 仅 26.85–32.85;平移 ±0.2 或挪峰位降至 24.31–33.31(Table 8)。按距离分析(Figure 6)显示 DAMI 在 1K/2K/4K 的远距离 bin 保持更高精度。
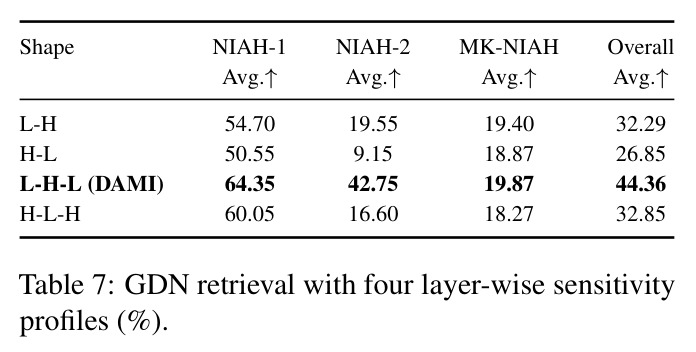
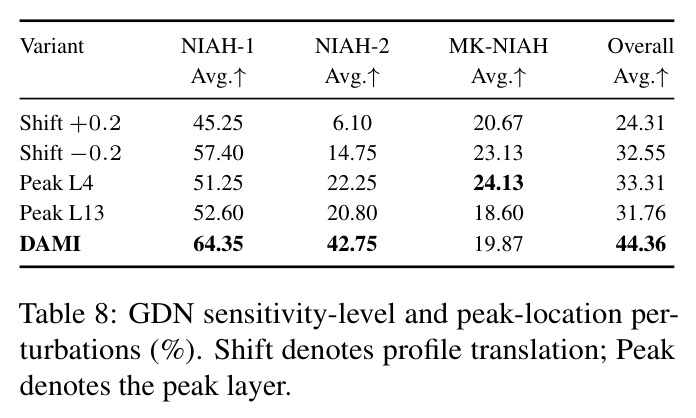
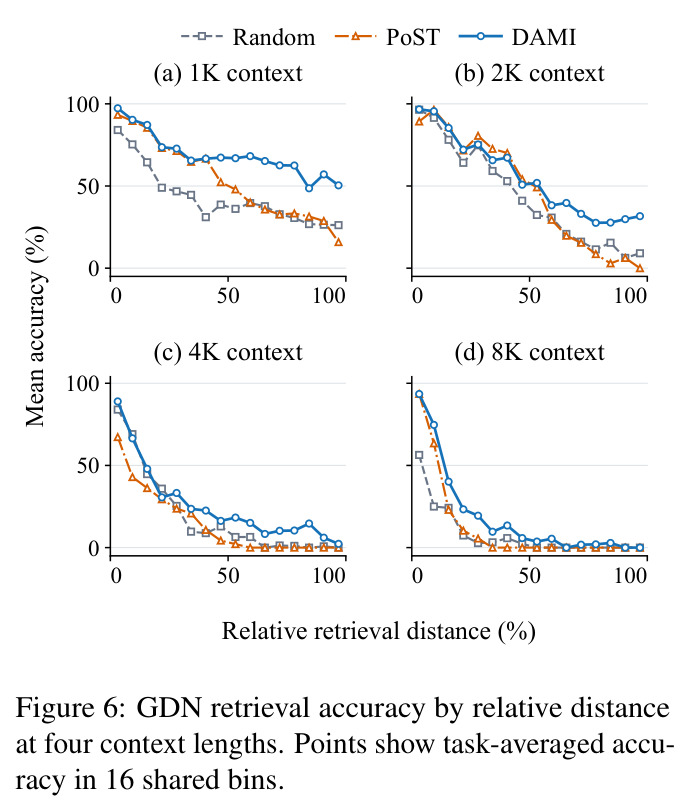
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RULER 风格 NIAH(GDN,11 设置平均) | 答案包含准确率 (%) | 44.36 | Random 30.42 | +13.95pp |
| RULER 风格 NIAH(KDA) | 答案包含准确率 (%) | 43.09 | Random 26.38 | +16.71pp |
| RULER 风格 NIAH(GDN2) | 答案包含准确率 (%) | 43.71 | Random 30.27 | +13.44pp |
| RULER 风格 NIAH(Mamba-2) | 答案包含准确率 (%) | 24.42 | Random 9.95 | +14.47pp |
| RULER 风格 NIAH(RWKV-7) | 答案包含准确率 (%) | 29.16 | Random 23.87 | +5.29pp |
| RULER 风格 NIAH(GDN,对比谱初始化) | 答案包含准确率 (%) | 44.36 | PoST 33.49 | +10.87pp |
| GDN 消融:仅随机化 $A_{\log}$ | Overall 准确率 (%) | 44.36(完整 DAMI) | 22.80 | 两参数联合配置缺一不可 |
| GDN 消融:仅随机化 $dt\_bias$ | Overall 准确率 (%) | 44.36(完整 DAMI) | 26.33 | 两参数联合配置缺一不可 |
局限与改进
作者承认:本工作只做衰减侧初始化,写入侧(新内容如何进入状态)未涉及;分析与实验都在各架构原生写入参数化与状态更新规则下进行。我的补充观察:规模很小(约 100M 参数、5B token、4K 训练上下文),持久性相关在更大规模、更久训练下是否保持未知;RWKV-7 提升最小(+5.29pp)且其 NIAH-1 在 4K/8K 反而崩到 4.4%/0.8%,说明 sigmoid 门的适配尚不成熟;MK-NIAH 几乎无改善(GDN 19.20→19.87),多键关联检索依旧困难;六个真实检索任务绝对分值极低(SQuAD 0.03–2.99%),对 100M 模型可能存在地板效应,区分度有限;RWKV-7 的对比使用了不同种子(Random/PoST 用 42、DAMI 用 43);低-高-低剖面的水平(0.25/0.748)与峰位是手工设定,Table 8 显示对扰动高度敏感(最多掉约 20pp),缺乏自动选择机制;校准集本身的鲁棒性也未分析。
独立分析的弱点
(1) 规模外推风险:持久性相关是 100M/5B 规模的观察,更大的模型训练更久、参数漂移更大,初始化优势可能被稀释——应在 ≥1B 规模复测相关性并按规模自适应调整目标。(2) 低-高-低剖面是启发式:Table 8 显示平移 +0.2 就从 44.36 掉到 24.31,方法对超参极其敏感,但论文没给自动搜索或理论依据——可用小规模代理任务做剖面搜索,或用元学习直接学初始化。(3) RWKV-7 适配薄弱:sigmoid 门的几何与 Softplus 不同,冻结缩放解法在 4K/8K 反而退化(NIAH-1 4.4/0.8),需要针对 sigmoid 响应的专门推导与验证。(4) 评测偏合成:MK-NIAH 几乎无改善(19.20→19.87),真实任务有地板效应,应补充更长上下文、更贴近应用的检索基准(如多跳 QA、聚合类任务)。(5) 校准集敏感性未知:若校准 token 分布与下游域差异大,$S_\ell^\star$ 与均值 Softplus 都会偏移,需要做域迁移鲁棒性实验。(6) 包络近似(单步衰减近恒定)在高敏感层可能失效,缺少理论误差界。
未来方向
作者提出的方向:联合研究衰减侧与写入侧的初始化,澄清两者如何协调新信息的写入与有用历史的保留。在此基础上可延伸:(1) 规模化验证——在 1B–7B 参数、百B token 上检验持久性相关与 DAMI 增益是否保持,观察初始化的影响随规模衰减还是放大;(2) 把初始化目标变成可学习对象,例如用小规模代理任务的元梯度搜索时间尺度谱与敏感度剖面,替代手工的低-高-低;(3) 扩展到更多门控架构(xLSTM、HGRN2、各类 DeltaNet 变体)以及注意力-线性混合模型,检验双轴框架的边界;(4) 训练中在线重校准:随激活分布漂移动态更新 $A_{\log}$/$dt\_bias$ 的行为目标;(5) 理论工作:把敏感度剖面与梯度流/可训练性联系起来,为包络近似给出误差界;(6) 与 PoST 的位置自适应缩放结合,检验谱初始化与位置自适应是否互补——本文明确排除了该组件。
复现评估
复现条件较好。代码开源于 https://speedai.com/research/dami;训练规模小——5 个架构 × 3 种初始化、每个约 100M 参数、5B token、4K 上下文,单机多卡可负担(每次运行约数 GPU-天);DAMI 校准只需小样本无梯度前向,成本可忽略。附录 D 给出全部配置:hidden 512、head dim 64;GDN/KDA/GDN2 为 18 层 6 头(103.79M/101.69M/112.25M),Mamba-2 42 层 16 头(105.01M),RWKV-7 20 层 8 头(101.43M);DAMI 目标时间尺度、剖面端点 0.25/峰值 0.748、KDA/GDN2 扰动 std 0.03、RWKV-7 的 160 个冻结缩放值均明确列出;评测为固定 500 预生成样本 × 11 设置加固定解码设置。注意事项:RWKV-7 的 Random/PoST 用种子 42 而 DAMI 用 43;校准集构成需查阅代码;PoST 基线是作者自实现的仅谱版本(不含位置自适应缩放),与原方法有差异。
论文图表
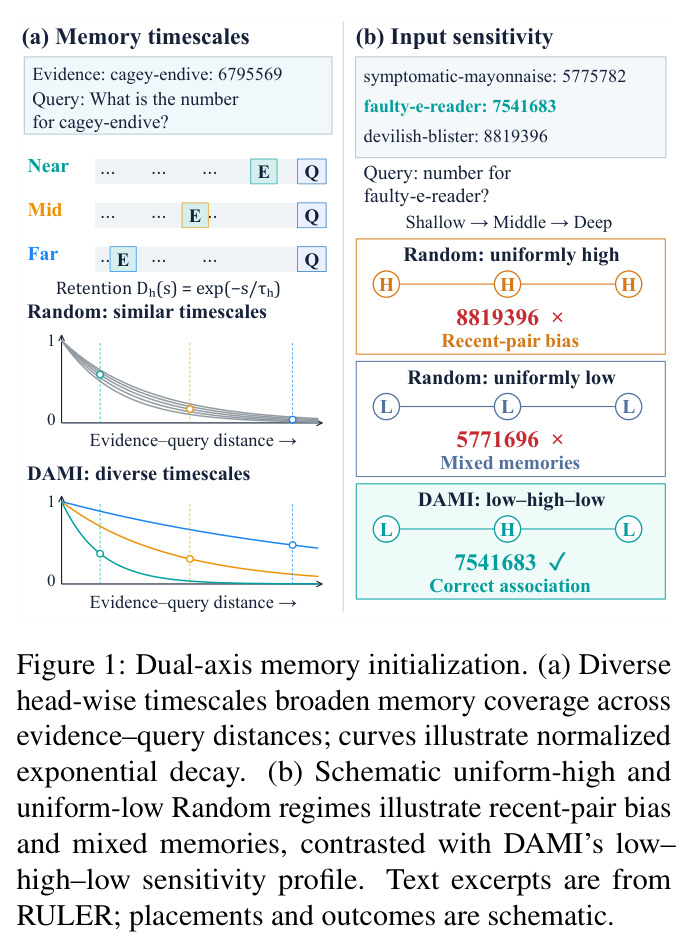
双面板总览图。(a) 记忆时间尺度:Random 初始化的头具有相似时间尺度,导致 recent-pair bias——远处证据-查询对检索失败;DAMI 给不同头分配几何分布的多样时间尺度,形成混合记忆,覆盖远近不同距离,并绘出归一化指数衰减曲线示意。(b) 输入敏感度:示意均匀高/均匀低的 Random 区制(recent-pair bias 与均匀低保留)与 DAMI 的低-高-低敏感度剖面对比,图中嵌入 RULER 文本片段及正确(7541683 ✓)/错误(8819396 ×、5771696 ×)关联示例。
一图总览论文的两个轴与核心动机(近期对偏好),是理解全文设计的入口。
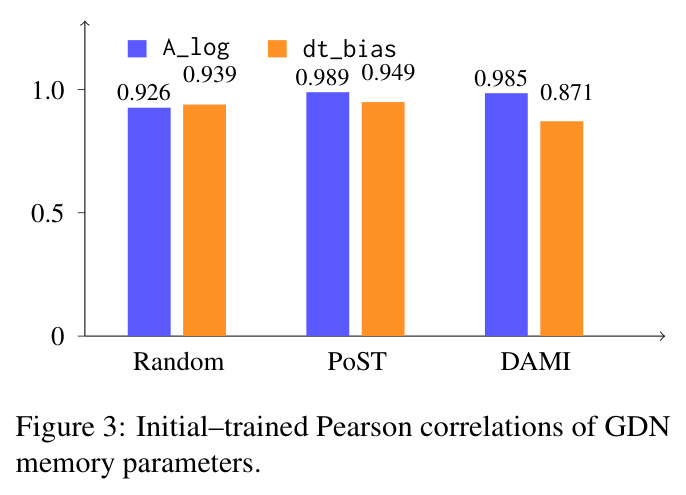
柱状图,比较 Random/PoST/DAMI 三种初始化下训练前后 $A_{\log}$(0.926/0.989/0.985)与 $dt\_bias$(0.939/0.949/0.871)的 Pearson 相关,全部高于 0.87,表明训练后记忆参数仍保留初始化的统计结构。
这是全文动机的核心实证证据:既然初始化结构能“穿过训练”保留,结构化初始化就是塑造最终记忆行为的可行杠杆。
WikiText 困惑度与 WinoGrande、ARC-Easy/Challenge、OpenBookQA、Social IQa 准确率。三种初始化大体持平:如 GDN ppl 44.44/44.83/45.27,WinoGrande 上 Mamba-2(49.64→51.46)与 RWKV-7(50.12→50.91)分别提升 1.82/0.79 点;DAMI 在 30 项对比中 17 项最优(含并列)。
证明检索增益不以通用能力退化为代价,是“改进检索且能力持平”这一核心主张的证据。