WorldBridge:面向任务泛化、桥接视频与动作的世界动作模型 WorldBridge: Bridging Video and Action for Task Generalization in World Action Models
解耦视频与动作监督的作用,用双专家流匹配世界模型实现机器人跨任务泛化
前置知识
世界动作模型(World Action Model, WAM)
一类同时建模"未来视觉演化"和"机器人动作"的具身基础模型:给定当前观测和语言指令,模型既预测未来视频帧(世界模型部分),又输出可执行的动作序列(策略部分)。与只输出动作的 VLA 不同,WAM 把视频预测作为显式中间目标,使模型学到物理世界的动力学规律,动作生成可以从预测的视觉未来中获得接地。代表工作包括 DreamZero、Zero-WAM、Long-WAM 等。
本文的整个框架(视频专家 + 动作专家、video-to-action 桥)都建立在 WAM 范式之上,任务泛化实验也是在 WAM 中设计并解读的。
流匹配(Flow Matching)
一种生成式建模训练方法:在数据 $z$ 和高斯噪声 $\epsilon$ 之间构造线性插值路径 $z^{(\tau)}=(1-\tau)z+\tau\epsilon$,训练网络预测速度场 $u^*=\epsilon-z$,推理时从纯噪声($\tau=1$)出发沿速度场积分逐步去噪到数据($\tau=0$)。相比扩散模型路径更直、采样步数更少,$\pi0$ 等 VLA 已用它生成连续动作块。
WorldBridge 用联合流匹配同时训练视频和动作两个专家,动作强迫(action forcing)、注意力掩码等关键设计都围绕流时间步 $\tau$ 展开。
混合 Transformer(Mixture-of-Transformers, MoT)
一种多模态架构组织方式:不同模态(本文中是视频和动作)各自拥有独立的参数,包括 FFN、QKV 投影和输出解码器,但通过共享的自注意力交换信息。相比单一共享骨干同时处理所有模态,MoT 保留模态特有的处理路径,避免模态间梯度干扰,同时仍允许跨模态条件化。
WorldBridge 的视频专家和动作专家正是用 MoT 组织的,注意力掩码如何设计直接决定两个专家之间的信息流向,是理解方法的关键。
逆动力学模型(IDM)与 video-to-action 桥
逆动力学回答"要造成某个视觉状态变化,应该执行什么动作"。本文把从"预测的未来视频"到"动作"的映射称为 video-to-action 桥,功能上等同逆动力学模型。关键洞察在于:这个桥是在有动作标签的任务上学到的,如果桥本身可迁移,那么新任务只需要视频(无需动作标签)也能被执行。
这是全文的核心科学假设——视频监督扩展"能想象什么任务",动作监督强化"桥能否落地执行",核心实验就是围绕拆解这两条轴设计的。
统一动作空间与效度掩码(Validity Mask)
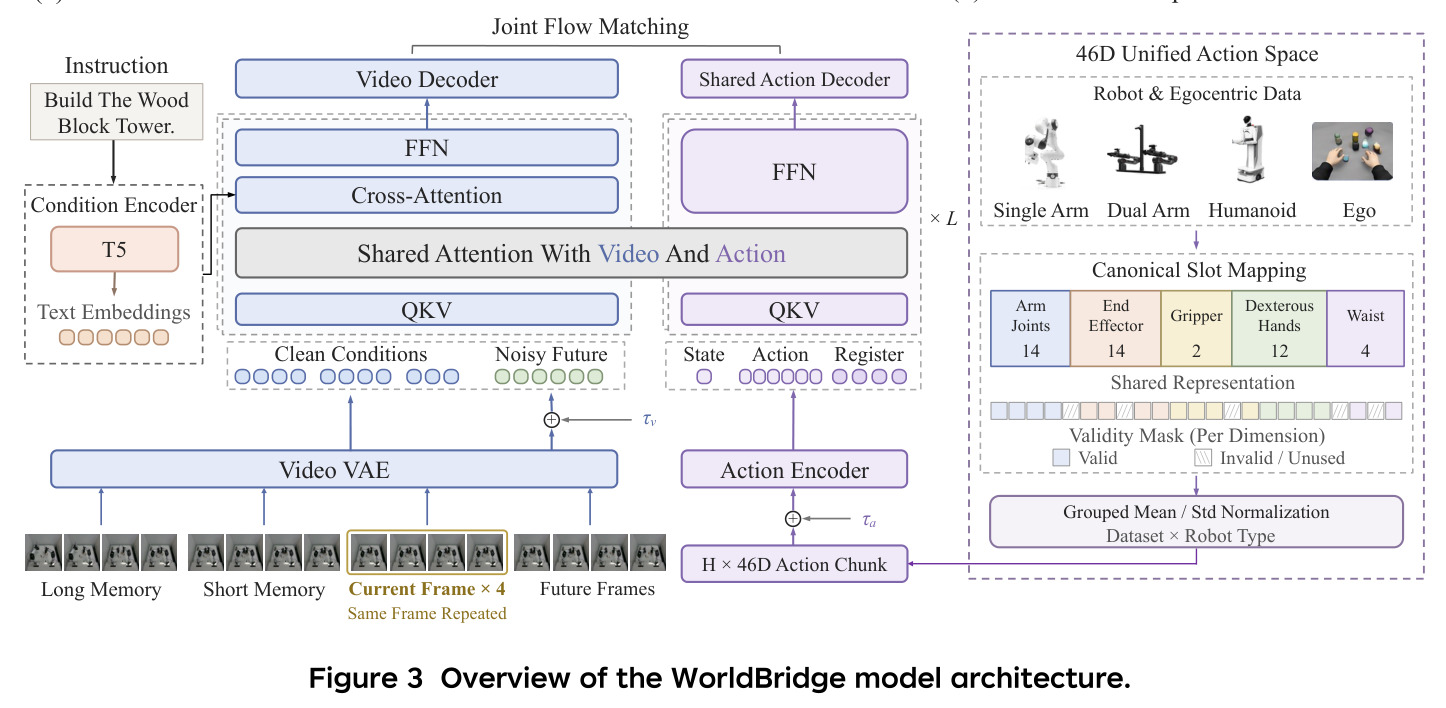
把所有机器人本体的控制量映射到固定的 46 维共享布局:臂关节 14 维 + 末端位姿 14 维 + 夹爪 2 维 + 灵巧手 12 维(每手 6 槽)+ 腰部 4 维。每个本体只填充自己可用的维度,其余置零并用逐维 0/1 掩码标记无效;训练时损失只在有效维度上计算。这样部分监督可用而不会引入假标签。
它是 10 个机器人数据集和 7 个人类自我中心数据集能进同一个动作专家的关键机制,也是真机上跨本体微调(G2 16 维、AC-1 14 维原生命令)的基础。
研究动机
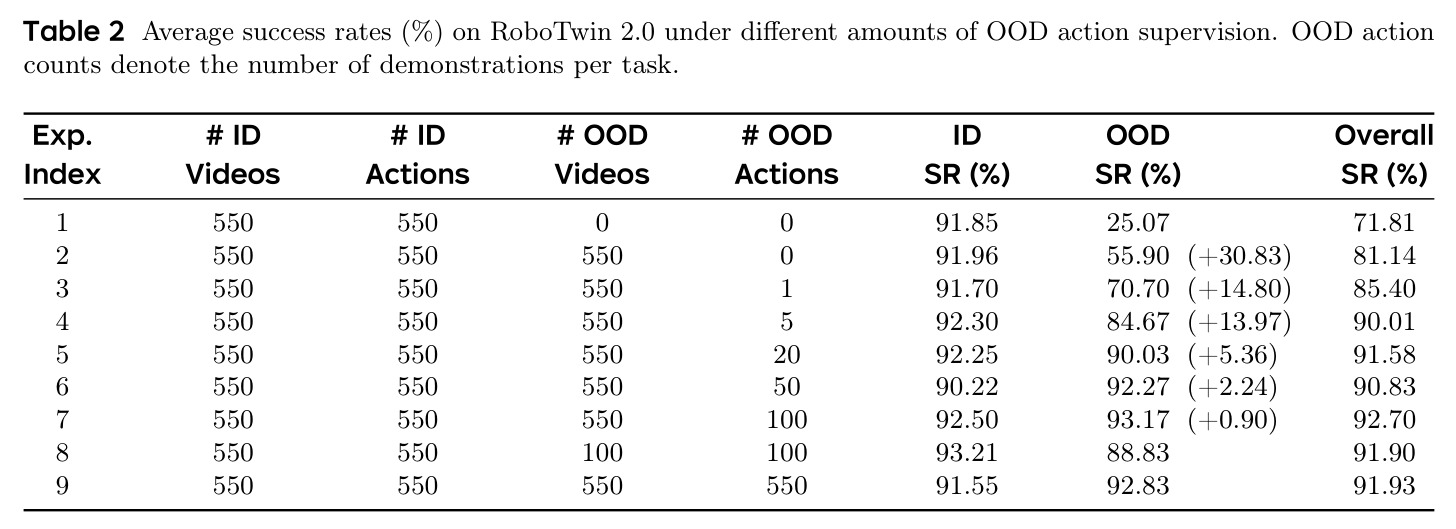
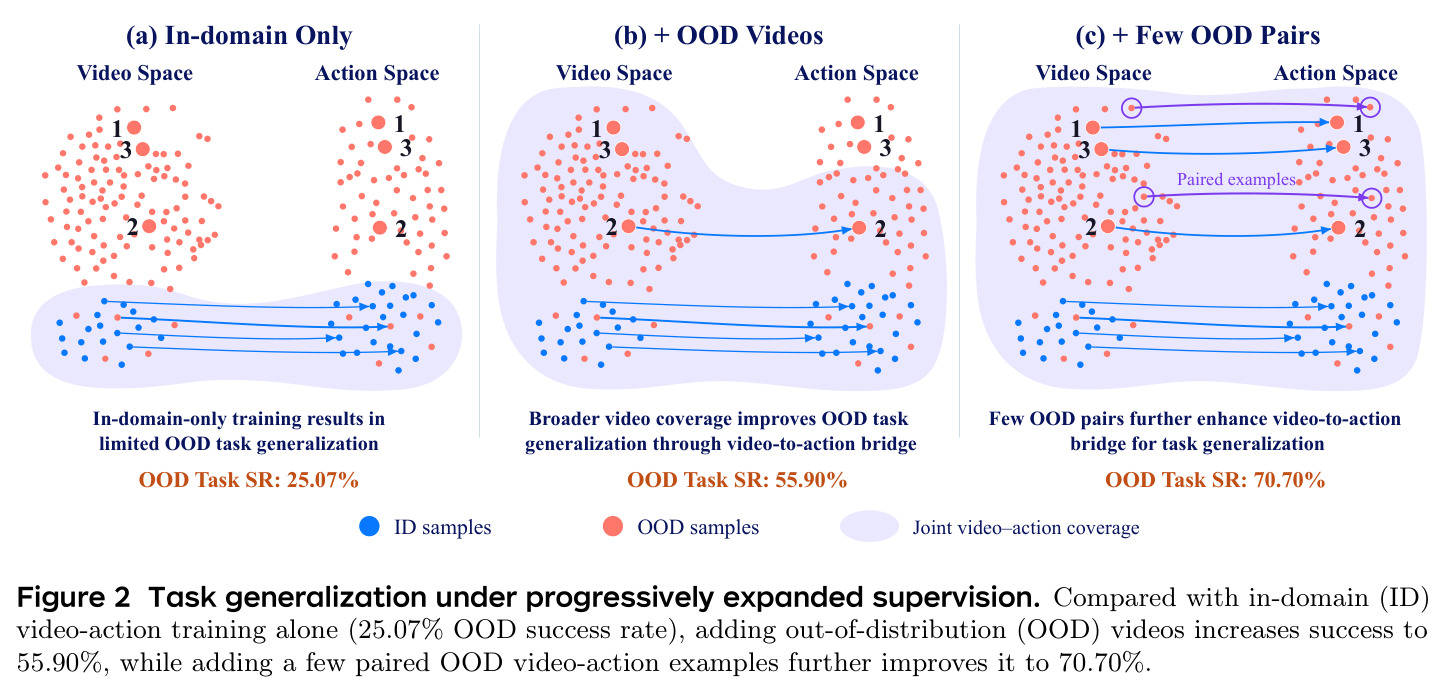
机器人学习的核心瓶颈之一是任务泛化:模型能否执行训练任务集之外的新任务。此前的稳健性研究(如 LIBERO-Plus)关注的是同一任务在物体摆放、相机视角、光照变化下的脆弱性,而任务泛化要求更苛刻——机器人要在几乎没有对应机器人示教的情况下完成全新任务。为每个新任务采集遥操作示教非常昂贵,动作标注成为扩展任务面的硬约束。本文用控制变量实验量化了这一困境:在 RoboTwin 2.0 上,只用分布内(ID)任务的 550 条视频-动作配对数据训练,模型在 ID 任务上成功率达 91.85%,但在分布外(OOD)任务上只有 25.07%——模型有一定迁移能力,但远不足以可靠执行新任务。VLA 模型(RT-2、OpenVLA、π0 等)能理解语言指令并不等于具备执行指令的物理能力,语义知识必须连接到视觉动力学和运动控制才能转化为行为。
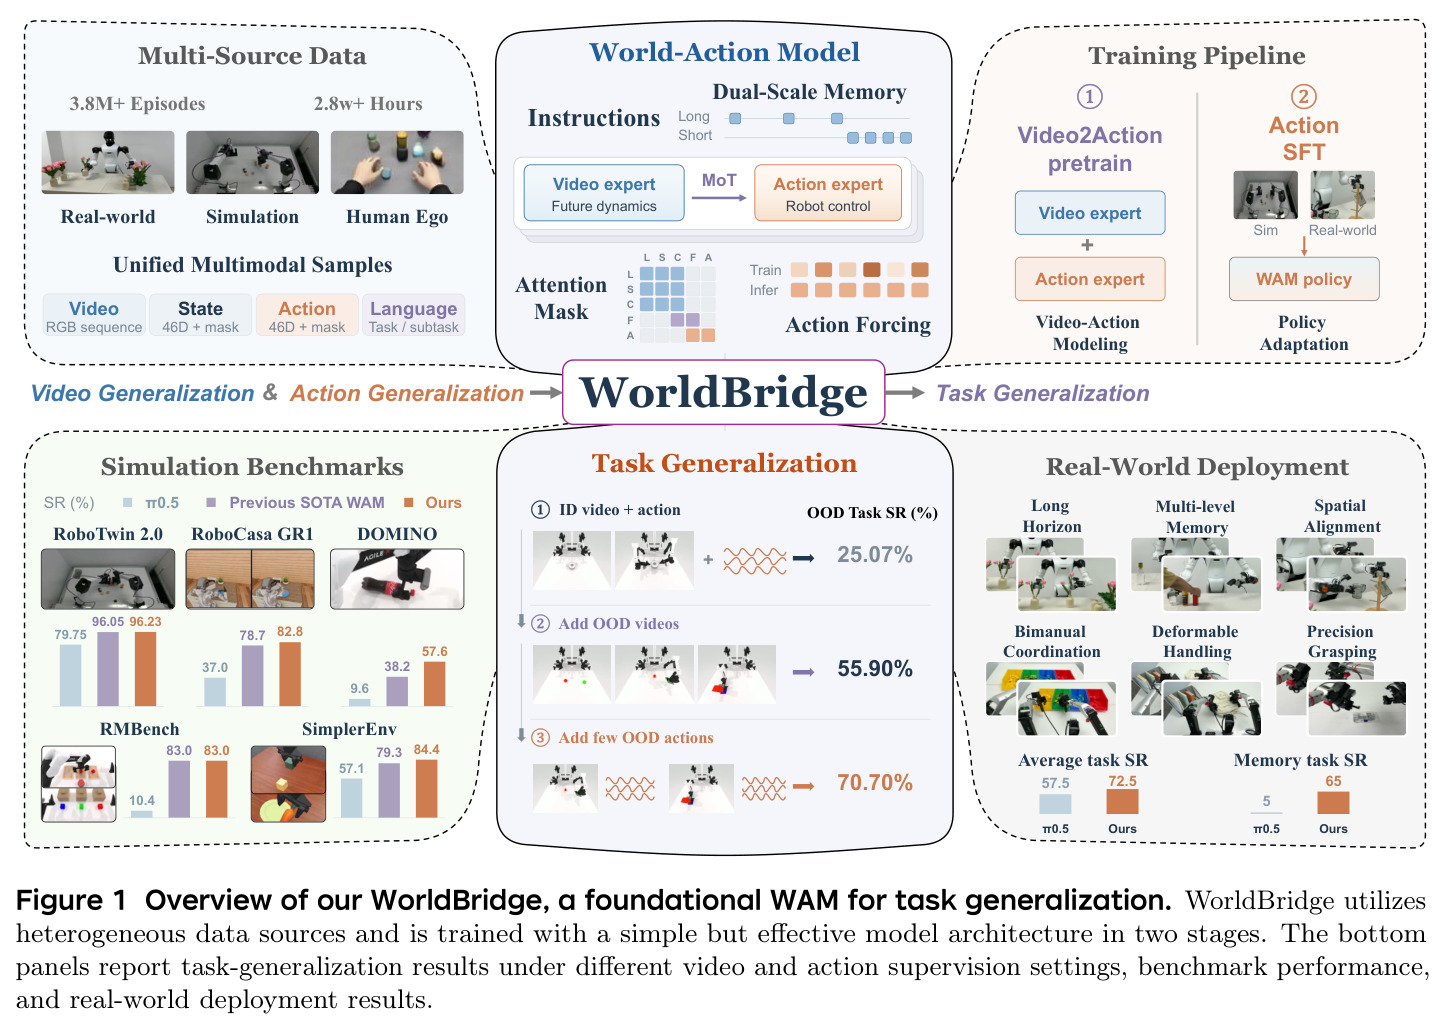
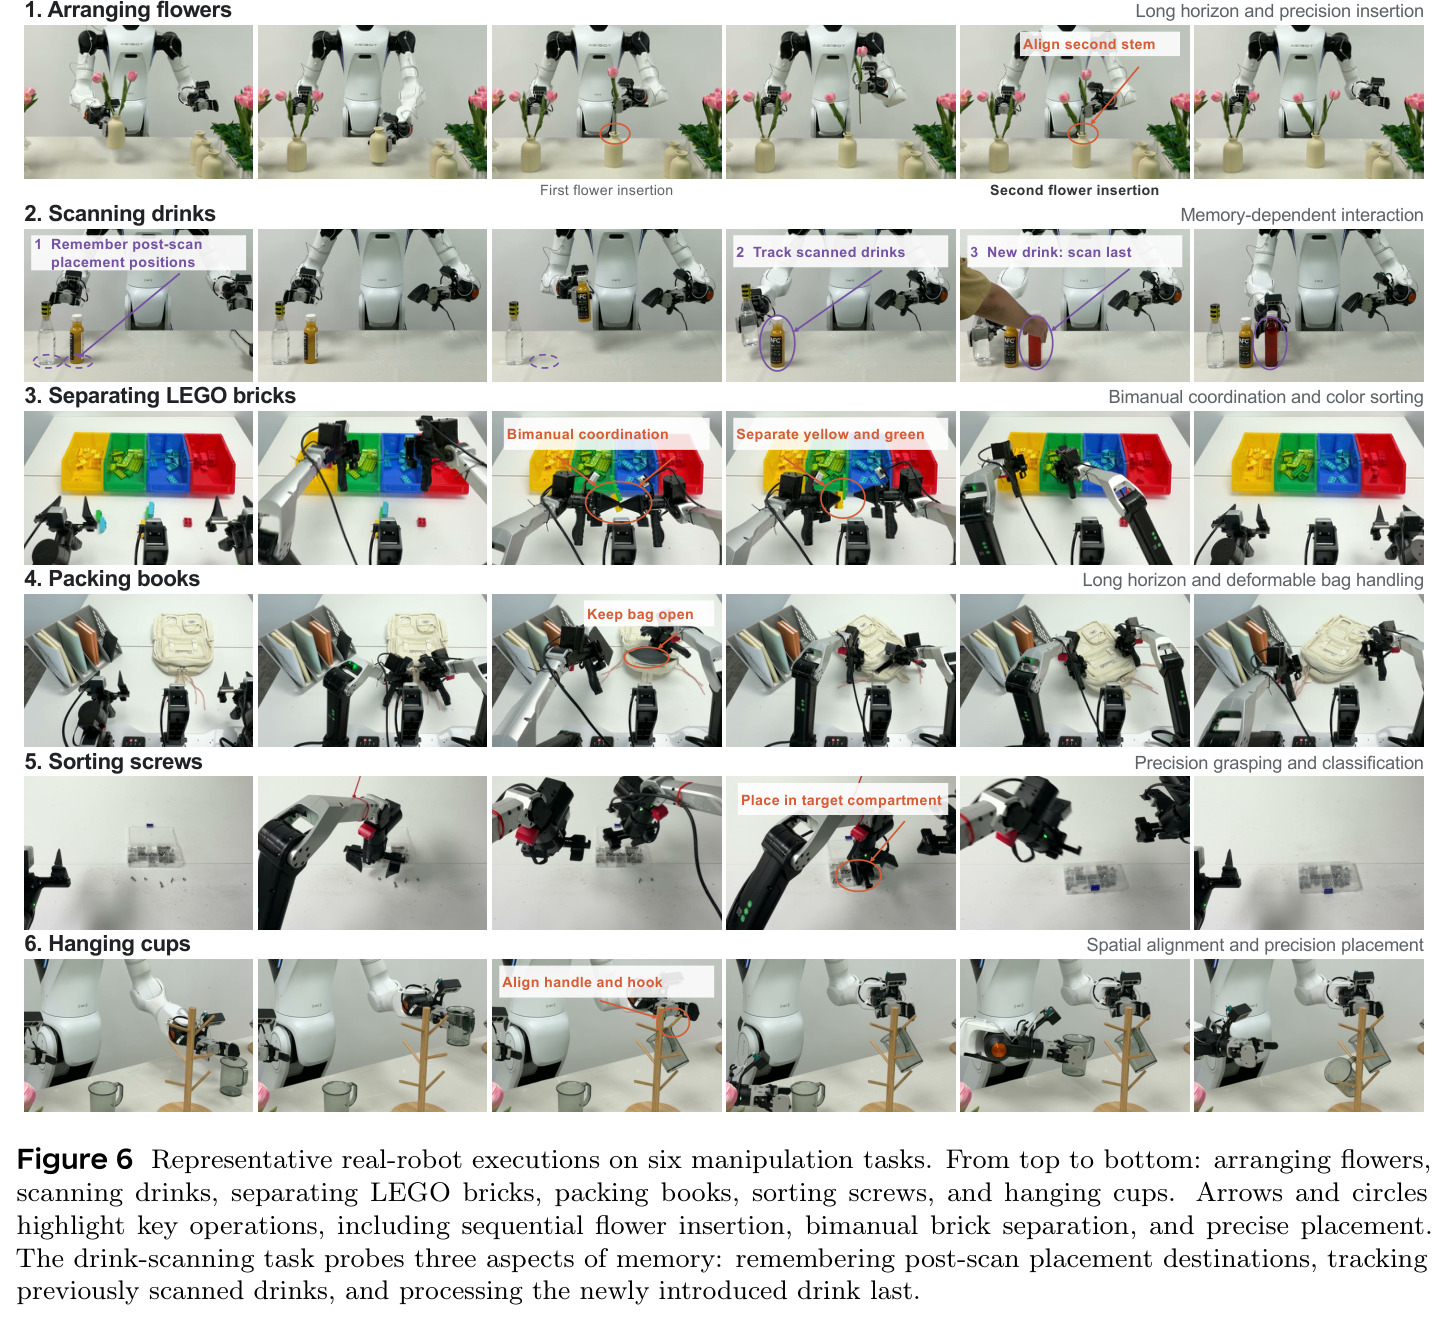
本文的目标是本文要回答一个具体问题:在 WAM 中,视频监督和动作监督对任务泛化各自贡献什么?两者之间的连接何时成为瓶颈?具体做法是在固定 ID 视频与动作数据的前提下,逐级增加 OOD 任务的视频(不带动作标签)和稀疏动作标注(每任务 1/5/20/100/550 条),观察 OOD 成功率的变化曲线。在此基础上构建 WorldBridge——一个把视频预测与动作生成通过结构化注意力连接起来、并用统一数据管线整合机器人轨迹与人类自我中心演示的 WAM,目标是在 RoboTwin 2.0、RoboCasa GR1、RMBench、DOMINO、SimplerEnv-WidowX、RoboDojo 等多个基准上达到对比方法中的最优,并能在 AgiBot G2 和 ARX AC-1 真机上覆盖长时程执行、记忆依赖交互、空间对齐和双臂协同任务。
与已有工作不同的是,已有工作分别从不同侧面接近这个问题:DreamZero 证明视频先验可支持未见任务执行,Zero-WAM 用人类视频做上下文引导,Long-WAM/MemoryWAM 研究时序上下文与记忆。但这些工作大多把"更多数据有帮助"当作笼统结论,没有把监督类型拆开。本文的独特切入是把任务泛化分解成两个正交能力轴——视频泛化(预测新任务的视觉演化)与动作泛化(把预测翻译为可执行动作),然后像做消融实验一样系统控制两条轴的监督量。这带来了三个此前未被量化的发现:仅增加 OOD 视频(无动作标签)就能把 OOD 成功率从 25.07% 提到 55.90%,说明从 ID 动作监督学到的"桥"可以迁移;每任务仅加 1 条动作演示就再提到 70.70%;20 条演示达到 90.03%,只用了全量 550 条预算的约 3.6%——视频覆盖和稀疏动作接地是互补而非冗余的。
核心方法
直觉上,这像教一个人做新菜:给他看大量"这道菜做完是什么样"的视频(视频专家学视觉演化),再让他亲手练一两遍关键步骤(动作专家把视觉预测接地为控制),他就能做没有完整教程的新菜。技术路线上,WorldBridge 采用 MoT 架构:视频专家接收因果视频 VAE 编码的观测(双尺度视觉记忆 + 当前帧 + 未来帧)和 T5 编码的语言指令,动作专家处理 46 维统一动作空间中的动作块(预测时域 $H=32$),两专家通过联合自注意力交换信息,用联合流匹配训练——视频和动作各自有独立的流时间步 $\tau_v$ 和 $\tau_a$。数据侧用统一管线把 10 个机器人数据集和 7 个人类自我中心数据集整理成共享格式。训练分两阶段:预训练(6 万步、64 卡)用宽松注意力掩码保持视频生成与动作无关;后训练切换到结构化掩码,强制信息沿"观测 → 未来视频 → 动作"方向流动,显式构成 video-to-action 桥。
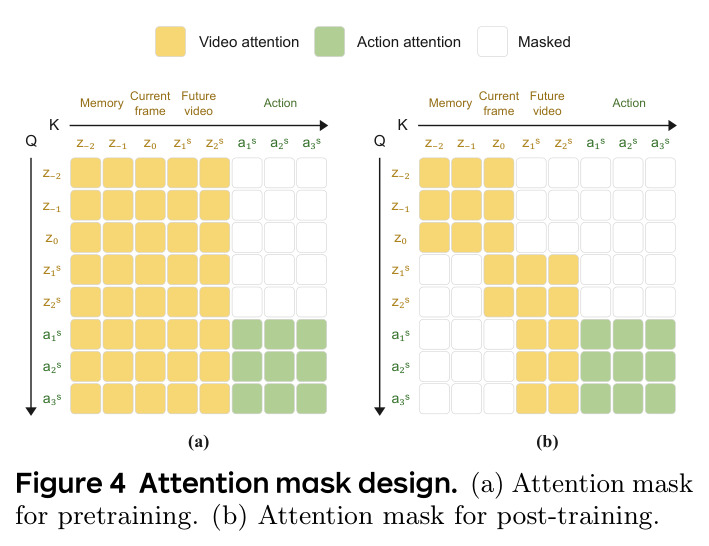
核心创新有三点。第一,结构化注意力掩码显式构造 video-to-action 桥:预训练时视频 token 不看动作(保持视频生成不受动作干扰),动作 token 看全部视频;后训练时动作 token 只能看未来视频 token 和动作 token——动作必须以"预测的未来视觉演化"为条件,把世界模型预测变成控制的显式中间源,这正是可跨任务迁移的桥。第二,动作强迫(action forcing):传统做法让整个动作块共享一个噪声水平,本文把标量 $\tau_a$ 扩展为逐组采样的向量 $\tau^a$(组大小 $g$),同一块内不同动作处于不同噪声水平,迫使每个 token 依赖上下文视觉信息而非仅靠自身噪声水平来去噪。第三,46 维统一动作空间 + 逐维效度掩码 + 末端执行器相对表示 $\Delta p_{t,k}=R_t^\top(p_{t,k}-p_t)$、$\Delta\phi_{t,k}=\mathrm{Log}(R_t^\top R_{t,k})^{\vee}$,让人类自我中心手部关键点也能转化为带掩码的动作监督,与机器人数据在同一个动作专家中联合训练。
方法步骤详情
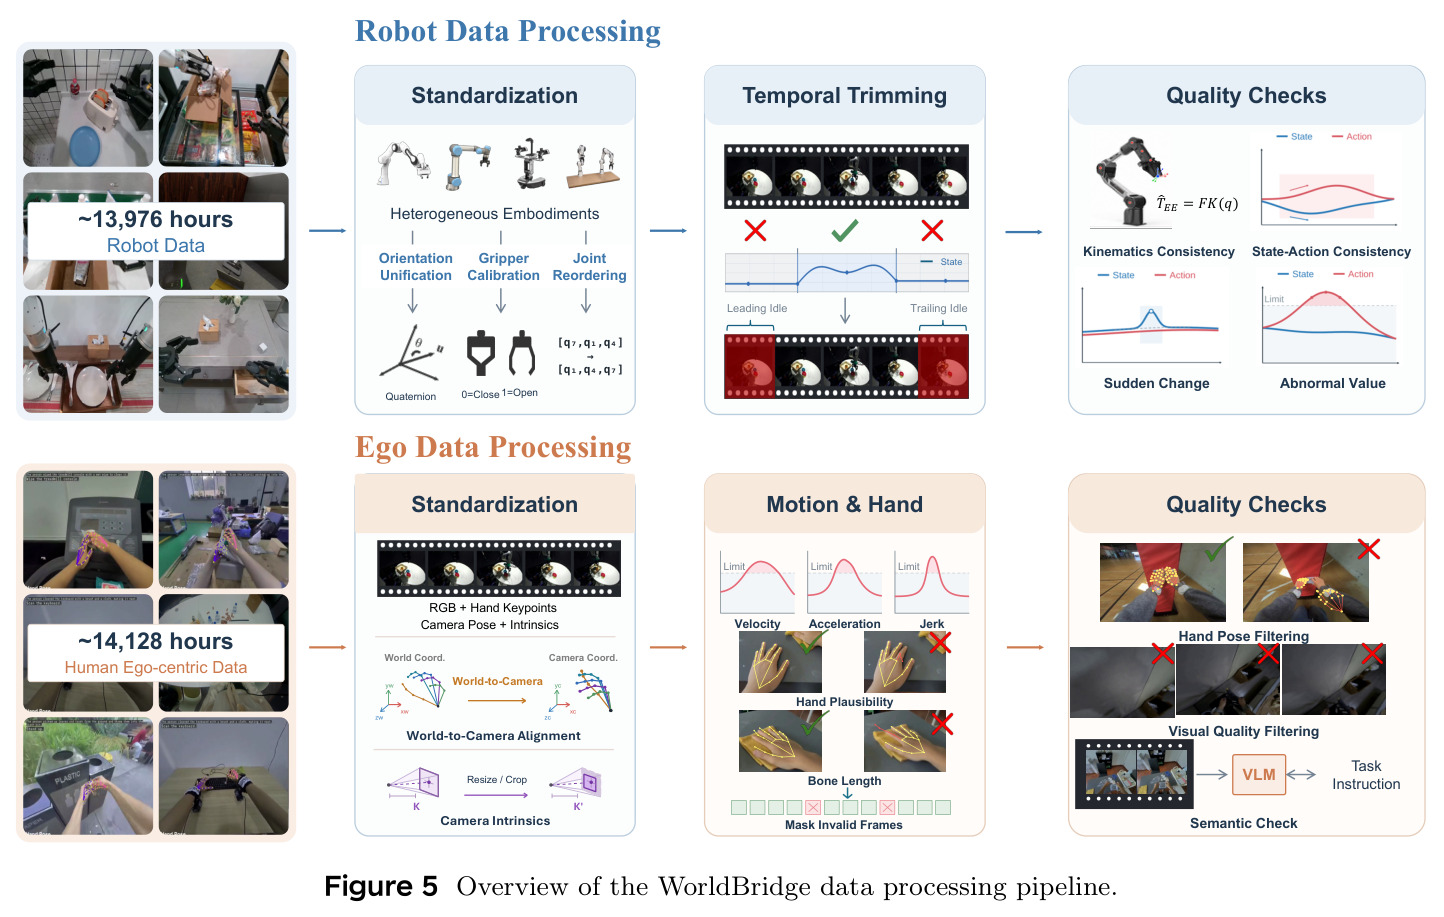
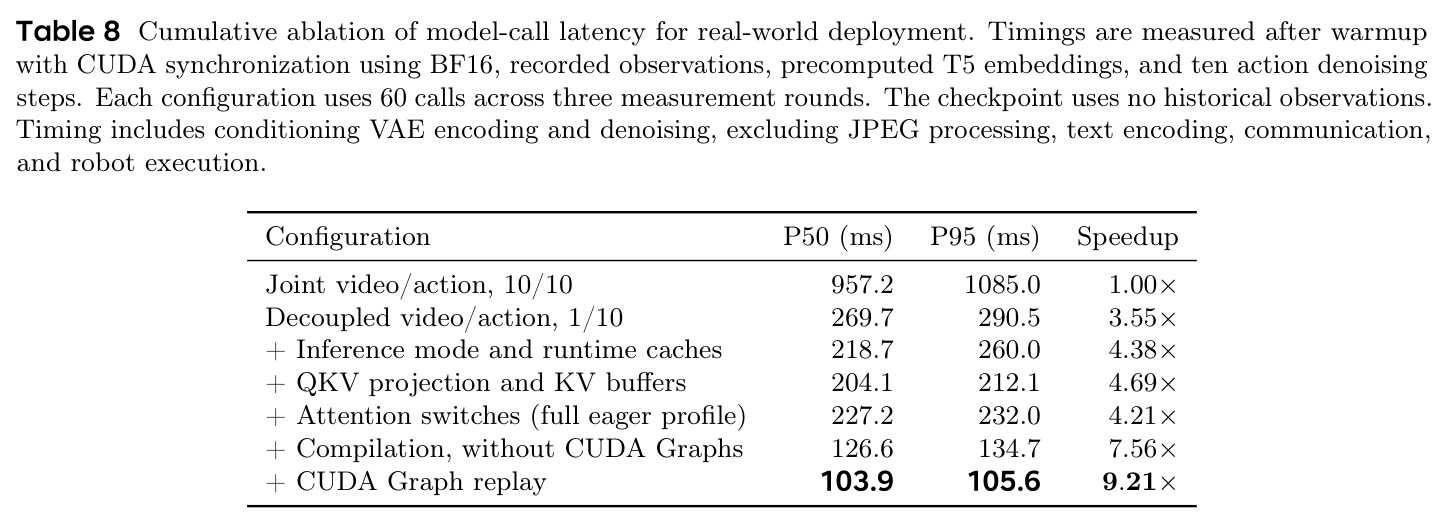
完整流程如下。(1)输入构造:按短步长偏移 $[-8,-6,-4,-2]$、长步长偏移 $[-128,-96,-64,-32]$ 各采 4 帧历史观测,与重复 4 次的当前帧(对齐 VAE 时间压缩因子)经因果 VAE 编码为长期/短期/当前 3 个隐帧,与 T5 文本嵌入构成条件 $c$。(2)目标与加噪:预测 8 帧未来视频隐变量和 32 步动作块,按线性路径 $z^{(\tau_v)}=(1-\tau_v)z+\tau_v\epsilon_v$ 加噪,动作强迫下逐组采样噪声水平。(3)联合去噪网络:$L$ 个 MoT 块处理含噪输入,视频专家经交叉注意力融入语言特征,输出速度预测并用 $u^*=\epsilon-\text{target}$ 回归。(4)数据管线:机器人数据经语义审计(关节顺序、四元数、夹爪 0 闭 1 开校准)、静止边界裁剪(阈值 $10^{-4}$、最短 48 帧)、运动学一致性检查 $e_{pos}=\|p_{FK}-p_{data}\|_2$、突变与状态-动作方向一致性($\pm 15$ 帧搜索)、极值过滤;自我中心数据经世界系到相机系对齐、手部关键点到位姿/张开度/6 槽手指弯曲映射、运动学统计过滤。(5)预训练:6 万步、64 卡 BF16、有效批 1536,机器人与自我数据 0.7:0.3 采样。(6)推理:从 $N(0,I)$ 去噪,视频 KV 复用 + CUDA Graph 加速到约 103.9ms/次、真机约 7Hz。
技术新颖性
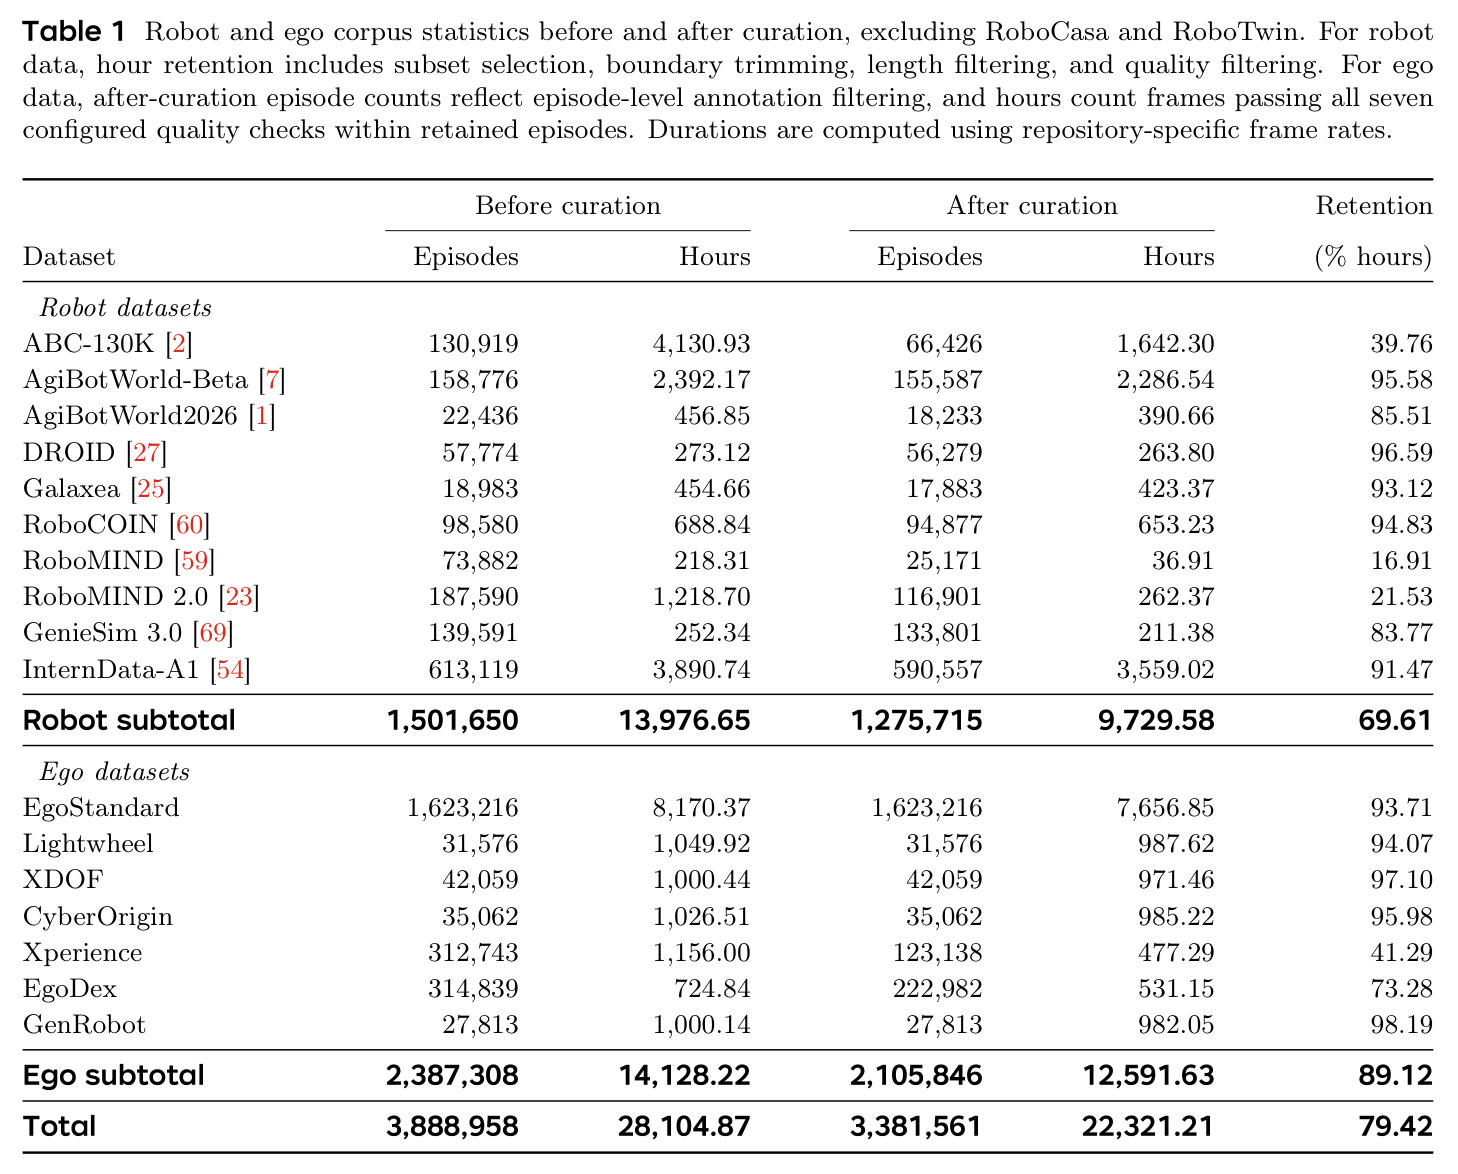
与已有工作的本质区别:(1)相对于 π0/π0.5 等只输出动作的 VLA,WorldBridge 让动作以预测的未来视频为条件,把世界模型预测作为控制的显式中间表示,而不是并行输出两个独立的头;(2)相对于 DreamZero/Zero-WAM 只定性演示"视频先验有用",本文首次系统量化了视频与动作监督的边际贡献曲线(OOD 成功率 25.07→55.90→70.70→84.67→90.03→93.17%),并给出"视频扩展覆盖、稀疏动作强化桥"的可操作结论;(3)MoT 双专家 + 阶段化注意力掩码不同于在单一 Wan 视频骨干上简单外接动作头的做法,保留了模态独立性和定向信息流;(4)动作强迫的逐组噪声水平设计在动作生成中是新的,可视为作用在噪声调度维度上的 teacher forcing;(5)把人类自我中心视频转成带掩码的动作监督并与机器人数据同损失训练,比单纯用人类视频做上下文引导(Zero-WAM)更进一步,且表格化记录了每个数据源清洗前后的时长留存率(总保留 79.42%)。
实验结果
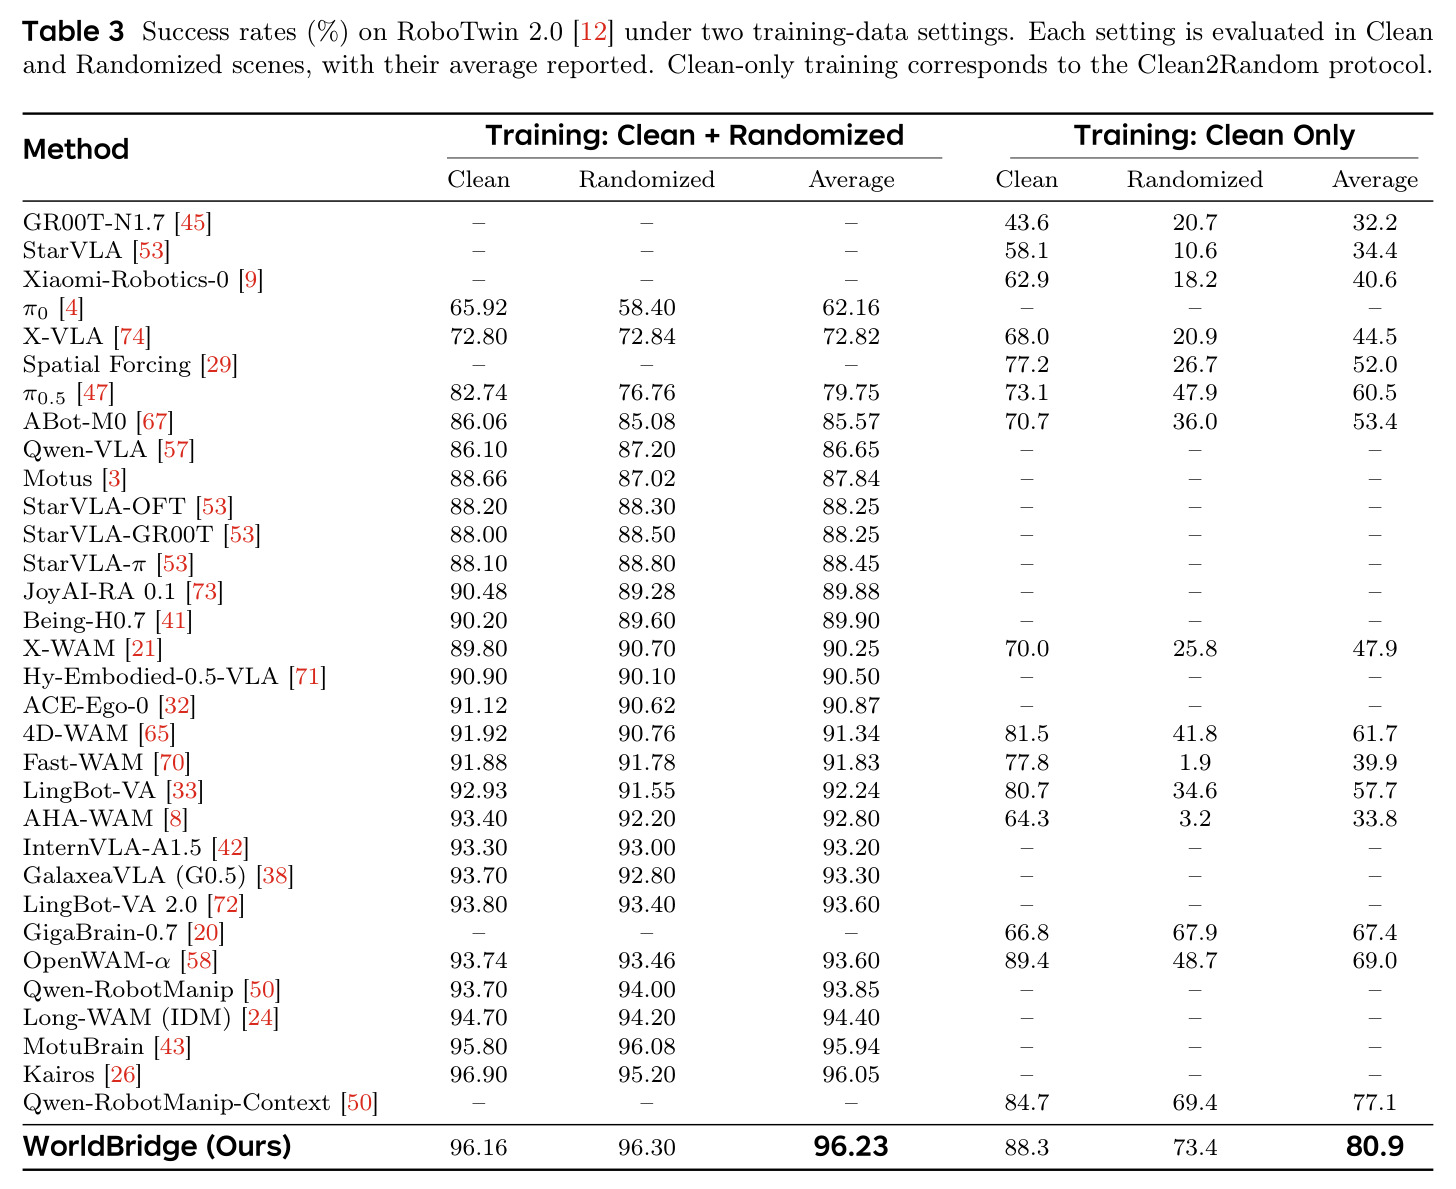
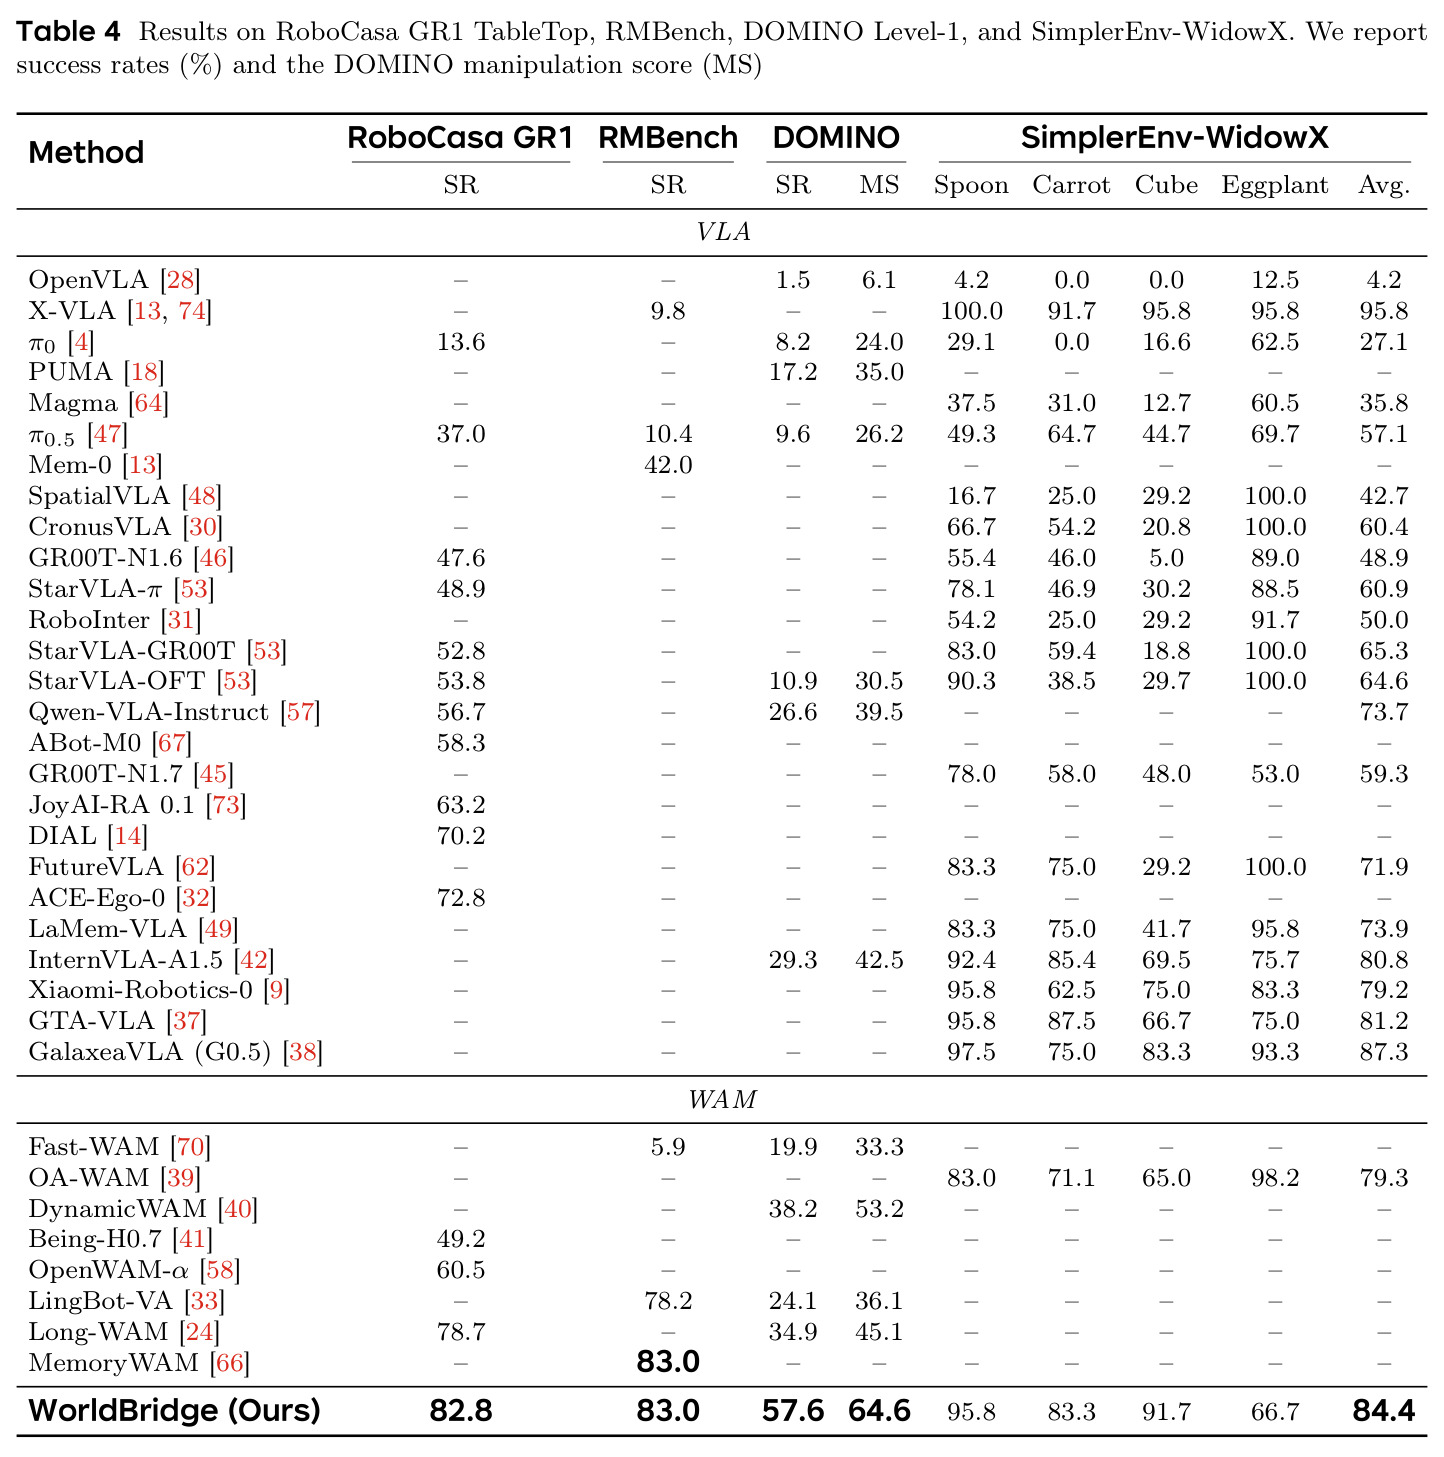
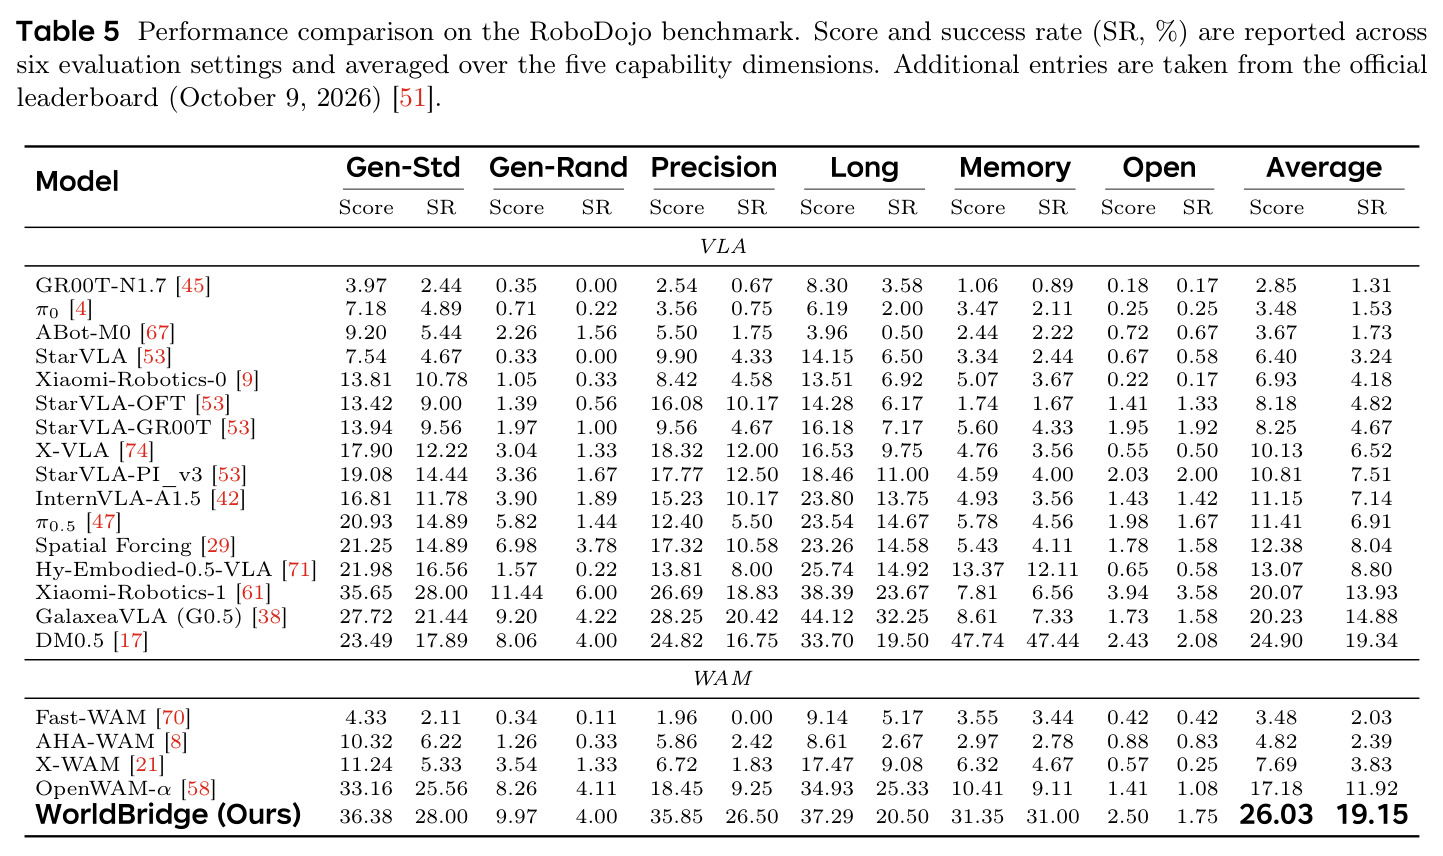
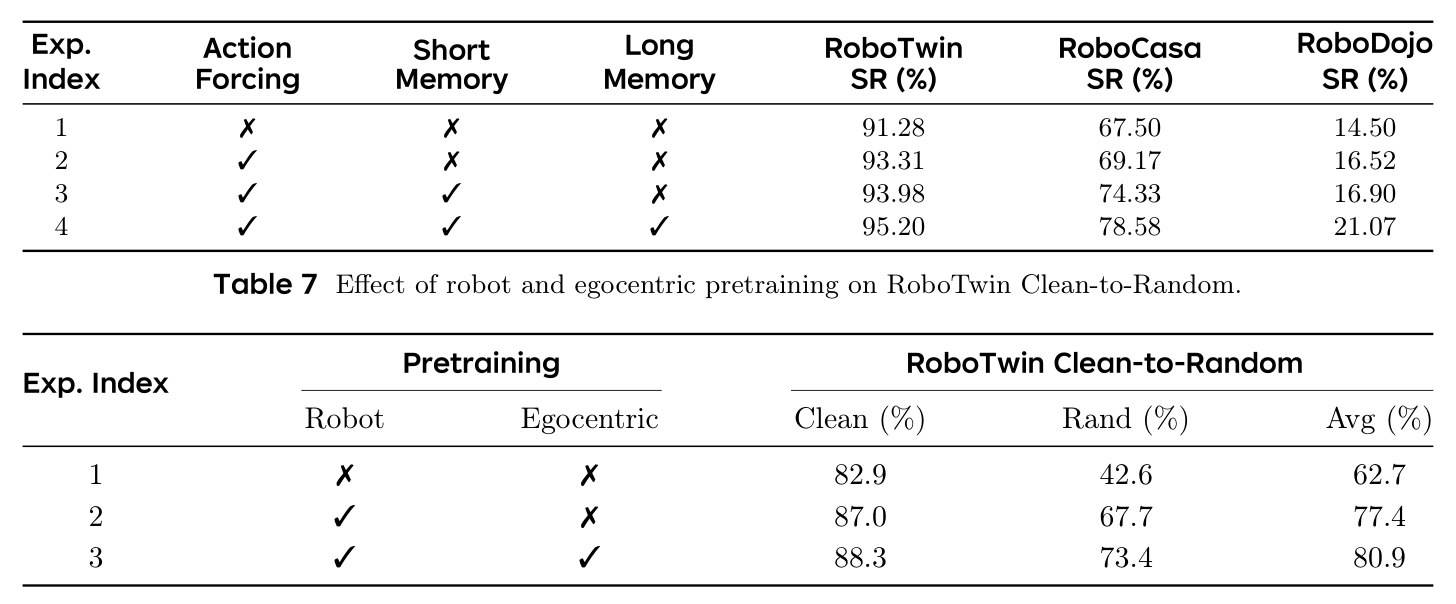
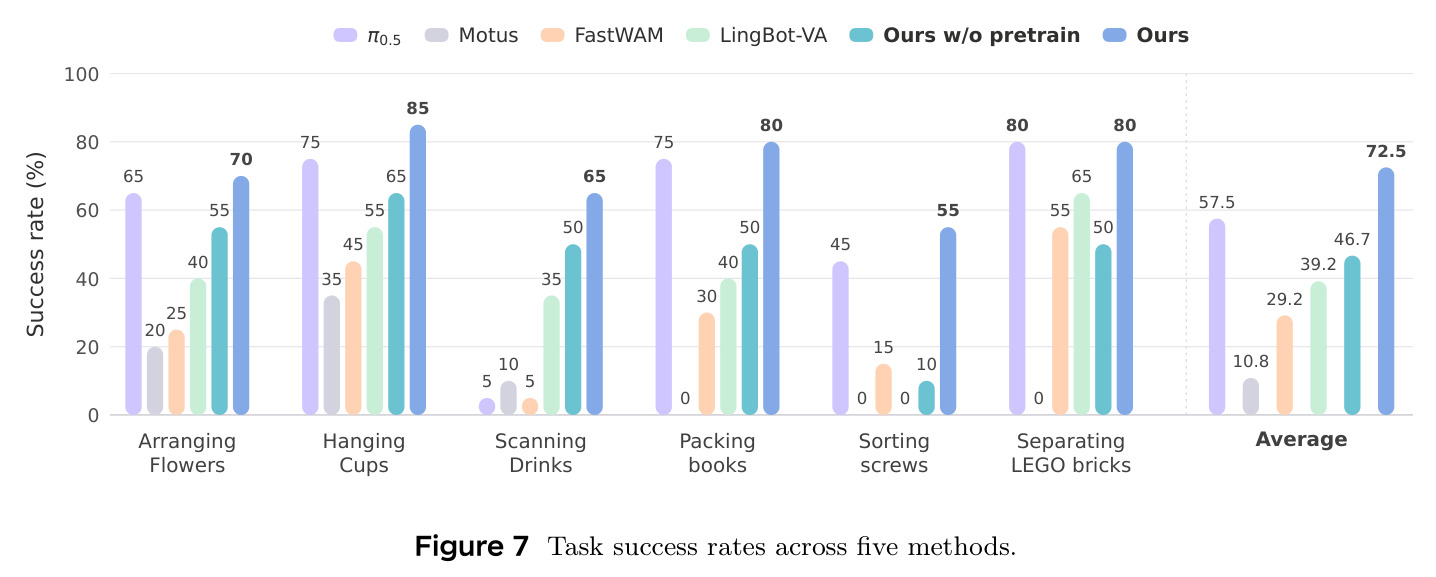
核心科学结果(Table 2,RoboTwin 2.0):固定 550 条 ID 视频-动作数据,仅加 OOD 视频(无动作标签)就把 OOD 成功率从 25.07% 提到 55.90%(+30.83 pt),ID 性能几乎不变(91.96%);再加每任务 1 条 OOD 动作演示达 70.70%,5 条达 84.67%,20 条达 90.03%(仅占 550 条预算的约 3.6%),100 条达 93.17%,550 条反而略降至 92.83%。交叉验证互补性:100 条动作预算下 OOD 视频从 100 加到 550 带来 +4.34 pt,而视频固定 550 时动作从 100 加到 550 无增益。基准成绩:RoboTwin 2.0 全数据 96.23%(超 Kairos 96.05,共 1 万次评测);Clean2Random 80.9%(超 OpenWAM-α 69.0);RoboCasa GR1 82.8%(超最强 VLA ACE-Ego-0 72.8 达 +10.0 pt);RMBench 83.0%(追平 MemoryWAM,远超 π0.5 的 10.4%);DOMINO Level-1 复用 RoboTwin 检查点零微调得 57.6% SR / 64.6 MS(超 DynamicWAM +19.4 pt);SimplerEnv-WidowX 84.4%;RoboDojo Score 26.03 / SR 19.15%(官方榜对比最优)。真机 6 任务平均 72.5%(π0.5 为 57.5%),去掉联合预训练掉到 46.7%(-25.8 pt)。消融:动作强迫/短期/长期记忆在三个基准累计 +3.92/+11.08/+6.57 pt;机器人+自我预训练在 Clean2Random 累计 +18.2 pt。部署:单次调用延迟 957.2ms 降至 103.9ms(9.21×),真机约 7Hz。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RoboTwin 2.0 全数据(50 任务,Clean+Randomized 训练) | 平均成功率 | 96.23%(Clean 96.16 / Randomized 96.30) | Kairos 96.05%(次优 MotuBrain 95.94%) | +0.18 pt,1 万次评测 |
| RoboTwin 2.0 Clean2Random(仅 50 条 Clean 示教训练) | 平均成功率 | 80.9%(Clean 88.3 / Randomized 73.4) | Qwen-RobotManip-Context 77.1%、OpenWAM-α 69.0% | 对比已报告最强 +3.8 pt |
| RoboCasa GR1 TableTop(24 任务,1000 示教/任务) | 成功率(1200 次) | 82.8% | 最强 WAM Long-WAM 78.7%、最强 VLA ACE-Ego-0 72.8% | +4.1 pt / +10.0 pt |
| RMBench(9 个双臂非马尔可夫任务,50 示教/任务) | 成功率 | 83.0% | MemoryWAM 83.0%(追平)、LingBot-VA 78.2%、π0.5 10.4% | 追平最优、超次优 +4.8 pt |
| DOMINO Level-1(35 个动态目标任务,RoboTwin 检查点零微调迁移) | 成功率 / 操作分数 MS | 57.6% / 64.6(Clean 59.1%,Randomized 56.1%) | DynamicWAM 38.2% / 53.2 | +19.4 pt SR / +11.4 MS |
| SimplerEnv-WidowX(4 个 Bridge 风格任务,BridgeData V2 微调) | 平均成功率 | 84.4%(勺子 95.8 / 胡萝卜 83.3 / 方块 91.7 / 茄子 66.7) | InternVLA-A1.5 80.8%、OA-WAM 79.3% | +3.6 pt(对比已报告最强) |
| RoboDojo(42 任务,Generalization/Precision/Long-Horizon/Memory/Open 五维) | 平均 Score / 成功率 | 26.03 / 19.15% | DM0.5 24.90 / 19.34%(官方榜 2026-10-09) | Score +1.13(SR 略低 0.19 pt,Memory 维度 31.35 显著领先) |
| 真机 6 任务(AgiBot G2 + ARX AC-1,每任务 20 次) | 平均成功率 | 72.5%(挂杯 85%、叠书入包 80%、分积木 80%) | π0.5 57.5%、LingBot-VA 39.2%、FastWAM 29.2%、Motus 10.8% | +15.0 pt;无联合预训练版本仅 46.7% |
局限与改进
作者承认的局限:真机套件中分类螺丝最难(55%),指出小零件精确分拣仍是挑战;扫描饮料任务 65%(虽远超 π0.5 的 5%),说明记忆依赖任务仍有失败模式;RoboDojo 的 Open 维度(未见任务规范迁移)Score 只有 2.50,是明显短板;DOMINO 随机化配置下 SR 从 59.1% 降到 56.1%。我的独立观察:其一,Table 2 的 ID/OOD 任务划分细节和 OOD 任务与 ID 任务的语义相似度未充分披露,视频迁移收益可能部分来自 OOD 任务与 ID 任务共享物体和技能原语;其二,OOD 视频若来自不同机器人本体,video-to-action 桥能否迁移并未单独测试;其三,自我中心手部到 46 维动作的映射是有损代理(每手仅 6 个弯曲槽、张开度由拇指尖与食中指尖距离估计),其增益(+3.5 pt)远小于机器人预训练(+14.7 pt);其四,多数基准是仿真,真机每任务仅 20 次试验、成功率在 55%~85% 间波动,置信区间较宽;其五,结构化后训练掩码在强记忆任务上要回退到预训练掩码,说明该设计尚非普适最优。
独立分析的弱点
(1)video-to-action 桥的跨本体迁移未验证:Table 2 的增益可能依赖 OOD 视频与 ID 动作数据来自同一形态的机器人。改进方向:构造跨本体的 OOD 视频实验,或在桥上引入本体嵌入条件化。(2)手部监督过于粗糙:6 个弯曲槽加单一张开度无法表达手指内收、对掌等精细运动,且"共享握合信号映射到各指槽"本身是近似标注,可能注入系统性标签噪声。改进:用 MANO 参数重定向到目标灵巧手的逆运动学求解关节角,或学习手-手对应模型。(3)动作强迫的组大小 $g$、双尺度记忆步长、后训练掩码切换都是手工超参,记忆任务要切回预训练掩码说明存在两个并存开关、机制不统一。改进:可学习的掩码路由或按任务元特征自动选择。(4)推理时视频 KV 复用是对联合去噪的近似,在需要精确视觉预判的动态拦截类任务(DOMINO)可能损失精度。改进:自适应同步步数 $n$,或蒸馏成少步一致性模型。(5)真机评估每任务仅 20 次且无置信区间,结论稳健性有限。改进:增加试验次数并报告 bootstrap 置信区间。(6)Open 维度接近零分说明对全新任务规范的组合泛化仍弱,可引入 VLM 任务分解做子任务级规划。
未来方向
作者明确提出的方向是把 video-to-action 桥扩展到更多任务、更少动作监督的场景。基于本文成果还可以延伸:(1)把稀疏动作监督进一步压缩为语言描述或仿真器自动验证,迈向"零演示"的任务接地;(2)在线精炼桥——部署中用成功/失败回放持续微调动作专家,形成数据飞轮,因为 Table 2 已显示极少量配对数据即可显著强化桥;(3)结合 VLM 任务分解,把长时程任务切成子任务序列后逐段做视频条件动作生成,补齐 RoboDojo Open 维度短板;(4)把视频专家当作现成的世界模型用于 rollout 评分与拒绝采样(Best-of-N),在推理时用"想象"筛选动作块;(5)放大自我中心人类视频的价值——目前仅 +3.5 pt,若提升手部映射保真度(如 MANO 重定向),剩余空间可观;(6)引入触觉、力觉等多模态条件,覆盖可变形物体和小零件操作等当前失败场景;(7)把统一 46 维动作空间扩展为可增插拔的槽位结构,适配更多本体而无需重设布局。
复现评估
论文有项目页(worldbridge-jd.github.io),但正文未明确承诺开放权重或数据处理代码,需关注后续发布。预训练门槛很高:64 卡 BF16、6 万步、有效批 1536,语料 338 万条目 / 22,321 小时(10 个机器人数据集 + 7 个自我中心数据集),其中 EgoStandard、AgiBotWorld2026、GenieSim 3.0、XDOF 等可能非完全公开,全量复现基本只有大型实验室可行。下游复现则分层来看较友好:若拿到预训练检查点,各基准微调成本温和(RoboTwin 2 万-6 万步、RoboCasa 16 卡 10 万步、SimplerEnv 在公开的 BridgeData V2 上 6 万步、RoboDojo 5 万步),评测协议均为公开基准且论文给出了评测规模(如 RoboTwin 每任务每场景 100 次、共 1 万次)。数据管线描述得相当具体——边界裁剪阈值 $10^{-4}$、FK 一致性公式、$\pm 15$ 帧状态-动作一致性搜索、极值检测的百分位规则——工程上可照抄实现。综合评级:完整预训练复现难度极高;基于开放检查点做下游微调或复现视频/动作监督消融(Table 2 类实验,只需单本体仿真数据)属于中等难度,值得尝试。
论文图表
累进消融:基线在 RoboTwin/RoboCasa/RoboDojo 为 91.28/67.50/14.50,加动作强迫升至 93.31/69.17/16.52,加短期记忆再升 0.67/5.16/0.38 pt,加长期记忆又升 1.22/4.25/4.17 pt,全配置达 95.20/78.58/21.07。
证明动作强迫和双尺度记忆各自的独立贡献,是方法组件设计的实证依据。