Glance:生成器即重排器 Glance: The Generator Is Its Own Reranker
给生成器加装轻量决策适配器,一次共享预填充同时完成重排与答案生成
前置知识
RAG 与重排流水线
检索增强生成先用检索器(如 BM25)从语料取回 top-k 候选段落,再用重排器精挑最相关的几段,最后把这些段落拼进上下文让 LLM 生成答案。重排质量直接决定生成器看到什么证据,进而影响答案质量。
本文要解决的核心问题就是『重排与生成能否合并进同一个模型』,理解这条流水线的成本结构是读懂动机的前提。
Cross-encoder 重排器
把『查询+段落』拼接成一个序列送入 Transformer 联合编码后输出相关性分数。因每对都要独立过一遍模型,质量高但需 k 次前向;典型代表 monoT5 与 bge-reranker-v2-m3,后者是本文全程基线。
所有对比都围绕『一次共享 prefill 能否替代 k 次独立编码』展开,必须知道基线的工作方式和成本(31–60 ms/查询)。
LoRA 低秩适配
冻结原权重 $W_0$,旁路训练低秩增量 $W_0 + BA$(秩 $r \ll d$),只训练极少量参数即可改变模型行为,且可随时挂载/卸载而不改动主干。本文决策适配器为 rank-16 LoRA,约 0.08 GiB。
Glance 实现『一个 backbone 承载多个决策技能、按请求热切换』全靠未合并的 LoRA;训练成本 39 分钟也源于只训适配器。
Prefill 与 KV cache
Transformer 推理分两阶段:prefill 一次性并行处理提示并缓存每层 K/V(即 KV cache),decode 阶段逐 token 生成并复用缓存。缓存可复制与分叉,使多个分支从同一前缀继续而无需重算前缀。
Glance 的计算节约本质是『段落只 prefill 一次,k 条探针从共享缓存分叉』;内存墙问题也来自每条分支复制缓存。
指针头与决策模式
在输入末尾放一个 <decide> 标记,取出该位置的隐状态,与每个选项末标记(如 </opt>)的隐状态比较后 softmax,得到选项概率分布;全程不生成文本,一次 prefill 即完成一次决策。
这是 Glance 给每个段落打相关性分数的具体机制:在 packed_all 里每个候选段落就是状态里的一个『选项』。
线性注意力与混合骨干
Gated DeltaNet 等线性注意力用固定大小的循环状态 $S_t$ 替代 $O(n^2)$ 注意力矩阵,代价随序列长度线性;混合骨干(本文 3:1 DeltaNet:全注意力)结合两者。线性层只有单一递归状态,分支隔离必须复制每层状态(含卷积窗口与 initial_state)。
论文骨干 MiMo-V2.6-Distill-Qwen-9B 就是混合 9B;不理解线性注意力就无法理解为何主流程要重新 prefill 而不能随意拼接缓存。
nDCG@10
排序质量指标:按模型排序的前 10 位计算折扣累积增益 $DCG=\sum_i \frac{2^{rel_i}-1}{\log_2(i+1)}$,再除以理想排序的 DCG 归一到 [0,1],越高越好。BEIR 评测的标准主指标。
论文所有检索实验(SciFact、NFCorpus)的数字比较全靠它;论文还提醒 n≈300 时低于 0.02 的差距只可视为提示性证据。
paired bootstrap 置信区间
对同一组查询上两个方法的成对差值进行重采样(本文 10,000 次)估计差值分布,给出 95% 置信区间;区间不含 0 说明差异在统计上可靠,可用于小样本(n=300)端到端对比。
论文最重要的端到端结论(Glance 上下文比 cross-encoder 上下文 F1 高 0.045)就是靠它证明不是噪声。
研究动机
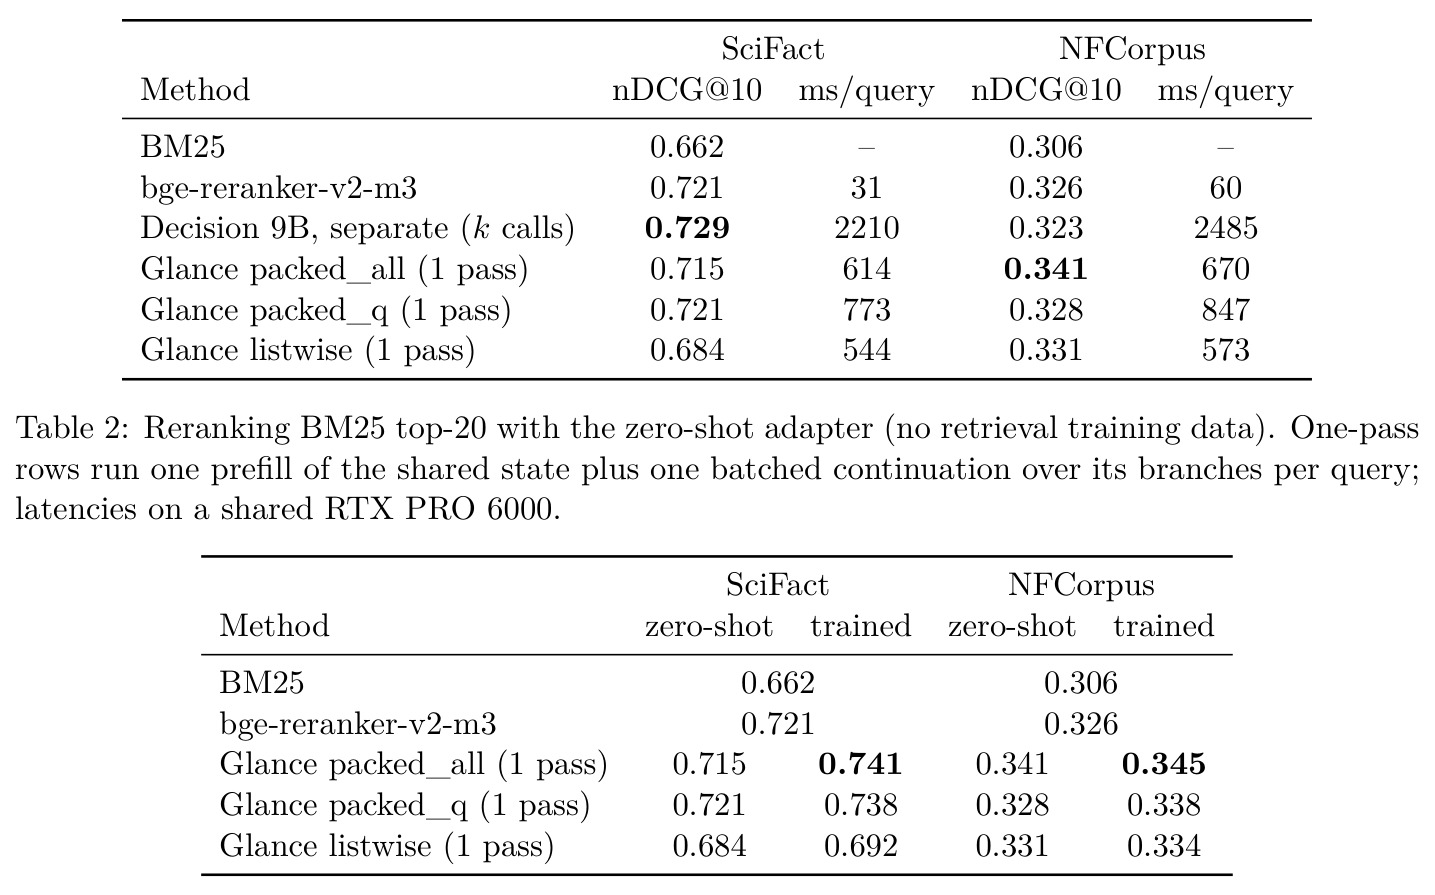
RAG 系统通常把证据筛选和答案生成拆给两个模型:cross-encoder 重排器(monoT5、bge-reranker 等)要把每个『查询–段落』对分别编码、分批处理;LLM 重排器(pointwise yes/no、listwise 排列生成)质量更高但成本更大。无论哪种,系统都必须额外驻留一个模型,并在生成器阅读之前预先处理全部候选段落。论文实测了这种冗余:同一个 9B 模型对 BM25 top-20 的 20 个段落逐一单独打分(sequential pointwise),SciFact 上每查询需 2210 ms,而专用 cross-encoder bge-reranker-v2-m3 只要 31 ms,但质量上限更低(0.721 vs 0.729 nDCG@10)。另一方面,长上下文模型仍会漏读位于长输入中部的证据(lost in the middle),候选多时重排依旧必要。于是核心问题浮现:这些段落生成器反正都要读,能否让它用跨段落共享的计算直接判断它们,从而省掉第二个模型和重复编码?
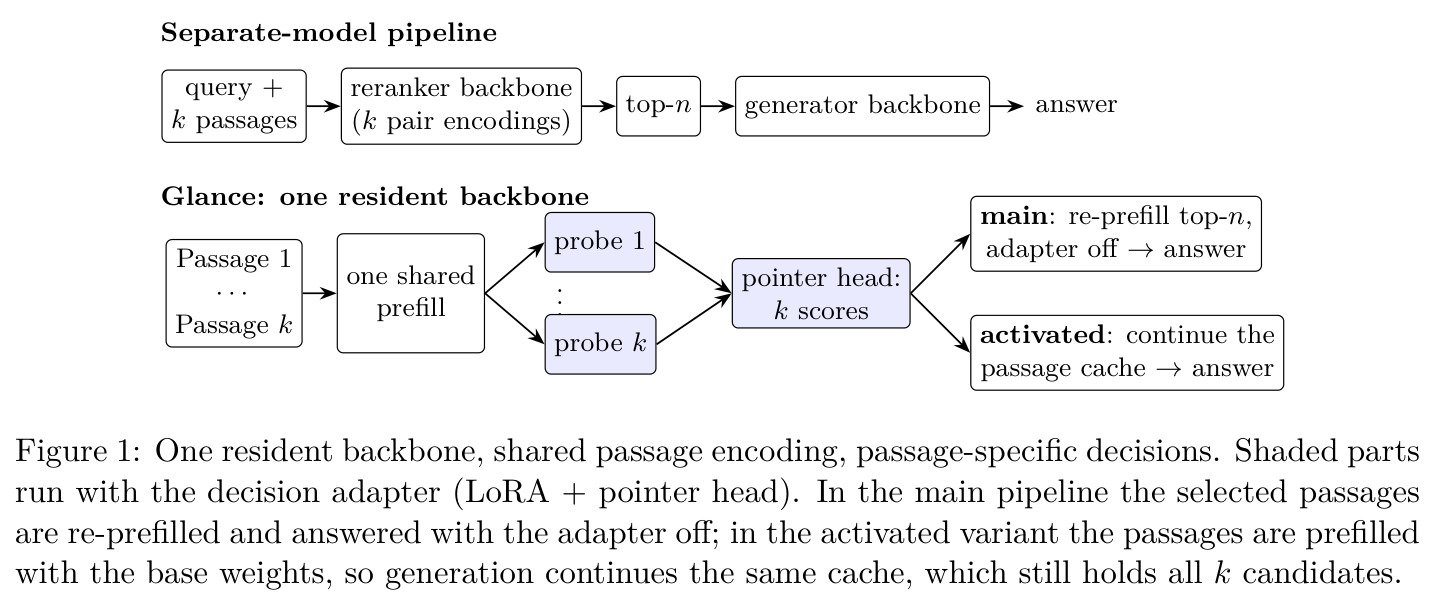
本文的目标是目标是把重排降格为生成器自身的一个轻量决策技能:在冻结的 9B backbone 上只加 rank-16 LoRA 决策适配器和一个 256 维指针头(每个技能约 0.1 GiB),从一次共享的候选段落 prefill 中为每个段落产出相关性分数,随后同一常驻 backbone 关闭适配器生成答案,彻底移除额外重排模型的驻留与重复编码。量化目标有三条:一,零样本(训练数据不含任何检索集)和 39 分钟 MS MARCO 微调后两种设定下,nDCG@10 与专用 cross-encoder 相当或更好;二,同一生成器使用 Glance 选出的上下文时,HotpotQA 答案 F1 显著高于使用 cross-encoder 上下文(paired bootstrap 95% CI 不含 0);三,单次共享 prefill 可扩展到 200 个候选约 43k token。附带目标:多个决策技能共享一个常驻 backbone,按请求切换且输出与单独加载逐位一致。
与已有工作不同的是,已有工作各有缺口:cross-encoder 逐对编码没有任何共享;LLM pointwise/listwise 重排器虽强但仍需额外模型常驻且成本更高;FIRST 从首个生成 token 的 logits 读排序、in-context reranking 用冻结模型的注意力启发式(不训练参数);Self-RAG 对每个段落各跑一遍判断;TurboRAG、CacheBlend、HyperRAG 复用文档侧缓存,但只为加速生成或 decoder 式重排,并没有把重排合并进生成器。Glance 的独特切入:在共享多段落上下文上,为每个候选段落接一条独立训练的短探针分支(从共享缓存末尾分叉、各约 30 token),由 256 维指针头读出 k 个段落专属分数——所有判断来自一次共享读取,而非注意力启发式或单一排列;同时借助 Kev 运行时的共享前缀路径,在 Gated DeltaNet 线性注意力层通过精确复制循环状态实现分支隔离,使方法在混合骨干上严格成立而非近似。
核心方法
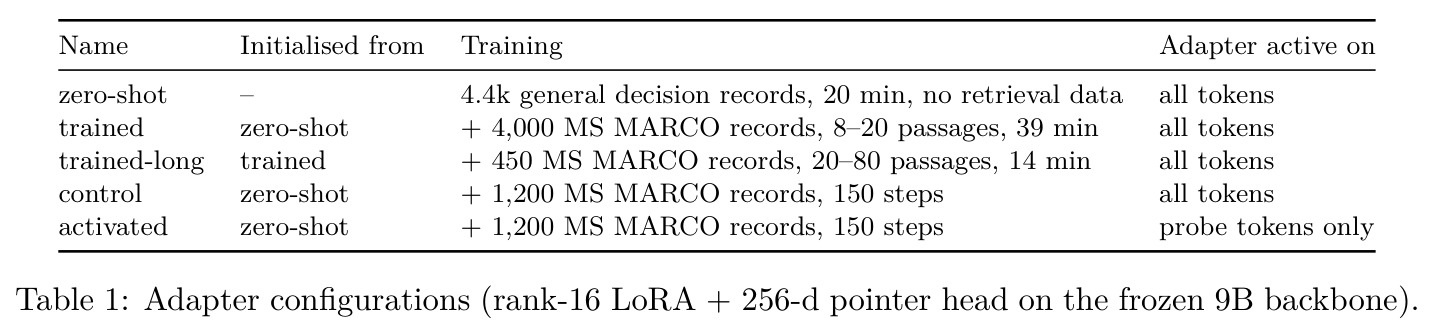
直觉很直接:生成器 prefill 时本来就要把候选段落全部读进 KV cache,理应『顺便』判断每段是否相关,而不必让第二个模型把每段重读一遍。技术路线分两个变体。主流程 Glance:决策适配器在所有 token 上激活——先把 k 个候选段落一次 prefill 成共享 state,再从缓存末尾分叉 k 条各约 30 token 的短探针分支(问句形如『第 i 段是否包含能回答或支持查询 q 的信息?』),256 维指针头把隐状态转成每段相关性分数;选出 top-n 后关闭适配器、用 chat 模板重新 prefill 这 n 段并生成答案。Glance-Activated 变体借鉴 Activated LoRA:适配器只在探针 token 上激活,段落 prefill 用基础权重完成,其缓存与基础模型逐位一致,因此生成可直接续用原缓存、不必重 prefill。训练极轻:仅 4000 条 MS MARCO 查询、1 epoch、39 分钟单张 B200,学习率 $5\times10^{-5}$(头 $10^{-4}$)、rank-16 LoRA、bf16,峰值 21 GiB。
核心创新是『段落专属探针 + 单次共享 prefill + 指针头读出』的组合。与 cross-encoder 相比,没有任何段落被编码两次;与 listwise(全部候选共用一个排列或一个 token)不同,每段有独立分支、独立分数;与 in-context reranking(冻结权重、注意力启发式)不同,这里有一个真正训练过的 decision LoRA 与可学习的 256 维指针头;与 Self-RAG(每段单独一遍)不同,所有判断出自同一次共享读取。packed_all 打包中每个探针能看到全部段落,因此具备跨段落比较能力——这解释了 NFCorpus 上一次打包 0.341 反超同一模型 20 次单独调用 0.323 的现象。工程上另一个关键点:骨干是 3:1 Gated DeltaNet/全注意力混合结构,线性注意力层只有单一递归状态、无法用注意力掩码隔离分支,Kev 共享前缀路径通过复制每层缓存(注意力 KV、卷积窗口、DeltaNet 的 initial_state)实现精确分支隔离,且训练与推理走同一条路径。
方法步骤详情
(1) 组装 packed_all 状态『[Passage 1] p1 … [Passage k] pk』,候选为 BM25 top-k(默认 20 段、每段 220 词);(2) 激活适配器的 9B backbone 一次 prefill 该状态得到各层缓存;(3) 从缓存末尾分叉 k 条约 30 token 探针分支:『Does Passage i contain information that answers or supports the query: q?』,分支互不可见、位置顺延;(4) 指针头比较分支末位置与段落末标记隐状态并 softmax,输出 k 个分数;(5) 取 top-n(HotpotQA 用 n=3);(6) 关闭适配器,用 chat 模板重 prefill 这 n 段(约 1.5k token:DeltaNet 状态不能任意拼接且原缓存由适配模型写出);(7) 贪心生成答案(至多 48 token)。训练:4000 条 MS MARCO 查询(Tevatron BM25 难负例),每条打包 1 正例加 7–19 难负例、每探针一个二元标签;1 epoch、500 步、55,598 个标注探针,rank-16 LoRA、batch 8、bf16,单张 B200 39 分钟、峰值 21 GiB。
技术新颖性
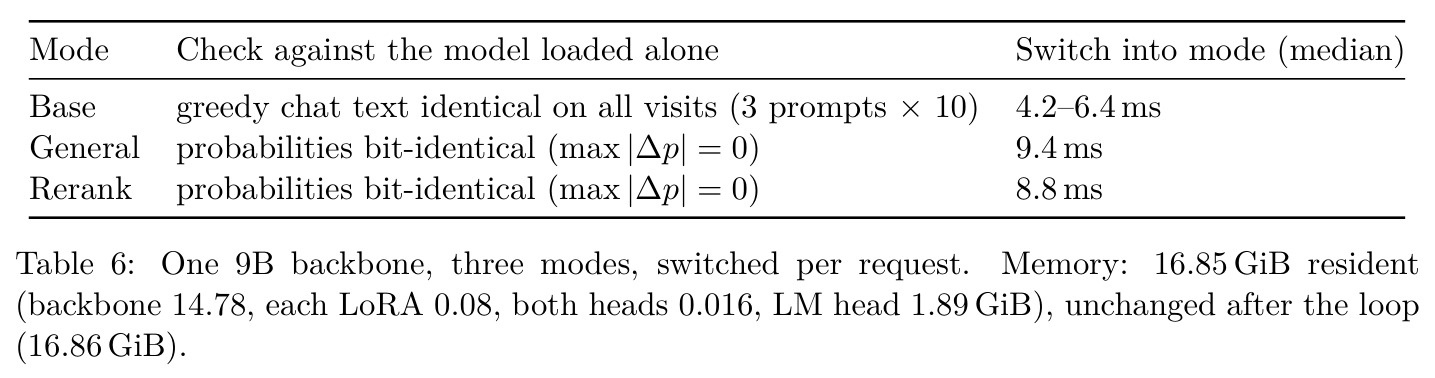
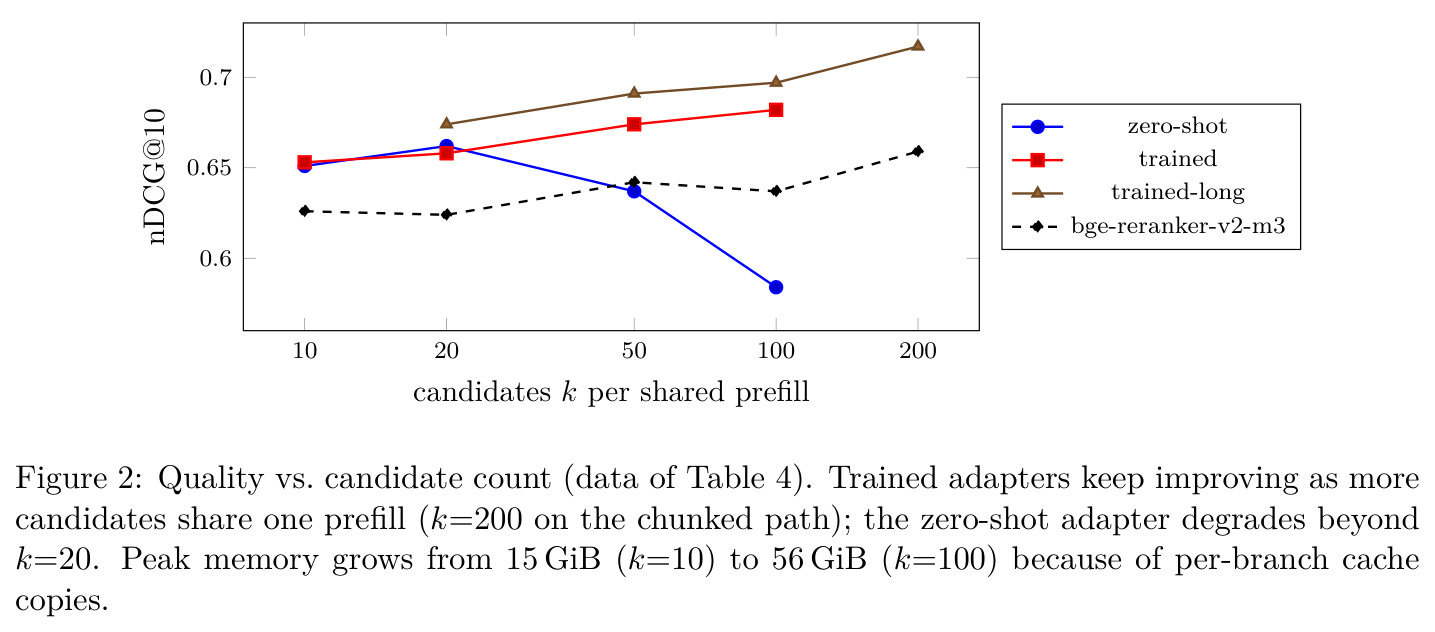
新颖性体现在四个层面。(1) 问题重构:把重排从『独立模型的任务』降格为『生成器 prefill 之上的轻量决策技能』,每技能约 0.1 GiB(LoRA 0.08 GiB + 指针头 0.016 GiB),实测按请求热切换中位数 2.8–11 ms 且概率逐位一致——这种服务形态在重排文献中是新的。(2) 结构设计:段落级探针分支加指针头,兼顾共享计算与独立评分;探针互可见带来的跨段比较能力是逐段 isolated 打分没有的。(3) 系统适配:在线性注意力骨干上以状态复制实现分支隔离;activated 变体把 LoRA 限制在探针 token(打补丁后 0.8B 模型检查 48 张量 max |Δ|=0,未打补丁为 8.18),使缓存续用成为可能。(4) 训练效率与结论:39 分钟、4000 条查询即超过专用 cross-encoder(0.741 vs 0.721 nDCG@10);缩放实验进一步证明大 k 下的退化是适配器欠训练所致(zero-shot k=100 时 0.584 vs trained 0.682)而非方法固有上限。
实验结果
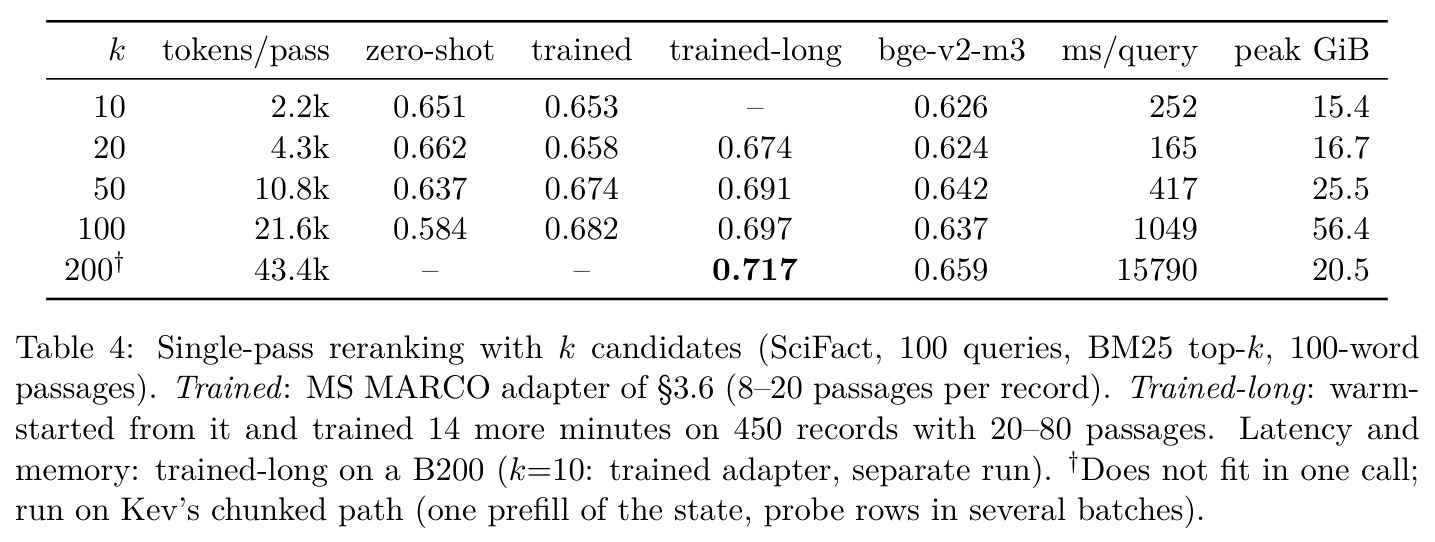
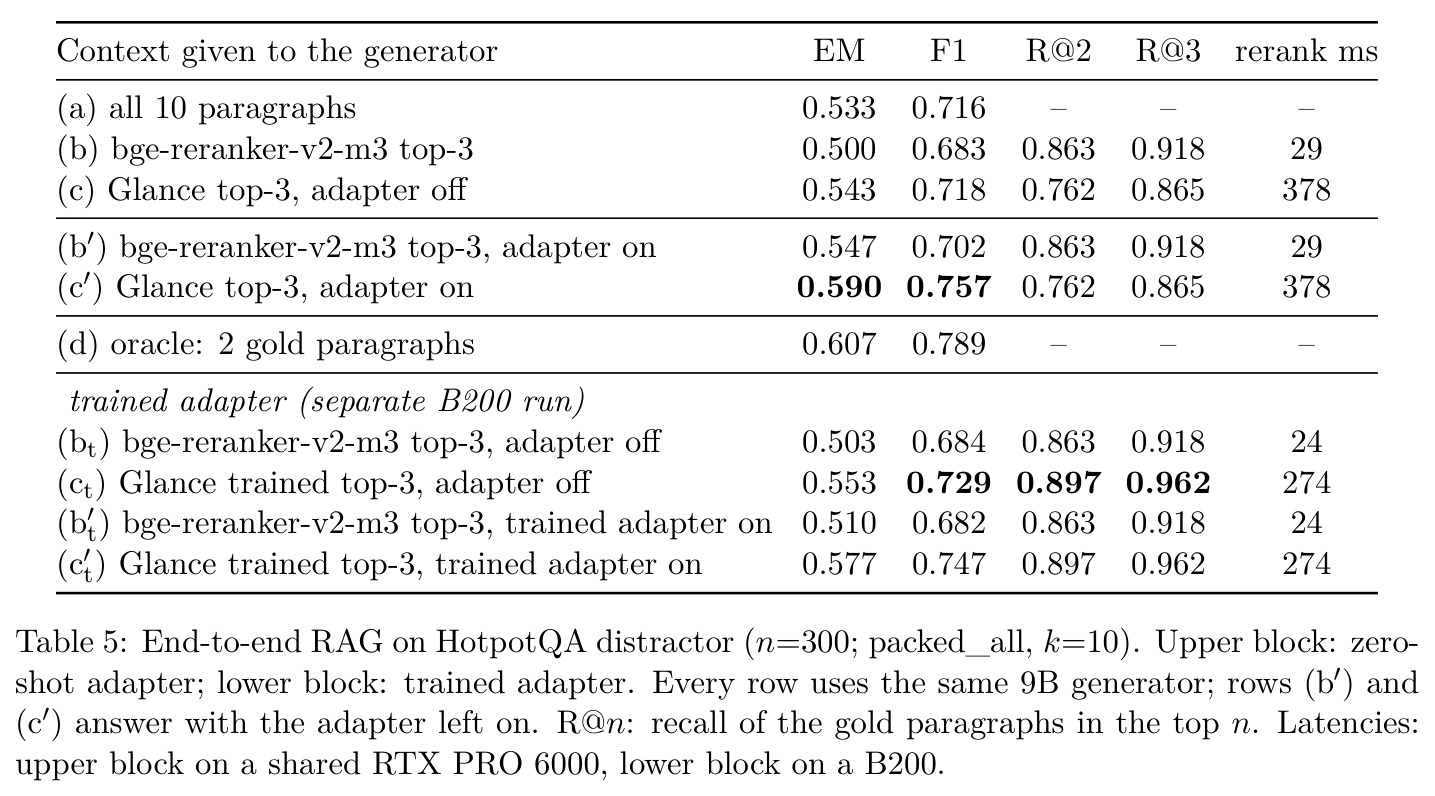
零样本(表2):packed_all 在 SciFact 0.715、614 ms/查询,为同模型 20 次单独调用(0.729、2210 ms)的 3.6 倍速,接近 bge 的 0.721;NFCorpus 上 0.341 全场最高,超 bge 0.326 与逐段调用 0.323,提速 3.7 倍。训练后(表3):packed_all 0.741/0.345(B200 延迟 420/411 ms),超 bge 0.020/0.019。缩放(表4):k=100 trained-long 0.697 vs bge 0.637,k=200(43.4k token)0.717 vs 0.659;零样本 k=100 退化至 0.584、k=200 崩至 0.505;内存 15.4→56.4 GiB。HotpotQA 300 题(表5):trained Glance R@2 0.897 超 bge 0.863,同生成器下 F1 0.729 vs 0.684(+0.045,95% CI [0.014,0.076]);adapter-on 差距 +0.065;零样本 adapter-on 0.757 距 oracle 0.789 仅 0.032。三模式(表6):16.85 GiB 常驻、切换 2.8–11 ms、概率逐位一致;JevBench 79.7%→75.8%。activated:0.740/0.351≈对照,续缓存 F1 0.750≈重 prefill 0.754,延迟 138 vs 181 ms。顺序敏感性:0.678–0.693、top-1 一致 91%。vLLM:概率差均值 0.006、Spearman 0.995、4/400 翻转、吞吐 1.54 vs 0.86 req/s。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BEIR SciFact 检索重排(BM25 top-20) | nDCG@10 | 0.741(Glance trained,packed_all,39 分钟 MS MARCO 训练) | bge-reranker-v2-m3 0.721;BM25 0.662 | +0.020 vs cross-encoder,+0.079 vs BM25 |
| BEIR NFCorpus 检索重排(BM25 top-20) | nDCG@10 | 0.345(trained packed_all);零样本即达 0.341 | bge-reranker-v2-m3 0.326;BM25 0.306;同模型逐段调用 0.323 | +0.019 vs cross-encoder,零样本即超基线 |
| HotpotQA distractor 端到端 RAG(n=300,top-3 上下文,adapter-off) | F1 / EM | 0.729 / 0.553(trained adapter) | bge-reranker-v2-m3 top-3:0.684 / 0.503 | +0.045 F1(paired bootstrap 95% CI [0.014, 0.076]) |
| HotpotQA 端到端(adapter-on,同一生成器) | F1 | 0.757(zero-shot adapter-on,Glance top-3) | cross-encoder top-3 + 同 adapter-on:0.702;oracle 2 金段 0.789 | +0.055(95% CI [0.018, 0.093]),距 oracle 仅 0.032 |
| SciFact 大候选池缩放(k=200,43.4k token 单次 prefill,100 查询) | nDCG@10 | 0.717(trained-long,分块路径 15.8 s/查询) | bge-reranker-v2-m3 同候选池 0.659 | +0.058;k=100 时 0.697 vs 0.637(+0.060) |
局限与改进
作者承认:这是概念验证,评估仅数百条查询,只有两个 BEIR 数据集加一个 QA 集(HotpotQA)、一个混合 9B 骨干家族;BEIR 差异未做显著性检验(n≈300 时低于 0.02 的差距只能视为提示);逐段落基线未用训练后适配器重跑;延迟来自未优化的 eager 路径和不同且部分共享的 GPU,cross-encoder 每查询仍更快(31–60 ms vs 约 400 ms);activated 与缓存续用为单种子、仅 100 题,位级检查用 0.8B 模型;续缓存时生成器看到全部段落而非重排子集。我的补充:内存随 k×上下文长度增长(k=100 即 56 GiB),单卡难扩展;查询间批处理反而降吞吐(B=16 从 2.87 降到 1.57 q/s、B=32 溢出);adapter-on 对答案风格有可测影响(答案均长 2.5 vs 3.1 词、F1 0.718→0.757),虽用配对行分离了选择与风格效应,机制仍未解释;零样本 R@2 更低(0.762 vs 0.863)却答案更好,说明分数与真实证据效用错位;JevBench 特化丢 9 题提示技能遗忘。
独立分析的弱点
(1) 内存墙:每条探针分支复制共享状态缓存,内存 $O(k\times\text{context})$,k=100 达 56.4 GiB,64 GiB 卡无法单次调用 k=200,只能走慢约 15 倍的分块路径(15.8 s/查询);改进方向是论文自提的块掩码共享缓存或按页共享前缀。(2) 延迟弱:训练后约 420 ms/查询,cross-encoder 仅 31–60 ms,延迟敏感场景不会切换;可只在候选池大或需效用对齐时启用,并用 CUDA graph、融合核压缩延迟。(3) 顺序与邻居效应:分数依赖段落顺序(每查询 std 0.020、单段最大概率变化 0.36);可多序平均(5 序平均 0.689)或训练时随机顺序。(4) 技能遗忘:重排特化使 JevBench 从 79.7% 降到 75.8%,丢的 9 题中 7 题在困难档;多适配器是绕过而非解决,应研究联合训练或正则化。(5) 证据面窄:两 BEIR 集一 QA 集、单骨干、部分单种子,泛化证据薄弱。(6) 标签错位:训练标签是段落相关性而非答案效用,零样本 R@2 更低(0.762 vs 0.863)却答案更好的机制不明,需效用对齐训练。
未来方向
作者提出的方向:(1) 用块掩码让所有分支共享一份缓存,把内存从 k×上下文降为线性,冲击 128k token 共享 prefill 的重排;(2) 在更多基准与骨干家族上验证收益;(3) 优化 serving——在 vLLM 引擎内导出读出位置并运行指针头的正式连接器,改变与小 cross-encoder 的延迟权衡。基于成果可延伸:(1) 把训练标签从段落相关性升级为答案效用(结合 REPLUG 式 LM 似然或 Self-RAG 式反馈),让分数直接对齐下游质量,解释并放大『低召回高 F1』现象;(2) 把 activated 变体的缓存续用扩展到大 k 并做多种子验证,使单次读取同时完成重排与生成成为默认路径(目前答案看到全部段落,重排未真正筛上下文);(3) 研究多技能共存的保持策略(弹性加权、适配器正交化)以消除 JevBench 上的遗忘;(4) 消除顺序效应后与 RankGPT 类 listwise LLM 重排器在 100+ 候选上正面对比;(5) 在生产 RAG 中刻画缓存续用与重 prefill 两条路径的质量-延迟 Pareto 前沿。
复现评估
复现条件较好。开源:Apache-2.0,三个 HuggingFace 仓库齐全——重排适配器(根目录为 trained-long,39 分钟检查点在 checkpoints/msmarco-short)位于 airun-ai/GlanceRAG-MiMo-9B-Reranker,activated 变体在 GlanceRAG-MiMo-9B-Reranker-Activated,通用决策适配器在 MiMo-V2.6-Distill-Qwen-9B-Decision,代码在重排仓库的 code/ 目录。数据全公开:MS MARCO、BEIR SciFact/NFCorpus、HotpotQA distractor、JevBench。算力:训练单张 B200 39 分钟(峰值 21 GiB),个人实验室可承受;推理 16.85 GiB 常驻即可三模式服务,24 GiB 消费卡可跑小 k 推理,但 k=100 峰值 56 GiB 需 A100/H100/B200 级,k=200 依赖 Kev 分块路径。难点:方法深度依赖 Kev 运行时的共享前缀实现(含 DeltaNet initial_state 复制)、activated 补丁与 vLLM 原型连接器,需精读代码;论文警告延迟来自共享 GPU,复现时必须重测、比例不可照搬。
论文图表
三种单次打包方式在 39 分钟 MS MARCO 训练前后的 nDCG@10 对比:packed_all 0.715→0.741(SciFact)、0.341→0.345(NFCorpus);packed_q 0.721→0.738、0.328→0.338;listwise 0.684→0.692、0.331→0.334;基线 BM25 0.662/0.306、bge-reranker 0.721/0.326。trained packed_all 在 B200 上延迟 420/411 ms。
量化极低成本训练的收益,并确认 packed_all 是训练后最优的打包方式——从零样本『接近基线』走向训练后『超过基线』结论的桥梁。