学习率调度或有失原则:权重归一化训练中的有效学习率调度 Your LR Schedule May Not Be Principled: Effective Learning Rate Scheduling in Weight-Normalized Training
有效学习率才是调度的原则性对象;据此导出的 AIR 仿射 1/√t 衰减全面优于余弦调度
前置知识
有效学习率(Effective Learning Rate, ELR)
ELR 定义为 $\eta_{\text{eff}} = \eta / r$,其中 $\eta$ 是优化器的名义学习率,$r = \|\theta\|$ 是参数块的欧氏范数。它衡量一次优化器更新对参数方向的实际改变比例:同样的名义 LR,若参数范数很大,则方向几乎不动;范数小则方向大幅旋转。附录 A.2 证明一阶意义下方向的改变量正比于 $\eta_{\text{eff}} u_\perp$($u_\perp$ 是更新中垂直于参数方向的分量)。
全文的核心主张就是“调度的原则性对象是 ELR 而非名义 LR”。不理解 ELR 的定义与几何含义,就无法理解为什么 WN 与 WD 在相同名义 LR 下动力学不同,也无法理解 AIR 调度设计的出发点。
权重归一化训练(Weight Normalization, WN)
每步更新后将参数块重新缩放到固定范数 $R$、只保留方向:$\theta_{k+1} = R\,\frac{\theta_k + \eta_k u_k}{\|\theta_k + \eta_k u_k\|}$(式 2)。它与解耦权重衰减(WD)相对:WD 在加更新前先收缩参数 $\theta_{k+1} = (1-\lambda\eta_k)\theta_k + \eta_k u_k$(式 1)。WN 下范数恒为 $R$,因此每块的 ELR 恰好等于 $\eta_k/R$,与名义 LR 严格成正比。
WN 的这个正比性质消除了 WD 中“改 LR 会同时改变后续范数”的耦合,使 ELR 可以被名义 LR 直接控制,是论文选择 WN 作为调度设计干净实验台的原因,也是所有理论推导的出发点。
余弦衰减与 WSD 调度
余弦衰减(cosine decay)是最常用的 LLM 预训练 LR 调度:warmup 后 LR 按 $\frac{1}{2}[1+\cos(\pi\tau)]$ 从峰值平滑降到终端值。WSD(warmup-stable-decay)是三段式调度:warmup 后保持 LR 恒定(stable 段),最后一段快速衰减(decay 段)。两者的差异在于中段 LR 的下降时机与形状。
论文用这两个调度揭示了核心谜题:同一 WN 算法在 cosine 下最终胜过 WD、在 WSD 下却全程落后(Figure 1)。理解这两种调度的形状差异,才能理解为什么它们的 ELR 诱导轨迹截然不同,从而引出 ELR 主导动力学的发现。
Muon 优化器与 MoE 架构
Muon 是一种基于 Newton–Schulz 正交化的优化器,将更新矩阵投影到正交化方向上,近年来与固定范数约束配合使用于 LLM 预训练。MoE(Mixture-of-Experts,混合专家)是稀疏激活架构:论文的小规模模型总参数 4.7B 但每 token 仅激活 110M 参数,大规模模型总参 35.7B、激活 790M,在等效计算量下扩大总容量。
论文的全部实验都在“Muon + WN + MoE”这一具体技术栈上进行(这代表了当前前沿的开源训练配方之一),知道这些组件的定位有助于判断结论的适用边界与复现所需的软件栈。
方向对齐与保留因子 H
论文把“训练进展”理想化为参数方向与某个固定理想方向 $v$ 的余弦对齐 $m_k = \mathbb{E}[v^\top\theta_k/R \mid \mathcal{F}_0]$。其演化满足 $\dot{m} = a\eta - b\eta^2 m$:LR 线性增加新对齐、二次回缩已有对齐。积分解中每项贡献被保留因子 $H(h,t) = \exp(-b\int_t^h \eta(s)^2 ds)$ 加权,表示 $t$ 时刻的对齐能存活到终点 $h$ 的比例。
$H$ 因子是理解本文两大结论的钥匙:无约束最优调度 $1/\sqrt{t}$ 由最大化对齐导出;共享后期调度时 $\Delta m(K) = H(K,K_s)\Delta m(K_s)$ 解释了“后期调度主导最终 loss”的现象。
研究动机
权重归一化(WN)训练正成为传统权重衰减(WD)的有力替代,已有工作报告它能带来更低的预训练 loss、更高的 token 效率、更好的稳定性与超参迁移性。但本文 Figure 1 揭示了一个令人困惑的事实:WN 与 WD 的相对优劣完全取决于 LR 调度。在余弦衰减下,WN 前期落后(10k–20k 步时 loss 更高)但约 29k 步后反超,最终取得更低 loss;而在 warmup-stable-decay(WSD)调度下,WN 全程落后,最终 loss 明显更高(约 1.80 对 WD 的 1.74 量级)。同一个优化算法、同一组超参,仅仅更换调度就结论反转,说明以往围绕“WN 本身是否更优”的争论没有触及本质。根源在 ELR:WN 固定参数范数(约 12000–16000 的全参数范数保持不变),使 ELR = η/r 在 WSD 的稳定阶段恒定于峰值约 1.5×10⁻⁷,loss 下降缓慢;而 WD 的参数范数持续增长,ELR 从峰值稳步跌落,loss 因此下降更快。也就是说,当参数范数随训练演化时,以名义 LR 为对象的调度设计理论失去了原则性依据。
本文的目标是本文的目标分三层递进。第一层是解释现象:回答“WN 何时、为何优于 WD”,把 Figure 1 中调度反转优劣的谜题归因到有效学习率 ELR = η/r 的轨迹差异上。第二层是确立原则:通过双向 ELR 匹配干预实验证明,只要 WN 与 WD 的 ELR 轨迹一致(无论通过重放范数还是逐块缩放 LR 实现),两者的训练 loss 曲线就基本重合,从而主张“原则性的调度设计应以 ELR 为目标,而非名义 LR 单独”。第三层是回答由此自然引出的设计问题——“更好的 ELR 调度应该长什么样”:在 WN 这个 ELR 与名义 LR 成正比的干净设定下,从最大化方向对齐的优化目标出发解析推导无约束最优衰减形状(1/√t),再通过仿射变换满足预设的峰值与终端 LR 以适配有限训练视界,得到可实践的 AIR 调度,最终在 128B token 的 MoE 预训练中验证其在训练 loss、下游性能与超参稳健性上全面优于余弦及其他十余个候选调度族。
与已有工作不同的是,以往 LR 调度理论全部聚焦名义 LR:river-valley 分析解释 WSD 的有效性,凸界与函数缩放律论证 cooldown 与幂律衰减——但当参数范数随训练演化时,这些以名义 LR 为对象的理论便不再原则化。与本文同时期的工作(其参考文献 17、34、38)也独立报告了“匹配 ELR 可使 WN 与 WD 的 loss 动力学重合”,与本文发现相互印证,但它们停留在经验观察层面,没有从任何优化目标出发推导出衰减律的形状。本文的独特切入有三点:其一,把 WN 选作 ELR 调度设计的“干净实验台”——因为 WN 下每块的 ELR 恰好等于名义 LR 除以固定范数 R,消除了 WD 中改 LR 会联动改变后续范数的耦合,使“设定 ELR 轨迹”成为一件直接可控的事;其二,将调度设计形式化为最大化与理想方向 v 的期望余弦对齐 m(h),通过配平方解析求出无约束最优调度 η*(t) = η₀/√(1+2bη₀²t),这是文献中首次从优化目标推导出衰减形状;其三,用保比例的仿射变换把无穷视界的理论最优转入有限视界工程,并给出“共享后期调度收缩早期差异”的理论刻画,将经验现象提升为可检验的机制。
核心方法
直觉上,一步更新对参数方向的改变量由 ELR = η/r 决定而非名义 LR:范数越大,同样的 LR 越难转动方向(附录 A.2 给出一阶关系 θ̂_{k+1} − θ̂_k = η_eff u_⊥ + O((λη + η_eff‖u‖)²))。因此调度的正确设计对象是 ELR 轨迹。技术路线分三步。第一步,干预实验:把 WN 的每块 ELR 逐步匹配到 WD——via norm 方式在每步把 WN 各块 rescale 到记录的 WD 范数;via LR 方式固定 WN 范数 R 并设 η_k^WN = R·η_k^WD/r_k^WD(式 4)——反向亦然,观察 loss 曲线是否重合。第二步,理论建模:在 WN 下假设固定范数 R、切向更新 θ_kᵀu_k = 0、‖u_k‖ = U,推导期望方向对齐 m_k = E[vᵀθ_k/R | F₀] 的精确递推 m_{k+1} = (m_k + aη_k)/√(1+2bη_k²),其中 a = E[vᵀu_k/R | F₀] > 0、b = U²/(2R²);二阶展开得连续近似 ODE ṁ(t) = aη(t) − bη(t)²m(t)。第三步,解析求最优并工程化:用积分因子解出 m(h) = m₀H(h,0) + a∫₀ʰ H(h,t)η(t)dt,配平方证明 m(h) ≤ √(m₀² + a²h/(2b)),取等当且仅当 m(t)η(t) = a/(2b),由此解出 1/√t 最优调度;再用仿射变换把它映射到预设峰值 LR p 与终端 LR η_min,得到 AIR:η_AIR(k) = η_min + (p−η_min)·f(k),f(k) = (q(k)−q(K))/(1−q(K)),q(k) = (1+k/α)^(−1/2)。
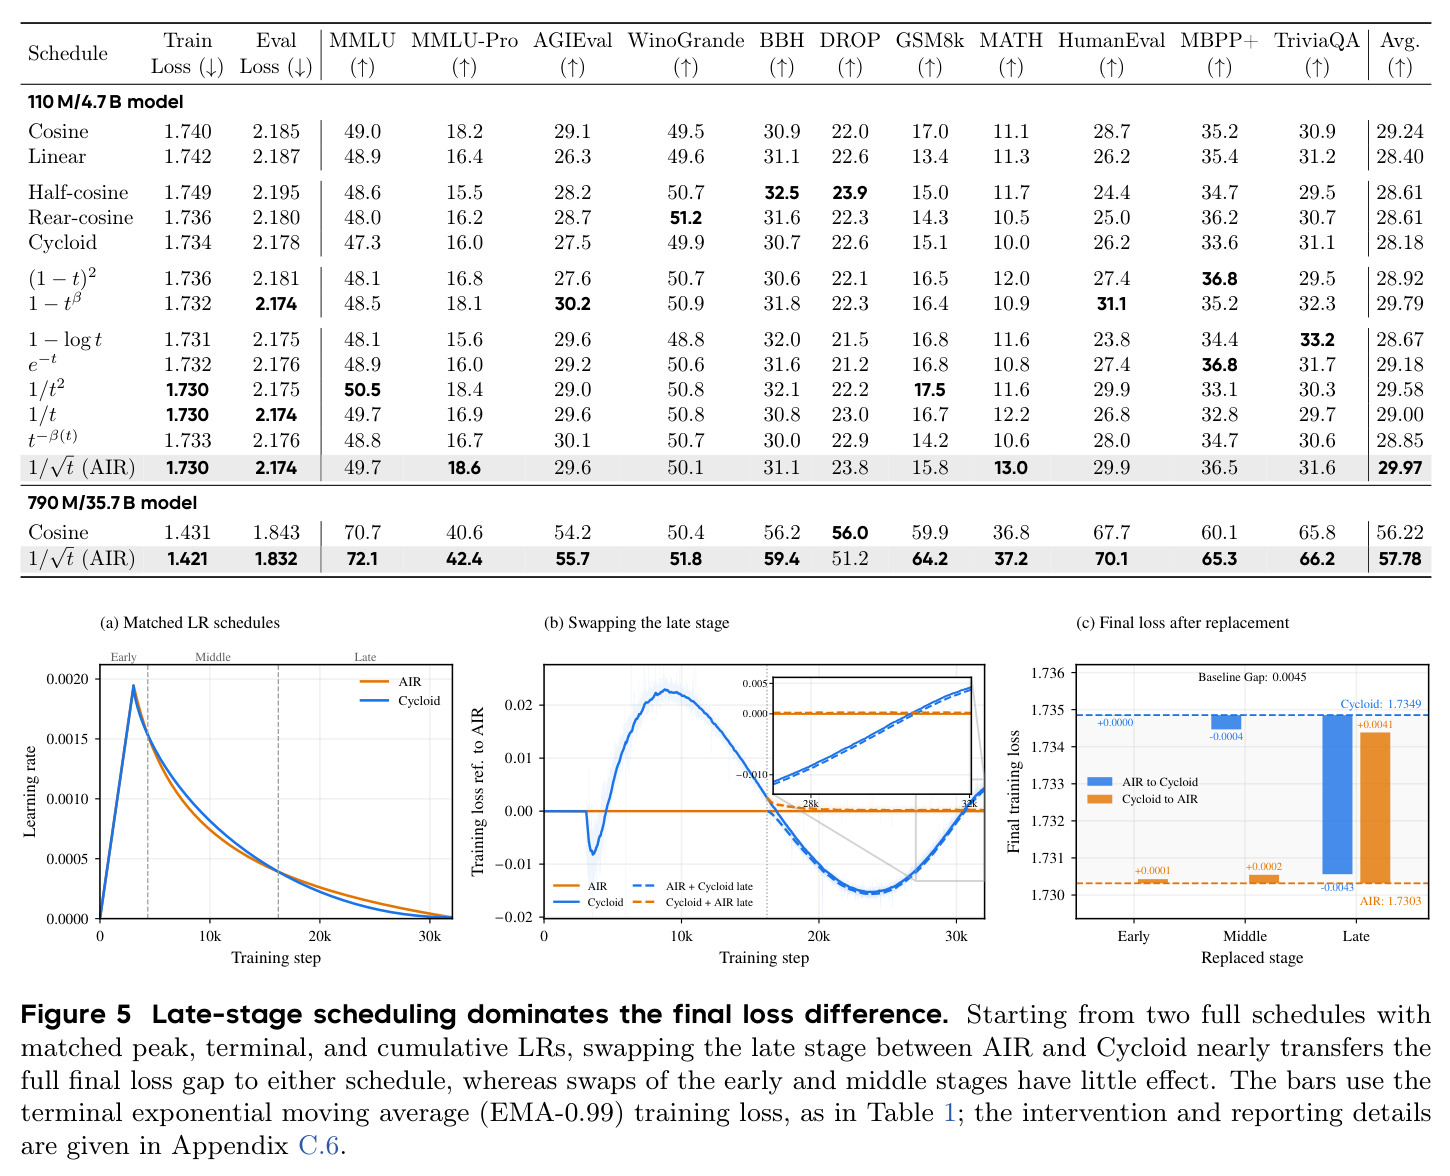
核心创新有两点,且都与已有方法有本质区别。其一,把调度设计的目标函数从“启发式衰减形状”换成“最大化方向对齐”。对齐动力学 ṁ = aη − bη²m 中 LR 具有双重作用:线性项 aη 增加新对齐,二次项 −bη²m 回缩已有对齐。配平方得 d(m²)/dt = a²/(2b) − 2b(mη − a/(2b))²,故每步都应满足乘积恒定 m(t)η(t) = a/(2b),立即解出 η*(t) = η₀/√(1+2bη₀²t)。该调度不仅最大化任意终点 h 的对齐,且在所有时刻同时最优,其整数采样在离散递推下也精确最优(附录 B.3 式 26)。这与以往从经验(cosine、WSD)或凸界/缩放律出发的设计有本质区别:形状是推导出来的而非试出来的。此外,无 weight decay 时参数范数增长会隐式产生 t^(−1/2) 的相对更新衰减——同一形状在两种机制下殊途同归。其二,“共享后期调度收缩早期差异”的理论刻画:若两个调度在 [Ks, K] 相同,则 Δm(K) = H(K,Ks)Δm(Ks),保留因子 H = exp(−b∫η²) ∈ (0,1] 严格收缩早期差异且不改变符号,从数学上解释了为什么后期调度主导最终 loss 差距——实验中交换后期阶段可关闭 AIR 与 Cycloid 之间约 90% 的 0.005 gap,与理论预测精确对应。
方法步骤详情
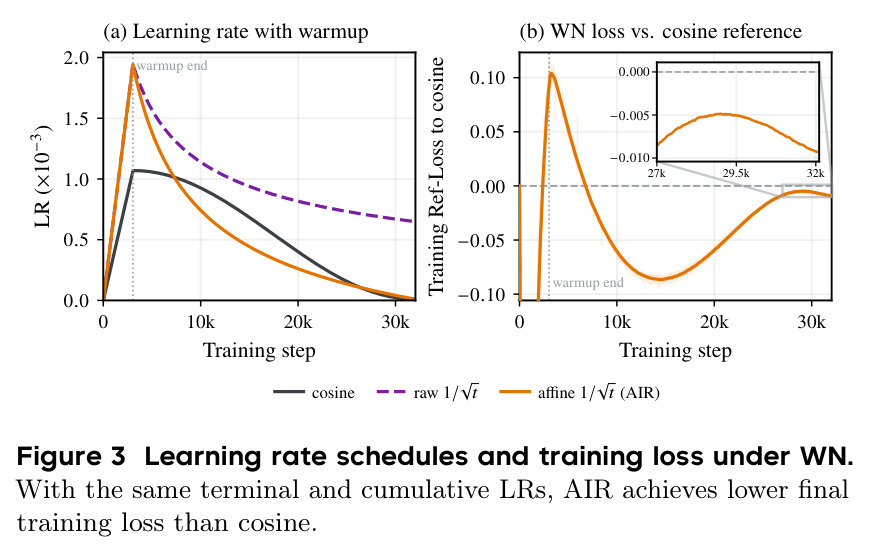
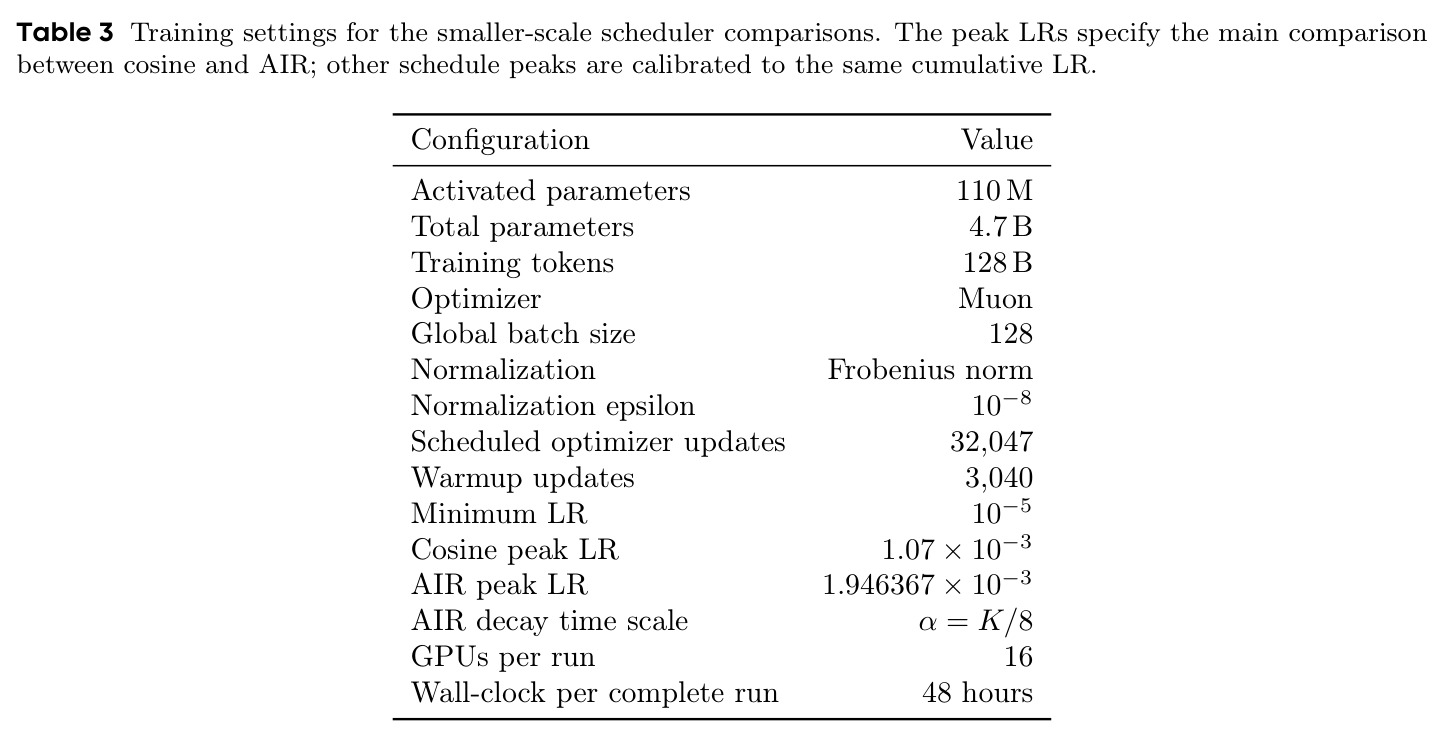
第一步(ELR 匹配验证,Section 2.2):在余弦与 AIR 两种调度下训练 WD 与 WN 基线;对 WN 采用两种匹配——via norm 在每步把 WN 各块 rescale 到记录的 WD 范数 r_k^WD、保留 WD 的名义 LR;via LR 固定 WN 范数 R 并按式 (4) 设 η_k^WN = R·η_k^WD/r_k^WD。反向匹配用式 (22):把 WD 名义 LR 乘上 r_k^WD/R 以复现 WN 的 ELR。结果:cosine 下 norm replay 使 WN 精确复现 WD 动力学(gap < 2×10⁻⁴),LR 匹配残差 gap 为数个 10⁻³;AIR 下反向匹配也逼近 WN 基线。第二步(动力学推导,Section 3.1):对与理想单位方向 v 的内积取条件期望,得精确递推 m_{k+1} = (m_k + aη_k)/√(1+2bη_k²)(式 6),二阶展开近似为 ODE ṁ = aη − bη²m(式 8),积分因子法解出 m(h) = m₀H(h,0) + a∫₀ʰ H(h,t)η(t)dt(式 9)。第三步(求最优,Section 3.2):配平方得 m(h)² ≤ m₀² + a²h/(2b),取等条件 m(t)η(t) = a/(2b) 给出时移最优调度 η*(t) = η₀/√(1+2bη₀²t)(式 11)。第四步(AIR 构造,Section 3.3):定义 q(k) = (1+k/α)^(−1/2),仿射映射 f(k) = (q(k)−q(K))/(1−q(K)),η_AIR(k) = η_min + (p−η_min)f(k)(式 12–13),主实验取 α = K/8;给定 LR 预算而非峰值时,用式 (29) 从含 warmup 的离散 LR 总和反解峰值 p。第五步(公平比较,Section 4.1):所有调度共享相同 warmup(3,040 步)、终端 LR(10⁻⁵)与累积 LR,峰值经校准(cosine 1.07×10⁻³,AIR 1.946367×10⁻³),110M 激活/4.7B 总参 MoE 训 32,047 步(128B tokens),Muon + Frobenius 范数 WN。
技术新颖性
技术新颖性体现在四个方面。第一,对象转移:首次明确提出并系统验证“ELR 而非名义 LR 是调度的原则性对象”,并用双向匹配的干预实验(norm replay 下 gap < 2×10⁻⁴)给出因果证据,而非停留在相关性描述;与同时期独立报告相似现象的工作相比,本文额外给出了从目标函数到衰减律的推导。第二,解析最优形状:现有调度理论只能论证某族形状“还不错”,本文则在明确的方向对齐目标下证明 1/√t 全局最优且在所有时刻同时最优,并给出离散版本的精确最优性;还指出无 weight decay 时范数增长会隐式产生同样的 t^(−1/2) 相对更新衰减,两处殊途同归增强了形状的可信度。第三,仿射适配:式 (12)–(13) 的构造在满足预设峰值/终端值的同时保持衰减速率的相对比例(式 28 证明每段 LR 降幅占比不变),把无穷视界的理论最优无缝转入有限视界工程,并配有从 LR 预算反解峰值的闭式公式(式 29)。第四,阶段分解理论:式 (15)–(17) 用保留因子 H 定量刻画“共享尾部收缩早期差异、越靠近终点的 LR 差异权重越大”,并给出斜率 refinement(附录 D.4)与无穷小敏感性核(D.6),使“后期调度重要”从经验观察升级为可定量预测、可被干预实验检验的机制。
实验结果
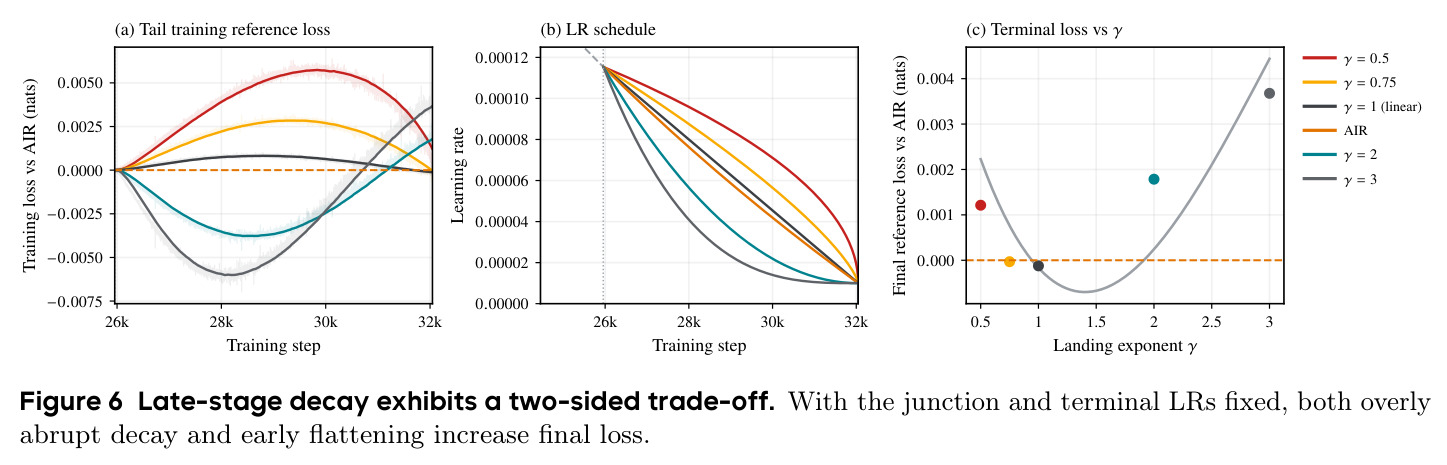
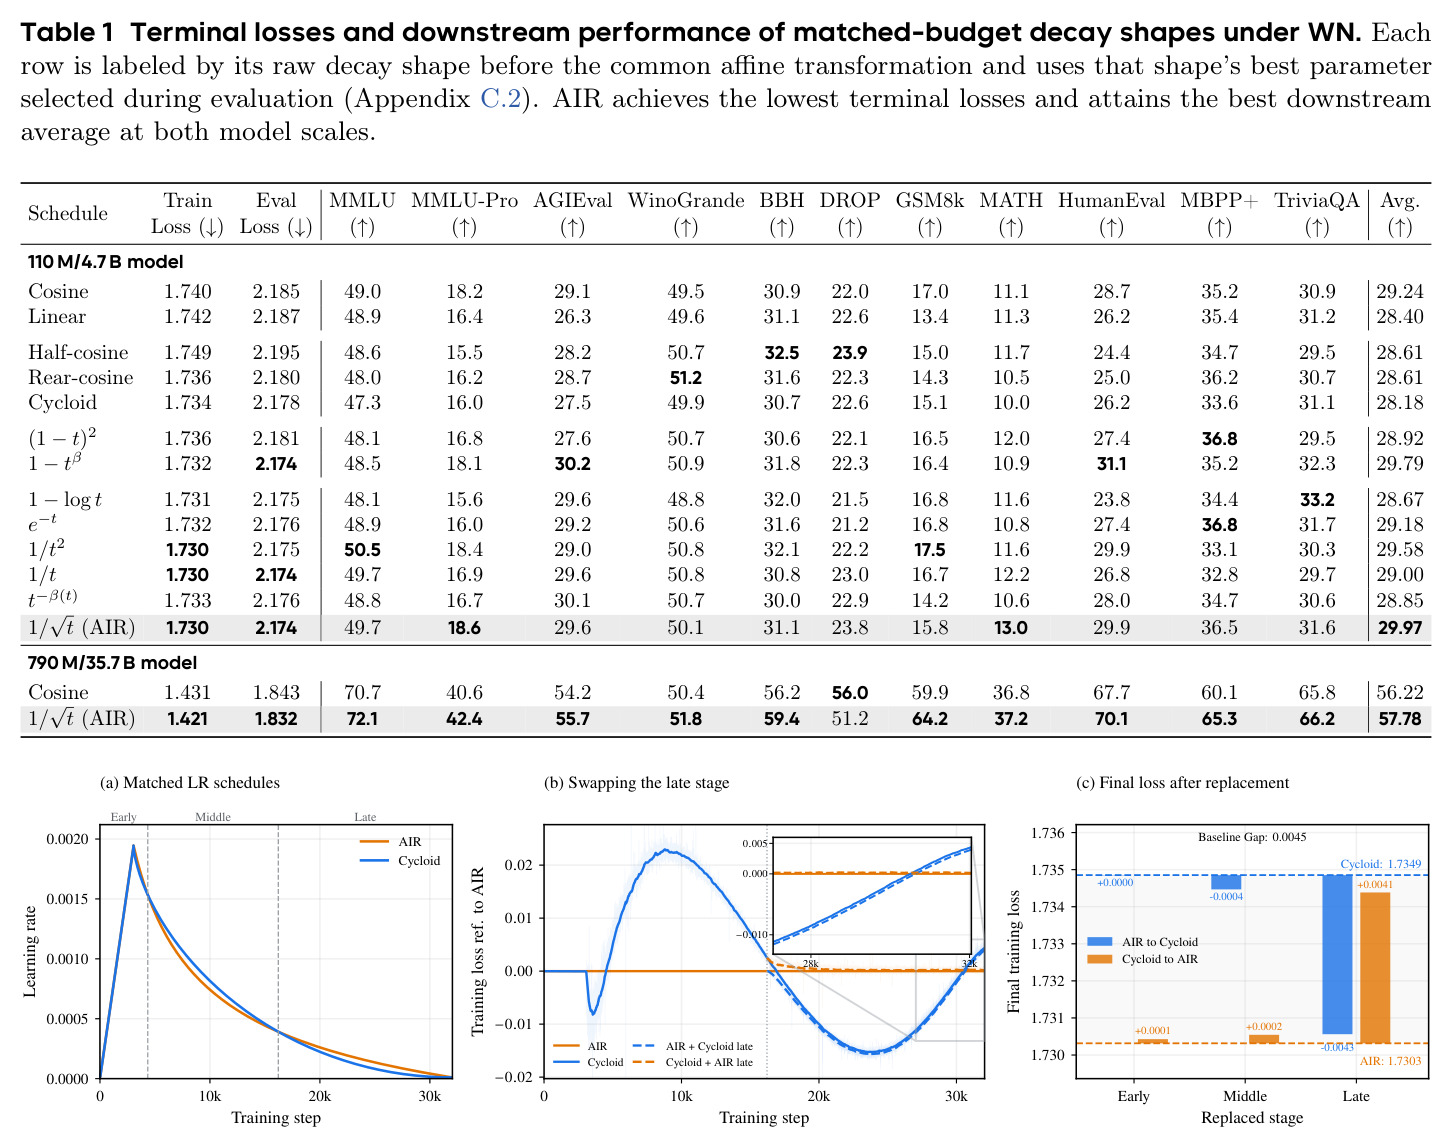
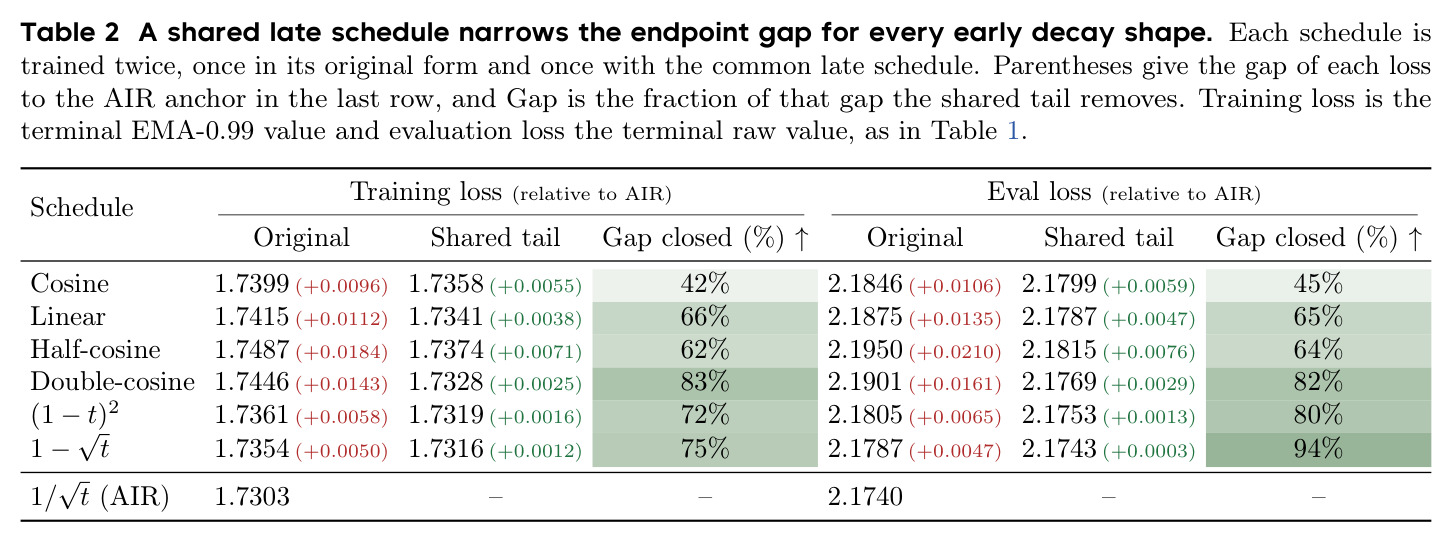
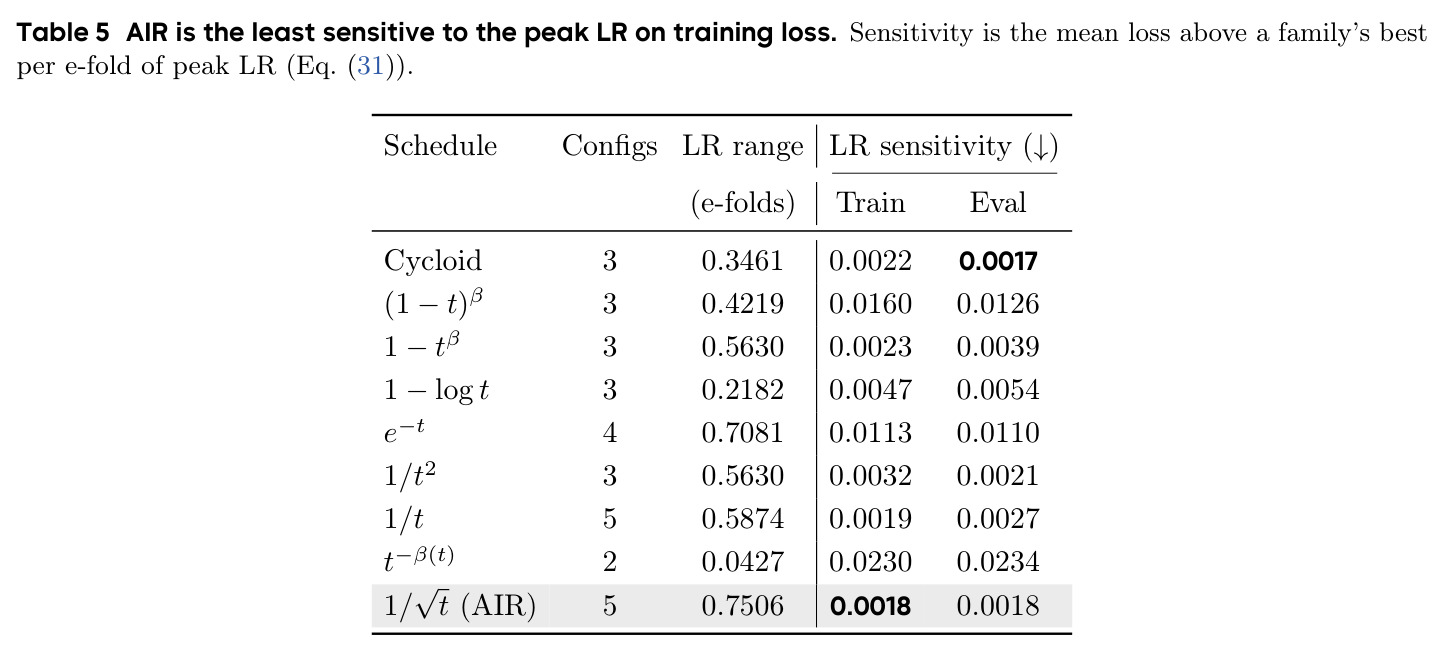
(1)ELR 匹配实验(Figure 2):余弦调度下,via norm 重放使 WN 精确复现 WD 的 loss 动力学(gap < 2×10⁻⁴),via LR 匹配也紧贴 WD 基线(残差 gap 数个 10⁻³);反向把 WD 的 ELR 匹配到 WN 时,在余弦与 AIR 下都逼近 WN 基线。这证明 ELR 轨迹是 loss 动力学的关键驱动,而非归一化本身。(2)主实验(Figure 3、Table 1):110M 激活/4.7B 总参 MoE、128B tokens、Muon+WN 下,AIR 终端训练 loss 1.730、eval loss 2.174,均低于 cosine 的 1.740/2.185(约 −0.01),且是 14 个对比形状中最低的;下游 11 项基准平均 29.97 亦为最高(cosine 29.24,次优 1−t^β 为 29.79)。(3)规模扩展(Table 1 底部):790M 激活/35.7B 总参、500B tokens 时,AIR train/eval loss 1.421/1.832 对 cosine 1.431/1.843,下游平均 57.78 对 56.22,且在 MMLU(72.1 对 70.7)、MMLU-Pro(42.4 对 40.6)、AGIEval(55.7 对 54.2)、BBH(59.4 对 56.2)、GSM8k(64.2 对 59.9)、HumanEval(70.1 对 67.7)、MBPP+(65.3 对 60.1)等多数基准上占优,DROP 是例外(51.2 对 56.0)。(4)超参稳健性(Figure 4、Table 5):AIR 的峰值 LR 敏感性 S 最低(train 0.0018 / eval 0.0018),且其低 loss 区覆盖 0.7506 e-folds 的扫描跨度,为所有家族最宽,说明增益不依赖精调峰值、利于 LR 迁移。(5)后期调度主导(Figure 5、Table 2):AIR 与同峰值/终端/累积 LR 的 Cycloid(θ₁=π) 最终 loss 相差约 0.005,仅交换后期阶段即可为任一方关闭约 90% 的差距(+0.0041 / −0.0043),而交换早/中期仅 ±0.0001–0.0002;让六个形状共用 AIR 的后期调度(前 70% 保持原形状)能关闭各自与 AIR 差距的 42%–83%(train)/ 45%–94%(eval)。(6)尾部权衡(Figure 6):固定接点与终端 LR 后,γ=0.5 的骤降与 γ∈{2,3} 的过早变平都推高最终 loss,γ∈{0.75, 1} 与 AIR 相当,揭示“持续退火但避免突变”的两难,AIR 自然处于平衡点。
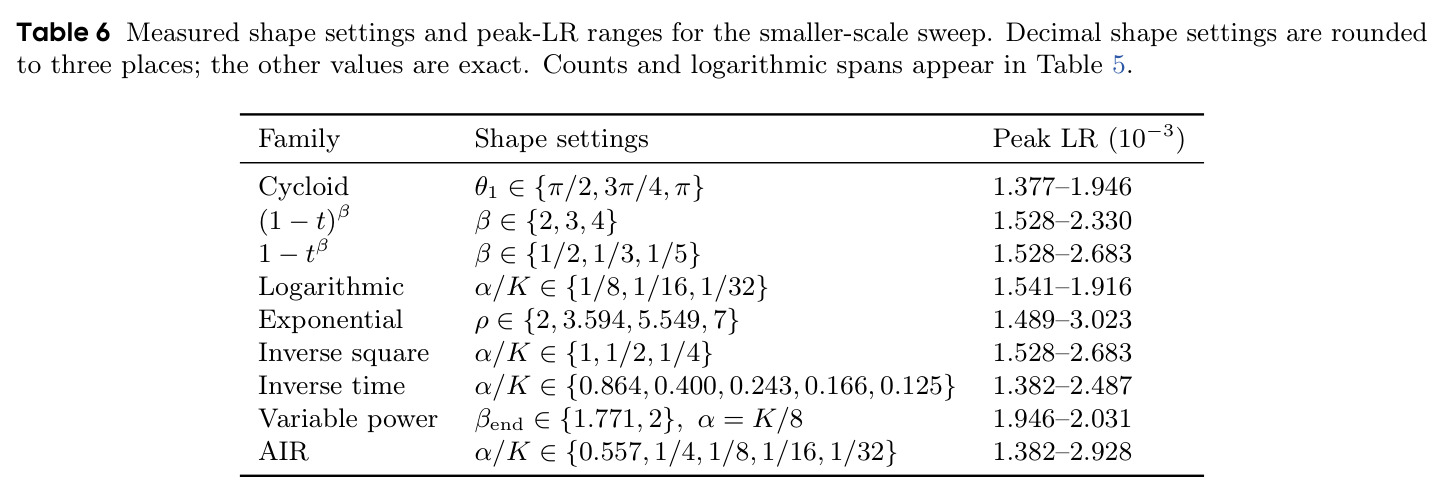
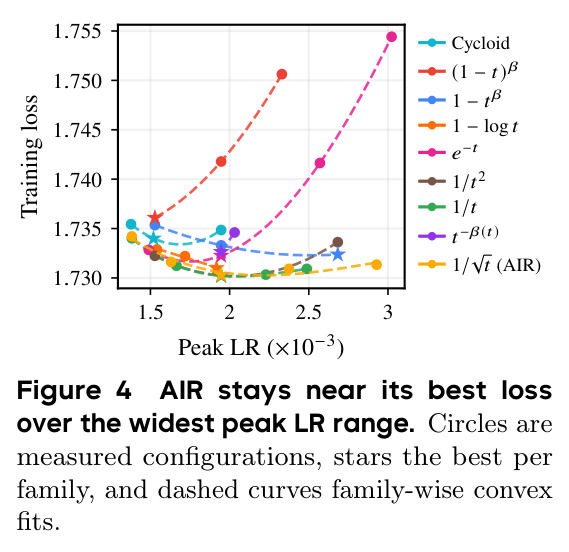
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MoE 预训练(110M 激活/4.7B 总参, 128B tokens, Muon+WN) | 终端训练 loss | 1.730(AIR) | 1.740(cosine) | 约 −0.010 |
| MoE 预训练(110M/4.7B, 128B tokens) | 终端 eval loss | 2.174(AIR) | 2.185(cosine) | 约 −0.011 |
| 大规模 MoE 预训练(790M 激活/35.7B 总参, 500B tokens) | 终端训练 loss | 1.421(AIR) | 1.431(cosine) | 约 −0.010 |
| 下游 11 项基准平均(小规模 110M/4.7B) | 平均准确率 | 29.97(AIR) | 29.24(cosine) | +0.73 |
| 下游 11 项基准平均(大规模 790M/35.7B) | 平均准确率 | 57.78(AIR) | 56.22(cosine) | +1.56 |
| 峰值 LR 稳健性(8 个调度族扫描) | LR 敏感性 S(每 e-fold 峰值 LR 的平均 train loss 劣化,越低越好) | 0.0018(AIR) | 0.0019(1/t,次优)至 0.0230(t^(−β(t))) | 全场最低且扫描跨度最宽(0.7506 e-folds) |
| 后期阶段交换(AIR vs Cycloid θ₁=π,同峰值/终端/累积 LR) | 交换后期阶段可关闭的最终 loss 差距比例 | 约 90%(AIR→Cycloid +0.0041,Cycloid→AIR −0.0043) | 交换早/中期阶段仅 ±0.0001–0.0002 | 后期阶段解释了几乎全部 0.005 差距 |
局限与改进
作者承认的限制:理论建立在常数系数 a、b、固定切向更新幅度 ‖u‖ = U、小步长条件 2bη² ≪ 1 等理想化假设上,且几何可解释性要求 m² + a²/(2b) ≤ 1(附录 B.4),因此理论只在“对齐可实现”的区间内有效,且尚未定量连接对齐与 loss;实验仅覆盖 Muon 优化器 + Frobenius 范数 WN,最高规模为 35.7B 总参/500B tokens,未及前沿 LLM 规模;所有 loss 报告为单次运行的终端 EMA-0.99 值而非多 seed 平均,缺少方差与显著性信息。我自己的观察:AIR 峰值 LR(1.946×10⁻³)几乎是 cosine(1.07×10⁻³)的两倍,实践者从 cosine 迁移必须重新校准累积 LR,论文虽给出式 (29) 的反解公式,但校准本身需要额外搜索成本;α = K/8 的选择依赖经验,最优点可能随模型/数据规模变化;大规模下 DROP 反而下降 4.8 分(51.2 对 56.0),说明收益在任务间不均匀,某些依赖知识记忆的任务可能受损;此外全文的 WD 对照只做 ELR 轨迹复现(需重放范数或逐块改 LR),未系统探索 WD 下直接实施目标 ELR 轨迹的工程方案,而 WD 中名义 LR 与范数耦合,实际部署远比 WN 复杂。
独立分析的弱点
弱点一:理论-现实 gap。常系数 a、b 的假设忽略了更新统计量随训练的演化(梯度噪声谱变化、Muon 正交化后 U 并非常数),1/√t 的最优性只在该模型内成立;改进方向是把 a、b 建为可在线估计的时变量,推导自适应调度 η(t) ∝ a(t)/(b(t)m(t)),让调度随训练状态自校准。弱点二:峰值大幅上移的迁移成本。AIR 需要约 1.95×10⁻³ 的峰值(对 cosine 的 1.07×10⁻³)才能在匹配累积 LR 下发挥优势;若用户沿用 cosine 的峰值而不重校准,可能既破坏累积 LR 匹配又得不到增益。改进方向是给出“cosine 超参 → AIR 超参”的换算规则或自动校准工具。弱点三:规模外推未验证。790M 激活/35.7B 总参、500B tokens 的结论能否外推到百亿级激活、数万亿 tokens 的训练未知,尤其“后期调度主导”现象可能与训练总时长和进入稳态的时机相关;改进方向是在不同 horizon(延长/截断训练)下测试 α = K/8 的鲁棒性,并寻求更大规模验证。弱点四:收益的任务不均匀性。大规模下 DROP 从 56.0 降至 51.2(−4.8),提示 1/√t 后期退火可能不利于某些知识密集任务;改进方向是按任务类别分析 ELR 轨迹与能力涌现的关系,必要时采用混合调度。弱点五:统计严谨性。所有比较基于单次运行的终端 EMA 值,0.01 量级的 loss 差异可能部分来自随机波动;改进方向是报告 2–3 个 seed 的均值±标准差并做显著性检验,这也是让后续工作可信对比的前提。
未来方向
作者明确列出的方向:(1)扩展方向对齐理论以纳入演化的更新统计,并定量建立“对齐—loss”的联系,使理论能预测数值而非只解释符号与趋势;(2)在更多架构、优化器(如 AdamW)与更大训练规模上检验 ELR 原则与 AIR;(3)研究持续训练(CT)、监督微调(SFT)与强化学习(RL)中的 ELR 调度——这些场景参数范数动态与预训练不同,名义 LR 调度同样缺乏原则。基于本文成果可自然延伸的方向:(4)利用保留因子 H(K,Ks) = exp(−b∫η²) 处理训练中途改预算的场景(如“训到平台再决定延长”),为 horizon 不确定的真实项目给出调度修正规则;(5)把 ELR 原则与 μP 类超参迁移框架结合,研究是否存在跨规模不变的目标 ELR 轨迹;(6)在多阶段训练(预训练→退火→长上下文扩展)中把每阶段的 ELR 预算作为统一接口做全局优化;(7)将无穷小敏感性核 δm(K) = ∫H(K,k)(a−2bηm)δη(k)dk(附录 D.6)发展为调度设计的变分工具,回答“LR 预算应该花在训练的哪个阶段最划算”;(8)为 WD 设计范数反馈控制器以直接实施目标 ELR 轨迹,把“WN 证明了 ELR 有效”转化为 WD 上的实用方法。
复现评估
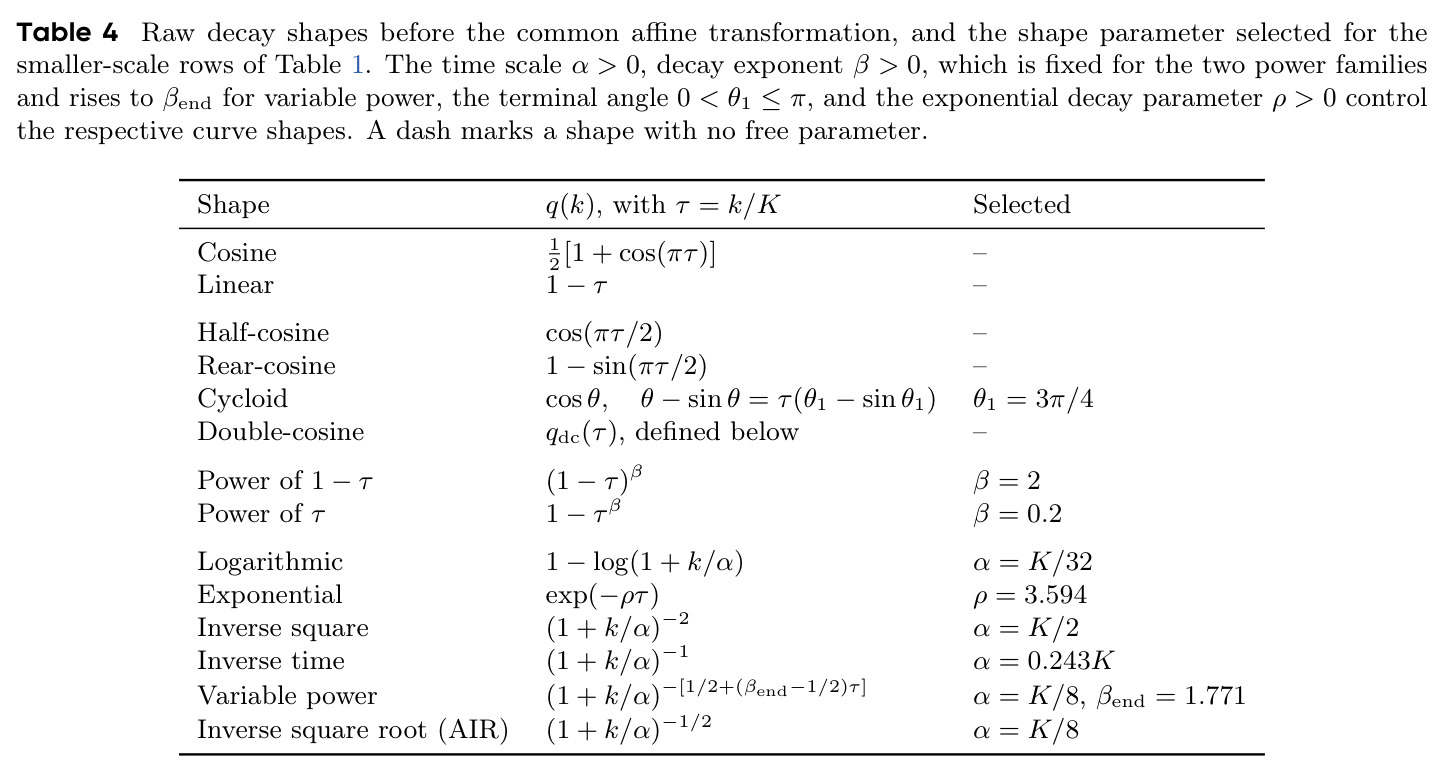
复现条件评估:论文正文与附录均未给出开源代码或权重链接,需自行实现。好在核心公式极简——AIR 只需式 (12)–(13) 约 10 行代码,且关键工程细节都写在附录:峰值校准的离散 LR 和公式(B.6 式 29)、终端 loss 的 EMA-0.99 约定(C.3 式 30,对最后 100 个日志点做 z_j = 0.99z_{j−1} + 0.01x_j 递推)、14 种衰减形状的精确定义与评测选定参数(C.2 Table 4:如指数 ρ = 3.594、Cycloid θ₁ = 3π/4、可变功率 β_end = 1.771、AIR α = K/8)。数据与模型:需要 128B/500B tokens 的预训练语料、MoE 实现(110M/4.7B 与 790M/35.7B 两种规模)、Muon 优化器与 Frobenius 范数 WN(ε = 10⁻⁸)。算力:单个完整小规模运行需 16 GPU × 48 小时(约 768 GPU·时),大规模需 32 GPU × 168 小时(约 5,376 GPU·时);完整复现 Table 1、2、5 及阶段交换实验共 40+ 次运行,估计需要数千至上万 GPU·时。难度评级中等偏高:公式实现容易,但公平复现要求精确执行累积 LR 匹配、日志步对齐与 batch-size ramp 约定;单 seed 报告使复现者难以判断 0.01 量级差异是否落在自己实现的噪声带内。建议先在小规模(如 1B tokens)复现 Figure 1 的 ELR 定性差异与 Figure 5 的阶段交换效应,再投入全量算力验证 AIR。
论文图表
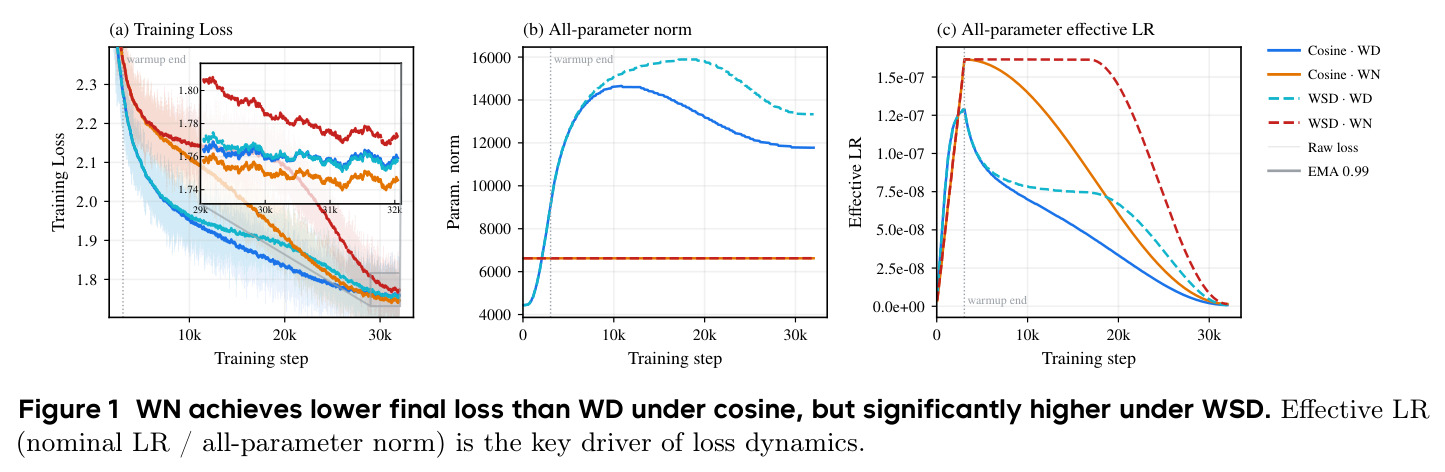
三联图。(a) 训练 loss:cosine 下 WN 初期落后但约 29k 步后反超 WD 并以更低 loss 收尾;WSD 下 WN 全程落后,终局 loss 明显更高。(b) 全参数范数:WD 的范数从约 4,000 持续增长到约 14,000,WN 固定不变。(c) 全参数有效 LR(名义 LR / 全参数范数):WSD 的 stable 段中 WN 的 ELR 恒定在峰值约 1.5×10⁻⁷,而 WD 因范数增长使 ELR 持续下滑。
一图道破全文动机:调度选择会反转 WN/WD 的优劣,而 (c) 直观显示两者的 ELR 轨迹差异正是原因,是后续所有理论论证的经验起点。
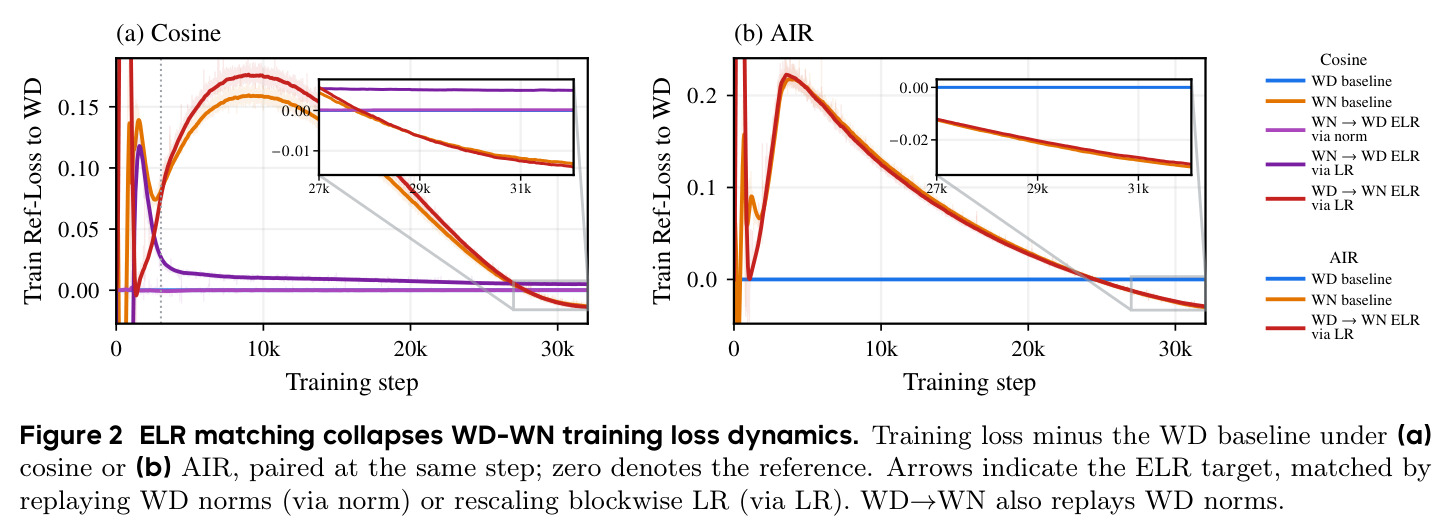
展示 cosine 与 AIR 下训练 loss 相对 WD 基线的差值曲线。四种匹配方式:WN→WD via norm(重放 WD 范数,gap < 2×10⁻⁴)、WN→WD via LR(固定范数逐块调 LR,残差数个 10⁻³)、WD→WN via LR 与 via norm(反向匹配后紧贴 WN 基线)。无论哪种方向、哪种调度,匹配 ELR 后曲线基本塌缩到一起。
这是“ELR 是 loss 动力学关键驱动”这一核心主张的直接因果证据,把相关性升级为干预性结论,是全文立论的实验基石。