条件交互:System-1与System-2协同设计的AGI扩展效率视角 Does Scaling Toward AGI Depend on What System-1 Lets System-2 Execute?
廉价System-1预测交互效用、门控System-2执行,$\rho_u$是扩展效率新坐标
前置知识
System-1 / System-2 双系统
借自认知科学的快/慢思维隐喻:System-2 是资源密集的执行器,负责推理与工具调用,每次交互付出高昂算力或行动代价;System-1 是轻量判断模块,只给候选交互打效用分数而不求解,打分成本 $c_{\mathrm{pred}}$ 远小于执行成本 $c_{\mathrm{exec}}$;两者按计算角色而非模型家族界定。
全文主张即二者必须协同设计:System-1 决定 System-2 执行什么、花多少、记什么,System-2 的结果又回流为 System-1 的监督,不懂这对分工就无法理解任何定理。
RLVR 与 GRPO
可验证奖励强化学习(RLVR)用低成本验证器给推理模型的思维链打分做后训练。GRPO 对每个提示采样 $G$ 个回答,按组内相对优势(以组均值为中心、标准差归一)加权策略梯度;当组内奖励全相同时所有优势为零,该提示成为消耗 $G$ 个 rollout 却无梯度信号的“退化提示”。
这是数字域的核心例子:文中指出池中相当比例提示是退化的,“预测哪些提示会产生非零优势”是条件交互最直接的落地场景,$\rho_{\mathrm{adv}}$ 也由此定义。
贝叶斯惊奇与信息增益
论文的典范效用定义:交互 $i$ 的效用是其引起的期望后验-先验 KL 散度(信念更新幅度的期望),等于条件互信息 $I(\theta;o\mid i,H)$,回答“执行后信念会变多少”;结果可预测的交互得分趋零。信息增益是可能效用之一,不是有用性的普适定义。
所有形式结果都以此为特例陈述(此时 $\rho_u$ 记作 $\rho_{\mathrm{info}}$);文章同时强调它不是唯一效用,课程学习期望改进、决策价值、适应风险都填入同一槽位。
神经缩放定律
经验规律:损失随累积计算量呈幂律下降 $L(C)\propto C^{-\alpha}$,性能 $P=1-L$ 的边际增益 $dP/dC\propto\alpha C^{-\alpha-1}$ 随算力增长趋零。它描述的是固定地景上无差别交互的收益递减,并不约束“执行哪些交互”这一自由度。
本文的核心假设正是要改写它:性能应由信息性计算 $C_{\mathrm{info}}=\int\rho_u^{\mathrm{exec}}(c)\,dc$ 而非总计算量描述;不懂缩放定律就无法理解 $1/\rho_u$ 重缩放与“指数是否被改变”之争。
交互信息效率 IIE 与 $\rho_u$
IIE 是每单位系统级成本获得的效用,须与产率(每筛选候选的效用)一起报告,以防“低成本低产出”虚高。$\rho_u$ 是效用超过事先固定下限 $u_{\min}$ 的候选占比,属候选池在当前策略下的属性,门控无法改变它、只能提高已执行部分中相关交互的占比;不同效用定义下的 $\rho_u$ 不可互换。
$1/\rho_u$ 是全文所有效率上限(执行计算、筛选时间、测试时花费)的公共基准,IIE 及含误差的修正式是把理想上限折算为可实现收益的账本。
模型预测控制(MPC)
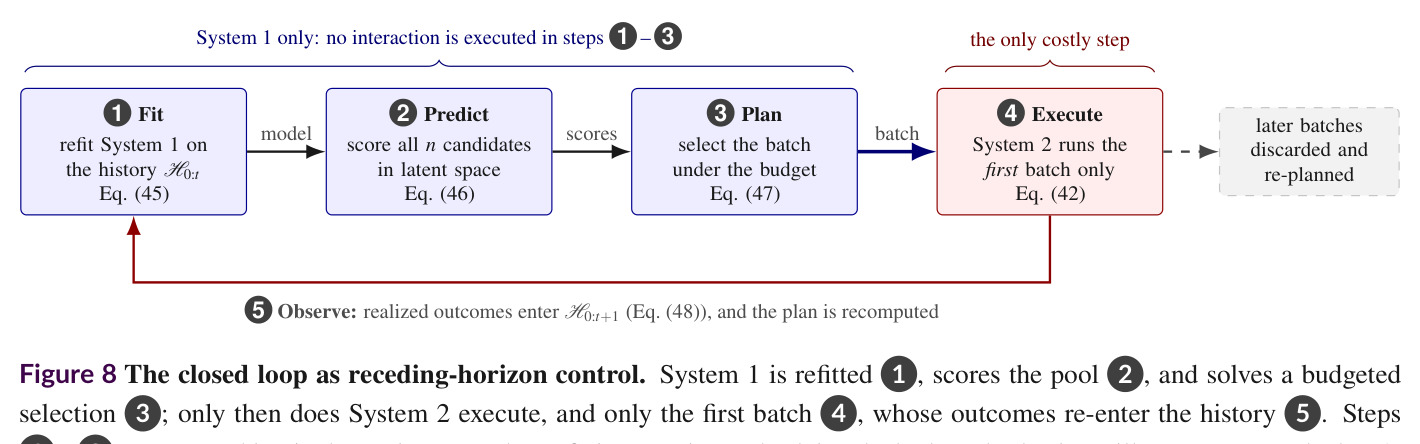
控制论方法:每步用模型预测未来 $H$ 步代价、在预算内规划、只执行第一批、观测后重规划,对模型误差鲁棒。文中把条件交互解读为对“被控对象(策略参数)的动力学仍在被学习”这一非平稳对象的 receding-horizon 控制,阈值执行规则另由最优停止与 Gittins 指数动机化(仅 bandit 假设下成立)。
这是理解 Figure 8 闭环操作与“为何只有执行一步真正昂贵”的控制论视角,也解释了双时间尺度分离为何能稳住耦合回路。
研究动机
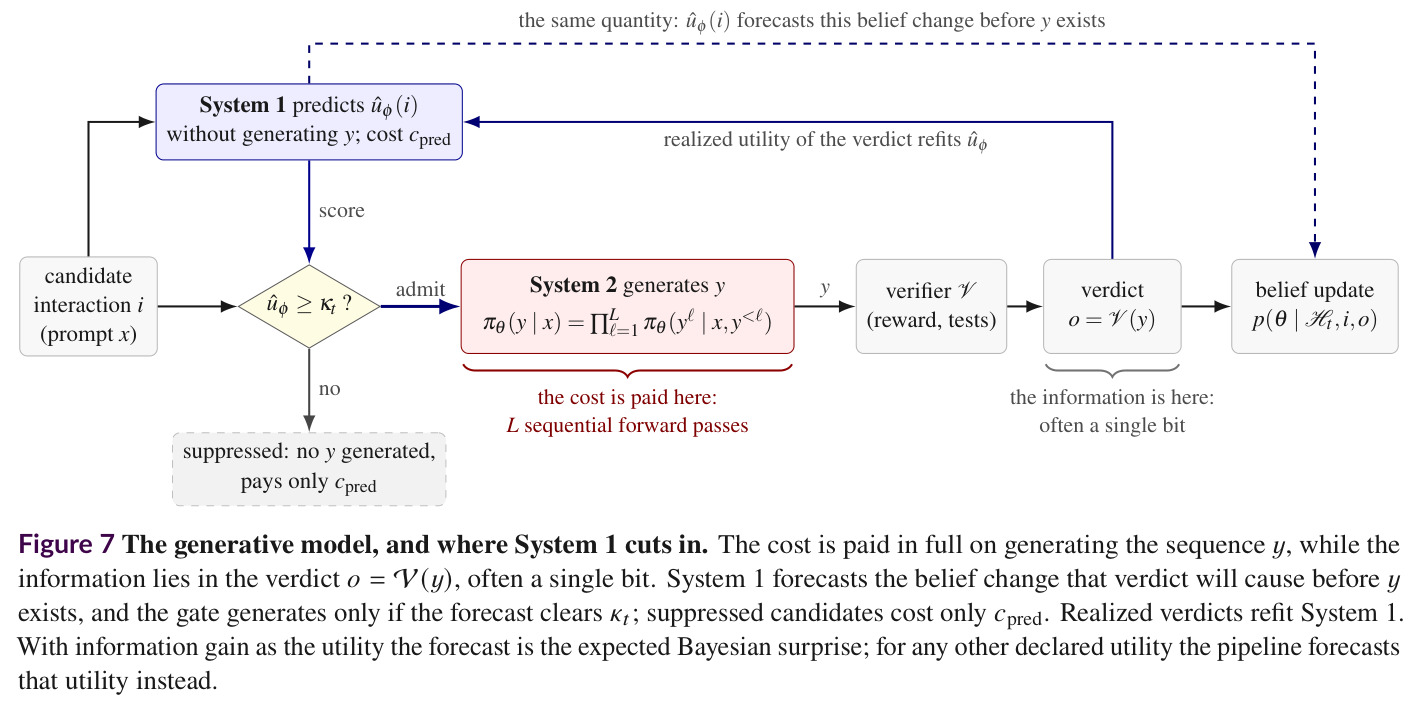
通向 AGI 的进展几乎全部押在扩展一个资源密集的 System-2 上:更大的模型、更多的数据与算力、更长的推理链、更多的智能体。缩放定律 $L(C)\propto C^{-\alpha}$ 表明无差别交互的边际收益随算力增长趋于零。数据端,公开人类文本存量可能在本十年内耗尽(Villalobos et al., 2024),高质量数据更稀缺,合成数据的空间组合爆炸使“哪些合成交互值得做”成为新问题;机器人与科学发现中的交互按物理节奏产生,无法用算力加速。浪费在两个域都具体可见:数字域的 RLVR 后训练中,GRPO 对每个提示采样 $G$ 个回答,奖励全同时组内优势全为零,这类“退化提示”不产生任何策略梯度信号却消耗全部 rollout,且报告显示池中相当大比例提示是退化的;物理域中域随机化把大多数轨迹花在已掌握的配置上,而真实 rollout 不可并行、按物理时间计价。判断一个交互值不值得执行,System-2 无法自行解决——因为评估价值必须远比执行便宜。
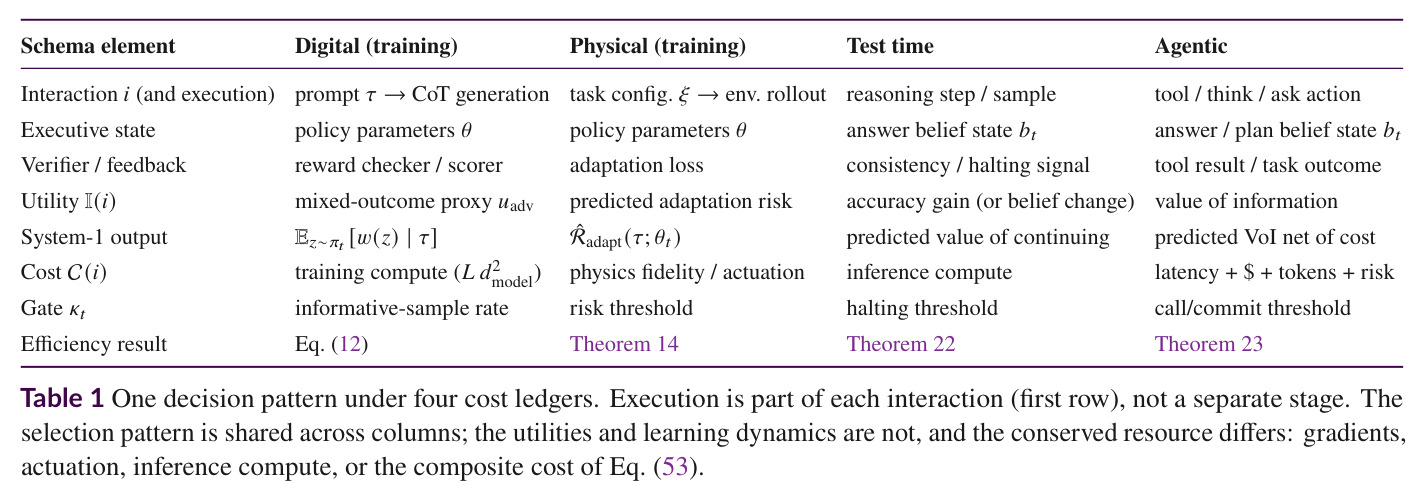
本文的目标是论文要回答的核心研究问题是:System-2 如何能在执行之前就感知一个交互的价值?作者的目标是给出一个“有保留的是”:下一阶段的进展可能来自 System-1 与 System-2 的协同设计,而非继续单独扩展 System-2。具体地,它提出“条件交互”——一个预测–门控–执行–更新闭环——作为两个系统之间的精确接口:System-1 估计每个候选交互的效用,System-2 只执行被自适应阈值 $\kappa_t$ 放行的交互,执行结果再回流更新 System-1。在形式层面,文章为该闭环建立筛选效率、内存、选择遗憾与协同缩放四类定理,并提出中心假设:效用相关交互的密度 $\rho_u$ 是扩展效率的一个可测量坐标,缩放定律应改用“信息性计算”而非总计算量来描述。全文按前提、立场、假设、预测四层置信度陈述主张,并给出可证伪的测量协议。
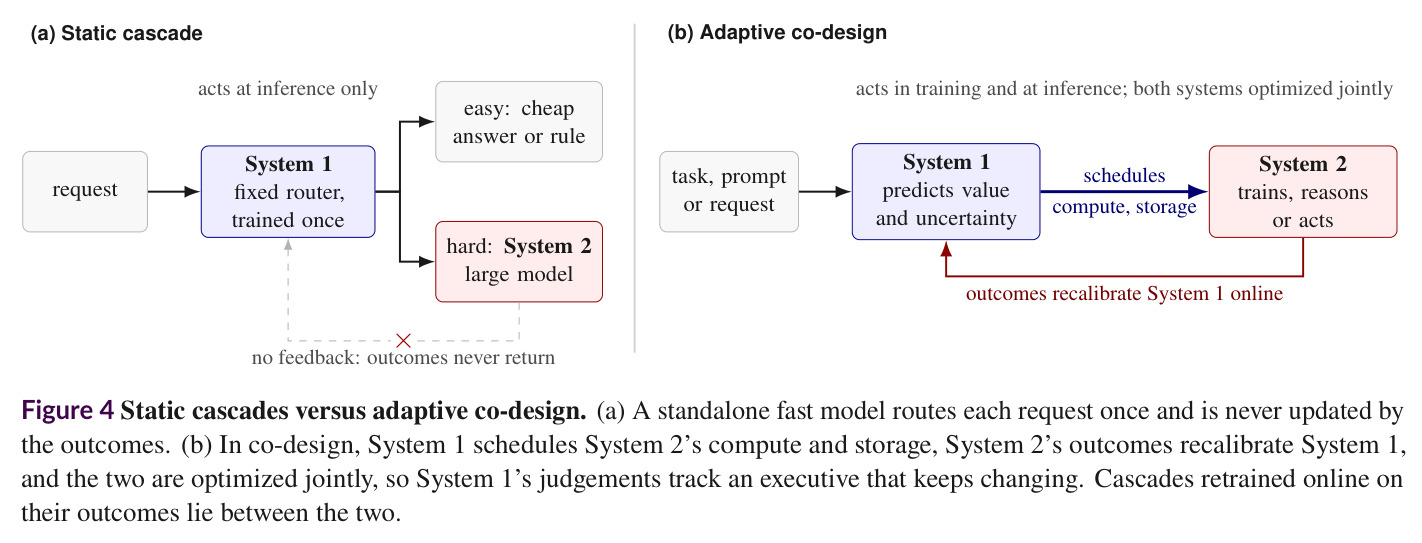
与已有工作不同的是,独特切入有三点。第一,以“交互”(一次生成、一条轨迹、一次工具调用)为统一分析单元,把训练 rollout、测试时推理、自适应决策与智能体工具使用放进同一本账,用一个分数背包主目标统一四类技术——统一的是架构而非目标函数。第二,坚持“架构优先于算法”:关键不是某个筛选技巧,而是给执行器配置一个专职判断的伙伴并联合优化——这区别于训练一次、只在推理层路由、从不接收 System-2 结果的静态级联(如被描述为“System One”的商业模型 Jev);区别于 execute-then-filter(DAPO 动态采样、在线难度过滤全额支付揭示性 rollout);也区别于主动学习、实验设计与静态池 bandit——那些不在执行前估值、也不跟踪一个持续变化的学习者。第三,把 $\rho_u$ 提升为效率坐标并提出可独立测量的协议(事先固定 $u_{\min}$、在独立于门控的审计池上估计),使“信息性计算”成为可检验假设而非事后叙事;AlphaZero 的价值网络与树搜索互相训练是先例,本文将其推广到训练、推理与部署全链路。
核心方法
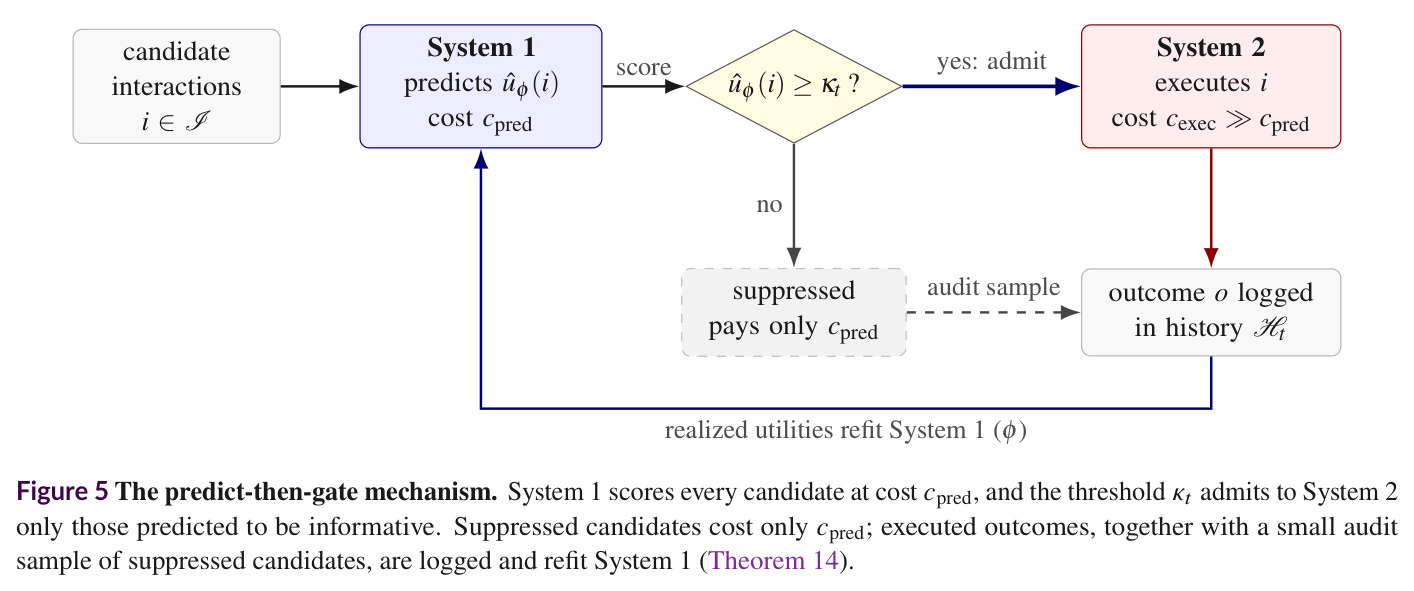
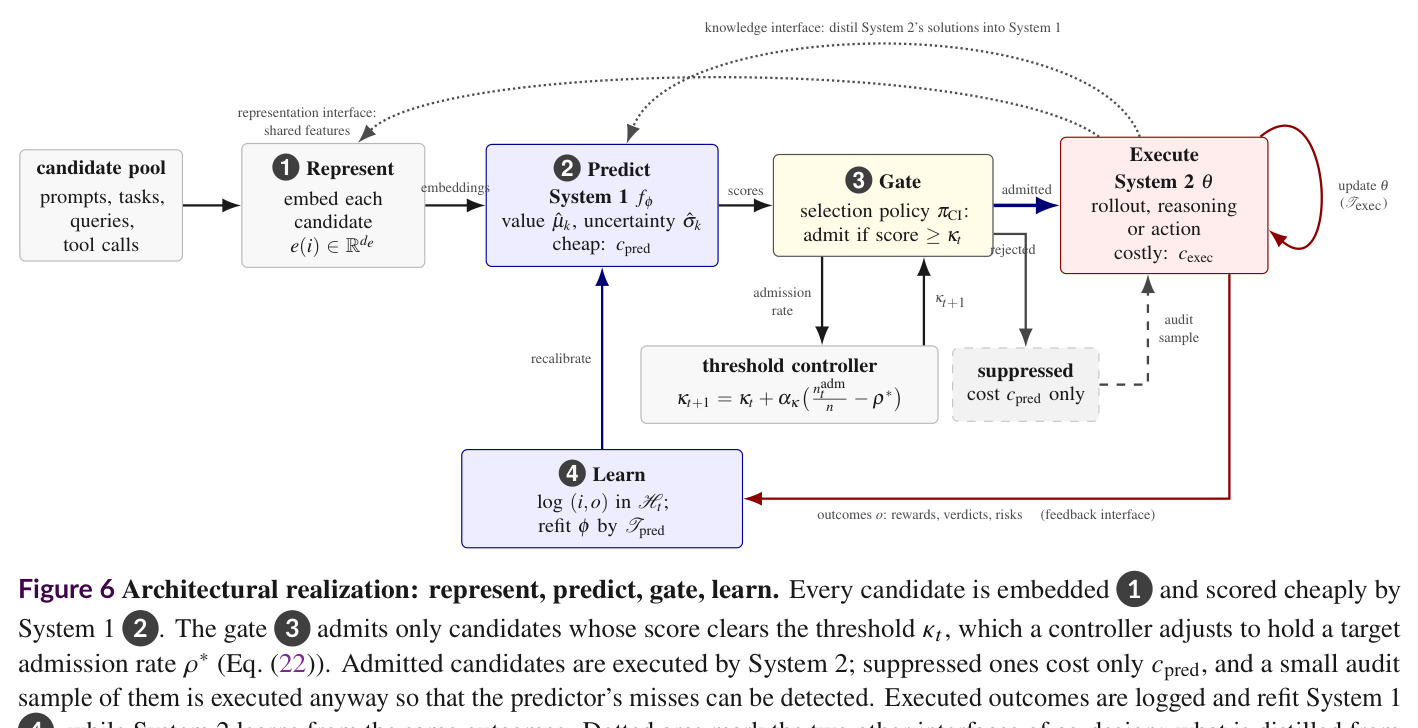
直觉:与其让昂贵执行器盲目执行每次交互再事后过滤,不如让廉价判断器在执行前估值,只执行值得花成本的部分。形式上,条件交互策略为 $\pi_{\mathrm{CI}}\propto\exp(\beta\hat u)\cdot\mathbf{1}[\hat u\ge\kappa_t]$:逆温度 $\beta$ 控制选择锐度(极限为贪婪 argmax),阈值 $\kappa_t$ 决定放行谁,可行集为空则弃权。总成本经主目标——预算约束下的分数背包——进入,其最优解即阈值规则 $x^*(i)=\mathbf{1}[\hat u(i)\ge\lambda C(i)]$,成本异质时改用净分数 $\tilde u=\hat u-\lambda C$。学习侧用算子分解 $(\theta,\phi)\leftarrow T_{\mathrm{exec}}\circ T_{\mathrm{pred}}$ 描述:System-2 沿通过门控采样的梯度慢更新,System-1 以严格 proper scoring rule 对已实现效用快 refit,双时间尺度分离保证耦合稳定。架构落地为四个动词:represent(嵌入)、predict(轻量预测器输出均值与不确定度)、gate(掩码与阈值控制器)、learn(日志回灌)。
核心创新是与静态级联有本质区别的“反馈式协同设计”:System-1 不仅在推理时路由,还在训练时调度 System-2 的算力与存储(rollout 预算、replay buffer、批次、KV cache、上下文窗口),System-2 的实现奖励、梯度与验证判决在线重校 System-1,二者联合优化——判断器追踪的是一个不断变化中的执行器。第二个关键洞察是“估值而非模拟”:System-1 只学习生成模型 $p_\psi(o\mid i,s)$ 的一个标量泛函(执行将引起的信念改变),不学习模拟世界所需的世界模型,因此可以比执行便宜几个数量级;Figure 7 点明这一不对称性——成本付在生成长度 $L$ 的序列 $y$ 上,信息却常在判决 $o=V(y)$(往往一个比特)里,预测器要在 $y$ 存在之前预报这个比特引起的信念变化。第三,提出 $\rho_u$ 作为效率坐标:门控不创造资源,而是把已执行部分中相关交互的占比推向 1,使固定 $N,D,C$ 下更多预算买到效用相关的交互。
方法步骤详情
闭环每轮五步。①表示:候选经嵌入 $e:\mathcal{I}\to\mathbb{R}^{d_e}$ 编码,数字域用冻结语言模型编码器,物理域编码任务 MDP 结构。②预测:轻量 System-1 $f_\phi$ 输出均值与不确定度 $(\hat\mu_k,\hat\sigma_k)$,参数量 $d_\phi\ll d_\theta$ 保证 $c_{\mathrm{pred}}\ll c_{\mathrm{exec}}$。③门控:$\pi_{\mathrm{CI}}$ 产生执行掩码 $z_t$,阈值控制器 $\kappa_{t+1}=\kappa_t+\alpha_\kappa(n_{\mathrm{adm}}/n-\rho^*)$ 跟踪目标准入率,成本异质时在净分数上比较。④执行:System-2 只执行过门候选,同时对被抑制候选按固定比例 $a$ 抽审计样本,以估计错误率并保持 positivity。⑤学习:结果与审计样本记入历史 $\mathcal H_t$,做一步 $T_{\mathrm{pred}}$ refit 预测器,System-2 经 $T_{\mathrm{exec}}$ 更新。测试时退化为最优停机:在预测效用跌破阈值的步停止;智能体场景改用复合账本 $C(i)=\lambda^\top c(i)+\lambda_{\mathrm{risk}}\Pr[\text{不可逆}\mid i]$。
技术新颖性
技术新颖性主要在统一与定理化,而非单点算法。与 execute-then-filter(DAPO 动态采样、在线难度过滤)相比,预测发生在生成之前,省掉揭示性成本;与静态级联(Jev)相比,反馈与联合优化使判断跟随变化中的执行器;与主动学习、实验设计、Gittins 指数策略相比,候选分布非平稳且由单一演化策略耦合;与影响函数、data Shapley 等事后数据估值相比是事前估值;与世界模型路线相比只学标量估值泛函而非完整转移模型。文章还诚实定位:主动推断的期望自由能在均匀偏好下退化为信息增益选择(其 Prop 20),条件交互是其“成本门控+预测摊销”特例,作者明言不主张该恒等式的新颖性。真正新的形式贡献是:IIE 增益闭式、筛选成本比 $\rho_u+r$、与池大小无关的峰值内存、由 $2\varepsilon_\phi<\mathrm{gap}_{\min}$ 触发的零遗憾、协同缩放的单调比较静态、水平重缩放恒等式 $L_{\mathrm{CI}}(C)=L_{\mathrm{base}}(C/\rho_u)$,以及把门控自身造成的选择性标注问题作为核心开放问题提出。
实验结果
本文是 Perspective,没有自己的新实验,结果分“已证/有据/假设”三层。已证层:IIE 增益——完美免费预测器下 $\mathrm{IIE}_{\mathrm{CI}}/\mathrm{IIE}_{\mathrm{unc}}=1/\rho_u$,含误检率 $f_p$、漏检率 $f_n$ 与预测成本的修正式随三者单调不增;筛选增益——相对全量 execute-then-filter,成本比降为 $\rho_u+r$,理想时执行计算节省接近 $1/\rho_u$;内存——预测式打分的峰值内存与候选池大小 $n$ 无关,可零内存代价扩池;遗憾——当 $2\varepsilon_\phi<\mathrm{gap}_{\min}$ 时与神谕选择完全一致,一般上界 $2TB\varepsilon_\phi$,预测器总体准确时盲点项占主导;测试时——单探针门控最多损失 $\delta_{FN}$ 精度、花费接近 $1/\rho_u^{\mathrm{tt}}$;智能体——期望成本不超过全执行成本的 $\rho_u^C+r+m\varepsilon_\phi R_c$ 倍,精度差至多 $Nm\varepsilon_\phi$;缩放——完美门控只是水平重缩放 $L_{\mathrm{CI}}(C)=L_{\mathrm{base}}(C/\rho_u)$。有据层:引用的预测式提示/任务采样文献(MoPPS、MPTS、GPS 等)报告数倍 rollout 节省,仅构成间接支持。假设层:$\rho_u$ 单调衰减与缩放指数改变均未验证,作者明言测试时前提“连间接支持都没有”。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数字域训练:RLVR rollout 预算分配(理论界) | 执行计算量比(相对全量 execute-then-filter) | $C_{\mathrm{CI}}/C_{\mathrm{react}}=\rho_u+r$,$r\to 0$ 时接近 $1/\rho_u$(等成本、完美筛选) | DAPO 动态采样、在线难度过滤等先全量执行再过滤的方法 | 理想情形执行计算节省接近 $1/\rho_u$ 倍;文献报告预测式提示采样有数倍 rollout 节省(如 MoPPS) |
| 同步评估峰值内存(理论界) | 峰值内存随候选池大小 $n$ 的标度 | $M_{\mathrm{CI}}=\Theta(BGLd_{\mathrm{model}}+bd_e+B)$,与 $n$ 无关 | $M_{\mathrm{react}}=\Theta(nGLd_{\mathrm{model}})$,随池大小线性增长 | 解除内存对池大小的依赖,可在不增内存的条件下扩大候选池再选 top-$B$ |
| 测试时推理:自适应停机(理论界) | 每查询推理计算量与精度损失 | 单探针门控最多损失 $\delta_{FN}$ 精度,花费占无条件预算的 $(1+c_{\mathrm{pred}}/C)/(\rho_u^{\mathrm{tt}}+\delta_{FP})$ 附近 | 无条件 test-time scaling(每查询花满预算 $C$) | 计算量降低接近 $1/\rho_u^{\mathrm{tt}}$ 倍(作者明言该前提尚无实测甚至间接支持) |
| 智能体工具/动作选择(理论界,可分离动作) | 期望成本与相对 call-everything 的精度差 | $\mathbb{E}[C_{\mathrm{CI}}]\le(\rho_u^C+r+m\varepsilon_\phi R_c)\,\mathbb{E}[C_{\mathrm{all}}]$,精度差 $\le Nm\varepsilon_\phi$ | call-everything(执行全部候选动作) | 成本占比压到效用相关动作的成本份额 $\rho_u^C$ 附近,同时近似保精度 |
| 缩放曲线(理论恒等式) | 损失-计算曲线的位置 | $L_{\mathrm{CI}}(C)=L_{\mathrm{base}}(C/\rho_u)$,log 算力轴左移 $\ln(1/\rho_u)$ | 无条件训练的缩放曲线 $L_{\mathrm{base}}(C)$ | 等效 $\rho_u$ 倍计算;是否进一步改变指数本身属未验证假设(Hypothesis 25 与曲线塌缩检验待做) |
局限与改进
作者承认的限制:主张分层中最强的三件事——协同设计前沿三轴同时支配(Figure 3)、$\rho_u$ 随能力提升衰减、缩放指数被改变——都属于“提出的假设”;测试时的效率声明没有任何间接支持;若 $\rho_u$ 随策略漂移,$1/\rho_u$ 只是时变重参数化;最关键的结构性问题是门控审查自己的训练数据(Eq.57),标签缺失非随机,被误判低价值的候选可能永不执行、永不纠错,且效用误设时会系统性抑制能暴露误设的交互。我的观察:其一,全部定量结果都是理想化上限,实际收益由 $f_p,f_n,c_{\mathrm{pred}}$ 打折,而文中没有任何 $\rho_u$ 实测数值或衰减曲线,可检验性尚未兑现;其二,margin 条件在测试时大量效用恰为零的查询上失效(零效用原子落入误差带),需 $\kappa>\varepsilon_\phi$ 绕开,代价是小效用查询的漏检风险;其三,可分离动作假设在长界面轨迹上失败且精度损失随动作数 $N$ 线性增长;其四,框架是单学习者的,多智能体中“对发起者无信息、对观察者有信息”的交互无法处理;其五,延迟、金额、token、风险如何统一标价 $\lambda$ 缺乏可操作方法。
独立分析的弱点
独立分析的弱点:一是 $\rho_u$ 的可识别性与测量成本——用损失曲线拟合 $\rho_u$ 是循环论证(Remark 9),独立测量需要独立于门控的审计池、重复 rollout 与置信区间,本身不便宜,改进方向是社区共建标准化测量协议。二是选择性监督的统计后果——逆倾向加权 $1/e(i)$ 的方差会侵蚀筛选收益,作者自认“最需要理论”,改进方向是 doubly robust 估计与自适应审计率设计。三是效用误设的阴险失败模式——预测器在自己无数据的盲点处出错,而这些盲点恰因被抑制而无法被发现,改进方向是把不确定性写进获取函数($\hat u+c\sigma_\phi$)并强制保留探索混合,但温度软化不解决 positivity(指示函数使被抑制候选概率严格为零)。四是效用间隔假设——连续空间中全局间隔消失,$\mathrm{gap}_{\min}$ 只能解释为第 $B$ 阶统计量处的间隔,近邻候选排序噪声可能吃掉理论收益。五是交互粒度——以单次动作为单元在长程界面任务上失效,效用应属于子轨迹或状态转移,但子轨迹划分与状态相关价值信息估计都是未解问题。
未来方向
作者提出的方向:最干净的单次检验是测量 $\rho_u(\theta_t)$ 的衰减轮廓——它同时检验框架与一种涌现的机制解释(某子技能的 $\rho_u$ 突然跨过可用阈值应表现为能力突现);刻画效率最优的内点准入率 $\rho^*(\varepsilon_\phi)$(一个非平稳 bandit 问题);扫描 System-1 尺寸 $s$ 在多个 System-2 尺度下测 $f_p,f_n,c_{\mathrm{pred}}$,得到两系统的计算最优配比——Chinchilla 参数-数据比的协同设计版;把框架扩展到智能体社会,定义交互图上的关系效用与信息密度(对发起者无信息、对观察者有信息的交互);与 enactive 认知观和“经验时代”的对接。基于其成果可延伸:在真实 RLVR 训练中做“匹配信息性计算”的曲线塌缩实验,区分水平重缩放与指数改变两种假设;量化停机预测器自身前向成本对节省的侵蚀;设计审计率 $a$ 与探索率 $\epsilon$ 在策略漂移下保精度的最优调度;以及把训练期校准的 System-1 直接复用为部署期的路由器,让部署数据回流为其训练集,实现训练-部署同构。
复现评估
这是 Perspective 文章,本身不附带代码、数据或新实验,“复现”的含义是实例化框架并检验其定理与假设。理论部分自包含:所有定理的假设、账本定义与推导脉络都在文中给出,验证数学只需纸笔。实证检验门槛较高:复现数字域实例需要 RLVR 后训练基础设施(GRPO、可验证奖励、多卡 GPU 集群跑推理模型的 rollout);文中引用的 MoPPS、MPTS、GPS、DPS 等是独立文献工作,其开源情况需到各自仓库确认,本文不为其负责;复现物理域实例需要域随机化仿真器或真机。测量 $\rho_u$ 需按文中协议建立独立于门控的审计池、每候选重复 rollout、给出置信区间,并随策略更新重估。项目网站提供博客级导览(cheemswang.github.io/blogs/sys1-sys2-codesign.html)。总体难度评估:读懂并验证理论为中等,完整复现实证假设检验(尤其曲线塌缩实验与 $\rho_u$ 衰减测量)为高,主要瓶颈是训练算力与测量协议的工程量。
论文图表
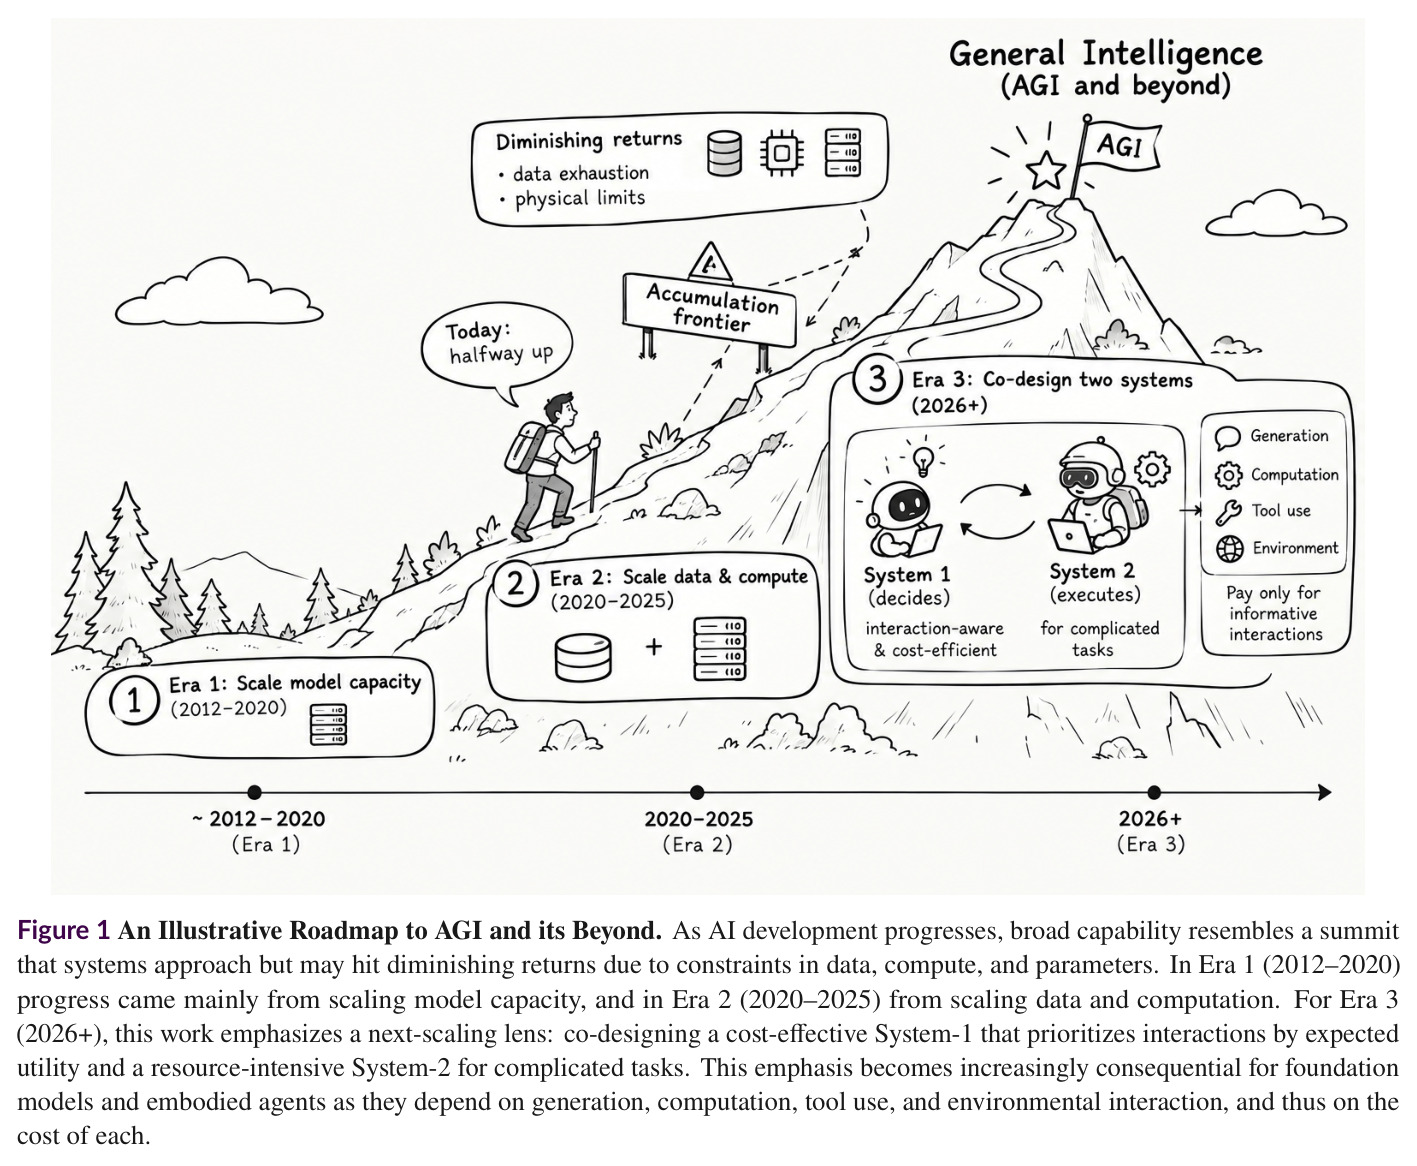
把 AI 发展画成三段登山路线:Era 1(2012–2020)靠扩展模型容量、Era 2(2020–2025)靠扩展数据与计算逼近“能力之峰”,并在数据、算力、参数约束下遭遇收益递减;Era 3(2026+)作者提出下一级扩展杠杆——协同设计一个按期望效用给交互排优先级的低成本 System-1 与资源密集的 System-2。
一张图给出全文的宏观定位:本文不是又一个方法,而是把“交互效率”立为第三个扩展时代的核心资源约束。
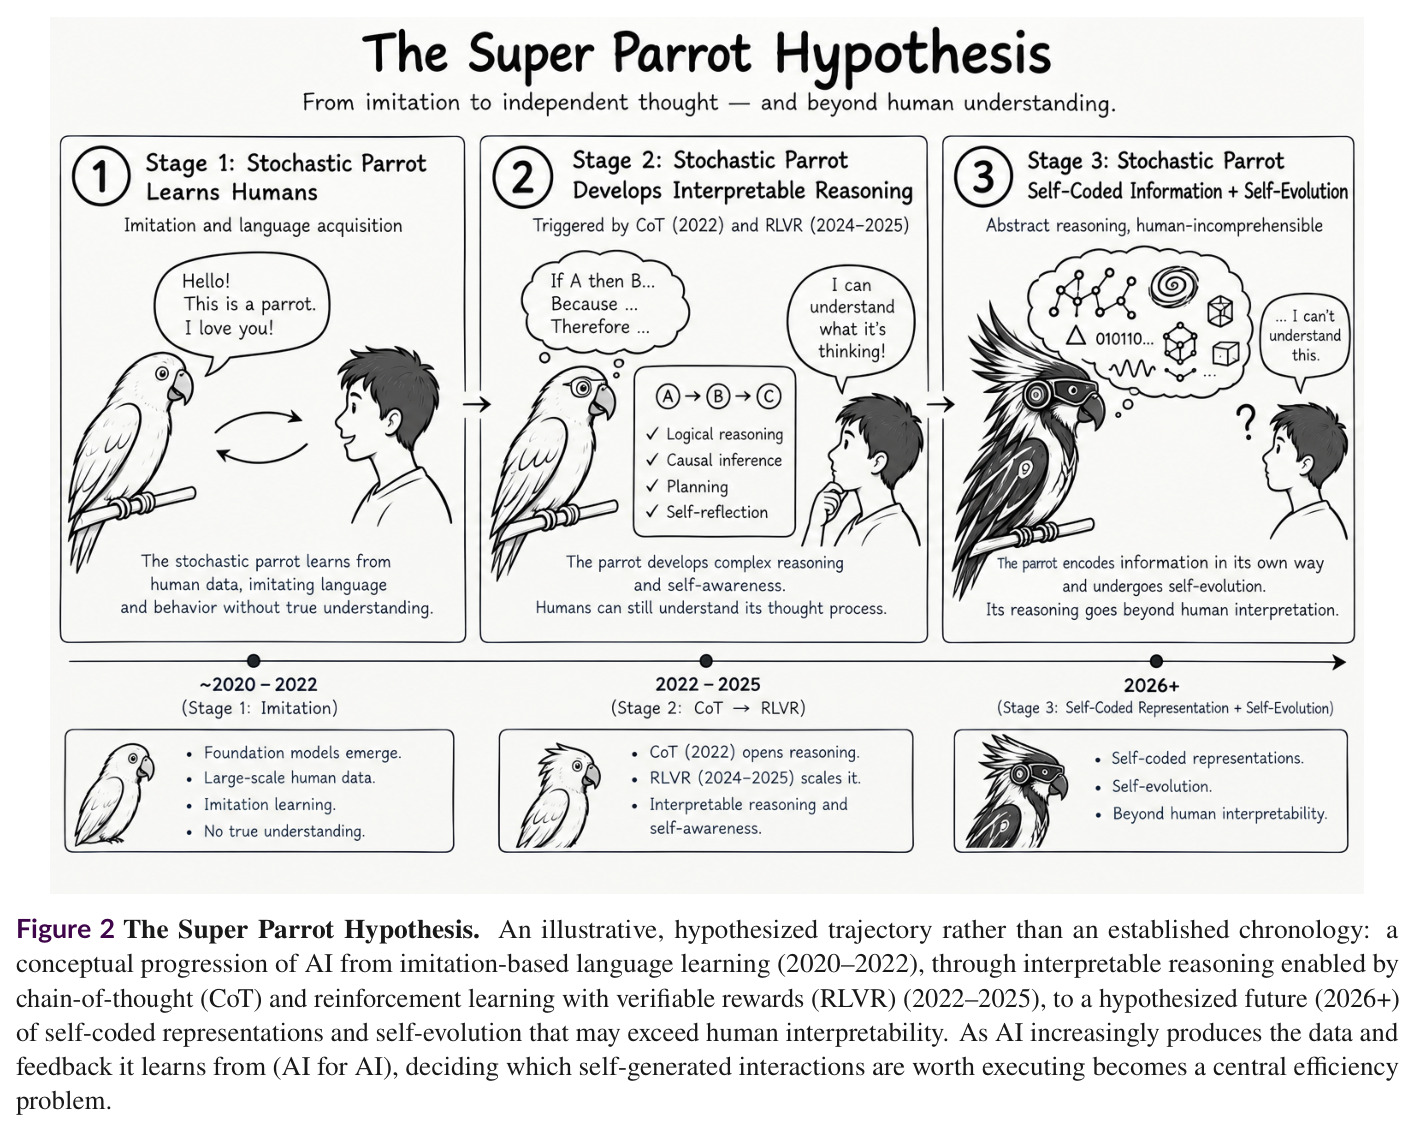
假设性轨迹图:Stage 1(约2020–2022)“随机鹦鹉”式模仿人类文本;Stage 2(2022–2025)经 CoT 与 RLVR 发展出人类可循的推理;Stage 3(2026+)假设模型以自编码表示自我进化、超出人类可解释范围。每一阶段 AI 自产学习素材的占比上升(AI for AI),因此“哪些自生成交互值得执行”成为核心效率问题。
解释了为什么效率问题会随能力增强而加剧而非缓解:自我进化系统的每次自生成交互都在消耗自身算力,执行前估值(System-1 的角色)由此成为刚需。
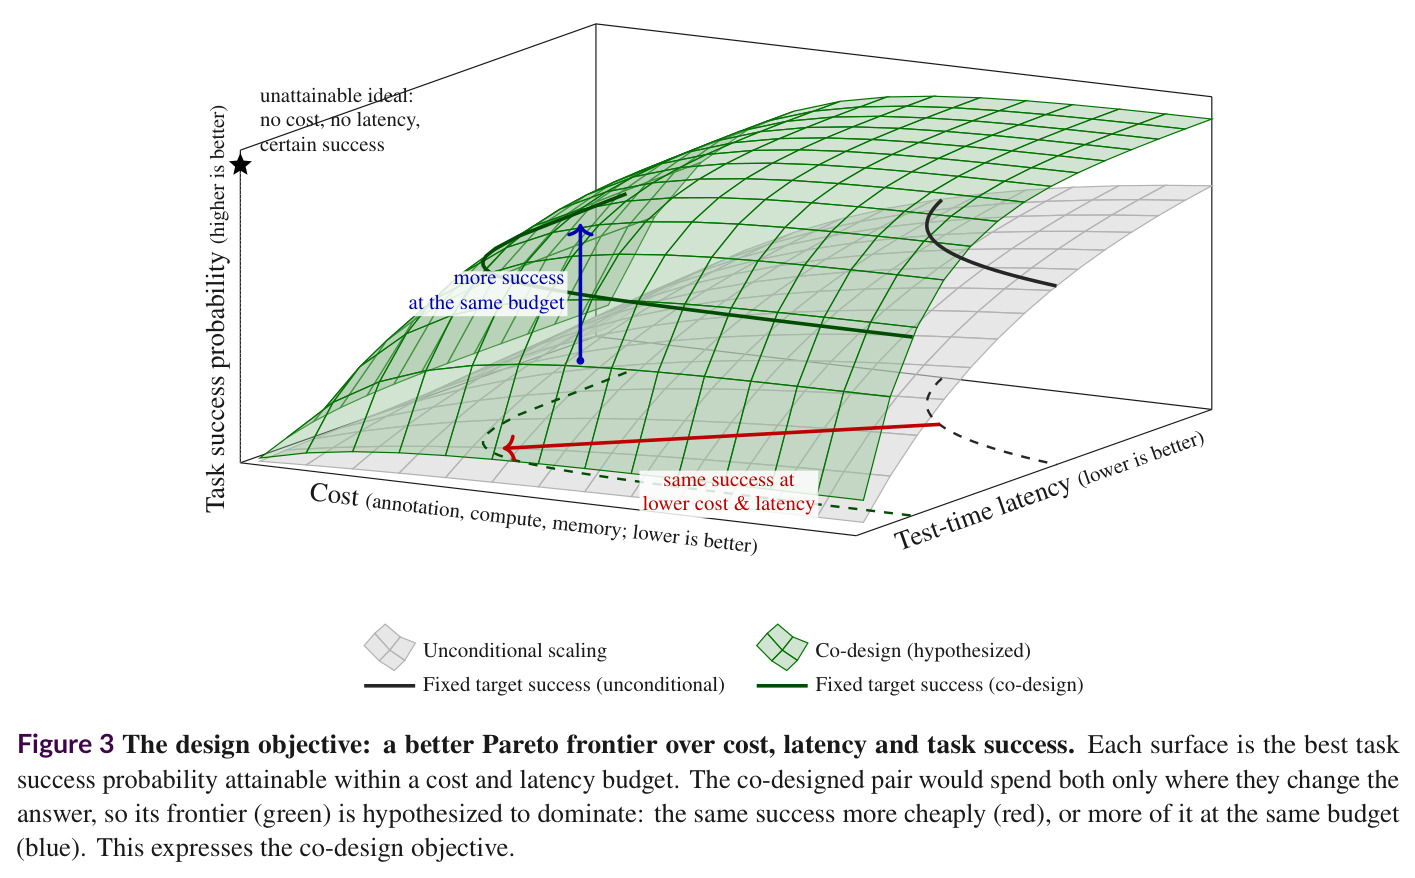
以“成本×时延预算内可达的任务成功率”为曲面,画出协同设计对(绿色前沿)相对无条件扩展的假设优势:同样成功率更便宜(红色箭头方向)、同样预算更高成功率(蓝色箭头方向)。门控只在能改变答案的地方花钱,故假设其前沿全面支配。
给出协同设计的目标函数与可检验预测:论文明确把“三轴同时支配的前沿”列为假设层声明而非已证结论,看懂这张图才能准确把握全文主张的置信度层级。