IntReal:面向多模态交错生成的真实世界数据集与基准 IntReal: A Real-World Dataset and Benchmark for Multimodal Interleaved Generation
构建10万条真实交错图文数据与七维细粒度评测基准,证明单模态优化可迁移到交错生成
前置知识
统一多模态模型(UMM)
在单一模型内同时支持文本与图像理解和生成的模型,通常由自回归语言骨干加扩散/流匹配生成分支组成,代表工作包括 Chameleon、Bagel、Emu3.5、SenseNova-U1。推理时模型自回归地产出文本,一旦生成特殊的 token 就切换到图像生成分支产出一张图,然后继续生成文本,从而实现图文穿插输出。
本文的数据集、评测基准和 SFT/RL 后训练实验全部以 UMM 为对象,评测协议中模型生成文本到 token 时切换生成分支这一机制正是交错生成的实现基础。
多模态交错生成
指一段回复中文本段落与图像按内容需要交替出现,模拟真实网页、百科、教程、绘本的形态。与一次生成一张图的文生图任务不同,模型必须自主决定何时插图、插什么图、总共插几张,并保持图文在语义和时序上的连贯,是比单图生成更接近人类内容创作的开放式任务。
交错生成本身就是论文定义的核心任务,四个场景类别(规划/知识/教程/故事)和七个评测维度都是围绕这一任务的能力分解设计的。
IQA 图像质量/美学评估模型
Image Quality Assessment 模型对单张图像输出感知或美学分数(通常 1–5 分),通过在大量人工标注的美学数据上训练获得,与人类审美判断高度相关。本文使用的 RALI 即此类模型,既用于数据过滤(单图 >3.0、样本均值 >3.5),也充当评测中的视觉专家和 RL 训练中的美学奖励信号。
Image Aesthetic 指标、数据管线的视觉过滤、Flow-GRPO 的美学奖励三处都依赖 IQA 模型,理解它的作用才能理解论文“专家模型分工评测”的设计。
DINOv3 特征与余弦相似度
DINOv3 是自监督训练的视觉编码器,其输出特征对语义内容敏感而对低层风格变化相对稳健。两张图像特征的余弦相似度 $\cos(f(I_1), f(I_2))$ 可衡量语义相似程度:相似度极高说明两张图内容几乎重复,适中说明主题一致但内容有推进。
论文用 DINOv3 相似度做序列内去重(相邻图相似度需低于 0.85)、构建 Image Diversity 和 Subject Consistency 两个评测指标,以及 RL 中的奖励信号。
Flow-GRPO(扩散/流模型强化学习)
把流匹配模型去噪过程中的确定性 ODE 轨迹通过随机采样器(如 Flow-SDE、Flow-CPS)转化为随机策略,再用组相对策略优化(GRPO)思想:同一提示采样一组候选,以组内奖励归一化作为优势进行策略梯度更新。奖励可以来自 IQA 分数、DINO 相似度或 rubric 校验等不可微指标。
论文用 Flow-GRPO 在交错上下文的下一图生成任务上做 RL,奖励直接取自 IntReal 评测指标,这是“指标可作为学习信号”这一核心结论的实验载体。
Spearman 秩相关
衡量两组排序单调一致性的非参数统计量 $\rho \in [-1,1]$,只关心秩次而不关心数值间距。在评测研究中常用于两件事:检验多个指标之间是否高度相关(冗余),以及检验换一个评审模型后排名是否稳定(稳健性)。
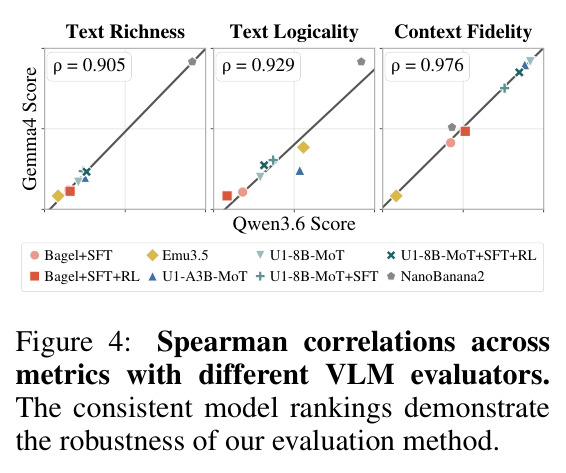
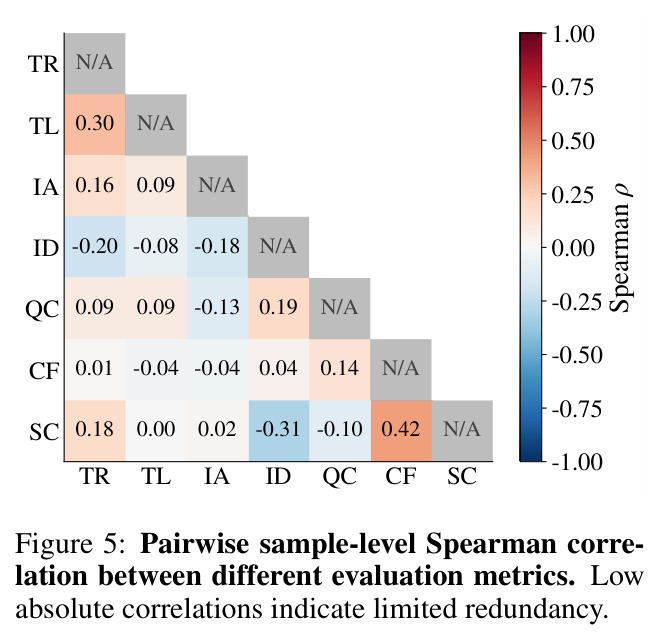
论文用它量化评测套件的三大可靠性证据:指标间最大成对相关 $|\rho| \le 0.42$ 证明低冗余,换用 Qwen3.6 评测器后模型排名 $\rho > 0.9$ 证明稳健。
研究动机
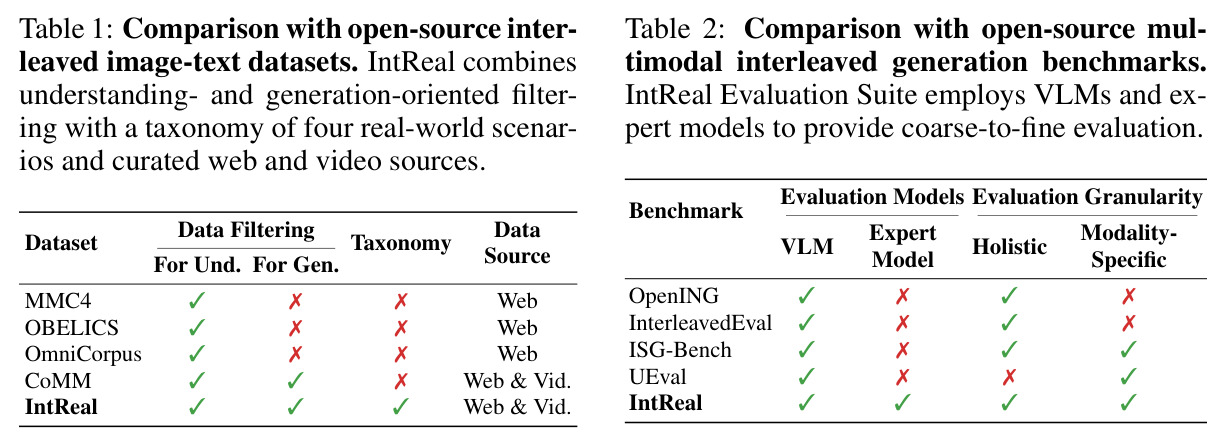
统一多模态模型(UMM)虽然已能同时生成文本和图像,但多模态交错生成一直被当作模型统一化的副产品,而非一个独立的生成任务。数据侧存在明显缺口:MMC4、OBELICS、OmniCorpus 等大规模交错数据集是为多模态理解与预训练收集的网络语料,只做了理解导向过滤,没有面向生成的质量控制;CoMM 虽然引入了生成导向过滤,但没有围绕真实世界场景的分类学组织数据,导致交错生成的任务空间刻画不清。评测侧问题同样突出:OpenING、InterleavedEval 等基准依赖单个 VLM 对长交错回复做整体打分,这种粗粒度评估与刻画复杂生成能力所需的细粒度诊断天然错位;ISG-Bench 虽把回复分解为四层结构粒度,但这种分解并未映射到相互独立的能力维度,而且所有层级都只用同一个 VLM 评审,缺乏某些维度需要的专业能力——例如图像美学需要专门的 IQA 模型而非通用 VLM。结果是社区既缺高质量训练数据,也没有可靠工具诊断模型在交错生成各能力维度上的强弱。
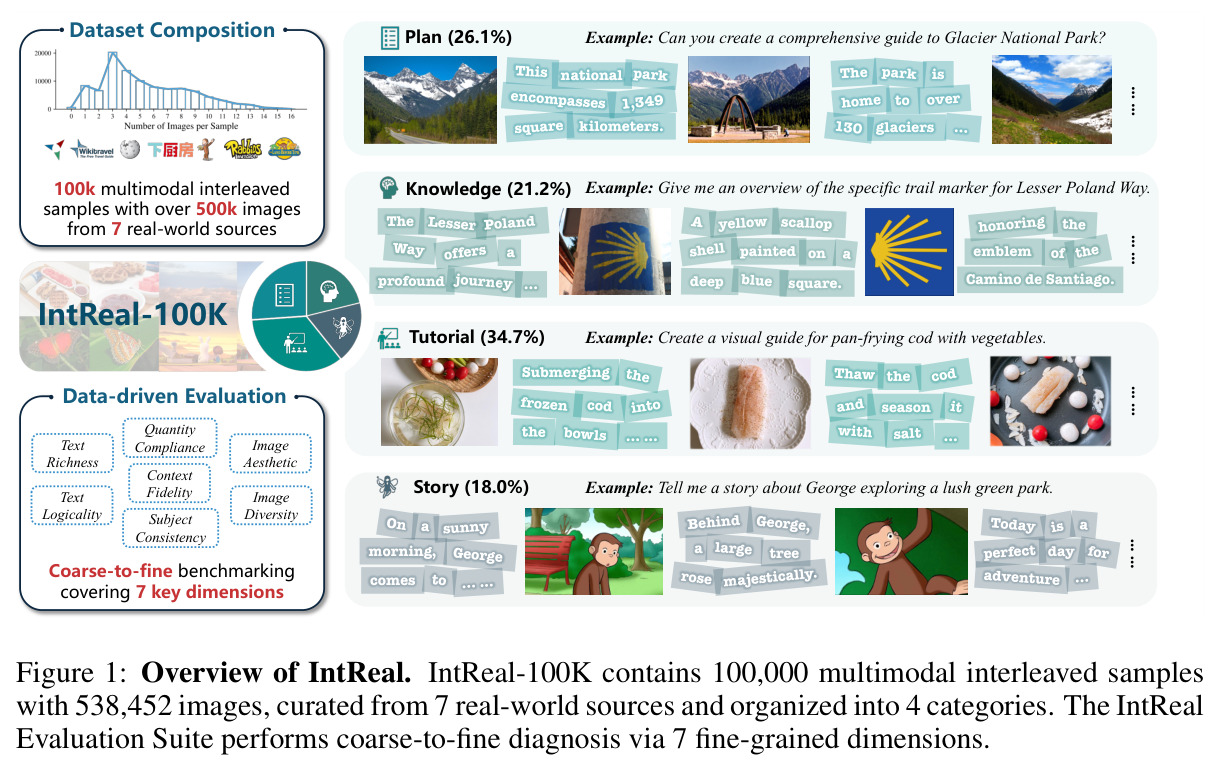
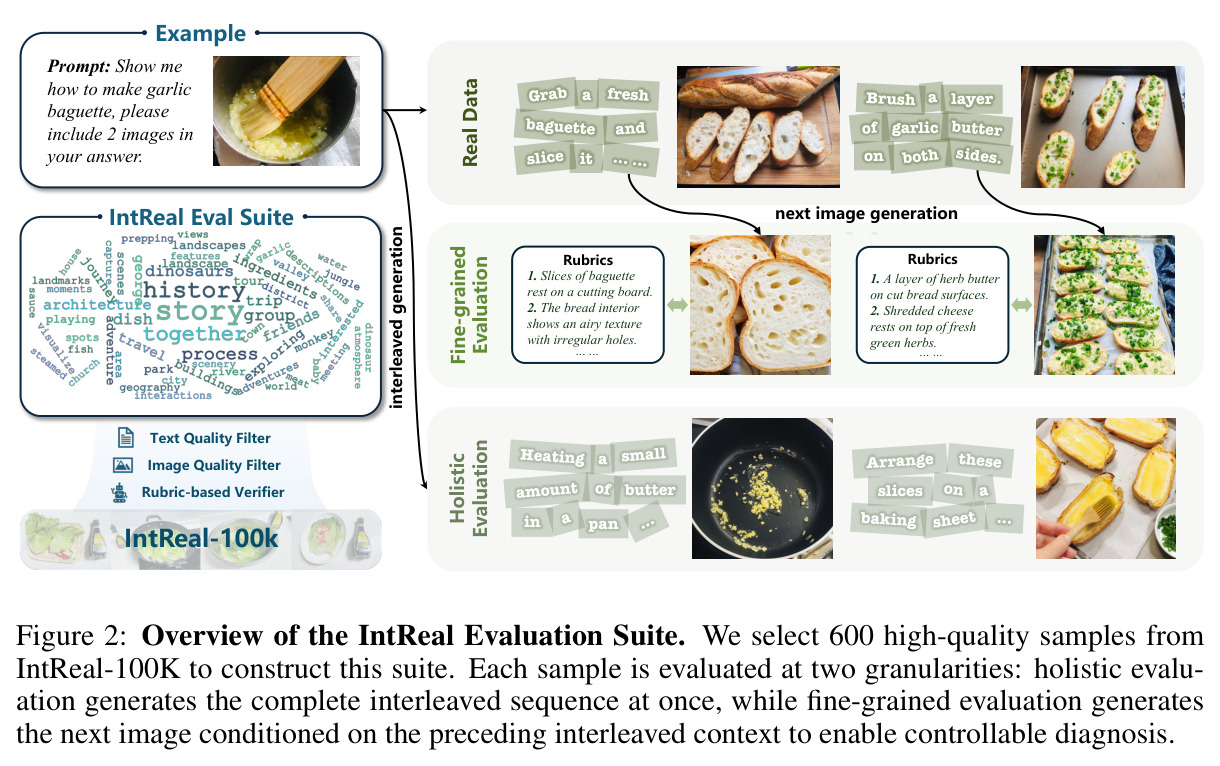
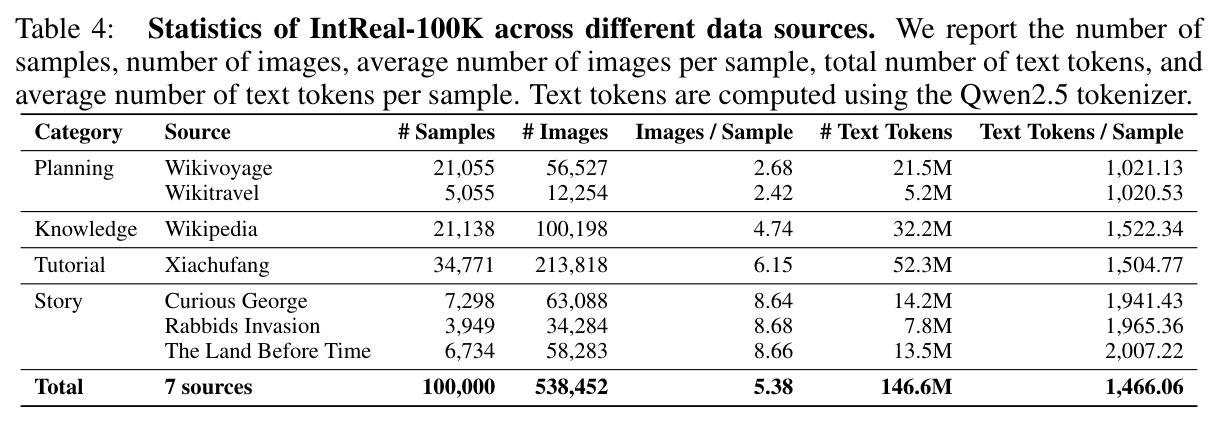
本文的目标是论文的目标是端到端地补齐“数据+评测+训练验证”三块拼图。数据上,从真实世界交错内容中归纳场景分类学,构建 IntReal-100K:100,000 条高质量交错样本、538,452 张图像、146.6M 文本 token,覆盖四大类别并保持类别均衡。评测上,构建 IntReal Evaluation Suite:从数据集中严格筛选 600 条样本(每类 150 条),设计整体生成与细粒度下一图生成两种互补设定、七个能力维度,每个维度由最擅长的专家模型(LLM、IQA、DINOv3、VLM+rubric)评测,并通过三项验证研究证明其低冗余、与人判一致、跨评测器稳健。训练上,用该数据对 Bagel、SenseNova-U1 做 SFT,再用 Flow-GRPO 把评测指标当奖励做 RL,回答两个问题:指标能否作为有效学习信号?优化单一模态能否提升整体交错生成?
与已有工作不同的是,本文的独特切入角度有三点。第一,分类学驱动:不是无差别堆网络数据,而是从“文本与图像在真实内容中的功能协作模式”出发归纳出 Planning(决策规划,26.1%)、Knowledge(知识解释,21.2%)、Tutorial(程序教程,34.7%)、Story(叙事表达,18.0%)四类,指导数据采集、过滤与均衡采样。第二,专家分工的粗到细评测:不让一个 VLM 打总分,而是按能力维度分派给各自擅长的专家——文本交给 LLM 成对比较、美学交给 IQA、多样性与一致性交给 DINOv3 几何度量、上下文忠实交给“先从上下文派生原子化 rubric 再对照验证”的协议,且指标直接构建在真实世界参考样本上(data-driven)。第三,训练评测闭环:训练集(99.4K)与评测集(600)严格分离,并把评测指标直接用作 Flow-GRPO 奖励,用训练效果反向验证指标有效性,最终得到“单模态优化可迁移到交错生成”这一超越常规联合 SFT 的结论。
核心方法
先说直觉:要让模型像人写网页、教程、绘本一样图文穿插,需要两样东西——真实多样的“范文”数据,和能分别诊断文、图、图文协作各环节的“考卷”。技术路线分三步走。第一步数据构建:从 7 个允许公开收集与再分发的来源(WikiVoyage、WikiTravel 提供规划类,Wikipedia 提供知识类,下厨房提供教程类,Curious George、Rabbids Invasion、The Land Before Time 三部动画提供故事类)收集百万级原始交错语料,经四阶段“低成本过滤到高成本语义精修”的管线后仅保留约 10%,得到 IntReal-100K。第二步评测构建:从数据集中经自动过滤加人工复核选出 600 条高质量样本,设计整体(一次性生成完整交错回复)与细粒度(给定真实交错上下文生成下一张图)两种设定,七个指标各由专属专家模型计算。第三步训练验证:用剔除评测集后的 99.4K 样本对 U1-8B-MoT、Bagel 做 SFT,再对 10K 高质量样本标注 rubric,用 Flow-GRPO 以 IQA/DINO/rubric 奖励做 RL,验证指标的学习信号价值并缓解 SFT 引入的文本-图像能力权衡。
核心创新有三。其一,场景分类学驱动的数据构建:四类场景对应文本与图像四种不同的协作模式——Planning 中文本承载决策信息而图像可视化时空变化,Knowledge 中图像为抽象概念提供视觉锚定,Tutorial 中图像标注程序步骤的中间状态与时序转换,Story 中图像构建角色与场景;这使数据采集有原则可循,而非依靠单一过滤启发式。其二,专家模型分工的 coarse-to-fine 评测:七个指标分别绑定最合适的评估者,Text Richness 用 LLM 与真实回复成对排序(交替顺序消除位置偏置),Image Diversity 用 DINOv3 相邻图相似度并只在超过阈值 $\tau=0.85$ 时惩罚,Context Fidelity 采用评测集构建时派生的原子化 rubric 验证协议并可部分给分,Subject Consistency 用位置对齐的参考图做 DINO 余弦相似度。其三,也是结论层面最重要的:通过 RL 只优化图像生成(SFT 后退化的 Image Aesthetic 与 Context Fidelity 被恢复、Image Diversity 进一步提升),就能把整体交错生成推到开源最高分,证明交错生成可以从模态专属优化中获益,无需每阶段都做联合文图训练。
方法步骤详情
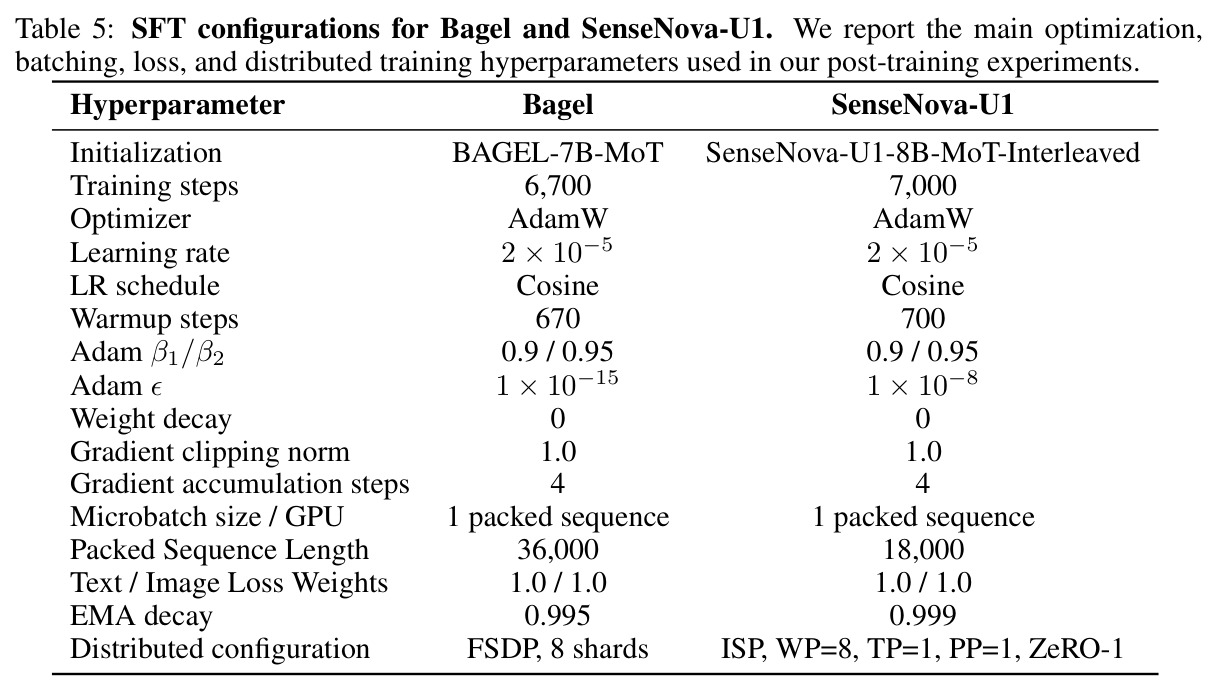
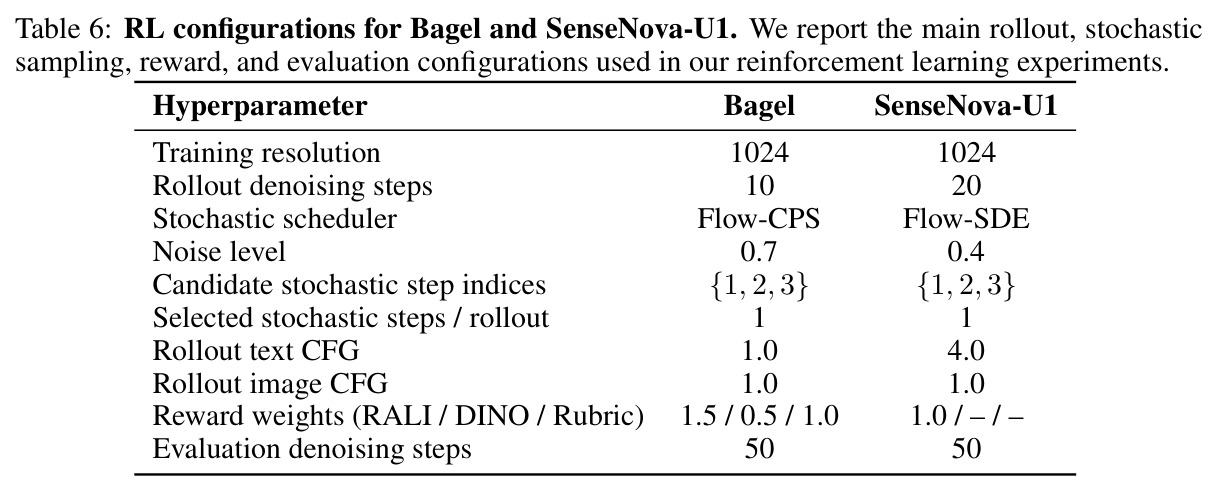
数据管线四步(输入为百万级原始交错语料,输出为 IntReal-100K):Step 1 元数据过滤——保留长宽比在 1:2 到 2:1 之间的图像,剔除 GIF/WebP,Wiki 类与下厨房要求短边 ≥512px、三部动画放宽到 384px(老动画原生分辨率低);Step 2 表示过滤——RALI 要求单图得分 >3.0 且样本内均值 >3.5,用 5000 条人工标注的下厨房样本微调 SigLIP2 二分类器检测水印与人脸(held-out F1=0.82,人脸过滤仅对下厨房启用),DINOv3 序列内去重要求相邻图特征相似度 <0.85;Step 3 VLM 精修——Qwen3.5-397B-A17B 为每张图生成 caption 并润色周边文本,原则是原文事实优先于生成 caption;Step 4 LLM 标注——为每个样本生成用户 prompt、序列级与图像级两级推理链,转化为可直接微调 UMM 的结构化交错数据;最后类别均衡采样,保留约 10%。评测集构建:先按图像美学均分 ≥3.8、输出图 3–10 张初筛,再用 Qwen3.5 按 prompt 具体性 ≥3、回复丰富度 ≥4、主题信息量 ≥4 打分,随后做上下文感知 rubric 验证(每张图至少满足一条原子化 rubric 且样本通过率 ≥50%),自动过滤得约 1.5K 候选,人工复核后分层采样出 600 条;每个模型评测需生成 6000+ 张图。后训练:SFT 用 8×H800(lr $2\times10^{-5}$,AdamW,packed 序列长 36000/18000,Bagel 6700 步、U1 7000 步),RL 用 16×H800 的 Flow-Factory,奖励权重 Bagel 为 RALI/DINO/Rubric=1.5/0.5/1.0,随机噪声水平 $\alpha$ 分别为 0.7 与 0.4。
技术新颖性
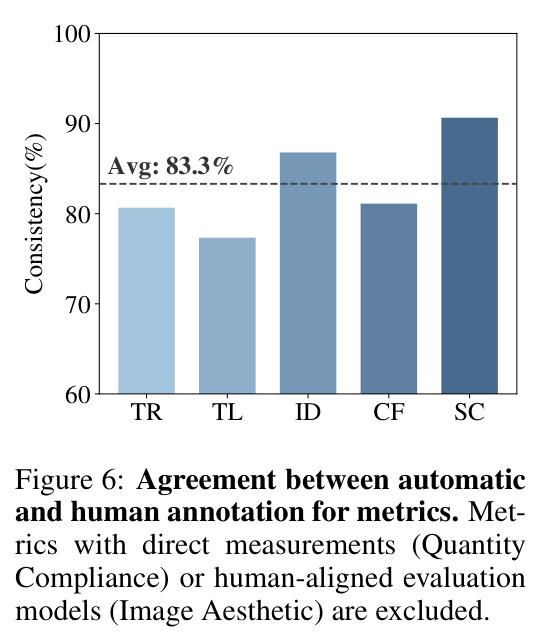
与已有工作的本质区别体现在三个层面。数据层面:MMC4/OBELICS/OmniCorpus 是理解导向的网络语料,无生成导向质量控制;CoMM 有生成过滤但无场景分类学;IntReal 是首个“真实来源 + 分类学引导 + 理解与生成双重过滤 + 许可证逐条核查 + prompt 与两级推理链标注”的交错生成训练集,且统计特征天然分化(Story 每样本约 8.6 张图 vs Planning 约 2.6 张)。评测层面:OpenING/InterleavedEval 依赖整体 VLM 打分,ISG-Bench 的四层结构分解未对应独立能力维度且全靠单一 VLM;IntReal 的每个指标绑定专属专家模型,并给出三项量化验证——成对冗余 $|\rho|\le0.42$、人机一致 83.3%、跨评测器排名 $\rho>0.9$——这是此前交错生成基准缺失的可信度证据;Context Fidelity 的部分给分函数 $CF_i = 0.5 + \frac{K_i-1}{R_i-1}\times 0.5$ 明确区分完全失败与部分满足。训练层面:首次把 Flow-GRPO 应用于交错上下文条件下的下一图生成,并实证评测指标可直接充当奖励(配 GDPO 平衡多奖励),得出“模态专属优化迁移到交错生成”的新结论,突破了交错生成只能靠交错数据联合 SFT 的惯性思路。
实验结果
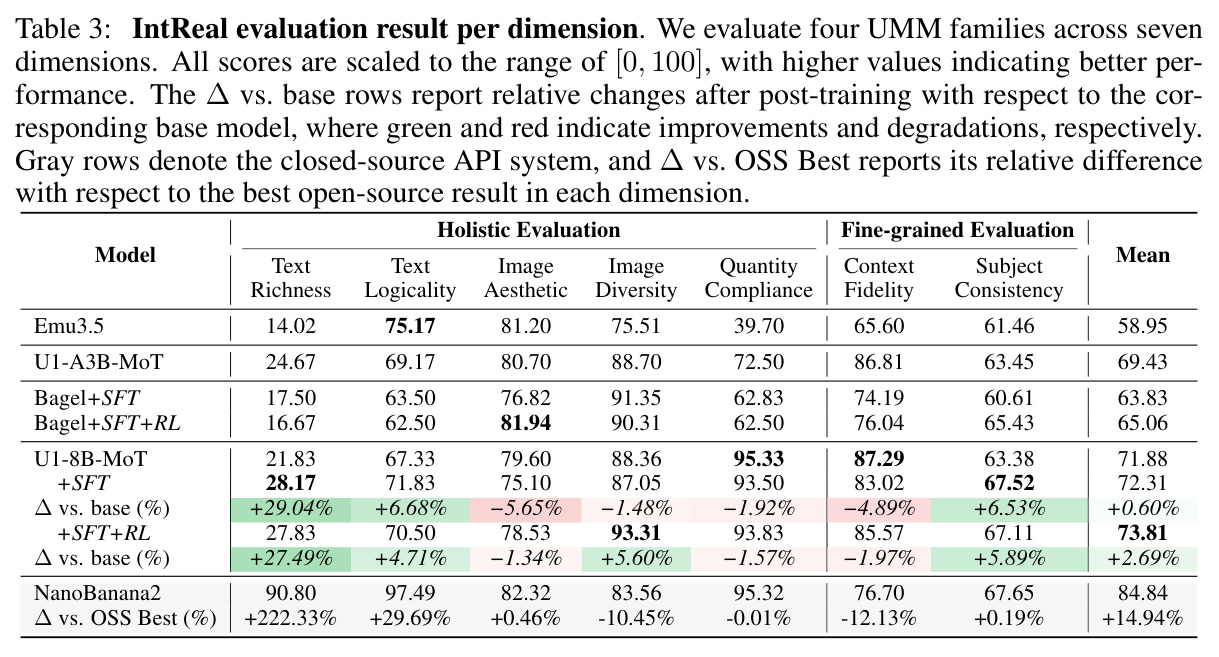
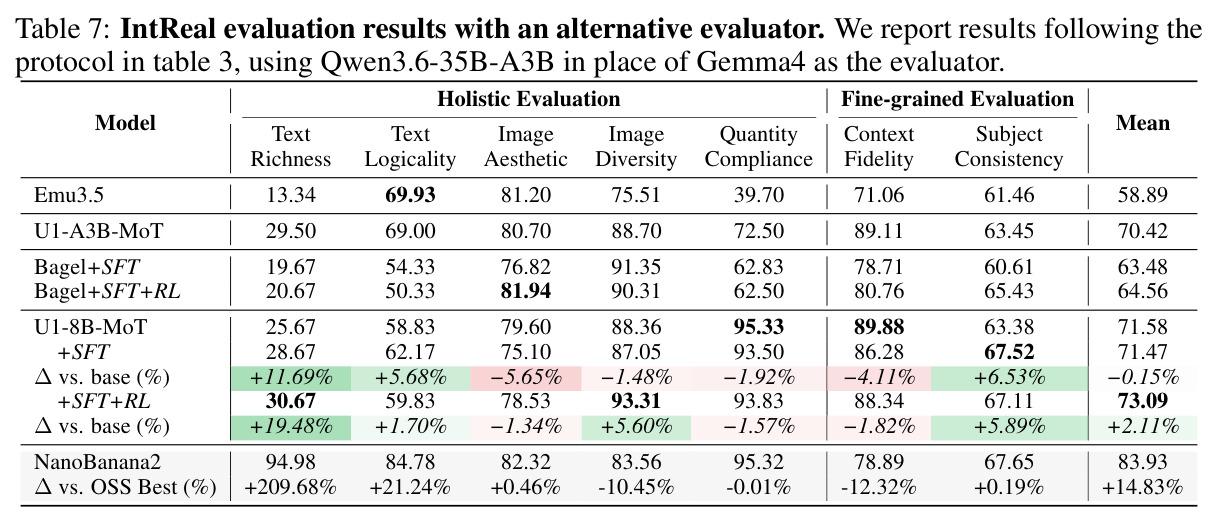
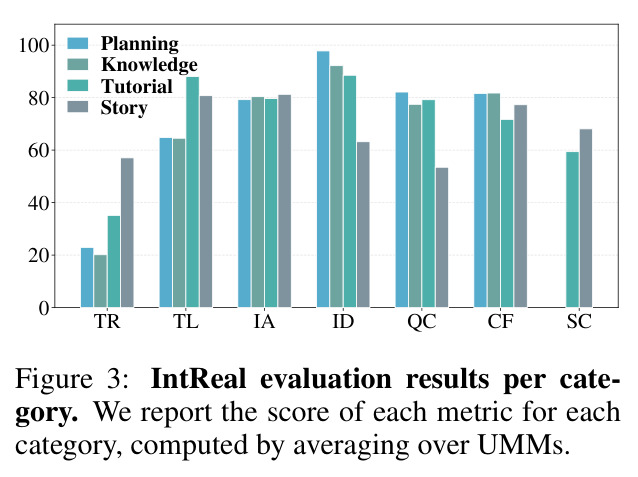
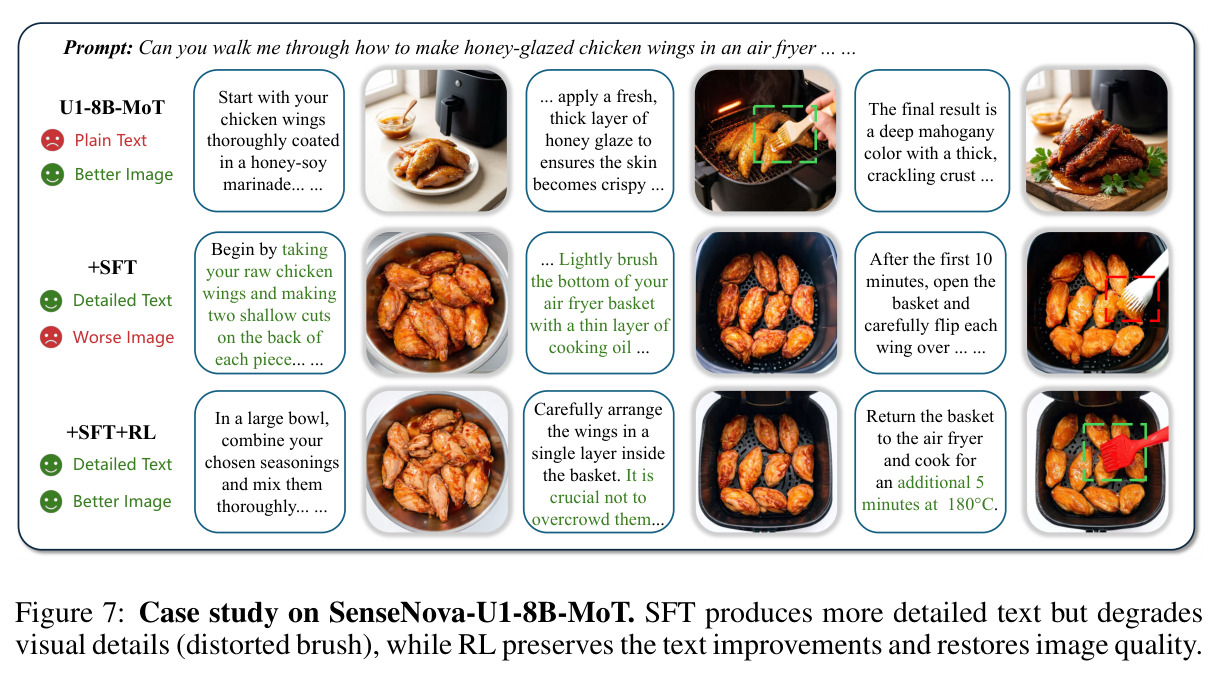
实验结果可分四块解读。(1)基准测试(Table 3,四族 UMM,分数归一到 [0,100]):U1-8B-MoT+SFT+RL 取得开源最高均分 73.81;Emu3.5 均分 58.95,虽然 Text Logicality 在开源中最高(75.17),但 Text Richness 仅 14.02、Quantity Compliance 仅 39.70,暴露严重短板;闭源 NanoBanana2 均分 84.84,Text Richness 90.80(相对开源最佳 +222.33%)、Text Logicality 97.49,但在交错特有维度上反而落后——Image Diversity 83.56(−10.45%)、Context Fidelity 76.70(−12.13%),说明强单模态能力是必要非充分条件。(2)类别差异(Fig 3):Planning/Knowledge 更依赖文本丰富度与逻辑性;Tutorial 在细粒度评测下 Context Fidelity 与 Subject Consistency 最低、最难;Story 序列长,Quantity Compliance 与 Image Diversity 挑战最大。(3)套件可靠性(Fig 4/5/6):七指标成对样本级 Spearman 相关绝对值最大 0.42,冗余低;自动评测与专家人判在 750 对比较(10 个模型对 × 每对 15 例 × 5 个主观指标)中平均一致率 83.3%;换用 Qwen3.6-35B-A3B 评测器后模型排名相关性 TR 0.905、TL 0.929、CF 0.976,均超 0.9。(4)后训练(核心发现):U1-8B-MoT 经 SFT 后 Text Richness +29.04%、Text Logicality +6.68%、Subject Consistency +6.53%,但 Image Aesthetic −5.65%、Context Fidelity −4.89%,印证 UMM 中文图优化的张力;接续 Flow-GRPO 后 Image Aesthetic 恢复到仅 −1.34%、Context Fidelity 反超基线至 +5.89%,Image Diversity 再 +5.60%,均分达开源最高的 73.81——证明只训练图像这一单模态即可提升整体交错生成。另观察到位移:开源与闭源的差距主要集中在文本模态,图像模态差距很小,与“语言更吃参数、视觉更吃数据”的结论一致。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 多模态交错生成(七维总评) | IntReal Overall 均分 [0,100] | U1-8B-MoT+SFT+RL = 73.81(开源最佳) | U1-8B-MoT 原始检查点 = 71.88 | +2.69%,在全部开源模型中均分第一 |
| 交错生成·文本丰富度(整体设定) | Text Richness [0,100],LLM 成对排序胜/平计 1 | U1-8B-MoT+SFT = 28.17 | U1-8B-MoT 基线 = 21.83;闭源 NanoBanana2 = 90.80 | SFT 相对基线 +29.04%;闭源仍领先开源最佳 +222.33% |
| 交错生成·图像美学(整体设定) | Image Aesthetic [0,100],RALI 归一化均值 | U1-8B-MoT+SFT+RL = 78.53 | SFT 后跌至 75.10(相对基线 79.60 为 −5.65%) | RL 使美学相对 SFT 回升 +4.56%,退化从 −5.65% 收窄到 −1.34% |
| 交错生成·上下文忠实(细粒度下一图生成) | Context Fidelity [0,100],原子化 rubric 验证 | U1-8B-MoT+SFT+RL = 67.11 | U1-8B-MoT 基线 = 63.38(SFT 曾退化至 67.52,−4.89%) | RL 后反超基线 +5.89%,完全修复 SFT 造成的退化 |
| 交错生成·图像多样性(整体设定) | Image Diversity [0,100],DINOv3 相邻图相似度惩罚 | U1-8B-MoT+SFT+RL = 93.31 | U1-8B-MoT 基线 = 88.36 | +5.60%,且闭源 NanoBanana2(83.56)反而落后开源最佳 10.45% |
| 评测套件·人机一致性 | 自动评测与专家人判一致率 | 平均 83.3%(750 对专家标注比较) | 无(方法学验证实验) | 辅以指标冗余 $|\rho|\le0.42$、跨评测器排名 $\rho>0.9$ 的三重验证 |
局限与改进
作者承认的局限有二:其一,构建高质量真实交错数据需要激进过滤,最终保留率仅约 10%,任何一段有缺陷都会导致整条长样本被丢弃,扩展成本高;其二,为保持实验设置干净,未探索单模态生成数据与交错数据的混合后训练。此外作者强调 Overall 均分只是粗粒度参考,应逐维度查看。我自己的观察补充五点:第一,评测集仅 600 条(每类 150),且 Subject Consistency 只在 Tutorial/Story 上计算,小样本下指标方差与统计功效存疑;第二,Text Logicality 是二元判定,是三个 VLM 指标中跨评测器差异最大者——NanoBanana2 在 Gemma4 与 Qwen3.6 下相差 12.71 分(97.49 vs 84.78),说明事实/逻辑判断对评审模型本身能力敏感;第三,Story 数据取自三部动画的视频帧与字幕,其图像风格(截图)与模型生成图分布有差距,可能使该类评测对生成模型偏难;第四,Quantity Compliance 采用与参考样本图数的严格精确匹配,会惩罚合理但数量不同的输出;第五,闭源 NanoBanana2 无法确认其交错能力是原生还是 agentic 流水线实现,作为对照基线的可比性有限;另外 Emu3.5 有 8 条样本因超上下文被排除(按 592 条计),NanoBanana2 有 2 条被安全护栏误拦(按 598 条计),虽影响小但属协议不对称。
独立分析的弱点
弱点一:数据保留率 10% 意味着 90% 的原始语料被丢弃,可扩展性受限,且过滤阈值(如 RALI>3.0、相邻相似度<0.85)是人工设定而非学习得到的——改进方向是作者已提出的合成数据增强,或改用质量加权采样/课程学习代替硬过滤。弱点二:两阶段后训练后 Image Aesthetic 仍残留 −1.34% 的退化,且 RL 只优化图像分支、文本维度奖励未启用——改进方向是把 7 指标全部纳入多目标 RL(论文已用 GDPO 平衡多奖励,扩展到文本侧是自然延伸),或做交错+单模态美学数据的混合训练。弱点三:Text Logicality 的二元判定让长交错回复的事实核查高度依赖评审模型,证据是其跨评测器波动最大(NanoBanana2 差 12.71 分)——改进方向是逐声明分解验证或引入检索增强的事实核查。弱点四:Subject Consistency 用 DINOv3 余弦相似度,对风格变化稳健但对“画对了主体却画错关键属性”不敏感——改进方向是叠加 VLM 属性级一致性检查。弱点五:评测集与训练集来自同一管线和来源(Wiki/下厨房/动画),可能共享分布偏置(如对百科式文风的偏好)——改进方向是引入独立来源的 out-of-distribution 评测子集。弱点六:Quantity Compliance 严格匹配参考图数,现实中“同一内容可用不同图数表达”,二值判定过于刚性——可改为容差区间或比例评分。
未来方向
作者明确提出的方向有两个:合成数据增强以缓解 10% 低保留率的数据瓶颈;单模态生成数据与交错数据的混合后训练,以在保持文本增益的同时修复图像退化。基于论文成果还可延伸:其一,把七个指标扩展为统一的多目标奖励框架,对文本维度(Richness/Logicality)也做 RL,实现全模态强化学习而非仅图像侧;其二,利用四类场景分类学做数据配比消融,回答“哪类数据对哪类能力贡献最大”,指导面向应用的数据配方;其三,从一次性交错生成扩展到多轮对话式交错生成(如 WEAVE 的多轮设定)与交互式应用,如可提问的图文教程 agent;其四,扩展到视频-文本交错生成,Tutorial 与 Story 场景天然适配;其五,测试时扩展策略——先生成结构化大纲再逐段填充图文,可能改善 Quantity Compliance 与 Image Diversity;其六,利用 NanoBanana2 在文本丰富度上的巨大优势(90.80 vs 开源最佳 28.17)做跨模型蒸馏或 rejection sampling 合成高质量交错文本数据。
复现评估
可复现性总体较好但算力门槛不低。开源情况:论文配有项目主页(https://yushaohan.github.io/IntReal/),附录完整给出了数据许可证(7 个来源均允许公开收集与非商业再分发,Wiki 类为 CC BY-SA,附录 A.1 逐条说明)、SFT 与 RL 全部超参数(Table 5/6:AdamW,lr $2\times10^{-5}$,cosine 调度,packed 序列长 Bagel 36000/U1 18000,Flow-CPS 噪声 $\alpha=0.7$、Flow-SDE $\alpha=0.4$,奖励权重 RALI/DINO/Rubric=1.5/0.5/1.0 等)、评测 prompt 与指标数学定义(附录 B.2/B.3 公式 (1)–(9))。算力需求:评测部分每个模型需生成 6000+ 张 1024×1024 图像;SFT 在单节点 8×H800-80G 上完成,RL 需要两节点共 16×H800;Emu3.5 有 8 条样本在 8×H800 上仍超显存/上下文。数据侧复现最难:需要 Qwen3.5-397B-A17B 级别的 VLM 做 caption、润色与标注,外加人工复核(评测集的人工审核环节难以完全自动化)。难度评估:评测协议复现容易(判官 Gemma4 开源、协议明确、指标公式完备);后训练复现中等偏高(需 H800 级多卡,但代码框架 Flow-Factory、GDPO、MixGRPO 均有公开实现);从零重建数据集最困难。对有算力资源的团队,整体属于可复现但非轻量级的工作。
论文图表
对比 MMC4、OBELICS、OmniCorpus、CoMM 与 IntReal 五个交错数据集在四个维度的差异:数据过滤(理解导向/生成导向)、分类学、数据来源(网络 vs 网络+视频)。只有 IntReal 同时具备理解与生成双重过滤、四类场景分类学、网络与视频双来源。
定位数据集贡献在相关工作坐标系中的位置,一眼看清“分类学+双重过滤”的组合是本文独有的。