DeFT-RAG:将多跳问题分解为答案可复用的自包含子问题 DeFT-RAG: Decomposing Multi-Hop Questions into Self-Contained Sub-Questions with Reusable Answers
逐个生成自包含子问题,把跟踪与判决交给规则QA表和微调小模型,并跨问题缓存复用答案
前置知识
检索增强生成(RAG)
LLM 的知识固化在参数里,过时或缺失时会产生幻觉。RAG 先从外部语料中检索与问题相关的段落,再把段落放进上下文让 LLM 生成答案:$a=\mathrm{LLM}(Q, R(Q,C))$。最朴素的实现(vanilla RAG)用稠密向量余弦相似度或 BM25 做检索,取 top-k 段落一次性作答。它是本文的对照基线与改进对象。
全文都在讨论 RAG 在多跳问题上的失效模式与修复方案,不熟悉检索-生成两段式流程就无法理解论文的任何实验设计与对比对象。
多跳问答与桥接实体
多跳问题无法从单个段落作答,需要串联分散在多篇文档中的事实链;链中间那些问题从未点名、必须先被找到才能继续推理的实体叫桥接实体(bridge entities)。例如“Darlings 的表演者成军的城市里灰狗巴士从哪发车”需要依次找到 Darlings→Kevin Drew→Toronto→Toronto Coach Terminal,其中 Kevin Drew 和 Toronto 就是桥接实体。
桥接实体不可预知正是规划式分解失败的根源,也是“自包含子问题”这一核心设计要解决的问题;论文的关键分析(Table 3 的覆盖率按 hop 数统计)都围绕它展开。
图式 RAG 与迭代式 RAG
多跳 RAG 的两条主流改进路线。图式 RAG 离线用 LLM 抽取实体关系建图(GraphRAG、HippoRAG、LightRAG 等),答题时从问题提到的实体出发沿图边收集段落,多为每题一次检索;迭代式 RAG(IRCoT、Self-Ask、LogicRAG、Hi-Q)把问题分解为子问题,交替执行检索与 LLM 推理,让后一步子问题用上前一步找到的桥接实体。
本文的贡献必须放在这两条路线的坐标系里理解:Table 2 的 13 个基线全部来自这两类,引言中对 planning/dependency/rewriting/tracking 四类错误的划分直接对应迭代式方法的设计缺陷。
固定 top-k 检索
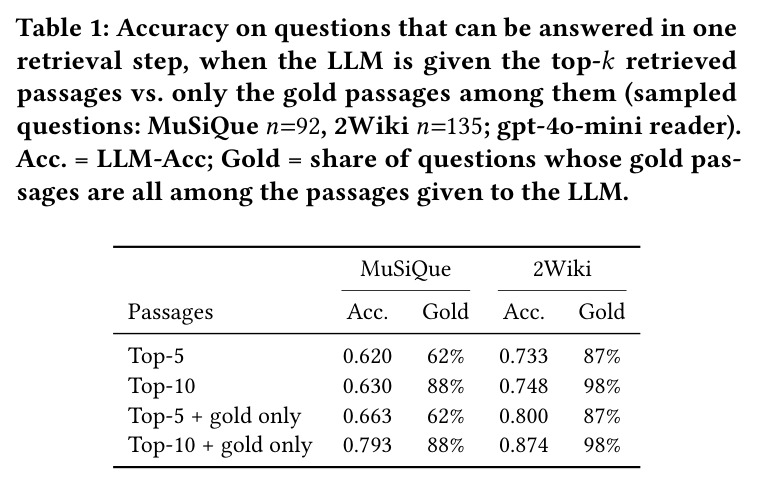
绝大多数 RAG 系统预先固定检索段落数 k,只按与查询的相似度排序返回 $R_k(q,C)=\mathrm{top}_k\, s(e(q),e(p))$。k 小则漏掉部分证据,k 大则证据被大量相似但无用的段落淹没。论文 Table 1 显示:把 MuSiQue 单步可答问题从 top-5 扩到 top-10,gold 段落齐全率从 62% 升到 88%,但准确率几乎不动(0.620→0.630),只保留 gold 段落才能到 0.793。
这正是 DeFT-RAG 用决策模型做相关性过滤(宽松检索 w=10 + 严格筛选每步最多留 5 段)的直接依据,理解它才能看懂消融实验为什么掉点。
LoRA 微调与校准的 yes/no 概率模型
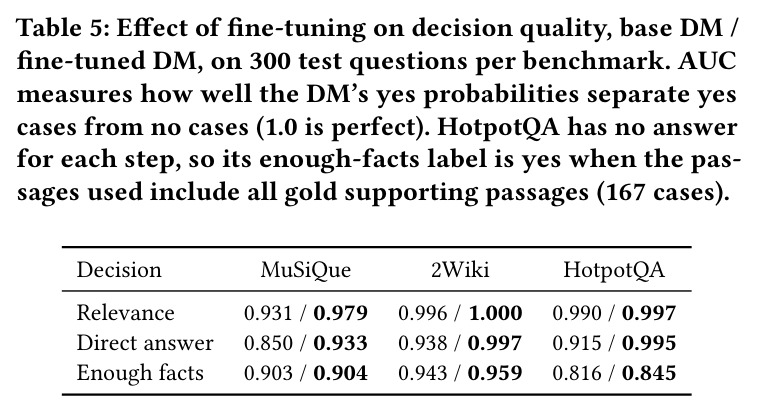
LoRA 在冻结的大模型旁挂低秩适配矩阵,只训练极少量参数即可完成领域适配。StartLux-Decision-4B 是一个 4B 参数、专门输出校准 yes/no 概率的语言模型:$p_{DM}(yes\mid x)$ 在数值上反映 yes 真正正确的频率,因此可用固定阈值判决 $D(x)=\mathbb{1}[p_{DM}(yes\mid x)\ge\tau]$。本文用 LoRA(rank 16)只训练 32.5M/4.24B 参数,两块消费级 GPU 约 6.4 小时完成。
DeFT-RAG 把全部判决任务外包给这个轻量 DM 是方法成立的前提,不理解 LoRA 与概率校准就无法评估其训练成本与判决质量的来龙去脉。
LLM-as-judge 评测与 McNemar 检验
开放域问答常用 EM(精确匹配)和 token F1,但它们会低估用完整句子作答的系统,因此本文另用 LLM 按 SimpleQA prompt 判定答案是否正确作为主指标(LLM-Acc);为避免模型给自己打分,gpt-4o-mini 的答案由 Qwen3.6 评判、反之亦然。两个系统在同一批题目上的配对表现差异用精确 McNemar 检验判断统计显著性。
看懂 Table 2 的指标含义与“显著/持平”的判断标准需要这两个评测概念,否则无法正确解读“+5.2 点且显著”这类结论的强度。
研究动机
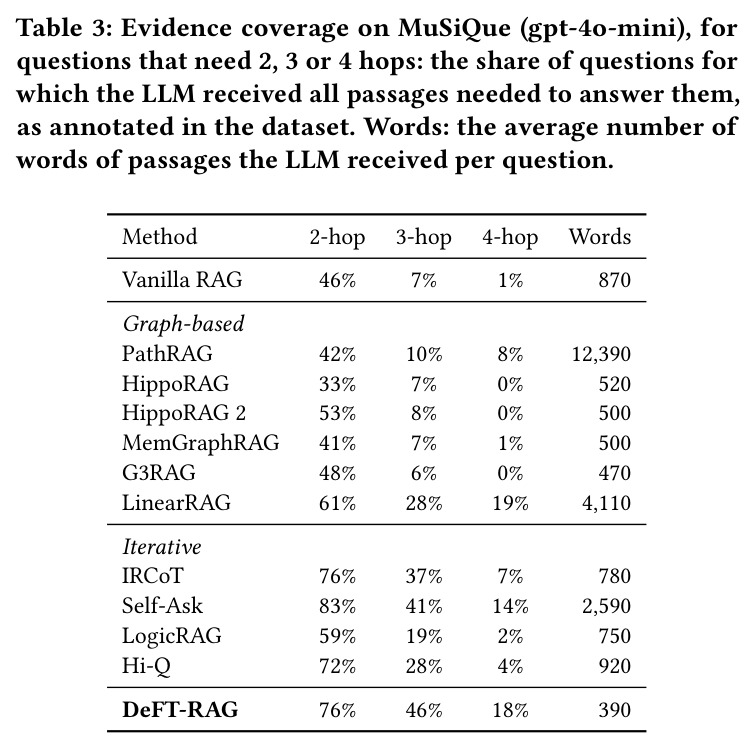
RAG 在多跳问答上表现很差,根本原因是答案的事实链穿过问题从未提及的桥接实体。以 MuSiQue 为例,vanilla RAG 的固定 top-k 相似度检索只为 7% 的 3-hop 问题检索到完整证据链;图式 RAG 大多只有 6–10%(最强的 LinearRAG 达 28%,但代价是每题喂给 LLM 约 4,100 词、近 vanilla RAG 的 5 倍,且大部分与证据无关)。迭代式 RAG 虽把全链覆盖率提到 19–41%,却让 LLM 在一次调用里同时承担规划子问题、判断依赖、随答案重写子问题、在长上下文中跟踪已知事实等多项任务,每项都引入一类错误:LogicRAG 在“Top Gun 吉他手的厂牌所有者”一题中把子问题错规划成“主题曲作曲家的厂牌”(规划错误);依赖连接错序会让子问题在所需事实找到之前就被检索(依赖错误,Figure 1b);Hi-Q/REAP 在答案到来后可能没把占位符换成实体名或换成错误实体(重写错误);IRCoT 在 greyhound/Darlings 一题中明明已在推理中写出乐队成立于多伦多,却跟随费城的灰狗段落答错(跟踪错误,Figure 1c)。此外固定 top-k 使问题雪上加霜:top-5→top-10 只把 gold 覆盖从 62% 提到 88%,准确率几乎不变(0.620→0.630),只保留 gold 段落才能到 0.793。最后,迭代方法答题后即丢弃全部中间结果,而同一语料上的多跳问题常共享中间事实,造成大量重复检索与调用的浪费。
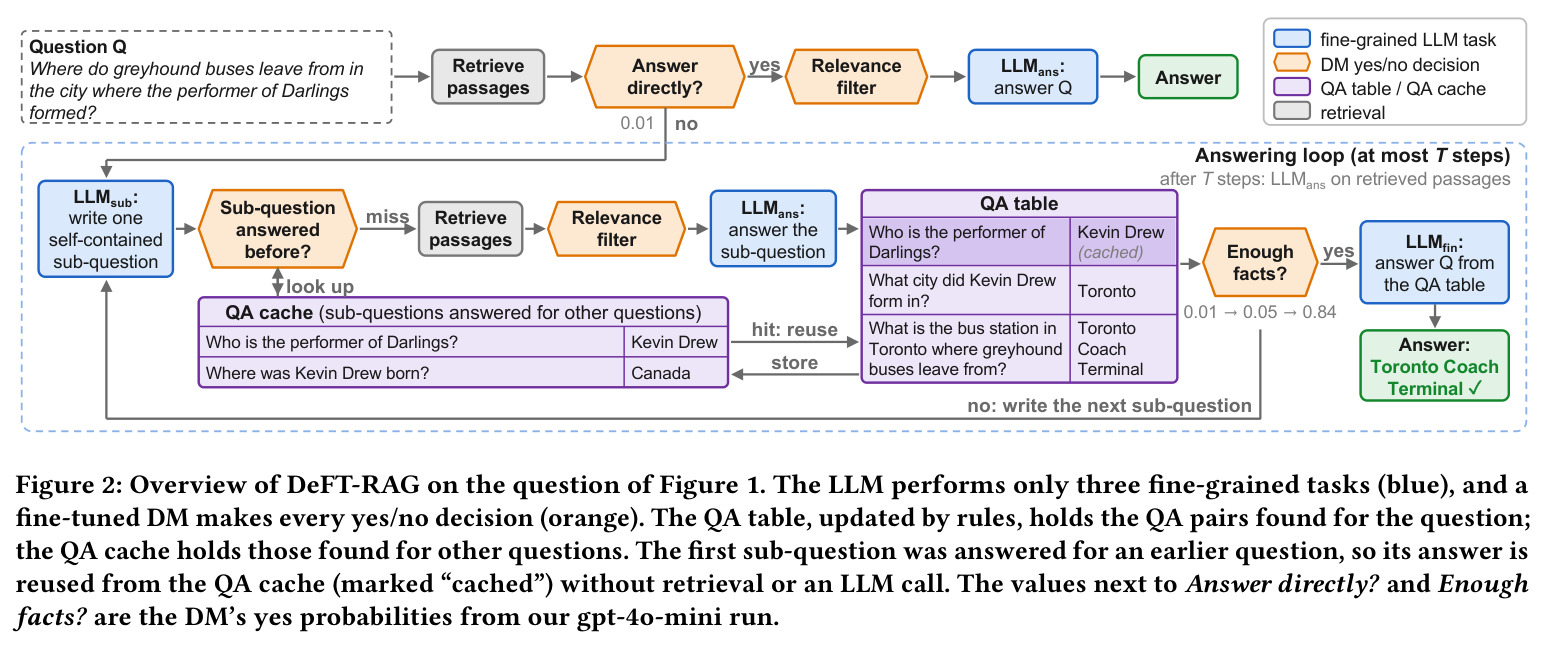
本文的目标是本文目标是构建一个不牺牲效率的多跳 RAG 框架,同时做到三点。其一,把 LLM 的任务压缩为三个短输入、短输出的细粒度文本生成任务——写出下一个自包含子问题(LLM_sub)、从筛选后的段落回答子问题(LLM_ans)、从已积累的 QA 表回答原问题(LLM_fin),从机制上消除规划、依赖、重写、跟踪四类错误;其二,把所有二选一判断(检索段落是否相关、原问题可否一步直答、已知事实是否足够、缓存候选是否同义)交给一个微调过的 4B 轻量决策模型 DM,骨干 LLM 保持冻结、可任意替换;其三,通过跨问题共享的 QA 缓存复用子问题答案,减少重复检索与 LLM 调用。最终目标是:在 MuSiQue、2WikiMultiHopQA、HotpotQA 三个基准上,以比所有迭代方法更少的输入 token 取得 13 个基线中的最高准确率。
与已有工作不同的是,已有迭代式 RAG 把“先规划整棵子问题树再执行”当作默认范式,本文的切入点是彻底放弃规划:每一步只根据原问题和已有 QA 对生成一个自包含子问题——它点名自己询问的每个实体、不依赖任何其他子问题的答案,因此桥接实体无需预先猜测、不存在依赖边、答案到来后无需重写,三类错误不是被修补而是在设计上不可能发生。第二个独特视角是“认知外包”:LLM 只负责文本生成,状态跟踪交给由纯规则更新的 QA 表 $F_t$,所有判决交给输出校准概率的 4B 决策模型,这与训练骨干 LLM 自身做决策的 Self-RAG/Search-R1 路线相反,换取了可插拔性与极低的训练成本。第三个视角是把子问题答案当作可跨问题复用的语料级资产:自包含性保证“Sazerac 公司总部在哪个城市”无论源自哪个原问题答案都相同,从而使 QA 缓存成为可能——这是此前迭代式 RAG 完全忽视的维度。
核心方法
直觉上,多跳问答失败不是因为 LLM 不够聪明,而是一次让它做太多事。DeFT-RAG 用三个组件把工作拆细。第一,增量式问题分解:LLM 每次只做一件事——从原问题 $Q$ 和已有 QA 表 $F_t$ 生成下一个自包含子问题 $q_{t+1}=\mathrm{LLM}_{sub}(Q,F_t)$;子问题点名它询问的所有实体、可独立检索和回答,如此逐跳补齐证据链,直到 DM 判定事实足够。第二,LLM 之外的处理:QA 表由纯规则更新($F_{t+1}=F_t\cup\{(q_{t+1},a_{t+1})\}$,无任何模型调用),承担“已知什么”的跟踪;微调过的轻量决策模型 DM(StartLux-Decision-4B,4B 参数)做全部 yes/no 判断——段落相关性 $D_{rel}(q,p)$、可否直答 $D_{direct}(Q,R_w(Q,C))$、事实是否足够 $D_{suff}(Q,F_t)$,判定规则为 $D(x)=\mathbb{1}[p_{DM}(yes\mid x)\ge\tau]$。第三,QA 缓存:新子问题先查跨问题共享的缓存,同义则直接复用答案,省去检索和 LLM 调用。整个流程(Algorithm 1)最多 T=6 步,超时则回退为从 top-20 检索段落中筛选后直答。
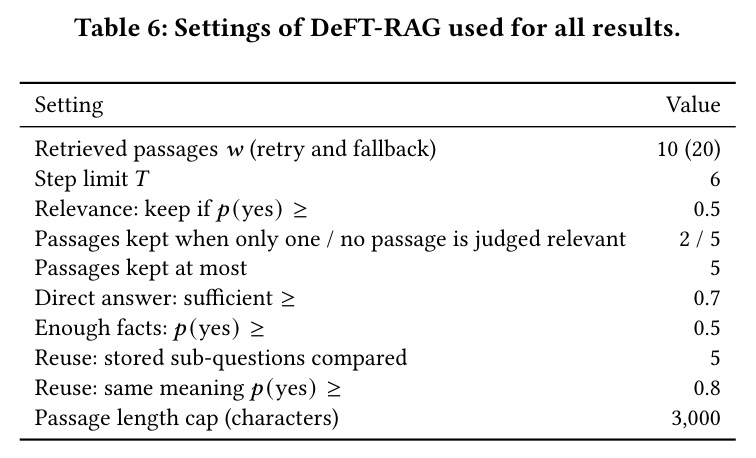
核心创新是把“自包含子问题”作为贯穿全局的不变量,用它同时替代了以往系统的三个模块。规划器(LogicRAG、REAP)之所以存在,是因为子问题间有依赖;依赖建模与重写器(Hi-Q、REAP)之所以存在,是因为子问题里留有占位符。DeFT-RAG 的每个子问题都点名全部实体(如把“that sea”改写成“莱茵河注入的海(北海)”),不依赖其他子问题,于是规划、依赖、重写三类错误在机制上被消除,LLM 每次只面对一个细粒度任务。与之配套的两个设计同样关键:一是把跟踪交给外部 QA 表——LLM 的输入始终短且信息密度高(每题 1,569 输入 token,而 Self-Ask 为 6,140、Hi-Q 为 13,928),从源头缓解长上下文丢失事实的跟踪错误;二是让微调 DM 以校准概率承担所有判决(相关性 τ=0.5、直答 τ=0.7、足够 τ=0.5),并用“宽松检索 w=10 + 严格过滤每步最多留 5 段”取代固定 top-5,让 LLM 看到更多所需段落、更少干扰段落——Table 1 显示只保留 gold 段落可把单步问题准确率从 0.630 提到 0.793。自包含性还带来复用红利:同义子问题的答案与原问题无关,可跨题缓存(τ=0.8 从严判定同义,防止错误传播)。
方法步骤详情
完整流程见 Algorithm 1,输入为问题 Q、语料 C、检索量 w=10、步数上限 T=6。第 1 步:用 Qwen3-Embedding-4B 为 Q 检索 top-10 段落;第 2 步:DM 判断 $D_{direct}(Q,R_w(Q,C))$,若 yes 概率 ≥0.7 则 LLM_ans 直接从这些段落回答并结束——这使单步问题只需 1 次 LLM 调用;第 3 步:否则开一个空 QA 表进入循环。每步内:LLM_sub 读取 Q 与 QA 表 $F_t$,写出下一个自包含子问题(提示词要求优先询问未被解决的描述性指称,如“Y 的作者是谁”先于“Y 作者的出生地在哪里”);随后为该子问题检索 top-10 段落,DM 逐段判断相关性(τ=0.5),最多保留 5 段给 LLM_ans(只判中 1 段时保留 2 段、全未判中时保留 top-5 兜底),得到短答案 $a_t$;若 $a_t$ 非空则按规则更新 $F_{t+1}=F_t\cup\{(q_t,a_t)\}$,无效子问题会被记录并禁止重问,措辞重复的子问题会被检出并要求换写法。每步之后 DM 判断 $D_{suff}(Q,F_t)$(τ=0.5),满足则 LLM_fin 仅凭 QA 表中的事实回答 Q(提示词内置日期/年龄比较规则)。若 T 步仍未结束,回退为从 top-20 检索段落中筛选相关后直答。缓存路径:新子问题先做忽略大小写与标点的精确匹配,未命中则取缓存中最相似的 5 个候选,由 DM 判断同义(τ=0.8,从严以防错误传播),命中即复用答案,否则正常作答并把新 QA 对写入缓存。
技术新颖性
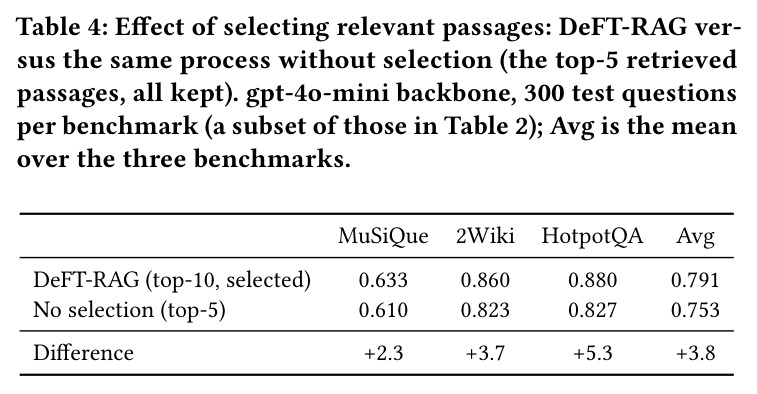
技术新颖性体现在三处。(1) 机制级消除而非修补:以往工作用更强的规划器、更细的依赖图、更聪明的重写器去减少错误,本文通过“自包含”不变量让这三类错误无从发生,属于问题表述层面的创新。(2) 判决与生成解耦:用 LoRA 微调的 4B 校准概率模型(只训练 32.5M/4.24B 参数,两块 RTX A5000 约 6.4 小时,训练数据 48,036 样本全部来自基准训练集 gold 标注并通过泄漏检查)承担全部 yes/no 决策,骨干 LLM 完全冻结、即插即换(gpt-4o-mini 与 Qwen3.6-35B-A3B 双骨干均验证有效),相比训练骨干的 Self-RAG/Search-R1/R1-Searcher 路线成本降低几个数量级;宽松检索+严格过滤也不同于 reranker 那样保留固定数量。(3) 跨问题答案复用首次引入多跳 RAG:把中间 QA 对沉淀为语料级缓存资产,1,000 题内 23.1% 子问题命中、LLM 调用省 12.9% 而准确率不降。消融证明各组件缺一不可:去掉段落选择平均掉 3.8 点,去掉 DM 微调端到端掉 3.6 点。
实验结果
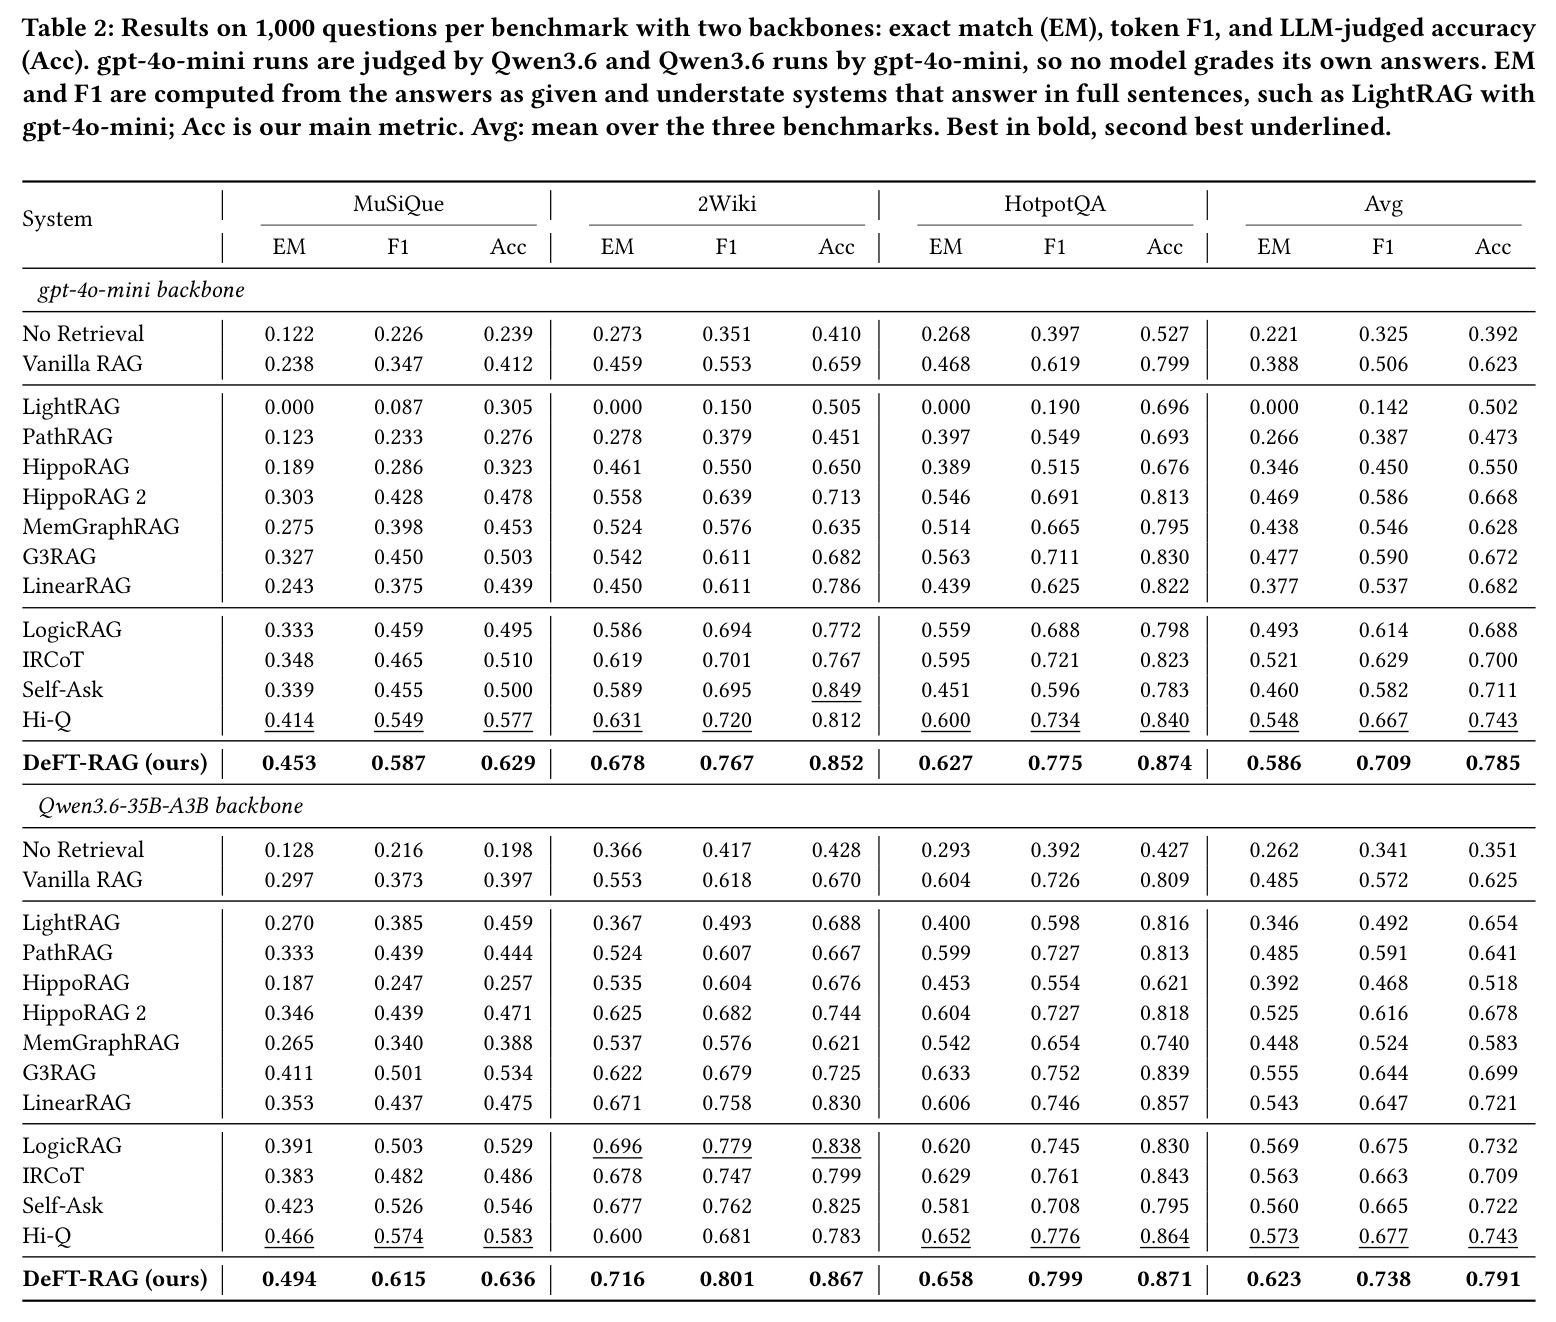
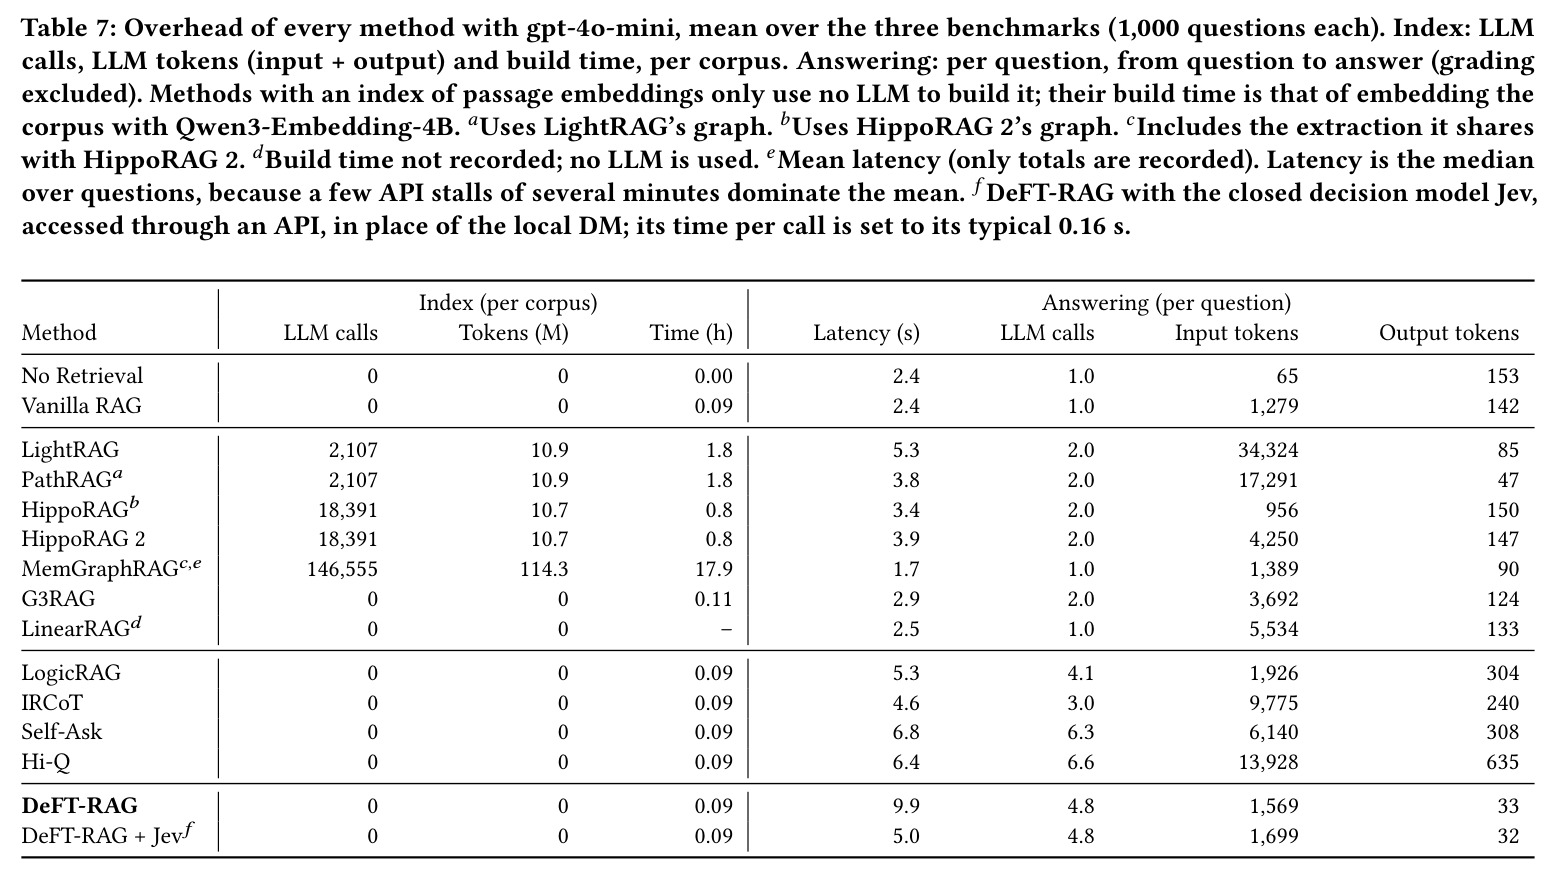
评测在三个基准各 1,000 题、两个骨干(gpt-4o-mini API 与本地 Qwen3.6-35B-A3B)、13 个基线上进行,指标为 EM、token F1 与 LLM 判定的准确率(SimpleQA prompt、交叉评判避免自评、McNemar 检验显著性)。主结果(Table 2):DeFT-RAG 在全部 6 个设置的三项指标均第一。增益最大的 MuSiQue(链最长):gpt-4o-mini 准确率 0.629,超最强基线 Hi-Q(0.577)5.2 点;Qwen3.6 下 0.636 对 0.583,超 5.3 点,均显著。2Wiki:0.852,与 Self-Ask(0.849)持平;Qwen3.6 下 0.867,超 LogicRAG 2.9 点(显著)。HotpotQA:0.874,超 Hi-Q 3.4 点(显著);Qwen3.6 下 0.871 与 Hi-Q(0.864)持平。机理验证(Table 3):DeFT-RAG 为 46% 的 3-hop 和 18% 的 4-hop 问题送齐全链,均为所有系统最高,且每题仅喂 390 词,不到 vanilla RAG(870 词)的一半,而 Self-Ask 覆盖 41% 需 2,590 词、LinearRAG 覆盖 28% 需 4,110 词。消融(Table 4):去掉 DM 段落选择后三个基准分别掉 2.3/3.7/5.3 点。DM 微调(Table 5):直答判决 AUC 0.850→0.933(MuSiQue)、0.938→0.997(2Wiki)、0.915→0.995(HotpotQA),相关性 0.931→0.979,端到端把 300 道 MuSiQue 题的准确率从 0.587 提到 0.623。复用(§4.6):1,000 题共享一个 QA 缓存,23.1% 的子问题命中缓存,LLM 调用减少 12.9%,准确率 0.642 对 0.629(p=0.18)不降。开销(Table 7):每题输入 1,569 token(所有迭代方法中最低,Hi-Q 为 13,928)、输出 33 token(全场最少)、LLM 调用 4.8 次(Self-Ask 6.3、Hi-Q 6.6);索引仅需约 5 分钟嵌入、零 LLM 调用,而 MemGraphRAG 需 146,555 次 LLM 调用、114.3M token、17.9 小时建图;代价是延迟中位数 9.9 秒为全场最高,主因是本地 DM 串行推理(每题 3.2–7.0 次调用、每次 1.6–1.8 秒,占总时长约 60–70%),换 API 决策模型 Jev(每次约 0.16 秒)后延迟降至 5.0 秒,精度损失不超过 1.2 点。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MuSiQue 多跳问答(gpt-4o-mini 骨干) | LLM 判定准确率(LLM-Acc) | 0.629 | 0.577(最强基线 Hi-Q) | +5.2 点(McNemar 显著) |
| MuSiQue 多跳问答(Qwen3.6-35B-A3B 骨干) | LLM-Acc | 0.636 | 0.583(Hi-Q) | +5.3 点(显著) |
| 2WikiMultiHopQA(gpt-4o-mini 骨干) | LLM-Acc | 0.852 | 0.849(Self-Ask) | +0.3 点(统计上持平) |
| 2WikiMultiHopQA(Qwen3.6 骨干) | LLM-Acc | 0.867 | 0.838(LogicRAG) | +2.9 点(显著) |
| HotpotQA(gpt-4o-mini 骨干) | LLM-Acc | 0.874 | 0.840(Hi-Q) | +3.4 点(显著) |
| MuSiQue 3-hop 完整证据链覆盖 | 全链检索率 / 每题喂词数 | 46% / 390 词 | Self-Ask 41% / 2,590 词;vanilla RAG 7% / 870 词 | 覆盖率最高且词数最少(LinearRAG 4,110 词才到 28%) |
| 每题 LLM 输入开销(gpt-4o-mini,三基准均值) | 输入 token 数 / LLM 调用次数 | 1,569 token / 4.8 次 | 迭代基线 1,926–13,928 token;Self-Ask 6.3 次、Hi-Q 6.6 次 | 所有迭代方法中最低 |
| 跨问题答案复用(1,000 道 MuSiQue 题共享缓存) | 缓存命中率 / LLM 调用节省 / 准确率变化 | 23.1% 命中 / 调用省 12.9% / 0.642(复用) | 0.629(不复用) | 准确率不降(p=0.18),纯省调用 |
局限与改进
作者承认的局限:(1) 嵌套/比较型问题仍是软肋——2Wiki 的“哪部电影导演更年长”类问题上,38% 的嵌套子问题(询问尚未点名的实体,如“未命名导演的出生日期”)拿不到答案,而单关系子问题只有 4% 无答案;235 道此类题中 75 道触及步数上限或循环重复,这正是 gpt-4o-mini 上只能与 Self-Ask 打平(0.852 对 0.849)的主因;(2) “找对人、问错事”——案例中先正确找到 Maradona,却问了他的出生日期而非被签约的日期,DM 误判事实已足够,最终答案错误;(3) 延迟最高(中位 9.9 秒);(4) 对 2Wiki 的 148 个错误做归因,只有约 19 个来自 DM 决策,其余多为骨干 LLM 的子问题生成与阅读错误。我的补充观察:(1) DM 微调标签与三个基准的 gold 分解/证据标注深度耦合,迁移到无标注的新领域需重新构造标签;(2) 直答阈值 0.7 是在部分测试题存档答案上调出的,虽有敏感性分析(0.6–0.8 只影响 ≤13/1000 题、准确率变化 ≤0.1 点),但仍非全自动;(3) QA 缓存只在同基准 1,000 题内验证,真实场景的答案时效性与缓存污染未测;(4) T=6 的步数上限对 5-hop 以上深链会触发回退直答,精度无保障。
独立分析的弱点
独立分析的弱点与改进方向:(1) 子问题自包含性没有校验机制——LLM_sub 仍会生成“未点名导演的出生日期”这类违反不变量的问题(嵌套子问题 38% 无答案),可在子问题进入检索前用 DM 加一道“该问题是否点名了所有实体”的检查,或对比较型问题并行展开两个实体分支;(2) DM 推理是延迟瓶颈(占总时长 60–70%,每题最多 7 次串行调用、每次 1.6–1.8 秒)——可把 10 个段落的相关性打分合并为一次前向、量化或蒸馏到 1B 级模型、用 vLLM 连续批处理压到亚秒级;(3) 相关性过滤完全依赖检索器召回,若 gold 段落不在 top-10 中后续全盘皆输——可对未判中任何相关段落的子问题自动扩大 w 或改写重检索;(4) 缓存同义判断只比对 5 个最相似候选且 τ=0.8 手工设定——规模化后应改用向量索引全库检索加专门训练的等价判断模型,并为缓存条目加时间戳与来源以应对语料更新导致的答案过期;(5) 硬编码的领域规则反而有害——提示词里“比较年龄先问出生日期”的规则在 Maradona 案例中把子问题带偏,应改为让 DM 从数据中学习何时需要哪类属性;(6) 直答分支是 2Wiki/HotpotQA 的主要错误来源(需要一步直答的题在长段落列表中找证据容易失败),可对直答概率做分桶校准或二段确认。
未来方向
论文未设专门的 future work 章节,基于成果可延伸:(1) 把 QA 缓存升级为持久化跨会话记忆库,研究缓存失效、更新与冲突消解策略,与 HippoRAG 的“长期记忆”视角结合,考察缓存命中率随问题规模的 scaling 曲线;(2) DM 与骨干协同优化:用 DM 概率引导检索(confidence-aware top-k)、把 DM 判决能力蒸馏进骨干或反向精炼;(3) 处理聚合与比较型多跳问题(计数、最值、日期比较),目前靠提示词硬规则,可引入专门聚合模块或让分解树支持并行分支;(4) 训练标签自动化:用强 LLM 自动生成 gold 分解替代人工标注,把方法推广到无标注的企业语料与垂直领域;(5) 检索-判决联合训练:让 DM 的相关性判断信号反过来微调嵌入模型,形成检索与过滤的闭环;(6) 超长链(5-hop 以上)与多约束问题的自适应步数控制与停滞检测;(7) 把“细粒度任务外置 + 轻量判决模型”的思想移植到多模态 RAG、Text2SQL、agent 工具链规划等同样多步多判决的场景。
复现评估
复现条件较好。代码与全部 prompt 已开源(github.com/Dingyi-Kang/DeFT-RAG)。数据与索引:三个基准均为公开数据集,测试集与语料采用 LogicRAG 作者发布的版本(各 1,000 题;语料分别为 11,656/6,119/9,811 段落);索引仅需用 Qwen3-Embedding-4B 嵌入语料,每库约 5 分钟,无需任何 LLM 调用。DM:基于 HuggingFace 公开的 StartLux-Decision-4B,LoRA 微调 32.5M 参数(rank 16、alpha 32、dropout 0.05、lr 1e-4、1 epoch、2,262 步),两块 RTX A5000 约 6.4 小时;训练数据 48,036 样本全部来自基准训练集并做了泄漏检查(跳过 gold 段落出现在测试语料中的训练题);附录 C 给出完整数据配方、标签规则与温度校准(1.08)。注意作者声明开源的是代码与 prompts,微调后的 DM 权重可能需自行复现训练。骨干二选一:gpt-4o-mini 走 API(每题约 4.8 次调用,费用可控)或本地部署 Qwen3.6-35B-A3B。总体难度中低:无需训练大模型,一块 24GB 级 GPU 加 API 预算即可复跑主要实验;主要工作量在 DM 训练数据构造与阈值复现(附录 A 已给出全部阈值及敏感性分析)。
论文图表
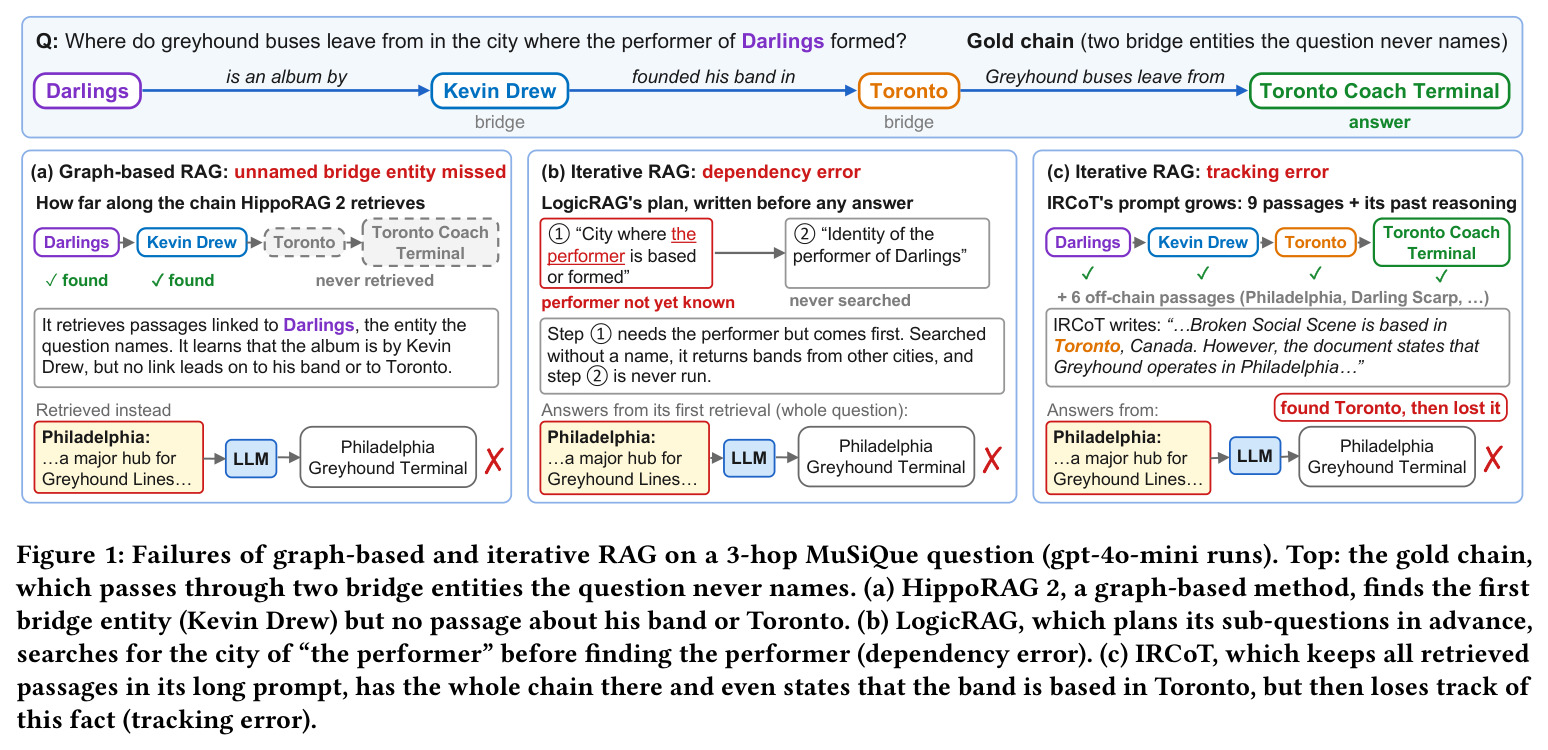
顶部是 gold 证据链:Darlings 是 Kevin Drew 的专辑、他在多伦多成军、灰狗巴士从 Toronto Coach Terminal 发车——两个桥接实体(Kevin Drew、Toronto)均未在问题中出现。下部三个面板:(a) 图式方法 HippoRAG 2 找到第一个桥接实体 Kevin Drew 后无链接可继续,检索不到他的乐队与多伦多的段落,转而命中费城的灰狗段落;(b) 规划式 LogicRAG 在表演者未知时就搜索“the performer 所在城市”(依赖错误),返回其他城市的乐队且从未回头搜索表演者,步骤②永远没有执行;(c) IRCoT 的长提示里明明有全部三段 gold 且推理中已写出“乐队成立于多伦多”,却跟随费城段落给出 Greyhound Terminal ✗(跟踪错误)。
这张图用同一个问题具体演示了论文归纳的四类错误中的三类,是动机部分最直观的证据,直接解释了为什么需要“自包含子问题 + 外部 QA 表 + 判决外置”的设计。
方法伪代码:先为 Q 检索 w 段落并尝试直答($D_{direct}$ 判断);否则循环至多 T 步——LLM_sub 写下一个子问题、DM 从 $R_w(q,C)$ 中过滤相关段落、LLM_ans 作答并把非空答案按规则并入 QA 表、$D_{suff}$ 判定足够后由 LLM_fin 从 QA 表给出最终答案;若 T 步仍未结束,回退为从 top-2w 检索段落中筛选相关后直接作答。
算法是方法的精确规范,所有关键实现细节(w=10、T=6、回退策略、QA 表更新时机)都在其中,是复现与理解控制流的第一手材料。