OpenFrontiers:开放科研问题集与科学再发现基准 OpenFrontiers: A Collection of Open Research Problems and a Benchmark for Scientific Rediscovery
构建万条开放问题语料与Lean基准,揭示LLM闭卷再发现罕见、联网多为检索已发表解。
前置知识
开放科研问题(Open Problem)
指学术界公开提出、尚无人给出完整解答的研究问题,如猜想、存在性或极值问题,典型例子包括千禧年问题、Erdős Problems 网站追踪的数百个组合与数论问题、Kourovka Notebook 中的群论问题。它的定义性特征是“参考答案不存在”,与竞赛题、考试题有本质区别:无法对着已知答案打分,而且状态会随时间漂移——今天开放的题目明天可能被人(或 AI)解决。
本文的任务定义、语料状态策略(unassessed 与 open 的区分)以及“再发现”这一核心概念,全部建立在“参考答案不存在”这一点上;不理解它就无法理解为什么要用回溯式设计和时间锚定。
Lean 4 与 Mathlib
Lean 4 是基于依赖类型论的证明助手,Mathlib 是其社区数学库,包含大量已形式化的数学定义与定理。在 Lean 中声明定理后由内核逐条检查证明,只依赖极少数标准公理(如 propext、Classical.choice、Quot.sound)的证明才会被接受,过程无法作弊。本文把每道题写成一个在固定环境编译通过的 Lean 陈述,模型必须提交能通过内核重放的完整证明。
判分的全部机制是“双 Lean 检查器验证证明”,而不是比对最终答案;不懂 Lean 就无法理解评测协议、什么是双检查器一致性,以及“证明级评分 vs 答案级评分”的区别。
数据污染与时间锚定(Time-anchoring)
数据污染指评测题目及其解答已进入模型训练数据,导致成绩虚高。时间锚定是针对性控制手段:只考“模型 cutoff 之前就已公开的问题表述”,解答必须晚于 cutoff 出现且只留给评测者。本文进一步指出时间锚定并不充分——若解答本身是该模型厂商的 AI 系统产出的,模型在训练中等于“见过”自己的解,因此需要按 lineage(厂商谱系)逐模型剔除相关题目。
这是理解全文实验设计的钥匙:为什么基准分 Rediscovery-110 与 Open-90、为什么结果表有 all/clean 两列、为什么闭卷是主条件而联网只是泄漏参照。
LLM 智能体(Agent)
以 LLM 为核心、能多轮调用工具(执行 shell、编译代码、检索网页、提交文件)自主完成长周期任务的系统。本文用厂商官方 CLI(Claude Code、Codex)作为智能体框架,让模型在隔离沙箱里编译测试自己的 Lean 代码并按条件检索或联网。文中区分两种运行协议:原生协议由智能体自行决定何时结束;续跑协议在结束后提醒剩余预算并继续,直到提交通过预检或时间耗尽。
实验对象是 7 个 LLM agent 而非单轮问答模型,关键结果(如“中位尝试仅 0.3–4.1 分钟就放弃”)反映的是智能体行为与 harness 设计,而非纯粹的模型推理能力。
MSC 2020 分类
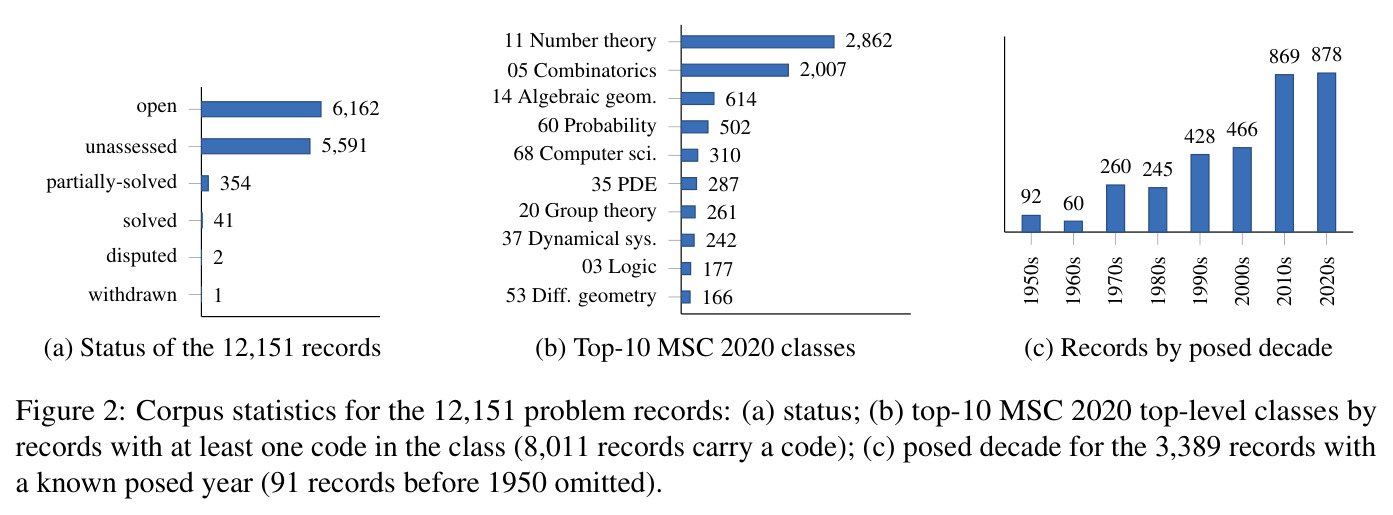
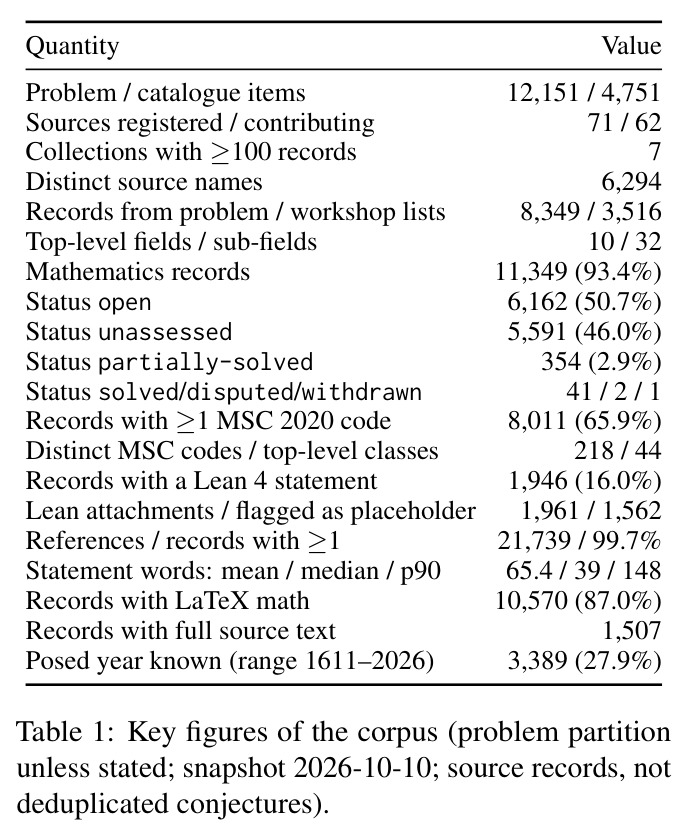
Mathematics Subject Classification 2020 是数学文献的标准分类体系,顶层类如 11(数论)、05(组合)、14(代数几何)等。本文语料用 218 个具体 MSC 码、44 个顶层类给问题记录标注领域,且每个码的赋值都记录映射依据:source-map(来源自带分类,2,665 条)、community-map(按社区领域标签映射,5,241 条)或 editorial(编辑指定,297 条)。
语料的领域统计(数论、组合领先)和按领域的分析都基于 MSC 码,理解它才能读懂图 2b 与 Table 1 的数字含义。
研究动机
现有 LLM 评测几乎都建立在“参考答案已知”的题目上:FrontierMath、Humanity's Last Exam、GPQA 让模型对着专家早已知道答案的参考解打分;GSM8K、MATH、OlympiadBench、Omni-MATH 等竞赛题库不仅快速饱和,还大量泄入训练数据(已有工作记录了静态基准污染与 cutoff 后成绩骤降),而且 2025 年 USAMO 的证明级评分显示,即使最终答案正确的模型也几乎写不出完整严格的证明。真正的科研问题以“参考答案不存在”为定义,它们散落在 Kourovka Notebook、Smale 问题、Clay 千禧年问题、AIM workshop 列表、Erdős Problems、TheoremDB、ICM Conjectures 等数十个平台,措辞、状态口径、许可各不相同,把“哪些问题仍然开放”拼成一张可信地图本身就是策展难题。更麻烦的是时间问题:一道曾经开放的题只有在被评模型 cutoff 之后出现的解答才能当考题,而 2026 年 AI 系统开始批量产出解答,仅靠日期已经挡不住污染。
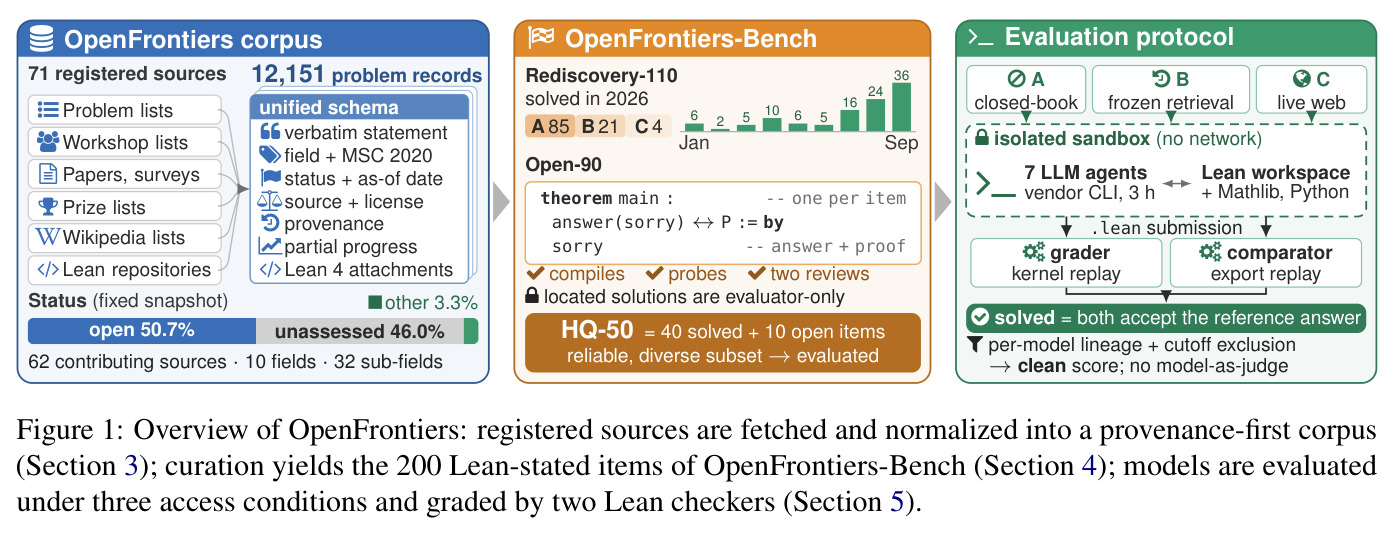
本文的目标是本文要为“科研级问题求解”建立可度量的基础设施,具体三件事:其一,一张诚实的开放问题地图——覆盖 71 个注册来源(其中 62 个贡献记录)的跨学科语料,用统一 schema 记录逐字题面、MSC 2020 分类、日期化状态、来源许可与溯源信息,状态不确定就标 unassessed 而不是一律称 open;其二,一个可以真正打分的基准——OpenFrontiers-Bench 的 200 道研究级数学题,每题配一个在固定环境(Lean 4.33.1 + Mathlib)编译通过、经自动化探针与两轮独立审查的 Lean 4 陈述,其中 Rediscovery-110 是 2026 年内才解决、解答有据可查(85 题有独立复核的 Lean 证明或精确证书)的回溯题,Open-90 是仍开放的题;其三,一套标准化协议——闭卷/冻结检索/联网三种访问条件加隔离沙箱与两个独立 Lean 检查器,并按模型 lineage 与 cutoff 排除受污染题目。最终目标是回答:模型能否在拿不到答案的条件下,重新做出别人刚刚做出的研究?
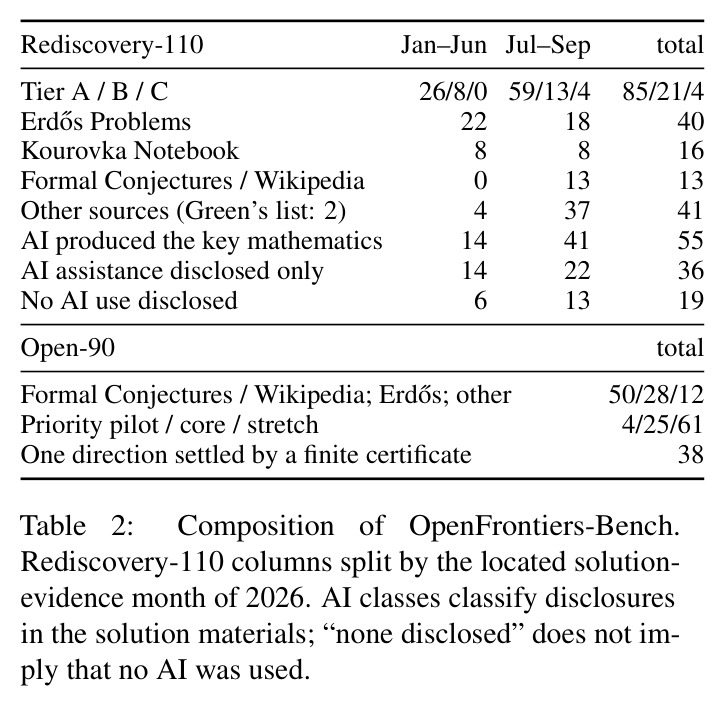
与已有工作不同的是,本文的独特切入是把“开放问题地图”与“可正式判分的评测”耦合起来。已有工作两条线互不相交:收集侧的各类问题列表各自为政——一个社区一种格式、“开放”的定义不一、状态随解题漂移;评测侧要么只收机器可查答案(FrontierMath: Open Problems、OEIS Open 面向真开放题但只接受可核验答案),要么用证明助手考已有答案的题(miniF2F、ProofNet、PutnamBench),IMO-ProofBench 虽是证明级但题目并非真实开放题。本文的时间锚定也更严格:模型拿到的是解答公开之前的题面,located solution 只归评测者;更重要的是它量化观察到一个新的污染通道——110 道已解决题中 55 道的解答材料把关键数学归功于 AI 系统(OpenAI 46、Anthropic 5、Google 4、Harmonic 3),且多数 Tier A 题有公开 Lean 证明,因此“解答晚于 cutoff”只是必要不充分条件,协议据此逐模型做 lineage 排除并把闭卷设为主条件,这是静态或滚动刷新基准都没有的处理。
核心方法
要回答“模型能不能独立重新做出一项刚发表的研究”,必须同时解决三个障碍:没有答案可对(需要可机器验证的判分)、答案可能已在训练数据或网上(需要检索与时间控制)、开放题状态漂移(需要可溯源的语料)。技术路线分三块耦合组件。第一,OpenFrontiers 语料:确定性爬取 62 个贡献来源,得 12,151 条问题记录,覆盖 10 个一级领域与 32 个子领域,65.9% 有 MSC 2020 码,1,946 条(16.0%)附 Lean 4 陈述;状态快照 open 6,162(50.7%)、unassessed 5,591(46.0%)。第二,OpenFrontiers-Bench:从语料策展出 200 道研究级数学题,每题一个 pinned 环境下编译通过的单定理 Lean 陈述,分 Rediscovery-110(2026 年解决)与 Open-90(仍开放),再用可复现脚本选出 HQ-50(40 已解决 + 10 开放)。第三,评测协议:7 个 LLM agent 在隔离沙箱中以 3 小时预算作答,提交 Lean 证明,由两个独立检查器同时接受参考答案才判解决。
核心创新是“回溯式再发现”任务加上配套的污染控制,与已有基准的区别有三层。第一,任务定义:考题必须是解答出现之前就公开 posed 的真实研究问题,模型拿到的题面是历史版本,located solution 只归评测者;模型必须提交 Lean 证明,由自研 grader 与 leanprover/comparator 两个独立检查器分别编译、内核重放、逐常量比对,两者都接受参考答案才算解决——判的是建立证明而非猜答案,且完全没有 model-as-judge。第二,污染控制升级:55/110 道已解决题的解答把关键数学归功于 AI 系统、多数 Tier A 题还有公开 Lean 证明,故仅靠时间锚定不够;协议按厂商 lineage 逐模型剔除其自家系统产出的题目,并对 cutoff 前已有解答证据的题做排除,主表同时报 all 与 clean 两列、只报解题数不报准确率(是非题瞎猜即得 50%)。第三,状态诚实:语料把不确定状态标为 unassessed(46.0%),open 记录只代表“来源在 status-as-of 日期声称开放”,防止把声称当事实。
方法步骤详情
语料构建:确定性 fetcher 抓取 71 个注册源并记录校验和,按统一 schema 存逐字题面与溯源字段。基准构建:多轮检索得 291 条已解决线索,另筛 1,061 条 Formal Conjectures 声明得开放题候选;每题写成 pinned 环境(Lean 4.33.1 + Mathlib 0df444a)中唯一定理 main,是非题写成 $\texttt{answer(sorry)} \leftrightarrow P$;编译要求无公理与 native_decide,带参考答案的陈述对 110 道已解决题全部编译通过;两名独立 AI 审查员核对题面忠实性与形式化漏洞(无 must-fix),47 个文件删除暗示答案的注释。HQ-50 用脚本三层筛选:硬过滤(高形式化置信、重要性 ≥4)→ 打分排名 → 贪心配额(每解答论文一题、Erdős 至多 16、每领域至多 8 题等)。评测:每尝试在全新隔离沙箱(5 CPU、24 GB、无网络)跑 3 小时;A 闭卷、B 冻结检索(截止 2026-01-06)、C 联网(URL 全留痕);7 个模型各跑原生与续跑两种协议。
技术新颖性
技术新颖性体现在四个组合而非单点。其一,判分范式:证明级双检查器形式化验证替代最终答案比对,直接回应“答案对但证明不完整”造成的虚高(Petrov et al. 2025 在 USAMO 上的发现);comparator 用 lean4export 导出并重放全部常量,还修补了对结构的计数,使评测自身的投影攻击无法通过。其二,污染控制的三重设计——verbatim 历史题面、evaluator-only 解答、lineage+cutoff 逐模型排除——把“再发现”与“检索”在协议层面解耦;C 条件被明确定义为泄漏参照而非再发现度量,C−A 差距即答案可检索性的估计。其三,基准与语料的时间结构:Rediscovery-110 中 76 题的解答证据在 2026-06-30 之后,cutoff 早于 7 月的模型必然未见过这些题,形成可持续滚动的评测流。其四,语料本身:12,151 条记录、218 个 MSC 码带证据串、逐条许可与溯源快照(2026-10-10),是首个跨 62 个社区、统一 schema 的开放问题库,为问题演化与状态预测研究提供数据底座。
实验结果
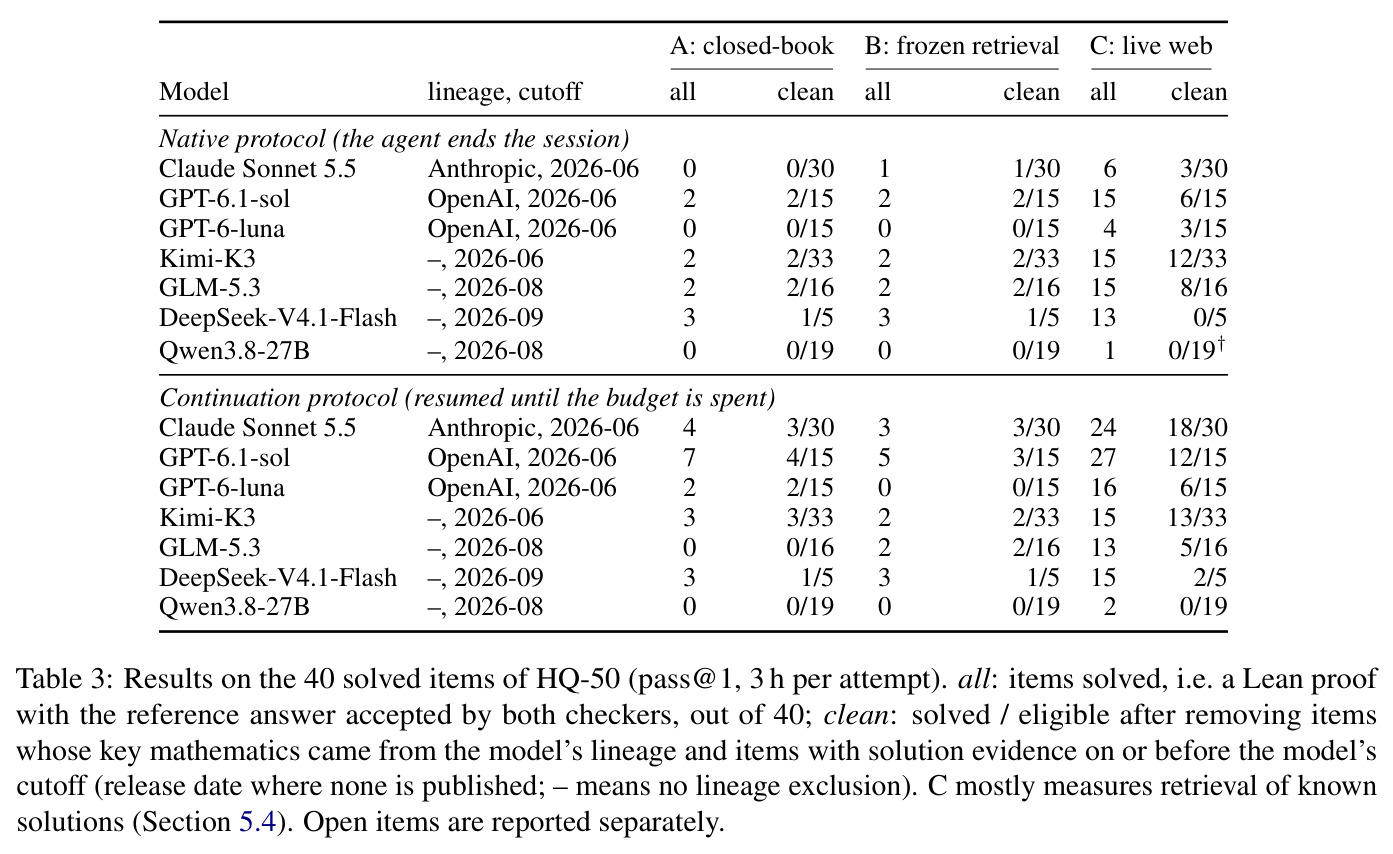
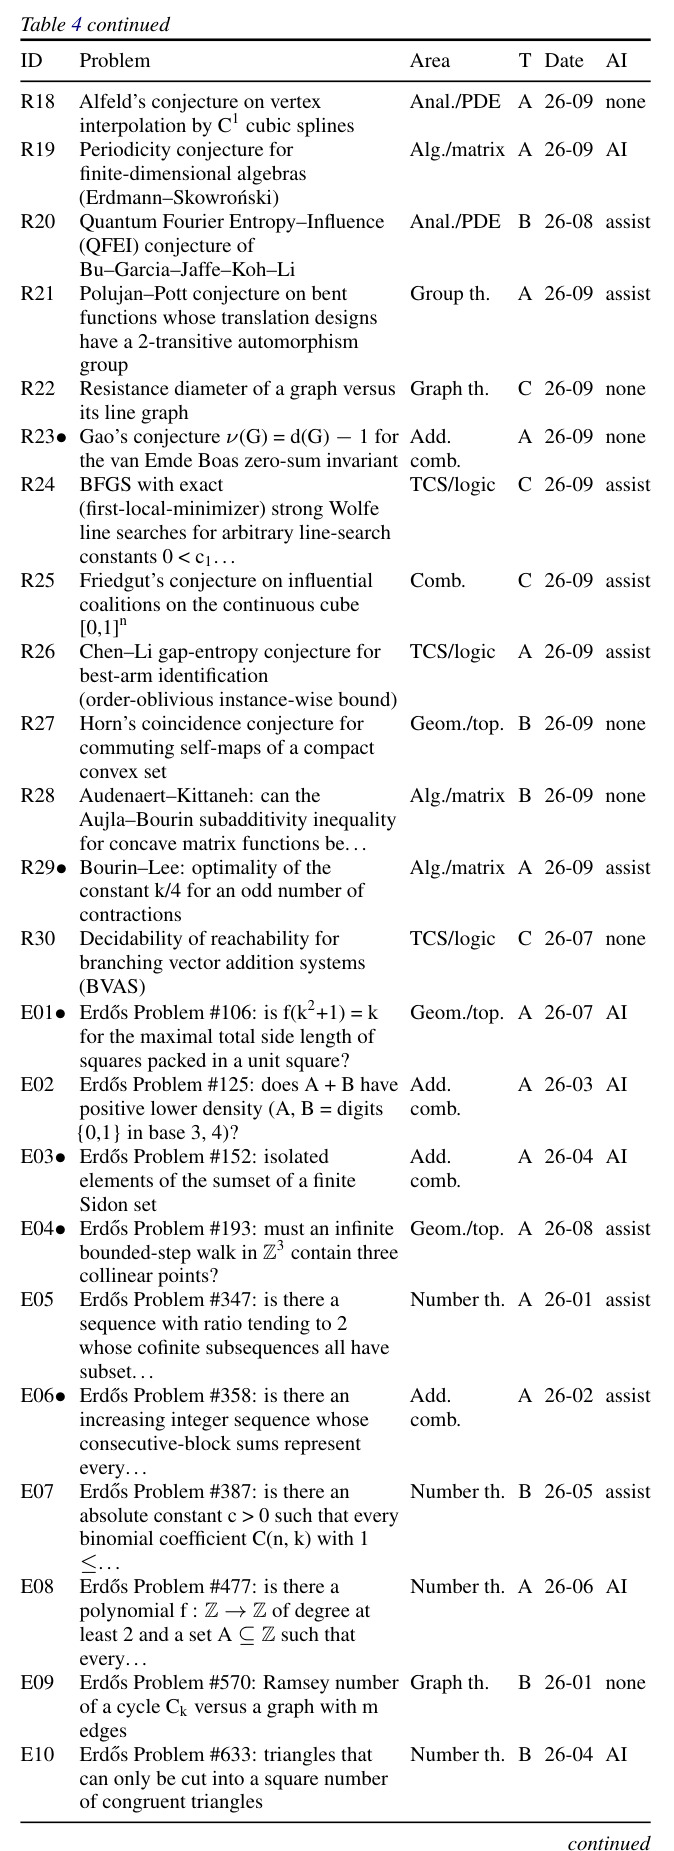
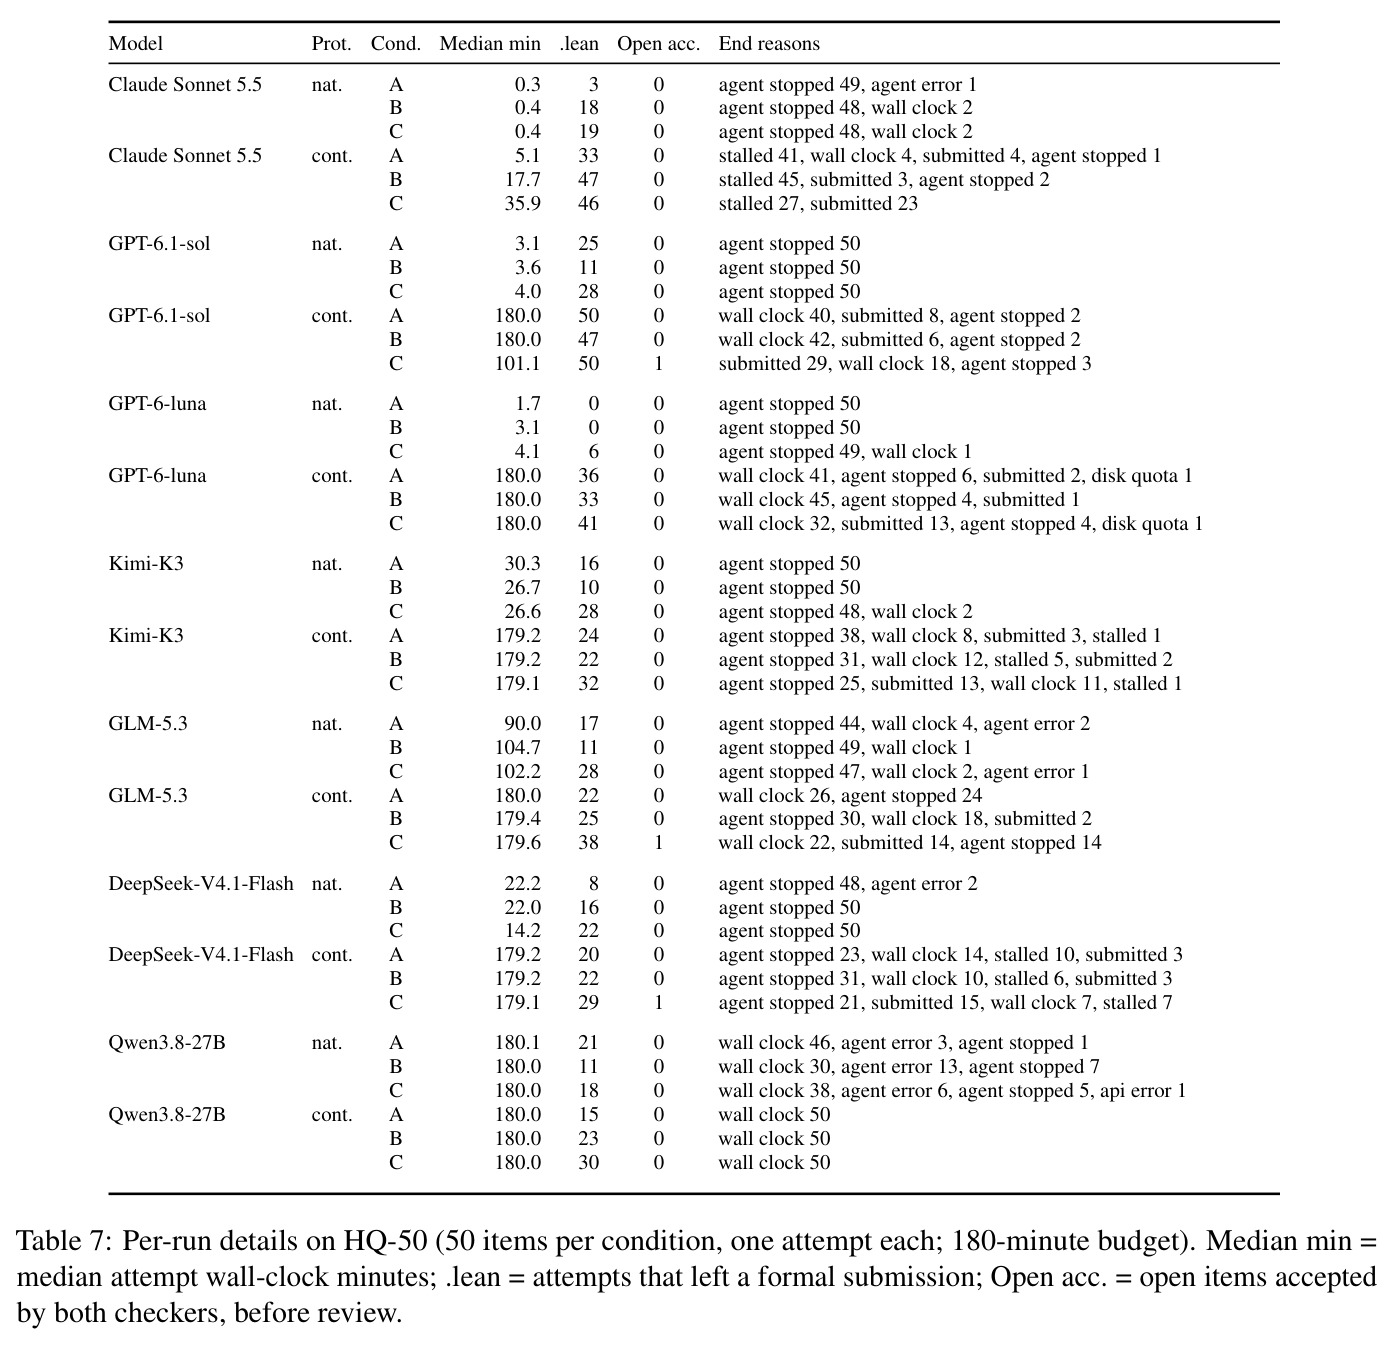
在 HQ-50 的 40 道已解决题上(每条件每模型 1 次、3 小时):闭卷再发现罕见——原生协议 7 个模型解 0–3 题,续跑协议 0–7 题,GPT-6.1-sol 从 2 升到 7(clean 4/15)。14 次运行的 53 个 A/B 解集中在 8 道题上,其中人类短构造可解的 3 道重要性 3 分题(R01、R04、R29)占 44 个;21 道重要性 5 分题只有 1 道(N28)被解过一次。冻结检索无系统增益(2 次高于 A、3 次低于 A)。联网下解 1–27 题(GPT-6.1-sol 续跑 27/40),但 181 个 C 解中 167 个抓取过已发表解:如 Erdős #152(E03)有公开 Lean 证明(2026-04-03),28 次 A/B 尝试 0 解、14 次 C 运行解 11 次。10 道开放题在 A/B 下无一被双检查器接受,C 下 3 次接受(三家模型各 1 次)疑似陈述错误,均触发审查。agent 还普遍过早放弃:前沿模型中位尝试仅 0.3–4.1 分钟(预算 180 分钟),Qwen3.8-27B 则总耗满预算仍几乎不解题。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 闭卷再发现(HQ-50 已解决题,条件 A) | 双检查器接受的 Lean 证明数(/40,pass@1) | 原生协议最高 3,续跑协议最高 7(GPT-6.1-sol,clean 4/15) | 同为前沿的冻结检索最高 5;无既有基准可比(全新任务) | 首次量化:前沿 agent 无检索条件下最多解决 17.5% 的刚解决研究题,且解集中在 3 道人类短构造可解的低重要性题上 |
| 联网求解(条件 C) | 解题数(/40,pass@1) | 最高 27/40(GPT-6.1-sol 续跑;clean 12/15) | 同模型闭卷 7/40 | +20 题,但 181 个 C 解中 167 个抓取过已发表解,证明 C−A 差距度量的是答案可检索性而非再发现能力 |
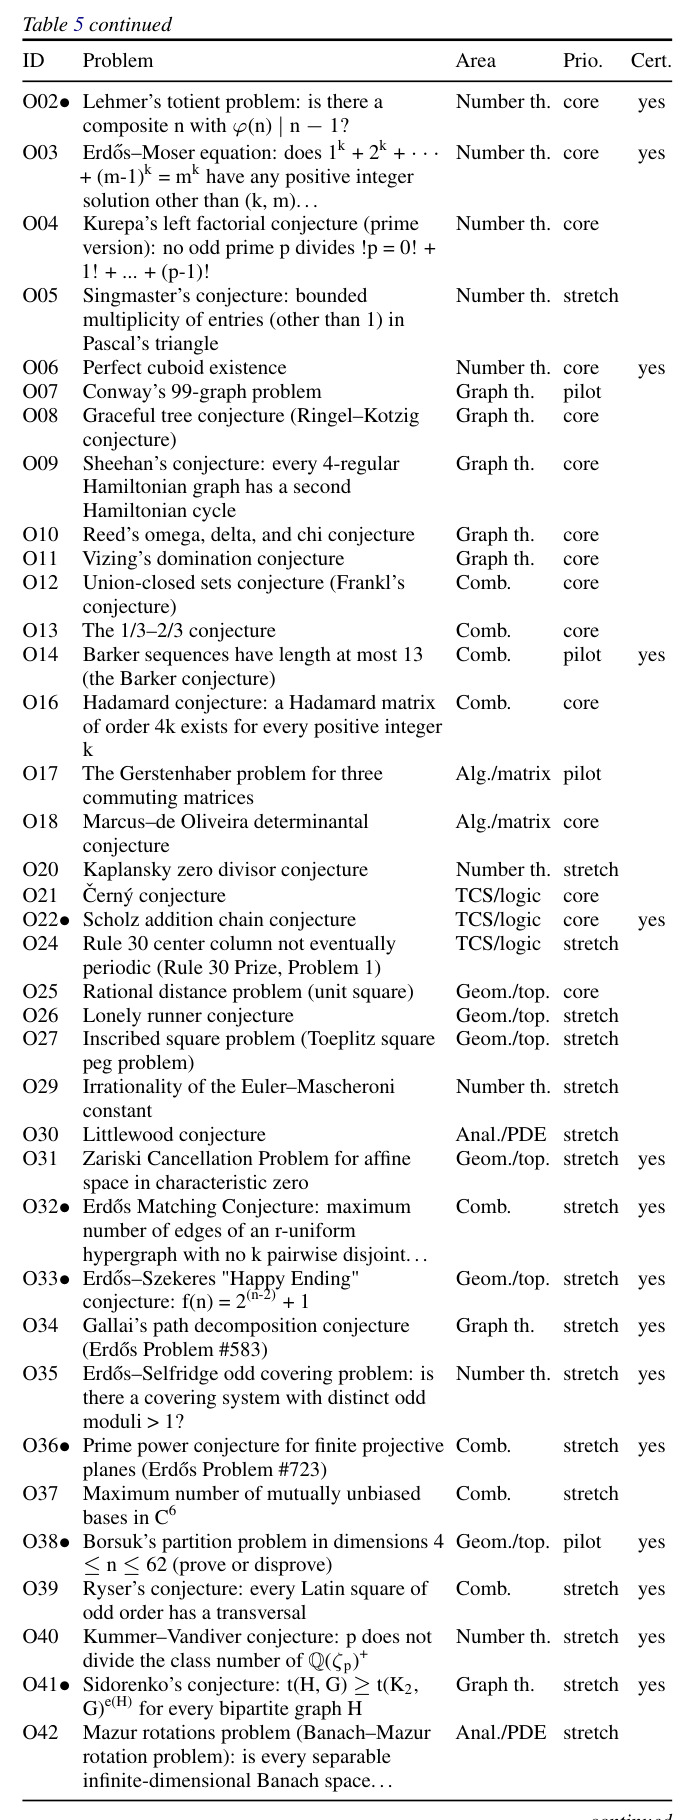
| 开放题求解(HQ-50 的 10 道 Open 题) | 双检查器接受的提交数 | A/B 条件 0;C 条件 3 次接受(待人工审查,疑似陈述错误) | 无 | 尚无模型在受控条件下严格解决任何开放题,说明真正的新数学仍未出现 |
| 开放问题语料规模 | 问题记录数 | 12,151 条(62 来源、10 一级领域、32 子领域,1,946 条附 Lean 4 陈述) | 单一社区列表(TheoremDB 3,909、AIM 3,470、Erdős 634、Formal Conjectures 459) | 首个跨社区统一 schema、逐条许可与溯源的开放问题汇聚,附带 4,751 条目录条目 |
局限与改进
作者承认的局限:语料 93.4% 是数学(物理 339、CS 285、ML 70),跨学科打折;仅 16.0% 记录带 Lean 陈述,只能覆盖可形式化问题;语料不去重,12,151 条不等于独立猜想数;解答日期审计并非穷尽式检索;Tier B/C 共 25 题未经独立重验证;每题每条件只跑一次 pass@1;clean 子集对部分模型只剩 5–15 题,统计功效有限。我的补充观察:第一,答案必须是 Lean 定理,天然偏向离散领域——Rediscovery-110 由群论与数论(各 19 题)领先,分析、几何的定量结论难以入选;第二,3 小时、5 CPU、单 agent CLI 远低于 AlphaProof、Seed-Prover 的算力与 scaffold,测到的是通用 agent 的下限;第三,结果对 harness 敏感——Claude Sonnet 5.5 有 41/50 次停滞,续跑收益或来自提示;第四,开放题“双检查器接受”与“陈述有漏洞”不可区分,3 次接受均按疑似错误处理;第五,55/110 解答归功 AI,未来无污染的刚解决题会越来越稀缺,基准必须滚动维护。
独立分析的弱点
独立分析的弱点与改进方向:(1) 领域偏斜——数学占 93.4%、开放题以数论(25)与图论(20)为主,对物理/CS/ML 的科研求解几乎无覆盖;应与 SciCode、LAB-Bench 类实验任务互补,或引入可形式化的非数学判分对象。(2) pass@1 单次尝试——研究级问题方差极大,单次既可能低估能力也无法区分运气;应报 pass@k、best-of-n 与预算–成功率曲线。(3) 缺专用 prover 基线——AlphaProof、Seed-Prover 未进对比,通用 agent 不代表形式化数学最强水平;应加入 prover 基线定位差距。(4) 停滞判据与续跑提示可能引入噪声——20 轮无工具调用判 stalled,“剩余预算”提示本身是提示工程;应对措辞与阈值做消融。(5) lineage 排除依赖披露质量——“未披露 AI 使用”(19 题)不等于没用 AI,私有系统的 lineage 边界靠公开材料推断;应推动解答发布时的系统性 AI 参与披露标准。(6) 非是非题的参考答案验证成本高,Tier A 中仅 10 题依赖精确证书;应发展证书自动复核工具链。
未来方向
作者提出的方向:开放题状态持续变化,基准将定期重审——文中已示范把新解决的 N01(Beck–Fiala)、N02(Kourovka 20.76)、N03(Tu–Deng)、N04($\zeta(5)$ 无理性)从开放组移入 Rediscovery 组并弃用旧 ID;语料定位为定位研究问题与评测研究级推理,明确不作为宽松许可训练数据。基于成果可延伸:(1) 滚动评测——定期把刚解决的题转入基准,形成对前沿模型长期、无污染的纵向追踪(76/110 解答证据在 2026-06-30 之后,供给充足);(2) 用 12,151 条语料研究问题演化——哪些领域的猜想解决快、AI 参与度趋势(图 3 显示 2026 下半年 AI 产出激增)、预测哪些开放题最先被解决;(3) 把 94.9% 记录已存的部分进展上下文变成部分得分信号,度量实质性进展而非全对;(4) 引入专用证明搜索系统测真实开放题上限;(5) 扩展到 Open Quantum Problems 等可给有限反例的非数学领域;(6) 针对过早放弃设计更好的 harness:预算感知、进展记忆、多 agent 协作与验证器反馈循环。
复现评估
复现条件较好。数据公开在 HuggingFace 集合 FlippyDora/openfrontiers:语料为统一 JSON Schema,附校验和、验证报告与逐条许可;200 题基准包是 pinned 的 Lake 项目(Lean 4.33.1 等三个固定依赖),可干净构建。判分完全确定:无 model-as-judge,grader 与 comparator(pinned 并移植到 Lean 4.33)可离线重放,判分复现门槛低。完整评测复现较贵但不苛刻:需两个闭源前沿模型 API、四个开放权重模型与自托管 Qwen3.8-27B;沙箱需 rootfs、seccomp/cgroup、私有命名空间等 Linux 隔离;总量约 7 模型×3 条件×2 协议×50 题×3 小时墙钟,主要是 API 成本,CPU 沙箱可并行。风险是闭源端点静默更新与 harness 版本漂移,作者用 evalkit-0.3 与逐模型 cutoff/lineage 记录部分缓解;扩集需重建双 AI 审查员流水线(附录 H 披露 AI 深度参与策展与写作)。
论文图表
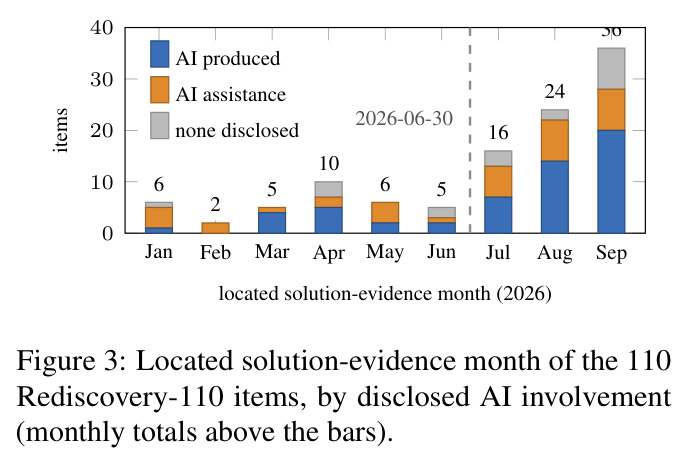
按月堆叠柱状图,展示 110 道 Rediscovery 题的解答证据出现月份与披露的 AI 参与类型:AI 产出关键数学 55 题(1–6 月 14 题、7–9 月 41 题)、仅披露 AI 辅助 36 题、未披露 19 题;解答供给在 6 月之后明显加速(76 题在下半年)。文中注明分类基于解答材料中的披露声明,“未披露”不等于没用 AI。
它是协议设计的关键证据:AI 产出占比过半且集中在 6 月后,说明仅靠 cutoff 时间锚定挡不住污染,必须按厂商 lineage 逐模型排除——这是理解 Table 3 中 all/clean 两列差异的前提。
展示语料中一条删节的问题记录(Erdős Problem #7:是否存在模皆为奇数的互不相同覆盖系统):逐字题面与背景、领域 slug、MSC 2020 码(含映射依据 community-map 与证据串)、日期化状态与 status_as_of 时间戳、来源 URL 与许可措辞、SHA-256 校验和、上游 Lean 4 形式化(工具链 v4.33.1、verification_status 为 not-checked、含 sorry 占位符)、引用列表与快照时间戳。
具体说明“统一 schema + 溯源优先”落到单条记录是什么样子,是理解语料可复现性与状态诚实策略(来源声称 vs 本地核实)的最直观样例。
62 个贡献来源清单,按记录数排序并附许可/复用注记:TheoremDB 3,909(CC0-1.0)、AIM Problem Lists 3,470(编辑审核、按列表条款)、ICM Conjectures 2,898、Erdős Problems 634(陈述经改写并署名)、Formal Conjectures 459(Apache-2.0/CC BY 4.0)、Optimization Constants 115、Open Quantum Problems 114 等,另有 Wikipedia 各学科列表(CC BY-SA 4.0)、Clay 千禧年问题、COLT 开放问题 track 等小集合,合计 12,151 条。
语料的许可与溯源基础:决定哪些子集可宽松复用、哪些需遵守原条款,是数据治理透明度的体现,也说明“混合来源、不授予统一许可”的发布策略。