知而后绘:视觉生成的新学习范式 Know, then Draw: A New Learning Paradigm for Visual Generation
自回归预训练学知识、扩散后训练管渲染,3B模型用6600 H100小时达到GenEval 0.86
前置知识
自回归视觉生成(AR)
将图像经 tokenizer 离散化为 token 序列后,用因果 Transformer 逐个预测下一 token 的范式,目标为交叉熵 $\mathcal{L}=-\sum_i\log p(v_i|v_{<i})$。RandAR 对空间位置采样随机排列,并用位置指令 token 标注每步预测的位置。本文用它作预训练目标。
本文第一个核心主张是 AR 是更好的『知识获取』预训练目标;需要理解 AR 的损失形式,以及 tokenizer 定义预测目标、从而决定模型学到什么信息这一层关键关系。
扩散模型与流匹配
扩散模型学习逐步去噪:像素扩散模型(PDM)直接在像素空间去噪,潜在扩散模型(LDM)先经自编码器压缩到潜空间。流匹配用线性插值构造 $x_t=(1-t)x_0+t\epsilon$,训练网络预测速度,损失为速度 MSE。本文的渲染器就是在像素空间做流匹配的可训练模块。
渲染阶段的目标函数(Eq. 2)、时间步采样以及后训练缩放定律所拟合的 loss(velocity-MSE)全部建立在流匹配之上,不懂它就无法理解方法与缩放分析。
视觉分词器与 IBQ 量化
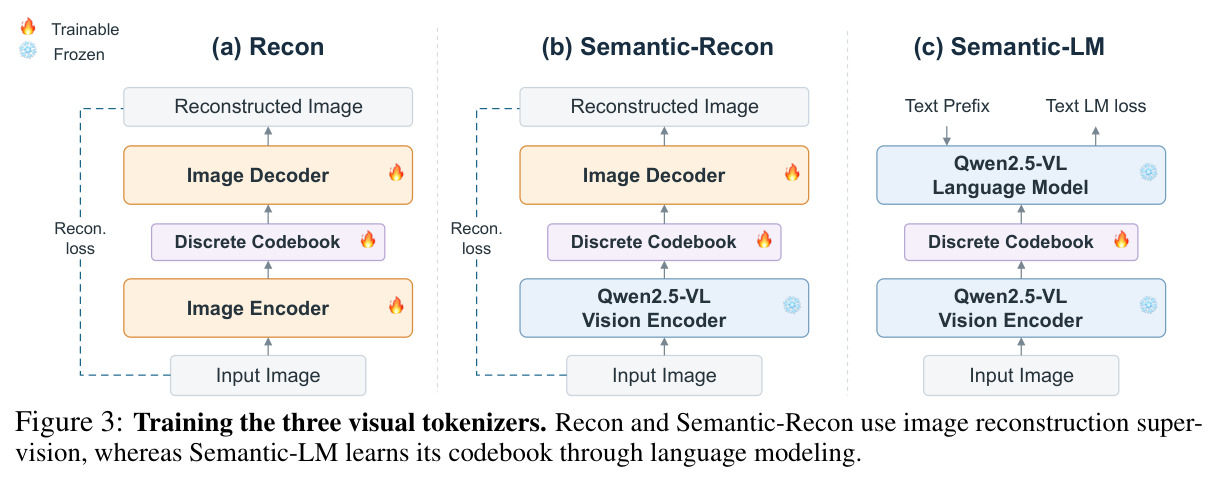
把连续图像特征量化为离散码本索引的模块。IBQ(Index Backpropagation Quantization)使量化索引可由梯度直接优化。传统分词器用图像解码器加重建损失训练、追求低 rFID;本文提出的 Semantic-LM 仅用语言建模损失训练码本,完全没有解码器与重建损失。
Sec 3.2 的核心结论『语义质量而非重建质量决定最终生成』完全建立在 Recon/Semantic-Recon/Semantic-LM 三种分词器的对比上,码本监督方式与 rFID 是关键实验变量。
缩放定律与计算最优训练
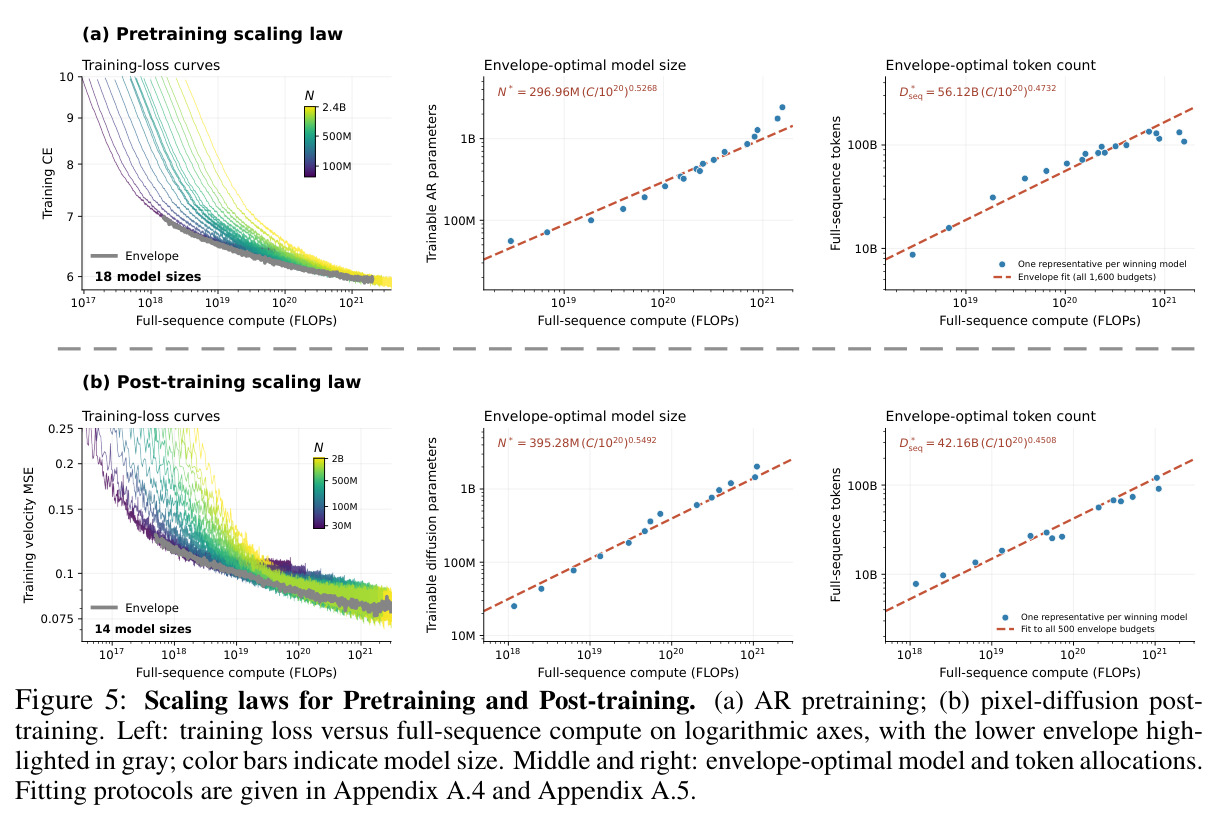
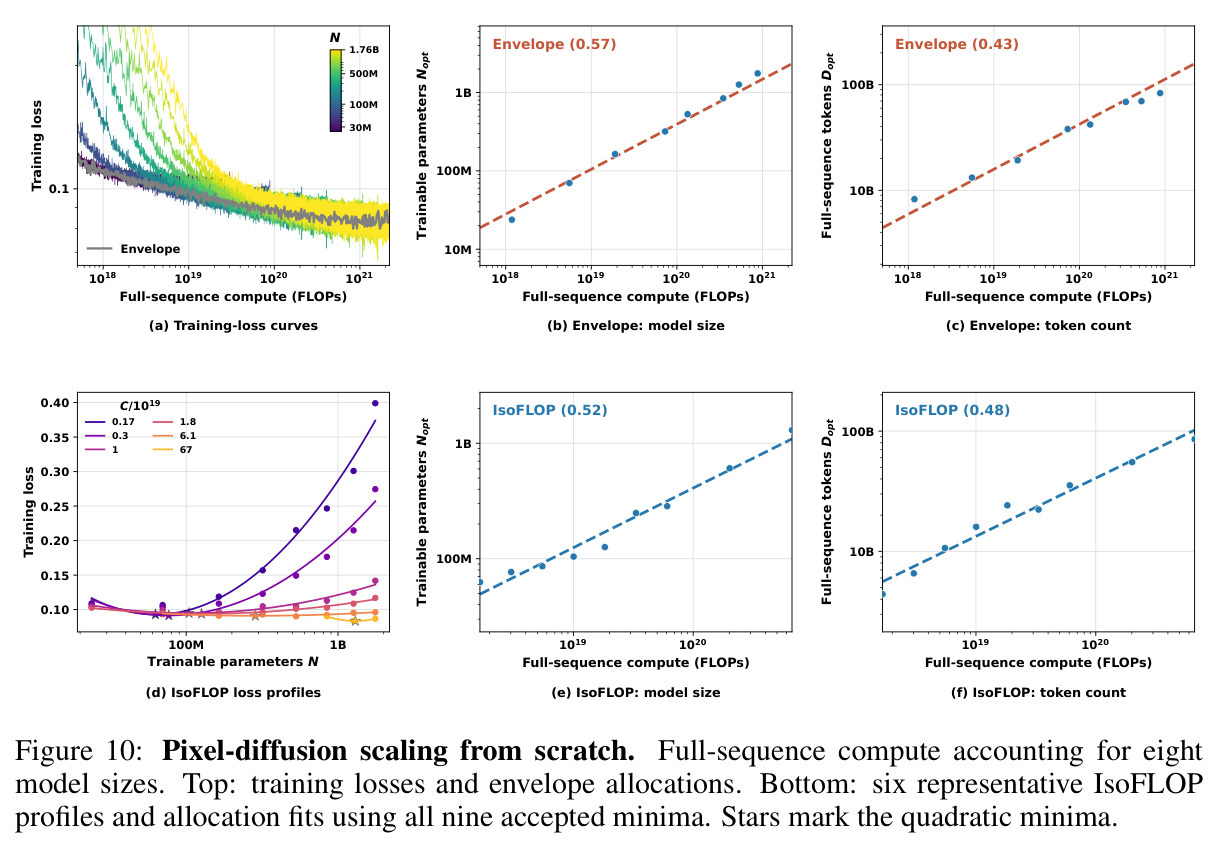
用幂律拟合损失随参数量 $N$ 与数据 $D$ 的变化:$\hat{L}=E+AN^{-\alpha}+BD^{-\beta}$,以 $C=6ND$ 估计算力。Envelope 法取每个预算下最优训练曲线,IsoFLOP 法在固定算力下对 $\log N$ 拟合二次曲线找最优模型大小,交叉验证。本文据此为两阶段分别拟合。
本文贡献之一是分别为 AR 预训练与扩散后训练拟合缩放定律并推导两阶段算力分配(约 3:2),不掌握这套 Chinchilla 式方法论就看不懂 Sec 3.3 与附录 A.4–A.8。
无分类器引导(CFG)
推理时同时计算条件与无条件预测,用 $v=v_{uncond}+s\cdot(v_{cond}-v_{uncond})$ 外推放大条件影响,$s$ 为引导强度。本文 AR rollout 用 CFG 3,扩散渲染用 AR 条件 CFG 3 与文本 CFG 4,采样用 50 步 Euler。
评测协议(附录 A.9)与 AR-only 生成消融都显式给出 CFG 设置,理解它有助于判断各基准分数受引导强度调节的程度,以及对比是否公平。
GenEval 与 DPG-Bench
两个常用的文生图对齐基准。GenEval 用 553 条 prompt 从单物体、双物体、计数、颜色、位置、颜色属性六个维度打分后取均值;DPG-Bench 用 1,065 条密集 prompt(每条生成 4 张图)由 VLM 评分,衡量细粒度图文对齐能力。
论文所有受控实验(Tab. 1/2)与最终模型对比(Tab. 3)都以这两个指标汇报,需要知道它们测什么、分数如何构成,才能正确解读各项结果。
研究动机
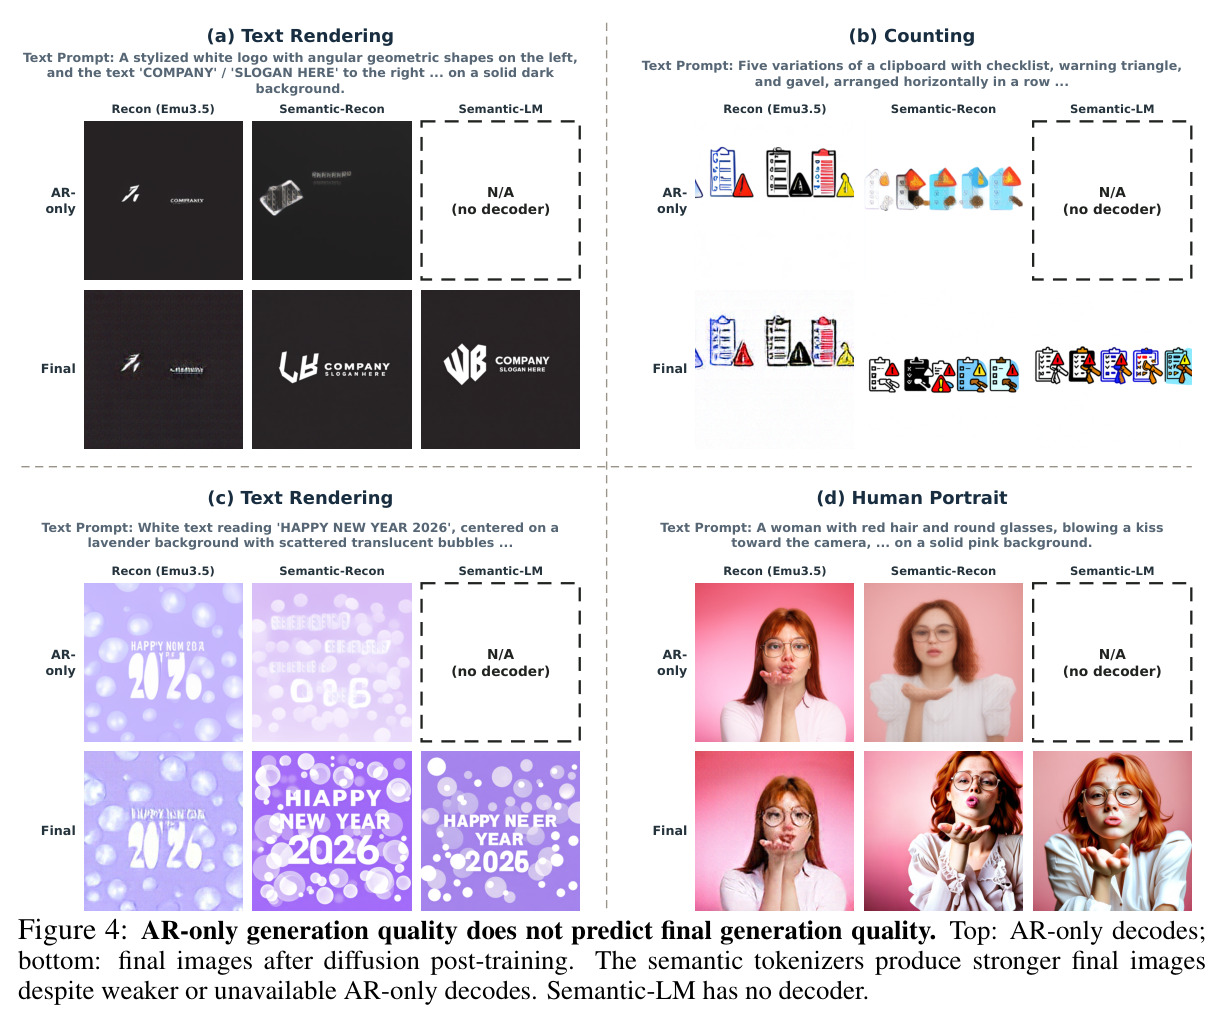
视觉生成领域长期把自回归(AR)模型与扩散模型当作相互竞争的范式,直接比较『谁生成的图像更好』。但这种比较隐含地要求每个范式同时解决两个性质不同的学习问题:获取高层视觉语义知识(画什么、如何构图、属性如何组合),以及把知识渲染成高保真像素(纹理、文字、细节)。代价体现在两方面。其一,为了能独立生成图像,AR 模型的 tokenizer 必须保留低层外观信息支持重建,语义学习被重建目标绑架:本文实测 Emu3.5 重建型 tokenizer 的 rFID 低至 1.04,但其最终生成器 GenEval 只有 54.67,反而不如 rFID 高达 40.5 的语义型 tokenizer(65.51);AR-only 生成质量同样与最终性能脱钩——Recon 与 Sem-Recon 的 AR-only GenEval 为 57.49 对 50.44,扩散后训练后排序完全反转为 54.67 对 65.51。其二,前沿文生图系统训练算力巨大——Z-Image-Base 估计耗用约 31.6 万 H100 GPU 小时——而在一个训练流程内部该如何在『知识获取』与『渲染』之间分配算力,此前没有任何定律可循。
本文的目标是本文的目标是建立并验证一种『先知后绘』(Know, then Draw)的预训练-后训练范式:第一阶段用文本条件的自回归目标获取视觉知识,第二阶段冻结 AR 骨干、用像素扩散后训练专责高保真渲染。围绕该范式作者设定了三个必须用受控实验回答的问题:(1)在匹配参数量(约 400M)与图像曝光量的条件下,AR 与 LDM 哪个是更好的预训练目标?(2)AR 预训练应当预测什么样的视觉 token——保细节的重建型 token 还是语义型 token?重建监督是否必需?(3)知识获取与渲染两阶段之间的算力应如何分配,各自又如何在模型大小与数据量之间权衡?在回答这些问题的基础上,作者为两阶段分别拟合缩放定律,并为从零训练的像素扩散基线拟合对照定律,最终在约 6,600 H100 GPU 小时预算内按定律配置并训练一个约 3B 参数的文生图模型,用 GenEval 与 DPG-Bench 在真实规模上检验范式有效性。
与已有工作不同的是,本文的独特之处在于转换了提问方式:不再问『AR 和扩散哪个范式更强』,而是问『它们各自擅长什么』。已有的结合方案——MAR 把扩散当作 AR 内部的条件分布、Transfusion 在同一模型中对文本用 AR 目标而对图像用扩散目标、并发的 VoT 用语义视觉 token 预测来扩展预训练 VLM——都把 AR 保留在图像生成回路内,其表征因此必须支持视觉合成。本文则让 AR 彻底退出像素生成、只负责知识获取,从而第一次把视觉 tokenizer 从『必须支持重建或独立生成』的约束中解放出来,提出仅用语言监督训练的 Semantic-LM 分词器:在冻结的 Qwen2.5-VL 内以下一 token 预测训练 IBQ 码本,没有图像解码器、没有重建损失,rFID 无定义,却仍支撑 64.84 GenEval 的最终生成。缩放层面,以往工作(Kaplan、Chinchilla、视觉扩散的 Chimera)都缩放单一目标,本文首次量化跨目标的算力分配 $r=C_{post}/(C_{pre}+C_{post})$,并发现 AR 预训练降低的是扩散渲染的渐近损失地板,而非仅仅加快收敛。
核心方法
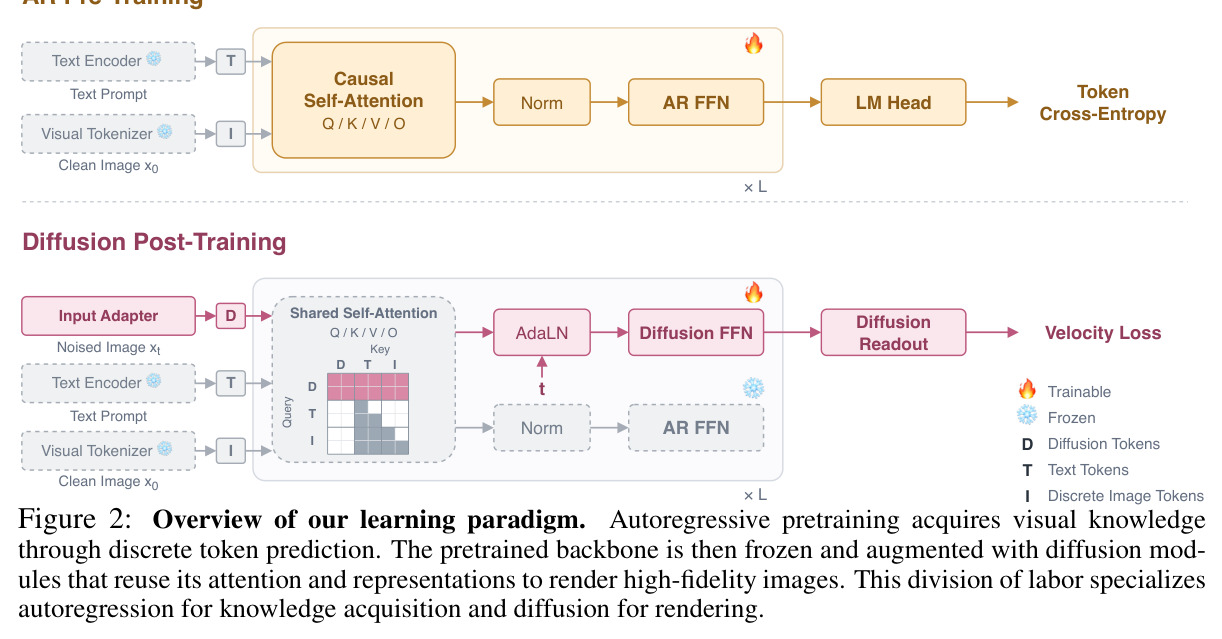
直觉上,这模仿了现代大语言模型的训练哲学:先在大规模语料上获取广泛知识(预训练),再适配到目标行为(后训练)。技术路线分两步。第一步(知识获取):冻结的视觉 tokenizer 将图像编码为离散 token $v=(v_1,\dots,v_L)$,冻结文本编码器给出条件特征 $c$;文本条件 AR 模型按 RandAR 方式采样随机排列 $\pi$,用位置指令 token $o$ 指明预测位置,最小化 $\mathcal{L}_{AR}(\theta)=-\sum_{i=1}^{L}\log p_\theta(v_{\pi(i)}\mid v_{\pi(<i)},o,c)$。第二步(渲染):冻结骨干参数 $\theta$,接入可训练的像素扩散模块 $\phi$——噪声图块输入投影、时间步嵌入、扩散专用 FFN、AdaLN 与线性像素读出——并复用骨干已学好的注意力 Q/K/V/O 投影;用像素空间流匹配训练,$x_t=(1-t)x_0+t\epsilon$,损失为速度 MSE。后训练时条件 token 来自真值图像;推理时换成 AR 从文本 prompt 自回归 rollout 出的 token,衔接两个学习过程。
核心创新有三层。第一是『目标分工』:AR 只被要求学『画什么』(语义知识),扩散只被要求学『怎么画』(像素渲染),两者用各自损失分别优化、分别缩放,推理时以 AR rollout 的 token 作为扩散的结构化条件——这与 MAR/Transfusion 把两目标耦合在同一个生成过程内有本质区别。第二是『语义决定论』:作者发现重建质量与 AR-only 生成质量都不预测扩散后训练后的最终性能,决定性因素是 token 的语义质量。据此提出 Semantic-LM 分词器:在冻结 Qwen2.5-VL-32B 内仅用语言建模交叉熵训练 131,072 项、维度 256 的 IBQ 码本(4 万步、DataComp-VLM 200B 数据),无图像解码器、无重建损失——视觉 token 化的目标从『为重建保留像素』转变为『为 AR 知识获取提供语义学习目标』。第三,缩放定律揭示 AR 预训练把扩散渲染的拟合渐近损失从 0.0788(从零训练 PDM)降到 0.0701,说明收益超越『收敛更快』,是可达性能上限的提升。
方法步骤详情
流程分五步。第 1 步训练分词器:Semantic-Recon 与 Semantic-LM 都用 IBQ 码本(131,072 项、码维 256)量化冻结 Qwen2.5-VL-32B 的视觉特征,在三档原生分辨率按 4:2:1 采样训练;前者另训 12 层解码器做重建,后者把量化特征输入冻结 LM 做文本 next-token 预测,无解码器。第 2 步 AR 预训练:按随机排列顺序预测视觉 token,最小化交叉熵,控制实验 250M、15 万步。第 3 步扩散后训练:冻结骨干,新增约 150M 渲染模块,对 $x_t=(1-t)x_0+t\epsilon$ 做流匹配并最小化速度 MSE,logit-normal 时间步加分辨率 shift;控制实验 25 万步。第 4 步按幂律 $\hat{L}=E+AN^{-\alpha}+BD^{-\beta}$($C=6ND$)拟合两阶段缩放律,三种方法互验,导出预训练:后训练约 3:2。第 5 步按律训练 3B 模型:AR 骨干宽 2304、27 层、15 万步,扩散 10 万步,合计约 6,600 H100 小时;推理时 AR 以 CFG 3 生成 token,扩散 50 步 Euler 采样。
技术新颖性
技术新颖性有四点。(1)问题重构:把『AR vs 扩散谁更好』的范式之争改写为『哪个目标适合哪个学习阶段』的角色分配问题,并用 LDM→PDM(56.61)反而劣于直接 LDM(57.34)的反直觉结果证明『分两阶段』本身不是关键,『用什么目标预训练』才是。(2)表征解放:首次证明视觉 tokenizer 可以完全摆脱重建监督——Semantic-LM 的码本仅靠冻结 VLM 的语言建模损失训练,rFID 无定义、AR-only GenEval 为 0,却支撑 64.84 的最终 GenEval,颠覆『好 tokenizer 必须能重建图像』的行业默认。(3)跨目标缩放定律:以往缩放分析都针对单一目标,本文为 AR 交叉熵与扩散速度 MSE 分别拟合 Chinchilla 型三参数律,用『先各自求最优、再配对推导』的方式导出近似尺度不变的 3:2 分配,回避了两种损失不可通约、不能直接相加的问题。(4)渐近地板证据:通过独立调参的从零 PDM 基线(8 个模型)拟合出 0.0788 的渐近项,高于后训练的 0.0701,为『预训练提升可达上限』提供首个缩放律层面的量化证据;作者也诚实指出这是对整条流水线的评估而非组件消融。
实验结果
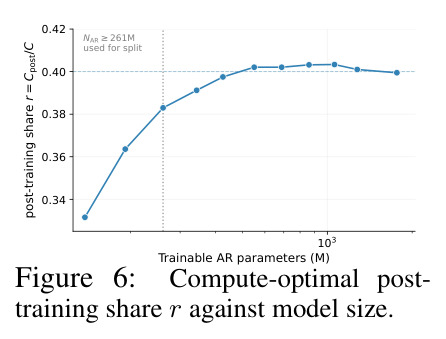
(1)预训练目标对比(Tab. 1):AR→PDM 达 65.51 GenEval/71.11 DPG,超过从零 PDM(61.16)、LDM(57.34)与 LDM→PDM(56.61);10 万步后训练(64.8)已超 PDM 40 万步(61.2)——关键在目标。(2)Tokenizer 消融(Tab. 2):Recon 的 rFID 1.04 最好、AR-only 57.49 最高,最终仅 54.67;Sem-Recon(rFID 40.5)最终 65.51/71.11;Sem-LM 无解码器、AR-only 为 0,最终仍 64.84/67.72——语义质量决定最终性能。(3)缩放定律(Fig. 5):拟合 18/14 个模型的幂律,AR 最优模型/数据指数均约 0.5;后训练渐近项 0.0701 低于从零 PDM 的 0.0788,AR 预训练降低了损失地板。(4)算力分配(Fig. 6):9 个规模上后训练占比 r≈0.40,尺度不变。(5)最终模型(Tab. 3):约 3B、6,600 H100 小时(Z-Image-Base 的 1/48),GenEval 0.86(弱项双物体 0.82)、DPG 87.78,仅次 Qwen-Image 与 Seedream 3.0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 受控对比:匹配数据与参数(约400M)下的文生图 | GenEval Overall (%) | 65.51(AR→PDM) | PDM 61.16 / LDM 57.34 / LDM→PDM 56.61 | +4.35 对最强基线 PDM,+8.17 对 LDM |
| 受控对比:文生图细粒度图文对齐 | DPG-Bench | 71.11(AR→PDM) | PDM 62.56 / LDM 64.33 | +8.55 对 PDM,+6.78 对 LDM |
| Tokenizer 消融:扩散后训练后的最终生成 | GenEval (%) | Sem-Recon 65.51 / Sem-LM 64.84 | Recon 54.67 | +10.84 / +10.17,且 Sem-LM 无重建监督 |
| 大规模文生图 | GenEval Overall | 0.86 | SeFi-Image-5B 0.88 / Qwen-Image 0.87 / FLUX.1-dev 0.82 / SD3-Medium 0.74 | 以约 3B、6600 GPU 小时逼近 5B–20B 系统 |
| 大规模文生图 | DPG-Bench | 87.78 | Qwen-Image 88.32(20B)/ Seedream 3.0 88.27 / HiDream-I1 85.89(17B) | 仅低于两个更大系统,超过 FLUX.1-dev(84.00)与 Z-Image-Turbo(84.86) |
| 训练效率 | H100 GPU-hours | 约 6,600 | Z-Image-Base 估计约 316,800 | 约 48 倍减少 |
局限与改进
作者承认的局限:跨系统比较只是近似的——各系统文本编码器、训练数据与评测设置不同,且本文使用 LLM prompt 重写并在固定种子下按分数选择 prompt 变体,会向有利方向偏置;缩放定律的渐近项 $E$ 是拟合外推,且比较的是整条流水线而非隔离组件贡献;算力分配由拟合定律导出,作者明确表示并未证明其最优;结论限定在所评测协议与预算内。我补充的观察:其一,最终模型在双物体(0.82)与计数(0.75)上仍明显落后 Qwen-Image(0.92/0.89),语义 token 可能丢失了精确的空间与数量细节;其二,推理时扩散完全依赖 AR rollout 的 token,AR 的语义错误会未经校正地传导到渲染端,且逐 token 自回归带来额外延迟;其三,Semantic-LM 的语义先验完全继承自冻结的 Qwen2.5-VL-32B 与 DataComp-VLM,tokenizer 上限被该 VLM 锁定;其四,r≈0.40 基于 $6ND$ 归一化代理,真实硬件 FLOPs 下的最优分配可能不同,且未在其他数据分布或模型族上验证;其五,缺乏与 VoT 等并发语义 token 方法的直接对比。
独立分析的弱点
独立分析的弱点与改进方向。(1)误差传播无校正:AR rollout 一次性决定语义内容,扩散只是忠实执行;若 AR 生成语义错误的 token(数量、属性绑定出错),渲染端无法纠正。改进:渲染前加入轻量 token 校验或对低置信 token 做 beam/verifier 搜索。(2)细节与文字渲染依赖单一语义通路:语义 token 不携带像素信息,小字与精细纹理全靠渲染器从噪声恢复;Fig. 4 显示保留重建信息的 Sem-Recon 在文本渲染上优于 Sem-LM,说明两类信息互补。改进:设计混合或多尺度 tokenizer,或给渲染器并联低层特征通路(类似 REPA 思路)。(3)评测协议含 prompt 重写与按分数选变体,可能高估泛化能力。改进:同时报告原始 prompt 与盲测协议结果。(4)缩放结论依赖 $6ND$ 代理与特定模型族,真实算力会改变最优 r;渐近地板差异(0.0701 对 0.0788)尚未转化为 FID 或人类偏好上可感知的差距。改进:补充实测 FLOPs 记账并做更大算力端到端验证。(5)范式尚未在视频或统一多模态设定下检验,AR 骨干为从零训练而非复用预训练 VLM。改进:以预训练 VLM 为骨干验证定律迁移性。
未来方向
作者在结论与附录 A.10 中提出的方向:把『先语义后渲染』解读为前沿视觉生成器的普遍趋势——AR 过程可以产出文本 rollout、视觉 token、结构化表征、检索结果乃至 agentic 交互,逐步消解用户请求的歧义,然后由扩散专注渲染;由此引出未决问题:当系统已能获得丰富的语言或智能体上下文时,Semantic-LM 式的语言对齐 token 与 Semantic-Recon 式的保留视觉信息 token 哪个是更好的接口?文本 rollout 与视觉 rollout 应各自消解多少不确定性再交给渲染器?基于本文成果可延伸的研究:把 AR 骨干替换为预训练 VLM,统一理解与生成并扩展到视频 token;研究 tokenizer 与 AR 的联合训练或迭代蒸馏,突破冻结 VLM 的先验上限;对渲染器做 token 扰动鲁棒性训练以切断误差传播;把 3:2 分配定律推广到不同数据分布、不同目标对(如掩码建模+扩散)与多分辨率课程,检验普适性;将缩放拟合的渐近差异与下游感知指标(FID、人类偏好)建立映射;探索推理时用更长文本 rollout 替代部分视觉 token 的算力-质量权衡。
复现评估
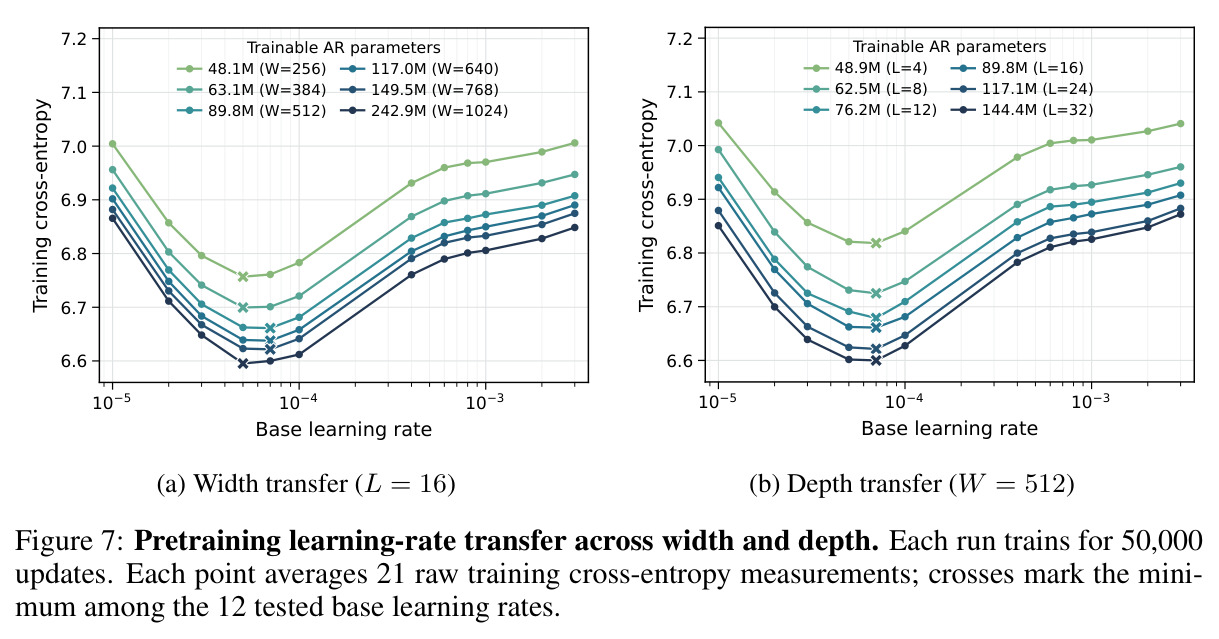
复现评估:论文为 Adobe Research 与 UCSD 的 preprint,未提及开源代码、权重或训练数据(in-house 图文数据不可得),完整复现难度较高。有利条件是附录异常详尽:A.1–A.3 给出 tokenizer 与受控实验全部超参(AdamW 设置、CompleteP 学习率迁移规则、lr 网格、262,400 token/update 预算),A.4–A.8 给出缩放拟合协议与全部架构表,A.9 给出最终模型配方与评测设置(EMA 0.9999、AR CFG 3、50 步 Euler、GenEval 553 prompt 单图 seed 42、DPG 1,065 prompt×4 图 seeds 42–45)。依赖的外部组件大多公开:RandAR、IBQ、Qwen2.5-VL-32B、DataComp-VLM 200B、Emu3.5 tokenizer 等。算力方面:复现 400M 受控对比约需数千 H100 小时,可行;复现缩放定律需训练 18+14+8 个模型(最大 2.4B),估计数万 GPU 小时;复现最终 3B 模型需约 6,600 H100 小时。综合难度中等偏高:方法可从公开组件拼装,但内部数据与总算力是主要门槛。
论文图表
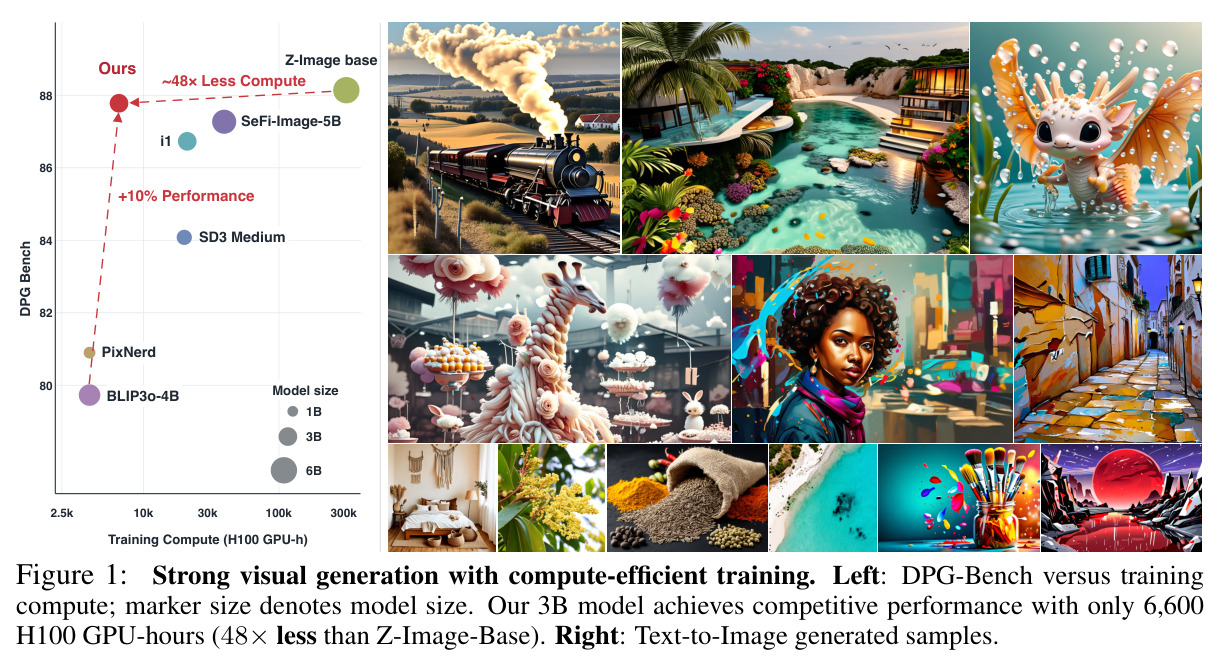
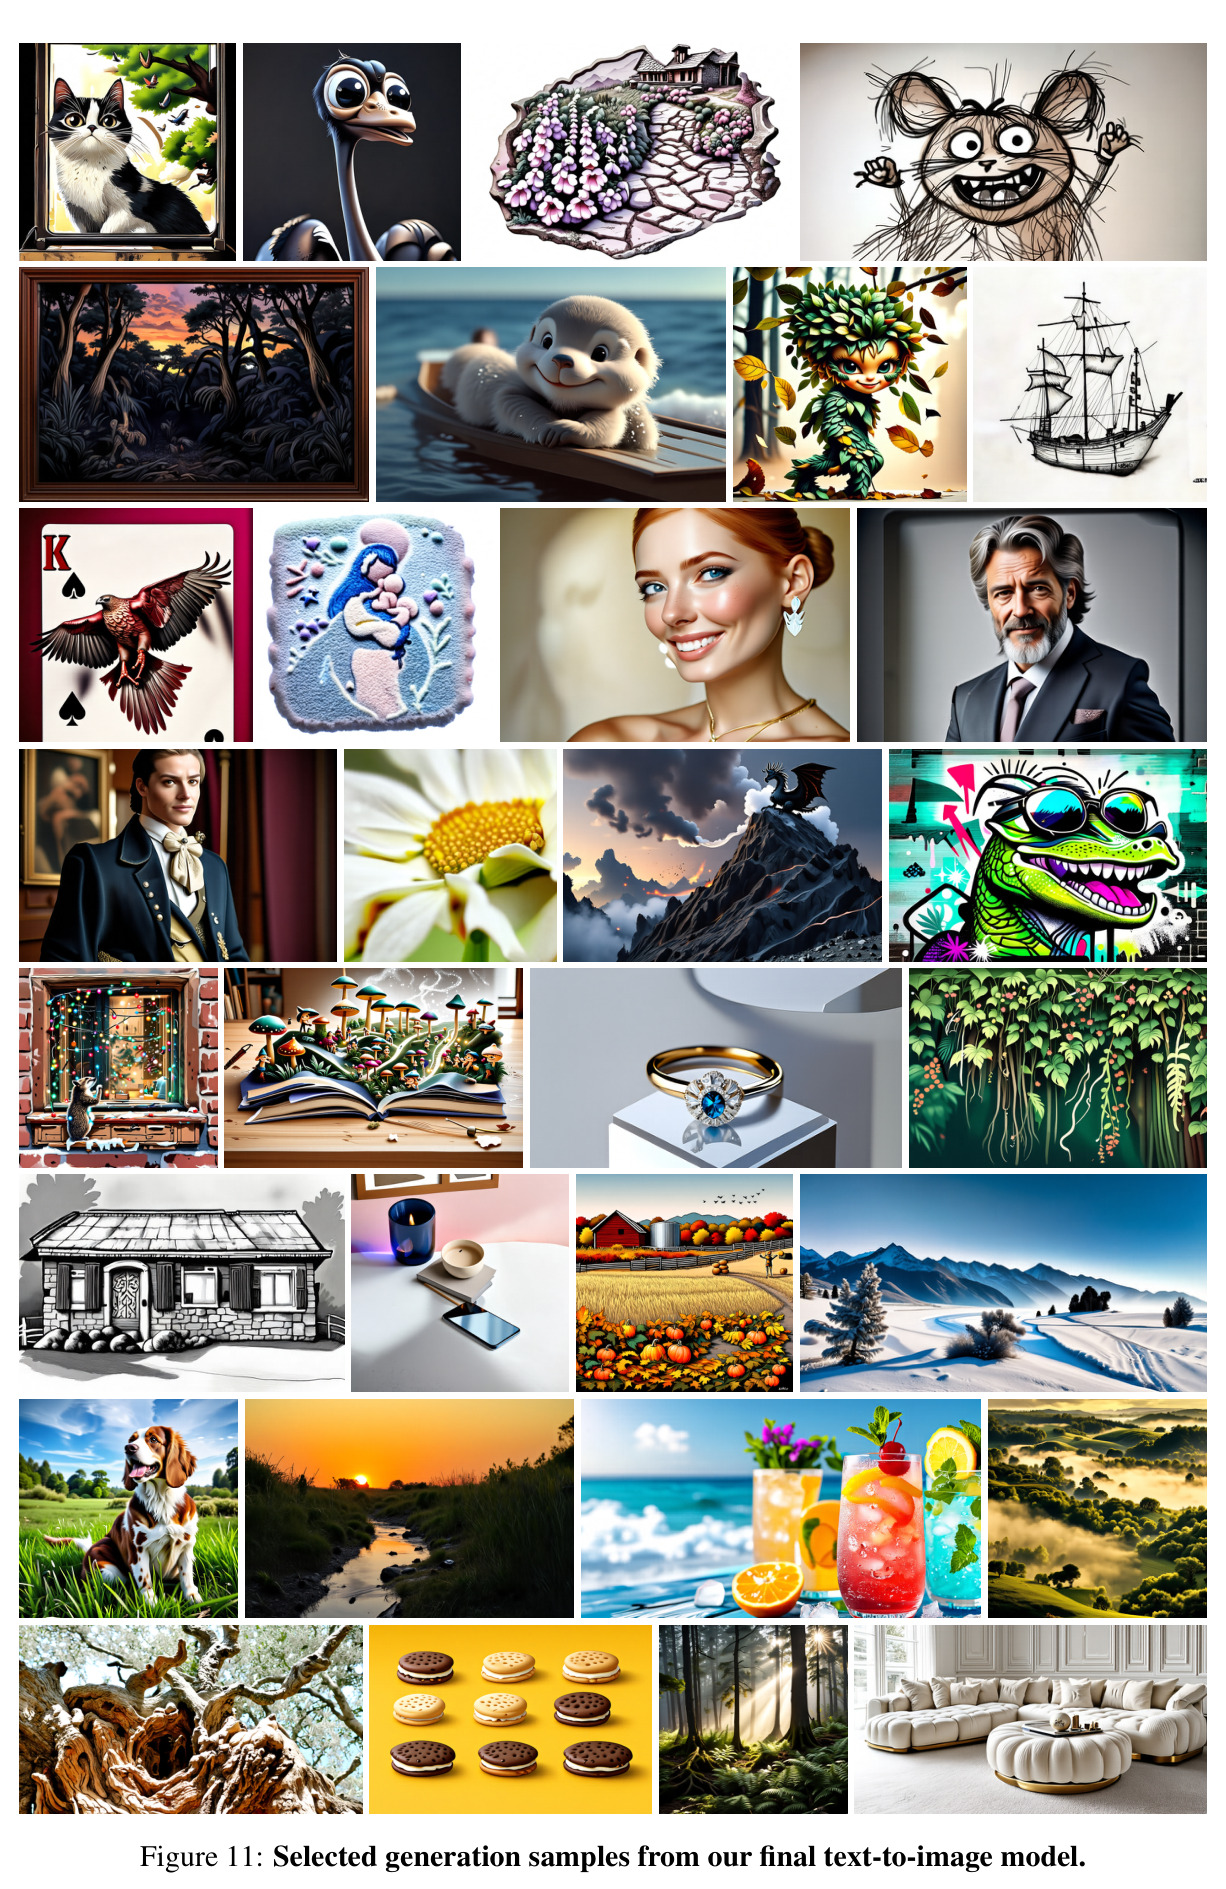
左图为 DPG-Bench 分数对训练算力(2.5k–300k H100 GPU 小时,对数轴)的散点图,点的大小表示模型规模:本文 3B 模型仅用 6,600 H100 小时(约为 Z-Image-Base 的 1/48,标注 48× Less Compute)就达到约 88 的 DPG,比 SD3-Medium、PixNerd、BLIP3o-4B 等高约 10%(标注 +10% Performance);右图展示生成的样例图像。
一图概括论文核心卖点——算力效率:用近两个数量级更少的训练算力达到可比的生成质量,是全文动机与结论的视觉摘要。
四条受控路线的完整配方:架构(宽度 1408/1280、层数、FFN 宽度)、表征(像素/FLUX.2 潜码/SVG/三种离散码本)、训练预算(各 40 万步,两阶段为 15 万+25 万)、分辨率课程(前 5 万步仅 256²,其余混合 256²/512²,低高 token 配额 1:4,每 update 262,400 token)、优化器与扩散设置(logit-normal、16px patch、噪声 std 2、速度流匹配)。
保证 Tab. 1/2 对比公平性的协议细节都在此表,是判断受控实验可信度以及日后复现的必要参考。
9 个 AR≥261M 的配对模型在各自 envelope 最优点上的两阶段算力分配:r 从 0.383 到 0.403,合计 $C_{pre}=7.63\times10^{21}$、$C_{post}=5.11\times10^{21}$,总分配约 1.50:1(r=0.401);小于 261M 的模型因 envelope 赢家噪声大而被剔除。
以具体数字展示 3:2 分配在不同规模上的稳定性,是 Fig. 6 结论的数据表支撑。