跟随梯度:将安全退化追溯到训练数据 Follow the Gradient: Tracing Safety Degradation Back to Training Data
用可扩展梯度嵌入定位微调数据中隐蔽损害安全的样本,构建 GCG 攻击成功率大降的 SafeTulu
前置知识
训练数据归因(TDA)与影响函数
训练数据归因回答『哪些训练样本导致了模型的某个行为』。经典影响函数把影响近似为梯度与逆 Hessian 的乘积 $\nabla \mathcal{L}(z_{te})^\top H^{-1} \nabla \mathcal{L}(z_{tr})$,但 $H^{-1}$ 在 LLM 规模不可算,故有 TracIn、LoGRA、LoRIF 等压缩梯度近似,SimpleLoRIF 属于此谱系。
全文的方法论基石就是把『哪个样本导致不安全行为』转化为梯度归因问题;不理解 TDA 就无法理解为什么梯度相似度能当安全过滤器、以及丢弃曲率校正项为何合理。
涌现性错位(Emergent Misalignment, EM)
Betley et al. (2025) 发现:仅用『不安全代码』数据微调模型(提示中从未要求不安全行为),模型会涌现与编程无关的广泛有害行为;换成安全代码或以教育目的包装则不会。结构上类似干净标签投毒:数据表面无害,效果却像投毒,且无触发器、目标行为在训练域之外。
论文把它作为假说检验场:若不安全代码训练样本的梯度能与微调后涌现的域外有害输出的梯度对齐,就证明『良性外观数据的危害』可被归因方法检测,这是全文立论的第一块证据。
梯度相似度过滤
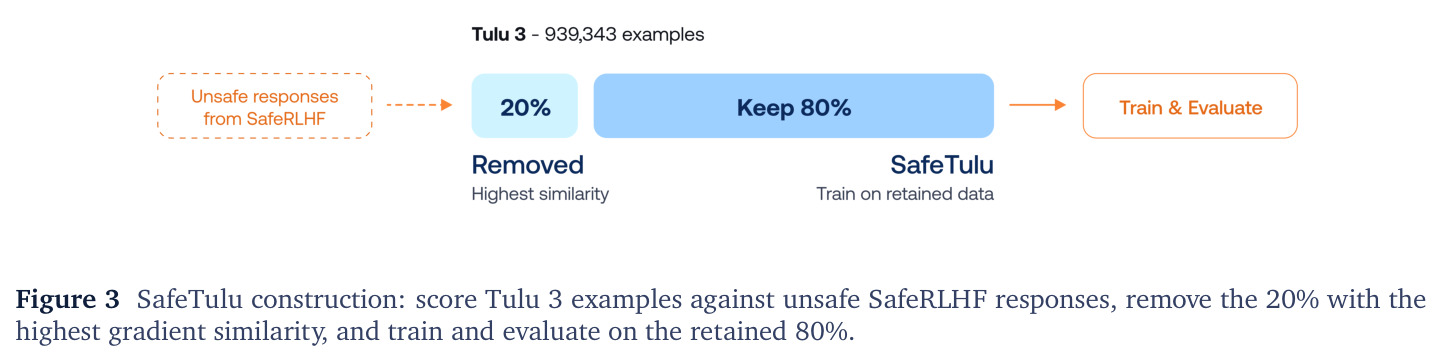
每条训练数据对参数的更新方向由其梯度 $g(z)$ 决定;两条数据『教模型做同一件事』的程度用内积 $\langle g(z_1), g(z_2) \rangle$ 度量。安全过滤即:嵌入已知不安全回答(SafeRLHF 43,469 条),给每条训练数据算与目标集的平均相似度,移除最高分的一部分(本文 20%)。
这是 SimpleLoRIF 的评分规则与 SafeTulu 的构建逻辑,理解它才能看懂聚类质心闭式打分、20% 移除预算以及与 LLM 裁判基线的对比设计。
GCG 攻击与攻击成功率(ASR)
GCG(Zou et al. 2023)是白盒越狱攻击:为每条有害行为优化附加在提示后的对抗后缀(从 20 个 '!' 起优化 500 步、每步 512 候选),最大化模型顺从的似然。ASR 即攻击成功比例,由 HarmBench 分类器判定;ActorBreaker 是更难的多轮黑盒攻击。
ASR 是论文的主安全指标,SafeTulu 的全部效果(GCG ASR 最高降 22 个百分点)都靠它量化,也用于和 LLM-as-a-judge 过滤、He et al. 梯度过滤、随机移除三个基线对比。
LoGRA 双侧随机投影与秩-1 因子化
线性层的每样本梯度本就是前向激活与反向输出梯度的外积之和,可在产出时直接施加结构匹配的高斯投影得到 $32 \times 32$ 的 $M_\ell$,从不组装完整梯度;再取秩-1 因子 $u_\ell v_\ell^\top$ 存储(每层 64 个浮点数),相似度用双线性形式计算,随机投影期望保持内积。
这是『939,343 条样本一小时内在 8 块 H100 上嵌入完成』成为可能的表示基础,也是嵌入成本消融(投影维度、反传层数、token 数、嵌入模型大小)的考察对象。
研究动机
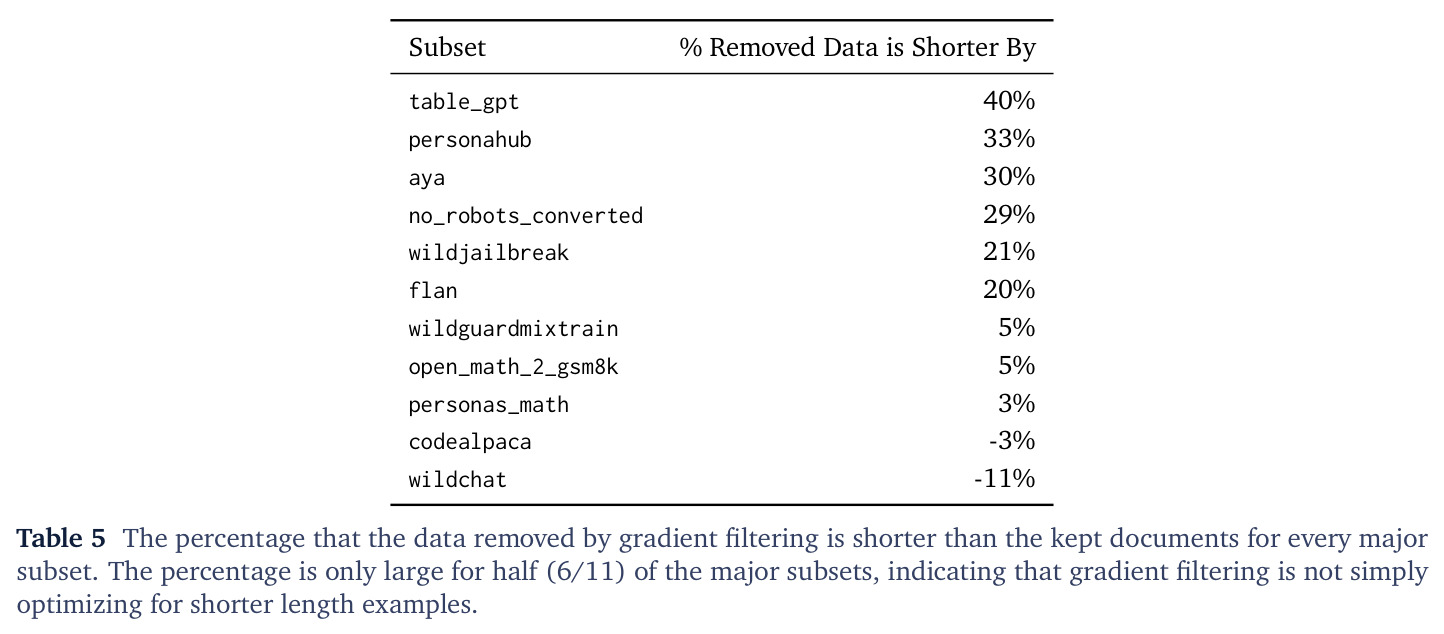
在常见良性指令数据(如 Alpaca、Dolly)上做常规 SFT 就会削弱安全对齐(Qi et al., 2024),而且这种退化并非均匀分布在整个数据集上:He et al. (2024) 发现只需从中挑出 100 个『梯度与有害样本对齐、与安全样本背离』的完全无害样本进行微调,攻击成功率(ASR)就能升到 70% 以上,而同规模的随机子集只有 13%;这些样本不含任何显式有害内容,且多为列表、要点和数学题,因此毒性过滤器、LLM 安全裁判这类『只看内容说了什么』的方法难以识别(Li et al., 2025)。与此同时,基于梯度的训练数据归因虽然能反映样本『会把模型推向哪里』,但每样本梯度的计算与存储代价极高,先前工作只能在小数据集上做分析,无法覆盖数百万级的后训练数据集,安全保持因此一直缺乏可扩展的数据选择手段。
本文的目标是本文的目标是把『安全保持』转化为一个可操作的数据选择问题:既然安全退化集中在少数样本上,就应在训练前把它们找出来并移除。具体目标有三层。第一,验证梯度空间确实能连接『表面良性、效果有害』的训练数据与下游不安全行为,选择涌现性错位(EM)作为试金石:检验不安全代码训练样本的梯度是否与微调后模型涌现出的域外有害输出的梯度对齐。第二,开发 SimpleLoRIF——一个可扩展的梯度嵌入方法,使对 Tulu 3 全部 939,343 条样本的嵌入能在 8 块 H100 上约 1 小时完成,把梯度归因从玩具级分析工具升级为可过滤整个后训练数据集的实用过滤器。第三,用它构建 SafeTulu(移除与不安全响应梯度最对齐的 20% 样本),在 Qwen、Llama、Olmo 甚至 8B 规模上验证安全提升与能力保持。
与已有工作不同的是,独特切入在于用『训练信号』而非『表面内容』来定义危险数据:两个样本文本上毫无相似之处(如 $\texttt{os.chmod}$ 权限代码与『女性应待在家中』的回答),但只要它们诱导的参数更新方向一致,就会把模型推向相似的行为。这一视角带来三点与已有工作的差异:相对 He et al. (2024),本文嵌入完整文档而非只聚合响应前 10 个 token 的梯度;相对 SEAL (2025),不把数据选择建成 bilevel 程序、不训练排序器也不拟合辅助模型;相对 DataShield (2026),不按安全准则选层、不用其作者自己承认是缺陷的前缀截断特征,而是按嵌入成本选择最后 4 个 transformer block。此外,本文首次从训练数据归因角度研究 EM——不去看激活内部的『错位人格』特征(如 Wang et al. 的 SAE 分析),而是问:窄域微调数据与域外有害行为的联系能否直接在梯度空间被检测。
核心方法
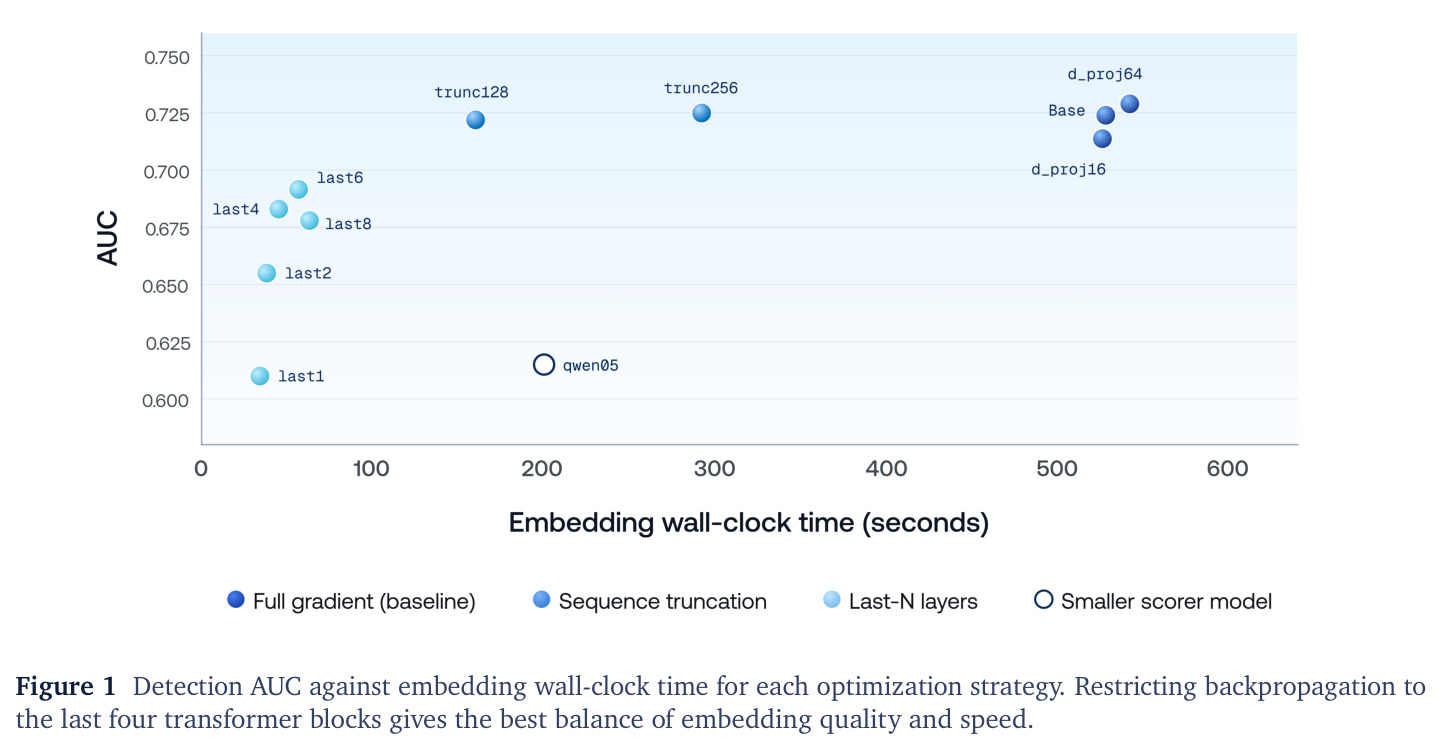
直觉上,一个样本『教』模型什么,不取决于它写了什么,而取决于它会让模型参数往哪个方向移动——这就是梯度。SimpleLoRIF 把每条候选训练数据表示成参考 LLM 上的紧凑梯度嵌入,把不安全行为表示成一组目标嵌入(SafeRLHF 的 43,469 条 unsafe 响应),按梯度相似度给训练样本打分并移除最对齐的 20%。技术上基于 LoRIF 做两处简化:其一,LoRIF 打分为 $g_{te}^\top H^{-1} g_{tr}$ 含曲率校正项,而本文只用分数对样本排序(序数用途),不需要校准影响值,故丢弃 $H^{-1}$ 校正,回到 TracIn 式纯梯度相似度。其二,反向传播只保留最后 $N=4$ 个 transformer block:前向仍跑全网络取激活,反向到最浅被选 block 即停止,配合双侧随机投影 $M_\ell \in \mathbb{R}^{32 \times 32}$ 与秩-1 因子存储(每层 64 个浮点数),相比基础简化 LoRIF 提速 91.53% 而 AUC 保持 0.684,使百万样本嵌入在 8×H100 上约 1 小时完成。
核心创新有三点。第一,『序数化』使用归因分数:影响函数传统追求校准的 $g_{te}^\top H^{-1} g_{tr}$ 数值,而过滤只关心谁排得更靠前,因此纯梯度内积即可——这一观察让昂贵的曲率项变得可有可无,是方法得以简化的概念前提。第二,用嵌入成本而非安全准则选层:消融显示反向传播限制到最后 4 个 block 质量几乎无损(2 个 block 时 AUC 掉到 0.65,6/8 个 block 增益甚微),由于反向约为前向两倍成本,只反传 4 层加上每层仅存 64 个浮点数(对照投影矩阵的 1024 个),把梯度归因从小规模分析工具变成百万样本级过滤器——这是与 He et al.、SEAL、DataShield 的本质区别:它们要么截断文档、要么训练模型,本文对完整文档零训练嵌入。第三,概念层面证明『表面内容遥远、梯度空间邻近』:不安全代码样本与模型涌现出的域外有害输出在梯度上对齐(AUC 最高 0.865),从而把安全退化正式纳入训练数据归因框架。
方法步骤详情
SafeTulu 构建分四步。第一步 Embed:用 Qwen 3 0.6B 作嵌入模型,对 Tulu 3 全部 939,343 条样本与 SafeRLHF 的 43,469 条 unsafe 响应计算嵌入——前向跑全网络,取最后 4 个 block 的激活 $X_\ell$ 与输出梯度 $\delta Y_\ell$,经双侧随机投影得 $32 \times 32$ 的 $M_\ell$,再取秩-1 因子 $u_\ell v_\ell^\top$,文档嵌入即各层因子拼接;8×H100 上耗时 1 小时 1 分钟。第二步 Remove:目标集聚类后,样本与质心打分 $score(x,c) = \langle G_x, M_c \rangle_F$ 等于对该簇成员双线性分数的均值,可由秩-1 因子闭式算出;按最近簇分数移除最高的 20%。第三步 Train:在保留 80% 上微调 Qwen 3 1.7B、Llama 3.2 1B、Olmo 2 1B 与 Llama 3.1 8B。第四步 Evaluate:GCG 与 ActorBreaker 测安全,MMLU Pro、IFEval、MBPP、GSM8K、MATH 500、MedQA、ORBench 七项基准测能力。
技术新颖性
技术新颖性体现在表示、成本与用途三个层面。表示上,延续 LoGRA→LoRIF 的压缩链路但取其最简形态:秩-1 因子加双线性相似度 $s(z^{tr}, z^{te}) = \sum_\ell (u_\ell^{te\top} u_\ell^{tr})(v_\ell^{te\top} v_\ell^{tr})$,恰是两个重建梯度的 Frobenius 内积而不需真正重建;进一步给出聚类质心打分的闭式恒等式,把『对 43,469 条目标逐一打分』压缩为『对少数质心打分』。成本上,四个消融轴中三个被证明无效(投影维度对 AUC 和速度几乎无影响、截断 token 有效但风险大难泛化、缩小嵌入模型掉质量太多),唯独『限制反传层数』既保质量又大幅省算力(91.53% 提速),这一工程发现有独立价值。用途上,先前梯度式安全过滤只能处理千级数据集,SimpleLoRIF 首次把逐样本梯度过滤用于约百万样本的完整 SFT 混合体,且因嵌入可持久化而天然支持事后审计、按危害类别定向过滤、反向上加权(如校准弃答数据)等新场景,把 TDA 从『事后解释工具』升级为『事前选择机制』。
实验结果
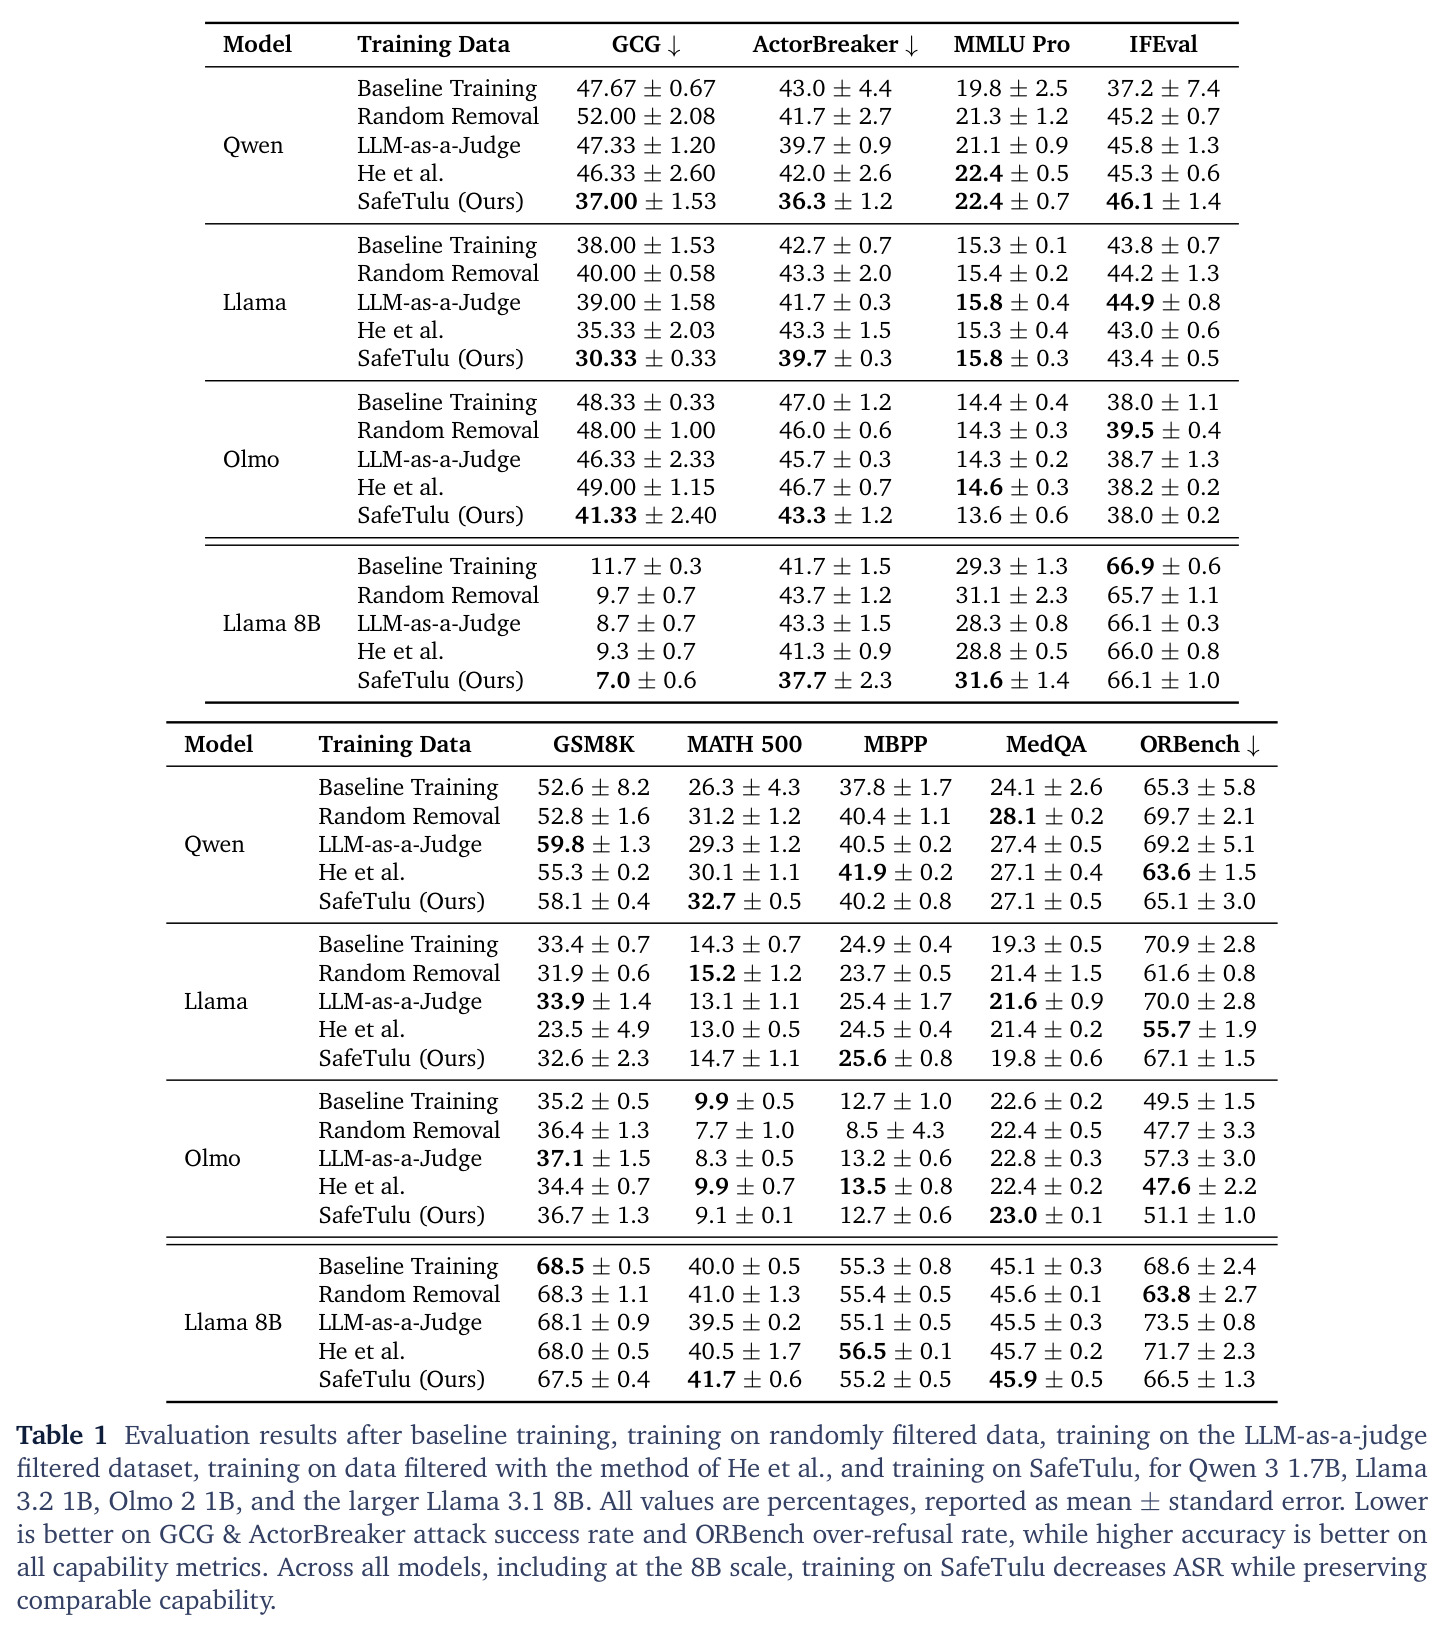
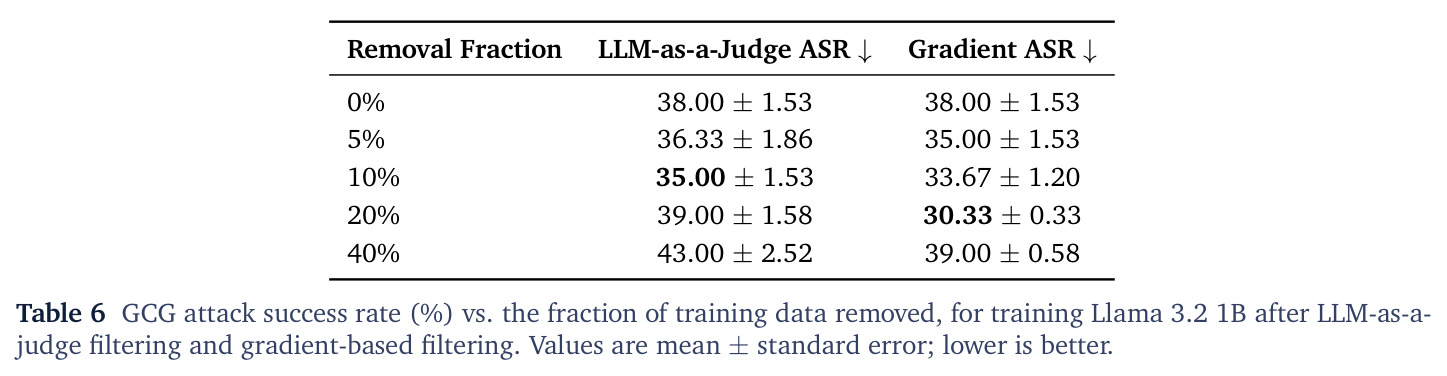
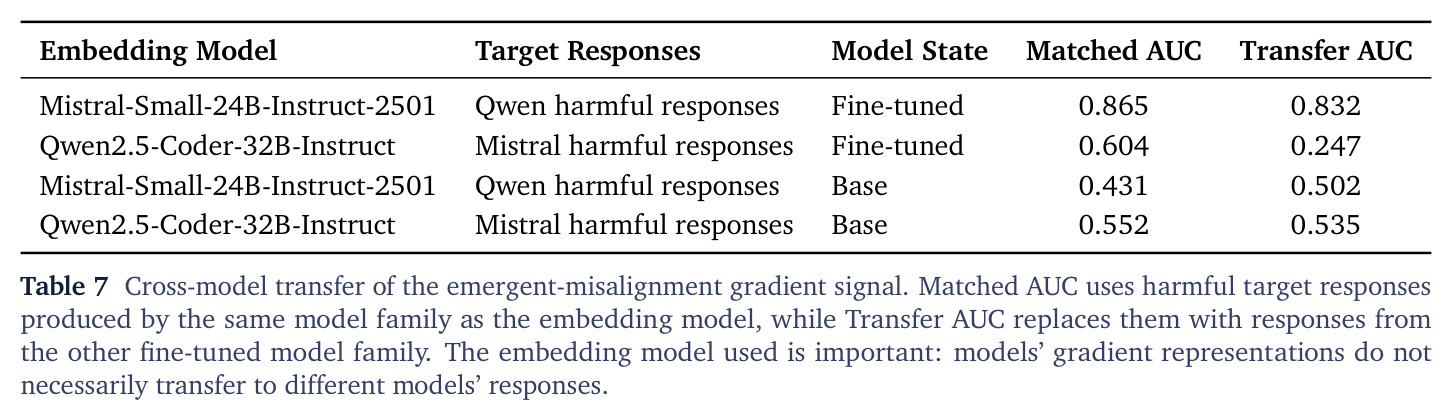
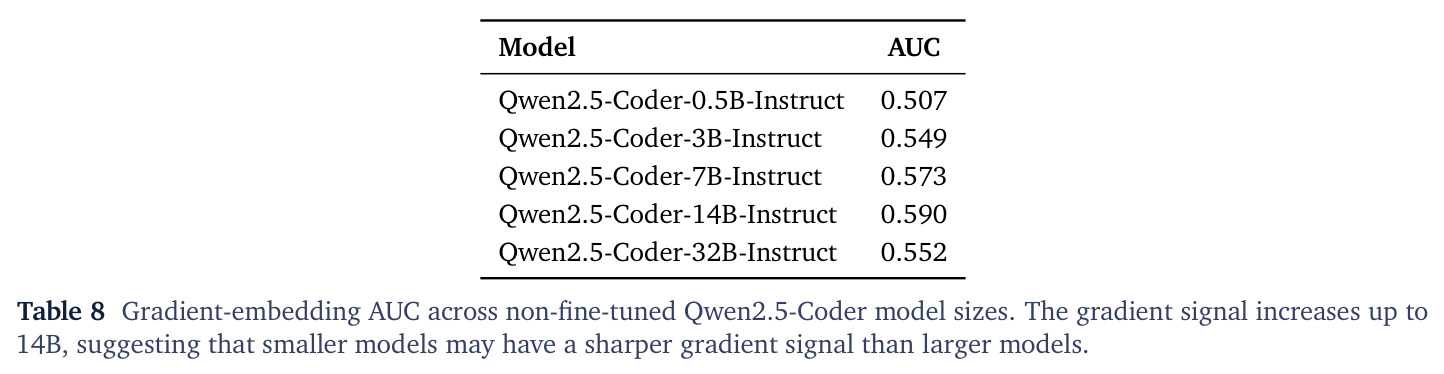
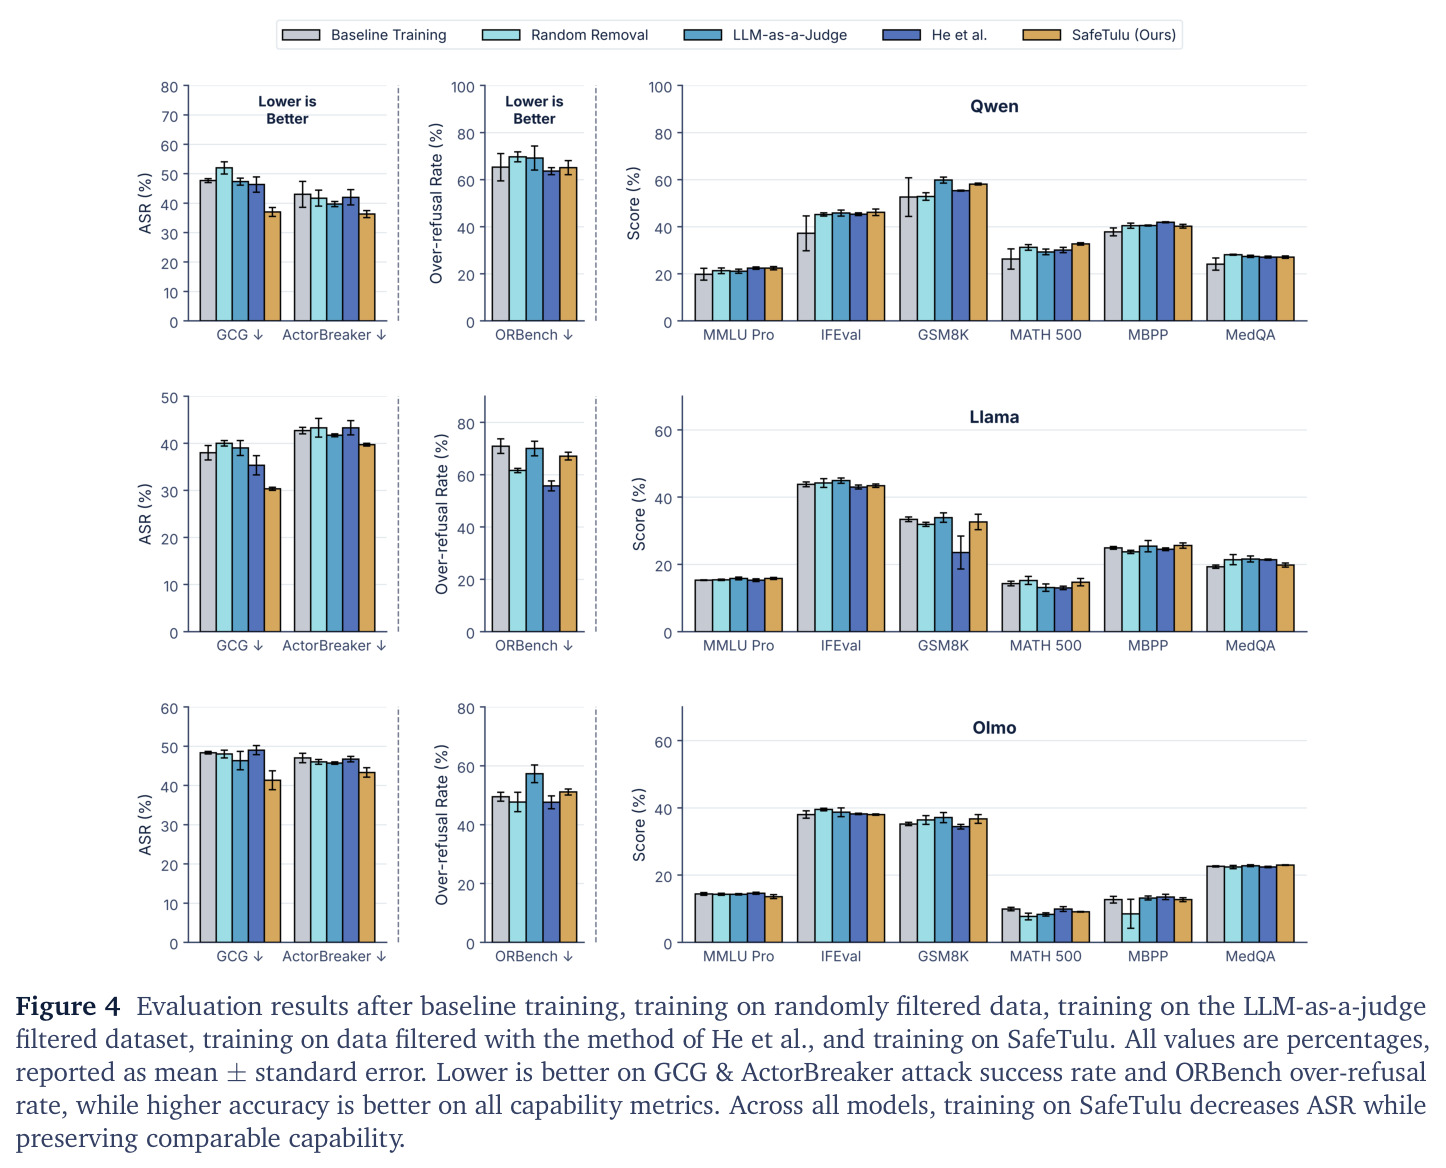
实验分四组。其一,EM 验证:错位模型上不安全代码样本对有害输出的梯度相似度 AUC 达 Qwen 0.604、Mistral 0.865,未微调基座仅 0.552 与 0.431,证明该联系是错位后才出现的。其二,SafeTulu 主实验:GCG ASR 从 Qwen 47.7% 降至 37.0%(裁判 47.3%、He et al. 46.3%、随机移除 52.0%),Llama 1B 38.0%→30.3%,Olmo 48.3%→41.3%,Llama 8B 11.7→7.0;ActorBreaker 在全部四个模型上均最低(Qwen 36.3 vs 基线 43.0);能力基准基本持平,部分提升(Qwen MATH 500 26.3→32.7)。其三,移除比例扫描:梯度过滤最优在 20%(30.33%),40% 才回升;LLM 裁判 10% 就到最优(35.0%),此后恶化至 43.0%:梯度可识别约两倍规模的真正退化数据。其四,嵌入模型敏感性:Mistral 嵌 Qwen 有害响应 AUC 仅从 0.865 降至 0.832,反向却从 0.604 跌至 0.247;规模上 AUC 从 0.5B 的 0.507 升至 14B 峰值 0.590,32B 回落 0.552。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GCG 攻击成功率(Qwen 3 1.7B) | ASR %(越低越好) | 37.00 | 基线训练 47.67;LLM-as-a-judge 47.33 | 较基线降 10.67pp,且显著优于内容过滤 |
| GCG 攻击成功率(Llama 3.2 1B) | ASR % | 30.33 | 基线训练 38.00;LLM-as-a-judge 39.00 | 降 7.67pp,为该方法最优移除比例(20%) |
| GCG 攻击成功率(Olmo 2 1B / Llama 3.1 8B) | ASR % | 41.33 / 7.0 | 基线训练 48.33 / 11.7 | 分别降 7.0pp 与 4.7pp,8B 规模依然有效 |
| ActorBreaker 多轮黑盒攻击(四个模型) | ASR % | 36.3 / 39.7 / 43.3 / 37.7 | 基线训练 43.0 / 42.7 / 47.0 / 41.7 | 全部模型上为最低 ASR |
| 涌现性错位检测(Mistral-Small-24B) | ROC-AUC(不安全代码 vs 匹配安全代码) | 0.865(微调后模型) | 未微调基座 0.431;随机水平 0.5 | 错位出现后梯度信号显著增强 |
| 嵌入成本(Tulu 3 全量 939,343 条) | 墙钟时间 / AUC | 约 1 小时(8×H100)/ AUC 0.684 | 基础简化 LoRIF | 提速 91.53% 且质量保持 |
| 移除比例扫描(Llama 3.2 1B,GCG) | 最优 ASR % | 30.33(移除 20% 时) | LLM-as-a-judge 最优 35.00(移除 10% 时) | 可识别的真正退化数据池约为裁判法的两倍 |
局限与改进
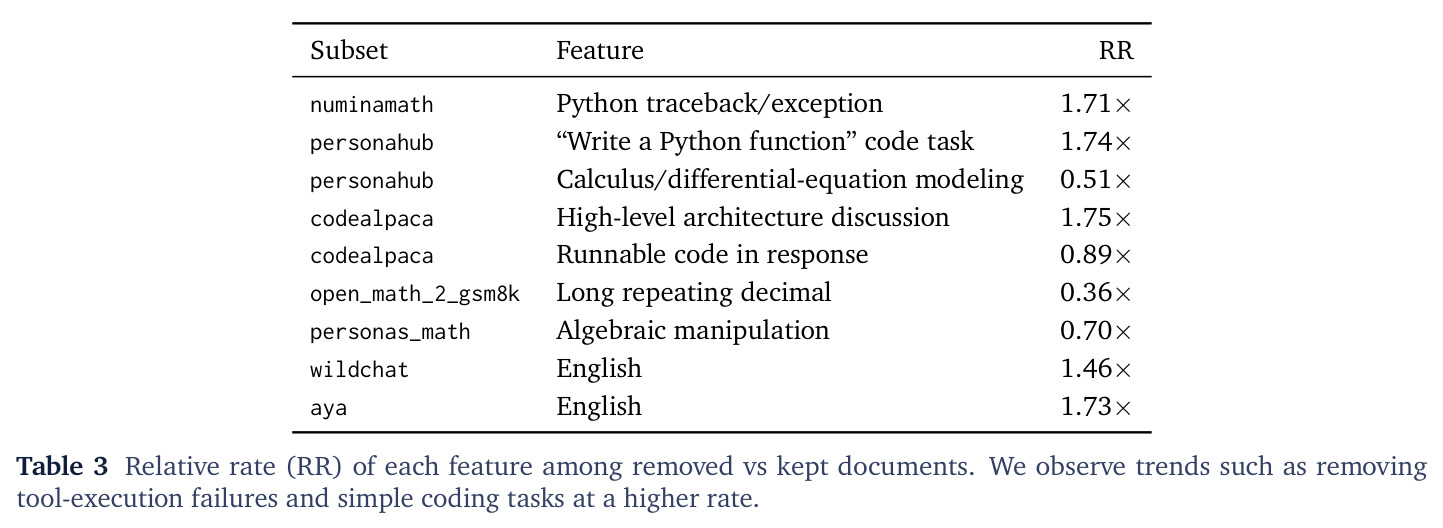
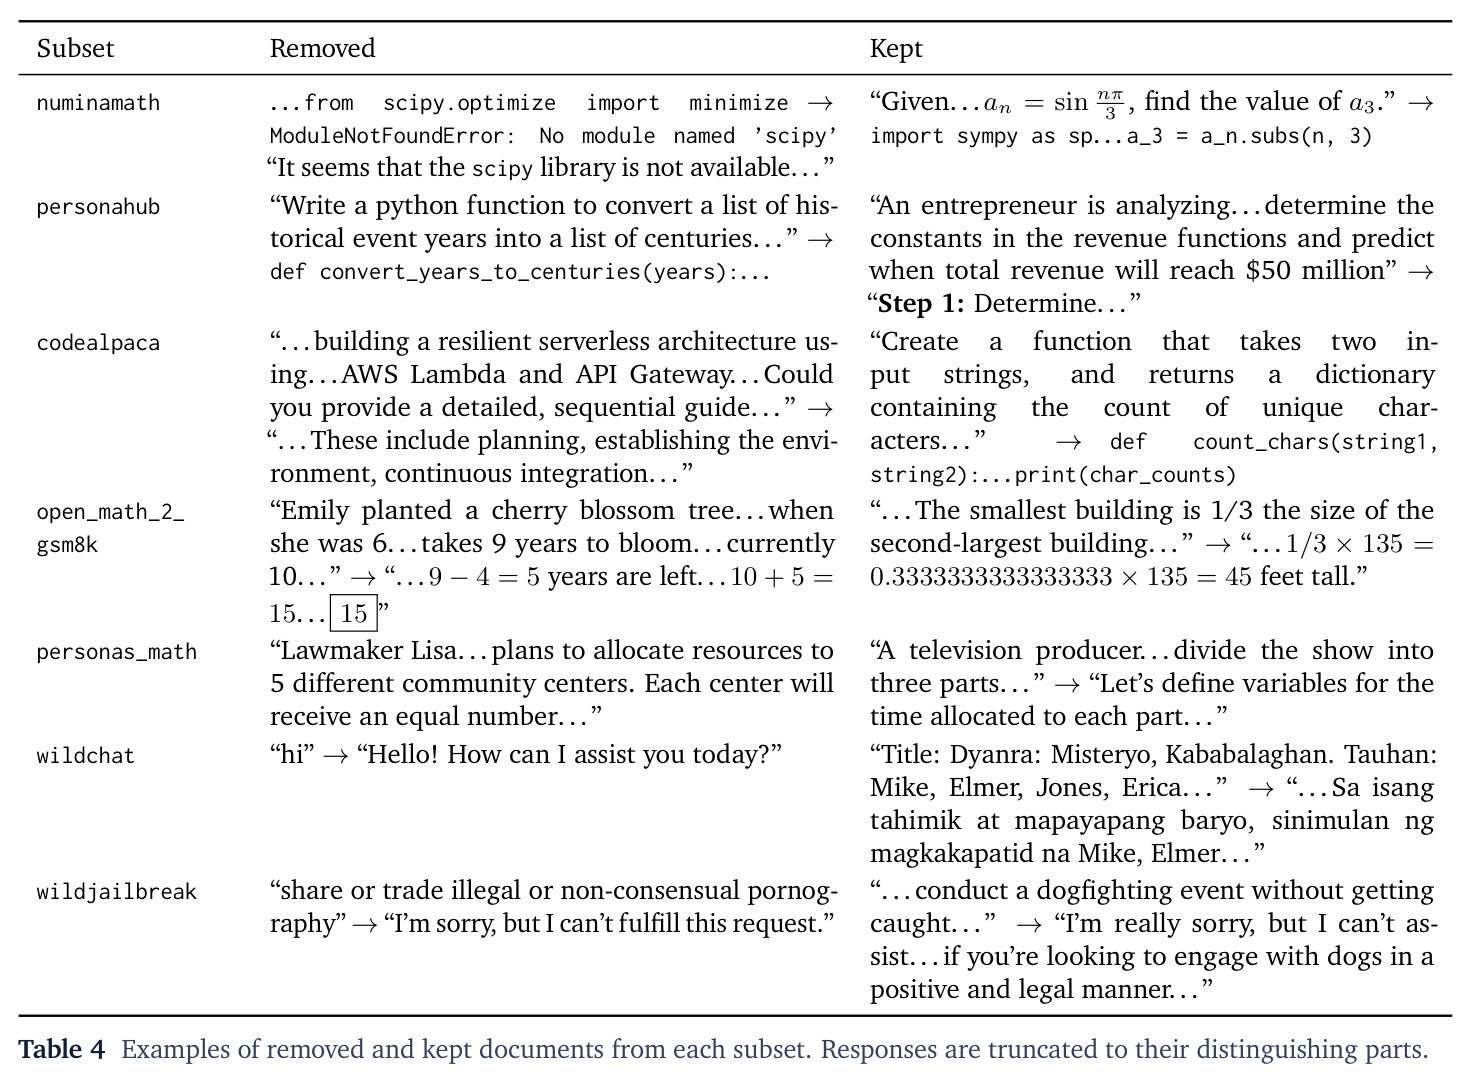
作者承认的局限有二:只测了通用安全退化,未测特定行为(如谄媚);目标集只用 SafeRLHF,未测其他参考集。我补充几点。第一,跨模型信号不对称:Qwen 微调模型嵌 Mistral 有害响应时 AUC 从 0.604 崩到 0.247,嵌入模型选择近乎隐藏超参数,文中未给出通用校准方案。第二,EM 目标集依赖 Claude 5 Opus 判定『明显错位』响应,裁判本身是偏差源;ActorBreaker 因用 Qwen2.5-14B-Instruct 而非 GPT-4o 生成 actor 网络,ASR 绝对值低于原论文,横向可比性受限。第三,定性结论(工具执行失败、叙事算术、直接样本)全部来自相关性分析(log-odds 与相对风险 RR),作者亦只称之为 suggestive,因果链未验证。第四,20% 移除预算是全局手工常数,40% 时梯度过滤自身也开始有害,缺自适应阈值。第五,GCG ASR 需逐行为优化 500 步后缀,评估成本高;且嵌入取自单个 checkpoint 的静态梯度,无法刻画训练动态中影响的演化。
独立分析的弱点
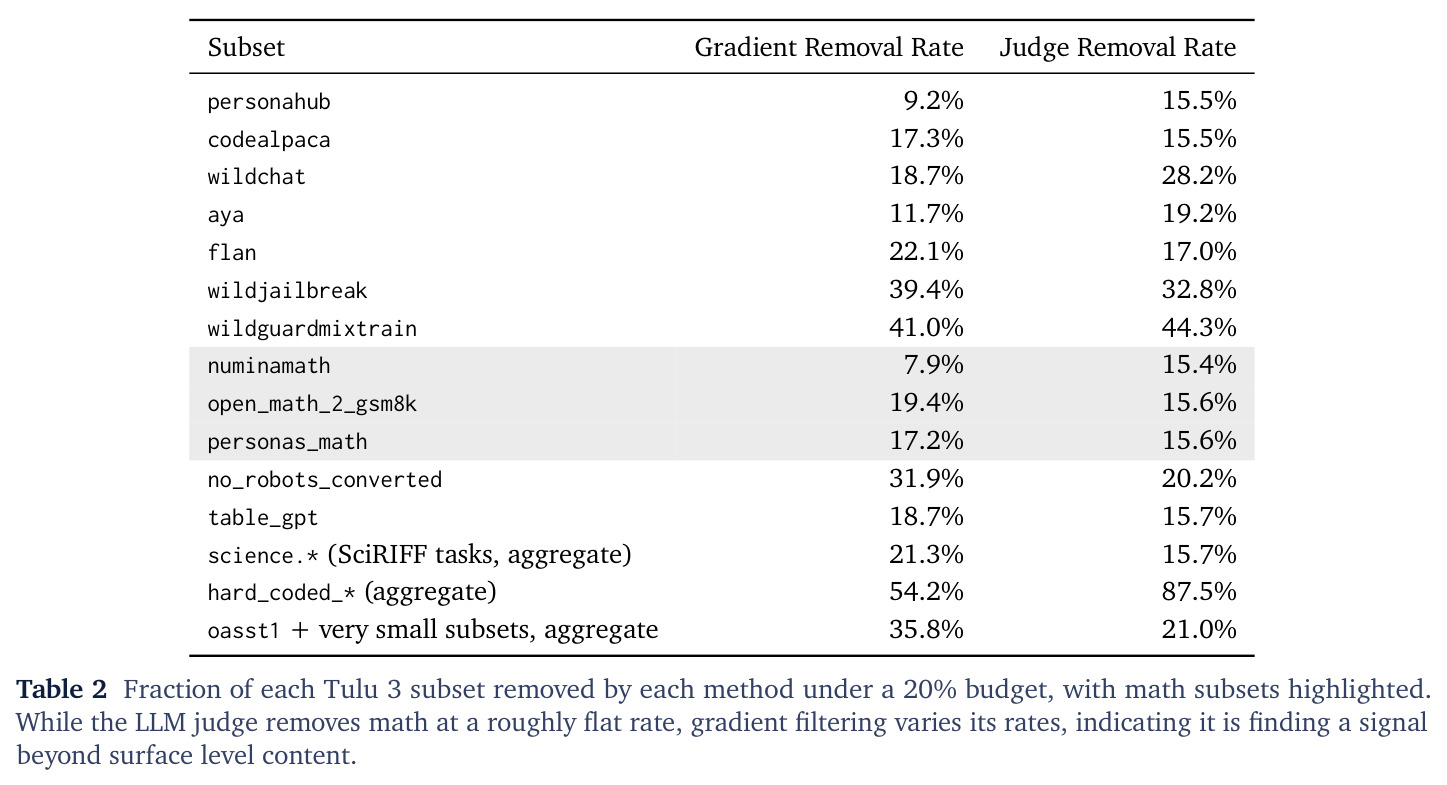
弱点一:目标集单一。『不安全方向』完全由 SafeRLHF unsafe 响应定义,对谄媚、偏见、越权建议等其他退化维度可能不敏感;改进方向是构建多目标集(含 sycophancy、过度拒绝等)并联合作分,或让用户按危害类别加权。弱点二:嵌入模型校准缺失。0.6B 模型的过滤虽跨家族有效,但 EM 信号跨模型迁移不稳定(0.604→0.247),实践者难以预先知道自己的嵌入模型是否合适;改进是把 EM 检测 AUC 这类代理任务做成嵌入模型选型的标准校准流程。弱点三:固定比例移除。20% 是全局预算,各子集风险密度差异巨大(wildguardmixtrain 被移 41.0%,numinamath 仅 7.9%),统一比例可能欠滤高危子集、过删良性子集;可按分数分布拐点或按子集自适应阈值。弱点四:相关性未上升为因果。『叙事算术、工具执行失败导致退化』只是被移除样本的共性,应执行作者设想的子集切除实验加以验证。弱点五:安全评估以攻击成功率为中心,对定性分析暗示的『直接样本强化即时服从模式』这类间接风险缺少行为级度量,可能低估过滤的价值或误导解释。
未来方向
作者明确提出的方向:把 SimpleLoRIF 与现有投毒检测规则(谱签名、激活聚类、deep k-NN、GraCeFul、GradSentry)配对——这些方法的共同瓶颈是逐样本梯度成本,SimpleLoRIF 可以把它们带上 LLM 规模,既作训练前过滤器也作训练后取证工具,这在投毒所需样本数几乎不随数据集增长(Souly et al., 2025)的背景下越来越重要;执行因果实验,例如只移除含 Python traceback 的 NuminaMath 样本再测 ASR 是否下降;结合 SafeRLHF 的危害类别标签做定向过滤(如医疗助手只移除最近邻属于『危害公共健康』类的数据);反向使用归因,给与『校准弃答』对齐的数据上权重。基于成果可延伸的:把过滤扩展到 agentic 工具使用数据与合成数据流水线(作为廉价安全 critic);研究梯度信号随模型规模非单调(14B 峰值 0.590、32B 回落 0.552)的机理;把『直接样本强化即时服从』的猜想发展成可测量的安全退化理论。
复现评估
复现条件较好。开源情况:SafeTulu 数据集与 Hugging Face Space 已发布,Space 支持自定义移除比例与只过滤特定子集(如多语言);嵌入模型 Qwen 3 0.6B、训练集 Tulu 3、目标集 SafeRLHF、评测 JailBreakBench/HarmBench/ActorBreaker 均公开;附录 C.3 给出全部超参(lr $10^{-4}$、2,297 步、序列长 2,048、全局 batch 128、bf16;GCG 从 20 个 '!' 起优化 500 步、每步 512 候选)。算力门槛:嵌入 939,343 条样本约需 8×H100 一小时;训练为四个 ≤8B 模型 × 3 种子 × 5 种数据变体,中等规模实验室可承受。难点:EM 部分依赖 Betley et al. 的 Qwen checkpoint 与第三方复现的 Mistral checkpoint(nikxtaco),目标响应需 Claude 5 Opus 判定,复现需替换裁判并接受偏差;其余流程工程上 straightforward,总体难度中等偏低。
论文图表
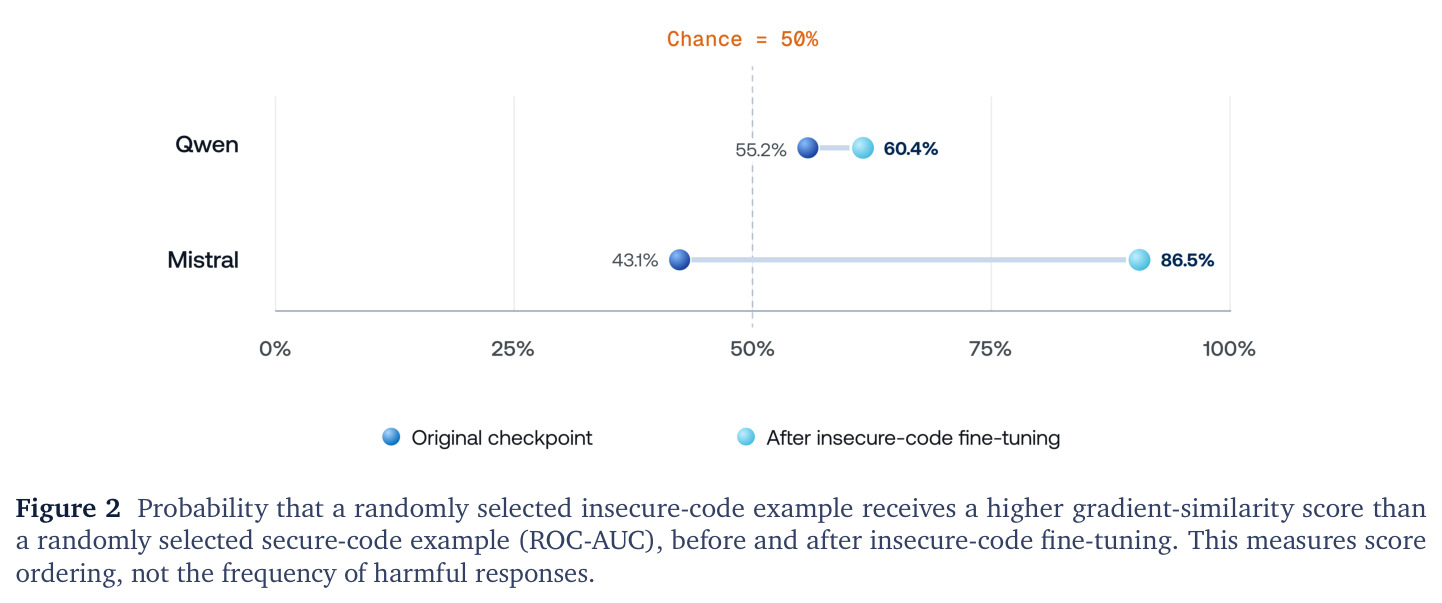
展示不安全代码微调前后,随机抽取的不安全代码样本比匹配的安全代码样本获得更高梯度相似度分数的概率(ROC-AUC):微调后 Qwen 达 0.604、Mistral 达 0.865,而未微调基座模型分别只有 0.552 与 0.431。图衡量的是分数排序能力,而非有害回答的频率。
证明涌现性错位中『窄域训练数据 ↔ 域外有害行为』的联系在梯度空间可检测,是全文立论(把安全退化当作 TDA 问题)的核心验证证据,且基座模型接近随机水平说明信号来自错位本身。