基于迭代事后重标注的质量可控机器人策略学习 Learning Quality-Controllable Robot Policies with Iterative Hindsight Relabeling
质量标签条件化策略加迭代事后重标注,推理时可控执行质量,持续突破演示数据质量上限
前置知识
行为克隆
行为克隆(BC)是机器人模仿学习的标准做法:收集人类遥操作的成功轨迹,用监督学习最大化策略输出与演示动作的似然,损失为 $\mathcal{L}(\theta) = -\mathbb{E}_{(h_t,A_t)}[\log \pi_\theta(A_t|h_t)]$。它把所有成功轨迹同等对待,学到的策略会复现数据中快、慢、平滑、抖动等各种执行方式的混合分布。
本文的问题起点正是 BC 无法区分'怎么完成任务',QCP 本质上是在 BC 目标上加入质量标签条件化的改进,且实验中多个基线(BCacc、BCfilter)就是 BC 的变体。
流匹配
流匹配(Flow Matching)是一种生成式建模方法:训练速度场 $v_\theta$ 学习把高斯噪声 $\epsilon$ 沿插值路径 $A^u_t = (1-u)\epsilon + uA_t$ 输运到目标动作,回归目标为 $A_t - \epsilon$;推理时把 $v_\theta$ 从 $u=0$ 积分到 $u=1$ 生成动作块。$\pi_0$、$\pi_{0.5}$、GR00T 等现代机器人策略普遍用它生成连续动作。
QCP 的策略骨干就是流匹配,质量标签通过嵌入向量(从头训练时)或语言提示文本(VLA 微调时)注入速度网络,不理解这一生成框架就读不懂方法细节。
事后经验回放
事后经验回放(Hindsight Experience Replay, HER)原是稀疏奖励强化学习的技巧:轨迹未到达预期目标时,把实际达到的目标事后当作该轨迹的目标重新标注,从而把失败数据转化为有效训练信号,大幅提升样本效率。
本文把这一思想从'目标'迁移到'质量'维度:请求最高质量档采到的 rollout 不按请求标签、而按实际测得的质量重新标注,这是迭代扩展可控质量范围的核心机制,也是标题中 hindsight relabeling 的由来。
经验CDF分位数量化
把连续质量分数映射为离散标签的方法:先计算数据集上的经验累积分布 $\hat{F}(s) = \frac{1}{|D|}\sum_{\tau'} \mathbf{1}\{m(\tau') \le s\}$,再按 $q(\tau) = B\hat{F}(m(\tau)) - 1$ 划成 $B$ 个等频桶。等频划分保证每个标签都有足够的训练样本支撑,避免回报条件化(如 Decision Transformer)请求超出训练分布时不可靠的问题。
QCP 的质量标签就由它生成,且每轮迭代在累积数据上重算分位数边界——这正是'最高档指代的绝对质量逐轮上移'的具体实现,是全文最关键的一步操作。
研究动机
机器人策略普遍用行为克隆在成功演示上训练,把每条轨迹同等对待:无论执行得快还是慢、平滑还是抖动,只要是成功轨迹就进入同一个损失。结果是策略复现数据中所有执行风格的混合,推理时没有任何旋钮可以选择部署真正需要的行为。而现实中任务对质量的要求各不相同:传送带分拣线上速度决定吞吐,托盘端送酒杯时稳定性决定成败。已有的质量可控策略(如 Zhan et al. 2020 的可校准策略、Yang et al. 2025、Petitbois et al. 2026 的 SCIQL)以及风格化离线 RL 方法 SORL 都只在静态演示数据集上训练,存在两个硬伤:其一,数据集的质量范围有限——例如 Robomimic Multi-Human 数据由不同水平的操作员采集,虽然覆盖面广,但没有物理极限附近的高性能区间,缺少部署所需的'最快速度'或'理想平滑度';其二,风格条件化方法存在风格-任务权衡——SORL 只训练标签匹配的轨迹、丢弃大量成功数据导致成功率下降,SCIQL 把任务优势与风格优势加权求和,两个目标难以兼得。
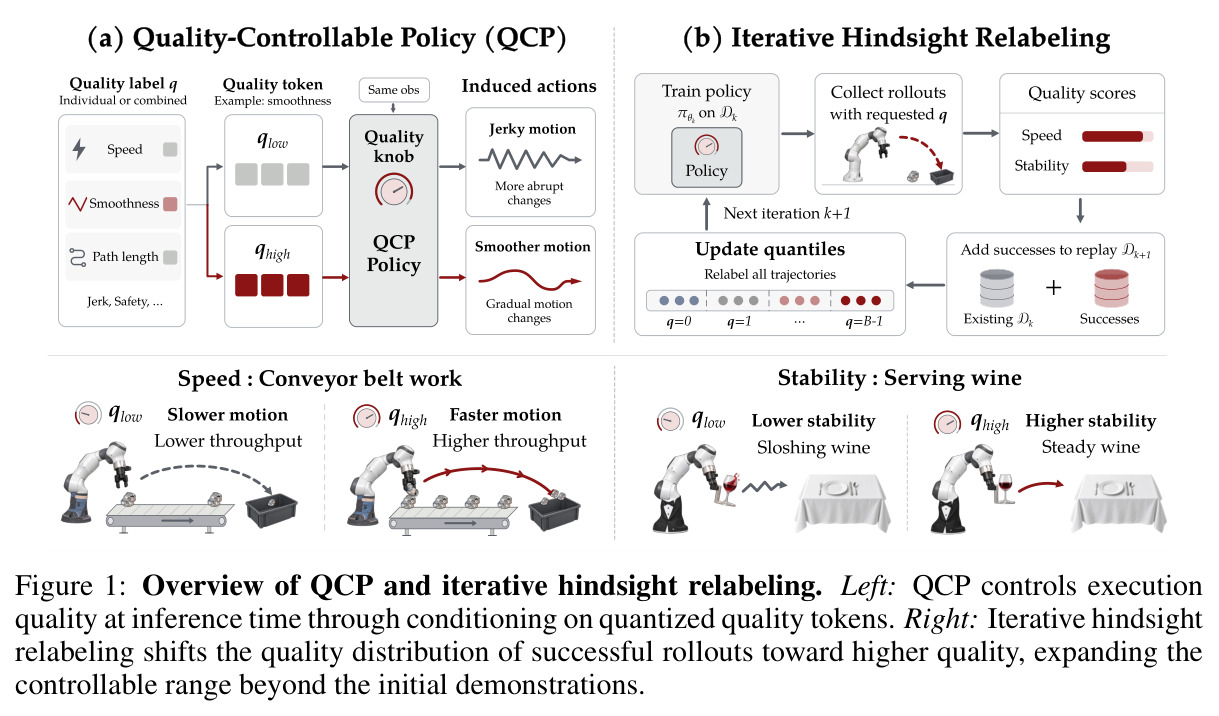
本文的目标是本文要同时做到两件事。第一,学习质量可控策略 QCP:把执行质量(速度、平滑度、效率、稳定性等)变成推理时可显式指定的条件输入,用户请求某个质量档位,策略就朝该档位的行为偏移,并且支持单属性和最多六个属性的组合控制。第二,不只停留在演示数据覆盖的质量范围内,而是通过在线 rollout 采集、事后重标注和策略更新的迭代循环,把可控质量范围持续扩展到初始演示之外,让'最高档'最终代表的绝对质量超过任何一条人类演示。整个过程用规则分数函数自动测量质量,无需人工质量标注或偏好比较,同时要求扩展质量的过程中任务成功率不下降,甚至同步提升。
与已有工作不同的是,本文的切入角度有三点独特之处。第一,对质量信号的处理方式:不同于 DSRL、EXPO 等方法把质量做成奖励交给在线 RL 优化——作者发现这些为流匹配策略设计的 RL 方法主要在消费成功信号,新加的质量奖励即使调高权重也消费不好——QCP 用纯监督的方式把实测质量作为条件标签,所有成功轨迹都参与训练。第二,范围扩展机制:借鉴文本生成中 Quark 的'按最高奖励采样-按实现值重标注-重训'循环,把奖励换成分位数质量标签应用于机器人执行质量,并用经验 CDF 在累积数据上重算所有桶边界,使'最高档'的含义随数据水涨船高,这是对事后经验回放思想从目标到质量维度的迁移。第三,坚持用轨迹级单一标签而非段级标签,避免局部质量分数与任务进度纠缠带来的训练信号污染。
核心方法
直觉上,与其让策略把所有成功执行方式平均成一锅粥,不如给每条轨迹打上'执行得怎么样'的标签,让策略学会'在指定的质量档位下完成任务';然后让策略自己去生成请求最高档的轨迹,把其中实际质量超出演示的部分按实测值重新标注后喂回训练集,于是'最高档'这个词指代的绝对质量逐轮上移,策略的能力边界随之向外推。技术路线分两块:其一,质量可控策略训练——用规则分数函数 $m(\tau)$(如速度取 $1/T$、平滑度取归一化动作 jerk、效率取关节路径长度)给每条成功轨迹测分,按经验 CDF 量化成 $B=4$ 个等频档位,训练以($L=2$ 步观测历史 $h_t$、质量标签 $q$)为条件的流匹配策略,输出 $H$ 步动作块;其二,迭代事后重标注——每轮用当前策略在最高档 $q^\star = 3$ 下采集 rollout,保留成功者并按实测质量重标注,重算全数据集的分位数边界后从头重训策略,重复 $K$ 轮,成功轨迹的质量分布因此逐轮向更高质量移动。
核心创新有二。第一是量化质量条件化对数据的完整利用:BCfilter、SORL 这类方法只保留与请求标签匹配的数据——Square 上 BCfilter 只留最好的 10%,丢弃 90% 成功轨迹导致成功率下降——而 QCP 让所有成功轨迹都带着各自的标签参与训练:低质量轨迹教'如何完成任务',标签只负责区分'怎么执行的',推理时请求最高档即可选出高质量行为,从而同时提高质量与成功率,打破风格-任务的权衡。第二是事后重标注带来的范围外推:请求最高档的 rollout 实际质量参差不齐(动作生成是随机的,且标签附着在每个动作块上,策略能把高质量演示中各阶段的动作重新组合成质量超过任何单条演示的轨迹),按实测质量贴标签使最高档边界逐轮上移,而旧演示保留低档覆盖、拓宽了可控范围。冻结策略对照实验证明,质量分布的移动确实来自这个循环,而非条件化架构本身。
方法步骤详情
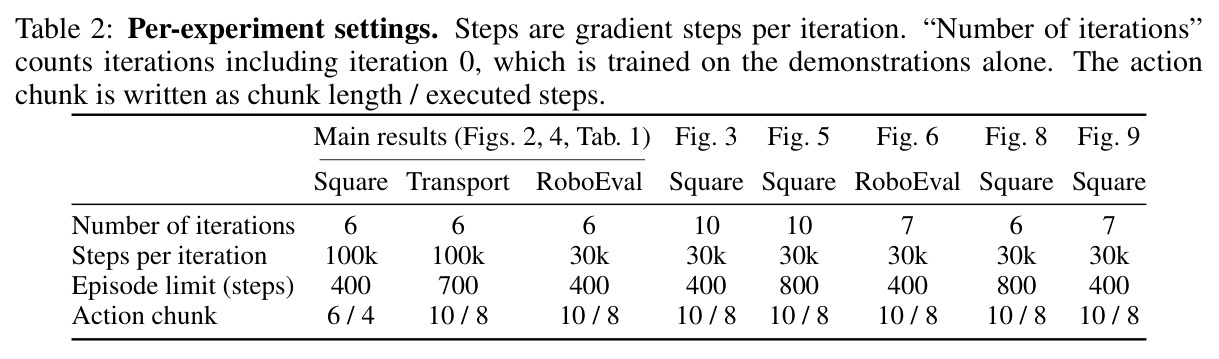
流程(Algorithm 1):(1)输入演示集 $D$、分数函数 $m$、桶数 $B=4$、轮数 $K=6$,按 $q(\tau)=B\hat{F}(m(\tau))-1$ 打标签。(2)训练 $\pi_{\theta_0}$:轨迹切片为样本 $(h_t,A_t,q)$($L=2$ 步观测历史、$H$ 步动作块),用流匹配损失 $\mathcal{L}_{\mathrm{FM}}=\mathbb{E}[\|v_\theta(A^u_t,u,h_t,q)-(A_t-\epsilon)\|^2]$ 训练;仿真用 3 层 512 宽 MLP(每轮 10 万/3 万步,batch 1024),真机用 $\pi_{0.5}$ 在语言提示中插入 'quality level: 3' 文本微调 10 epoch。(3)第 $k$ 轮采集:用 $\pi_{\theta_k}(\cdot|h_t,q^\star=3)$ 采 300 条 rollout,只保留成功者(作者试过纳入失败数据反而降低性能)。(4)按实测 $m(\tau)$ 给新轨迹标注,并入得 $D_{k+1}$。(5)在 $D_{k+1}$ 上重算经验 CDF 与所有轨迹的标签,桶边界整体上移。(6)从头重训 $\pi_{\theta_{k+1}}$(VLA 则从预训练检查点重训),因为重标注改变了标签语义,续训需先'遗忘'旧映射。如此循环 $K$ 轮。
技术新颖性
与最相关工作的本质区别:与 Quark(文本生成)相比,把'奖励分位数 token'换成规则分数函数测得的执行质量标签,全程无人工比较(对比 FPL 每轮都需要人工偏好标注);与 HER 相比,重标注的对象从'达到的目标'变为'达到的质量',且每次重算全局经验 CDF、移动所有桶边界,而非只改单条轨迹的标签;与 SORL/SCIQL 相比,完全不用优势加权,绕开了离线 RL 中的风格-任务权衡项;与 DSRL/EXPO 相比,不给 RL 喂质量奖励而是监督式条件化。架构层面还有三个新颖点:其一,轨迹级单一标签——Appendix G 证明它优于段级标签,因为段级分数与任务阶段(接近、插入等)纠缠,策略可以刷高局部分数却不推进任务;其二,每轮从头重训以应对标签语义漂移,顺带规避深度 RL 中的可塑性丧失与首因偏差;其三,对 VLA 无需改架构,把质量档位写成文本插入语言提示即可,与 $\pi_{0.7}$ 的可引导思路一致。
实验结果
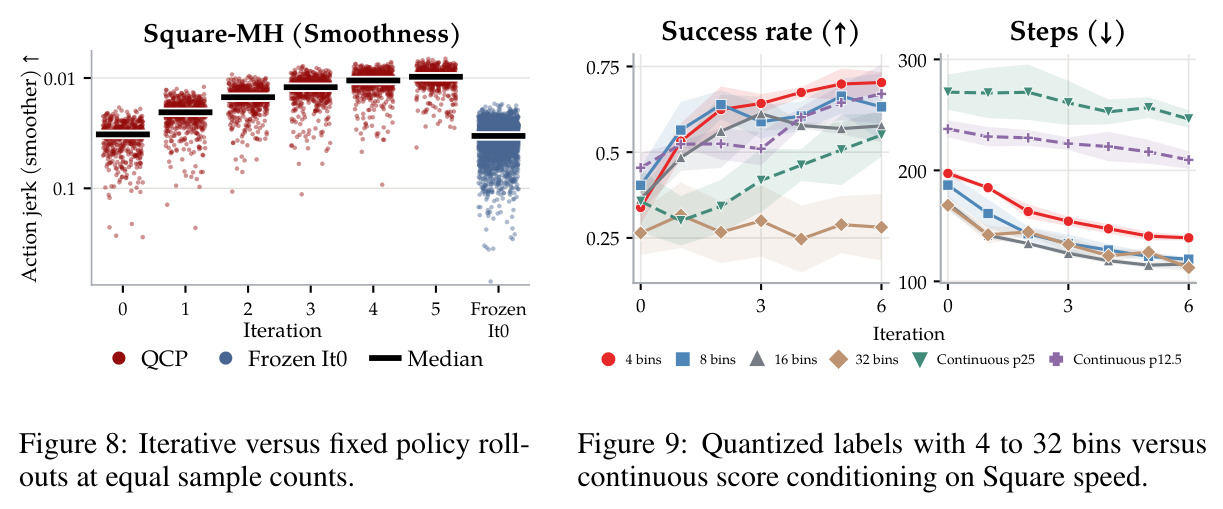
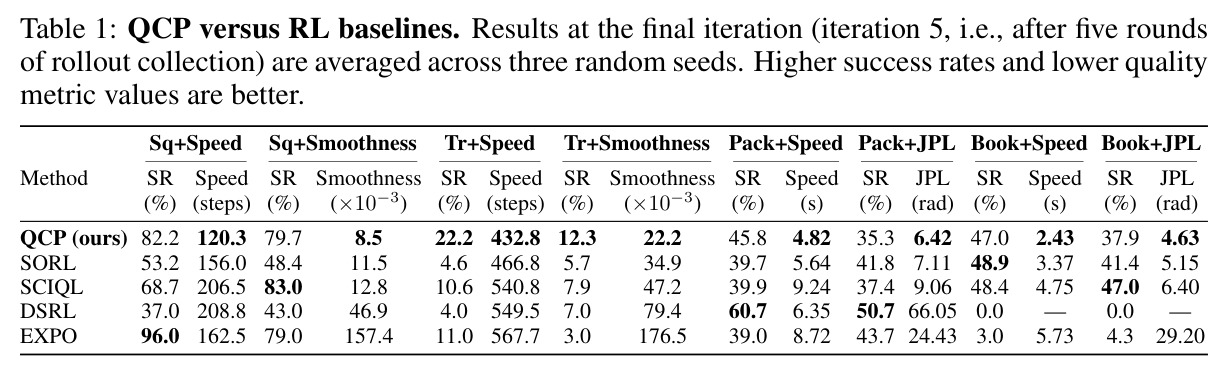
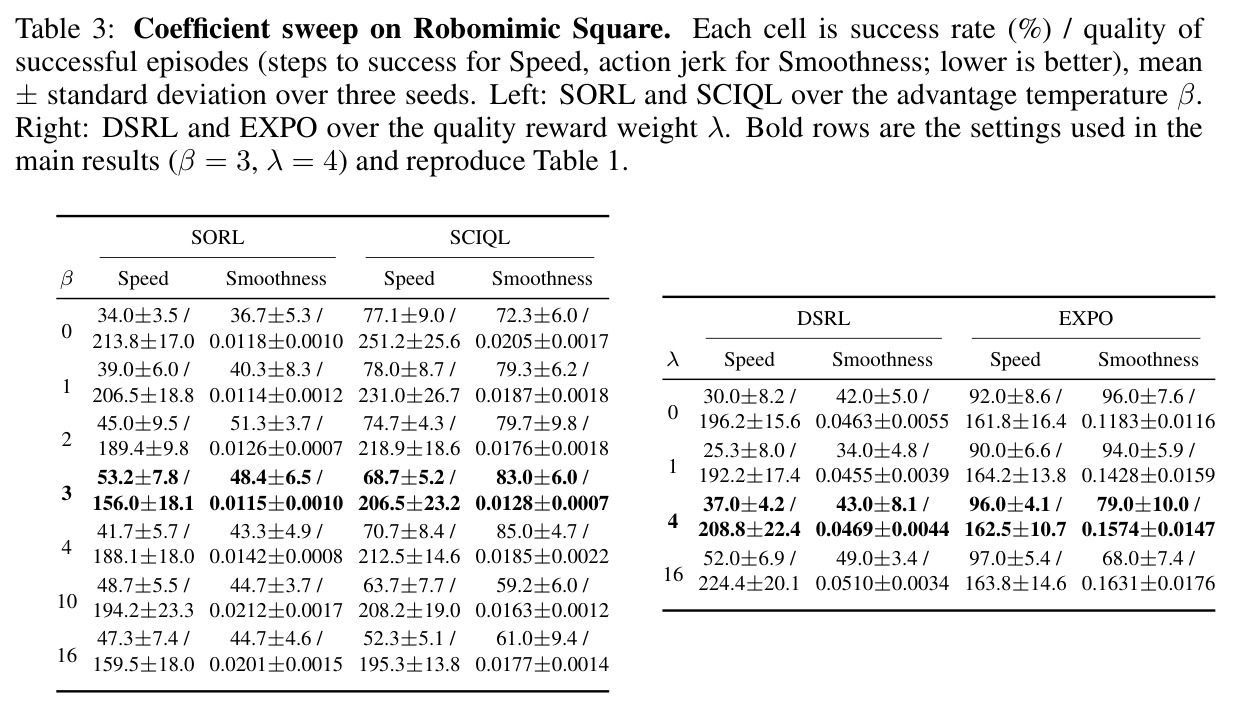
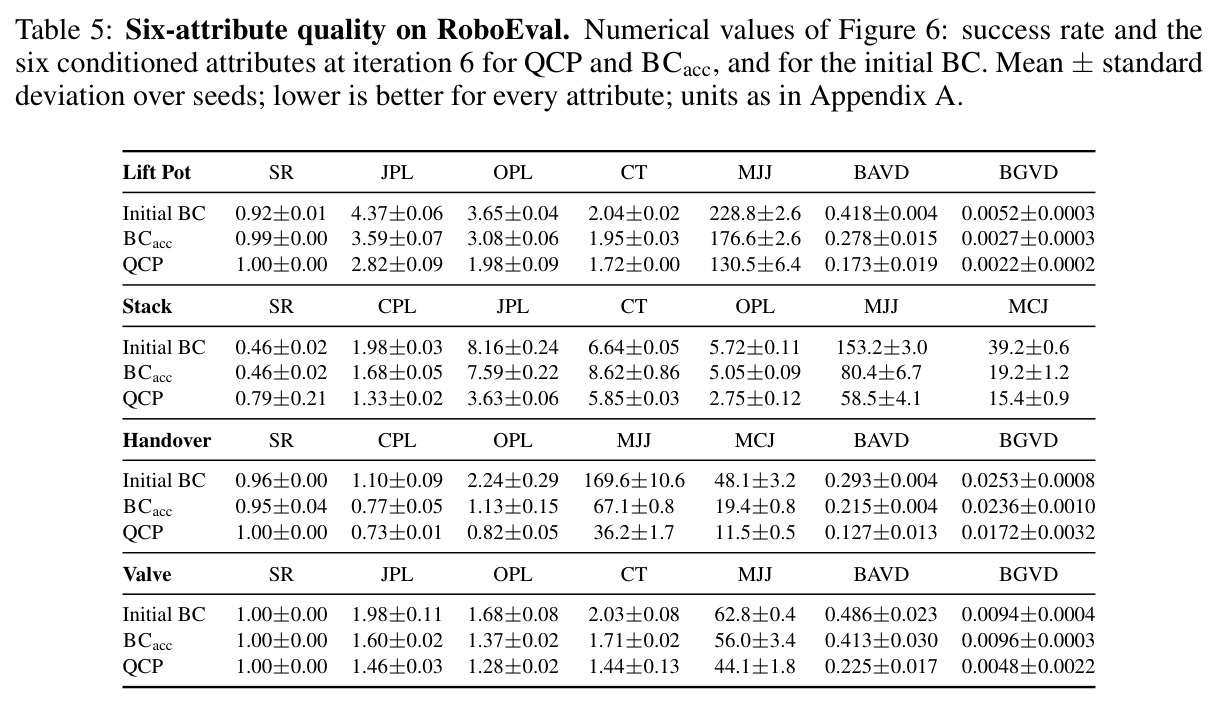
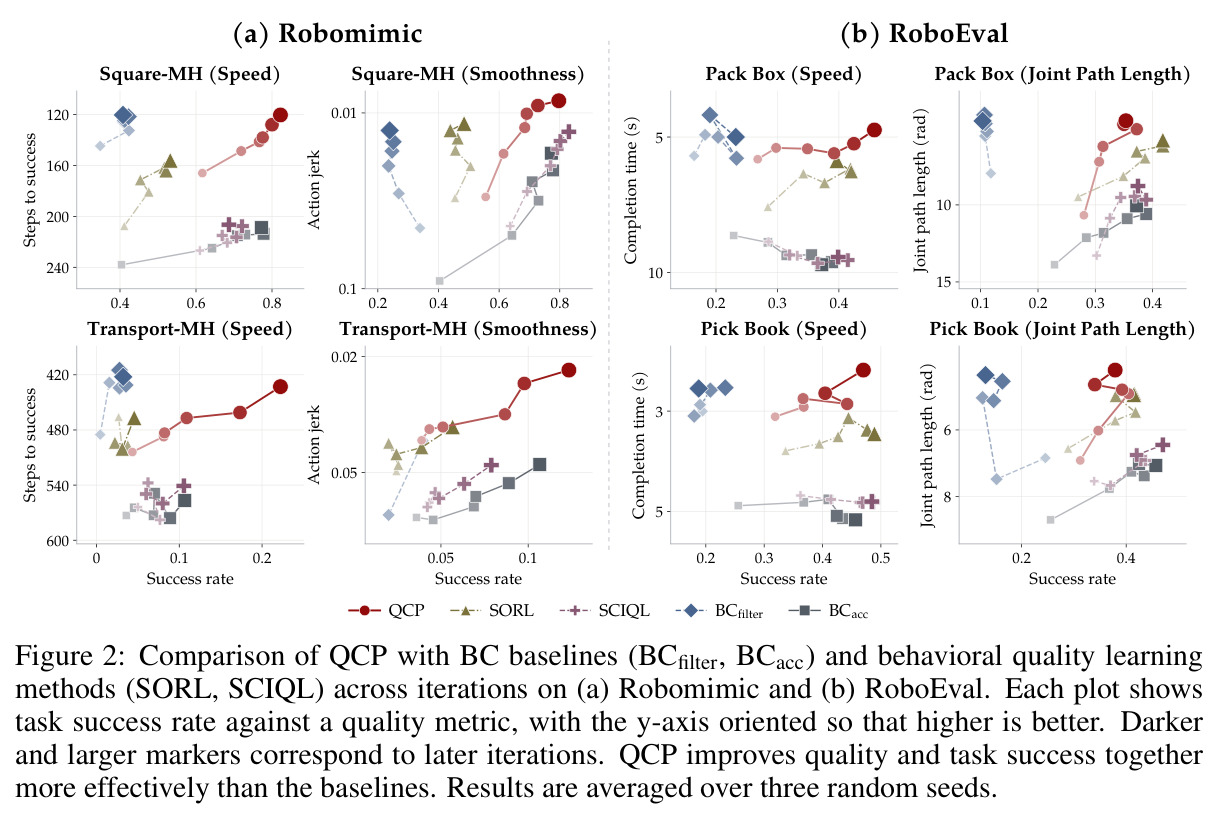
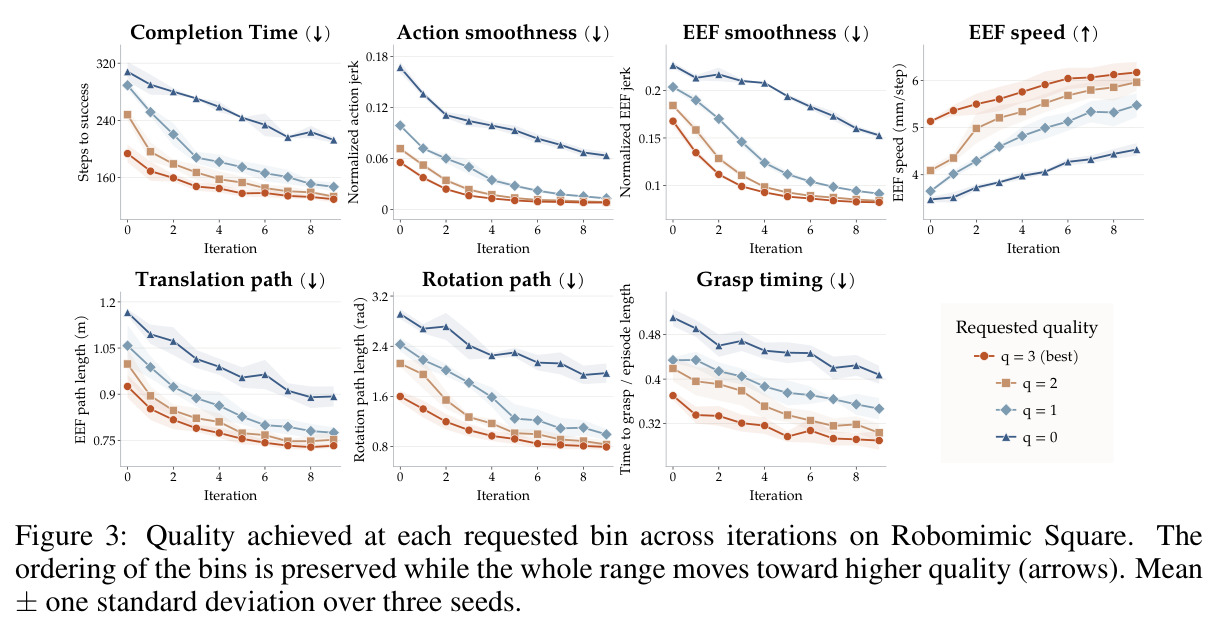
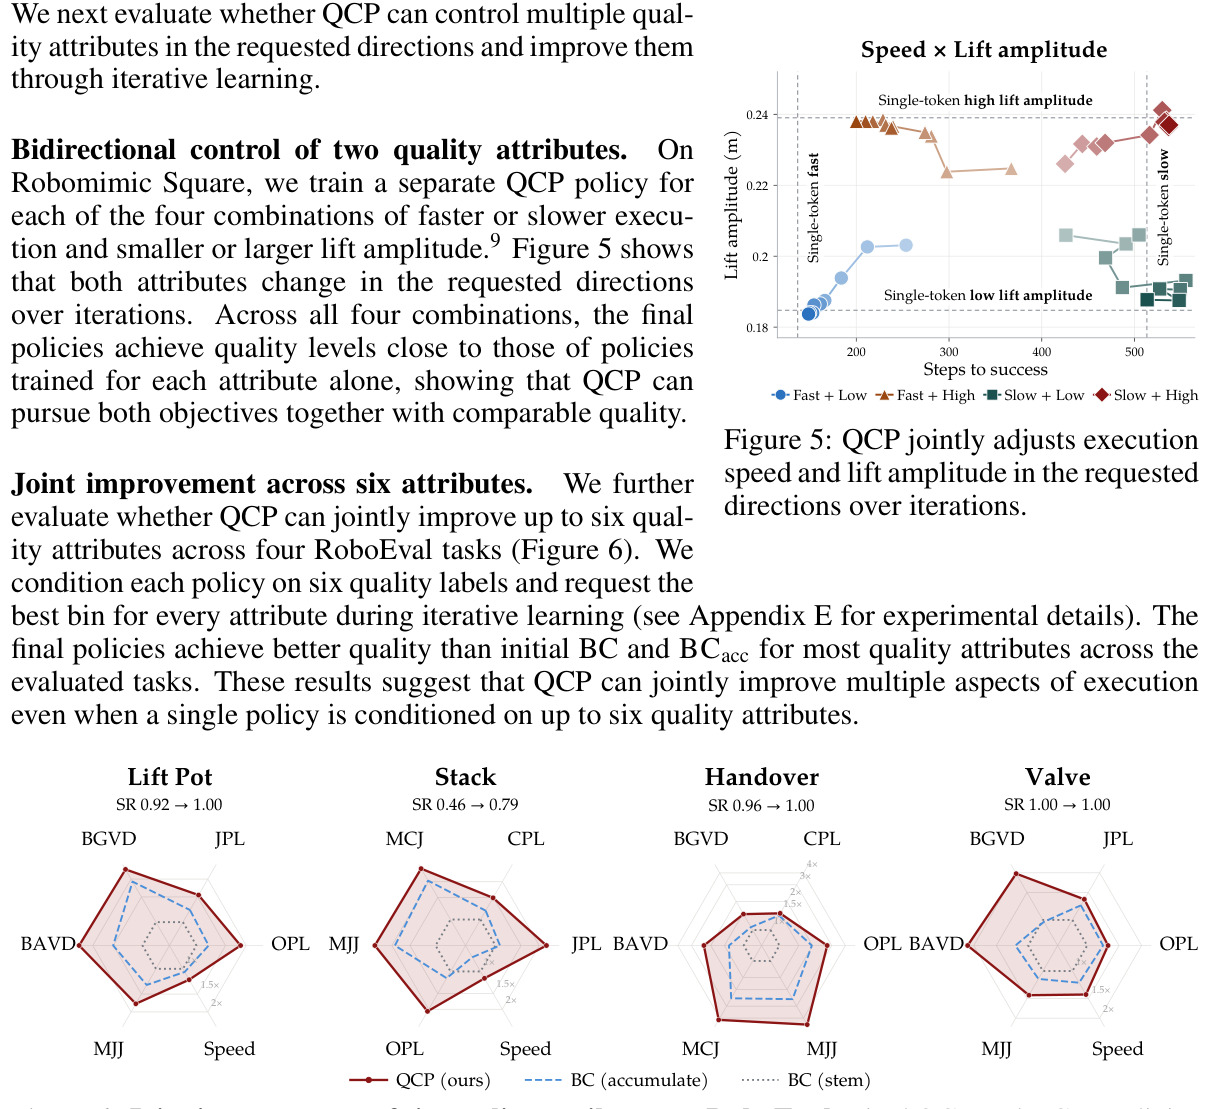
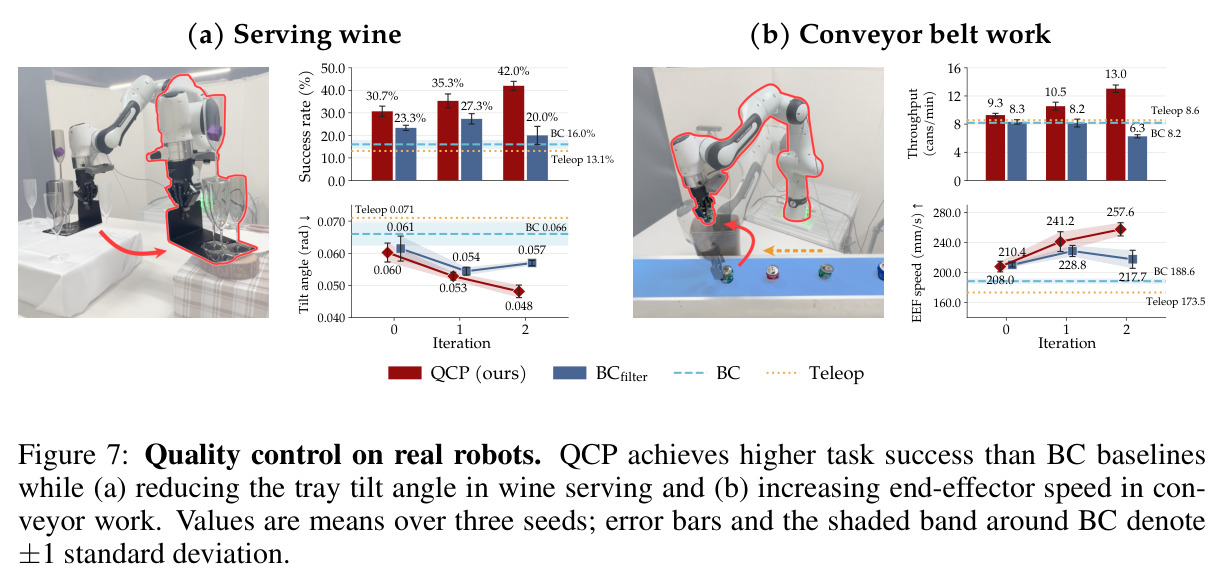
(1)质量与成功率协同提升(Fig.2/Table 1):迭代 5 时 QCP 在 Square-Speed 达 82.2% 成功率、120.3 步,SORL 53.2%/156.0,SCIQL 68.7%/206.5,DSRL 37.0%/208.8;EXPO 成功率 96.0% 但平滑度 jerk 157.4(QCP 8.5,$\times10^{-3}$)劣化约 18.5 倍。(2)档位可控(Fig.3):迭代 0 请求 Square 最高档平均 193.7 步、最低档 308.1 步,中间档居中,且排序在所有属性、所有迭代保持。(3)分布外扩(Fig.4):Wasserstein-1 距离按演示 IQR 归一后达平滑度 1.582、关节路径长 1.594、速度 1.017。(4)多属性(Fig.5/6):速度×提升幅度四组合逼近单属性基线;六属性下 Lift Pot 成功率 0.92→1.00、Stack 0.46→0.79、Handover 0.96→1.00,JPL 4.37→2.82 rad。(5)真机(Fig.7):端酒杯遥操作 382 次仅 50 次(13.1%)成功,QCP 倾角 0.0660→0.0482 rad(-27.0%)、成功率 30.7%→42.0%;传送带速度 188.6→257.6 mm/s(+36.6%)、吞吐 8.2→13.0 罐/分(+59.3%),超人类遥操作 173.5 mm/s,BCfilter 吞吐反从 8.3 跌至 6.3。(6)消融:冻结策略 1800 条 rollout 最平滑 jerk 0.0171 仍高于迭代 5 分布的 75 分位(中位 0.0098),证明增益来自循环(Fig.8);4 桶 70.3%@139 步优于连续条件 55.0%@246(Fig.9);轨迹级标签 84.3% 成功率优于段级 48.0%(Fig.10)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Robomimic Square 速度(迭代 5) | 成功率 / 步数(越低越好) | QCP:82.2% / 120.3 步 | SORL 53.2% / 156.0 步;SCIQL 68.7% / 206.5 步;DSRL 37.0% / 208.8 步 | 成功率较最强离线 RL 基线 SCIQL 高 13.5 个百分点,速度快 86.2 步 |
| Robomimic Square 平滑度(迭代 5) | 成功率 / 归一化动作 jerk(×10⁻³,越低越好) | QCP:79.7% / 8.5 | SORL 48.4% / 11.5;EXPO 79.0% / 157.4 | 较 SORL 成功率 +31.3 个百分点且 jerk 降低约 26%;较 EXPO(同成功率)jerk 降低约 18.5 倍 |
| RoboEval Pack Box 速度(迭代 5) | 成功率 / 完成时间(s) | QCP:45.8% / 4.82 | SCIQL 39.9% / 9.24;DSRL 60.7% / 6.35 | 较 SCIQL 成功率 +5.9 个百分点、完成时间缩短 47.8%;较 DSRL 虽成功率低但更快 |
| 真机·托盘端酒杯 | 平均倾角(rad)/ 成功率 | QCP:0.0482 / 42.0% | BC 0.0660 / 30.7%;人类遥操作采集成功率仅 13.1% | 倾角降低 27.0%,成功率 +11.3 个百分点,远超遥操作的 13.1% |
| 真机·传送带抓取 | EEF 速度 / 吞吐量(罐每分) | QCP:257.6 mm/s / 13.0 | BC 188.6 mm/s / 8.2;BCfilter 迭代 2 时 217.7 mm/s / 6.3;人类遥操作 173.5 mm/s | 较 BC 速度 +36.6%、吞吐 +59.3%,超过人类遥操作速度 |
| Robomimic Square 速度·质量表示消融(迭代 6) | 成功率 / 步数 | 4 桶等频量化:70.3% / 139 步 | 连续分数条件(p25):55.0% / 246 步;32 桶:28.1% / 112 步 | 较连续条件成功率 +15.3 个百分点、步数缩短约 43% |
局限与改进
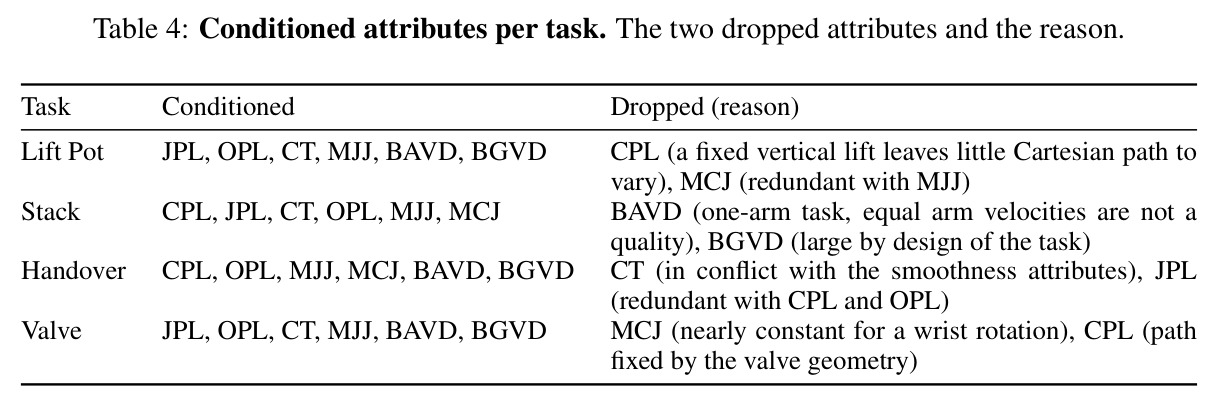
作者承认或实验中显见的局限:(1)依赖人工设计的规则分数函数,每个属性都要手写定义(Appendix A 列了十余个),遇到'优雅''灵巧'等难以规则化的属性就失效;(2)循环只保留成功 rollout——作者尝试纳入失败数据反而降低性能——因此对高难度任务样本浪费严重,Transport-Speed 迭代 5 成功率仅 22.2%,Pick Book 上 DSRL/EXPO 甚至为 0%;(3)新数据全部来自最高档,低档位行为只靠旧演示支撑,长期循环下低档质量是否退化、可控范围的下端是否稳固未经验证;(4)多属性实验需要预先剔除冲突属性(Table 4 中每个任务丢 2 个),说明属性间冲突仍需人工干预,六属性已是当前上限;(5)每轮从头重训在真机 VLA 上意味着每轮都要微调 $\pi_{0.5}$ 十个 epoch,迭代成本高;(6)我的观察:六属性实验方差很大(Stack 成功率 0.79±0.21),真机数据集小(酒杯仅 50 条成功演示),稳定性存疑;且质量外扩的度量(W1/IQR)只反映边缘分布移动,未验证轨迹多样性、安全性以及质量-成功率帕累托前沿的形状。
独立分析的弱点
独立分析的弱点及改进方向:(1)分数函数工程负担:每换一个任务或属性都要重新设计并验证 $m(\tau)$,以 $1/T$ 近似速度这类规则也未必反映真实人类偏好;改进方向是引入学习型奖励/评判模型(如 FPL 的偏好学习或 VLM 打分),但需解决其噪声与标注漂移问题。(2)采集策略单一:每轮只请求最高档,数据分布持续向高端集中,等频桶可能被少量超高质量轨迹拉伸导致标签语义失真;改进方向是混合档位采样或对桶宽施加正则。(3)丢弃失败数据:失败轨迹包含大量'何为低质量'的对比信息,却完全被扔掉;改进方向是把失败数据作为负样本训练质量判别器,或用约束机制安全地利用失败经验。(4)质量与成功耦合的假设:方法要求质量可测且成功可明确判定,对两者纠缠的任务失效(段级标签实验已暴露该问题);改进方向是学习解耦'执行质量'与'任务进度'的表示。(5)安全与物理极限未建模:'最快'未必安全,真机高速策略没有力/碰撞约束;改进方向是叠加安全层或约束 RL,使高速度档位与稳定性之间可显式权衡。
未来方向
作者明确提出的方向:更精细的质量信号(段级、连续分数)需要能将执行质量与任务进度解耦的方法(Appendix G 留作未来工作)。基于本文成果可延伸的方向:其一,把规则分数函数替换为学习型偏好模型,实现'用自然语言描述想要的质量',与 $\pi_{0.7}$ 这类可引导基础模型自然衔接;其二,理论层面分析迭代重标注循环的收敛性与分布移动速率,目前只有经验证据(W1/IQR 超过 1.5);其三,把循环扩展到多任务、多场景的机器人基础模型,让单个模型跨任务可控质量并研究任务间的质量迁移;其四,引入安全约束与硬件限制建模,在最高速度档与稳定性之间做显式帕累托权衡并可视化前沿;其五,探索用户端交互式质量选择界面,让非专家按需指定执行风格;其六,迁移到移动操作、双臂长程装配等更复杂场景,检验六属性以上联合控制的极限与冲突自动消解机制。
复现评估
复现评估:论文有项目页(https://sinnnj.github.io/qcp)提供视频与方法概览,但正文中未见明确的代码开源声明,复现需自行实现。数据门槛低:Robomimic Multi-Human 与 RoboEval 演示集均为公开数据集,全部分数函数在 Appendix A 有完整数学定义。仿真算力很温和:策略只是 3 层 512 宽的 MLP,每轮 10 万(Robomimic)或 3 万(RoboEval)梯度步、batch 1024,6 轮迭代每轮 300 条 rollout,单卡即可完成单任务配置,但完整主实验含 6 个任务 × 3 种子 × 6 个基线,总量不小。真机部分门槛高:需要 Franka Research 3 与 DROID 硬件平台、$\pi_{0.5}$ 预训练权重与多卡微调算力(每轮 10 epoch、batch 32),且遥操作数据采集成本大——酒杯任务 382 次尝试只得 50 条成功演示,传送带 936 段只得 400 段。总体:仿真复现难度中等($B=4$、每轮重算分位数、从头重训等关键细节交代清楚),真机复现难度高。
论文图表
从初始演示分布出发,It0-It5 各轮成功 rollout 的质量分布逐轮向更高质量移动(箭头方向),平滑度、关节路径长、速度三属性的 Wasserstein-1 距离除以演示 IQR 分别达 1.582、1.594、1.017,分布明显超出初始演示范围。
论文核心主张'突破演示质量上限'的最直接证据,用分布距离量化了质量外推的幅度。
四个 RoboEval 任务(Lift Pot/Stack/Handover/Valve)上的六轴雷达图:每轴为初始 BC 分数除以该方法分数(向外更好),初始 BC 落在 1× 环上;最终 QCP 在绝大多数属性上超过 BCacc 与初始 BC,成功率标注于上方(如 Stack 0.46→0.79、Lift Pot 与 Handover 达 1.00)。
证明单一策略可同时条件化并最多改进六个质量属性,是方法扩展性与'打破质量-任务权衡'的关键证据。
在 Square 速度属性上对比 4/8/16/32 个等频桶与两个连续分数条件变体(同一循环协议):迭代 6 时四桶达 70.3% 成功率@139 步,八桶 63.2%@120,十六桶 57.7%@116,三十二桶骤降至 28.1%@112;连续 p25 与 p12.5 分别为 55.0%@246 和 67.0%@209。
支撑'为何用等频量化而非连续分数'的核心设计决策:桶多速度略快但成功率锐减,四桶在速度与成功率间取得最佳平衡。
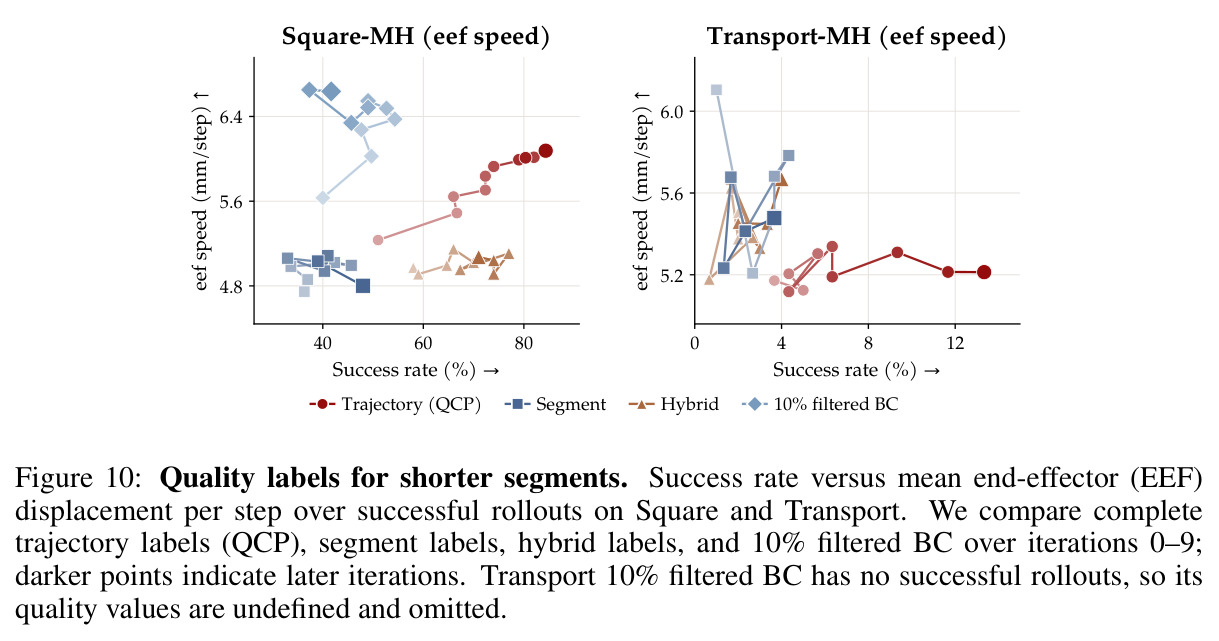
对比轨迹级标签(QCP 主方案)、段级标签(每步 ±8 窗口打分、按时段归一)、混合标签与 10% 过滤 BC 在 EEF 速度属性上跨 10 轮迭代的成功率-质量曲线:Square 迭代 9 轨迹级 84.3% 成功率@6.08 mm/步,段级仅 48.0%@4.80,混合 71.0%@5.07;Transport 轨迹级 13.3% 对段级 3.7%、混合 4.0%。
揭示段级质量信号与任务阶段纠缠、策略可刷局部分数却不推进任务的问题,直接标示了方法的适用边界与未来工作方向。