按需看图:证书引导的视觉路由加速扩散视觉语言模型 Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
免训练的预测一致性证书决定每步是否读图:0.35×FLOPs保住99.6%分数
前置知识
掩码扩散语言模型
与自回归模型逐 token 生成不同,掩码扩散语言模型从全掩码序列出发,通过 $T$ 个去噪步迭代恢复内容。每步模型对剩余掩码位置并行给出预测与置信度,解掩码固定数量 $k$ 个 token,直至全部揭示。代表工作 LLaDA 表明该范式可匹配同规模自回归模型。
LOWN 的全部设计建立在这种「每步并行预测 + 逐步解掩码」的结构上,理解它才能明白图像为何被反复处理。
扩散视觉语言模型(DVLM)
在扩散语言模型上外挂视觉编码器,把图像经 projector 转成视觉 token,与 prompt、响应序列拼接后统一处理。因双向注意力,自回归式精确 KV 缓存不可用,标准推理每个去噪步都要对整个多模态序列做完整前向,视觉 token 因此被反复计算。
论文针对的正是 DVLM 每步重复处理视觉 token 的算力浪费,这是全文问题的载体。
视觉 token 剪枝
在解码前或解码中删掉部分视觉 token 以缩短序列、降低单次前向成本:RedVTP 用掩码响应 token 的注意力选 token,ZOO-Prune 结合 projector 敏感度与多样性选择,D3ToM 用已解码 token 指导选择与合并。代价是被删信息永久丢失。
剪枝是 LOWN 的主要对比基线且与之正交:「每次前向处理多少」与「多少步前向处理」构成全文的核心对比轴。
KV 缓存与 Fast-dLLM
自回归模型缓存历史 token 的 key/value 张量避免重复计算;但双向注意力下每个位置依赖后续 token,只能用 Fast-dLLM 这类分块近似缓存,按块选择性更新并可能引入误差。
理解 KV 缓存在 DVLM 中受限的原因,才能看懂 LOWN 的成本模型与缓存组合实验的动机。
置信度引导解掩码
基线 LLaDA-V 每步解掩码置信度最高的 $k$ 个位置($k$ = 响应长度/$T$),即以模型自报的确定性排序控制生成节奏;KLASS 等调度进一步结合跨步分布稳定性等信号,但需逐基准调阈值。
LOWN 把这一调度改造成「证书筛选 + 整段接受」,是理解方法一步的关键前置。
研究动机
扩散视觉语言模型(DVLM,如 LLaDA-V)采用双向注意力,无法像自回归模型那样使用精确 KV 缓存,因此标准推理必须在每个去噪步骤对完整的「视觉 token + prompt + 部分掩码响应」序列做一次 FULL 前向。论文统计了十个基准的输入构成:视觉 token 占比高达 89–97%,而一次不含视觉 token 的前向只需 3–10% 的成本——解码算力的绝大部分花在反复处理一张不变的图像上。现有加速手段各有盲区:视觉 token 剪枝(RedVTP、ZOO-Prune、D3ToM)减少每次前向处理的图像 token,但删掉的信息永久丢失,剩余图像仍每步被处理;中间状态缓存与 Fast-dLLM 式 KV 缓存复用计算但依赖近似;KLASS、Prophet 等多 token 解掩码调度减少步数却需逐基准调阈值。这些方法都没有回答一个更基本的问题:当前这一步到底需不需要图像?
本文的目标是本文的目标是在完全不训练、不调任何任务阈值、不改变模型参数与注意力结构的前提下,让 DVLM 在每个去噪步骤自适应地决定是否处理视觉 token,同时顺带决定该步解掩码多少 token,从而大幅压低解码 FLOPs 而几乎不损失质量。量化目标:在覆盖多选题、文档与图表理解、数学推理、开放描述的十个基准(MathVista、ScienceQA、ChartQA、MME、MMBench、DocVQA、GQA、LLaVA-Bench、CapArena、DeCapBench)上保持 LLaDA-V 分数的 99% 以上,并把解码 FLOPs 压到 0.4× 以下;方法需免训练免阈值、可迁移到 LaViDa 与 VidLaDA 等其他骨干,并可与视觉 token 剪枝和 KV 缓存正交叠加。最终实测:0.353× FLOPs 保住 99.6% 分数,叠加 RedVTP 后达 0.223× 保住 98.3%。
与已有工作不同的是,切入角度来自一个被此前工作忽视的实证观察。作者沿 LLaDA-V 的标准解码轨迹,逐步、逐位置地配对比较「带图前向」(FULL)与「去图前向」(TEXT-ONLY):被解掩码的位置上 83.4% 两者 top-1 预测一致;85.0% 的最终 token 在被解掩码之前就已作为 top-1 预测出现过;图像真正改变解掩码决策的步骤平均只占 22.8%(MMBench 低至 7.9%,DocVQA 高达 43.8%),且这些步骤倾向于聚集在解码早期而非周期性出现。这意味着「何时读图」必须按输入与步骤自适应决定,任何固定时间表都天然失配。更妙的是,暴露这种冗余的 TEXT-ONLY 前向只花 FULL 前向 3–10% 的成本,天然是每步都跑得起的检测器。把两个前向预测的一致性转化为「证书」,用它同时决定读图时机与解掩码数量——这是剪枝、缓存、调度三条已有路线都没触及的信号。
核心方法
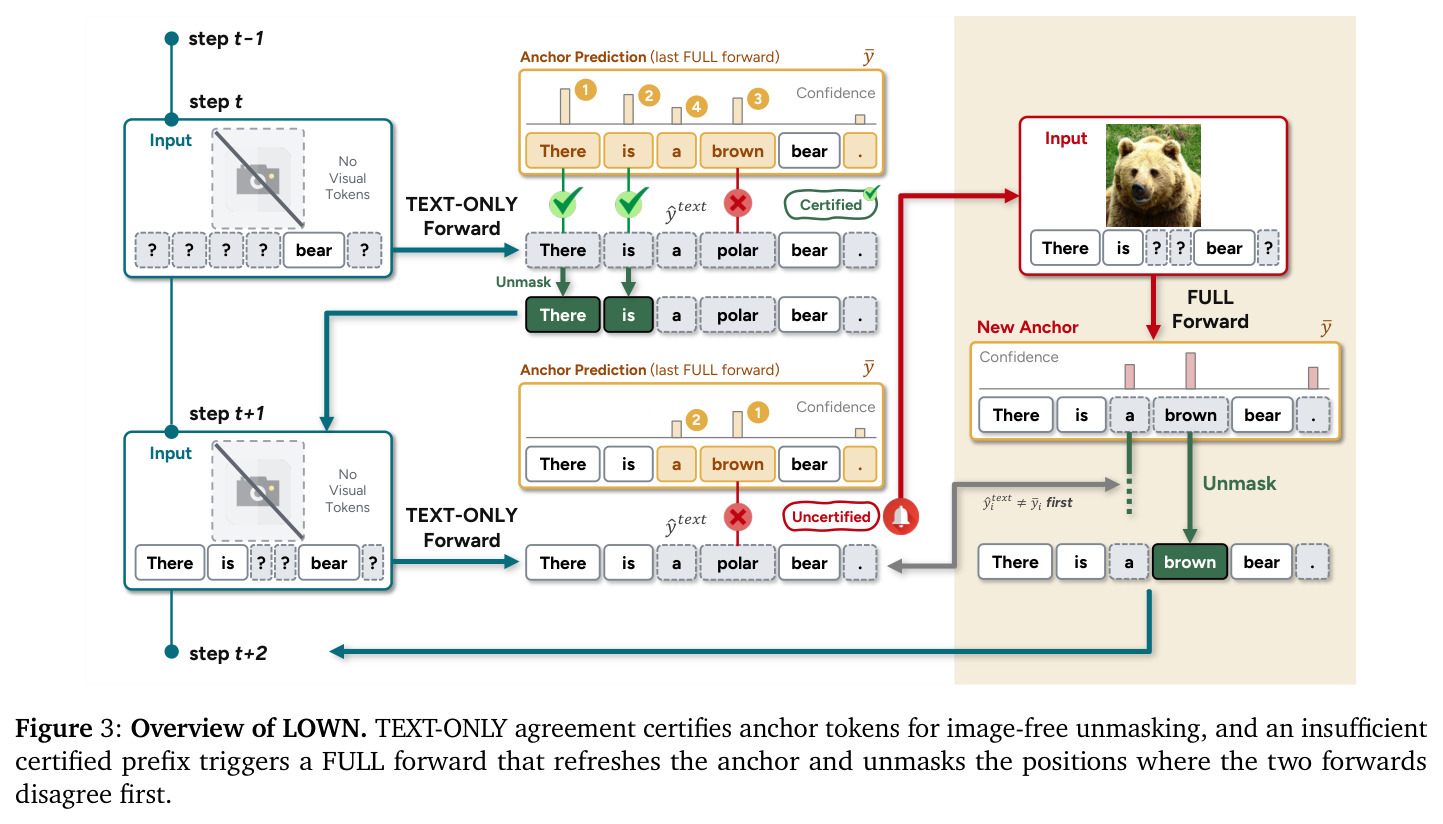
直觉上,LOWN 像一个「偷懒但有担保」的读者:它把上次带图阅读得出的答案记在便签上(锚点 anchor),之后每步先合上书作答——即只对文本跑一次 TEXT-ONLY 前向(成本仅为 FULL 前向的 3–10%);凡是与便签一致的答案就盖上「合格」戳,从置信度最高的位置开始扫描,遇到第一个不一致就停止。如果合格答案足够多(不少于基线每步解掩码数 $k$),这一步完全不读图,并把整段合格答案一次性解掩码——这允许一步超过 $k$ 个 token;如果不够,才重新「翻开书」跑一次 FULL 前向,刷新便签并优先解掩码「带图与不带图答案不同」的位置。技术路线:FULL 前向时保存剩余掩码位置的 top-1 预测 $\bar{y}$ 与置信度 $\bar{s}$;每步 TEXT-ONLY 前向后按 $\bar{s}$ 降序扫描,$\hat{y}^{text}_{t,i} = \bar{y}_i$ 即认证通过,取最长认证前缀 $\mathcal{U}_{text}$;$|\mathcal{U}_{text}| \geq k$ 走免图分支,否则走 FULL 分支。总成本满足 $R = f + \sigma\rho$:$f = n_F/T$ 为 FULL 前向频率,$\sigma = n_T/T$ 为相对步数,$\rho = \mathcal{C}(N_T)/\mathcal{C}(N_F)$ 为 TEXT-ONLY 前向单位成本。
核心创新是把「TEXT-ONLY 与上次 FULL 前向预测是否一致」变成一个免训练、免阈值的证书机制,用一个信号同时回答两个问题:这一步要不要读图、能解掩码多少 token。与已有方法的本质区别在操作对象:剪枝决定「每次前向处理哪些视觉 token」,缓存决定「前向之间复用哪些状态」,解掩码调度决定「每步解几个 token」,三者都以「图像每步必被处理」为前提;LOWN 直接质疑这个前提,用一致性测试把 FULL 前向次数从 $T$ 次压到少数几次。一致性一次近似了两件事:该 token 当前不需要图像,且旧锚点在响应状态变化后仍然有效——因此无需绝对置信度阈值(对比 KLASS 需逐基准调阈值)。认证按锚点置信度降序扫描、首个不一致处截断,使接受长度由当前输入与步骤动态决定而非常数。安全性有实测背书:新鲜 FULL 前向对一 step 旧锚点认证 token 的推翻率仅 4.1–11.0%,LOWN 自身轨迹上为 2.2–4.7%。
方法步骤详情
完整流程分三步。(1)建立锚点:每当 LOWN 运行 FULL 前向(输入为视觉 token $v$、prompt $c$、部分掩码响应 $x_t$),对所有掩码位置 $i \in M_t$ 记录 top-1 预测 $\bar{y}_i$ 与置信度 $\bar{s}_i = \max_w p_\theta(y_i = w \mid v, c, x_t)$,构成锚点;图像视觉嵌入只编码一次,各 FULL 前向复用。(2)每步证书检查:运行 TEXT-ONLY 前向 $p_\theta(\cdot \mid c, x_t)$——移除视觉嵌入但保留原位置 ID;按 $\bar{s}$ 降序扫描掩码位置,凡当前预测与锚点一致($\hat{y}^{text}_{t,i} = \bar{y}_i$)即认证通过(附重复防护检查,见附录 B.1),取最长认证前缀 $\mathcal{U}_{text}$。(3)状态更新:若 $|\mathcal{U}_{text}| \geq k$($k$ 为响应长度除以步数 $T$,即基线每步解掩码数),跳过 FULL 前向,把整个前缀按锚点预测一次性解掩码,允许一步超过 $k$ 个;若 $|\mathcal{U}_{text}| < k$,运行 FULL 前向刷新锚点,并按「分歧优先」解掩码 $k$ 个位置——TEXT-ONLY 与 FULL 预测不同的位置排最前,其余按 FULL 置信度排序。两分支每步至少解 $k$ 个 token,保证总步数不超过基线的 $T$。
技术新颖性
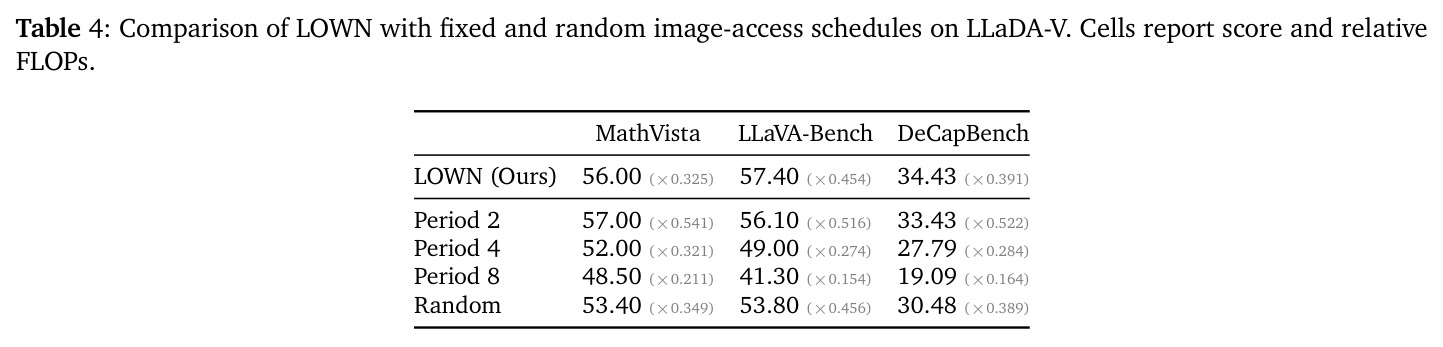
新颖性有三点。第一,问题重构:首次把 DVLM 推理效率的优化对象从「每次前向多便宜」(剪枝、缓存)与「跑多少步」(解掩码调度)转向「多少次前向需要图像」,并用配对 FULL/TEXT-ONLY 前向的逐步逐位置大规模测量给出实证——图像依赖步骤占比从 7.9%(MMBench)到 43.8%(DocVQA)不等且聚于早期,这是文献中此前缺失的量化证据。第二,机制设计:证书复用模型自身输出作验证信号,不引入训练、外部分类器或阈值超参;锚点随每次 FULL 前向整体刷新,保证证书总是对着最近一次带图预测校验,控制陈旧化误差。第三,可组合性:LOWN 只减少 FULL 前向次数,与降低单次前向成本的剪枝(成本因子 $\pi$)、KV 缓存正交,组合成本 $R = \pi f + \sigma\rho$ 清晰刻画叠加收益。消融显示其读图时机比匹配次数的随机时间表质量高 4.9–13.0%,比固定周期更稳。
实验结果
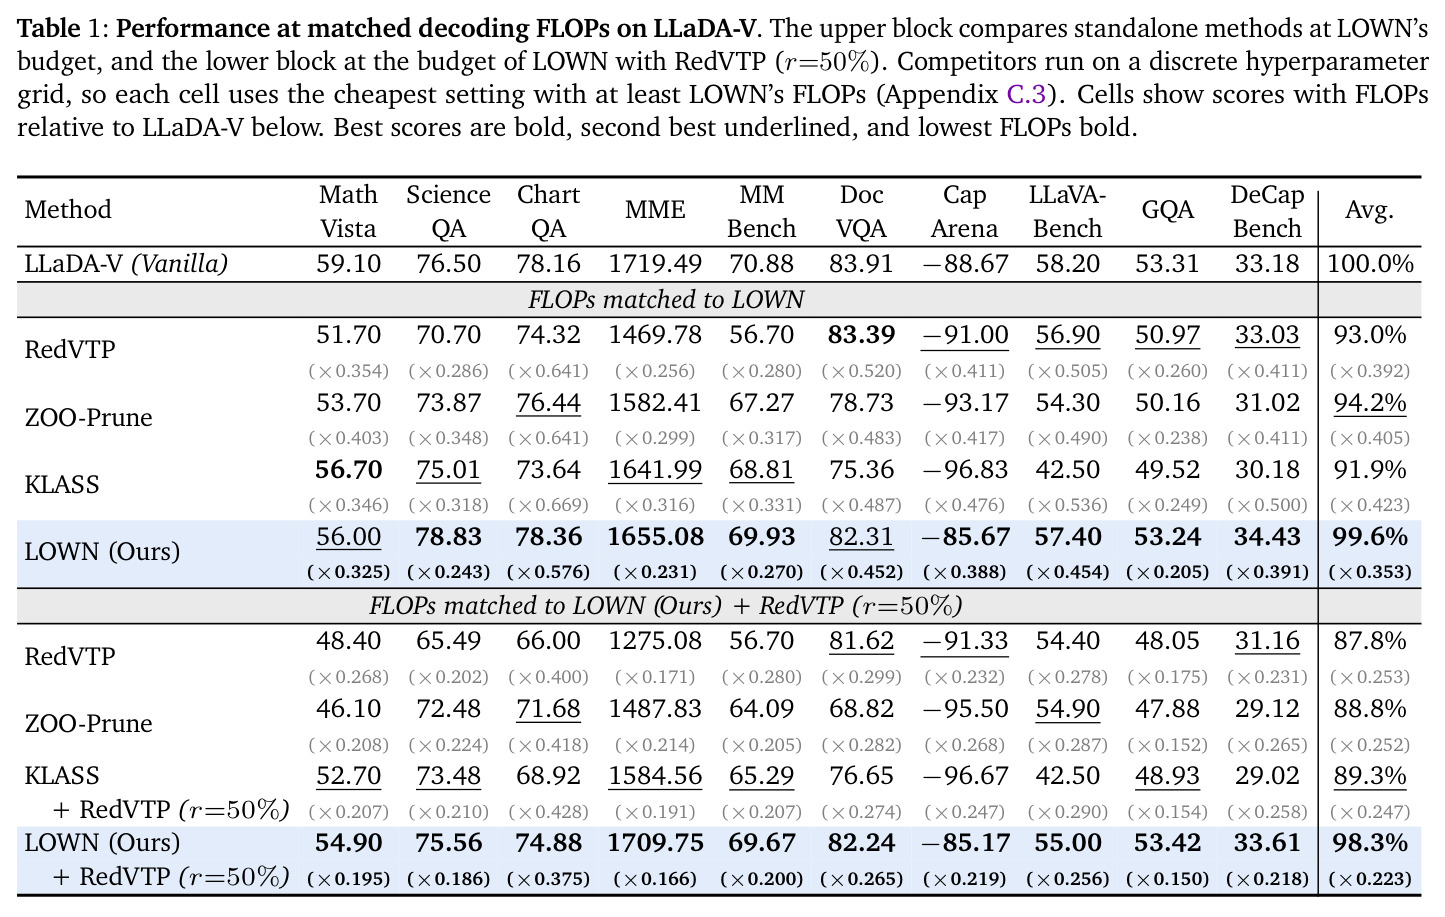
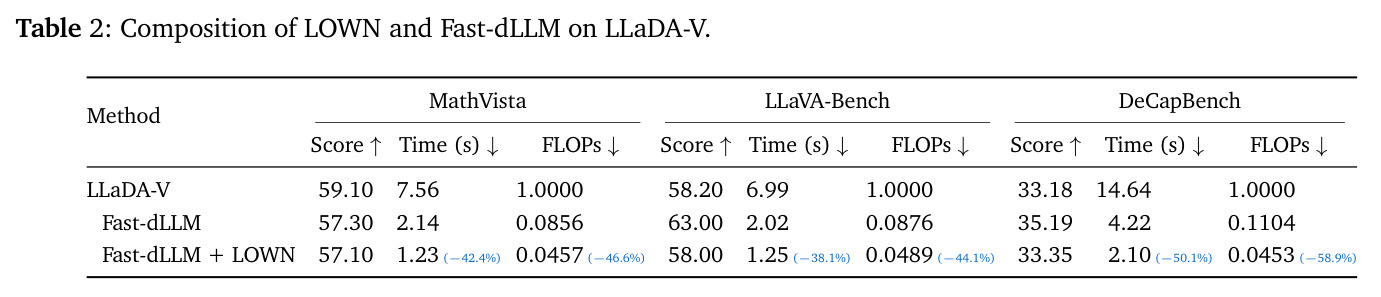
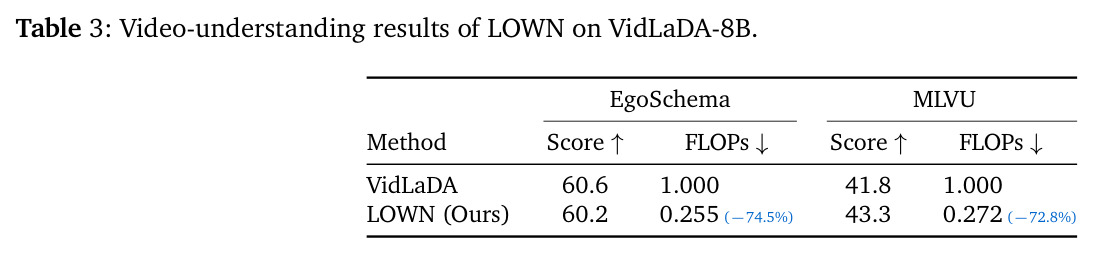
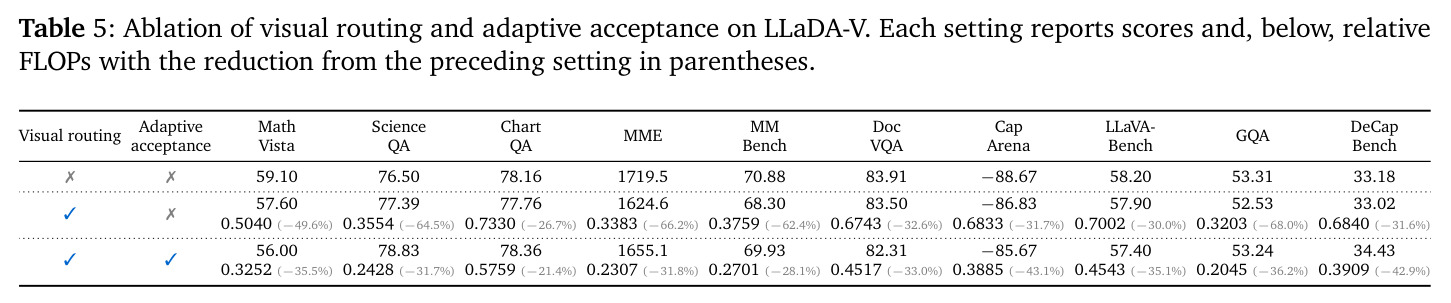
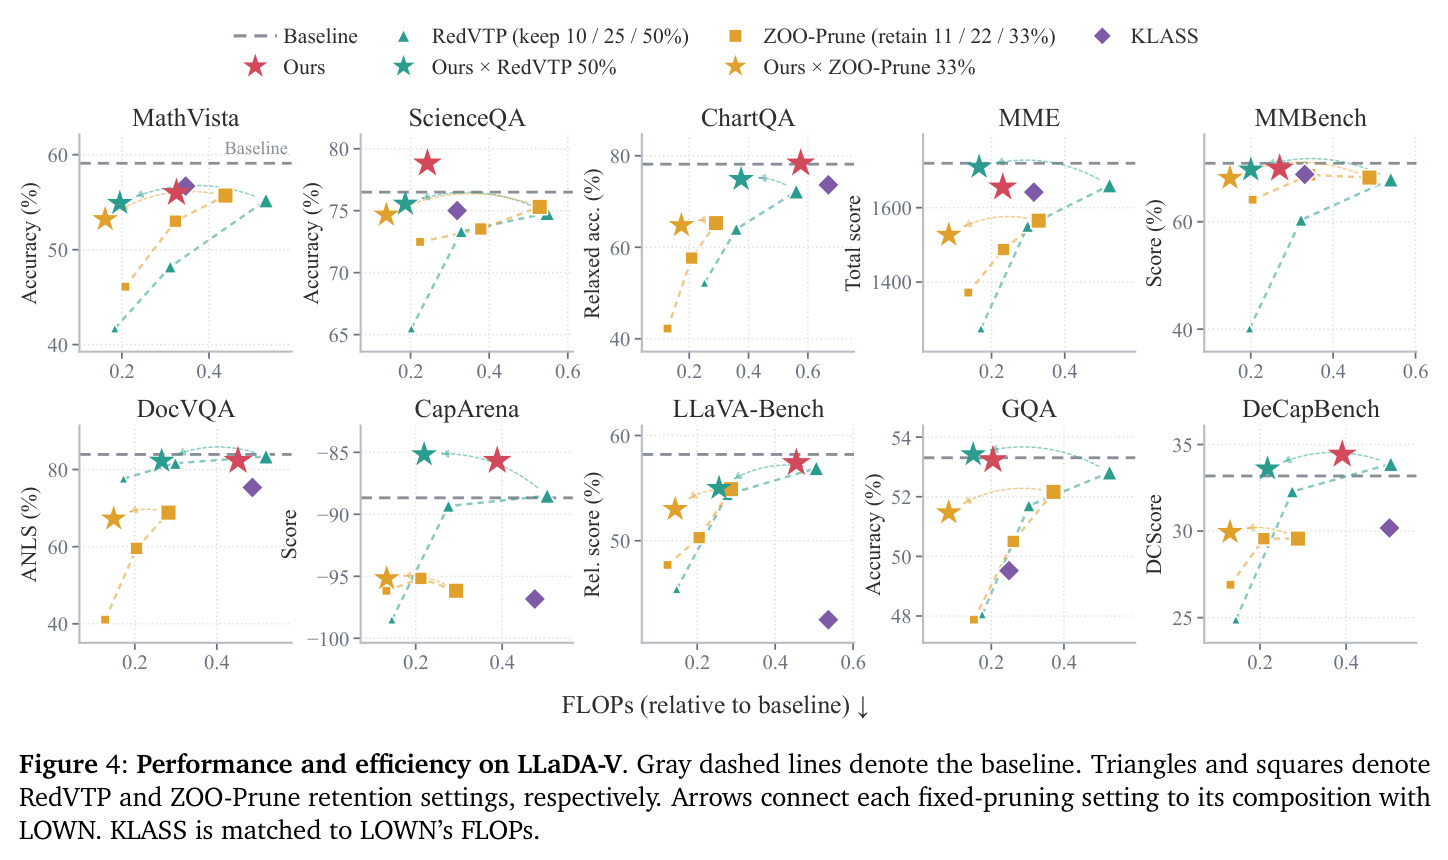
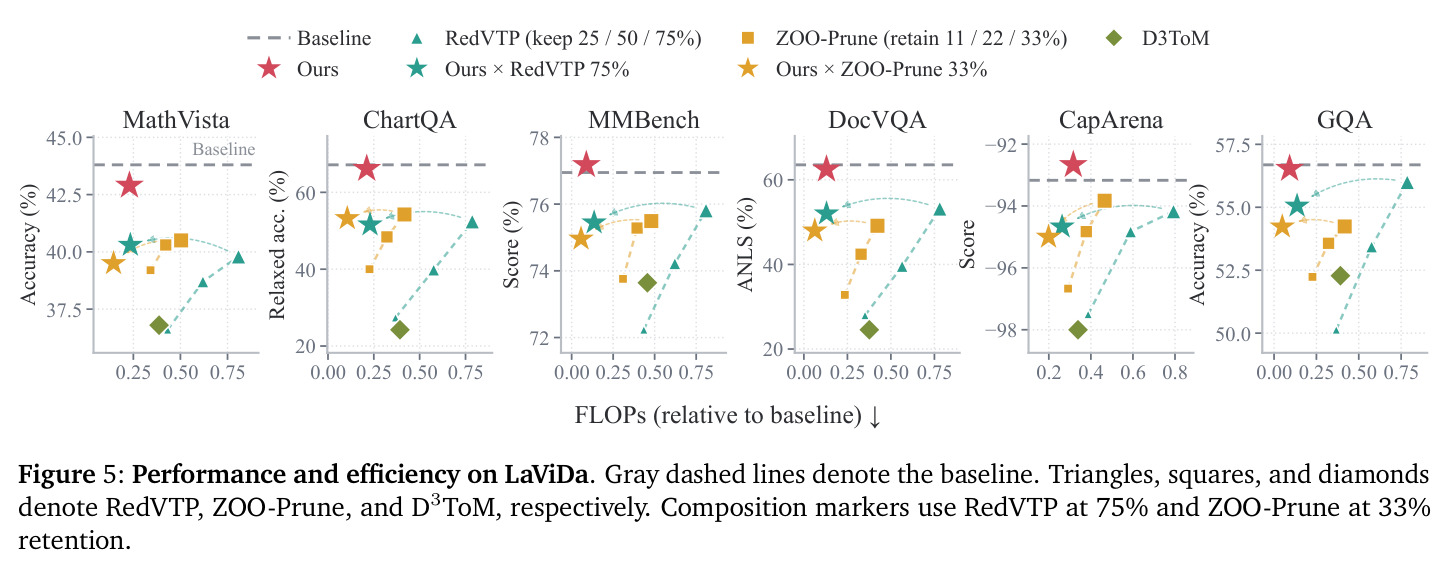
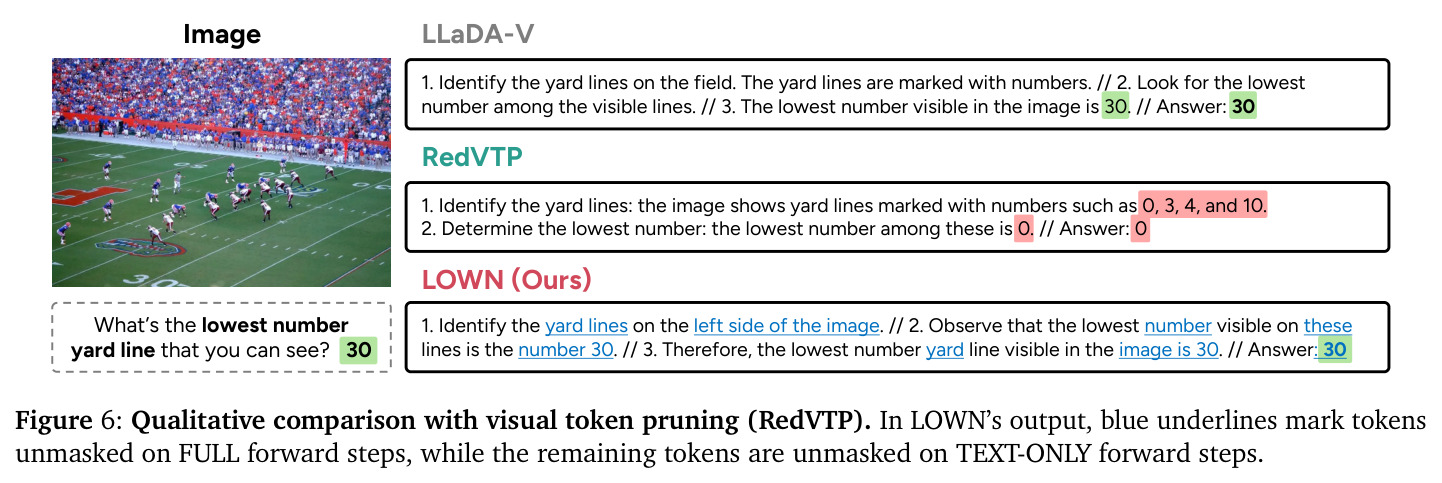
主结果分四块。(1)LLaDA-V 十基准:LOWN 保留基线分数 99.6%、解码 FLOPs 0.353×;将四个超基线的基准封顶到 100% 后仍有 98.6%。同预算对比中 LOWN 在十个基准的八个上得分最高,优于 RedVTP(93.0% @ 0.392×)、ZOO-Prune(94.2% @ 0.405×)、KLASS(91.9% @ 0.423×)。(2)与剪枝组合:LOWN + RedVTP(保留 50%)达归一化平均 98.3、FLOPs 0.223×,十项全部第一;相对 RedVTP 单独再省 57.6% FLOPs,相对 ZOO-Prune(33% 保留)再省 60.6%。MathVista 上 RedVTP 50%+LOWN 得 54.9(0.195×),好于 RedVTP 30% 的 51.7(0.354×),说明「温和剪枝+按需读图」优于激进剪枝。(3)与 KV 缓存组合:Fast-dLLM 之上叠加 LOWN,生成时间再降 38.1–50.1%(1.61–2.01× 额外加速)、FLOPs 再降 44.1–58.9%;带缓存的组合比裸模型快 5.6–7.0×,但分数略低于 Fast-dLLM 单独。(4)跨骨干迁移:LaViDa 保 99.7% 分数 @ 0.174× FLOPs(MMBench 77.18 vs 76.95 @ 0.088×,GQA 56.54 vs 56.69 @ 0.091×);叠加剪枝再省 77.3%/72.2% FLOPs,质量指数 99.5/99.8。VidLaDA-8B:EgoSchema 60.2 vs 60.6(0.255×),MLVU 43.3 vs 41.8(0.272×,反超 1.5 分)。墙钟时间平均降 57.4%、最高 73.2%。消融:视觉路由单独省 27–68% FLOPs,自适应接受再省 21–43%;oracle 时间表为 0.33× vs LOWN 实测 0.35×,已接近上限。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LLaDA-V 十基准平均 | 分数保持率 / 解码FLOPs | LOWN:99.6% 分数 @ 0.353× | LLaDA-V vanilla:100% @ 1.0× | 同等质量下省 64.7% 解码算力 |
| LLaDA-V + RedVTP(50%) 组合 | 归一化平均分数 / FLOPs | LOWN+RedVTP:98.3 @ 0.223×,十项全第一 | RedVTP 单独:87.8 @ 0.253× | 分数 +10.5pt,FLOPs 再省约 12% |
| Fast-dLLM KV 缓存组合 | 生成时间 / FLOPs | 时间再降 38.1–50.1%,FLOPs 再降 44.1–58.9% | Fast-dLLM 单独 | 1.61–2.01× 额外加速 |
| LaViDa 跨骨干迁移 | 分数保持率 / FLOPs | 99.7% @ 0.174× | LaViDa vanilla:100% @ 1.0× | 约 82.6% 算力节省,质量几乎无损 |
| VidLaDA-8B 视频理解 | 分数 / FLOPs | EgoSchema 60.2 @ 0.255×;MLVU 43.3 @ 0.272× | VidLaDA:60.6 / 41.8 @ 1.0× | 省约 73% 算力,MLVU 反超 +1.5 |
| vs 随机读图时间表(MathVista/LLaVA-Bench/DeCapBench) | 任务归一化质量 | LOWN | 匹配 FULL 次数的 Random 时间表 | +4.9–13.0% |
| vs 固定周期读图(MathVista) | 分数 / FLOPs | LOWN:56.00 @ 0.325× | Period 4:52.00 @ 0.321× | 算力相当下 +4.0 分 |
局限与改进
作者承认的局限有三。(1)证书复用的是锚点预测,可能与新鲜 FULL 预测不一致且随锚点老化增长——8 step 旧锚点在 DocVQA 上推翻率达 25.3%;实践中靠 92–97% 的 token 使用前一 step 锚点、最老不超过 5 step,才把错误压在 2.2–4.7%。(2)图表与文档任务省得少:ChartQA 相对 FLOPs 0.576×、DocVQA 0.452×,远高于 MMBench 的 0.27×,因视觉依赖持续、更多步骤需要 FULL 前向。(3)一致性信号同时决定 FULL 前向次数,解码前无法预定成本预算,需靠与剪枝组合的保留率间接控制。我的补充观察:其一,实验全为 batch=1 贪心解码,批处理下不同样本认证长度异构带来的调度与显存问题未讨论;其二,与 Fast-dLLM 组合后分数全面低于 Fast-dLLM 单独(LLaVA-Bench 低 5.0 分),说明缓存块选择与证书接受存在交互损耗;其三,「去视觉嵌入但保留位置 ID」依赖模型对缺口位置的鲁棒性,仅在三个 LLaDA 系骨干上验证,泛化到其他 DVLM 架构存疑。
独立分析的弱点
独立分析四点。(1)证书是「事后近似」而非「事前判据」:一致性证明的是旧锚点仍成立,而非当前状态真不需要图像;对视觉细节密集、逐段展开的任务(DocVQA、ChartQA),认证前缀短导致 FULL 前向频繁,收益受限。改进方向:插入「半图前向」档位,如用少量压缩视觉摘要 token 参与校验,在免图与全图之间提供中间粒度。(2)成本不可预算:解码前无法预知 FULL 次数,对延迟敏感的在线服务是隐患。改进方向:给接受规则加预算约束(动态调整前缀要求以逼近目标 FLOPs),或用前若干步的 $f$ 值在线外推。(3)batch=1 评测与真实部署脱节:批处理下样本分支异构,padding 浪费会吃掉理论收益。改进方向:按认证前缀长度分组重排 batch,或研究批内共享 FULL 前向的策略。(4)重复防护规则与认证机制的交互未量化,且全部实验用贪心解码,温度采样与 classifier-free guidance 下的一致性稳定性未测。改进方向:补测采样解码下的证书错误率,并把防护规则形式化为接受条件的一部分。
未来方向
作者在结论中把「图像访问调度」确立为 DVLM 高效解码的一个正交轴,可与剪枝、缓存、步数调度自由组合;并已在 LLaDA 系三个骨干上验证,自然延伸是 DiffusionGemma 等其他 DVLM,乃至自回归 VLM 多轮对话中重复编码图像场景的按需读图。基于成果可延伸:(1)把证书思想推广为「按需模态路由」——音频、视频流场景按步决定读取哪个模态的哪些片段,视频 DVLM(VidLaDA 初步 0.255×)尤有空间;(2)把锚点刷新从「整体替换」升级为「局部选择性刷新」,只重算分歧高的区域,进一步压低 FULL 前向本身成本;(3)训练时显式强化 TEXT-ONLY 分支(如混合无图训练),有望把 2.2–4.7% 的认证错误率再降、拉长接受前缀;(4)TEXT-ONLY 前向天然类似 draft 模型,可与推测解码结合,构造免额外模型的草稿-验证框架;(5)探索成本可预算的变体以适配在线服务的延迟 SLA。
复现评估
复现条件较好。代码与项目页已公开(https://hyeon9698.github.io/LOWN/),方法免训练,只需推理端改动:(1)能分别构造带视觉嵌入与去视觉嵌入(保留位置 ID)的两次前向;(2)锚点缓存与按置信度排序的认证扫描;(3)重复防护规则(附录 B.1)与分歧优先排序。评测需跑 LLaDA-V(8B 级)、LaViDa、VidLaDA-8B 在十个图像基准与两个视频基准;batch=1、贪心解码、无 KV 缓存的设置下单卡 A100/H100 级即可,成本主要在多基准评测而非训练。风险点:五个加速基线(RedVTP、ZOO-Prune、KLASS、D3ToM、Fast-dLLM)的超参网格与「给竞争者至少 LOWN 预算」的 FLOPs 对齐协议在附录 C.3,复现对比数字时须严格遵循;部分 2026 年引用方法开源情况未知,可能只能按论文描述近似复现。总体难度中等:核心方法约数百行推理代码,最费事的是搭齐全部基线与评测管线。
论文图表
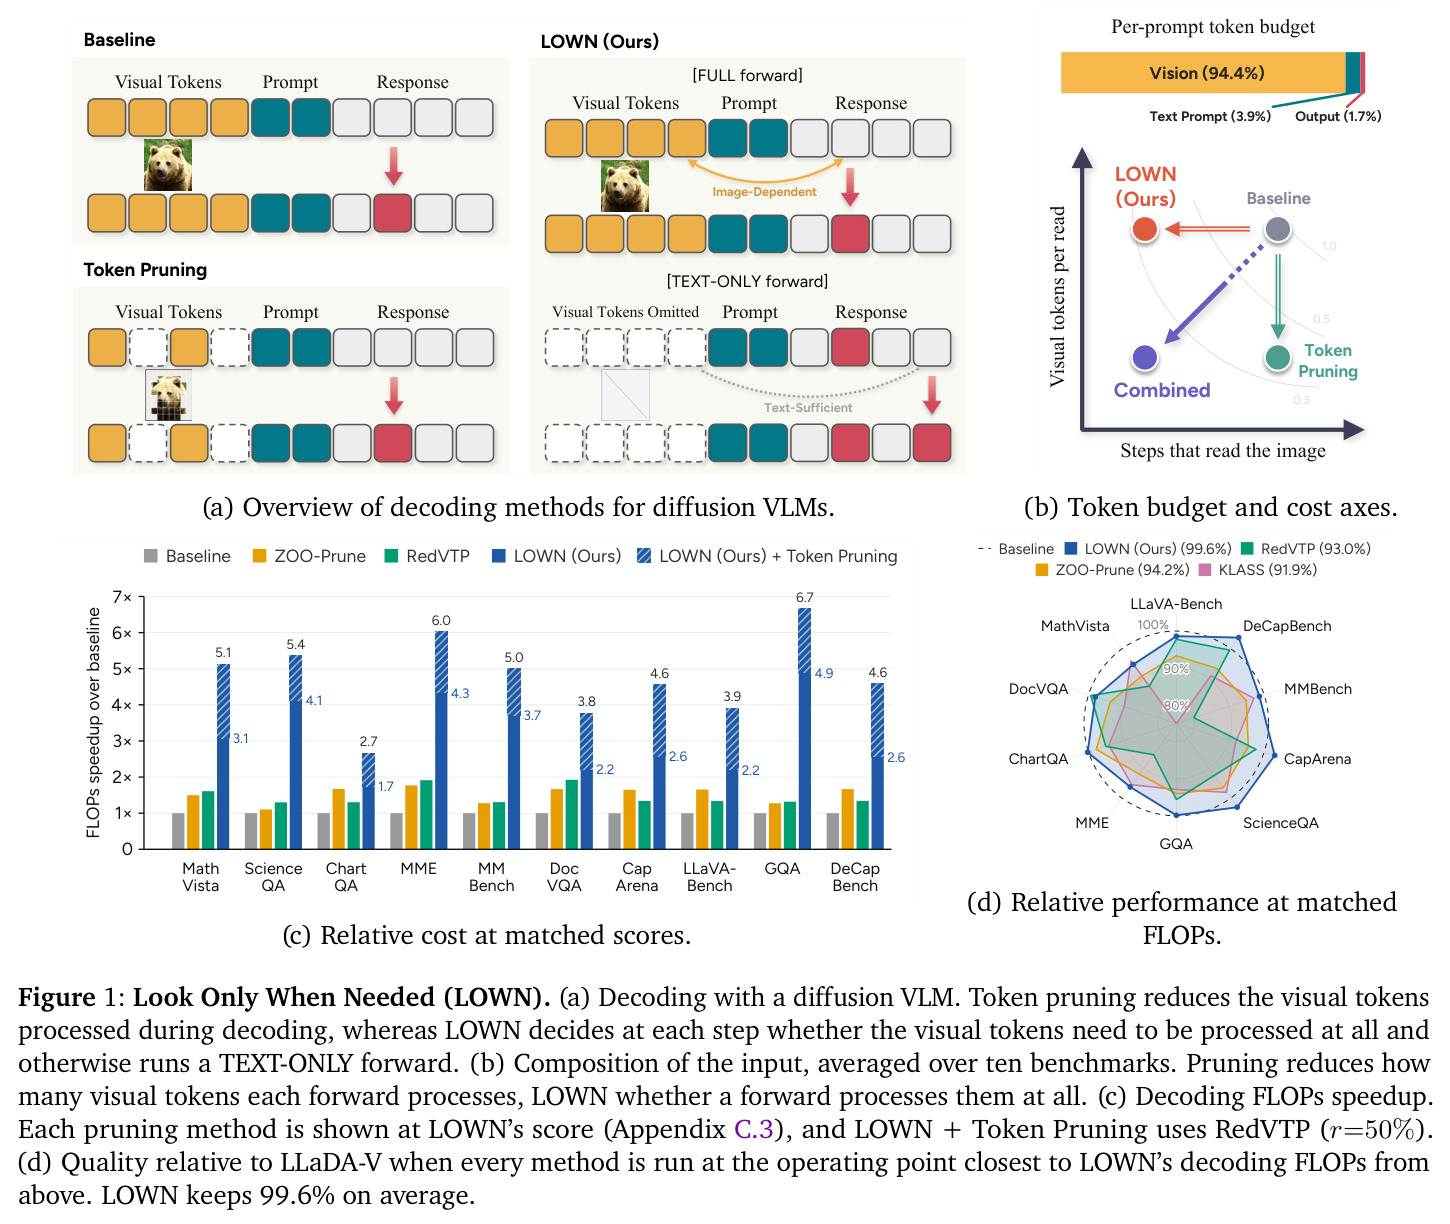
(a) 对比三种解码方式:基线每步全量处理,Token Pruning 削减每次前向处理的视觉 token 数,LOWN 决定每步是否处理视觉 token、否则走 TEXT-ONLY 前向;(b) 十基准平均输入构成中视觉 token 占 94.4%;(c) 各剪枝方法被调到 LOWN 分数时所需的解码 FLOPs 对比;(d) 在不低于 LOWN FLOPs 的运行点上各方法相对 LLaDA-V 的质量:LOWN 保 99.6%,ZOO-Prune 94.2%、RedVTP 93.0%、KLASS 91.9%。
一图概括问题规模(视觉 token 占比)、方法定位(是否读图 vs 读多少图)与全部主结果的量级,是判断论文价值的入口。
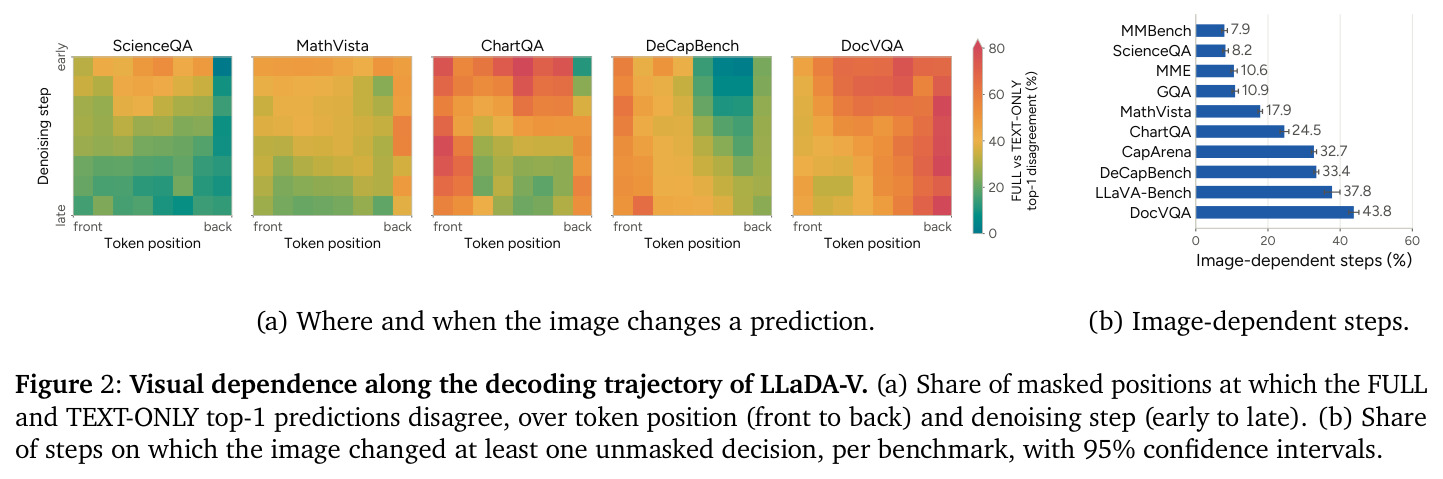
热力图显示 FULL/TEXT-ONLY 预测不一致集中在解码早期(十个基准中的八个),且受影响的 token 位置因任务而异;柱状图显示图像依赖步骤占比从 MMBench 的 7.9% 到 DocVQA 的 43.8%,平均 22.8%。
这是全文立论的实证基础:既证明大部分步骤可免图,又证明固定读图时间表不可行,直接导出「按输入与步骤自适应」的方法设计。