FrameForge:利用视频基础模型先验实现统一条件图像生成 FrameForge: Harnessing Priors of Video Foundation Models for Unified Image Generation
让视频模型的时间先验按输入自适应决定距离与变换,统一三类条件图像生成
前置知识
流匹配(Flow Matching)
一类扩散式生成训练范式:把干净潜变量 $z_0$ 与高斯噪声按连续时间 $t$ 插值得到 $z_t$,训练网络预测两者之间的速度场 $v$,损失为 $\mathcal{L} = \|v - v_\theta(z_t, t, c)\|_2^2$。相比 DDPM 的离散噪声预测,流匹配路径更直、采样更稳定,是 FLUX、HunyuanVideo 等新模型的默认选择。
FrameForge 的视频底座 HunyuanVideo1.5 就是用流匹配训练的,理解 $z_t$、速度 $v$ 的含义才能看懂目标帧预测的训练目标与去噪过程。
3D-RoPE(三维旋转位置编码)
Rotary Position Embedding 将位置信息以旋转矩阵形式作用在 attention 的 query/key 上,3D 版本把视频 token 的(时间、高、宽)三个坐标分别编码,使注意力天然感知帧间距离:时间坐标相差越大,旋转相位差越大。只改 RoPE 的时间坐标,就能改变模型眼中两帧的时间关系。
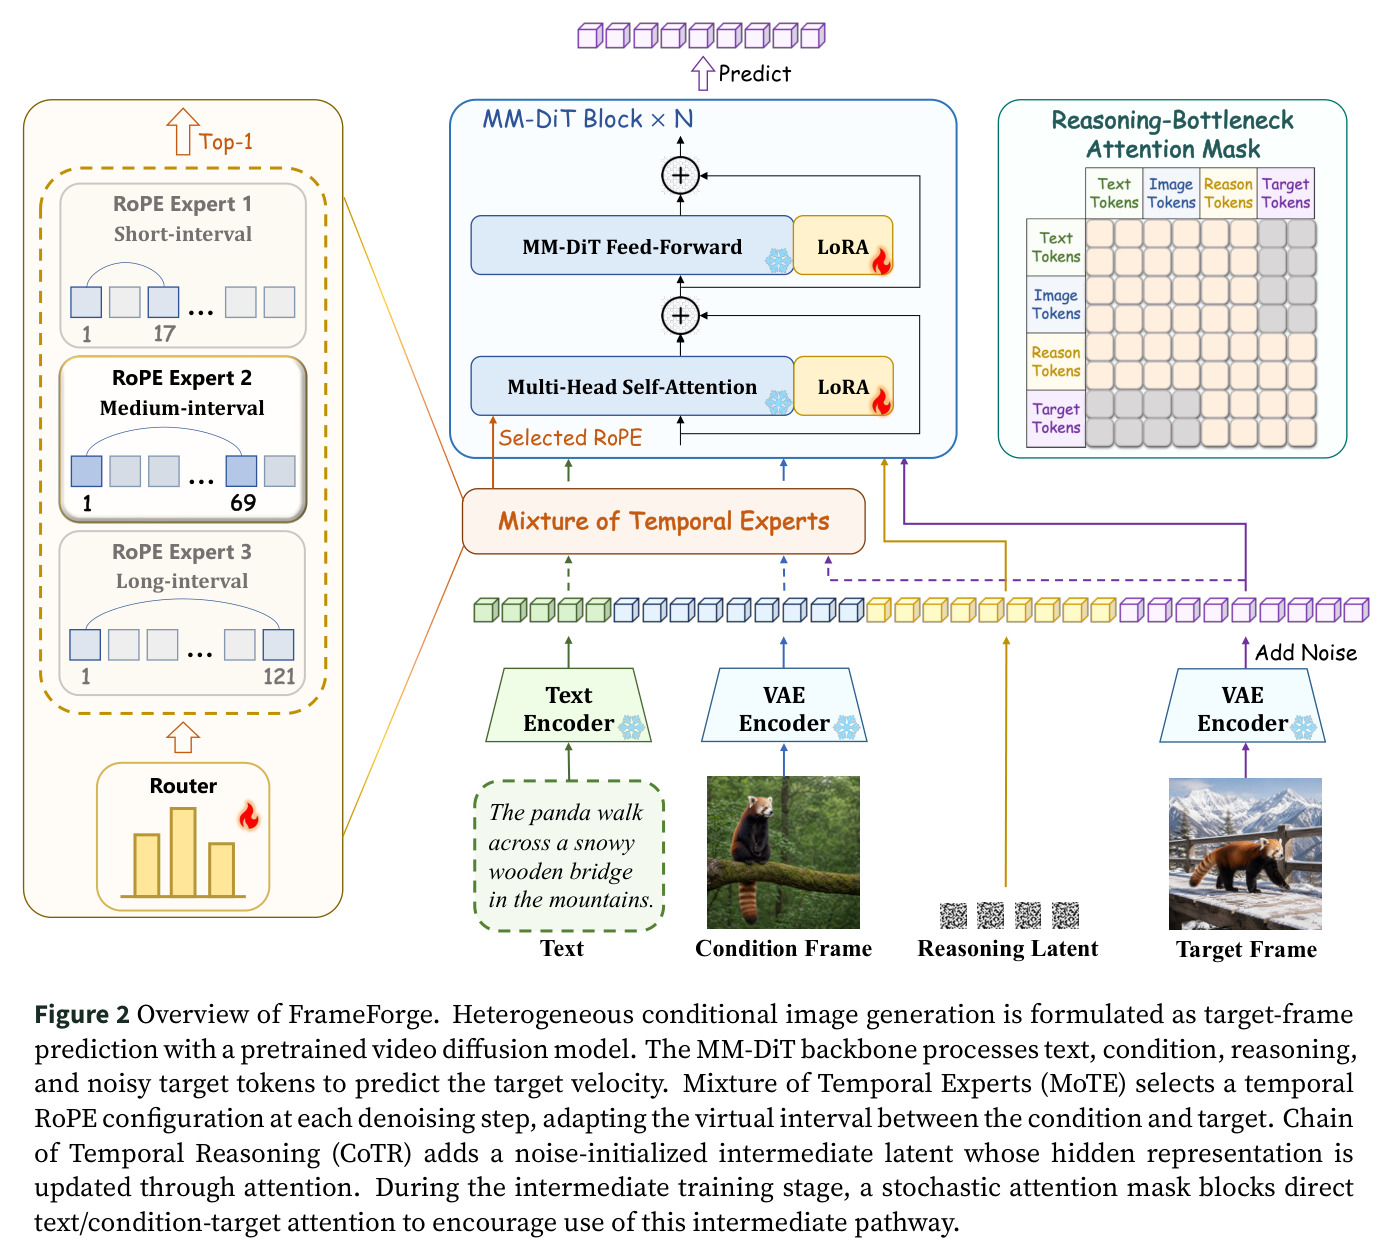
MoTE 的全部机制就是为不同样本选择不同'虚拟时间间隔'的 RoPE,不懂 3D-RoPE 就无法理解'时间专家'到底改了什么。
LoRA 低秩适配
冻结预训练权重 $W$,旁路一个低秩增量 $\Delta W = BA$($B\in\mathbb{R}^{d\times r}, A\in\mathbb{R}^{r\times k}$,秩 $r$ 远小于维度),只训练 $A,B$。参数量小、显存占用低,是扩散大模型微调的标准做法。
本文只用一个 rank=alpha=32 的共享 LoRA(182M 可训练参数)跨三类任务联合训练,底座完全冻结,参数高效是该框架成立的前提。
混合专家与直通估计器
MoE 用路由器为每个输入在多个专家中做选择以扩容模型;Top-1 离散选择不可导,常用直通估计器(straight-through estimator):前向用 one-hot 硬选择 $g_{\text{hard}}$,反向用软概率 $p$ 的梯度,形式为 $g = \text{sg}(g_{\text{hard}} - p) + p$($\text{sg}$ 为 stop-gradient),并常配负载均衡损失防路由塌缩。
MoTE 本质是一个作用于时间 RoPE 而非 FFN 的微型 MoE,理解路由、直通估计与负载均衡才能读懂它的训练方式。
MM-DiT 与 3D VAE
MM-DiT 是多模态扩散 Transformer:文本 token 与视觉 token 拼接成同一序列,共享自注意力与 FFN(HunyuanVideo 采用此架构)。3D VAE 把视频在时间/空间上压缩(本文为 4 倍/16 倍)得到低维潜空间,扩散与注意力都在潜空间进行。
FrameForge 的文本、条件帧、推理潜在态、噪声目标全部以 token 形式进入同一个 MM-DiT,瓶颈注意力掩码也作用在这个序列的自注意力上。
LPIPS 感知距离
在预训练视觉网络特征空间中度量两张图像的感知差异,比逐像素 MSE 更接近人眼判断:语义与结构变化会产生更大距离,而亮度微调则距离较小,常用于衡量图像变换幅度。
论文的核心动机图(Fig. 1)就是用 LPIPS 统计三类生成任务的条件-目标距离分布,并与自然视频帧间过渡的分布对比,这是整个方法成立的经验证据。
研究动机
现有异质条件图像生成方法几乎都以图像模型为中心:一类在多任务大数据集上从头训练原生统一模型(如 OmniGen、BAGEL、OmniGen2),另一类给预训练生成器加控制分支或轻量适配器(如 OminiControl、ACE++、EasyControl)。它们把条件当作辅助的空间或语义信号注入,并不显式建模'条件与目标差异有多大、应如何从条件变换到目标',单一共享模型因此难以容纳差异巨大的生成行为。基于视频模型的方法(RealGeneral、DRA-Ctrl、iMontage、Video4Edit、ChronoEdit)虽把条件和目标排成不同帧,但通常分配固定的时间位置,所有任务、所有样本共享同一时间偏移。然而 Fig. 1 的 LPIPS 统计显示:图像编辑只需小改动,主体驱动与 canny 生成则涉及外观、结构、场景的大幅变化,三类任务的条件-目标距离中位数明显不同且任务内分布很宽——固定偏移无法覆盖这种差异,限制了共享适配器的容量。
本文的目标是本文要构建一个统一条件图像生成框架:以冻结的预训练视频基础模型(HunyuanVideo1.5 首阶段视频扩散模型)为底座,仅用单一共享 LoRA(182M 可训练参数)同时完成主体驱动生成、canny-to-image 生成和指令引导图像编辑三类任务,不引入任何任务专属适配器。具体而言,模型需根据输入自适应地决定目标相对条件在'虚拟时间轴'上的距离(编辑近、canny 远),并学习从条件到目标的隐式变换路径,且训练只依赖目标帧重建损失、无需中间帧监督。评测目标是在 DreamBench、COCO2017、GEdit-Bench 三个基准上同时超过任务专用方法与统一基线,并把训练开销控制在 2 张 A800 约 6 天的量级。
与已有工作不同的是,本文的独特切入是'输入自适应的虚拟时间关系'视角。关键观察是:自然视频中相隔不同时间间隔的帧对应不同程度的视觉变化,而三类生成任务的条件-目标 LPIPS 分布恰好与视频帧间过渡的分布区间大幅重叠,说明不同任务可能分别落在视频模型预训练学到的时间变换先验的不同区域。据此,条件生成被拆解为两个互补问题:目标离条件'多远'(距离问题,交由 MoTE 从多个时间间隔专家中按输入动态选择)与条件'如何'变成目标(变换问题,交由 CoTR 的无监督中间潜在态建模)。与已有工作用任务标签或固定偏移刻画关系不同,FrameForge 让这个关系由每个样本、每个去噪步骤的文本与视觉上下文实时决定;同时用推理瓶颈注意力掩码切断目标直连条件的捷径,保证信息真的流经'推理'通路。
核心方法
FrameForge 把异质条件图像生成统一表述为'目标帧预测':目标图像经冻结 3D VAE(时间/空间压缩 4/16 倍)编码加噪,条件图像编码为 $z_{\text{cond}}$,CoTR 额外引入噪声初始化的推理潜在态 $z_{\text{reason}}$,与文本表示拼成 $c = [z_{\text{text}}, z_{\text{cond}}, z_{\text{reason}}]$,由 HunyuanVideo1.5 的冻结 MM-DiT 主干(流匹配训练)预测目标速度,总损失 $\mathcal{L}_{\text{final}} = \mathcal{L}_{\text{diffusion}} + \lambda_{\text{bal}}\mathcal{L}_{\text{balance}}$。直觉上,视频模型本来就会预测'下一帧长什么样',只要把条件放到虚拟时间轴起点、目标放到自适应选出的终点,就能复用视频预训练先验完成跨任务生成。底座完全冻结,仅在注意力与 FFN 投影插入单个共享 LoRA(rank=alpha=32、182M 参数)。训练共 51 万样本(每任务 17 万)、12000 迭代、全局 batch 60、学习率 $3\times10^{-4}$,2 张 A800 约 6 天。
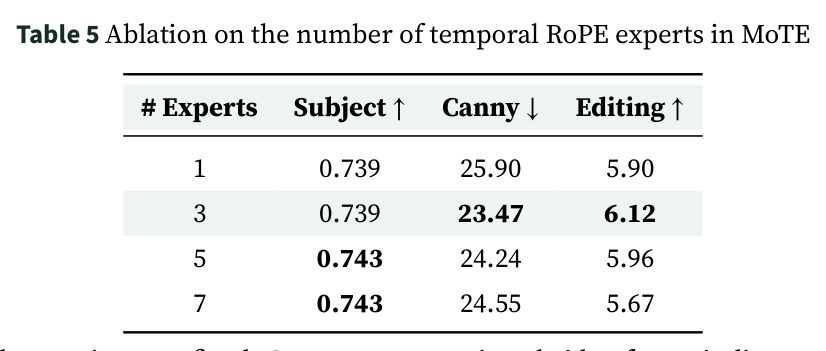
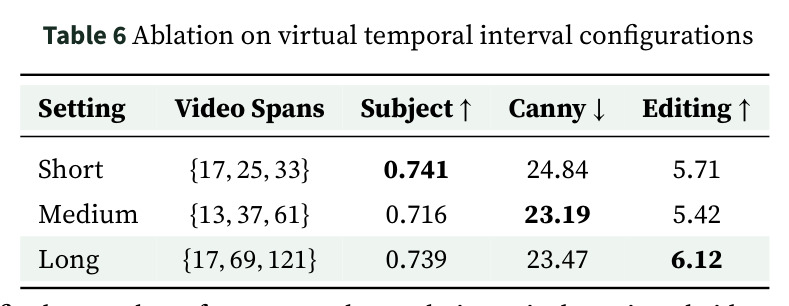
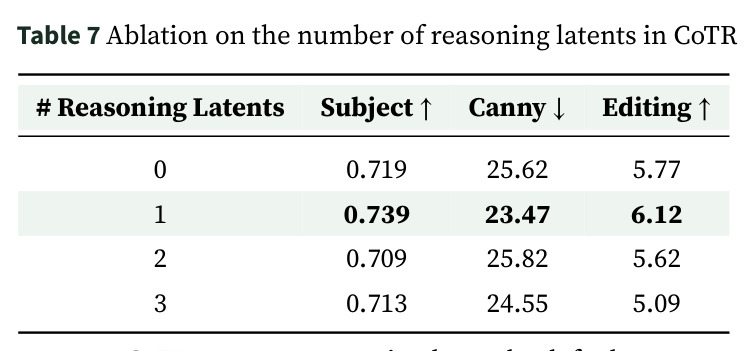
核心创新有二。其一 MoTE(时间专家混合):构造 $E=3$ 个候选视频帧跨度 {17, 69, 121}(潜在跨度 {5, 18, 31},时间压缩 $r_t=4$)的时间 RoPE 专家;路由器把 $[z_{\text{text}}, z_{\text{cond}}, z_{\text{target}}]$ 拼接后对有效 token 掩码平均池化得样本级 logits,经温度 $\tau_{\text{router}}=1.0$ 的 Softmax 与 Top-1 选择,用直通估计器 $g = \text{sg}(g_{\text{hard}} - p) + p$ 保证前向离散、梯度连续,并以 $\mathcal{L}_{\text{balance}} = -\sum_{e}\log(\bar{g}_e + \epsilon)$($\lambda_{\text{bal}}=0.01$)防路由塌缩,选中的 RoPE 施加于视觉 query/key。其二 CoTR(时间推理链):在条件与目标之间插入一个噪声初始化、不解码、不监督的推理潜在态,中间训练阶段以 $p_{\text{mask}}=0.5$ 概率施加瓶颈掩码,把文本/条件与目标间的直接注意力置 $-\infty$,迫使信息只经推理潜在态传播。与 RealGeneral 双帧固定位置、ChronoEdit 后期丢弃推理 token 的本质区别:时间关系由输入逐样本、逐步决定。
方法步骤详情
训练分三阶段。第一阶段:冻结 LoRA、去掉推理潜在态,仅优化 MoTE 路由器,让模型先学会按输入选时间间隔;第二阶段:加入噪声初始化的 $z_{\text{reason}}$,联合优化路由器与 LoRA,并以 $p_{\text{mask}}=0.5$ 随机施加式 (11) 的推理瓶颈掩码(文本/条件与目标互注意力置 $-\infty$,推理潜在态成为唯一桥梁);第三阶段:保留两模块、恢复全注意力继续联合训练,与推理配置一致,三任务共用同一适配器。推理:文本经文本编码器、条件图像经冻结 VAE 编码,目标加噪后与推理潜在态共同进入 MM-DiT;路由器在每个去噪步骤选一个时间专家,其 RoPE 施加于视觉 query/key;全部任务 50 步去噪,CFG 尺度主体驱动与编辑为 6、canny 为 2。训练数据来自 Subject200K+UNO-1M(主体对)、512-2M 子集(canny 对)、GPT-Image-Edit-1.5M 的 HQ-Edit/UltraEdit 子集(编辑对),每任务 17 万、共 51 万样本,512×512。
技术新颖性
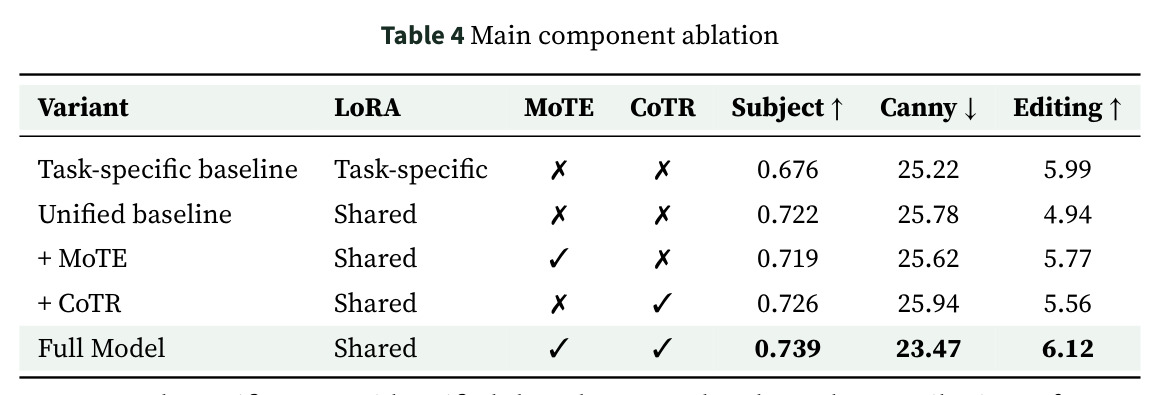
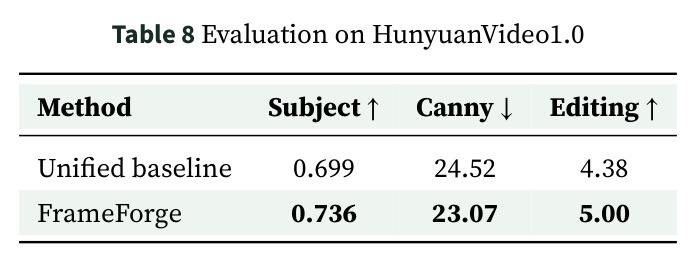
新颖性体现在三处。第一,把条件-目标关系显式参数化为可路由的虚拟时间间隔:与 TAG-MoE 把图像 token 路由到语义特化 FFN 专家不同,MoTE 保留全部共享特征处理参数,只在时间 RoPE 上做 $E=3$ 专家的 Top-1 选择,改动极小且与视频底座的位置编码机制天然兼容;与 DRA-Ctrl 的 mixup 镜头过渡、iMontage 的 Marginal RoPE 相比,间隔由样本内容而非任务标签决定,且 Fig. 6 证实选择随去噪步骤动态漂移。第二,CoTR 用单一无监督推理潜在态加随机瓶颈掩码实现信息通路约束,不依赖显式中间帧监督,也与 ChronoEdit 需在后期去噪步丢弃推理 token 的做法不同——推理态贯穿全部 50 步,推理时使用全注意力。第三,跨任务只共享一个 LoRA、无任务专属参数,配合负载均衡损失实现联合训练不互相干扰:共享基线让编辑从任务专属的 5.99 跌到 4.94,MoTE+CoTR 把它拉回 6.12 并同时提升另外两个任务,说明两模块针对性解决了任务间干扰;框架还在 HunyuanVideo1.0 上复验成功,证明与具体底座解耦。
实验结果
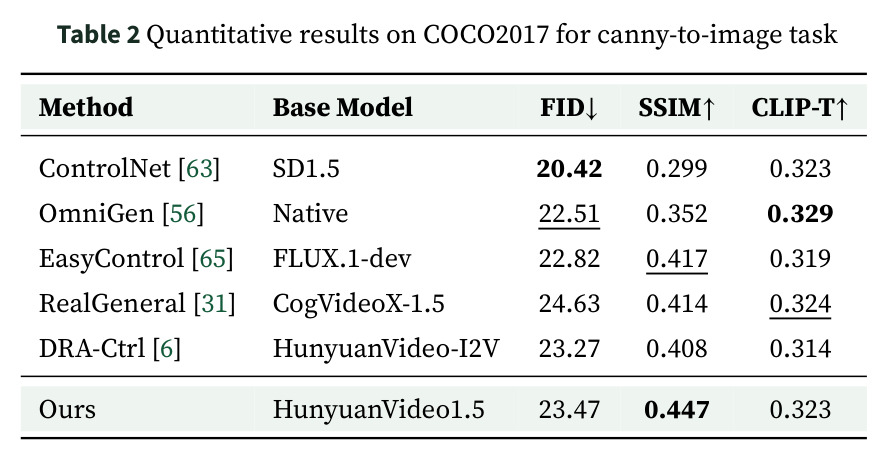
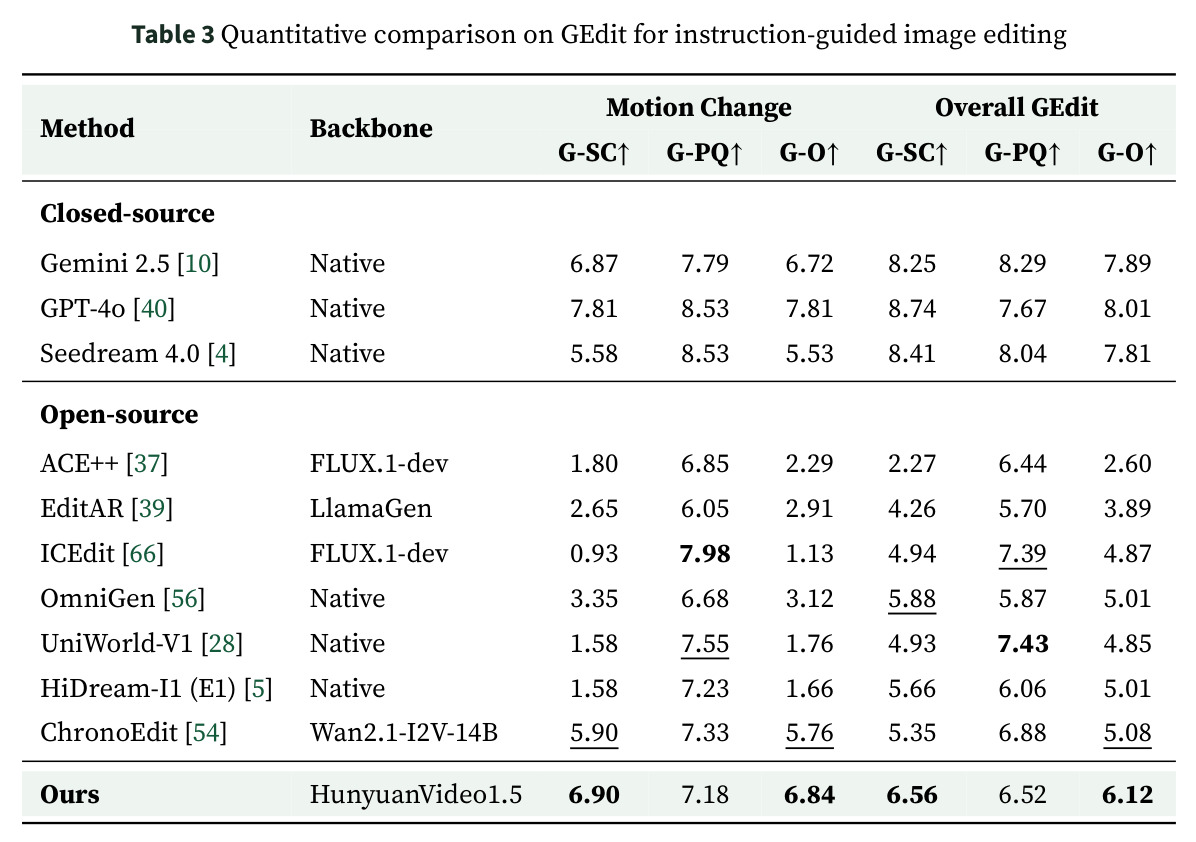
三组主实验均以单一共享模型取得最优或接近最优结果。主体驱动生成(DreamBench,30 主体×25 提示,VIEScore/GPT-4o):综合分 $O=0.739$ 全场最佳,超 ChronoEdit(0.729)1.37%;$SC=0.739$ 仅次于 ChronoEdit 的 0.757,$PQ=0.783$,保真与真实感的平衡更好。Canny 生成(COCO2017 验证集 5000 张):$SSIM=0.447$ 最佳,较 EasyControl(0.417)相对提升 7.2%;$CLIP\text{-}T=0.323$ 与 ControlNet 持平;$FID=23.47$ 与视频类方法相当(ControlNet 最低 20.42 但样例偏离边缘)。图像编辑(GEdit-Bench 英文 606 样本、GPT-4.1 评分):开源最佳,Motion Change $G\text{-}O$ 从 ChronoEdit 的 5.76 升至 6.84,Overall 从 5.08 升至 6.12,Motion Change 超 Gemini 2.5(6.72)与 Seedream 4.0(5.53)。消融证明互补性:统一基线编辑 4.94 → +MoTE 5.77 → +CoTR 5.56 → 完整 6.12 且 FID 降至 23.47;3 专家、{17,69,121} 间隔、单推理潜在态最优;跨底座 HunyuanVideo1.0 三任务一致提升(编辑 4.38→5.00、FID 24.52→23.07)。Fig. 6 显示 canny 偏好长间隔专家、编辑最早切向短间隔,印证逐样本逐步自适应的设计。
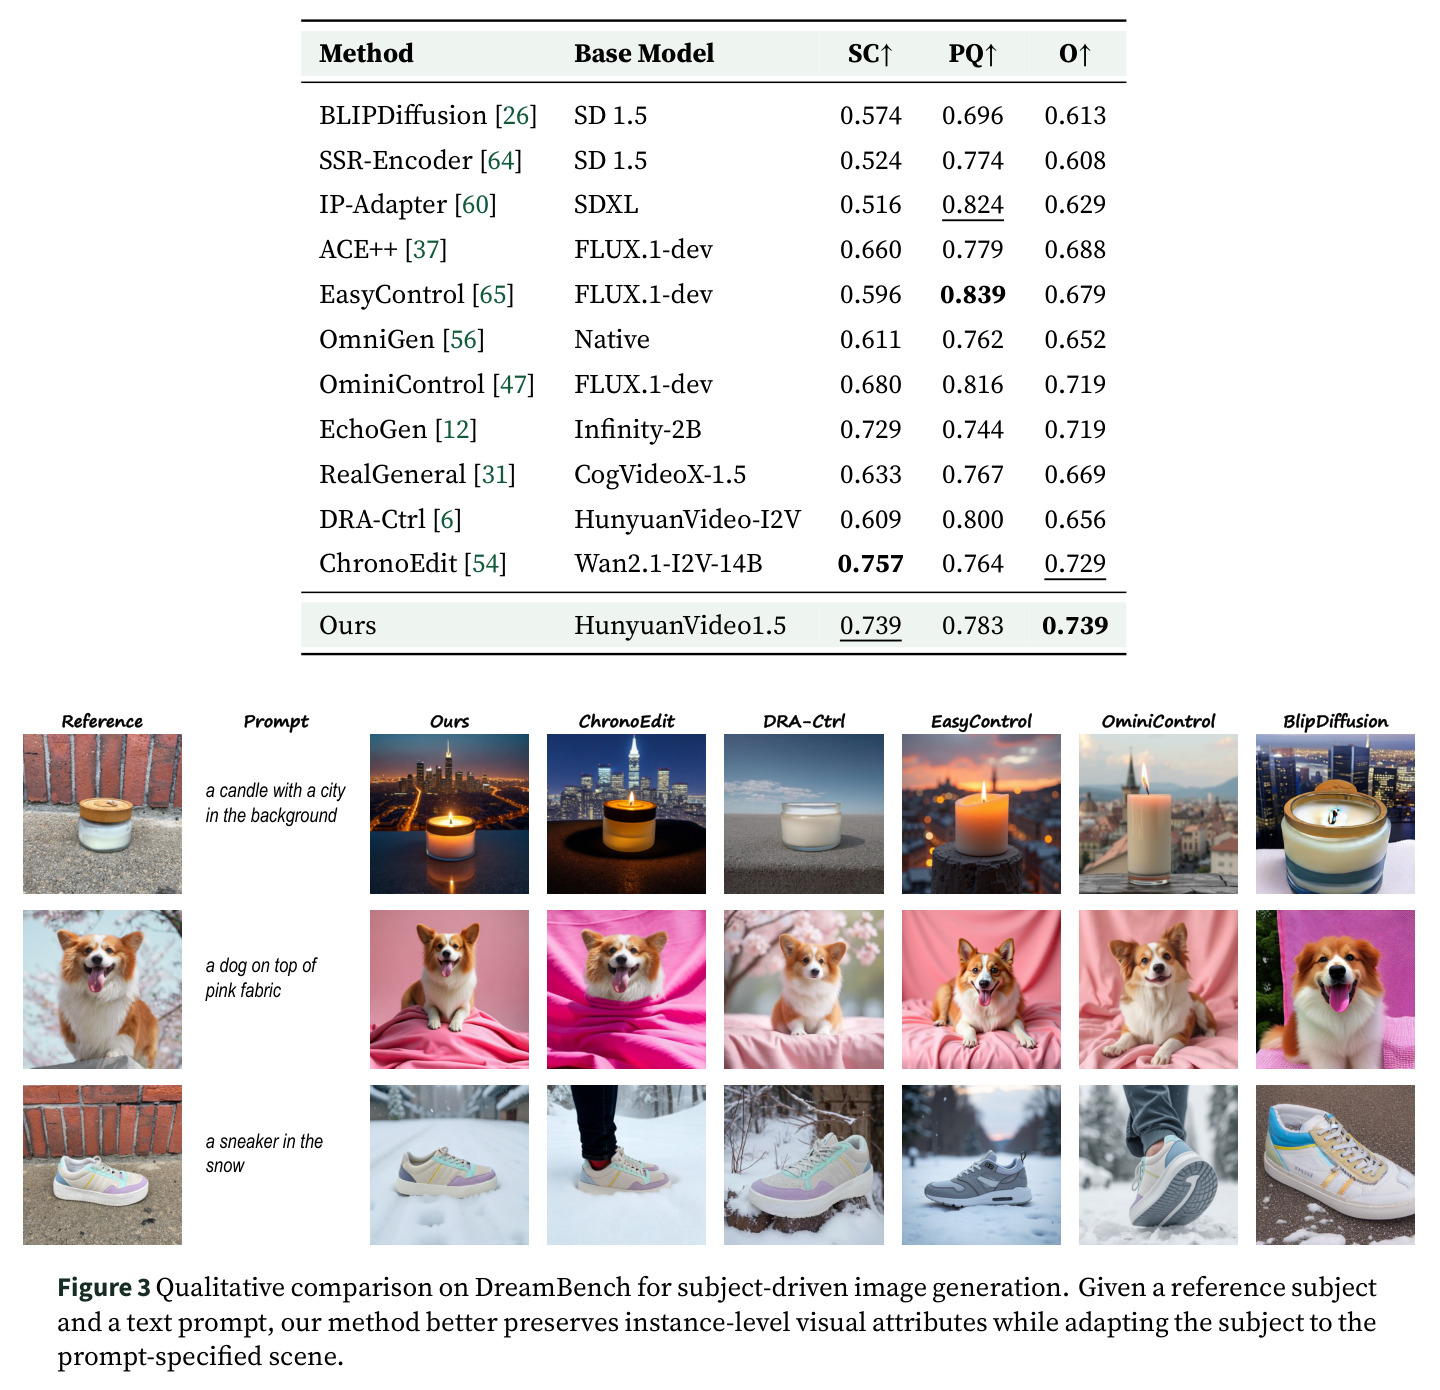
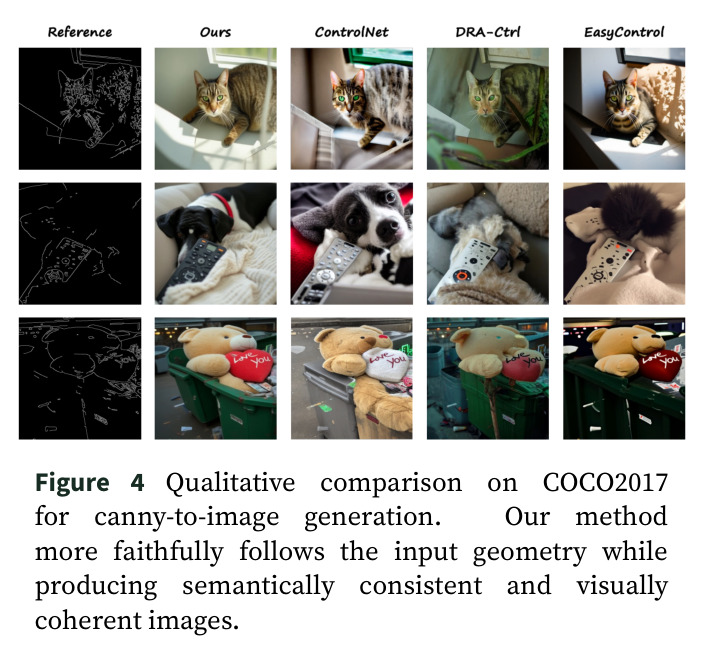
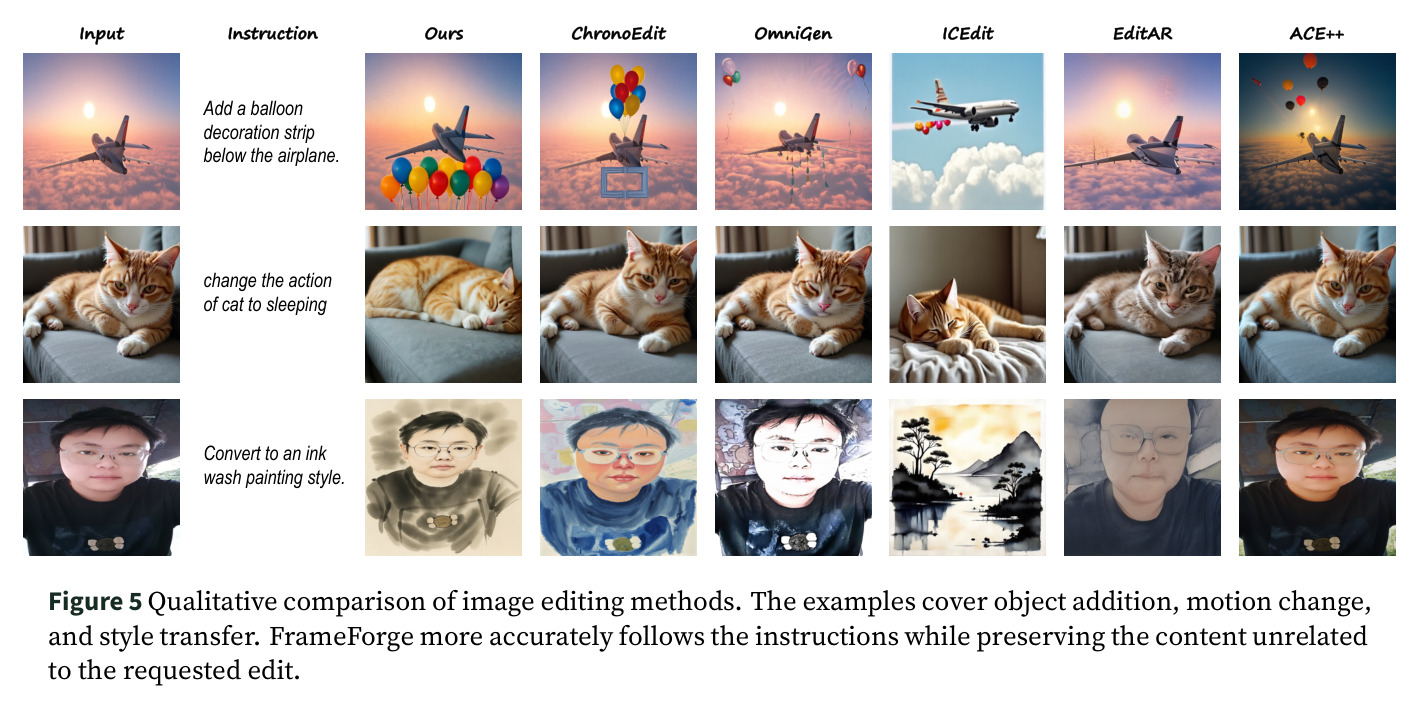
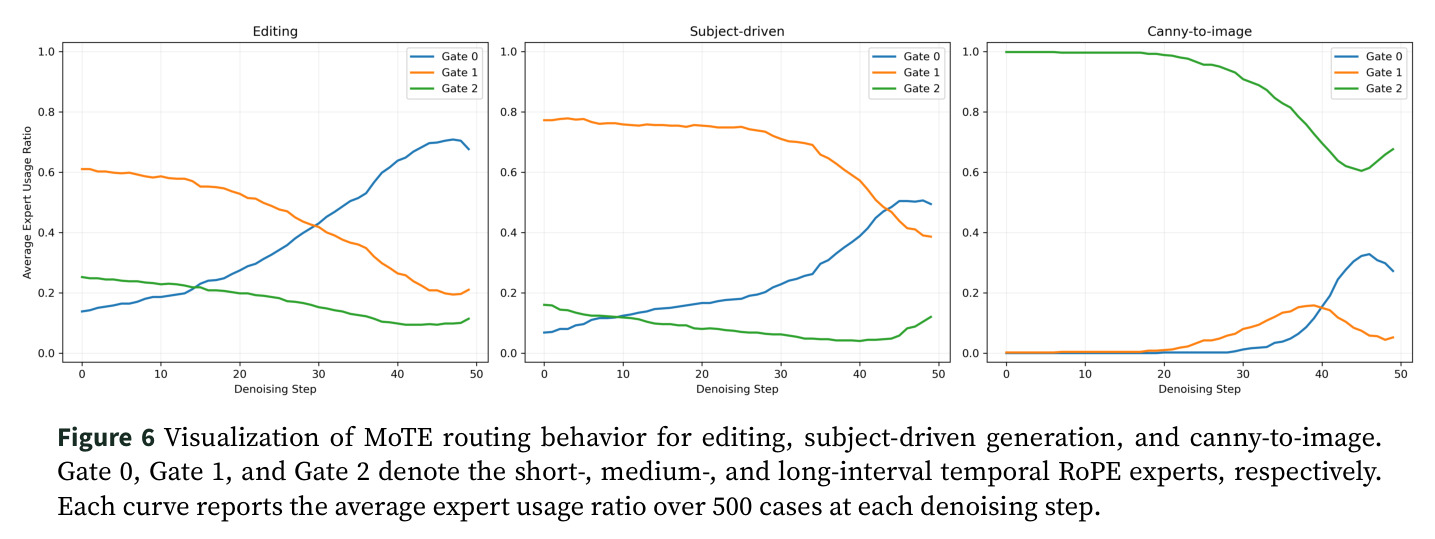
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 主体驱动生成(DreamBench) | VIEScore 综合 O↑ | 0.739 | ChronoEdit 0.729 / OminiControl 0.719 | 较 ChronoEdit +1.37%,全场最佳 |
| 主体驱动生成(DreamBench) | 语义一致性 SC↑ | 0.739 | ChronoEdit 0.757 | 第二名,低于 ChronoEdit 0.018 |
| Canny 生成(COCO2017 5000 张) | SSIM↑ | 0.447 | EasyControl 0.417 | 相对提升 7.2%,全场最佳 |
| Canny 生成(COCO2017) | FID↓ | 23.47 | ControlNet 20.42 / DRA-Ctrl 23.27 | 与视频类基线相当,非最佳 |
| 图像编辑(GEdit-Bench,Motion Change) | G-O↑ | 6.84 | ChronoEdit 5.76 / Gemini 2.5 6.72 / GPT-4o 7.81 | 较 ChronoEdit +1.08,超 Gemini 2.5 与 Seedream 4.0 |
| 图像编辑(GEdit-Bench,Overall) | G-O↑ | 6.12 | ChronoEdit 5.08 / GPT-4o 8.01 | 较 ChronoEdit +1.04,开源最佳但低于闭源 |
| 跨底座(HunyuanVideo1.0,三任务) | 主体 O↑ / Canny FID↓ / 编辑 G-O↑ | 0.736 / 23.07 / 5.00 | 统一共享 LoRA 基线 0.699 / 24.52 / 4.38 | 三任务全面优于统一基线,验证可迁移性 |
局限与改进
作者承认与自行观察到的局限。其一,FID 非最佳:canny 上 ControlNet 以 20.42 低于本文 23.47,作者归因于底座外观统计差异及 FID 与人类判断的已知分歧,但仍是短板。其二,主体一致性 $SC=0.739$ 低于 ChronoEdit 的 0.757,$PQ$ 亦不及 IP-Adapter(0.824)与 EasyControl(0.839),保真与真实的权衡未完全解决。其三,编辑 Overall $G\text{-}PQ$ 仅 6.52,低于 ICEdit 的 7.39 与 Gemini 2.5 的 8.29,综合 6.12 与 GPT-4o 的 8.01 差距仍大。其四,实验统一 512×512、单条件输入,未覆盖多参考与 many-to-many 场景。其五,VIEScore/GEdit 依赖 GPT-4o/GPT-4.1 打分,评测器本身有偏差。其六,专家数从 3 增至 5/7 反而损害 canny 与编辑,说明机制对专家池设计敏感;训练数据仍按任务均衡采样 17 万/任务,'免任务标签'更多体现在模型侧而非数据侧。
独立分析的弱点
独立分析可见几处弱点。(1)MoTE 是样本级 Top-1 离散路由,粒度粗且逐步跳变:同一张图内不同区域(需精细保留的前景与大改的背景)可能需要不同间隔,改进方向是 token 级或区域级路由、多专家软混合,或直接回归连续间隔替代离散专家。(2)CoTR 的推理潜在态完全无监督,论文未提供对其内容的探针实验或可视化,'推理'之名缺乏机制证据,可加线性探针、中间解码或注意力消融来验证它究竟编码了什么。(3)瓶颈掩码仅在中间阶段以 $p_{\text{mask}}=0.5$ 随机施加,掩码与全注意力的随机切换可能引入训练不稳定,可研究退火式掩码调度或课程式收紧瓶颈。(4)专家池 {17, 69, 121} 为手工网格,表 6 显示中等区间在 canny 上更优(FID 23.19),说明间隔搜索空间设计粗糙,可学习非均匀网格。(5)512×512 与 HunyuanVideo1.5-720P 的原生能力不匹配,高分辨率下路由稳定性与显存开销未验证,未来需补充多分辨率实验。(6)路由在 500 例上的统计虽显示了任务与步数依赖,但缺乏对失败案例(选错专家)的分析与纠错机制。
未来方向
作者将框架定位为'冻结视频底座 + 输入自适应虚拟时间关系'的通用适配范式,可延伸方向包括:把 MoTE/CoTR 推广到 many-to-many 可变长度生成(如 iMontage 场景),让多个条件帧与多个目标帧各自获得自适应时间关系;将专家选择从离散 Top-1 扩展为连续间隔预测或层级路由,并探索空间维度上不同图像区域使用不同间隔;在 Wan、CogVideoX、SANA-Video 等更多视频底座上验证迁移性(论文已给出 HunyuanVideo1.0 的正向结果:编辑 4.38→5.00、FID 24.52→23.07);结合 KV 缓存与专家选择缓存降低 50 步去噪开销;对推理潜在态做机制可解释性研究,或用轻量蒸馏将其能力固化后去掉该通道;把时间间隔先验用于物理一致性编辑(与 ChronoEdit 正面对话),以及迁移到视频编辑、插帧等原生时序任务;进一步让数据侧也实现任务无关采样,与模型侧的自适应形成完整闭环。
复现评估
复现条件中等偏友好。论文给出项目主页(lyne1.github.io/FrameForge-page/),但正文未明确声明开源训练代码,需关注主页发布;底座 HunyuanVideo1.5-T2V-720P 与三个评测基准(DreamBench、COCO2017、GEdit-Bench)均公开。训练成本明确且不高:LoRA rank/alpha=32、182M 可训练参数,12000 迭代、全局 batch 60、学习率 $3\times10^{-4}$、2 张 A800 约 6 天。训练数据全部来自公开数据集(Subject200K、UNO-1M、512-2M、GPT-Image-Edit-1.5M 子集),每任务 17 万、共 51 万样本,512×512;但'过滤高质量主体对'的具体规则未详述,可能带来复现偏差。关键超参齐全:$\tau_{\text{router}}=1.0$、$\lambda_{\text{bal}}=0.01$、$p_{\text{mask}}=0.5$、CFG 6/2、50 步去噪。主要门槛是熟悉 HunyuanVideo 代码库并修改 MM-DiT 与 3D-RoPE,以及 VIEScore/GEdit 评测的 GPT API 费用;总体属于可复现性较好的学术工作。
论文图表
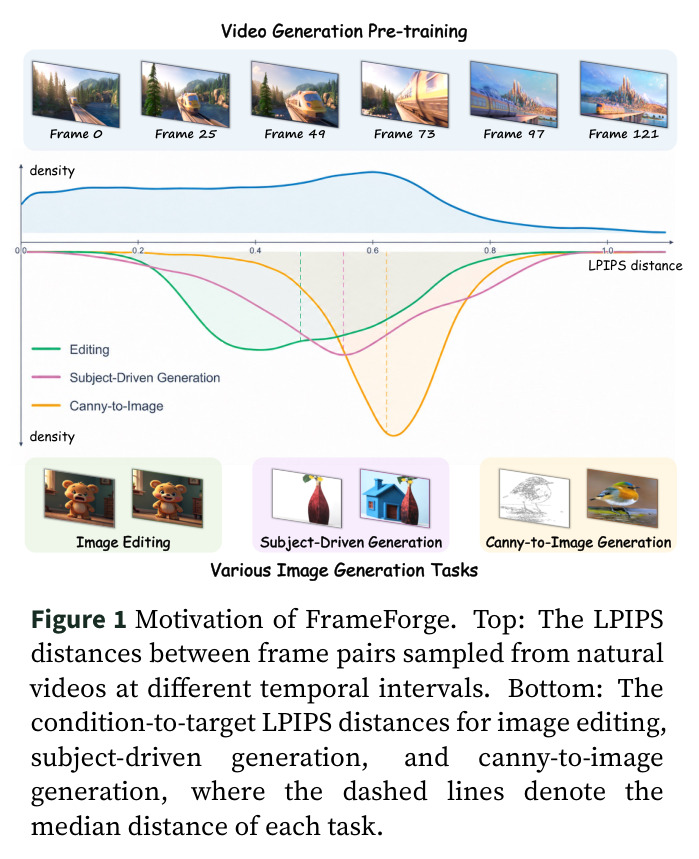
上图为自然视频中按不同时间间隔采样的帧对的 LPIPS 距离分布,下图为图像编辑、主体驱动生成、canny 生成三类任务的条件-目标 LPIPS 距离分布,虚线为各任务中位数。三类任务的分布明显不同(编辑最小、canny 最大),且与视频帧间过渡的分布区间大幅重叠。
这是全文的经验基石:它证明'条件-目标差异'可以映射到视频模型学到的不同时间变换区域,是 MoTE 设计的直接依据。
11 个方法在 DreamBench 上的 SC/PQ/O 对比:本文 O=0.739 全场最佳(ChronoEdit 0.729、OminiControl 0.719、ACE++ 0.688),SC=0.739 第二(ChronoEdit 0.757),PQ=0.783 低于 EasyControl 0.839 但后者 SC 仅 0.596。
主体驱动任务的主结果表,量化说明本文在保真与真实感之间的平衡优于所有对比方法。