SOMA:细粒度自我中心行为与身体运动理解基准 SOMA: A Benchmark for Fine-Grained Egocentric Behavior and Body-Motion Understanding
首个自我中心身体运动理解基准:最强MLLM仅50.0%,显著落后人类的68.5%
前置知识
MLLM(多模态大语言模型)
以大语言模型为骨干、外接视觉编码器的模型:视频被均匀抽帧成图像,经视觉编码器转成token序列,与文本问题一起送入语言模型,输出文本答案。本文评测37个,覆盖闭源(Gemini、GPT、Claude系列)、开源(Qwen3-VL、Qwen3.5、InternVL3.5、Gemma-4、GLM-4.6V等)和自我中心专用模型(EgoGPT、EgoVLM、EgoThinker)。统一用lmms-eval框架,16帧均匀采样、温度0、零样本作答四选一多选题。
SOMA的受试对象就是MLLM:所有核心结论(最强50.0%对人类68.5%、右手偏差、四类错误、运动信号是否互补)都是对这类模型感知与推理机制的诊断。
自我中心视频(Egocentric video)
由头戴设备(如Aria眼镜、GoPro)以第一人称拍摄的视频,相机随佩戴者头部一起运动。与第三人称视频的根本差异是:佩戴者自己的躯干、腿、大部分身体通常在画面之外,只能靠手部入镜、视野变化、运动模糊、自我运动等间接线索推断自身的姿态与动作。
SOMA的三大能力轴(身体配置、运动动态、时序推理)全部建立在这一视角的独特困难上:身体部分可见、运动线索随时间分散、必须跨帧整合ego-motion信息。
SMPL-X 与 263 维身体运动表示
SMPL-X是参数化人体网格模型,用低维姿态与形状参数表示包含手部的全身网格;一段人体运动即逐帧姿态参数序列,常用263维特征(关节旋转、角速度、脚部接触等)描述。本文用VQ-VAE的卷积编码器把20fps的运动序列编码为连续latent(每4帧一个),经MLP投影到语言模型嵌入空间,作为'运动token'插入输入序列——这是LLaVA/MotionLLM式的标准设计。
理解SOMA-Train的对齐训练数据和video+motion多模态基线(Table 3、11、12)必须知道运动是如何被表示、编码并注入模型的,否则无法判断运动信号实验的意义。
语言先验捷径与盲语言过滤(blind-language filtering)
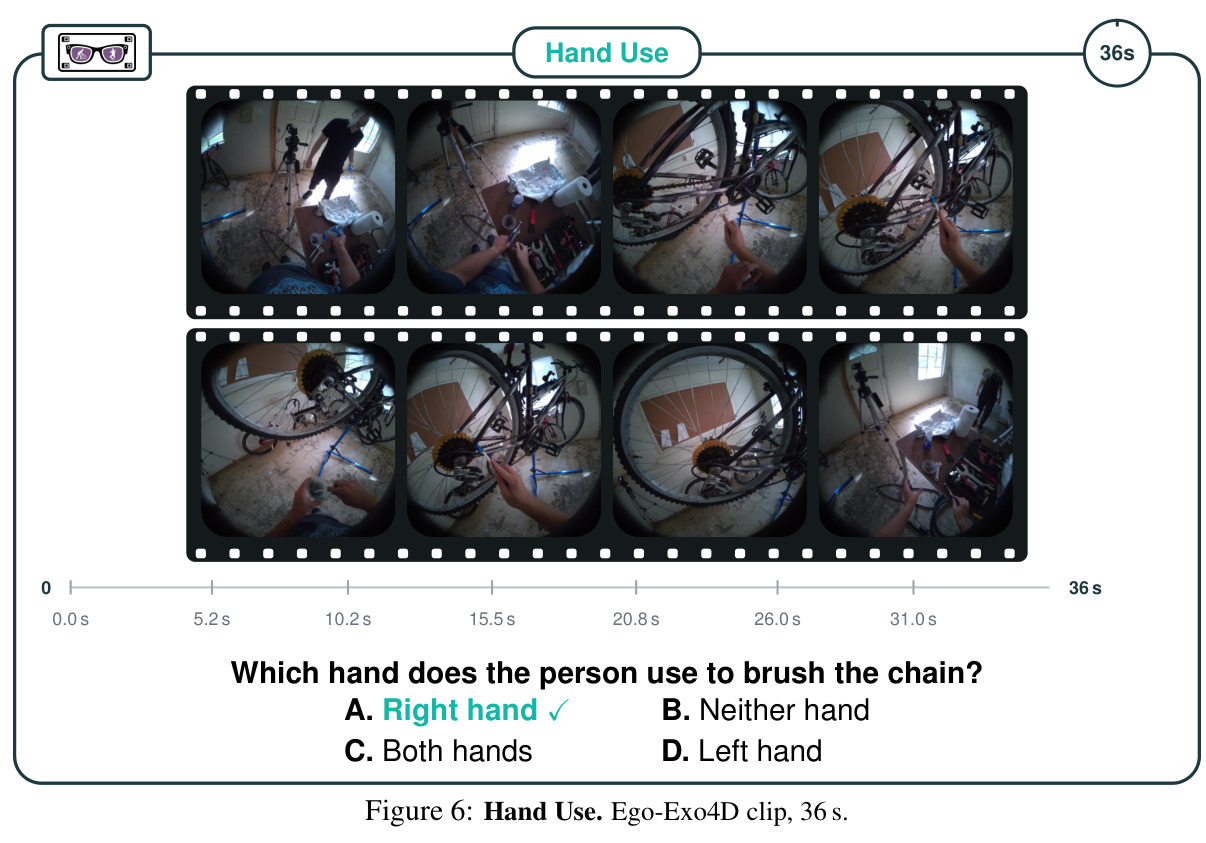
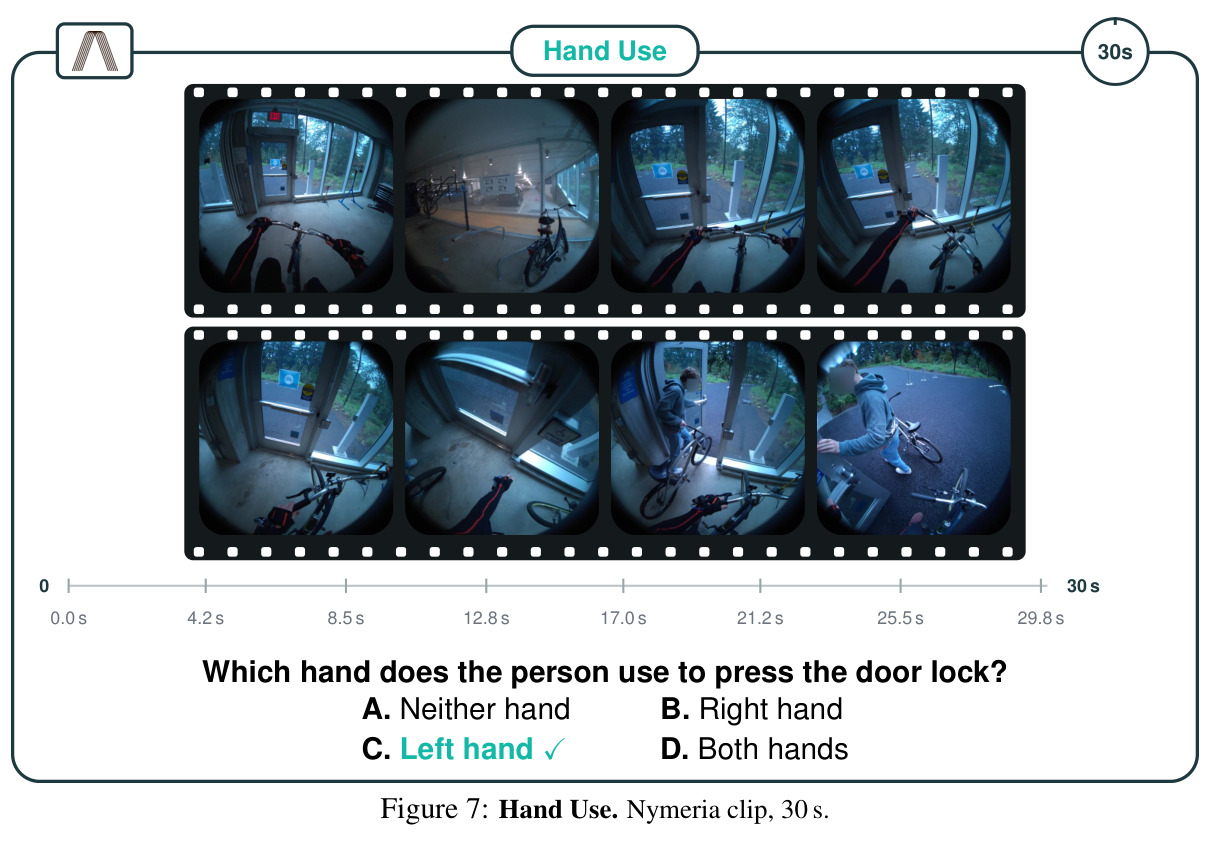
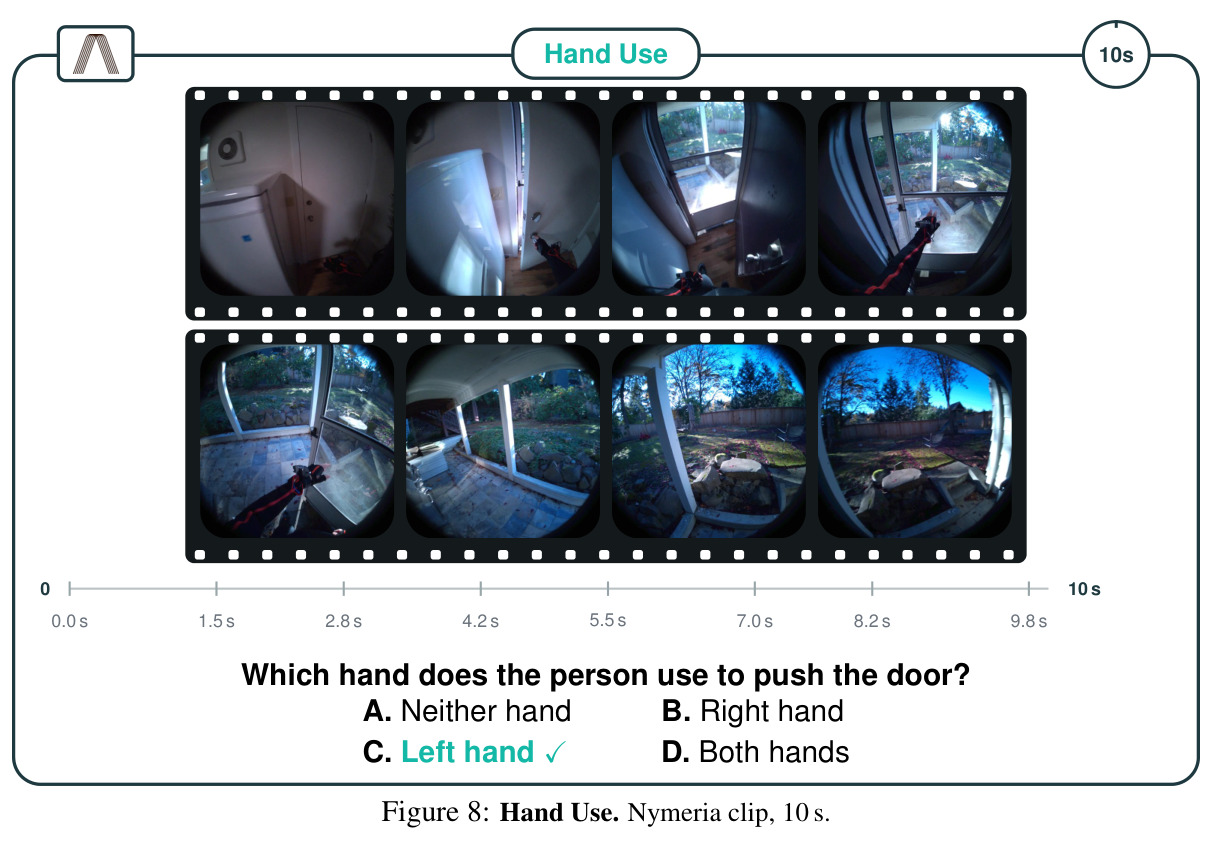
LLM在预训练中积累了大量世界知识,很多视频问答不看视频、仅凭文本常识即可答对(例如'刷牙用哪只手',统计上多数人用右手),这称为语言捷径,会污染评测效度。盲语言过滤即让多个LLM在完全不看视频的情况下作答,把盲答正确率过高的题目删掉,迫使评测考察真正的视觉感知。
这是SOMA可信度的核心设计:4个模型盲答、≥2个答对即删题,共删45.9%;SOMA-Train的去偏验证(Table 8盲训练迁移)也是同一思想的延伸,不理解它就无法评估该基准结论的有效性。
LoRA 微调
低秩适配微调:冻结原模型全部权重,只在权重矩阵旁注入一对低秩矩阵,即 $\Delta W = BA$,其中秩 $r \ll d$,训练参数量骤减。本文第二阶段用 rank 128、$\alpha=256$、dropout 0.05、学习率 $5\times10^{-5}$,在8张H100上微调语言模型2个epoch,全局batch size 48。
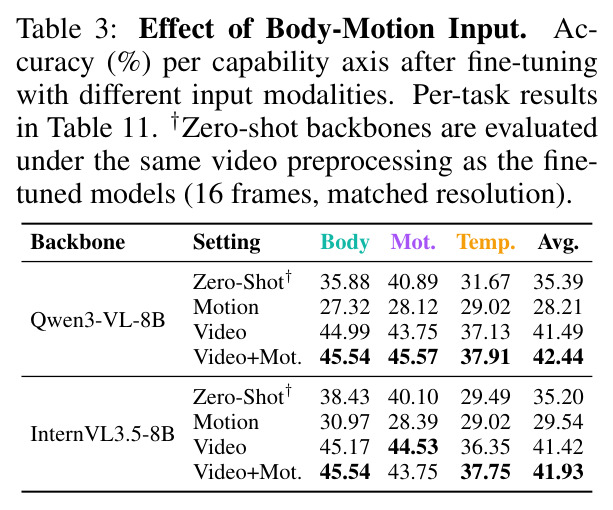
SOMA-Train的三个输入变体(motion-only、video-only、video+motion)都用同一LoRA配方训练,是控制变量比较'运动信号是否带来互补信息'的实验基础。
研究动机
现有视频MLLM评测几乎都围绕对象、场景和粗粒度活动:EgoSchema(5,063题)考长视频理解,EgoTaskQA(40,000题)考目标导向的任务推理,LEMONADE(36,521题)考活动级理解,没有一个直接考察'身体本身'——某一刻身体如何配置、动作如何随时间展开(Table 1)。自我中心视角让问题更尖锐:佩戴者的身体大部分在画面之外,运动模糊与视角剧变频发,重复次数、运动方向这类细粒度动态极难从第一人称读出。更隐蔽的是先验污染:约90%的人是右撇子(Papadatou-Pastou et al., 2020),训练语料中右手动作被过度代表,模型可能用'常识'替代视觉证据。结果是,我们无法判断ego视频理解上的进步究竟来自读懂了人体运动,还是只是认出了运动发生的物体和场景。
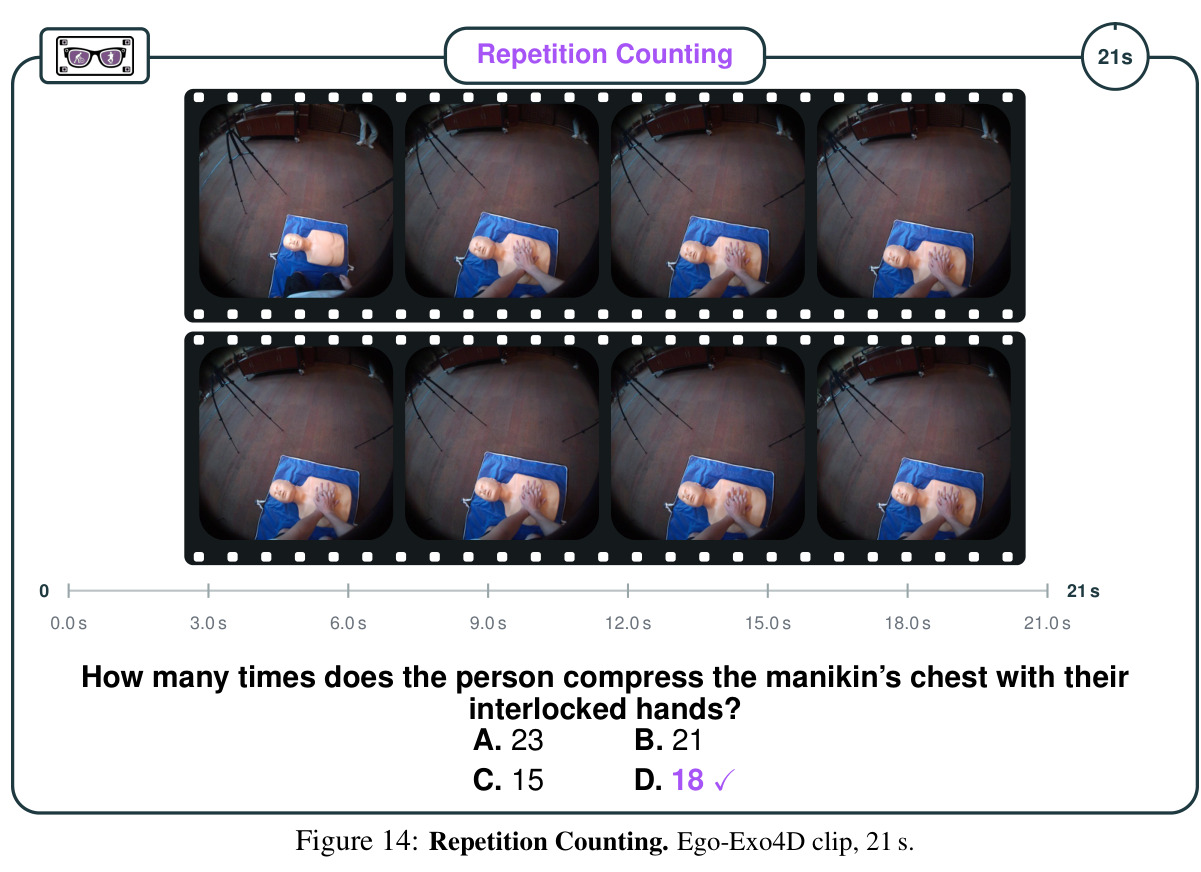
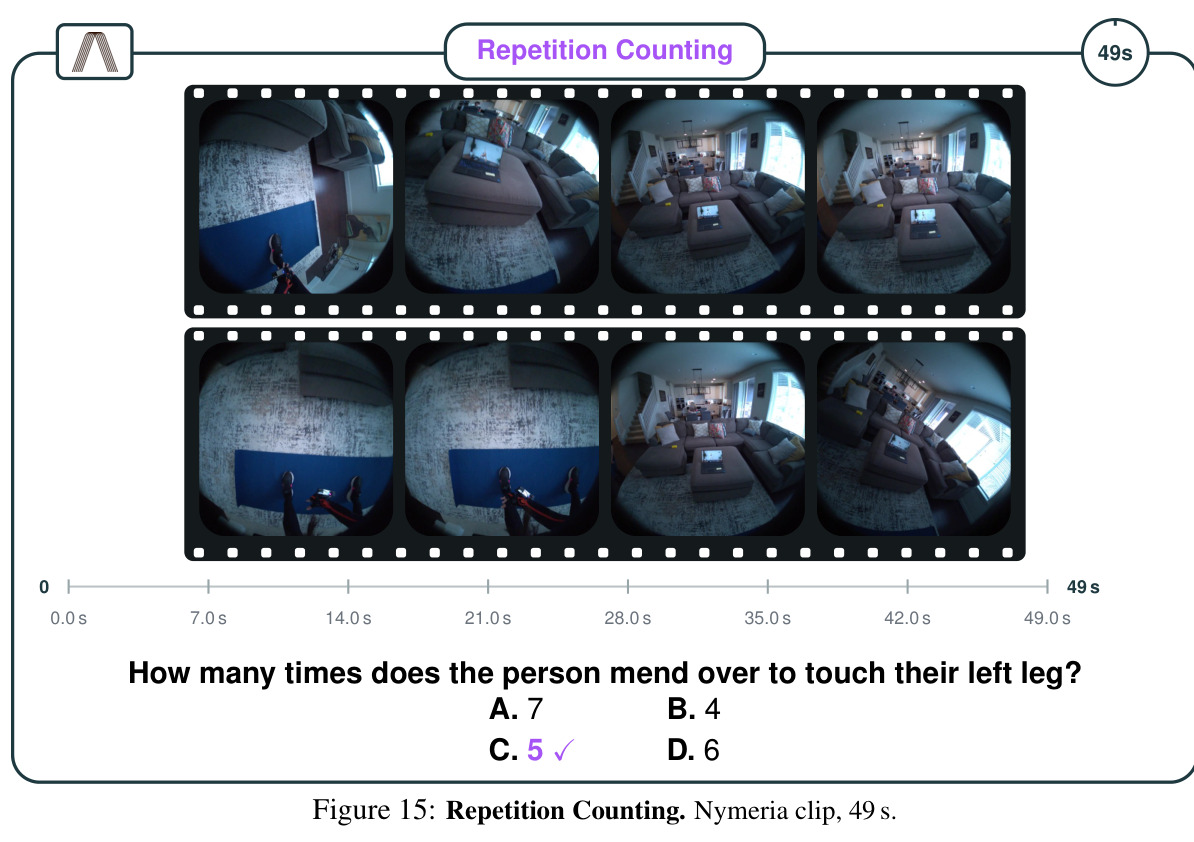
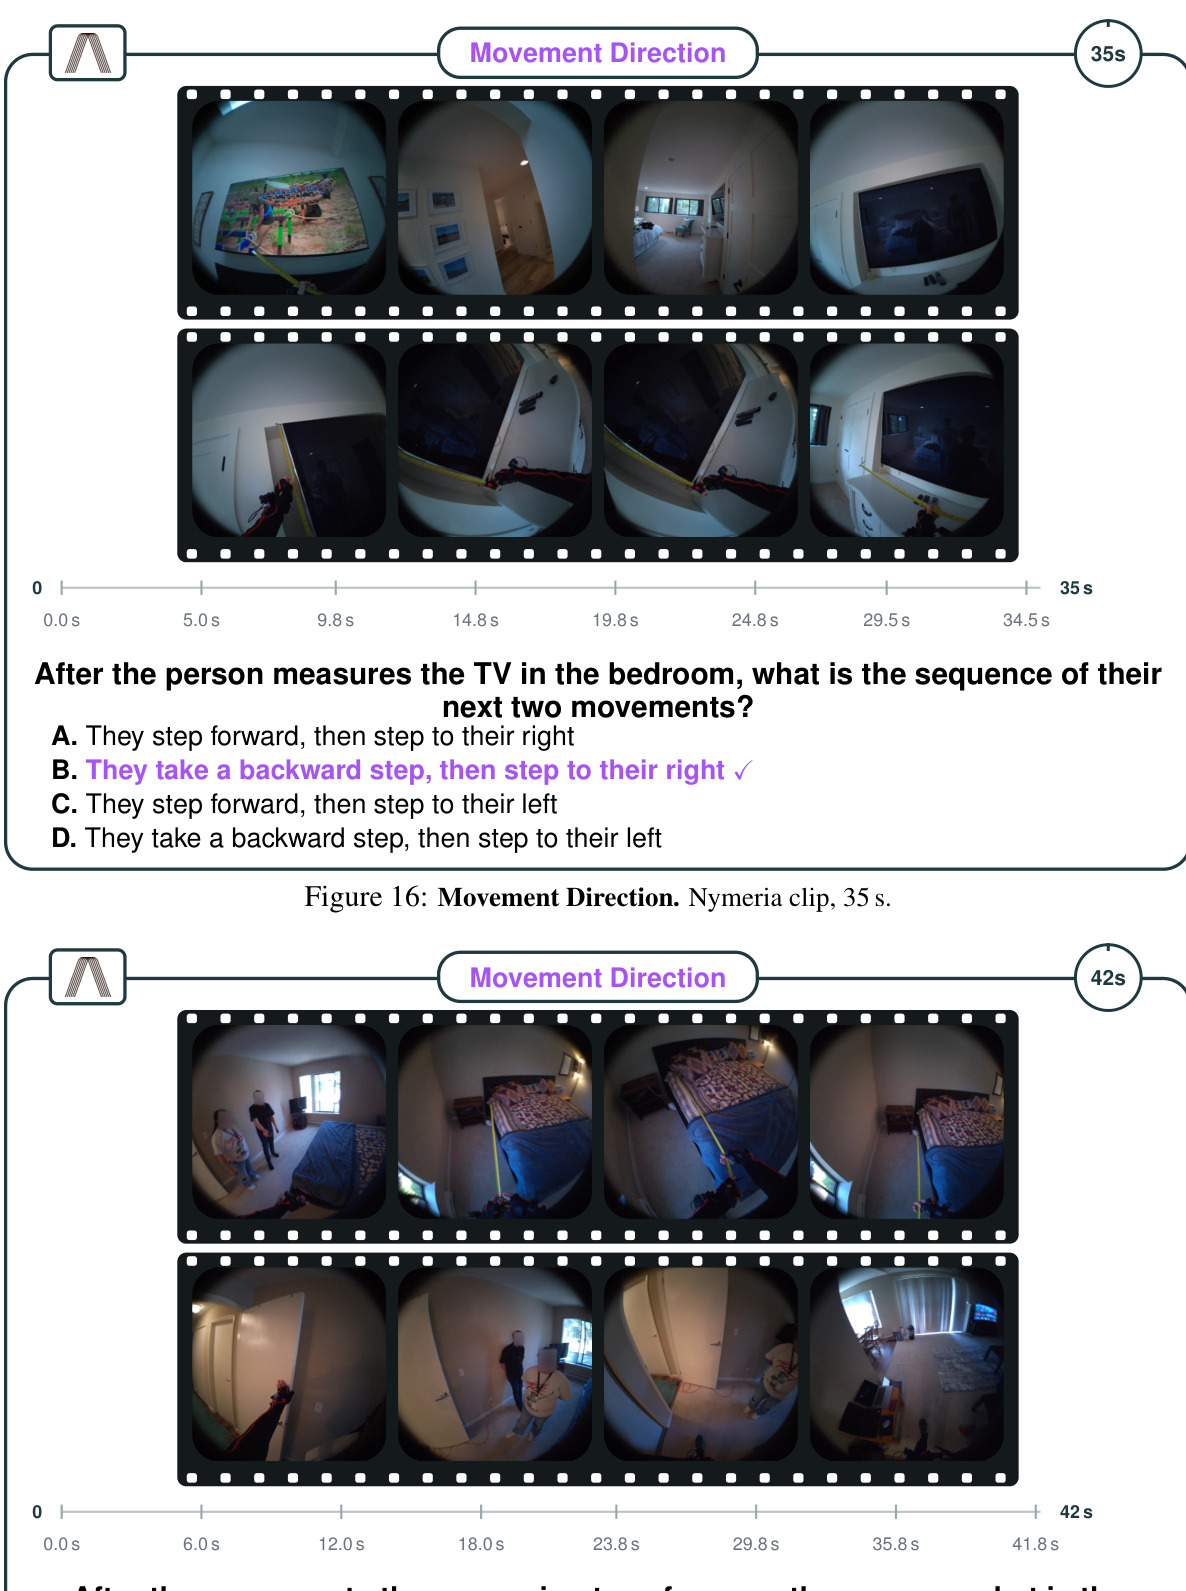
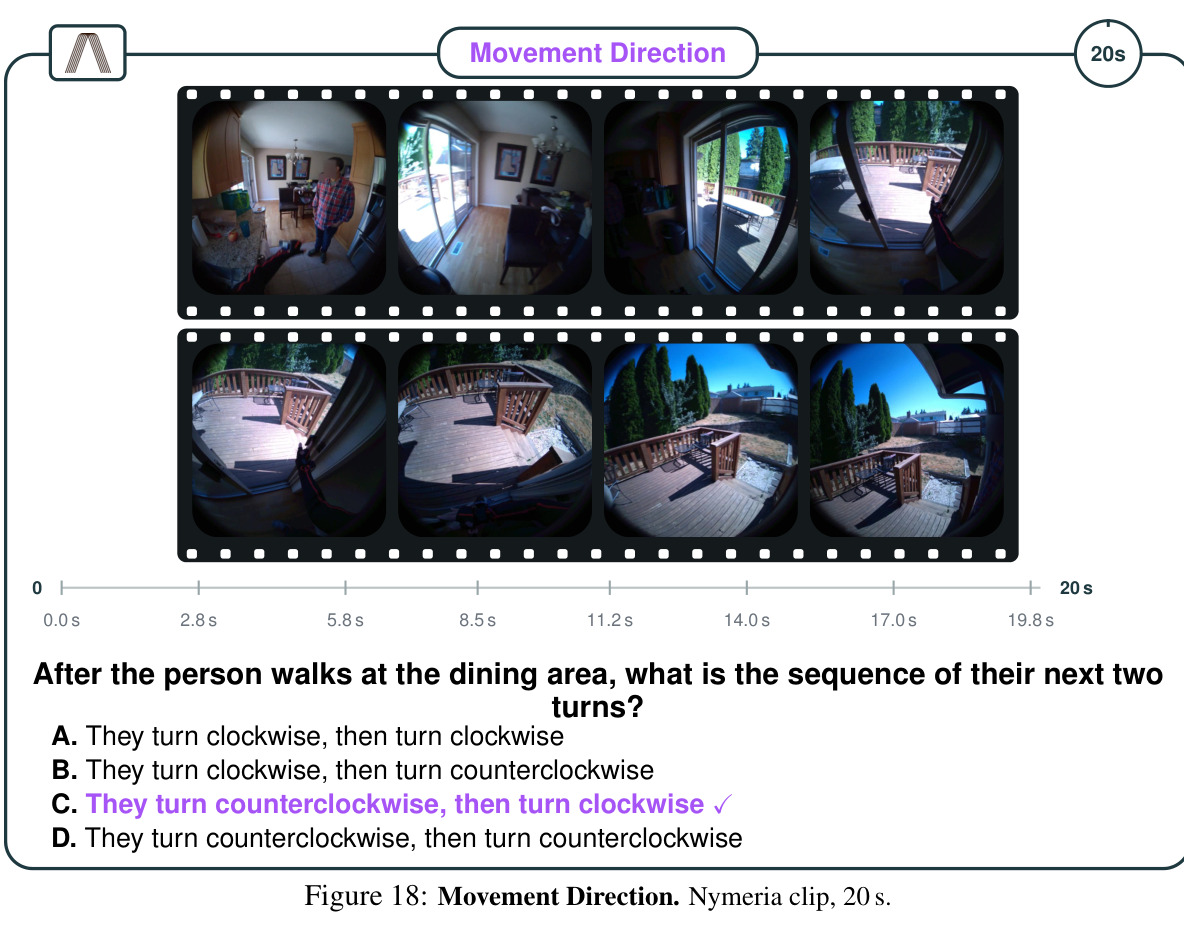
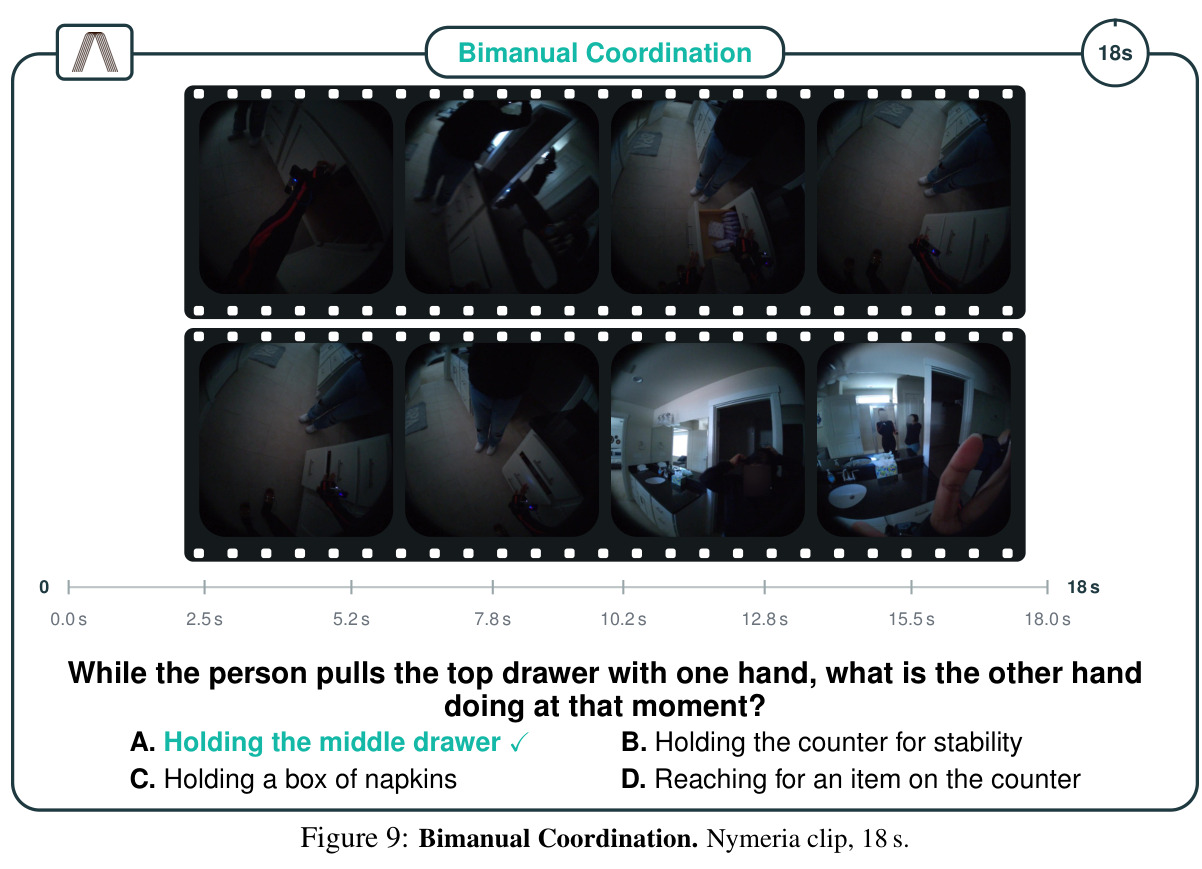
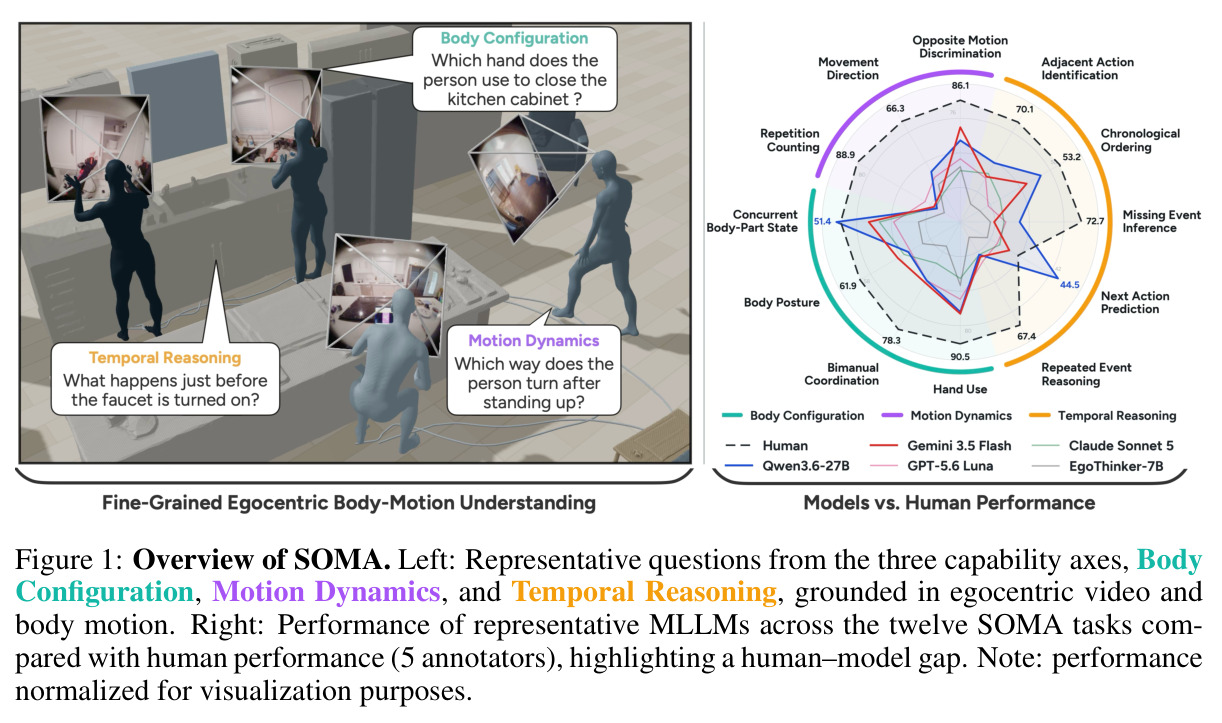
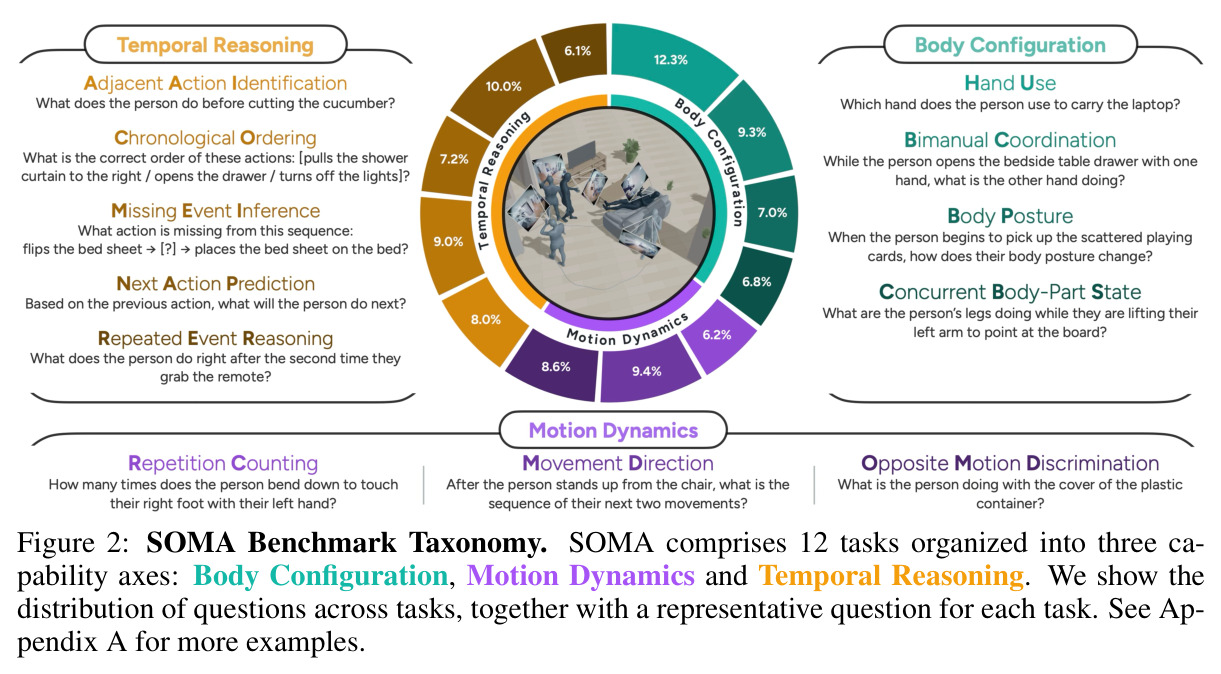
本文的目标是本文要量化并弥补这一空白,目标有四。第一,构建SOMA(希腊语'身体'):针对自我中心视频细粒度身体运动理解的多模态基准,含Body Configuration、Motion Dynamics、Temporal Reasoning三大能力轴共12个任务、1,632道全部经过人工验证的四选一题。第二,系统评测37个闭源、开源与自我中心专用MLLM,并让5名互不相关的人类标注者独立完成全部1,632题(共465小时),建立可靠的人类基线。第三,通过帧采样密度、thinking模式与CoT提示三组消融,检验推理期手段能否缩小人机差距。第四,发布SOMA-Train(110.2小时视频-20fps身体运动-语言三方对齐、28,596个QA)并训练video/motion联合基线,检验显式运动信号能否提供视频之外的互补信息。
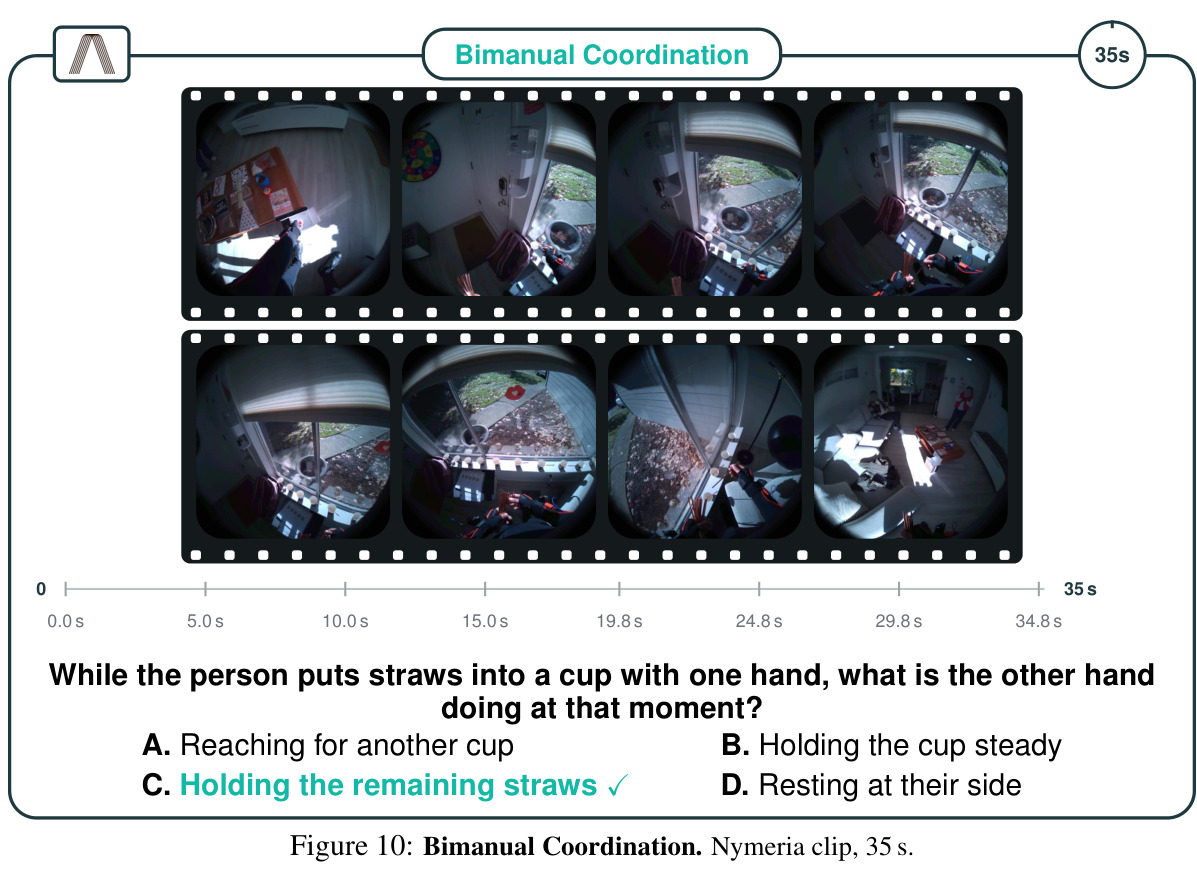
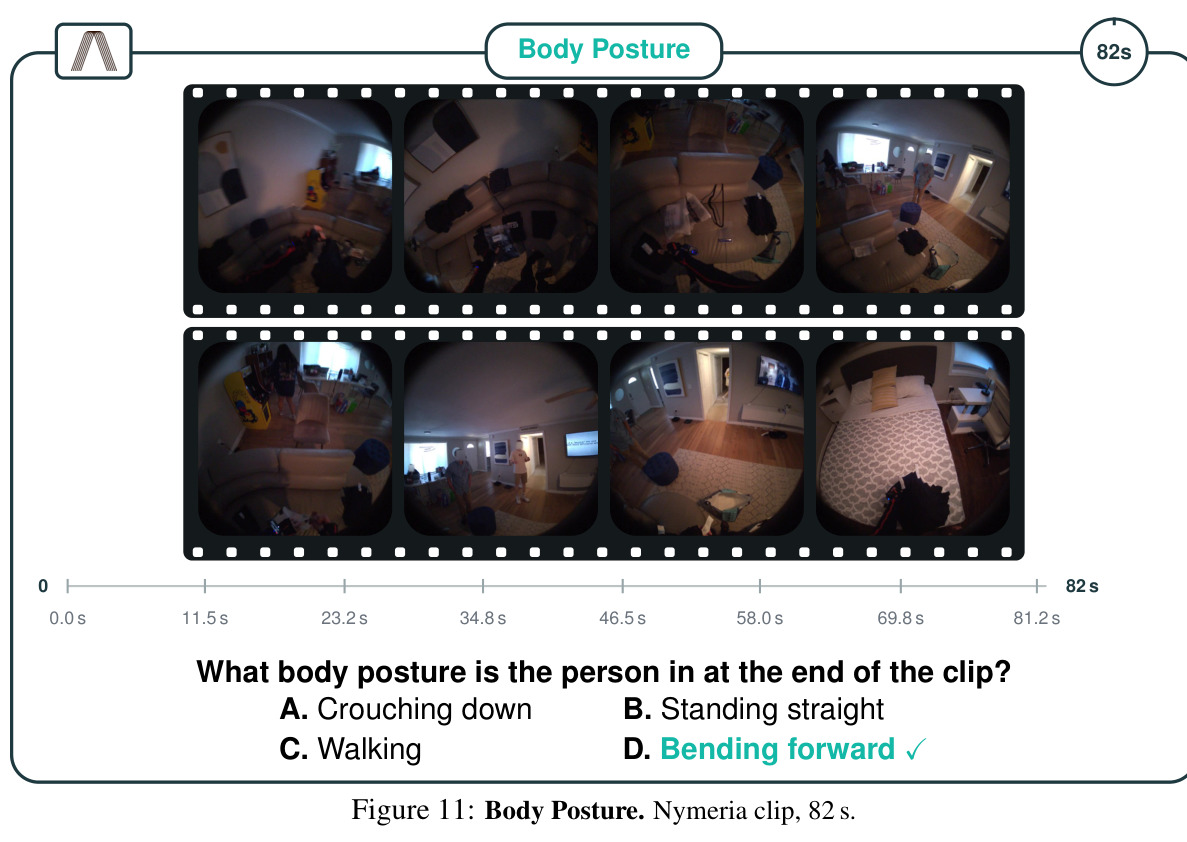
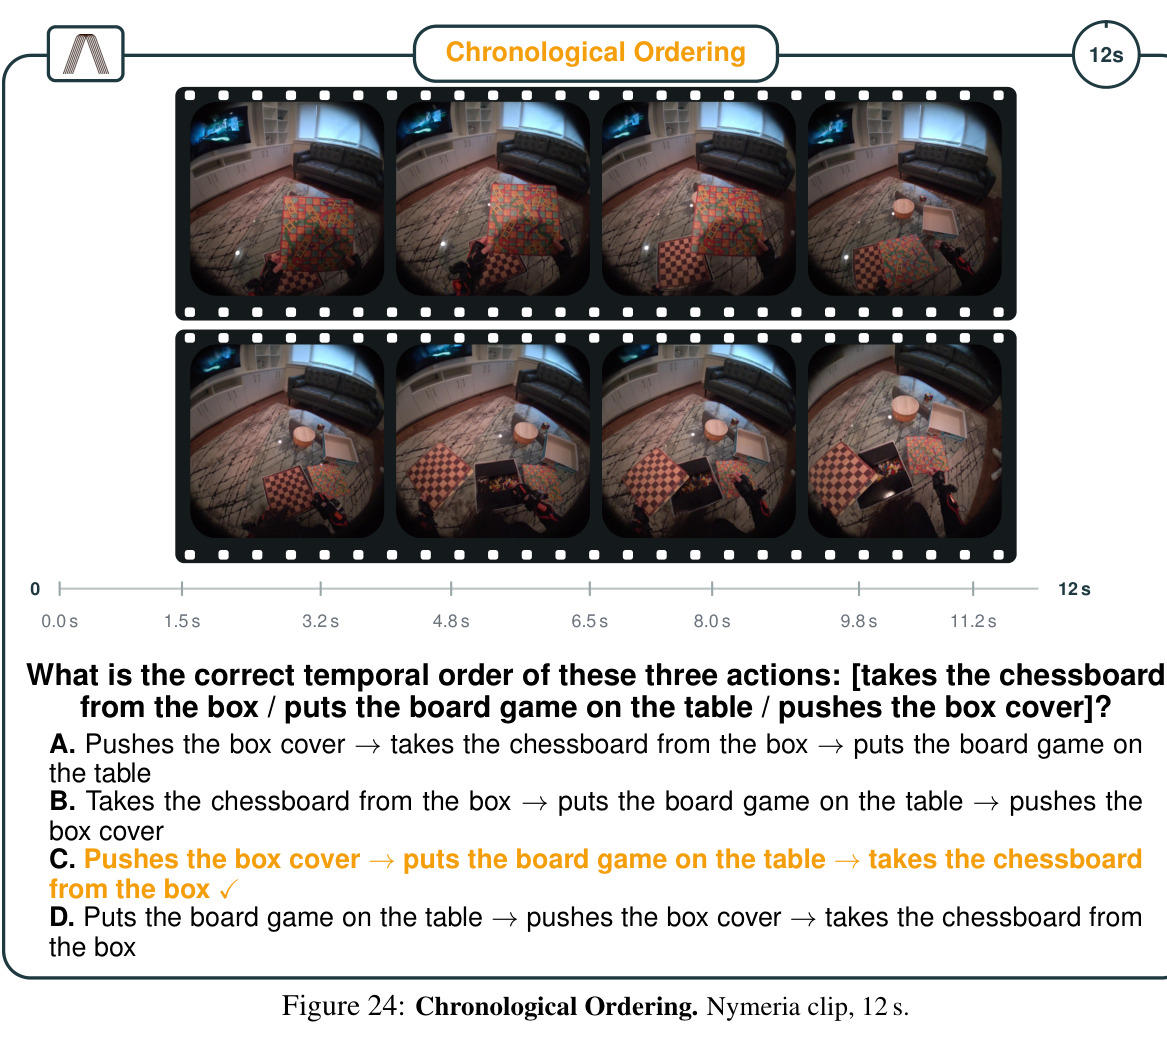
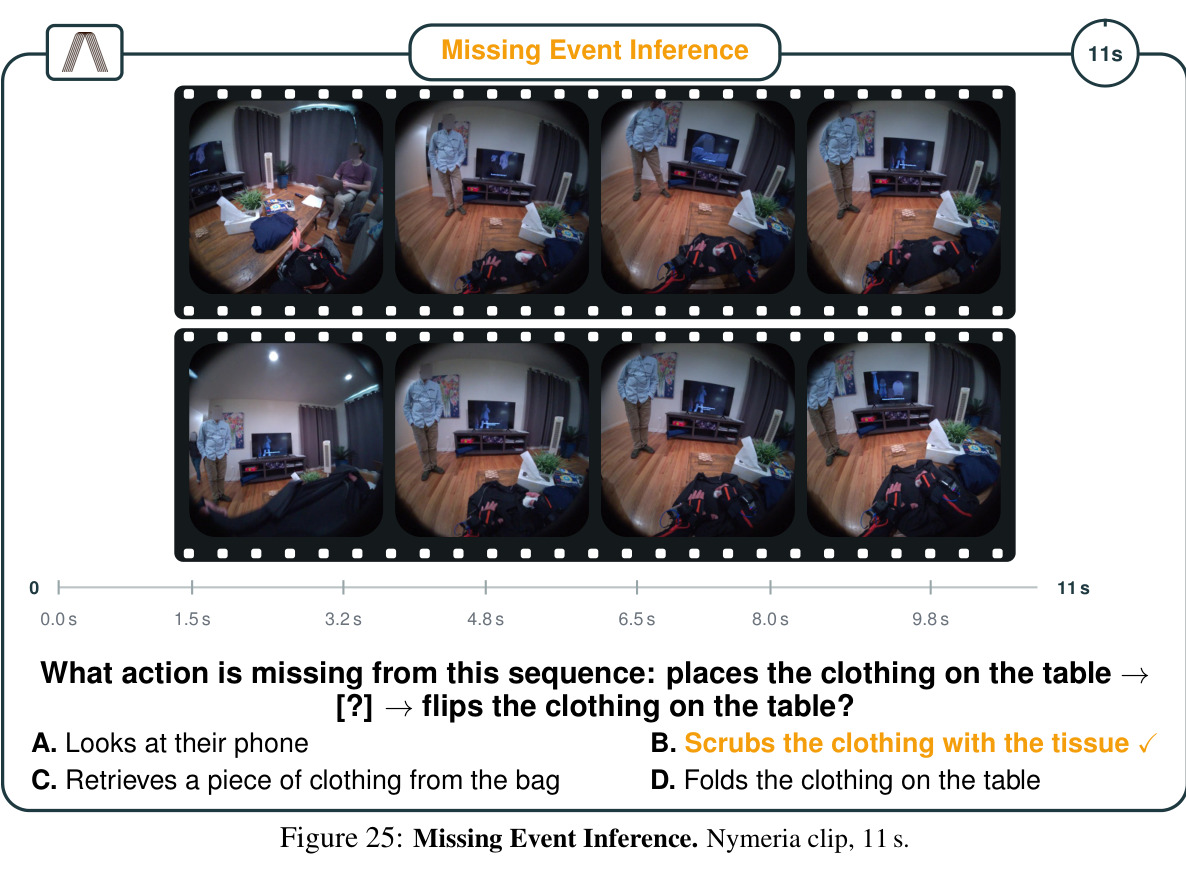
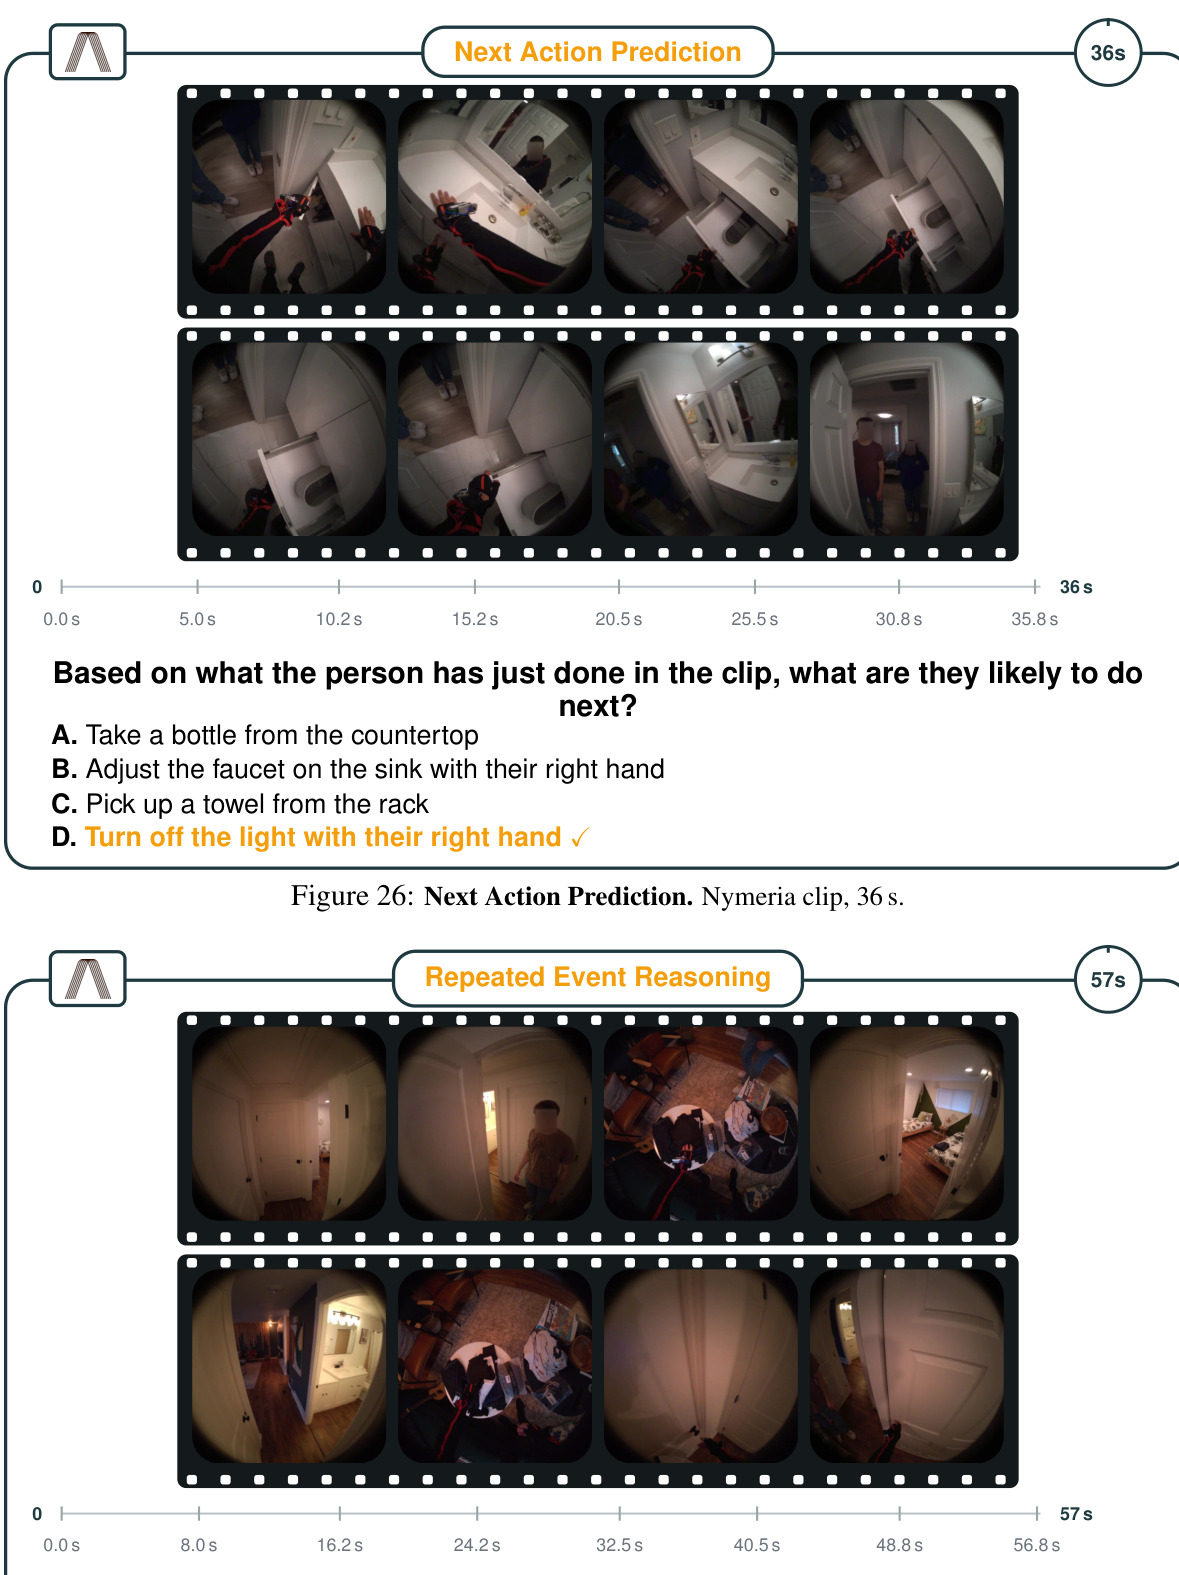
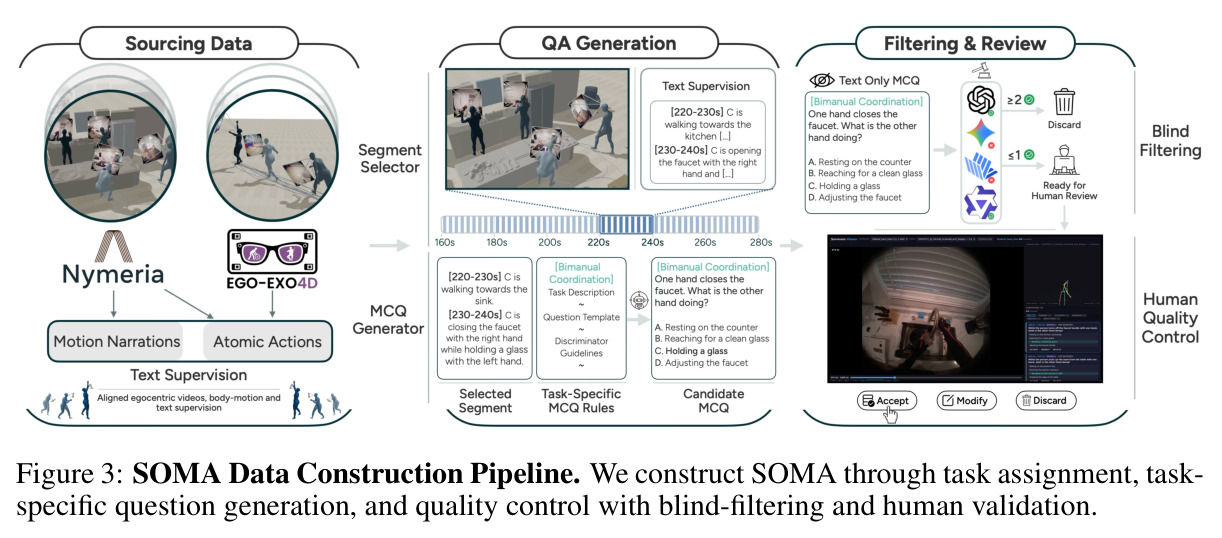
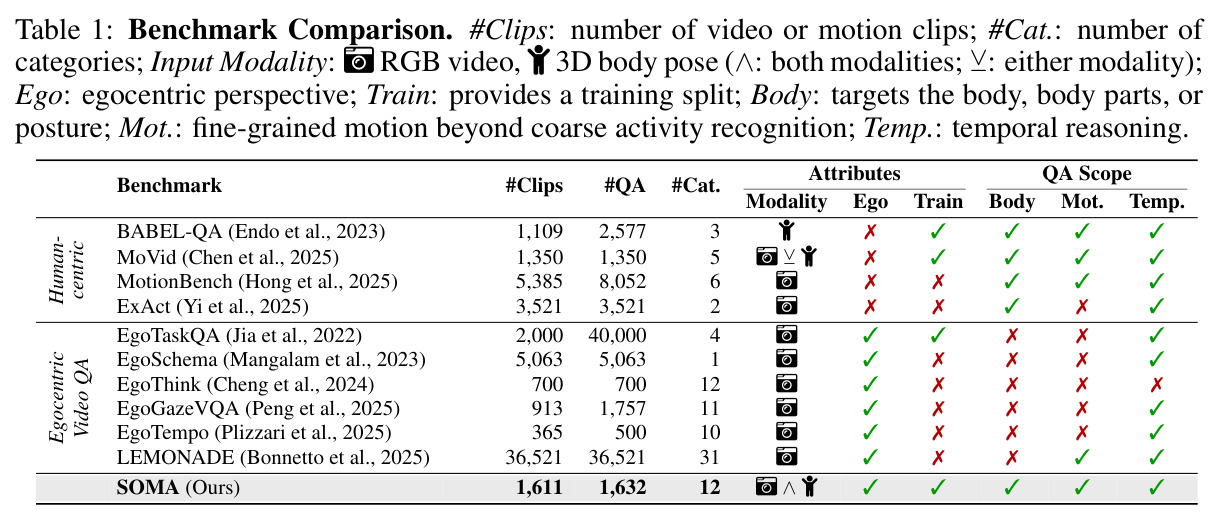
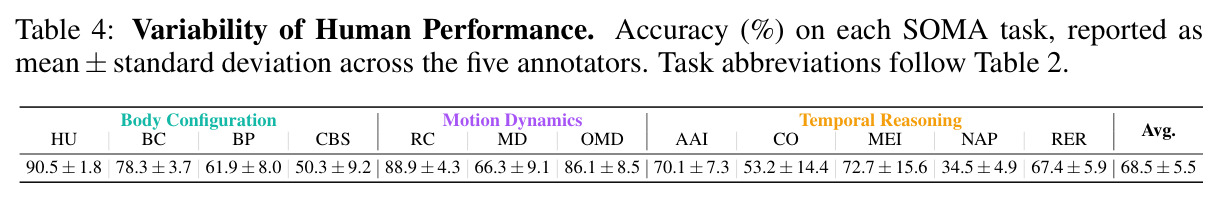
与已有工作不同的是,本文的独特切入是把'考感知'做到工程级严格。其一,题目不是自由撰写,而是从Nymeria的运动叙述(姿态/手部/腿部三路细粒度自然语言描述)与原子动作标注中按模板规则生成,正解与干扰项均有构造规则,从源头控制歧义。其二,blind-language过滤用4个LLM盲答删掉语言先验可解的题(45.9%),剩余题目逐题经人工对照视频与同步3D姿态渲染审核。其三,它是自我中心领域唯一同时具备训练集、RGB视频与3D姿态双模态输入、且同时覆盖Body/Motion/Temporal三属性的基准(Table 1)。其四,人类基线以465小时的真实作答给出均值与标准差(Table 4),而非估算。这些设计使'模型到底能不能看见身体'第一次成为可干净测量的问题。
核心方法
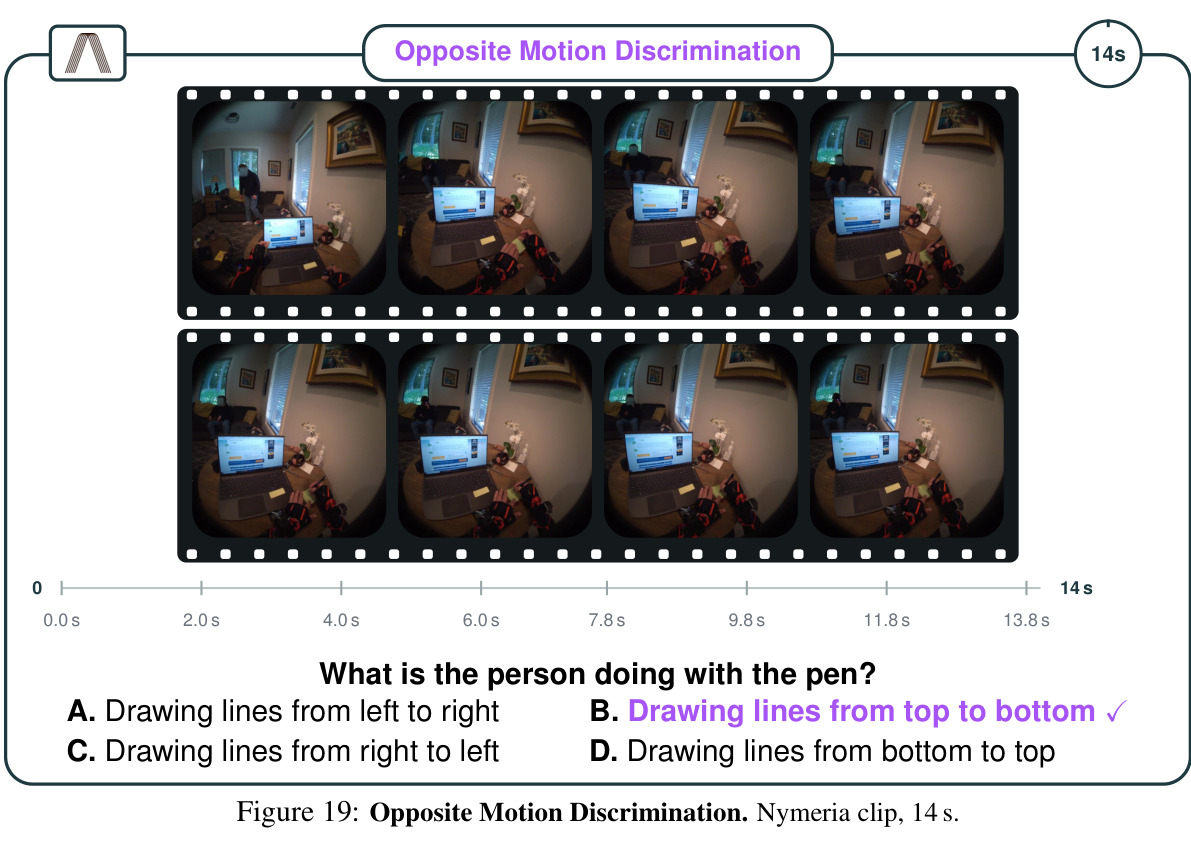
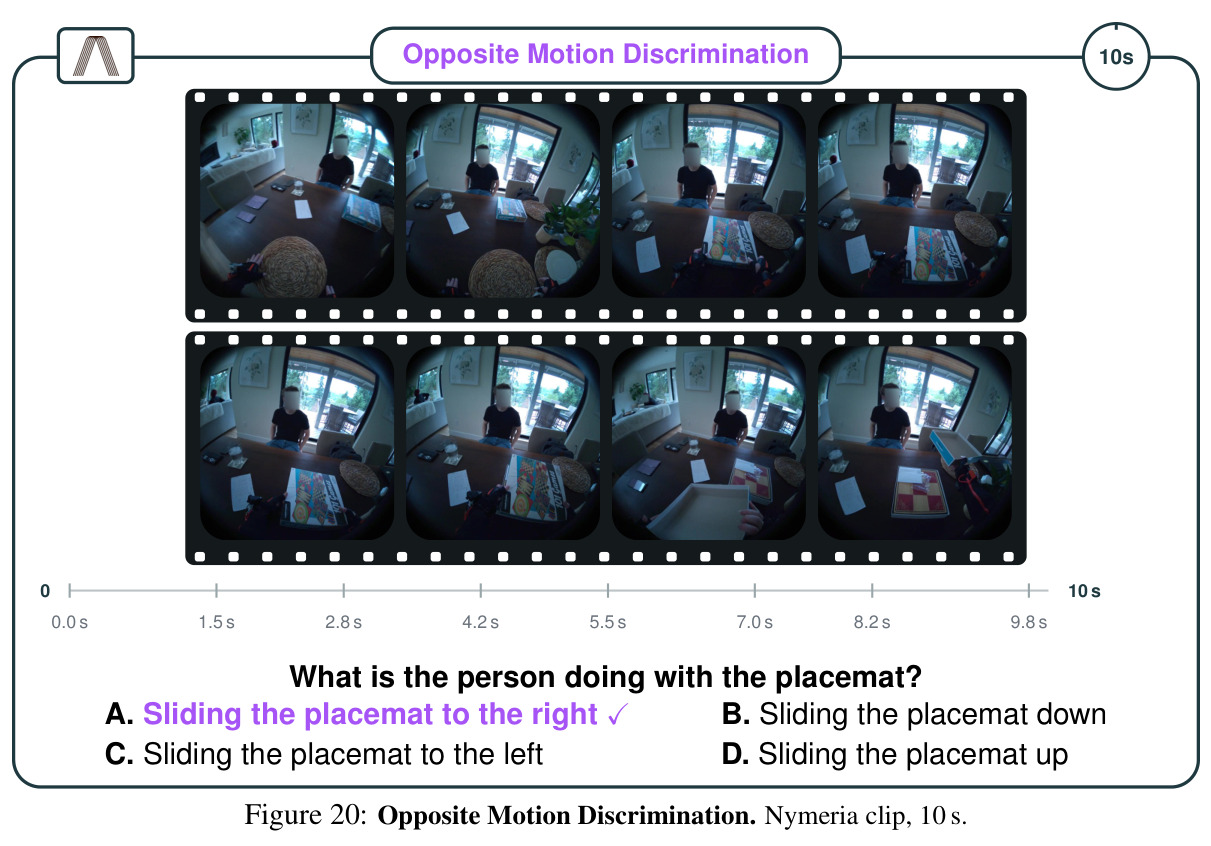
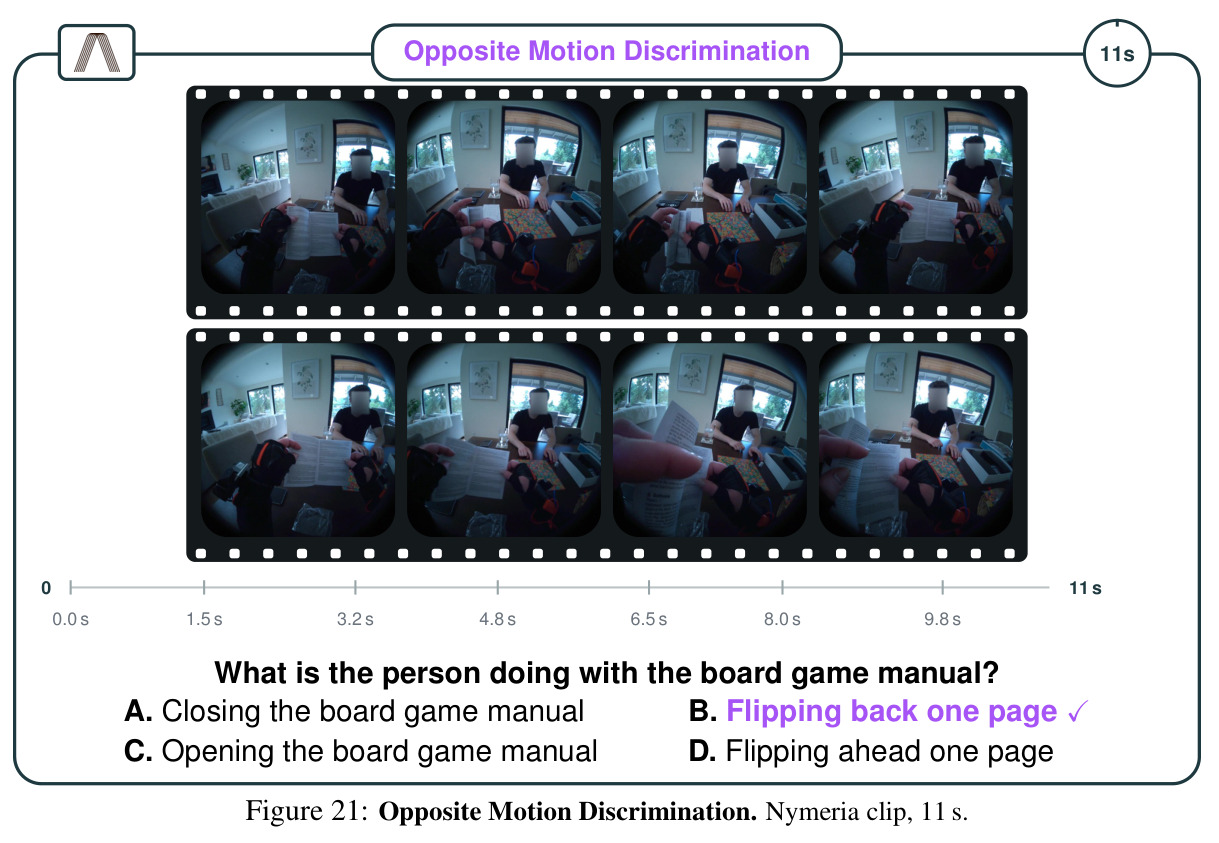
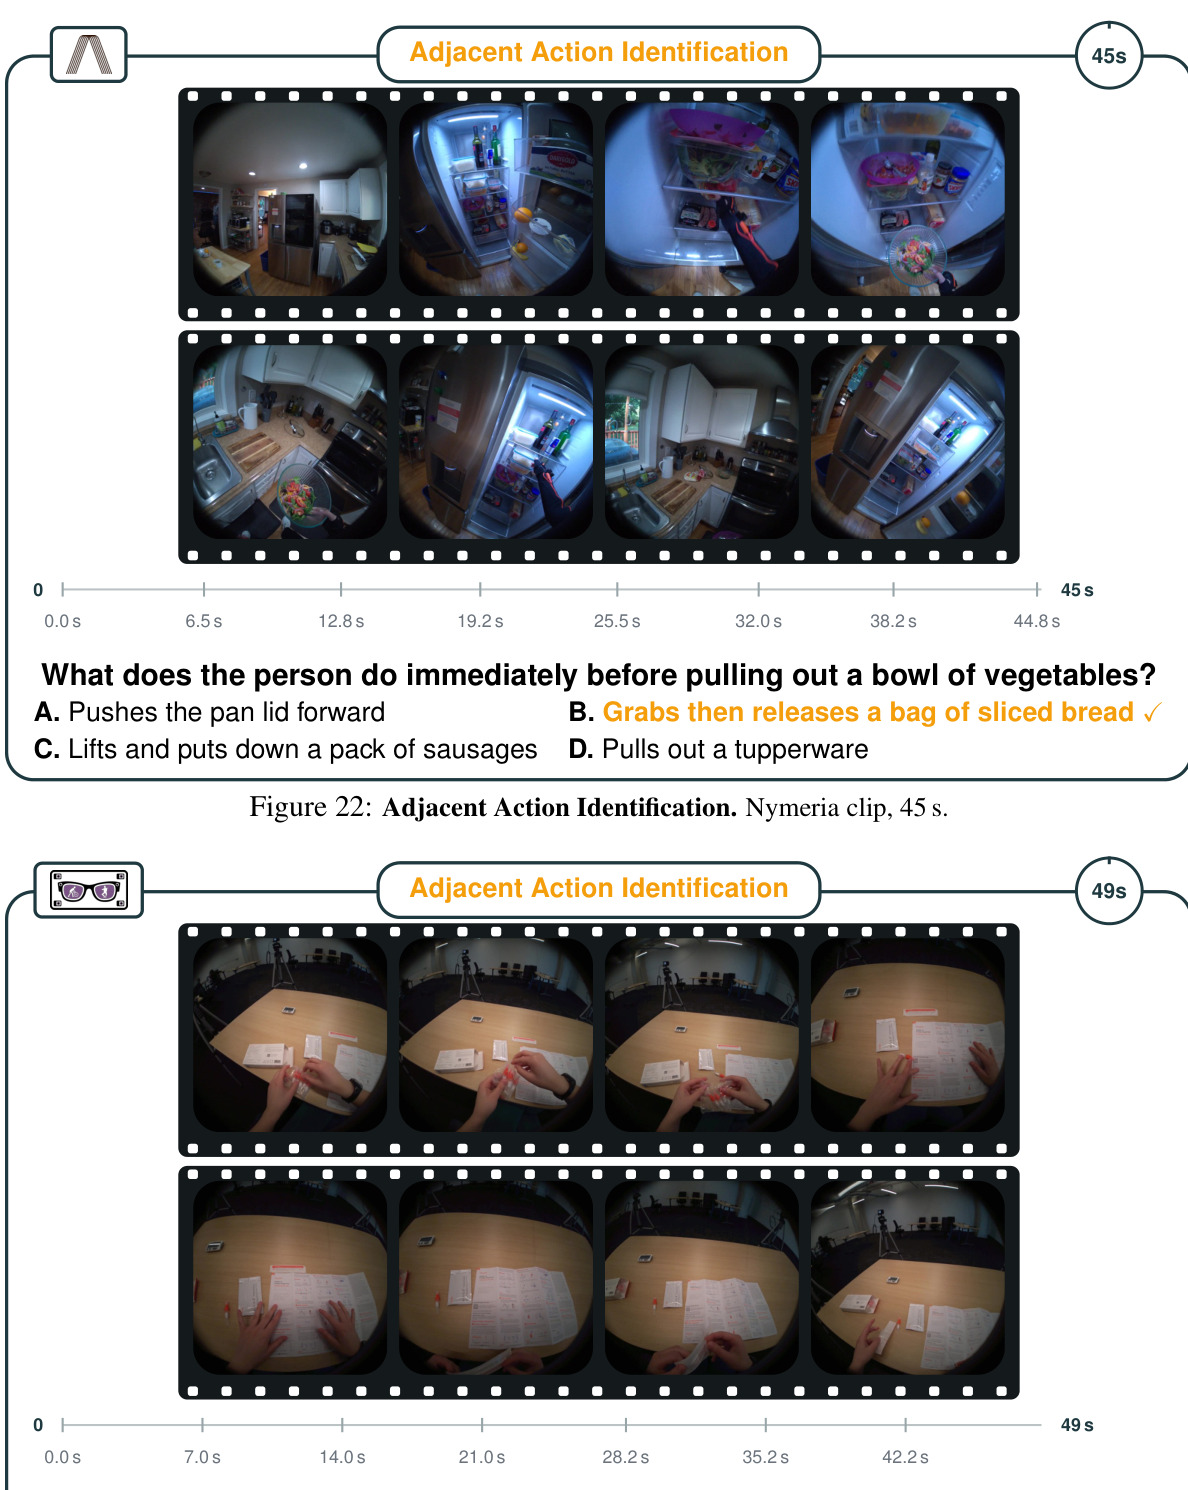
直觉上,要考'看懂身体'就必须保证答案只存在于视频里。技术路线是四阶段流水线(Figure 3)。阶段一'数据与任务分配':从Nymeria与Ego-Exo4D取原子动作标注 $A=\{(a_j,\tau_j)\}$ 与Nymeria特有的运动叙述 $M=\{(p_j,h_j,\ell_j,\tau_j)\}$(姿态/手部/腿部),丢弃会产生平凡问题的域-任务对(如双手闲置时问用哪只手)。阶段二'题目生成':Gemini 2.5 Flash先作selector挑出任务相关子段,再由generator按固定模板产出1个正解+3个干扰项,共3,928个候选;Repetition Counting例外,101题由人工对照视频与3D姿态手动标注。阶段三'盲语言过滤':Gemini 2.5 Flash、GPT-4o、Qwen2.5-72B、InternVL3-78B四个模型不看视频作答,≥2个答对即删,共删1,801题(45.9%)。阶段四'人工审核':界面同步视频与3D姿态渲染,逐题接受/修改/删除(945/586/596),最终1,632题、1,611个片段,平均35.6秒,答案分布均衡。
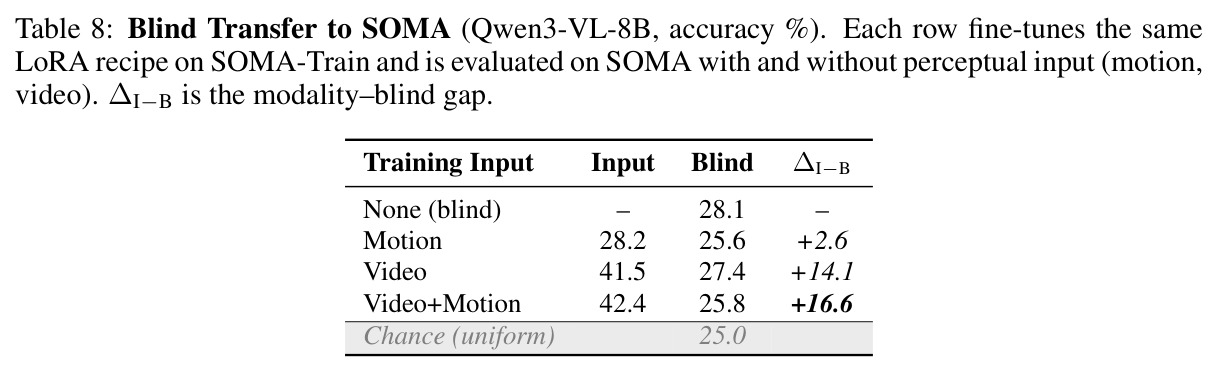
核心创新有三点。第一,'以真值标注为锚的问题工程':题目内容被约束在ground-truth运动标注之上,正解与干扰项按规则构造,这与让LLM自由出题、事后人工抽查的主流做法有本质区别——生成器几乎没有自由发挥空间,题目忠实反映源标注。第二,盲语言过滤将'语言可解'系统性移除:Body Posture被删62.4%、Hand Use被删53.7%(答案空间小、先验强),而依赖多事件时序结构的Repeated Event Reasoning只删30.8%,说明过滤精准命中了先验可解的题型,把基准推向纯感知。第三,SOMA-Train不只是'更多的同类题':它在构造层面保证无语言捷径(闭集使 $P(g\mid s)=1/4$、上下文内旋转正确答案、可交换选项集、对Chronological Ordering做对抗过滤),并用'盲训练迁移'验证——只用文本微调的模型在SOMA上仅28.1%,接近25%的随机线,而video+motion版本领先盲模型16.6分(Table 8),证明微调收益来自感知而非分布捷径。
方法步骤详情
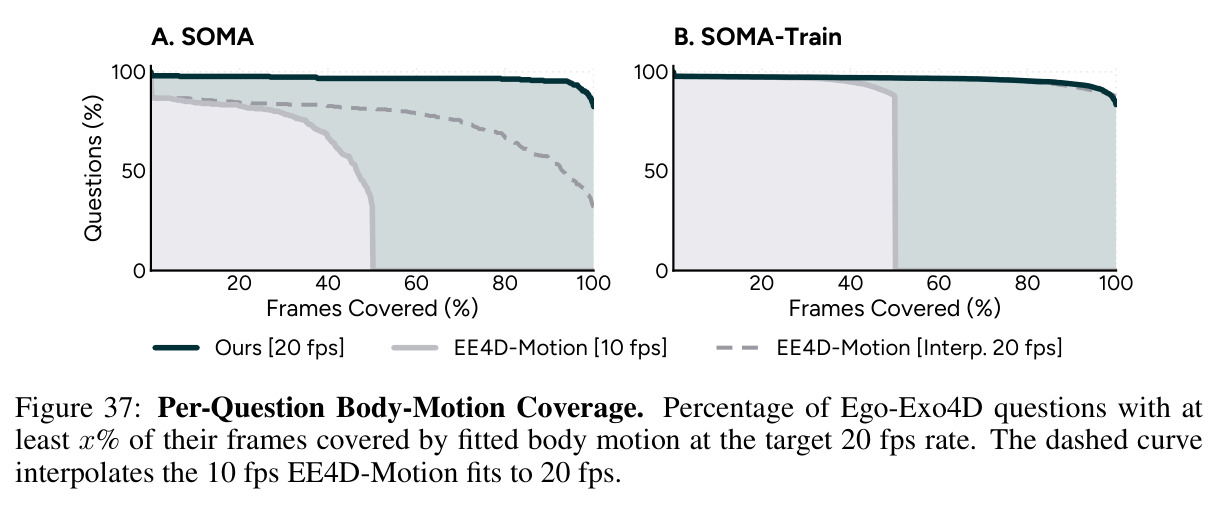
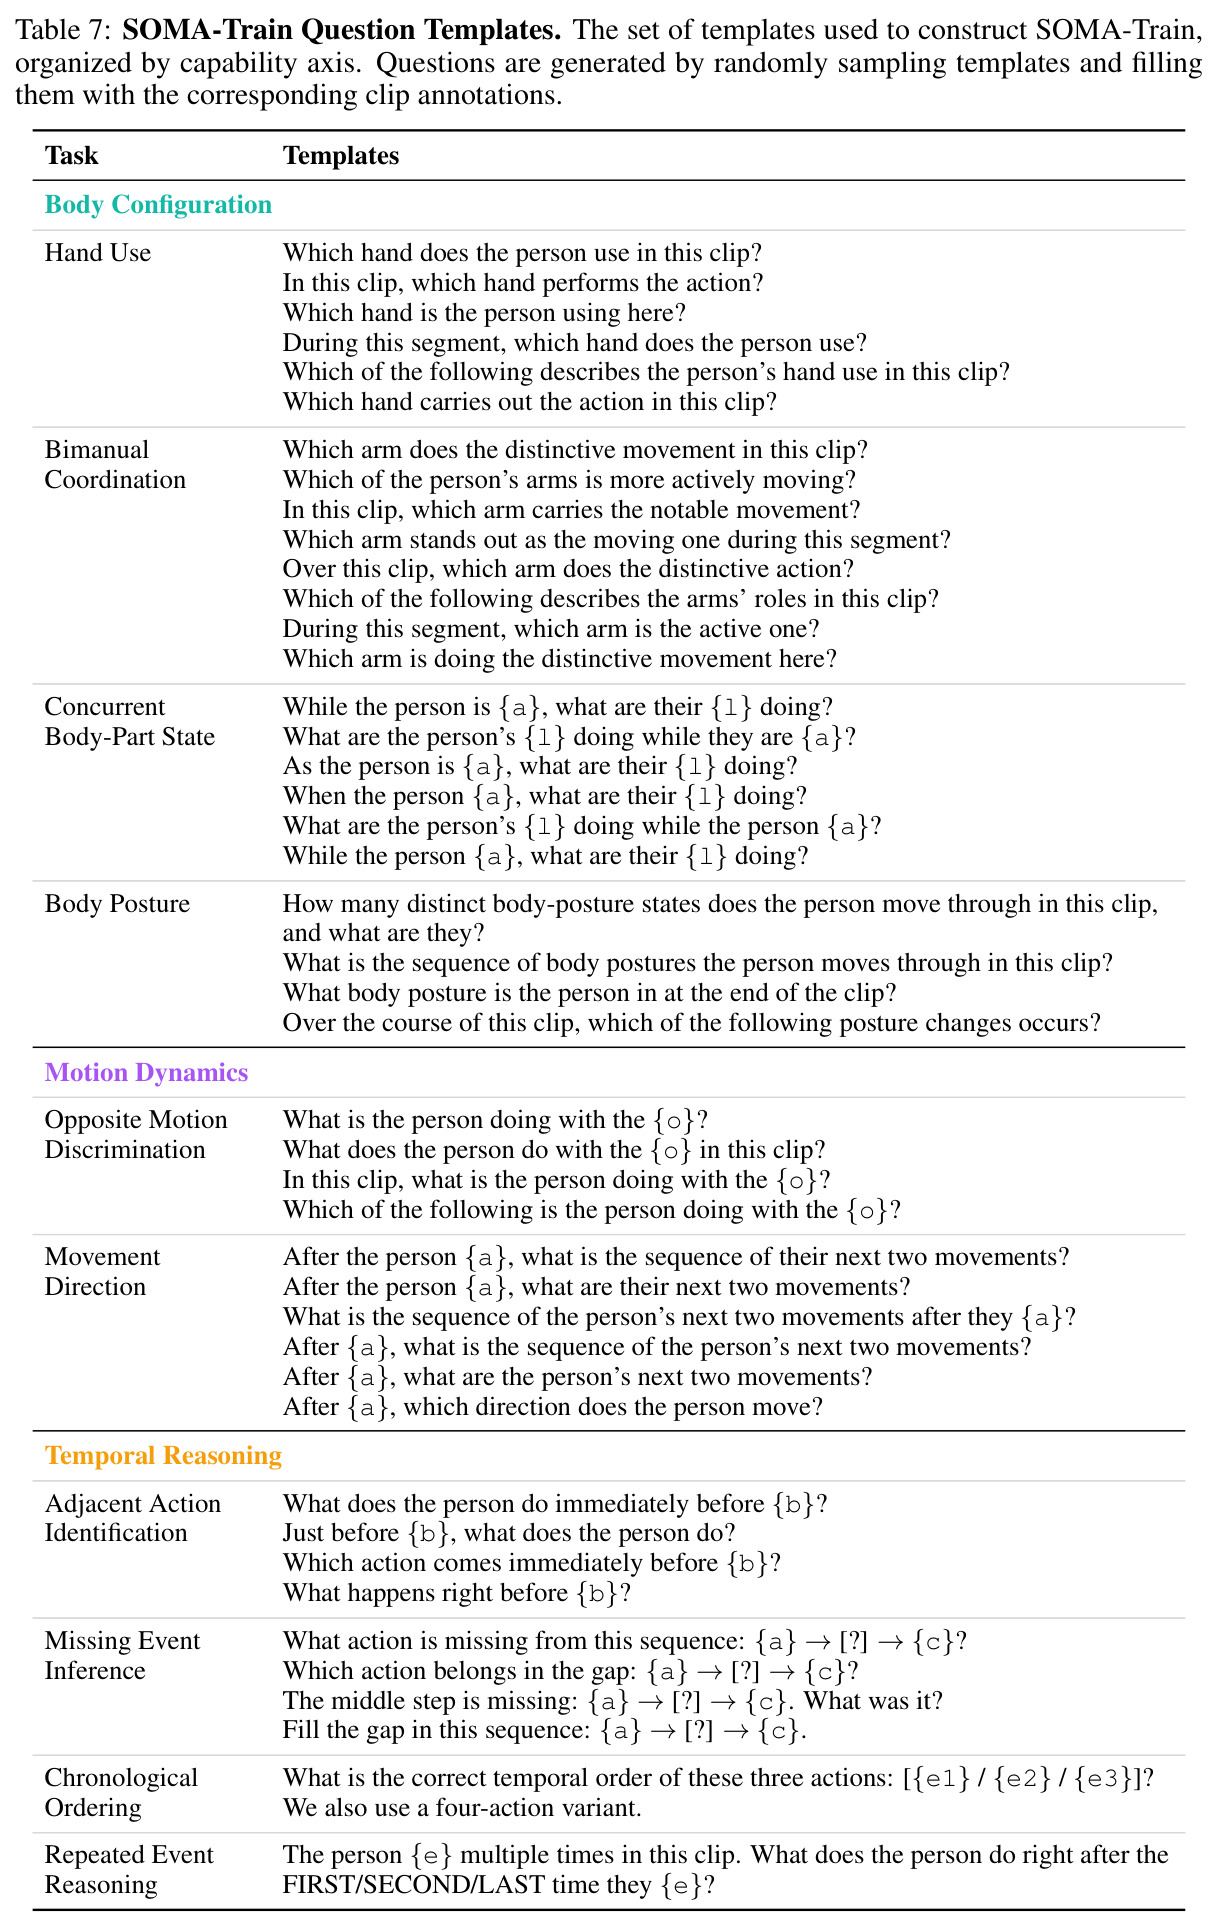
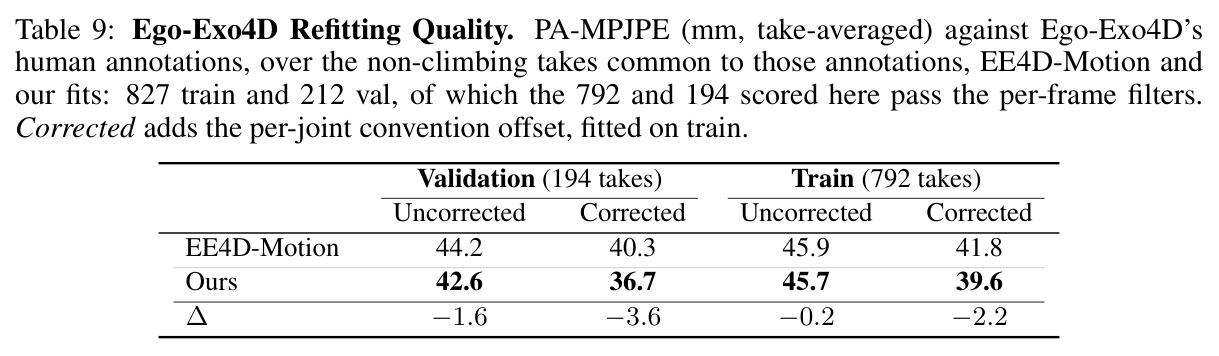
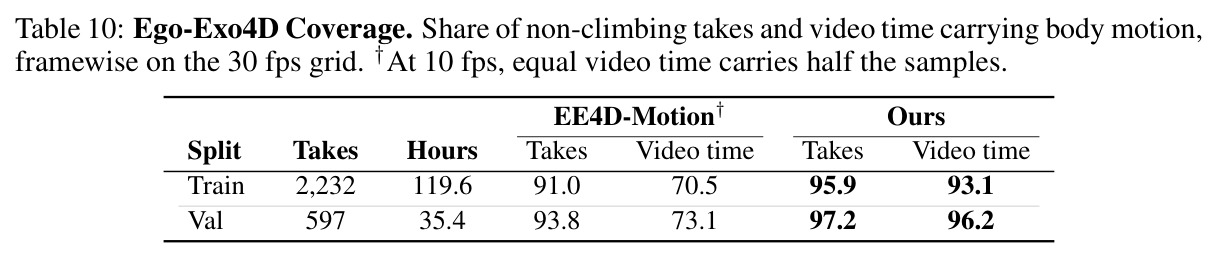
流程分六步。(1)运动重建:Nymeria直接可用;Ego-Exo4D原拟合仅10fps且覆盖不全,作者用RF-DETR检测、Aria轨迹定位佩戴者、SAM 3D Body逐视角估计、多视角SMPL-X联合优化重建20fps运动(PA-MPJPE 36.7mm、覆盖96.2%,均优于原EE4D-Motion拟合),转为263维表示。(2)题目生成:selector从标注流挑任务相关子段,generator输出四选一MCQ。(3)盲语言过滤:四个LLM盲答,删1,801题(45.9%)。(4)人工审核:接受945、修改586、删除596,加101道手动计数题,得1,632题。(5)SOMA-Train:28,596题、110.2小时对齐视频-运动-语言,确定性正则抽取+模板填充+构造性干扰平衡+语法事实校验,与评测集在参与者与场景层面不相交。(6)基线训练:冻结的VQ-VAE编码器(每4帧一个latent);Stage 1以24,549个运动-叙述样本对齐projector(学习率 $10^{-3}$);Stage 2以LoRA(rank 128)在8×H100上微调三个输入变体。
技术新颖性
横向对比Table 1可见其新颖性:BABEL-QA、MoVid、ExAct依赖第三人称或动捕输入且无自我中心视角;EgoSchema、EgoTaskQA、EgoThinker、LEMONADE等虽用ego视频但只考长视频理解、任务推理、第一人称思维或活动级理解,无一针对'运动中的身体'。SOMA是唯一同时满足ego+train+Body+Mot.+Temp.并支持RGB视频与3D姿态双模态(表中记号∧)的基准。评测方法学上也有多处新意:465小时人类评测(多数基准无人类对照或仅少量抽样)、生成器偏差的双重缓解(模板约束+生成器Gemini本身参与盲筛)、错误分析用GPT-5.1与Gemini 2.5 Pro双judge对照真值标注判定四类错误(一致率80.0%,Cohen's $\kappa=0.69$)、以及训练集的盲迁移去偏验证——这些严谨设计在VQA基准文献中都属少见,使SOMA既是评测工具也是一套可复用的基准构建方法论。
实验结果
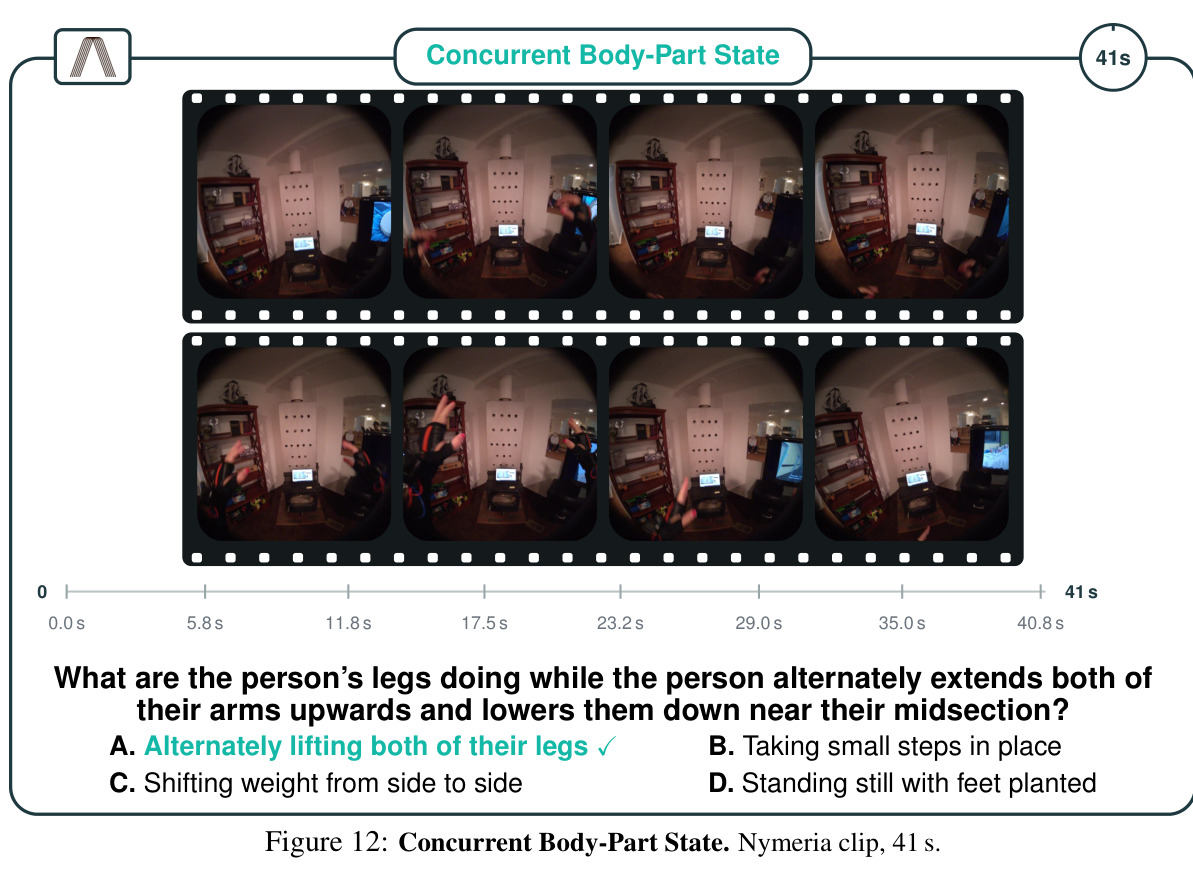
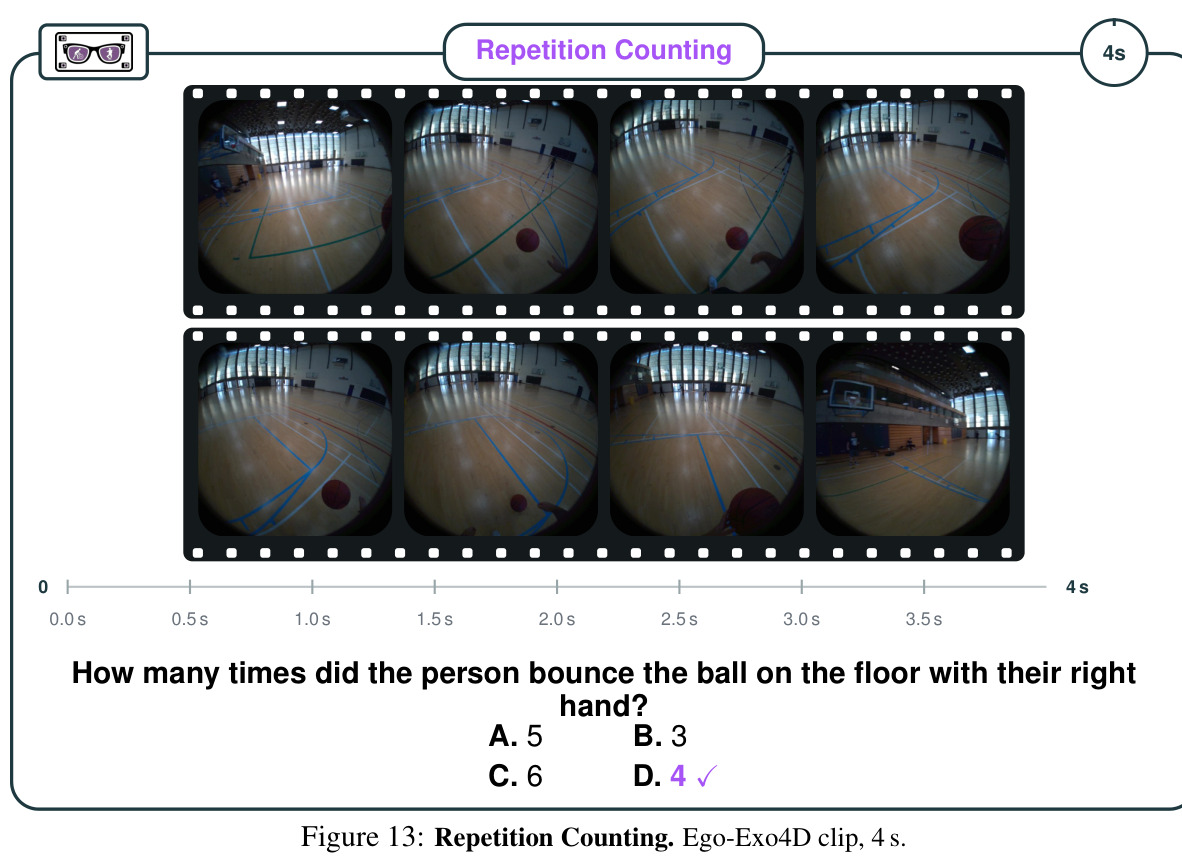
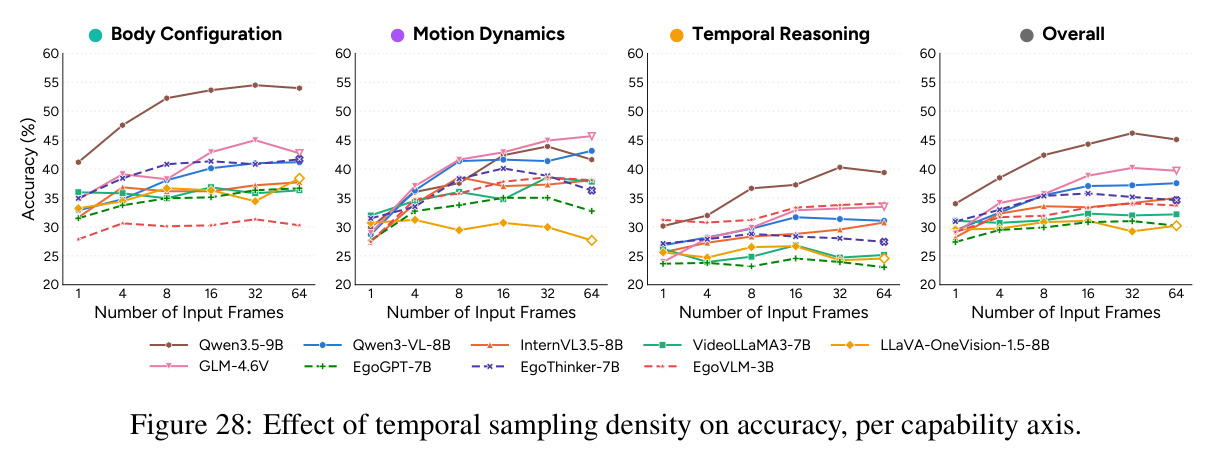
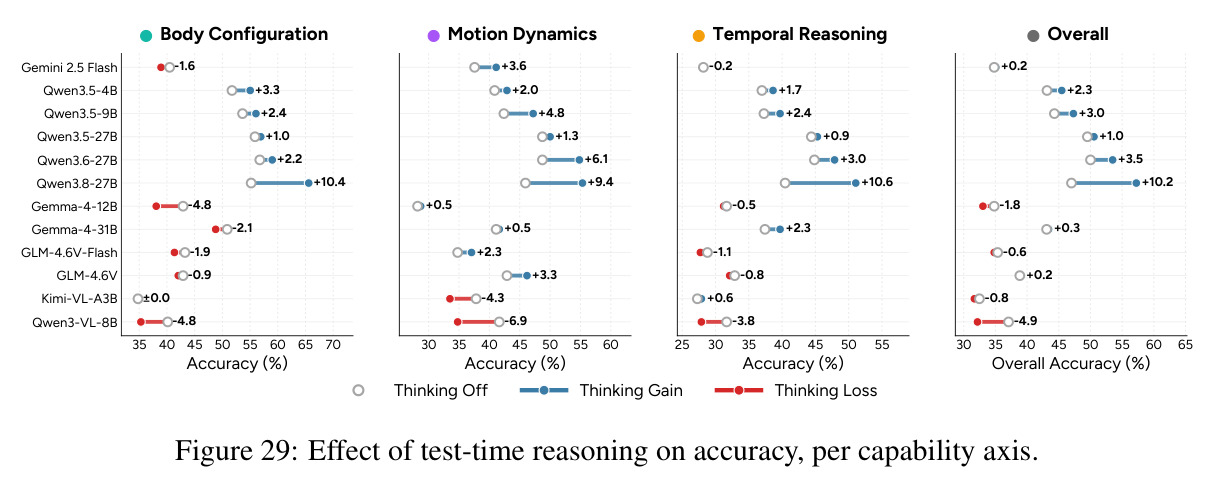
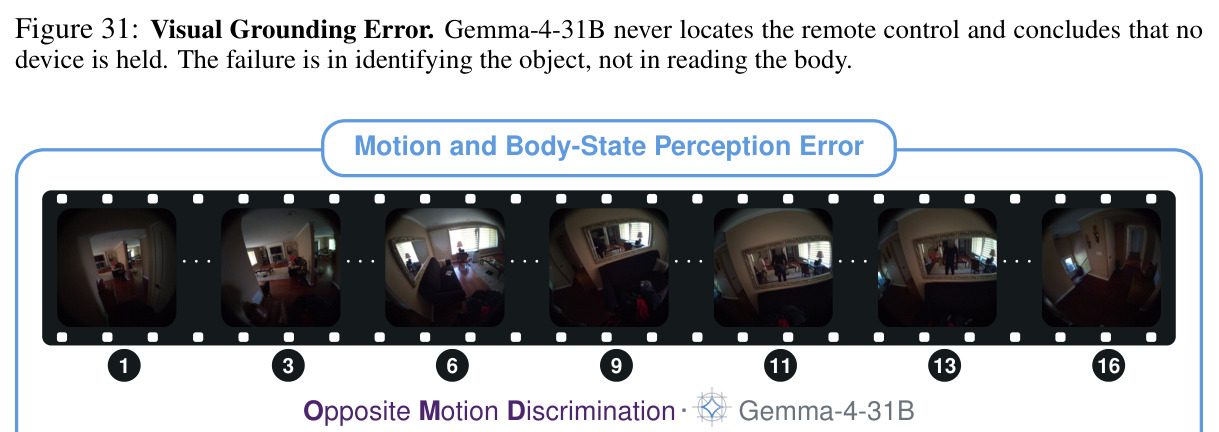
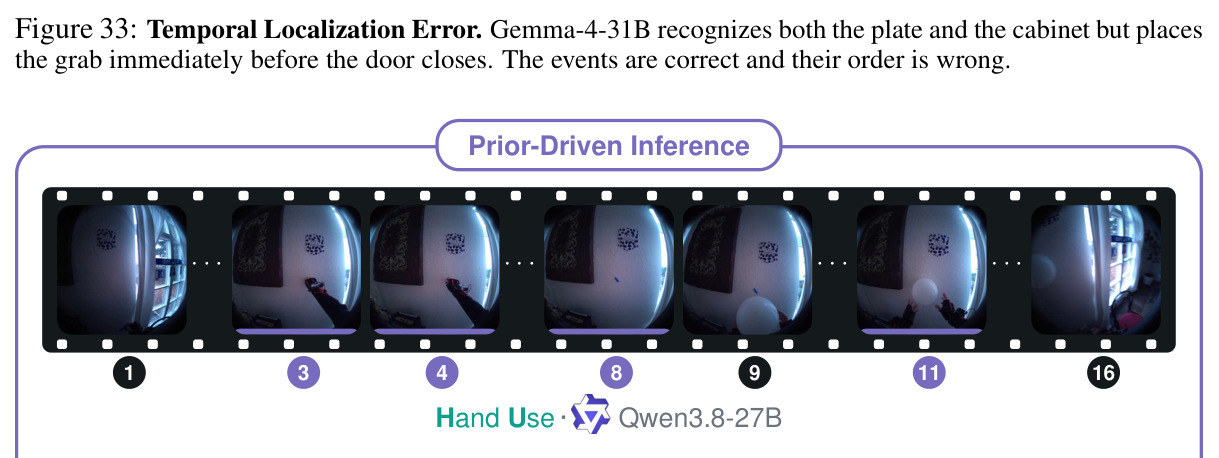
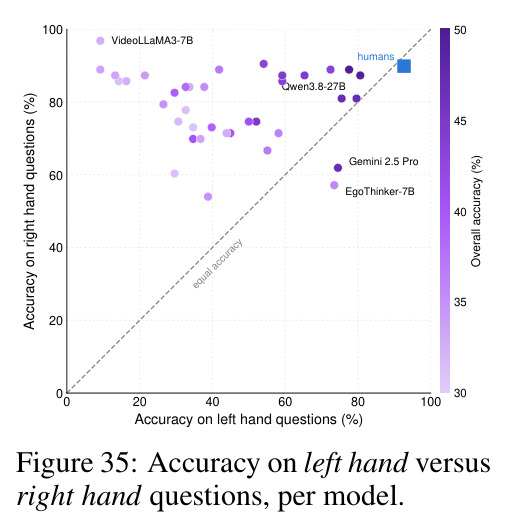
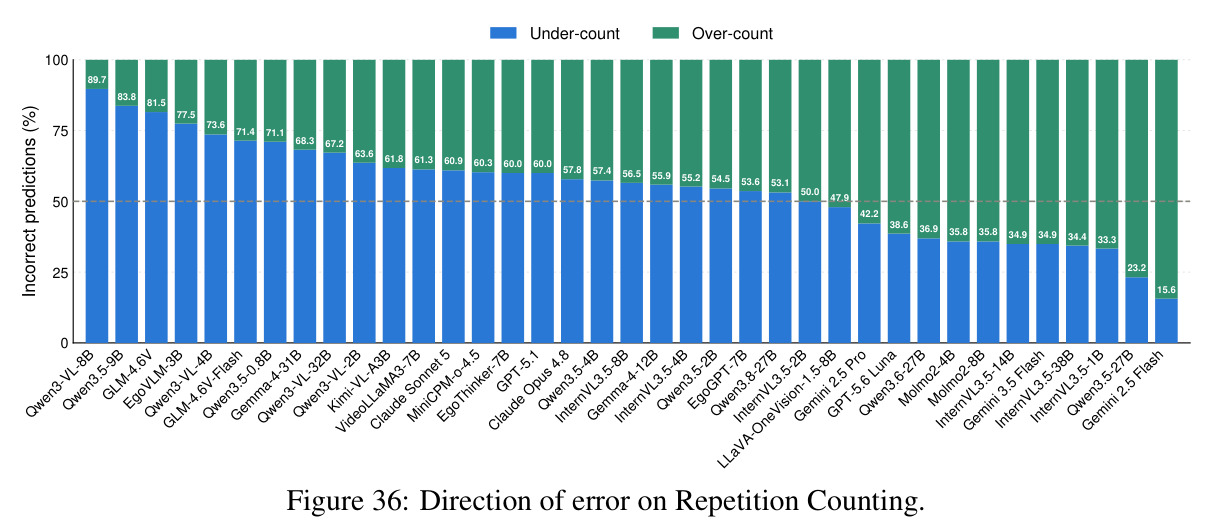
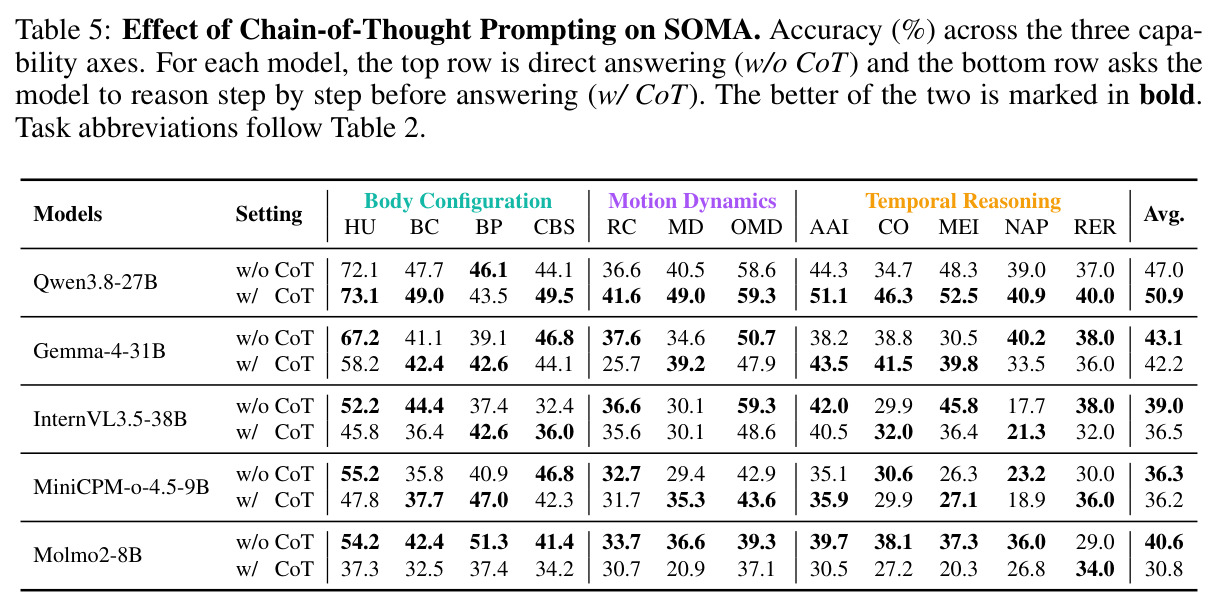
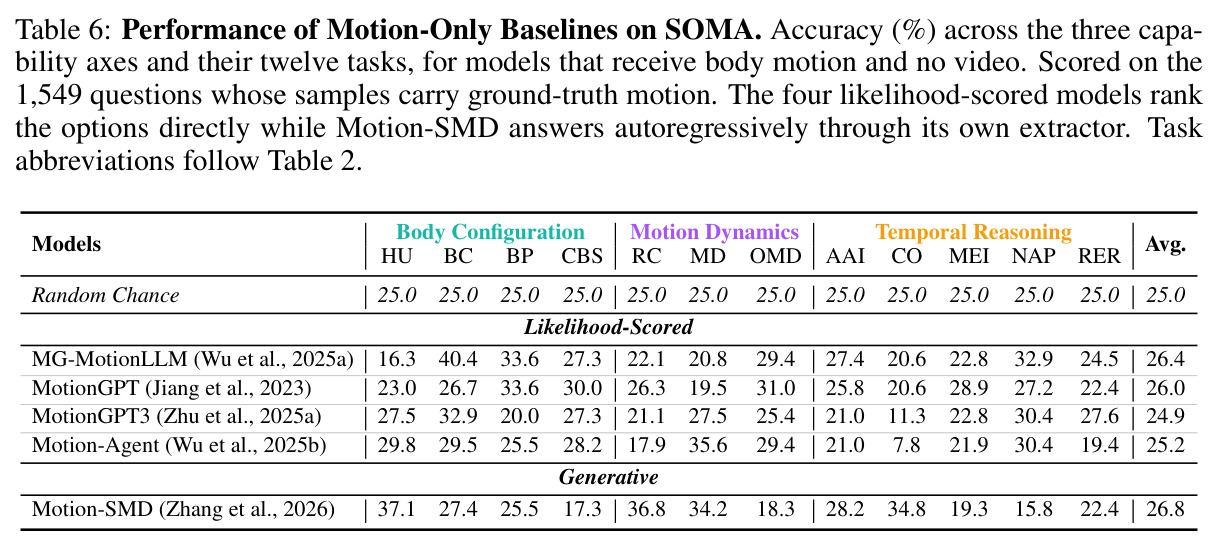
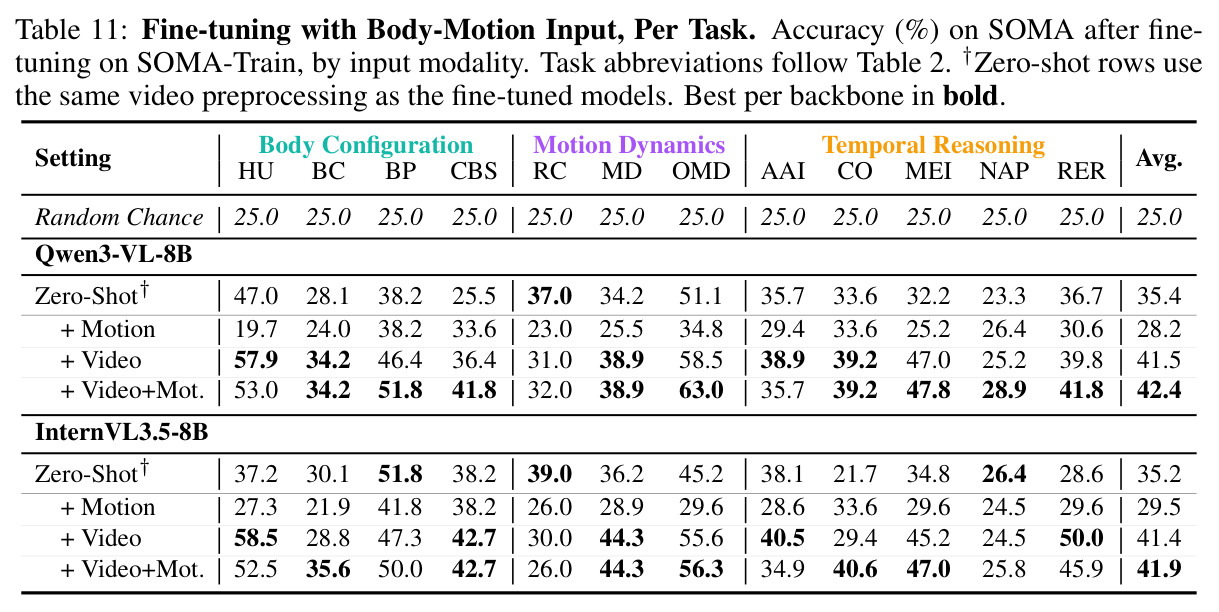
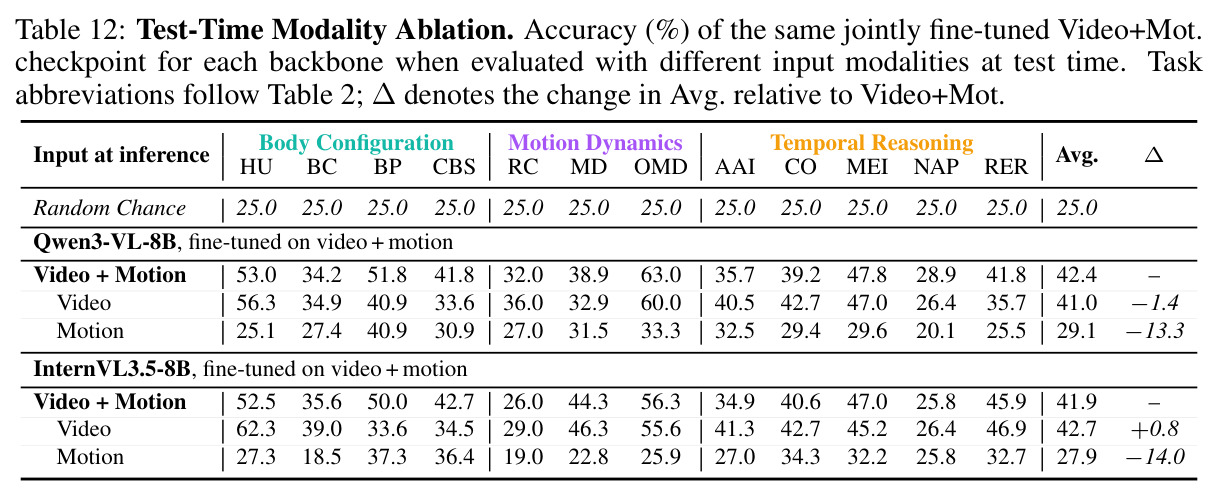
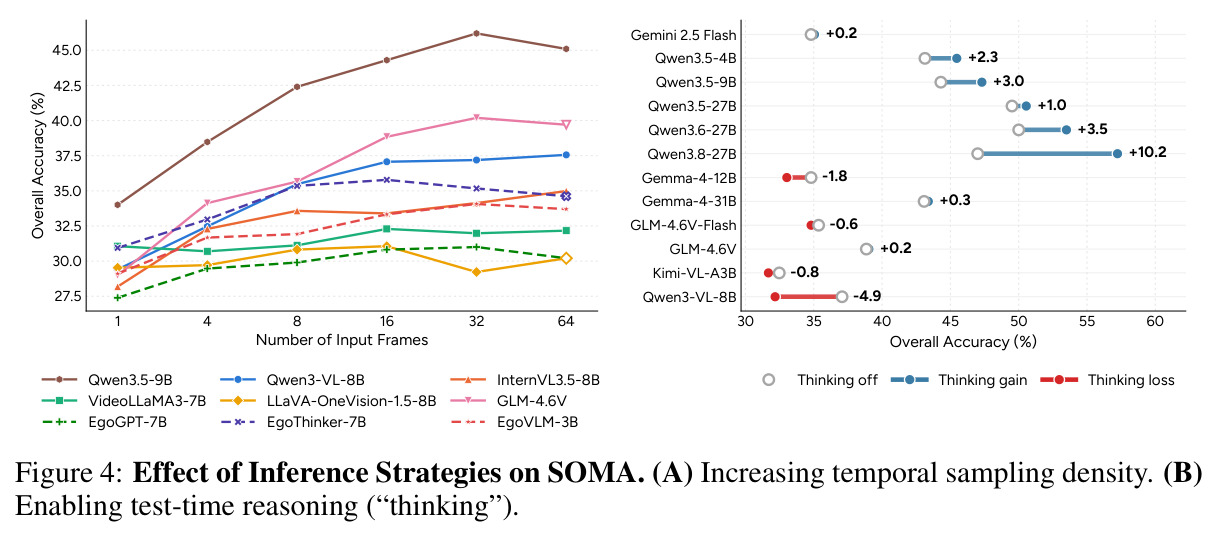
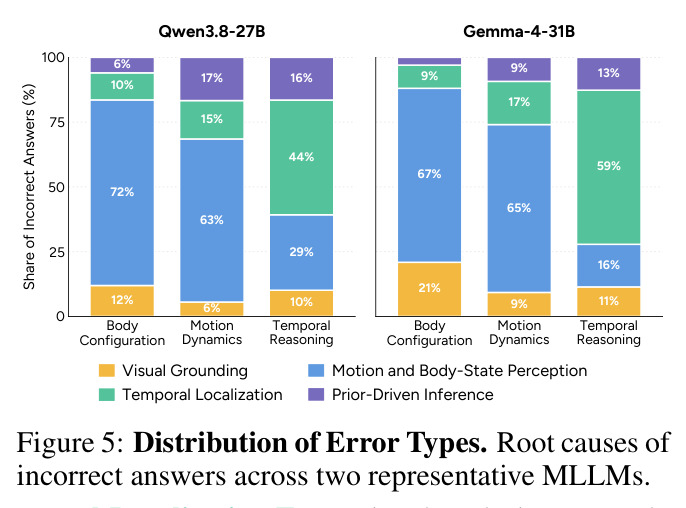
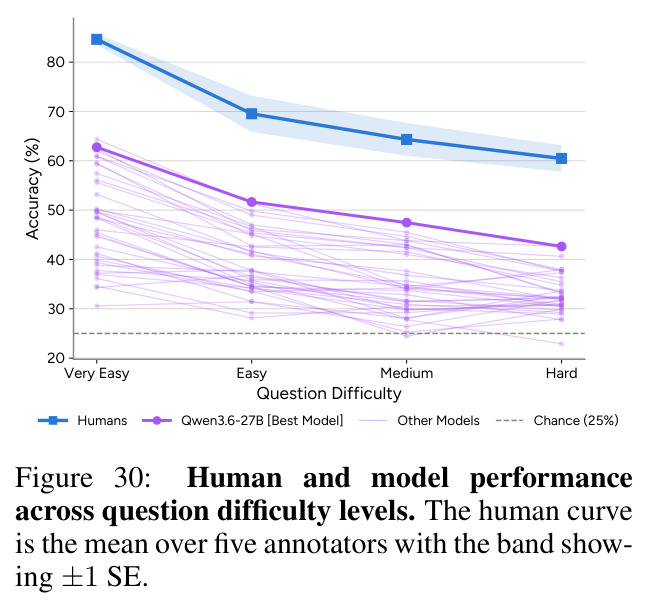
主榜(Table 2):37个模型无一接近人类:最佳Qwen3.6-27B仅50.0%(闭源最佳47.0%),人类68.5%(随机基线25%)。差距不均:重复计数差45.3分(人类88.9),重复事件推理/双手协调差25.4/25.3;而并行身体部位状态(-1.1)与下一动作预测(-10.0)上人类优势消失甚至反转,因答案在画面外。时序整合类任务多数模型低于40%;ego专用模型不敌同规模通用模型,扩容也不封顶(最大17.8分)。推理策略(Figure 4):1→16帧平均+5.4分,16→64帧最多+0.5;thinking仅5个Qwen系模型提升(最高+10.2),其余持平或下降。偏差与错误(Figure 5):37模型右手78.8%对左手44.3%(人类约90%),24/37模型计数偏低;身体配置轴上'运动与身体状态感知'错误占72%与63%。运动信号(Table 3/11/12):Qwen3-VL-8B零样本35.39→video微调41.49→加运动42.44;motion-only专用模型仅25–27%近随机;移除视频掉13.3/14.0分,移除运动仅-1.4/+0.8。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| SOMA 整体(12任务平均) | 准确率 %(零样本,16帧) | 50.0(Qwen3.6-27B,全场最佳) | 人类 68.5;最佳闭源 Gemini 3.5 Flash 47.0;随机 25.0 | 较随机 +25.0,但仍落后人类 18.5 分 |
| Repetition Counting | 准确率 % | 43.6(该任务最佳模型) | 人类 88.9 / 随机 25.0 | 人机差距 45.3 分,为全基准最大 |
| Hand Use(最佳任务) | 准确率 % | 74.6(Qwen3.5-4B) | 人类 90.5 / 随机 25.0 | 仍差人类 15.9 分 |
| Handedness 按类准确率(37模型平均) | 左手 vs 右手准确率 % | 左手 44.3 / 右手 78.8 | 人类左手 92.7 / 右手 89.8 | 暴露 34.5 分的右手偏差 |
| SOMA-Train 微调(Qwen3-VL-8B) | 准确率 % | video+motion 42.44 | zero-shot 35.39 / video-only 41.49 / motion-only 28.21 | +7.05(其中运动输入贡献约 +0.95) |
| Ego-Exo4D 身体运动重建 | PA-MPJPE (mm) | 36.7(本文重拟合,20 fps,验证集) | EE4D-Motion 40.3(10 fps) | -3.6 mm;帧覆盖 96.6% vs 37.9%(SOMA 问题级) |
局限与改进
作者承认的局限:video+motion增益modest且高度任务依赖——Motion Dynamics轴上运动输入甚至轻微损害InternVL3.5-8B;基线是'原生'的LLaVA/MotionLLM式设计,未探索更强融合架构;运动token在视觉证据已可见时引入冗余噪声。我的补充观察:其一,人类整体也只有68.5%,下一动作预测上人类仅34.5%(接近随机25%),这类推断型任务区分度有限,计入平均会稀释'感知'维度的信号;其二,评测统一16帧采样,重复计数的少计偏差部分可能是采样协议的产物,若允许模型自选关键帧结论可能不同;其三,题目由Gemini生成,虽有模板约束与盲筛,措辞偏置无法完全排除;其四,数据仅来自两个语料,域多样性受限;其五,四选一格式对细粒度感知的测量较粗,排除法可得分;其六,运动真值有36.7mm PA-MPJPE误差,motion实验的天花板受拟合质量约束;其七,双LLM judge错误分类一致率80.0%($\kappa=0.69$),仍有约五分之一分歧。
独立分析的弱点
独立分析的弱点与改进方向:(1)运动通路收益过小(+0.95/+0.51分),因为motion token只是拼接输入、靠LoRA被动学会何时信任它;改进应做架构级融合——运动与视频特征的跨模态交叉注意力、时间戳对齐约束,或在预训练阶段加入视频-运动对齐目标,而非仅后挂微调。(2)均匀抽帧结构性低估重复动作:16帧固定采样注定漏掉帧间重复;改进方向是可学习的关键帧选择、事件触发的非均匀采样,或要求模型输出证据链(指出数到的各次重复发生位置)再评分。(3)右手偏差是数据层面先验:可在训练中做handedness再平衡(左右镜像视频+文本对调),评测协议应强制报告按类别分解的准确率。(4)ego专用模型无优势暴露其训练配方缺陷——现有ego微调数据以字幕与任务推理为主、没有身体状态监督;改进是把motion narrations式的身体状态监督直接并入ego模型的训练集。(5)推断型任务(人类NAP仅34.5%)计入总分稀释信号:应区分'感知型'与'推断型'两个总分分别汇报。(6)MCQ格式允许排除法得分:可补充开放式生成+LLM评分或数值作答(直接输出计数)的交叉验证协议。
未来方向
作者提出的方向:构建把第一人称视频与运动信号配对的多模态系统,类比大脑以触觉、前庭、本体感受补全视觉形成身体表征;新兴世界模型(world models)可能天然适合这一挑战;以及修正右手偏差。基于其成果可延伸的研究:把SOMA-Train的110.2小时对齐数据扩展为预训练语料,做视频-运动-语言联合预训练而非LoRA后训;引入Aria眼镜的头动/IMU轨迹作为第三模态,模拟本体感受输入;推理时工具化——让MLLM先调用姿态估计器把视频转成显式骨骼序列再作答(visual programming思路);构建流式在线版本以服务AR实时场景(现平均35.6秒片段+均匀抽帧不适合在线推理);用世界模型做预测式自监督(预测下一时刻身体状态),可能比QA监督更贴近'身体感知'的本质;把四类错误类型学做成lmms-eval中的自动诊断套件,供后续模型持续追踪感知与时序弱项。
复现评估
复现条件较好。作者承诺论文接收后公开基准、SOMA-Train与全部代码(cnai.epfl.ch/soma);数据基于公开语料Nymeria(CC BY-NC 4.0)与Ego-Exo4D(Ego-Exo4D Model License),评测框架lmms-eval开源(MIT/Apache 2.0),所有构建与评测prompt在附录完整给出。算力方面:开源模型推理只需4×H100或4×A100;联合微调需8×H100(LoRA rank 128、2 epochs),中等规模实验室可负担;闭源模型结果可通过API复验。较难复现的是数据构建环节:Ego-Exo4D运动重建管道(RF-DETR检测+SAM 3D Body估计+多视角SMPL-X拟合)实现门槛较高,但附录E.2细节充分且质量指标可对照(PA-MPJPE 36.7mm、覆盖率96.2%);人工审核与465小时人类评测依赖人力与预算,普通团队难以复制但也不必——直接使用发布数据即可。总体评级:评测复现容易,训练基线中等,从零重建数据集较难且无必要。
论文图表