指令容量:受控指令负载下语言模型的行为规律与退化 Instruction Capacity: Behavior and Degradation of Language Models under Controlled Load
用单词替换规则作原子指令,测得GPT-4o mini在95%正确率下约可同时执行37条指令
前置知识
指令跟随与可验证指令(IFEval 谱系)
指令跟随指模型按提示中的要求生成回答的能力。Zhou 等人 2023 年提出可验证指令:像“写 400 词以上”“提到 AI 至少三次”这类可由程序判定的要求,构成 IFEval 基准(25 类指令、约 500 条提示)。后续 FollowBench、IFScale、Multi-IF 等不断叠加约束数量与对话轮数,研究执行质量如何随负载下降。
本文的问题意识正来自这条研究脉络的缺陷——指令数量与任务难度混在一起,无法换算成一个可比较的容量数字;读懂动机与相关工作部分必须先了解它。
伯努利试验
一次只有两种结果的随机试验:成功记 1(概率 $\pi$),失败记 0(概率 $1-\pi$)。大量重复后用频率估计 $\pi$。本文把文本中每一处待替换词的执行结果视为一次伯努利试验:该位置写出了规则要求的替换词即成功。
整套统计模型建立在“每次替换=一次伯努利试验”之上,且每次试验的位置与规则号已知;GPT-4o mini 测量的 642 430 次试验正是这些试验,是全部参数估计的数据基础。
Logit 与逻辑斯蒂回归
logit 是成功概率的对数几率 $\eta=\ln\frac{\pi}{1-\pi}$,把 $(0,1)$ 区间的概率映射到整个实数轴,使各因素的贡献可以相加;logit 每变化 $\Delta$,正确率的优势比(odds)就乘以 $e^{\Delta}$。逻辑斯蒂回归即在 logit 尺度上对协变量做线性建模。
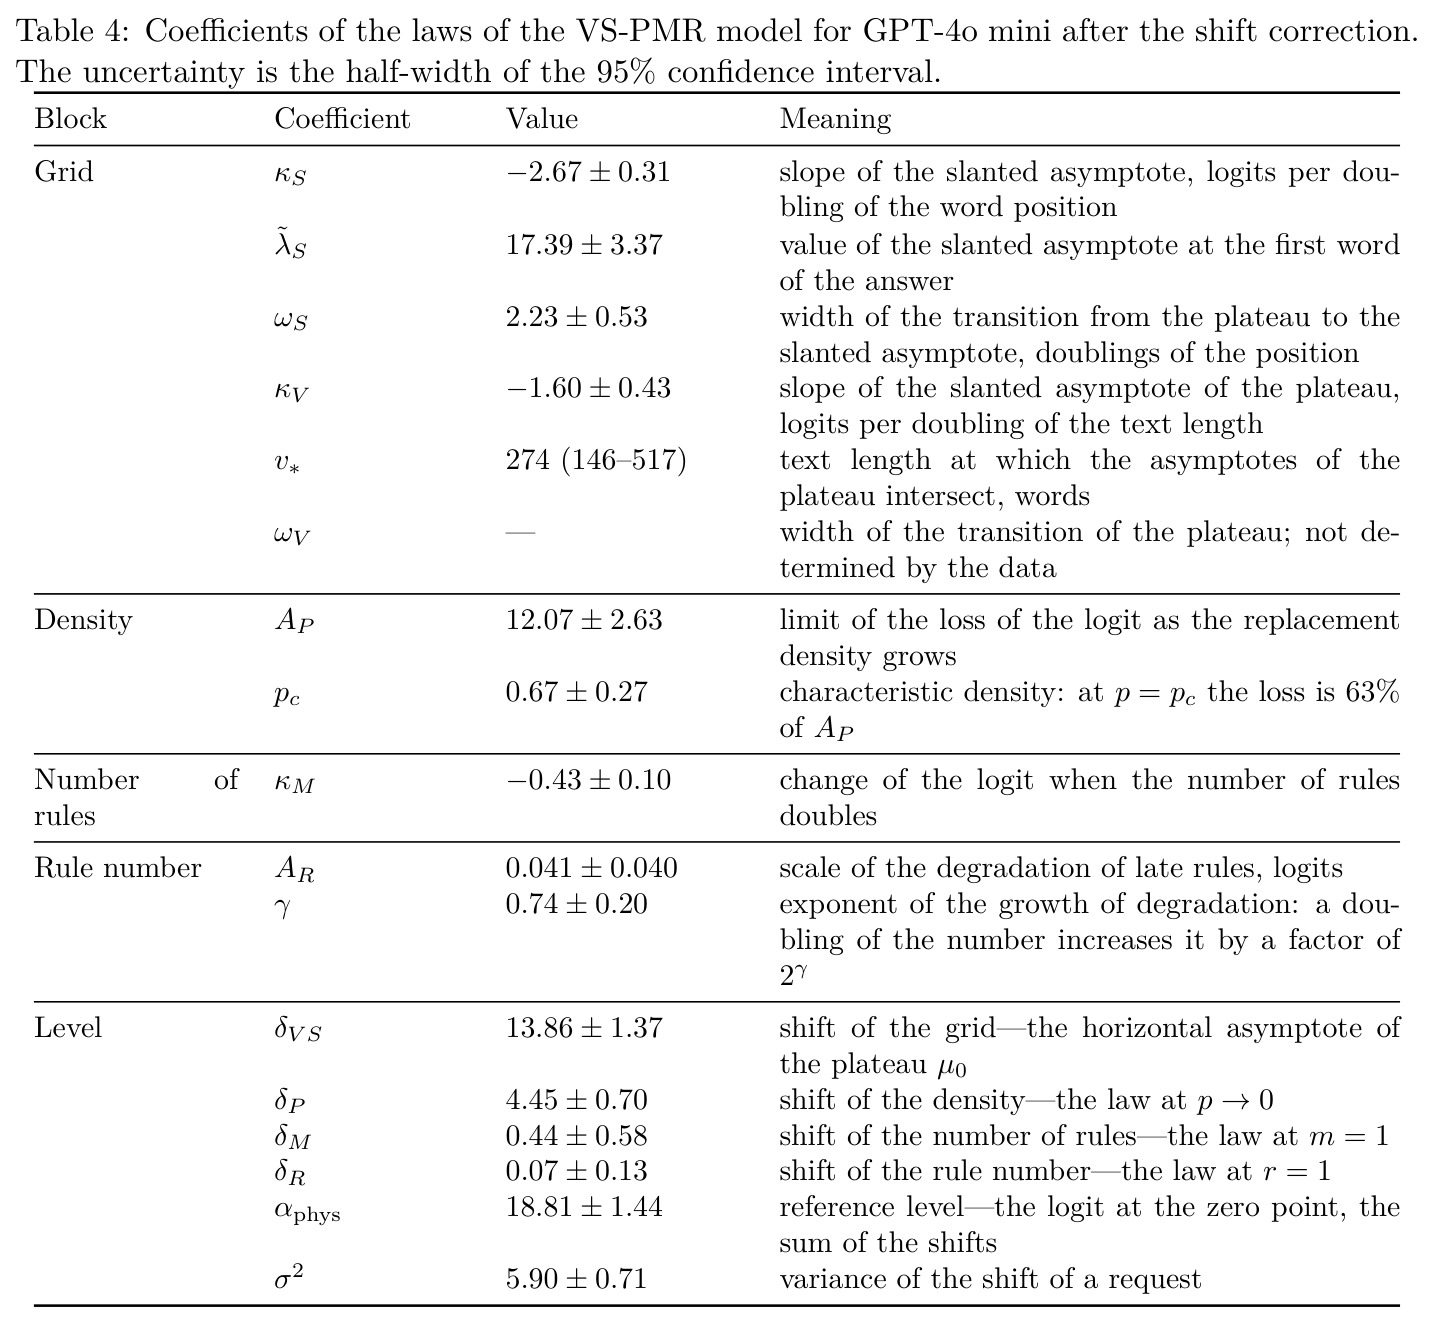
本文所有退化定律都以 logit 为单位计量负载的代价(如规则数每翻倍损失 0.43 logits),容量也是从 logit 储备中反解出来的;不熟悉 logit 就无法理解任何一条定律。
广义线性混合模型(GLMM)
在广义线性模型(如逻辑斯蒂回归)上加入随机效应:本文中同一请求的所有试验共享一个服从 $N(0,\sigma^2)$ 的随机偏移 $b_j$,代表该任务材料的难度;不对每个 $b_j$ 单独估计,而是对边际似然求最大来估计固定系数与方差。
请求之间的任务难度差异必须与负载效应分离,否则容量估计有偏;实测的 $\sigma^2=5.90$ 还把 0.95 质量等级的阈值从 2.94 推高到 4.97 logits,直接影响容量数值。
分箱(binned)回归与参考水平问题
不预设函数形式,把每条负载轴的取值切成对数等宽的区间(每箱=数值翻一倍),每箱各配一个自由系数,由数据估计出“剖面”。传统写法要设自由项 $\alpha$ 并把某箱系数固定为零(参考箱),但水平会随参考箱的选取而变,不是数据决定的量。
本文定律的形状(双曲线、指数饱和、对数直线、幂律)都是先由分箱无假设地测出、再拟合光滑定律的,这套“先自由后参数化”的流程是全文方法论的核心,也是理解第 4 章的前提。
逆回归、有效剂量与 Delta 方法
逆回归是回归的反问题:由响应-暴露关系反解“响应达到给定值时的暴露”,药理学中的有效剂量 ED 即此类量。Delta 方法用线性化 $\mathrm{Cov}\,g(\hat\theta)\approx\nabla g\,\Sigma\,\nabla g^{\mathsf T}$ 传播不确定度,可为隐式定义的量给出置信区间。
指令容量 IEC 正是从拟合模型反解的“有效剂量”(累积代价恰好耗尽储备时的规则数),其 ±95% 区间完全由 Delta 方法算出;这是理解第 4.5 节和护照数字的关键。
研究动机
模型同时执行的指令越多、输入与输出越长,执行质量越差——这在 IFEval 之后的研究中被反复证实,但始终没有一个以负载为单位、带不确定度、可在模型间比较的“极限”数字。根源在于负载的设定方式。第一,几乎所有形式类指令都作用在同一段有意义的文本上,指令彼此耦合:“每行不超过 79 字符”这条代码风格规则单独执行时成功率达 97% 和 99%(Claude 3.5 Sonnet 与 Gemini 1.5 Pro),与其他 5 条规则合在一起骤降到 2% 和 20%,无法区分这份下降中多少是模型极限、多少是任务本身变难。第二,实质约束要靠裁判模型评分,其误差与被测效应同量级:Harada 等用判官模型得到 10 条指令全履行率 0.657,程序核查只有 0.213,虚高三倍;SEQUOR 的判官把 11.5% 的正确答案误判为错误,与 50 轮对话中 11% 的真实退化幅度相当。第三,结果只是若干测试点上的份额:IFScale 中最强模型在 500 条指令下仍未崩溃(最好成绩 68%),RULER/NoLiMa 的“有效长度”只能在倍增的测试长度里挑选,精度不过 2 倍且没有区间。
本文的目标是本文的目标是把“指令负载”变成可计量的量。具体而言:构造一种原子指令——在无意义文本中把某个单词的所有出现替换为另一个词——使每条规则互不耦合、每次应用有唯一正确结果且由程序判定;以规则条数为负载单位,测量正确替换概率随五条负载轴(文本长度、词位置、替换密度、规则条数、规则序号)下降的规律;再从规律中反解出指令容量——模型在给定正确份额下能同时持有的规则数——连同其不确定度。最终交付 GPT-4o mini 的“护照”:每条负载定律的参数、答案崩溃的速率与位置定律、以及 0.95 和 0.5 两个质量等级下的指令容量(IEC)、疲劳容量(FEC)与保底指令容量(IGC),且护照上每个数字都能从公开数据重算。
与已有工作不同的是,作者的独特切入是把认知心理学的计量传统(Miller 的“7±2”、Cowan 的约 4 个组块)移植到指令跟随上,坚持负载必须由实验者设定、指令本身不得成为混淆变量。为此它反其道而行:不沿用“在有意义文本上叠约束”的思路,而是把语义彻底抽掉——词表全是单 token 单音节名词,文本无意义,规则只是机械映射,执行不依赖理解、知识或推理,错误只能归因于模型同时持有独立对应关系的能力上限。统计上则借用药物剂量-反应框架:先用对数分箱无假设地测出每条轴的剖面形状,再用最小距离估计拟合光滑定律,并提出“近似平移校正”,把传统编码中依赖参考箱选择的自由水平,还原为与编码无关的参考水平 $\alpha_{\mathrm{phys}}$。由此容量成为连续、带区间的可比参数,而非从倍增测试点中挑出的粗粒度“有效长度”。
核心方法
直觉上,这篇文章想让“模型能同时记住并执行多少条指令”变成像体温一样可测的量。仪器分三步:任务生成、模型调用、答案校验。任务是一段由词表单词组成的无意义文本(每行 10 词)加一张替换规则表(如 lake -> stone),模型须输出应用全部规则后的文本;正确答案由程序一步算出,逐行比对后,每个待替换词的出现都成为一次伯努利试验,其在答案中的位置与所属规则号同时被记录。统计模型名为 VS-PMR:在 logit 尺度上,文本长度 $v$ 与词位置 $s$ 合并为二维网格 VS,另加替换密度 $p$、规则数 $m$、规则号 $r$ 三个分箱贡献,再给每个请求加一个 $N(0,\sigma^2)$ 的随机难度偏移(GLMM)。每条轴的贡献先用对数分箱自由估计剖面,再拟合光滑定律(双曲线、指数饱和、对数直线、幂律),经平移校正后各定律在最轻负载处的渐近水平之和构成参考水平 $\alpha_{\mathrm{phys}}$;容量即“逐条规则的代价累积耗尽水平储备”这一逆问题的解,按分箱与光滑定律两条途径各算一遍互为校验。
核心创新有三层。第一是任务的构造性独立:替换词集合与被替换词集合不相交、替换词不出现在原文、规则不构成链(lake->stone、stone->fish 之类不可能存在),因此任何一条规则的执行都不改变其他规则的要求,负载加到几百条也不改变任务性质——这与其他方法“指令共享同一段文本”有本质区别,负载的增长不再与任务难度的增长混淆。第二是观测粒度:每个词的出现都是带坐标的伯努利试验(答案内位置 $s$、规则号 $r$ 已知),退化可以被定位到答案中的具体位置,而不是整段平均;行级比对把局部失败限制在一行内,无法匹配的位置一律记 0,模型分数不可能被高估。第三是统计模型没有依赖编码的自由水平:分箱拟合只决定各轴剖面的形状,水平由光滑定律在最轻负载处渐近值(平移量)之和恢复,与参考箱的选择无关。在此之上,“指令容量”被定义为逆问题 $\pi(m;x_0)=q$ 的解,连续且带 Delta 方法不确定度——类比药理学的有效剂量,而不是像 RULER 那样在倍增长度里挑一个没有区间的档位。
方法步骤详情
第一步,构建词表:从 CMU 发音词典 123 455 词出发,依次过滤小写拉丁字母、≥3 字母、单音节(14 884)、WordNet 名词(5 750)、单数原形(3 581),最后要求在 o200k_base、cl100k_base、Qwen2.5 三个分词器下均为单 token,得 2 220 词。第二步,生成任务:由六个数完全决定——规则数 $m$、不同词数 $D$、每词重复次数 $n$ 与三个随机种子(规则种子选 $2m$ 个词按序配对、文本种子选背景词并洗牌、顺序种子打乱规则行序),约束 $1\le m\le D$、$D+m\le 2220$,每词恰出现 $n$ 次、每行 10 词,任务可逐字节重现。第三步,调用模型:温度 0、seed=20260907、top_p=1、max_tokens=16384,固定提示模板。第四步,校验答案:程序算出参考答案并逐行比对,剔除前后多余行;偏差分三类失败——一类(替换错误、结构完好)、二类(行内局部错乱后恢复)、三类(结构丢失或截断),无法匹配的位置记 0,分数不会被高估。第五步,统计建模:以 VS 网格+P+M+R 分箱 logit 加请求随机偏移(GLMM)拟合全部 642 430 次试验,再以协方差逆矩阵为权重的最小距离估计拟合光滑定律,Delta 方法传播不确定度。第六步,计算容量:第 $r$ 条规则的价格 $a(r)=-\Delta M(r)-\tilde R(r)$,累积价格 $C(m)$ 耗尽储备 $\Delta_q=\alpha_{\mathrm{phys}}-\eta^*(q,\sigma^2)$ 处的 $m$ 即容量 $\mathrm{IEC}_q$。
技术新颖性
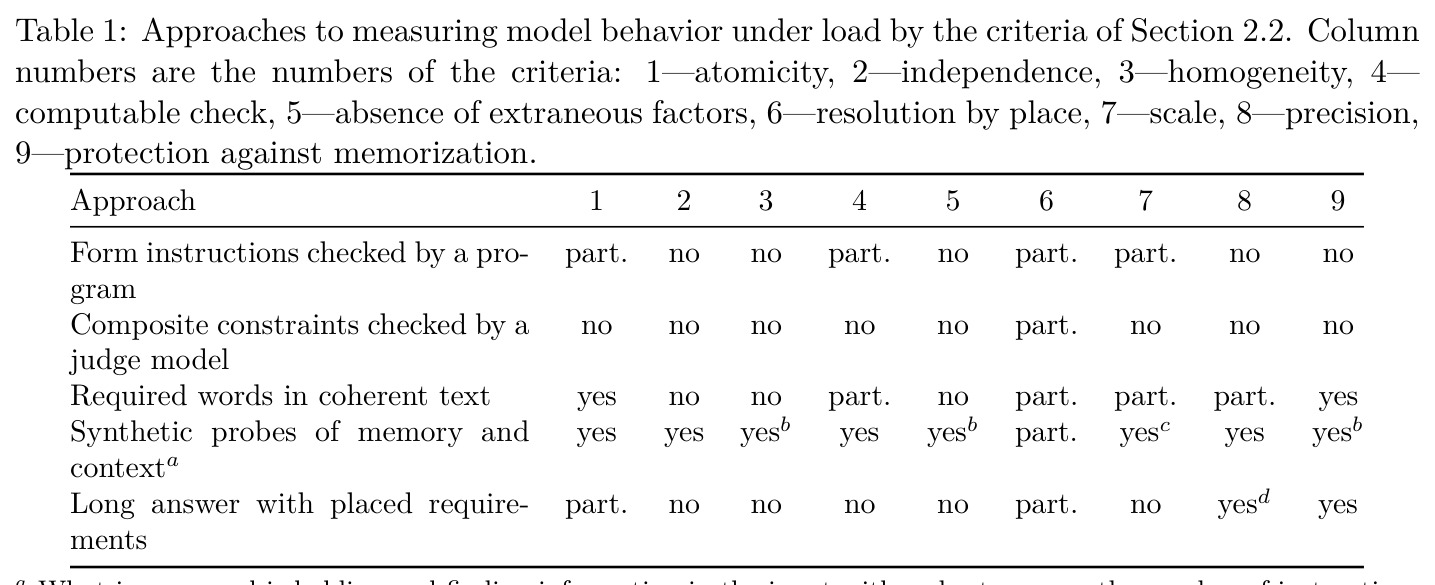
技术新颖性集中在度量学而非模型本身。其一,论文明确提出九条计量准则(原子性、独立性、同质性、可计算核查、无外生因素、按位置分辨、量程、精密度、防背诵),并据此系统批评五类已有方法(Table 1),本文仪器是唯一同时满足全部九条且负载恰为“指令数量”的方案。其二,VS 二维网格来自实证发现:文本长度与词位置的贡献不可加——答案开头处长度翻倍损失 1.4–1.8 logits,答案深处趋近于零——故必须合并建模,再用“双曲线=两渐近线最小值的平滑化”给出解析形式,这种交互结构在已有指令负载研究中未见。其三,把“规则数”与“规则号”拆成两条独立轴(靠顺序种子随机置换规则行序实现),首次分离了“规则表更长”与“规则排得靠后”两种代价,而 IFScale、Harada 等的工作中这两者总是同步增长。其四,答案崩溃(三类失败)被单独建模为请求级的伯努利事件,得出与指令容量无关的另一组定律,揭示了“执行指令”与“保持文本位置”是两种不同的模型极限。
实验结果
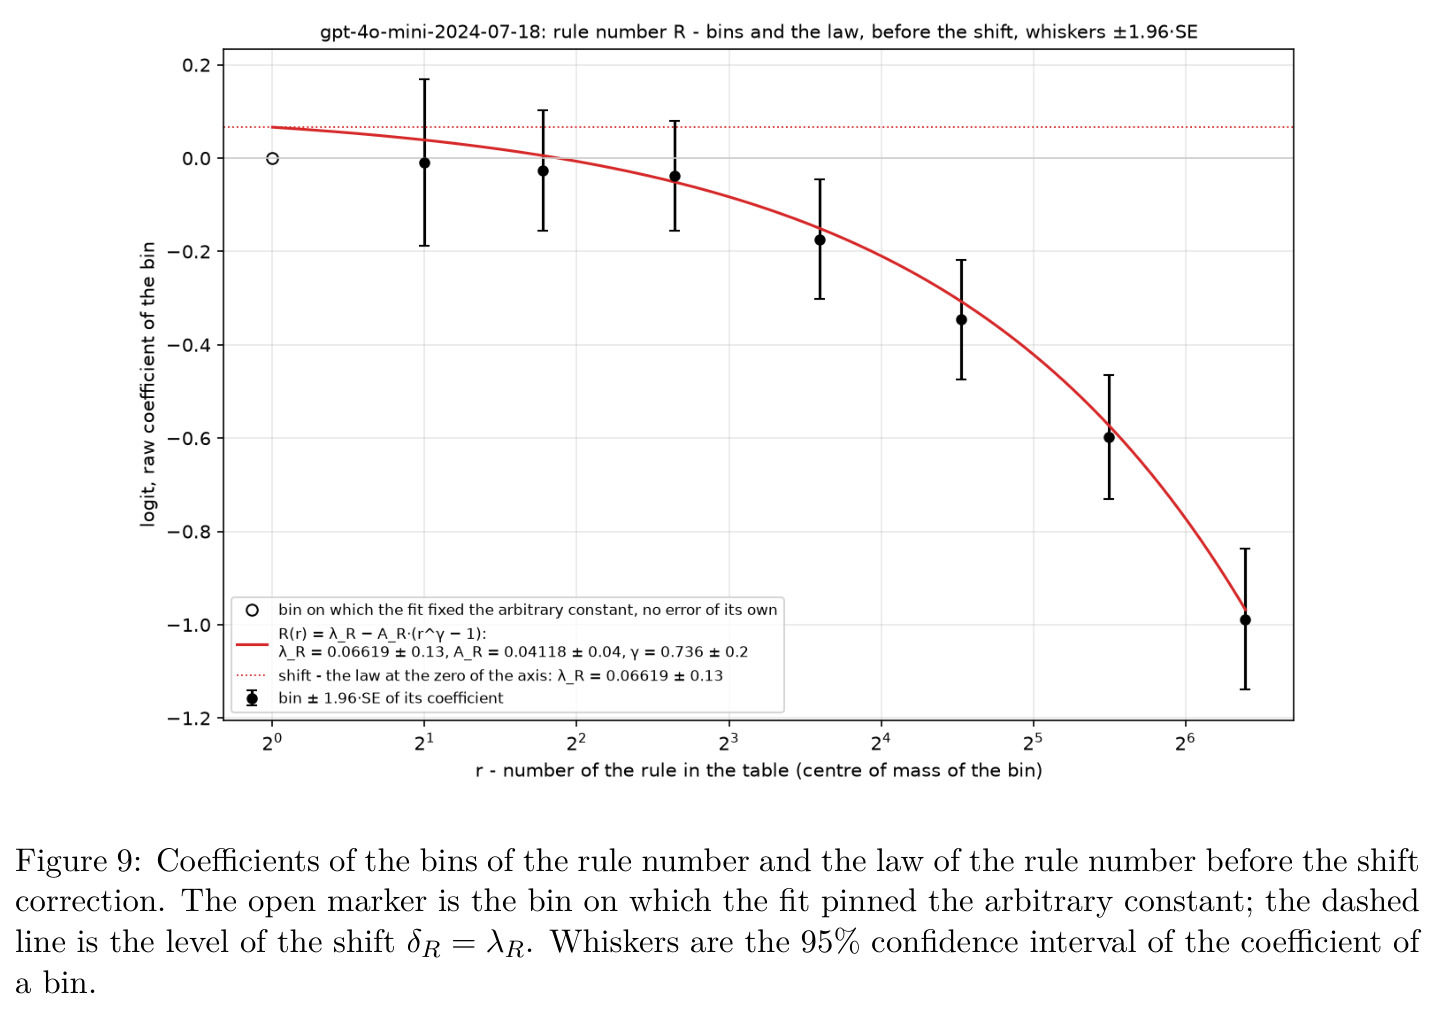
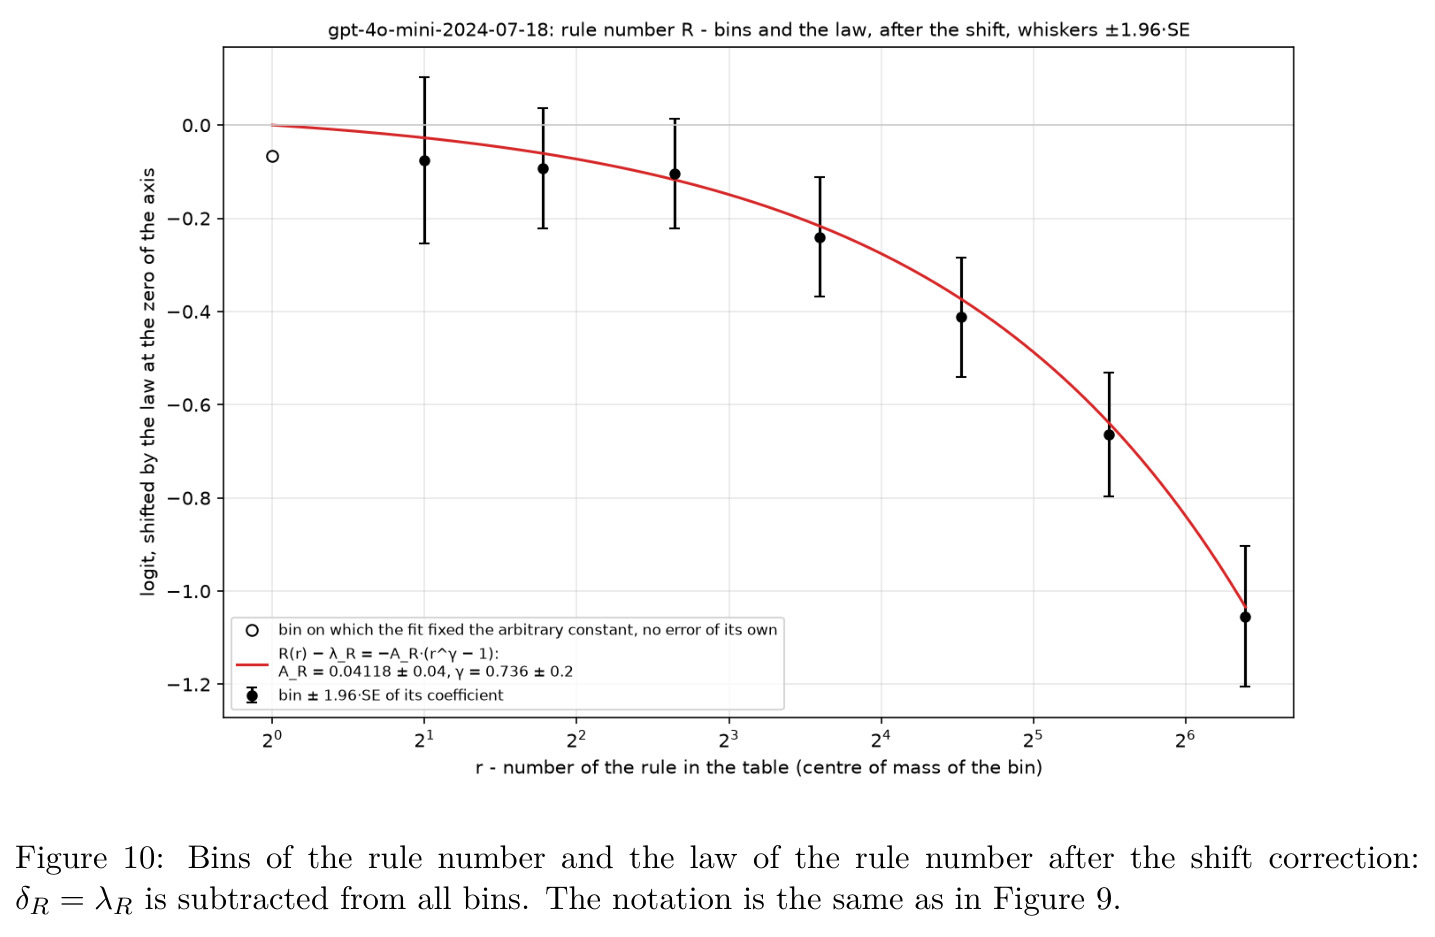
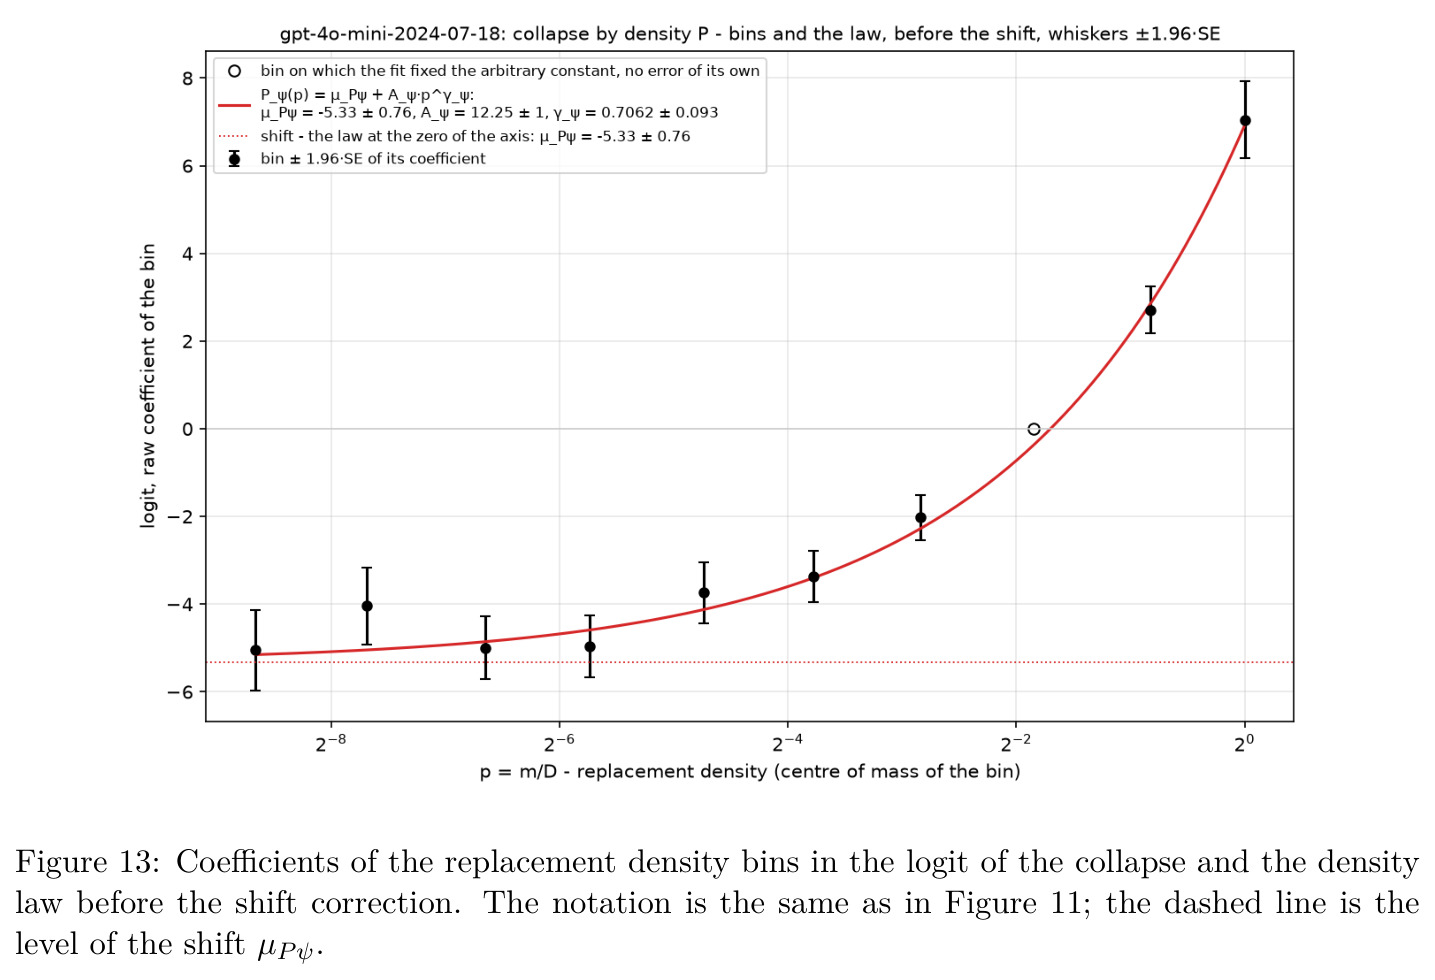
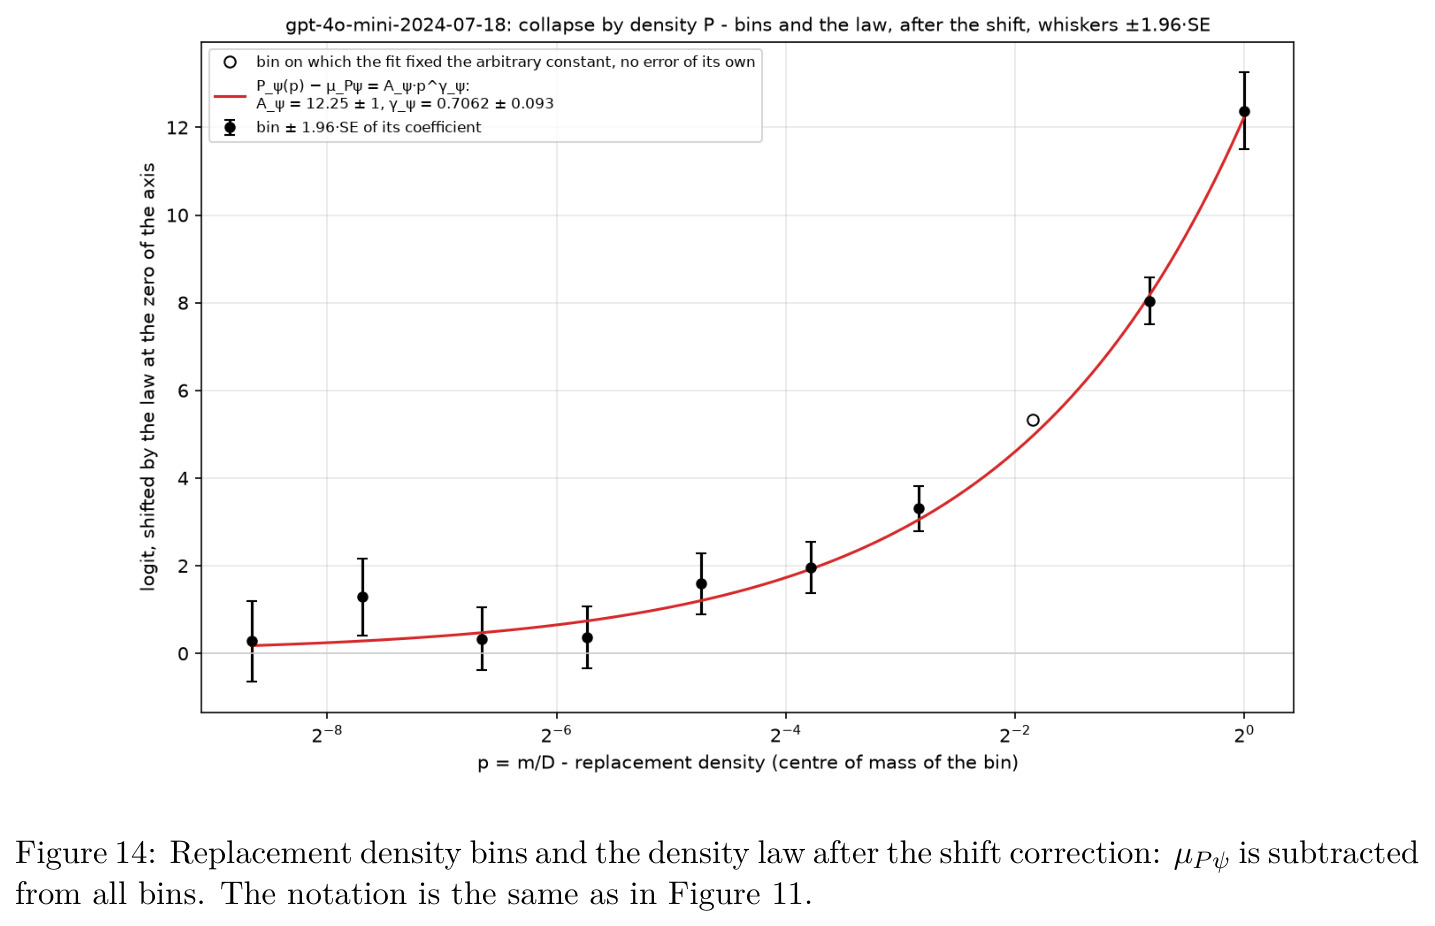
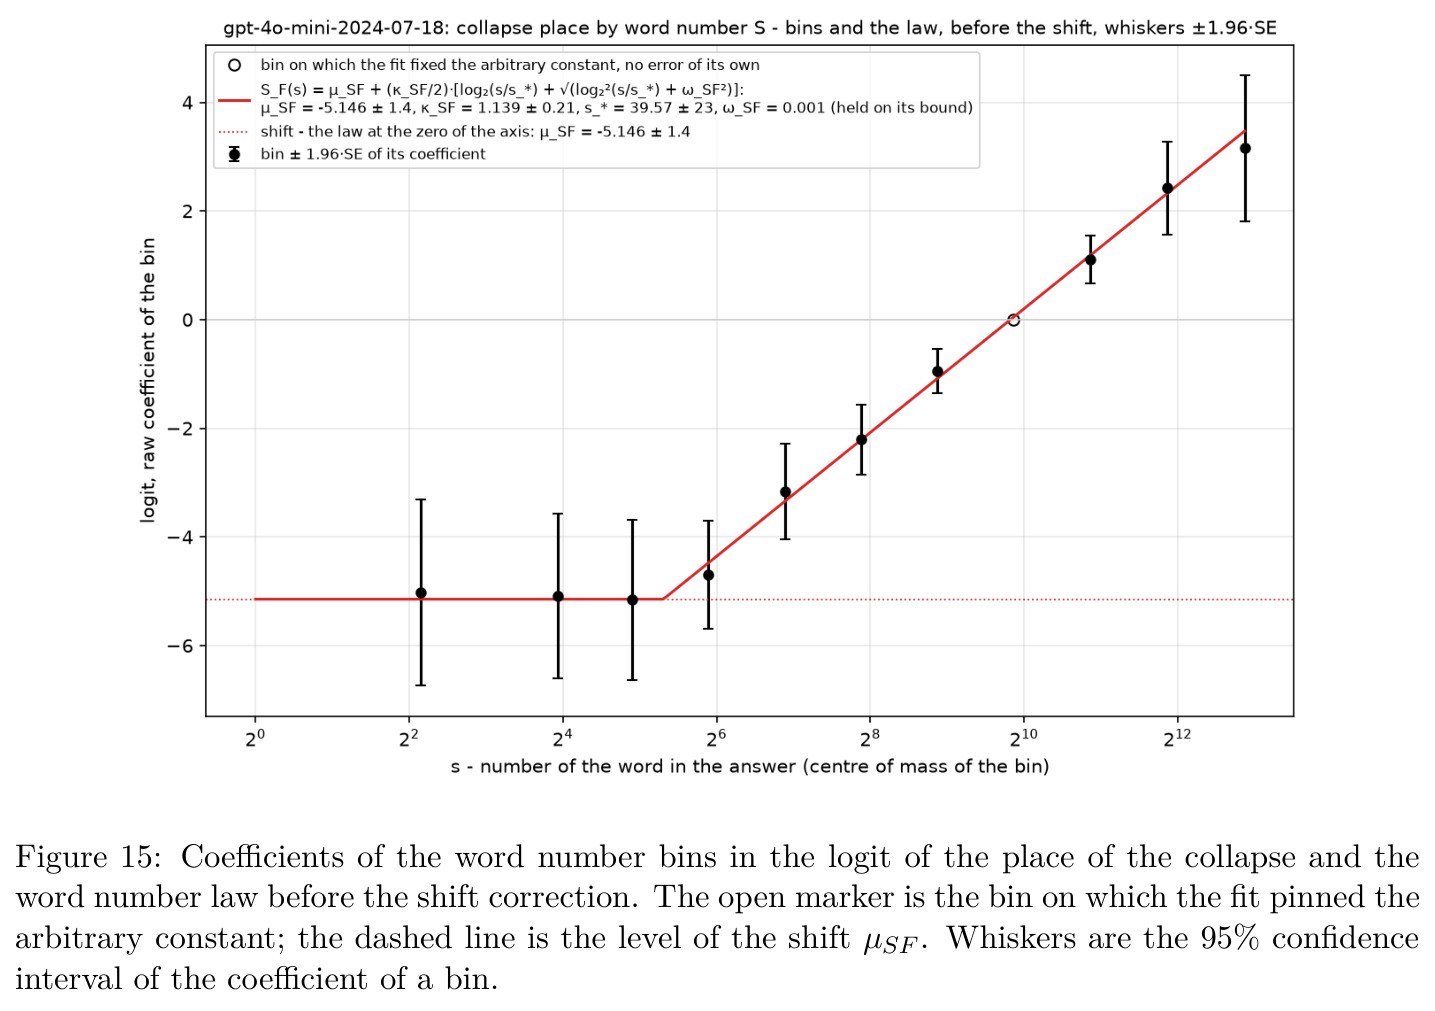
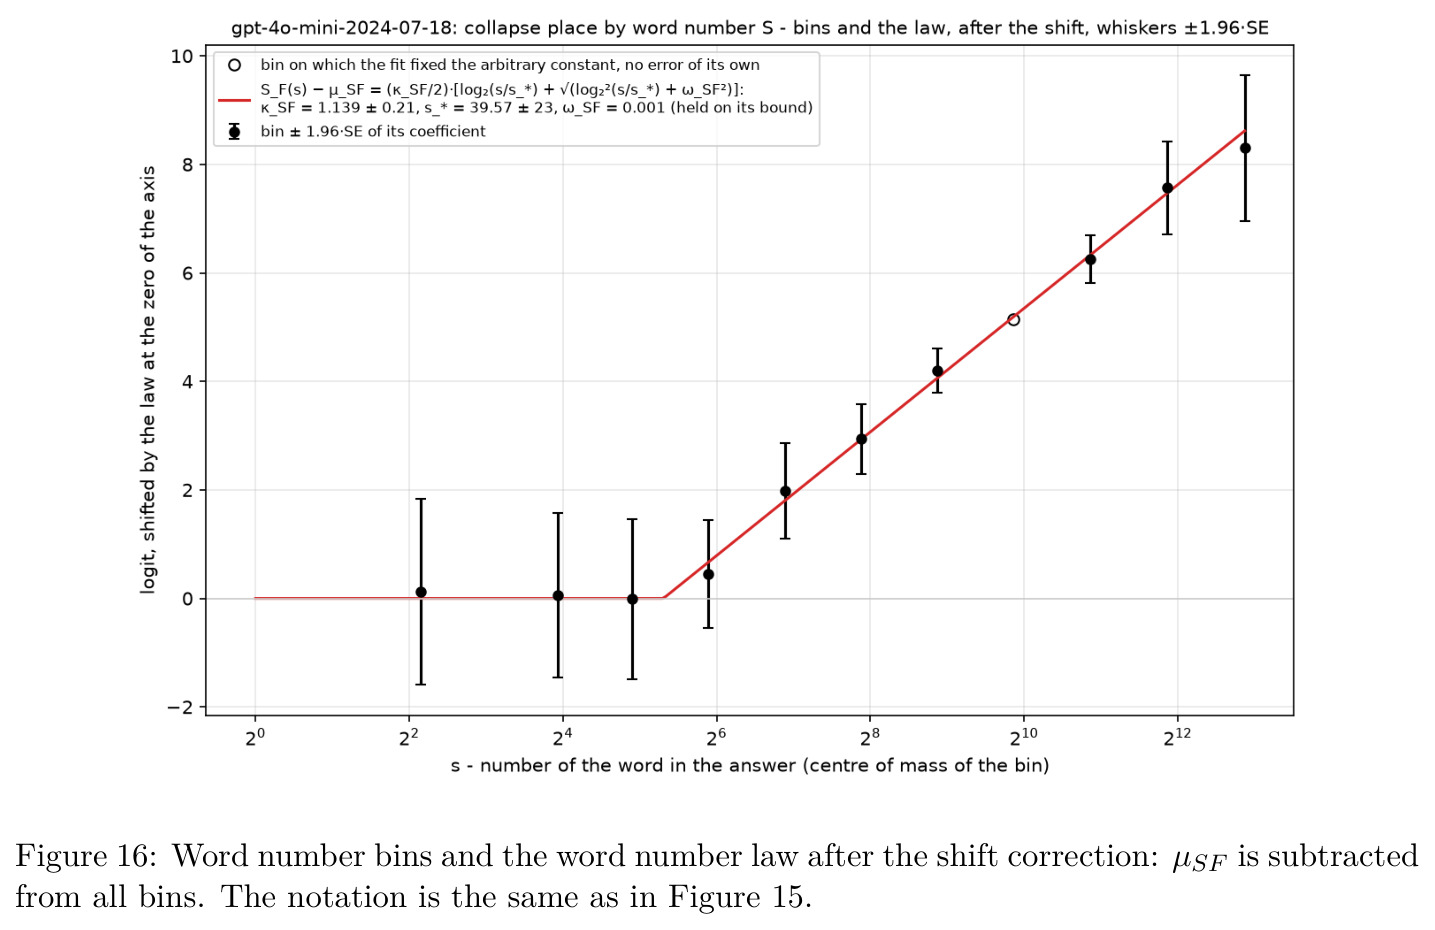
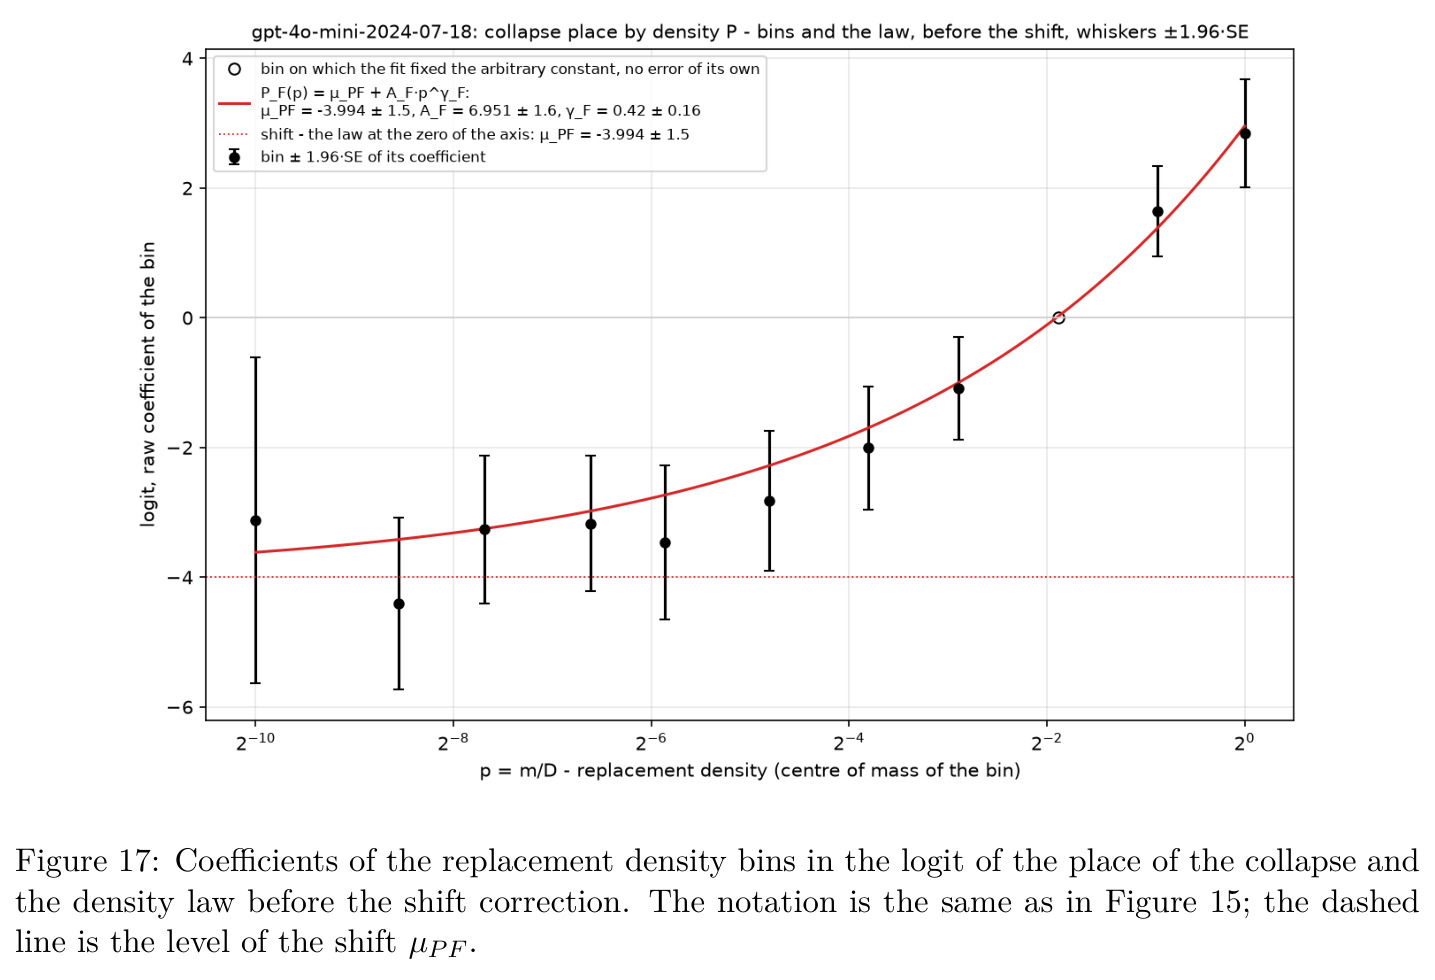
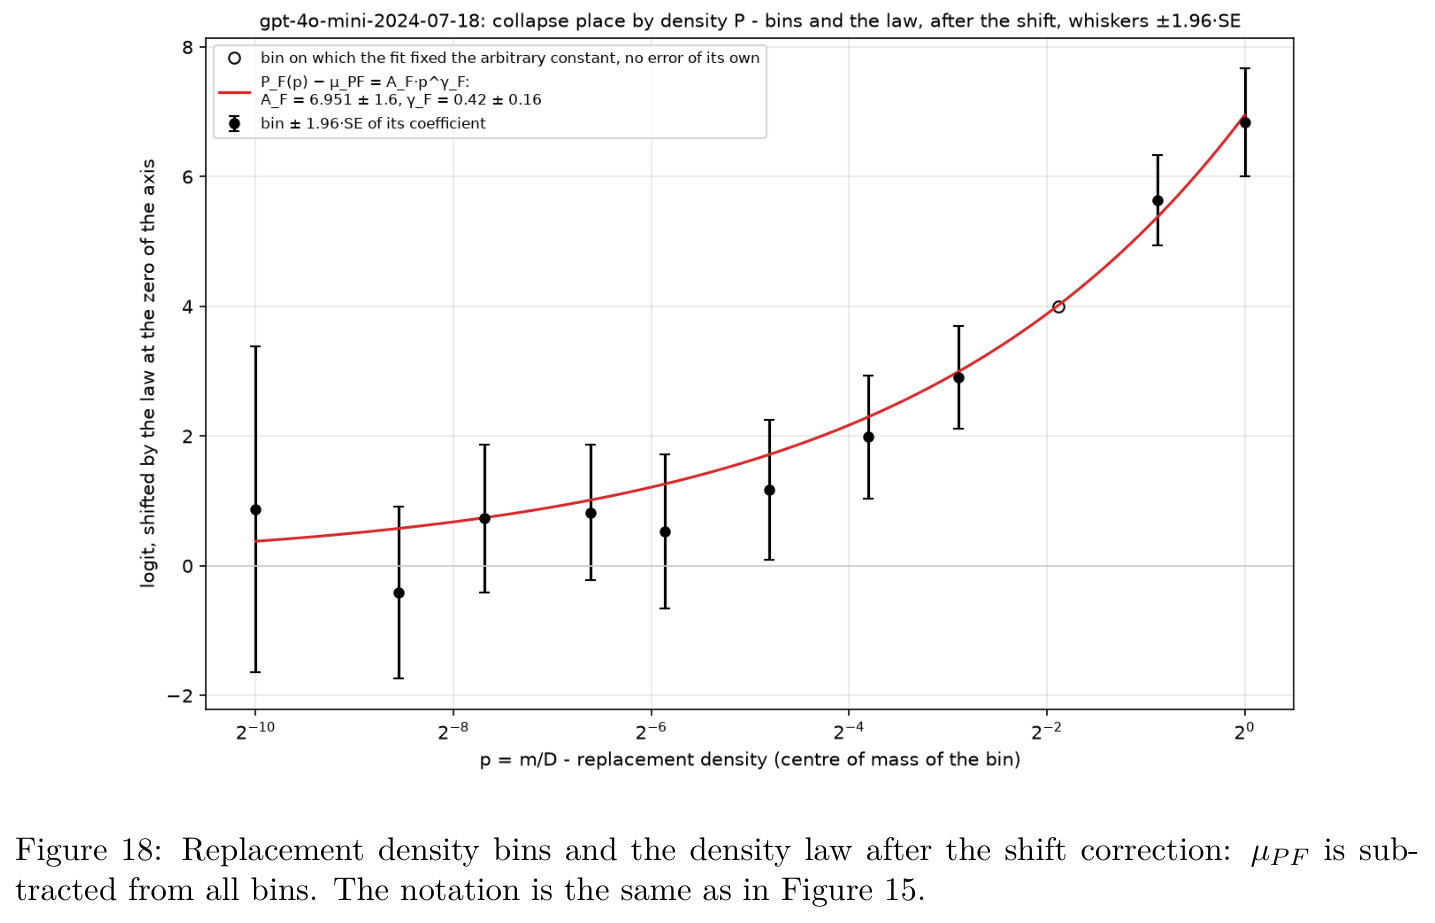
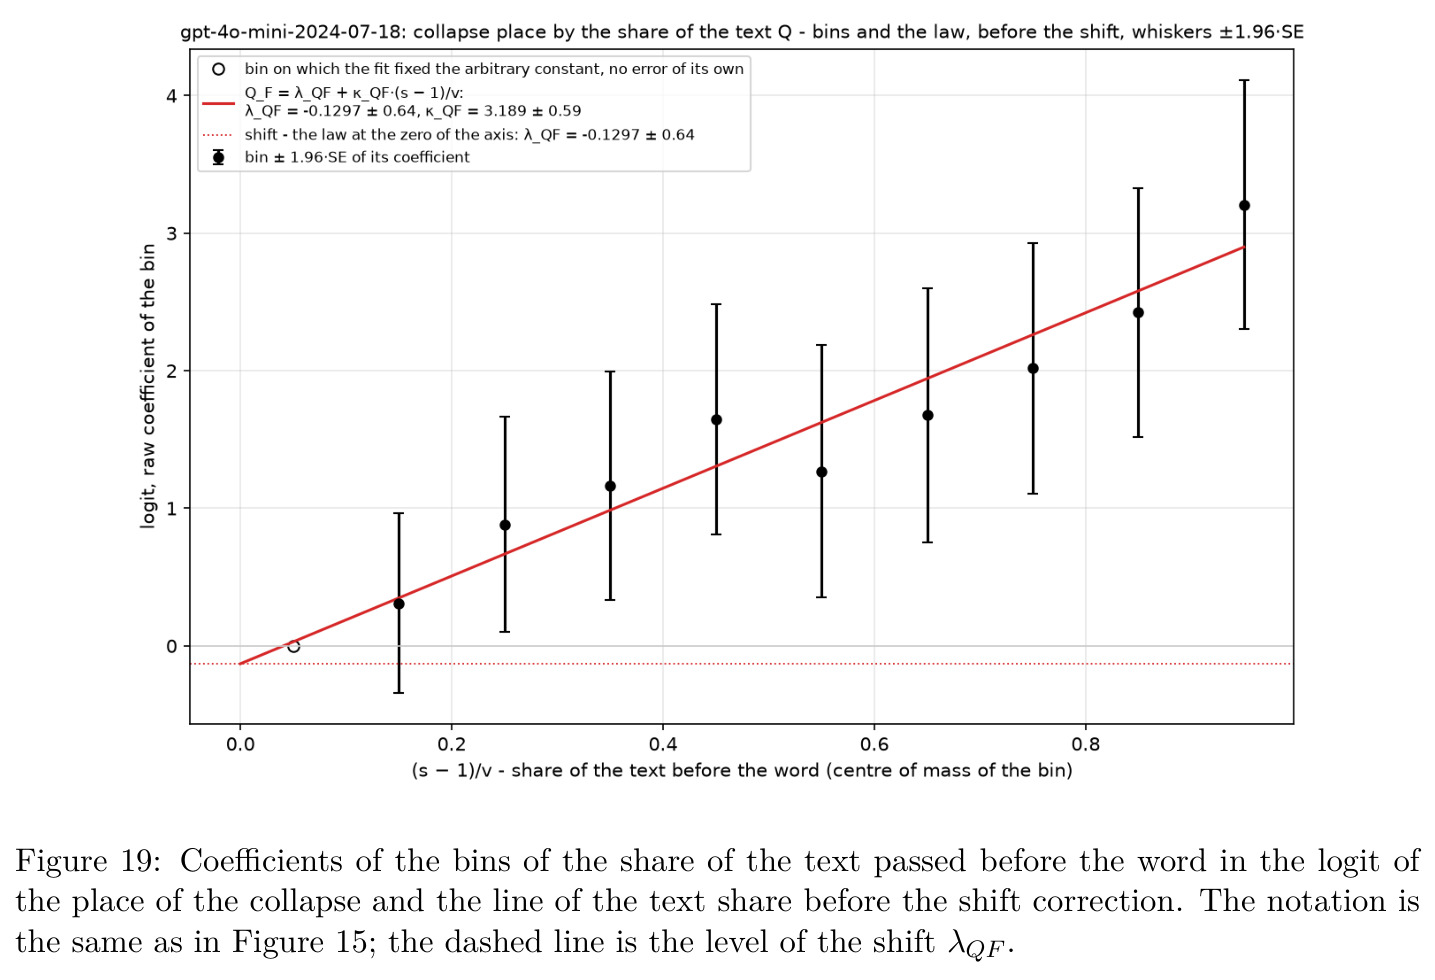
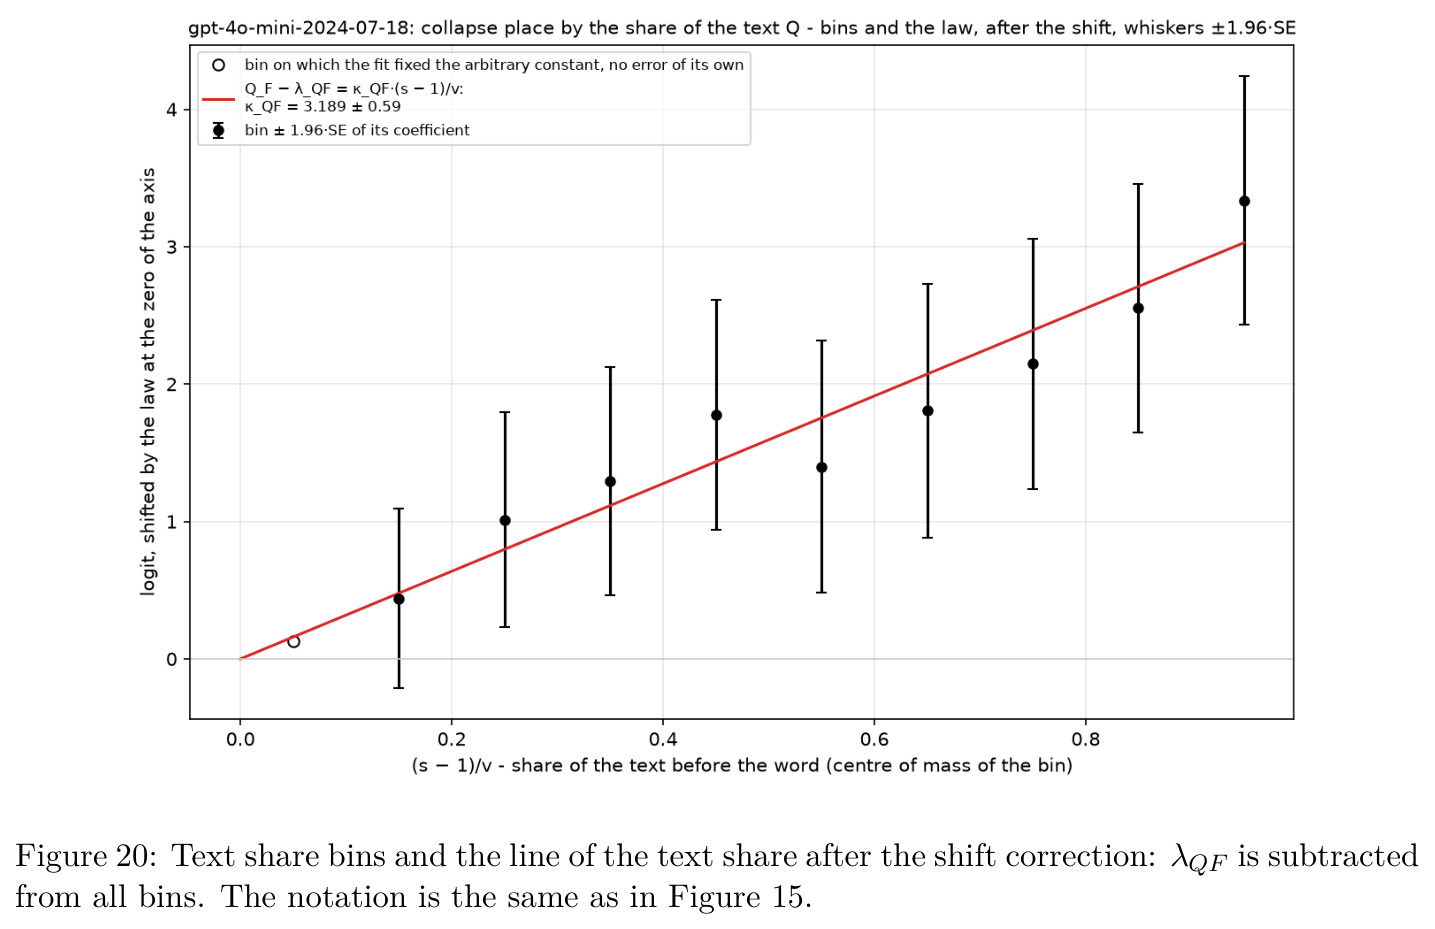
对 GPT-4o mini 的测量(1890 个实验点、2958 次请求、642 430 次试验)产出五条定律。①长度×位置呈双曲线:所有长度切片共享斜渐近线 $\kappa_S=-2.67\pm0.31$ logits/位置翻倍,平台在 $v^*\approx274$ 词转折后按 $\kappa_V=-1.60\pm0.43$/翻倍下降(41–320 词约 14 → 5121–10240 词 6.5),二者是相互作用的两个限制而非独立损失之和。②替换密度呈指数饱和:$A_P=12.07\pm2.63$、$p_c=0.67\pm0.27$,密度 1/16 时仅约 1 logit,满密度达 9.35±1.01。③规则数对数线性:每翻倍损失 0.43±0.10 logits。④规则号幂律加速:前 8 条几乎免费,65–128 号损失 1.05±0.12,每翻倍恶化约 1.7 倍。⑤崩溃独立成律:33.6%(995/2958)的请求丢失文本,几率按 $(v/20)^{3.5}$ 增长、密度超 1/16 后陡增,且固定长度与密度下与规则数无关;崩溃位置由词数(拐点约 40 词)与已过文本份额决定而非总长。最终护照:$\alpha_{\mathrm{phys}}=18.81\pm1.44$、$\sigma^2=5.90\pm0.71$;零点处 $\mathrm{IEC}_{0.95}=36.6$–$38.1$ 条、$\mathrm{IEC}_{0.5}=43.9$–$46.1$ 条;满密度 $\mathrm{IGC}_{0.95}\approx18$–$19$ 条、$\mathrm{IGC}_{0.5}\approx30$ 条;$\mathrm{FEC}_{0.95}=3277\pm571$ 词。到第 37 条规则时约 2.2 logits 花在表长、约 11 花在规则号。
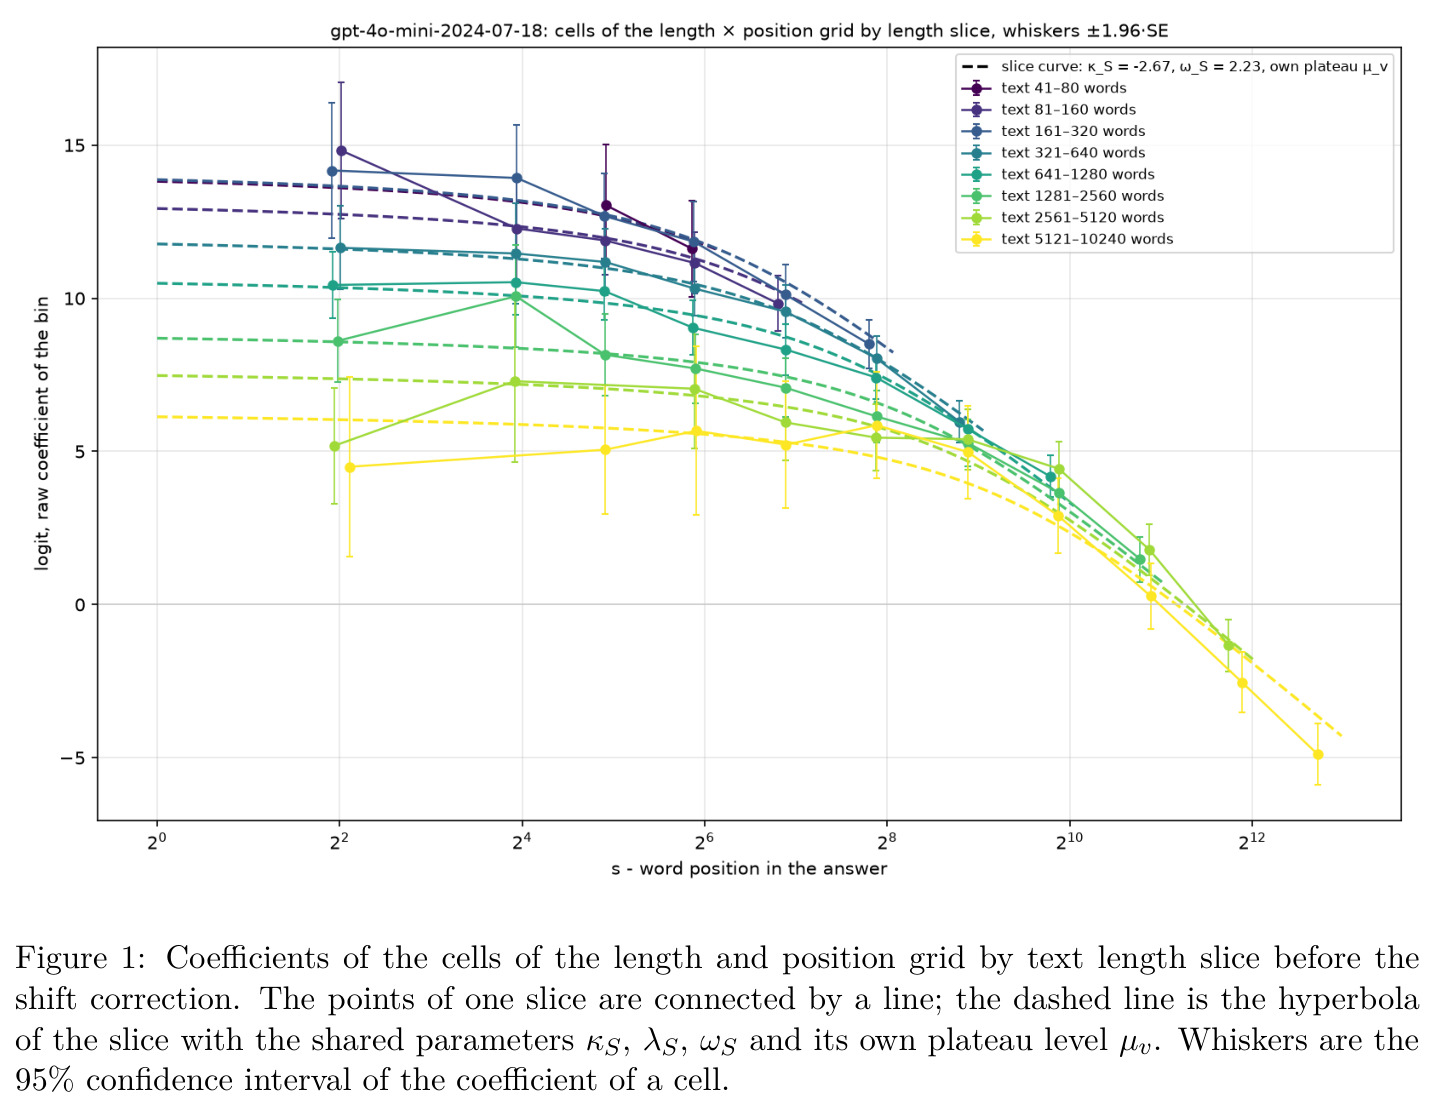
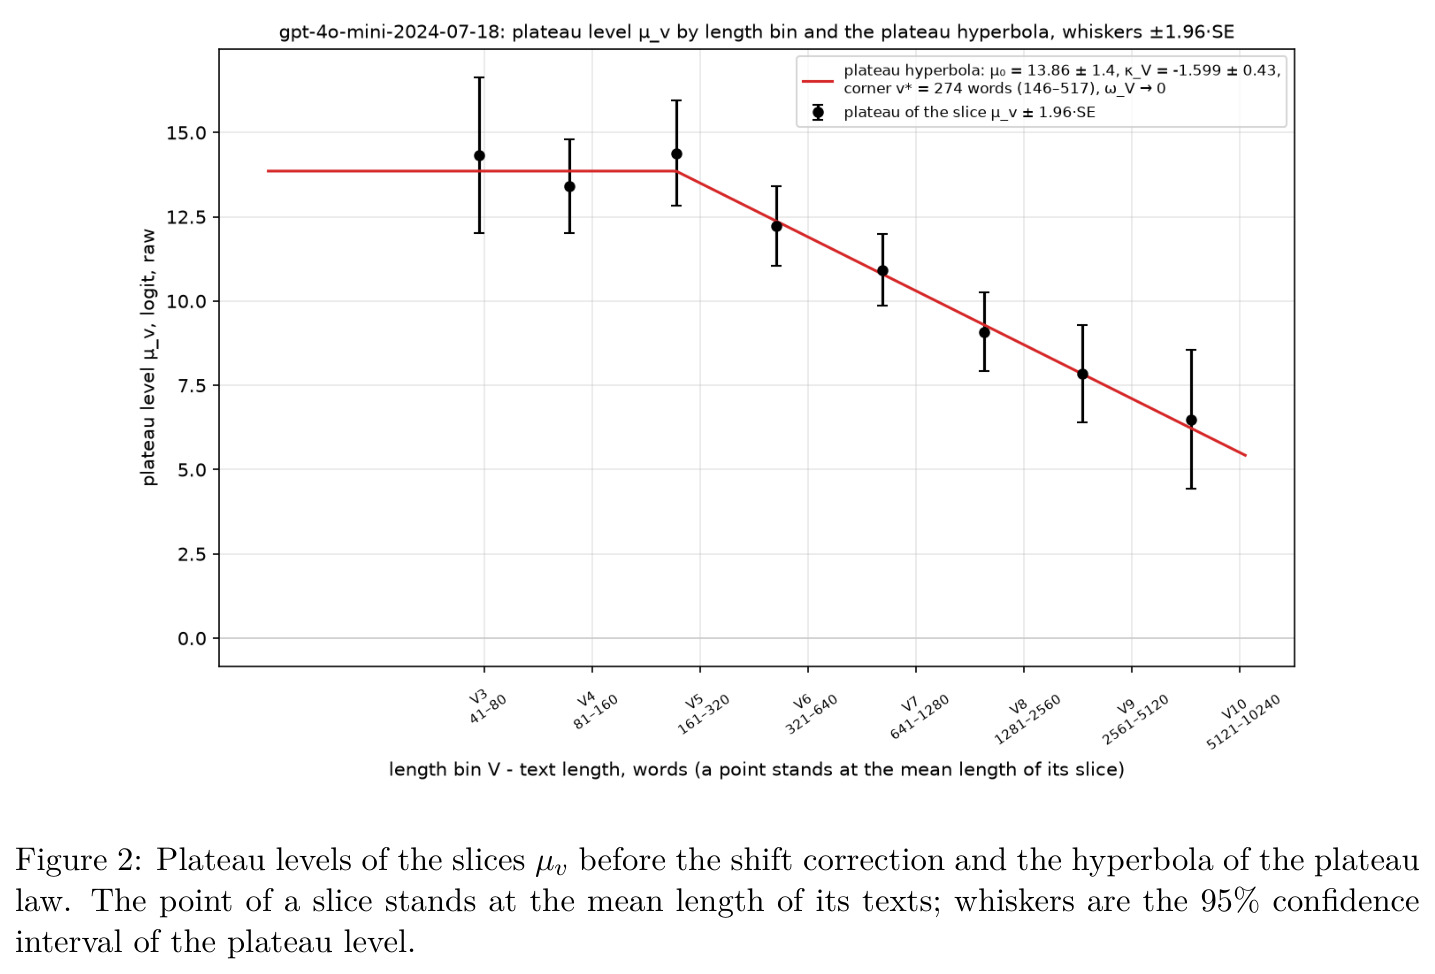
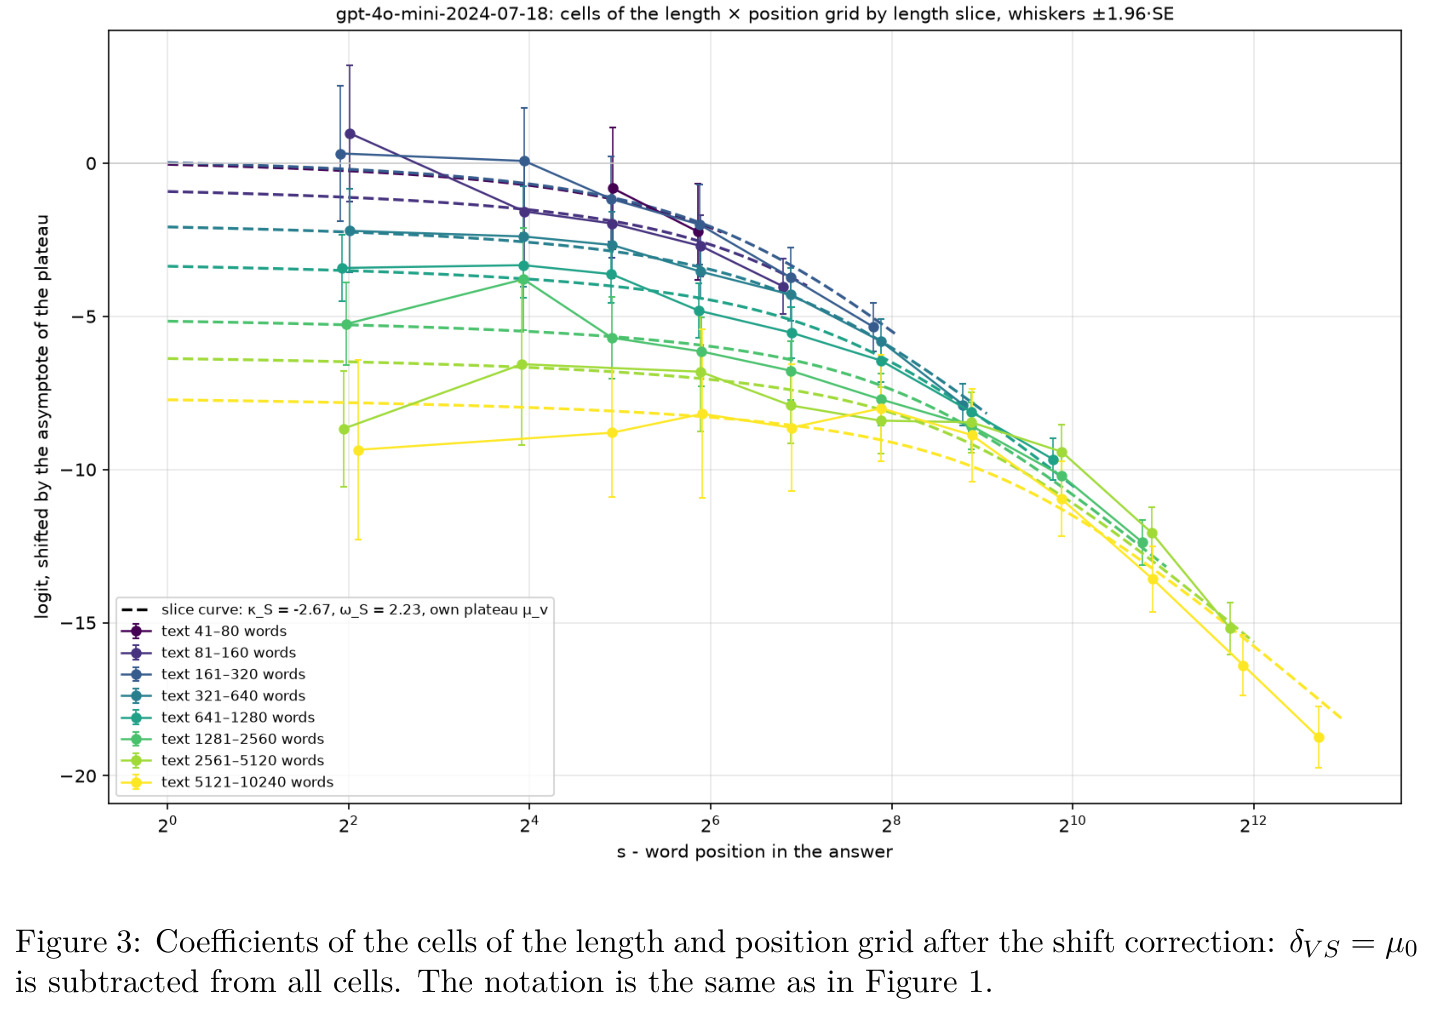
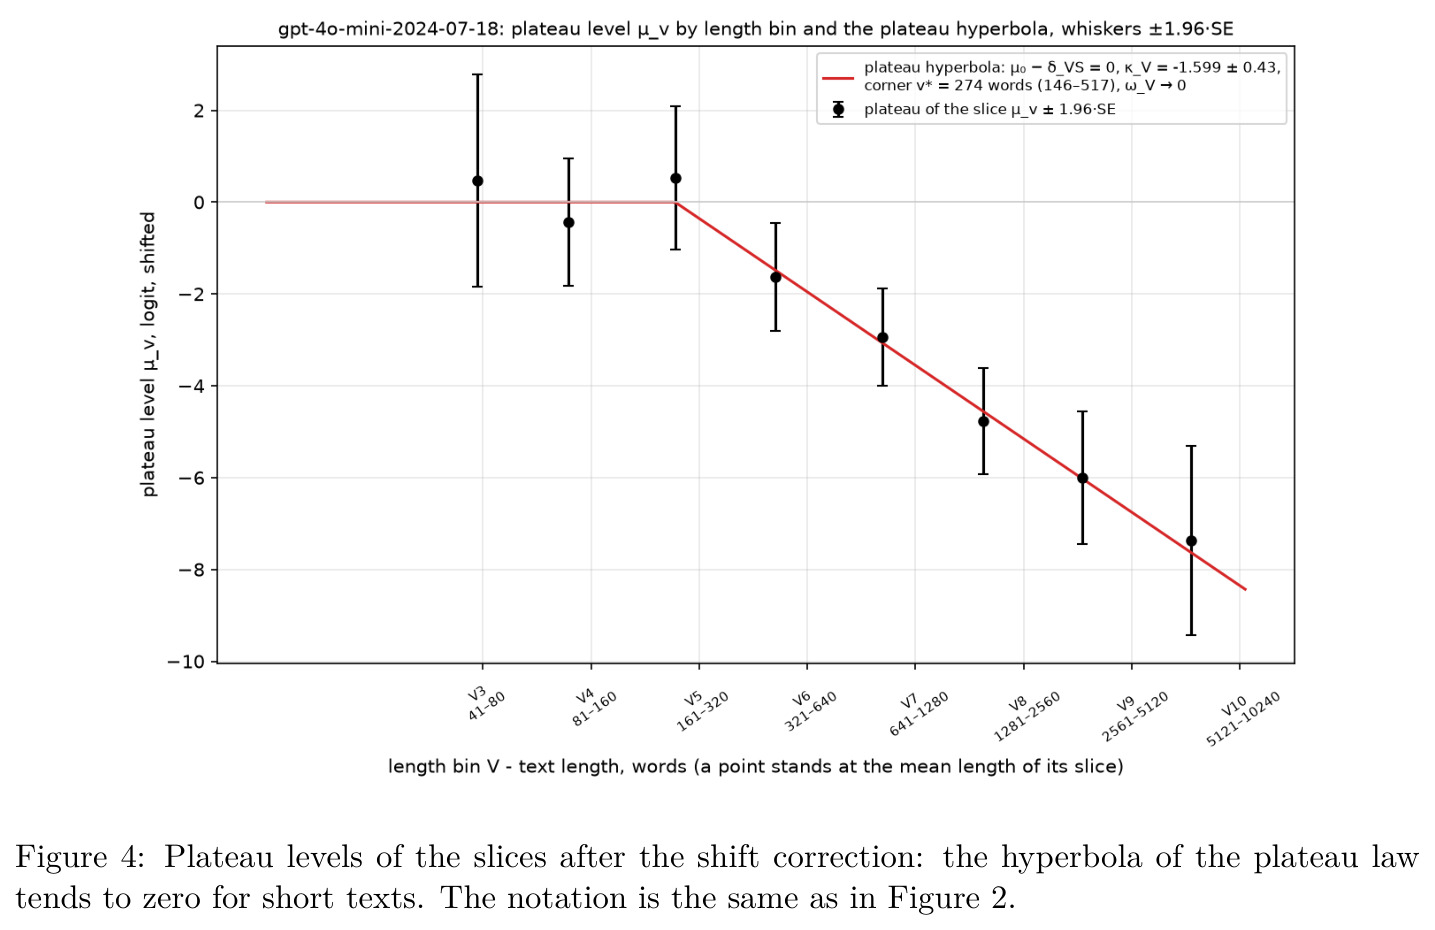
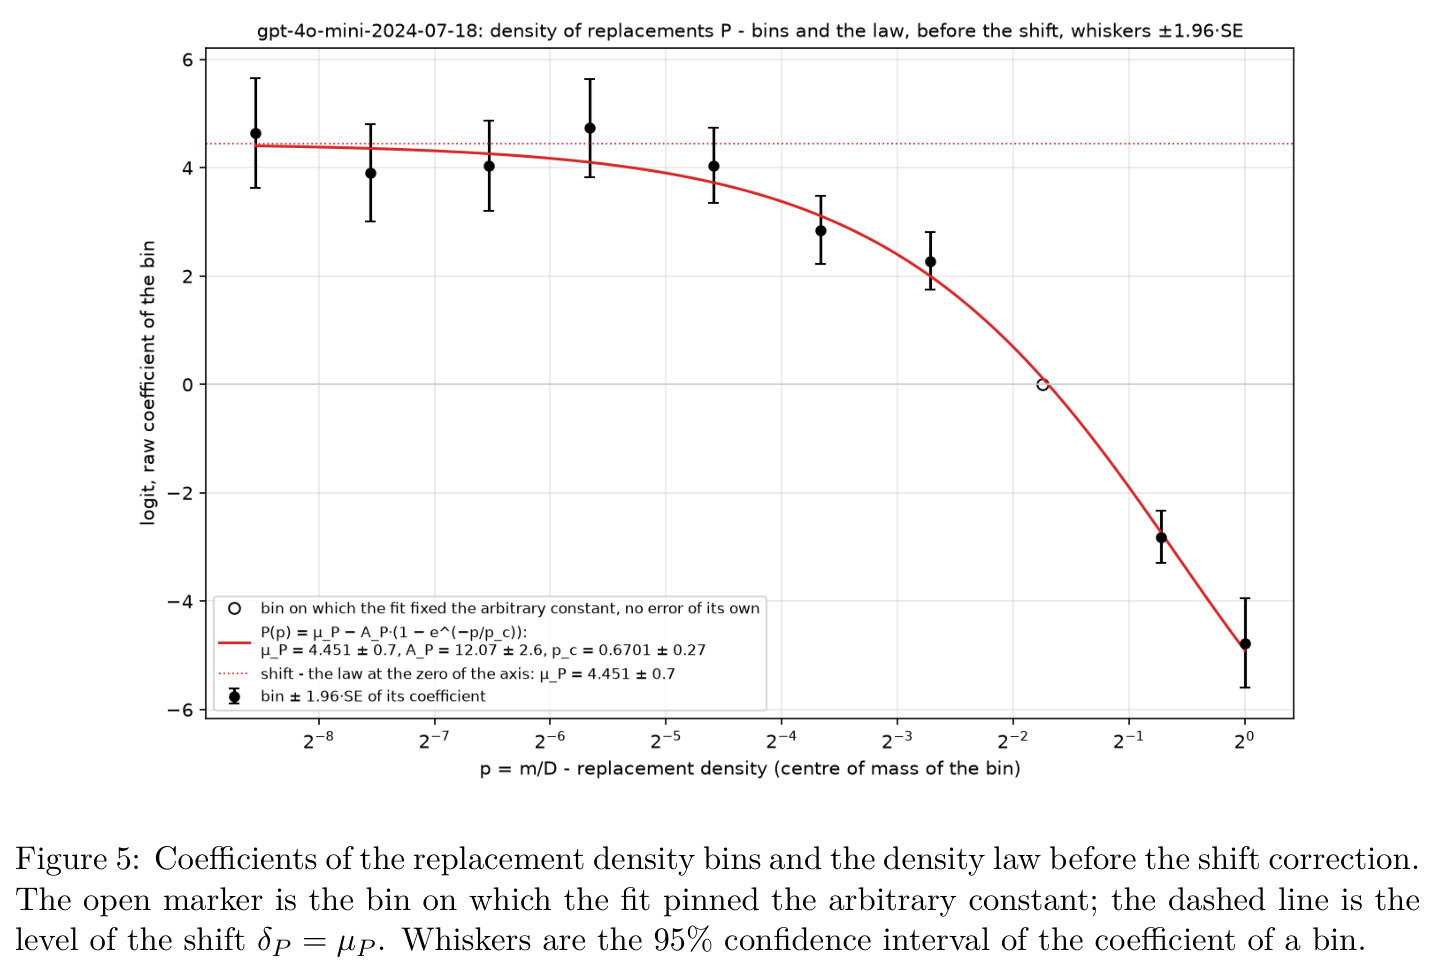
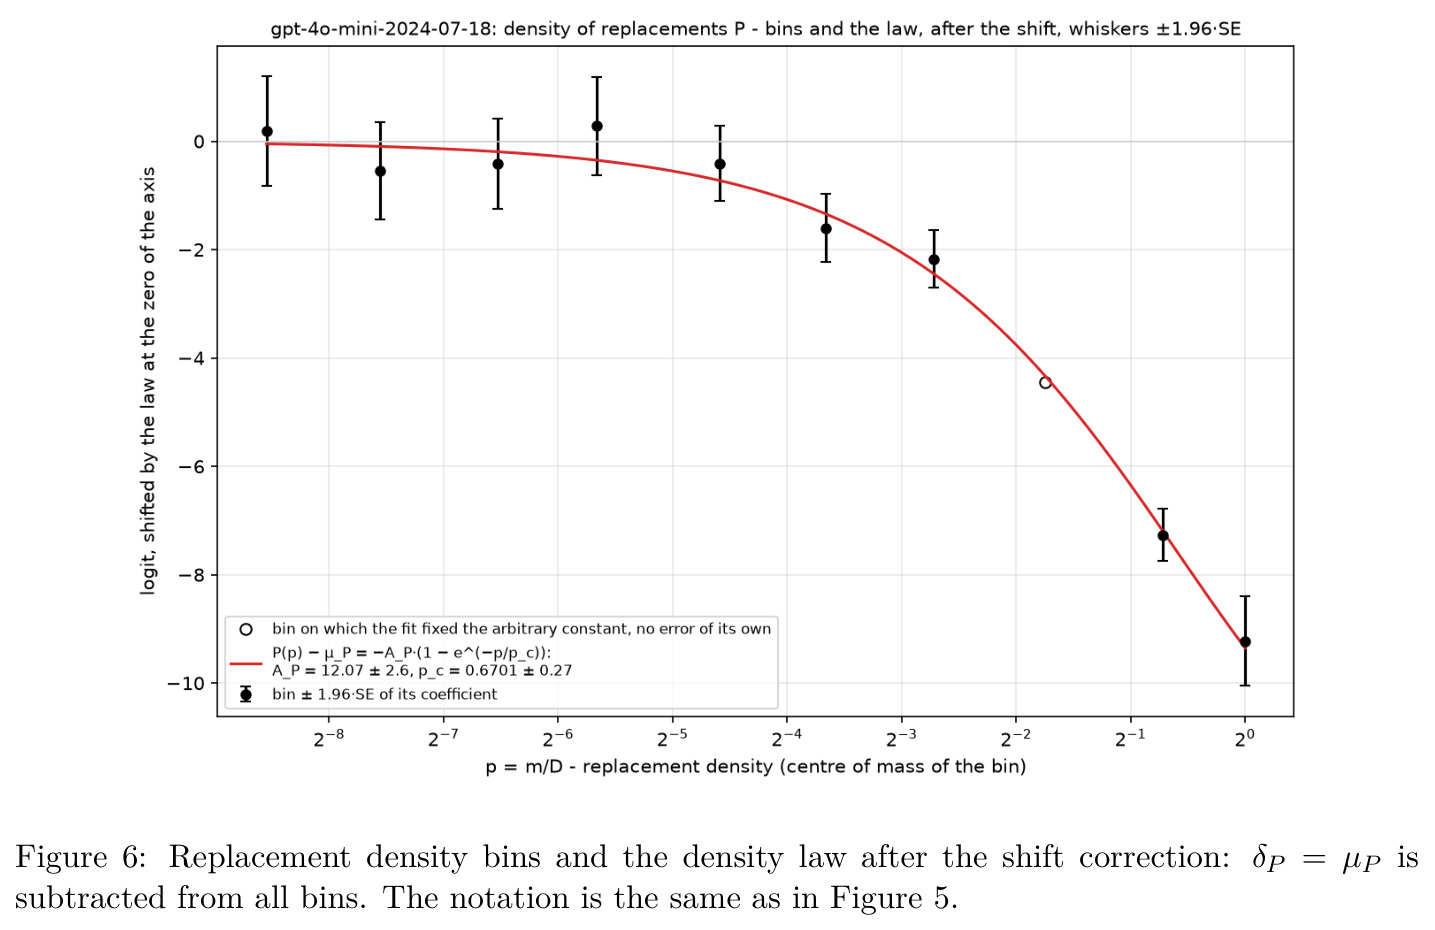
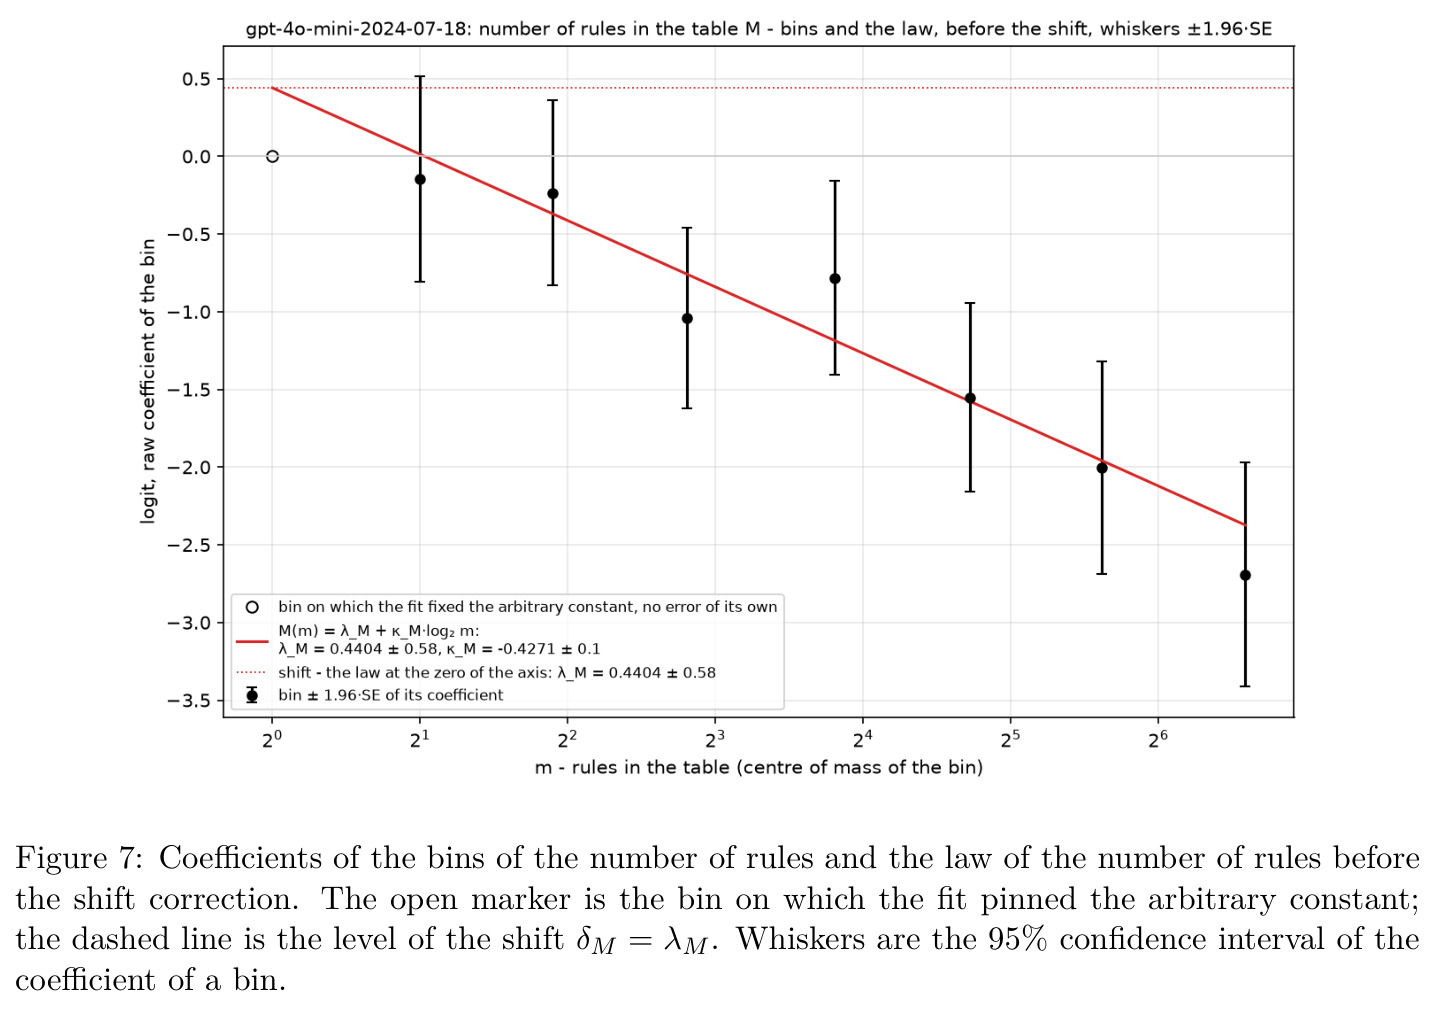
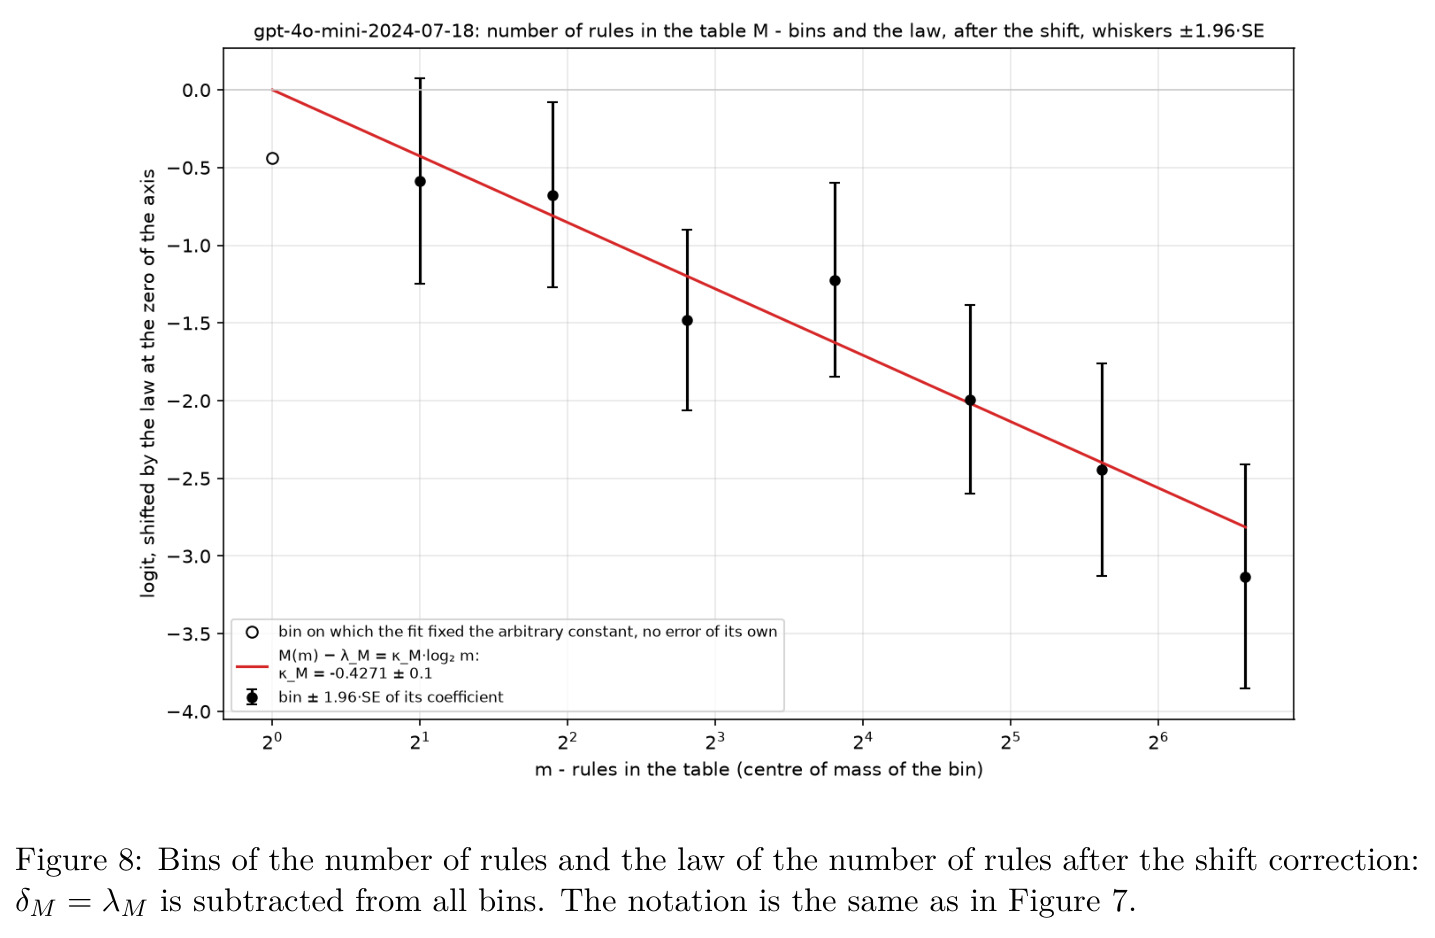
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 指令容量测量(零点:短文本、答案开头、稀疏替换) | IEC0.95(正确替换份额降至 0.95 时的规则数) | 36.58±5.41 条(分箱)/ 38.06±6.13 条(光滑定律) | 此前无可比参数:IFEval/Harada 只报告份额,Harada 的逻辑回归不含负载参数,RULER/NoLiMa 的有效长度只有倍增档位且无区间 | 首个以规则为单位、连续、带 95% 不确定度的指令容量参数 |
| 满替换密度下的保底容量 | IGC0.95(每个词都被替换,p=1) | 17.55±4.04 条(定律)/ 18.69±3.62 条(分箱) | IFScale 最多 500 词任务,最强模型履行 68% 且尚未到崩溃点,无法折算为容量 | 扣除密度饱和代价(9.35±1.01 logits)后给出可解释的容量下界 |
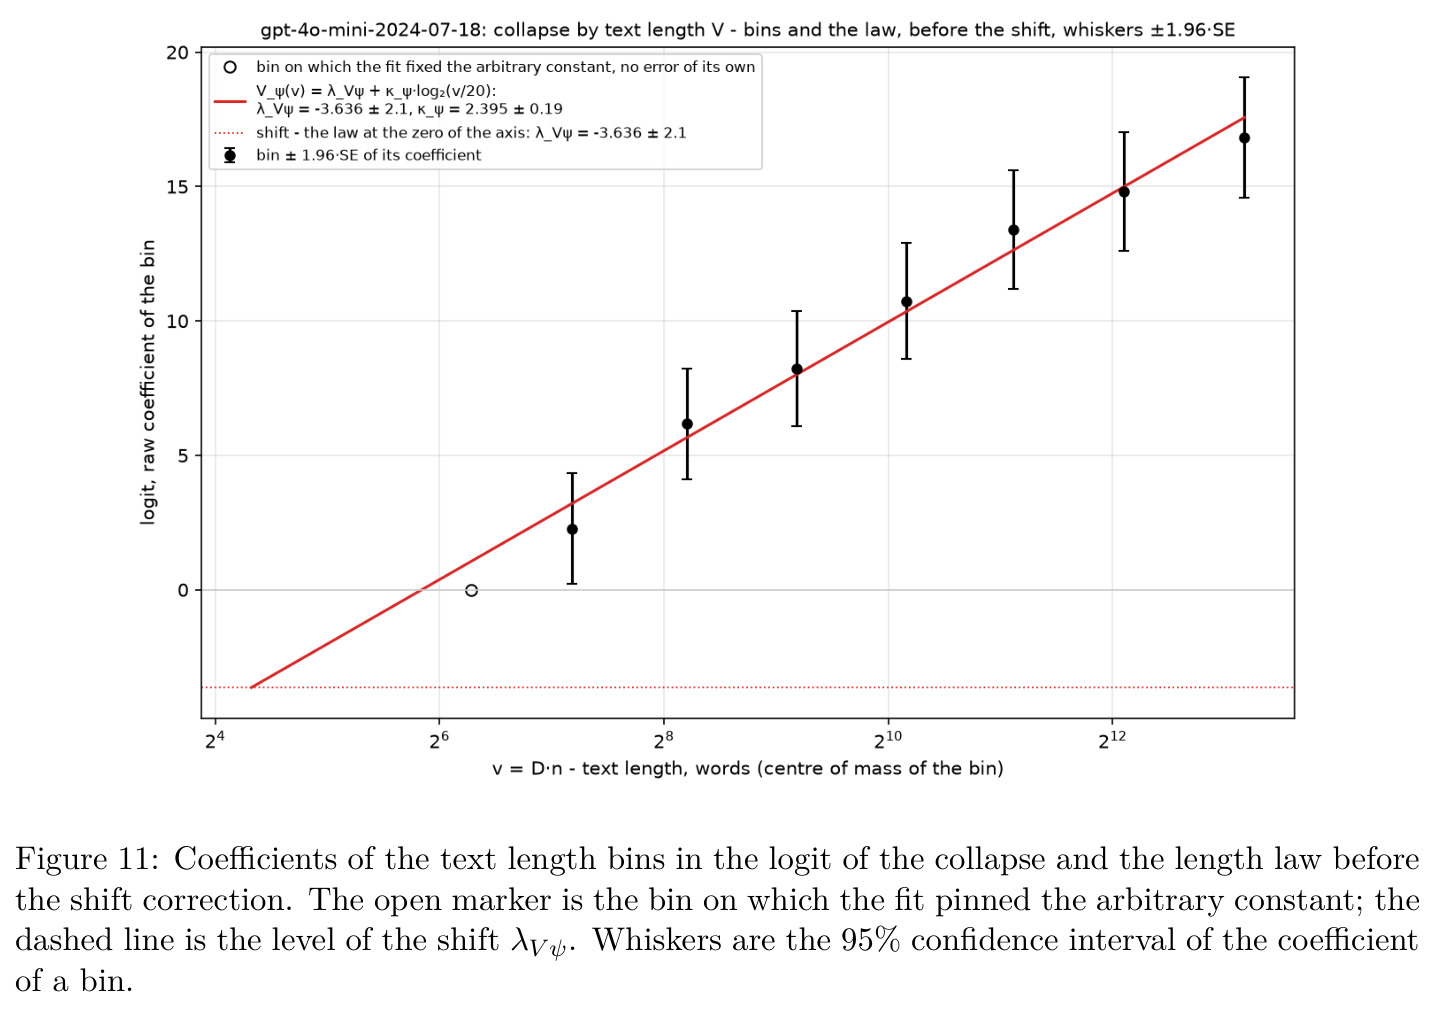
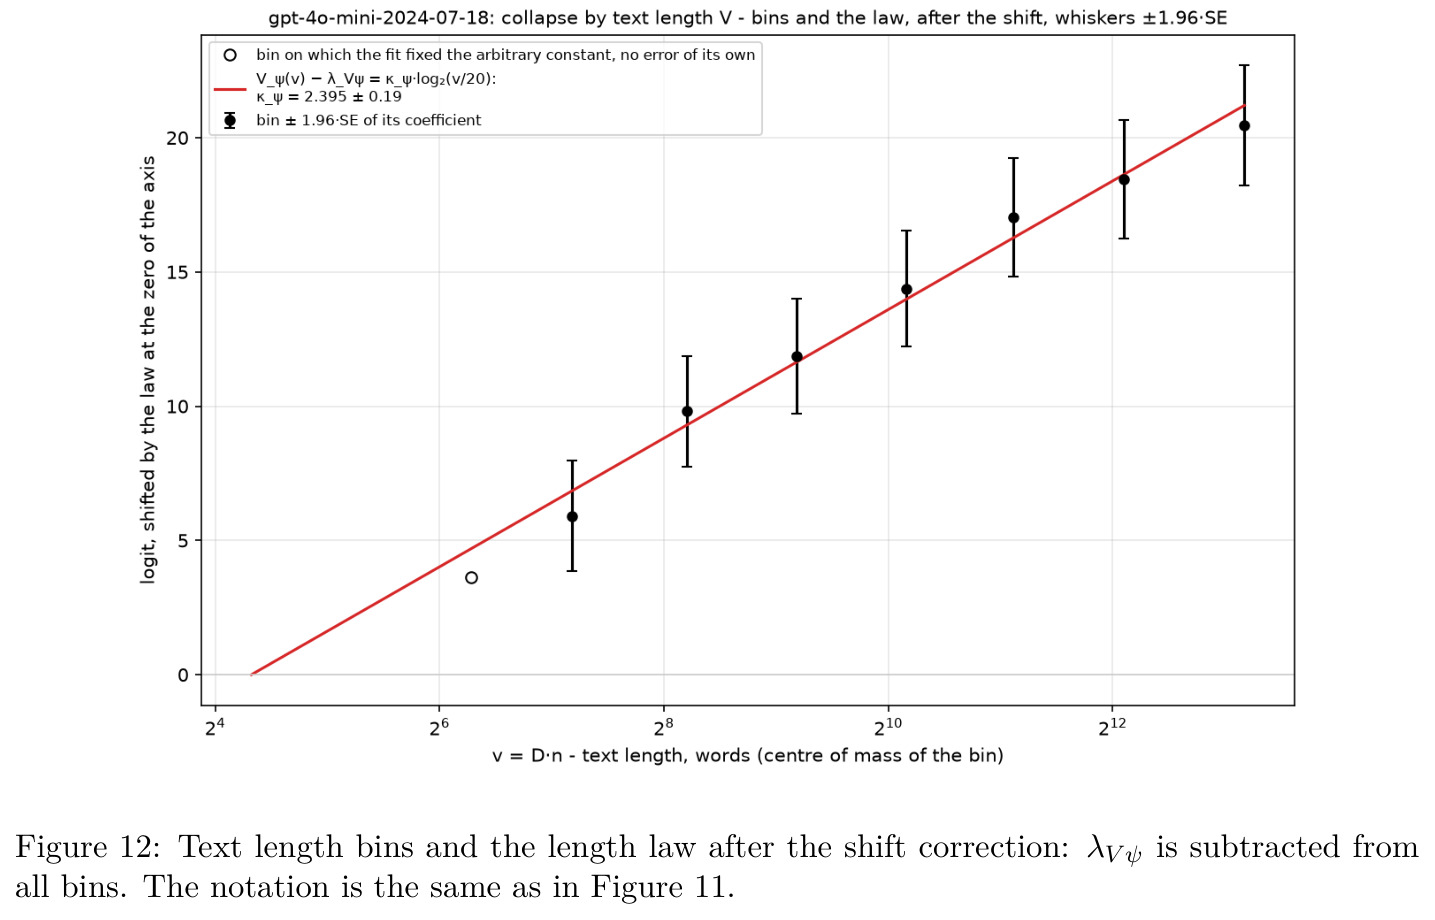
| 答案崩溃率建模(请求级三类失败) | 崩溃几率随文本长度的增长指数 | κψ=2.40±0.19,几率 ∝ (v/20)^3.5;密度贡献 Aψ=12.25±1.01;与规则数无关 | LongGenBench 仅定性观察到 4K token 后退化、约 45% 长答案退化为重复,无定量定律 | 首次给出崩溃的定量幂律,并证明其与指令容量是两种不同极限 |
| 答案核查 | 评估误差与偏差 | 程序精确比对参考答案,评估误差为 0,无法匹配位置一律记 0(不会高估) | 判官模型:Harada 全履行率 0.657 vs 程序 0.213;SEQUOR 误拒 11.5%;AdvancedIF 判官 F1=0.723;MMMT-IF 中判官偏袒同门模型 | 消除裁判噪声与偏差,全部离散度归于被测模型本身 |
| 答案内位置容量(疲劳) | FEC0.95(正确份额保持 0.95 的词数) | 3277±571 词;FEC0.5≈11890±1839 词(外推) | 无对应参数:LongGenBench 只给平滑曲线,RULER 有效长度精度仅 2 倍且无区间 | 给出连续的疲劳容量参数及其不确定度 |
局限与改进
作者明确承认的局限:所有定律只测了一个模型(gpt-4o-mini-2024-07-18),没有理由假设其形状普遍成立,更大或不同架构的模型可能出现极值、幂律或完全不同的显著轴;几处机理解释(归纳头复制机制、规则互相干扰、通过率限制)都只是假设,“仪器测量的是依赖的形式而非原因”;替换密度与文本长度是相关最强的一对轴(Table 3 中相关 0.76),稀疏替换的渐近水平主要靠长文本支撑,二者的分离依赖模型可加性假设;FEC0.5 超出测量区域(文本最长 10 240 词),只能外推。我自己的观察还有几点:容量定义在“零点”(答案开头、短文本、稀疏替换),真实提示几乎从不处于该状态,须另行换算;规则是约定单位,依赖提示模板与词表,跨协议不可比;实验点的自适应规划技术是闭源黑箱,虽不影响护照复算,但测量区域的选择本身不可审计;每个任务只生成一次回答(温度 0、固定种子),模型侧随机性与种子稳定性没有被独立重复验证;请求难度方差很大($\sigma^2=5.90$),把 0.95 等级阈值从 2.94 推到 4.97 logits,容量估计对这一方差相当敏感。
独立分析的弱点
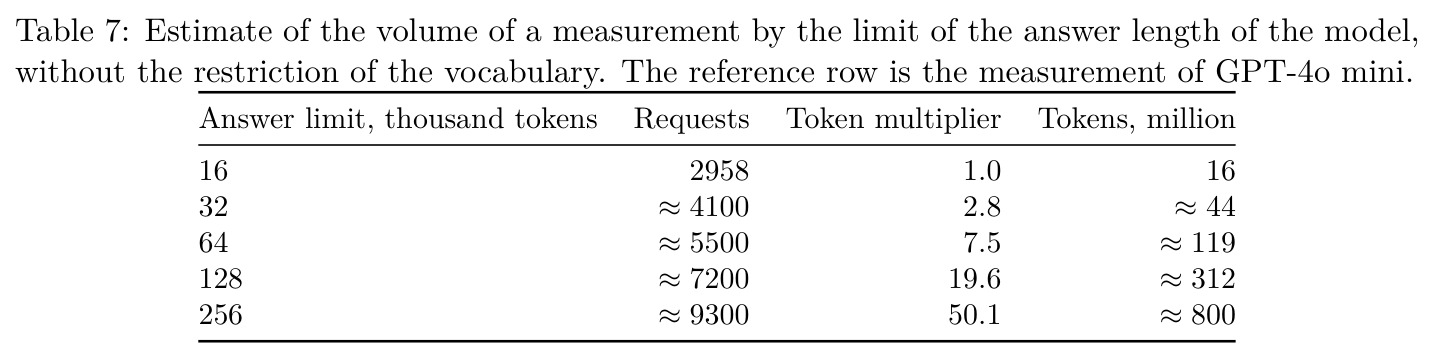
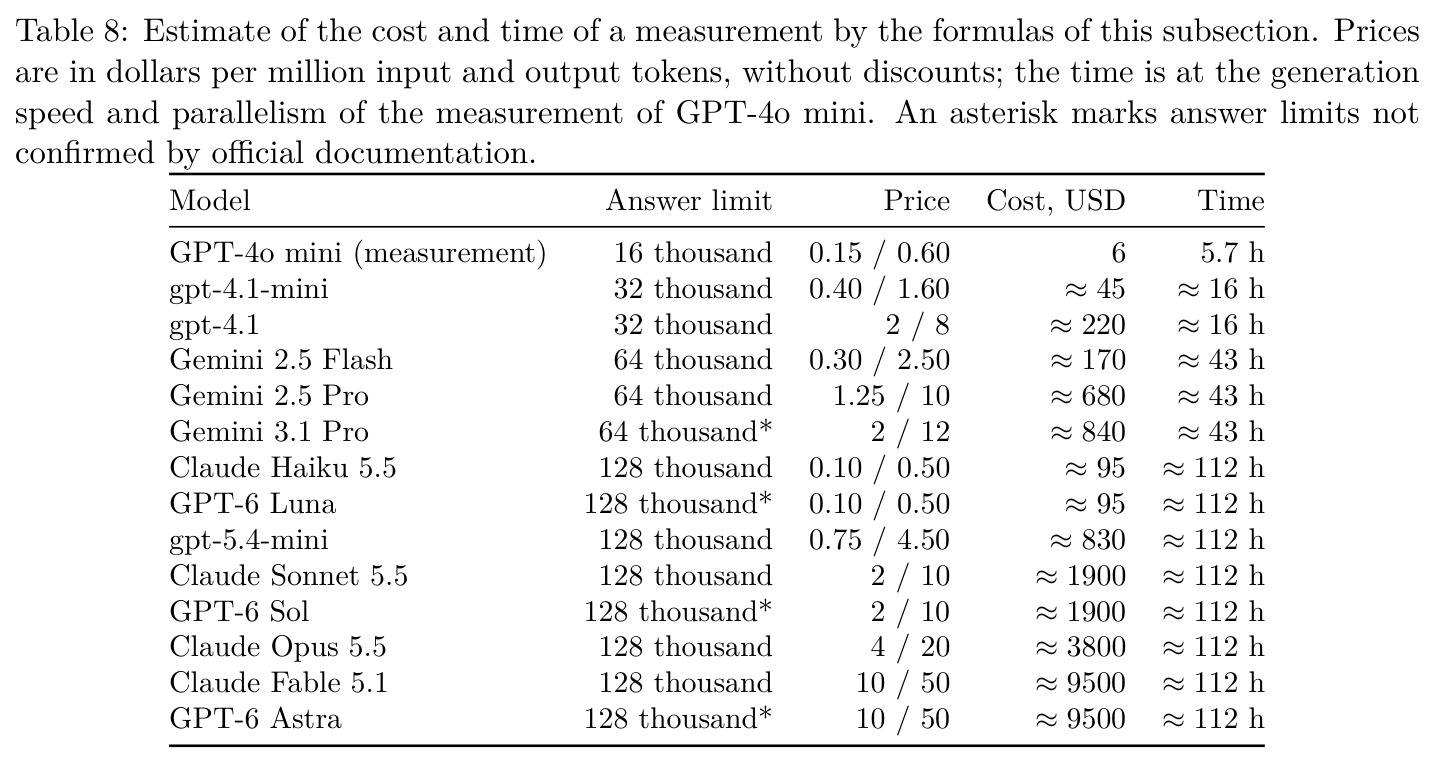
(1)单模型证据:全部定律来自一个小模型,是否适用于其他模型未知,作者也承认无普遍性依据——应尽快给出 3–5 个不同厂商、规模的护照检验定律形状的稳定性。(2)词表与协议绑定:2 220 个单 token 词只对三个分词器保证原子性,Claude 等不公开 tokenizer 的模型只能用 token 计数间接验证;且“一条规则=一个单位”依赖特定提示模板与校验协议,换模板需重新校准——应发布多模板、多语言词表的交叉校准系数。(3)满密度的生态效度:满密度替换对应“逐词改写”,但真实 prompt 的多条指令通常作用于共享文本,密度轴能否代表这种负载尚未证明——可设计“规则+并行实质任务”的桥接实验验证等效性。(4)崩溃的核算:崩溃后所有后续试验记 0 虽保守,却把“位置保持失败”与“规则执行失败”混入同一容量核算,作者用独立崩溃定律缓解但未彻底分离——可用生存分析把崩溃作为删失事件同时建模。(5)大模型成本:答案长度上限使 token 需求超线性增长(128K 上限约 7200 请求、3.12 亿 token、112 小时,百万 token 级模型约 50 亿 token),全立方扫描只在首发校准时可行——选择性复测策略本身仍是未解问题。
未来方向
作者提出的方向:一是给尽可能多的不同类别、不同代际模型建护照,比较退化定律本身——显著轴的组成、单调性、对数还是幂律——与模型内部结构的关系,形成护照目录;二是“提示称重”:把待测 prompt 放在规则表旁边,测其对独立对照任务正确率的影响,按护照定律换算成等效规则数,使模型容量与提示负载同尺度可比,催生提示负载计量学。基于本文成果还可延伸:把候选轴 c(词在完整上下文中的位置,5.2 节已验证含独立信息)纳入模型;用归纳头探针或激活补丁检验复制机制的因果解释;把崩溃建模换成生存分析以同时估计崩溃率与崩溃位置;为无公开 tokenizer 的模型建立标准化的间接单 token 校验流程;发展基于已知定律的序贯/最优实验设计,把复测成本再降一个数量级(作者估计至少可降 10 倍);以及把词表扩展到其他语言,检验退化定律的跨语言稳定性。
复现评估
复现条件在同类工作中属于极好:代码 MIT 许可、数据与文档 CC-BY 4.0,公开仓库(github.com/kutomanovhennadii/instruction-capacity)含单点执行代码(种子生成任务→调用模型→校验答案)、建护照与校验代码、词表及其生成代码,以及完整测量记录(每点含提示、答案、token 计数与校验和)。运行 python scripts/verify.py 会比对校验和、用种子逐字节重生成每个任务并重算护照,全程不调用模型,任何护照数字都能在普通电脑上免费复核。任务材料来自 CMU 词典 0.7a 与 WordNet 3.0 固定版本,可逐字节重现。测量本身仅耗 6.03 美元、5 小时 43 分钟(借 OpenAI 流量共享计划的免费 token),算力与费用门槛极低。主要障碍:自适应点选择技术是闭源部分(不影响护照复算,但无法复现同一测量区域);依赖特定 API 版本(gpt-4o-mini-2024-07-18),存在退役风险;跨厂商模型需各自重建词表并处理 tokenizer 不公开问题。总体:复算护照=入门级;在另一模型上完整测量=中等,成本主要在时间与 token。
论文图表
词表筛选漏斗:CMU 词典 123 455 → 小写拉丁 115 533 → ≥3 字母 115 318 → 单音节 14 884 → WordNet 名词 5 750 → 单数 3 581 → 三分词器均单 token 2 220 词。
说明原子性(一词一 token)与同质性(单音节单数名词)如何在工程上落实,词表是任务可复现与跨模型可比的基础。
VS-PMR 五轴两两的典型相关:V–P 最高 0.76,V–M 0.53,R 与其他轴最弱(0.10–0.42)。
说明选出的坐标系分离度如何、可加性假设在哪些地方最脆弱(密度与长度),是评估定律可信度的必要背景。
崩溃定律参数:速率律 λψ=−20.00±1.58、κψ=2.40±0.19、Aψ=12.25±1.01、γψ=0.71±0.09;位置律 λF=−10.65±1.99、κSF=1.14±0.21、s*≈40 词、AF=6.95±1.56、γF=0.42±0.16、κQF=3.19±0.59。
汇总崩溃速率与位置的两组定律,支撑“崩溃由文本负载与生成进程决定、与规则数无关”这一独立极限的结论。
三容量总表:IEC0.95=36.58±5.41 / 38.06±6.13 条,IEC0.5=43.90±6.62 / 46.09±6.61 条;IGC0.95=18.69±3.62 / 17.55±4.04 条,IGC0.5≈29.5–29.8 条;FEC0.95=3277±571 词,FEC0.5=11890±1839 词(外推)。
论文的最终交付物:摘要中“37–38 条规则(0.95)与 18–19 条(满密度)”的出处;分箱与定律两算法的差异均小于不确定度,互为校验。