OmniShowcase:从多视角图像生成全向主体一致视频 OmniShowcase: Omnidirectional Subject-Consistent Video Generation from Multi-View Images
以参考视图重建的法向转盘为几何条件,实现360°全向主体一致视频生成
前置知识
Subject-to-Video (S2V) 生成
给定一张或多张参考图像与文本提示,生成一段视频,要求主体在整段视频中保持外观一致。主流方法(Phantom、MAGREF)把参考图作为 in-context 条件拼入视频扩散 Transformer 的序列,靠注意力机制把参考外观注入生成帧,无需对每个主体做测试时优化。本文的设定是 S2V 的加强版:相机要绕主体旋转甚至完成 360° 轨道,因此不仅外观要一致,转出来的 3D 结构也必须一致。
本文的问题设定、所有基线(Phantom-MV、MAGREF-MV、MV-S2V、3DreamBooth)和评测协议都建立在 S2V 框架上,不理解 S2V 的条件注入范式就无法理解本文改进了什么。
Rectified Flow 与扩散 Transformer (DiT)
现代视频生成主干(如 Wan2.1)采用 DiT 架构和 rectified flow 训练:对潜变量做噪声插值,模型学习速度场,训练目标是让预测速度逼近真值 $z-\epsilon$,即 $\mathcal{L}=\mathbb{E}\|\hat{v}_\theta-(z-\epsilon)\|^2$;推理时沿学到的流做 50 步迭代采样。视频 VAE 把像素压缩到时空潜空间(本文因果 VAE 时间压缩因子为 4)。
本文的损失函数(式 4)、三流通道拼接的噪声化方式(式 2-3)、以及 latent 帧数计算(27 帧 latent 解码为 105 帧)全部依赖这套机制,不懂 rectified flow 就读不懂方法章节的核心公式。
LoRA 低秩适配
冻结预训练模型的全部权重,只在每层注入低秩增量 $\Delta W = BA$,其中 $B\in\mathbb{R}^{d\times r}$、$A\in\mathbb{R}^{r\times k}$,秩 $r$ 远小于维度。训练参数量和显存开销大幅下降。本文用 rank 128、$\alpha=128$ 的 LoRA 微调 Wan2.1 I2V-14B,其余权重全部冻结。
本文走的是「小数据 + 轻适配」路线:4,000 条视频、4 张 B200 训 50 小时就能把 I2V 模型改造成多参考几何条件 S2V 模型,LoRA 是这条路线成立的前提,也直接影响复现成本估计。
前馈多视图 3D 重建与 3D Gaussian Splatting
以 DUSt3R/VGGT/$\pi$3 为代表的前馈重建器,单次前向传播即可从若干未标定图像预测对齐的 pointmap,无需逐场景优化;再由多视图融合模块(本文用 MV-SAM3D)把各视图点聚合成一组 3D 高斯,就能在新视角渲染深度图,深度梯度可进一步转为表面法向。本文用 Depth Anything 3 加 MV-SAM3D 从 4 张参考图重建主体,再沿偏航轨道渲染 25 帧法向转盘。
本文整个几何条件分支(训练和推理完全相同的流程)就建立在这些前馈重建器之上;理解「从稀疏参考图直接拿到可渲染几何」的能力边界,才能判断该方法在真实数据上的适用范围。
表面法向图(surface normal map)
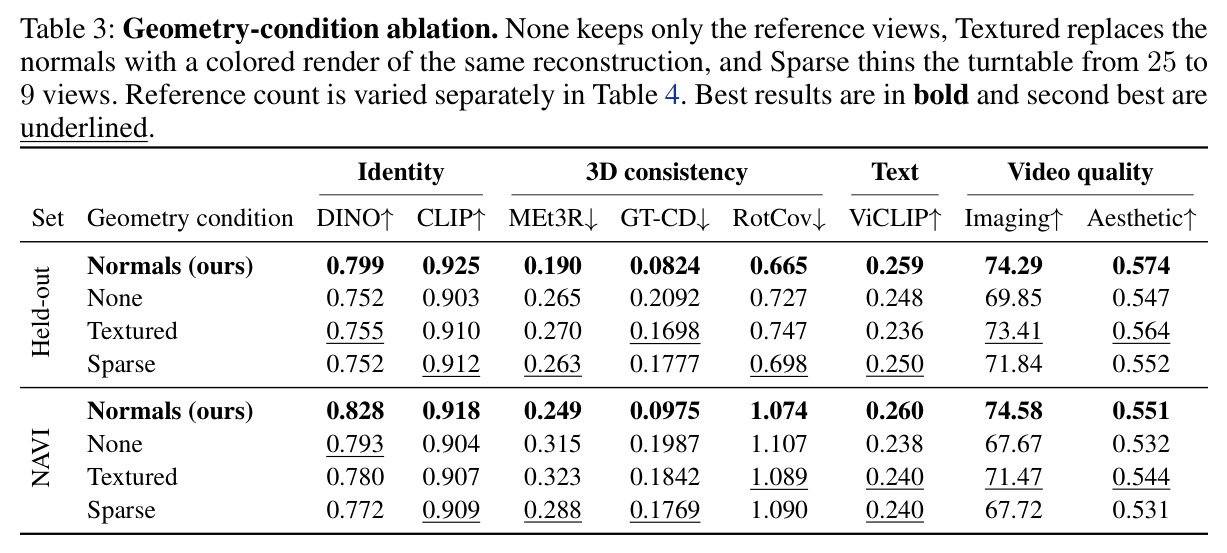
每个像素编码该处表面朝向 $(n_x, n_y, n_z)$ 的图像,只描述几何形状、不携带颜色和纹理。相比深度图,法向对平滑曲面的变化更敏感,能表达凹凸结构。本文特意选法向而非彩色渲染作为几何条件:消融实验显示彩色渲染会与参考图「竞争」外观信息,导致文本对齐下降,而法向纯粹补充三维结构信息。
法向转盘是本文的核心条件信号,理解它「只含几何、不含外观」的性质,才能理解为什么它能与参考图互补而不是冲突,也才能读懂 Table 3 中 Textured 变体的失败原因。
GT-CD 与 MEt3R:3D 一致性评测指标
GT-CD 是对称 Chamfer 距离:把生成视频用 $\pi$3 提升为点云,与真值网格点云各自做质心中心化、平均半径归一化,再用固定尺度的刚性 ICP 对齐,最后计算对称最近邻平均距离 $\mathrm{GT\text{-}CD} = \frac{1}{2}(d(P,Q)+d(Q,P))$,衡量生成形状与真值形状的偏差。MEt3R 则直接度量参考帧与生成帧之间的多视角一致性。
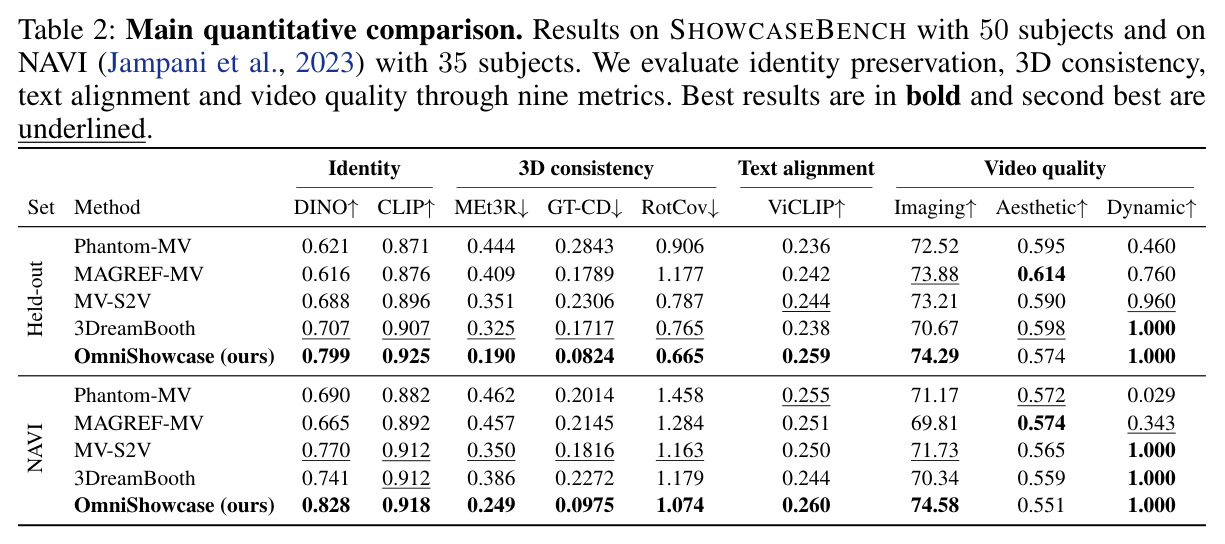
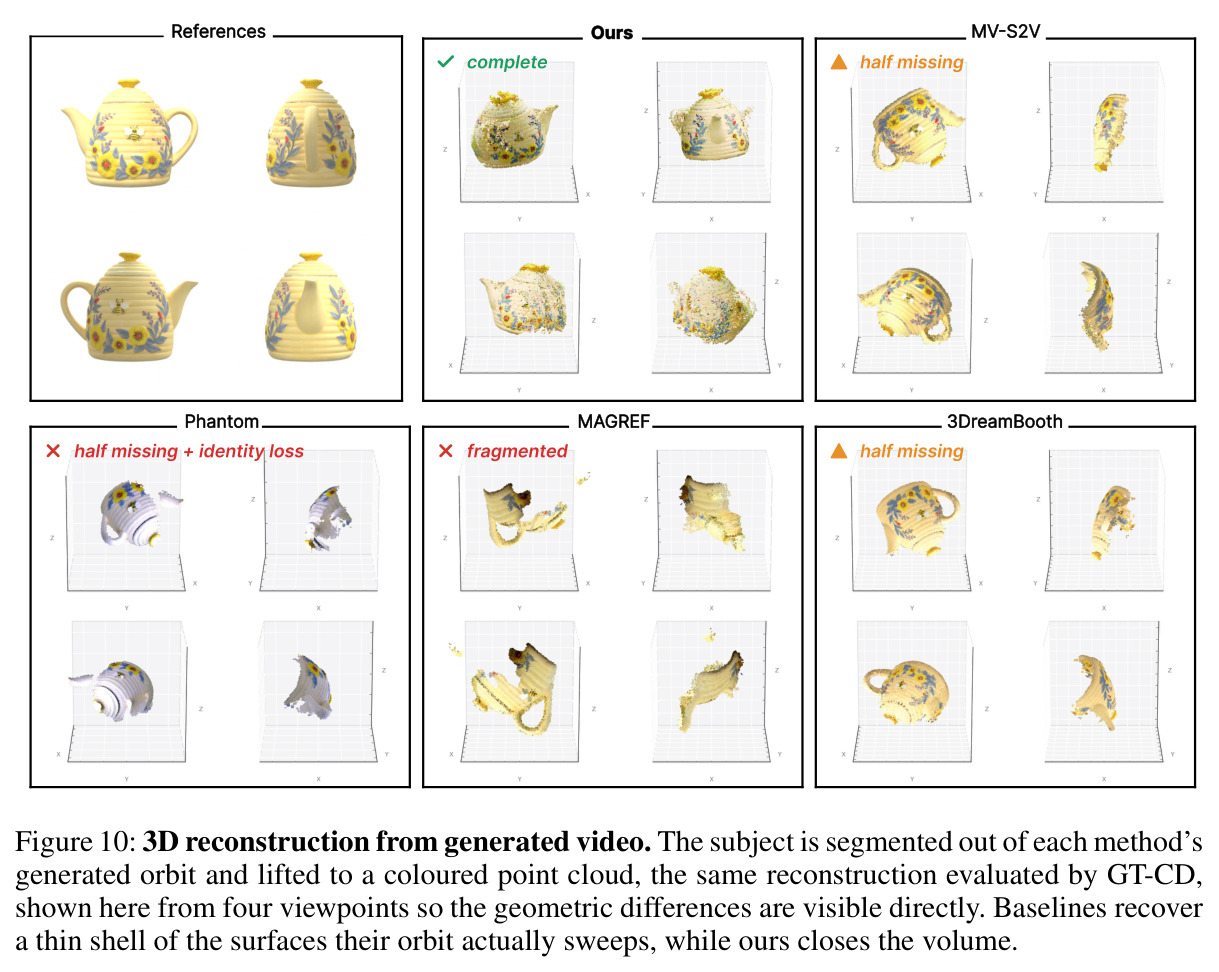
本文最重要的卖点是 3D 一致性,而 GT-CD 是首个针对多视角 S2V 提供真值几何监督的指标之一(依赖 SHOWCASEBENCH 提供的源网格),看懂它的计算流程才能正确解读 Table 2 中 0.0824 对 0.1717 这类数字的含义。
研究动机
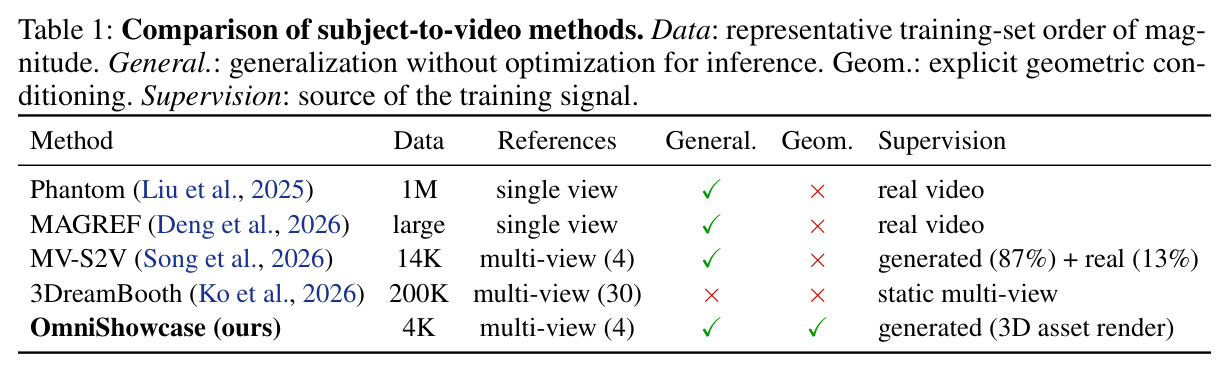
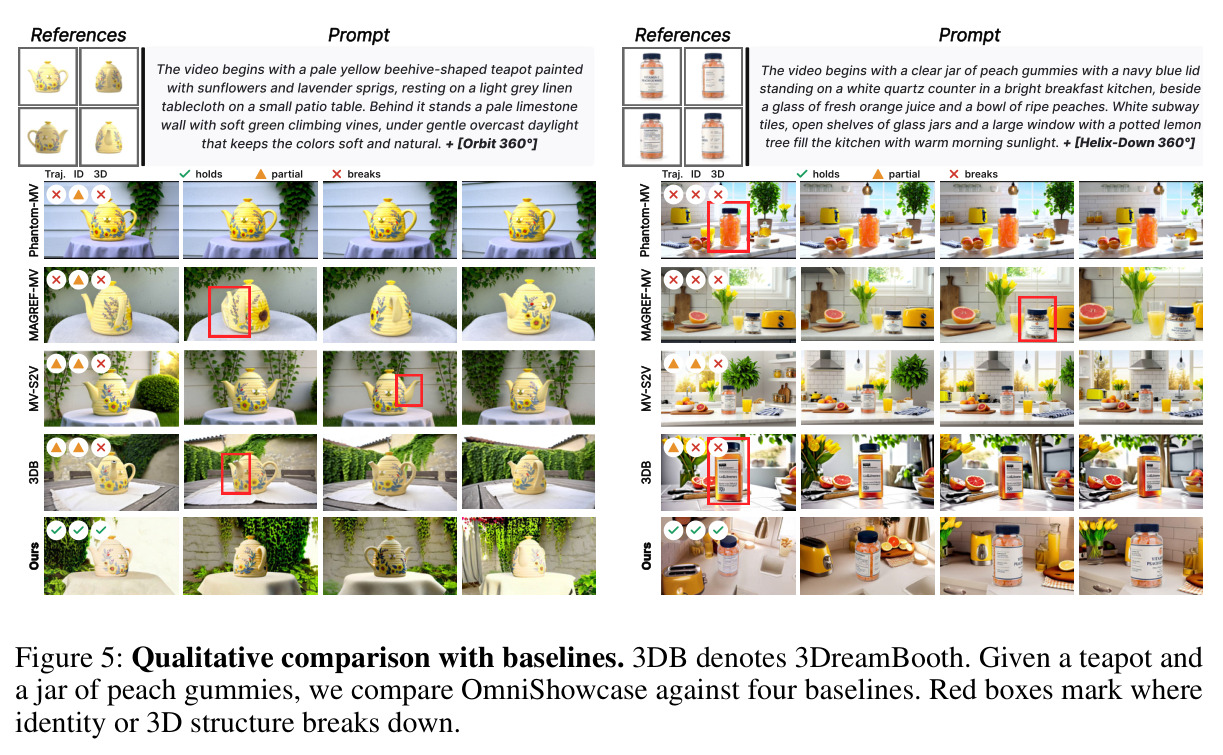
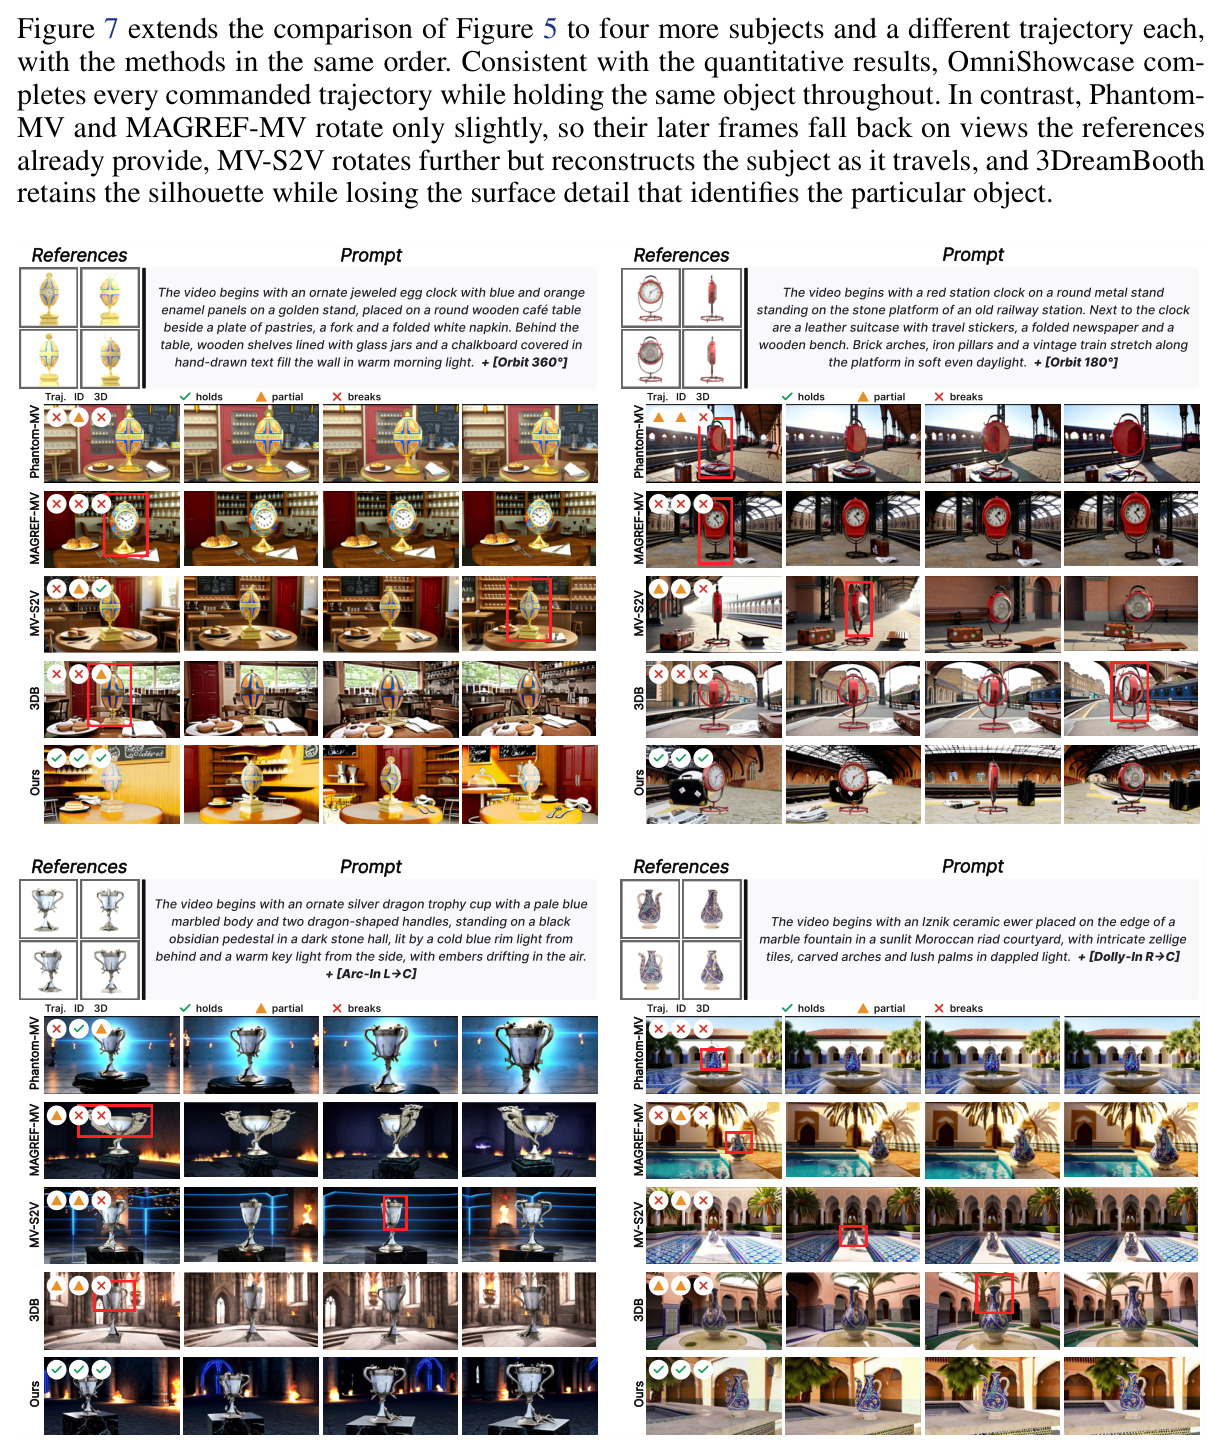
主体驱动视频生成(S2V)的主流方法大多只条件在单张参考图上,例如 Phantom 和 MAGREF:参考图只提供可见表面的外观信息,其余表面完全交给生成先验去「猜」。当文本要求相机绕主体旋转、揭示参考图中看不到的背面时,生成的视频会出现剪影改变、结构漂移、表面细节不一致等 3D 不一致现象——这在 360° 轨道这种大视角变化场景下尤其严重。近期工作开始引入多参考视角:MV-S2V 把 4 张参考视图喂给视频扩散 Transformer,但参考只提供几个离散视角的外观,没有显式编码连接这些观察的 3D 结构;而且它的训练视频由相机可控的视频生成器合成,视角变化并不绑定于同一个底层 3D 资产,导致同一片段内会出现主体长出第二个壶嘴、跳回早期帧这类崩溃。3DreamBooth 使用约 30 张静态多视图做逐主体优化,每个新主体都要重新训练,无法即插即用;真实多视角采集数据虽然满足几何一致,却不附带显式几何条件。作者在定性对比(Figure 5)中展示:各基线在 360° 命令下要么几乎不旋转(Phantom-MV、MAGREF-MV 在 NAVI 上的动态程度低至 0.029 和 0.343),要么旋转途中主体解体,没有一个方法能同时守住轨迹、身份和 3D 结构三关。
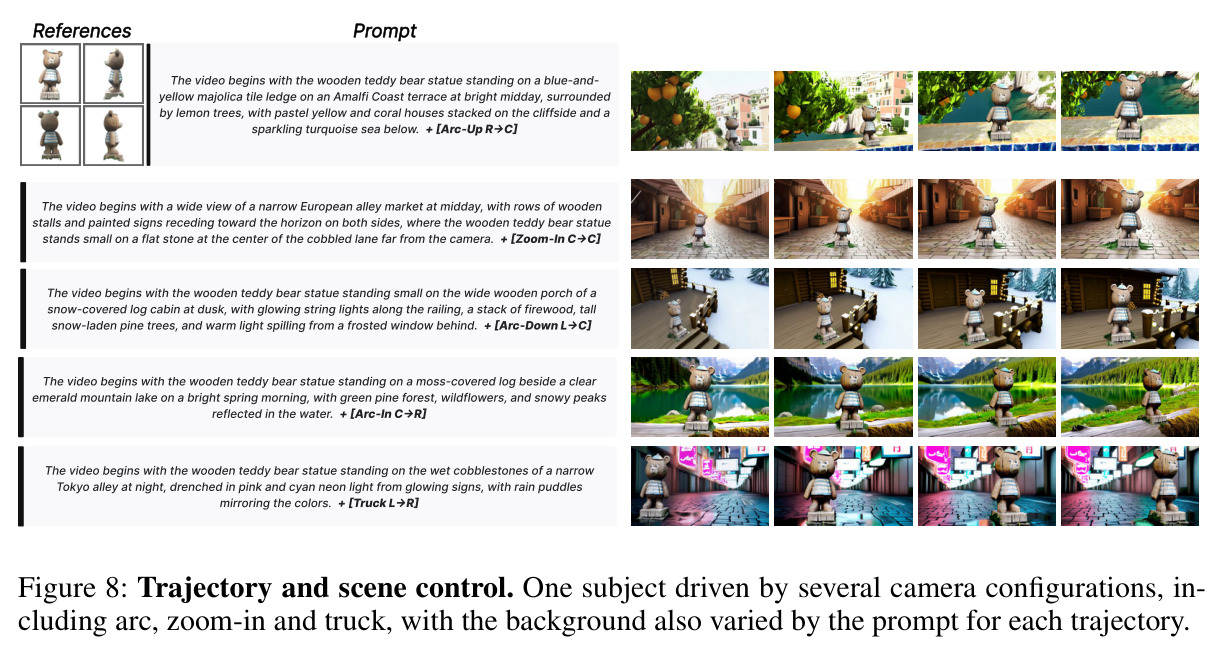
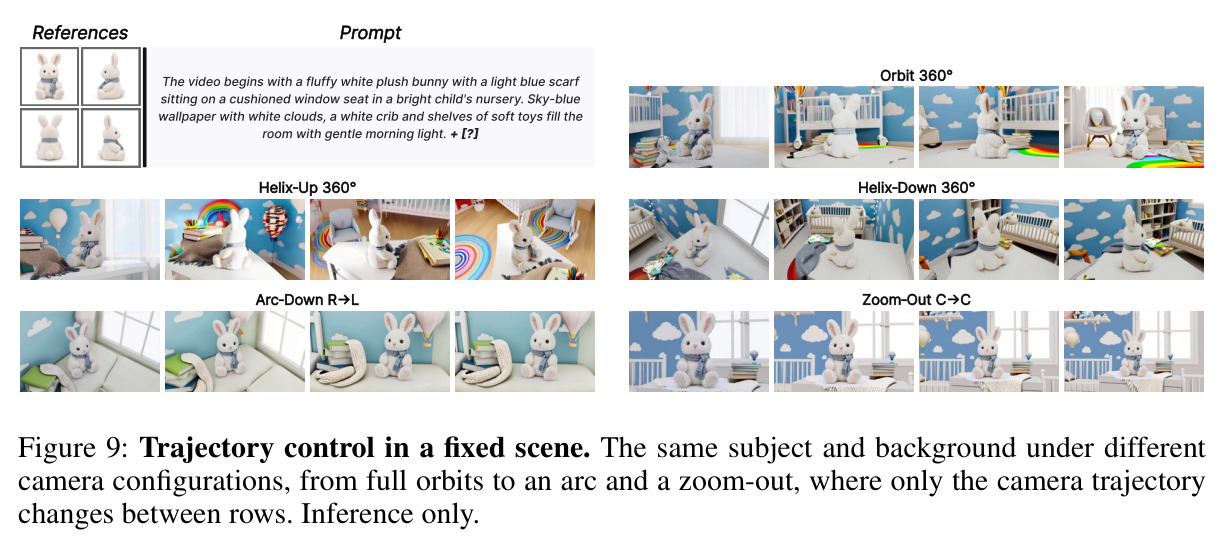
本文的目标是本文的目标是:给定一个主体的少量参考视图(实验中固定为 $N=4$ 张、偏航间隔 90°)和一个带相机轨迹描述的文本提示,即插即用地(无需任何逐主体优化)生成一段跟随指定轨迹——包括完整的 Orbit/Helix 360° 旋转以及 arc、truck、dolly、zoom 等扩展运动——的视频,使主体在每一个被揭示的视角上都保持外观身份和 3D 结构一致。同时,这项能力不能以牺牲文本对齐和视频质量为代价:在 ViCLIP 文本对齐和 VBench 成像质量上要保持与基线可比或更优。为支撑训练与评测,还需要解决两个基础设施问题:其一,构造一个保证「同一 3D 主体在几何一致的视角变化下被拍摄」的训练语料 SHOWCASE-4K(4,000 条视频、88 种轨迹配置、附重建法向条件);其二,构造一个带真值网格和相机参数的保留评测集 SHOWCASEBENCH,使 3D 一致性可以用 GT-CD 这样的几何指标严格量化,而不是依赖容易饱和的外观相似度。
与已有工作不同的是,本文的独特切入有两个互补的方向,分别对应数据和条件两端。数据端:作者论证相机可控视频生成器产出的训练数据天然无法保证「视角变化保持同一 3D 主体」,因为未见表面仍由生成先验合成;而直接从 3D 资产渲染可以一次性满足主体身份、几何一致视角变化、显式几何三个要求,再用视频修补(VACE)把干净背景渲染的主体合成进提示驱动的真实场景弥补域差距——这是首个把「3D 资产渲染 + 背景补全」作为多视角 S2V 训练数据的系统性流水线。条件端:与把几何作为逐帧通道条件(如深度控制,要求与目标帧一一对应)的做法不同,本文发现法向转盘是固定偏航扫描、而目标视频跟随提示中的任意轨迹,二者之间根本不存在逐帧对应,因此把转盘作为时间轴上独立的条件段注入,明确免除时间对齐约束;且几何条件刻意从参考视图在线重建而非源网格,保证训练与推理的信号分布完全一致。这两个设计互为支撑:只有当数据中的视角变化真实绑定同一 3D 主体时,法向条件才是可靠的监督信号;只有当条件来自与推理相同的重建流程时,模型学到的是「如何使用带噪重建」而非「如何使用完美网格」。
核心方法
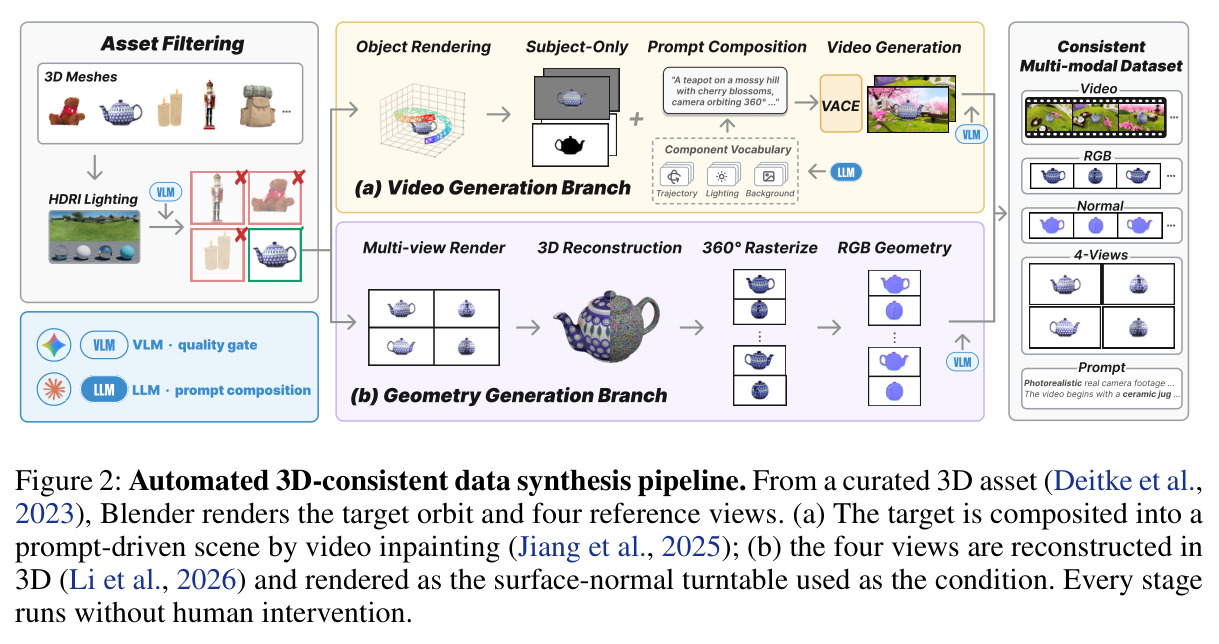
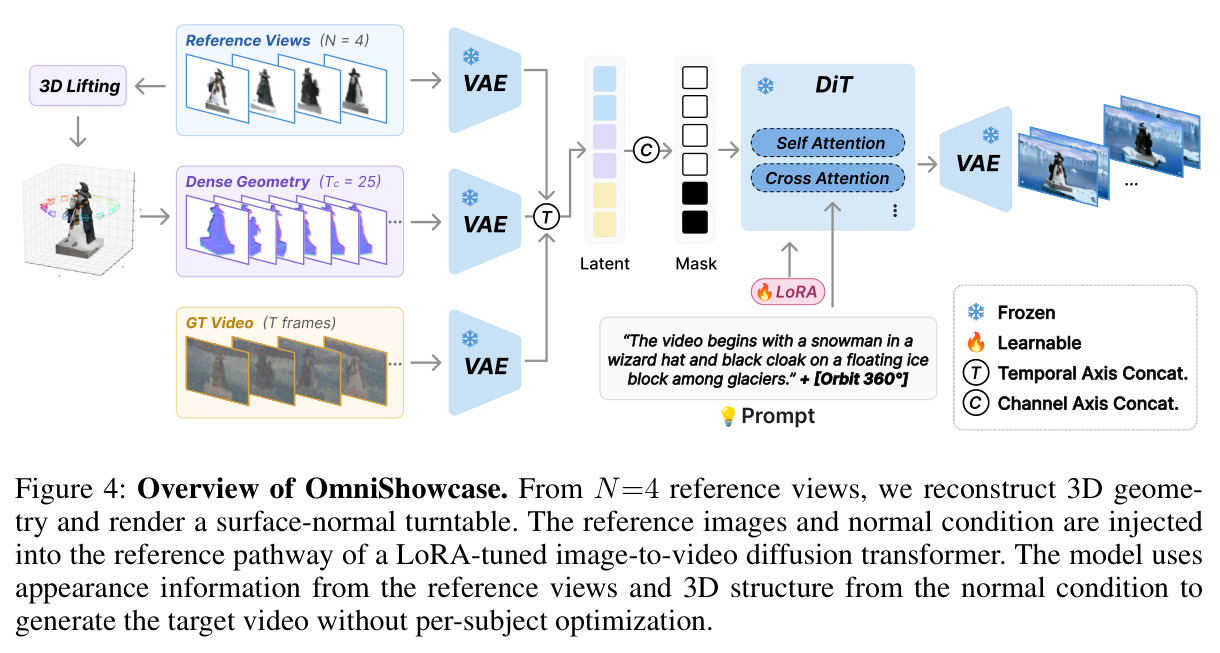
直觉上,这篇论文做的事是:除了给模型看几张「这个物体的照片」,再给它看一套「这个物体从各个角度转一圈时表面朝向长什么样」的法向转盘。照片负责外观身份,法向转盘负责三维结构,模型旋转到任何没见过的角度时都有几何依据可循,而不是靠先验幻觉。技术路线上分三步。第一步是全自动数据合成:从 Objaverse、Digital Twin Catalog、Google Scanned Objects 筛选 3D 网格,用 Blender 从同一网格渲染 81 帧目标视频和 4 张参考视图(保证二者共享同一形状与外观),用 VACE 视频修补把主体合成进语言模型撰写的场景中;同时从那 4 张参考视图前馈重建 3D 高斯,沿 15° 仰角的偏航轨道渲染 $T_c=25$ 帧深度并转为表面法向,构成几何条件。第二步是条件注入:把 4 张独立编码的参考图潜变量、7 帧法向条件潜变量、20 帧目标潜变量沿时间轴拼接成长度 $L=31$ 的序列,送入 LoRA 微调的 Wan2.1 I2V-14B-480P 扩散 Transformer,通道轴上堆叠噪声化潜变量、掩码、干净条件三路共 36 通道。第三步是训练与推理:rectified-flow 损失只施加在目标片段上;推理时对新主体的参考视图执行完全相同的重建与渲染流程,50 步采样后 27 帧潜变量联合解码为 105 帧(25 条件帧 + 80 目标帧)。
核心创新点是「几何条件的免对齐注入」加上「训练-推理一致的几何来源」,这是与已有方法的本质区别。第一,与 MV-S2V 的区别:MV-S2V 只把多张参考作为外观特征输入,视角之间的 3D 结构仍靠模型内隐推断;OmniShowcase 显式提供重建的表面法向转盘,把「未见面长什么样」从生成问题变成条件查找问题。第二,与 3DreamBooth 的区别:后者用约 30 张视图做逐主体优化,牺牲即插即用性;OmniShowcase 用前馈重建器在线构造几何条件,任何新主体零优化。第三,与 Uni3C 等相机控制模型的区别:相机控制只规定相机在哪,未见面仍由先验合成(Figure 3 中 Uni3C 的主体会消失或一分为二);OmniShowcase 的训练数据中主体像素是物理渲染的真值,只有背景是生成的。第四,也是最精妙的一点:法向转盘不作为目标潜变量的逐帧通道条件,而是作为时间轴上的独立条件段——因为转盘是固定的偏航扫描而目标跟随提示中的任意轨迹,逐帧对齐不存在;通道式条件必须被逐帧读取,会强行施加一个不存在的 25 帧(法向)对 80 帧(目标)的对应。掩码机制保证只有目标片段被加噪并计算损失,参考与法向潜变量始终保持干净上下文,模型由此学会把法向段当作「几何字典」去查,而不是当作目标帧去重建。
方法步骤详情
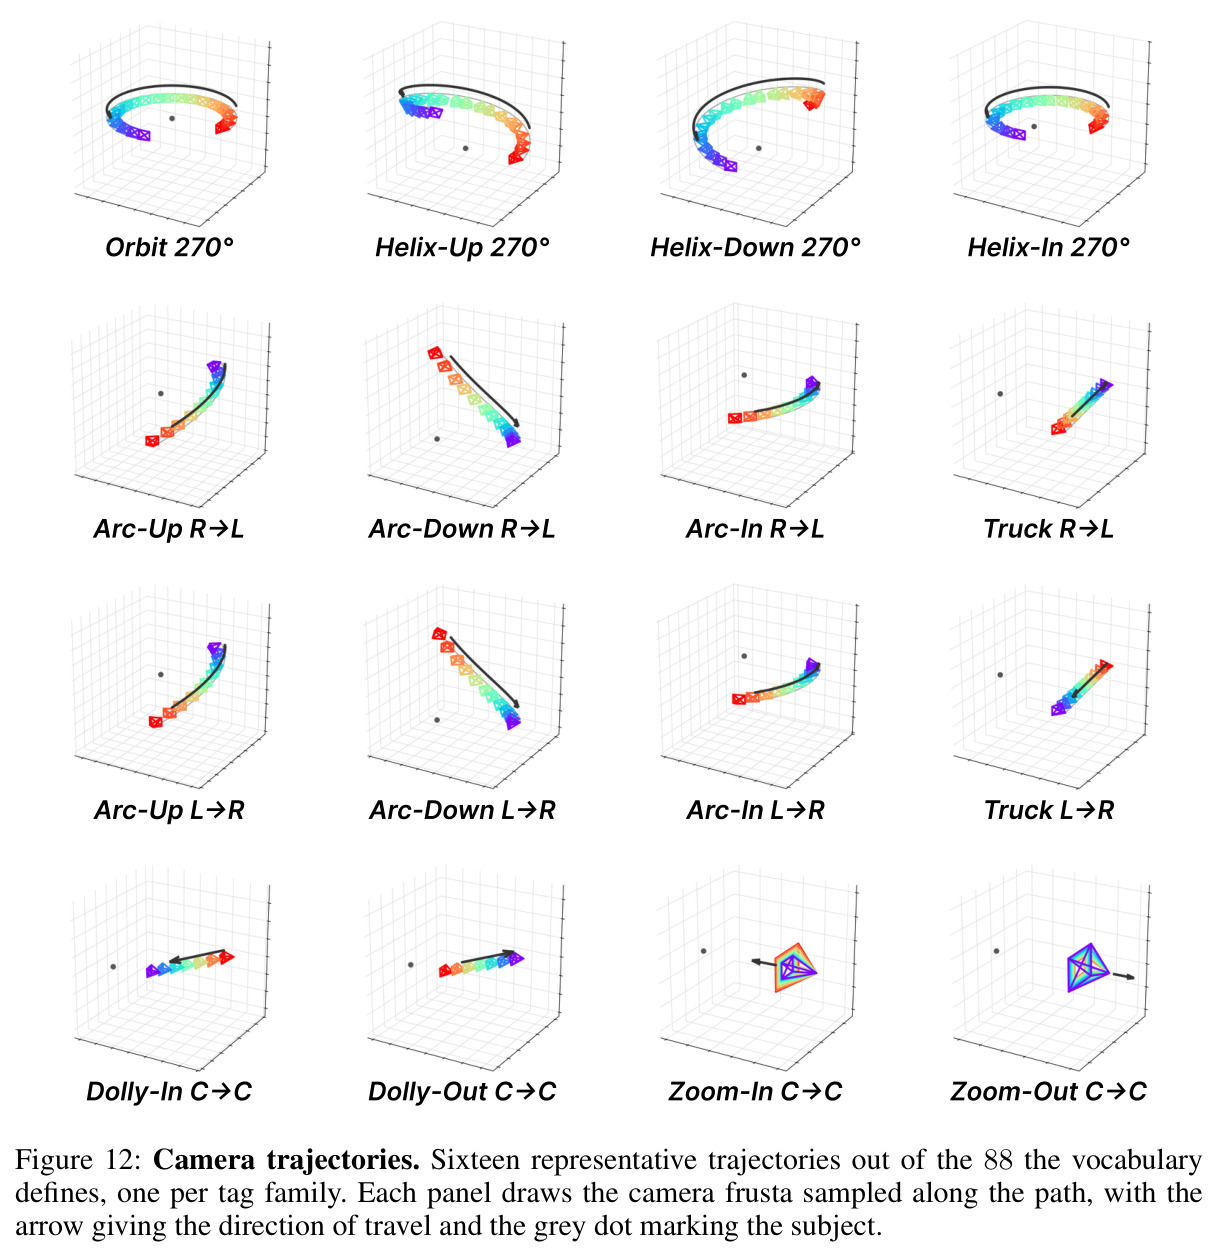
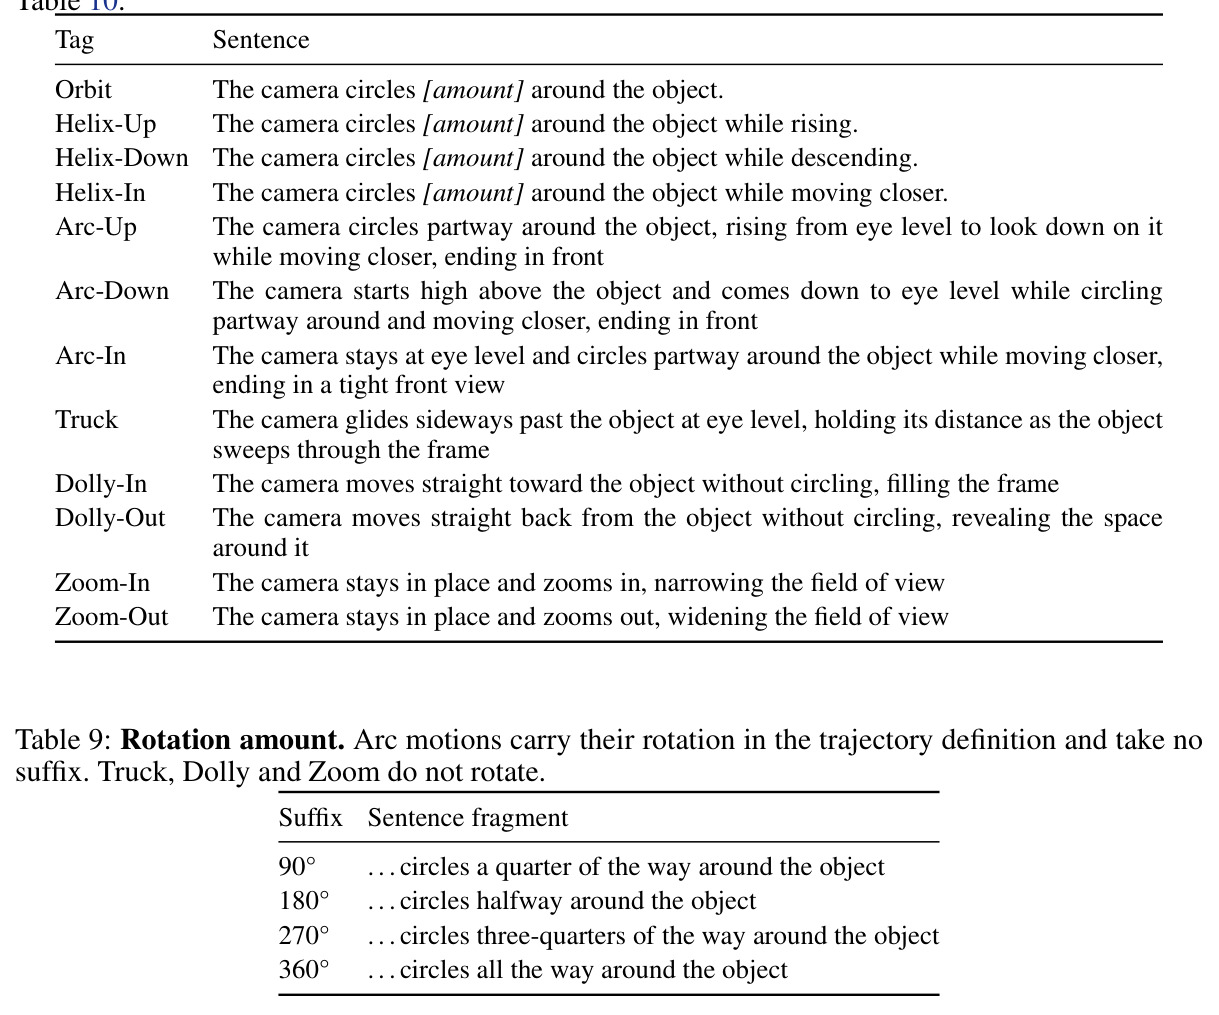
方法完整流程如下。步骤一(资产筛选):网格经 G0 启发式预筛剔除退化网格(拒绝约 17%),再用 Gemini 2.5 Flash 检查 4 张渲染视图的 6 项二值标准(工艺、几何完整、无底板、有纹理、类别匹配、非薄立形态),G1 从 7,016 个资产保留 4,186 个(60%)。步骤二(渲染):对每个资产按 88 种轨迹配置之一(4 种轨道族运动 × 4 种旋转量共 16 条,加 8 种 arc/truck/dolly/zoom 运动 × 9 种取景过渡共 72 条)用 Blender 渲染 81 帧目标视频,另渲染偏航间隔 90° 的 $N=4$ 张参考视图。步骤三(主体保持合成):渲染 alpha 通道提供主体掩码,VACE 视频修补模型围绕固定主体像素合成提示驱动的场景背景(场景位置来自 Claude Opus 5 撰写的 2,000 条场景库,提示组合位置、相机运动与光照),目标裁剪至 80 帧;G2 门(主体不漂浮、场景像刚性三维空间等 6 项标准)只保留 44% 的合成片段。步骤四(几何条件生成):对 4 张白底参考视图掩码主体,用 Depth Anything 3 预测对齐的逐视图 pointmap,经 MV-SAM3D 融合为 3D 高斯,沿 15° 仰角偏航轨道在 $T_c=25$ 个均匀位姿渲染深度并转为法向;G3 门淘汰偏离参考或破碎的重建,通过率 63%。步骤五(样本构建):Tarsier2-7B 分别为法向转盘和目标视频写描述,配上 [CONDITION] 与 [VIDEO] 标记。步骤六(训练):80 帧目标与 25 帧法向分别经因果 VAE 编码为 $T_v=20$ 和 $T_n=7$ 帧潜变量,与 4 张独立编码的参考图潜变量时间轴拼接为 $L=N+T_n+T_v=31$;通道轴堆叠噪声化输入 $\tilde{z}_\tau = m\odot z + (1-m)\odot\tau z + (1-\tau)\epsilon$、掩码 $M\in\{0,1\}^{L\times4\times h\times w}$、干净条件 $m\odot z$ 三流共 $16+4+16=36$ 通道;以损失 $\mathcal{L}=\mathbb{E}\|\hat{v}_\theta^V-(z_V-\epsilon_V)\|^2$ 只在目标片段上训练 LoRA(rank 128),33,000 步、4 张 B200 约 50 小时。步骤七(推理):对新主体的参考视图重复步骤四得到法向转盘,50 步采样、三方 CFG(参考流 $s_{ref}=5.0$、文本流 $s_{text}=5.0$),27 帧潜变量按因果 VAE 压缩因子 4 解码为 $1+4(27-1)=105$ 帧。
技术新颖性
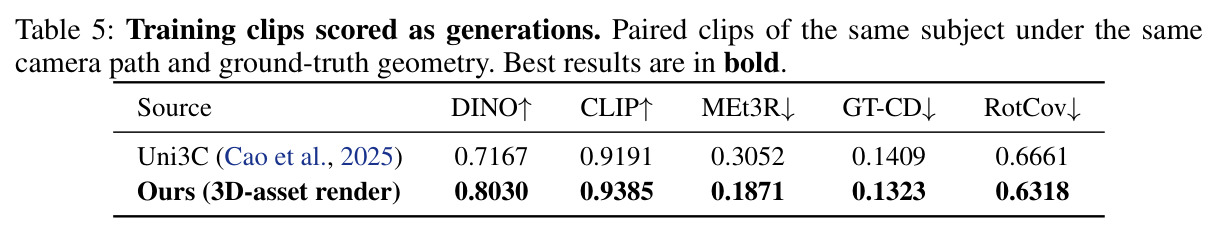
技术新颖性体现在四个层面。其一,数据范式:此前 S2V 训练要么用真实视频(Phantom 约 1M 条、MAGREF 更大,但无法保证多视角对应同一 3D 主体),要么用生成视频(MV-S2V 的 14K 条中 87% 为生成数据),要么用静态多视图做逐主体优化(3DreamBooth 的 200K);本文首次以「3D 资产渲染为主体真值 + 视频修补生成背景」构造多视角 S2V 语料,并用 Table 5 的配对实验证明数据质量的实质差异——同一主体同一轨迹下,渲染数据的 DINO 相似度 0.8030 显著高于 Uni3C 生成数据的 0.7167,MEt3R 0.1871 优于 0.3052。其二,条件设计:把重建法向转盘作为时间轴独立条件段是新的,它绕开了通道式几何控制(深度/姿态类 ControlNet 方法)必需的逐帧对齐假设,使同一个几何条件可以服务任意目标轨迹。其三,训练-推理一致性原则:几何条件刻意从参考视图重建而非源网格,避免「训练时见到完美几何、推理时只能拿到带噪重建」的分布漂移,这个设计原则对后续工作有普遍参考价值。其四,评测基础设施:SHOWCASEBENCH 首次为多视角 S2V 提供带源网格与相机参数的保留集,使 GT-CD 这类真值几何指标成为可能,配套的 RotCoverage 提供视角覆盖诊断。整条流水线(含 VLM 门控的精确判据)以约 25 美元每千条保留片段的成本实现无人介入,也展示了「生成式模型当质检员」的工程范式。
实验结果
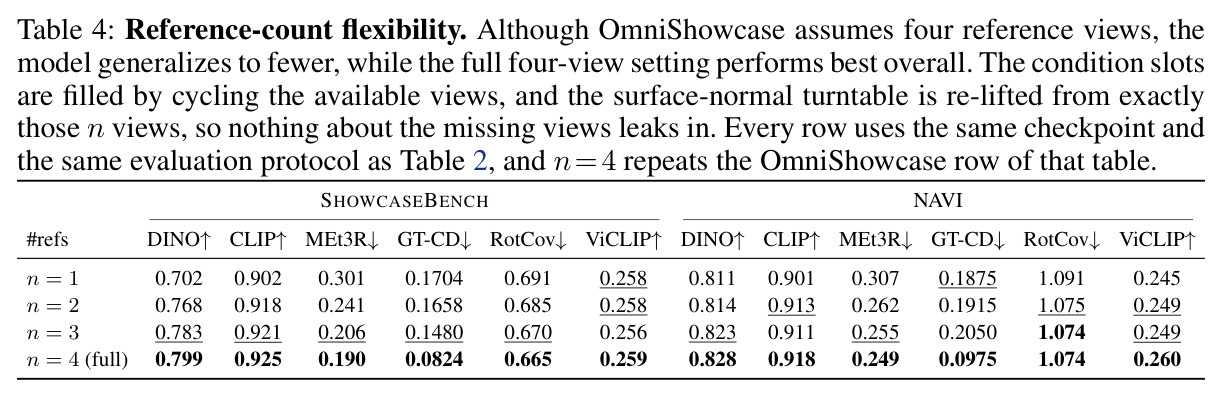
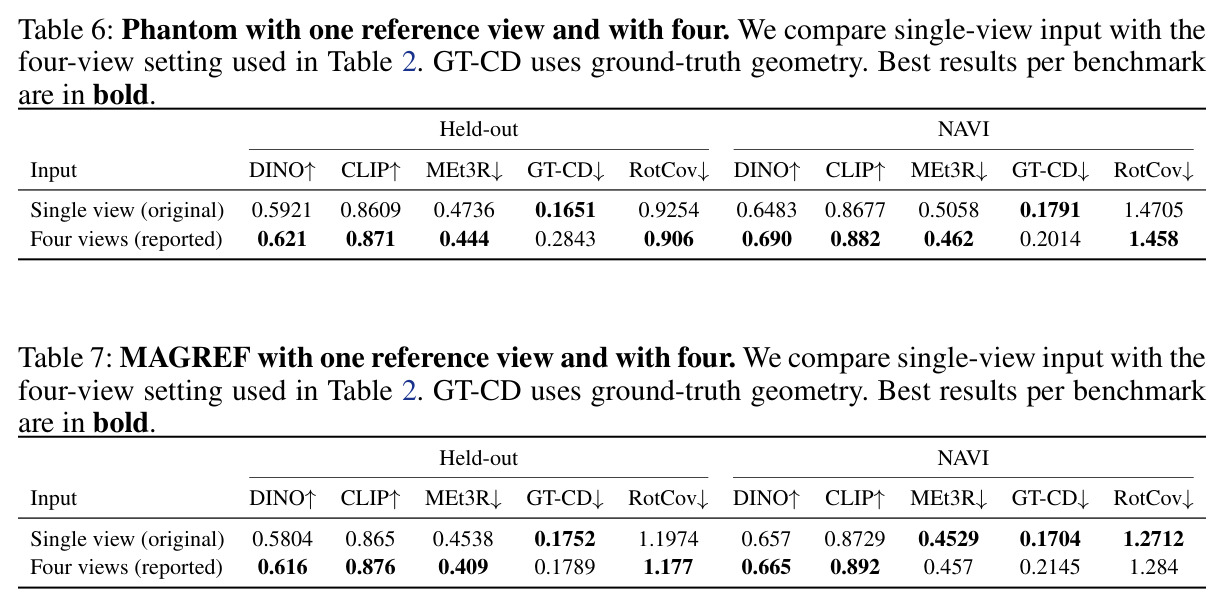
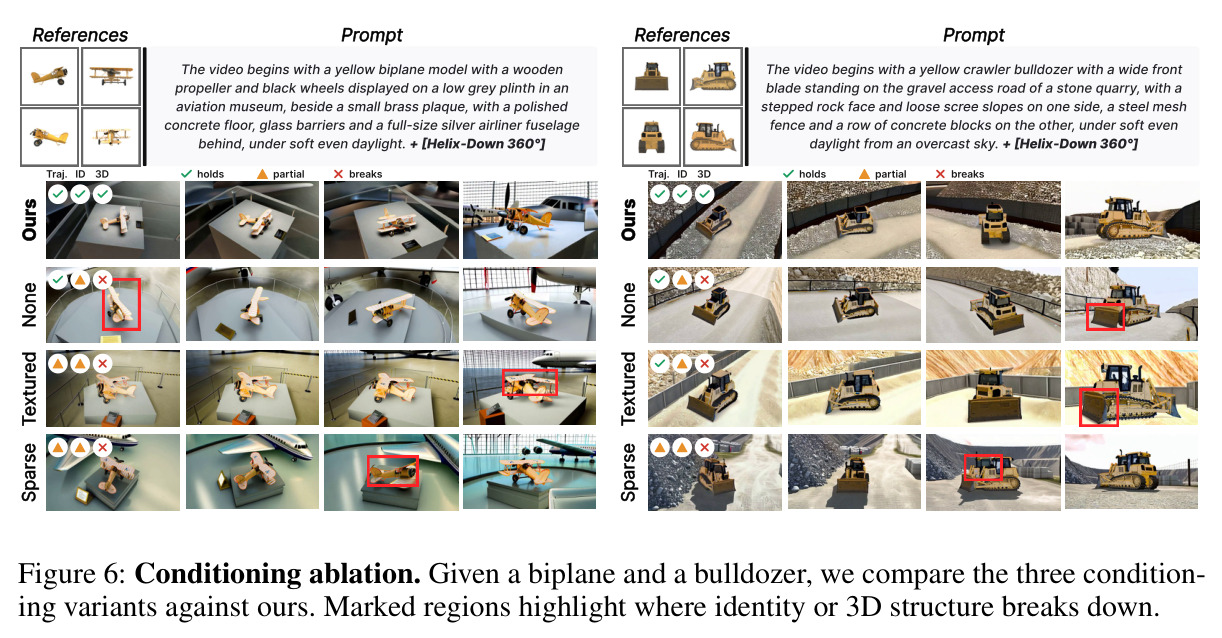
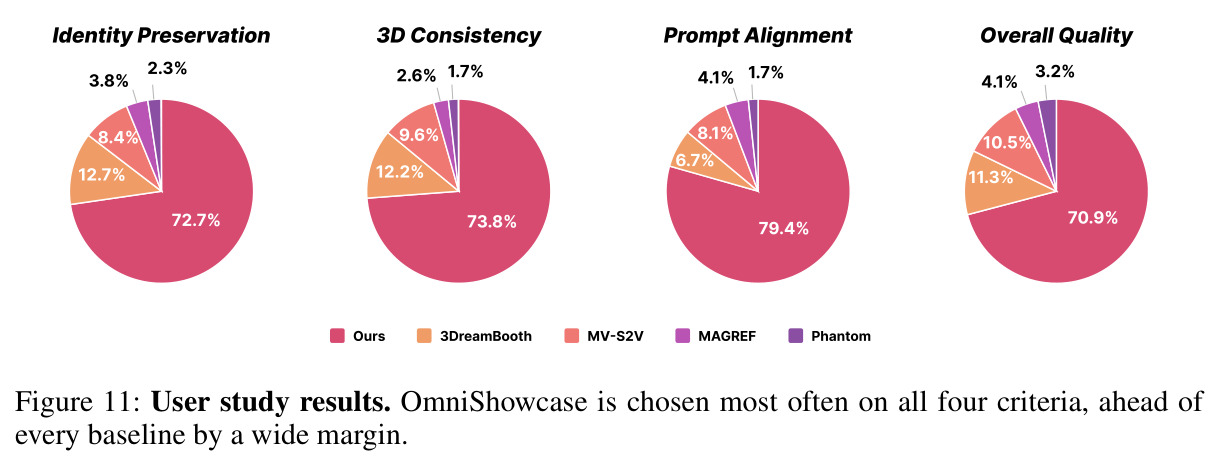
核心实验在两个基准上展开:SHOWCASEBENCH(50 个保留主体、4 种 360° 轨迹、与训练集不共享 3D 资产、附真值网格)和真实扫描的 NAVI(35 个主体),所有身份与 3D 指标在 GroundingDINO+SAM 分割出的主体掩码上计算。主结果(Table 2):保留集上 OmniShowcase 的 DINO 身份相似度达 0.799,比最强的 3DreamBooth(0.707)高 0.092;GT-CD 仅 0.0824,比次优的 3DreamBooth(0.1717)降低约 52%,说明生成形状与真值几何的偏差减半以上;MEt3R 0.190 对次优 0.325,改善约 42%;同时 ViCLIP 文本对齐 0.259、VBench 成像质量 74.29、动态程度 1.000 均为全场最佳。NAVI 上趋势一致:DINO 0.828、MEt3R 0.249(次优 MV-S2V 0.350)、GT-CD 0.0975(次优 0.1816,改善约 46%)、ViCLIP 0.260、成像质量 74.58;唯一例外是美学质量 0.551 略低于 Phantom-MV 的 0.572。用户研究(44 人、24 个训练未见视频)中,OmniShowcase 在身份保持、3D 一致性、提示对齐、整体质量四项上分别获得 72.7%、73.8%、79.4%、70.9% 的选票,没有任何基线超过 12.7%,提示对齐优势最大——因为它是唯一真正完成命令轨道的方法。消融(Table 3)显示去掉几何条件后保留集 GT-CD 从 0.0824 恶化到 0.2092、MEt3R 从 0.190 升至 0.265;换成彩色渲染(Textured)虽然携带相同几何,但外观与参考图竞争,ViCLIP 跌至 0.236 为三者最低;把转盘从 25 帧稀疏到 9 帧(Sparse)则各项中等,验证了密集法向条件的必要性。参考数量消融(Table 4)表明模型对 $n=1$ 也有泛化(保留集 DINO 0.702),$n=4$ 时 GT-CD 最优;NAVI 上身份指标几乎不随参考数变化,因为其主体小且凸,单张视图已足够锁定外观。训练数据对比(Table 5)直接证明数据管线的价值:配对比较中渲染数据对 Uni3C 生成数据的 DINO 为 0.8030 对 0.7167、MEt3R 为 0.1871 对 0.3052。附录 F 还揭示一个反常现象:把 Phantom/MAGREF 从单参考扩展到四参考提升了身份指标(Phantom 保留集 DINO 0.5921→0.621),但 GT-CD 反而变差(0.1651→0.2843),说明单纯堆参考视图并不能带来几何约束,显式几何条件才是关键差异。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 主体身份保持(SHOWCASEBENCH,50 个保留主体) | DINO 相似度(DINOv2-L,越高越好) | 0.799 | 3DreamBooth 0.707(次优);MV-S2V 0.688、Phantom-MV 0.621、MAGREF-MV 0.616 | 较次优提升 0.092(约 +13%) |
| 3D 形状一致性(SHOWCASEBENCH) | GT-CD(对称 Chamfer 距离,越低越好) | 0.0824 | 3DreamBooth 0.1717(次优);MAGREF-MV 0.1789、MV-S2V 0.2306、Phantom-MV 0.2843 | 较次优降低约 52% |
| 多视角一致性(SHOWCASEBENCH) | MEt3R(越低越好) | 0.190 | 3DreamBooth 0.325(次优);MV-S2V 0.351、MAGREF-MV 0.409、Phantom-MV 0.444 | 较次优降低约 41.5% |
| 3D 形状一致性(NAVI,35 个真实扫描主体) | GT-CD(越低越好) | 0.0975 | MV-S2V 0.1816(次优);Phantom-MV 0.2014、MAGREF-MV 0.2145、3DreamBooth 0.2272 | 较次优降低约 46% |
| 文本对齐(两基准) | ViCLIP 余弦相似度(越高越好) | 保留集 0.259 / NAVI 0.260 | 保留集次优 MV-S2V 0.244;NAVI 次优 Phantom-MV 0.255 | 两基准均为最佳 |
| 人类偏好(44 人、24 个未见视频) | 四项标准选票占比(身份/3D/提示对齐/整体) | 72.7% / 73.8% / 79.4% / 70.9% | 所有基线各项均不超过 12.7%(如 3DreamBooth 整体 11.3%) | 每项都领先最强基线 5 倍以上 |
| 训练数据几何保真度(同主体同轨迹配对) | 以评测协议打分训练片段:DINO / MEt3R | 3D 资产渲染:DINO 0.8030 / MEt3R 0.1871 | Uni3C 相机可控生成:DINO 0.7167 / MEt3R 0.3052 | DINO +0.086,MEt3R 降低约 39% |
局限与改进
作者明确承认两点局限(Figure 13)。第一,背景有时显得合成:训练目标中只有主体是物理渲染的,背景由视频修补模型事后「画」上去,主体与背景之间的光传输从一开始就不一致,模型忠实地复现了这一统计特性,于是背景继承平坦着色和单薄材质。第二,不处理非刚性主体:法向转盘来自把参考视图融合成的单一静态重建,当 4 张参考捕捉到同一主体的 4 个不同姿态时,重建会把它们熔成一个从未存在过的刚体;静态提示下输出会收敛到一个不属于任何参考的平均姿态,而要求运动时文本与几何条件互相矛盾,姿态过渡处出现 3D 纠缠。我自己的观察还有几点:其一,推理阶段没有对应 G3 的质量门控,若前馈重建失败,污染的法向条件会直接注入生成器,方法缺少对条件置信度的自我评估;其二,NAVI 上美学质量 0.551 为全场最低,暗示几何一致性是以一定的视觉美感折损换来的;其三,评测中 GT-CD 依赖 π3 把生成视频提升为点云,指标本身叠加了重建误差,且只扫过薄壳的方法可能因覆盖小而占便宜;其四,80 帧(16 fps 下约 5 秒)、480×832 的输出规格使 360° 轨道必须在 5 秒内转完,限制了展示类应用的节奏;其五,设定局限于单个刚性、可分割的主体,不涉及多主体与主体-环境交互。
独立分析的弱点
第一,条件质量无兜底:训练时 G3 门淘汰了 37% 的失败重建,但推理时同样的前馈重建没有任何质量检查,遇到透明、反光、细长结构(G1 中「薄立形态」就是已知难点)的主体,重建可能破碎,法向条件反而会把错误几何「教」给模型。改进方向:推理时加入重建置信度估计,置信度低时退化为纯参考条件或对法向条件降权(可学习条件 dropout)。第二,非刚性主体完全不可用:宠物、人物、有活动部件的物体是 S2V 的高价值场景,而本文条件信号本质上是单一刚体扫描。改进方向:把条件从静态转盘扩展为随生成序列变化的时变几何(4D 重建),或让模型预测逐帧几何残差。第三,背景真实感:修补模型生成的背景缺乏与主体一致的光照传输,可把渲染时的 HDRI 光照传给修补过程做 relighting,或改用真实场景扫描作背景。第四,输出规格偏小:480×832、80 帧,14B 主干加 LoRA 的方案理论上可迁移到更高分辨率主干,但几何条件的注入逻辑和显存开销需要重做。第五,GT-CD 的反常信号未被解释:附录 F 中 Phantom 单参考的 GT-CD(0.1651)好于四参考(0.2843),作者仅以「几乎每个指标上四视图更强」带过,这暗示 GT-CD 对「只生成薄壳」的方法可能系统性偏低(覆盖小的形状更容易贴近真值的一部分),指标设计值得复核,比如加入覆盖度惩罚项。第六,数据规模仅 4K 条,scaling 行为未知,好在其成本曲线(约 25 美元每千条)让扩展实验相当便宜。
未来方向
作者提出的方向:其一,为非刚性主体设计「随生成序列变化的条件表示」,使几何条件能编码姿态演化而非单一刚体;其二,解决背景合成感,让主体与背景的光传输一致。基于本文成果可延伸的方向:其一,生成-重建闭环——本文证明几何条件能显著提升视频的 3D 一致性,反过来可用这类一致性视频作为 image-to-3D 生成的训练数据或测试时优化信号,形成「多视角视频生成喂 3D 重建」的飞轮。其二,数据规模扩展——把语料从 4K 扩到 50K 并研究 scaling 行为,验证小而精数据的收益是否随规模持续。其三,混合真实数据——用手机环拍真实物体加本文的重建-法向流程构造真实域样本,缩小合成-真实差距,同时绕开修补背景的光照不一致。其四,更长视频与自回归扩展——80 帧限制源于 VAE 时序约束,可研究法向条件的分段重注入以支持分钟级轨道展示。其五,条件信号正交组合——把几何转盘与主体运动轨迹、多主体布局等控制信号组合,向场景级生成推进;非刚性方向上可探索从单目视频提取时变几何作为条件。其六,指标转化为信号——用 GT-CD 类几何指标做推理时引导(几何感知的 CFG 或多采样择优),把评测协议变成生成时的质量控制器。
复现评估
复现条件总体较好但门槛不低。开源方面:作者承诺公开 SHOWCASE-4K 数据集(4,000 条视频、2,593 个资产、620 个类别,附许可证与原始作者信息)、SHOWCASEBENCH(50 个保留主体带源网格与相机参数)以及数据合成代码;附录 G/I 逐字给出全部 VLM 门控判据(G0-G3 的完整 prompt)、类别与场景词汇生成规则、caption 模板和推理 prompt 格式,训练超参数完整(Wan2.1 I2V-14B-480P 的 Diffusers 实现、LoRA rank 128 与 $\alpha=128$、学习率 $2\times10^{-5}$ 经 100 步 warmup 后恒定、AdamW $\beta=(0.9,0.95)$、权重衰减 $10^{-4}$、梯度裁剪 1.0、33,000 步、bf16、seed 42),评测协议(每视频采样 16 帧、分割模型、点云中心化/归一化/去最外 3% 点/2 万点下采样、固定尺度 ICP)也写得足够细。但需注意:模型权重是否发布未明确承诺,只提了 data、benchmark、code;算力上需要 4 张 NVIDIA B200 训练约 50 小时,对多数实验室是显著门槛,14B 主干推理本身也需高端 GPU;流水线依赖一长串第三方组件(Blender、VACE、Depth Anything 3、MV-SAM3D、3DGS、Tarsier2-7B、Gemini 2.5 Flash、Claude Opus 5),其中两个商用 API 有依赖成本(虽便宜,全程约 120 美元),版本漂移可能改变门控行为;复现评测还需跑通 π3 提升、GroundingDINO+SAM 分割等。综合评估:数据与协议复现难度中等,端到端训练复现难度中高,主要成本在算力与组件拼装。
论文图表
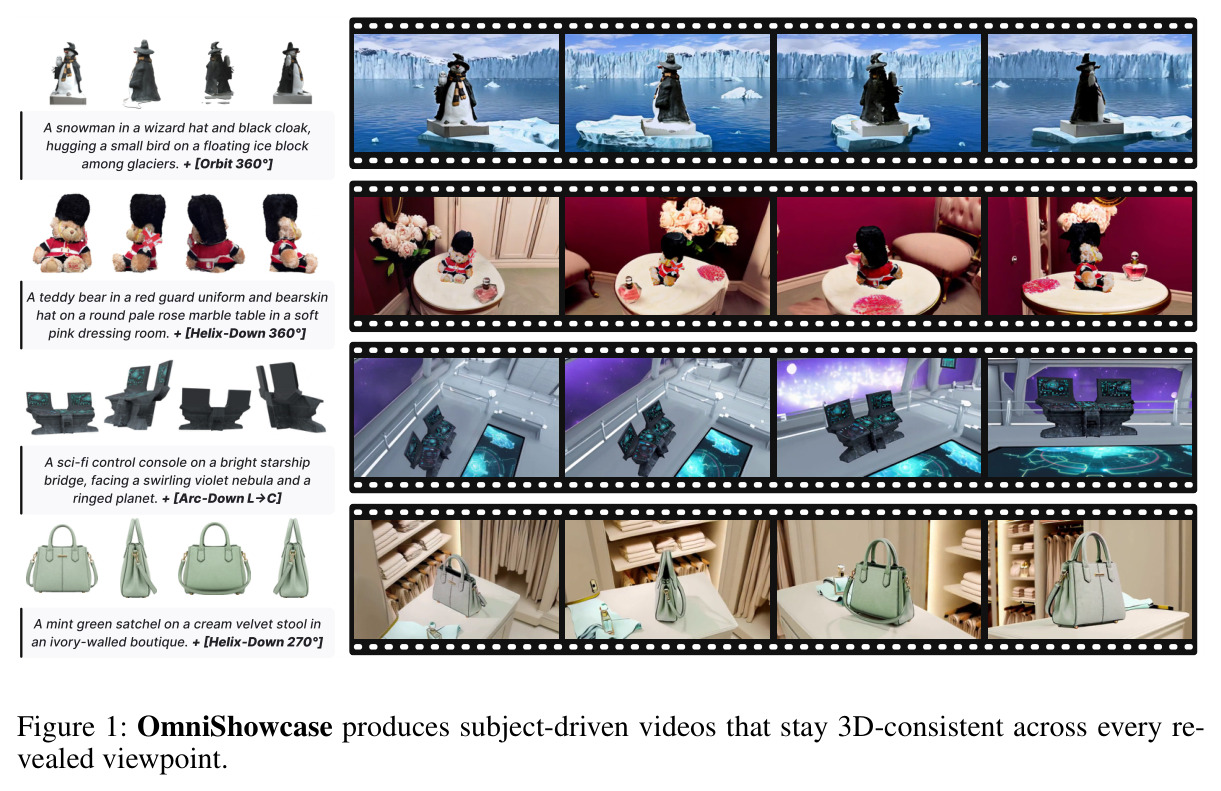
首页展示图:四个例子各配一段文本提示加轨迹标签(Orbit 360°、Helix-Down 360°、Arc-Down L→C、Helix-Down 270°),展示雪人、泰迪熊、科幻控制台、薄荷绿挎包等主体在完整轨道或弧线相机运动下的生成帧序列。
一图定义了论文的能力边界:给定 4 张参考图与带轨迹的提示,主体在每一个被揭示的视角上都保持身份与 3D 结构,包括 360° 完整旋转。
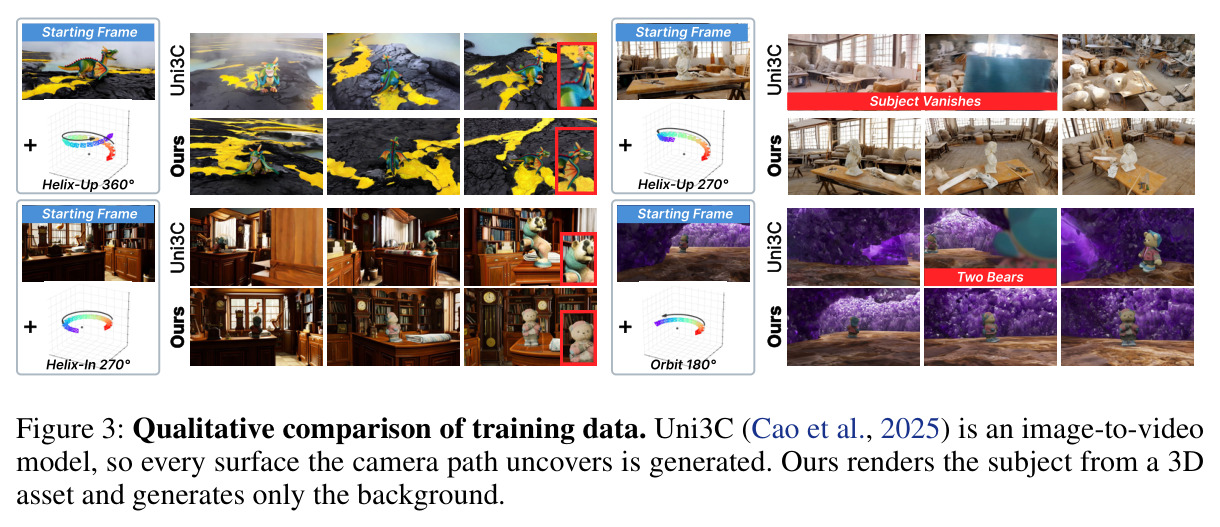
把本文的 3D 资产渲染训练数据与相机可控生成器 Uni3C 的输出并排比较:给定相同起始帧与相机路径(Helix-Up 360°、Helix-In 270°、Helix-Up 270°、Orbit 180°),Uni3C 出现主体消失(Subject Vanishes)、一分为二(Two Bears)等崩溃,而本文的主体始终保持同一物体。
直观论证论文最核心的数据论断:相机可控视频生成器无法保证视角变化绑定同一 3D 主体,因为未见面全靠先验合成;这是选择 3D 资产渲染路线的直接理由。
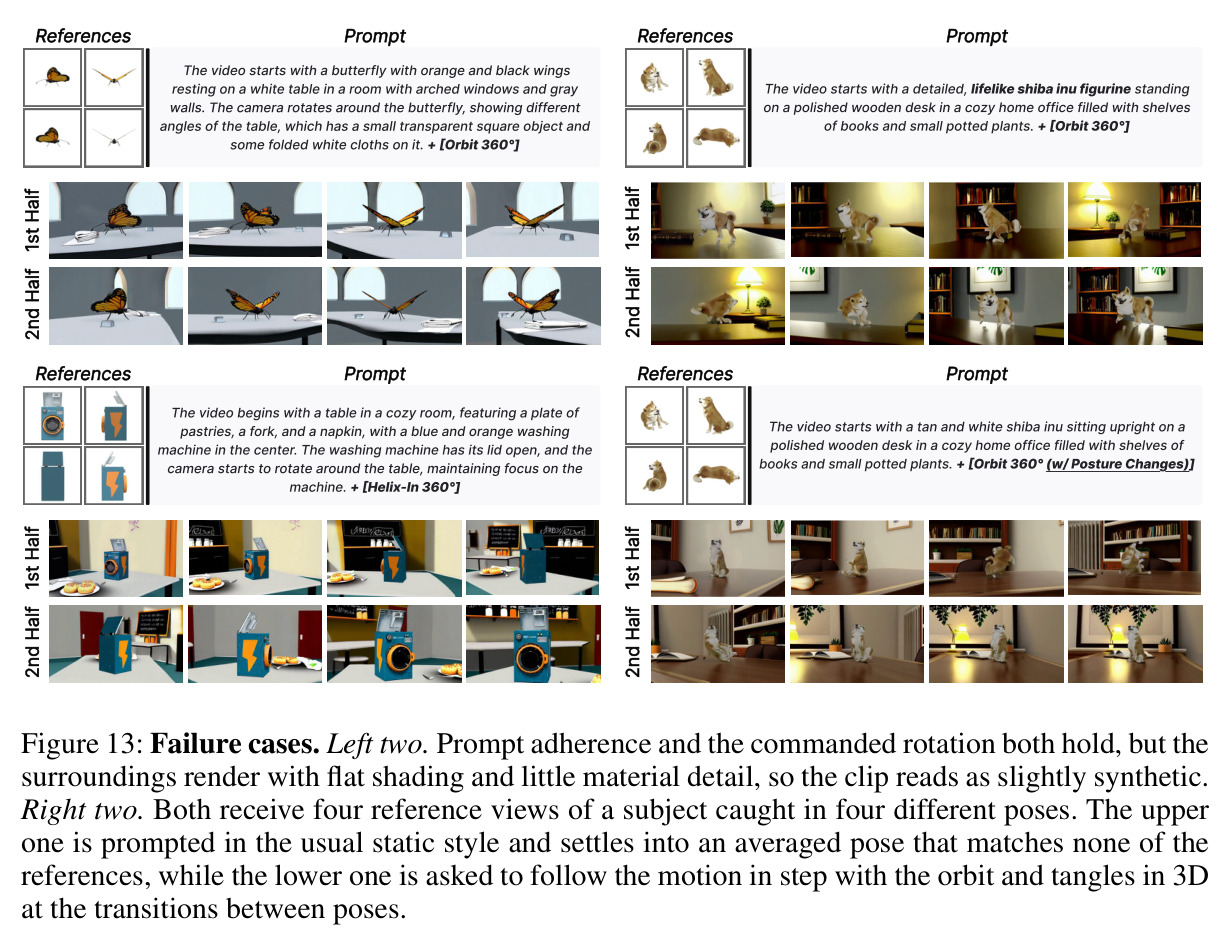
两类失败各两例:左侧命令旋转保持但环境渲染出平坦着色与单薄材质、读起来偏合成——源于「主体物理渲染、背景修补生成」的光传输不一致;右侧是四张参考捕捉到非刚性主体(蝴蝶、柴犬摆件)不同姿态的情形,静态提示下输出收敛到不属于任何参考的平均姿态,要求运动时在姿态过渡处 3D 纠缠。
作者给出的官方失败分析,对应结论章节承认的两大局限,并解释了各自的成因机制(数据构造 vs 条件信号本身),是评估方法适用范围的必读材料。