S3AC:面向大语言模型推理的稳定、可选、可扩展的Actor-Critic强化学习方法 S3AC: Stabilized, Selective, and Scalable Actor-Critic for LLM Reasoning
稳定化Actor-Critic训练配方,提供token级优势与难度感知选题,将RLVR扩展至397B
前置知识
RLVR(可验证奖励的强化学习)
用可程序化验证的信号(数学答案对错、代码测试通过与否)作为强化学习的标量回报来训练 LLM,是 DeepSeek-R1 以来推理训练的主流范式。本文采用二值奖励约定:验证器只在响应最后一个 token 上给出 $R \in \{-1, +1\}$,其余位置为 0,折扣因子 $\gamma=1$。在此设定下成功率为 $p$ 的 prompt 期望回报恰为 $2p-1$,且终端值 $V(s_T)=0$,这一线性关系是把 critic 值直接解释为难度估计的数学基础。
本文所有设计(critic 初值转成功率、DAPS 难度估计、值预训练回归目标)都建立在这个稀疏二值奖励与 $\gamma=1$ 的 MDP 约定之上,不理解它就无法理解 critic 值为何能当难度用。
GRPO 与组基线(group baseline)
GRPO 对同一 prompt 采样 $K$ 条响应(如 16 条),用组内奖励的均值和标准差把序列级奖励标准化为优势,从而完全免训练 critic。代价是每条 prompt 必须等组内最慢的响应生成完毕;改用单 rollout 的方法(REINFORCE++、FlashREINFORCE)只能用整个 batch 的统计量做共享基线,无法区分 prompt 难度——在难题上失败是意料之中、在简单题上失败才是异常,这个信息在 batch 统计量里被抹掉。
本文的定位正是补上 GRPO 缺失的 token 级信用分配和单 rollout 缺失的 prompt 级基线,需要先明白被替代者各缺什么。
GAE(广义优势估计)
PPO 家族用 critic $V_\phi(s_t)$ 与 TD 误差 $\delta_t = r_t + V_\phi(s_{t+1}) - V_\phi(s_t)$ 的指数加权和 $\hat{A}_t = \sum_{l=0}^{T-t-1} \lambda^l \delta_{t+l}$ 估计优势,等价于 $\lambda$-return 减去 $V_\phi(s_t)$;$\lambda<1$ 时向后 bootstrap,用偏差换方差。本文 critic 侧直接回归蒙特卡洛回报($\lambda_{critic}=1$),actor 侧采用 VAPO 的长度自适应 $\lambda_{actor} = 1 - 1/(\alpha T)$($\alpha=1.5$,$T$ 为响应长度),响应越长 $\lambda$ 越接近 1。
S3AC 输出的核心学习信号就是 GAE 优势,其解耦 actor/critic $\lambda$ 的做法直接继承 VC-PPO 与 VAPO,是读懂方法节点的必修概念。
值预训练与轨迹覆盖
稀疏奖励下,新初始化的 value head 直接在线训练很难收敛,常见做法(VC-PPO、SAO)是先冻结策略、用已生成轨迹预训练 value head。覆盖问题指:若预训练只用初始策略的轨迹,'长且最终正确'的响应极度稀缺(本文实测初始策略中超过 24K token 的响应仅 5.0% 正确),critic 便学不会给长链后期的正确 prefix 高估值,一旦策略变强、开始产出长正确响应,值预测立刻失准。
S3AC 的第一项稳定性创新就是用多策略强度的轨迹池化扩大覆盖,Figure 5/10 的消融与诊断全部围绕这一点展开。
训练-推理失配与 CISPO/掩码
LLM RL 中 rollout 用推理引擎、训练用训练引擎,数值实现差异会使 token 级重要性比率 $r_t = \pi_\theta(a_t|s_t)/\pi_{\theta_{old}}(a_t|s_t)$ 大幅偏离 1,产生虚假的离策略信号甚至训练崩溃。CISPO 目标把裁剪后的重要性权重 $\bar{r}_t = \mathrm{clip}(r_t, 1-\epsilon_{low}, 1+\epsilon_{high})$ 当作常数(stop-gradient),只优化 $\log \pi_\theta$ 项;IcePoP 在 token 级、MIS 在序列级把比率超出阈值的 token 或整条响应掩掉。
论文把 actor 目标与失配处理作为所有方法共享的配方(S3AC 和 GRPO-X 都用同一套),评价 critic 带来的增益时必须知道这些变量已被控制。
DAPO 动态采样
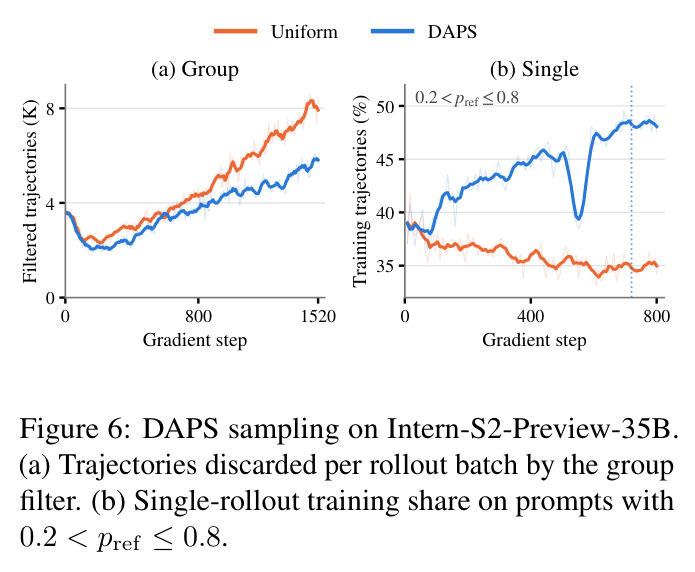
组 rollout 时若某 prompt 的 $K$ 条响应全对或全错,组内优势全为 0、没有学习信号,DAPO 的动态采样会在生成后丢弃这些组并继续补采样。这提升了有效样本率但浪费算力:必须先生成完才知道这组没有价值。本文实验表明动态采样对 S3AC 同样有增益,而 DAPS 的价值在于生成之前就预估难度、少把算力花在注定被丢弃的 prompt 上。
DAPS 的直接对照就是动态采样,Figure 6 中'每批被丢弃的轨迹数'这一指标必须放在这个背景下才能理解。
研究动机
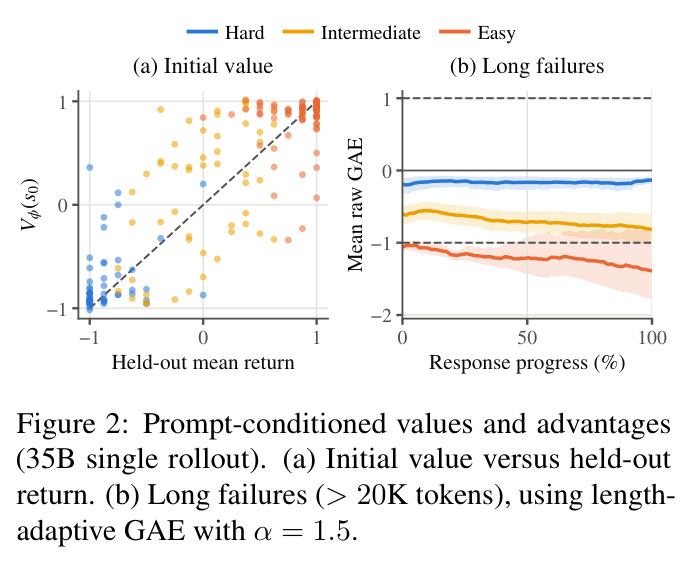
当前 LLM 推理的 RLVR 训练主流是 GRPO 这类无 critic 方法:对每个 prompt 采样一组响应(本文 dense 模型 K=16、MoE K=8),用组内奖励统计构造序列级优势。这带来两个结构性缺陷。其一,缺乏 token 级信用分配:一条答错的长推理链里,有用的中间推理步骤会与把模型带离正确解的步骤收到同样的负信号;而单一的响应级标量奖励完全无法反映'随着推理推进、到达正确答案的难度如何变化'。其二,组基线依赖 grouped rollouts,每条 prompt 必须等组内最慢响应完成,严重拖慢训练;改用单 rollout 的 REINFORCE++ 或 FlashREINFORCE 则只能用整个 batch 的均值/标准差做共享基线,无法区分 prompt 难度差异。理论上,一个学好的 critic 可以同时解决两个问题:既提供无需组 rollout 的 prompt 条件化基线($V_\phi(s_0)$ 只依赖 prompt),又通过随响应前缀演化的 $V_\phi(s_t)$ 给出 token 级学习信号。但对长思维链(响应可达数万 token)训练可靠的 critic 极其困难:稀疏奖励下初始策略的长而正确的响应几乎不存在(>24K token 响应仅 5.0% 正确),新初始化的 value head 又会在早期梯度中占绝对主导——这正是 GRPO 在 DeepSeek-R1 等系统中取代 PPO 的根本原因。
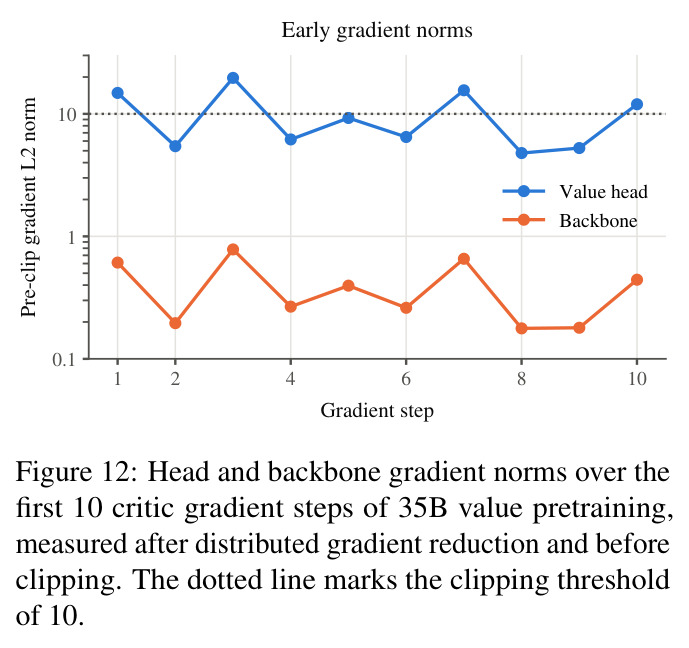
本文的目标是本文的目标是构建一套实用的 actor-critic 训练配方,让 critic 在长思维链 RLVR 中真正可用,可拆成三个子目标。第一,稳定性:克服 critic 训练的两大障碍——初始策略轨迹对长、正确响应的覆盖不足,以及新初始化 value head 在早期梯度中占主导导致的优化失衡(实测该值头虽只有约 2,048 个参数,却贡献了超过 99% 的平方梯度范数)。第二,可扩展性:配方要在 1.5B 稠密模型到 397B MoE 模型上都有效,并在 group rollout(K=8/16)和 single rollout(K=1)两种 regime 下都能工作;尤其要在单 rollout 下长期稳定训练,而不是像被测 critic-free 基线那样初期上涨后衰退。第三,选择性:critic 的价值不止于策略学习——它在生成之前就能给出 prompt 条件化的难度估计 $V_\phi(s_0)$,本文希望复用这个已为策略学习训练好的 critic 来指导 prompt 选择,在不引入离线初始化统计(如 SPO)或独立难度值模型(如 PCL)的前提下,减少 rollout 浪费并提升两种 rollout 设置下的最终性能。
与已有工作不同的是,把 critic 带回 LLM RL 的已有尝试各有局限:VC-PPO 用固定初始策略的轨迹预训练值模型并解耦 GAE 参数;VAPO 让 $\lambda$ 随响应长度自适应;VinePPO、EVPO、AsyPPO 分别用蒙特卡洛 rollout、解释方差门控和 critic 集成改进值估计;SAO 与 CompactionRL 把 PPO 用于大 MoE 的单 rollout 训练,但 SAO 强调的是扩大预训练语料规模而非覆盖结构。本文的独特切入有三点。第一,诊断驱动而非技巧堆叠:先定量刻画两大失败模式(长正确响应的覆盖缺口——初始策略 >24K token 响应仅 5.0% 正确而训练 1,600 步后的策略达 61.8%;值头梯度占平方梯度范数超过 99%),再针对性地设计覆盖池化预训练、小型值头初始化与放宽的裁剪阈值。第二,策略学习与 prompt 选择统一在同一个 critic 上:DAPS 把 $V_\phi(s_0)$ 转换成成功率估计再与结果历史融合,与需要离线 rollout 初始化的 SPO、需要独立 prompt 级值模型的 PCL、只依赖奖励历史的 GRESO 形成鲜明对比。第三,评测的系统性与规模罕见:横跨稠密与 MoE、1.5B 到 397B、group 与 single 两种 rollout regime,并对照配置了 R3、GEPO 等现代组件的强化版 GRPO-X 基线。
核心方法
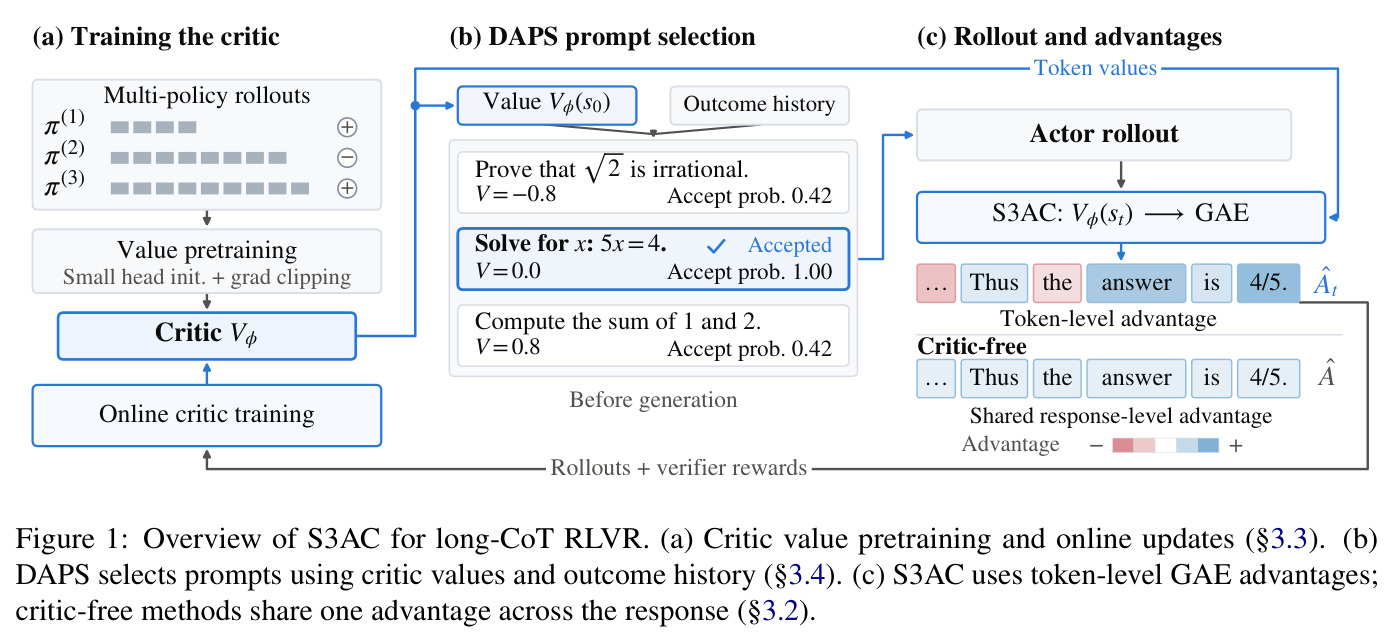
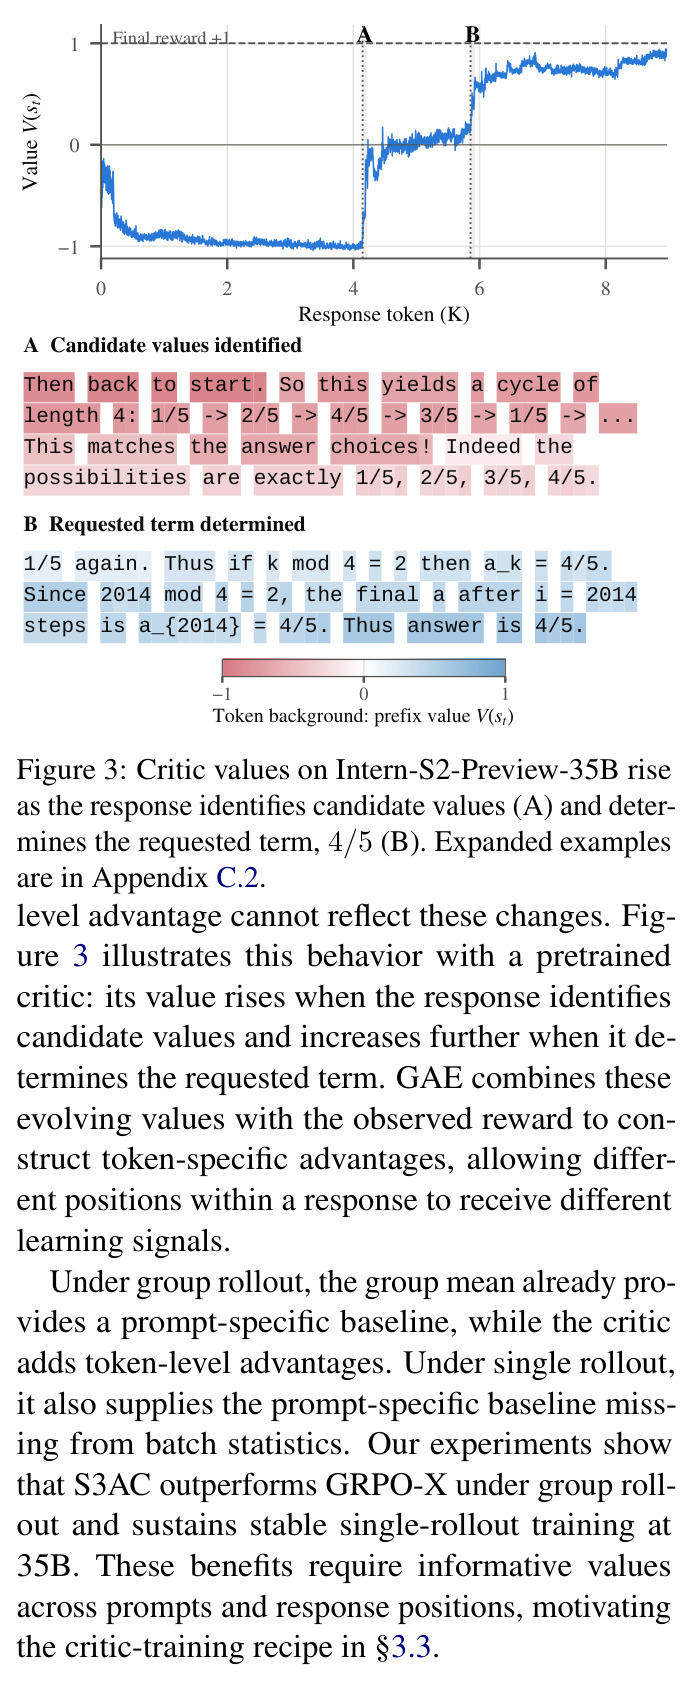
直觉上,一个好 critic 回答的问题是:'给定 prompt 和已生成的前缀,模型最终答对的期望还有多大?'这个量在生成前(只看 prompt,即 $V_\phi(s_0)$)就是难度估计,可用于选题;在生成过程中随推理进展变化,与终端奖励一起经 GAE 组合成 token 级优势,可区分推理链中的好步骤与坏步骤。技术上,S3AC 把响应生成建模为 token 级 MDP:状态 $s_t$ 包含 prompt 和前 $t$ 个响应 token,动作为下一个 token,验证器只在最后一个 token 给 $R\in\{-1,+1\}$,$\gamma=1$。critic $V_\phi(s_t)$ 拟合期望回报;对 $T$ 个 token 的响应按 $\hat{A}_t = \sum_{l=0}^{T-t-1}\lambda^l \delta_{t+l}$ 计算 token 级优势,其中 $\delta_t = r_t + V_\phi(s_{t+1}) - V_\phi(s_t)$。actor 侧采用 CISPO 代理目标 $J = \hat{E}_t[\mathrm{sg}(\bar{r}_t\hat{A}_t)\log\pi_\theta(a_t|s_t)]$(对裁剪后的重要性权重取 stop-gradient),并配合 token 级 IcePoP 掩码与序列级 MIS 风格掩码处理训练-推理失配;critic 侧对蒙特卡洛回报 $R$ 做裁剪平方误差回归。整体流程分三块:(a) 用多策略强度的轨迹池做覆盖导向的值预训练;(b) 随策略演化在线更新 critic(学习率为 actor 的 5 倍、每 rollout batch 更新 2 个 epoch 对 1 个 actor epoch);(c) 每个 rollout batch 生成前,用 $V_\phi(s_0)$ 与历史成败记录融合成成功率估计,按 DAPS 接受概率选题,再生成并交替更新 actor 与 critic。
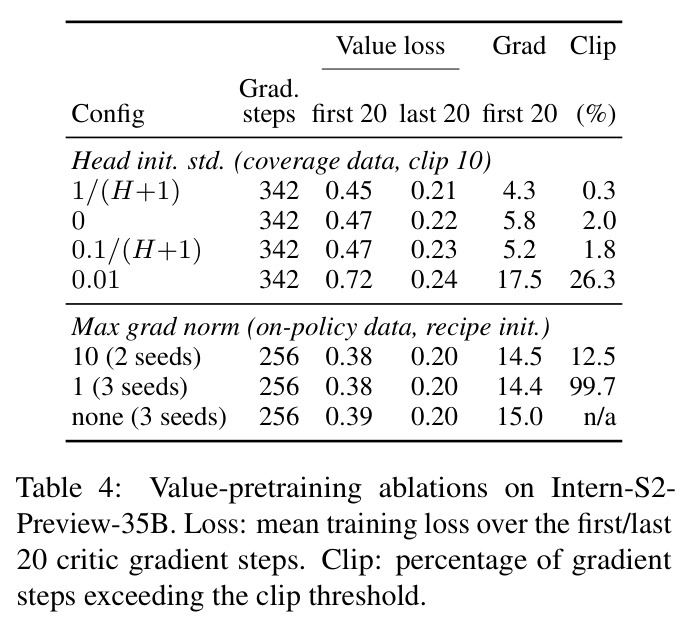
核心创新是把'让 critic 可训'拆成三个相互配套的机制,每一项都与已有方法的默认设置针锋相对。第一,覆盖导向的值预训练:不沿用 VC-PPO 的固定初始策略数据,也不是 SAO 那样单纯堆语料规模,而是从不同强度策略的轨迹中池化采样(35B 覆盖 critic 用 327,680 条轨迹、7.08B 响应 token,而只用初始策略的对照仅 65,536 条、0.74B token),刻意纳入初始策略中近乎绝迹的长而正确的响应(>24K token 响应正确率仅 5.0%,训练后期策略则达 61.8%),使 critic 从一开始就见过'长链后期答对'的样本。第二,值头优化失衡的修正:值头 $v_t = w^\top h_t$ 的头参数梯度 $\nabla_w \ell_t = e_t h_t$ 直接依赖隐状态、范数很大,而回传 backbone 的梯度 $\nabla_{h_t}\ell_t = e_t w$ 被很小的 $w$ 缩放;按 head 主导的范数做全局裁剪会过度压缩 backbone 更新。对策是双重放宽:head 初始化标准差取 $1/(H+1)$($H$ 为隐层维度)压低初始预测,使早期 value loss 从 0.72 降到 0.45;同时把 critic 梯度裁剪阈值从 actor 常用的 1 提高到 10,被裁剪更新比例从 99.7% 降到 12.5%。第三,DAPS 把值解释为难度:二值奖励下成功率 $p$ 对应期望回报 $2p-1$,故 $\hat{p}_c = (V_\phi(s_0)+1)/2$,与 Beta-Bernoulli 式历史计数融合后,按钟形接受率 $a = a_{\min} + (1-a_{\min})\,4\hat{p}(1-\hat{p})$ 偏向中间难度 prompt。
方法步骤详情
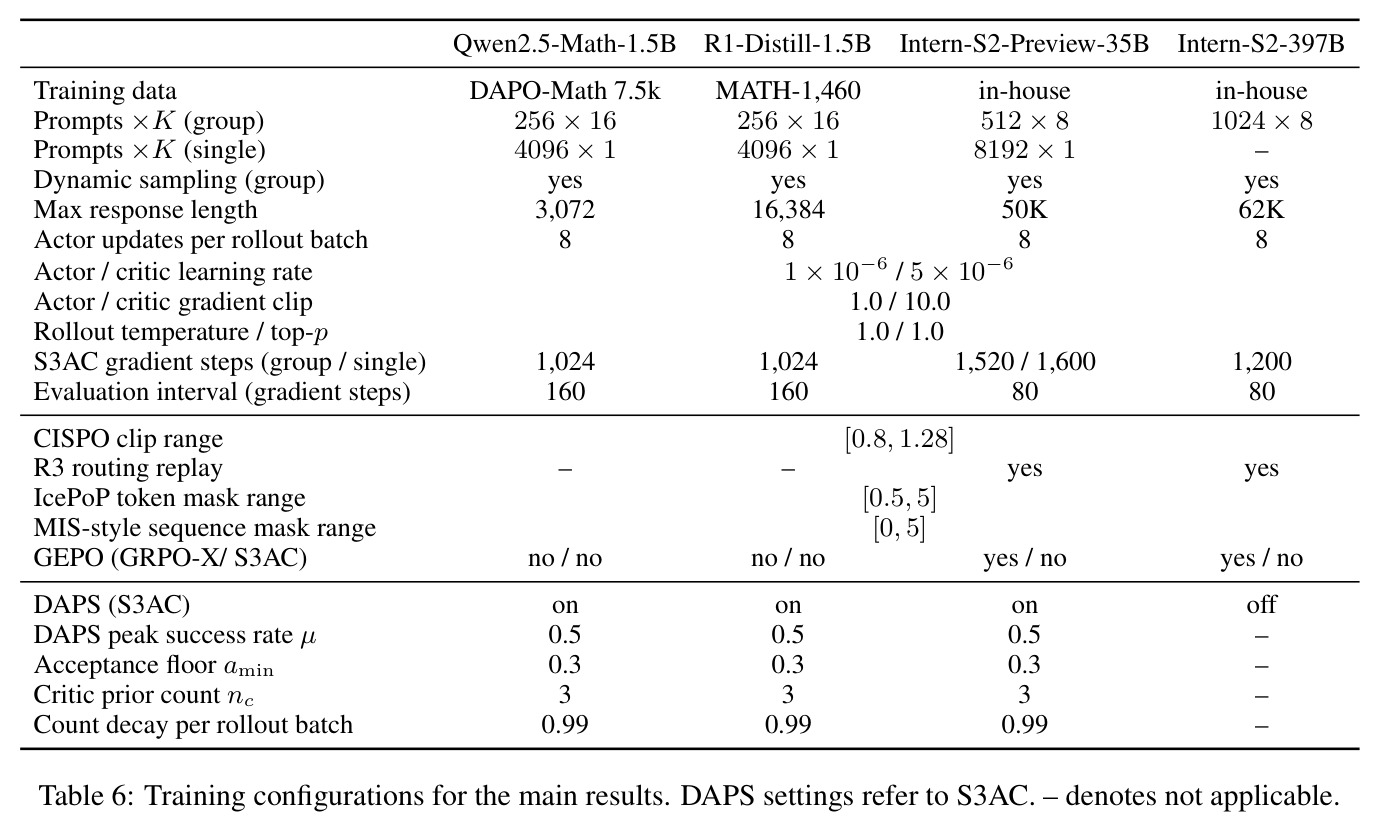
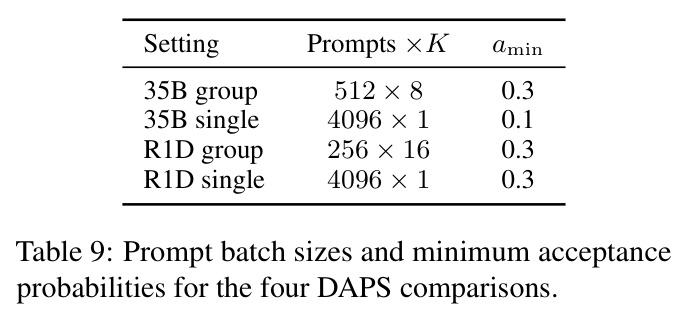
完整流程分四个阶段。阶段一(值预训练):从多个先前实验阶段、不同强度的策略池化轨迹,损失为 $\frac{1}{2}(V_\phi(s_t)-R)^2$ 的 token 平均 MSE,预训练 2 个 epoch,学习率从 $10^{-5}$ 余弦衰减到 $5\times10^{-6}$(3% 线性 warmup),冻结 attention 层、MoE router 与视觉塔;值头用 FP32、初始化标准差 $1/(H+1)$,梯度范数裁剪在 10。35B 覆盖 critic 的预训练语料为约 33 万条轨迹、7.08B token。阶段二(在线 actor-critic 更新):每个 rollout batch 生成 K 条响应并打分,切 8 个 mini-batch 做 1 个 actor epoch、对 critic 做 2 个 epoch;actor 用 CISPO 目标,$\bar{r}_t = \mathrm{clip}(r_t, 1-\epsilon_{low}, 1+\epsilon_{high})$;critic 学习率 $5\times10^{-6}$ 是 actor($1\times10^{-6}$)的 5 倍;GAE 解耦——critic 回归 MC 回报($\lambda_{critic}=1$),actor 用长度自适应 $\lambda_{actor} = 1 - 1/(\alpha T)$($\alpha=1.5$)。失配处理:当一条响应的最大 token 级对数概率比超过阈值时掩掉整条响应(MIS 式,范围 [0,5]),token 级用 IcePoP([0.5,5])。阶段三(DAPS 选题):生成前批量给候选 prompt 打分 $V_\phi(s_0)$,转成 $\hat{p}_c = \mathrm{clip}((V_\phi(s_0)+1)/2, 0, 1)$,与历史计数融合 $\hat{p} = (S + n_c\,p_c)/(N + n_c)$($n_c=3$,计数每 rollout batch 乘 0.99 衰减),接受概率 $a = a_{\min} + (1-a_{\min})4\hat{p}(1-\hat{p})$;初始 40 步均匀采样后经 80 步 ramp 渐进启用。阶段四(组过滤):group rollout 下套用 DAPO 动态采样丢弃全对/全错组——DAPS 已在生成前压低了这类 prompt 的进入比例。
技术新颖性
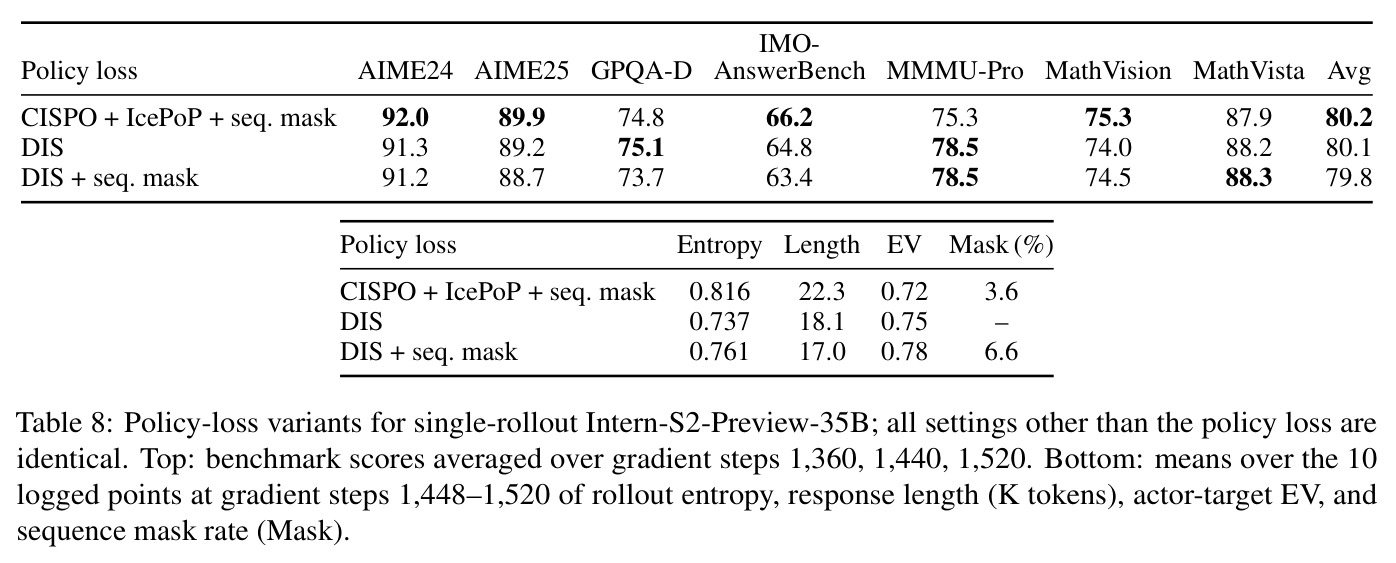
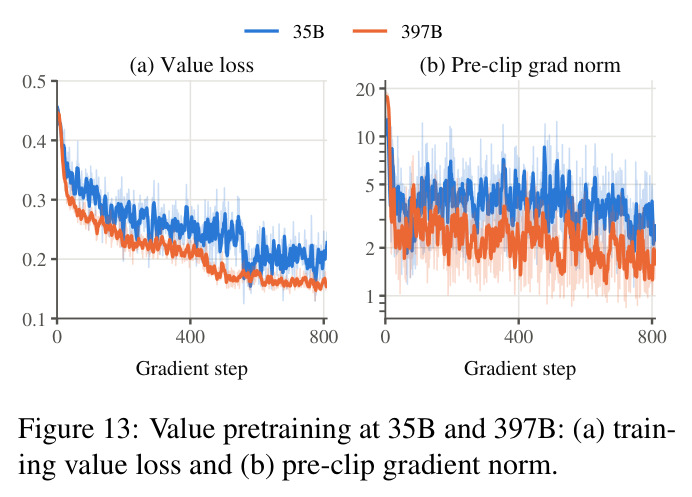
从技术谱系看,S3AC 的每个组件都有前身,但组合方式和若干关键选择是新的。与 VC-PPO 相比,预训练数据从单一初始策略改为多策略强度池化,并用 Figure 10 的长度-正确率数据(5.0% 对 61.8%)给出覆盖缺口的定量诊断;与 SAO 相比,强调的不是语料总量而是覆盖结构(长短、对错均衡)。值头初始化与裁剪阈值的组合此前未见系统分析:论文用 $\nabla_w\ell_t = e_t h_t$ 与 $\nabla_{h_t}\ell_t = e_t w$ 的分解指出全局裁剪的不对称伤害(head 占平方梯度范数超过 99% 却只有 2,048 个参数),以'小初始化 + 大阈值'让 backbone 更新免于被 head 主导的裁剪缩放;Figure 12/13 显示该诊断在 397B 上同样成立且更大模型的值拟合能力更强。DAPS 的创新在于复用:选题所需难度估计来自已为策略学习训练的同一个 critic,不需要 SPO 的离线 rollout 初始化、PCL 的独立 prompt 级值模型或 GRESO 的纯历史统计,且同时兼容 group 与 single rollout;接受概率除钟形峰值外还设 $a_{\min}$ 地板,保留 $\epsilon$-贪婪式探索。最后,actor 用 CISPO 配合 IcePoP/MIS 掩码的失配处理,使整套配方能在 397B MoE 上稳定运行;Table 8 显示换成 DIS 等其他策略损失结论不变(79.8-80.2),说明增益确实来自 critic 配方而非某个特定损失函数。
实验结果
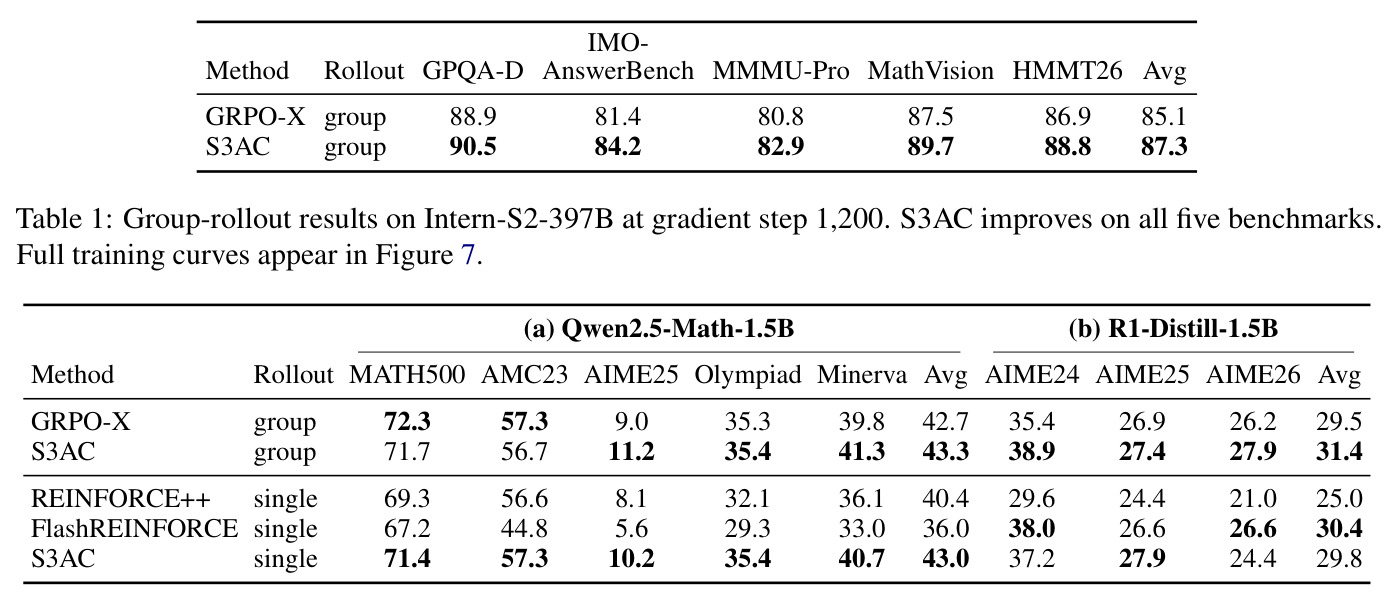
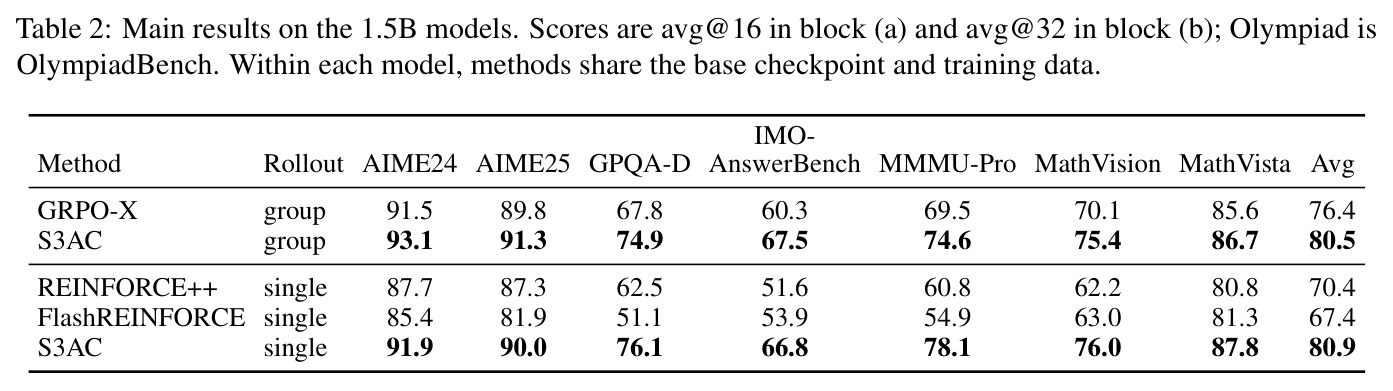
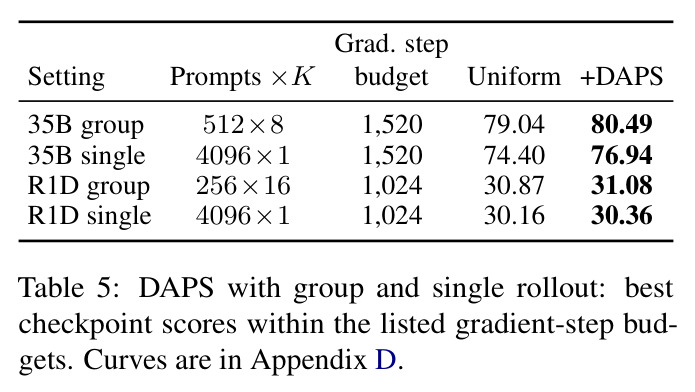
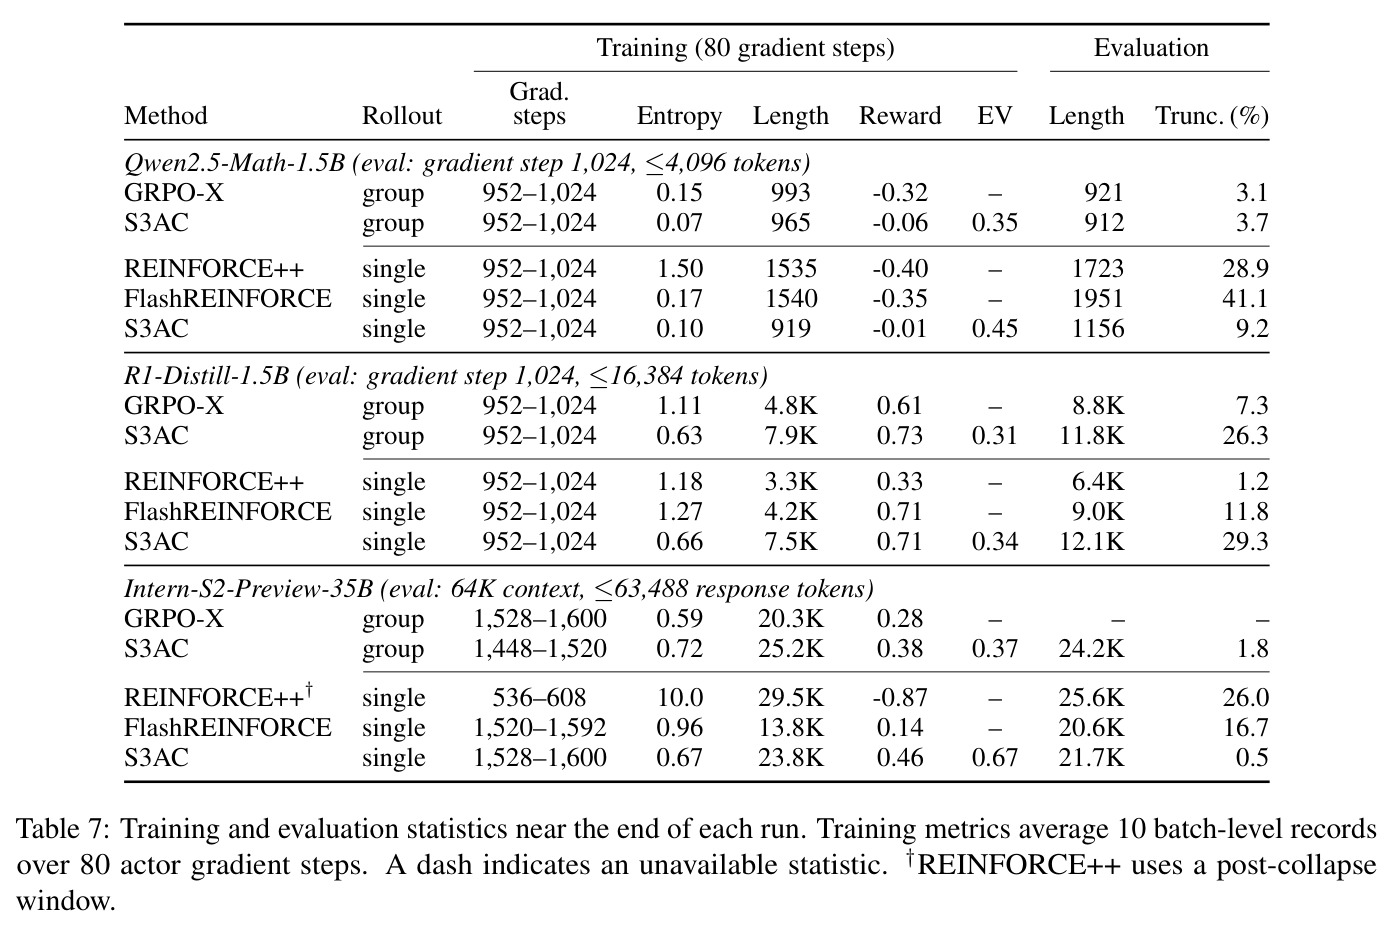
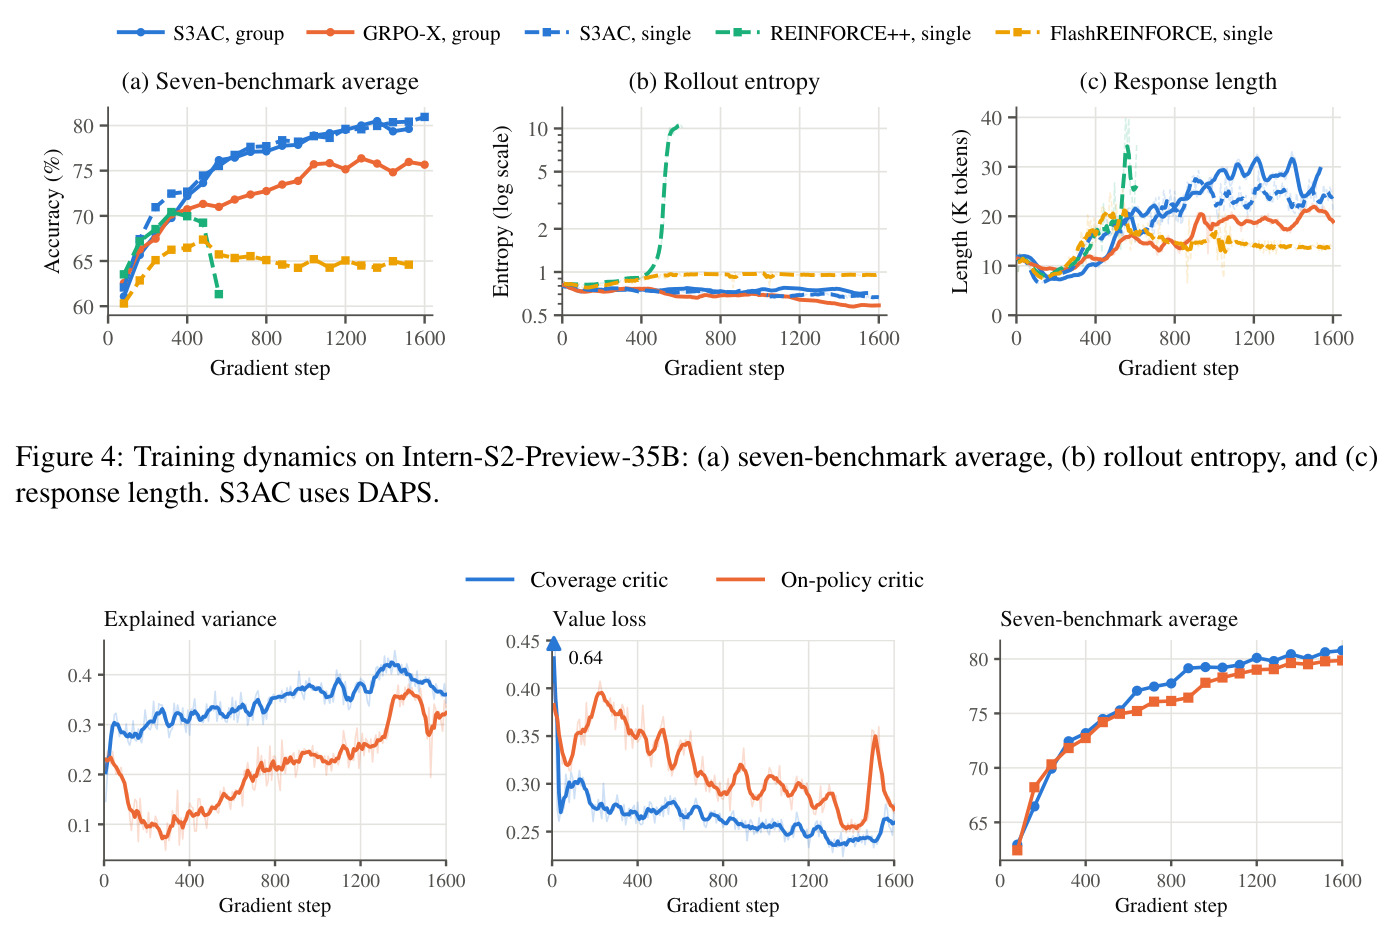
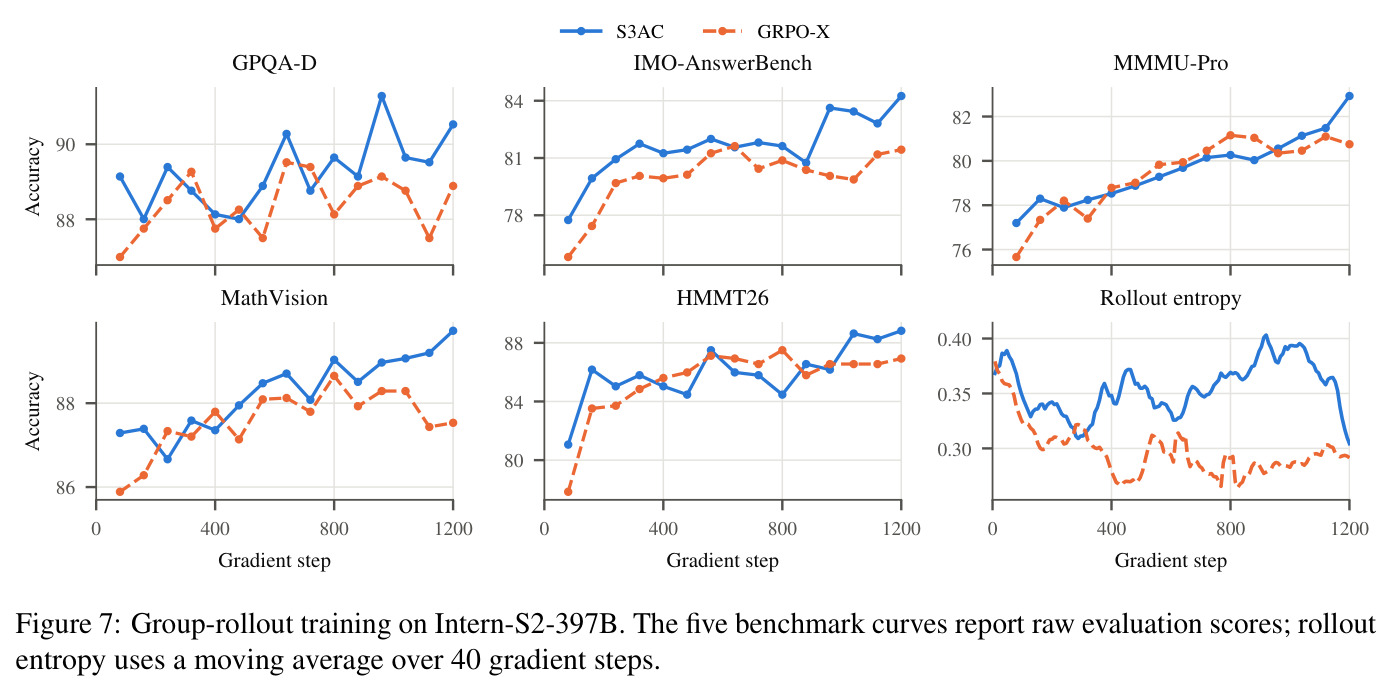
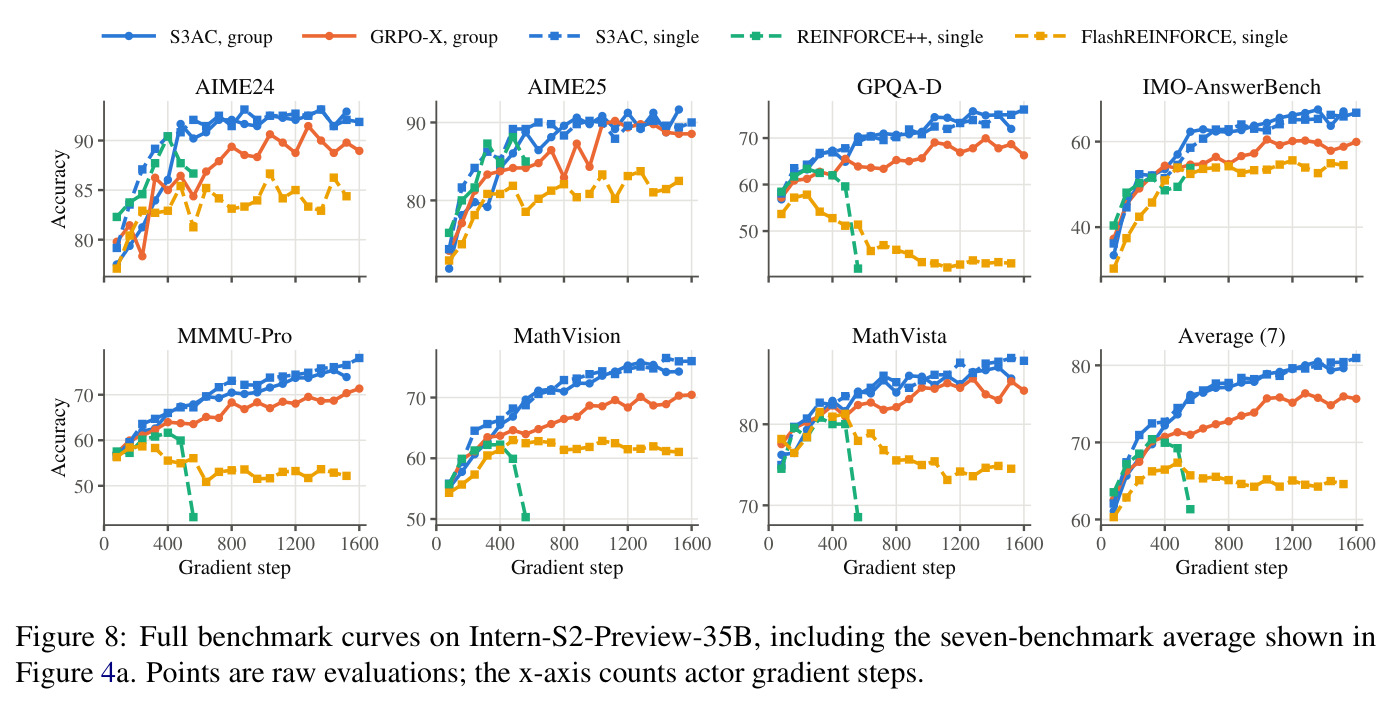
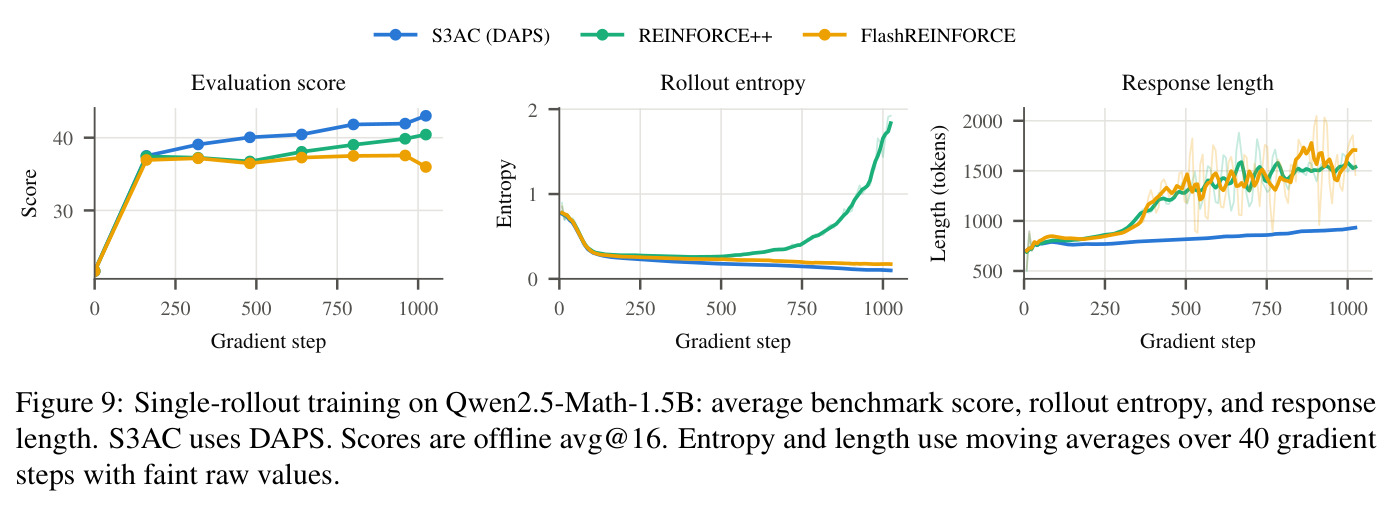
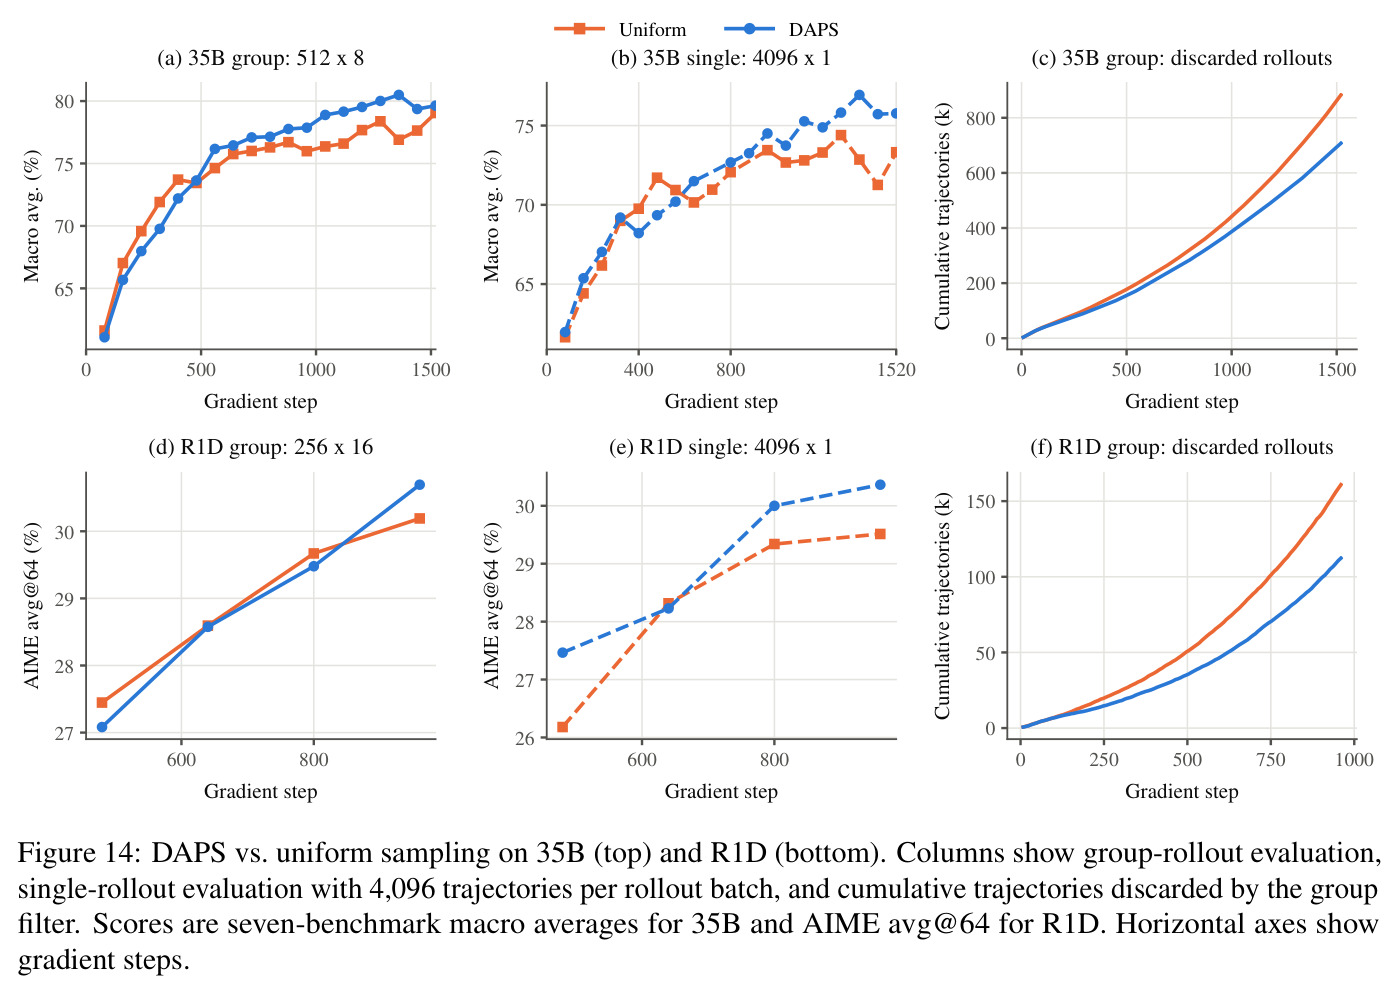
逐一分析四组实验。(1) Group rollout 主结果:S3AC 在全部四个模型上超过 GRPO-X。35B 七基准平均 76.4 升至 80.5(Table 3),七个基准全胜,其中 GPQA-Diamond 67.8→74.9(+7.1)、IMO-AnswerBench 60.3→67.5、MMMU-Pro 69.5→74.6、MathVision 70.1→75.4;397B 五基准平均 85.1→87.3(Table 1),GPQA-D 88.9→90.5、IMO-AnswerBench 81.4→84.2、MathVision 87.5→89.7;1.5B 上 Qwen2.5-Math 42.7→43.3、R1-Distill 29.5→31.4(Table 2)。(2) 单 rollout 稳定性:35B 上 S3AC 达 80.9,比 REINFORCE++(70.4)高 10.5 分、比 FlashREINFORCE(67.4)高 13.5 分(Table 3);Figure 4 显示两个 critic-free 基线初期上升后衰退——REINFORCE++ 的 rollout 熵与响应长度失控增长(熵升到对数刻度约 10)、FlashREINFORCE 转向短响应且分数下滑,而 S3AC 将大部分增益保持到 1,600 步。(3) 预训练消融:值头初始化标准差从 0.01 降到 $1/(H+1)$ 使前 20 步 value loss 从 0.72 降到 0.45、最终 loss 最低(0.21,Table 4);裁剪阈值从 1 提到 10 使被裁剪更新比例从 99.7% 降到 12.5% 且最终损失不变差;覆盖 critic 相比只用初始策略数据的 on-policy critic 有更高解释方差与更低值损失,同一 actor 更新预算下七基准平均 80.78 对 79.86(Figure 5)。(4) DAPS:匹配梯度步预算下 35B group 79.04→80.49、35B single 74.40→76.94、R1D group 30.87→31.08、R1D single 30.16→30.36(Table 5);Figure 6a 显示 DAPS 持续减少被动态采样丢弃的轨迹且后期差距扩大,Figure 6b 显示训练预算更多流向经验成功率在 0.2-0.8 之间的中间难度 prompt。代价:S3AC 每 actor 步摊销墙钟时间比 GRPO-X 多 27-40%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Intern-S2-397B(MoE)group rollout | 五基准平均(GPQA-D/IMO-AnswerBench/MMMU-Pro/MathVision/HMMT26) | 87.3 | 85.1(GRPO-X) | +2.2,五个基准全部领先 |
| Intern-S2-Preview-35B(MoE)group rollout | 七基准平均 | 80.5 | 76.4(GRPO-X) | +4.1,七个基准全部领先(GPQA-D +7.1 最大) |
| Intern-S2-Preview-35B single rollout | 七基准平均 | 80.9 | 70.4(REINFORCE++)/ 67.4(FlashREINFORCE) | +10.5 / +13.5 |
| Qwen2.5-Math-1.5B group rollout | 五基准平均(MATH500/AMC23/AIME25/Olympiad/Minerva) | 43.3 | 42.7(GRPO-X) | +0.6 |
| Qwen2.5-Math-1.5B single rollout | 五基准平均 | 43.0 | 40.4(REINFORCE++)/ 36.0(FlashREINFORCE) | +2.6 / +7.0 |
| R1-Distill-1.5B group rollout | AIME24/25/26 平均 | 31.4 | 29.5(GRPO-X) | +1.9 |
| 35B DAPS 消融(group) | 七基准平均(1,520 步预算内最佳) | 80.49 | 79.04(均匀采样) | +1.45 |
| 35B DAPS 消融(single) | 七基准平均(1,520 步预算内最佳) | 76.94 | 74.40(均匀采样) | +2.54 |
| 覆盖预训练消融(35B group) | 七基准平均 | 80.78(coverage critic) | 79.86(on-policy critic) | +0.92,且早期 EV 更高、value loss 更低 |
局限与改进
作者承认三点局限:任务范围局限于可验证奖励的推理类任务(数学、科学、多模态推理),未验证 agentic 多轮设置中跨工具调用与环境回合的信用分配是否同样有效;实验未系统评估跨独立 RL 训练种子的方差;计算开销上 S3AC 每步摊销墙钟时间比 GRPO-X 高 27-40%,因为 critic 需要额外训练和推理。我的补充观察:其一,397B 未报告 single rollout 结果,DAPS 在 397B 上也被关闭(Table 6 中标注 off),方法在最大规模下的完整有效性(尤其是单 rollout 稳定性主张)仍缺直接证据;其二,DAPS 在 R1-Distill-1.5B 上的增益很小(group +0.21、single +0.20)且曲线波动,说明其收益依赖模型与任务组合,并非普遍显著;其三,单 rollout 对比中 REINFORCE++ 在 536-608 步即崩溃,Table 7 不得不用'崩溃后窗口'报告其统计(奖励 -0.87、熵 10.0),极端基线在一定程度上削弱了稳定性结论的对照力度;其四,critic 值与成功率的线性对应依赖二值奖励、$\gamma=1$、$V(s_T)=0$ 的约定,若引入部分奖励或过程奖励,DAPS 的难度解释需要重新推导;其五,覆盖预训练的数据来自'多个先前实验阶段'的轨迹池,隐含较大的基础设施与历史积累成本,冷启动团队难以照搬;其六,Minerva 用 LLM judge 评分,作者自承可能与规则评分不一致,不同基准的 avg@k 也不统一(16/32/4/1),横向比较需谨慎。
独立分析的弱点
独立分析四个弱点。第一,开销与收益在小模型上不对称:27-40% 的额外墙钟时间在 35B 换来 group +4.1 分,但在 1.5B Qwen 上 group 增益仅 +0.6 分,且 R1D 单 rollout 下 FlashREINFORCE(30.4)甚至高于 S3AC(29.8),预算受限场景性价比存疑——改进方向是按模型规模或任务难度设计启用准则,或用轻量 critic(低秩/LoRA 值头、蒸馏小 critic)摊薄成本。第二,DAPS 超参敏感性未充分消融:接受地板 $a_{\min}$(0.1-0.3)、先验计数 $n_c=3$、衰减率 0.99、40 步均匀初始化加 80 步 ramp 均为手工设定,论文未报告扫描——改进方向是把接受率与梯度信噪比或值不确定性(如 critic 集成方差)自适应挂钩,减少每配置调参。第三,两种收益来源未被正交分离:prompt 级基线与 token 级优势同时生效,缺少'只用 $V_\phi(s_0)$ 做基线但优势仍取序列级'这类中间设置,读者难以判断增益主要来自哪一层(Figure 2 只是诊断而非因果消融)——改进方向是设计正交消融分别保留两种信号。第四,评估协议不统一:Minerva 用 LLM judge、各基准 avg@k 不同、R1D 上作者自承小差异需谨慎解读,且 35B 单 rollout 各方法取'各自最佳 checkpoint'对比(Table 3),存在事后选择偏差——改进方向是统一采样量与评分器、报告多种子均值与显著性检验、按固定步数对齐对比。
未来方向
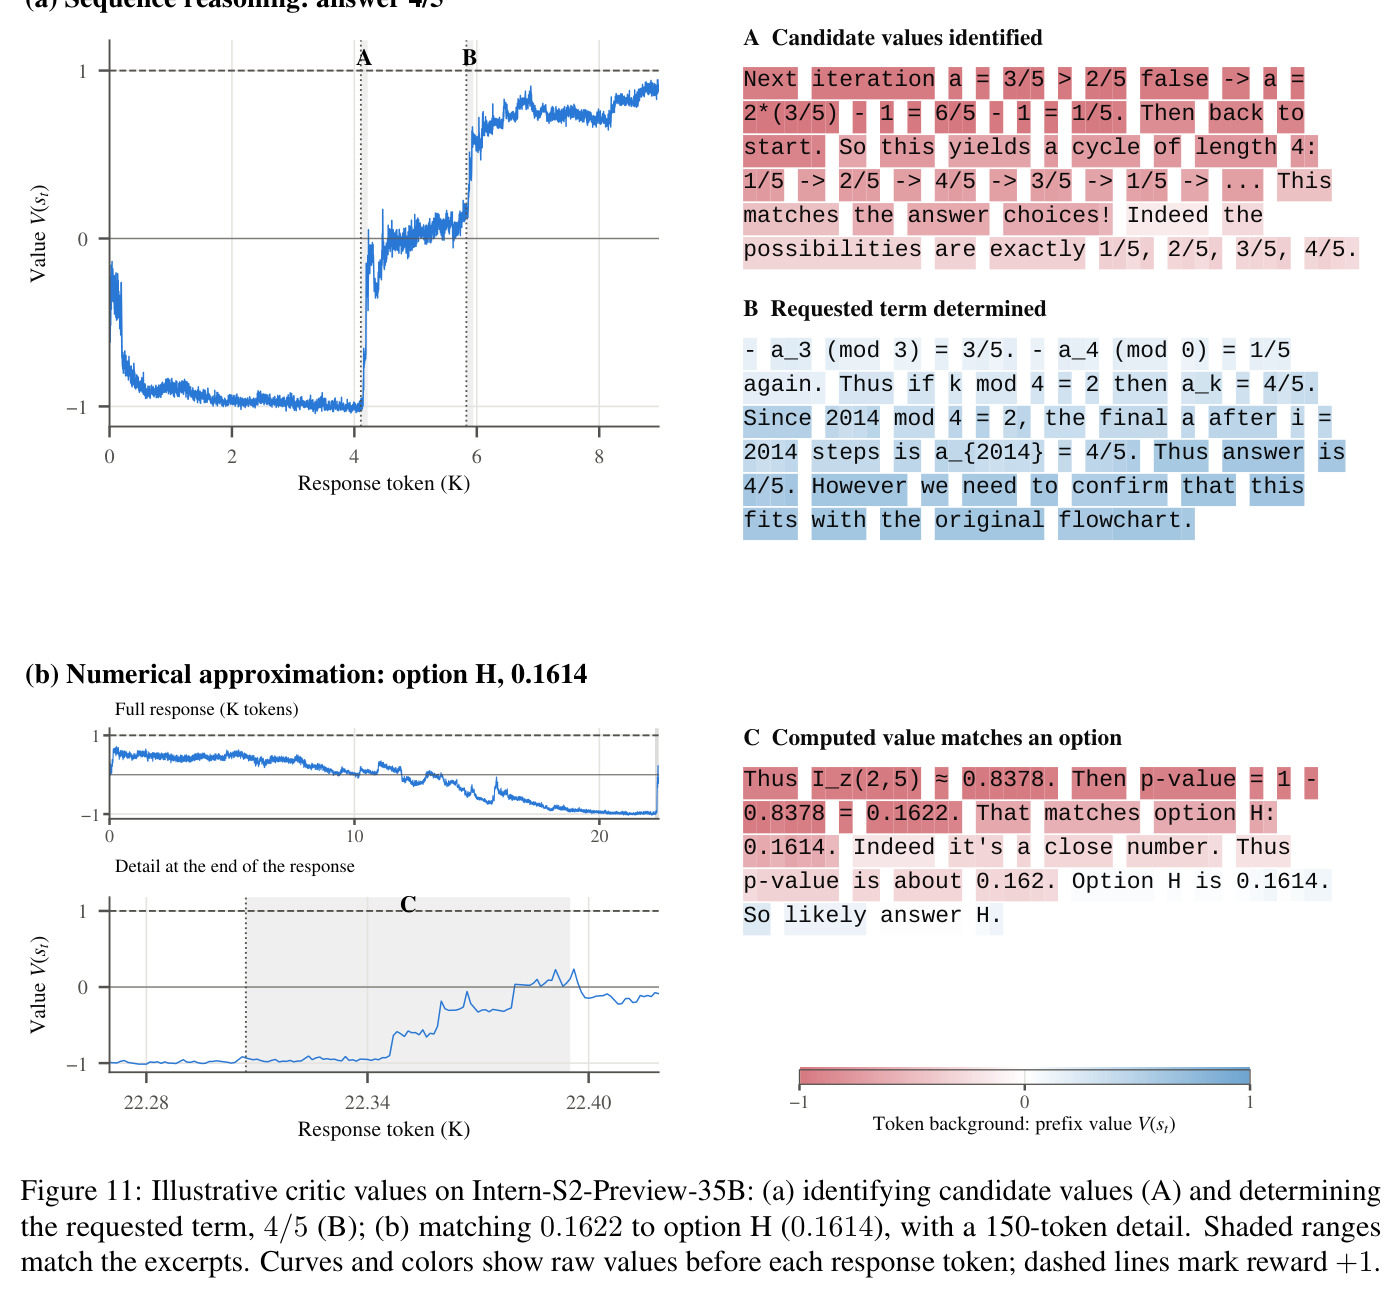
作者提出的自然延伸包括:把配方迁移到 agentic 多轮 RL,验证跨工具调用与环境回合的信用分配;系统化多种子方差评估。基于其成果还可延伸:其一,把训练好的 critic 用作过程奖励模型,在测试时引导 best-of-n 或树搜索——Figure 11 已显示值能精确追踪'识别候选值→确定所求项''计算 0.1622 匹配选项 H'这类中间推理进展,这是现成的 PRM 雏形;其二,补齐 397B 级别的 single rollout 训练与 DAPS 启用(本文留空),并借鉴 SAO/CompactionRL 的异步基础设施缓解 critic 的训练与推理开销;其三,DAPS 难度估计与课程学习、熵控制(GEPO)联合调控——本文 GRPO-X 基线在 35B/397B 配了 GEPO 而 S3AC 未配,公平联合调优可能进一步提升;其四,用 critic 集成或深度集成提供值不确定性,自适应决定 $n_c$、衰减率与接受地板,替代手工超参;其五,把覆盖池化思想推广到多任务混合(代码、agentic、长上下文)下的值预训练,检验'多强度轨迹池'是否是通用的 critic 冷启动配方;其六,压缩 critic 本身(量化、低秩值头、异步小 critic),把 27-40% 开销压到与 GRPO-X 相当,这对工业级部署最为关键。
复现评估
复现难度中高,分层看。有利条件:训练栈基于开源的 XTuner 与 LMDeploy;两个 1.5B 设置的训练数据完全公开(Qwen2.5-Math-1.5B 用 DAPO-Math 7.5k 子集,R1-Distill-1.5B 用 MATH-1,460);Table 6 给出了几乎全部关键超参(actor/critic 学习率 $1\times10^{-6}$/$5\times10^{-6}$、梯度裁剪 1.0/10.0、CISPO 范围 [0.8,1.28]、IcePoP [0.5,5]、MIS [0,5]、DAPS 的 $n_c=3$、计数衰减 0.99、接受地板 $a_{\min}$ 等),附录还给出值预训练的完整配置(学习率 $10^{-5}$→$5\times10^{-6}$ 余弦衰减、冻结 attention/MoE router)。1.5B 的 group rollout 消融与 DAPS 对比是单机多卡到小集群、数天内可复现的核心起点。不利条件:论文未明确承诺开源代码与预训练 critic 权重;两个 MoE 模型虽然 397B 权重在 HuggingFace 公开,但训练都用 in-house prompt 集(覆盖数学、指令、推理、物理、化学),外部无法获得;覆盖预训练需要约 33 万条、7.08B token 的多策略轨迹池(35B 主结果设置用 1.13M 条、6.24B token;397B 用 1.85M 条、10.0B token),并依赖'多个先前实验阶段'的轨迹积累与专门的算力;397B 级 RL(62K 响应长度、1,200 步)需要大规模集群。综合判断:1.5B 部分复现可行,35B 需专业集群与自有数据近似替代,397B 只能复现趋势而非精确数字。
论文图表
覆盖 critic 与 on-policy critic 的三联对比:覆盖预训练在在线训练早期给出更高解释方差(约 0.4 以上)、更低值损失(0.45 对 0.64 起),且该优势随后收敛;同等 actor 更新预算下最终七基准平均 80.78 对 79.86。
直接证明'多策略覆盖预训练'这一核心设计的因果贡献,是预训练部分最关键的消融图。
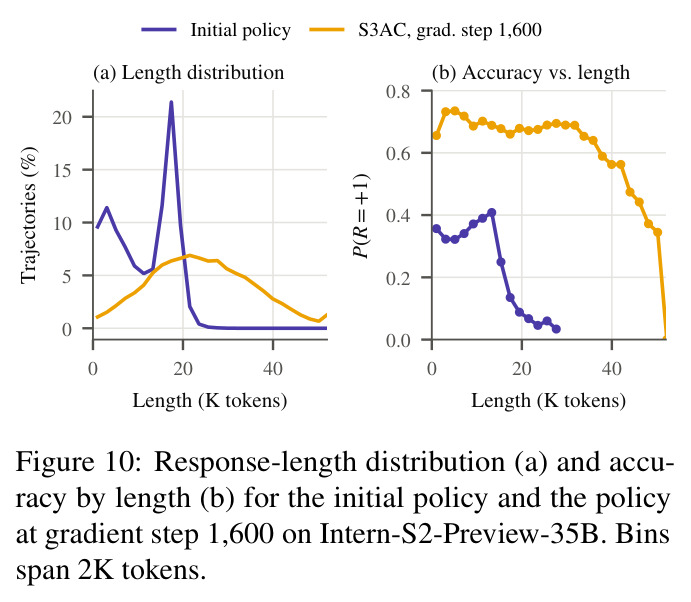
初始策略与训练 1,600 步后策略的响应长度分布与分长度正确率:超过 24K token 的响应在初始策略样本中仅 5.0% 正确,强策略下达 61.8%,说明长而正确的轨迹在初始策略数据中几乎不存在。
为'为什么要做多策略覆盖预训练'提供定量动机,是整个稳定性设计(Figure 5 消融)的逻辑起点。
35B 逐基准结果:group 下 S3AC 80.5 对 GRPO-X 76.4(七基准全胜,GPQA-D 74.9 对 67.8);single 下 S3AC 80.9 对 REINFORCE++ 70.4、FlashREINFORCE 67.4(GPQA-D 76.1 对 62.5/51.1)。
核心模型的主表:单 rollout 10.5 分的差距是全文最大的单点增益,也是 critic 提供 prompt 级基线价值的直接体现。