OBB-PBD:将并行框解码扩展至旋转框的航空图像指代表达定位 OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
把并行框解码从四坐标水平框扩展为六槽旋转框,并用诊断协议验证增益来源
前置知识
指代表达定位(Referring Expression Grounding)
给定一张图像和一句自然语言描述(如“离镜头最近的那辆车”),模型要在图中定位出描述所指的那个具体目标并输出边界框。它与通用目标检测的区别在于:检测结果不固定,完全由语言表达决定,要求模型具备语言-视觉联合推理能力。经典基准有 RefCOCO 系列,遥感版本则面临小目标、密集相似目标和关系性语言的额外困难。
本文的全部任务设定就是这个任务在无人机航空图像上的变体,理解任务定义才能明白为什么需要旋转框输出。
水平框(HBB)与旋转框(OBB)
水平框用两个角点 $(x_1,y_1,x_2,y_2)$ 四个坐标表示,边始终平行于图像坐标轴;旋转框用中心、宽、高、朝向角 $(c_x, c_y, w, h, \theta)$ 五个量表示,可以贴合任意朝向的细长目标。在俯视图像中车辆等目标朝向任意,用水平框拟合一个斜放目标会把大量背景框进来,旋转框才是自然选择。注意矩形满足 $(w,h,\theta)\equiv(h,w,\theta+90°)$,存在参数二义性,需要规范化处理。
本文的核心贡献就是把输出表示从四坐标水平框换成五参数旋转框,全文的指标 rotIoU 也是基于旋转框的多边形交并比。
并行框解码(Parallel Box Decoding, PBD)
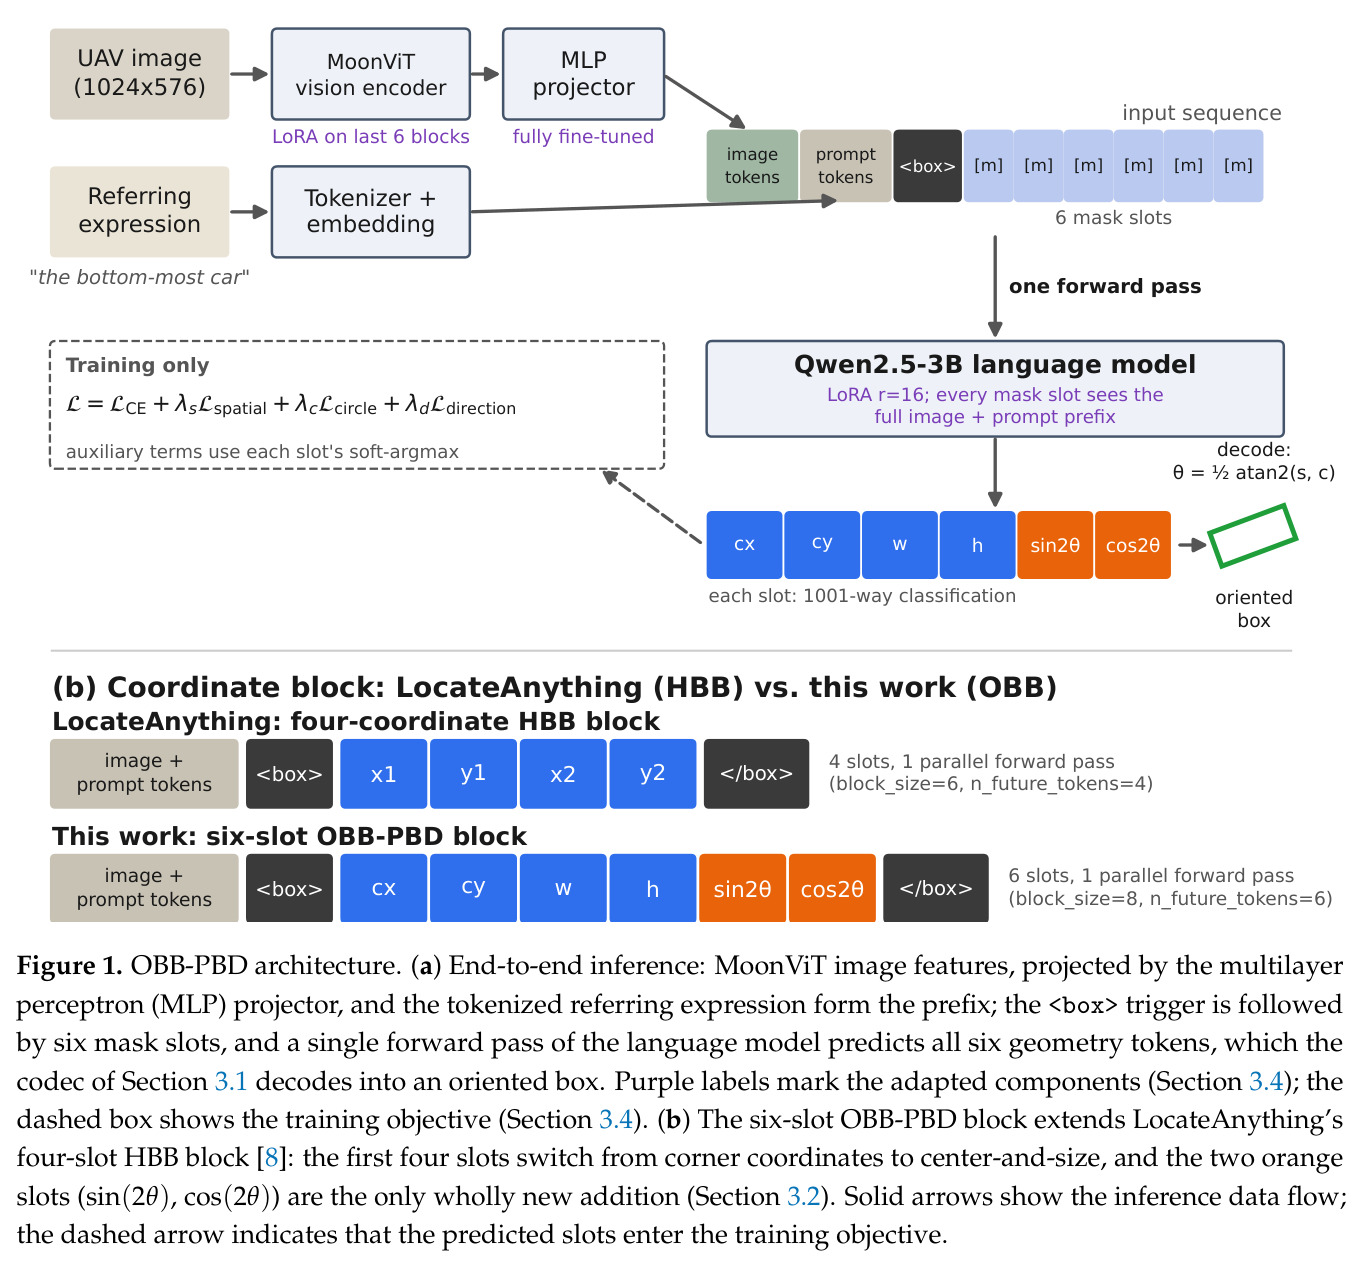
LocateAnything 提出的一种块对齐解码接口:触发 token 之后不再逐个自回归生成坐标 token,而是在一次前向传播中并行预测框的全部几何槽(原版为 4 个),每个槽做 1001 路坐标词表分类,最后补上 。这样既加快解码,又让坐标表示与“一个框”这个几何原子对齐。原版块配置为 block_size=6、n_future_tokens=4。
本文就是把这个接口从 4 槽扩展到 6 槽(block_size=8、n_future_tokens=6),并检验扩展的可行性与增益来源。
双角度参数化(Double-Angle Parameterization)
用 $\sin(2\theta)$ 和 $\cos(2\theta)$ 两个值代替角度 $\theta$ 本身来表示朝向。矩形的朝向以 180° 为周期,直接回归 $\theta$ 会在 0°/180° 边界处出现损失不连续(预测 179° 与真值 1° 实际只差 2°);而 $2\theta$ 的周期恰好是 180°,$(\sin 2\theta, \cos 2\theta)$ 这个单位圆上的点天然编码了周期性,解码时用 $\theta=\frac{1}{2}\operatorname{atan2}(\hat{s},\hat{c})\bmod 180°$ 恢复即可规避边界跳变。
这是本文六槽表示中两个新增槽的设计依据,也是训练中 circle/direction 辅助损失的作用对象,不理解它就看不懂损失函数和角度 MAE 指标。
旋转交并比(rotIoU)
两个旋转框之间的交并比:把预测框和真值框都还原为带朝向的四边形,用 Shapely 库做多边形求交和并集再算比值。它与普通 IoU 的区别是几何上尊重朝向:一个斜放的细长目标与它的水平外包络框,rotIoU 可能只有 0.6 左右。本文还配套报告轴对齐 IoU(aabbIoU,比较两者水平包络)和 Acc@0.50/Acc@0.75 阈值准确率。
rotIoU 是全文的主指标,主结果表、分解实验、置信区间全部围绕它展开。
图像聚类自助法与软 argmax
图像聚类自助法(image-cluster bootstrap)是置信区间估计方法:重采样单位是 120 张测试图像而非 6139 条记录(因为同一张图内的记录高度相关),每次重采样把该图所有记录一起池化,重复 10000 次得到 95% CI。软 argmax 是把槽位上的 softmax 概率 $p^{(k)}$ 做期望 $\hat{v}=\sum_k p^{(k)}\cdot k/1000$,得到可微的连续值估计,使辅助损失能对 logits 求导。
前者是本文所有“CI 排除零”结论的统计基础,后者是三个辅助损失可微化的关键技巧。
研究动机
航空/无人机俯视图像上的指代表达定位远比自然图像困难:4000×2250 像素的画面里密集排列着大量外观相似的车辆,目标相对整幅图非常小,描述又常依赖关系性语言(如“离镜头最近的车”)。更关键的是俯视视角下物体可朝向任意方向,主流定位模型仍输出的水平框对斜放细长目标拟合极差——数据审计显示 AVVG 中 97.85% 的框并非轴对齐。架构层面还有第二个问题:主流模型以自回归方式逐个生成坐标 token,一个框要四次前向,且把几何上不可分的“一个框”拆成了任意顺序的 token 序列。LocateAnything 的并行框解码(PBD)虽解决了效率问题,但发布版本只支持四坐标水平框,能否以及如何扩展到六槽旋转框、扩展后会带来什么精度与延迟代价,原方法完全没有检验。更隐蔽的是,作者发现块对齐一旦失效,训练损失仍会正常下降——坐标槽根本看不到图像和提示,loss 曲线却毫无异常。
本文的目标是本文目标分两层。方法层:把 LocateAnything 的块对齐并行解码接口从四坐标水平框 $(x_1,y_1,x_2,y_2)$ 扩展为六槽旋转框表示 $c_x\ c_y\ w\ h\ \sin 2\theta\ \cos 2\theta$ ,使其能表达朝向任意的航空目标,并量化这一扩展在精度(rotIoU、Acc@0.75、角度 MAE)和延迟上的代价与收益。验证层:作者明确拒绝“损失下降即正确”的朴素假设,构建一套诊断协议——图像/提示乱序对照、可见性与泄漏探针、编码器往返误差独立度量——来确认坐标槽真正使用了图像与提示信息,并用对照臂分解实验回答“提升究竟来自域适应、块格式扩大还是朝向学习”。最终在 AVVG 基准完整 6139 条测试记录上,给出三个训练种子、图像聚类置信区间支撑、且检查点选择与测试集完全隔离的可信结论。
与已有工作不同的是,已有两条路线做过“旋转框+语言定位”:GeoChat/GeoGround 证明了遥感旋转框定位可行,SATGround 用专用回归头联合预测 OBB 参数,但它们都不是块对齐的坐标 token 接口,本文也不与之做头对头比较。本文的独特切入有三点。第一,专注 PBD 这种“把一个几何原子当作一个块”的机制本身,考察它能否承载六槽旋转几何,而非另起新架构。第二,把“验证扩展”当作方法的一部分而非事后补充:用诊断探针发现并修复了主干中一个静默缺陷——训练路径的因果前缀长度由位置 ID 模式推出,导致坐标槽注意力只覆盖 894 个 key 中的 7 个、看不到任何图像或提示 token,而损失照常下降——修复后注意力恢复到 894/894。第三,用 HBB-envelope 对照臂把“块格式扩大”与“学习朝向”两个效应解耦,每个效应都配三个种子加图像聚类 bootstrap 置信区间,这种把归因做实到逐种子 CI 的严谨程度在同类系统论文中很少见。
核心方法
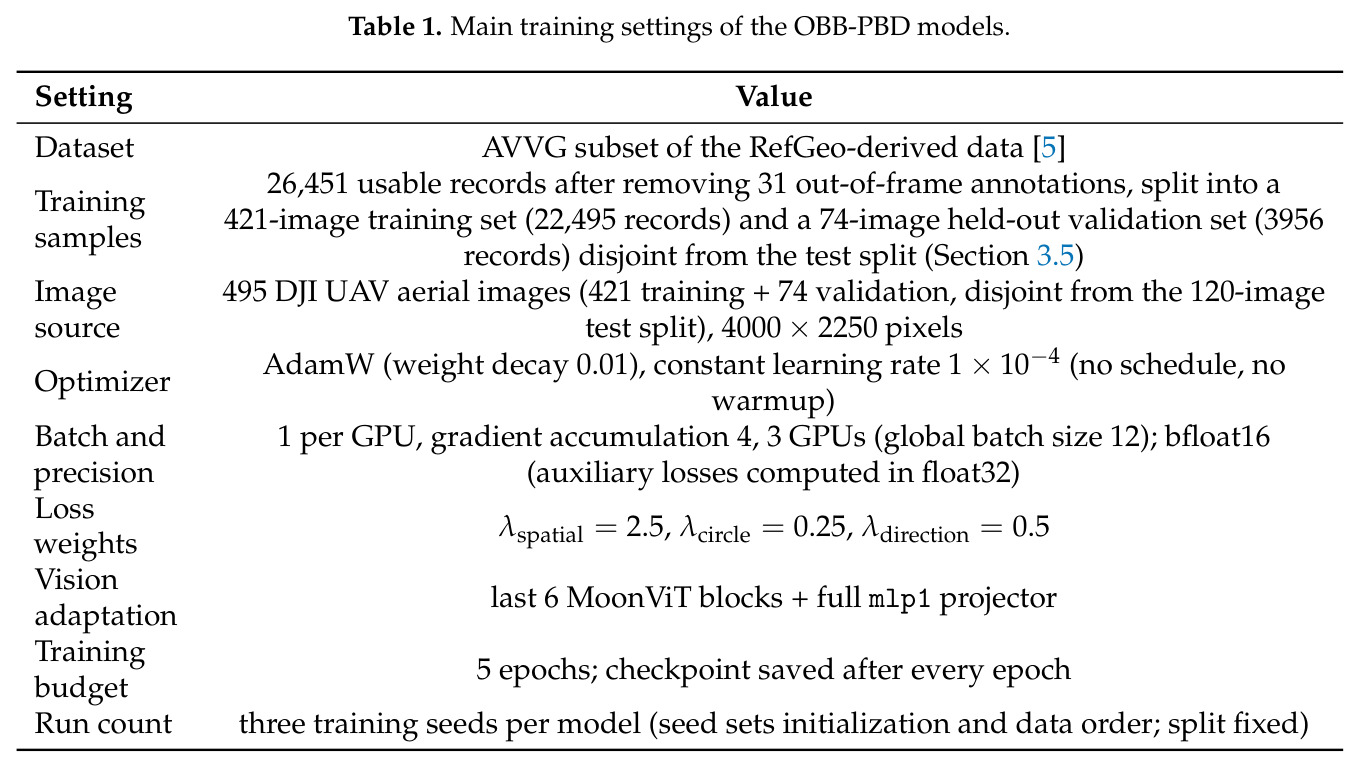
直觉上,作者把“一个旋转框”当作不可分割的几何单元:触发 token 之后,中心 $c_x,c_y$、宽高 $w,h$ 和双角度朝向槽 $\sin 2\theta, \cos 2\theta$ 六个槽在同一次前向传播中并行预测,而非自回归逐坐标生成。技术路线:先把真值框规范化到 $w\ge h$ 消除二义表示;再用 1001 级量化编码器,$q(v)=\operatorname{round}(v\cdot 1000)$ 处理 [0,1] 坐标,符号值先重标定再量化,解码端用 $\theta=\frac{1}{2}\operatorname{atan2}(\hat{s},\hat{c})\bmod 180°$ 恢复角度;然后在 LocateAnything-3B(Qwen2.5-3B-Instruct + MoonViT)上微调:语言模型 LoRA rank 16、MoonViT 最后 6 块加 LoRA、mlp1 投影器全量训练,AdamW 学习率 $1\times10^{-4}$,全局 batch 12,5 epoch,三个种子;推理用直接 PBD 解码器一次前向取得六槽 logits,rotIoU 用 Shapely 多边形求交计算。块配置为 block_size=8、n_future_tokens=6。
核心创新是“块对齐并行接口 + 双角度参数化”的组合,以及把验证协议内建进方法。与自回归逐 token 生成不同,PBD 保证六个坐标槽共享完整的图像+提示因果前缀,一次前向同时输出全部几何量:实测单样本延迟 329.82ms,对自回归解码同样的六个 token(568.65ms)快 1.72 倍,而相比原四槽块仅慢 1.075 倍。双角度槽 $(\sin 2\theta, \cos 2\theta)$ 是关键表示设计:矩形朝向以 180° 为周期,直接回归 $\theta$ 会在 0°/180° 边界不连续,二倍角向量把周期性编码进单位圆上的点,天然规避跳变;前四个槽同时从角点改为中心+尺寸,因为双角度项必须围绕框中心定义。与 SATGround 等专用回归头方案的本质区别在于:本文不新增任何回归头,坐标预测仍是 1001 路的 token 分类,几何结构完全由块的排列方式承载,因此可以直接继承主干既有的坐标接口。配套的三个辅助损失(spatial/circle/direction)只作用在软 argmax 期望上,保持端到端可微。
方法步骤详情
第一步,数据准备:取 RefGeo 的 AVVG 子集,剔除 31 条出界标注得 26451 条记录,划分为 421 张训练图(22495 条)、74 张验证图(3956 条),与 120 张测试图(6139 条)完全隔离;真值规范化到 $w\ge h$ 后量化编码,往返 IoU 达 0.9903/0.9823。第二步,主干修复:修复五个上游缺陷(U1 块大小被硬编码封顶、U2 前向返回元组、U3 叶子视图原地写、U4 掩码选择崩溃、U5 因果前缀错误导致坐标槽看不到图像),修复后首槽注意力从 7/894 恢复到 894/894。第三步,训练:$\mathcal{L}=\mathcal{L}_{CE}+2.5\mathcal{L}_{spatial}+0.25\mathcal{L}_{circle}+0.5\mathcal{L}_{direction}$,spatial 对四槽软 argmax 做 SmoothL1,circle 惩罚偏离单位圆,direction 是带 $r_{norm}\ge 1.05$ 门控的余弦距离。第四步,评估:直接 PBD 解码器一次前向出六槽,角度 MAE 用周期距离 $d=\min(|\hat{\theta}-\theta|\bmod 180°,\ 180°-|\hat{\theta}-\theta|\bmod 180°)$,检查点按验证集 rotIoU 选取。
技术新颖性
技术新颖性体现在四个层面。其一,这是 PBD 接口的第一个旋转框扩展:原版 LocateAnything 只覆盖四坐标水平框,本文证明该接口能承载六槽几何,且槽位扩展的延迟开销仅 1.075 倍。其二,表示设计:前四个槽从角点改为中心+尺寸(双角度项必须围绕框中心定义),两个全新槽 $(\sin 2\theta,\cos 2\theta)$ 借鉴遥感检测文献处理角度不连续的思路,但将其嵌入坐标 token 分类框架而非回归头。其三,辅助损失的细节设计:circle 损失约束预测对落在单位圆上,direction 损失用门控屏蔽近方形框的朝向梯度噪声——作者甚至诚实报告了这个门控在 4000×2250 非方形图像上的设计偏差(实际筛的是接近 16:9 的框而非物理方形框),并用控制变量的重训练证明修正无益(0.3008 对 0.3124)。其四,方法论层面的可复用贡献:乱序对照、可见性/泄漏探针、往返误差独立度量组成一套诊断协议,能暴露 loss 曲线无法显示的静默失败,适用于任何块并行解码扩展的验证。
实验结果
主实验在 AVVG 完整测试集(6139 条、120 张图)上进行,检查点选择与测试集隔离,每模型三个种子。零样本基线 rotIoU 仅 0.1253,OBB-PBD 达 0.303±0.012,相对提升约 142%;aabbIoU 从 0.1512 升至 0.334±0.012;Acc@0.75 从 3.3% 跃至 22.0±0.8%;角度 MAE 9.98±0.34°;解码率 99.9%。GT 包络参考 rotIoU 为 0.6037,提示仍有空间。三步分解最有信息量:适应+解码路径改变贡献 +0.125±0.002;纯格式扩展 ΔrotIoU 在三个种子中 CI 均含零,块扩容本身无增益;学习朝向贡献 +0.055±0.008(相对对照臂提升 18.7–23.7%,各种子 CI 均排除零)。图像乱序诊断:乱序后 rotIoU 仅剩 0.006,为正常的 1/46–1/51;残差 0.0032–0.0034 与无模型位置先验(0.0038)同量级,证明提升来自看图而非提示统计。延迟:六槽 329.82ms 对四槽 306.87ms(1.075 倍),比自回归 568.65ms 快 1.72 倍。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 航空车辆视觉定位(AVVG,6139 条记录) | rotIoU | 0.303 ± 0.012(三种子均值±标准差) | 0.1253(零样本 LocateAnything-3B,上游 generate() 路径) | +0.178±0.012,约 142% 相对提升;各种子图像聚类 95% CI 均完全高于基线区间 |
| 航空车辆视觉定位(AVVG) | aabbIoU | 0.334 ± 0.012 | 0.1512(零样本基线) | +0.183±0.012;配对逐记录差值最小下界 +0.155 |
| 航空车辆视觉定位(AVVG) | Acc@0.75 / Acc@0.50 | 22.0 ± 0.8% / 37.1 ± 1.5% | 3.3% / 15.1% | Acc@0.75 提升 18.7 个百分点(约 6.7 倍) |
| 朝向学习效应(对照六槽 HBB-envelope 臂) | ΔrotIoU(配对逐记录差) | +0.055 ± 0.008(学习旋转框而非轴对齐包络) | 匹配对照臂(同数据/解码器/预算,但目标是包络) | 相对对照臂自身 rotIoU 提升 18.7–23.7%;三个种子的 95% CI 均排除零 |
| 块格式扩展效应(四槽 HBB-PBD → 六槽包络臂) | ΔrotIoU | −0.002 ± 0.003(六槽学包络 vs 四槽学包络) | 四槽 HBB-PBD 臂 | 无增益:三个种子 CI 均含零(−0.005 到 +0.000) |
| 单样本推理延迟(batch=1,60 个测试样本) | 中位/均值延迟 | 329.82 ms(六槽并行,一次前向) | 568.65 ms(自回归解码同样六个几何 token) | 并行快 1.72 倍;相比原四槽块(306.87 ms)仅 1.075 倍开销 |
局限与改进
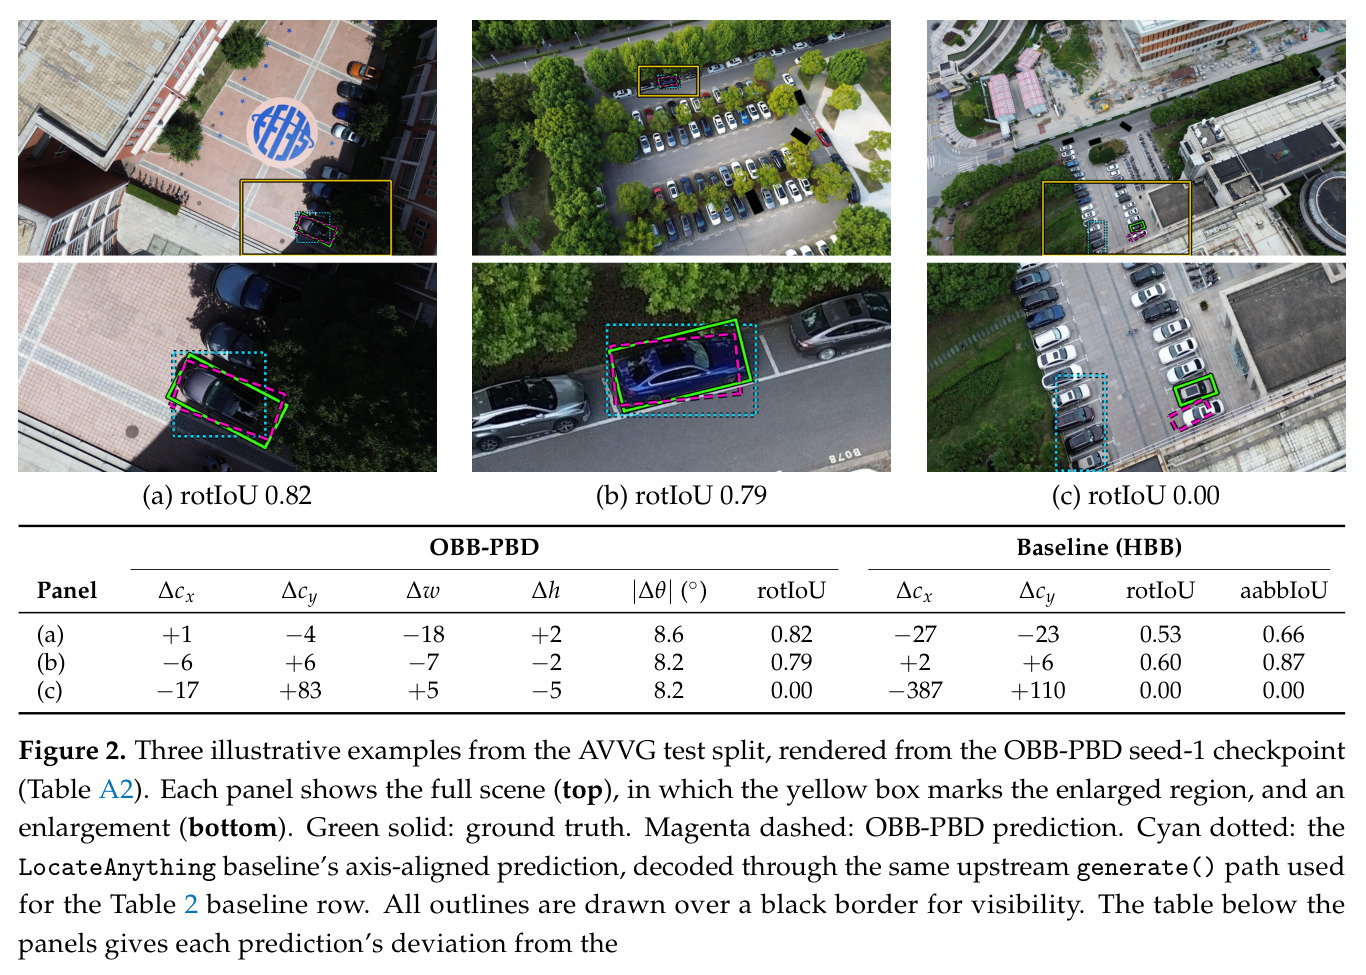
作者承认四点局限:结果仅限已验证的 AVVG/UAV 设定,不支撑跨数据集、传感器、尺度或标注格式的泛化;密集场景中的指代失败仍是主要错误模式(图 2c 中两模型都把框放到相邻车上),且提示含“the cheapest car”这类无法从几何解决的主观属性;未与 SATGround 等联合回归架构做同协议对比,不声称优于联合回归;角度 MAE 是全体成功解码样本的聚合,包含方向损失梯度为零($r_{norm}<1.05$)的样本,不能当作朝向质量诊断。我补充观察:绝对性能仍低,rotIoU 0.303 距 GT 包络参考 0.6037 差近一半,Acc@0.75 仅 22%;主表基线是跨路径比较(基线走 generate()),适应与路径两因素未分离;direction 门控偏差只跑了单个种子对照(0.3008 vs 0.3124),无法排除随机性;HBB-PBD 臂训练集少 10.3%(20182 对 22495 条),存在数据量混杂;数据集仅 495 张 DJI 图像,外部效度有限。
独立分析的弱点
弱点一:瓶颈在“指代”而非“几何”。图 2c 显示模型能把形状良好、角度误差仅 8.2° 的框放到错误的车上,改进方向是引入关系推理模块或对比式负样本训练,学会区分相邻相似目标。弱点二:direction 损失门控失真,$r_{norm}$ 是图像归一化比值而非物理长宽比,在 4000×2250 图像上实际筛出的是接近 16:9 的框,朝向梯度分配与设计意图不符,应改用 $w/h$ 并做多种子等预算消融。弱点三:格式扩展无收益且 aabbIoU 略降——四槽到六槽 ΔrotIoU CI 含零,OBB-PBD 的 aabbIoU 比包络对照低 0.010±0.010,可探索保留角点+两个角度槽等其他槽位设计。弱点四:损失权重 2.5/0.25/0.5 未经系统消融,五 epoch 预算固定,作者自己也列为待验证项。弱点五:与 GeoChat/GeoGround/SATGround 无可比数字,社区难以判断该路线的相对竞争力,至少可在同一测试集上跑一个公开基线做参照。
未来方向
作者提出的两个直接方向:一是对表 1 的损失权重做多 seed、等预算的系统消融,检验当前 5 epoch 配置是否最优;二是与 SATGround 类定位 token/MLP 联合回归架构做同骨干、同数据、同评估协议的匹配对比,量化坐标 token 解码与专用回归头在精度、解码成功率和推理成本上的差异。基于本文成果可延伸的方向:把已验证的诊断协议(乱序对照+可见性/泄漏探针+往返误差度量)作为标准工具推广到其他块并行扩展,例如掩码输出、多框输出、关键点输出;扩展到 AVVG 之外的遥感设定(卫星影像、不同传感器、不同尺度与标注格式);针对指代失败引入更强的关系推理或指代消解机制,缩小与 GT 包络参考 0.6037 的差距;按门控子集分层报告角度 MAE,使朝向质量可诊断;以及探索六槽块与旋转框后处理(如旋转 NMS)的联合优化。作者已承诺开源代码、检查点与上游缺陷的统一 diff,这些延伸的工程基础是现成的。
复现评估
复现条件相当充分。数据与模型:AVVG 来自公开的 RefGeo 集合,主干 LocateAnything-3B 公开,作者承诺发布完整代码、评估协议、三个种子的检查点(github.com/ce-dric/OBB-PBD),并附五个上游缺陷的统一源码 diff 和容器包清单(Python 3.11.10、PyTorch 2.5.1+cu121、Transformers 4.57.1)。算力:三块 RTX 6000 Ada(48GB),LoRA rank 16 只微调适配器、最后六个视觉块和投影器,5 epoch,全局 batch 12——24GB 消费级卡可能需减 batch 加大梯度累积。评估协议描述详尽:图像聚类 bootstrap 10000 次重采样、检查点选择与测试隔离、附录给出每个种子的完整数字与 95% CI。难度中等偏上:开源后复现主结果不难,但必须注意五个上游缺陷的修复(尤其 U5),否则会遭遇 loss 正常下降却什么都没学到的静默失败。作者完整披露使用 Claude Code、Codex、Gemini 辅助实现与写作。
论文图表
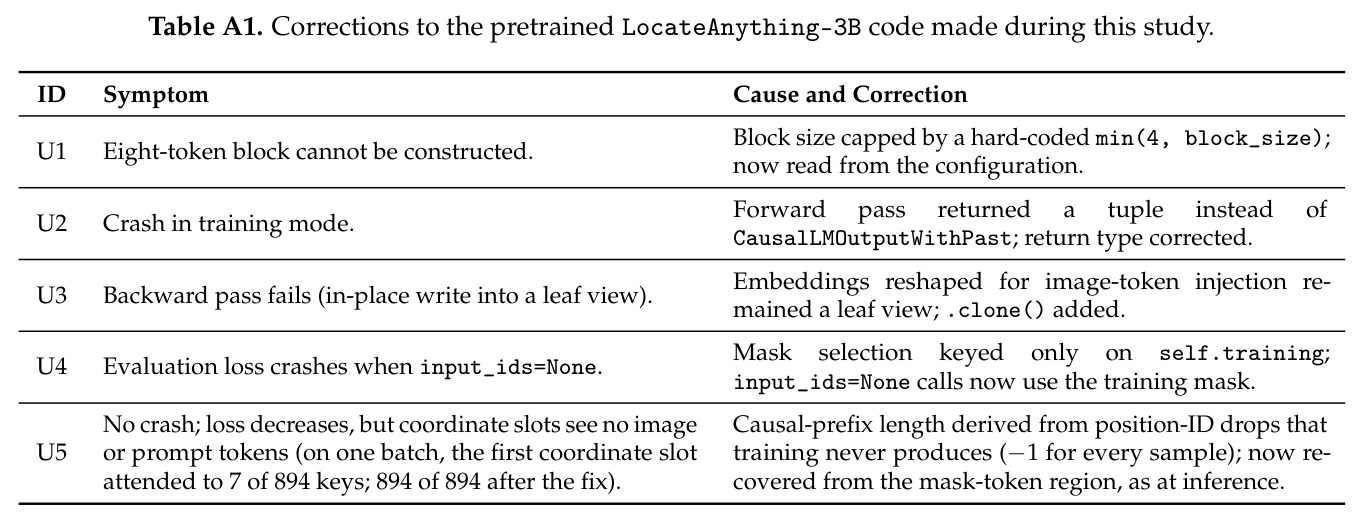
五个上游缺陷的修复清单:U1 块大小被硬编码 min(4, block_size) 封顶导致八 token 块无法构造;U2 训练前向返回元组而非 CausalLMOutputWithPast;U3 图像 token 注入的 embedding 是叶子视图导致反向传播原地写失败;U4 input_ids=None 时评估损失崩溃;U5 因果前缀长度从位置 ID 丢弃模式推导(每个样本都是 −1),导致坐标槽看不到图像和提示(修复前首槽注意力 7/894,修复后 894/894)——唯一的静默缺陷,其余四个都会显式崩溃。
本文“验证即方法”理念的直接体现:U5 是 loss 曲线无法发现的静默失败实例,对任何想在此主干上做微调或块扩展的后续工作都是必读的坑清单。
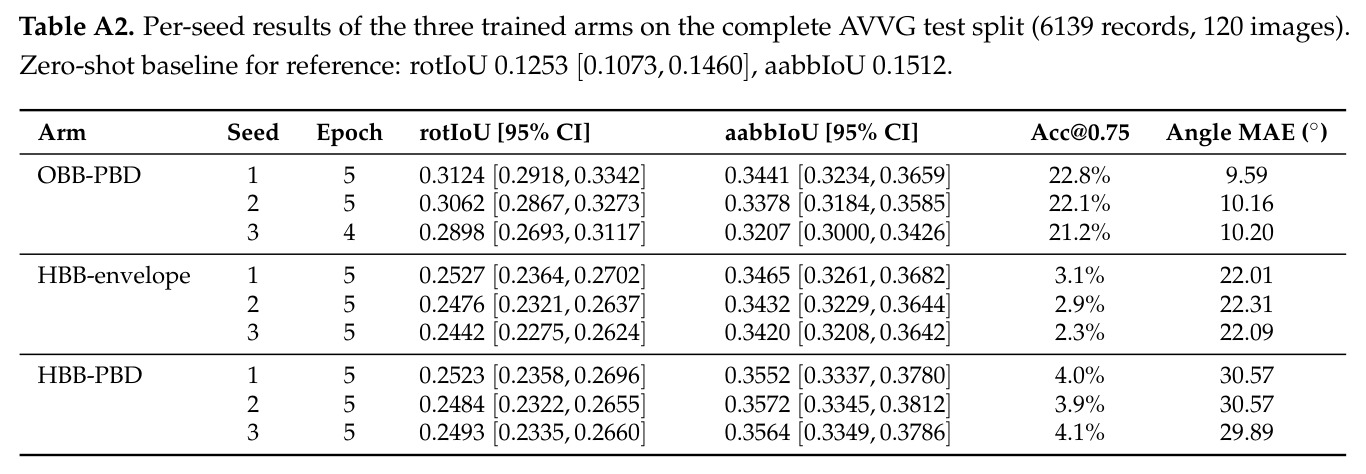
三个训练臂(OBB-PBD、HBB-envelope、HBB-PBD)每个种子的完整结果,含所选 epoch、rotIoU/aabbIoU 的 95% CI、Acc@0.75 和角度 MAE。例如 OBB-PBD 三个种子 rotIoU 分别为 0.3124、0.3062、0.2898(种子 3 选第 4 epoch),HBB-envelope 约 0.2442–0.2527(Acc@0.75 仅 2.3–3.1%),HBB-PBD 约 0.2484–0.2523。零样本基线参考:rotIoU 0.1253。
主表均值背后的原始数据:验证各种子间的一致性、CI 是否排除零、以及 HBB-envelope 臂 Acc@0.75 反而极低(2-4%)等细节,是核查分解结论稳健性的依据。
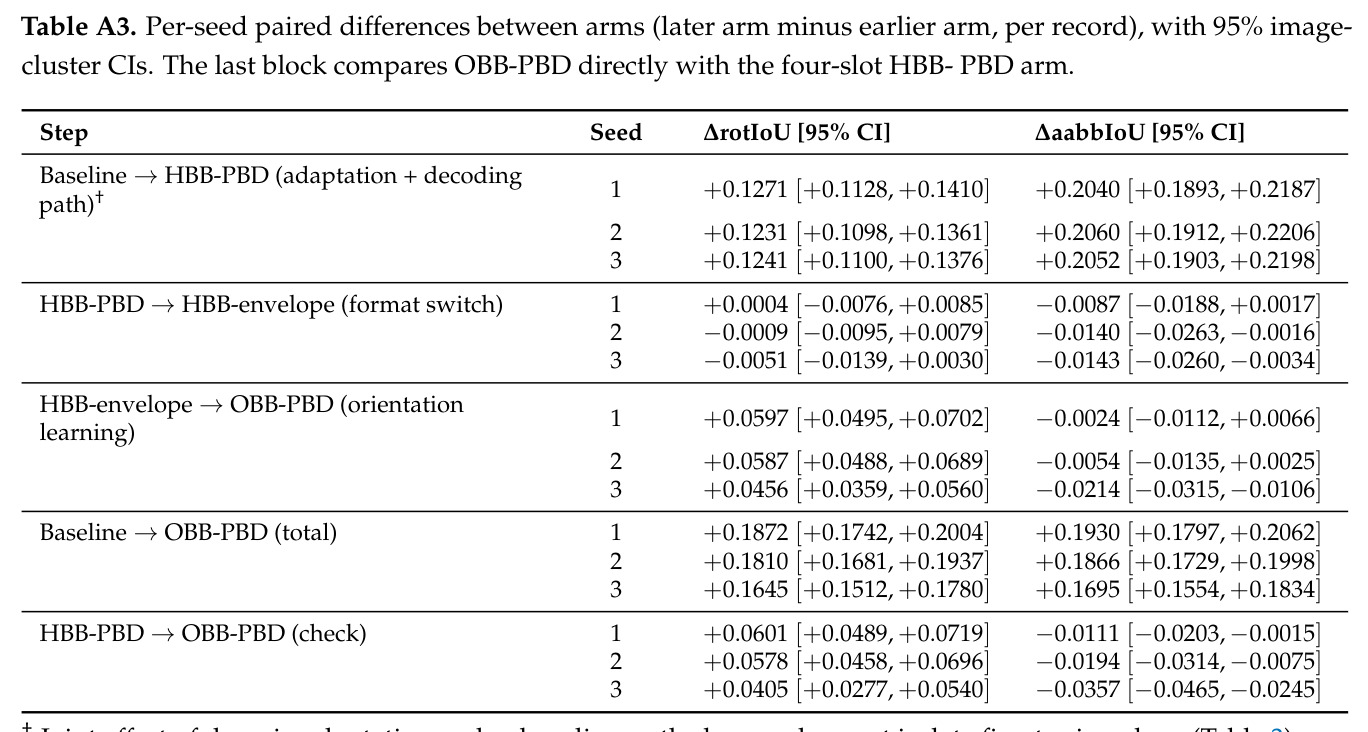
各臂之间逐记录配对差值的逐种子明细及 95% 图像聚类 CI:适应步三个种子 +0.1231 至 +0.1271 rotIoU(CI 均排除零);格式切换步 −0.0051 至 +0.0004(CI 均含零);朝向学习步 +0.0456 至 +0.0597(CI 均排除零,最小下界 +0.0359);OBB-PBD 对四槽 HBB-PBD 直接对比 +0.0405 至 +0.0601(CI 均排除零);总计 +0.1645 至 +0.1872。
支撑“每个效应在不同种子下都稳健”这一核心主张的最终证据:正文所有“CI 排除零/含零”的表述都能在此逐条核对,体现论文统计严谨性的完整链条。