约束解码再审视:格式、有效性与推理三类约束对大语言模型性能的影响 Constrained Decoding: Harmful or Beneficial? Revisiting Its Impact on LLM Performance
证明同等提示与格式下约束解码不降反升性能,并提出格式/有效性/推理三类约束分类
前置知识
文法约束解码(受约束解码)
在自回归生成的每一步,根据预定义文法或 JSON Schema 计算当前前缀下合法的 token 集合 $V_C(s_{<t})$,把非法 token 的 logit 置为 $-\infty$ 后重新归一化:$P_C(s_t|\cdot)=P_\theta(s_t|\cdot)\mathbb{1}[s_t\in V_C]/Z_t$,从而保证输出在语法上必然合法。代表工具包括 Outlines、XGrammar、guidance,以及本文使用的 Litelines(基于 outlines-core)。
本文全部理论与实验都围绕这一机制展开:必须先理解『逐步掩码+重归一化』这个操作,才能读懂三类约束的数学证明和因果消融实验的设计动机。
自回归生成与概率重归一化
LLM 按链式法则分解序列概率 $P_\theta(Y|x,R)=\prod_{t=1}^{T}P_\theta(s_t|x,R,s_{<t})$,每步输出词表上的分布。约束解码在每步乘以合法指示函数并除以配分函数 $Z_t$(合法 token 的概率质量之和)。本文证明其整体效果等价于序列级的缩放:沿正确答案路径累乘得到路径因子 $Z^*=\prod_t Z^*_t$,合法答案概率被放大 $1/Z^*$ 倍。
论文第 3 章定理的核心是把逐步掩码累乘成路径因子 $Z^*$,不熟悉链式分解与配分函数就无法理解『为何约束不会伤害正确答案、何时严格增益』的证明。
结构化输出与 JSON Schema
工业应用(函数调用、工具使用、数据抽取)要求 LLM 输出可解析的 JSON 等格式,常用 Pydantic/JSON Schema 定义字段与类型(如 reason: str、answer: int),约束解码据此限制生成。Tam et al. (2024) 发现让模型在 JSON 的 reason 字段内推理会显著掉分,引发了『格式税』之争,dottxt 与 Lee et al. (2026) 则质疑掉分来自提示层面。
本文要回应的核心争议正是『JSON 内推理掉分是否由约束解码本身造成』,文中三种解码策略(JSON、NL-to-Format、InWriting)都以 Schema 为载体,Schema 字段设计直接决定约束类型。
思维链与推理轨迹
思维链(CoT)让模型在给出最终答案前先生成中间推理文本,这段中间内容即推理轨迹 $R$。zero-shot CoT(『Let's think step by step』,Kojima et al. 2022)是最经典的提示技巧。本文把约束对象从最终答案扩展到推理轨迹,分析约束如何改变 $(R,Y)$ 推理-答案对的联合分布。
推理约束(RC)的收益完全取决于它强制的轨迹是否 beneficial:理解 CoT 与轨迹的概念,才能解读 Table 14/15 中 RC 在 GSM8K 上涨分、在 AIME2026 上对 Qwen3.5-4B 反降 6.6% 的正负混合结果。
研究动机
大模型在函数调用、工具使用与数据抽取等工业场景中必须输出可解析的结构化格式,文法约束解码(Outlines、XGrammar、guidance 等)通过逐步掩码非法 token 来保证这一点。但 Tam et al. (2024, EMNLP) 报告让模型在 JSON 的 reason 字段内推理会使准确率大幅下降;Banerjee et al. (2025) 从表达力角度证明不含推理空间的有限输出文法会削弱模型;Reddy et al. (2026) 把退化归因于约束生成造成的分布偏移。由此催生了一系列『先自由推理、再格式化』的补救方案:给 JSON 加 reason 字段、两步 NL-to-Format、以及用触发 token 切换模式的 InWriting。然而 dottxt (2024) 与 Lee et al. (2026) 提出异议,认为掉分主要来自提示层面或受约束/无约束设置间的 unfair comparison。各方测量口径不一,掉分的真正来源——解码器级掩码还是提示与格式差异——始终没有被严格分离。
本文的目标是本文要系统回答『约束解码究竟有害还是有益』。具体目标有四:其一,建立格式约束(FC)、有效性约束(VC)、推理约束(RC)三分类,刻画每类约束从输出空间中移除了什么;其二,在『提示与期望输出格式完全一致』的 apples-to-apples 条件下,给出约束解码不损害性能的理论证明,并进一步给出严格提升的条件;其三,在 4 个模型家族共 11 个开源模型(1.7B-32B,Qwen/Qwen3.5、Gemma2、Llama3、SmolLM3)上,于 GSM8K、LastLetter、LastLetter-Extended 与 AIME2026 基准上做因果消融,量化 FC/VC/RC 各自的收益;其四,比较 JSON、NL-to-Format、InWriting 三种 SOTA 解码策略的可解析率与 token 开销。
与已有工作不同的是,本文的独特切入是把『解码器级掩码』与『提示级格式指令』两种效应严格解耦:此前研究对比『JSON 内推理 vs 自由文本推理』,提示、格式、是否掩码三个变量同时变化;本文固定提示与期望格式,只切换是否施加掩码,从而分离出掩码的净效应,实证支持 Lee et al. (2026) 的提示归因。理论上,此前只有经验观察或表达力论证,本文首次给出非退化定理(假设 1:真值满足约束 $Y^*\in Y_C$ 时准确率不降)与严格增益条件(假设 2:路径上存在正概率非法 token 被剔除,即 $Z^*<1$)。此外,本文把约束解码从 JSON 拓展到纯文本答案生成,并把收益分解为 FC/VC/RC 三层分别计量,还以 IMDb 禁用标签实验初探约束作为内容过滤工具的可能性,这些都是既有工作未覆盖的角度。
核心方法
直觉上,掩码只是把非法 token 的概率质量重新分配给合法 token:若正确答案本身合法,它只会被相对放大、不会被削弱。技术上,设提示为 $x$、固定推理轨迹为 $R$、真值为 $Y^*$、约束 $C$ 的合法集为 $Y_C\subseteq Y$。自回归分解下每步执行掩码加重归一化:$P_C(s_t|x,R,s_{<t})=P_\theta(s_t|x,R,s_{<t})\mathbb{1}[s_t\in V_C(s_{<t})]/Z_t$,其中 $Z_t=\sum_{s'_t\in V_C}P_\theta(s'_t|x,R,s_{<t})$;整条序列可写成 $P_C(Y|x,R)=P_\theta(Y|x,R)\mathbb{1}[Y\in Y_C]/\prod_{t=1}^{T}Z_t$。在假设 1($Y^*\in Y_C$)下期望准确率为 $P_\theta(Y^*|x,R)/Z^*\ge P_\theta(Y^*|x,R)$;若再满足假设 2(真值路径上有正概率非法 token 被掩,$Z^*<1$)则严格提升。实验上用 Litelines(基于 outlines-core)在 4 个家族共 11 个开源模型上对 JSON、NL-to-Format、InWriting 三种策略做受控消融。
核心创新是三层约束分类学与『约束=概率质量再分配』的视角。FC 只保证输出可解析(answer 字段设为 str),当模型本就遵循格式时几乎没有增益;VC 把任务结构中关于答案子空间的先验编码进 Schema——GSM8K 答案限定非负整数、AIME2026 限定 0-999 整数、LastLetter 限定恰 4/8 个字母——相当于给掩码注入语义信息,使路径因子 $Z^*$ 更小、增益更大且近乎零成本;RC 则把期望的推理模式(如强制以 Let's think step by step 开头)写进约束,其效果取决于被强制轨迹是否 beneficial。理论上对应三案例:完全排除正确推理-答案对则严格有害(期望正确率为零)、oracle 约束严格有益、部分保留则效果不确定。这与既有工作『约束必然伤害推理』或『加个 reason 字段即可修复』的粗粒度结论有本质区别。
方法步骤详情
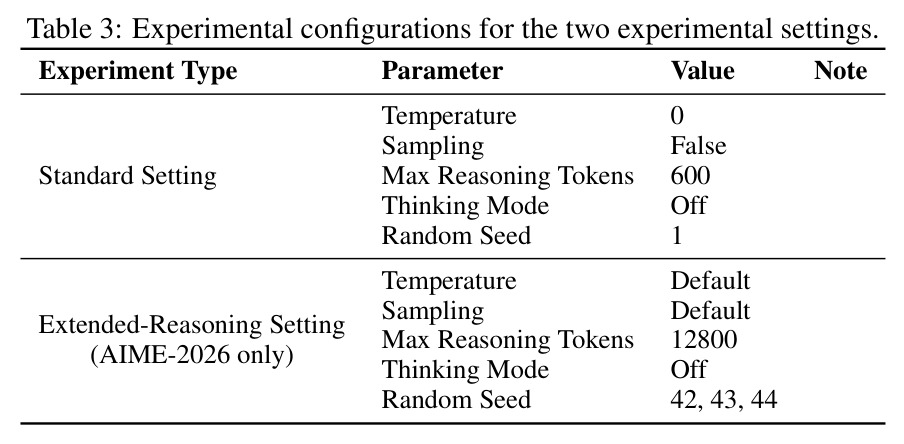
实验流程分五步。(1) 用 Pydantic 定义 Schema:JSON 策略含 reason:str 与 answer 字段;NL-to-Format 与 InWriting 只含 answer。(2) 配置三种解码策略:JSON 全程约束(allow_preamble=False);NL-to-Format 第一步自由推理、第二步由 Qwen3-32B 抽取器格式化答案;InWriting 单次生成、以 EOS/PAD 为触发 token 切换到约束解码(allow_preamble=True、max_preamble_tokens=600)。(3) 设置约束层级:FC 时 answer:str 任意;VC 按任务收紧(GSM8K 非负整数、AIME2026 0-999 整数、LastLetter 恰 4/8 个字母);RC 强制以 Let's think step by step 开头。(4) 每任务 3 个任务描述变体 ×(JSON 1 个、其余 3 个)格式变体,temperature=0、贪婪解码、推理上限 600 token;AIME2026 上限 12800 token 并用种子 42/43/44。(5) 计算准确率(精确匹配)、解析率、格式增益、有效性增益与推理增益五类指标。
技术新颖性
技术新颖性体现在四点。其一,理论结果此前缺失:现有讨论多为经验观察(Tam et al.)或表达力论证(Banerjee et al.),本文首次给出非退化定理与严格增益条件,并把掩码效果归结为对正确答案 $1/Z^*$ 的概率放大,还给出了 RC 三案例的定性分析框架。其二,测量设计新颖:通过固定提示与期望格式的因果消融,把文献中混杂的提示效应与掩码效应分开。其三,约束对象泛化:证明文法掩码同样适用于纯文本答案生成(NL-to-Format 第二步的 plain-text 生成),突破『约束只用于 JSON』的刻板印象,且 few-shot 实验显示 few-shot 只改善格式遵循、不改善推理。其四,应用拓展:IMDb 情感分类的禁词实验表明,把 Positive/Negative 从生成空间剔除、强制 Bad/Critical 等近义表达时,模型仍保持 76.0-85.8 的准确率,展示 VC 作为『事后一致性 enforcement』的潜力。
实验结果
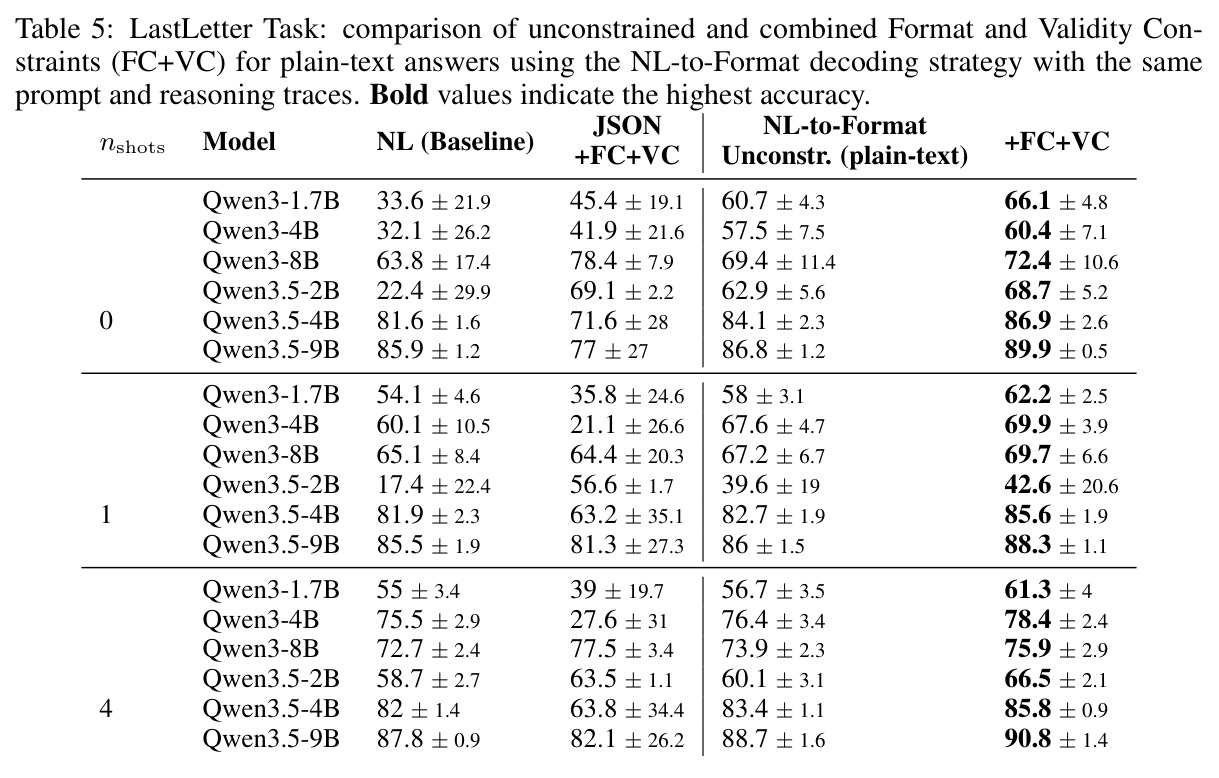
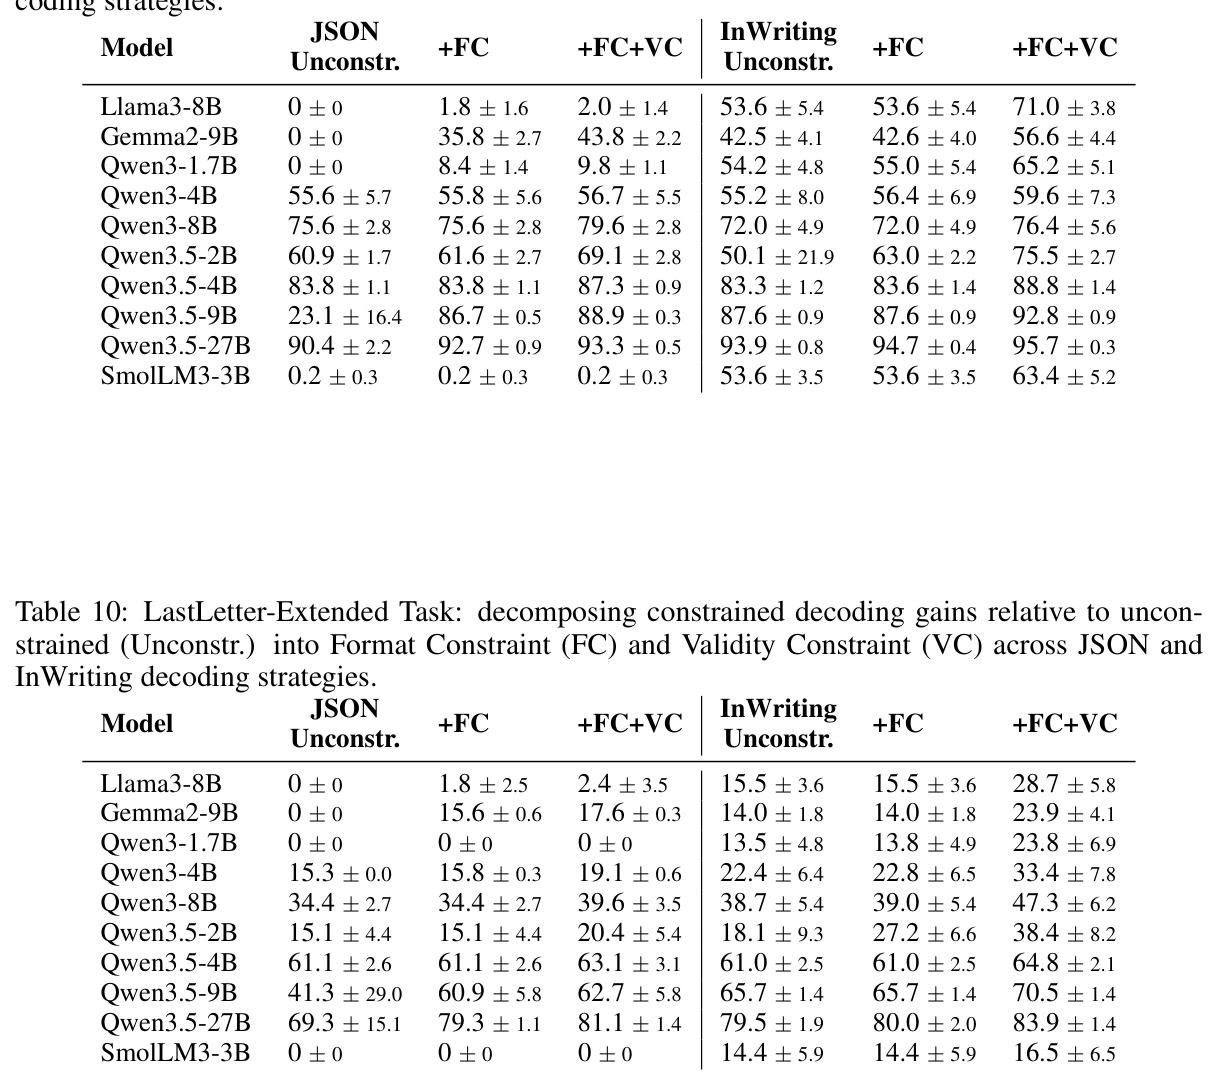
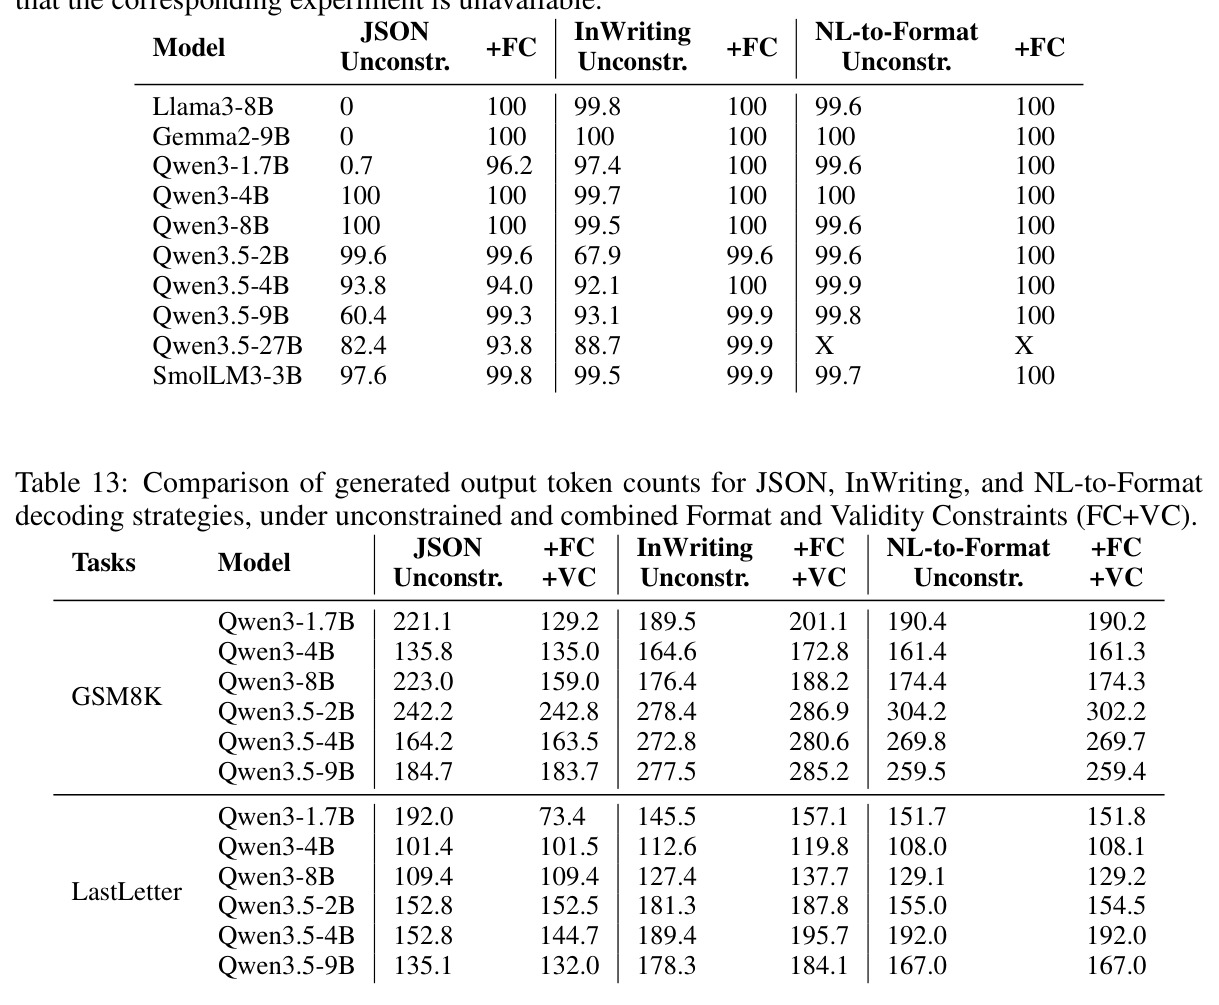
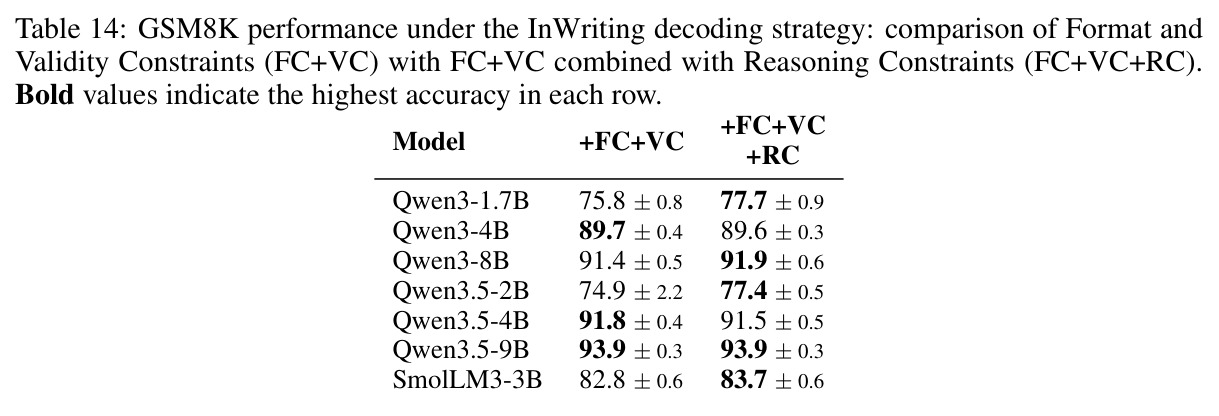
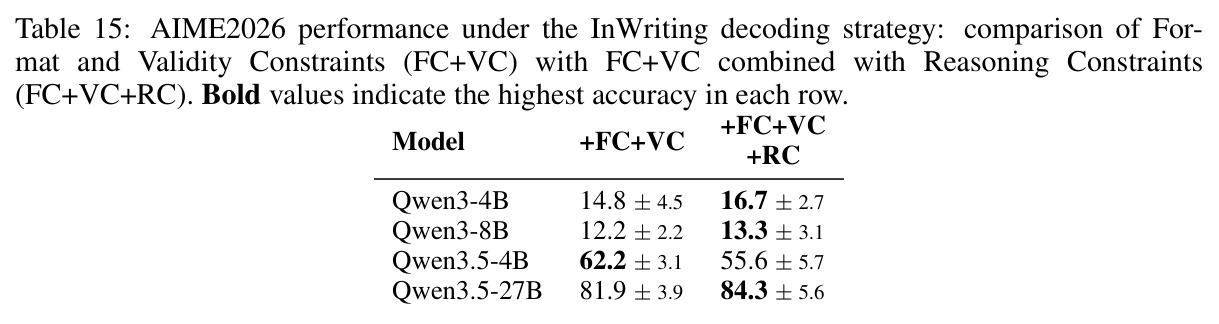
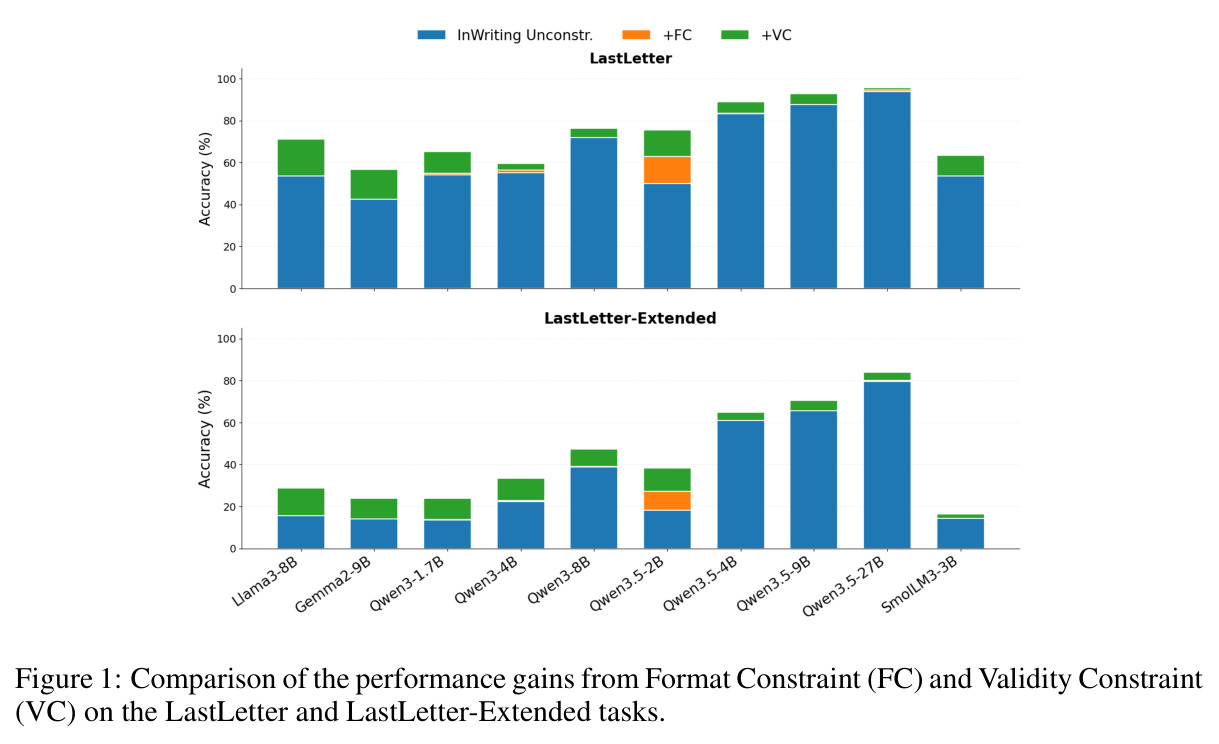
核心发现有五。其一,掉分主要来自提示而非掩码:固定提示与格式后 +FC+VC 一致匹配或超过无约束,如 LastLetter 上 Qwen3.5-9B NL-to-Format 从 86.8±1.2 升至 89.9±0.5,Qwen3.5-2B InWriting 从 50.1 升至 75.5;文献中反复出现的 JSON 掉分(Qwen3.5-9B JSON+FC+VC 仅 77 对 NL 基线 85.9)换成 NL-to-Format/InWriting 后消失,支持提示级归因。其二,VC 增益最稳定、最高达 17.4 个百分点(Figure 1、Table 9/10):Qwen3.5-9B JSON 23.1→86.7(+FC)→88.9(+FC+VC),而 FC 在模型已守格式时几乎无增益(Qwen3-8B JSON 三档均 75.6)。其三,解析率:Llama3-8B/Gemma2-9B/Qwen3-1.7B 无约束 JSON 解析率仅 0-28.5%,加 FC 后升至 96.2-100%,对 27B 级模型依然成立。其四,RC 双面性:GSM8K 上多数提升(Qwen3-1.7B 75.8→77.7、SmolLM3-3B 82.8→83.7),但 AIME2026 上 Qwen3.5-4B 反降 6.6%(62.2→55.6),Qwen3.5-27B 却升至 84.3。其五,成本与鲁棒性:InWriting 比 NL-to-Format 少一次 LLM 调用、仅增不到 15 个 token;IMDb 禁词实验中替代词约束仍保 76.0-85.8 准确率。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LastLetter(NL-to-Format,Qwen3.5-9B,同提示同推理轨迹) | 准确率 (%) | 89.9 ± 0.5(+FC+VC 约束纯文本生成) | 86.8 ± 1.2(无约束纯文本生成) | +3.1 |
| LastLetter(JSON,Qwen3.5-9B) | 准确率 (%) | 88.9 ± 0.3(+FC+VC) | 23.1 ± 16.4(无约束) | +65.8 |
| LastLetter-Extended(InWriting,Qwen3.5-27B) | 准确率 (%) | 83.9 ± 1.4(+FC+VC) | 79.5 ± 1.9(无约束) | +4.4 |
| GSM8K(InWriting,Qwen3-1.7B) | 准确率 (%) | 77.7 ± 0.9(+FC+VC+RC) | 75.8 ± 0.8(+FC+VC) | +1.9 |
| AIME2026(InWriting,Qwen3.5-27B) | 准确率 (%) | 84.3 ± 5.6(+FC+VC+RC) | 81.9 ± 3.9(+FC+VC) | +2.4(但 Qwen3.5-4B 反降 6.6:62.2→55.6) |
| GSM8K JSON 可解析率(Gemma2-9B) | 解析率 (%) | 100(+FC) | 0.2(无约束) | +99.8 |
| IMDb 情感分类(Qwen3.5-4B,禁用标签) | 准确率 (%) | 94.8(标签约束解码) | 94.6(无约束基线) | +0.2(替代词约束降至 85.8) |
局限与改进
作者承认的局限:VC 实验范围窄,主要在 LastLetter/LastLetter-Extended 与 IMDb 初步实验上验证,化学分子有效性等领域仅作展望;RC 的有益轨迹识别依赖先验甚至 oracle 知识,实验只是用既有模式证明可行性,没有给出寻找有益约束的实用指南;JSON Schema 较简单,需要长推理+复杂输出格式的任务未覆盖。我的补充观察:VC 的增益本质是把答案空间砍小(恰 4/8 个字母、整数区间),这依赖任务先验可形式化,开放生成任务难以复制;评估把解析失败一律计为错误,附录 A.4.3 甚至把 Markdown 代码围栏包裹的合法 JSON 和『先自由文本、结尾给 JSON』的输出判为失败,虽然与约束语义自洽,但会放大 FC/VC 的表观准确率收益,若采用宽容抽取口径增益会缩水;理论部分固定推理轨迹 $R$、只约束答案生成,未建模约束对推理过程本身的反馈影响;标准设置 temperature=0 且多数任务单种子,方差信息有限;LastLetter 类任务偏合成、简单,AIME 样本量也小。
独立分析的弱点
独立分析四点弱点。(1) VC 的通用性存疑:它要求答案子空间能从任务结构中刻画,LastLetter 的『恰 4 个字母』与 AIME 的『0-999』是人为给定的强先验,换成开放式问答、摘要或代码生成便无从构造,改进方向是从少量演示中自动归纳答案空间(约束学习/Schema 挖掘)。(2) RC 实验太弱:只测了强制开头短语这一个约束,与理论上 oracle/部分保留的丰富框架不匹配,且 AIME 上 -6.6% 的翻车说明缺乏可操作的选约束方法,改进方向是先用过程奖励模型或轨迹打分筛选候选约束再施加。(3) 评估口径偏严:把围栏 JSON、自由文本后接 JSON 等事实上可抽取的输出判为失败,与 dottxt 批评的口径问题同源,改进方向是同时报告严格/宽容两套抽取口径,分离『格式增益』与『答案增益』。(4) 计算开销只给了 token 数:掩码需要在每步计算合法 token 集,开销随文法复杂度增长(Geng et al. 2025),但本文未实测延迟与吞吐,改进方向是补充端到端效率基准。
未来方向
作者明确提出的方向:把 VC 拓展到化学(强制合法分子结构)与内容过滤(禁止违禁词/模式)等更多领域;研究如何实践性地识别有益推理轨迹,使 RC 从可行性演示变成可用工具;考察需要大量推理+复杂输出格式的任务。基于本文成果可延伸的方向:自动约束合成——用小模型或规则从任务描述自动推导 VC Schema;把 token 级掩码与事后文本规整(单位归一化、大小写折叠等)做受控对比,厘清两者贡献;在工具调用与 Agent 场景验证三类约束,参数类型与取值域校验天然对应 VC;系统测量不同文法复杂度下的解码延迟与吞吐,补全效率画像;探索动态约束——依据题目内容在线收紧答案空间(如由题面推断答案位数或取值范围),进一步压小 $Z^*$;把 RC 与可验证奖励的 RL 训练结合,让模型内化有益轨迹而非依赖推理时强制。
复现评估
复现条件较好。代码随补充材料提交并承诺录用后公开;约束解码用开源 Litelines(基于 outlines-core),触发词机制只需 eos/pad token id,配置仅三行。数据集除 LastLetter-Extended 外均可从 HuggingFace 直接获取;LastLetter-Extended 用 names-dataset 库采样人名构造,作者描述了排除复合名(如 Juan Pablo)的细节,可复刻。模型全部开源:Qwen3-1.7B/4B/8B、Qwen3.5-2B/4B/9B/27B、Llama3-8B、Gemma2-9B、SmolLM3-3B 加抽取器 Qwen3-32B,均为纯推理负载。超参数完整(Table 3:temperature=0、贪婪解码、标准任务推理上限 600 token、AIME2026 上限 12800 token、种子 1 与 42/43/44),全部提示变体与 Schema 在附录 A.2 原文给出。总体难度中等:最大 32B 约需 80GB 级显存或量化,1.7B-9B 模型单张消费级 GPU 即可,主要成本是多策略×多提示变体的组合评估量。
论文图表
对比 NL few-shot 基线、JSON+FC+VC、NL-to-Format 无约束与 +FC+VC 四种设置。斜体为 Nguyen et al. (2026) 报告的数字。可见 JSON 设置即便加约束仍低于 NL 基线(Qwen3.5-9B:77 对 85.9),而同提示同轨迹的 NL-to-Format 上 +FC+VC 一致超过无约束(Qwen3.5-9B 86.8→89.9,Qwen3.5-2B 62.9→68.7)。
直接检验文献中『JSON 内推理掉分』的来源:掉分出现在换提示/换格式时而非加掩码时,是『同提示同格式下约束不降反升』主张的第一份 apples-to-apples 证据。
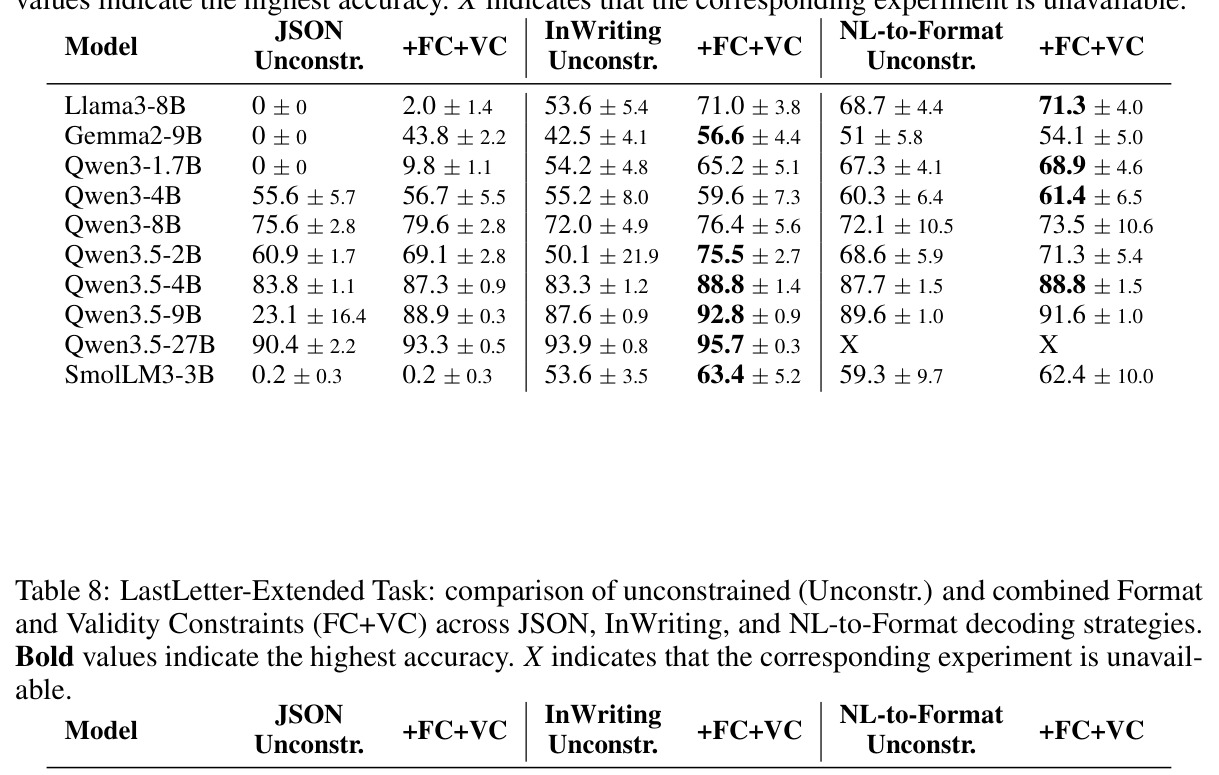
在共享同一自由推理轨迹的前提下,对比纯文本与 JSON 两种答案格式在无约束与 +FC+VC 下的准确率。JSON 在所有模型上持平或更好:Qwen3.5-9B 纯文本 86.8→89.9,JSON 89.6→91.6;Qwen3.5-2B 纯文本 62.9→68.7,JSON 68.6→71.3。
说明 JSON 作为信息抽取接口并不比纯文本差,为后续实验统一采用 JSON 目标格式提供依据,也反驳『JSON 本身伤害推理』的印象。
IMDb 情感分类三条件对比:无约束基线、仅允许 Positive/Negative 的标签约束、以及禁止原标签但允许 Bad/Critical/Good/Favorable 等近义替代词的替代词约束。Qwen3.5-4B 三者分别为 94.6/94.8/85.8,Qwen3-1.7B 为 81.6/81.6/76.0。
展示 VC 思想向内容过滤的初步外推:即使把标准标签从生成空间剔除,模型仍能借替代表达保持大部分正确性,是约束解码应用边界的探索性证据。
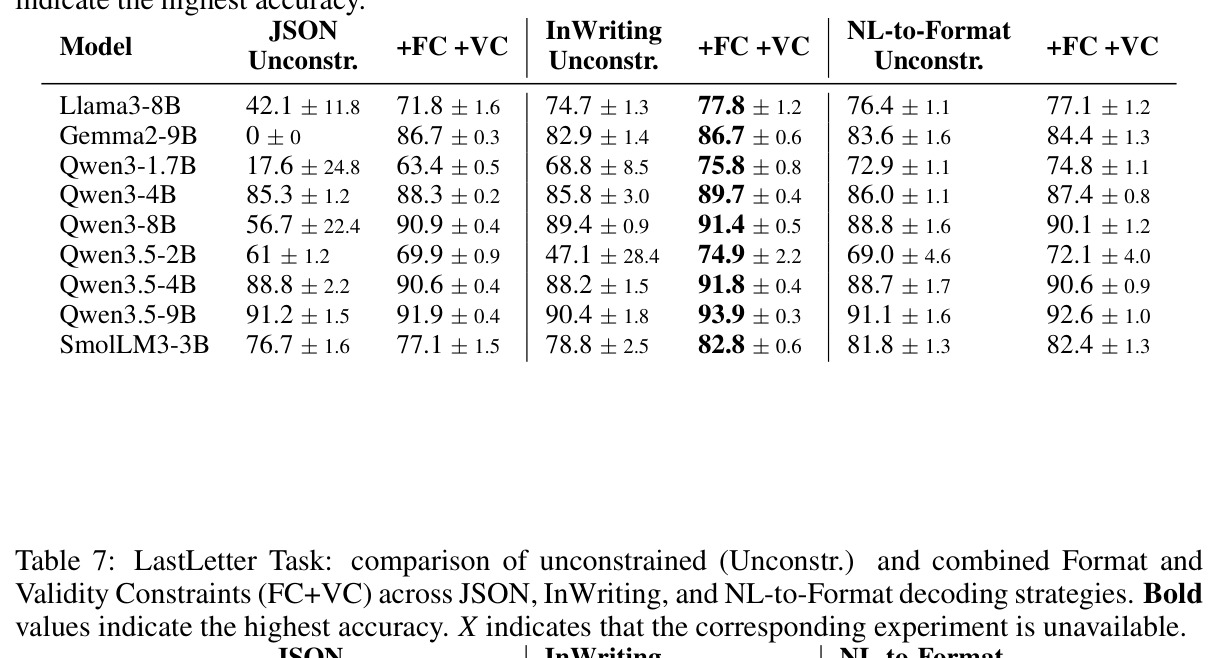
9 个模型在 GSM8K 上三种解码策略的无约束 vs +FC+VC 对比。无约束 JSON 波动极大(Gemma2-9B 为 0±0,Qwen3-1.7B 仅 17.6±24.8),而 +FC+VC 的 InWriting/NL-to-Format 稳定在 69.9-93.9 区间;如 Qwen3.5-9B InWriting 91.8→93.9。
主基准上的核心结论表:在数学推理任务上同样满足『固定提示与格式后,约束一致匹配或超过无约束』,且暴露无约束 JSON 的崩溃风险。
把约束增益分解为三档:无约束→+FC→+FC+VC。FC 单独的增益通常很小甚至为零(Qwen3-8B JSON 三档均 75.6),VC 的追加增益显著:Qwen3.5-2B InWriting 50.1→63.0→75.5,Qwen3.5-9B JSON 23.1→86.7→88.9。
这是 FC 与 VC 贡献的因果消融表,直接证明『格式保证』与『答案子空间先验』是两种性质不同的收益来源,是 Figure 1 的数据底稿。
GSM8K 可解析率:无约束 JSON 从 0.2(Gemma2-9B)、28.5(Qwen3-1.7B)、62.6(Qwen3-8B)到 98.6(Qwen3.5-4B)不等,加 FC 后全部升至 88.4-100;InWriting/NL-to-Format 无约束已达 63.1-99.8,加 FC 后达 99.6-100。
量化 FC 的本职收益——格式可解析性:即便 27B 级大模型,无约束 JSON 仍有不可忽略的解析失败率,约束提供不依赖模型规模的格式可靠性。
扩展任务可解析率:无约束 JSON 中 Llama3-8B/Gemma2-9B 为 0,Qwen3.5-9B 仅 60.4,加 FC 后升至 93.8-100;InWriting 无约束低至 67.9(Qwen3.5-2B),加 FC 后 99.6+;NL-to-Format 加 FC 后全部 100。
在更难任务上确认解析率结论,特别是 Qwen3.5-9B/27B 这类大模型无约束 JSON 解析率仅 60.4/82.4,说明格式可靠性不能靠模型规模保证。