能力相同,行为不同:MCP 与 CLI 接口下语言智能体的受控研究 Matched Capabilities, Different Behaviors: A Controlled Study of MCP and CLI Interfaces for Language Agents
同等能力下MCP与CLI表征显著改变智能体行为,DART只修表达不改决策,六设置全部提分
前置知识
MCP(Model Context Protocol,模型上下文协议)
一种把工具能力标准化呈现给模型的协议:每个能力被包装成一个命名工具,附带 JSON schema 定义的结构化参数,模型通过形如 {"name":"go","arguments":{"destination":"sofa 1"}} 的结构化调用发起请求,由运行时解码并分发执行。MCP 已成为现代智能体系统接入外部工具的主流方式之一,也催生了 MCP-Bench、MCPMark 等专门基准。
本文比较的一方就是 MCP 表征,理解其"命名工具 + 结构化参数"的呈现方式,是理解它和 CLI 在模型侧有何系统性差异的第一步。
CLI(命令行接口)
通过命令名、flag 和文本约定表达操作的方式,例如 bench alfworld go --destination 'sofa 1'。模型必须自行处理参数序列化、引号配对、多词参数拼接等表面细节,任何一个引号没闭合都会导致解析失败。InterCode、Terminal-Bench 等终端智能体研究均属此类接口。
CLI 的引号与序列化细节正是论文中"实现失败"的典型来源:Example S4 里点击 18''x18'' 规格按钮时撇号丢失导致命令失效,是贯穿全文的关键案例。
闭环交互与轨迹传播
语言智能体在有状态环境中循环执行"观察—决策—执行—反馈":每一步的决策都以公开交互历史 $h_t$ 和当前状态 $s_t$ 为条件。因此早期的一个局部差异会改变后续所有决策的条件上下文,使差异沿轨迹传播并放大,最终累积成不同的 token 成本、尝试次数和任务结局。
论文的核心论点是"接口表征是闭环决策环境的一部分"。没有闭环传播的概念,就无法理解为什么两种表面语法之间的差异会演变成 36.6 分的端点差距。
语义动作与契约匹配
语义动作是归一化二元组 $a=(u,v)$:$u$ 为操作名,$v$ 为完整的类型化参数元组。语义契约 $\mathcal{C}_t$ 规定当前状态下可用的操作、参数域 $V_u(s_t)$ 与原生执行绑定 $\Gamma_u$。两个表面响应只要解码出相同操作和等价参数,就记为语义等价 $a \equiv_{\text{sem}} a'$,与 JSON 字段顺序、空白、引号风格等表面差异无关。
这是全文"能力匹配"的基石:MCP 和 CLI 从同一契约渲染,解码后进入同一校验—编译—执行路径,行为差异才能干净地归因于表征本身而非能力差异。
析因实验(2×2×2 factorial design)
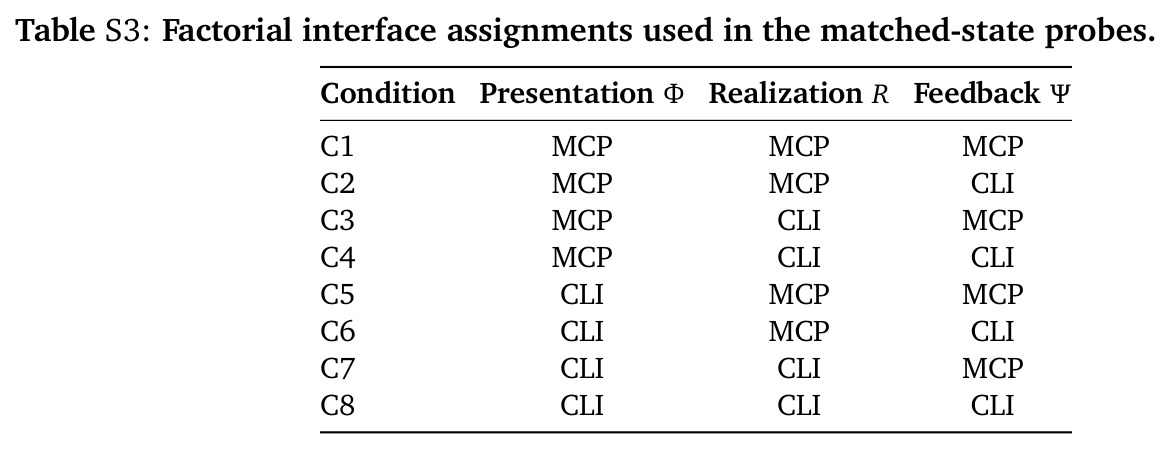
论文把接口形式化为三个模型侧组件:呈现 $\Phi$(能力如何展示给模型)、实现 $R=(\rho,D)$(响应语法与解码器)、反馈 $\Psi$(执行结果如何渲染回来)。每个组件取 MCP/CLI 两个水平,共 $2\times2\times2=8$ 种组合。组件 $k$ 的主效应 $\Delta_k$ 是固定其余组件、交换该组件时的平均对比;交互效应刻画组件间不可单独相加的耦合作用。
匹配状态探针与 Figure 3 的组件/交互效应完全建立在该设计上。不懂析因设计就看不懂论文如何把"接口效应"定位到具体组件。
首次关键分歧 $t^\star$
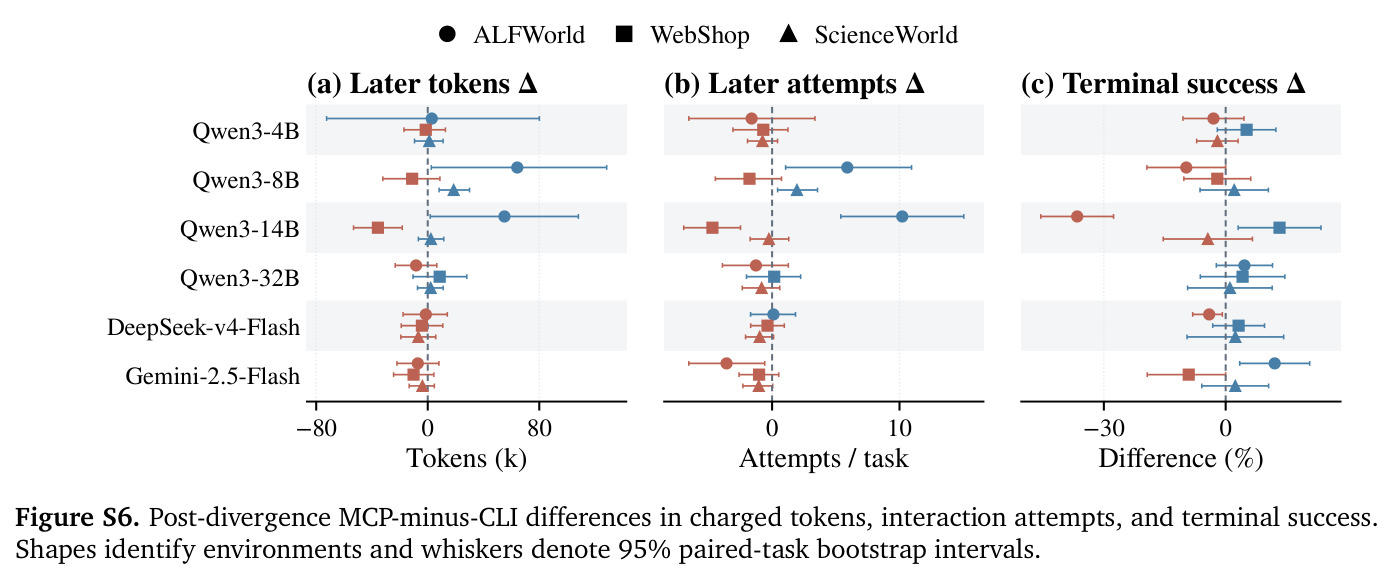
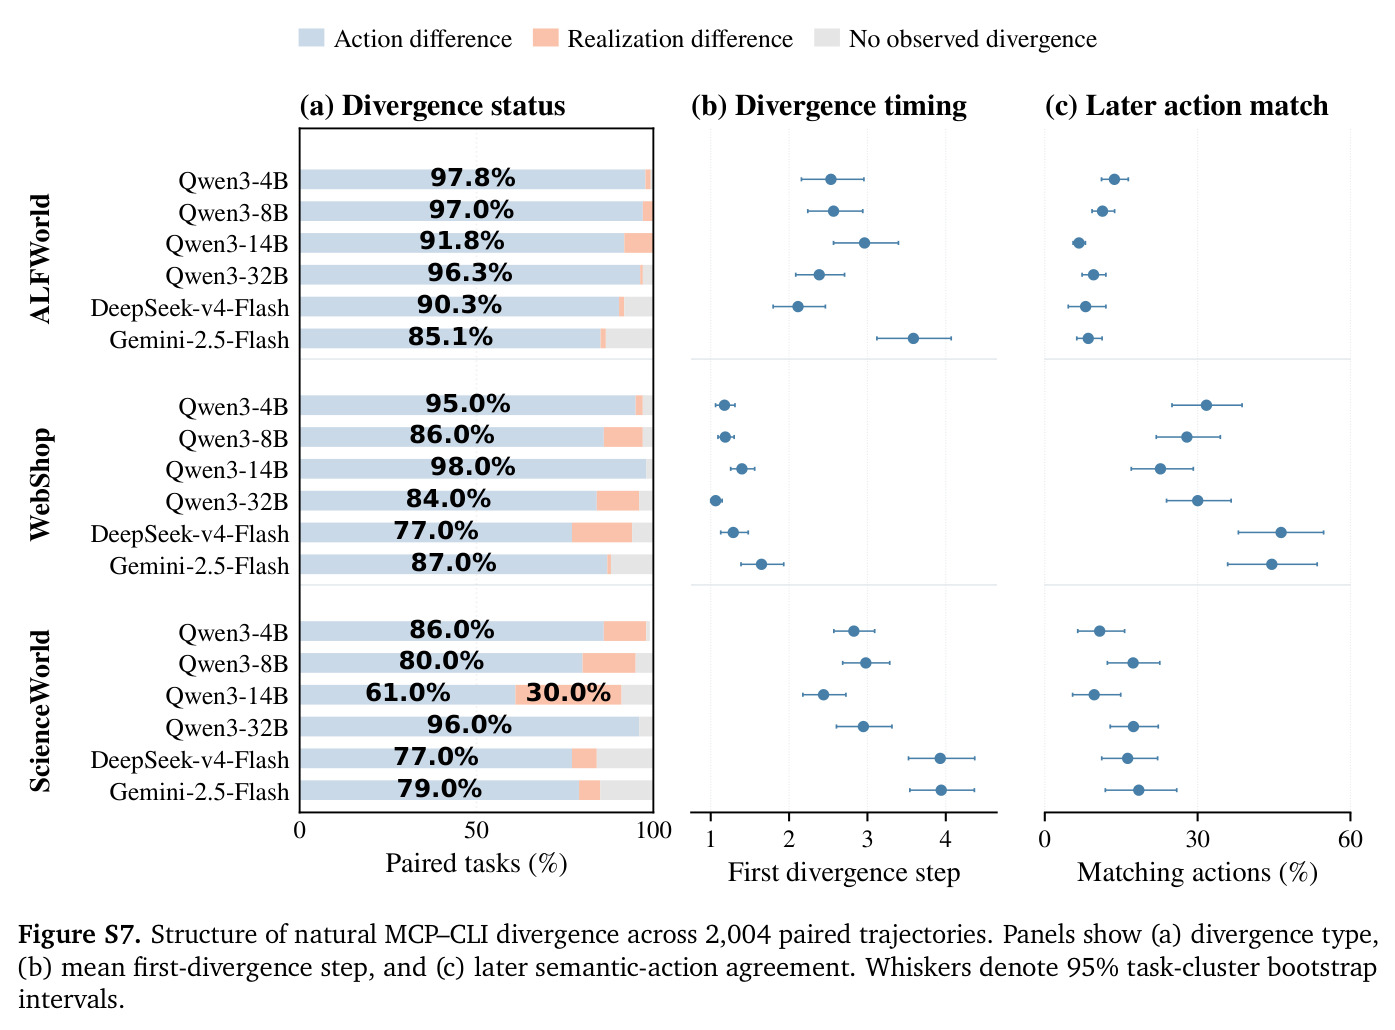
对每对 MCP–CLI 轨迹,先对齐由语义提议、失败阶段、执行结果、恢复状态构成的交互签名 $b_t$ 完全一致的最长公共前缀,其后第一步签名差异即 $t^\star=\min\{t \mid b^{\text{MCP}}_t \not\equiv b^{\text{CLI}}_t\}$。$t^\star$ 之前两条轨迹处于对齐状态可做匹配比较,之后各自在自己的历史与状态下演化。
轨迹传播分析、94.3% 的分歧率统计和 Figure S7 都围绕该量定义。它是论文把"局部归因"与"下游传播"分开的方法学枢纽。
研究动机
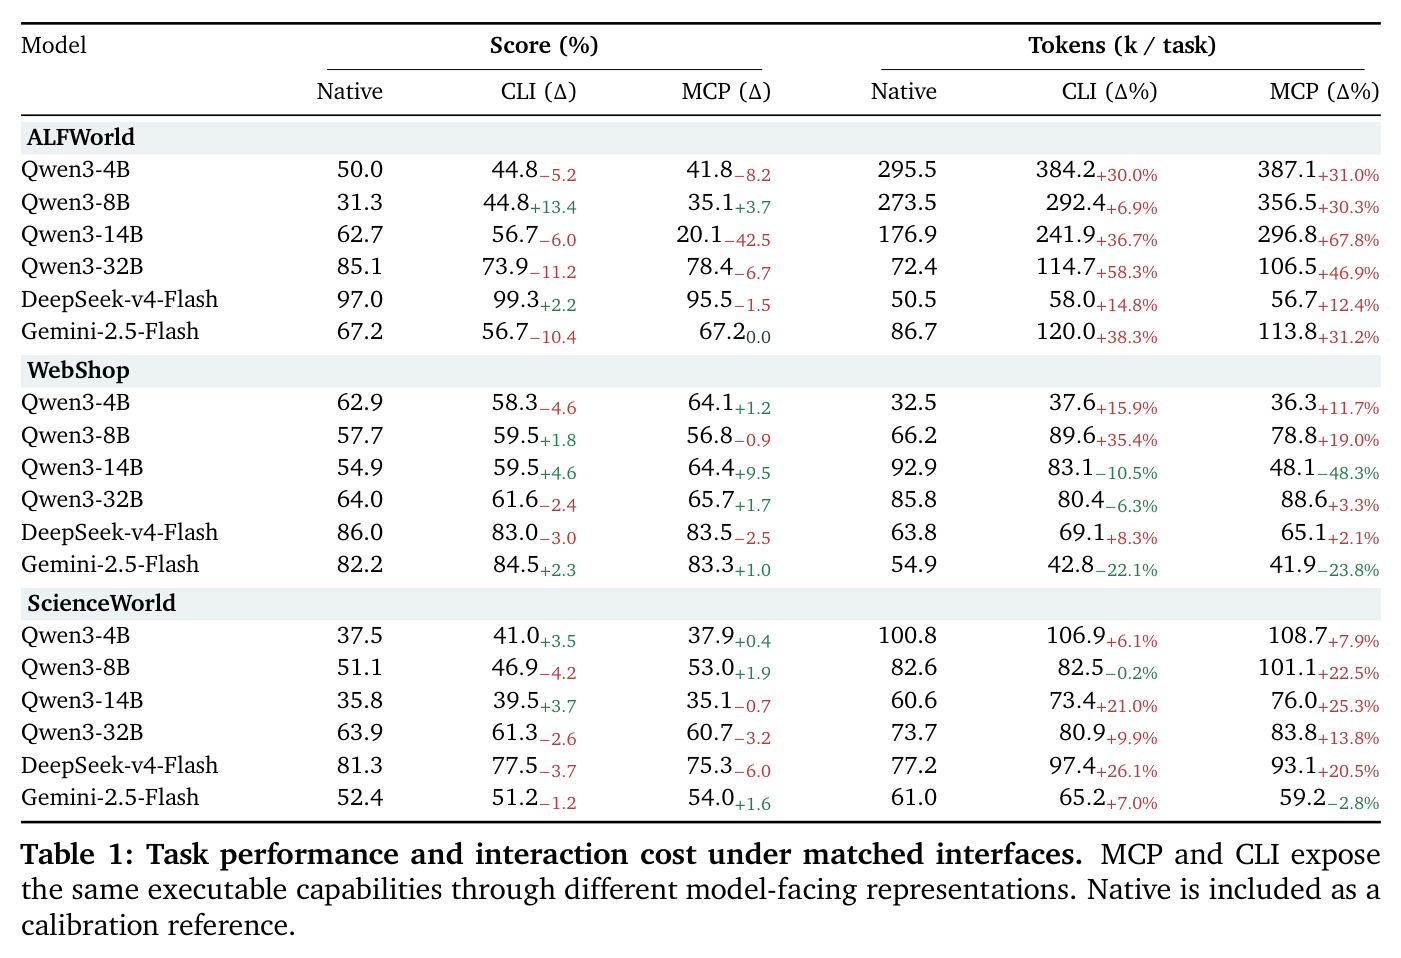
现代语言智能体通过 MCP 结构化工具调用或终端 CLI 命令与外部环境交互,但这两类接口对行为的影响一直缺乏受控证据。此前的系统级 MCP–CLI 对比(如企业自动化场景的研究)往往在换接口的同时改变了工具粒度、提示词、公开信息、校验与执行脚手架——已有工作甚至发现"能力打包方式"本身就能解释大部分性能差异——因此观察到的差异无法归因于模型侧表征本身。与此同时,主流基准(MCP-Bench、MCPMark、MCP-AgentBench、Terminal-Bench 等)只在单一接口内评估能力,端点分数把完全不同的语义选择、失败阶段与交互成本折叠成同一个数字:例如 Qwen3-14B 在 ALFWorld 上 MCP 只得 20.1 分而 CLI 得 56.7 分,相差 36.6 分,但我们不知道这 36.6 分来自解码失败、语义动作漂移还是恢复路径分化。同一个分数也可能经由不同的失败通路得到。"能力固定时,模型侧表征到底改变多少行为"这一基本问题因此悬而未决。
本文的目标是本文的目标是构建一个严格受控的比较与分析框架,回答四个递进的研究问题。RQ1:在可执行能力完全一致的条件下,接口表征(MCP vs CLI)对任务性能与 token 交互成本的影响有多大、方向是否稳定。RQ2:接口表征是否越过表面语法层,改变语义动作的选择以及失败后的恢复行为。RQ3:接口引起的差异起源于何处(呈现 $\Phi$、实现 $R$ 还是反馈 $\Psi$ 组件),又如何沿闭环轨迹传播到成本与结局。RQ4:针对分析中识别出的"实现失败"机制,能否设计一种保留已验证语义决策、只修复接口表达的控制策略(DART),在全部评测设置中同时提升分数并降低交互成本。
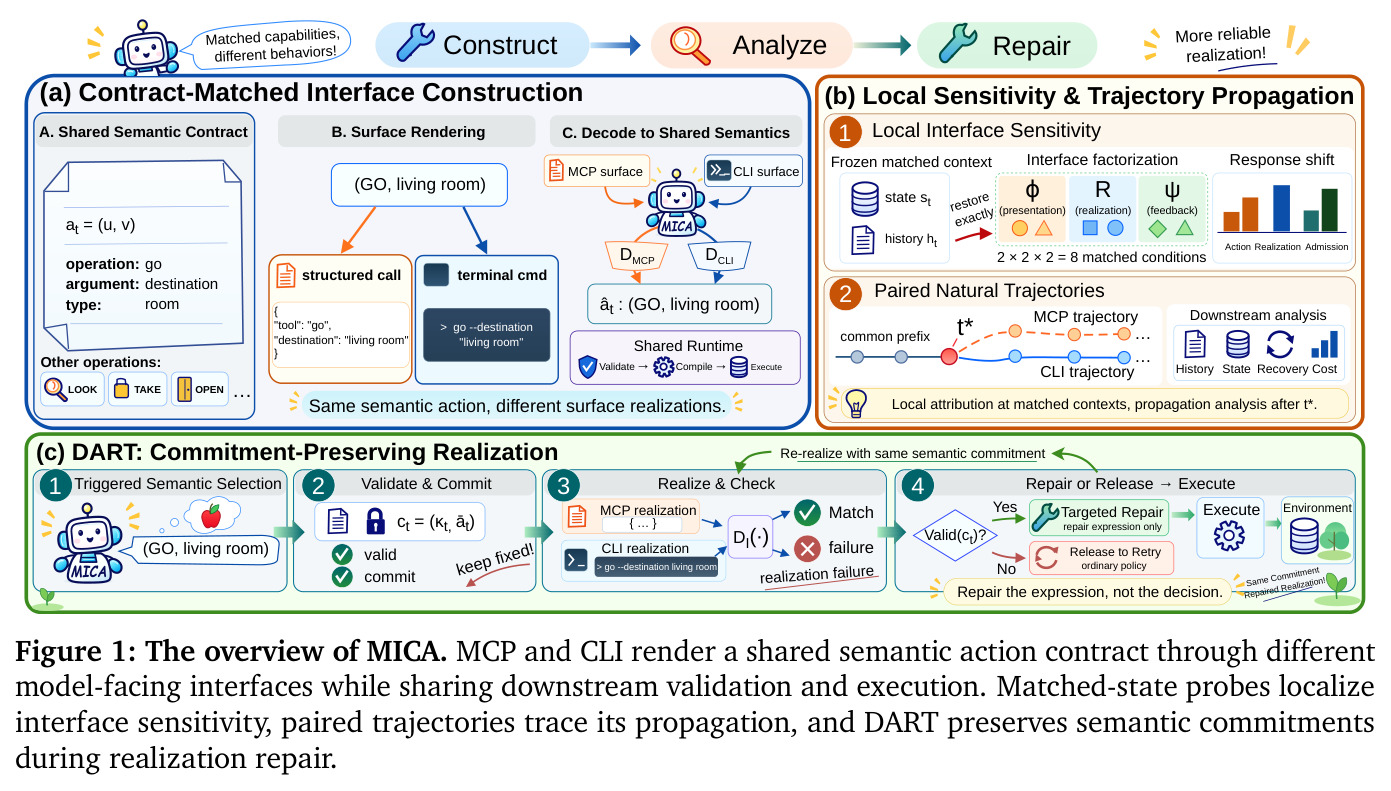
与已有工作不同的是,本文的独特之处在于"契约匹配"的实验设计与双尺度分析方法学。不同于换一个接口就换一套系统的做法,MICA 从同一个 benchmark 特定的语义契约 $\mathcal{C}_t$ 同时渲染出 MCP 与 CLI 两种表面形式,解码后的动作进入完全相同的共享校验、编译与执行运行时,并辅以往返等价等形式化一致性检查,从而把"能做什么"与"如何呈现"干净地解耦——这是对已有系统级对比的关键修正。分析上,它在两个互补尺度切入:匹配状态探针在冻结的决策上下文中对 $\Phi/R/\Psi$ 做析因交换,实现严格意义上的局部归因;配对自然轨迹以首次关键分歧 $t^\star$ 为界,追踪差异在历史、状态、恢复、成本与结局中的传播。更关键的是,分析揭示了一个可干预的机制边界:语义动作可能已经有效,但其接口特定表达失败——据此作者把"实现"定位为直接干预点,催生了承诺保持修复方法 DART,形成"分析定位机制、机制指导干预、干预反证机制"的完整闭环。
核心方法
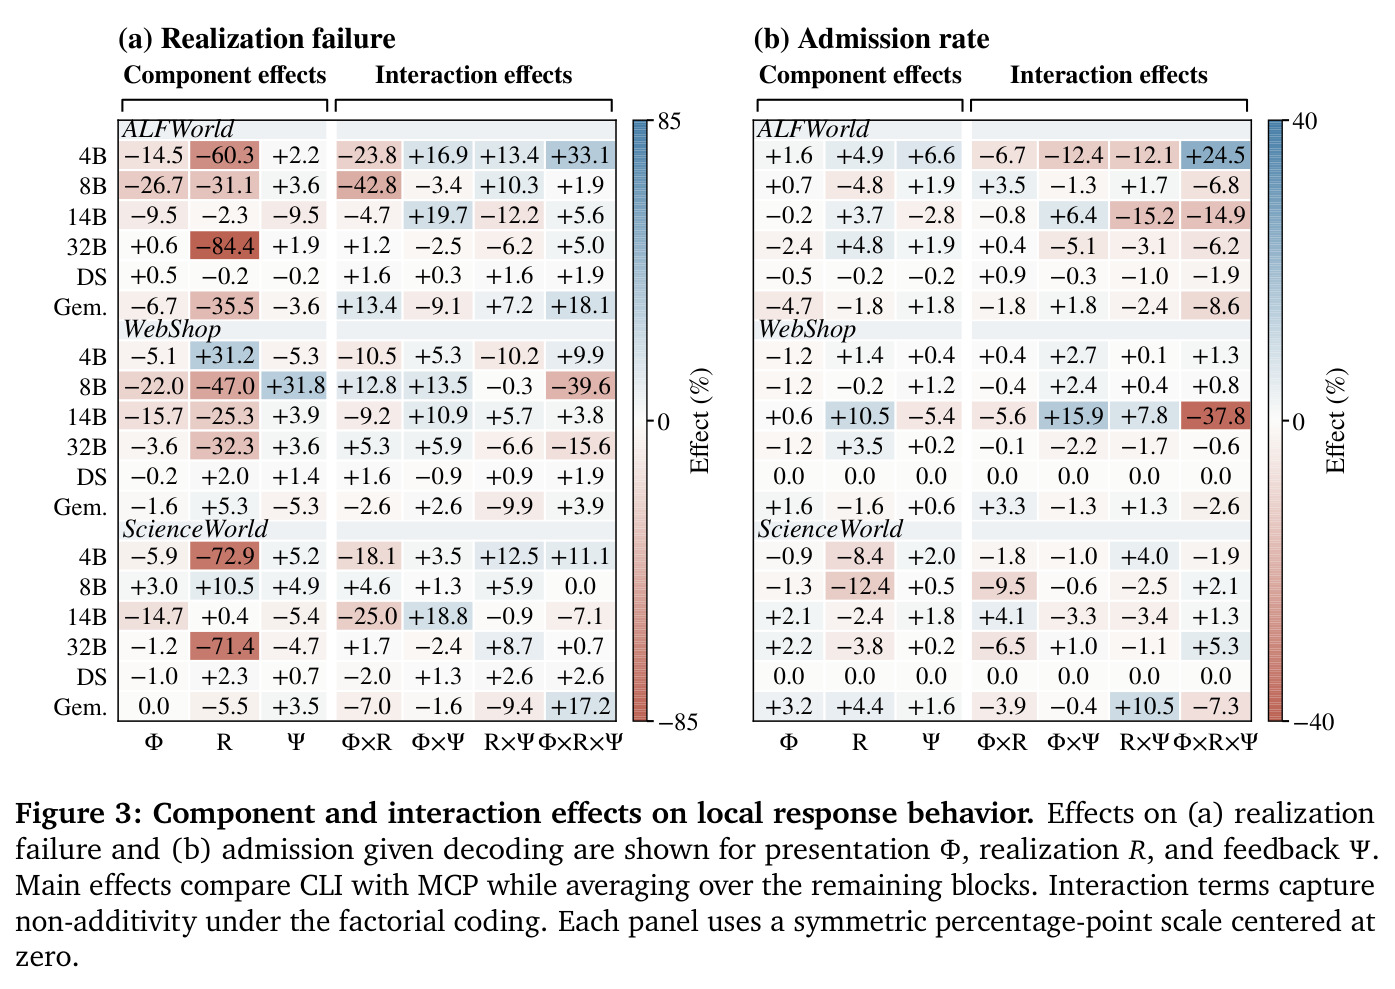
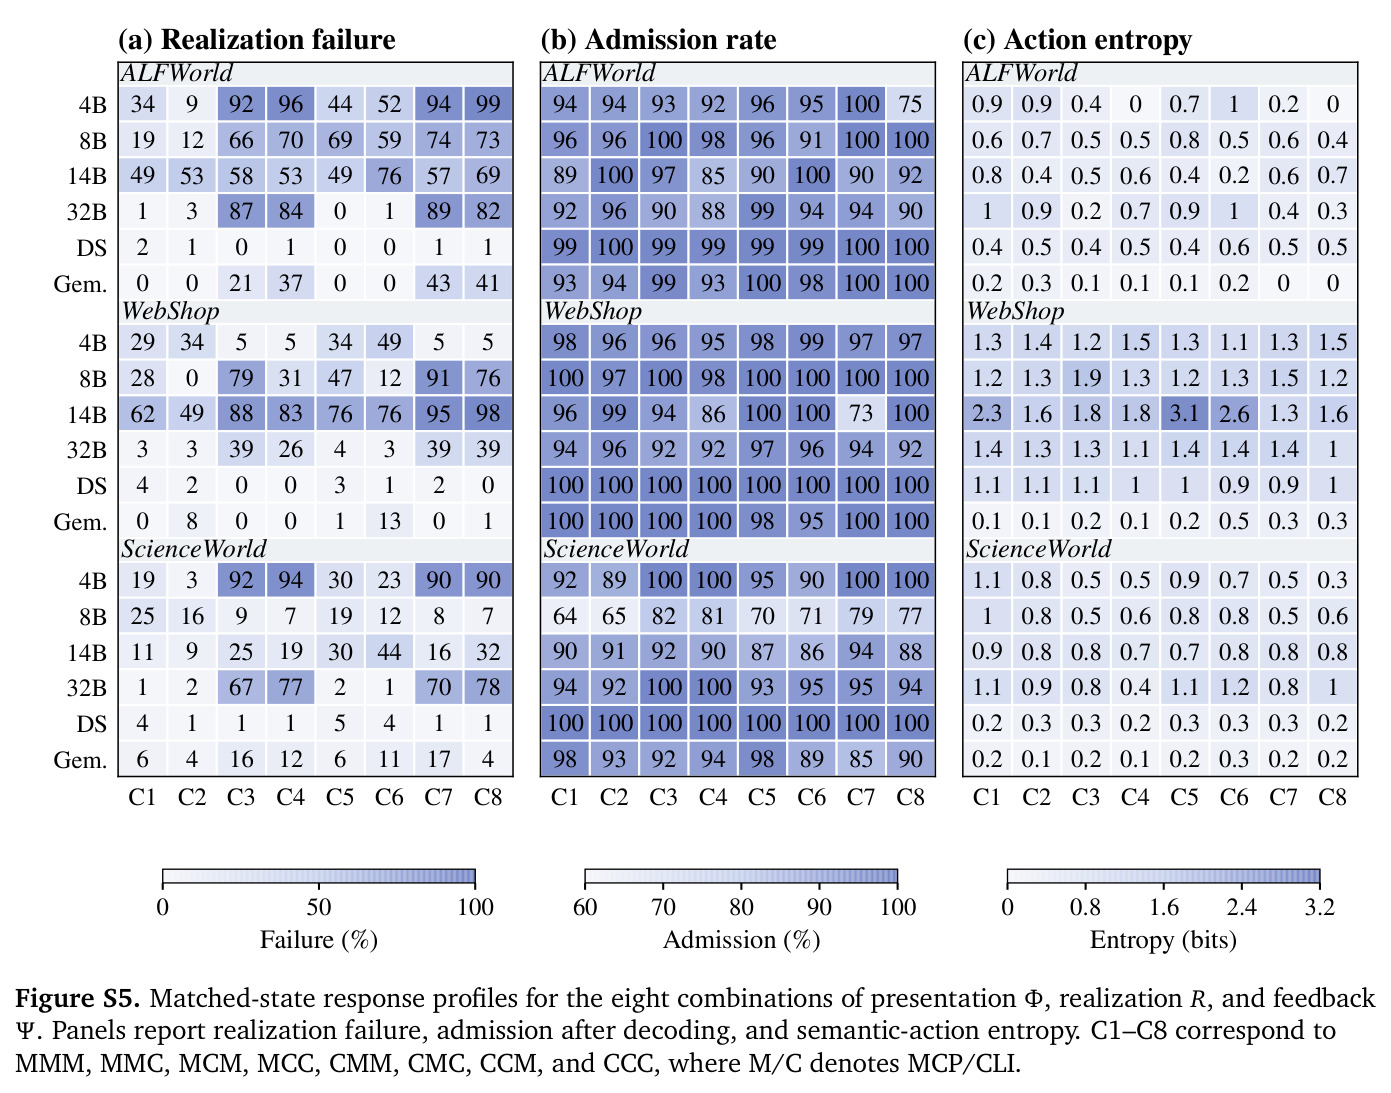
直觉上,同一个动作"去沙发"既可以写成 MCP 的 JSON 工具调用,也可以写成 CLI 命令 bench alfworld go --destination 'sofa 1';模型对这两种表面形式的敏感度不同,而闭环交互会把这种局部敏感度放大成完全不同的轨迹。技术上,MICA 分三步走。第一步契约匹配构建:从共享语义契约 $\mathcal{C}_t$(操作集合、类型化参数 $\Sigma_u$、状态局部参数域、原生执行绑定 $\Gamma_u$)渲染出 MCP/CLI 两个接口,解码后汇入同一校验—编译—执行路径。第二步双尺度分析:匹配状态探针在固定状态 $s_t$、历史 $h_t$、契约与生成配置下,对呈现 $\Phi$、实现 $R$、反馈 $\Psi$ 做 $2\times2\times2=8$ 种组合、每条件 8 次采样($T=0.6$),共 338 个源状态、21,632 条响应,估计组件主效应 $\Delta_k(d)=\mathbb{E}_{\xi_{-k}}[P_t^{\xi_k\leftarrow\text{MCP}}(d)-P_t^{\xi_k\leftarrow\text{CLI}}(d)]$;配对轨迹则在 2,004 对 episode 上对齐公共前缀、定位首次关键分歧 $t^\star$ 并分析后缀传播。第三步 DART 干预:把已验证的语义动作冻结为承诺,仅对其接口表达做针对性修复,直接检验 MICA 定位的实现机制。
核心创新是把"语义动作选择"与"接口实现"彻底解耦,并把后者识别为可直接干预的边界。与已有工作的本质区别有三。其一,已有基准与系统对比在换接口时连带改变工具粒度与脚手架,MICA 则以语义等价 $\equiv_{\text{sem}}$ 为唯一比较单元,配合共享运行时保证任何行为差异只能来自表征。其二,已有评估只看端点分数,MICA 用析因探针证明局部行为对三个接口组件的响应高度非可加——例如只切换实现协议 $R$ 就能让 Qwen3-32B 在 ALFWorld 的实现失败率从 1% 跳到 87%——并用 $t^\star$ 配对证明 94.3% 的轨迹会结构性分叉。其三,DART 提出"承诺保持修复":先用一次独立调用选出语义动作 $\bar{a}_t$ 并绑定契约身份 $\kappa_t$ 形成承诺 $c_t=(\kappa_t,\bar{a}_t)$;实现失败时只要承诺仍然有效——契约未变($\kappa_{\text{current}}=\kappa_t$)、解码结果匹配承诺($D_I(y^I_t)\equiv_{\kappa_t}\bar{a}_t$)、动作仍合法($V(s_t,\bar{a}_t)=1$)——就只发一次修正来修复表面表达,绝不重新选择语义动作。这与约束生成、对话恢复等工作允许在重试时更换语义的做法截然不同。
方法步骤详情
完整流程如下。第一步,构建共享契约 $\mathcal{C}_t$:ALFWorld 从当前可行动作实例生成导航、拾取、加热、冷却等操作并保留完整对象名;WebShop 只保留 search(query) 与 click(target) 两个语义操作(商品选项、翻页、购买都是 click 的参数值);ScienceWorld 把官方动作模板提升为类型化操作。第二步,表面渲染与一致性检查:MCP 渲染为命名工具加结构化参数,CLI 渲染为注册命令加 flag,并通过往返等价 $D^I(\text{Render}^I(a))\equiv_{\text{sem}}a$ 与共同原生编译 $K_{\mathcal{C}_t}$ 两道检查。第三步,受控评估:6 个模型(Qwen3-4B/8B/14B/32B、DeepSeek-v4-Flash、Gemini-2.5-Flash)× 3 环境(ALFWorld 134、WebShop 100、ScienceWorld 100 任务),共 2,004 对 episode;温度 0、top-$p=1$,输入/输出上限 24,576/16,384 token,各环境有独立的历史与调用预算。第四步,匹配状态探针:338 个源状态下交换 $\Phi/R/\Psi$ 的 8 种组合(C1=MMM 到 C8=CCC),每条件 8 次独立采样。第五步,配对轨迹:按任务配对、对齐最长语义前缀、定位 $t^\star$,统计后缀的语义一致性、失败恢复、token 与尝试次数、终局结果。第六步,DART 控制器:资格检查(可重试、策略自身失败、环境状态不变)→ 语义选择调用 → 验证并建立承诺 → 实现调用 → 保留门控 → 至多一次保留修正 → 否则 Release 回普通重试策略,所有调用共享 episode 级预算。
技术新颖性
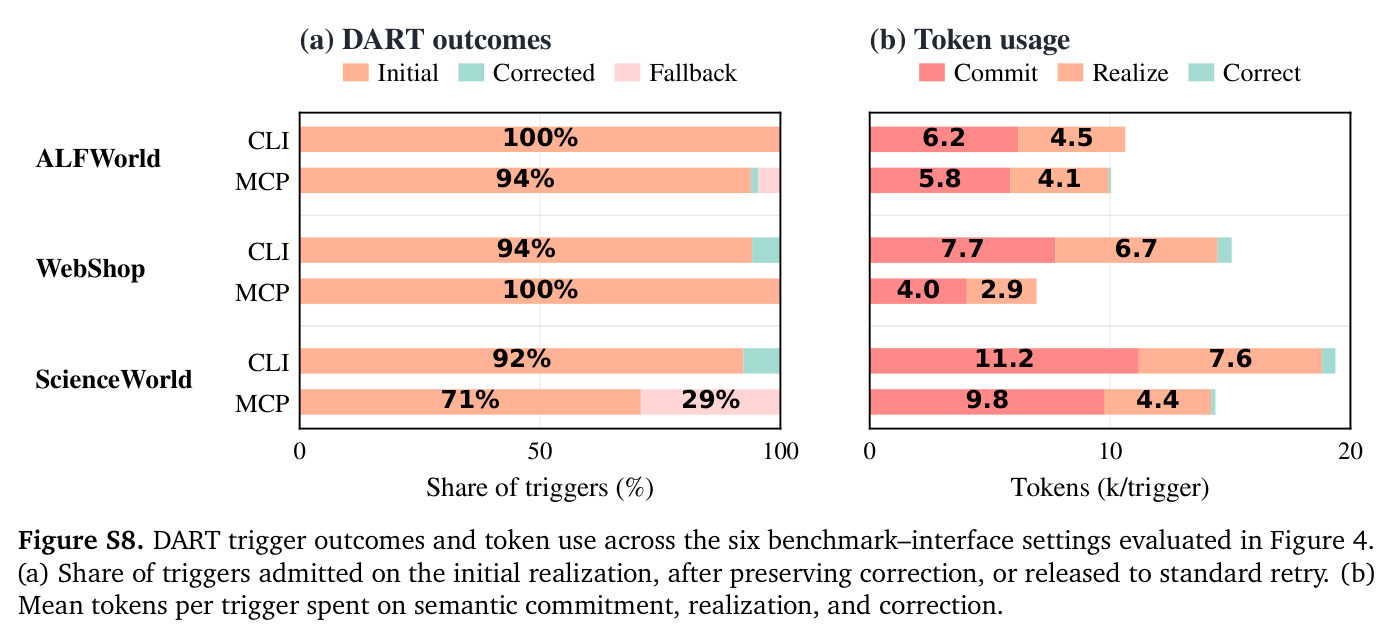
技术新颖性体现在四个层面。形式化上,论文首次把接口分解为 $I=(\Phi^I,R^I,\Psi^I)$、$R^I=(\rho^I,D^I)$ 四个模型侧组件并保持下游运行时共享,使"表征效应"成为一个可估计、可干预的量。统计上,$2\times2\times2$ 析因探针不仅给出主效应,还首次量化了此前被忽略的强交互效应——WebShop/Qwen3-14B 上三阶交互使 admission 移动 37.8 个百分点——说明接口组件的作用取决于周围配置,任何只消融单一组件的实验都可能得出误导性结论。方法学上,交互签名 $b^I_t=(\hat{a}^I_t,f^I_t,\omega^I_t,r^I_t)$ 与首次关键分歧 $t^\star$ 提供了一个可复用的轨迹层归因框架,把"哪里开始不同"与"之后如何演化"干净地分开。系统上,DART 的承诺—实现—修正三段式控制器以极小的协议改动(只增加控制器与触发配置)在六个设置中全部奏效,71–100% 的触发在首次实现即被接受,直接验证了 MICA 定位的实现边界。这套"分析定位机制 → 机制指导干预 → 干预反证机制"的论证结构本身也是一种方法论贡献。
实验结果
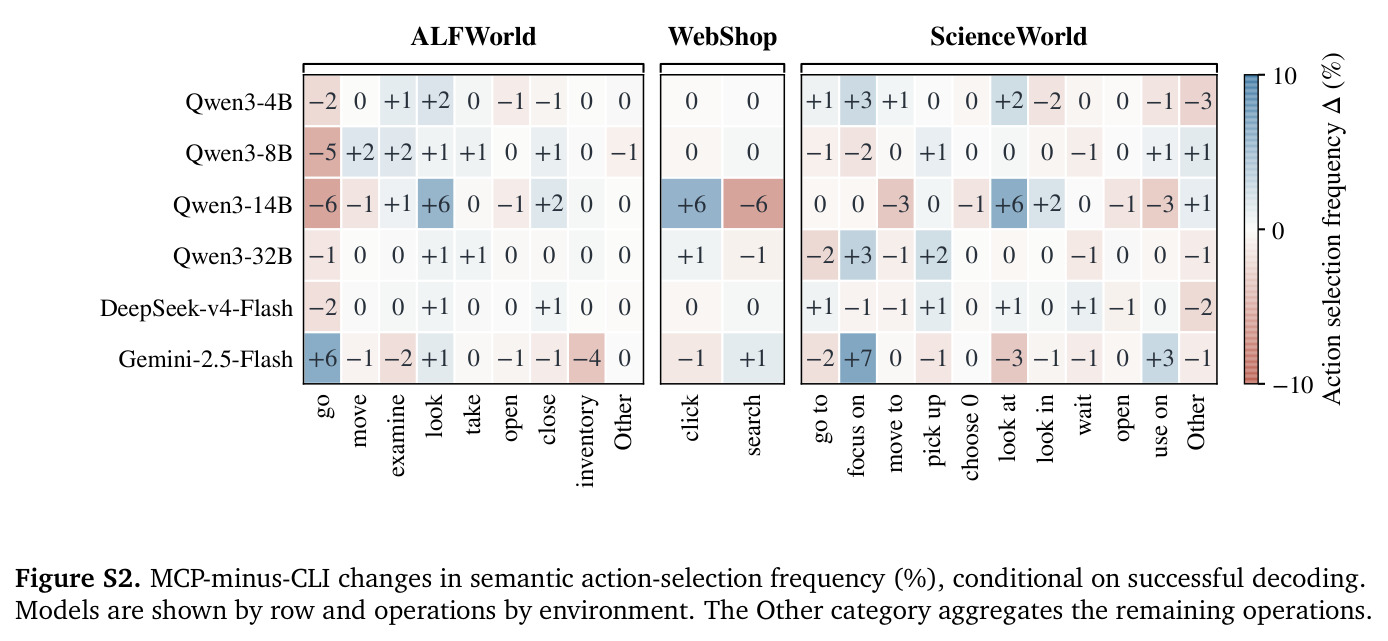
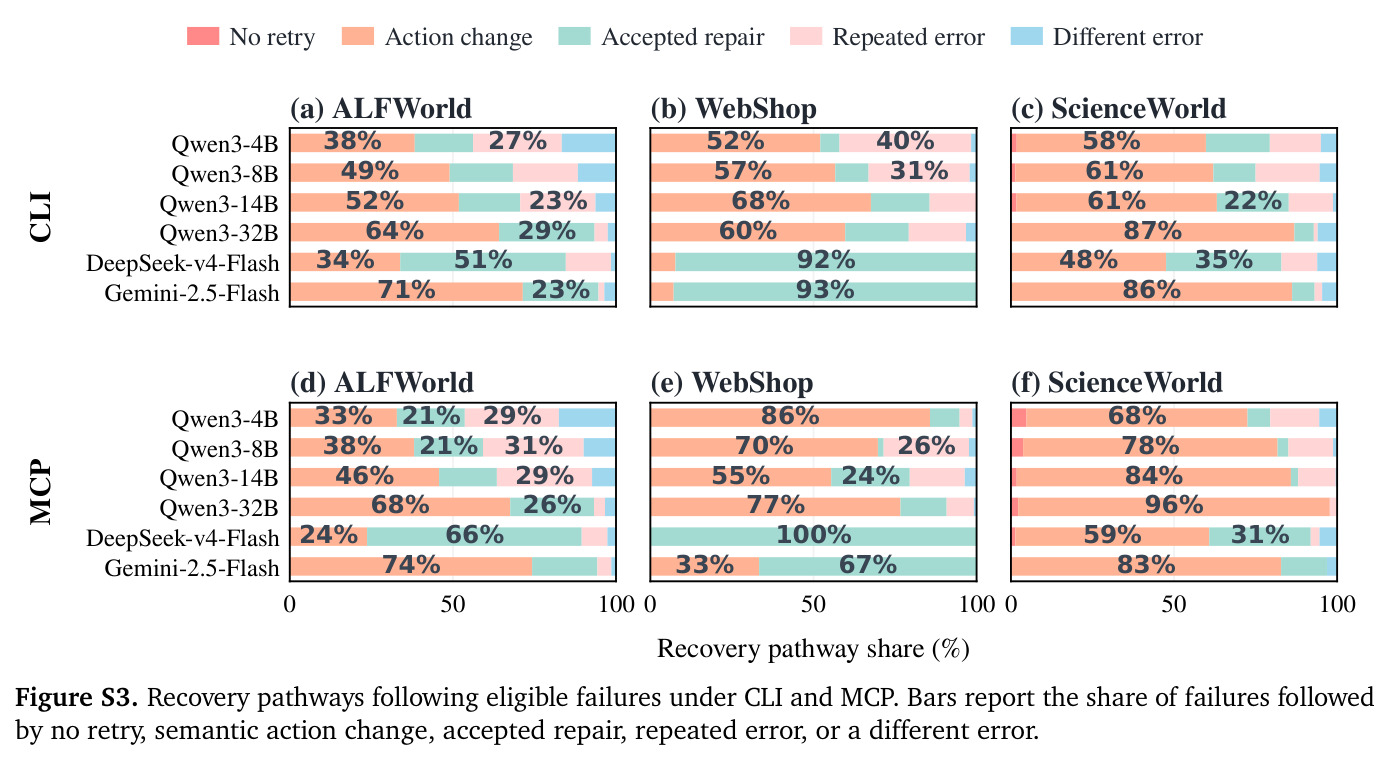
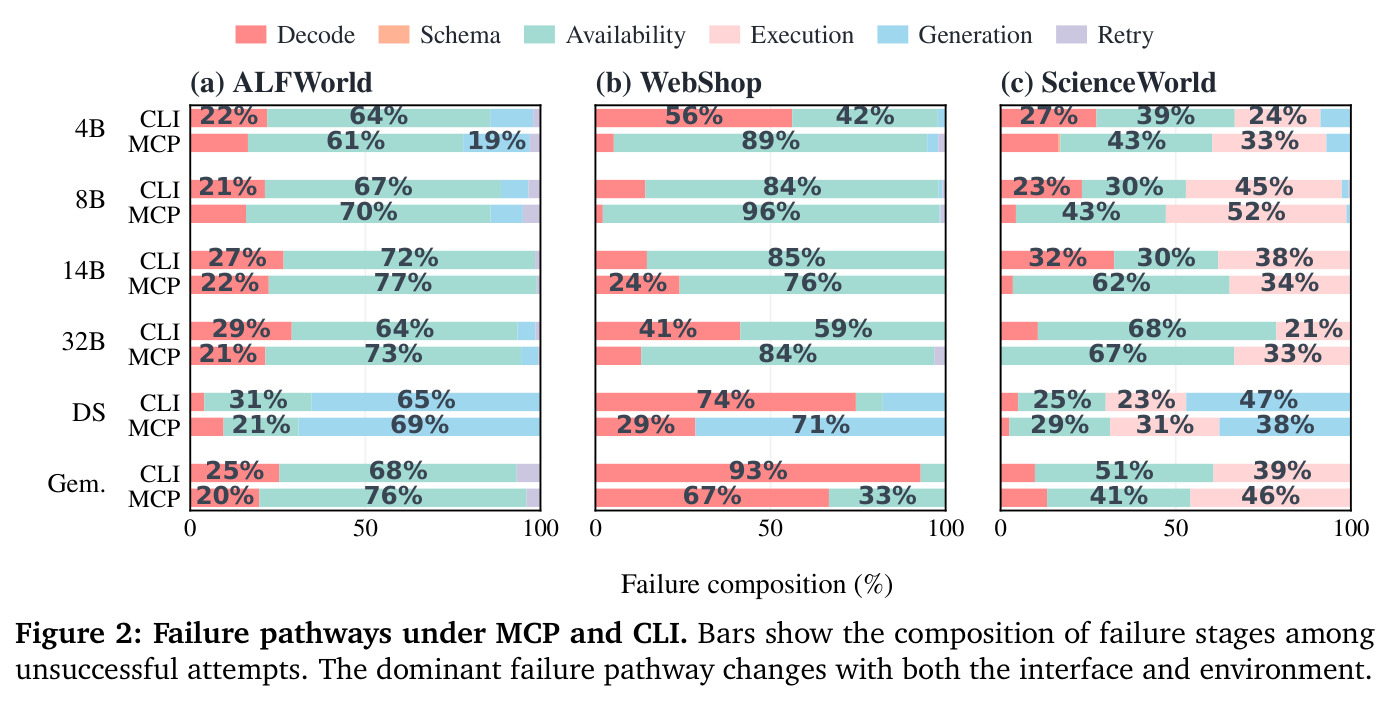
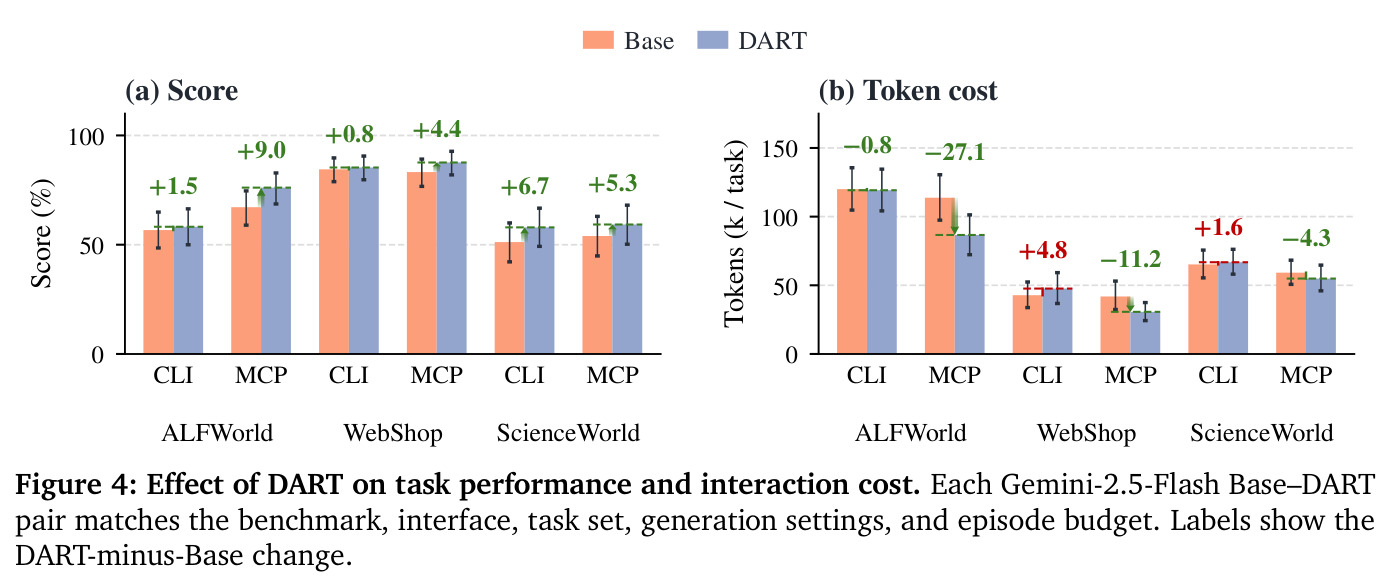
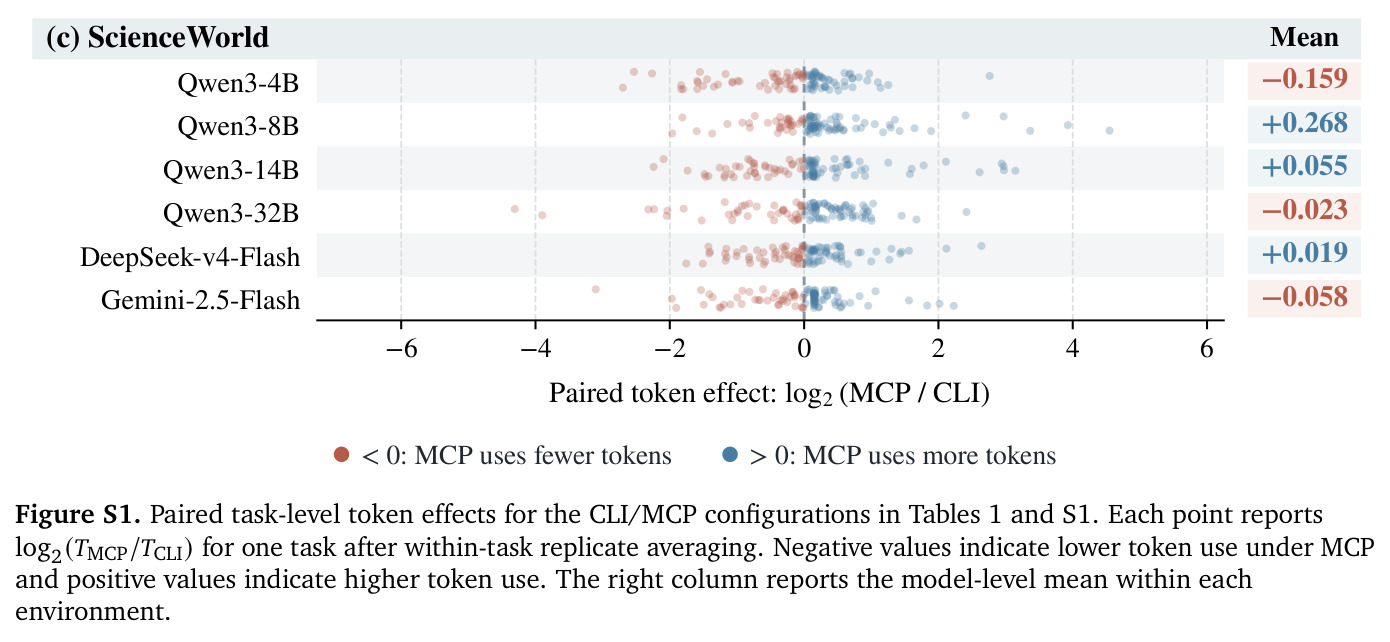
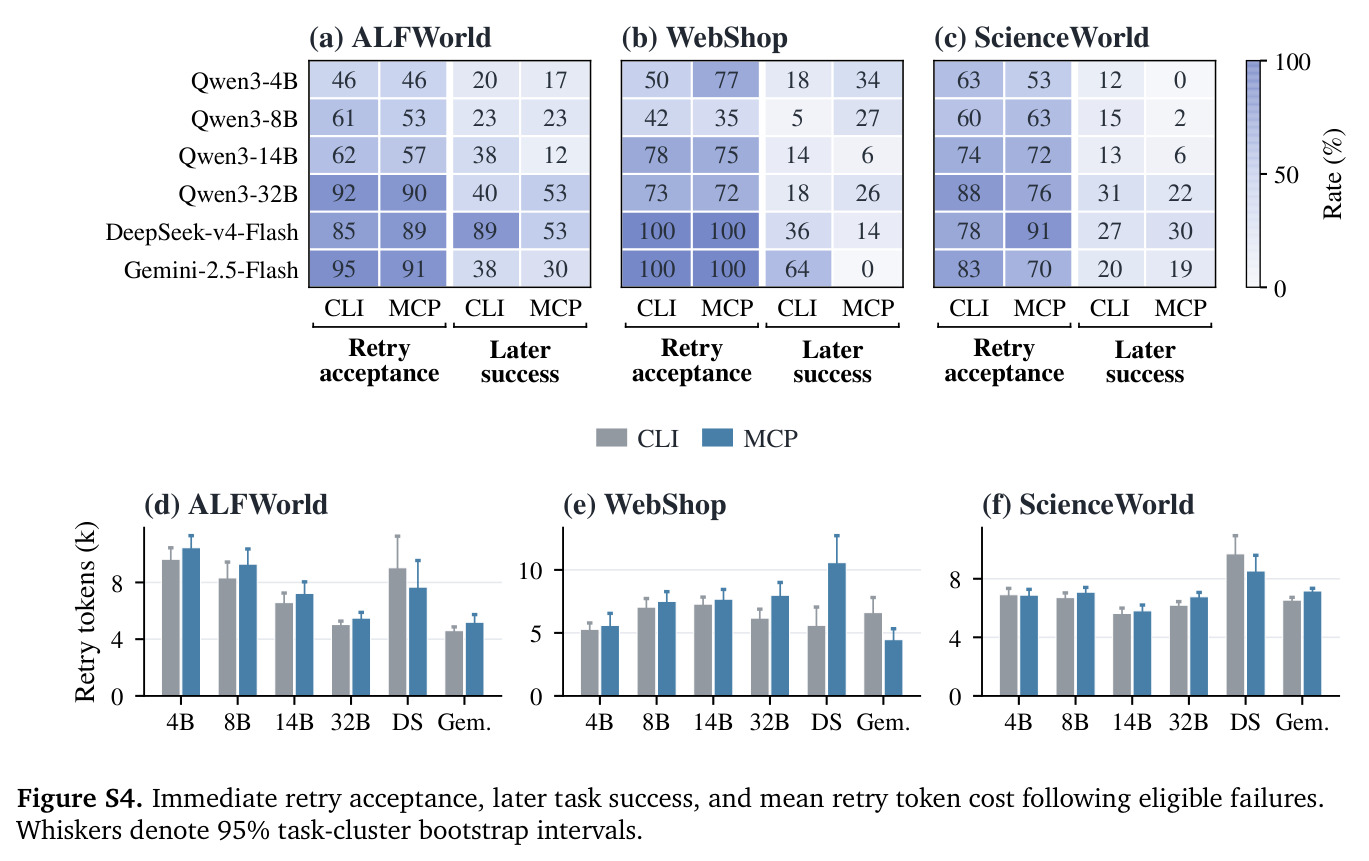
端点层面(Table 1):接口效应的方向与幅度随模型×环境剧烈变化。Qwen3-14B 在 ALFWorld 上 MCP 仅 20.1 分、CLI 56.7 分(差 36.6 分),token 296.8k vs 241.9k(+54.9k/任务);同一模型在 WebShop 上方向完全反转:MCP 64.4 vs CLI 59.5(+4.9 分),token 48.1k vs 83.1k(−48.3%)。Gemini-2.5-Flash 在 ALFWorld 上 MCP 反超 10.4 分(67.2 vs 56.7),DeepSeek-v4-Flash 则几乎免疫(ALFWorld 95.5–99.3)。成本分解(Table S1)显示机制不同:ALFWorld 上 MCP 高成本来自调用次数 46.9→57.1(每次调用 4.46k→4.50k 几乎不变),WebShop 上则调用 14.2→9.6 且每次 4.26k→3.23k。语义与失败层面(Figure 2、S2、Table S2):解码成功的响应中,WebShop/Qwen3-14B 在 MCP 下 click +6pp、search −6pp;MCP 在 WebShop 上对全部六个模型降低 attempt 级失败率 1.1–8.9pp,剩余失败从解码阶段后移到可用性/执行阶段。恢复层面(S3/S4):WebShop/Qwen3-4B 重试接受率 CLI 50% vs MCP 77%,但后续任务成功率仅 18% vs 34%,说明局部修复与轨迹进展脱节。局部敏感性(Figure 3、S5):实现组件 $R$ 主效应最大达 84.4pp(ALFWorld/Qwen3-32B)与 72.9pp(ScienceWorld/Qwen3-4B);只切换 $R$ 即让 Qwen3-32B 的实现失败率从 1%→87%;三阶交互使 WebShop/Qwen3-14B 的 admission 移动 37.8pp。轨迹层面(S6/S7):2,004 对中 1,889 对(94.3%)结构性分歧,首次分歧多在开头 1–2 步,语义差异占主导、实现差异次之,分歧后 token、尝试次数与终局成功率系统性分离。干预层面(Figure 4、S8):DART 用 Gemini-2.5-Flash 在全部六设置提分——ALFWorld CLI +1.5/MCP +9.0,WebShop +0.8/+4.4,ScienceWorld +6.7/+5.3;MCP 下 token 全降(−27.1k/−11.2k/−4.3k),CLI 下为 −0.8k/+4.8k/+1.6k;71–100% 的触发首次实现即被接受,4 个保留修正机会中 3 个一次成功。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| ALFWorld 室内任务(Qwen3-14B) | 任务得分/成功率 (%) | MCP 20.1 | CLI 56.7 | −36.6 分:全文最强的负向接口效应案例 |
| ALFWorld 室内任务(Qwen3-14B) | 总 token (k/任务) | MCP 296.8 | CLI 241.9 | MCP 多花 54.9k token(+67.8%),主要由调用次数 46.9→57.1 驱动 |
| WebShop 网购任务(Qwen3-14B) | 任务得分 (%) | MCP 64.4 | CLI 59.5 | +4.9 分,同时 token 从 83.1k 降至 48.1k(−48.3%),与 ALFWorld 方向完全反转 |
| ALFWorld 室内任务(Gemini-2.5-Flash) | 任务得分 (%) | MCP 67.2 | CLI 56.7 | +10.4 分:MCP 显著反超 CLI |
| WebShop(全部六个模型) | attempt 级失败率 (%) | MCP 失败率更低 | CLI | MCP 将六个模型的失败率绝对降低 1.1–8.9 个百分点 |
| 配对轨迹(六模型 × 三环境) | 结构性分歧比例 | 1,889/2,004(94.3%) | 其余 115 对无观测分歧 | 绝大多数轨迹对在早期即分歧,并传播为不同的成本与结局 |
| DART@ALFWorld(Gemini-2.5-Flash, MCP) | 任务得分 (%) | +9.0 分 | 协议匹配 Base | 六个设置中的最大单点提升,同时 token −27.1k/任务 |
| DART@WebShop(Gemini-2.5-Flash, MCP) | 任务得分 (%) | +4.4 分 | 协议匹配 Base | token −11.2k/任务 |
| DART@ScienceWorld(Gemini-2.5-Flash, MCP) | 任务得分 (%) | +5.3 分 | 协议匹配 Base | token −4.3k/任务 |
| DART@ALFWorld / WebShop / ScienceWorld(Gemini-2.5-Flash, CLI) | 任务得分 (%) | +1.5 / +0.8 / +6.7 分 | 协议匹配 Base | CLI 下 token 变化为 −0.8k / +4.8k / +1.6k |
局限与改进
作者承认的局限:RQ4 的 DART 评估只用了 Gemini-2.5-Flash 一个模型(六个设置),其对 Qwen 系列与 DeepSeek 的可移植性未验证;匹配状态探针需要 338 个源状态 × 8 条件 × 8 次采样共 21,632 条响应,实验成本高昂;DART 的触发范围限定为"可重试、策略自身、环境状态不变"的失败,不覆盖更深的语义层错误。我的补充观察:(1) 三个环境都是经典学术 benchmark,任务域较窄,未触及真实软件工程(SWE-bench 类)或真实 MCP 服务器生态中的长程任务;(2) 实验中的 CLI 是带 bench 前缀的受控子集,缺少真实 shell 的管道、组合命令、通配符与破坏性操作,结论向 Terminal-Bench/OSWorld 等真实终端环境的外推需要检验;(3) 接口效应与模型强耦合——Qwen3-14B 在 ALFWorld 上崩掉 36.6 分而 DeepSeek-v4-Flash 几乎免疫——暗示结论随模型版本快速漂移,任何"该用哪个接口"的结论都有保质期;(4) DART 每次触发需要 2–3 次额外模型调用,虽在 MCP 下总 token 下降,但推理延迟上升,对延迟敏感的场景需要权衡;(5) 恢复分析显示重试接受率与后续任务成功率明显脱节,说明 DART 只解决了恢复链条的第一环。
独立分析的弱点
独立分析发现以下弱点。第一,DART 假设"已验证的语义承诺值得保留",但语义有效 $V(s_t,\bar{a}_t)=1$ 不等于语义正确:如果模型选了一个合法却无助于任务的动作,冻结承诺会把策略锁死在次优分支上,尤其在 DART 自身制造的重试循环中。改进方向是引入进度或价值信号,在连续失败后允许承诺降级与重新选择。第二,析因探针的设计(338 状态 × 8 条件 × 8 采样 = 21,632 条响应)在工程上昂贵,难以作为常规开发流程的一部分;可用主动学习挑选高信息量源状态,或用分式析因设计 $2^{3-1}$ 只测 4 个条件先估计主效应。第三,论文揭示了接口效应的方向不一致性(同一模型跨环境反转、最大落差 36.6 分),但没有给出可操作的接口选择规则;可以训练一个轻量元预测器,从模型家族、任务结构与历史统计预测 MCP/CLI 哪个更优,实现自适应接口路由。第四,受控 CLI 的语法空间远小于真实终端,引号类失败(如 18''x18'' 案例)在真实 shell 中会以更多形态出现(转义、变量展开、通配符);应在真实终端环境复现 DART 的收益。第五,配对轨迹在温度 0 下进行,确定性解码可能低估分歧的随机成分,传播分析的效应量解释最好辅以温度扫描实验。
未来方向
作者指出的方向:接口设计应被当作决策环境的显式组成部分,智能体控制器可以通过"保留已确立的语义决策、把修复限制在表征特定组件"来改进恢复可靠性。基于本文成果可延伸的研究包括:(1) 自适应接口路由——按任务与模型动态选择或混合 MCP/CLI 乃至原生接口,把 Table 1 中 ±36.6 分的落差变成可收割的收益;(2) 把承诺保持修复推广到 code-as-action 接口(以可执行代码作为动作表征),检验"实现边界"是否是接口无关的普适机制;(3) 训练侧干预——用接口增强的数据增广或接口不变性正则,让策略对表征扰动天然鲁棒,从根源上消除实现失败;(4) 把 $t^\star$ 分歧检测改造成在线监控信号,在轨迹早期触发保守回退或人工介入;(5) 把析因探针应用于推理模型(长思维链)与多接口混合 episode,刻画 $\Phi/R/\Psi$ 交互在更强模型上的演化规律;(6) 追问接口效应的预训练根源——为什么 DeepSeek-v4-Flash 对接口不敏感而 Qwen3-14B 极度敏感,这可能指向工具调用格式的预训练暴露差异,进而反过来指导后训练数据配比。
复现评估
复现条件较好。代码开源于 GitHub(github.com/ModalityDance/MICA),论文的复现声明与附录覆盖非常完整:附录 B 给出任务集、生成配置(自然 episode 温度 0、探针 $T=0.6$、top-$p=1$、24,576/16,384 token 上下限)、各环境的历史与 episode 预算、配对估计量与 10,000 次 task-cluster bootstrap 协议;附录 C 给出契约渲染规则、三个 benchmark 的具体映射与往返一致性检查;附录 D/E 给出 DART 控制器伪代码、触发配置与完整 prompt 模板。数据全部来自公开 benchmark(ALFWorld 134、WebShop 100、ScienceWorld 100 任务),Qwen3 四个规模可从本地检查点加载,DeepSeek-v4-Flash 与 Gemini-2.5-Flash 走 API。主要成本在推理:基础研究需要 2,004×2 个 episode 加上 21,632 条探针响应,本地 32B 模型需要高显存单卡或量化方案,API 部分则是费用与限流问题。总体难度中等偏上:工程细节密集(解码器、保留门控、预算记账),但协议与代码覆盖充分,有智能体评测经验的团队可在数周内复现 Table 1 与 DART 六设置的核心结论。
论文图表
DART 触发结果与开销:71–100% 的触发在首次实现即被接受,4 个进入保留修正的机会中 3 个一次修正成功;token 分解显示承诺形成是每次触发的最大开销成分,修正只在少数触发中发生。
证明 DART 的收益确实来自修复实现边界而非重新选择动作,从机制上闭合了 MICA 诊断与干预效果的证据链。
DART 控制器伪代码:输入公共重试上下文、失败、契约、接口与剩余调用预算;依次执行资格检查(预算 <2 或失败不合格则 Release)、语义选择调用、承诺验证、实现调用与保留门控 Preserves(契约一致、解码匹配承诺、动作仍有效)、至多一次保留修正,任何环节不通过都 Release 回普通重试策略。
DART 的精确算法规格,明确了承诺在何时被冻结、修复被允许修改什么、预算如何记账,是复现 RQ4 实验的唯一权威描述。