超越基准测试:小规模开源权重模型能完成真实的编码工作吗 Beyond Benchmarks: Can Small Open-Weight Models Get Real Coding Work Done?
模型能跑不等于能干活:开源小模型做编码代理需闯服务、工具、会话、验证四关,且委派并不省钱
前置知识
KV 缓存与前缀复用(Prefix Caching)
Transformer 推理时每生成一个 token 都要对整段上下文计算注意力,KV 缓存把历史 token 的键值向量存下来避免重复计算。前缀复用(如 PagedAttention、RadixAttention)进一步把相同 token 前缀的缓存跨请求复用,命中时几乎跳过整个 prefill 阶段。
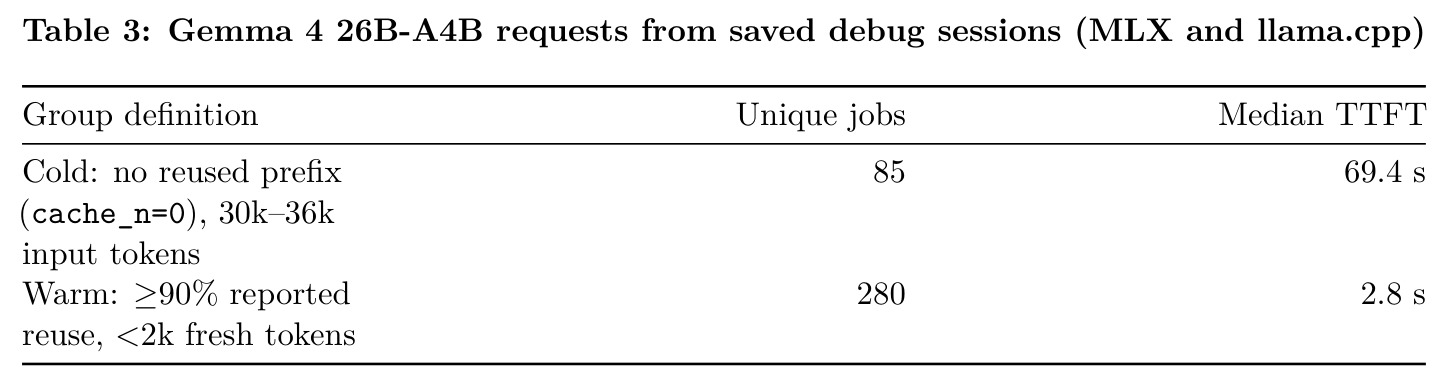
论文第 7 章的核心观察就是应用层消息序列的微小变化会静默摧毁前缀复用,使 TTFT 从 2.8 秒暴涨到 69.4 秒甚至 135.6 秒,这是理解会话连续性讨论的前提。
TTFT(Time To First Token,首 token 时间)
从发出请求到模型吐出第一个 token 的延迟,由 prefill(处理输入提示)与排队组成。缓存命中时 prefill 被跳过,TTFT 接近纯解码延迟;缓存未命中时几万 token 的 prefill 可能需要一分钟以上。
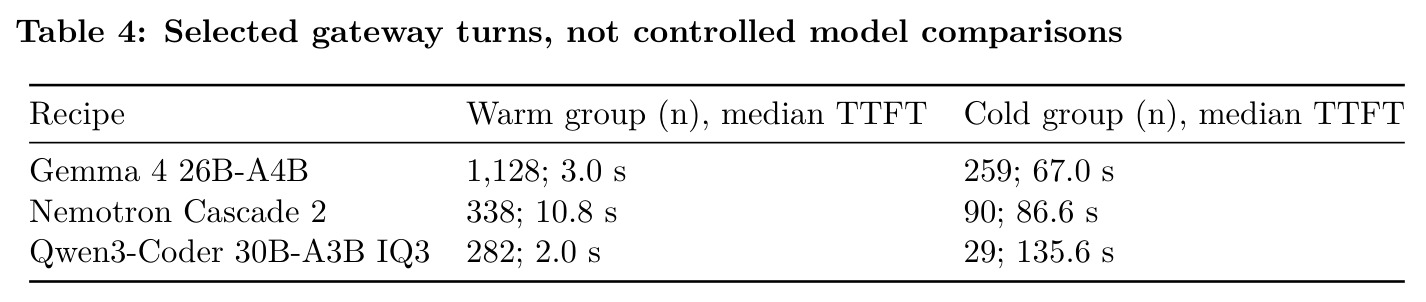
论文用冷/暖 TTFT 作为缓存连续性的主要观测量(表 3、表 4),是判断『会话是否真的连续』的关键指标,也是辅助请求拖慢主会话的证据来源。
工具调用(Tool Calling / Function Calling)
让模型在自然语言之外输出结构化调用(JSON:工具名加参数),由客户端解析执行并把结果回填对话。模型侧依赖 chat template 与 parser 把输出映射为可执行调用;服务端 tool_choice 设置、输出上限、流式参数拼接等任何一环出错都会导致调用丢失或畸形。
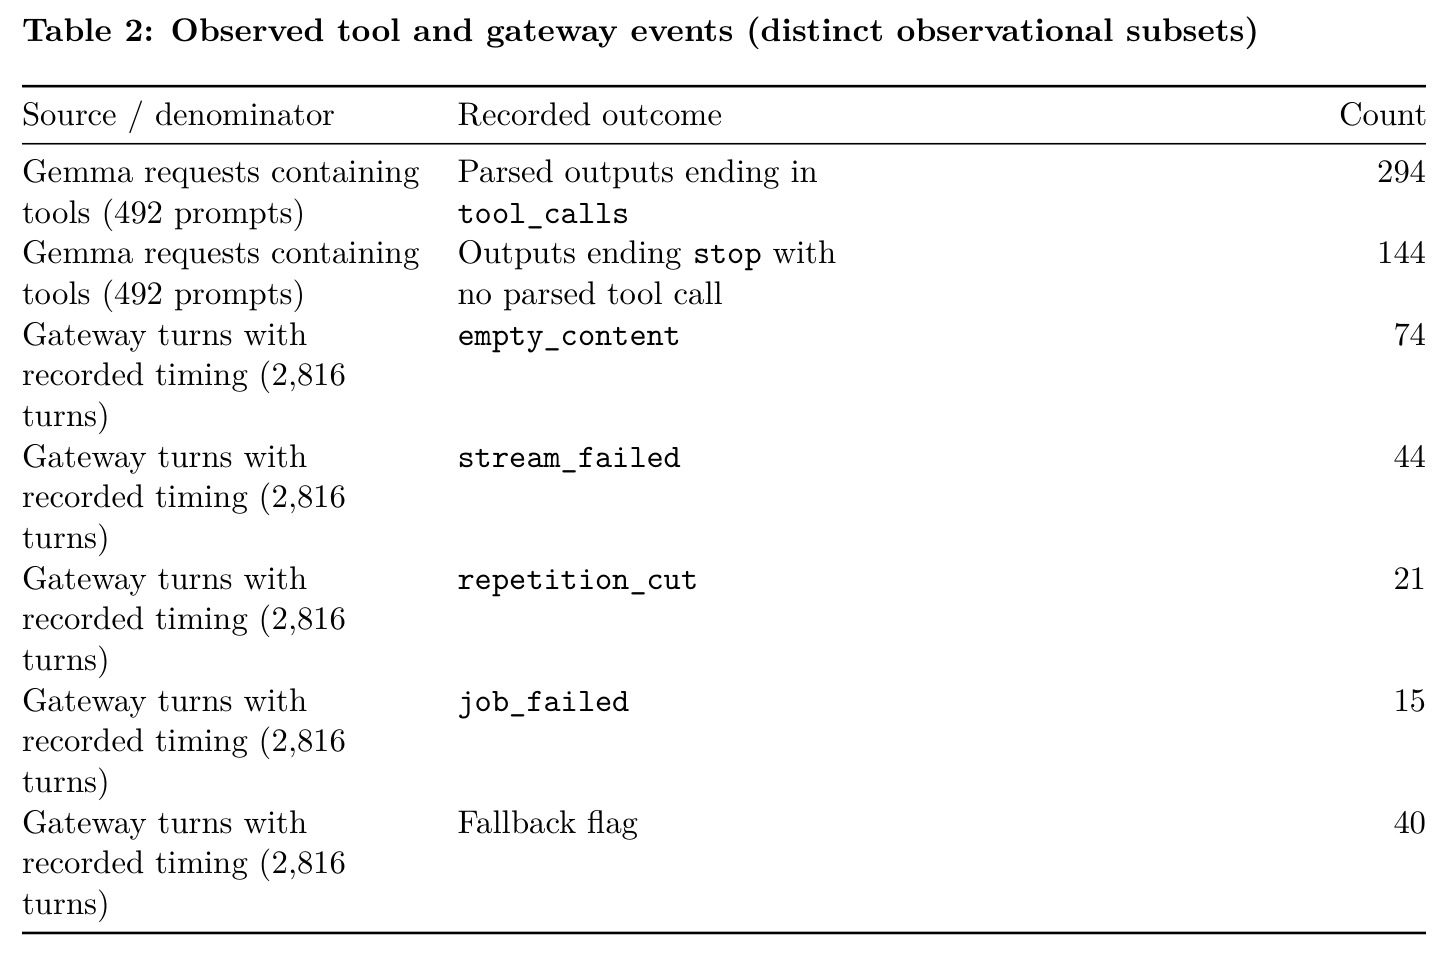
论文的第三级成功标准『解析并执行的工具调用』就卡在这里:Gemma 的 492 个含工具请求中 144 个以 stop 结束且无工具调用,还有 8 种畸形前缀输出完全无法解析。
量化与本地推理运行时(GGUF/MLX)
量化把权重从 FP16 压缩到 4-bit 或 3-bit 以塞进消费级内存(如 IQ3、4-bit MLX 格式),代价是精度损失与内核兼容性问题。GGUF 是 llama.cpp 的权重格式,MLX 是 Apple Silicon 框架,同一模型在不同 runtime 往往需要不同配置。
论文把部署单元定义为 checkpoint revision × 量化 × runtime 构建 × parser/template × 上下文配置 × 客户端的六元组,跨 vLLM/SGLang/llama.cpp/MLX 的移植失败案例是全文工程叙事的主线。
混合专家模型(MoE)与激活参数
MoE 模型总参数很大但每个 token 只激活一小部分专家网络,例如 Qwen3-Coder 30B-A3B 表示总参数 30B、每 token 激活约 3B。激活参数决定计算量,但全部权重仍需驻留内存——30B 总参 4-bit 也要约 15 GB 以上。
论文标题的『small』即指这类低激活参数模型,作者反复强调 MoE 的权重驻留负担不能只看激活数,这直接决定了 32 GB 笔记本上模型能力与上下文长度、可用内存之间的权衡。
隐藏行为检查(Hidden Behavioral Checks)
任务专属的测试集合,在编码代理声称完成后独立运行,以判断代码行为是否正确,与代理自己的 PASS 声明相互分离。本文中它们由作者(AI 辅助)编写,第二套件在评分前冻结并哈希记录,第一套件则没有预运行快照。
全文所有『verified』都以它为最终裁决,理解它才能分清 artifact 被拒、parent 拒绝与行为失败是三种不同结果,也才能理解事后下划线诊断为什么成立。
Wilson 置信区间
对比例型数据(n 次试验中 k 次成功)构造置信区间的方法,在小样本和边界情形(全过或全败)下比正态近似更稳健。本文用它报告 15 次试验通过率的不确定度。
读表 5 时必须知道区间相互重叠(如 [0.55,0.93] 与 [0.70,0.99])意味着不能断言条件间存在显著差异,这是作者反复强调『研究不用于排名模型』的统计学依据。
研究动机
论文的出发点是基准分数无法预测工程现场:『模型在跑』是一个极弱的成功标准。作者在 2026 年 7 至 10 月的工程记录显示,名义上兼容同一 API 的模型端点在工具调用格式、回合控制、上下文行为、缓存复用和可靠性上千差万别。具体数据:三周内网关记录了 4,165 个编码代理回合,其中 2,816 个带计时记录的回合里出现 74 次 empty_content、44 次 stream_failed、21 次 repetition_cut、15 次 job_failed(四类互斥,共 154 个错误回合);Gemma 4 的 492 个含工具请求中仅 294 个解析出 tool_calls,144 个以 stop 结束且没有任何工具调用。一个能加载、能对话的 checkpoint,仍可能在客户端要求检查文件、调用工具、维持长会话或遵守仓库契约时全面失败——文本生成成功与代码任务完成之间隔着多层未被基准测试覆盖的鸿沟。
本文的目标是作者要回答的问题是:从一个可用的开源权重 checkpoint,到一个开发者敢于信任的代码变更之间,到底还需要哪些环节正常工作?具体做法是把模型的『表面进展』拆成四级可分辨的里程碑:(1) served——checkpoint 加载并能响应;(2) coherent text——能用自然语言回答;(3) parsed and executed tool calls——输出能被代理接口解析并执行;(4) verified task completion——产出的代码通过任务专属的隐藏行为检查。在这个框架下,系统记录 serving recipe、agent 协议、会话连续性、artifact 校验和验证各层的工程失败,并用三个带隐藏行为检查的受控委派研究(固定 Claude Opus 5.5 为 parent),量化小型开源 worker 在真实工作流中的验证通过率与前沿模型成本。
与已有工作不同的是,本文的独特切入角度是不做新基准、不排名模型,而是提供一份『证据限定的回顾性系统工程经验报告』。三个差异点:第一,把兼容性单元从『模型名』重新定义为完整 recipe,即 checkpoint revision × 量化 × runtime 构建 × parser/template × 上下文配置 × 代理客户端的六元组,一个组合的成功配方无法安全复制到另一个;第二,把委派流程中的 artifact 生产、parent 审查与应用、行为验证拆成三个独立记账阶段——此前工作(SWE-bench、SWE-Lancer、FrugalGPT 级联)大多把『代码产出』与『任务通过』混为一谈;第三,成本核算以『每次验证成功的前沿 API 定价等价成本』为单位且分子包含失败会话,得出『委派实现反而更贵』的负结果,与 Scrouting 等正向路由研究(小模型侦察 + 前沿修复,266 题解出 159 题、成本约五分之一)形成鲜明的方向对照。
核心方法
方法的整体直觉是:编码代理是一条可靠性链,任何一环断裂都会在任务正确性被评估之前拦截工作,所以必须分层定位并逐层修复。技术路线分五层推进:(1) 分布式推理实验——用 llama.cpp RPC 把一个模型分片到两台笔记本(Wi-Fi 互联),发现聊天可用但编码代理的反复模型回合太慢,最终搁置;(2) 可复现服务——从云端 vLLM/SGLang 转向本地 llama.cpp GGUF 与 MLX,把每个能工作的模型配置固化为带回归测试的一键部署脚本;(3) 编码代理集成——客户端从 Cline 迁移到 OpenCode,9 月起经 Anthropic 兼容网关接入 Claude Code,并把网关简化为『薄翻译器』,验证仅保留协议与安全检查;(4) 会话连续性——通过 append-only 消息序列、MLX 缓存指纹与会话亲和保护 KV 前缀复用;(5) 验证——以 Claude Opus 5.5 为固定 parent,在两个 TypeScript 任务套件上运行带隐藏行为检查的委派研究并核算前沿成本。
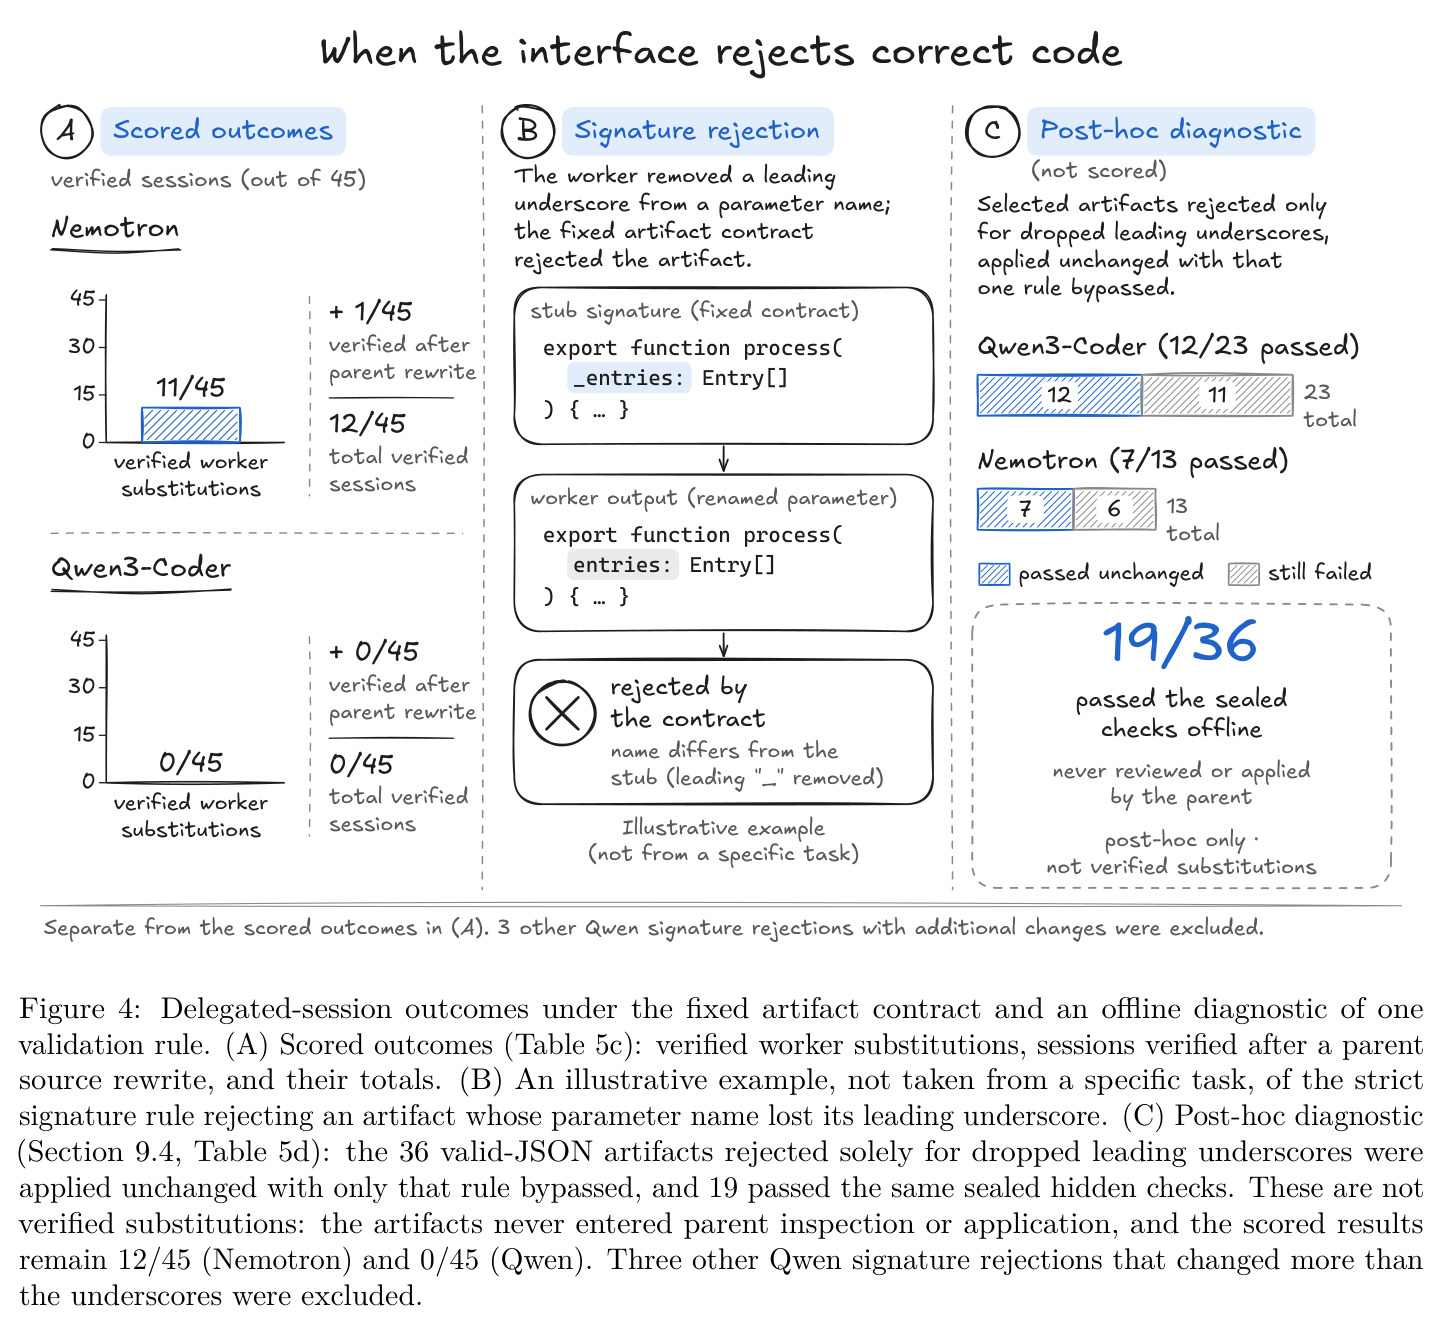
核心创新是『四级成功标准 + 三阶段分离的委派契约』。与已有工作的本质区别在于:SWE-bench 类工作检查代码是否通过测试,但本文证明在测试运行之前还有两道独立闸门——artifact 形式校验和 parent 审查——它们可以在功能正确的代码到达验证之前就将其拒绝。最直接的证据来自事后诊断:36 个仅因把参数名的下划线前缀去掉(如 $_entries$ 写成 $entries$)而被签名校验拒绝的合法 JSON artifact,在只绕过这一条规则后,有 19 个原样通过了原始隐藏行为检查(Qwen 12/23、Nemotron 7/13),但它们都不计为成功,因为从未经过 parent 审查与应用。这把『接口契约设计可以误杀功能正确代码』从直觉变成了有计数的观察,也解释了为什么 Qwen 在第二套件上的 0/45 不能直接读作能力为零。
方法步骤详情
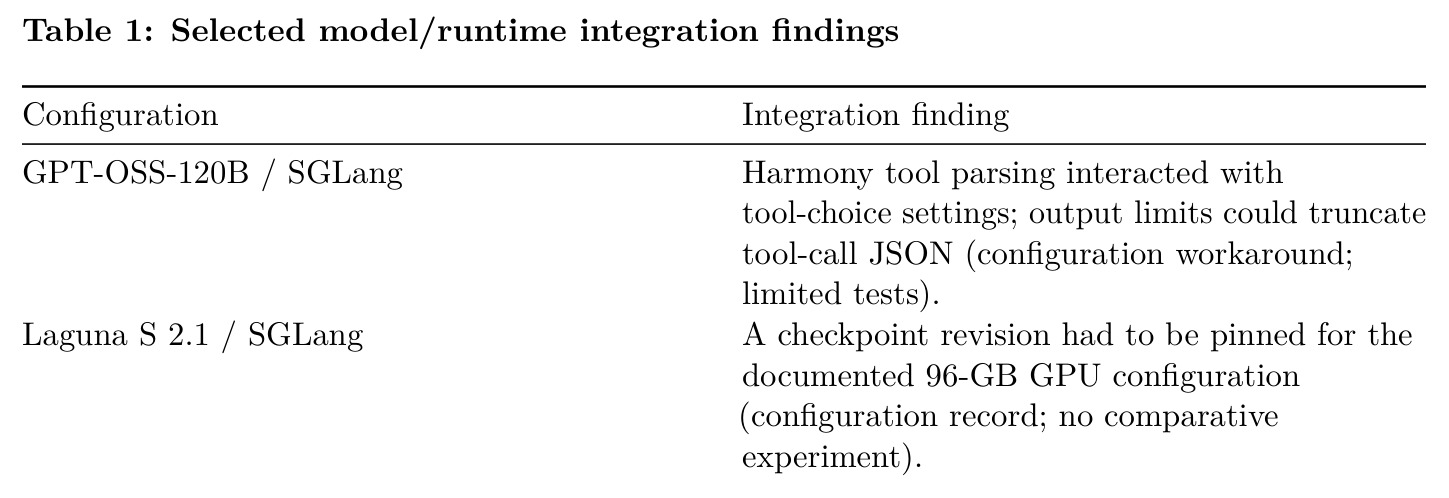
工程步骤依次为:(1) 分布式阶段:llama.cpp RPC over Wi-Fi,一次 32B 配置变更需向 helper 重传约 8.7 GB 权重、耗时约 5 分钟,迭代成本过高而搁置;(2) 服务阶段:逐个 runtime 排障并固化 recipe,如 Laguna S 2.1 缺编译器致 FlashInfer JIT 回退、GPT-OSS-120B 需强制 tool_choice=auto 规避 Harmony 解析问题;(3) 网关阶段:用 Python harness 对 Qwen3.5-122B-A10B/SGLang 做合成测试,通过率从 2/12 迭代到 12/12,但真实 Claude Code 会话仍暴露工作目录丢失、流式工具参数被当替换而非追加两类缺陷;(4) 会话阶段:确立消息 append-only、流式与最终工具 JSON 一致、元数据不改冻结前缀等纪律,并加会话亲和;(5) 研究阶段:固定契约——单次委派、120 秒截止、4096 输出 token、温度 0;artifact 须为单个 JSON 对象并通过 import/export/签名静态检查,经 parent 审查应用后跑 sealed 检查,成本按 $C_{delegate} = C_{parent,context} + C_{spec} + C_{review} + C_{recovery} + C_{worker}$ 框架核算。
技术新颖性
单项技术均非原创:PagedAttention、RadixAttention、FrugalGPT 式级联、harness 敏感性研究都有先例,作者也明确不据为己有。新颖性在组合与记账方式:(a) 把部署单元定义为六元组 recipe 并给出跨 vLLM/SGLang/llama.cpp/MLX 的失败案例账本;(b) 应用层缓存纪律的工程化——65 个辅助请求中 44 个无缓存复用,中位 TTFT 12.2 秒对主请求 2.7 秒,说明应用层不必要的提示变化会静默击穿运行时缓存;(c) 首次把委派经济学按『每次验证成功的前沿成本』(分子含失败会话)计账,并区分 verified substitution 与 parent 改写后才通过这两种结果;(d) 完整披露协议偏差——16 个被订阅限额拒绝的会话被替换执行,违反 keep-all 规则,并给出敏感性结果(37/45 与 8/45);(e) 事后下划线诊断量化了静态契约对行为正确代码的误杀率。合起来是一份罕见的负结果 + 证据限定的系统报告。
实验结果
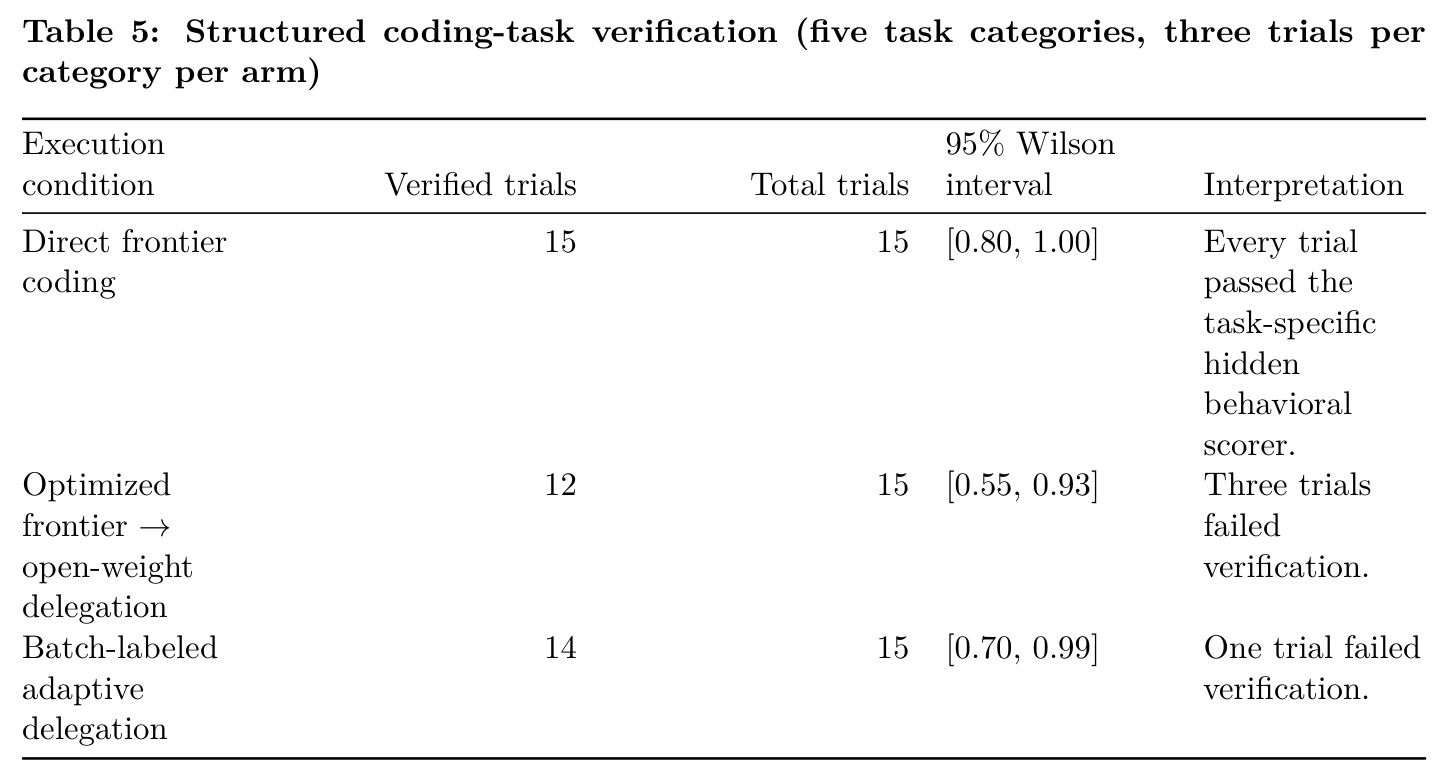
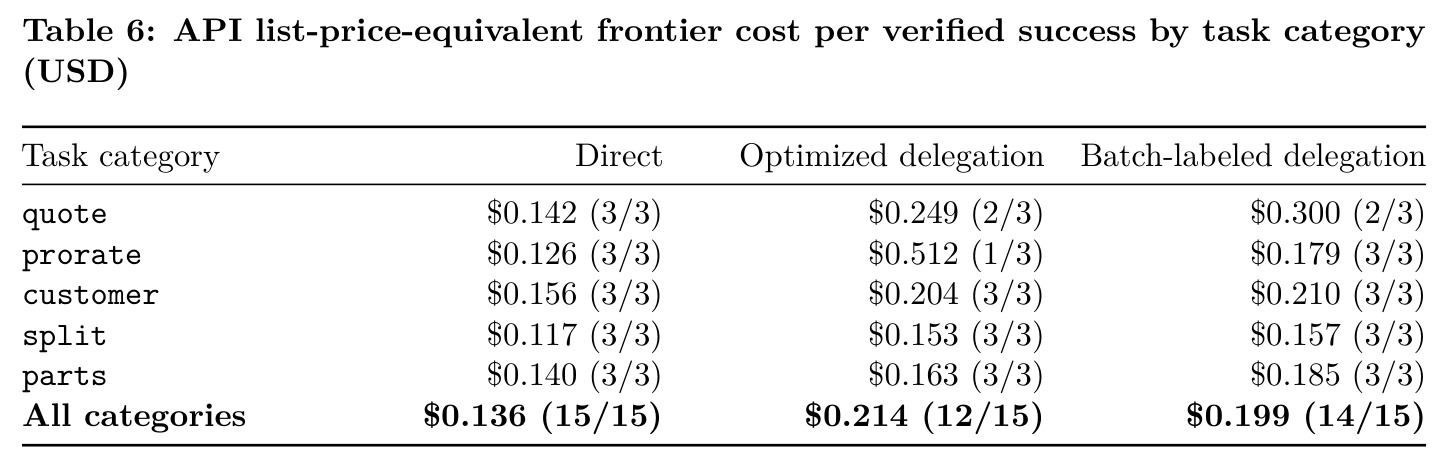
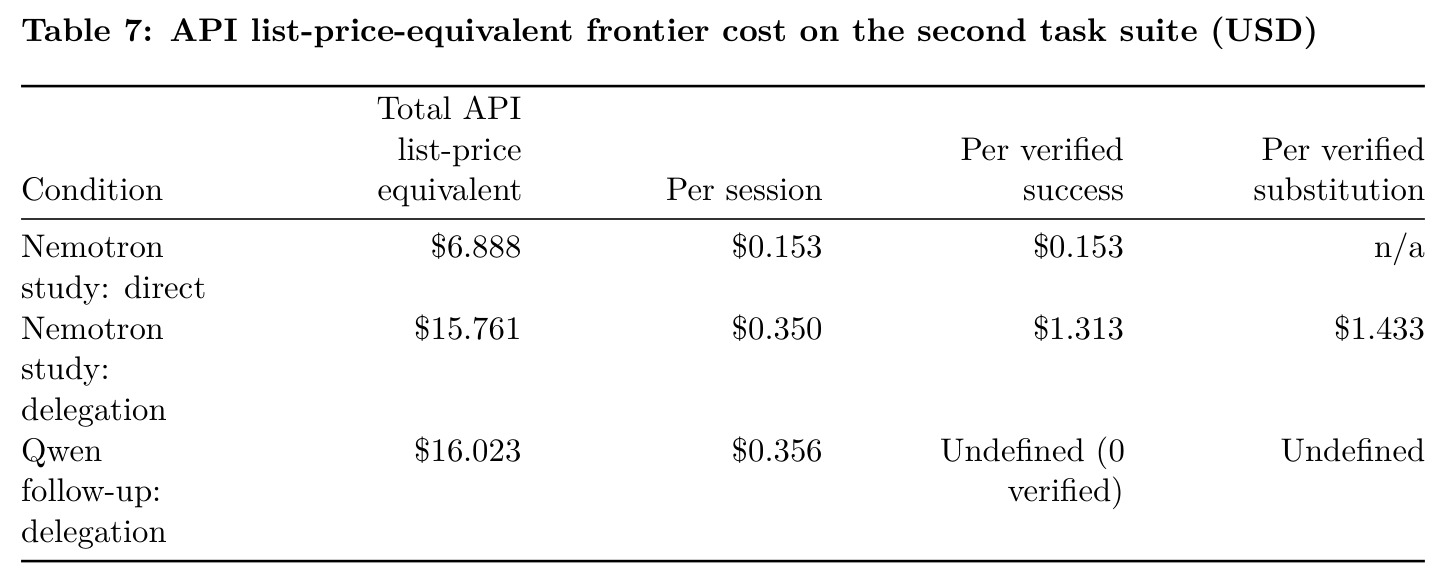
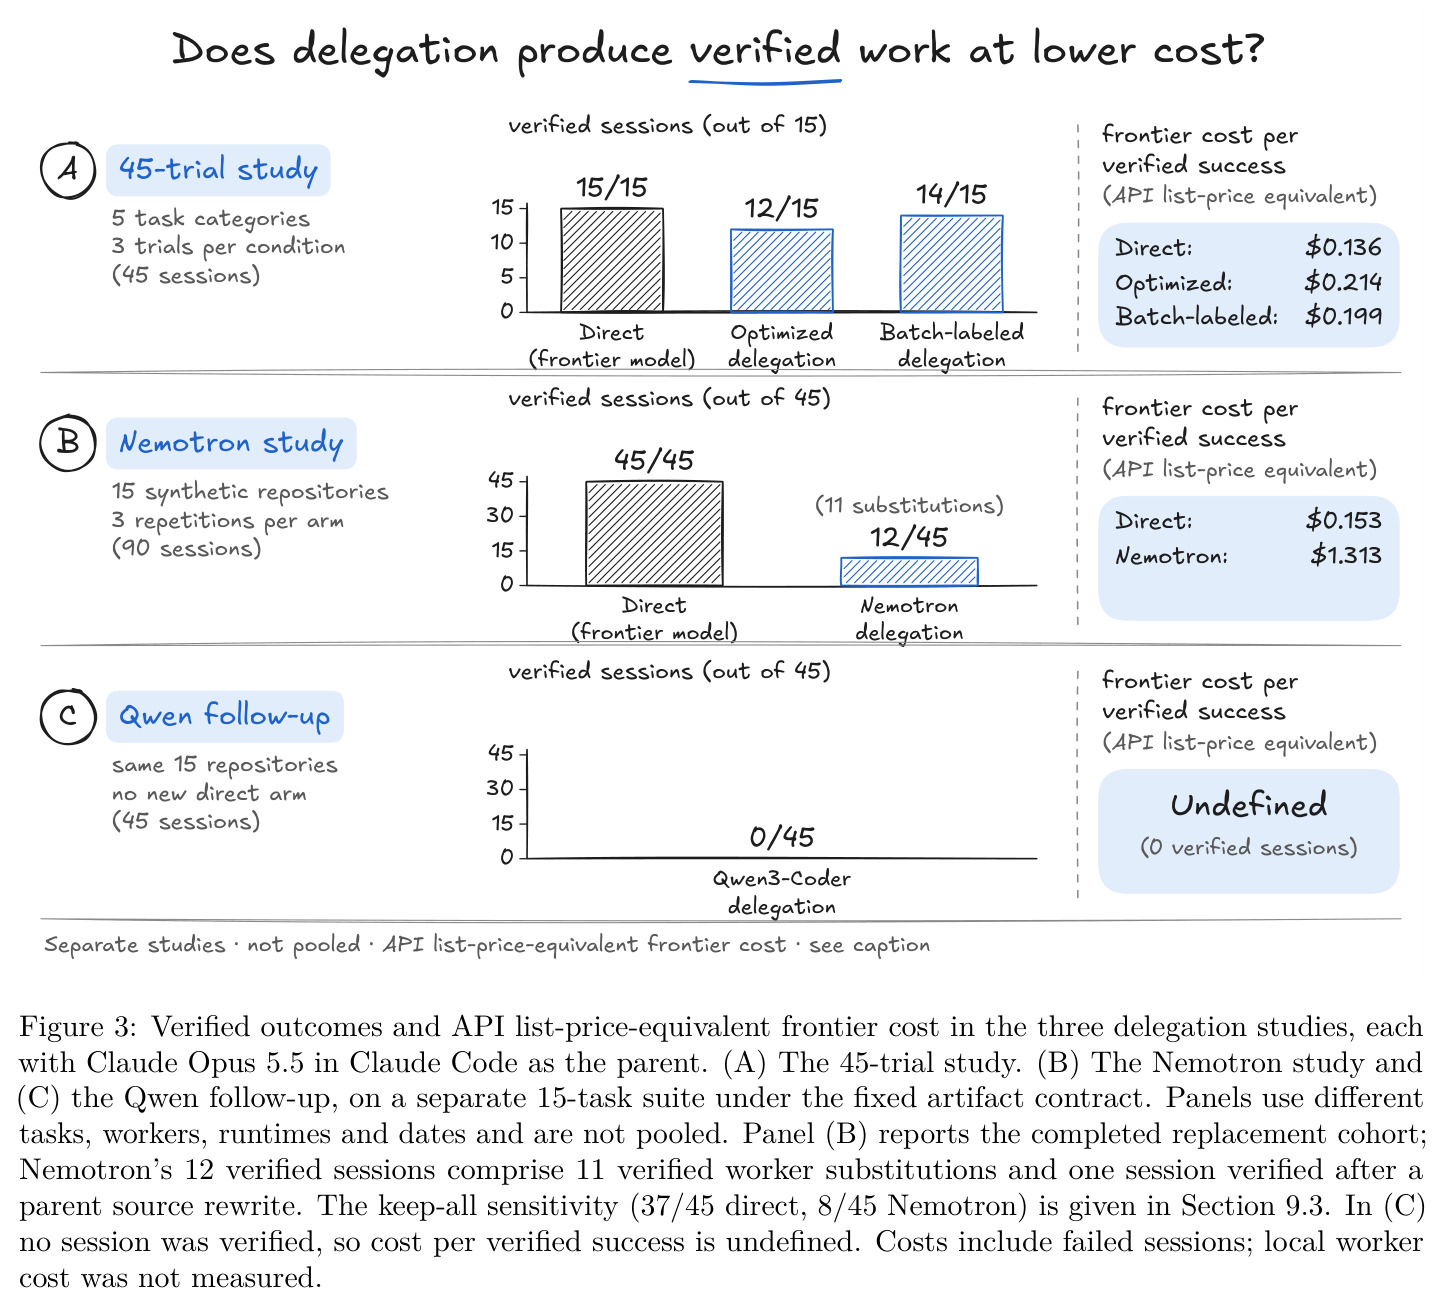
逐一分析各实验:(1) 45-trial 研究(5 类 TS 任务 × 3 条件 × 3 次):直接 15/15(Wilson [0.80,1.00])、优化委派 12/15、批量标记委派 14/15;前沿成本每验证成功 $0.136、$0.214、$0.199,直接最低且各类别单试验均值也最低;30 个委派试验中 26 个保留 worker 代码。(2) 第二套件(15 个合成仓库、固定契约):直接 45/45,Nemotron 委派 12/45(11 个替换 + 1 个 parent 改写后通过),Qwen 0/45;若把 16 个限额中断会话计失败则为 37/45 与 8/45。成本:直接 $0.153/成功,Nemotron $1.313/成功(约 8.6 倍),Qwen 未定义。故障分解:Qwen 45 会话中 26 死于签名校验、13 无效 JSON、5 parent 拒绝;Nemotron 为 13、4、8,另有 6 超时。(3) 缓存:冷前缀中位 TTFT 69.4 秒对高复用 2.8 秒;按 recipe 冷/暖:Gemma 4 为 67.0/3.0 秒、Nemotron 86.6/10.8 秒、Qwen IQ3 135.6/2.0 秒。(4) 工具事件:492 个含工具请求中 294 个解析出 tool_calls、144 个 stop 无调用。(5) 事后诊断:36 个仅因下划线被拒的 artifact 中 19 个原样通过隐藏检查。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 45-trial TypeScript 编码研究(5 类任务 × 3 条件 × 3 次重复) | 隐藏行为检查验证通过的会话数 | 直接 15/15;优化委派 12/15;批量标记委派 14/15 | 直接前沿执行(Claude Opus 5.5)为参照上界 15/15 | 委派比直接少 3 个和 1 个验证会话;委派仍保留 26/30 的 worker 代码 |
| 第二套件 15 个合成 TS 仓库(固定 artifact 契约) | verified worker substitution 数 | Nemotron 11/45(另有 1 个 parent 改写后通过,共 12/45);Qwen3-Coder 0/45 | 直接 Claude 45/45 | Nemotron 约为直接的 26.7%,Qwen 为 0% |
| 委派经济学(前沿成本核算) | API list-price 等价前沿成本 / 每次验证成功(USD) | Nemotron $1.313;Qwen 未定义(0 个验证成功);45-trial 优化/批量委派 $0.214/$0.199 | 直接执行 $0.153(第二套件)、$0.136(45-trial) | Nemotron 委派成本约为直接的 8.6 倍(负收益) |
| 前缀缓存冷/暖对比(Gemma 4 调试会话与网关回合) | 中位 TTFT(秒) | 高复用暖 2.8 对冷 69.4;按 recipe:Gemma 3.0/67.0,Nemotron 10.8/86.6,Qwen IQ3 2.0/135.6 | 同配置冷/暖分组互为参照(非受控实验) | 暖比冷快约 23-68 倍 |
| 静态签名契约敏感性(事后离线诊断,不计入成绩) | 仅绕过下划线规则后原样通过隐藏检查的 artifact 数 | 19/36(Qwen 12/23,Nemotron 7/13) | 原契约下这 36 个 artifact 记 0 成功 | 约 54% 被接口闸门误杀的功能正确代码被识别出来 |
局限与改进
作者承认的局限:回顾性私有记录,样本按实际问题选择而非随机;每格仅 3 次重复且聚类于任务,区间不能当独立任务不确定度解读;单一 parent harness(Claude Code + Opus 5.5),worker 配置有限;45-trial 的隐藏测试由 AI 辅助开发、无预运行快照、未预注册;第二套件虽冻结哈希但同样 AI 辅助;成本只计 API list-price 等价前沿 token,不含本地硬件、电力与工程时间;16 个会话被替换的协议偏差;冷/暖组构成不同,TTFT 差异是描述性而非因果;部分记录缺机器与运行时元数据。我自己的观察:全部 4,165 回合来自作者本人会话,外部效度与提示隐私受限;隐藏检查由同一作者起草,独立性有限;没有 SWE-bench 式真实仓库任务与产品级指标,『real coding work』范围比标题窄;缺 Thunderbolt 有线对照使分布式结论不完整;委派与直接 arm 非同期且 parent 缓存未重置,混杂时间与状态因素。
独立分析的弱点
独立分析的弱点:(1) 契约过严且无修复回路——签名校验仅做参数名文本比较,导致 36 个功能正确 artifact 被拒(Qwen 45 会话中 26 死于签名、13 死于无效 JSON),改进方向是按类型与语义比较签名,或如作者提议允许一次携带具体错误信息的修复回合;(2) worker 输入保真未受控——45-trial 中 parent 约束字段未转发、网关截断 1800 字符以上消息、两个 prompt 丢尾约 220 字符且都在失败试验里,Qwen 的 0/45 可能部分归因于输入劣化而非能力,应把端到端 prompt 保真审计作为研究前置检查;(3) 成本口径不完整——本地 worker 使 fee 试点墙上时间从 27.4 秒涨到 126.4 秒,而电力、硬件折旧与工程时间缺席,『委派更贵』只覆盖一半经济口径,应加入全成本模型;(4) 统计功效低——3 次重复、任务聚类、区间重叠,无法支持模型家族排名;(5) parent 缓存未重置、Claude Code 版本在研究期间变化,混杂时间趋势与客户端演进。
未来方向
作者明确提出的下一步:在同一固定契约下运行『一次有界修复』实验——签名校验失败时把具体错误反馈给 worker 并允许一次修复,测量 artifact 接受率、verified substitution 数、总体验证率、额外成本与含失败的前沿成本/验证成功;因为修复回合也增加 parent 与 worker 开销,只有同口径对照才能判断净效应。基于成果可延伸:(1) 与 Scrouting 的『小模型侦察 + 前沿修复』方向做头对头实验,检验任务边界设计能否扭转负成本结果;(2) 跨多个 parent harness 与更多 worker 家族重复第二套件,检验契约敏感性是否普遍;(3) 在 SWE-bench 风格真实仓库上复刻四级成功标准与三阶段记账;(4) 对缓存纪律做 A/B 因果量化,弄清前缀稳定性、会话亲和、辅助请求隔离各贡献多少 TTFT 改善;(5) 用 Thunderbolt 有线链路对照 Wi-Fi 重估分布式推理;(6) 用大规模重复运行研究配置间方差。
复现评估
复现评估:数据可用性声明明确原始记录是私有的,读者无法直接核查 4,165 个网关回合、623 个调试任务与会话日志;任务与隐藏检查为作者自制(AI 辅助),第二套件在评分前冻结并哈希记录,第一研究无预运行快照且未预注册。所依赖的资产全部公开:Qwen3-Coder 30B-A3B、Nemotron Cascade 2、Gemma 4 26B-A4B、Qwen3.5-122B-A10B 等开源权重,llama.cpp/MLX/vLLM/SGLang 开源运行时,硬件仅需一台 32 GB Apple M1 Pro 加 4-bit 量化,算力门槛很低;前沿侧只需 Claude 订阅或 API。但论文未发布代码、任务集或日志,加上协议偏差与缺失元数据,逐数字复现几乎不可能;复现定性结论(四级成功标准、缓存对 TTFT 的数量级影响、静态契约误杀功能正确代码)则相对容易。综合评级:概念复现难度中低,定量复现难度高,属于『可信但无法验证到底层』的经验报告。
论文图表
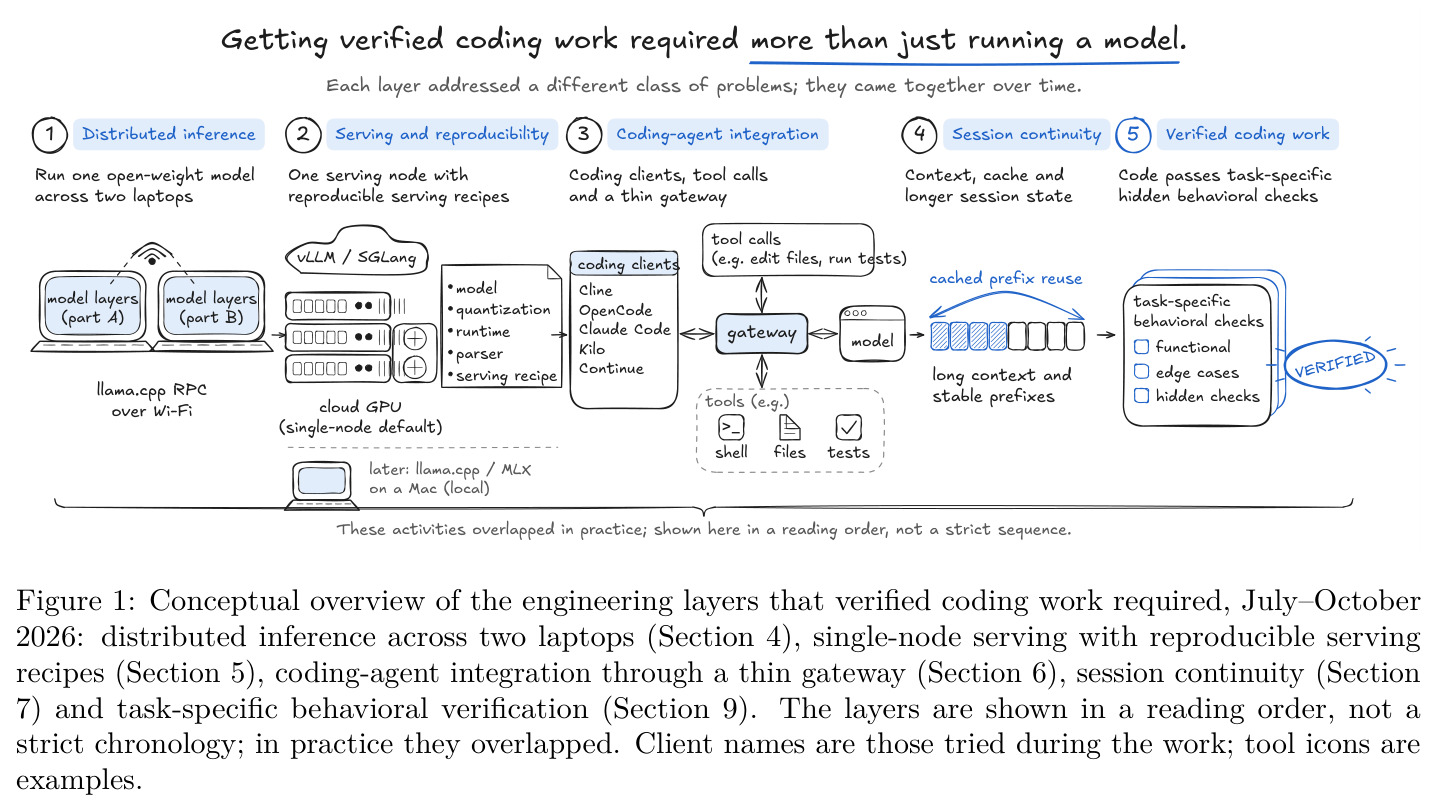
五层工程堆栈的概念总览:分布式推理(两台笔记本跑一个模型)→ 单节点可复现服务 recipe(vLLM/SGLang 云 GPU,后转 llama.cpp/MLX 本地 Mac)→ 通过薄网关的编码代理集成(Cline、OpenCode、Claude Code 等客户端与工具调用)→ 会话连续性(上下文、缓存前缀复用)→ 已验证编码工作(任务专属隐藏行为检查)。作者注明各层在实践中有重叠,图中是阅读顺序而非严格时间线。
这是全文的路线图,把『从模型能跑到代码被验证』所需的全部工程层一次性铺开,读者可以据此定位后续每一章在堆栈中的位置。
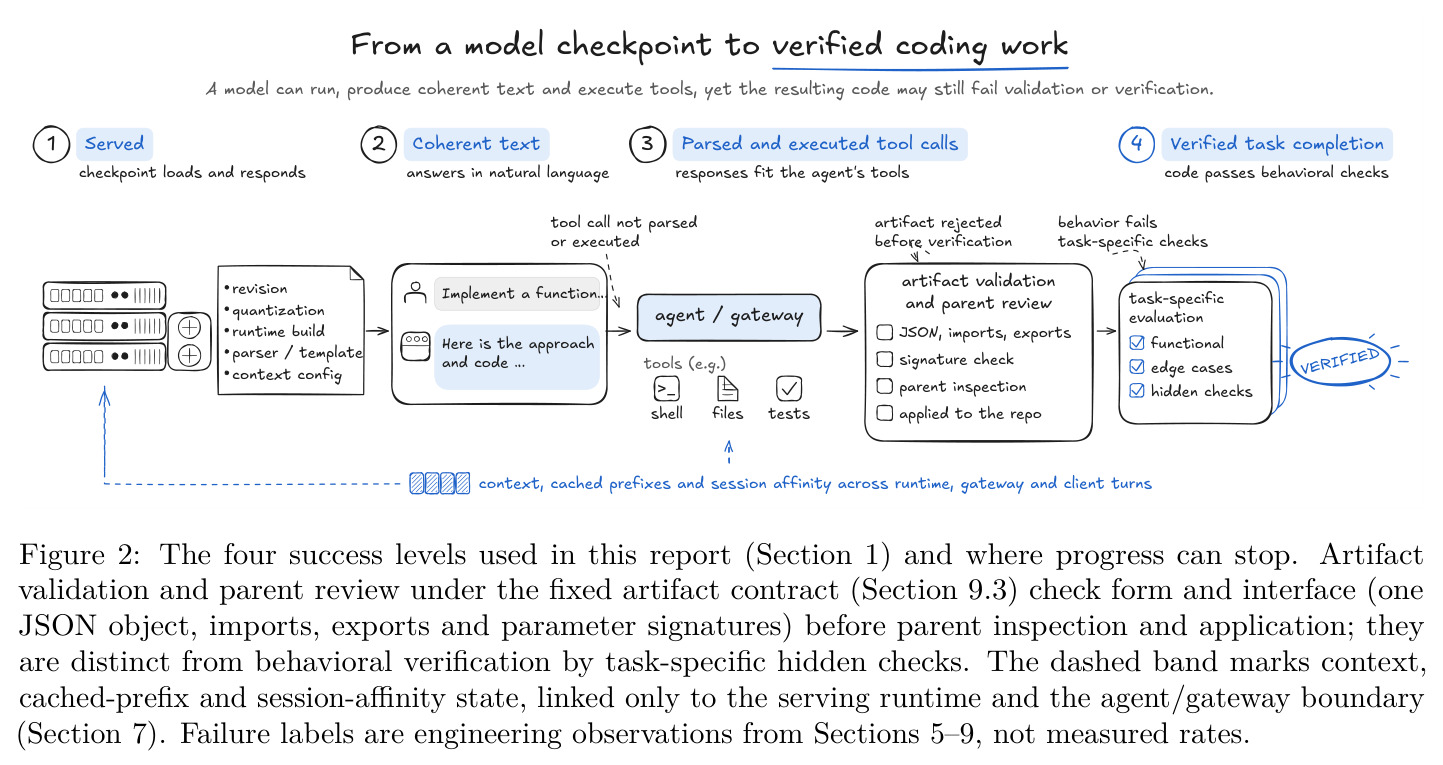
展示四级成功标准及各自的失败出口:Served(checkpoint 加载响应)→ Coherent text(自然语言回答)→ Parsed and executed tool calls(工具调用被解析执行,可能卡在解析或执行)→ Verified task completion(代码通过行为检查,此前可能被 artifact 校验或 parent 审查拒绝)。虚线带标注上下文、缓存前缀与会话亲和状态横跨 runtime、网关与客户端回合。
四级标准是全文的分析框架,所有实验结果都按这把尺子解读;理解『进度可以停在哪一级』是读懂委派研究结论的前提。