PatEx-Gym:面向专利审查新颖性评估的智能体先验技术检索框架 Novel or Not? PatEx-Gym: Agentic Prior-Art Search for Novelty Assessment in Patent Examination
首个专利审查智能体框架:百万级语料上免标注合成检索轨迹,训练出4B强基线
前置知识
现有技术(Prior Art)
专利法语境中申请日之前已公开的一切技术信息,包括在先专利、专利申请和科学论文等非专利文献(NPL)。审查员必须找到能覆盖发明权利要求特征的在先公开文献,才能以缺乏新颖性(35 U.S.C. §102)或显而易见性(§103)为由驳回申请。这类能否定新颖性的文献往往散落在数百万文档中,被称为“雪藏文献”。
本文全部任务都围绕“从大规模语料中自动发现现有技术”展开,不理解先验检索就无法理解任务定义、时间合法性约束与漏斗召回指标。
Office Action(OA,审查意见通知书)
专利审查员签发的官方文书,逐条回应权利要求、给出驳回或允许的结论、引用对比文献并说明适用法条(如 §101/102/103/112)。真实 OA 由持证审查员撰写、具有法律效力,因此可作为权威的黄金标签。本文把生成 OA 作为智能体的最终交付物。
OA 是论文“评估”环节的载体:OA 质量 Score、Decision Accuracy、Statute F1 以及引用文献的三级召回,全部针对 OA 及其参考文献进行评测。
Agentic Search 与 ReAct 模式
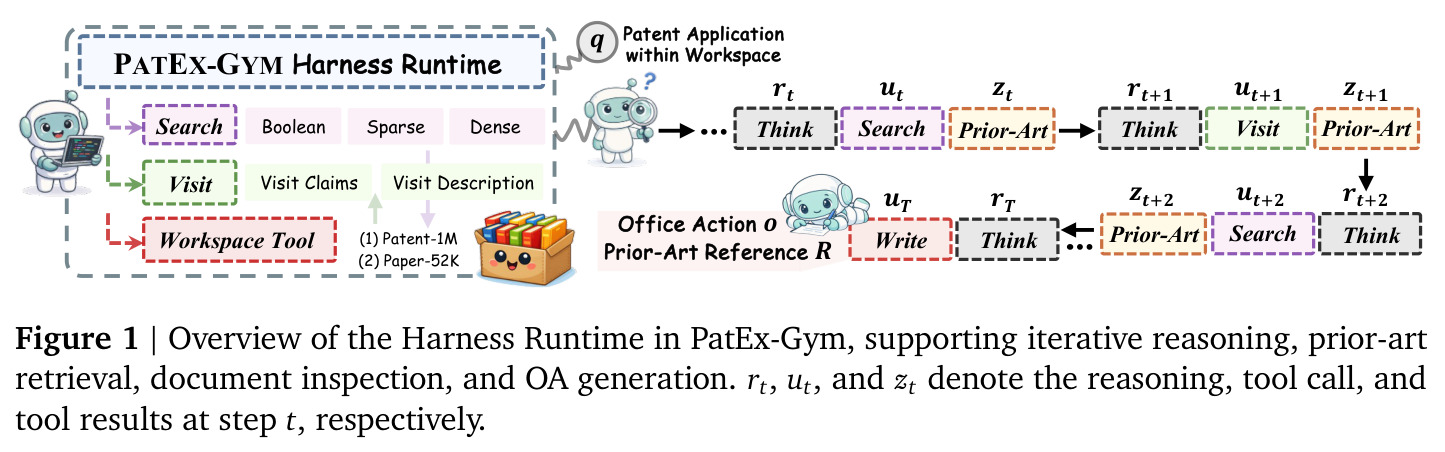
让 LLM 以“推理—行动”交替循环完成任务的范式:模型先输出思考(Think),再调用工具(Search、Visit、Read、Write),把环境返回结果并入上下文继续推理,直到产出最终答案。本文智能体在沙盒中执行 Think→Search→Visit→Write 循环,最多 50 步、最大输出 32,768 token。
论文的问题定义把轨迹 $ au_i$ 形式化为推理、工具调用与工具结果的序列,PASS 的轮次切分和多维过程评估都建立在 ReAct 式交互之上。
稀疏检索与稠密检索
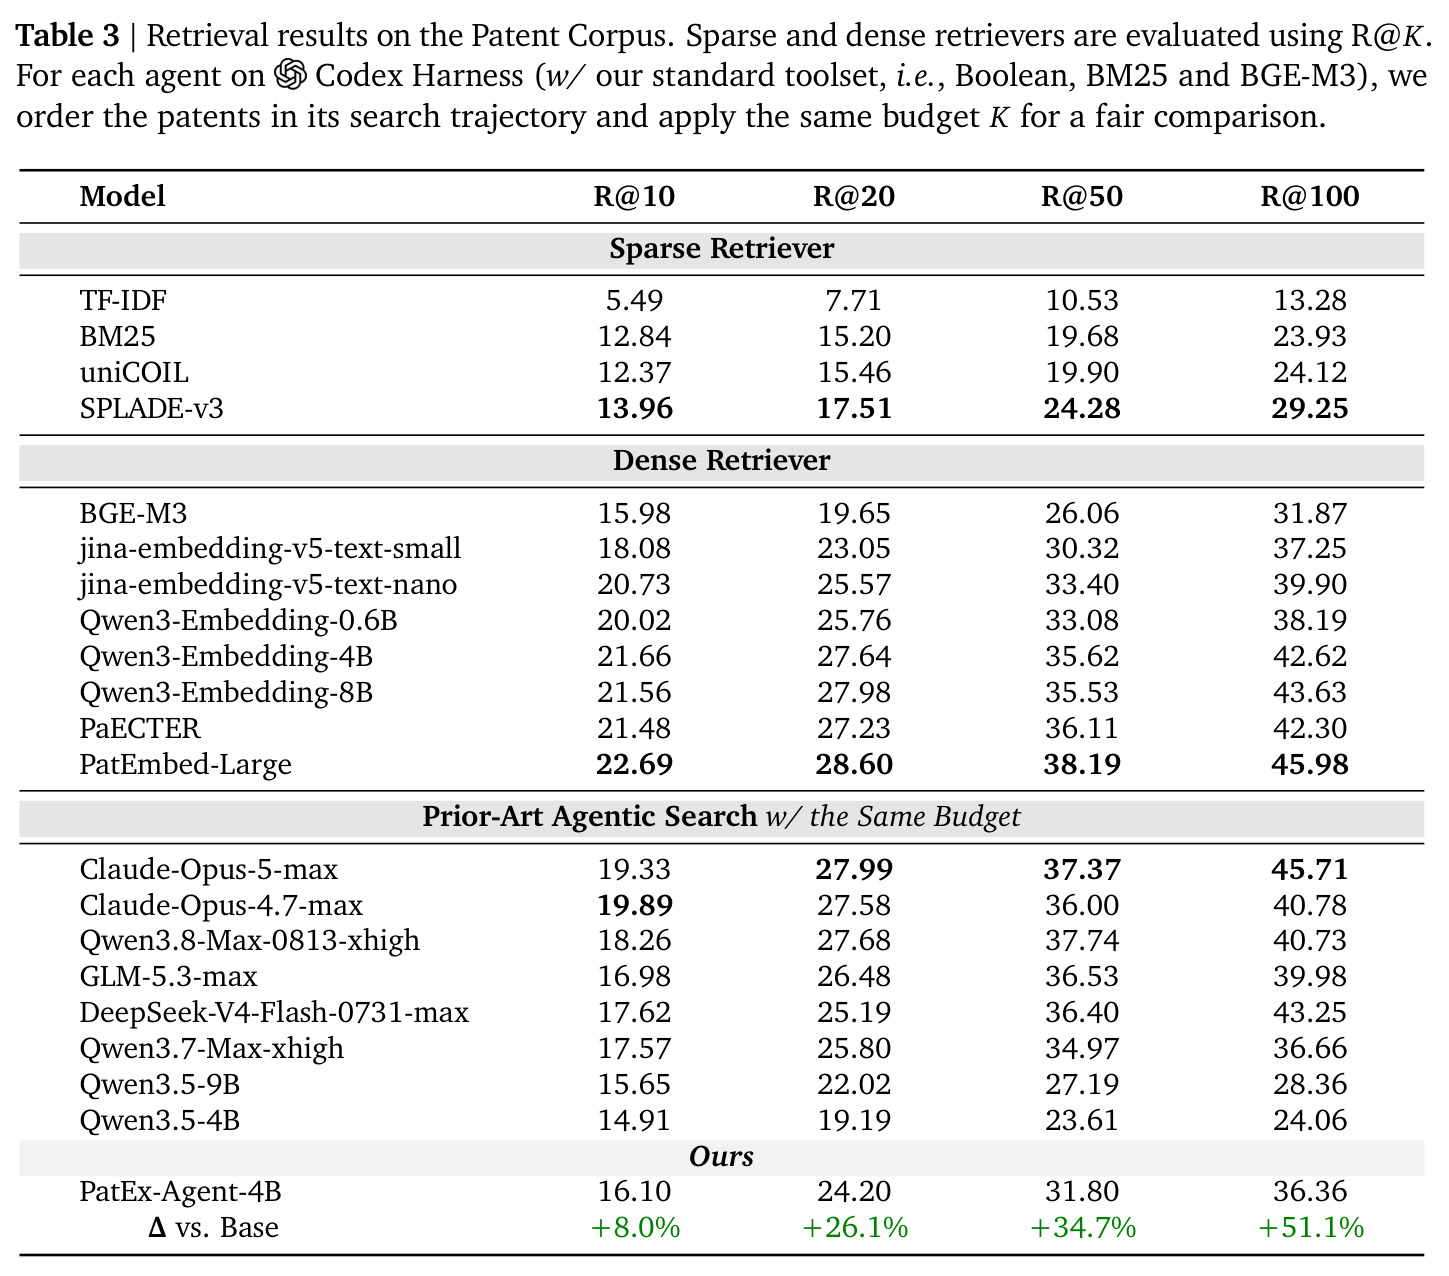
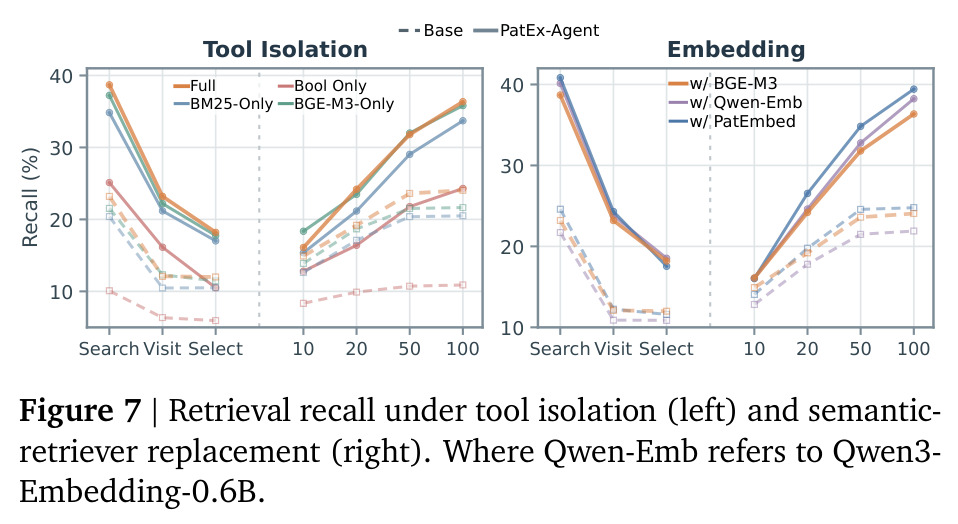
稀疏检索(BM25、TF-IDF、SPLADE、uniCOIL)基于词项匹配打分,无需语义训练、可解释性强;稠密检索(BGE-M3、Qwen3-Embedding、jina-embedding)用向量编码语义,在措辞不同但含义相近的文档上更占优。论文 Table 3 显示专利域稠密模型 PatEmbed-Large(R@100 45.98)全面碾压最强稀疏 SPLADE-v3(29.25)。
PatEx-Gym 的搜索工具由 Boolean、BM25、BGE-M3 组成,工具隔离消融与检索器替换实验的结论都依赖这一区分。
NDCG
归一化折损累计增益,衡量排序列表质量的指标:越相关的文档排得越靠前得分越高,且按位置折损。若智能体检回 20 篇候选而只访问了其中 3 篇,访问文档的排名位置就反映它把“值得深挖的证据”排到了多靠前。
PASS 的轮内质量分数 $s^{intra}$ 直接用 NDCG 在“已检索候选 vs 已访问文档”上计算,是理解轨迹筛选机制的关键。
SFT 与环境掩码
监督微调最大化模型生成目标 token 的似然。“环境掩码”指训练时把系统提示、用户输入和环境返回的工具结果 token 从损失中屏蔽,只对模型自己的输出(推理与工具调用)计算交叉熵损失,避免模型浪费容量去“预测环境行为”这类不可控目标。
公式 (9) 是 PatEx-Agent 的训练目标,理解掩码机制才能明白模型如何从教师轨迹中只学“决策部分”的搜索行为。
研究动机
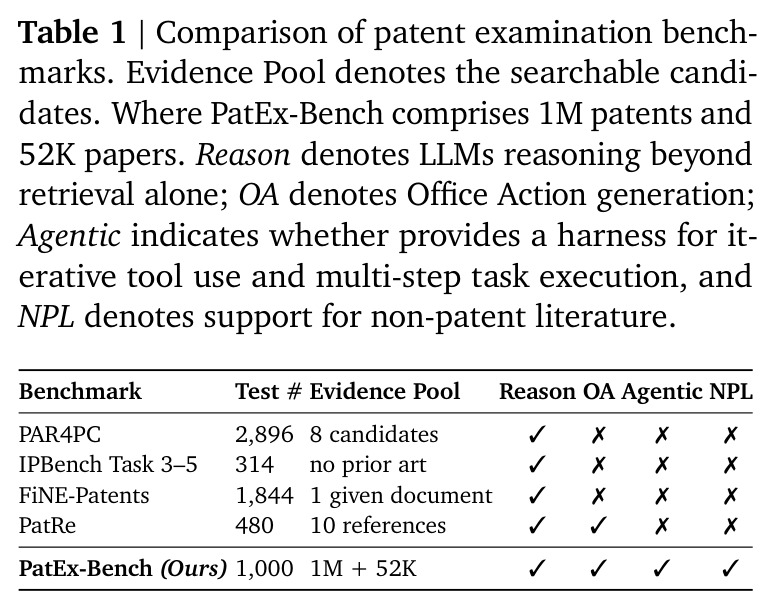
专利审查的核心是在海量现有技术中发现能否定新颖性的“雪藏文献”,但现有基准离真实场景差距很大。HUPD 把审查简化为申请是否被接受的二分类;IPBench 只有 314 个任务且不提供先验技术检索;PANORAMA 把检索、段落定位、新颖性分类拆成独立阶段,检索被限制在很小的固定候选池;FiNE-Patents 假设已给定一篇先验文档,只评特征级段落检索(1,844 任务);PatRe 有 480 个任务但只提供 10 篇已知参考文献,不支持智能体工具调用。这些设置要么假设相关文献已经找到,要么把候选池缩小到个位或十位数,完全无法考察真实的迭代式查询改写、跨语料证据发现与筛选,导致“检索到真正有用的先验技术”这一最难环节长期处于评测盲区。
本文的目标是论文要构建第一个覆盖“检索—推理—评估”完整闭环的专利审查智能体框架 PatEx-Gym,包含三部分:一是 PatEx-Bench,提供 1,000 个基于 USPTO 真实审查记录的任务,配套 Patent-1M(1,011,901 篇专利)和 Paper-52K(52,105 篇科学论文)两个大规模检索语料库,以及支持迭代搜索、文档访问与 OA 生成的 Codex 沙盒运行时;二是 PASS,一个无需人工标注的先验检索轨迹合成框架,从教师模型 1 万条 rollouts 中筛出约 3K 高质量轨迹构成 PatEx-SynData;三是训练 4B 规模的 PatEx-Agent 作为轻量基线,验证紧凑模型也能学会有效的搜索行为。整体目标是把评测从“只看最终 OA”推进到可审计的全轨迹评估,包括检索漏斗召回、法定条款识别与文书质量。
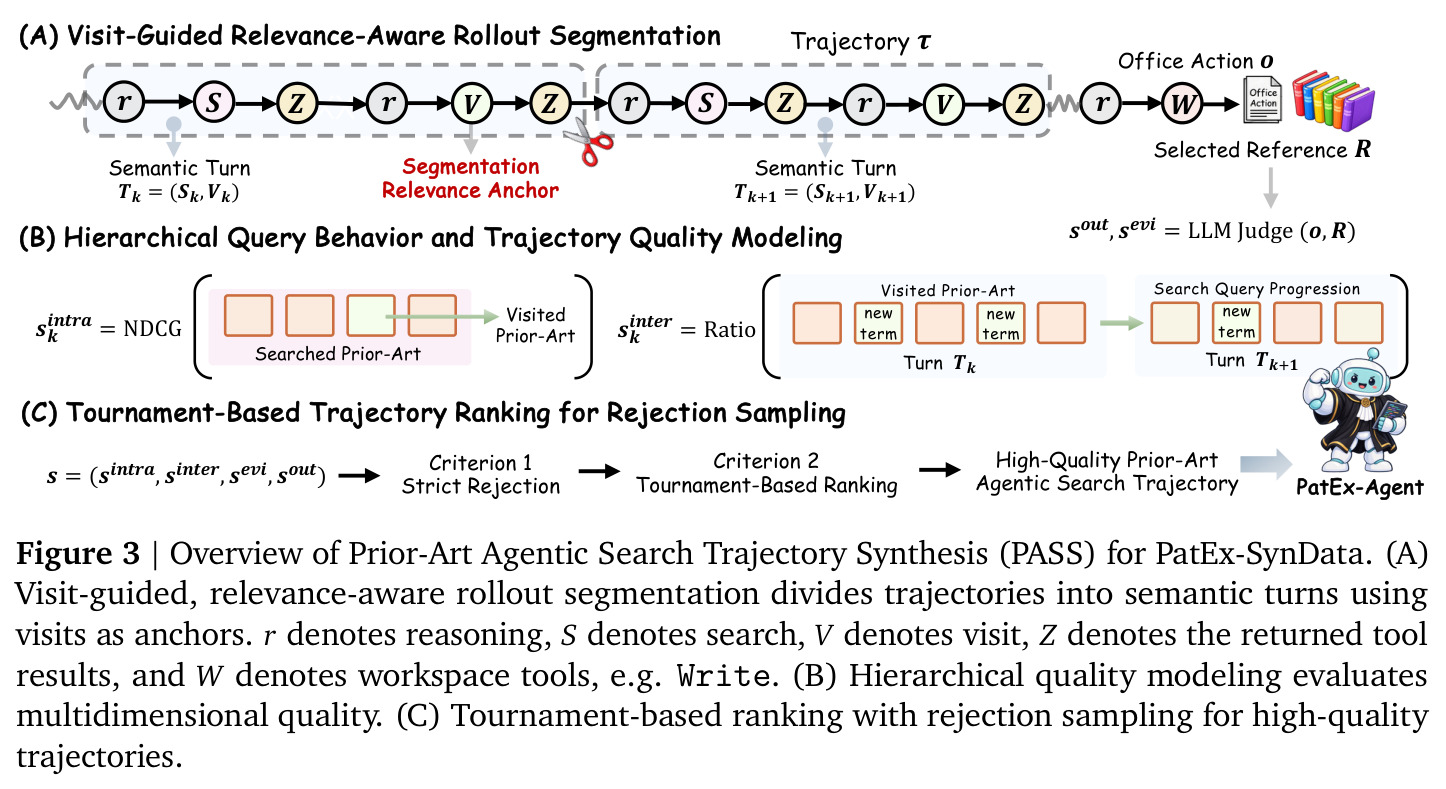
与已有工作不同的是,本文最独特的角度是把“文档访问(visit)”动作当作免费的隐式相关性信号。作者观察到在渐进式“先搜索后访问”范式中,智能体每一次 visit 都类似网络搜索中的点击反馈(类比 Joachims 2005 的点击模型),既表达了“我认为这篇候选相关”的判断,又意味着获取了更丰富的全文证据,因此可作为切分语义轮次、建模轮内检索效率与轮间查询演进的自然锚点。相比需要人工标注相关性或依赖考官引用文献做监督的方案,PASS 只用结构化专利文档就能合成并筛选训练轨迹,实现免标注扩展;评估上则首创 Search-R/Visit-R/Select-R 三级漏斗召回,把“检到—看过—最终引用”的转化过程拆开考察,而不是只看最终结论对不对。
核心方法
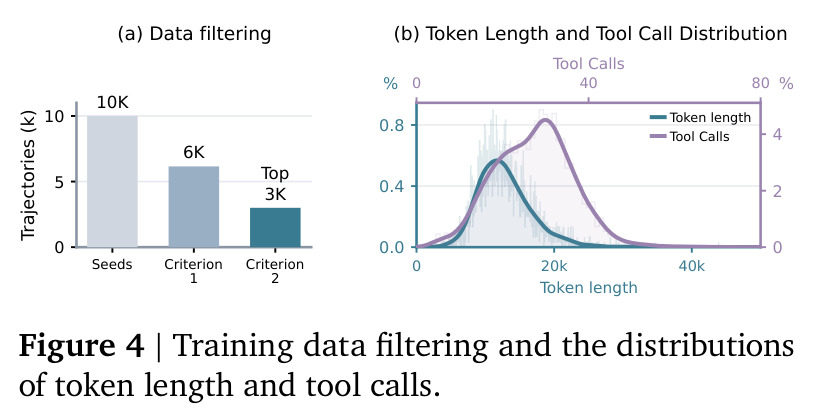
PatEx-Gym 由三个组件构成。第一,PatEx-Bench 基于 harbor 沙盒 + Codex 运行时构建隔离环境,提供 Boolean、BM25、BGE-M3 三种搜索工具和访问权利要求/说明书的 visit 工具:搜索只返回元数据、标题和摘要,全文需 visit 渐进披露;任务按 Preparation/Execution/Evaluation 三阶段隔离,评测规则对智能体不可见,并完整记录可审计轨迹。第二,PASS 用教师模型 GLM-5.3 在 1 万篇与基准不相交的种子专利上生成检索轨迹,按访问动作切成语义轮次 $T_k=(S_k,V_k)$,计算四维质量分数,经严格拒绝门留下 6,321 条,再按锦标赛排名取 top 约 3K 条构成 PatEx-SynData。第三,用 Qwen3.5-4B 做骨干,在 slime 框架上做带环境掩码的 SFT,8 张 H20 训 3 个 epoch,学习率 $1\times10^{-5}$。
核心创新是把不可见的过程质量变成可计算的监督信号。PASS 对每条轨迹算四个维度:轮内分数 $s^{intra}$ 用 NDCG 衡量检索候选中被访问文档的排序效率,即“把值得深挖的候选排到前面”的能力;轮间分数 $s^{inter}$ 由 LLM 判断查询是否基于上一轮访问到的新证据引入了新概念,而非对旧查询换汤不换药;证据分数 $s^{evi}$ 检查 OA 中针对每篇选中参考文献的论述是否被其实际访问过的段落支撑;结果分数 $s^{out}$ 在没有标准答案的情况下让 LLM 评估每个权利要求是否被显式回应、法定驳回理由是否有证据支撑。与把分数加权成单一标量不同,PASS 保留分数向量结构,用锦标赛式两两比较——在 $|D|=4$ 个维度中严格多数胜出即赢,$\sum_{d}\mathbb{I}[s_i^d>s_j^d]>|D|/2$——统计总胜场 $W_i$ 做拒绝采样,使不同失败模式保持可区分。
方法步骤详情
流程分五步。第一步数据构建:从 USPTO 审查记录取每件申请的首次 OA 与原始申请文件,得 1,000 个任务、覆盖 8 个 IPC 大类,共 2,946 篇考官引用专利 + 178 篇引用论文(均值 2.95 篇/件);施加时间约束 $C_i=\{e\in C \mid d_e<d_i\}$,只许检索申请日前公开的文献。第二步轨迹合成:GLM-5.3 在 Codex 环境生成 1 万条轨迹,教师看不到评测标准。第三步质量过滤:按 visit 切轮次,计算 $(s^{intra},s^{inter},s^{evi},s^{out})$;严格拒绝门要求产出 OA 与参考文献且不超预算,通过 6,321 条;按式 (7)(8) 锦标赛排名取 top 约 3K。第四步训练:$\mathcal{L}_{SFT}=-\sum_{t}\sum_{j}\log p_\theta(a_t^{(j)}\mid a_{<t}^{(j)},\tau_{<t})$ 只对模型输出 token 计损失。第五步评测:$\text{Score}=\frac{1}{6}F_i+\frac{5}{6}Q_i\times10$,另报 Dec、Stat F1 与 Search-R/Visit-R/Select-R 漏斗召回。
技术新颖性
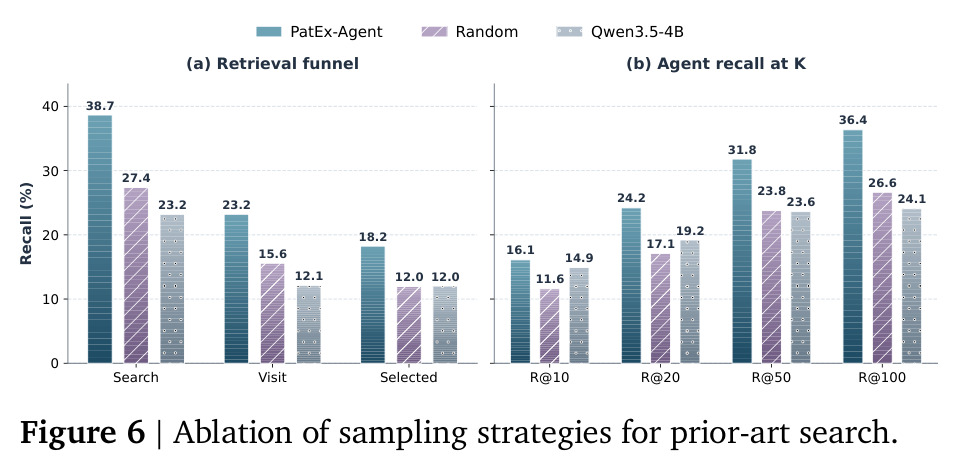
与已有工作的本质区别有三点。其一,评测范式上首次把专利审查当作开放语料上的智能体检索任务:Table 1 显示此前最完整的 PatRe 也只给 10 篇固定参考文献、不提供智能体运行时,而 PatEx-Bench 提供 1M+52K 证据池并支持多步工具调用与 OA 生成。其二,训练数据不依赖考官引用做监督:以往轨迹合成要么需要可验证答案,要么依赖人工标注,PASS 用访问行为做隐式反馈即可给轨迹打分,理论上可扩展到任意结构化专利集合。其三,质量建模拒绝把多维质量坍缩成标量,锦标赛排名保留分数向量结构。消融实验证明这条路有效:随机采样 3K 条轨迹训练后 R@10 从 14.9 跌到 11.6(-22.1%)、Select-R 仅 11.96,而 PASS 筛选的轨迹让 Select-R 达到 18.24(+51.6%),说明收益来自质量评估而非微调本身。
实验结果
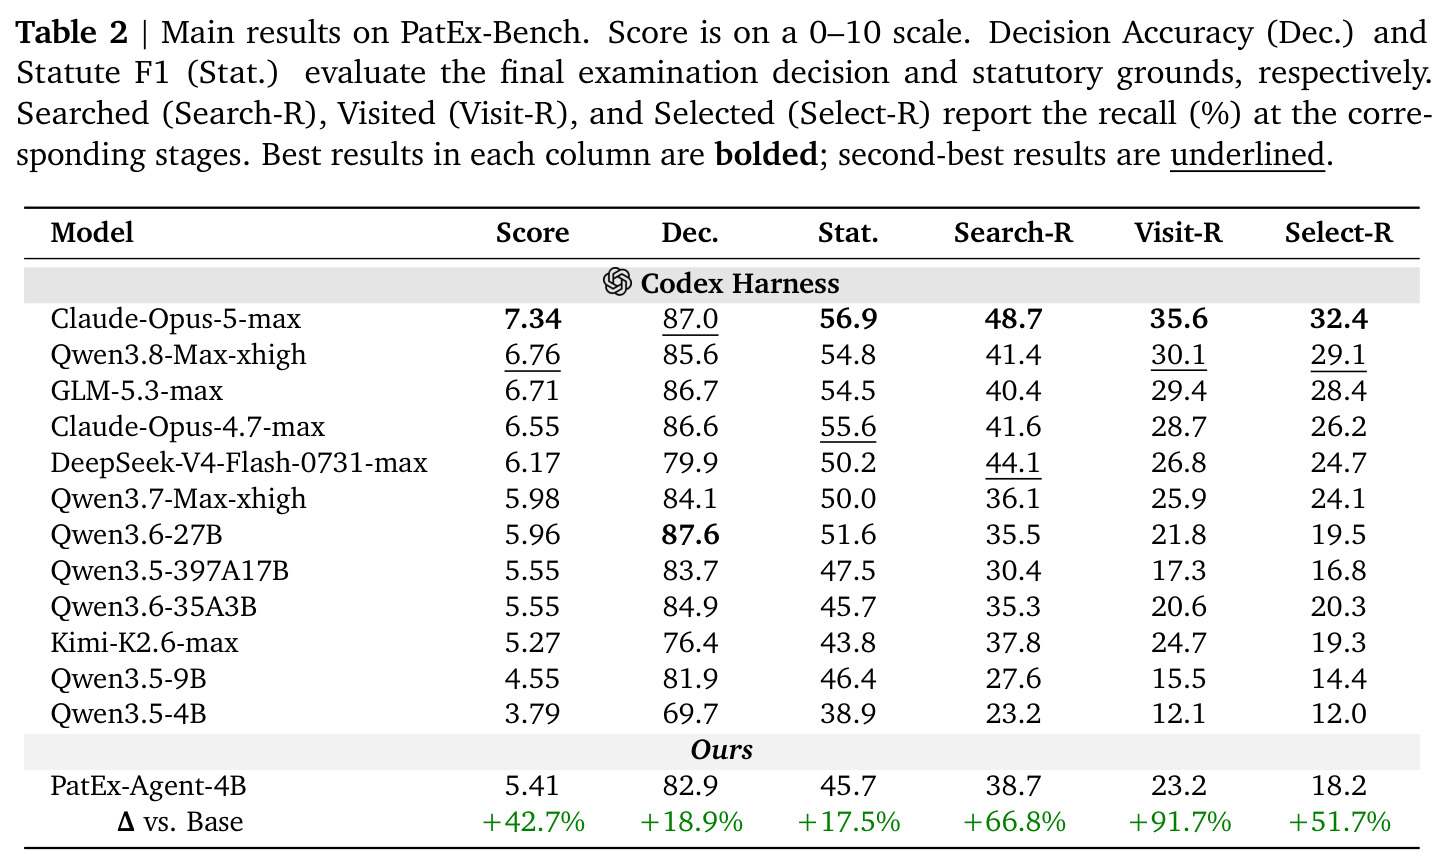
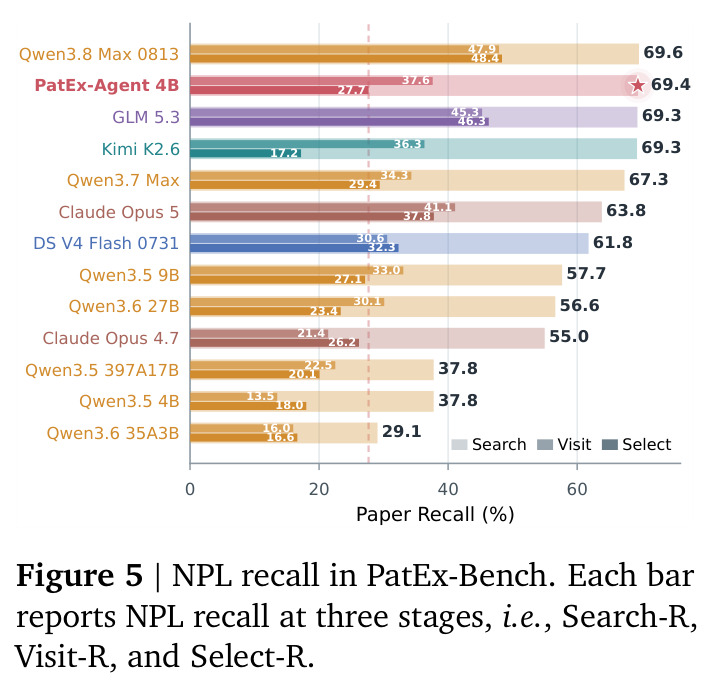
主实验(Table 2,13 个模型)有三层发现。第一,前沿模型也搞不定先验发现:Claude-Opus-5-max 全面领先——Score 7.34、Dec 87.0、Stat 56.9、Search-R 48.7、Select-R 32.4,但最强 Search-R 不到 50%。第二,4B 专用模型能打:PatEx-Agent-4B 相对骨干 Qwen3.5-4B 全面提升——Score 3.79→5.41(+42.7%)、Dec 69.7→82.9(+18.9%)、Stat 38.9→45.7(+17.5%)、Search-R 23.2→38.7(+66.8%)、Visit-R 12.1→23.2(+91.7%)、Select-R 12.0→18.2(+51.7%),Search-R 超过 397B MoE 的 Qwen3.5-397A17B(30.4),与 Qwen3.7-Max(36.1)相当。第三,单一指标会骗人:Dec 最高的 Qwen3.6-27B(87.6)Score 仅 5.96,两者 Kendall τ 仅 0.550;三位 LLM 裁判一致性 Kendall W=0.849。检索对比(Table 3):稠密碾压稀疏,PatEmbed-Large R@100 达 45.98 最佳,最强稀疏 SPLADE-v3 仅 29.25;PatEx-Agent 的 R@100 从 24.06 提到 36.36(+51.1%)。消融显示随机采样 3K 轨迹使 R@10 从 14.9 跌至 11.6(-22.1%),PASS 筛选则把 Select-R 提到 18.24;Boolean-only 下 PatEx-Agent Search-R 达 25.12(+149.2%)。NPL 上(Figure 5)其论文 Search-R 69.4 几乎追平 Qwen3.8-Max 的 69.6。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 专利审查综合评测(PatEx-Bench:OA 生成 + 决策 + 检索漏斗) | Score(0-10 综合) | PatEx-Agent-4B 达 5.41 | 骨干 Qwen3.5-4B 为 3.79;最强前沿 Claude-Opus-5-max 为 7.34 | 较骨干 +42.7%,达到约 30B 参数模型的水平 |
| 先验技术检索(考官引用专利的检回率) | Search-R (%) | 38.7 | Qwen3.5-4B 为 23.2;Claude-Opus-5-max 为 48.7 | +66.8%,超过 Qwen3.5-397A17B(30.4),与 Qwen3.7-Max(36.1)持平 |
| 证据筛选(考官引用文献最终被写进 OA 的比例) | Select-R (%) | 18.2 | Qwen3.5-4B 为 12.0;Claude-Opus-5-max 为 32.4 | +51.7%,但与最强模型仍有明显差距 |
| Patent-1M 大规模专利语料检索(同预算排序对比) | R@100 (%) | 36.36 | Qwen3.5-4B 为 24.06;最佳专用检索器 PatEmbed-Large 为 45.98 | +51.1%,且越深的 cutoff 增益越大(R@10 仅 +8.0%) |
| 非专利文献(NPL/科学论文)检索 | Paper Search-R (%) | 69.4 | Qwen3.8-Max-0813-xhigh 为 69.6 | 4B 模型几乎追平前沿大模型,Visit-R 37.6、Select-R 27.7 亦具竞争力 |
局限与改进
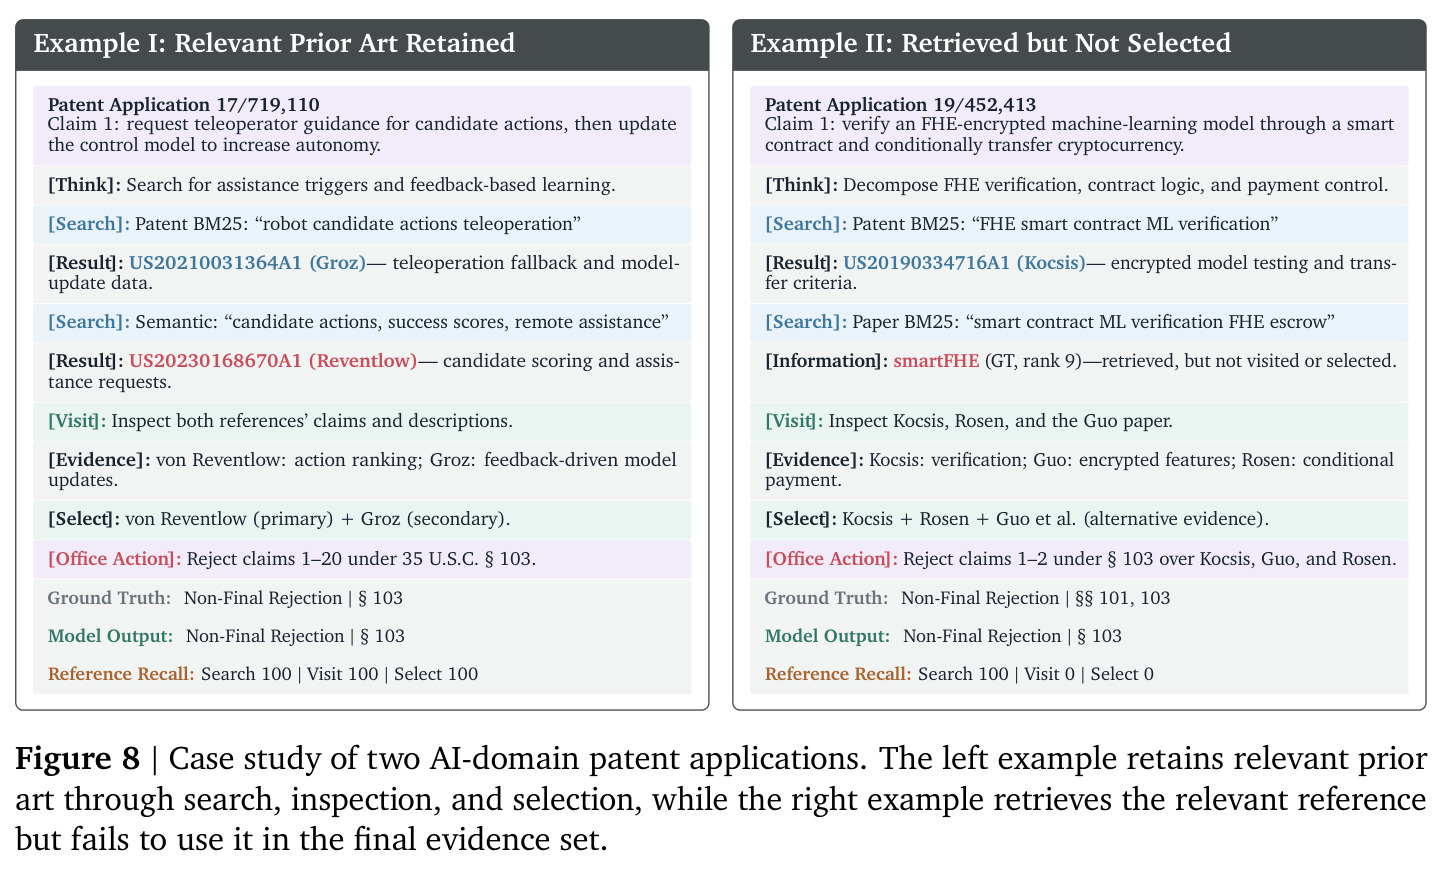
作者承认并可从实验读出的局限:其一,证据筛选仍是硬骨头,最强模型 Select-R 也只有 32.4%,PatEx-Agent 的 18.2% 说明“检到但不用”的漏斗断裂普遍存在——Figure 8 右侧案例就是检索到 oracle 文献(Search 100)却 Visit 0、Select 0 的典型失败。其二,语料构造要求每条考官引用都能在两个语料库中检回,筛选可能偏向易检索文献;NPL 语料仅 52,105 篇论文,远小于真实学术库,69.4 的 Paper Search-R 可能偏乐观。其三,数据全部来自 USPTO 首次 OA,只覆盖美国法条(§101/102/103/112)与单轮审查,未含 EPO/CNIPA 及“OA—申请人答复”的循环。其四,OA 质量与部分质量分数依赖三个 LLM 裁判(Claude-Opus-4.7、Gemini-3.5-Flash、GPT-5.5),评审偏好可能影响 Score;PASS 的 $s^{out}$ 也是 LLM 打分,教师模型的风格偏差可能被蒸馏进 4B 学生。
独立分析的弱点
独立分析几处弱点。第一,PASS 的结果分数 $s^{out}$ 在无标准答案的情况下让 LLM 判断驳回是否有据,可能奖励“看起来严谨但法条引用错误”的轨迹,建议用少量考官引用文献做锚定校验,或在严格拒绝门后追加法律条款一致性核查。第二,证据选择没有专门的训练信号,Select-R(18.2)显著落后 Search-R(38.7),可在 PASS 分数上派生轮级奖励做多轮强化学习(Search-R1/GRPO 式),或对“检索到却未访问/未引用”构造对比负样本做 DPO。第三,工具消融显示 Boolean-only 下基线 Search-R 崩到 10.08,而 PatEx-Agent 达 25.12,说明其查询构造能力仍强依赖稠密检索器;若部署环境只有关键词系统,专有查询技能可能迁移不动。第四,所有模型共享 Codex 框架的原生上下文压缩机制,不同模型对长上下文的利用差异可能混淆“能力差异”与“框架适配差异”,缺少去掉压缩机制的对照组。第五,1,000 个任务的规模对训练集与基准不重叠的结论支撑尚可,但对细粒度 IPC 大类分析而言每个大类的样本量偏小。
未来方向
可以延伸的方向:第一,SFT 之后接强化学习,把三级漏斗召回(尤其 Select-R)设计成可验证奖励做多轮 RL,直觉上最能攻“检而不用”的瓶颈;第二,把任务扩展到完整起诉周期——OA、申请人答复、后续 OA 的多轮对抗(与 PatRe 生命周期衔接),甚至模拟考官—申请人博弈;第三,跨法域(EPO、CNIPA)与跨语言迁移,检验 4B 学到的搜索行为是否语言无关;第四,扩大教师合成规模(1 万→10 万种子)并测试更强的教师能否继续抬升 4B 上限;第五,把 PatEx-Gym 当作通用 deep research 压力测试场——论文明确指出其横跨 8 个 IPC 大类的异构科技领域特性,适合评估通用搜索智能体的查询自适应与证据整合;第六,检索器与智能体联合优化:消融显示换上更强的 PatEmbed-Large 后基线 Select-R 反而从 12.0 微降到 11.6(相似候选更多导致选择更难),“检索质量 vs 选择难度”的权衡值得专门建模;第七,引入 reranker 或多跳引文扩展工具,缩小与 PaperScout 式学术检索的差距。
复现评估
复现条件中等偏上。有利因素:数据全部来自公开渠道(USPTO 审查记录、Google Patents、Google Scholar),构建流程描述完整,且作者验证了每条考官引用都可从两个语料库检回;训练用 slime 框架并提供了可复现配置,8 张 H20 训 3 个 epoch 对 4B 模型属于中等算力;评测协议写得具体(Codex v0.151.0、温度 1.0、最大输出 32,768 token、50 步上限、裁判温度 0 与 8,192 token 上限)。不利因素:教师模型 GLM-5.3 生成 1 万条轨迹、主表评测需调用 Claude-Opus-5/4.7、GLM-5.3、DeepSeek-V4 等前沿 API,且打分需三个 LLM 裁判各评 5 个维度,API 成本高;Patent-1M + Paper-52K 的检索索引(BM25 + BGE-M3)构建与托管工作量不小。论文提供官网与代码入口,数据与轨迹声称可获取,整体属于“有诚意但需要 API 预算”的复现难度。
论文图表
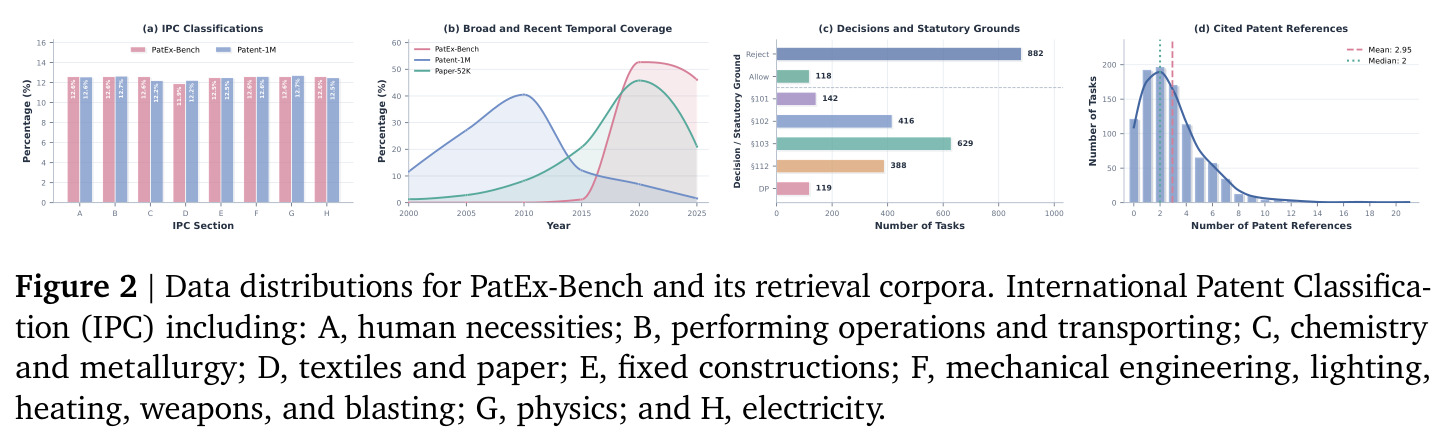
四个子图分别展示:(a) 任务在 8 个 IPC 大类(A 人类必需品到 H 电学)上的分布;(b) 2000-2025 年间语料的宽时间覆盖;(c) 最终决策分布(驳回约 88% vs 授权约 12%)与法定条款分布(§103 约 629、§102 416、§112 388、§101 142、DP 119);(d) 每件任务考官引用专利数的直方图,均值 2.95、中位数约 2,最多约 20 篇。
证明基准的真实性与难度:跨大类、跨年份、以 §103 显而易见性驳回为主、引用文献稀疏(均值不到 3 篇),这正是“在百万语料中找几根针”的任务设定依据。