基于能量的基础模型:可扩展的预训练新架构 OpenESM: Energy-Steered Models Are Scalable Foundation Learners
用能量引导优化隐状态后再生成的能量基础模型,26项任务上超越GPT且扩展更高效
前置知识
能量模型(EBM)
能量模型是一类不直接参数化归一化概率分布的模型:它为每个候选解输出一个标量"能量",通过学习使好的解能量低、坏的解能量高来隐式定义分布。由于能量不需要配分函数归一化,EBM 能灵活建模复杂依赖与约束,已应用于模式识别、结构化预测、机器人控制和序列规划等领域。推理时通常需要在能量地形上搜索或采样(如 MCMC)寻找低能量解。
本文的核心就是把 EBM 从"单一领域的评审器"升级为通用基础模型:理解 EBFM 必须先掌握能量函数、能量地形和"低能量=好解"这一基本范式,否则无法理解能量引导这一关键机制。
MCMC 与基于梯度的采样
对于只给出未归一化能量 $E(x)$ 的分布,无法直接采样,常用马尔可夫链蒙特卡洛方法:从初始点出发反复沿能量负梯度加噪声更新(Langevin 动力学 $z_k = z_{k-1} - \alpha\nabla_z E + \sqrt{2\alpha}\,\epsilon$),使链逐步收敛到低能量区域。步长 $\alpha$ 控制更新幅度,步数 $K$ 决定优化深度;实践中去掉噪声的确定性梯度下降也常被使用以求稳定。
EBFM 的能量引导正是用 K 步(论文中取 K=1)对潜变量 $z$ 做梯度下降来近似求解 $\arg\min_z E(x,z|\theta)$,这是推理和训练中反复出现的核心操作。
Scaling Law 与 IsoFLOP 分析
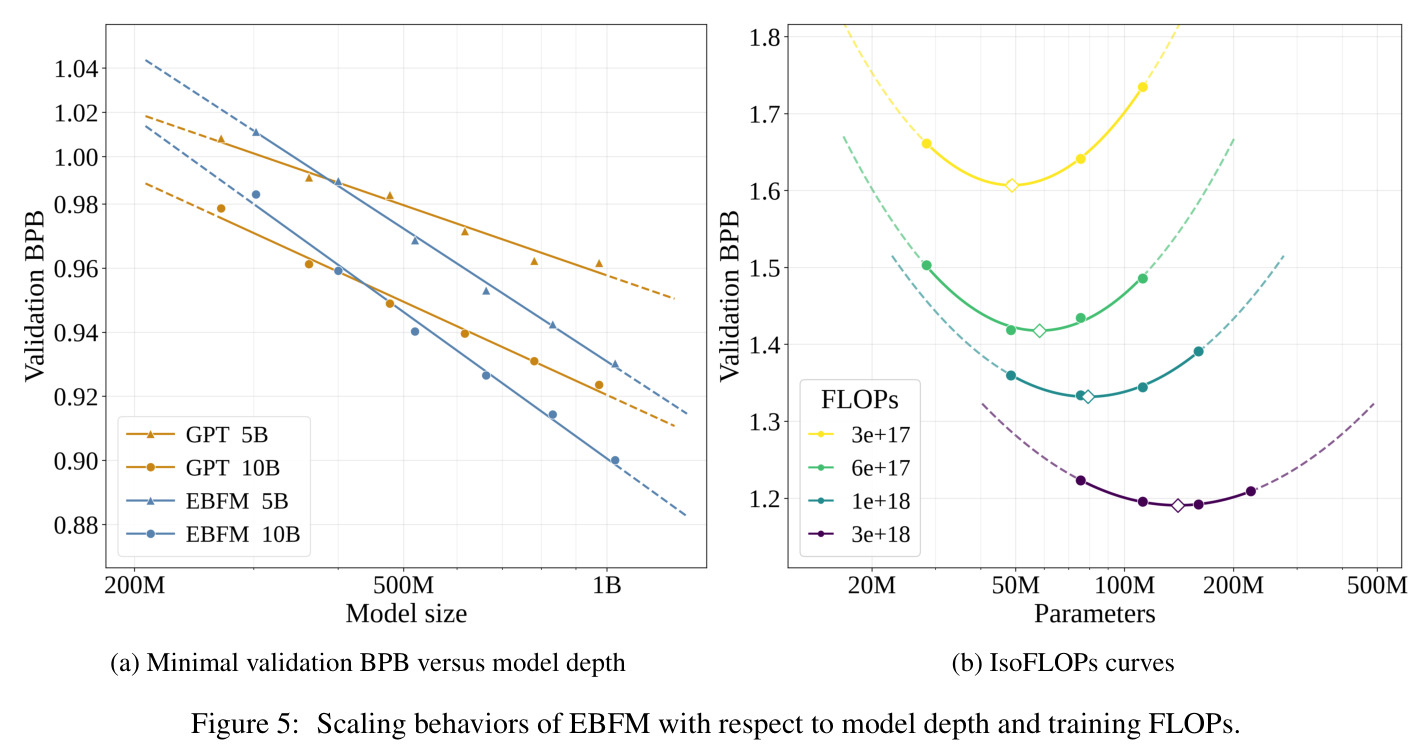
Scaling law 研究验证损失如何随参数量、训练 token 数和计算量变化,在对数坐标下通常近似为幂律。IsoFLOP 分析固定训练 FLOPs,画出不同模型规模的损失曲线,U 形曲线的最低点即该算力预算下的"计算最优"模型大小;随预算增大,最优点会向"更大模型+更多数据"方向移动,这是 Chinchilla 等工作的经典结论。
本文的主要证据就是 EBFM 在训练 token、模型参数和 IsoFLOP 三个维度上的扩展曲线均优于 GPT,只有理解这些曲线的读法才能判断其结论是否成立。
BPB(bits per byte)
BPB 是归一化的语言建模验证误差:$\mathrm{BPB} = \log_2 \mathrm{PPL} / (\text{每 token 平均字节数})$,其中 PPL 是词表上的困惑度。除以字节数抵消了不同 tokenizer(词表大小、压缩率)带来的差异,使不同模型/分词器之间的损失可以直接比较,数值越低越好。GPT-3、OLMo 等工作的 scaling 实验普遍采用该指标。
论文所有预训练、SFT 和零样本生成的核心指标都是 BPB,且 EBFM 与 GPT 使用同一 tokenizer(Nanochat),BPB 是判断"EBFM 是否真的更好"的主要量化依据。
潜变量与 test-time 计算
潜变量是模型内部不直接对应输出的辅助变量,推理时可对它做迭代优化,相当于把额外算力花在"思考"上而非一次性前向传播。类似思想见于扩散模型的迭代去噪和隐式思维链:更多迭代步数换来更精炼的中间表示,从而提升预测质量,代价是推理延迟随迭代次数增加。
EBFM 的潜变量 $z$ 在每个生成步都要先经过能量引导精炼、再用于预测 token,本质是把 test-time compute 兑换成质量,这是它与 GPT 最根本的行为差异。
研究动机
现有能量模型几乎都困在单一任务或单一领域:有的只在特定数据分布上做表征学习,有的只做特定任务的结构化理解与预测,还有的只用于专用环境中的机器人控制与序列规划。它们天然是"评审器"——对候选解输出一个标量能量分,而不是直接产出结构化输出;若想在语言生成中使用,就需要枚举整个词表寻找最低能量解,这在计算上完全不可行(词表数万级,逐 token 决策还会组合爆炸)。与之相对,GPT 类自回归模型和扩散语言模型(DLM)已通过大规模预训练证明了跨异构任务的泛化能力。因此"EBM 能否成为通用基础模型"仍是悬而未决的基本问题,而且把能量评估能力嫁接到 token 生成上也绝非易事。
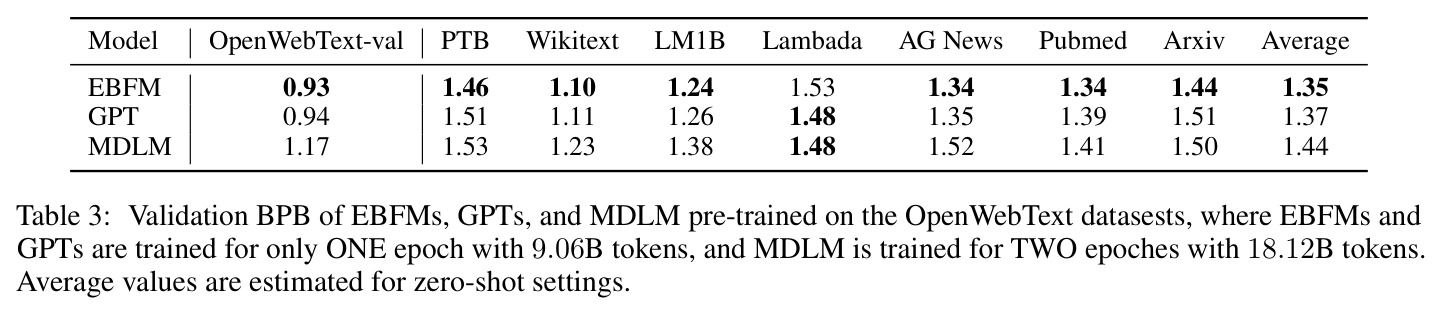
本文的目标是本文的目标是设计并验证一种把能量引导与 token 生成统一在单一架构中的基础模型 EBFM,并系统回答三个问题:一、EBFM 在大规模预训练下是否具有不差于甚至优于 GPT 的扩展行为;二、在零样本设置下能否在跨领域下游任务上稳定超越 GPT;三、能量评估与生成的结合能否带来数据效率优势。为此作者在 Fineweb、Climbmix、DCLM 三个大规模语料上预训练了深度 12/20/26(参数量约 268M 到 1.03B)的系列模型,用 BPB 衡量扩展性,在 19 个零样本问答任务和 7 个零样本生成评测集共 26 个下游任务上评估,并完全开源权重与训练设施供社区复现和扩展。
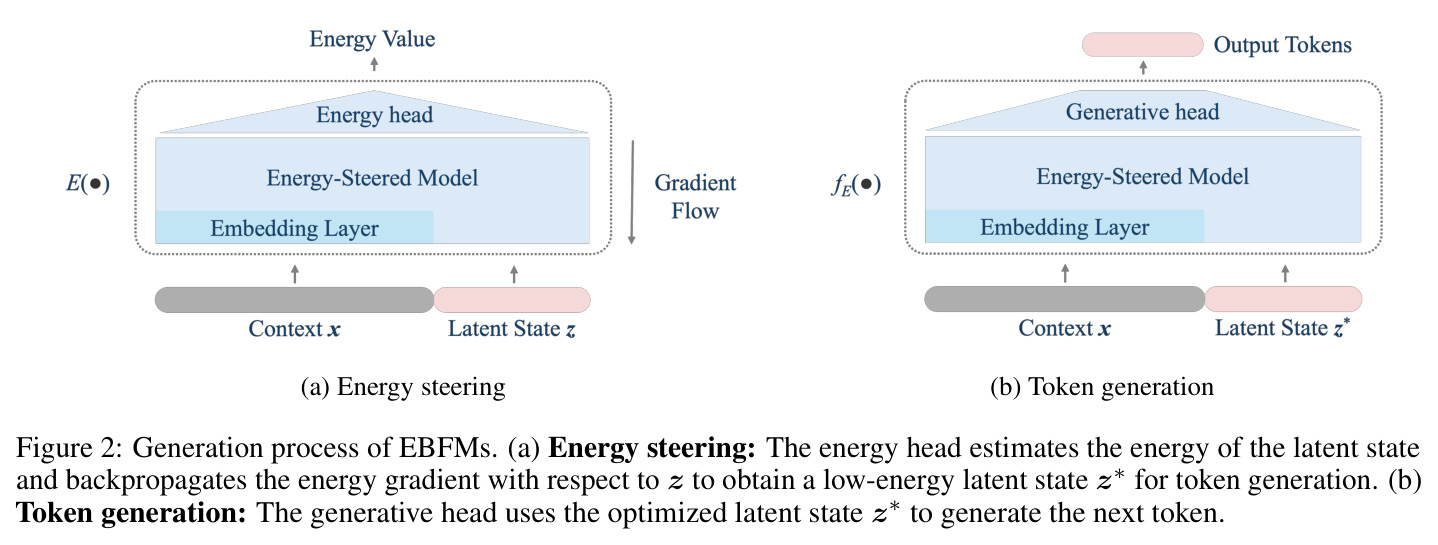
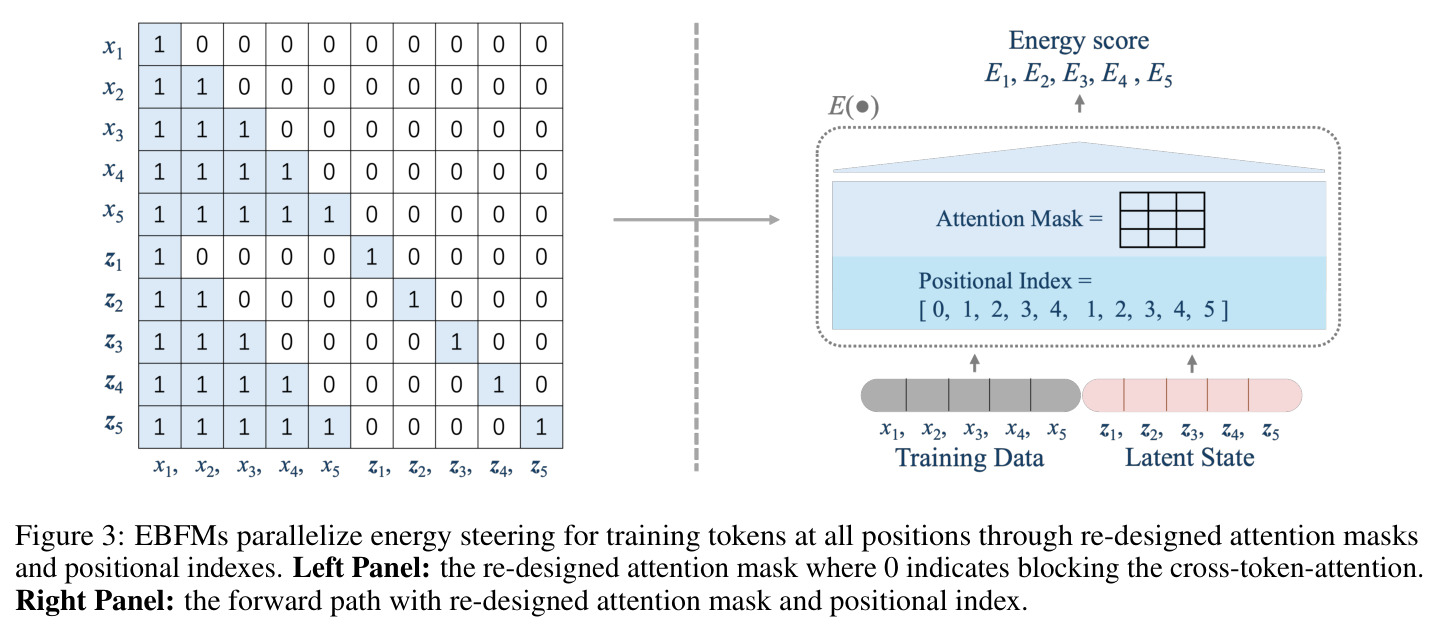
与已有工作不同的是,本文的独特切入是把 EBM 从"独立评审器"变成"生成模型的内循环优化器":不是用能量函数直接挑选输出 token,而是让它引导一个潜变量 $z$ 走向低能量区域,再用精炼后的 $z$ 参与下一 token 的预测——相当于把推理时算力显式花在隐表示的梯度下降上。与扩散语言模型"并行去噪整块 token"不同,EBFM 保持自回归生成但每步先优化隐状态;与 GPT"单次前向直接映射到输出分布"不同,EBFM 在上下文与输出之间插入了一个可优化的隐变量。真正让这件事在大规模预训练中可行的,是作者重设计的注意力掩码与位置索引,使全部 $S$ 个位置的 MCMC 引导能在一次前向中并行完成。
核心方法
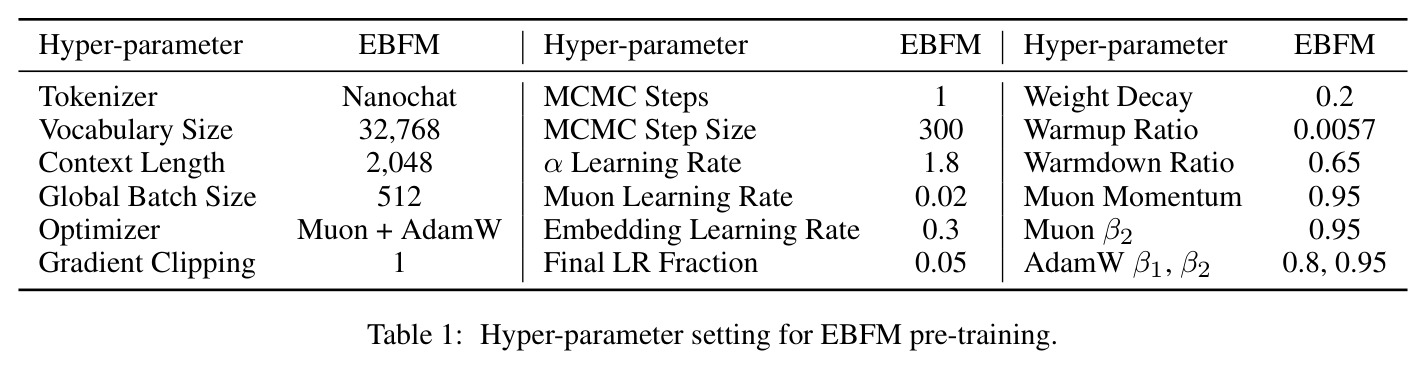
EBFM 由一个共享的 Transformer 骨干加两个头组成:能量头是线性层,对上下文 $x$ 和潜变量 $z\in\mathbb{R}^D$ 输出标量能量 $E(x,z\mid\theta)$;生成头是 embedding 层加 softmax,输出词表 $V$ 上的下一 token 分布 $f_E(x,z\mid\theta)$。直觉上,模型学到一个能量地形,"与上下文一致、利于预测下一 token"的隐状态对应低能量。推理分两步:先做能量引导,把从 $z_0\sim\mathcal{N}(0,I)$ 出发的 $z$ 用 $K$ 步梯度下降推向低能量区域;再用 $z^*$ 生成 token。预训练遵循 GPT-2 式深度-宽度联动缩放:深度 $d\in\{12,20,26\}$,隐藏宽度 $d_{model}=64d$,头数 $d_{model}/128$,最大 d26 约 1.03B 参数;Nanochat tokenizer(词表 32768、上下文 2048)、全局 batch 512、Muon+AdamW 混合优化器,能量引导仅 1 步 MCMC。
核心创新在于把"能量最小化"变成插在 next-token prediction 之前的 test-time 表示精炼步骤。GPT 直接从上下文一次前向映射到输出分布,表达能力被限制在一次前向计算里;EBFM 则引入潜变量 $z$,模型通过能量头学会评判 $z$ 与上下文的兼容性,生成前先迭代优化:$z_k = z_{k-1} - \alpha\nabla_{z_{k-1}} E(x, z_{k-1}\mid\theta)$。与已有 EBM 的本质区别是:传统 EBM 只做评估(结构化预测、控制、规划),无法直接生成,而 EBFM 用同一个骨干同时承担评估与生成,让能量评估真正服务于 token 生成,从而可以靠大规模预训练获得通用能力。另一个关键设计是训练时完全去掉 MCMC 的随机噪声、只用确定性梯度更新,作者发现在大规模预训练中这样优化更稳定。
方法步骤详情
第一步(训练时并行能量引导):把序列 $x_{[1:S]}$ 与各位置潜变量拼成 $[x_{[1:S]}, z_{[1:S]}]$ 单次前向,能量头同时输出 $E_1,\dots,E_S$;注意力掩码使 $z_i$ 只关注前缀 $x_{[1:i-1]}$ 和自身;$z_i$ 位置索引取 $1,\dots,S$ 对齐预测位。第二步:对总能量 $\sum_i E_i$ 做 $K$ 步并行梯度下降(Eq. 6)得 $z^*_{[1:S]}$,取 $K=1$。第三步(监督训练):生成头算 $p(x_{[2:S+1]})=f_E(x_{[1:S]}, z^*_{[1:S]};\, x_{[2:S+1]}\mid\theta)$,最小化 $\mathcal{L}(\theta)=-\log f_E(\cdot)$,每 batch 依次"更新潜状态→估计损失→更新 $\theta$"。推理时(Algorithm 1)采样 $z_0\sim\mathcal{N}(0,I)$,$K$ 步引导后输出 $\hat{x}_{S+1}\sim f_E(x,z^*\mid\theta)$。
技术新颖性
技术新颖性体现在四个层面。架构上,这是首批把能量引导与自回归 token 生成统一进单一 Transformer、并能做十亿级参数预训练的工作,打破了"EBM 只能当 critic"的定式。算法上,序列级并行能量引导是关键工程贡献:逐位置串行跑 MCMC 在长序列上开销不可接受,作者通过定制注意力掩码(潜变量间互不可见、各自只看前缀)加位置索引重排,把 $S$ 次独立优化折叠成一次批处理前向,使 MCMC 内循环可以嵌入每一步训练而不拖垮效率。实证上,论文首次为 EBM 类架构给出系统的 scaling law(数据、参数、IsoFLOP 三个维度),此前文献几乎只在小规模单域任务上评估 EBM。细节上,去掉 Langevin 噪声的确定性下降、以及仅 1 步 MCMC 即可工作的设置,说明能量引导的收益主要来自"梯度方向对齐"而非精细采样,这对后续复现与改进很有启发。
实验结果
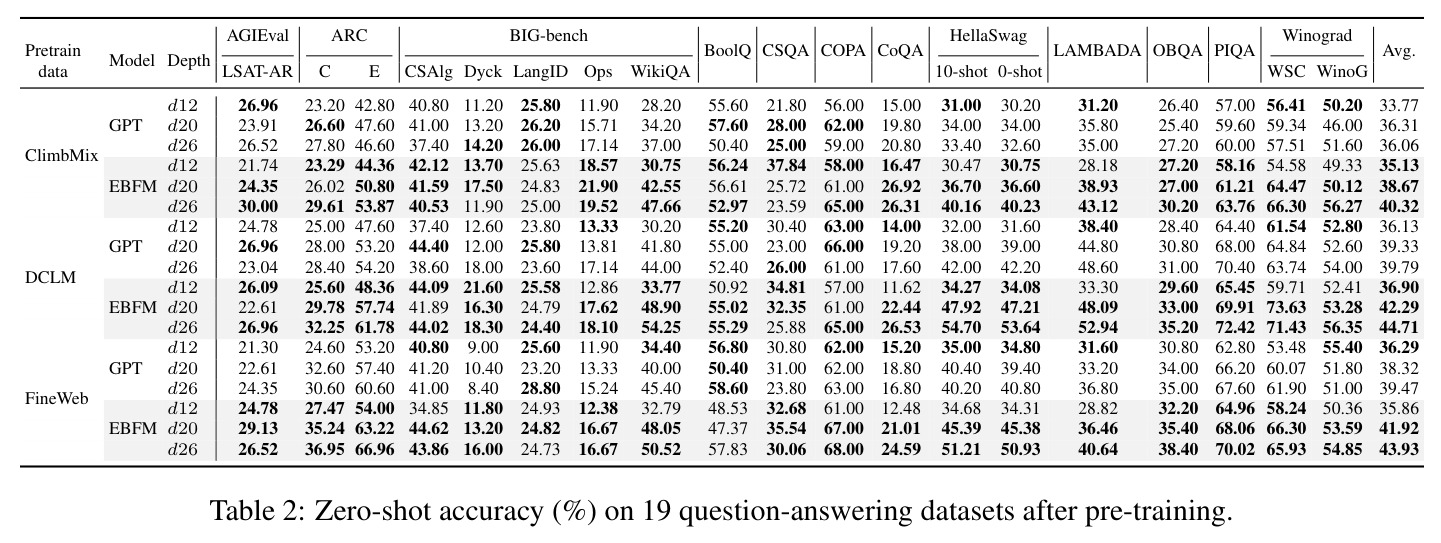
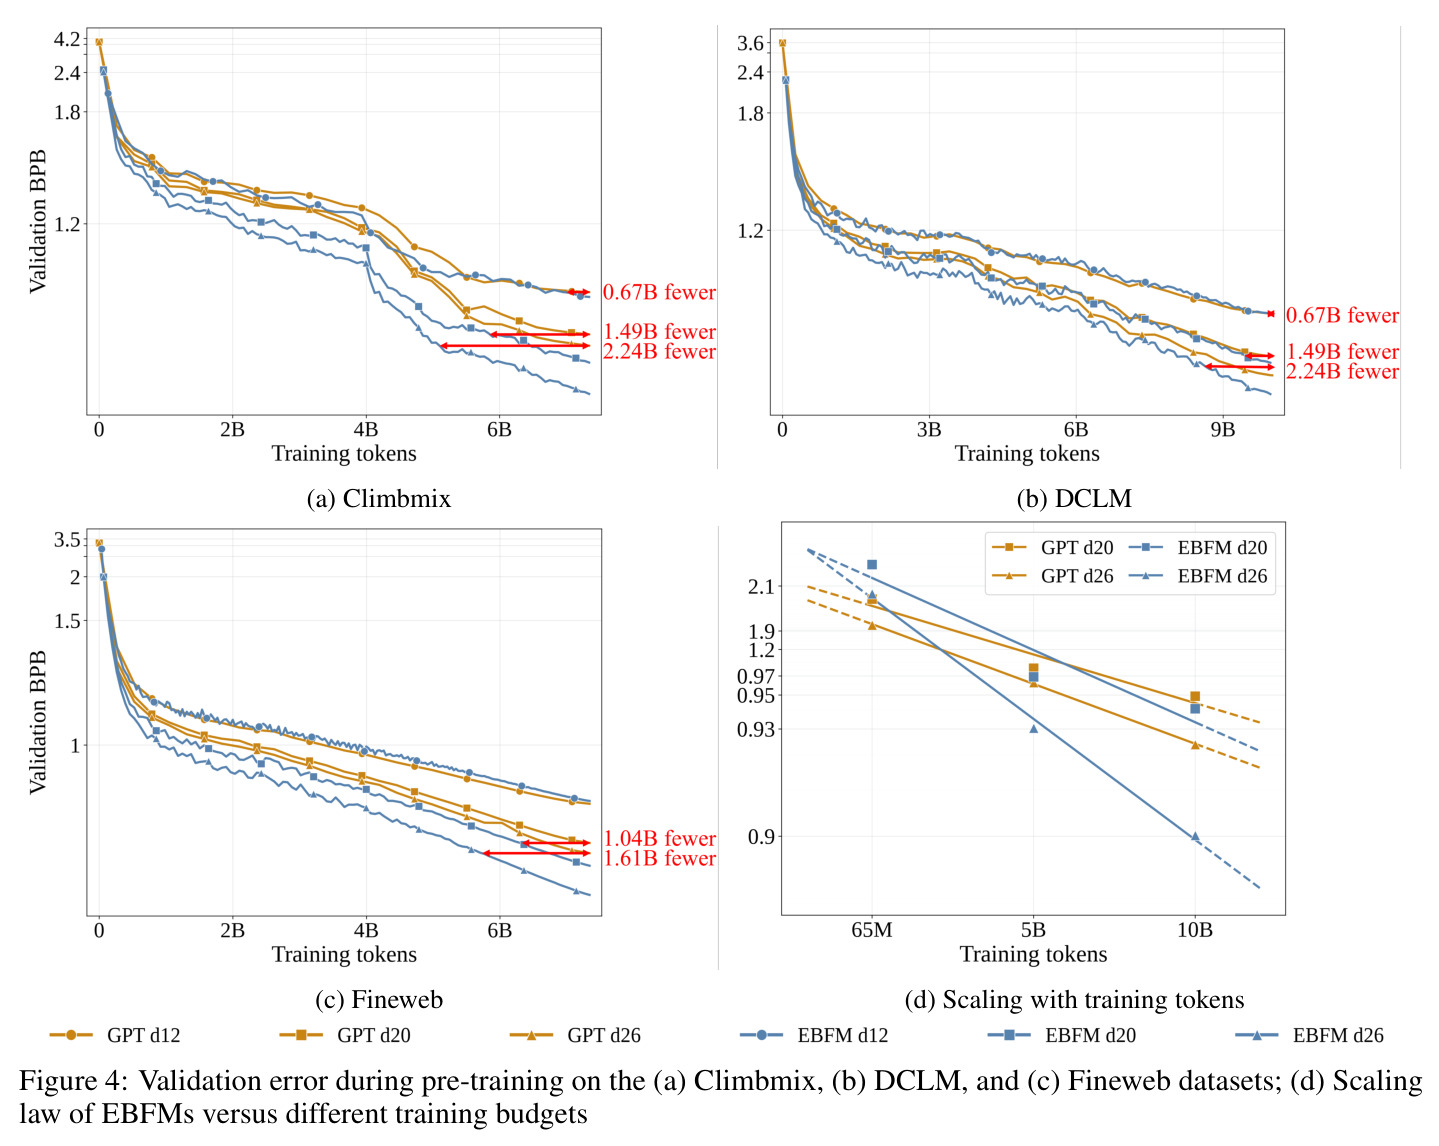
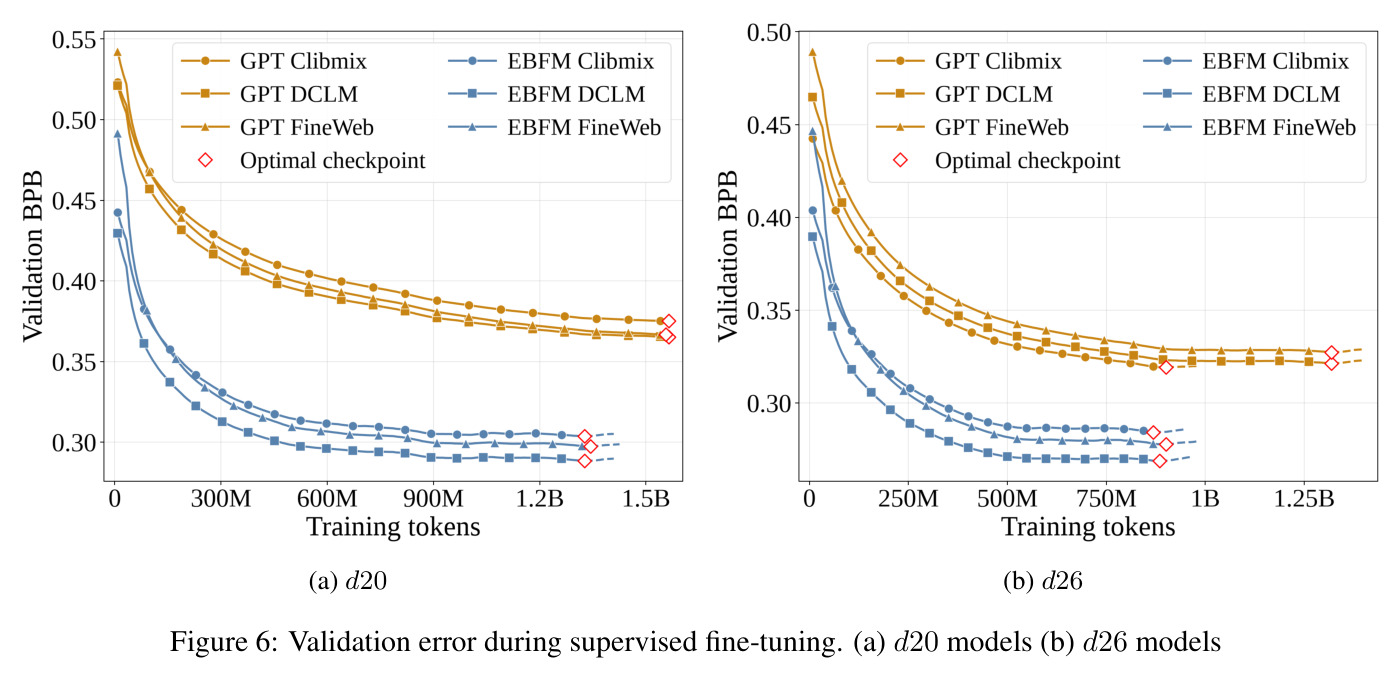
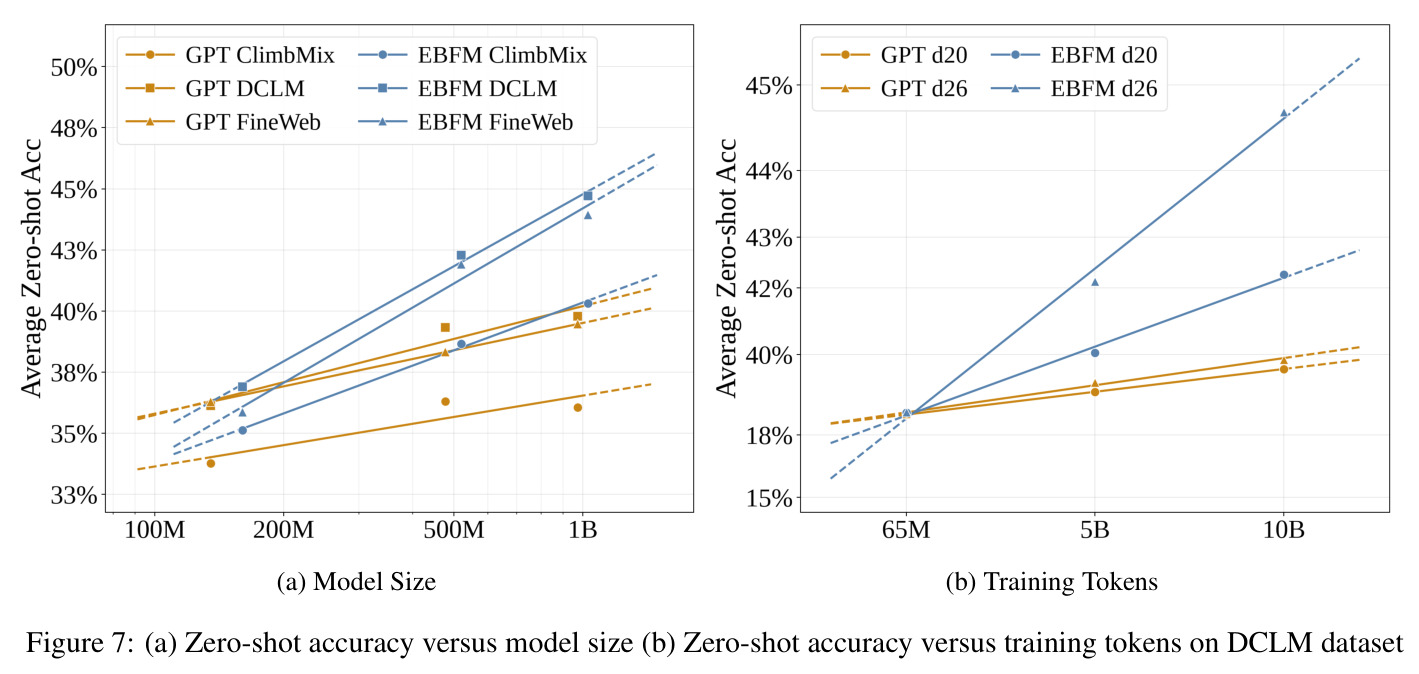
核心结果五组。一、数据扩展(Figure 4):EBFM BPB 随 token 下降快于 GPT;ClimbMix 上 EBFM 仅需 3.5B–5.1B token 即追平 GPT 7B token(省 2.24B),DCLM、Fineweb 分别少用 1.04B、1.61B token。二、参数扩展:268M→1.03B 时 EBFM 误差下降更快(Figure 5a);IsoFLOP 曲线呈 U 形,最优规模随预算右下移。三、零样本问答(Table 2,19 任务平均准确率):EBFM d26 在 DCLM 达 44.71 对 GPT 39.79、FineWeb 43.93 对 39.47、ClimbMix 40.32 对 36.06,例外是 FineWeb d12 略低(35.86/36.29)。四、零样本生成(Table 3):OpenWebText 1 epoch(9.06B token)平均 BPB 1.35,优于 GPT 1.37 与双倍预算 MDLM 1.44。五、SFT(Figure 6):Nanochat-SFT 上 EBFM 更少 token 达更低验证误差。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 预训练验证误差(ClimbMix 数据扩展) | BPB | EBFM d12/20/26 用 4.5B/3.5B/5.1B token 达到 GPT 7B token 的水平 | GPT 同深度训练 7B token | 论文报告节省 0.67B/1.49B/2.24B 训练 token |
| 预训练验证误差(DCLM / Fineweb 数据扩展) | BPB | EBFM 以更少 token 匹配 GPT 最终性能 | GPT 达到同等最终性能所需 token 数 | 分别少用 1.04B / 1.61B 训练 token |
| 零样本 QA 平均(DCLM,19 任务) | 平均准确率 % | EBFM d26:44.71(d20:42.29) | GPT d26:39.79(d20:39.33) | d26 提升 +4.92 个百分点 |
| 零样本 QA 平均(ClimbMix,19 任务) | 平均准确率 % | EBFM d26:40.32 | GPT d26:36.06 | +4.26 个百分点 |
| 零样本 QA 平均(FineWeb,19 任务) | 平均准确率 % | EBFM d26:43.93(d12:35.86) | GPT d26:39.47(d12:36.29) | d26 +4.46;d12 为 -0.43(唯一例外) |
| 零样本生成(PTB/Wikitext/LM1B/Lambada/AG News/Pubmed/Arxiv 平均) | 验证 BPB | EBFM:1.35(9.06B token,1 epoch) | GPT:1.37(同预算);MDLM:1.44(18.12B token,2 epoch) | 较 GPT 低 0.02,较 MDLM 低 0.09 |
| 参数扩展(DCLM 5B/10B token) | 最小验证 BPB | EBFM 随参数量 268M→1.03B 误差下降更快 | GPT 同规模同数据 | 规模越大优势越大(Figure 5a) |
| 监督微调(Nanochat-SFT:SmolTalk+MMLU+GSM8K) | 验证误差 BPB vs SFT token | EBFM d20/d26 更低误差且消耗更少 SFT token | 各自最优预训练检查点初始化的 GPT | 从预训练到 SFT 全流程数据效率更高(Figure 6) |
局限与改进
作者明确承认两处限制。一是训练效率:EBM 训练需要对潜变量的梯度(涉及对同一前向计算图的二阶自动微分),现有 FSDP、Megatron-LM、DeepSpeed ZeRO 都不支持,只能用分布式数据并行(DDP),整个模型必须装进单张 H200 的显存,因此最大只做到 d26(1.03B 参数)。二是只实现了逐 token 生成,block-wise 生成(整段联合能量优化)尚未实现,而这恰是能量引导理论上更该发挥优势的场景。此外现有高效推理/训练组件(GPTQ、FlashAttention、PagedAttention)不直接适用。我自己的观察:零样本绝对分数普遍偏低(如 LSAT-AR 约 25%、Dyck Languages 约 11-21%,接近随机水平),说明这是小算力探索而非成熟系统;上下文长度仅 2048,长文本能力未知;基线 GPT 全部为作者自行训练的同规模模型,缺少与 LLaMA、Pythia、OLMo 等公开权重的横向对照;预训练超参中 MCMC 步数 K=1,论文未给出 K、步长 α 以及"冻结 z 为噪声"的消融,能量引导的净贡献难以与额外参数量剥离。
独立分析的弱点
独立来看,该工作有几个值得警惕的弱点。第一,对高阶自动微分的依赖是工程死结:能量引导要在"对 $z$ 求导"的同时保留对 $\theta$ 的梯度,相当于每 batch 两次反向传播,封死了模型并行与 ZeRO 显存优化;改进方向是设计只需一阶导的代理目标(如 stop-gradient 能量近似、有限差分估计梯度),或为 EBM 定制支持高阶微分的分片方案。第二,推理成本被低估:每个生成步要做 K 次前向加反向,即使 K=1 仍接近双倍开销且随上下文增长;改进方向是训练小网络直接预测低能量 $z^*$(amortized inference),或只在困难位置触发引导。第三,K=1 且去噪的能量引导与普通 Transformer 的隐层计算界限模糊;应补齐 $K\in\{0,1,2,4\}$、固定 $z=0$、随机 $z$ 等消融,证明收益来自能量地形而非额外容量。第四,所有对比都在作者自训的小 GPT 上进行,最高 1.03B 参数、10B token,结论外推到更大规模有不确定性;应加入 Pythia/OLMo 公开基线并训练到 100B token 量级验证幂律是否持续。
未来方向
作者在 Limitations 和 Future Directions 中提出四条:面向科学推理、代码生成、金融等领域的监督微调;针对 EBFM 架构定制高效训练/推理算法(现有 GPTQ、FlashAttention、PagedAttention 均不适用);开发支持高阶梯度与模型切分的分布式基础设施(对标 FSDP/Megatron-LM);以及 block-wise 生成,用整段联合能量优化换取长程语义一致性与约束满足。基于其成果还可延伸:把能量头用作对齐信号(RLHF 中能量即偏好分数),或把能量引导视为隐式思维链、系统刻画 test-time compute 与质量的 scaling 曲线;与扩散语言模型的块级去噪结合形成混合架构;在多模态(图像、音频 token)上检验能量地形是否同样可扩展;以及给出理论分析——为何确定性单步下降足够、能量地形与损失景观的几何关系如何影响泛化。
复现评估
复现条件较好。开源情况:论文声称完全开源训练设施与日志(GitHub 仓库 datamllab/openebfm,正文第 5 节链接写作 openesm,与标题 OpenEBFM 不一致)和全部模型权重(HuggingFace 集合 guan-wang/openebfm),三个预训练语料 Fineweb、Climbmix、DCLM 均公开并在代码内链接。算力需求:最大配置 d26(1.03B 参数)因不支持模型切分必须装入单张 H200,预训练最多用到 10B token;中小实验室可用 d12(约 268M)以较低成本复现主要曲线。但要注意训练代码依赖对潜变量的二阶自动微分(create_graph),常规 FSDP/DeepSpeed 环境不能直接使用。难度评估:中等偏高——需要复现 Muon+AdamW 混合优化、定制注意力掩码与位置索引、以及 EBM 特有的梯度计算;评测 19 个 QA 任务加 7 个生成集需要 lm-evaluation 类工具链。总体而言权重、配方、日志齐全,论文"完全可复现"的承诺可信度较高。
论文图表
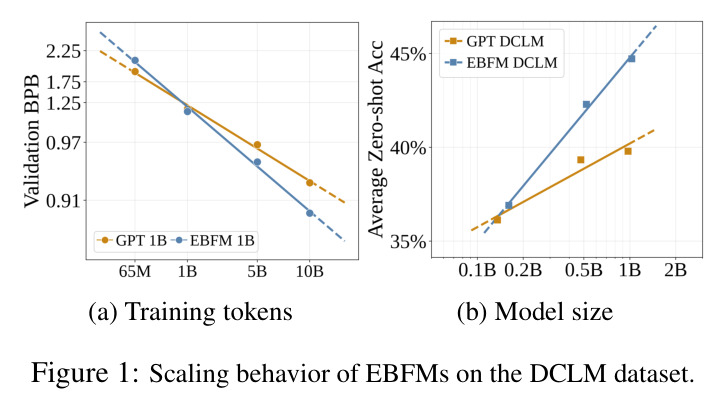
分 (a) 训练 token 数和 (b) 模型大小两个子图,展示 EBFM 与 GPT 在 DCLM 上验证误差随数据量/参数量增长的下降曲线,EBFM 曲线始终位于 GPT 之下,且随规模扩大差距拉大。
这是论文核心卖点(扩展性优势)在引言中的总览证据,一张图即可看出 EBFM 的数据效率与参数效率都优于 GPT。