DiscoDemo:为模仿学习发现高效且多样的机器人示教数据 DiscoDemo: Discovering Efficient and Diverse Robot Demonstrations for Imitation Learning
用带成功门控多样性目标的RL生成器批量产出多样成功示教,大幅提升下游VLA模仿学习成功率
前置知识
行为克隆(Behavior Cloning, BC)与分布偏移
行为克隆是最简单的模仿学习:把专家轨迹当成监督数据,用 $\ell_{IL}(\pi_{IL}(\cdot|o), a)$ 这类损失直接拟合观测到动作的映射。它有一个著名缺陷——分布偏移(covariate shift):策略一旦执行出错偏离专家轨迹,就会进入训练数据从未覆盖的状态,此时它的预测更不可靠,错误滚雪球式放大(Ross 等人 2011 年的 DAgger 论文形式化了这一问题)。因此 BC 的成败高度依赖训练数据对状态空间的覆盖广度:数据覆盖的“支撑集”越大,策略偏航后被拉回的概率越高。
本文的全部论点建立在“BC 对数据覆盖敏感”之上:作者主张 RL 不该当部署控制器,而该当覆盖更广的数据生成器,读者必须先理解为什么窄分布数据会让 BC 变脆,才能理解为什么要刻意追求“多种成功解法”。
稀疏奖励 RL 与反向课程(Reverse Curriculum)
操作任务的成功信号往往只有回合末的 0/1,从随机初始状态几乎不可能撞见成功,RL 无从学习。反向课程(如 RFCL、DemoStart)的解法是:先把环境重置到成功示教的末端附近,让策略只需完成最后一步就能拿到奖励;随着成功率上升,把重置边界 $c_i$ 沿示教逐步前移,任务难度渐增,最终策略能从真正的初始状态解出全程任务。这本质上是把稀疏奖励问题切分成一串易学的子问题。
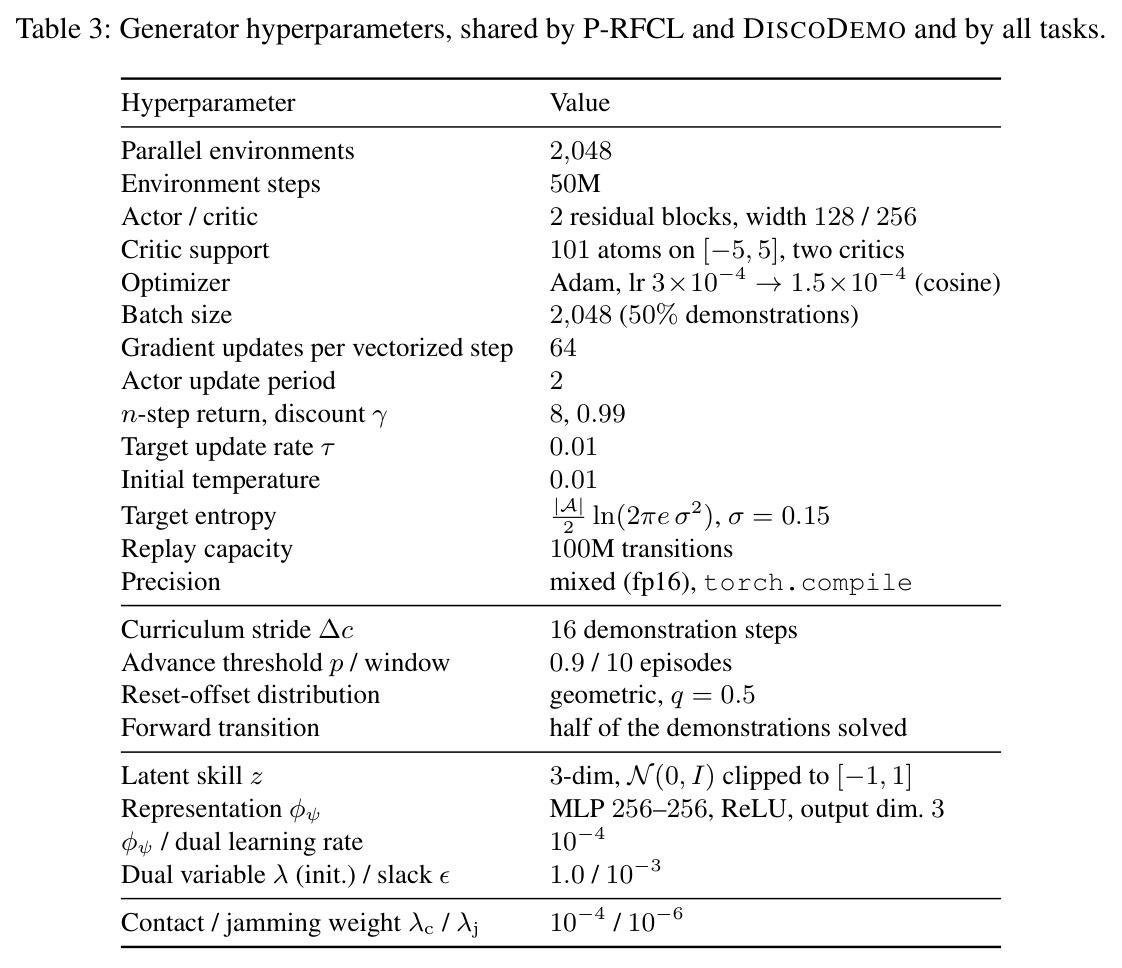
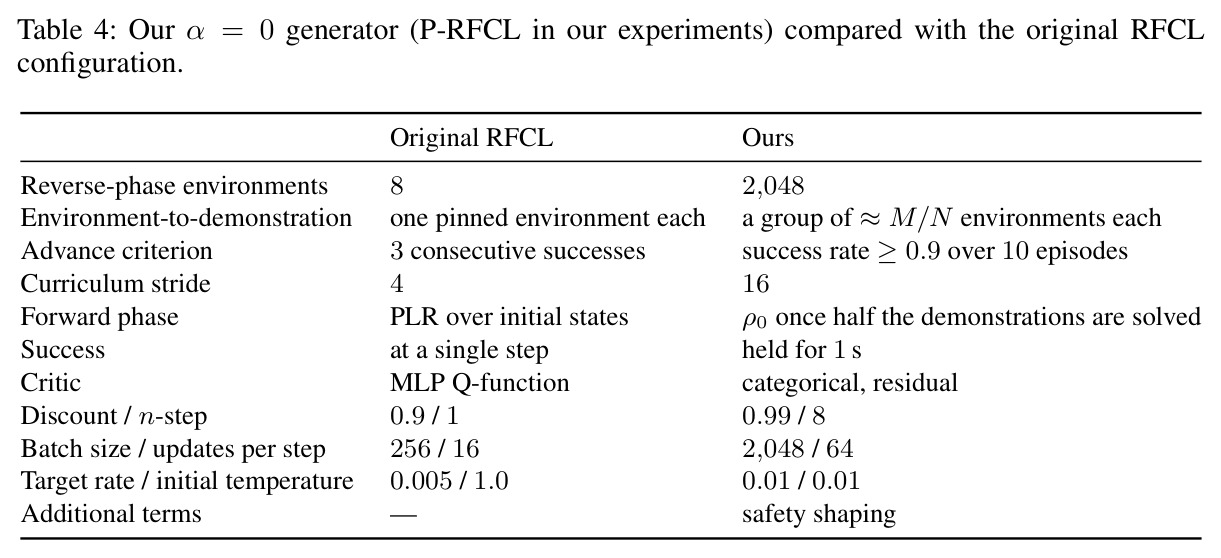
DiscoDemo 的生成器训练完全建立在这一机制上,且本文的关键工程贡献之一就是把原本“每条示教钉死一个环境”的反向课程改造成可在 2048 个并行环境上规模化的池化版本(反向阶段从 8.2 小时缩到 29 分钟,约 17 倍加速)。
潜在条件技能发现与 METRA
无监督技能发现给策略附加一个潜在变量 $z$(每回合采样一次并固定),奖励策略让不同 $z$ 产生不同行为。METRA(Park 等人 2024)的奖励是状态表征空间中的位移与 $z$ 的内积 $r_{div}=\langle\phi_\psi(s_{t+1})-\phi_\psi(s_t), z\rangle$,同时对 $\phi_\psi$ 施加 Lipschitz 约束 $d\|\phi_\psi(s')-\phi_\psi(s)\|_2\le 1$,使表征对齐真实状态度量,让不同 $z$ 覆盖状态空间的不同方向。本文直接借用该目标,但用途从“学部署用的技能库”变成了“扩展数据分布的支撑”。
DiscoDemo 的多样性奖励就是这个公式的逐字实现(3 维 $z$、输出 3 维 $\phi_\psi$、$d=3$),读懂 METRA 才能理解“解法发现”在数学上到底在优化什么。
SMERL 的成功门控多样性
单纯鼓励多样性会让策略学出一堆花哨但毫无用处的失败行为。SMERL(Kumar 等人 2020)提出“结构化多样性”:只有价值估计超过阈值的技能才发放多样性奖励,保证多样性不牺牲任务能力。DiscoDemo 用更直接的轨迹级版本:用 $y(\tau)\in\{0,1\}$ 标记整条轨迹是否成功,组合奖励写成 $\tilde r_t = r_{task}(s_t,a_t)+\alpha\, y(\tau)\, r_{div}(s_t,s_{t+1},z)$——失败轨迹拿不到任何多样性奖励。
成功门控是本文区别于朴素“RL+技能发现”的核心开关:消融显示若去掉门控($y\equiv 1$),多样性奖励会淹没稀疏任务奖励,生成器根本学不会完成任务。
特权信息(Privileged State)与师生解耦
特权训练指训练时使用仿真器才有的全量状态(物体真实位姿、接触力等),部署时换用只有视觉观测的学生策略。本文的生成器 $\pi_{Gen}$ 输入 45 维特权状态(物体/容器位姿、关节角、接触状态等),可以高效训练;导出数据时只渲染两个相机图像并配对动作,下游 $\pi_{IL}$($\pi_{0.5}$ VLA)完全见不到特权信息。这个解耦让 RL 可以跑在轻量 MLP + 大规模并行仿真上,而视觉负担留给预训练好的下游模型。
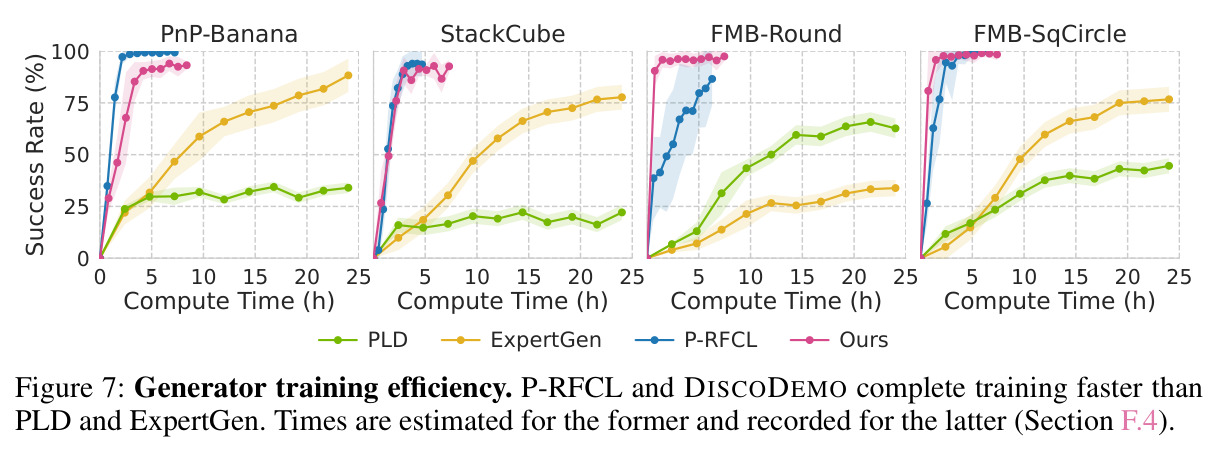
特权/非特权的划分是全文效率故事的根基:生成器每步不用调用大视觉模型,因此训练与生成远快于 PLD、ExpertGen 这类反复调用视觉行为先验的方法。
VLA 与 π0.5 / flow matching 微调
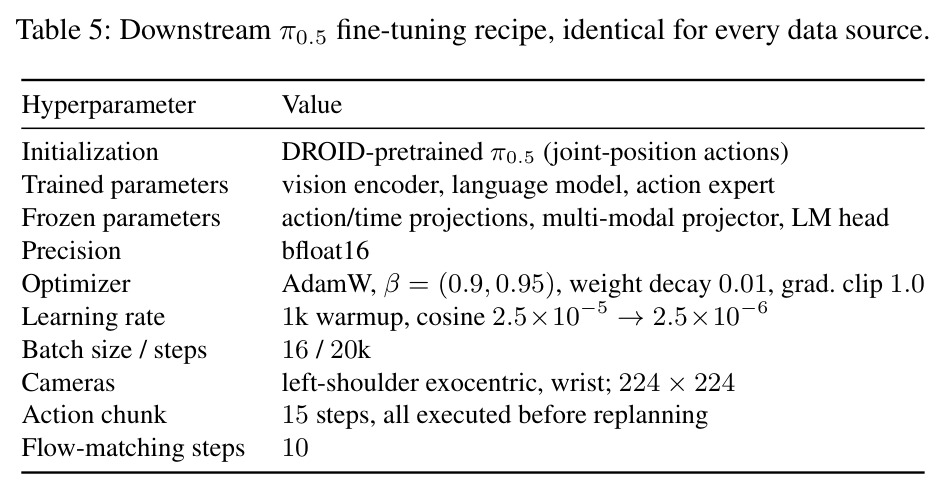
视觉-语言-动作(VLA)模型是在大规模机器人数据上预训练的多模态大模型,输入图像与语言指令、输出发给机器人的动作块。π0.5 是 Physical Intelligence 的代表性 VLA,用 flow matching 生成连续动作,本文使用其 DROID 预训练权重(关节位置动作),再用各数据源的 3000 条示教以完全相同的配方微调(vision encoder + LM + action expert 全训,batch 16、20k 步、lr 余弦 $2.5\times10^{-5}\to2.5\times10^{-6}$),从而把“数据质量”从“学习算法”中干净地剥离出来做对照。
所有对比实验都锚定在同一个 π0.5 微调流程上,这是本文实验结论可信的关键设计;理解这一点才能判断性能差异确实来自数据分布而非训练配方。
研究动机
现代机器人视觉运动策略几乎都用行为克隆训练,而 BC 的扩展受制于物理数据采集成本:每条轨迹都要真机加人类遥操作员的时间,即便 Open X-Embodiment、DROID 这样的大数据集也只有约百万量级的 episode,远少于视觉语言领域的数十亿图文对和语言领域的数万亿 token。仿真似乎提供了廉价出路——轨迹可以大规模并行生成,且 sim-to-real 技术已让仿真数据对真机策略有用——但它立刻抛出两个问题:成功轨迹怎么生成?这些成功行为应该覆盖什么样的分布?现有仿真数据管线各有短板:运动规划方法(如 CaP-X、RoboTwin 系列)依赖任务特定的规划结构;MimicGen 一类方法把源示教的片段几何变换到新场景,行为上限被源示教锁死,且在接触密集的操作中纯几何变换无法保证交互仍然成功;扰动/纠正类方法(PGDG、DAgger、DART)只能在已有行为周围扩展覆盖。而直接用 RL 生成数据的老路(RFCL、DemoStart、PLD、ExpertGen)有个更隐蔽的毛病:任务奖励本身会把策略收敛到少数几个窄解上(Kumar 等人 2020 指出稀疏奖励下一旦找到一条可靠解法,策略就没有动力探索其他解法),于是重复 rollout 采集 3000 条数据,状态-动作分布仍然高度集中;下游 BC 一旦因预测误差偏离这条“独木桥”,就落在训练分布之外无法恢复(Ross 等人 2011 的分布偏移问题)。论文用图 1 的条形图直观展示了这一谱系:单解数据(运动规划、RFCL 等)四任务平均成功率只有 2%-3%,增强类(PGDG 29%、PLD 23%)居中,而理想中的“解法发现”类最强。
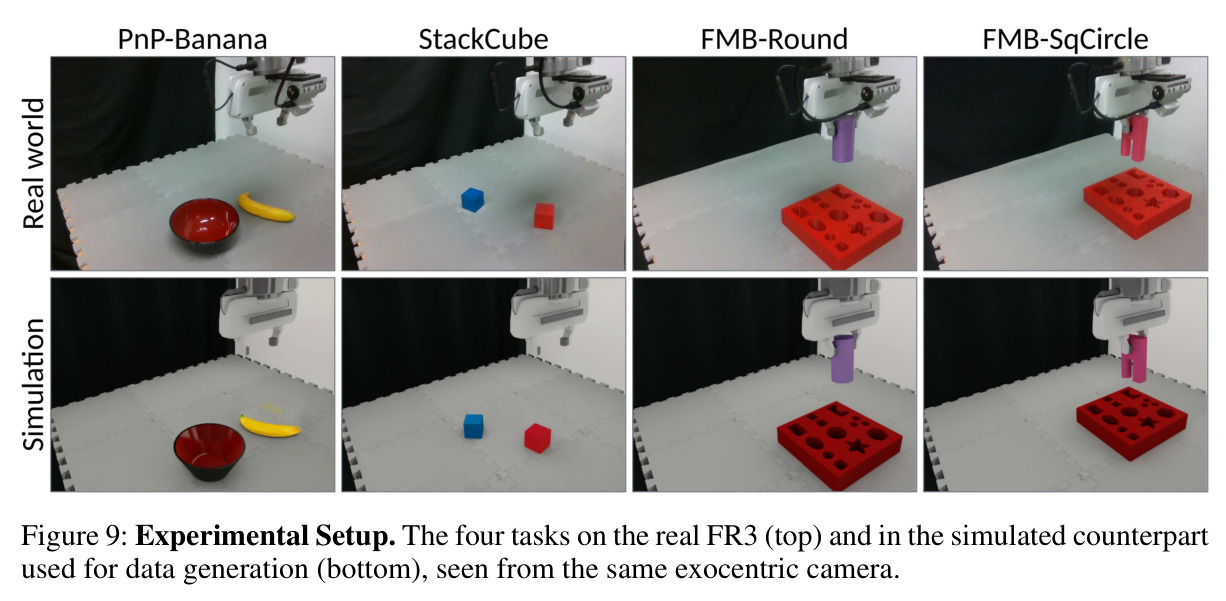
本文的目标是本文的目标是把 RL 重新定位成“数据生成器”而非“部署控制器”,并回答一个此前没人正面处理的问题:RL 生成器本身能否主动发现多种不同的成功解法,使导出的静态数据集覆盖更宽的成功状态空间?具体而言,作者希望仅凭 20 条人类遥操作示教加仿真器,自动训练一个既会完成任务、又会以多种方式完成任务的潜在条件化 RL 生成器;再用它批量生成 3000 条成功示教,经安全过滤后导出成纯观测-动作数据集,微调同一个 DROID 预训练的 π0.5 VLA,在四个真实重建的操作任务(PnP-Banana 香蕉入碗、StackCube 叠方块、FMB-Round 与 FMB-SqCircle 两种精密插销插入)上,同时验证仿真与真机(Franka Research 3,零样本部署)的下游成功率提升,并保持完成时间与 RL 基线相当。最终目标可以浓缩成一句话:让“成功数据的多样性”本身成为可优化的训练目标。
与已有工作不同的是,本文的独特切入角度在于把研究焦点从“如何生成成功轨迹”转移到“成功行为应该覆盖什么分布”。此前的 RL 数据生成工作——RFCL 与同期的 DemoStart 只关心从少量示教引导稀疏奖励 RL 并(在 DemoStart 中)蒸馏出视觉学生;PLD 和 ExpertGen 用残差 RL 或行为先验引导来对接预训练策略;DLR 虽然也追求多样数据,但它是先从成功示教中“发现”离散行为模式再逐个强化,属于离线的模式挖掘。没有人在线地训练一个单一生成器去同时保持任务成功与解法多样性。DiscoDemo 把两条成熟线索首次拼成一个面向数据生成的目标函数:用 METRA 式的度量感知技能发现提供“不同 $z$ 走不同的路”的机制,用 SMERL 式的成功门控保证多样性不侵蚀任务能力,再把示教的用法从“模仿目标”(BC/DAgger 的思路)改成纯粹的“课程重置状态”,配合可并行化的课程推进准则。此外它还补上了生成数据管线的现实环节——安全塑形与导出过滤,这在纯 RL 文献中通常被忽略,但在把数据喂给真机策略时不可或缺。
核心方法
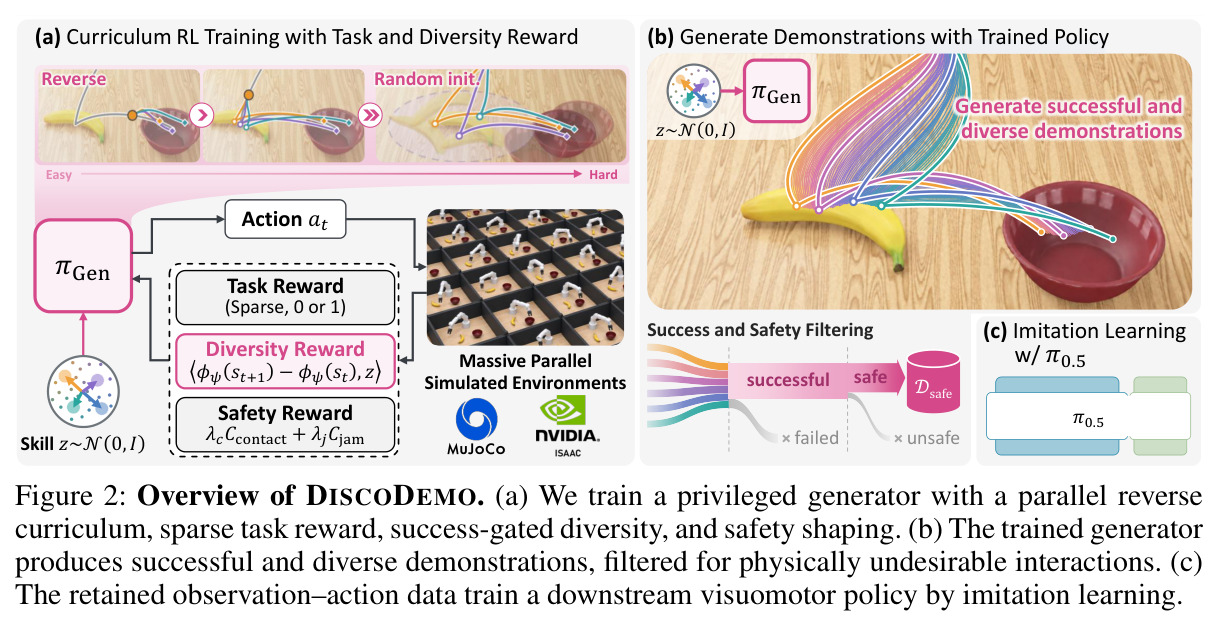
直觉上,DiscoDemo 的出发点是:一条会解任务的 RL 策略像一个只会走独木桥的老师,而一个“会多种解法”的老师才能教出见多识广的学生。技术路线分三步(图 2)。第一步,训练特权生成器:以 20 条人类示教为起点,用 FlashSAC 在 2048 个并行环境中训练一个输入 45 维特权状态的潜在条件化策略 $\pi_{Gen}(a_t|s_t,z)$,其中 3 维技能 $z\sim\mathcal{N}(0,I)$ 在回合开始时采样并整回合固定;训练奖励为 $\tilde r_t - r_{safe}$,其中 $\tilde r_t = r_{task} + \alpha\,y(\tau)\,r_{div}$,稀疏任务奖励 $r_{task}$ 只有在成功条件持续满足 1 秒时给 +1,多样性奖励 $r_{div}=\langle\phi_\psi(s_{t+1})-\phi_\psi(s_t),z\rangle$ 仅对成功轨迹 $y(\tau)=1$ 生效,安全项 $r_{safe}=\lambda_c C_{contact}+\lambda_j C_{jam}$ 惩罚非预期接触与插销卡死力;同时用大规模并行的反向课程从示教末端逐步回退重置边界解决稀疏奖励问题。第二步,生成与策展:冻结 $\pi_{Gen}$,从真实初始分布 $\rho_0$ 出发、每回合独立采样 $z$ 收集轨迹,丢弃失败轨迹并按训练期同一套安全信号过滤,渲染左肩外参相机与腕部相机(480×640、20Hz)并配对关节位置目标与夹爪命令,导出静态数据集。第三步,下游模仿学习:用标准 BC 目标 $\theta^*_{IL}=\arg\min\mathbb{E}_{(o,a)\sim\mathcal{D}}[\ell_{IL}(\pi_{IL}(\cdot|o),a)]$ 微调 DROID 预训练的 π0.5,下游策略看不到特权状态也看不到 $z$。
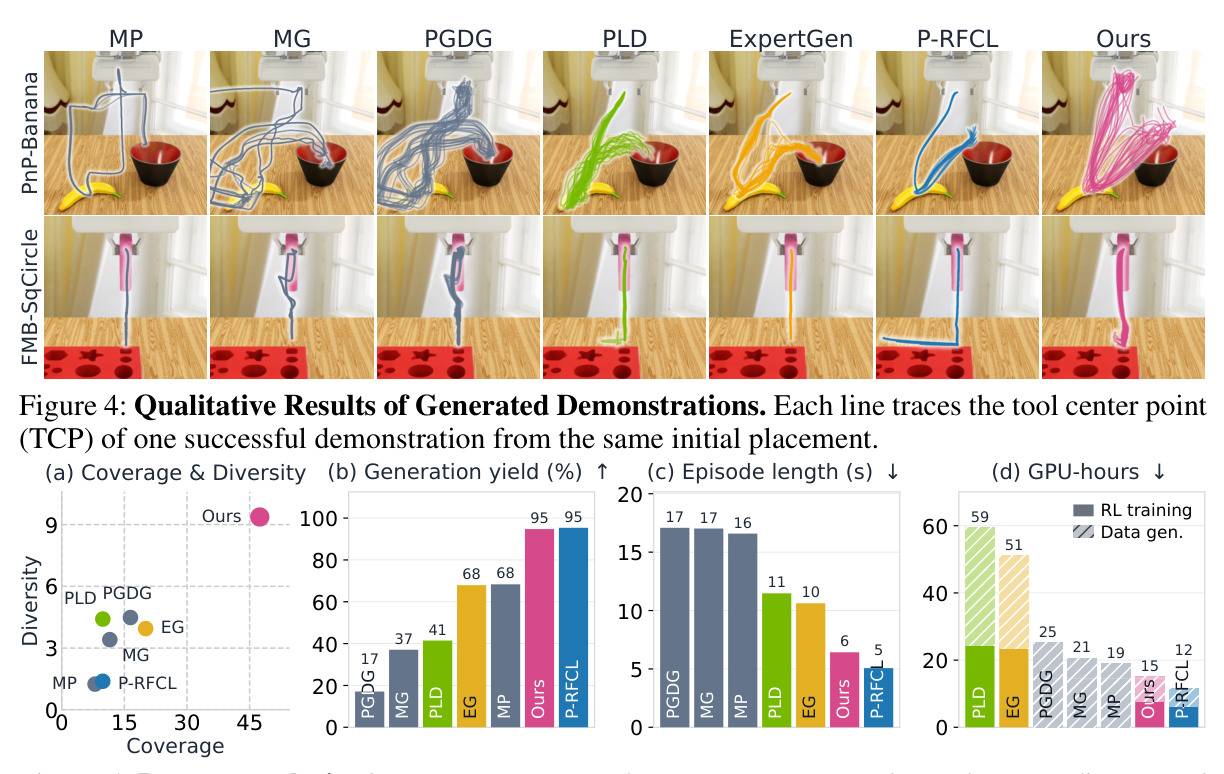
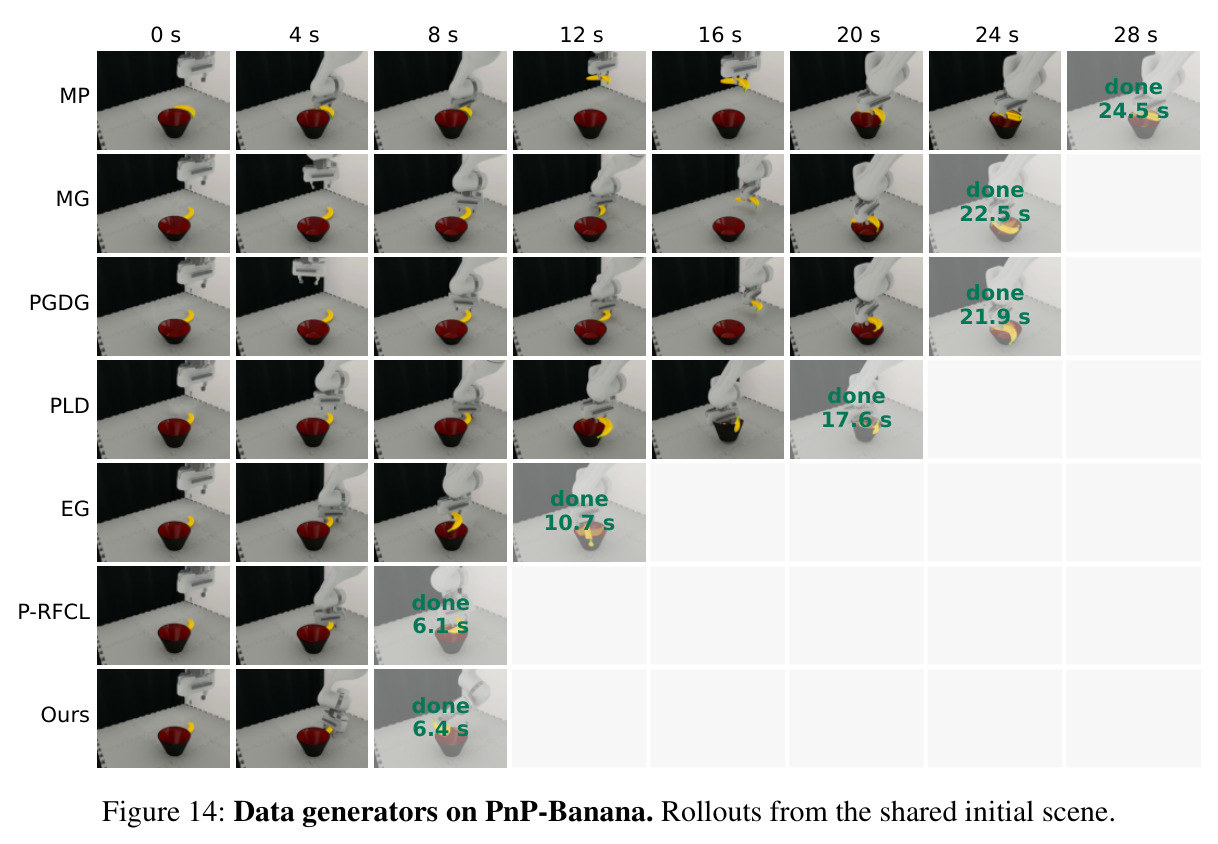
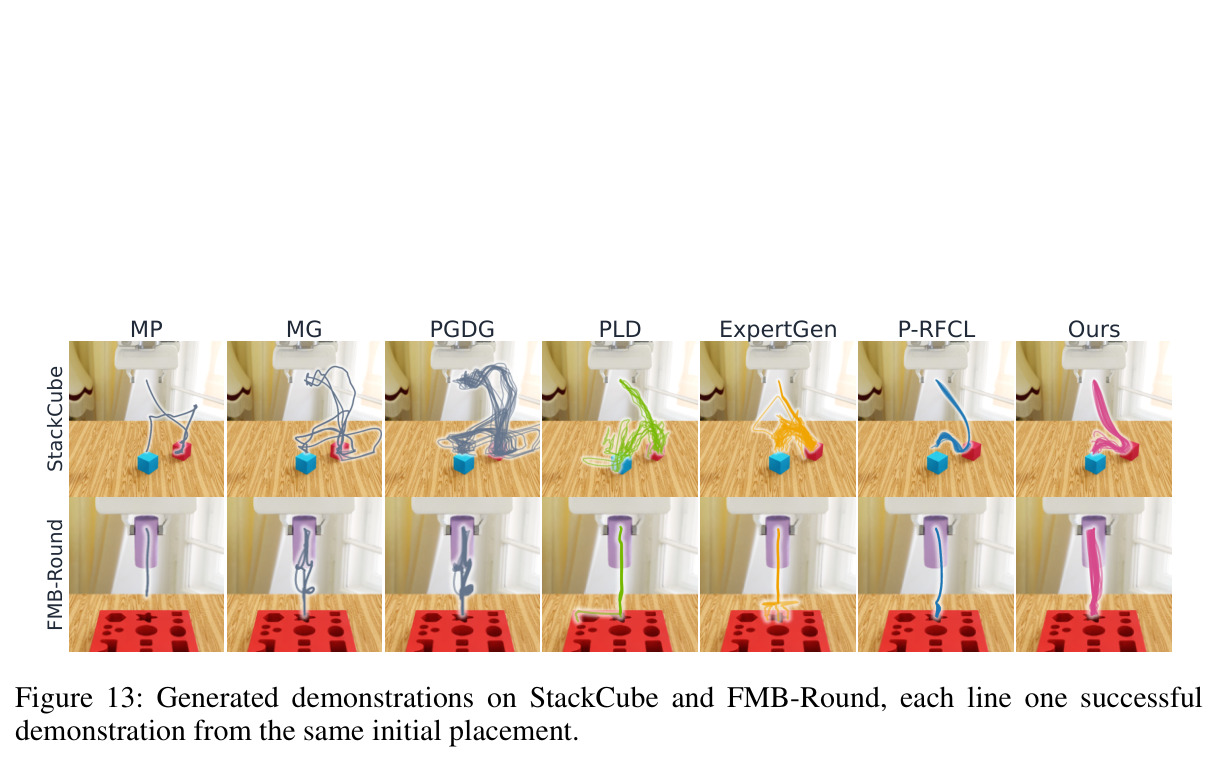
核心创新是“成功门控的解法发现”(success-gated solution discovery)作为数据生成目标。与已有方法的本质区别有三层。其一,与无监督技能发现(DIAYN、METRA 等)不同,这里的多样性不是目的而是手段:多样性奖励被轨迹级成功指示子 $y(\tau)$ 硬性门控($\tilde r_t=r_{task}+\alpha y(\tau) r_{div}$),只有真正完成任务的行为才有资格“求异”,作者明确指出若去掉门控,多样性奖励会压倒稀疏任务奖励导致生成器学不会任务——这正是 SMERL 结构化多样性思想第一次被用于“为下游 BC 造数据”的场景。其二,与 MimicGen/PGDG 的“围绕源示教做变换或扰动”不同,生成器通过不同的 $z$ 在线发现状态空间中截然不同的成功解,图 4 显示各方法的工具中心点轨迹:MP 与 P-RFCL 反复走同一条窄路,MG/PGDG 只在人类行为附近变化,而 DiscoDemo 在同一初始布局下走出形态各异的成功轨迹。其三,与把示教当模仿目标的 BC 类方法不同,示教在这里只提供课程重置状态(离线 RL 经验 + 重置候选),策略的动作完全由 RL 自主发现,因此不受源示教行为质量的限制。这三点合起来,使 DiscoDemo 同时保有 RL 数据的两大优点——短而目标导向的轨迹、以及增强类方法缺乏的广覆盖。
方法步骤详情
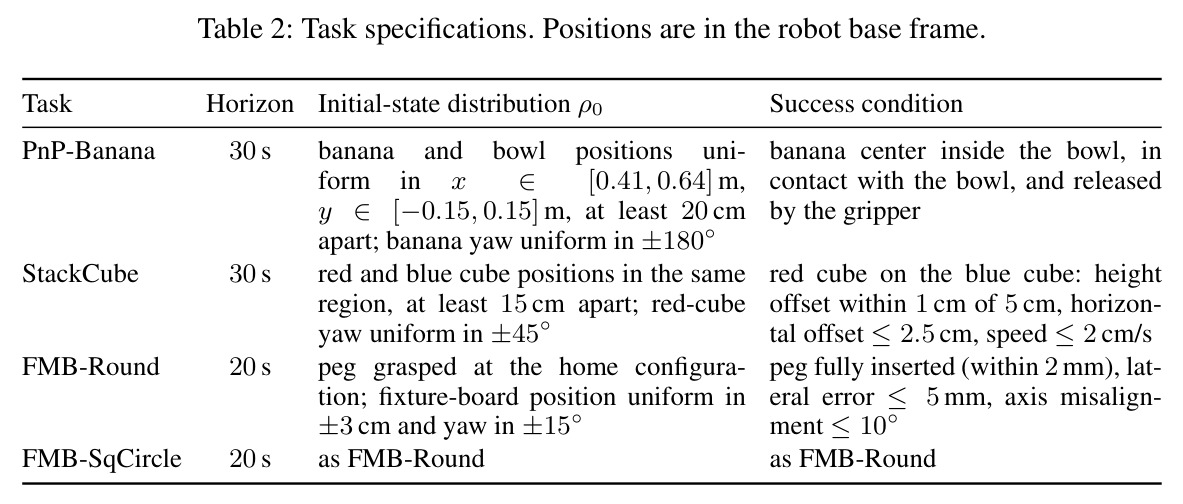
完整流程如下。第一步,问题建模:仿真器提供特权状态 $s$(45 维:物体与容器位姿及其相对工具中心点的位置、7 个关节角、夹爪、末端位姿、上一动作等)与指定状态重置;动作 8 维(7 个受速率限制和 jerk 滤波的相对关节位置增量 + 1 个二元夹爪命令),控制频率 20Hz;每条示教 $\tau_i$ 长度 $T_i$,成功条件(如香蕉入碗且松手)须持续 20 个控制步(1 秒)才算成功。第二步,并行反向课程:为每条示教分配一组约 102 个并行环境并维护独立边界 $c_i$(初始化在轨迹末端附近);每次重置按 $\Pr(i,t)\propto(1-q)^{t-c_i}$($q=0.5$)把环境重置到示教状态 $s_t^i$,使起点集中在前沿;统计恰好从前沿出发的最近 10 个回合,成功率 $\hat p_i\ge 0.9$ 则前移 $c_i\leftarrow\max(0,c_i-\Delta c)$,$\Delta c=16$ 步;当一半示教在 $c_i=0$ 也能解出,所有环境切换到真实初始分布 $\rho_0$。第三步,多样性学习:$z\in\mathbb{R}^3$ 每回合采样、逐元素裁剪到 $[-1,1]$ 并拼入 actor 与 critic 观测;$\phi_\psi$ 是 256-256 的 MLP 输出 3 维,按 METRA 在对偶约束下最大化期望位移内积;由于 critic 用 8-step return,多样性奖励在更新时按 $\langle\phi_\psi(s_{t+n})-\phi_\psi(s_t),z\rangle$ 结算,成功门控 $y(\tau)$ 通过回合 ID 表在回合结束后回溯查得;主实验取 $\alpha=0.3$。第四步,安全塑形:$C_{contact}=\min(\sum_{(b,o)\notin\mathcal{C}_{allow}}\|F_{b,o}\|_2, c_c)$ 只豁免手指-物体的抓取接触,$C_{jam}$ 把插销对孔板的力分解为轴向与侧向分量分别设 5N/15N 死区(正确插入靠侧向导向,卡死是轴向硬顶),力在 100N 饱和。第五步,训练配置:FlashSAC、50M 环境步、单张 B200、batch 2048(其中一半转移永远来自示教)、双 categorical critic 取 min、Adam 学习率 $3\times10^{-4}\to1.5\times10^{-4}$ 余弦。第六步,生成与过滤:冻结生成器,从 $\rho_0$ 采样初始状态、每回合新采 $z$ 收集轨迹;保留 $\mathcal{T}_{keep}=\{\tau\,|\,y(\tau)=1, F_{task}(\tau)=1\}$,其中 $F_{task}$ 检查单步接触超 50N、接触持续超 20N 达 150ms、插入任务的死区校正力 $\ell_2$ 范数超 15N、以及容器位移。第七步,导出与下游:把保留轨迹重置回放渲染两路相机,动作存滤波后的关节位置目标加夹爪命令;用统一配方微调 π0.5(224×224 输入、15 步动作块、flow matching 10 步、batch 16、20k 步),每数据源训练 3 个种子。
技术新颖性
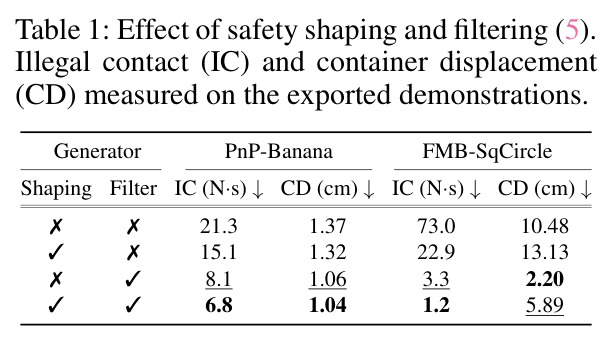
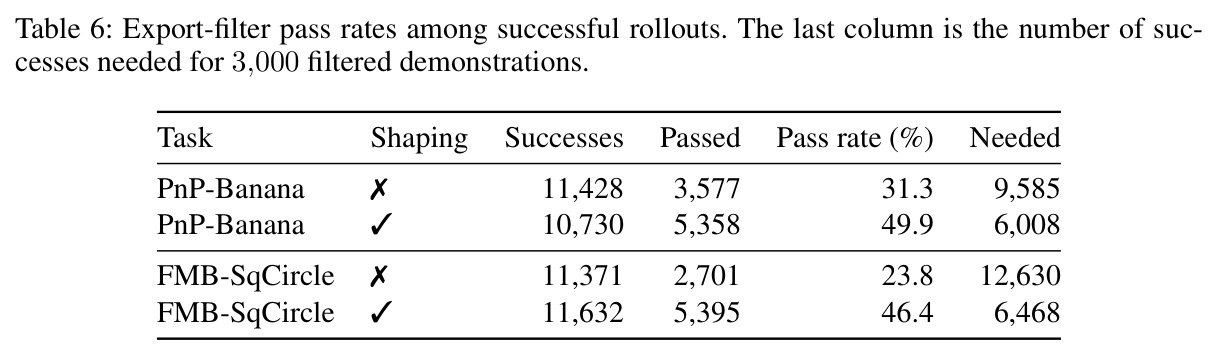
从组件看,反向课程来自 RFCL/DemoStart,度量感知多样性来自 METRA,成功门控来自 SMERL,安全惩罚是常规塑形——单点技术都不新。本文的新颖性在系统层面的三个“首次组合”。第一,把轨迹级成功门控的多样性目标当作数据生成目标而非策略学习目标来优化:SMERL 原本的动机是少样本外推,METRA 的动机是部署用技能库,而这里输出的是一张静态数据集,评价指标从生成器的成功率变成了下游 BC 策略的成功率,这一目标函数的“换位”是概念性贡献。第二,课程机制的可并行化改造:原版 RFCL 每条示教钉死一个环境、要求“最近 3 回合连续成功”才推进前沿,这在 2048 个环境下会永久卡死;DiscoDemo 改为池化所有从前沿出发的回合、以 10 回合内成功率 $\ge 0.9$ 推进,实测反向阶段从 8.2 小时缩到 29 分钟(约 17 倍墙钟加速),说明作者清楚区分了“样本效率”与“墙钟效率”这两个常被混淆的目标。第三,双阶段安全策展(训练时塑形 + 导出时过滤)被形式化并消融:表 1 显示塑形单用无法消除不良接触(任务成功仍可能压过软惩罚),过滤贡献主要削减,两者结合把 FMB-SqCircle 的非法接触从 73.0 降到 1.2 N·s,且塑形还把过滤通过率从 23.8% 提到 46.4%,等于把“过滤丢数据”变成了“塑形省数据”。与最接近的同期工作 DLR 相比,DLR 是从成功示教中挖掘离散行为模式再逐个强化,属于示教驱动的模式库方法;DiscoDemo 则是在线地、以连续潜在变量驱动地发现解法,理论上不受示教中已有行为模式的限制。
实验结果
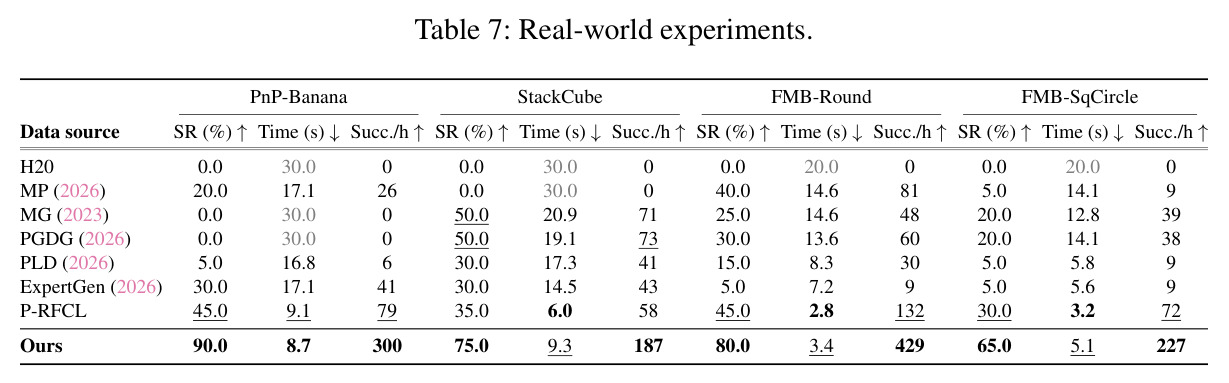
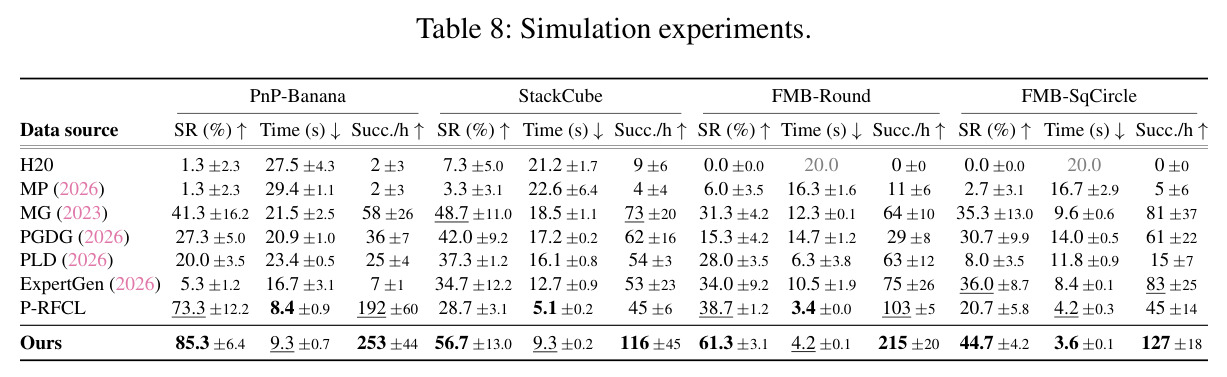
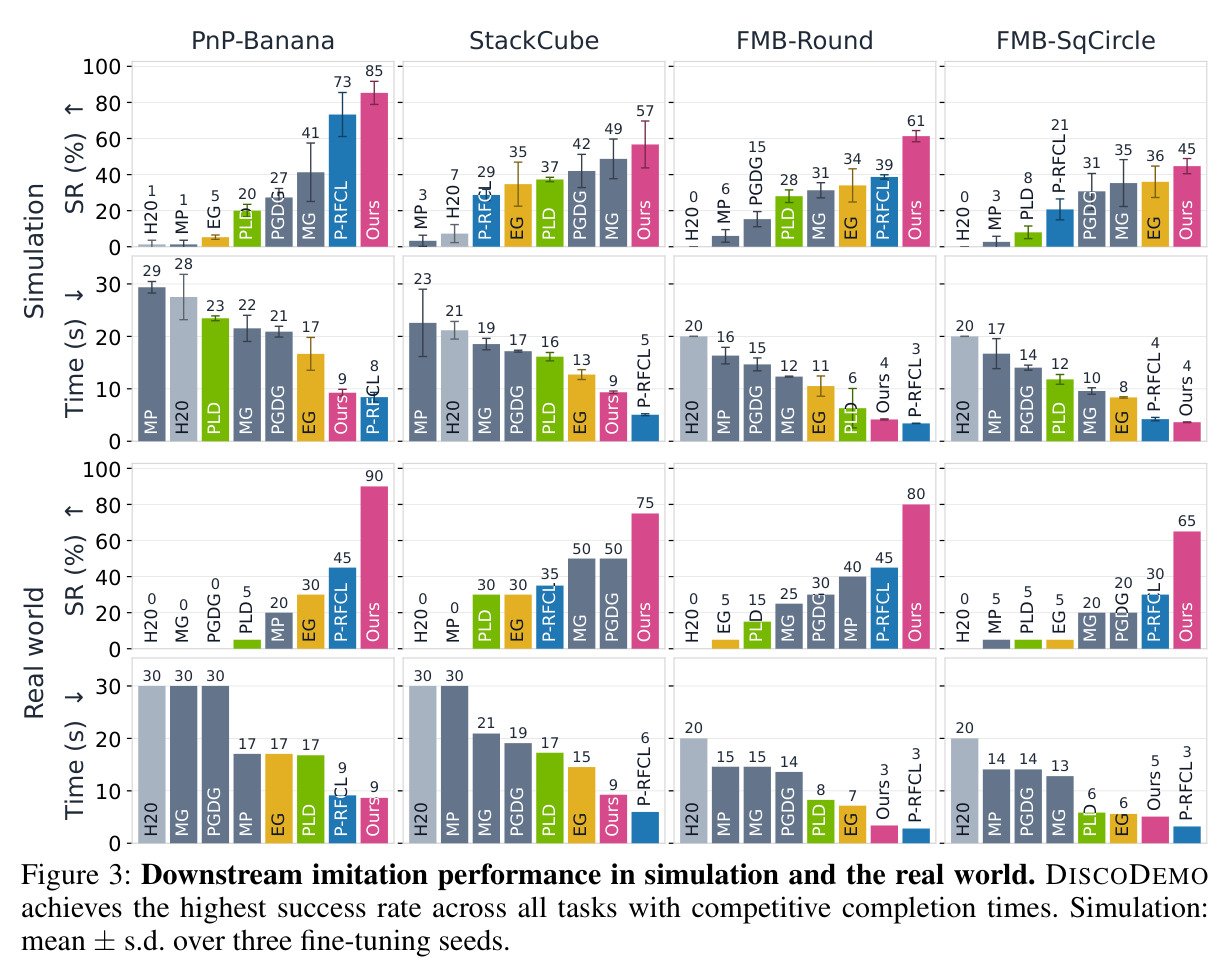
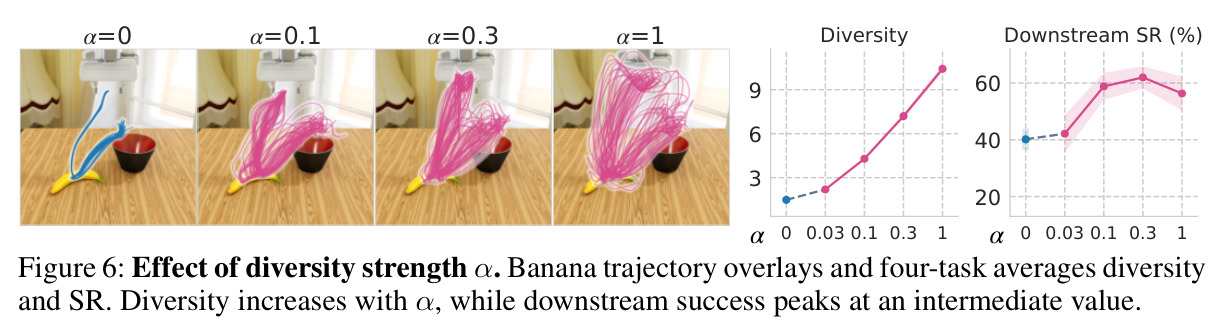
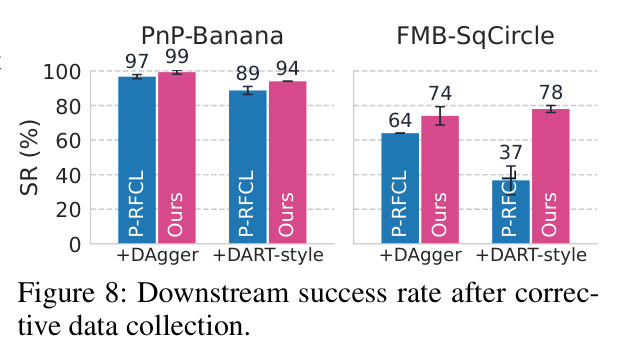
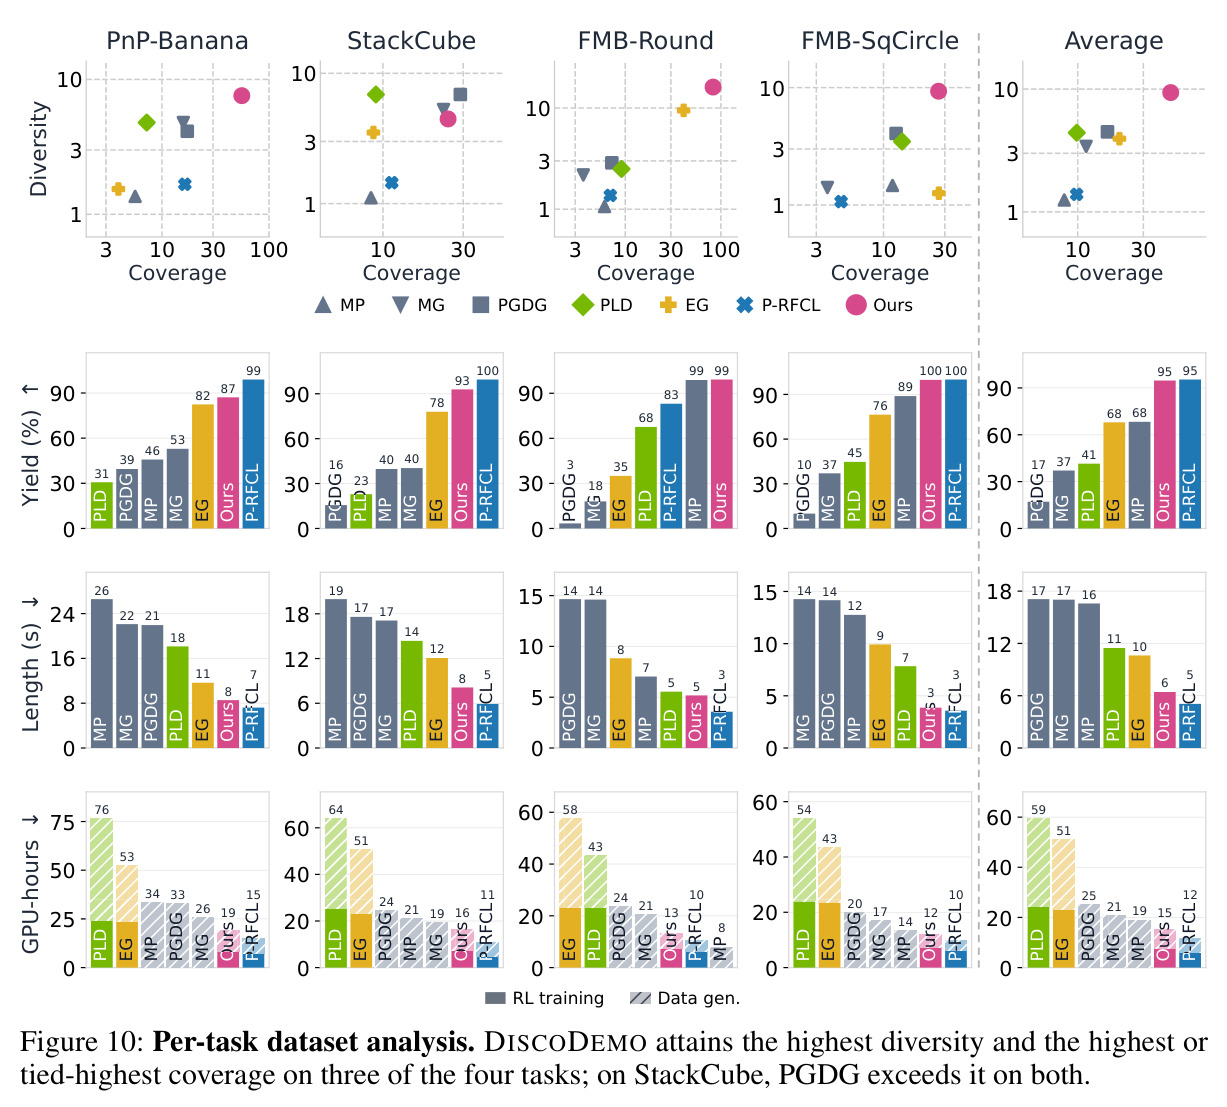
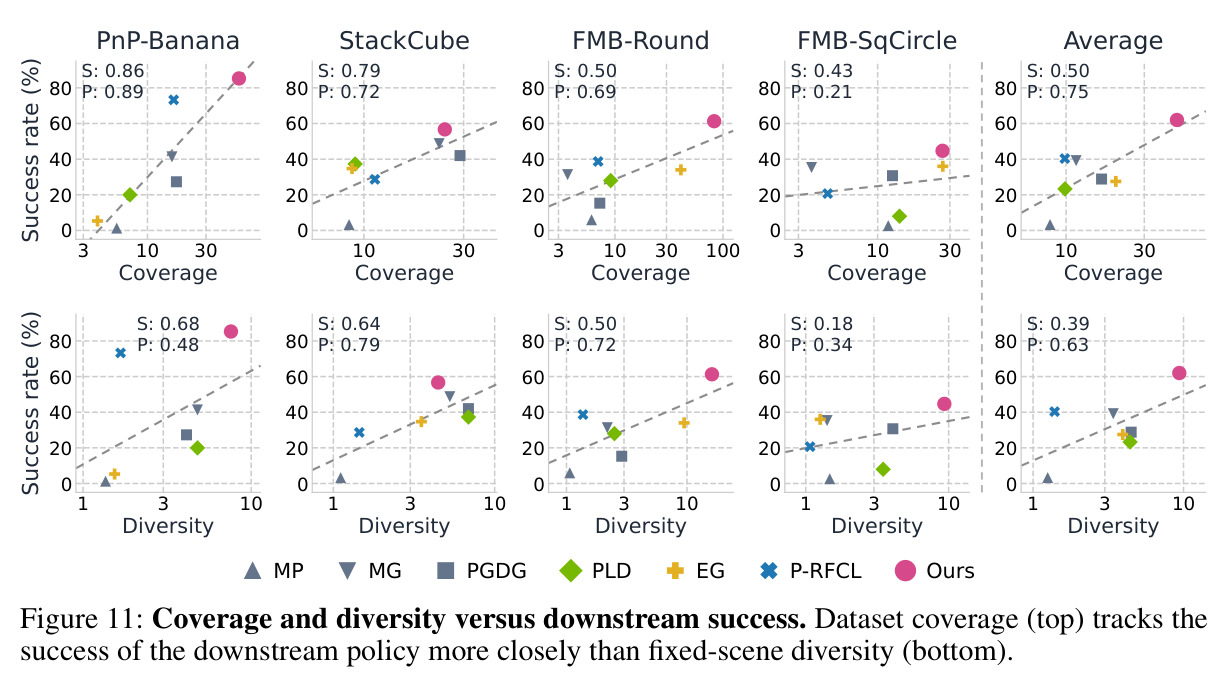
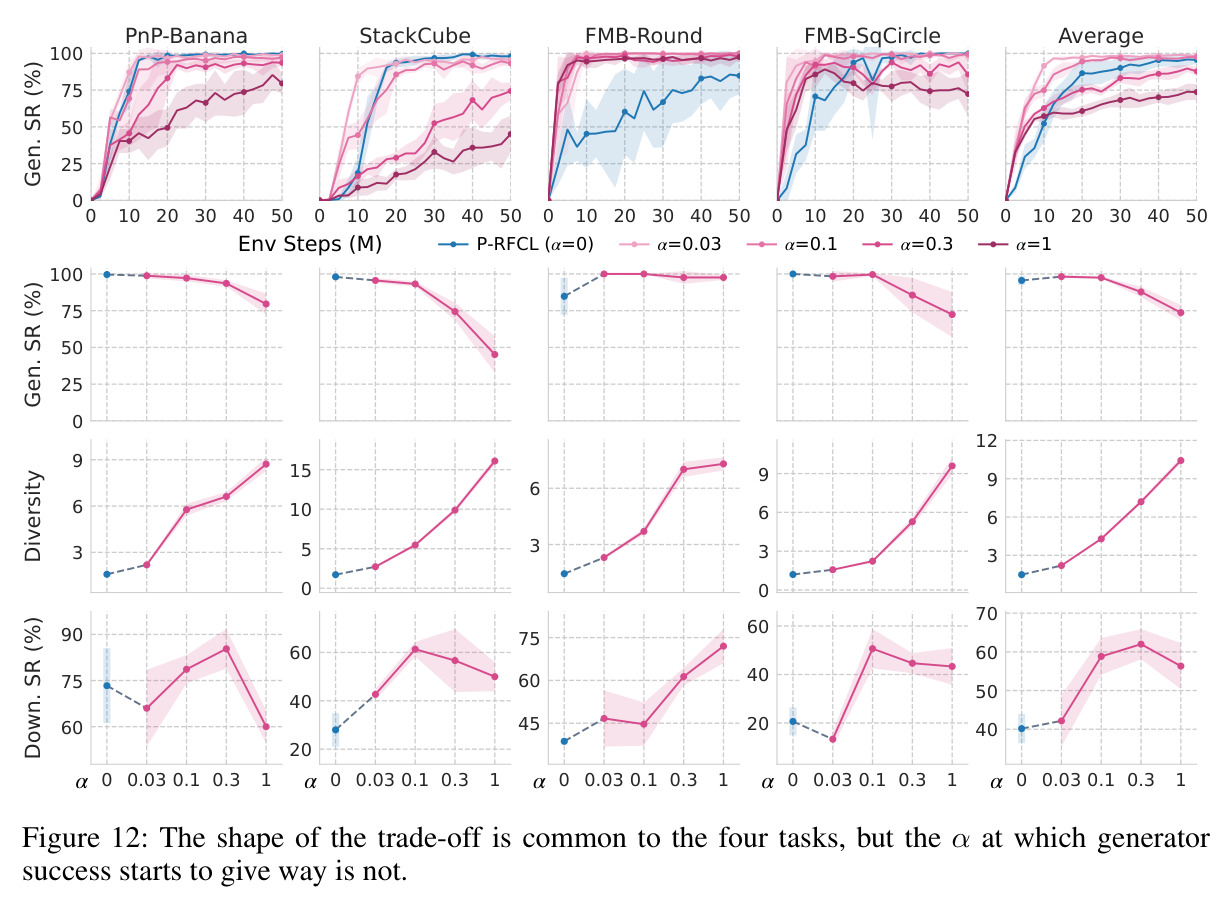
主结果(图 3,完整数据在表 7/8):所有数据源都提供 3000 条成功示教(H20 除外),微调同一个 DROID 预训练 π0.5,仿真每任务 3 种子×50 回合,真机每任务 20 次零样本部署。四任务平均,DiscoDemo 仿真成功率 62%,比最强基线 P-RFCL 的 40% 高 22 个百分点;真机 78% 比 39% 高 39 个百分点。逐任务看,仿真上 Ours 为 PnP-Banana 85.3%、StackCube 56.7%、FMB-Round 61.3%、FMB-SqCircle 44.7%,对应最大优势是 FMB-Round 上对 P-RFCL 的 +23 个百分点(61.3% 对 38.7%);真机上 Ours 为 PnP-Banana 90%、StackCube 75%、FMB-Round 80%、FMB-SqCircle 65%,最大优势是 PnP-Banana 上 +45 个百分点(90% 对 45%)。基线呈现清晰的行为学分工:20 条人类示教 H20 严重欠覆盖(真机全为 0%);运动规划 MP 数据量大但成功率低(真机 StackCube 0%);MimicGen 与 PGDG 相当强(真机 StackCube 各 50%)但继承人类示教的绕远路径,成功回合明显更长;P-RFCL 完成时间最短(仿真插入任务约 3.4 秒)却因解法单一导致下游一旦偏航难以恢复;PLD 与 ExpertGen 轨迹也短但成功率有限。数据集分析(图 5/10/11)用 Vendi 分数量化:DiscoDemo 平均获得最高多样性与覆盖;相关性分析显示数据集级覆盖与下游成功的相关强于固定场景多样性(平均 Spearman 0.50 对 0.39,PnP-Banana 0.86 对 0.68),但仅 7 个生成器 per 任务使系数噪声较大,且 StackCube 上 PGDG 覆盖更高而下游成功率仍低于 DiscoDemo(42.0% 对 56.7%)。$\alpha$ 扫描(图 6/12):$\alpha\in\{0,0.03,0.1,0.3,1\}$,多样性随 $\alpha$ 单调上升、证明目标可控,但四任务平均的下游成功率在中间值 $\alpha=0.3$ 达峰,过强的多样性开始以牺牲任务可靠完成为代价,每任务峰值在 0.1 到 1 之间。效率(图 7):P-RFCL 与 DiscoDemo 因轻量特权状态策略加并行仿真,训练远快于需反复调用视觉先验的 PLD/ExpertGen,多样性目标带来的表征学习开销相对很小。安全(表 1/6):塑形+过滤把 PnP-Banana 非法接触从 21.3 降到 6.8 N·s、FMB-SqCircle 从 73.0 降到 1.2 N·s;塑形把成功 rollout 的过滤通过率从 31.3% 提到 49.9%(PnP)、23.8% 提到 46.4%(SqCircle)。互补性(图 8):DAgger 与 DART 式纠正数据对 P-RFCL 有大幅提升,对 DiscoDemo 仍能继续提升且 DiscoDemo+纠正保持领先,说明解法多样性不消除学习者自身的分布偏移,但覆盖优势在加纠正后依然成立。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 四任务平均下游成功率(仿真,3 种子×50 回合) | Success Rate (%) | 62 | P-RFCL 40(最强基线);MG 39、PGDG 29、EG 28、PLD 23、MP 3、H20 2 | +22 个百分点 |
| 四任务平均下游成功率(真机 Franka FR3,零样本,每任务 20 次) | Success Rate (%) | 78 | P-RFCL 39(最强基线);PGDG/MG 25、EG 17.5、MP 16、H20 0 | +39 个百分点 |
| FMB-Round 插入(仿真) | Success Rate (%) | 61.3 ± 3.1 | P-RFCL 38.7 ± 1.2;EG 34.0;MG 31.3 | +22.6 个百分点(论文报告的最大仿真增益 +23pp) |
| PnP-Banana(真机) | Success Rate (%) | 90.0 | P-RFCL 45.0;EG 30.0;PGDG/MG/H20 0.0 | +45 个百分点(论文报告的最大真机增益) |
| 数据集安全质量(FMB-SqCircle 导出示教) | 非法接触 IC (N·s) ↓ | 1.2(塑形+过滤) | 73.0(无塑形无过滤) | 降低约 98% |
| 并行反向课程 vs 原版 RFCL 课程(反向阶段墙钟) | Wall-clock time | 29 分钟(2048 并行环境 + 池化推进准则) | 8.2 小时(原版 RFCL 每示教钉死一环境) | 约 17× 加速 |
局限与改进
作者承认的局限:方法依赖精确仿真、特权状态与指定状态重置访问、以及定义明确的成功信号,这限制了在动力学难以建模或目标含糊的任务上的适用性;评估仅限四个场景简单的桌面任务且 sim-to-real 差距不大,更复杂场景可能需要真机适配;安全准则是任务特定的手工规则;多样性目标鼓励“不同的成功行为”,但并不直接优化下游有用性。我的补充观察:真机评估每方法每任务只有 20 次试验且固定部署第一训练种子,没有种子间方差,39 对 78 的差距虽然巨大,但单点任务(如 StackCube 真机 75%)的置信区间很宽;三个 RL 基线均为作者重实现(PGDG 官方代码未公开、PLD/ExpertGen 被从视觉输入改为特权状态输入以在预算内收敛),与原论文数字不可直接比较,比较的公平性依赖作者的单点实现能力;数据规模固定在 3000 条,没有给出成功率随数据量的缩放曲线,无法判断多样性数据在 1 万条、10 万条尺度上是否仍保持优势;下游只测试了 π0.5 这一种 flow-matching VLA 架构,结论对扩散策略、ACT 等其他模仿学习骨干是否成立未验证;多样性指标本身(Vendi 分数)与下游成功的相关系数平均也只有 0.5 上下,说明“覆盖”仍是下游成功的代理指标而非充分解释,StackCube 的反例(PGDG 覆盖更高但成功率更低)也印证了这一点。
独立分析的弱点
第一,特权依赖是最大的适用性瓶颈:生成器需要 45 维特权状态、仿真器级指定状态重置和解析式成功判据,对于软体、流体、形变物体或接触动力学难以仿真的任务直接失效。改进方向:用视觉状态估计器替代特权输入、或用视觉/VLM 成功分类器替代解析判据,把生成器搬到“半特权”设定。第二,多样性目标与下游有用性之间只有间接联系:$\phi_\psi$ 度量的是特权状态空间位移,图 11 显示即便是最相关的数据集覆盖,Spearman 相关系数平均也只有 0.50,说明“状态空间上走得更开”不等于“BC 需要的监督更全”。改进方向:learner-aware 目标,例如按下游策略的预测误差或访问频率加权覆盖(把 DAgger 的“学习者误差区域”思想前移到数据生成阶段),或直接以若干候选下游策略的集成不确定性为多样性权重。第三,3 维固定高斯 $z$ 与整回合固定技能限制了可表达的解法结构——真实任务的解法族可能有内在维度更高或层次化的结构。改进方向:层次化/序列化技能(每段轨迹切换 $z$)、生成式技能先验或扩散式解法采样。第四,安全规范完全手工且任务特定(接触白名单、死区 5N/15N 都是拍出来的),换任务要重调。改进方向:用 LLM/VLM 从任务描述自动合成安全规范,或学习数据驱动的安全判别器。第五,评估统计强度不足:真机每格 20 次单种子,3000 条数据无缩放实验,单一下游架构;补齐种子×数据量×架构三个维度的消融会让结论更坚实。
未来方向
作者明确提出的方向包括:更通用的安全规范表达(摆脱任务特定规则),以及 learner-aware 的覆盖目标(直接以下游策略的效用为导向来分配数据覆盖)。基于本文成果可以自然延伸的方向还有:其一,把这套“RL 数据引擎”接到 VLA 预训练而非微调阶段——与 DLR 的路线合流,在数十个任务的仿真族上批量生产多样成功数据,用于扩大家庭机器人基础模型的操作数据分布;其二,闭环化:在 π0.5 微调后检测其失败状态分布,引导生成器的 $\rho_0$ 或多样性奖励向失败区域倾斜,形成“生成-训练-诊断-再生成”的主动数据循环;其三,与真机 RL 微调(如 RLDG)结合,用仿真生成的多样数据打底、少量真机纠偏收尾,降低整体数据成本;其四,理论上刻画多样性何时有益何时有害——作者引用了 Luo 等人 2026 关于几何熵的工作,指出过强多样性损害任务能力,一个把 $\alpha$ 与任务结构(可行解数量、接触模式数)联系起来的预测理论会很有价值;其五,扩展到双臂、灵巧手与移动操作,检验并行课程与成功门控在更高维动作空间中的可扩展性;其六,自动成功检测:用 VLM 判定自由形态任务的成功,替代解析判据,解除“成功信号必须明确定义”这一前提。
复现评估
复现条件较好。开源情况:代码、生成的数据集与训练好的 checkpoint 都已公开(GitHub: DAVIAN-Robotics/DiscoDemo,项目页 davian-robotics.github.io/DiscoDemo 含全部视频),且论文的附录异常详尽——任务规范(表 2 的初始分布与成功判据逐项给出)、生成器全部超参(表 3,从学习率到课程步长 $\Delta c=16$、前沿阈值 $p=0.9$ 无一遗漏)、每个基线的实现细节(附录 C 甚至给出了 PGDG 扰动的 B-spline 控制点数与 PLD 残差系数 0.4 这类实现级细节)、下游 π0.5 微调配方(表 5)与所有分析指标的精确定义(附录 E)。算力需求:生成器训练为单张 B200 上 50M 环境步、2048 并行环境,属于单 GPU 可承受的范围;数据渲染与 rollout 可多进程并行;下游微调需 π0.5 的 DROID 预训练权重并训练 vision encoder+LM+action expert,这是复现的主要算力门槛。硬件需求:真机部分需要 Franka Research 3 与 Meta Quest VR 遥操作采集的 20 条示教、标定好的双相机,无真机的读者只能复现仿真部分。难度评估:仿真端复现难度中等(依赖 Isaac Sim 场景重建与 FlashSAC 实现,两者均开源);难点集中在基线侧——PGDG 无官方实现需按附录 C 重写,PLD/ExpertGen 也需要按作者的状态化改法重实现;仿真主结果有 3 种子×50 回合的均值±方差可对照,复现验证标准清晰。总体属于机器人学习论文中复现友好度最高的一档。
论文图表
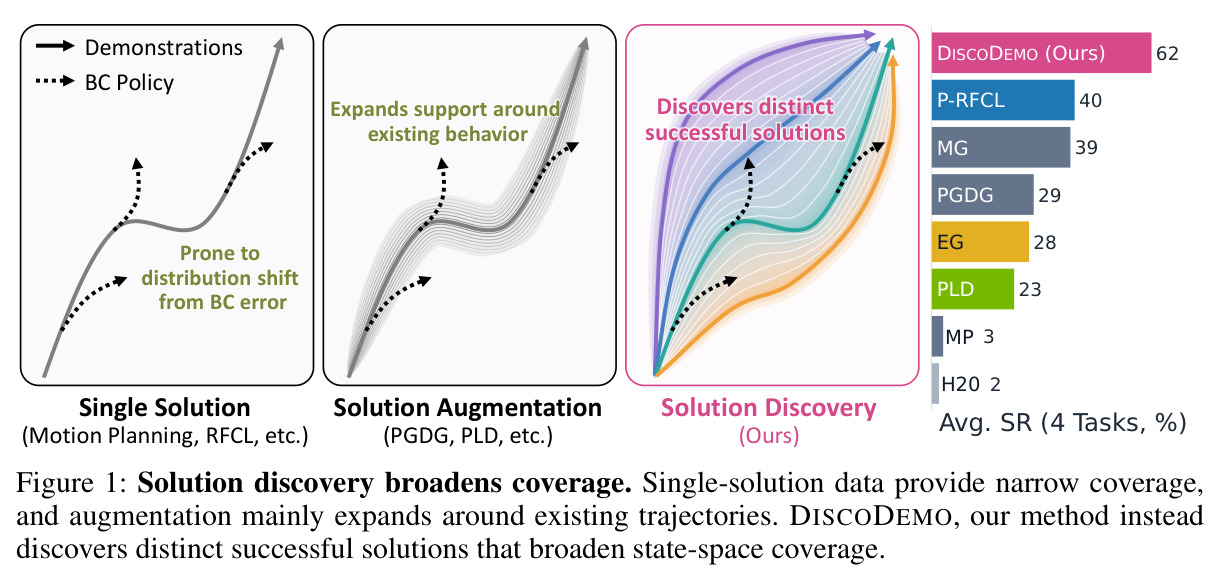
概念对比图加平均成功率条形图:左侧三栏分别展示“单解数据”(运动规划、RFCL 等,容易因 BC 误差产生分布偏移)、“解法增强”(PGDG、PLD 等,只在既有行为周围扩展)与“解法发现”(DiscoDemo,发现截然不同的成功解法);右侧条形图给出四任务平均仿真成功率:Ours 62%、P-RFCL 40%、MG 39%、PGDG 29%、EG 28%、PLD 23%、MP 3%、H20 2%。
这是全文的论点图:一图讲清“单解—增强—发现”三类数据生成范式的谱系与性能差距,是理解动机与定位的最佳入口。