HiP3R:面向长时程三维重建的分层位姿图优化 HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction
两级位姿图将分块前馈重建统一为全局一致的相机轨迹与三维几何,无需再训练
前置知识
位姿图优化(Pose Graph Optimization)
把相机或分块位姿作为图的节点,帧间/块间的相对运动测量作为边,通过最小化所有边残差(配 Huber 鲁棒核)求解全局一致的位姿;残差形如 $r=\mathrm{Log}(\hat{Z}^{-1}A_j^{-1}A_i)$,用稀疏雅可比的非线性最小二乘迭代求解,是 SLAM 后端的标准范式。
HiP3R 的两级图正是这一范式的两次应用,读懂边的构造与残差参数化是理解全文方法的前提。
Sim(3) 与 SE(3) 变换群
SE(3) 是刚体变换群,由旋转 $R$ 和平移 $t$ 组成;Sim(3) 额外携带尺度 $s$,即 $A(x)=sRx+t$。分块推理各自带未知尺度,块间对齐必须用 Sim(3);单个相机位姿本身不含尺度概念,帧级精化用 SE(3)。
论文的核心权衡就是“块级 Sim(3) 太刚性、帧级 SE(3) 全局求解太贵”,两个变换群的分工构成了分层设计的基础。
前馈 3D 基础模型与 pointmap
VGGT、VGGT-Omega 等模型一次前向即可从一组图像回归每像素 3D 点图(pointmap)、置信度与相机位姿,无需特征匹配和逐场景优化;但注意力的二次复杂度把输入限制在几十帧的窗口内。
HiP3R 完全冻结这些后端、只做后处理,输入正是分块推理输出的 pointmap 与位姿,“免训练、即插即用”是全文卖点。
ATE 与 RPE 评测指标
ATE 是逐序列做 Sim(3) 对齐后的平移 RMSE,衡量全局漂移;RPE 统计相邻帧($\Delta=1$)的相对旋转(单位为度)与平移误差,衡量局部精度;成对位姿 AUC@5°/15°/30° 评价所有 $i<j$ 相机对的相对误差。
论文所有实验结论都建立在这组指标上,例如 ATE 从 18.555 m 降到 4.906 m 就是核心证据,需先理解指标含义。
Umeyama 对齐与 IRLS
Umeyama 算法从对应 3D 点对闭式求解相似变换;IRLS(迭代重加权最小二乘)每轮执行加权 Umeyama 并按空间残差更新 Huber 权重,从而抑制离群点,是位姿图边测量的基本生成手段。
HiP3R 的重叠边与回环边都靠“限点采样 + 置信加权 IRLS Umeyama”生成,其质量直接决定后续图优化是否稳定。
研究动机
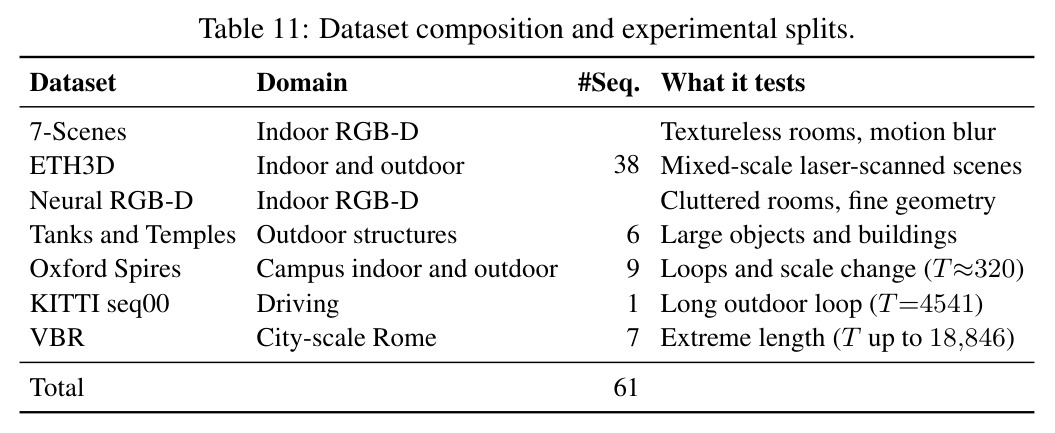
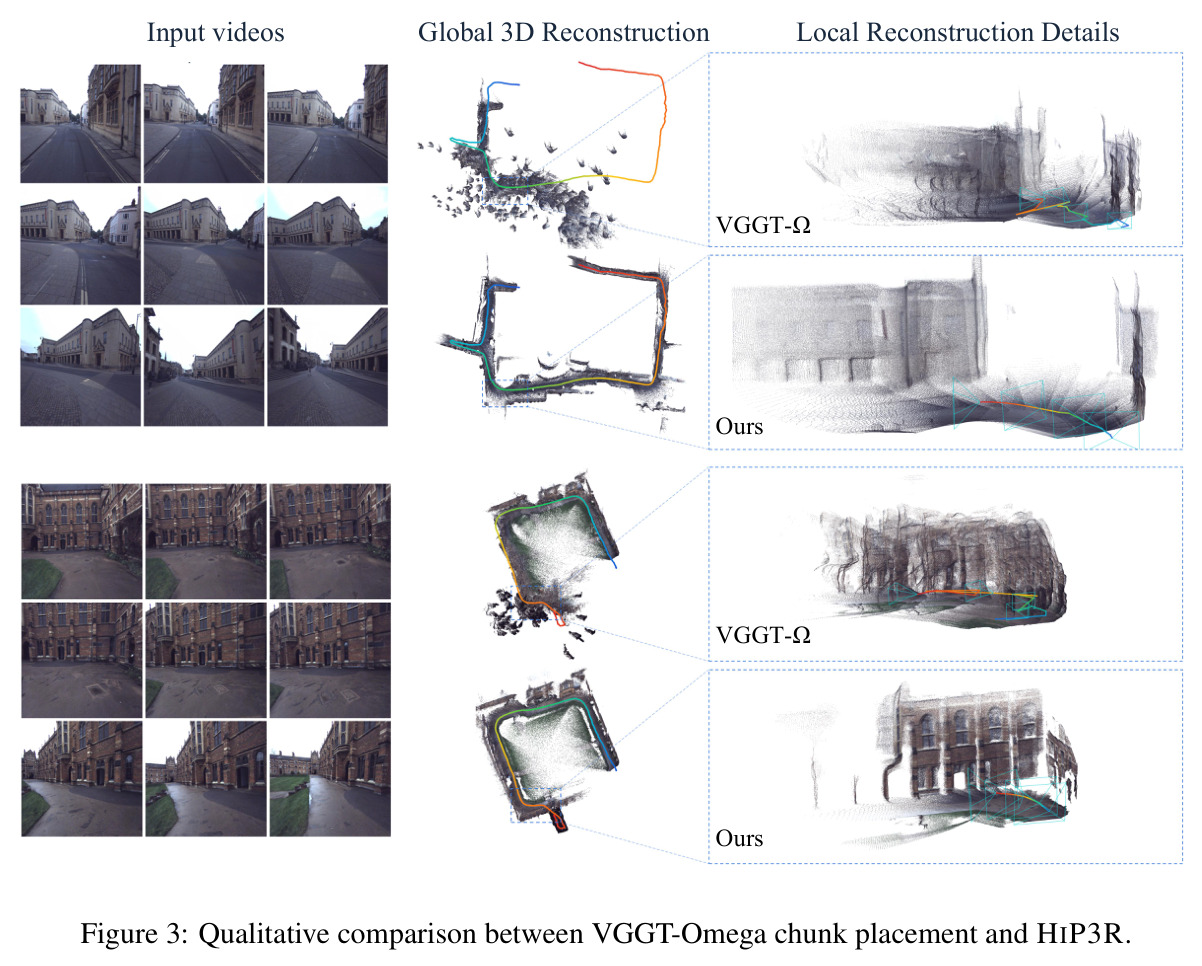
VGGT、VGGT-Omega 等前馈 3D 模型虽能一次前向同时回归相机位姿与稠密 pointmap,但视觉注意力的二次复杂度把输入限制在几十帧窗口(本文默认块大小 $C=60$、重叠 $O=30$)。处理 KITTI seq00(4,541 帧)或 VBR(单序列 8,815–18,846 帧)这类长视频只能切成重叠块独立推理再拼接。现有顺序对齐方法(VGGT-Long 等)面临三重困境:其一,全像素稠密对齐冗余昂贵,且成对对齐误差沿链条累积,无回环时 KITTI 的 ATE 高达 110.3 m、VBR 达 85.50 m;其二,把所有远距回环约束一次性加进非凸优化容易发散或陷入劣质局部极小;其三,也是更根本的,块级相似变换只能把整块刚性搬到全局坐标系,无法调和重叠窗口对同一物理帧给出的多个互相矛盾的相机位姿预测——任选一个都会丢弃多视角证据,并在块边界造成速度跳变,最终表现为墙面重影、表面复制等鬼影伪影。
本文的目标是本文的目标是:在不重训、不微调任何前馈后端的前提下,把数千帧长视频的局部重叠重建统一成单一全局一致的相机轨迹和点图。具体要同时做到四点:一是消除长序列累积的尺度与朝向漂移,让远距回访(distant revisit)能够真正闭合;二是为每个物理帧只保留一个相机位姿,调和跨窗口的冲突预测并消除块边界速度跳变;三是保持前馈模型给出的局部相对运动精度与度量尺度,不因全局对齐而破坏;四是把图构建与求解开销压到可扩展的水平,使其能作为通用后处理同时插到分块式(VGGT-Omega)与流式(LingBot-MAP)两类后端上,并在 CPU 上以秒到分钟级完成优化。
与已有工作不同的是,已有工作要么在块级做刚性 Sim(3) 链式对齐(VGGT-Long/Align/Motion),块内相机原封不动,跨窗口冲突无解;要么像 GlueMap 那样回到全局运动平均与捆绑调整,需要昂贵的稠密跟踪。HiP3R 的独特切入角度是把问题显式解耦成“全局布局”与“逐帧轨迹”两个粒度:先在块级用 Sim(3) 位姿图配合渐进式回环调度确立全局布局与尺度,再冻结布局、在帧级引入“每帧一个共享 SE(3) 相机变量”的位姿图,把每个块的预测都变成拉住同一变量的放置先验、把块内相对运动变成连接边。这样冲突预测被自然调和成一条轨迹,而不是被丢弃或简单投票。本质上,这是把经典 SLAM 位姿图针对前馈重建生态的一次重新设计,完全免训练。
核心方法
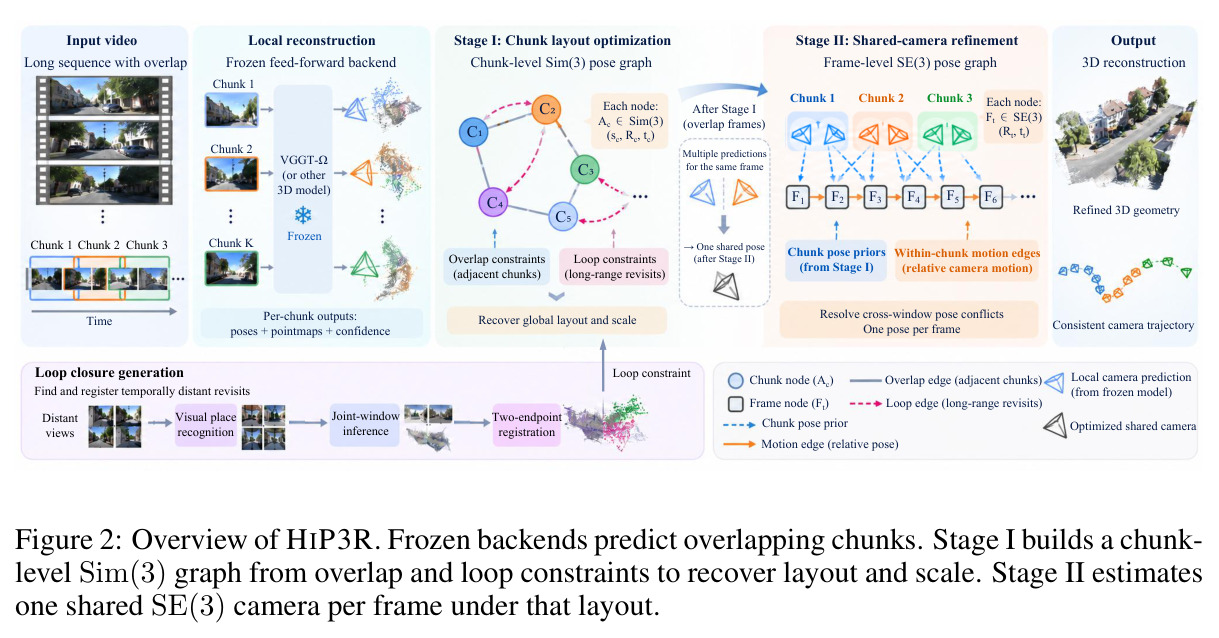
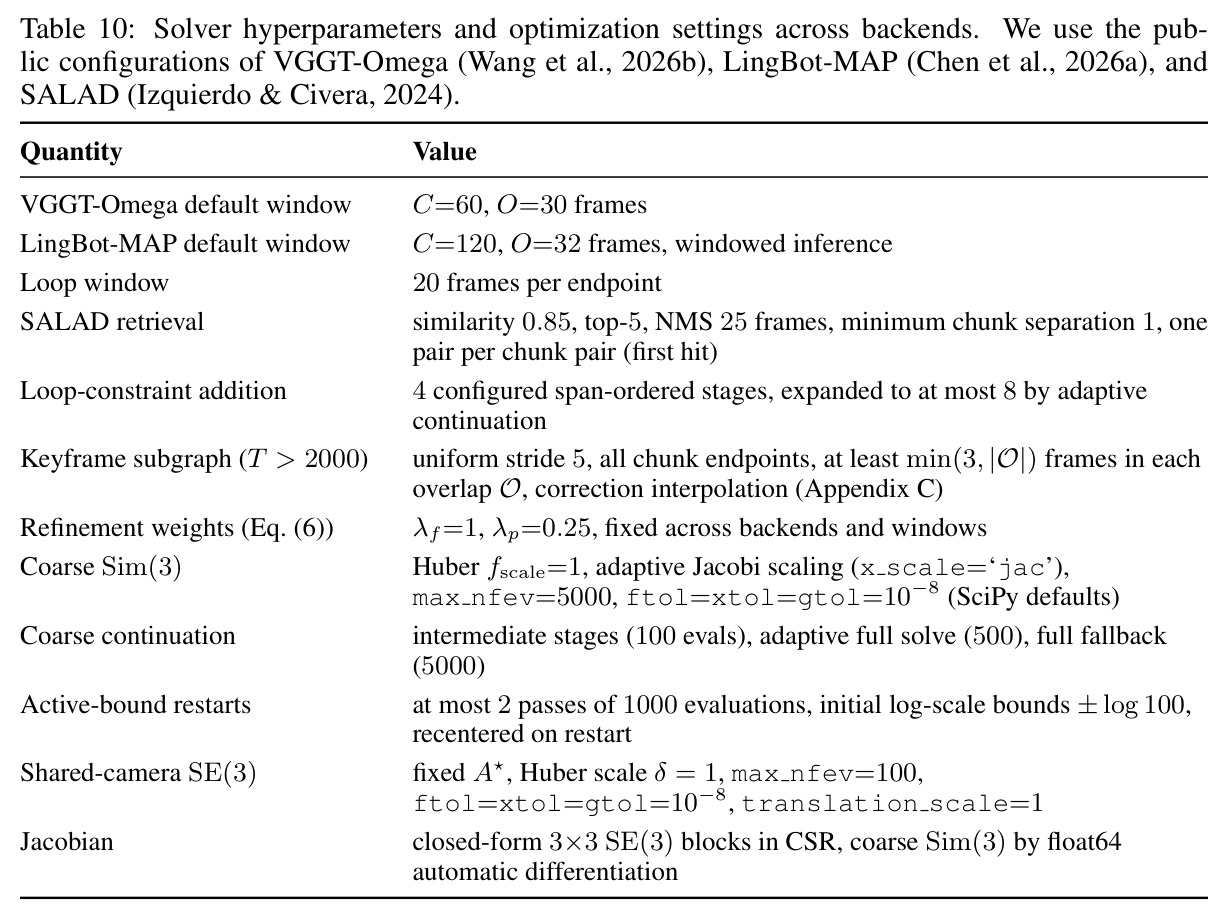
直觉上 HiP3R 先“摆正房间”,再“理顺步伐”。技术路线是两级位姿图:输入视频按 $C=60$、$O=30$ 分块,冻结的 VGGT-Omega 对每块输出 pointmap、置信度与块内位姿。Stage I 建块级 Sim(3) 图:节点是各块的相似变换 $A_k=(s_k,R_k,t_k)$,$A_k(x)=s_kR_kx+t_k$;边分两类——相邻块重叠边(用置信加权 IRLS 的 Umeyama 对齐、限点采样得到相对相似变换)与远距回环边(SALAD 检索回访、两端各取 20 帧做联合窗口重建后配准得到 $\hat{Z}_{ij}=B_jB_i^{-1}$,按配准残差赋有界权重);目标函数是 7 维残差 $r_{c_{ij}}=[\mathrm{Log}_{SO(3)}R(E_{ij}),\,\tau(E_{ij}),\,\log s(E_{ij})]$ 的 Huber 加权和,固定 $A_1$ 作尺度参考,用渐进回环调度和有界信赖域最小二乘求解,得到全局一致的块摆放 $A^\star$。Stage II 冻结 $A^\star$,为每个物理帧引入共享相机 $F_t\in SE(3)$,联合最小化块内运动边残差 $r_f\in\mathbb{R}^6$ 与放置先验残差 $r_p\in\mathbb{R}^6$($\lambda_f=1,\lambda_p=0.25$),用闭式雅可比的稀疏求解器在 CPU 上解出单一轨迹;长序列再借 stride-5 关键帧子图与修正插值 $\Delta_t=F_tQ_t^{-1}$ 扩展到全部帧,几何用刚体修正跟随相机、保持深度与块尺度。
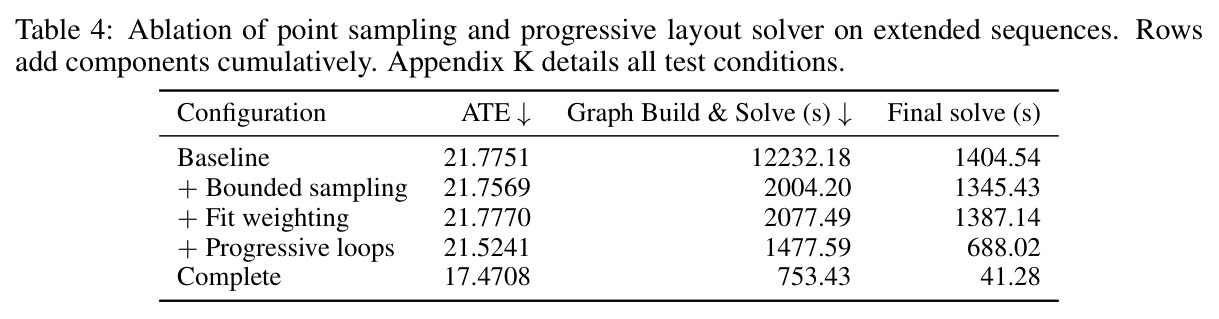
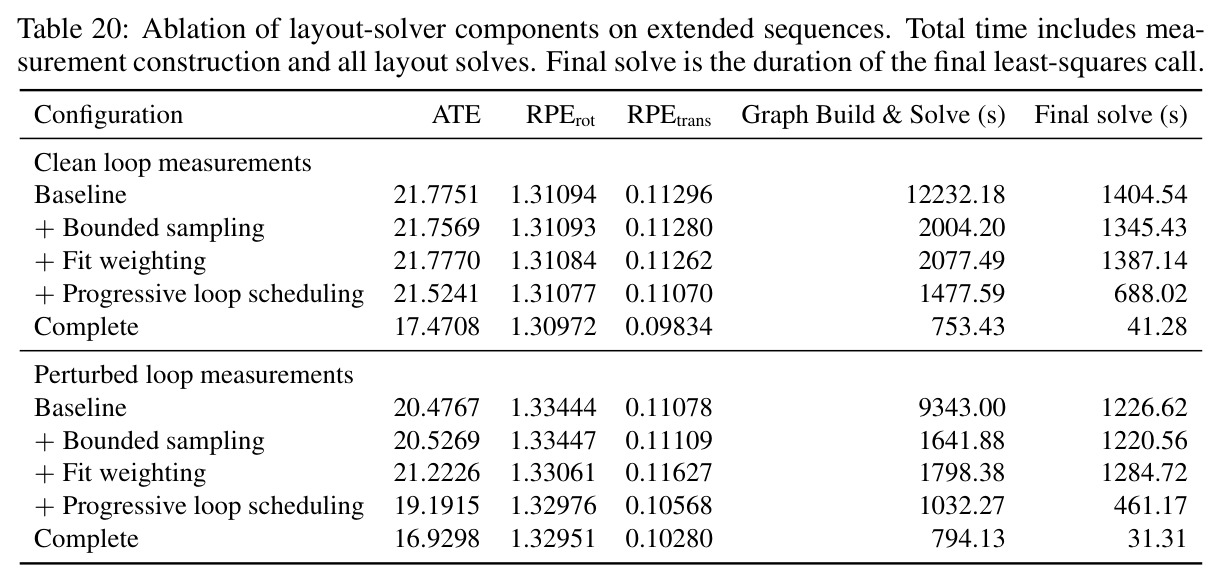
核心创新是“共享相机帧级图”:每个物理帧 $t$ 只有一个相机变量 $F_t\in SE(3)$,而观测到该帧的每个块都提供一元放置先验 $E_p=Q_{k,i}^{-1}F_{g(k,i)}$,块内相邻保留节点之间再连相对运动边 $M_{k,i\to j}=Q_{k,j}^{-1}Q_{k,i}$。与已有方法的本质区别在于:VGGT-Long/Align 对每块施加一个相似变换并保留块内相机,天然无法调和重叠区的矛盾预测;全捆绑调整又太贵且破坏度量尺度。HiP3R 让所有矛盾观测同时约束同一变量,既不丢多视角证据,又因布局冻结而保住尺度。第二项创新是渐进式回环调度:从顺序初始化出发,按回环时间跨度从小到大分阶段(默认 4 阶段、可自适应扩到 8)引入回环边,每阶段以上一阶段解为初值,避免一次性远距约束使非凸优化发散;配合基于配准残差的有界边权 $w_{ij}=\mathrm{clip}(\sigma/(\sigma+\max(q_{ij},0)),\,0.05,\,1)$ 抑制坏回环。第三是系统工程层面:有界点采样(每对至多 $2\times10^5$ 点)与闭式 SE(3) 雅可比,使构建+求解时间从 12,232 s 降到 753 s 且精度反而更好。
方法步骤详情
第一步 分块推理:长视频切成重叠块(VGGT-Omega 取 $C=60/O=30$,LingBot-MAP 取 $C=120/O=32$),冻结后端输出每块的 pointmap $X_{k,i}$、置信度 $\gamma_{k,i}$ 与相机位姿 $P_{k,i}=[R_{k,i}\mid c_{k,i}]$。第二步 边测量构建:相邻块在重叠帧上取配对 3D 点(均匀采样至多 $2\times10^5$ 对、置信度取几何平均),运行至多 10 次带自适应 Huber 阈值的 IRLS 加权 Umeyama 得相对相似变换;SALAD(相似度阈值 0.85、top-5、NMS 25 帧)检索回访对,把两端各 20 帧邻域拼成联合窗口送入后端重建,再将两端预测对齐回原块得 $\hat{Z}_{ij}=B_jB_i^{-1}$。第三步 Stage I 求解:固定 $A_1$,从顺序链初始化,按回环跨度升序分阶段加入回环边(每阶段以上一阶段解为起点),用有界信赖域反射最小二乘最小化式 (2),log-scale 约束 $\pm\log 100$,活跃界触发暖启动重启,输出 $A^\star$。第四步 Stage II 求解:每帧以首次出现的粗放置位姿初始化 $F_t=Q_t$,对保留节点连块内运动边并附各块放置先验,最小化式 (6);$T>2000$ 时改用 stride-5 关键帧子图(含全部块端点与重叠帧)。第五步 几何更新:pointmap 先经 $A_k^\star$ 放入世界系,再施刚体修正 $F_{g(k,i)}Q_{k,i}^{-1}$;关键帧间修正用旋转 Slerp、平移 Lerp 插值(式 18)恢复稠密轨迹并同步搬动几何。
技术新颖性
技术新颖性体现在四个层面。问题层面:论文首次明确指出“跨窗口相机位姿不一致”是与尺度漂移正交的独立失败模式——块级 Sim(3) 对齐再好也解决不了同一帧被预测成多个位姿的问题(Figure 1 中 Scene 2 误差 0.05627→0.01659→0.00818 的三段下降正对应两种失败模式的先后修复)。建模层面:共享相机节点把“观测冗余”变成“约束冗余”,图规模只随物理帧数而非“块数×帧数”增长。优化层面:渐进回环调度把经典的“一次性加入所有回环”改为按时间跨度升序的课程式引入,配合残差拟合的软权重而非硬剔除,是有别于 g2o/GTSAM 常规用法的稳定性技巧。工程层面:SE(3) 残差被因子化为旋转残差不含平移、平移残差不含源旋转的形式,每条边仅 5 个非零 $3\times3$ 雅可比块,配合 CSR 稀疏结构与批量 $3\times3$ 乘法,雅可比构建无需求残差扫描;Sim(3) 块用 float64 自动微分,与数值导数差仅 $1.1\times10^{-8}$。消融证明这些组件叠加把 10 条长序列的平均 ATE 从 21.78 m 降到 17.47 m、时间从 12,232 s 降到 753 s。
实验结果
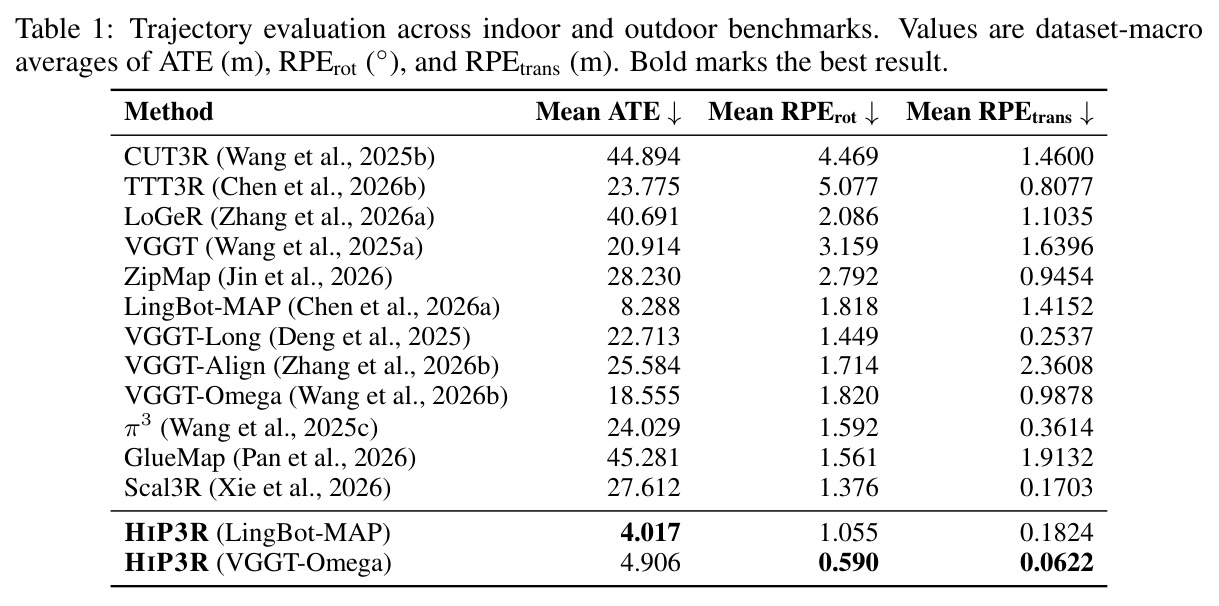
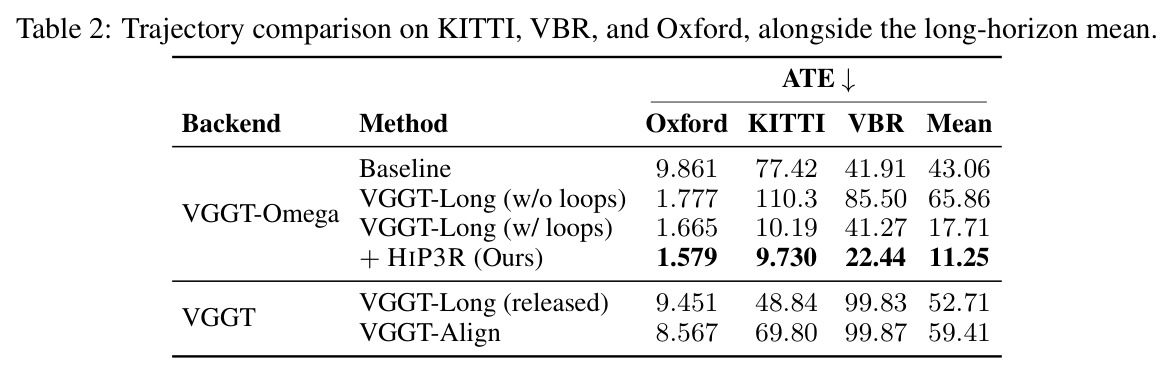
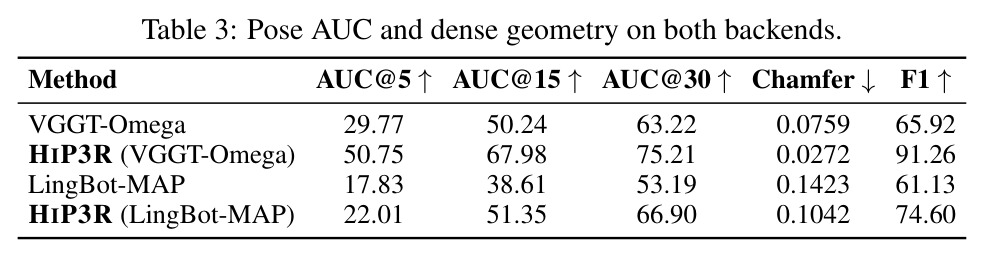
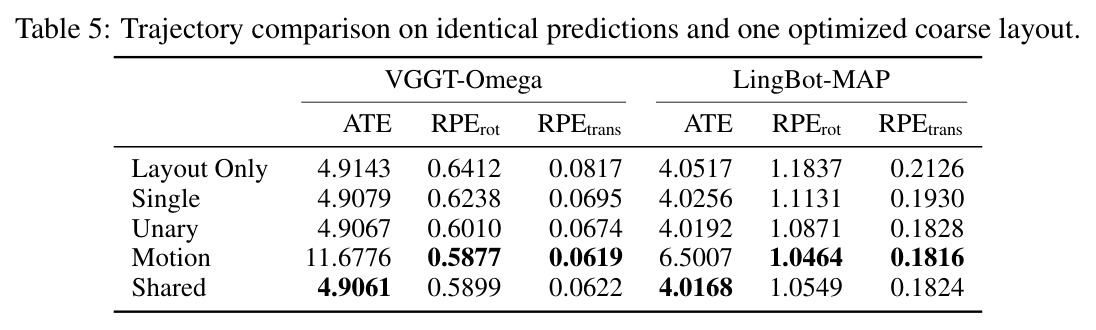
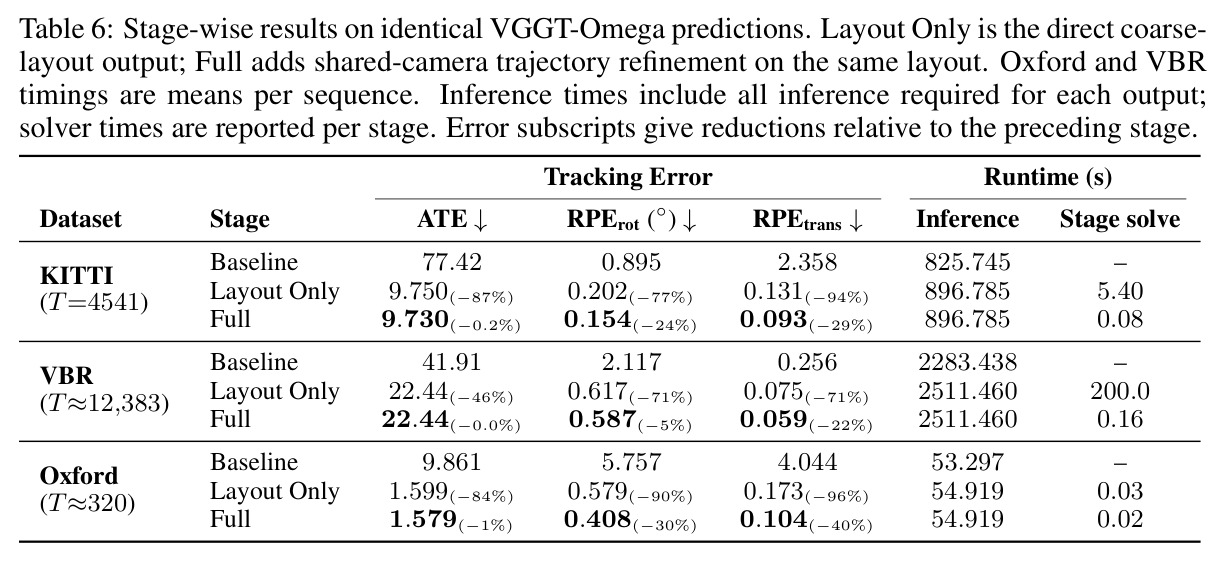
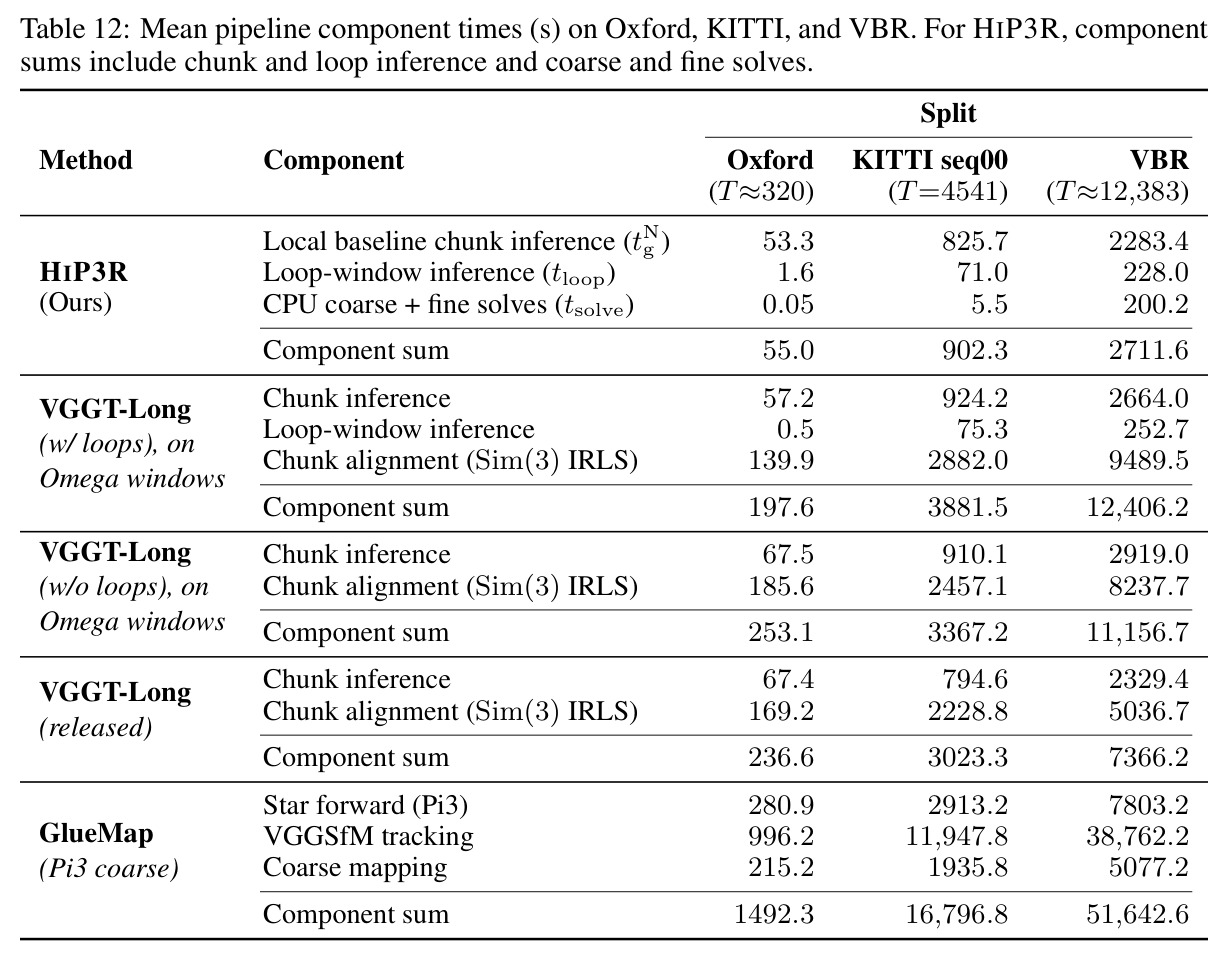
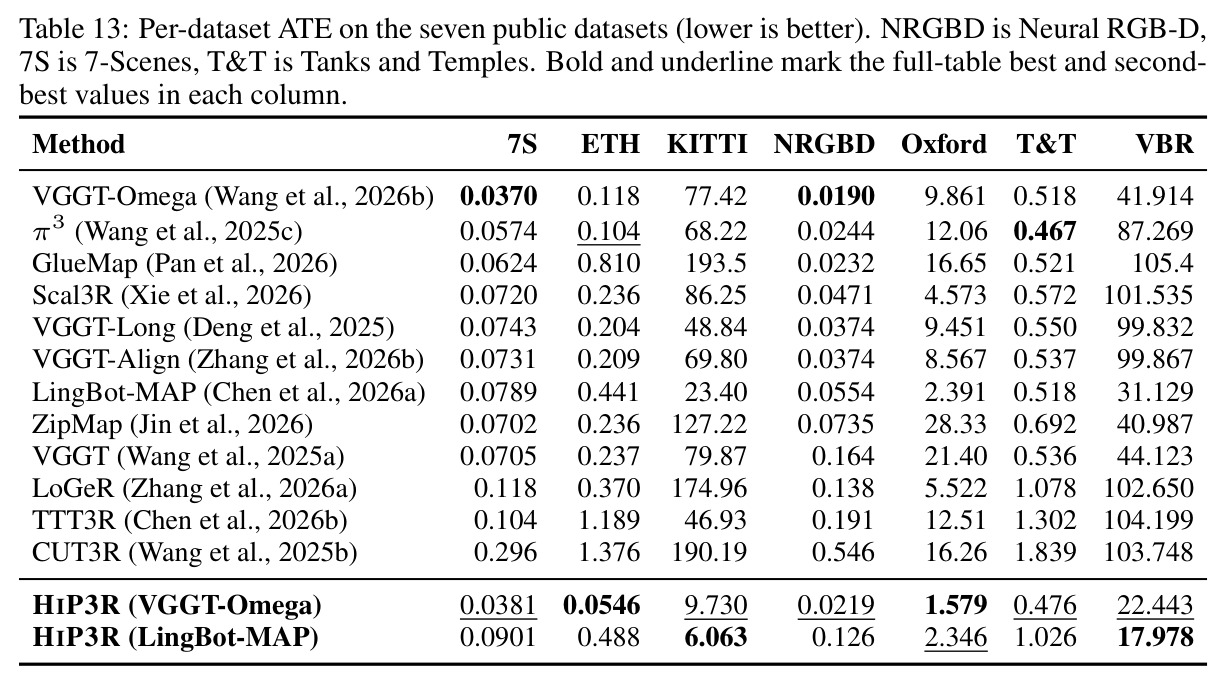
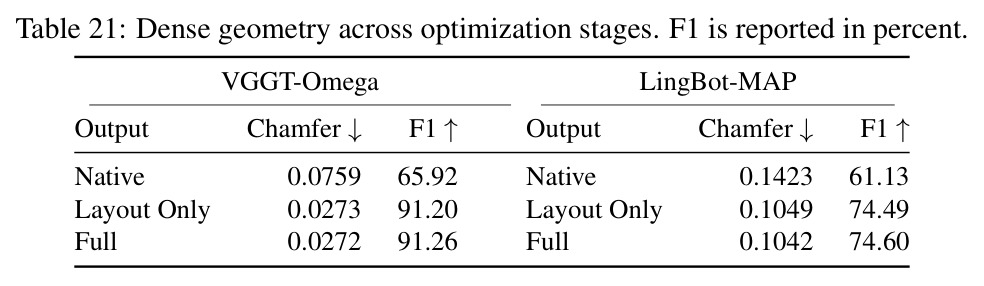
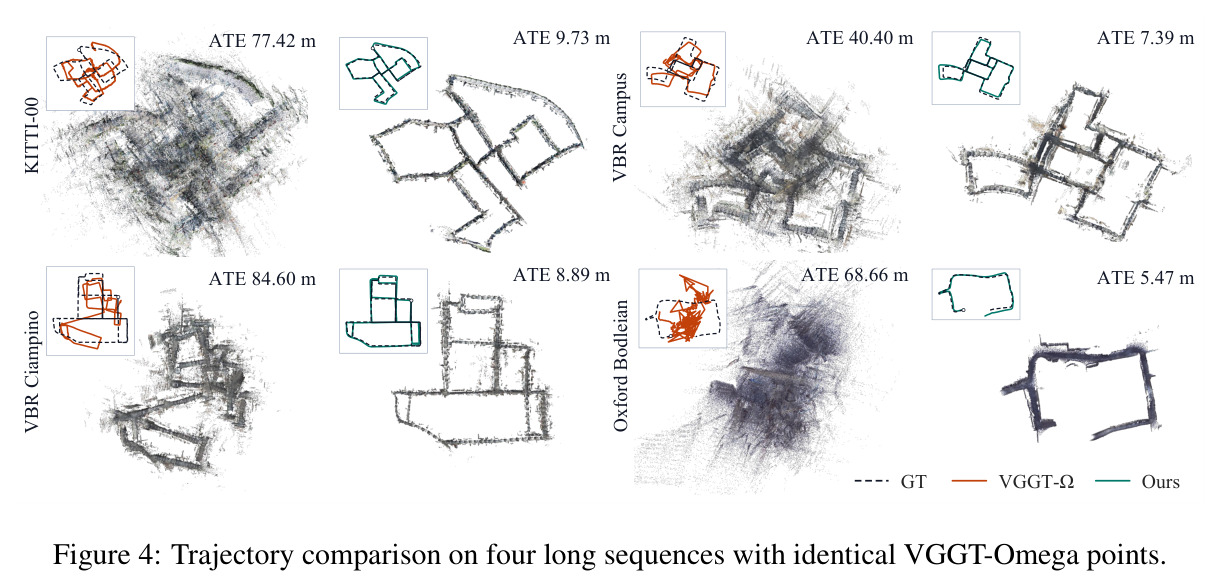
论文在 7 个公开基准、61 条序列上评测(Table 1 为宏平均)。其一,总体轨迹:以 VGGT-Omega 为后端,HiP3R 把 ATE 从 18.555 降到 4.906 m(−74%)、$\mathrm{RPE}_{rot}$ 从 1.820° 降到 0.590°、$\mathrm{RPE}_{trans}$ 从 0.9878 降到 0.0622 m(−94%);换流式后端 LingBot-MAP,ATE 从 8.288 降到 4.017 m(−52%),全程无需微调。分数据集(Table 13)收益集中在长序列:KITTI 77.42→9.730 m、VBR 41.914→22.443 m、Oxford 9.861→1.579 m、ETH3D 0.118→0.0546 m,而 7-Scenes 基本持平(0.0370→0.0381 m),因室内基线已达厘米级。其二,控制变量对比(Table 2):KITTI 上 VGGT-Long 无回环/带回环/HiP3R 依次为 110.3/10.19/9.730 m,VBR 为 85.50/41.27/22.44 m(剩余误差近乎减半),三集均值 65.86→17.71→11.25 m。其三,位姿与几何(Table 3):AUC@5° 29.77→50.75、AUC@15° 50.24→67.98、AUC@30° 63.22→75.21;Chamfer 0.0759→0.0272 m(−64%)、F1 65.92→91.26,Chamfer 收益主要来自 Stage I(Table 21:0.0759→0.0273),Stage II 把 F1 推至 91.26。其四,消融(Table 4/20):有界点采样把构建+求解时间从 12,232.18 s 砍到 2,004.20 s(−83.62%)而 ATE 几乎不变;完整求解器达 17.4708 m、753.43 s,末次求解仅 41.28 s;对 25% 回环注入 10° 旋转、25% 平移偏移与 0.10 log-scale 噪声时反而更稳(16.93 m)。其五,轨迹形成消融(Table 5):只用运动边不用放置先验会使 ATE 恶化到 11.678 m,证明先验保布局、运动边提平滑的互补分工。其六,效率(Table 12):VBR(约 12,383 帧)端到端 2,711.6 s,VGGT-Long 带回环 12,406.2 s,GlueMap 高达 51,642.6 s。
局限与改进
作者承认的局限:一是短序列室内场景收益有限,7-Scenes/Neural RGB-D 上基线已达厘米级(0.037/0.019 m),且 11 条 ETH3D 静态序列中 10 条单块即可容纳,两级图根本不会被激活,方法退化为原预测;二是系统目前是离线批处理,需要整段视频与全部块的缓存,结论明确指出扩展到在线更新与提升对不可靠回环的鲁棒性是未来工作;三是回环质量完全依赖视觉地点识别(SALAD)与配准残差加权,重复纹理或无回访场景只能退化为顺序对齐。我的补充观察:其一,布局冻结是双刃剑,Stage I 的尺度/朝向错误无法被 Stage II 纠正,误差按层级单向传播;其二,帧级优化假设块内相对运动准确,若后端在弱纹理、运动模糊段内部漂移,运动边会把错误固化为轨迹;其三,LingBot-MAP 后端上 ETH3D(0.441→0.488)、7-Scenes(0.0789→0.0901)等指标不升反降,说明缺少按块置信度自适应启用/关闭细阶段的机制;其四,ATE 评测先做逐序列 Sim(3) 对齐,对绝对尺度误差不敏感,度量尺度的改善在指标上被部分掩盖;其五,刚体修正只搬动 pointmap,不解决重叠区深度本身的矛盾,表面重影只能缓解而非根除。
独立分析的弱点
第一,无在线能力:两阶段都要求先看完整个序列,机器人实时导航用不上,改进方向是把 Stage I 改为滑动窗口增量式优化、由回环触发局部重优化(类似增量 SLAM 的边际化思路)。第二,单一全局尺度参考:固定 $A_1$ 为世界系与尺度基准,若开头块退化(低纹理、夜景)会污染全局尺度,可引入多个尺度锚点或把尺度作为带先验的软约束。第三,回环验证单薄:只靠配准残差 p95 的有界权重,地点识别本身失败时缺乏几何一致性校验,可引入多检索器一致性与成对几何一致性图筛选。第四,几何融合浅层:帧级修正只是刚体搬动 pointmap,重叠区两份深度预测的矛盾没有真正融合,仍可能出现双层表面,可在高置信重叠区做轻量深度一致性精化或 TSDF 融合。第五,后端无自适应:LingBot-MAP 在 ETH3D/7-Scenes 上细阶段反而略降,应按每块置信度与图能量变化自适应决定是否启用细阶段及 $\lambda_p$ 取值。第六,关键帧插值在急转弯或非匀速运动下会产生轨迹不平滑,可改用运动自适应的关键帧密度(论文的 motion stride 已给出雏形)。
未来方向
作者明确提出的方向:把层级结构扩展到在线/增量更新以支持实时机器人应用;提高对不可靠回环约束的鲁棒性。基于本文成果可自然延伸的方向包括:(1)端到端化——把两级图作为可微分层并入前馈模型训练,让网络学会预测边置信度与协方差,替代手工设计的 $w_{ij}$;(2)与神经渲染结合——用优化后的位姿直接喂 3DGS/NeRF,并把渲染一致性反过来作为新的回环验证信号;(3)动态场景——为运动物体加分割掩码或动态边,扩展到有行人车辆的城市街景;(4)更大规模——VBR 已到 18,846 帧,进一步测试城市级(10 万帧以上)与多楼层室内,检验渐进调度的极限;(5)与流式模型深度耦合——LingBot-MAP 实验已证明可行性,可设计流式增量版 HiP3R,让布局图随视频增长在线更新;(6)求解器 GPU 化与增量 CSR 更新,把 VBR 的 200 s CPU 求解压到秒级;(7)处理重复结构(长走廊、隧道)等回环检测本身失效的场景,融合 IMU/LiDAR 先验做跨模态约束。
复现评估
复现条件相当友好:方法完全不需要训练,所有后端均用公开 checkpoint(VGGT-Omega 1B、LingBot-MAP、SALAD),全部 7 个评测数据集公开可下载(7-Scenes、Neural RGB-D、ETH3D、Tanks and Temples、Oxford Spires、KITTI seq00、VBR),附录 D 的 Table 10 完整披露超参数:块 $C=60/O=30$、精化权重 $\lambda_f=1/\lambda_p=0.25$、Huber $\delta=1$、log-scale 界 $\pm\log 100$、信赖域容差 $10^{-8}$、SALAD 相似度 0.85/top-5/NMS 25 帧、关键帧 stride-5 等。算力需求:块推理在单 GPU(论文未注明型号),图求解全部在 CPU 上(float64 SciPy 信赖域 + CSR 稀疏雅可比),最长序列 VBR 端到端约 2,711.6 s,普通工作站即可承担。项目主页为 https://kkakkkka.github.io/HiP3R。风险点主要在工程细节:闭式雅可比、渐进调度器与重启逻辑需要仔细对照附录 B/D 实现;回环检索阈值在不同域的数据上可能需要微调。总体难度中等偏低——数据、超参与求解器设置披露充分,若代码开源则多数结果可直接复跑。
论文图表
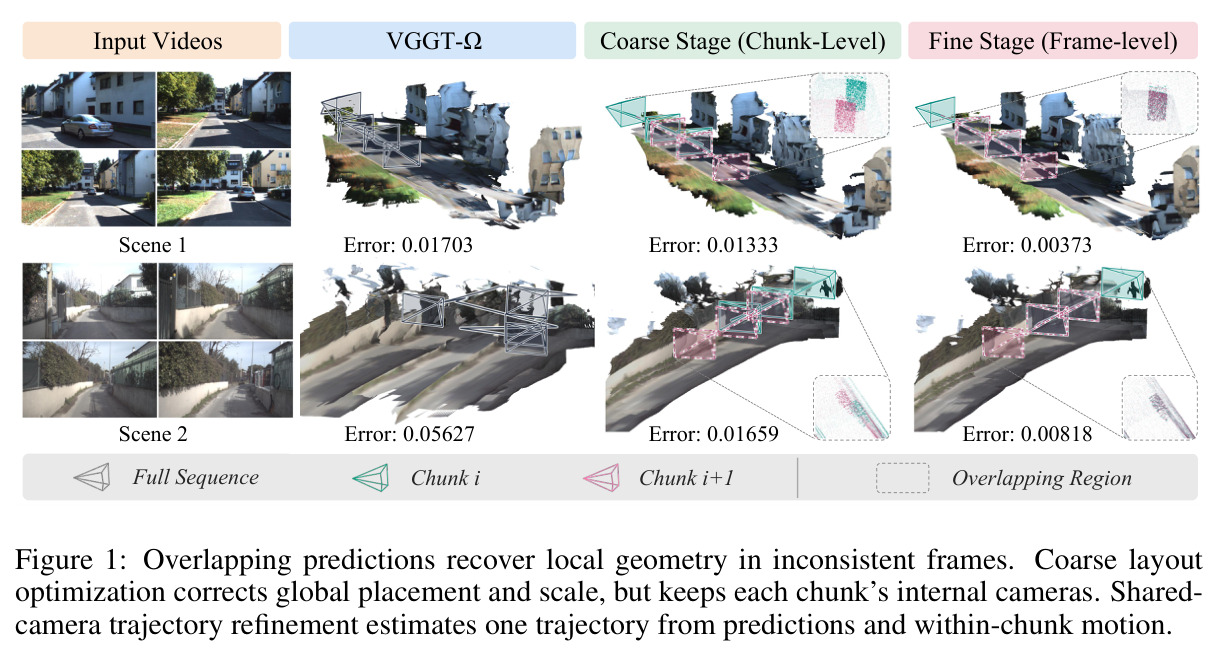
两个场景上三个阶段的误差对比:VGGT-Ω 直接输出(Scene 1 误差 0.01703、Scene 2 误差 0.05627)、粗阶段块级优化(0.01333/0.01659)、细阶段帧级共享相机精化(0.00373/0.00818),并标注了 Chunk i、Chunk i+1 与重叠区的边界。
用一张图把“块级布局/尺度误差”与“帧级位姿冲突”两种失败模式以及两级阶段各自的量化收益直观呈现,是理解论文动机与分层设计的最佳入口。