GLOW-FM:单步潜空间流匹配的高效生成式低光图像增强 GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
用终端速度匹配在冻结Tiny-VAE潜空间一步完成低光增强,单NFE仅34–48 GFLOPs
前置知识
低光图像增强(LLIE)与感知-失真权衡
LLIE 旨在把严重欠曝、带传感器噪声、颜色失真的低光图像恢复为曝光正常、细节真实的图像。评测分两条线:配对数据集上用 PSNR/SSIM/LPIPS 衡量失真与感知相似度;无参考场景用 NIQE/MUSIQ/BRISQUE 衡量自然度。Blau & Michaeli 的感知-失真权衡指出这两族指标存在结构性张力,生成式方法通常牺牲失真指标换取感知质量。
全文所有实验对比都建立在这套任务定义与指标体系上;理解感知-失真权衡才能读懂『一步生成方法 PSNR 更低但 NIQE/MUSIQ 更好』这类结果。
流匹配(Flow Matching)
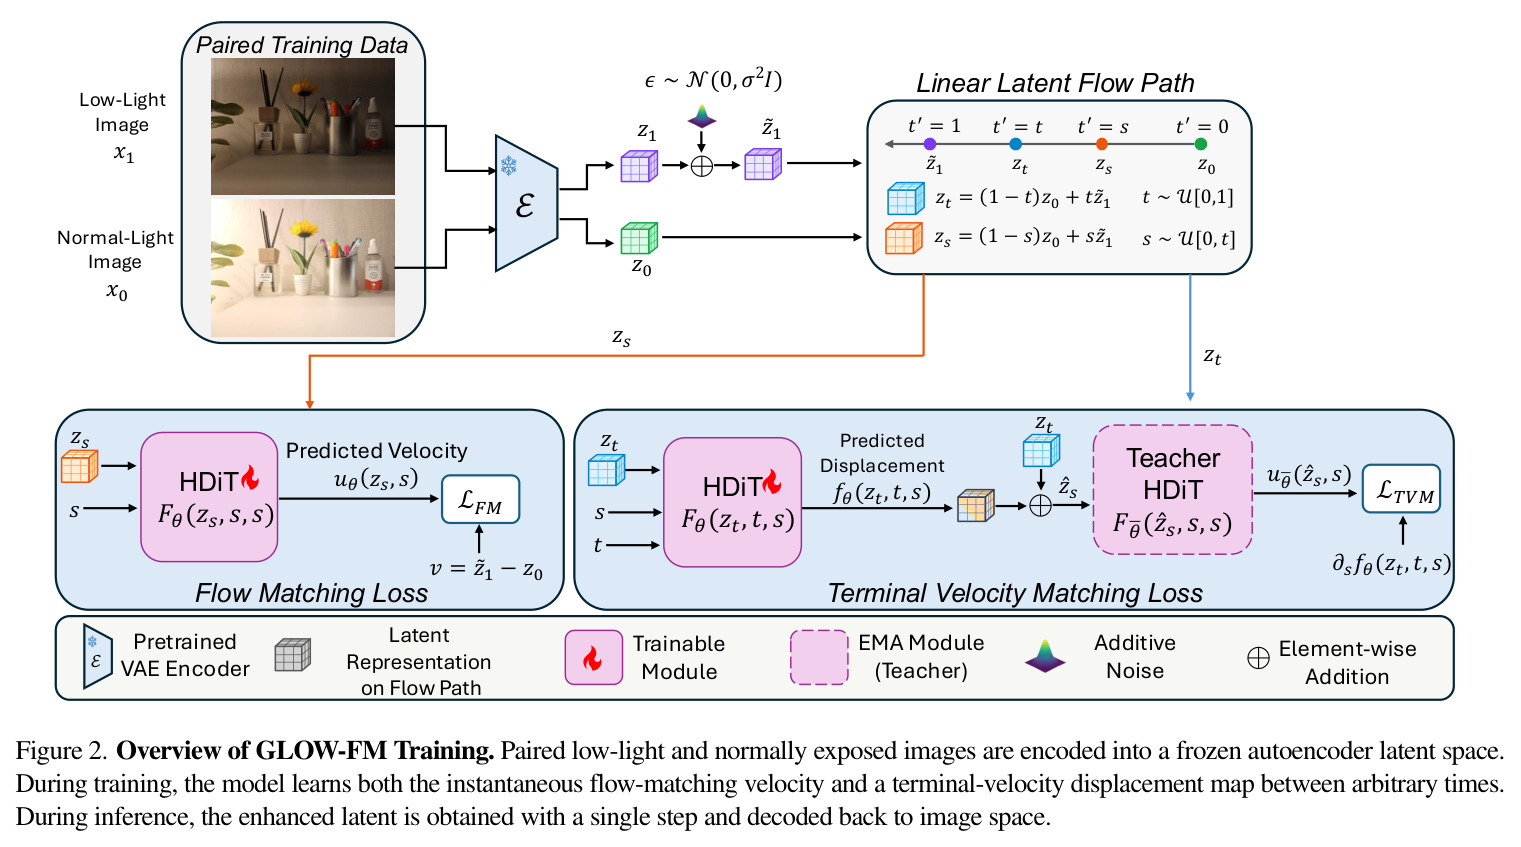
流匹配学习一个瞬时速度场 $u(z_t,t)$,把源分布沿 ODE 轨迹输送到目标分布。训练用条件流匹配损失 $\mathcal{L}_{FM}=\mathbb{E}\|F_\theta(z_t,t,t)-v\|_2^2$,线性插值路径 $z_t=(1-t)z_0+t\tilde z_1$ 对应目标速度 $v=\tilde z_1-z_0$。Rectified Flow 通过拉直轨迹来减少采样步数。
GLOW-FM 的骨架就是条件流匹配:FM 损失是其总损失的一部分,也是 TVM 位移分支在边界情形($s=t$)的锚点。
终端速度匹配(TVM)
TVM 用两时刻网络直接参数化有限位移 $f_\theta(z_t,t,s)=(s-t)F_\theta(z_t,t,s)$,即从时刻 $t$ 到更早时刻 $s$ 的净传输量,免去对速度场的数值积分。训练时让位移在预测终点处的偏导 $\partial_s f_\theta$ 匹配终点速度 $F_\theta(\hat z_s,s,s)$;真实终点不可得,故用 EMA 教师加 stop-gradient 提供代理目标,偏导用 JVP 计算。
TVM 是本文核心训练目标,作者声称这是 TVM 首次被用于图像修复/LLIE,理解它才能明白单步推理为何可行。
潜空间生成模型与 Tiny-VAE(TAESD)
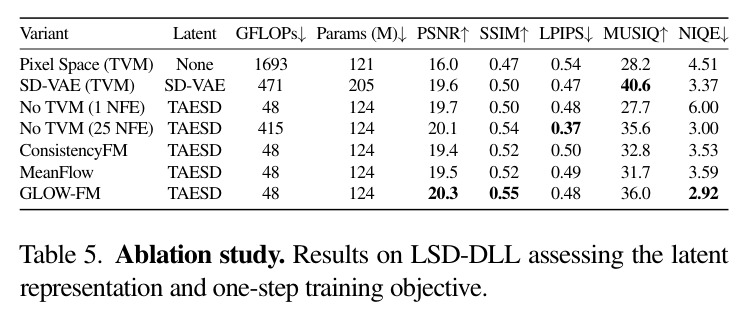
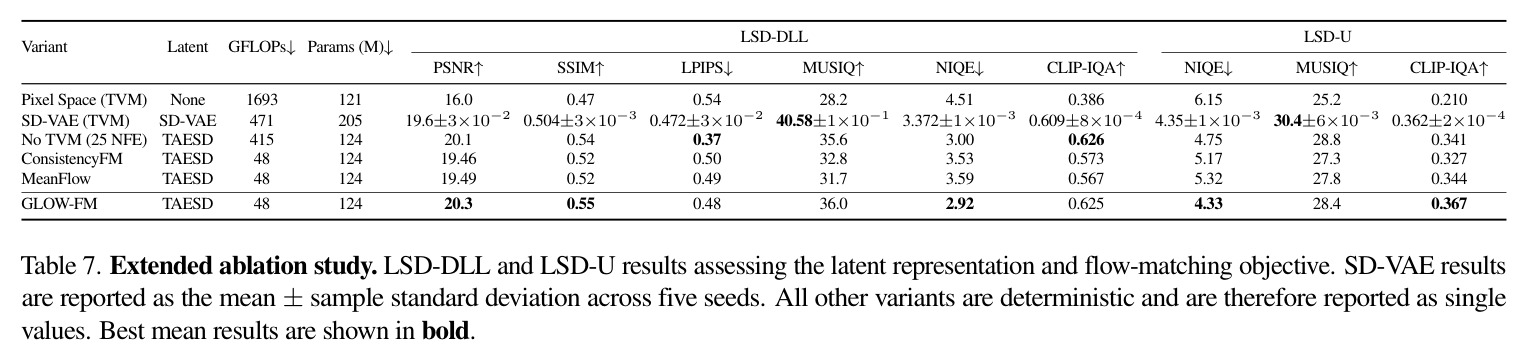
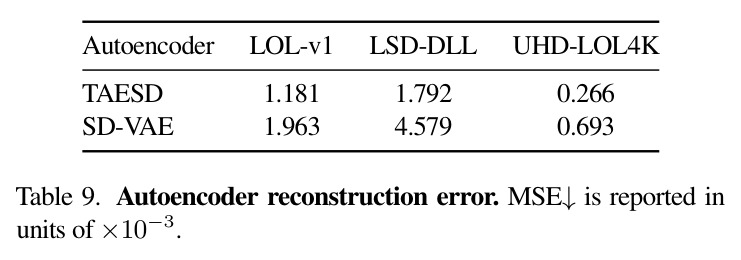
把扩散/流模型的传输过程放进预训练 VAE 的潜空间可大幅降低算力。TAESD 是从 Stable Diffusion VAE 蒸馏的轻量自编码器,把 RGB 图像压成 16 通道、空间下采样 8 倍的潜表示。本文实测其编解码 GFLOPs 比 SD-VAE 低 15 倍、参数少 33 倍,且三个基准上的重建 MSE 均更低(如 LSD-DLL 上 1.792 vs 4.579,单位 $\times10^{-3}$)。
本文的效率主要来自潜空间建模;论文还用消融证明 TAESD 潜空间不仅省算力,还提升修复质量与跨域泛化。
NFE 与一步/少步生成
NFE(number of function evaluations)指推理时调用去噪/速度网络的次数,是生成模型推理成本的主导项。传统扩散需几十到上百步;一致性模型、MeanFlow、TVM 等通过一致性约束或直接参数化把生成压缩到 1–4 步。对修复任务,一步推理意味着端到端延迟可与回归模型竞争。
本文的核心卖点就是单 NFE 达到生成式质量,NFE 与 GFLOPs 是贯穿所有表格的效率指标。
HDiT(Hourglass Diffusion Transformer)
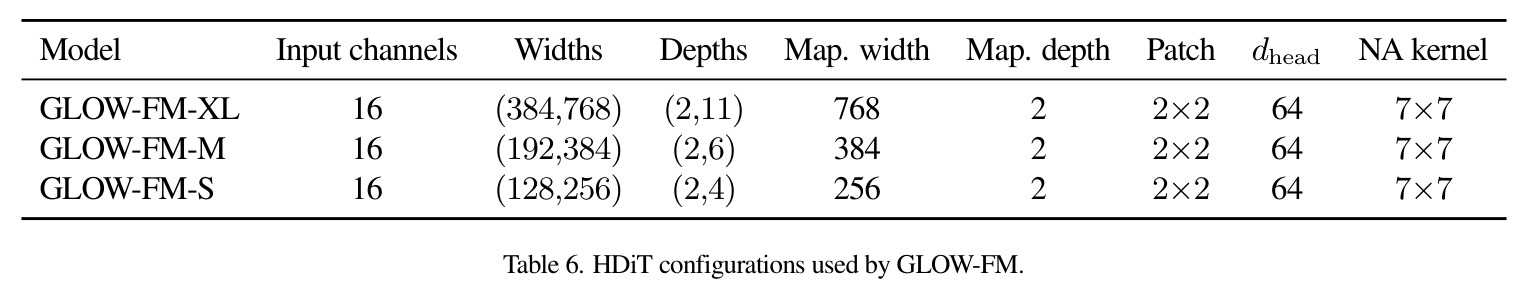
HDiT 是沙漏形多分辨率 DiT 变体:低分辨率层用全局自注意力负责曝光/色彩等全局校正,高分辨率层用固定窗口邻域注意力(kernel $7\times7$),把注意力开销从 $O(n^2)$ 降到 $O(n)$。这适合潜空间修复:既需全局色调校正,又要保留与退化输入空间对齐的局部细节。
GLOW-FM 的三档模型(XL/M/S)都是 HDiT 骨干,理解其结构才能读懂 Table 6 中参数量与 GFLOPs 的差异。
EMA 教师与 JVP
EMA(指数滑动平均)权重 $\bar\theta$ 是训练参数的平滑副本,常作稳定的目标网络,配合 stop-gradient 阻断梯度流向目标分支。JVP(Jacobian-vector product)计算 $\partial_s f_\theta(z_t,t,s)$ 这类对标量输入的偏导,一次前向即可得到,比完整反向传播更省内存和计算。
TVM 损失的实现完全依赖这套技巧,读懂算法 1 和复现代码的前提是理解它们。
研究动机
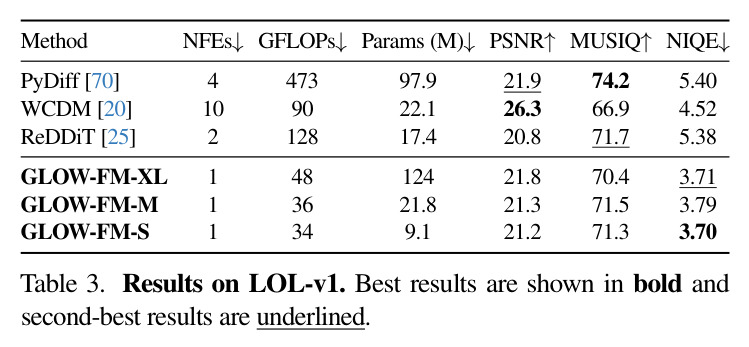
真实低光图像同时包含严重欠曝、传感器噪声、颜色失真、对比度下降、细节丢失与局部过饱和,且退化模式随相机和拍摄条件剧烈变化。回归式方法(Retinexformer、HVI-CIDNet、TFFormer、Multinex 等)推理高效、失真指标好,但逐像素损失训练使它们在信息严重丢失时输出过度平滑、抹掉纹理。生成式扩散方法(Diff-Retinex、GSAD、PyDiff、WCDM、ReDDiT)借强图像先验恢复真实纹理,却受制于迭代采样:WCDM 需 10 次 NFE、约 90 GFLOPs,ReDDiT 需 2 次 NFE、约 128 GFLOPs,PyDiff 需 4 次 NFE、高达 473 GFLOPs,VAE 编解码本身也可能占据大笔预算。这在智能手机成像等资源受限场景几乎无法部署,因此『单步推理 + 低总计算量 + 跨真实场景稳健』仍是悬而未决的挑战。
本文的目标是本文目标是构建一个同时满足三个此前未被同时达成约束的生成式 LLIE 框架:推理只需 1 次 NFE;端到端计算量足够小(小模型 34 GFLOPs,约为 ReDDiT 的 1/4、PyDiff 的 1/14);在 LSD-DLL、UHD-LOL4K、LOL-v1 等配对基准上质量有竞争力,并在 LSD-U 未见设备与 DICM/LIME/MEF/NPE/VV 跨数据集协议下取得领先的泛化。具体路径是:把 TVM 首次引入图像修复并通过受控实验证明它是 LLIE 最优的一步训练目标;用冻结 TAESD 的 16 通道紧凑潜空间压缩成本;再以理论把潜空间训练目标与像素空间的分布距离定量联系起来。
与已有工作不同的是,已有少步生成式 LLIE(WCDM、ReDDiT、IllumFlow、Consist-Retinex 等)要么在小波/反射率分解等复杂空间做扩散,要么依赖轨迹蒸馏,都没有回答『哪一种一步目标函数最适合修复任务』。本文的独特切入是:在完全相同的 HDiT 骨干、数据与算力预算下做受控目标对比(No-TVM/Rectified Flow、ConsistencyFM、MeanFlow、TVM),并把 ICLR 2026 提出的一步生成目标 TVM 第一次迁移到图像修复;理论层面,在解码器 $L_D$-Lipschitz 假设下证明像素空间 Wasserstein-2 距离满足 $\mathcal{W}_{2,X}\le L_D\big(\int_0^t\lambda[L](s)\,\mathcal{L}_{t,s}(\theta)\,ds\big)^{1/2}+\sqrt{\epsilon_{VAE}}$,把可训练的潜空间目标与不可约的 VAE 重建残差分开,为『潜空间训练确实压低像素分布差距』给出定量依据。
核心方法
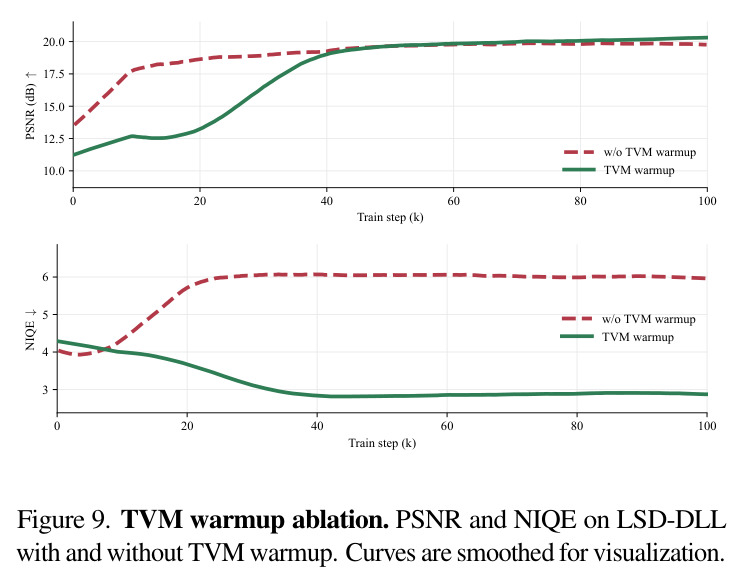
直觉上,作者把低光增强看成『在冻结 VAE 的潜空间里,让一个两时刻网络学会从退化端一步跳到正常光端』:不学瞬时速度再做数值积分,而是直接学有限位移。技术路线分四层。第一,用冻结的 TAESD 把配对数据编码成 16 通道潜表示 $z_1=E(x_1)$、$z_0=E(x_0)$,按 TVM 约定源在 $t=1$、目标在 $t=0$,训练路径为线性插值 $z_t=(1-t)z_0+t\tilde z_1$。第二,两时刻网络 $F_\theta(z_t,t,s)$ 用 HDiT 实现:$s=t$ 时输出瞬时速度,$s<t$ 时输出位移,参数化 $f_\theta(z_t,t,s)=(s-t)F_\theta(z_t,t,s)$ 保证边界处零位移且导数退回速度。第三,总损失 $\mathcal{L}=\mathcal{L}_{FM}+\lambda\mathcal{L}_{TVM}$,$\lambda$ 按 warmup 线性爬升。第四,推理时把低光图编码到 $t=1$ 端,取 $M=1$ 一步位移直达 $t=0$,解码输出增强图。
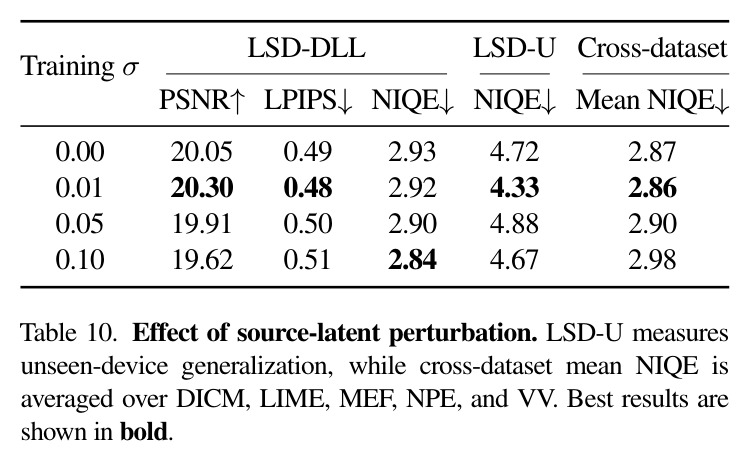
核心创新是把『一步传输』变成模型的原生输出而非积分结果。标准流匹配只学 $u_\theta(z_t,t)$,一步推理相当于大步长粗暴积分、误差大;TVM 直接回归位移 $f_\theta(z_t,t,s)$,并用终端速度一致性监督:$\partial_s f_\theta(z_t,t,s)\approx u_\theta(\hat z_s,s)=F_\theta(\hat z_s,s,s)$,即位移在预测终点处的变化率须与终点附近的速度场吻合,这把单步大跨度映射锚定到接近正常光分布的速度上。与 MeanFlow 的本质区别在于:后者的 JVP 目标基于初始时刻速度的样本级近似,训练易失稳,而低光修复的初始状态恰是高度退化的潜表示,问题更突出;ConsistencyFM 强制速度一致,会限制空间异质修复所需的全区间单段映射的自由度。此外,训练时对源潜加小高斯扰动 $\tilde z_1=z_1+\sigma\epsilon$($\sigma=0.01$),避免源分布过度集中于退化解码嵌入附近,使传输更平滑、泛化更好。
方法步骤详情
训练:(1) 冻结 TAESD 编码配对图像得 $z_1,z_0$;(2) 扰动源端得 $\tilde z_1=z_1+\sigma\epsilon$;(3) 采样 $s\le t$ 构造 $z_t,z_s$;(4) FM 损失令边界速度 $F_\theta$ 回归 $v=\tilde z_1-z_0$;(5) 由 $\hat z_s=z_t+f_\theta$ 与 EMA 教师得代理速度 $\bar u_\theta$;(6) TVM 损失令位移偏导 $\partial_s f_\theta$ 回归 $\bar u_\theta$(JVP 求偏导);(7) 以 $\mathcal{L}_{FM}+\lambda\mathcal{L}_{TVM}$ 更新,$\lambda$ 线性爬到 1。实现为 HDiT 三档骨干,AdamW $10^{-5}$,8×H100 约 10 万步。推理:从 $z=E(x_1)$ 沿网格迭代 $z^{(m-1)}=z^{(m)}+f_\theta(z^{(m)},t_m,t_{m-1})$,取 $M=1$ 即单步,解码得 $\hat x_0$。
技术新颖性
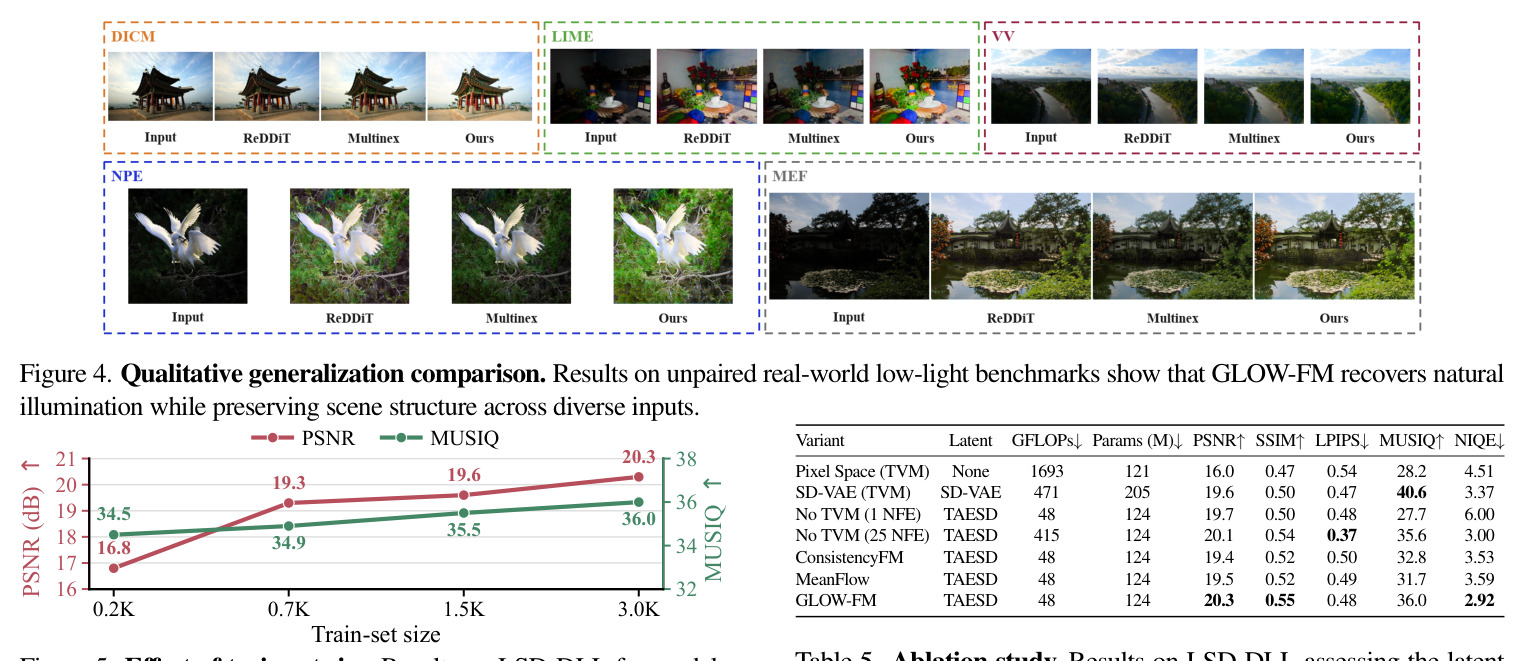
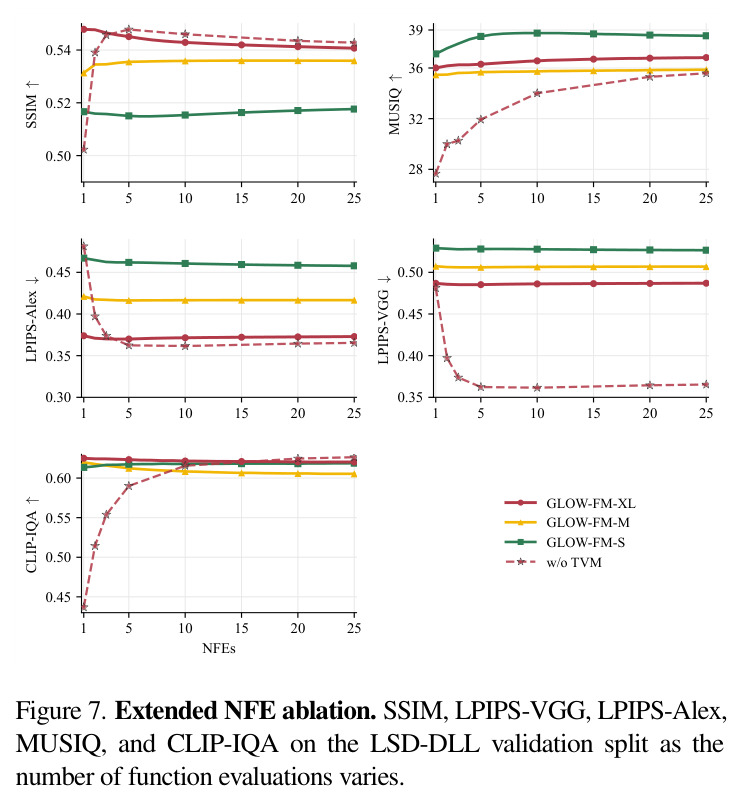
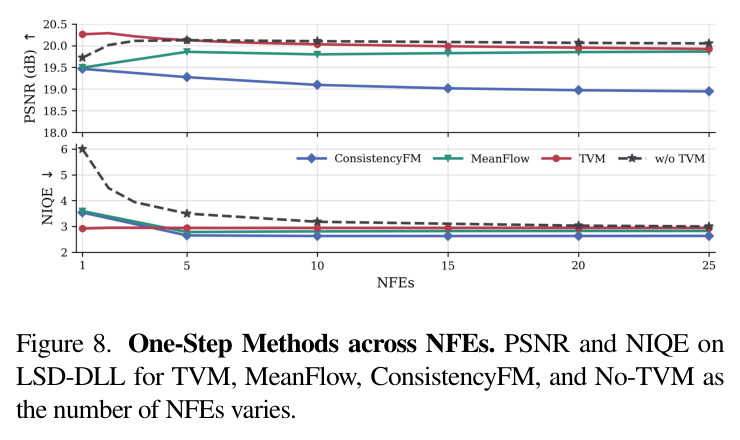
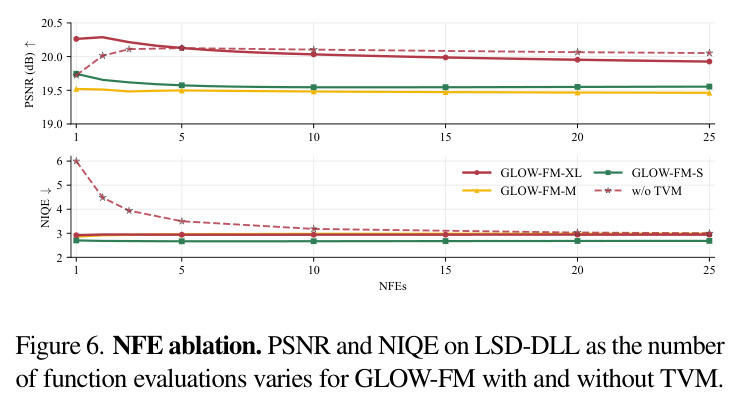
新颖性有四点。其一,任务层面首次把 TVM 从纯生成迁移到图像修复/LLIE,并给出像素空间 Wasserstein-2 理论界(附录 B 定理 1):把可训练的潜空间目标项与不可约的 VAE 重建项 $\sqrt{\epsilon_{VAE}}$ 分离,说明最小化 TVM 目标确实在压低像素分布差距。其二,实证层面做了少见的『受控目标对比』:固定骨干、数据与预算,TVM 一步在 LSD-DLL 达 PSNR 20.3/NIQE 2.92,优于 MeanFlow(19.5/3.59)、ConsistencyFM(19.4/3.53)与 No-TVM 一步;No-TVM 需 25 NFE、415 GFLOPs 才在 LPIPS 上反超。其三,系统证明紧凑潜空间不只是省算力:TAESD 相比 SD-VAE 编解码 GFLOPs 省 15 倍、参数省 33 倍,且 PSNR/SSIM/NIQE 更好;像素空间直连版 PSNR 只有 16.0。其四,工程消融(TVM warmup、源扰动 $\sigma$)表明训练课程设计对一步目标收敛质量影响显著。
实验结果
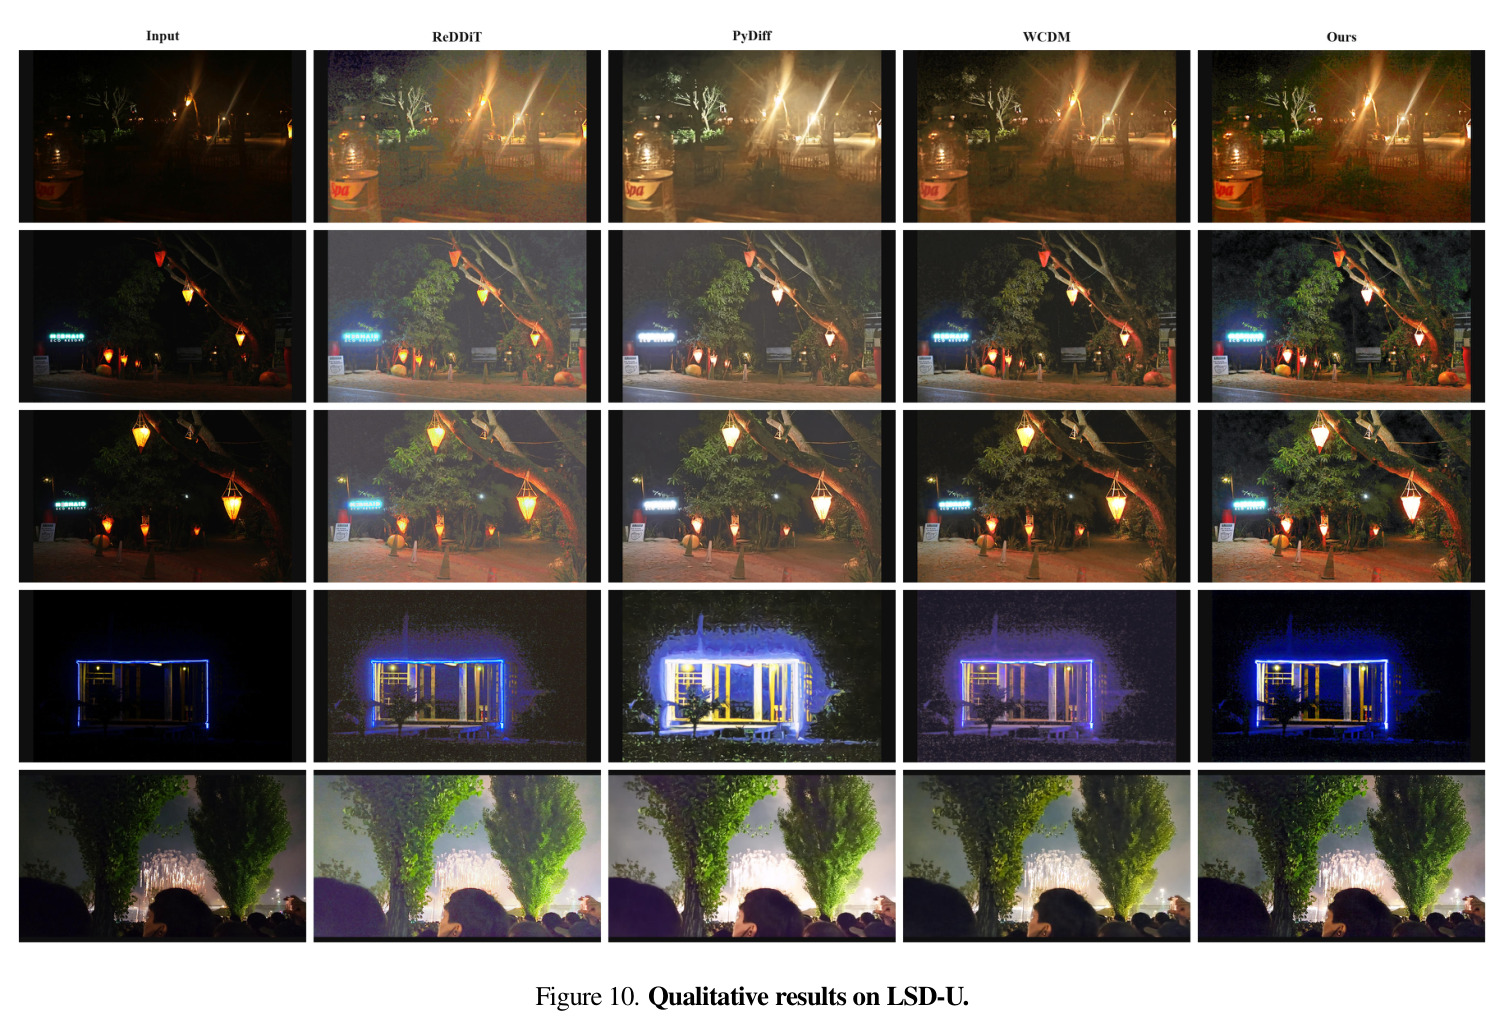
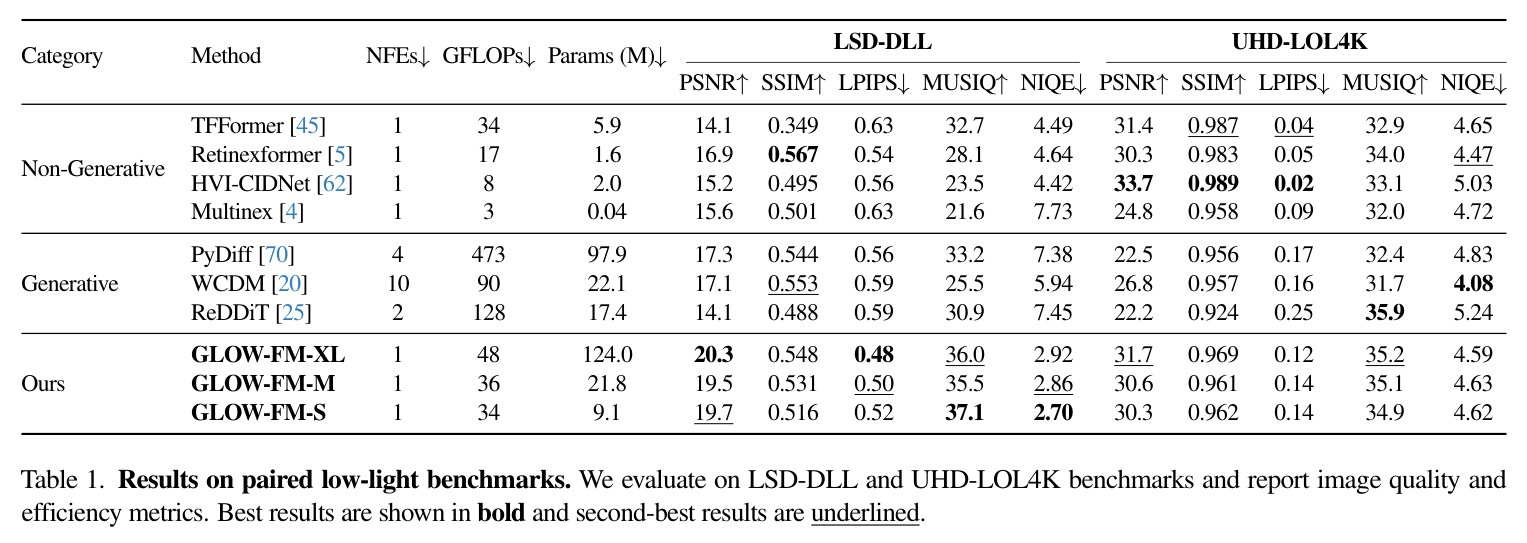
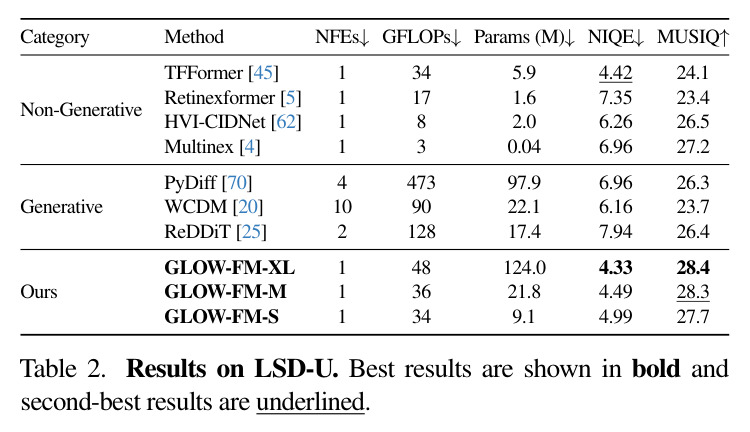
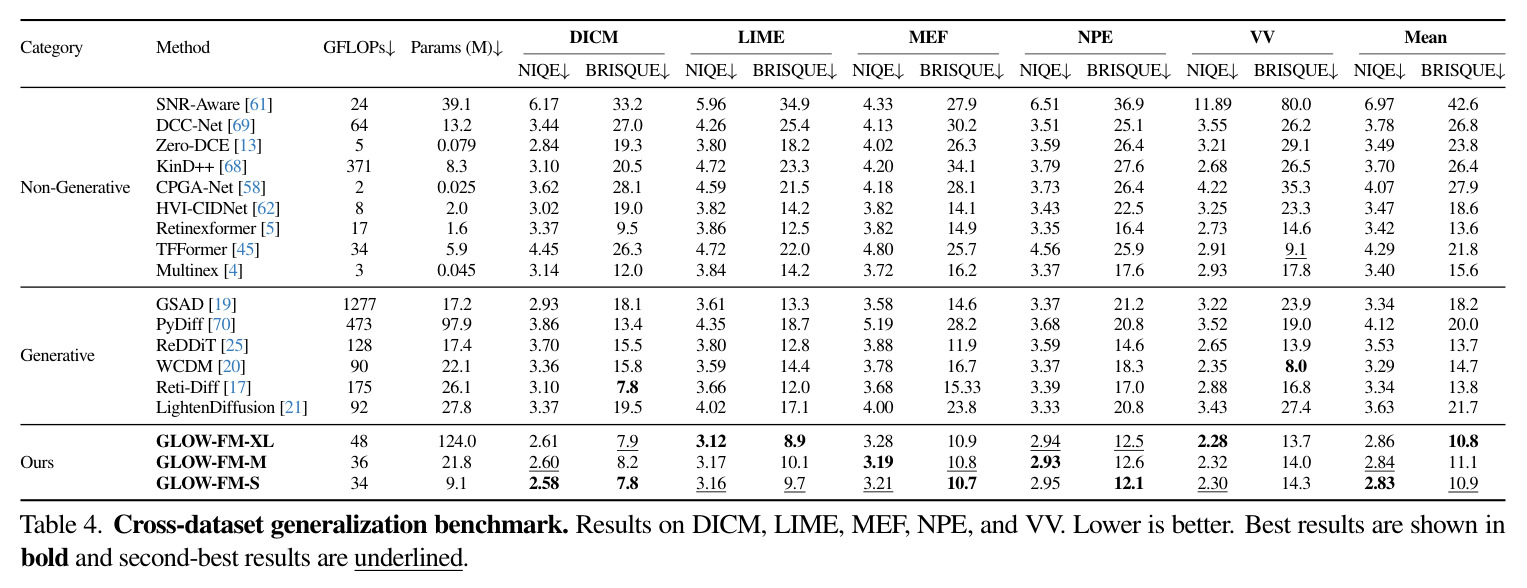
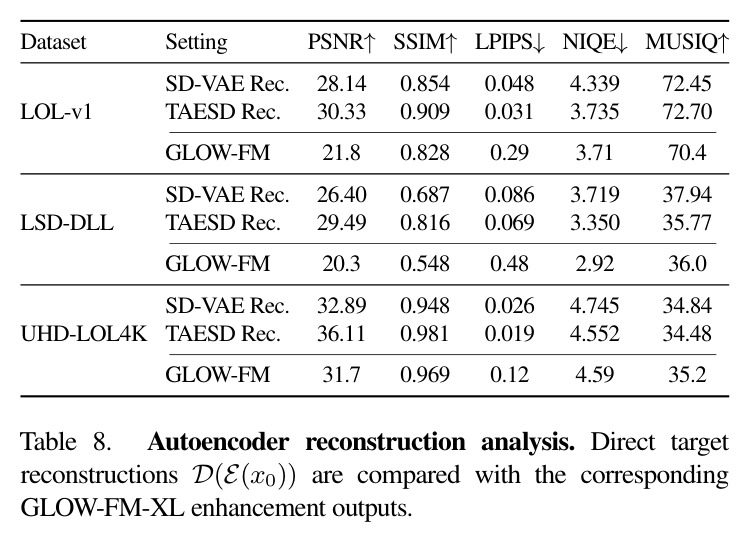
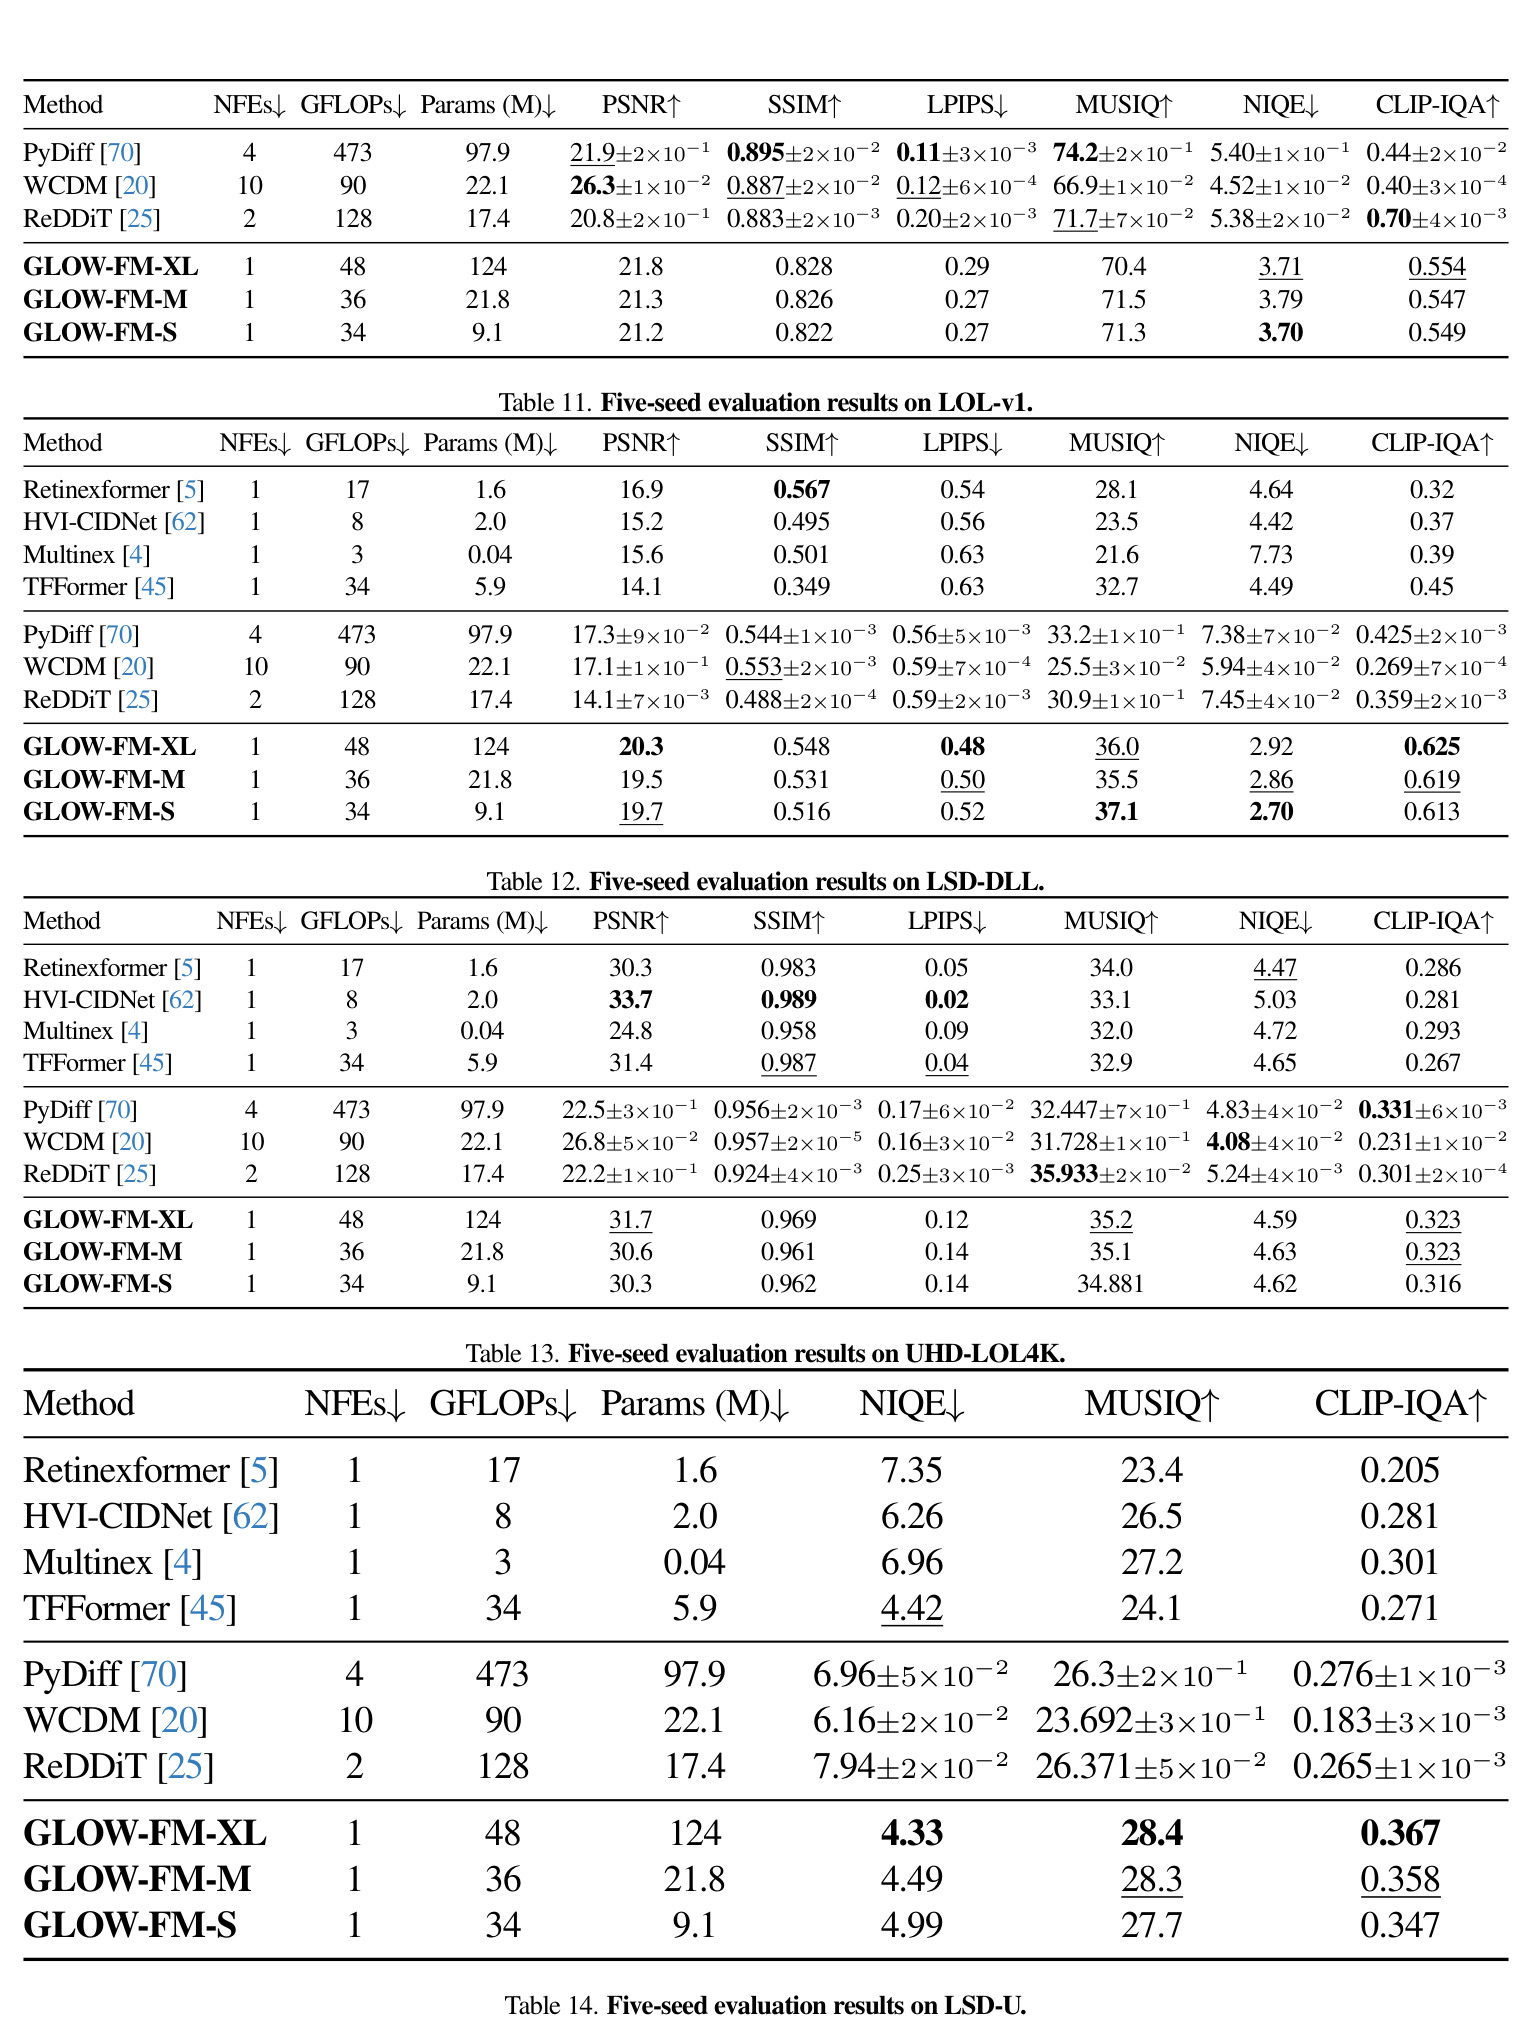
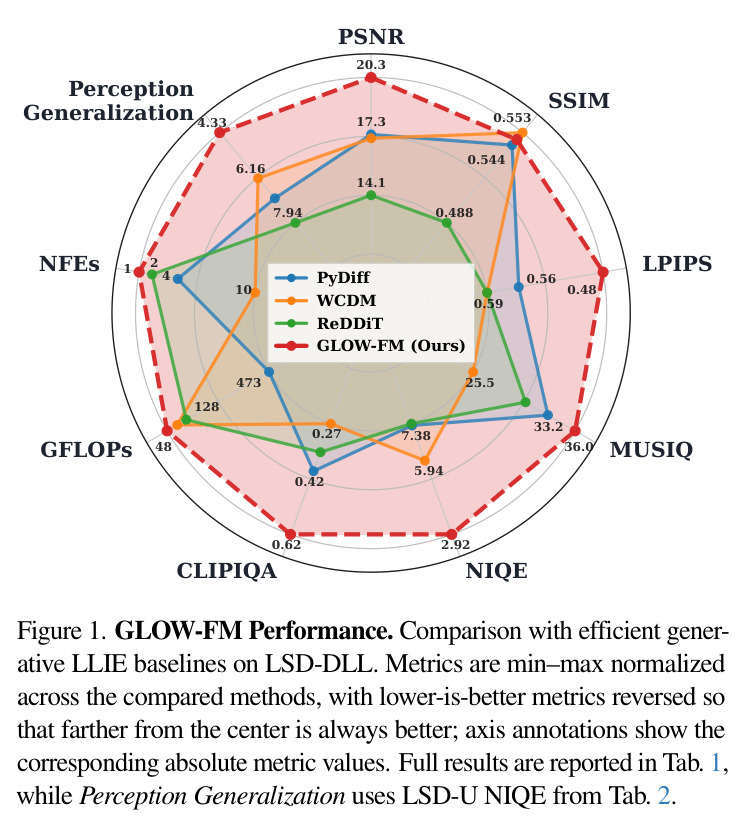
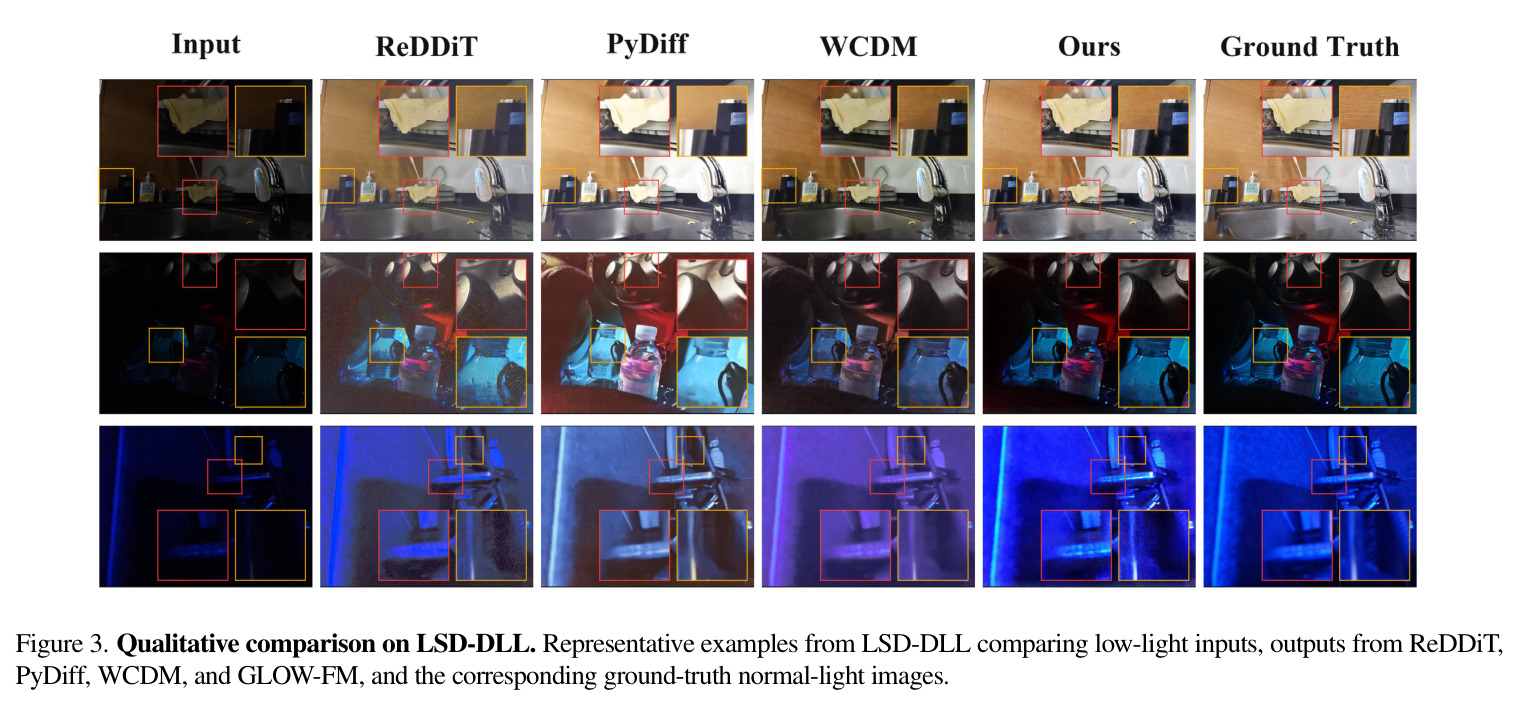
配对基准:LSD-DLL 上 XL 以单 NFE、48 GFLOPs 取得 PSNR 20.3/NIQE 2.92,比最佳生成基线 PyDiff(17.3)高 3.0 dB,远超 WCDM 17.1、ReDDiT 14.1;S 版 34 GFLOPs/9.1M,NIQE 2.70 最佳。UHD-LOL4K 上 XL 达 PSNR 31.7,感知居生成类之首,但非生成 HVI-CIDNet 失真更强 33.7。LOL-v1 上 NIQE 3.70 最佳,PSNR 落后 WCDM(21.8 vs 26.3),归因于数据不足。LSD-U 上 NIQE 4.33、MUSIQ 28.4 第一;LOL-v2-Syn 训练直推 DICM/LIME/MEF/NPE/VV,平均 NIQE 2.83–2.86、BRISQUE 10.8–11.1 最佳。消融:一步 TVM 优于 MeanFlow 19.5 与 ConsistencyFM 19.4。运行时:4096² 下 S 版 773.5 ms,ReDDiT/PyDiff 为 39704/80846 ms;M4 Max 上 1024² 仅 1811 ms。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LSD-DLL 低光增强(配对) | PSNR (dB) | 20.3(GLOW-FM-XL,1 NFE,48 GFLOPs) | 17.3(PyDiff,4 NFE,473 GFLOPs) | +3.0 dB,计算量约为基线的 1/10 |
| LSD-DLL 感知质量 | NIQE↓ | 2.92(XL);2.70(S,全场最佳) | 5.94(WCDM,10 NFE,90 GFLOPs) | 降低约 51% |
| UHD-LOL4K 高分辨率增强 | PSNR (dB) | 31.7(XL,1 NFE) | 22.5(PyDiff,4 NFE) | +9.2 dB |
| LOL-v1 | NIQE↓ | 3.70(S,全场最佳) | 4.52(WCDM) | 感知最佳,但 PSNR 21.2 低于 WCDM 的 26.3(数据量受限) |
| LSD-U 未见设备泛化 | NIQE↓ / MUSIQ↑ | 4.33 / 28.4(XL) | 6.16 / 23.7(WCDM) | 两项均为全场第一 |
| 跨数据集泛化(LOL-v2-Syn 训练→DICM/LIME/MEF/NPE/VV) | 平均 NIQE↓ / 平均 BRISQUE↓ | 2.86 / 10.8(XL) | 3.53 / 13.7(ReDDiT);3.29 / 14.7(WCDM) | 双指标全场最佳 |
| 一步目标受控对比(同 HDiT 骨干、同数据) | PSNR (dB) / NIQE↓ | 20.3 / 2.92(TVM) | 19.5 / 3.59(MeanFlow);19.4 / 3.53(ConsistencyFM) | +0.8 dB 且感知更好 |
| 4096×4096 端到端推理延迟(H100,batch 1) | Latency (ms) | 773.5(GLOW-FM-S) | 39704(ReDDiT);80846(PyDiff) | 约 51 倍于 ReDDiT、104 倍于 PyDiff |
局限与改进
作者承认的局限:其一,LOL-v1 上失真指标明显落后(PSNR 21.2–21.8 vs WCDM 26.3),归因于训练对太少;其二,UHD-LOL4K 上非生成方法失真更强(HVI-CIDNet PSNR 33.7/SSIM 0.989/LPIPS 0.02),体现感知-失真权衡。我自己的观察:其一,GLOW-FM-XL 参数量 124M 反而显著大于 ReDDiT 的 17.4M 与 WCDM 的 22.1M,GFLOPs 低但部署体积未必占优;其二,TAESD 直接重建上限约 29.49 dB(LSD-DLL),而 GLOW-FM 只到 20.3 dB,说明传输模型而非解码器是主要误差源,改进空间很大;其三,单步确定性映射无法表达多模态合理输出,极端暗光下可能出现幻觉纹理且无法量化不确定性;其四,泛化评测依赖 NIQE/MUSIQ/BRISQUE/CLIP-IQA 等无参考指标,可能与下游检测/分割性能不一致,论文未做下游任务验证;其五,生成基线由作者自行重训,跨实现公平性存在不确定性,训练需 8 张 H100 约 10 万步。
独立分析的弱点
弱点一:单步生成质量对训练数据量高度敏感,LOL-v1 的失利提示小数据集上 TVM 目标难以充分学习——改进方向是先在大规模合成低光数据或自监督低光-正常光对齐上预训练,再小数据微调。弱点二:感知-失真权衡未被显式参数化,用户无法在保真与观感之间调节——可在位移目标中加入可调失真正则,或利用少步模式($M>1$)提供质量档位。弱点三:TAESD 是为 SD 生成设计的通用编码器,并非为 4K/UHD 优化,UHD-LOL4K 上 LPIPS 0.12 明显劣于 HVI-CIDNet 的 0.02——可微调或蒸馏一个 LLIE 专用 VAE 以压低 $\epsilon_{VAE}$ 上限。弱点四:EMA 教师 + stop-gradient 的代理速度是有偏估计(沿用 TVM 的有偏实现),训练后期可能限制精度——可探索自校正或双向一致性目标。弱点五:效率对比集中在 GPU/端侧延迟,缺少功耗与真实手机 ISP 流水线集成数据;下游语义任务(夜间检测/分割)收益未验证——应补充任务级评测来支撑『增强服务于识别』的实用主张。
未来方向
作者方向的延伸:其一,把 TVM 推广到视频 LLIE 与低光视频去噪,利用时间一致性摊薄单帧成本;其二,在 RAW 域或极端低照度(夜间监控、车载夜视)上检验潜空间流传输的极限;其三,引入 Retinex 分解或光照先验作为条件,提升色彩校正的物理合理性。基于成果可延伸:其一,把 TVM 一步化范式移植到去雨、去雾、超分等其他修复任务,系统比较其在不同任务上的适用边界;其二,利用 Figure 5 的数据缩放趋势(0.2K→3.0K 时 PSNR 16.8→20.3)研究更大训练集与更大 VAE 的组合上限;其三,显式参数化感知-失真权衡,训练一族可调模型供应用按需选择;其四,研究多步精化(Algorithm 2 的 $M>1$)在极端退化下相对单步的收益曲线,找到最优步数-质量工作点;其五,在 Arm SME/SME2 端侧路线(1024² 已达 1811 ms)上叠加量化、剪枝与专用内核,迈向实时;其六,加入不确定性估计或轻量判别器标注不可信区域,支持安全关键场景。
复现评估
复现条件较好。代码已开源(github.com/arm-research/AAIR-GLOW-FM);数据集全部公开:主基准 LSD-DLL、UHD-LOL4K、LOL-v1/v2-Syn,泛化评测 DICM/LIME/MEF/NPE/VV 与 LSD-U 均为社区常用数据;TAESD 直接使用公开的 madebyollin/taesd3 权重并全程冻结。超参数披露完整:AdamW $10^{-5}$、有效 batch 16、约 10 万步、TVM warmup $(W,R,\lambda_{\max})=(5k,10k,1.0)$ 或 $(10k,20k,1.0)$、$\sigma=0.01$、HDiT 三档配置见 Table 6、JVP 细节见算法 1。算力门槛在训练端:8 张 H100 约 10 万步,实验室外完整重训成本高;推理端极轻(单步、34–48 GFLOPs),拿到官方权重即可低成本验证全部定量结果。附录 D 详列基线重训配方,附录 F 提供五种子均值±标准差,统计规范透明。总体:用官方权重评估难度低,完整复现训练难度中高,瓶颈在 GPU 资源而非方法不透明。
论文图表
固定架构与训练协议,把 LSD-DLL 训练集从约 0.2K 对扩到 3.0K 对:PSNR 单调从 16.8 dB 升至 20.3 dB,MUSIQ 从 34.5 升至 36.0。
证明 LOL-v1 上 PSNR 落后源于数据不足而非方法缺陷,是理解本文局限与适用条件的关键证据。