IQuest-Q1:面向Agentic CLI系统的基座能力进阶 IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
开源320B稀疏MoE智能体模型,以稳定预训练、多脚手架RL与多教师蒸馏强化CLI能力
前置知识
稀疏混合专家模型(Sparse MoE)
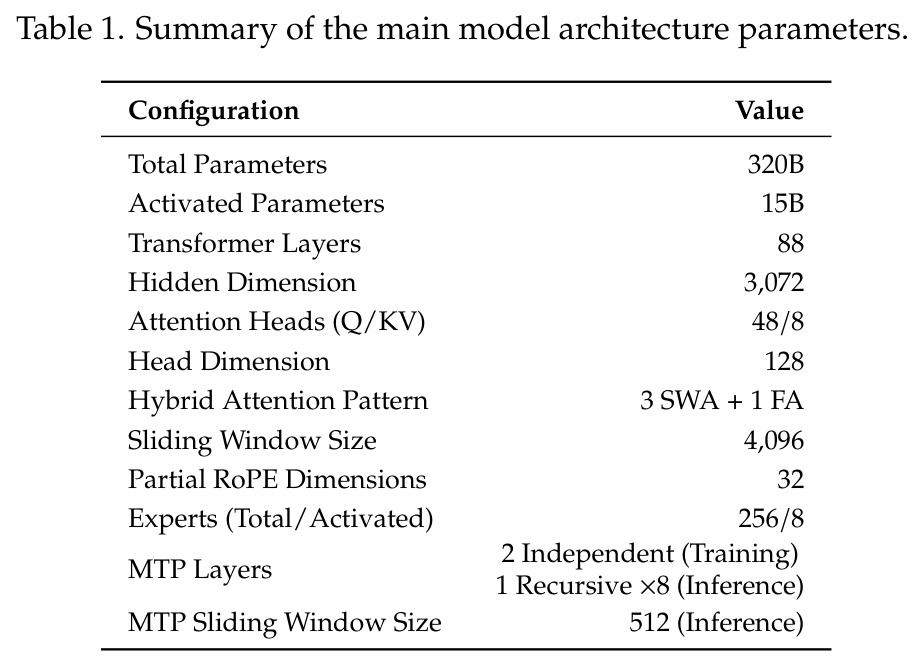
稀疏MoE把Transformer的FFN替换成多个专家网络,由路由器为每个token只激活一小部分专家(本文为256选8),使总参数量大(320B)而每token计算量小(15B激活)。首层通常改用稠密FFN以缓解早期专家负载不均。
IQuest-Q1的320B/15B激活架构、256/8专家配置与首层稠密FFN设计都建立在MoE之上,理解路由与负载均衡才能读懂其架构表与扩展性分析。
Muon优化器与μP参数化
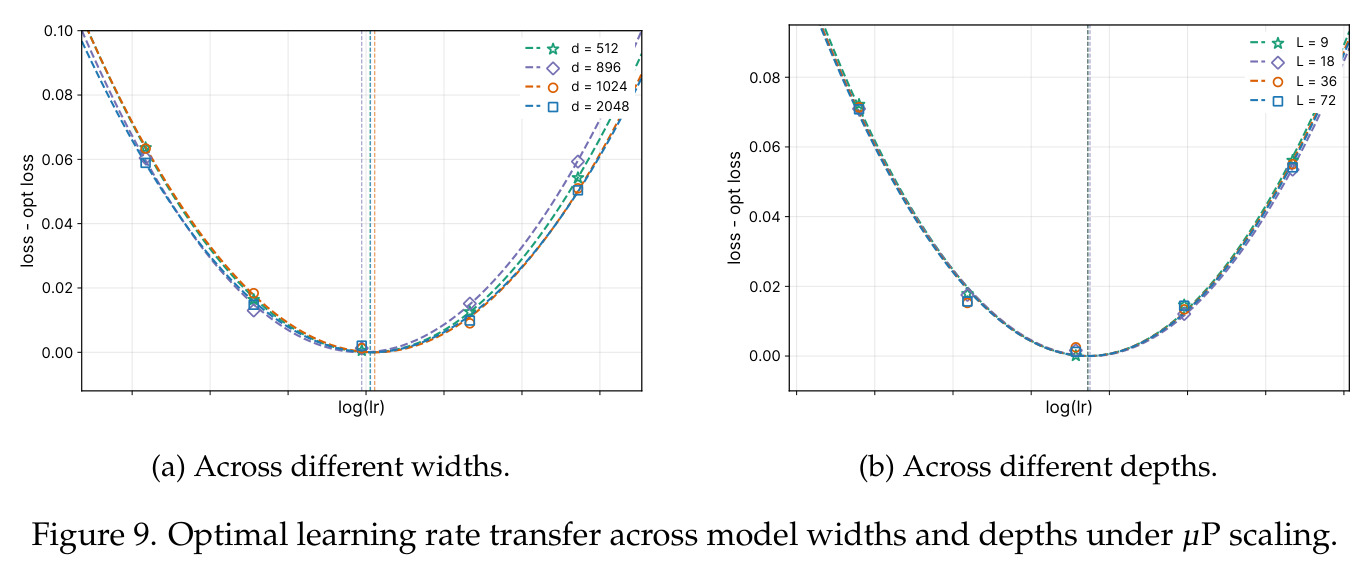
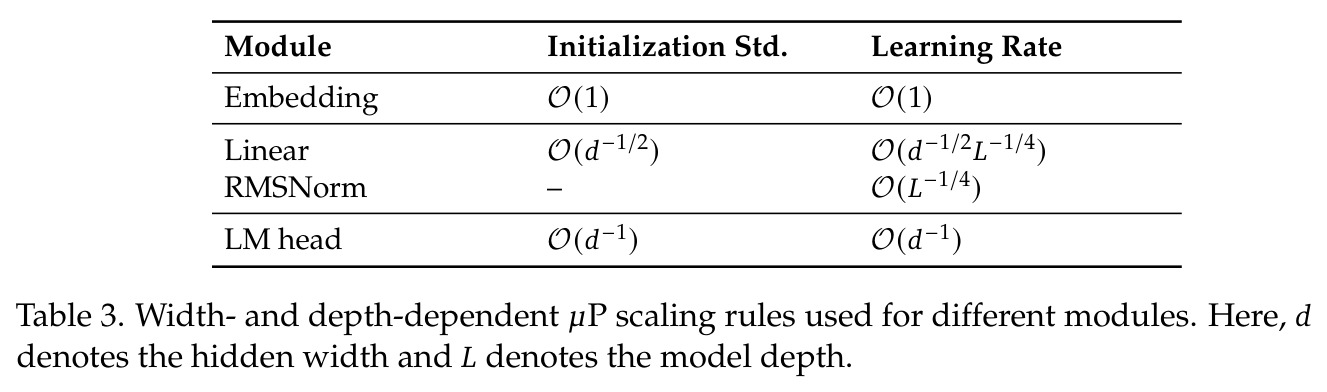
Muon对矩阵参数的更新做正交化,再乘以谱缩放 $0.2\sqrt{\max(m,n)}$ 使更新RMS与Adam风格对齐;μP(Maximal Update Parameterization)让在小代理模型上调好的超参数(尤其学习率)可以零样本迁移到大模型。本文在宽度896、18层的代理上调参后直接迁移到320B目标模型。
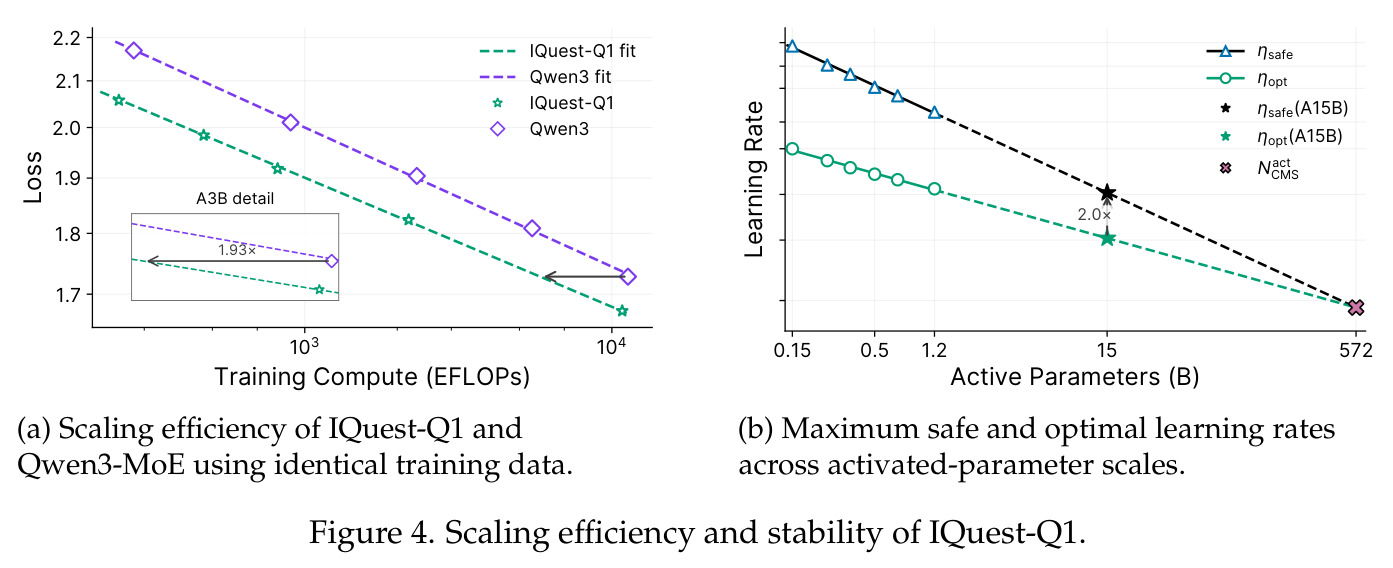
本文声称在4倍宽度、4倍深度范围内实现超参迁移,省去大模型学习率搜索,这是理解其稳定高效扩展叙事和Figure 4b的前提。
滑窗注意力与混合注意力
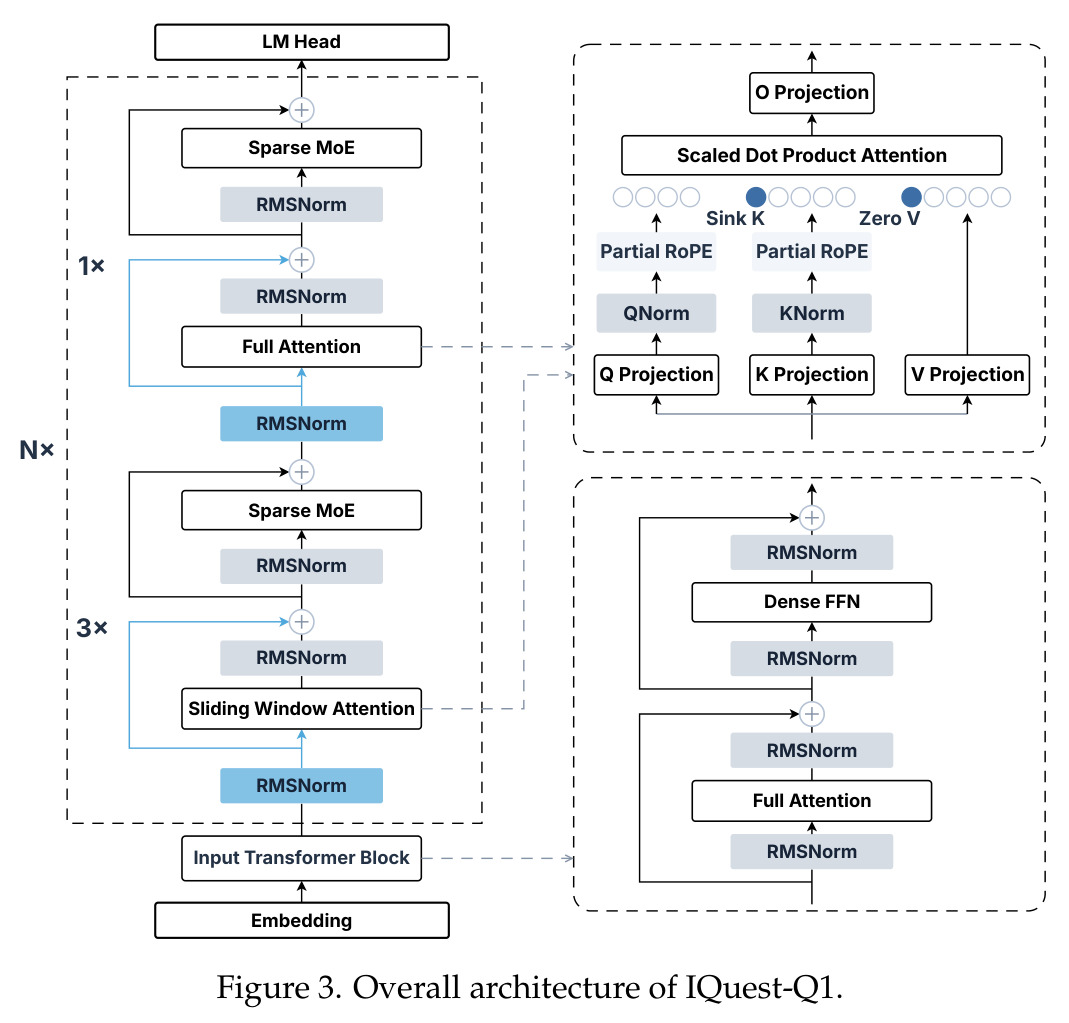
SWA让每个query只关注固定窗口(本文4096)内的key,长上下文下计算近似线性。本文用3层SWA+1层全注意力(FA)交错,头两层和末两层用FA,配合Partial RoPE(每头仅32维加旋转位置编码)和query-aware sink token吸收多余注意力质量。
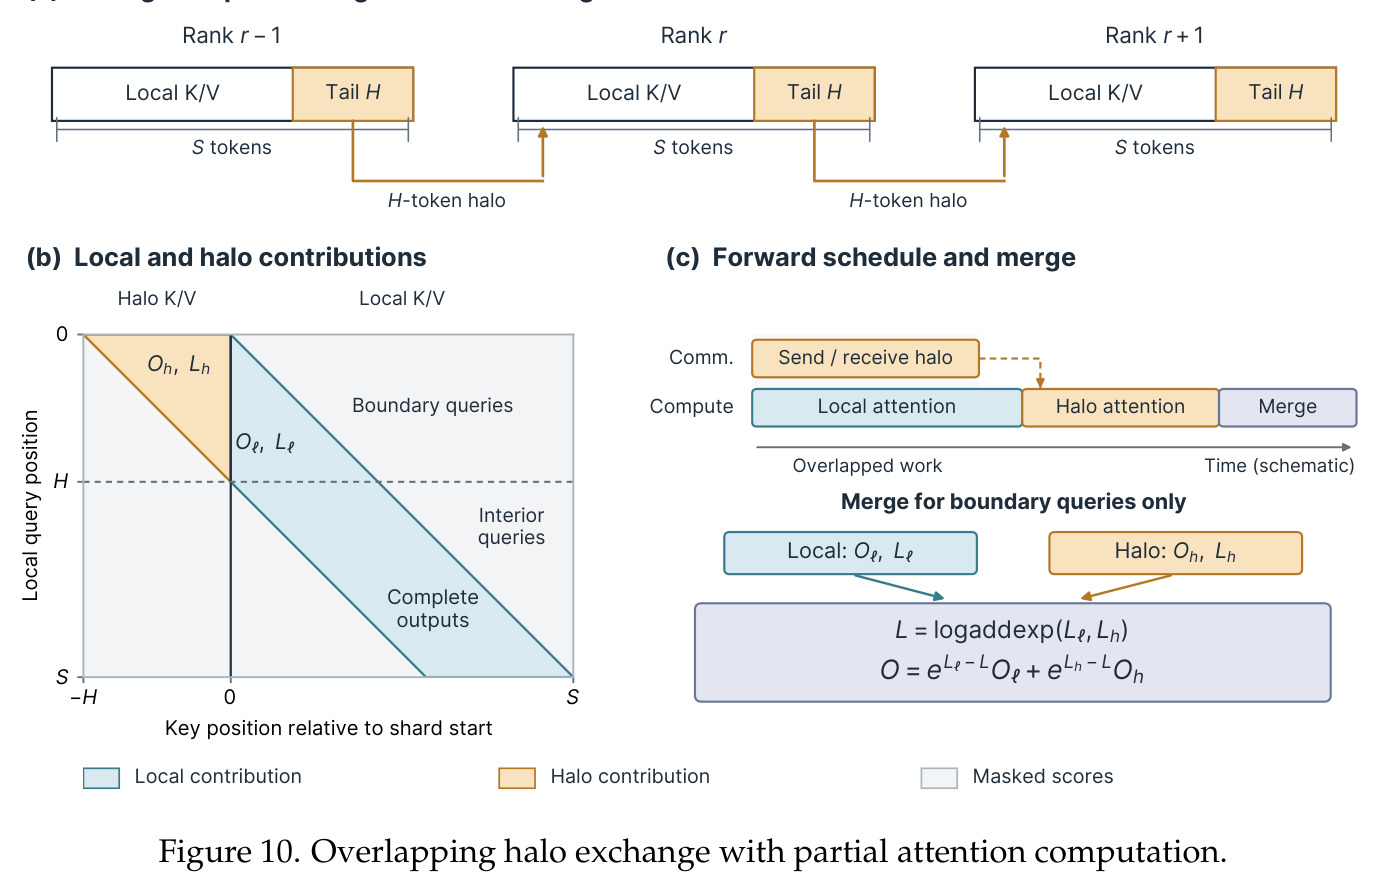
架构图Figure 3、长上下文课程和上下文并行的halo交换实现都围绕这一混合注意力展开,是读懂第2章和基础设施部分的基础。
GRPO(组相对策略优化)
GRPO对同一任务做多次rollout采样,用组内奖励的相对比较替代价值网络来估计优势,属于可验证奖励的RL算法。本文在固定脚手架和评测器版本下比较重复rollout,并按领域-脚手架组合平衡采样、保留回归案例。
第4.4节的领域专项RL以GRPO为核心,涉及奖励设计、失败归因与TITO token级更新,不了解GRPO无法理解该节流程。
多教师在线策略蒸馏(MOPD)
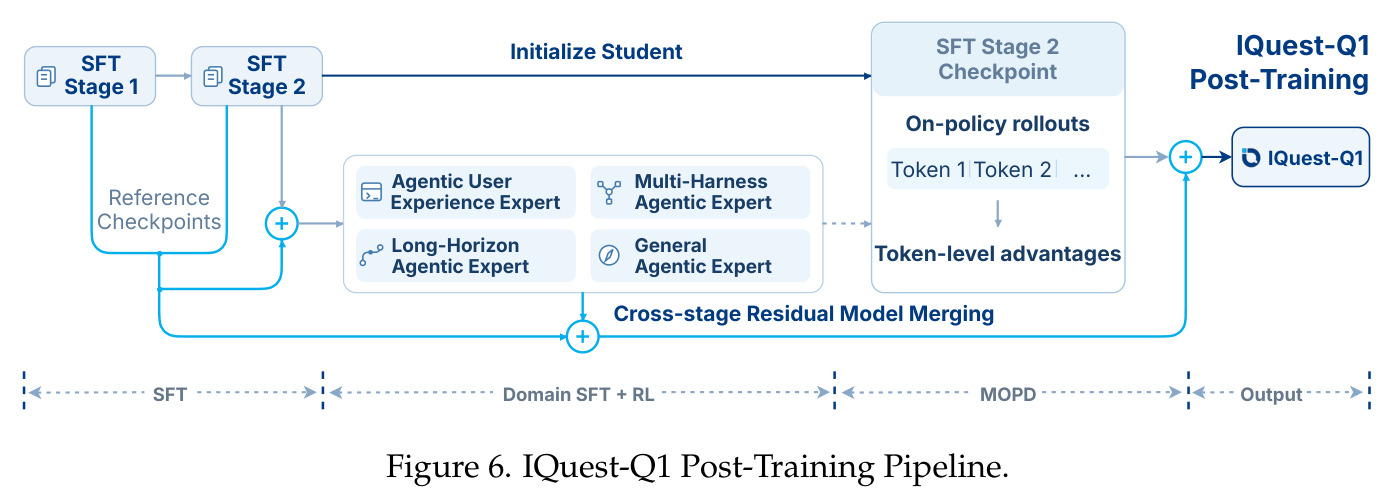
MOPD让学生模型自己rollout,再由按任务领域选出的冻结教师对学生生成的每个token打分,得到裁剪的对数比优势 $\tilde{a}_{i,t}=\mathrm{clip}(\log(q_{d_i}/p_k),-c,c)$,用长度归一化的反向KL式代理损失更新学生,把多个专家的能力合并进一个模型。
MOPD是本文后训练的核心创新之一,与SFT、RL并列构成三路训练信号,其损失公式和4个专家的分工是方法部分的重点。
奖励破解(Reward Hacking)
指模型在训练环境中绕过真正解题,通过泄露的答案、隐藏测试或修改评测脚本骗取奖励。常见诱因包括Git历史残留修复提交、评测文件可被读取、环境未隔离等。
本文用环境准备、执行时拦截和轨迹审计三层防护专门对抗奖励破解(4.2节),理解它才能明白任务合成与RL环境工程的良苦用心。
多token预测(MTP)与投机解码
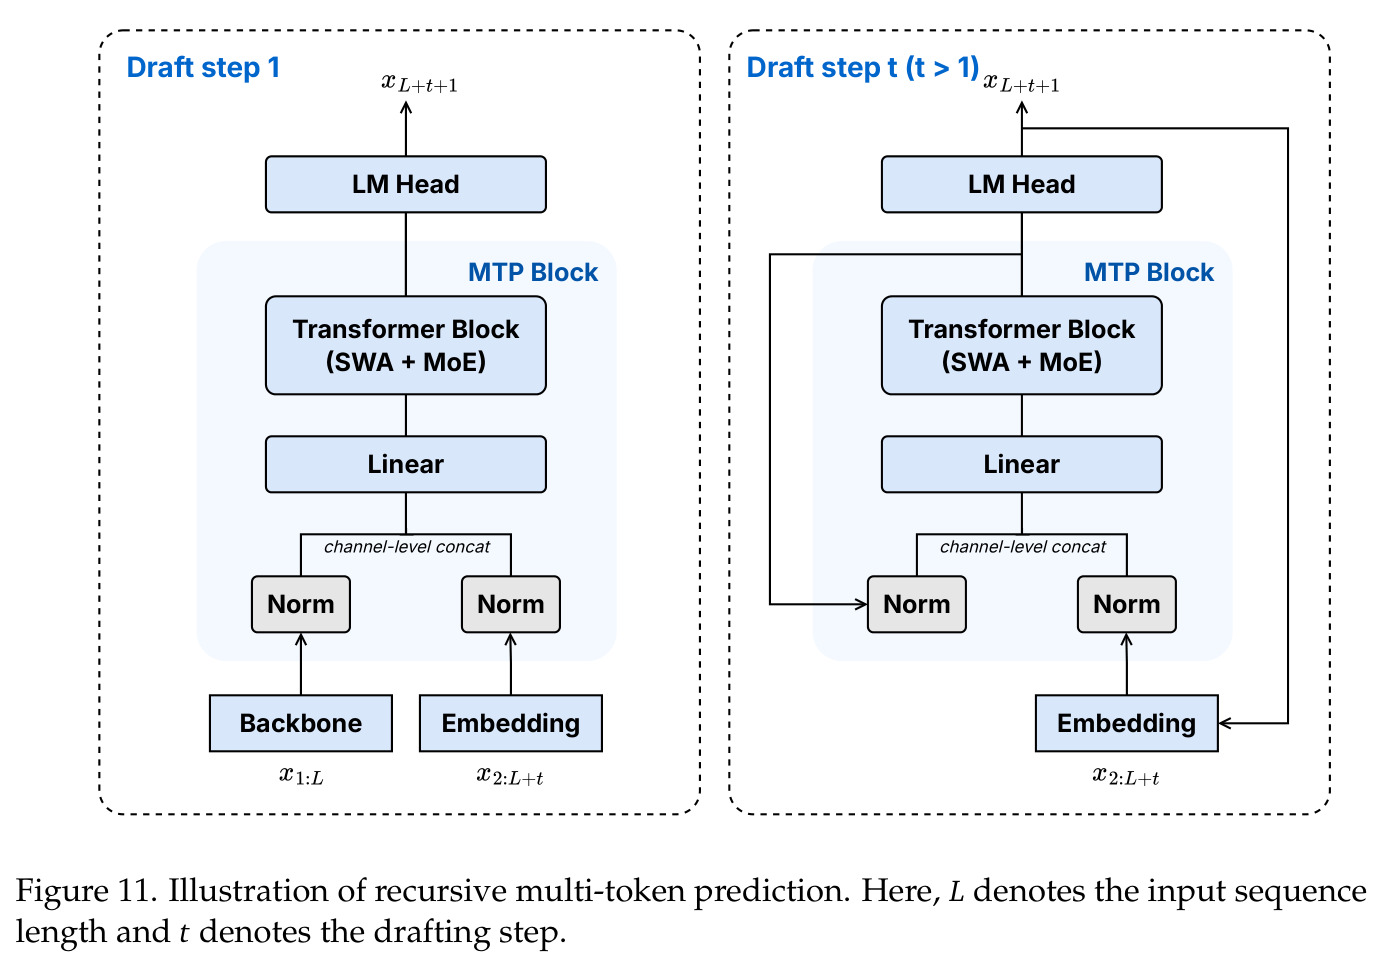
MTP在训练时附加预测未来token的辅助层,加强主干学习信号;推理时可将该层改造成投机解码的drafter。本文把两个MTP层之一改造成递归drafter,复用同一层做7步草稿(类似EAGLE-3),并用512的SWA限制每步注意力成本。
这解释了Table 1中MTP训练2层、推理时1层递归×8的配置,是架构设计与推理效率之间的衔接点。
研究动机
开源智能体模型与闭源前沿模型在CLI(命令行)编码能力上存在明显代差:在Terminal-Bench 3.0/4.0这类长程终端任务上,此前开源模型(如GLM-5.3-Flash、DeepSeek-V4-Flash、MiniMax M3)得分普遍在个位数到30之间,而Claude Opus 5分别达到42.7和53.9。同时现有开源模型的训练管线有几个具体缺陷:其一,Pre-Norm架构的残差流方差随深度累积,深层贡献被稀释,模型深度利用不足;其二,大模型学习率必须在大规模上直接搜索,成本高昂且容易越过稳定边界;其三,后训练通常只针对单一agent脚手架(如仅Claude Code),换一个工具调用schema就频繁出错——论文自述模型在一次长程任务中出现35次工具调用错误,追溯6054次调用后发现训练数据严重偏向单一schema;其四,RL训练环境容易遭受奖励破解,泄露的答案和隐藏测试会污染训练信号。
本文的目标是本文目标是训练并开源一个面向CLI智能体场景的基座模型IQuest-Q1:320B总参数、每token激活15B的稀疏MoE模型,要求同时在五个维度接近闭源前沿水平:软件工程(bug修复、功能开发、仓库生成,对应DeepSWE v1.1、NL2Repo等基准)、通用智能体执行(工具调用、搜索、多轮对话,对应AutomationBench、JobBench等)、长程推理执行、网络安全(漏洞复现验证,对应CyberGym)以及真实人机协作的CLI交互体验(自建IQuest-CLIBench,用脚本化用户模拟评估交互质量)。此外还要把模型接入内部迭代开发流程,让它在人类监督下参与构建自己的后继版本,验证human-on-the-loop递归自我改进路径的可行性。
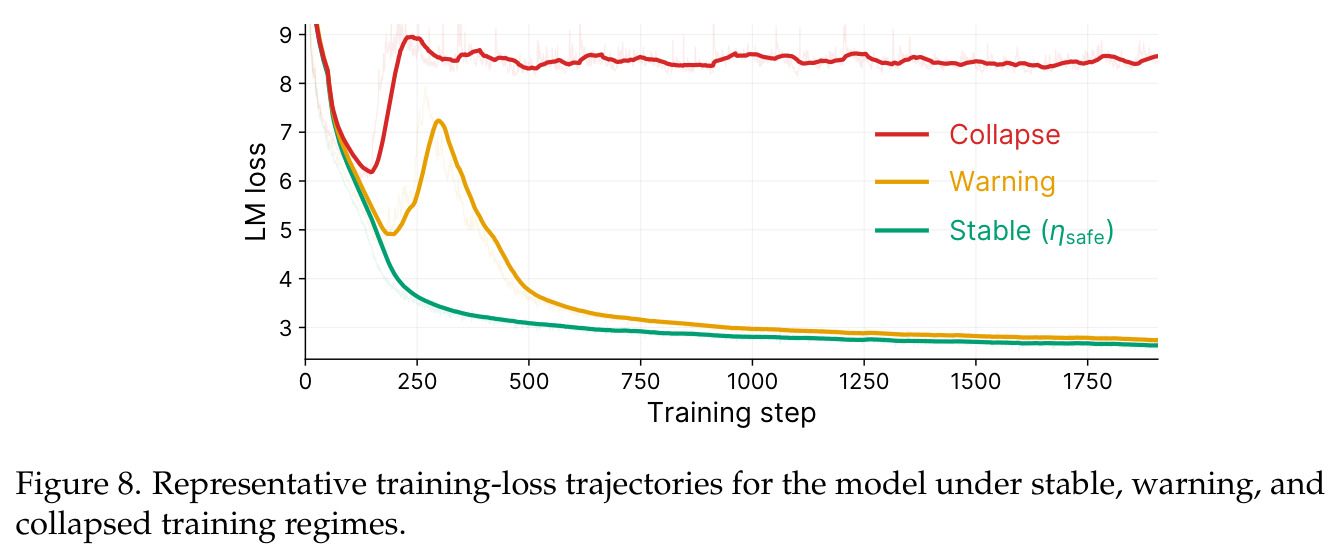
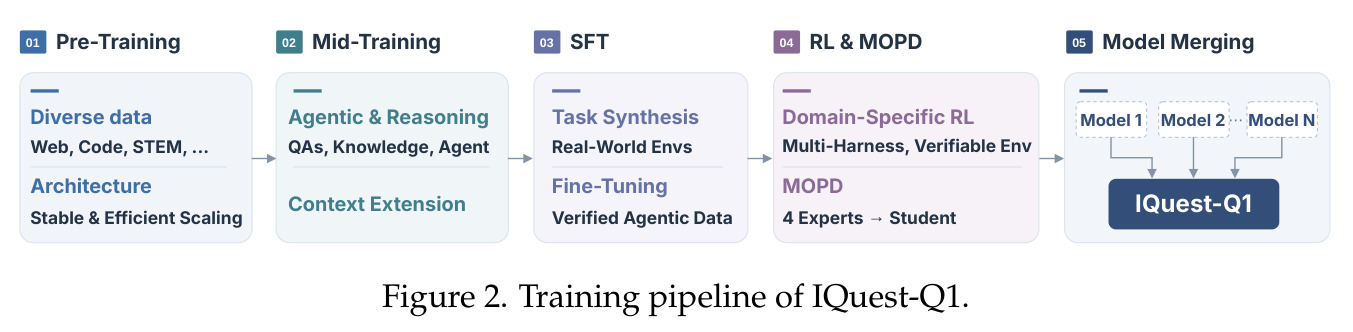
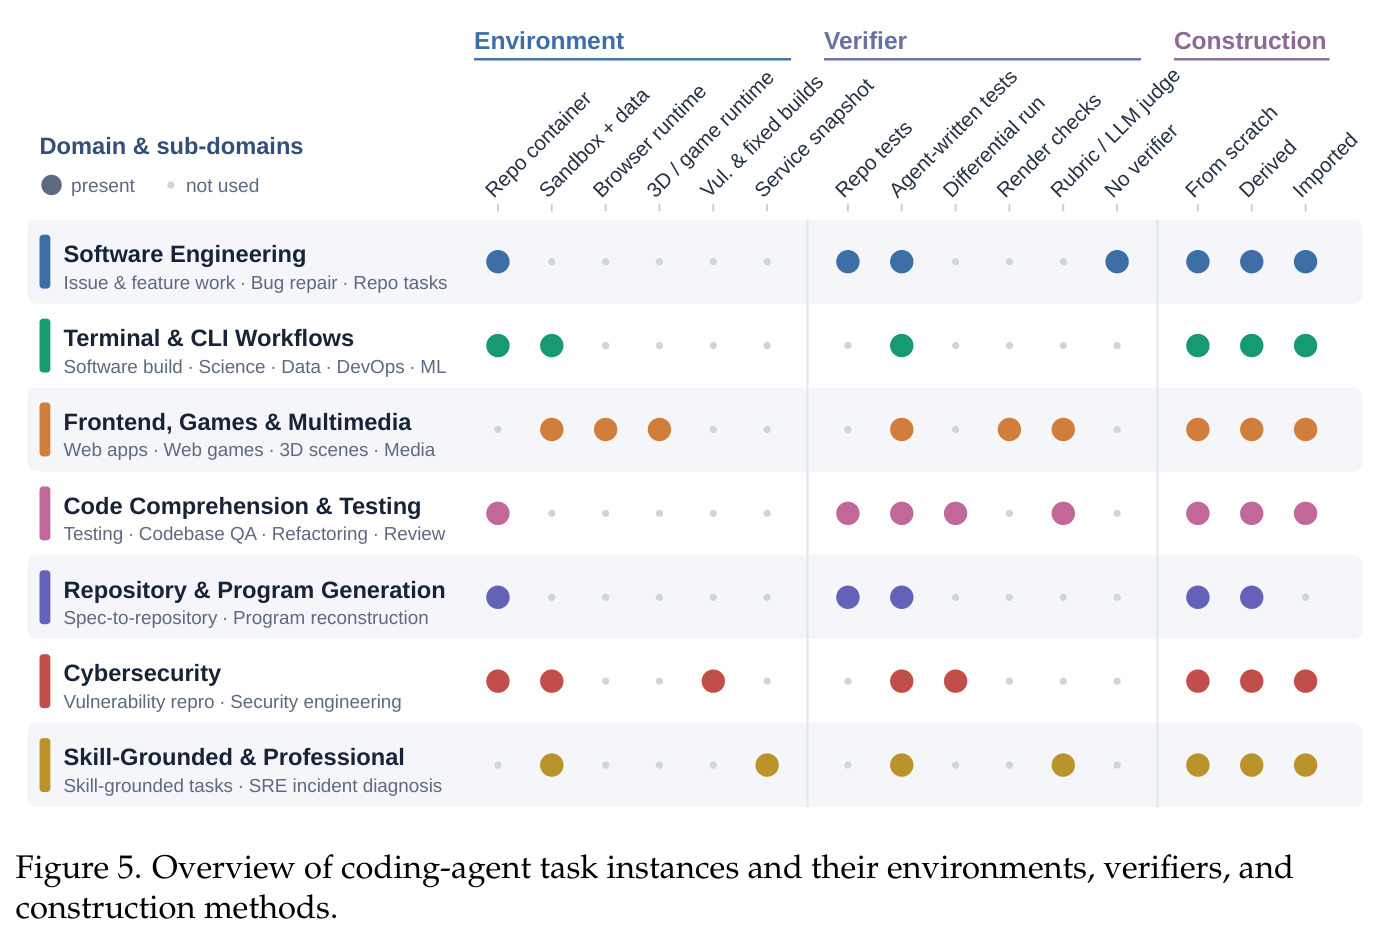
与已有工作不同的是,本文的独特之处在于把整条训练管线围绕CLI智能体交互来组织,而非先做通用模型再微调:预训练阶段用两阶段课程把代码数据占比从40%提到70%;中期训练直接用从真实仓库构建的超过100万个可执行容器实例rollout出的合法agent轨迹做数据,并用token级loss mask精细控制监督范围;后训练同时使用SFT、领域专项RL和多教师在线策略蒸馏(MOPD)三路信号,且RL显式覆盖Claude Code、Codex等多个脚手架及其不同版本,训练共享策略而非单脚手架特化模型。另一个独特角度是把扩展稳定性变成可测量的量:借鉴临界批大小(CBS)思想定义临界模型尺寸(CMS),用 $H_N=\log(\eta_{\mathrm{safe}}(N)/\eta_{\mathrm{opt}}(N))$ 度量稳定性余量,回答架构和配方还能放大到多大规模。
核心方法
IQuest-Q1的训练分五个环节。首先是稳定高效的预训练:架构采用Stable SplitNorm混合归一化、Muon优化器与μP参数化,在29T token的两阶段课程上训练,第二阶段把代码与STEM数据占比从40%提升到70%;学习率先warmup到 $6\times10^{-4}$,Stage 2末衰减到 $2\times10^{-4}$,中期训练末再降到 $6\times10^{-5}$。其次是精细的中期训练:数据混合扩展到高质量自然语料、QA对与agentic轨迹三类,上下文经32K、128K、512K三阶段渐进扩展,全程可变长序列packing,并以精选轨迹为锚点在兼容仓库上构建超100万个可执行实例。第三是两阶段SFT(240B+与50B+ token)。第四是环境中心的RL:用GRPO在可验证环境、多脚手架多版本episode上训练,配合失败归因、进度奖励与惩罚项。第五是MOPD多教师在线蒸馏(4个冻结专家)与跨阶段残差模型合并,最终输出统一模型。受控对比显示其扩展效率是Qwen3-MoE同规模设计的1.93倍。
核心创新有三点。第一是稳定扩展的系统性方案:SplitNorm只对进入注意力子层的残差流做归一化、FFN路径保持恒等残差,兼具Pre-Norm稳定性与Post-Norm深度利用率;再对注意力输出额外加RMSNorm防止激活爆炸、首层用SandwichNorm稳定输入,配合Muon+μP实现学习率跨规模零样本迁移(代理模型仅896宽度×18层)。论文还提出临界模型尺寸(CMS)框架:定义最优学习率 $\eta_{\mathrm{opt}}(N)$ 与安全学习率 $\eta_{\mathrm{safe}}(N)$,两者相等的规模即CMS,据此推断激活参数CMS约572B、总参数CMS约12T,说明当前15B激活规模仍有大量余量。第二是多脚手架多版本RL:同一策略在Claude Code、Codex等不同脚手架和版本上混合训练,直接提升跨harness的工具schema鲁棒性。第三是MOPD:按任务领域从4个冻结专家(交互体验、多脚手架、长程、通用)中选择教师,对学生on-policy rollout做token级裁剪对数比打分蒸馏,把互补能力合而为一。
方法步骤详情
具体流程:(1)架构——88层Transformer,隐藏维3072,48/8注意力头;3层SWA(窗口4096)+1层FA交错;首层稠密FFN,其余层256专家选8;2个MTP层。(2)预训练与中期训练——合计29T token,代码占比经四阶段从40%升至70%;中期训练用token级loss mask,上下文按32K→128K→512K扩展,并构建超100万可执行实例、保留合法轨迹。(3)SFT两阶段——分别240B+与50B+ token,初始学习率 $5\times10^{-5}$ 与 $1.5\times10^{-5}$,多样本packing。(4)RL——episode指定领域、脚手架版本、环境与评测器,GRPO在固定配置下比较重复rollout,失败归因后掩蔽环境故障,更新经TITO管线。(5)MOPD——按领域 $d(x_i)$ 从4个冻结专家选教师,优化长度归一化蒸馏损失 $L_k=-\frac{1}{B}\sum_i\frac{m_i}{T_i}\sum_t\tilde{a}_{i,t}\log p_\theta$。(6)模型合并——相对参考checkpoint合并参数增量,经全局 $\ell_2$ 范数校准后加回。
技术新颖性
技术新颖性体现在多个层面。架构层面,SplitNorm本身引用了先前工作[11,12],但把它与注意力输出RMSNorm、首层SandwichNorm、QKNorm Clip(上限10)组合成稳定的有效深度方案,并用1.93×扩展效率的受控对比实验(相同数据对比Qwen3-30B-A3B式MoE)验证累积收益,比单纯堆砌组件更有说服力。基础设施层面,滑动窗口halo交换与LSE重归一化的上下文并行实现、把sink贡献融合进注意力计算以减少显存访问、以及best-fit序列packing,都是工程上少见的设计。后训练层面,多脚手架多版本episode让单一策略学会适配不同harness的工具schema,直击开源模型在陌生schema上崩溃的痛点;MOPD把多专家蒸馏从离线数据蒸馏推进到on-policy token级打分,教师权重按需加载并在前向时预取,避免GPU副本随教师数量线性增长;TITO(Token-In Token-Out)前缀树保证rollout与训练的token级一致性。奖励破解的三层防护(环境准备、执行时拦截、轨迹审计)也是系统化的工程贡献。
实验结果
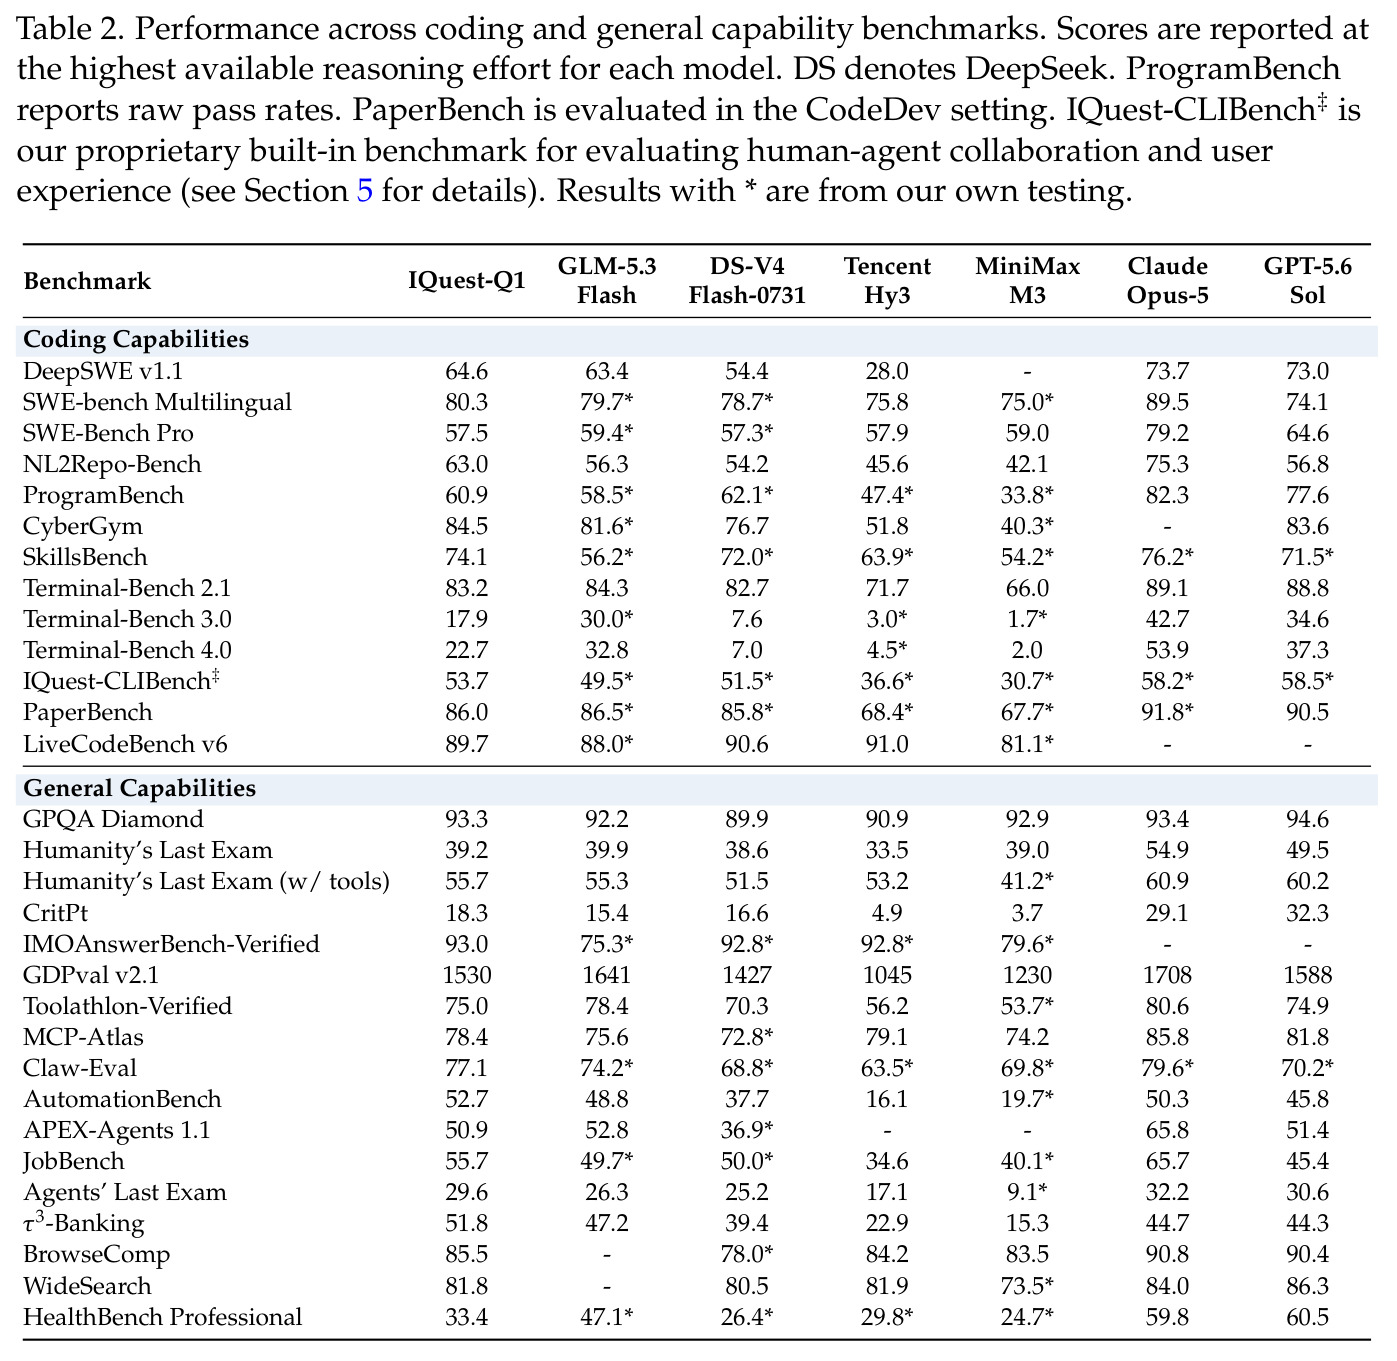
编码方面:DeepSWE v1.1得64.6,超过开源最佳DS-V4-Flash(63.4),落后Opus 5(73.7);SWE-bench Multilingual 80.3、SWE-Bench Pro 57.5(Opus:89.5/79.2);NL2Repo 63.0大幅领先开源最佳的56.3;CyberGym 84.5超过GPT-5.6 Sol的83.6居首;SkillsBench 74.1为全场最高;Terminal-Bench 2.1得83.2,但3.0/4.0仅17.9/22.7,远低于Opus的42.7/53.9。通用方面:GPQA Diamond 93.3、IMOAnswerBench 93.0接近前沿;AutomationBench 52.7超过Opus 5的50.3;HLE无工具39.2(Opus 54.9)、带工具55.7;HealthBench Professional仅33.4(Opus 59.8)是最大短板。自建IQuest-CLIBench得53.7,开源最高但低于Opus的58.2。总体上:多数编码与工具基准开源第一,部分触及闭源前沿,超长程与专业知识仍是短板。
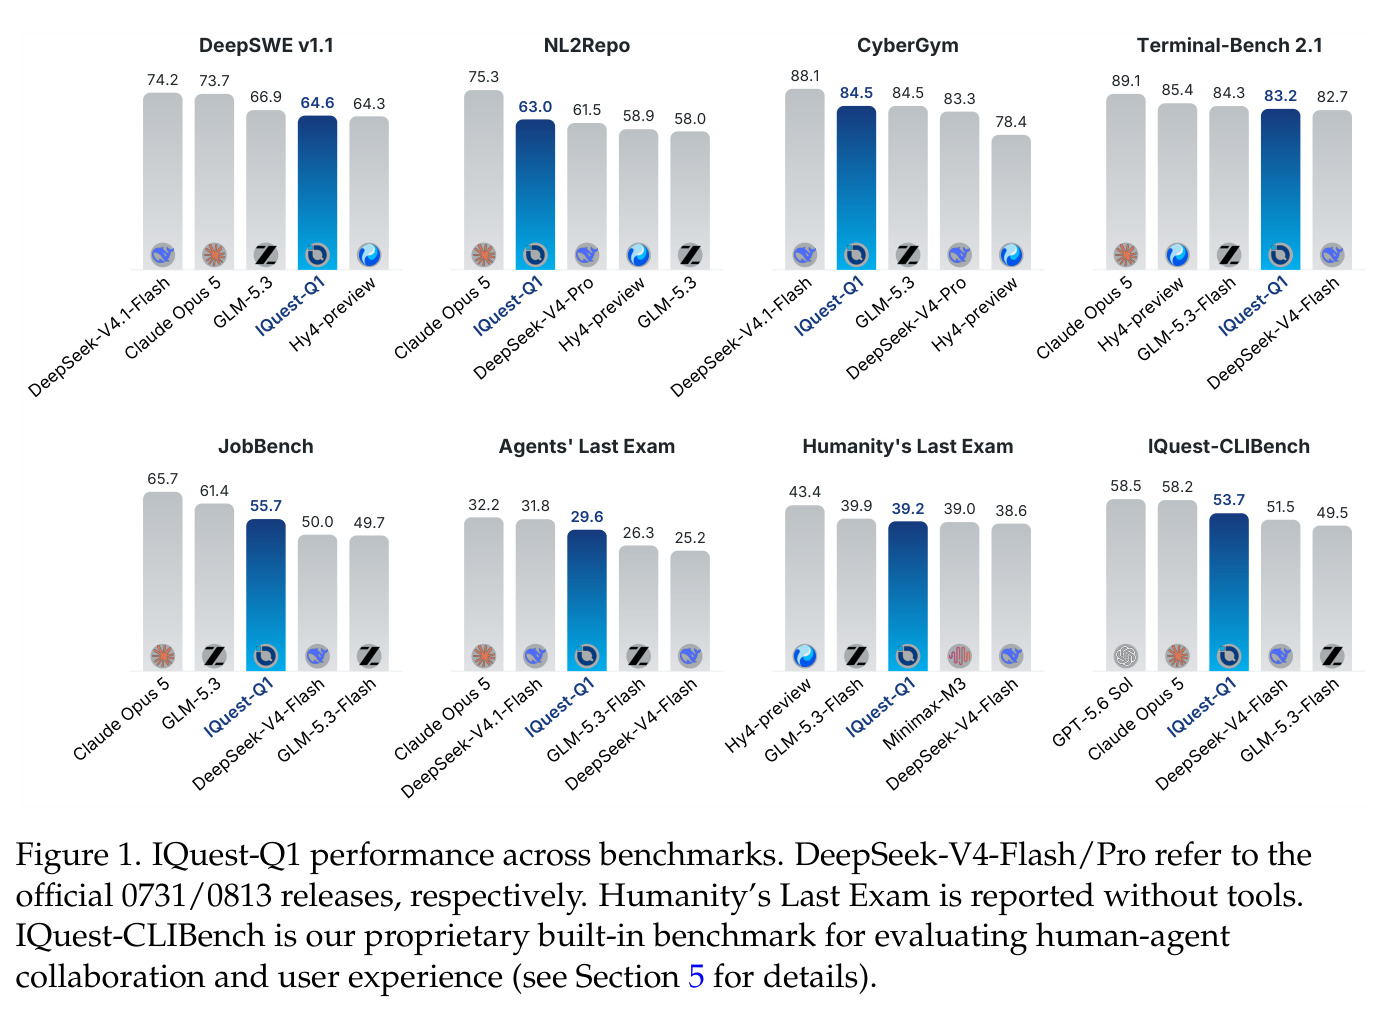
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DeepSWE v1.1 | 解决率(%) | 64.6 | Claude Opus 5: 73.7 / DeepSeek-V4-Flash: 63.4 | 开源第一,超最强开源基线1.2点,落后Opus 9.1点 |
| CyberGym | 漏洞复现验证成功率(%) | 84.5 | GPT-5.6 Sol: 83.6 / DeepSeek-V4-Flash: 81.6 | 超过GPT-5.6 Sol 0.9点,居所有模型首位 |
| NL2Repo-Bench | 自然语言生成仓库成功率(%) | 63.0 | DeepSeek-V4-Flash: 56.3 / Claude Opus 5: 75.3 | 超最强开源基线6.7点,开源最佳 |
| Terminal-Bench 2.1 | 任务通过率(%) | 83.2 | Claude Opus 5: 89.1 / DeepSeek-V4-Flash: 84.3 | 接近开源最佳,落后Opus 5.9点 |
| Terminal-Bench 4.0 | 任务通过率(%) | 22.7 | Claude Opus 5: 53.9 / DeepSeek-V4-Flash: 32.8 | 落后Opus 31.2点,长程终端是明显短板 |
| GPQA Diamond | 准确率(%) | 93.3 | Claude Opus 5: 93.4 / GPT-5.6 Sol: 94.6 | 与闭源前沿基本持平 |
| Humanity's Last Exam | 无工具准确率(%) | 39.2 | Claude Opus 5: 54.9 / DeepSeek-V4-Flash: 39.9 | 持平开源最佳,落后Opus 15.7点 |
| IQuest-CLIBench | 人机协作交互质量(%) | 53.7 | Claude Opus 5: 58.2 / DeepSeek-V4-Flash: 49.5 | 开源最佳,超DS-V4-Flash 4.2点 |
| HealthBench Professional | 准确率(%) | 33.4 | Claude Opus 5: 59.8 / DeepSeek-V4-Flash: 47.1 | 落后Opus 26.4点,最大短板 |
局限与改进
作者明确承认的局限包括:仅支持文本输入,没有原生图像、音频、视频能力;生成的解释与代码可能出错,需人工审查或用任务适配的测试验证;工具调用使用IQuest自有格式,需要兼容的serving解析器和agent harness配合;真实CLI任务中可能忽略约束、重复失败尝试或留下未解决问题。从数据看还有几点:长程终端任务与前沿差距最大(Terminal-Bench 4.0上22.7对Opus的53.9),说明超长程执行可靠性不足;专家级推理(HLE 39.2对Opus 54.9)和专业领域知识(HealthBench Professional 33.4对59.8)明显落后;IQuest-CLIBench是自建基准,脚本化用户模拟能否代表真实用户体验存疑,其他模型在该基准上的得分也由作者测试,存在评测口径偏差的可能;SWE-Bench Pro(57.5对79.2)表明高难度仓库级修改仍落后闭源前沿不少;此外模型合并与MOPD各专家的独立消融未充分报告,难以分辨各组件贡献。
独立分析的弱点
第一,长程执行衰减:从Terminal-Bench 2.1的83.2跌到4.0的22.7,说明随任务步数增长错误累积严重,改进方向是把segment级辅助奖励扩展为更系统的过程监督,或引入显式的计划-验证-回溯机制。第二,领域知识不均:HealthBench Professional仅33.4,说明后训练数据在医疗等专业领域覆盖不足,可用文档接地的推理任务合成管线定向扩充。第三,自评基准风险:IQuest-CLIBench由作者构建和评测,虽53.7对58.2的差距仍反映相对水平,但缺第三方复现,建议开源该基准并邀请独立团队复核。第四,数据一致性风险:论文自己发现训练数据严重偏向单一工具调用schema导致35次调用错误,虽经混合schema增强修复,但这提示需要常态化的数据-schema自动化审计。第五,纯文本输入限制了前端调试(截图)、文档理解等CLI高频场景,接入多模态编码器是明确方向。第六,模型合并使用预设权重且与MOPD的交互效应缺乏消融,读者难以判断合并对最终分数的具体贡献,应补充组件级消融实验。
未来方向
作者方向:继续推进能力与可靠性,并开源权重、部署配置和agent集成指令以促进社区开发;通过human-on-the-loop的递归自我改进缩短开发周期——论文给出的实例(agent自行定位6054次工具调用中的失败模式、提出数据清洗与混合schema增强方案、经人类批准后执行2.35B token/938.7 GPU小时的训练并评估回归)展示了该路径的可扩展性。可延伸方向:其一,用CMS稳定性框架规划下一代模型规模,理论上激活参数可放大到约572B仍保持稳定;其二,将MOPD教师池扩展到多模态与更多领域专家;其三,把RL环境的三层防奖励破解体系提炼为开源基础设施,惠及社区RL训练;其四,长程任务可靠性研究,如自动错误归因与课程式难度爬坡;其五,在网络安全方向深化人机协作工作流——三天部署中人类专家借助模型产出30份经独立验证并负责任披露的漏洞报告,证明该模式有进一步产品化的空间。
复现评估
可复现性中等偏上但门槛极高。开源部分:模型权重、部署配置与agent集成指令将开放(含IQuest专有工具调用格式的解析要求),架构超参(Table 1)与训练配方(Muon/Adam分工、学习率日程、课程与数据混合比例、SFT token量)在论文中披露得相当详细,比多数闭源模型透明。未开源部分:29T token的预训练语料、100万+可执行容器实例、RL环境库与4个教师专家模型均未提及开放,IQuest-CLIBench为专有基准。算力方面:320B总参/15B激活的MoE,即便推理也需要多卡GPU加兼容serving parser;训练算力未披露,但从单次RSI实验就耗938.7 GPU小时可推知全流程成本在数十万GPU小时量级。复现建议:社区可行路径是直接部署开源权重做评测复现(用论文报告的Claude Code等脚手架与各基准时限配置),完整训练复现只有拥有大规模集群的机构可以尝试;而Muon+μP的小代理模型调参流程(896宽度×18层代理迁移到4倍宽深目标)对中小团队亦有借鉴价值。
论文图表