继承而非发明:推理模型“Wait”反思标记的来源溯源 Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
推理模型的“wait”反思标记几乎从不由RL发明,而是由训练数据植入、再被RL配方改塑。
前置知识
语法化(Grammaticalization)
历史语言学的核心概念:实词在特定语境中反复使用后逐渐演变为语法标记的过程,教科书案例是英语 going to 缩蚀为将来时标记 gonna。Lehmann (2015) 把过程拆成六个可测参数:范式轴上的完整性(语义漂白)、范式化、范式变异性,组合轴上的辖域、粘着度、组合变异性(位置固定);Bybee (2003) 则指出使用频率是驱动力——重复使结构自动化、习惯化使意义漂白。这些参数都可直接从词的出现样式中测量。
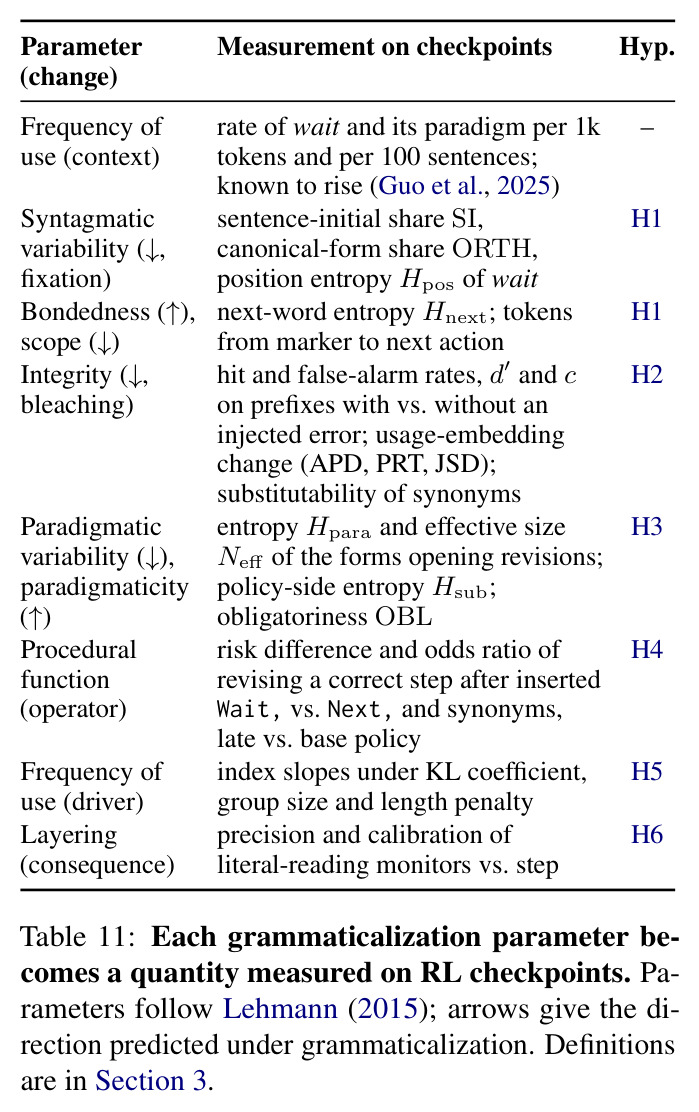
本文把每个模型检查点当作“历时语料库”,整套方法论词汇(source、fixation、attrition、bleaching)和六条预注册预测全部来自语法化理论,不理解这套框架就无法理解作者为什么这样设计指标、以及哪些理论预测被证伪。
RL-Zero 与 GRPO(结果奖励强化学习)
RL-Zero 指不做监督冷启动、直接从 base 模型用可验证奖励(最终答案对错)做强化学习。GRPO 对同一问题采样一组回答,以组内相对奖励作为优势(advantage),且整条思维链的所有 token 共享同一优势信号。DeepSeek-R1 的“aha moment”即来自这种训练:wait、recheck 等反思词在训练中频次成倍增长。
本文要检验的核心命题是“RL 能否发明 wait”。理解 outcome-based RL 的信用分配方式(整条 trace 同一 advantage、奖励只看最终答案)才能理解为什么 RL 会放大‘标记→动作’这一既有关联,而不是凭空创造标记。
信号检测论的 d′ 与 c
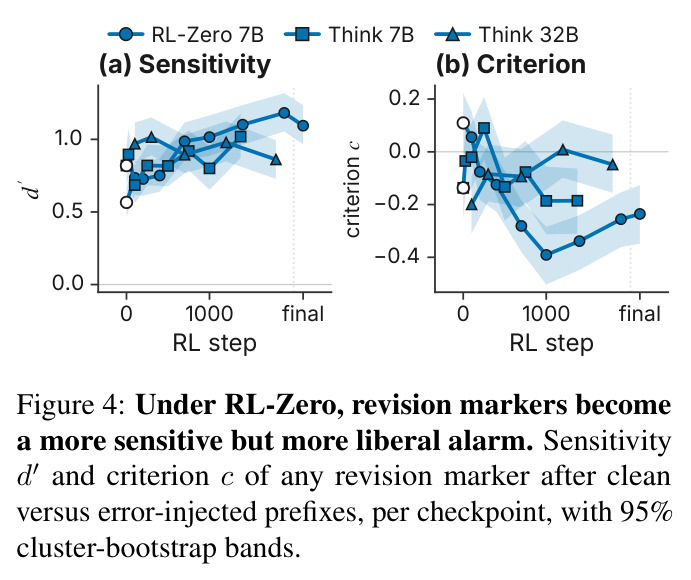
心理物理学经典框架:把二分类检测拆成两个独立量。敏感度 $d' = z(HR) - z(FA)$,其中 $HR$ 是命中率、$FA$ 是虚警率,$z$ 是标准正态的逆函数,衡量区分信号与噪声的能力;判断标准 $c = -\tfrac{1}{2}(z(HR) + z(FA))$,衡量反应偏向——$c$ 越低越“宽松”,越容易拉响警报。两者独立:敏感度不变时判据可以移动。
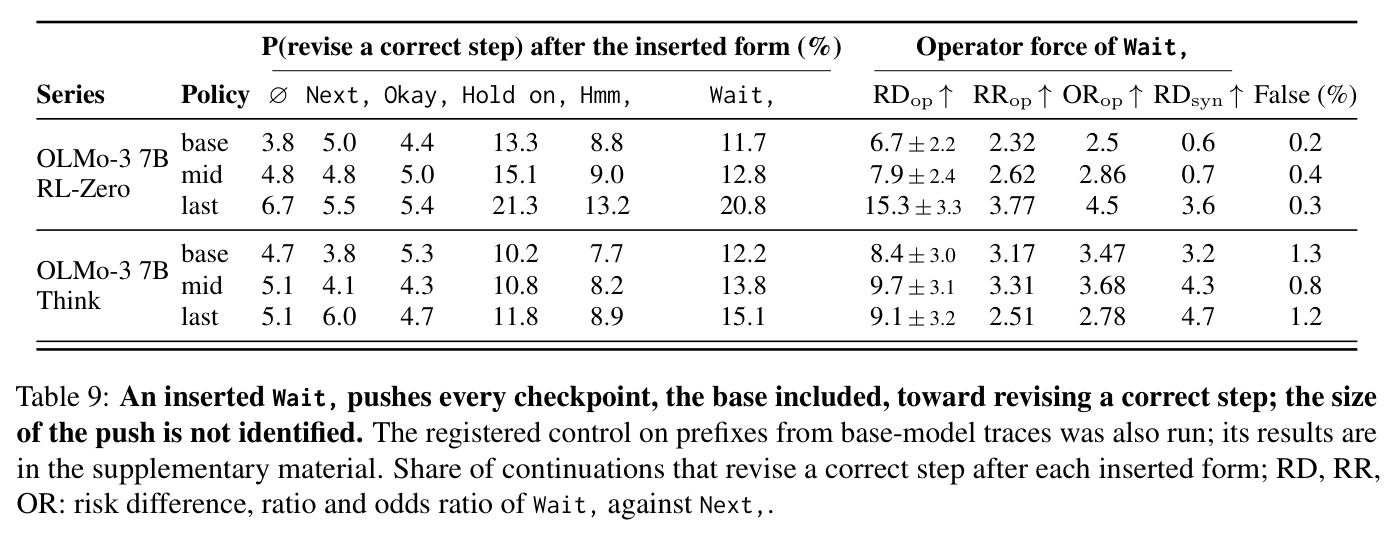
论文用注入错误实验把“wait 是不是报错信号”变成可测问题,结论是 OLMo-3 RL-Zero 让它成为“更敏感但更宽松的警报”($d'$ 从 0.57 升到 1.09,$c$ 从 0.11 降到 $-0.24$),这一表述完全建立在 d′ 与 c 之上。
中训练(Mid-training)
介于预训练与后训练之间的持续预训练阶段,向语料中混入 STEM、代码、推理与合成数据等高质量内容(如 OLMo-3 的 stage 2)。它与预训练共用下一词预测目标,但分布向推理倾斜;Qwen3 的报告也描述过提高 STEM/推理数据占比的中训练阶段。
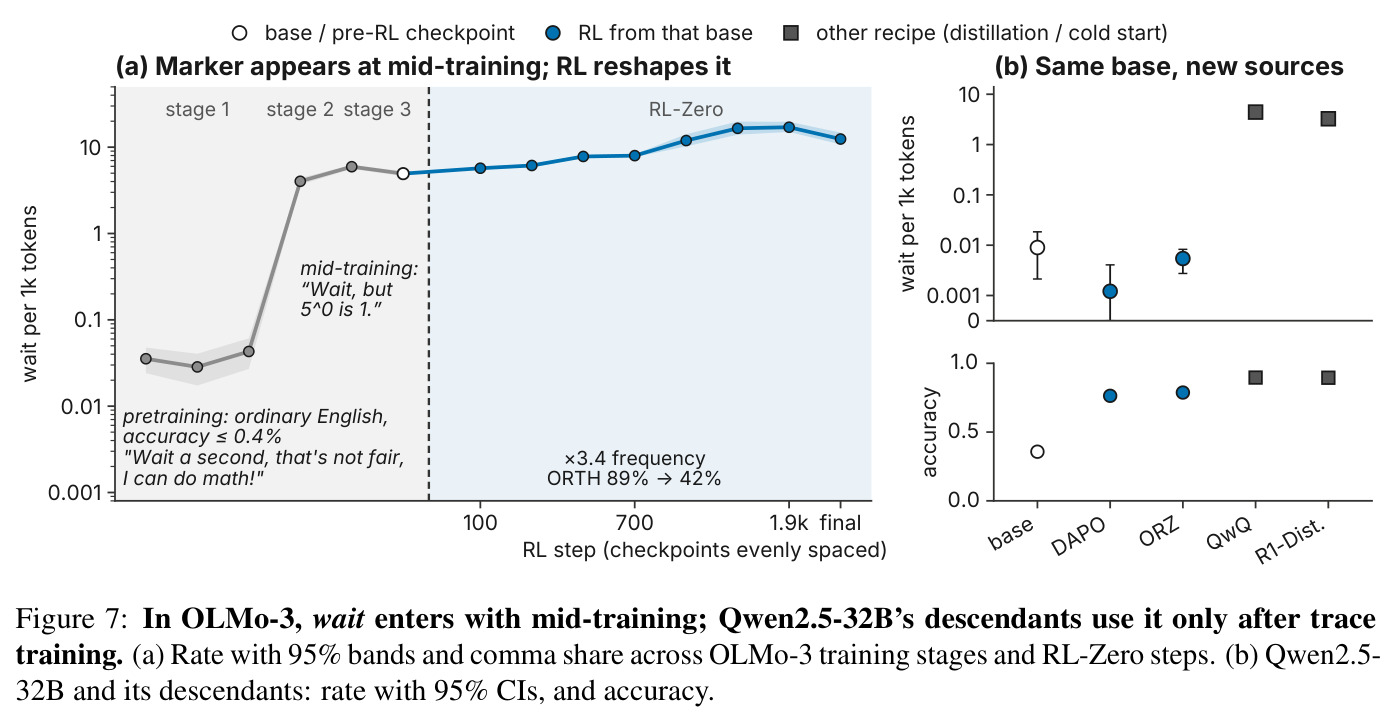
论文最关键的定位结论之一是:OLMo-3 的 wait 正是在 mid-training 进入模型的——预训练时每 1k token 不足 0.04 次,mid-training 后跳到 4.03 次。没有这个概念就无法理解“aha 时刻”的时间轴如何被重写。
预注册实验(Pre-registration)
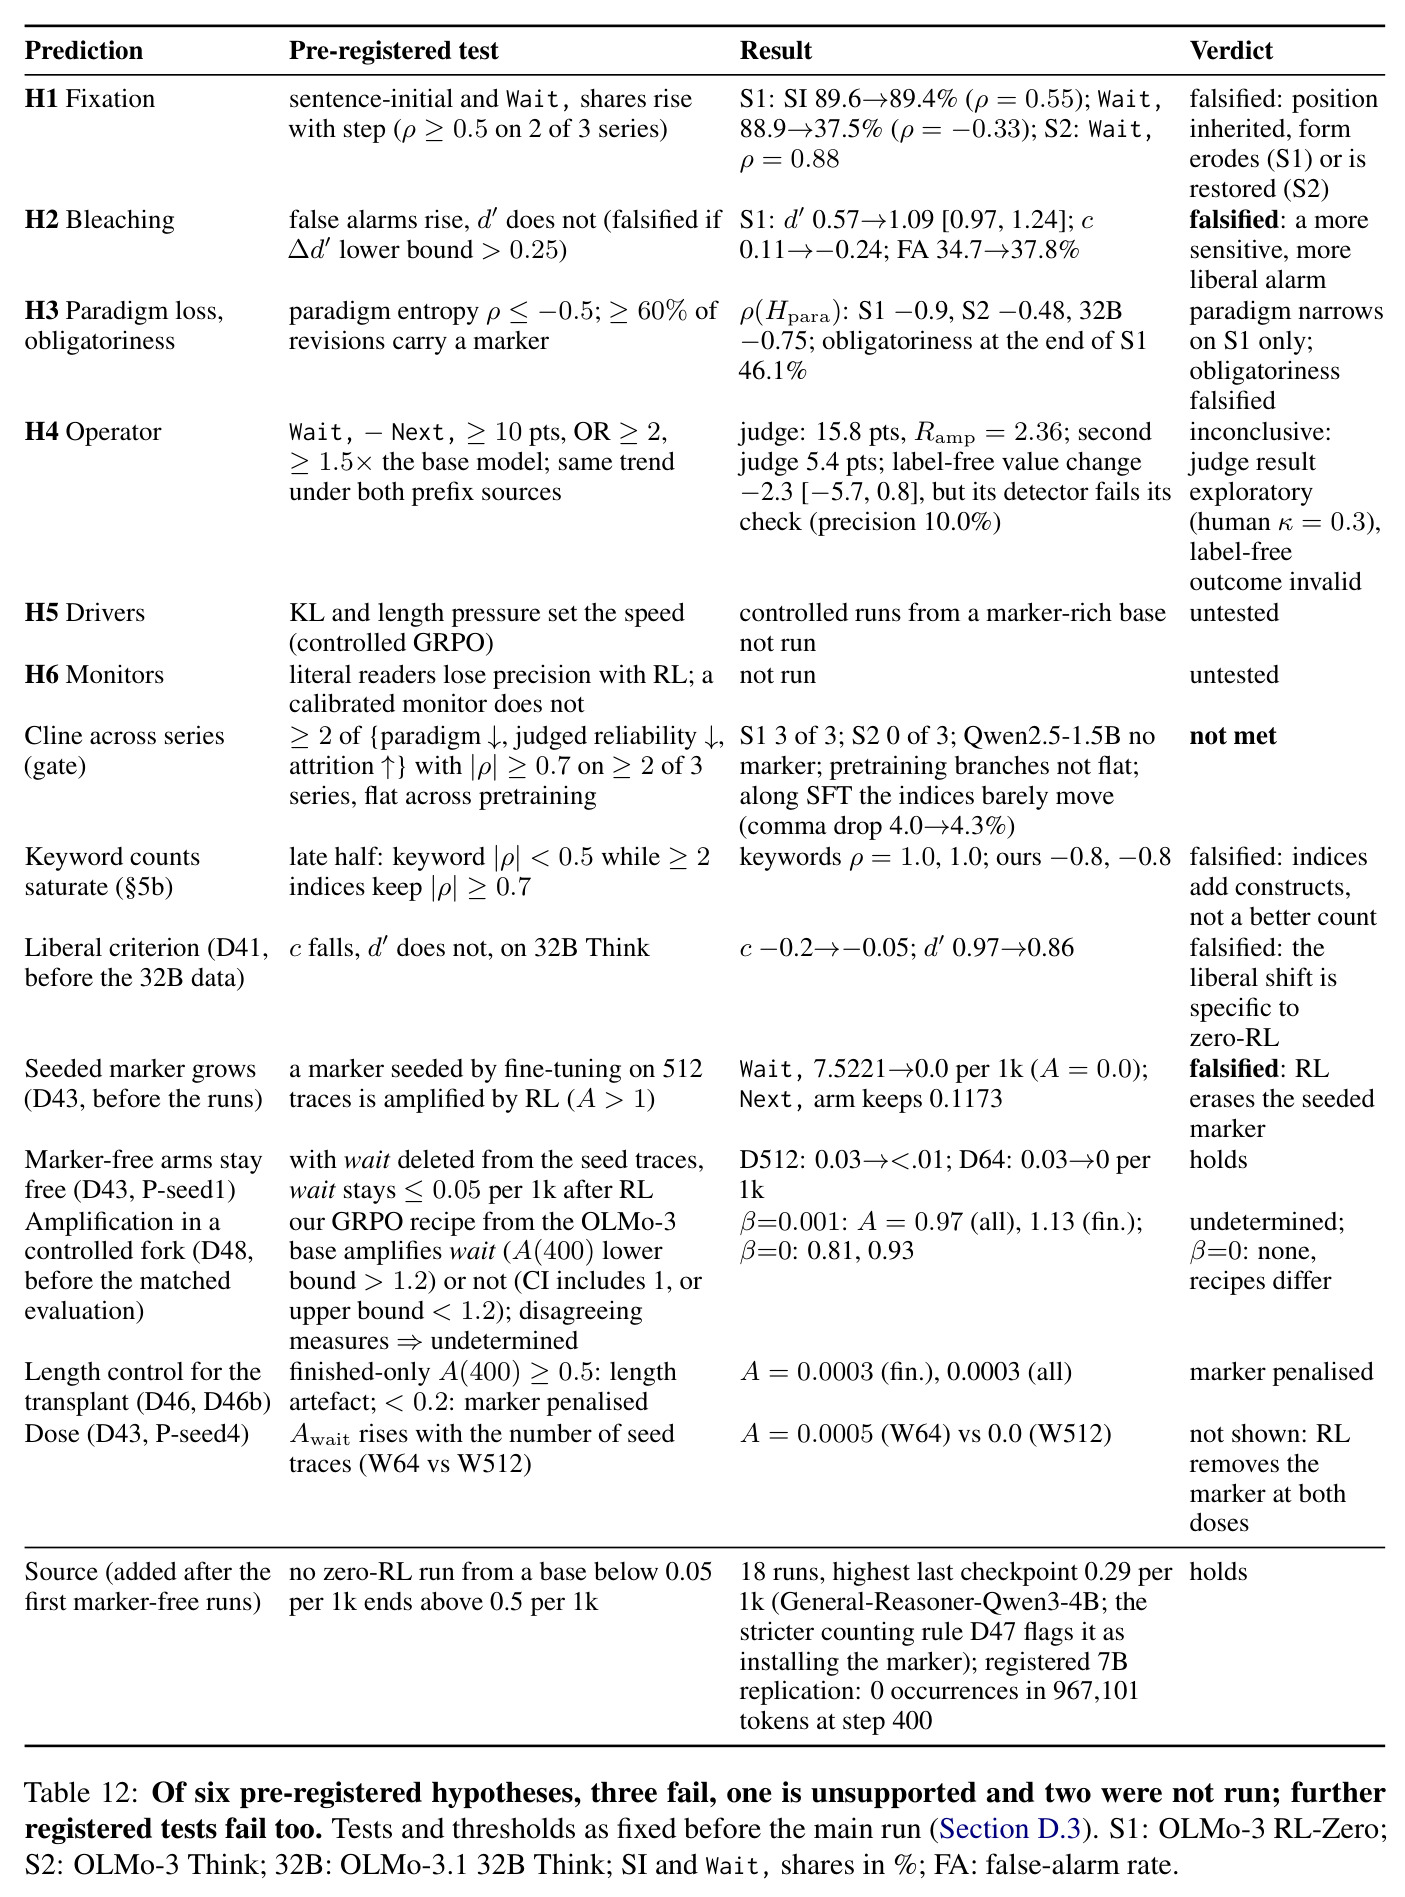
在主实验运行前公开固定假设、判定阈值与证伪条件,防止事后为结果编造解释。本文在主实验前注册了源自语法化理论的六条预测(H1 固定化、H2 漂白、H3 范式收窄、H4 算子、H5 驱动、H6 监控),每条附带明确的证伪条件,并在附录 Table 12 逐一报告结局——其中三条被证伪、两条未运行。
本文的可信度很大程度上来自诚实的负结果报告:理解预注册机制才能明白“RL 不是在重演语法化”这一结论的证据强度,以及哪些声明(如校准干预 D50)没有通过自己设定的门槛。
研究动机
社区普遍把推理模型写作“wait, let me reconsider”归功于强化学习:R1-Zero 训练中 wait 及其同族词频次翻了几倍,被称为模型学会重新审视的“aha moment”(Guo et al., 2025),此后不确定性启发式方法和思维链监控器都把这些标记词当作怀疑与推理的证据。问题在于,这类叙事建立在一个从未被检验的假设上:RL 显式发明了这个标记并在训练全程固定其语义。现有研究要么在最终模型上统计反思关键词(Hu et al., 2025a;Zeng et al., 2025;Gandhi et al., 2025),要么用 LLM 裁判给行为贴标签,而裁判效度参差不齐(Zheng et al., 2023;Bavaresco et al., 2025);虽然已有工作发现反思行为在 RL 之前就存在于 base 模型(Liu et al., 2025d;Essential AI et al., 2025),但没有任何研究沿一条开放的训练轨迹逐检查点追踪这个“词”本身——它在模型史上何时首次出现、RL 到底对它做了什么,仍然是空白。具体例子是:OLMo-3 在一道竞赛题的解答里写了 36 次 wait,RL 后同一模型写出“Wait, but hold on.”“Wait, 2 is 2/1.”这类用法。
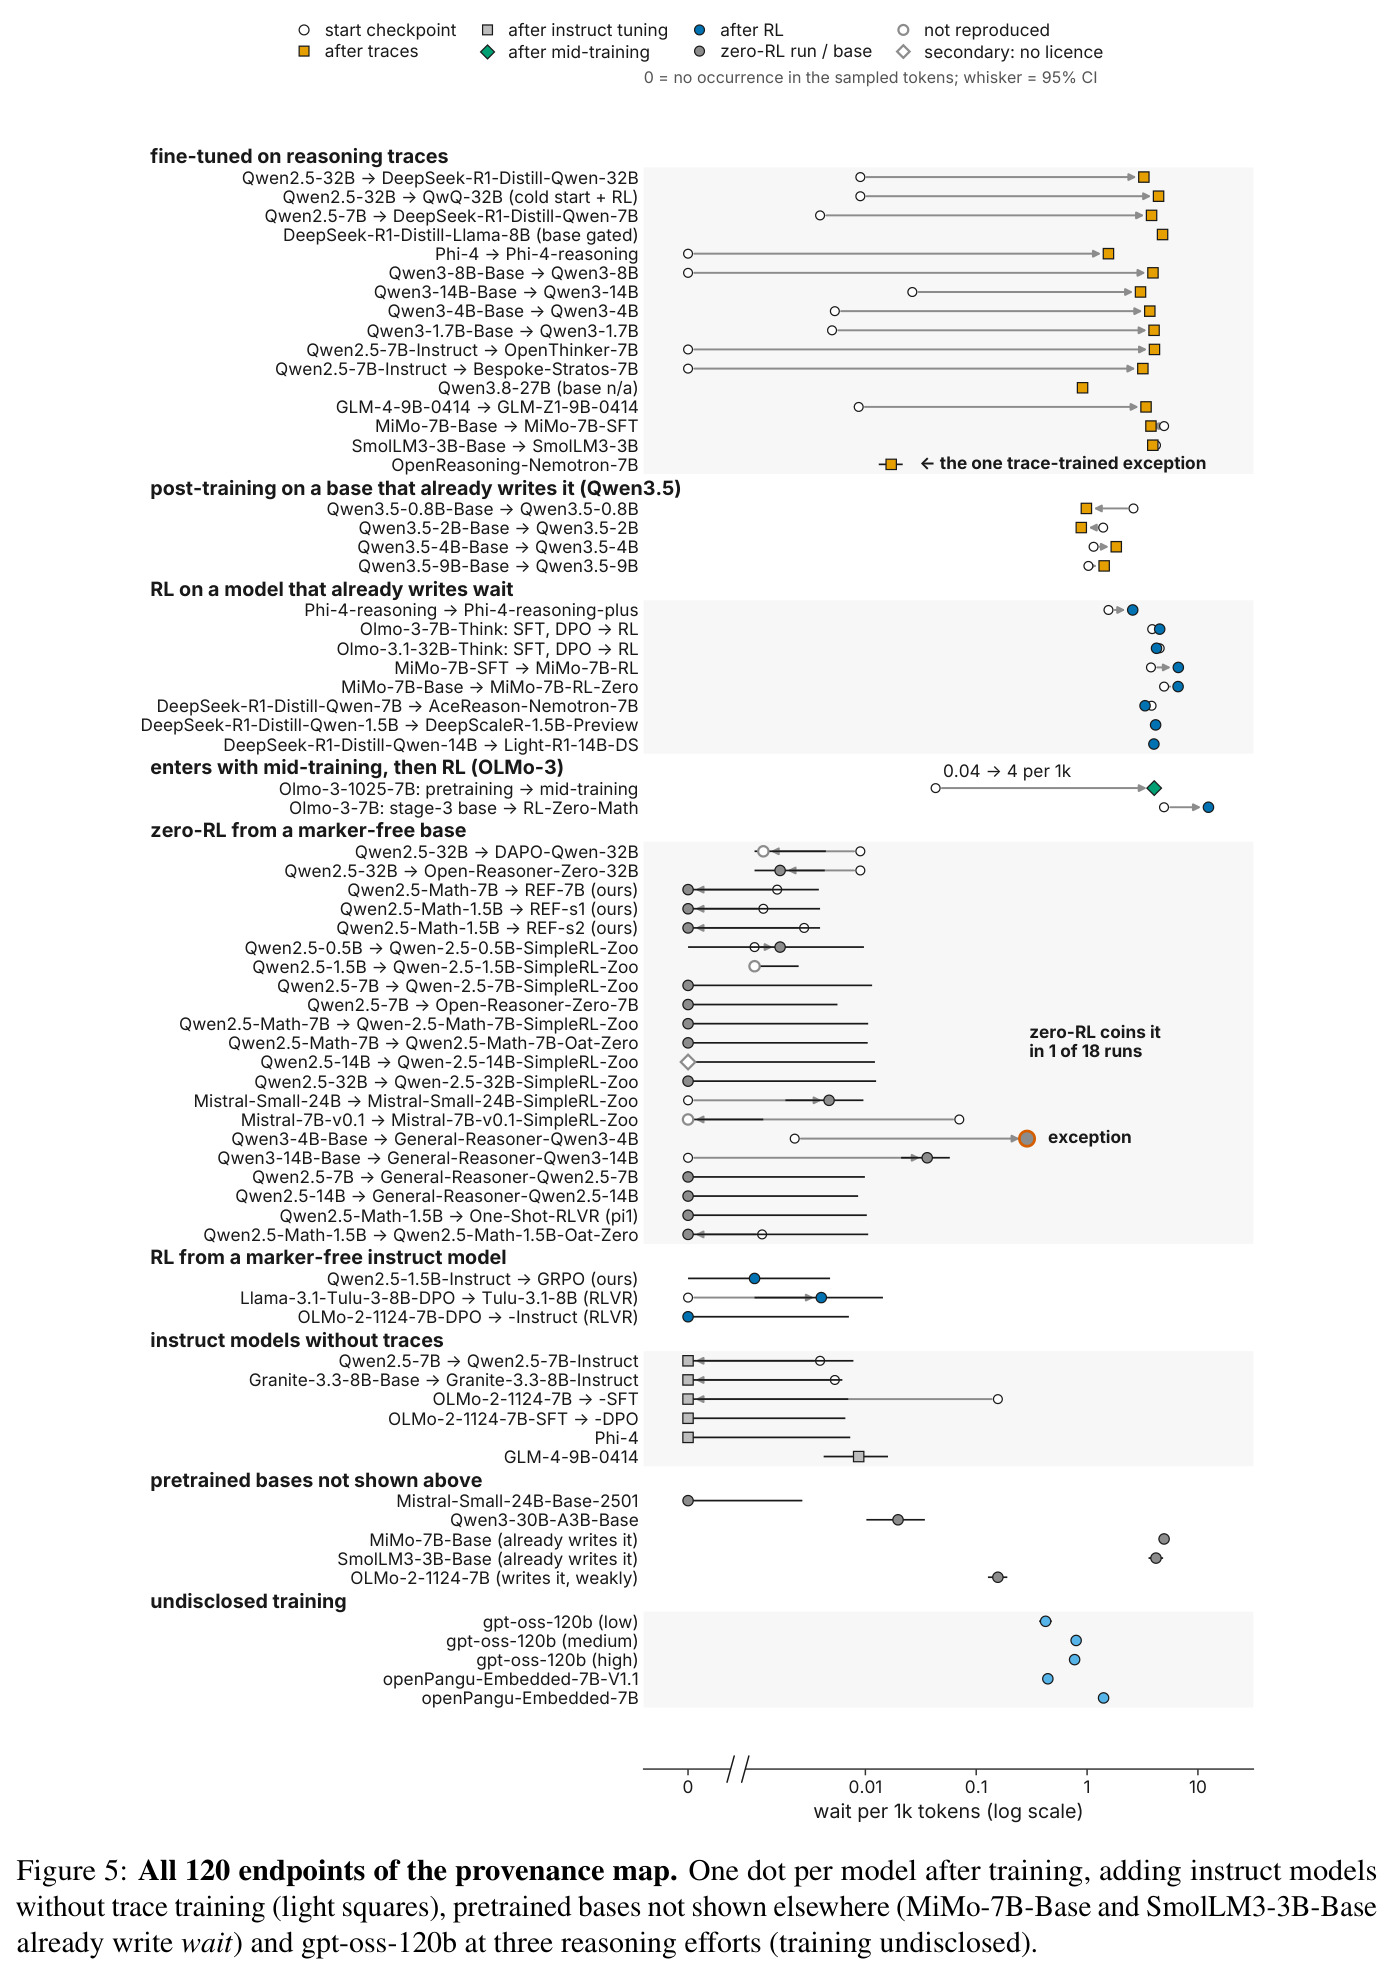
本文的目标是本文要回答两个紧密相关的问题:wait 这个词从哪里来,RL 对它做了什么。具体目标是利用开放模型发布构建可核查的训练史:(1)在完全开源的 OLMo-3 7B 谱系上,从预训练、mid-training、base 到 RL-Zero 与 Think(SFT+DPO+RL)逐检查点采样,为标记的首次出现精确定年;(2)从不含该词的 base(Qwen2.5、Mistral、Qwen3,0.5B–32B)出发运行 18 次 zero-RL,检验 RL 能否凭空发明标记,同时以蒸馏/微调谱系(QwQ-32B、R1-Distill、Phi-4、MiMo 等)作为训练数据来源的对照;(3)构造只依赖采样输出的无标签指标(频率、位置、形态、用法)与注入错误的警报测试,量化每个训练阶段如何改写标记的语义;(4)用预注册的移植实验因果检验“RL 能否抹除已被微调植入的标记”。最终为“aha moment”叙事提供来源校正,并给监控者留下按检查点校准的实用方法。
与已有工作不同的是,本文的独特切入是把历史语言学的语法化理论整体移植为对训练过程的测量框架:把一个模型沿检查点的采样输出当作历时语料库,像历史语言学家考据一个词的演变那样,从出现本身构造频率、位置固定、形态磨损、粘着等参数,并在主实验前预注册可证伪的预测。与已有工作的本质区别有三层。第一,时间轴:先前研究只看最终模型或 RL 轨迹上的关键词计数,本文第一次在单一开源谱系内为标记的“形式”定年,并区分训练数据的供给作用与 RL 配方的改塑作用。第二,测量方式:不依赖 LLM 裁判或模型内部访问,用确定性规则指标加上信号检测式的注入错误实验,把“标记是什么信号”变成可测的 $d'$ 与 $c$——论文还用 60 句盲审计证明 LLM 裁判会反转人类标注的趋势,反衬这种选择的必要性。第三,干预实验:通过先用 512 条以 Wait, 开头的轨迹做轻量 SFT 植入标记、再用自家 GRPO 训练 400 步的注册移植,直接观察 RL 对已存在标记的处理,而不止于观察性比较。
核心方法
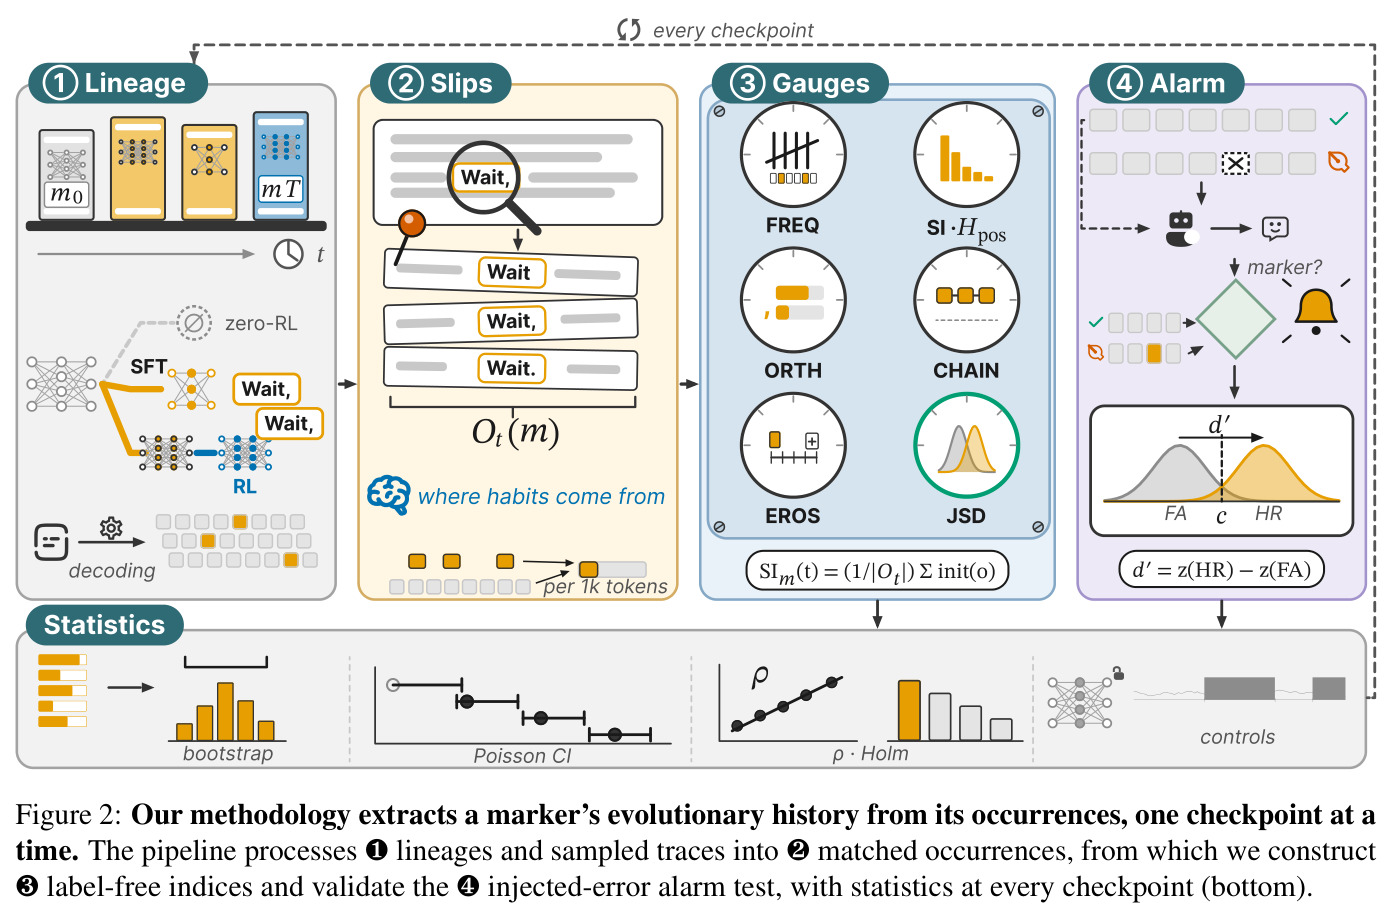
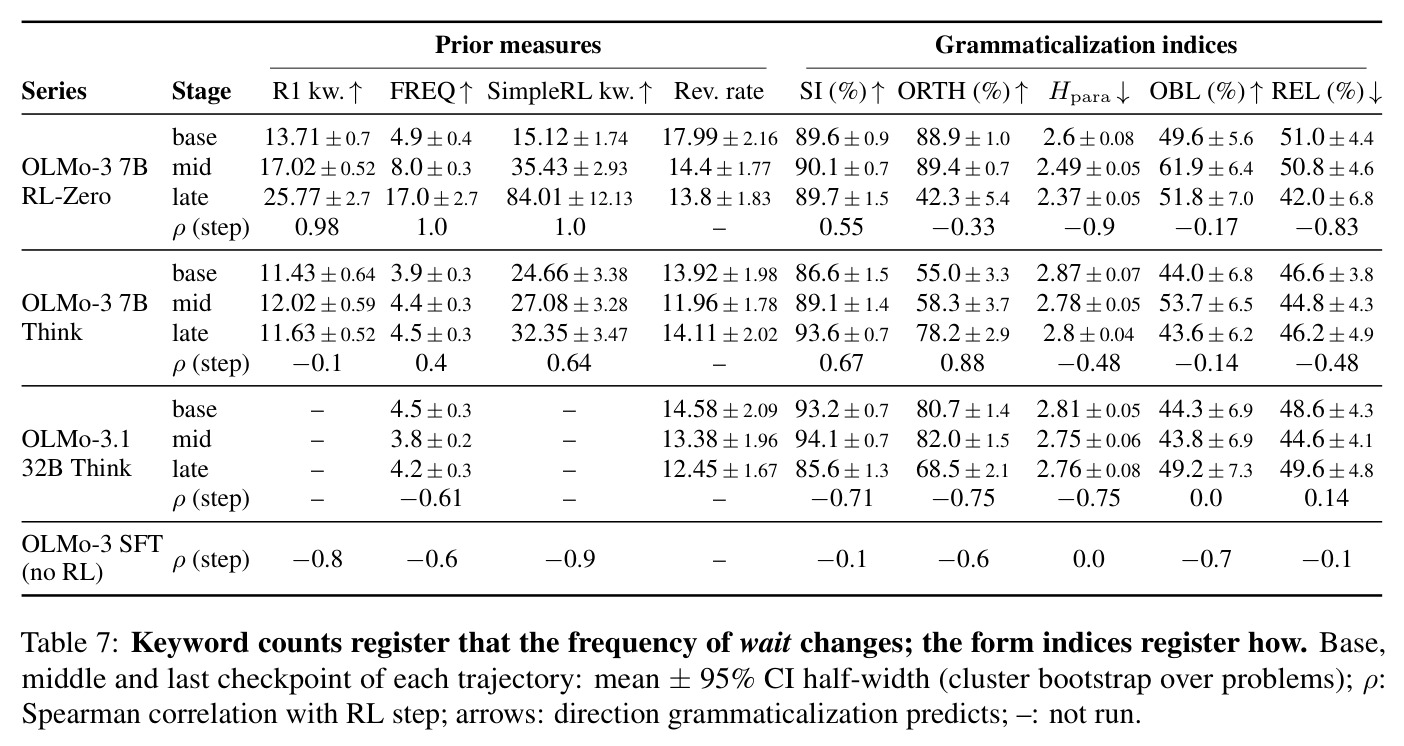
直觉上,判断一个词是不是 RL 发明的,最直接的办法是沿训练历史逐检查点看它何时首次出现:如果 base 里没有、RL 之后仍然没有,RL 就没有发明它;如果 RL 之前就有,RL 只是改塑它。技术上论文分四步走。第一步构建三类谱系并采样:完全开源的 OLMo-3 7B(预训练→mid-training→base→RL-Zero 或 Think,另有 32B 复刻 OLMo-3.1)、从无标记 base 出发的 RL-Zero(自家 GRPO 跑 Qwen2.5-Math-1.5B 两种子与 7B,另评 DAPO 与 Open-Reasoner-Zero on Qwen2.5-32B)、以及从 Qwen2.5-32B 等出发的微调后代(QwQ、R1-Distill、Phi-4、Qwen3、GLM、MiMo、SmolLM3),共 120 个模型端点;每个检查点在 MATH-500 上用固定解码每题采样 2–8 个回答。第二步在 detokenized 文本上匹配所有拼写变体的出现并计算每 1k token 频率。第三步构造无标签语言学指标:句首固定率 $\mathrm{SI}_m(t)=\frac{1}{|O_t(m)|}\sum_{o\in O_t(m)}\mathrm{init}(o)$、位置熵 $H_{pos}$、规范形态占比 ORTH、链式粘着 CHAIN、侵蚀 EROS 与用法分布的 Jensen–Shannon 漂移。第四步是注入错误警报实验:对每题构造正确前缀与注入一个算术错误的平行副本,用检查点 $\theta_t$ 续写并观察两句话内是否出现反思标记,计算 $d'(t)=z(HR)-z(FA)$ 与 $c(t)=-\tfrac{1}{2}(z(HR)+z(FA))$。所有阈值、趋势检验(Spearman 对 RL 步、Holm 校正)在主实验前注册。
核心创新是把“标记的来源”与“标记的改塑”分解成两个独立问题,并用语法化的第一课回答来源问题:一个语法标记需要“已在使用的源结构”,它不能凭空被发明——RL 学到的是“标记→重查动作”这一既有关联,而非“错误→标记”的因果关系,因为在 GRPO 中整条轨迹共享同一优势,标记只要出现在成功轨迹中就会被强化,无论那里是否真有错误。与已有方法的本质区别在于:(1)把“aha moment”从行为叙事还原为词的形式史,第一次给出单一开源谱系内的进入时点(OLMo-3 的 mid-training);(2)测量完全脱离 LLM 裁判与内部探针,只靠确定性规则与信号检测实验,因而可跨谱系移植到 120 个端点;(3)预注册六条理论预测并接受被证伪——结果发现 RL 并不重演语法化的经典路径(没有漂白、没有位置固定化、各配方不构成单一大致统一的演变斜坡),这修正了“RL=语法化”的类比;(4)移植实验提供了因果证据:标记可以被人工植入(SFT 后 7.52 次/1k),也可以被特定配方在 400 步内完全抹除,从而把“训练数据播种、配方决定存留”从相关性提升为可操作的因果陈述。
方法步骤详情
完整管线分四阶段。①谱系与采样:构建三类历史——全开源 OLMo-3 7B(预训练 stage 1、mid-training stage 2、base stage 3,随后 RL-Zero-Math 或 SFT+DPO+RL 的 Think,及 OLMo-3.1 32B Think 复刻);从无标记 base 的 RL-Zero(自家 KL-free GRPO:Qwen2.5-Math-1.5B 两种子、7B;以及公开的 DAPO、Open-Reasoner-Zero on Qwen2.5-32B);标记继承者(在 Qwen2.5-32B 等的推理轨迹上微调的 QwQ-32B、R1-Distill、Phi-4-reasoning、Qwen3、MiMo、SmolLM3 等)。每个检查点用固定解码在 MATH-500 每题采 2–8 个回答。②出现匹配:在 detokenized 文本上匹配 wait 的全部拼写变体(Wait,、wait、Wait. 等),定义 $\mathrm{FREQ}_m(t)=|O_t(m)|$ 每 1k 生成 token,注册的“近乎缺席”阈值为点估计 0.05/1k。③无标签指标:句首固定率 $\mathrm{SI}_m(t)$ 与位置熵 $H_{pos}$(固定化);规范形态 ORTH(Wait, 份额);粘着 CHAIN(续接成 Wait, wait 链的比例);侵蚀 EROS(标记到下一数学动作的 token 距离与句长);用法漂移 JSD(固定编码器对比 base 的 split-half 噪声底 0.002)。④警报实验:正确前缀 vs 注入一个算术错误的副本,续写两句话内出现标记范式(wait、hmm、actually 等)记为命中,$HR=P(\text{marker}\mid\text{error})$,$FA=P(\text{marker}\mid\text{no error})$,$d'=z(HR)-z(FA)$,$c=-\tfrac{1}{2}(z(HR)+z(FA))$。统计上:出现计数用精确 Poisson 区间;比值与 $d'$ 用按题聚类的 bootstrap(95% CI);趋势用对 RL 步的 Spearman 相关并 Holm 校正;绝不合并序列。干预端:移植实验把 Qwen2.5-Math-1.5B 在 512 条以 Wait, 开头的正确轨迹上微调(植入 7.52/1k),再跑 400 步自家 GRPO,并设 Next,-种子对照臂与 8,192 token+YaRN 的长度对照臂。
技术新颖性
技术新颖性体现在五个方面。第一,溯源定年:首次在单一开源谱系内为反思标记的进入时点精确定年,证明 OLMo-3 的 wait 在预训练阶段 $\le 0.04$/1k、mid-training 后跳到 4.03/1k(88.6% 句首),恰与 RL-Zero 思维轨迹进入中训练语料同步——这是“aha 时刻属于数据而非 RL”的直接证据。第二,理论移植与证伪:把 Lehmann 的六个语法化参数逐一映射为可在检查点上计算的量(Table 11),预注册预测并公开汇报三条被证伪(无漂白、形式被磨损而非固定、跨配方不构成统一斜坡),明确声明“RL 不是语法化”,只保留“标记需要源结构”与“形式会磨损”两条教训。第三,无标签语义测量:注入错误 + 信号检测的警报测试不需要裁判、标注或内部访问,给出 $d'$ 与 $c$ 的检查点轨迹,使“标记证据权重是检查点的属性”这一结论可复算。第四,因果移植实验:人工植入标记再观察 RL 的处理(400 步后 306 万 token 中 0 次出现),并以中性词 Next, 的对照臂与长度对照臂排除混淆。第五,可复用资源:120 端点的溯源地图、指标套件与三个专家共识盲审计随论文开源,构成后续研究的公共基础设施。
实验结果
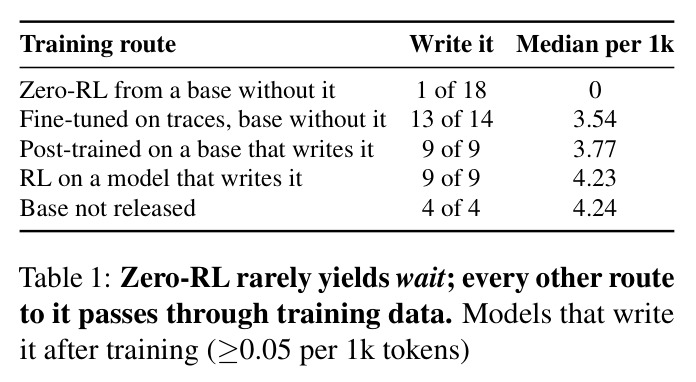
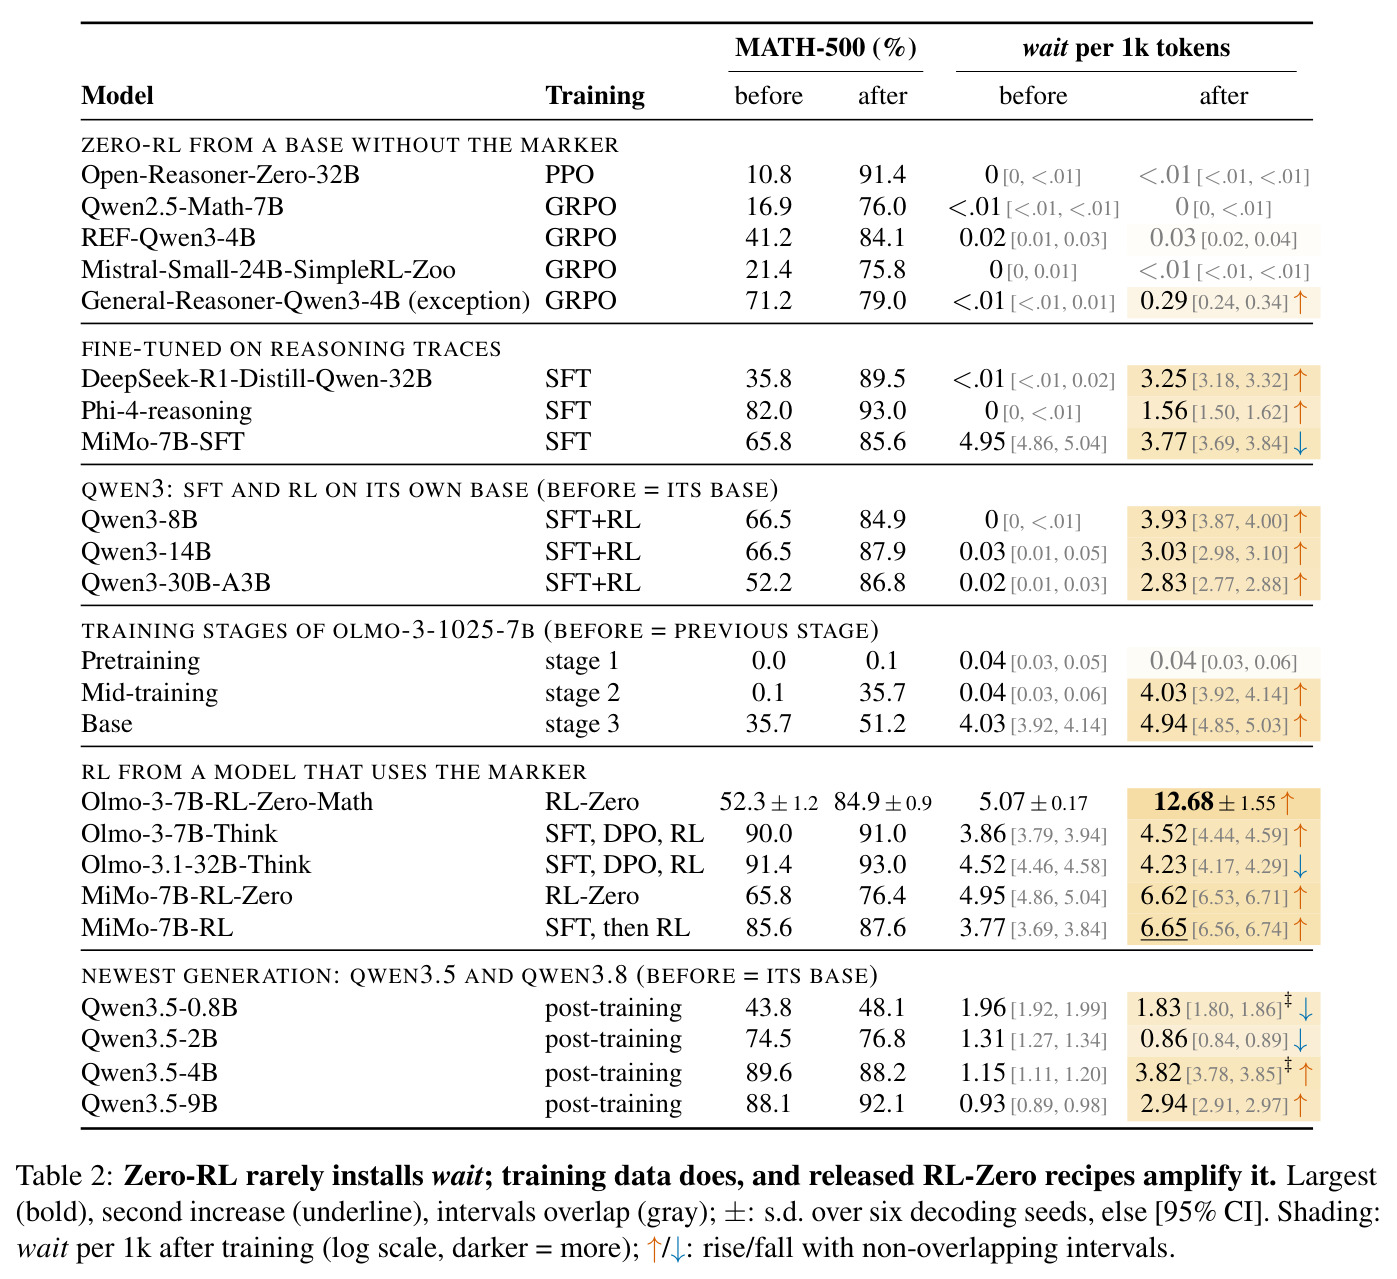
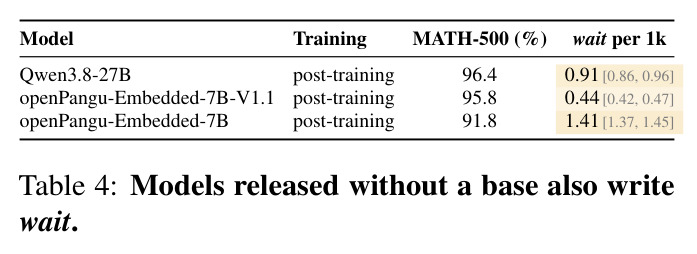
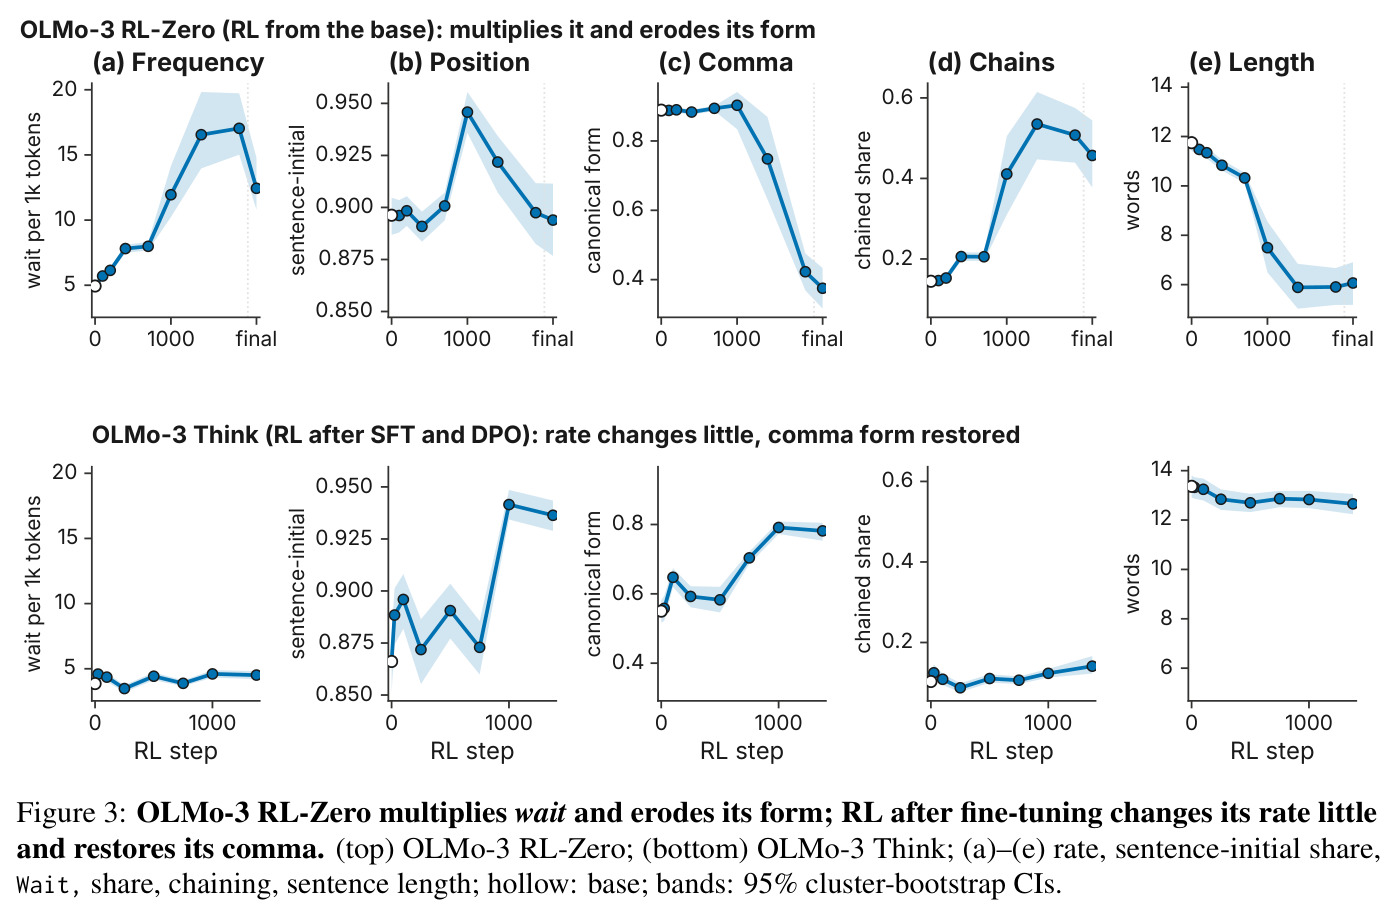
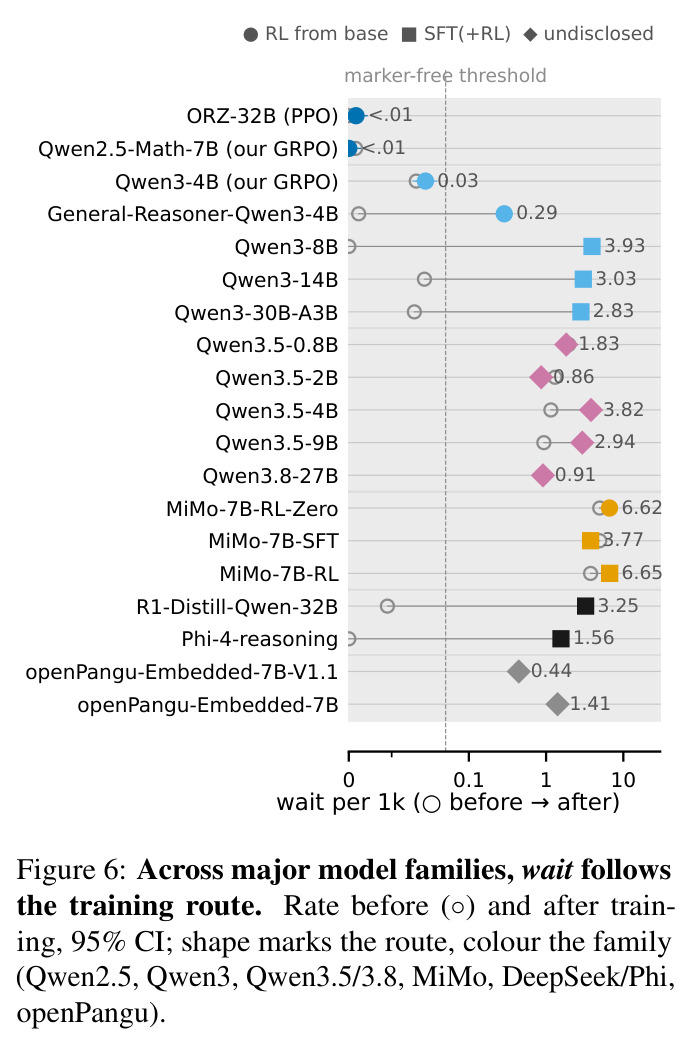
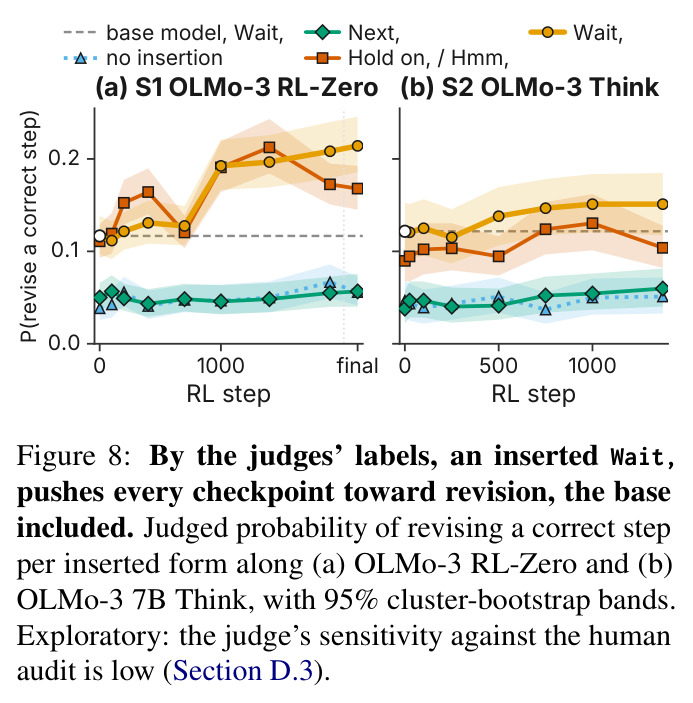
发现一:RL 几乎从不发明标记。18 个从无标记 base 出发的 zero-RL 运行中,MATH-500 准确率中位数提升 42.9 个百分点(Open-Reasoner-Zero-32B 从 10.8% 升至 91.4%;自家 GRPO 在 Qwen2.5-Math-7B 上从 16.9% 升至 76.0%、1.5B 达 74.4% 与 74.2%),但其中 17 个运行的 wait 频率 95% 置信上界低于 0.06/1k token——7B 运行的最终检查点在 306 万采样 token 中出现 0 次;唯一例外是 General-Reasoner-Qwen3-4B(0.29/1k,CI [0.24, 0.34])。发现二:训练数据供给标记。OLMo-3 的 wait 在预训练阶段 $\le 0.04$/1k,mid-training 后升至 4.03/1k(88.6% 句首);13/14 个在无标记 base 上用推理轨迹微调的模型采用了该标记(R1-Distill-Qwen-32B 3.25、QwQ-32B 4.42、Qwen3-8B 3.93、Phi-4-reasoning 1.56,中位数 3.54/1k),唯一例外 OpenReasoning-Nemotron-7B 用 but(98.3/1k)与 perhaps(28.1/1k)替代 wait(0.2/1k),说明标记形式随轨迹数据迁移。发现三:配方决定存留与形态。OLMo-3 RL-Zero 把标记从 4.9 乘到峰值 17.0/1k(step 1900,Holm 校正 $p<0.001$),六个解码种子下终值 12.68±1.55;同时形式磨损:规范 Wait, 形态从 88.9% 跌至 37.5%,链式 Wait, wait 从 117.6 升至 213.0 每千次出现,标记起始句从 11.8 词缩到 6.1 词,用法分布 JSD 达 0.05(噪声底 0.002)。而 OLMo-3 Think(RL 在 SFT+DPO 之后)频率几乎不变(3.9→4.5)并恢复逗号形态(55.0%→78.2%,$p=0.029$);自家 KL-free GRPO 从同一 base 出发不放大标记($A=0.81$–$0.97$,发布版为 1.58)。移植实验:SFT 植入 7.52/1k 后,400 步 GRPO 使 wait 归零(3,066,514 token 中 0 次),准确率从 41.0% 升至 77.6%,回答从 2,466 缩到 767 token,中性词 Next, 增长 4.83 倍;8,192 token+YaRN 长度对照下放大比 $A=0.0003$(CI [0.0001, 0.0006]),证明抹除的是标记本身而非长度副产物。发现四:警报更敏感也更宽松。RL-Zero 下任意反思标记的 $d'$ 从 0.57 升至 1.09(CI [0.97, 1.24])、$c$ 从 0.11 降至 $-0.24$;wait 单独看,命中错误前缀 73.7%(base 47.1%)但也在 25.4% 的无错前缀触发(base 19.9%)——标记没有漂白,而是变成了更灵敏但更爱报警的警报器;SFT 之后的 RL 几乎不动警报(32B:$c$ 从 $-0.2$ 到 $-0.05$,$d'$ 0.97→0.86)。发现五:LLM 裁判不可靠。60 句盲审计中主裁判与共识标签 $\kappa=0.64$,却把趋势反转(裁判的修正率从 26.0% 降到 12.9%,共识从 1.3% 升到 15.9%);第二裁判($\kappa=0.71$)追踪共识。发现六:预注册六条假设中三条被证伪、两条未运行,诚实显示语法化预测在 RL 上大多失效。
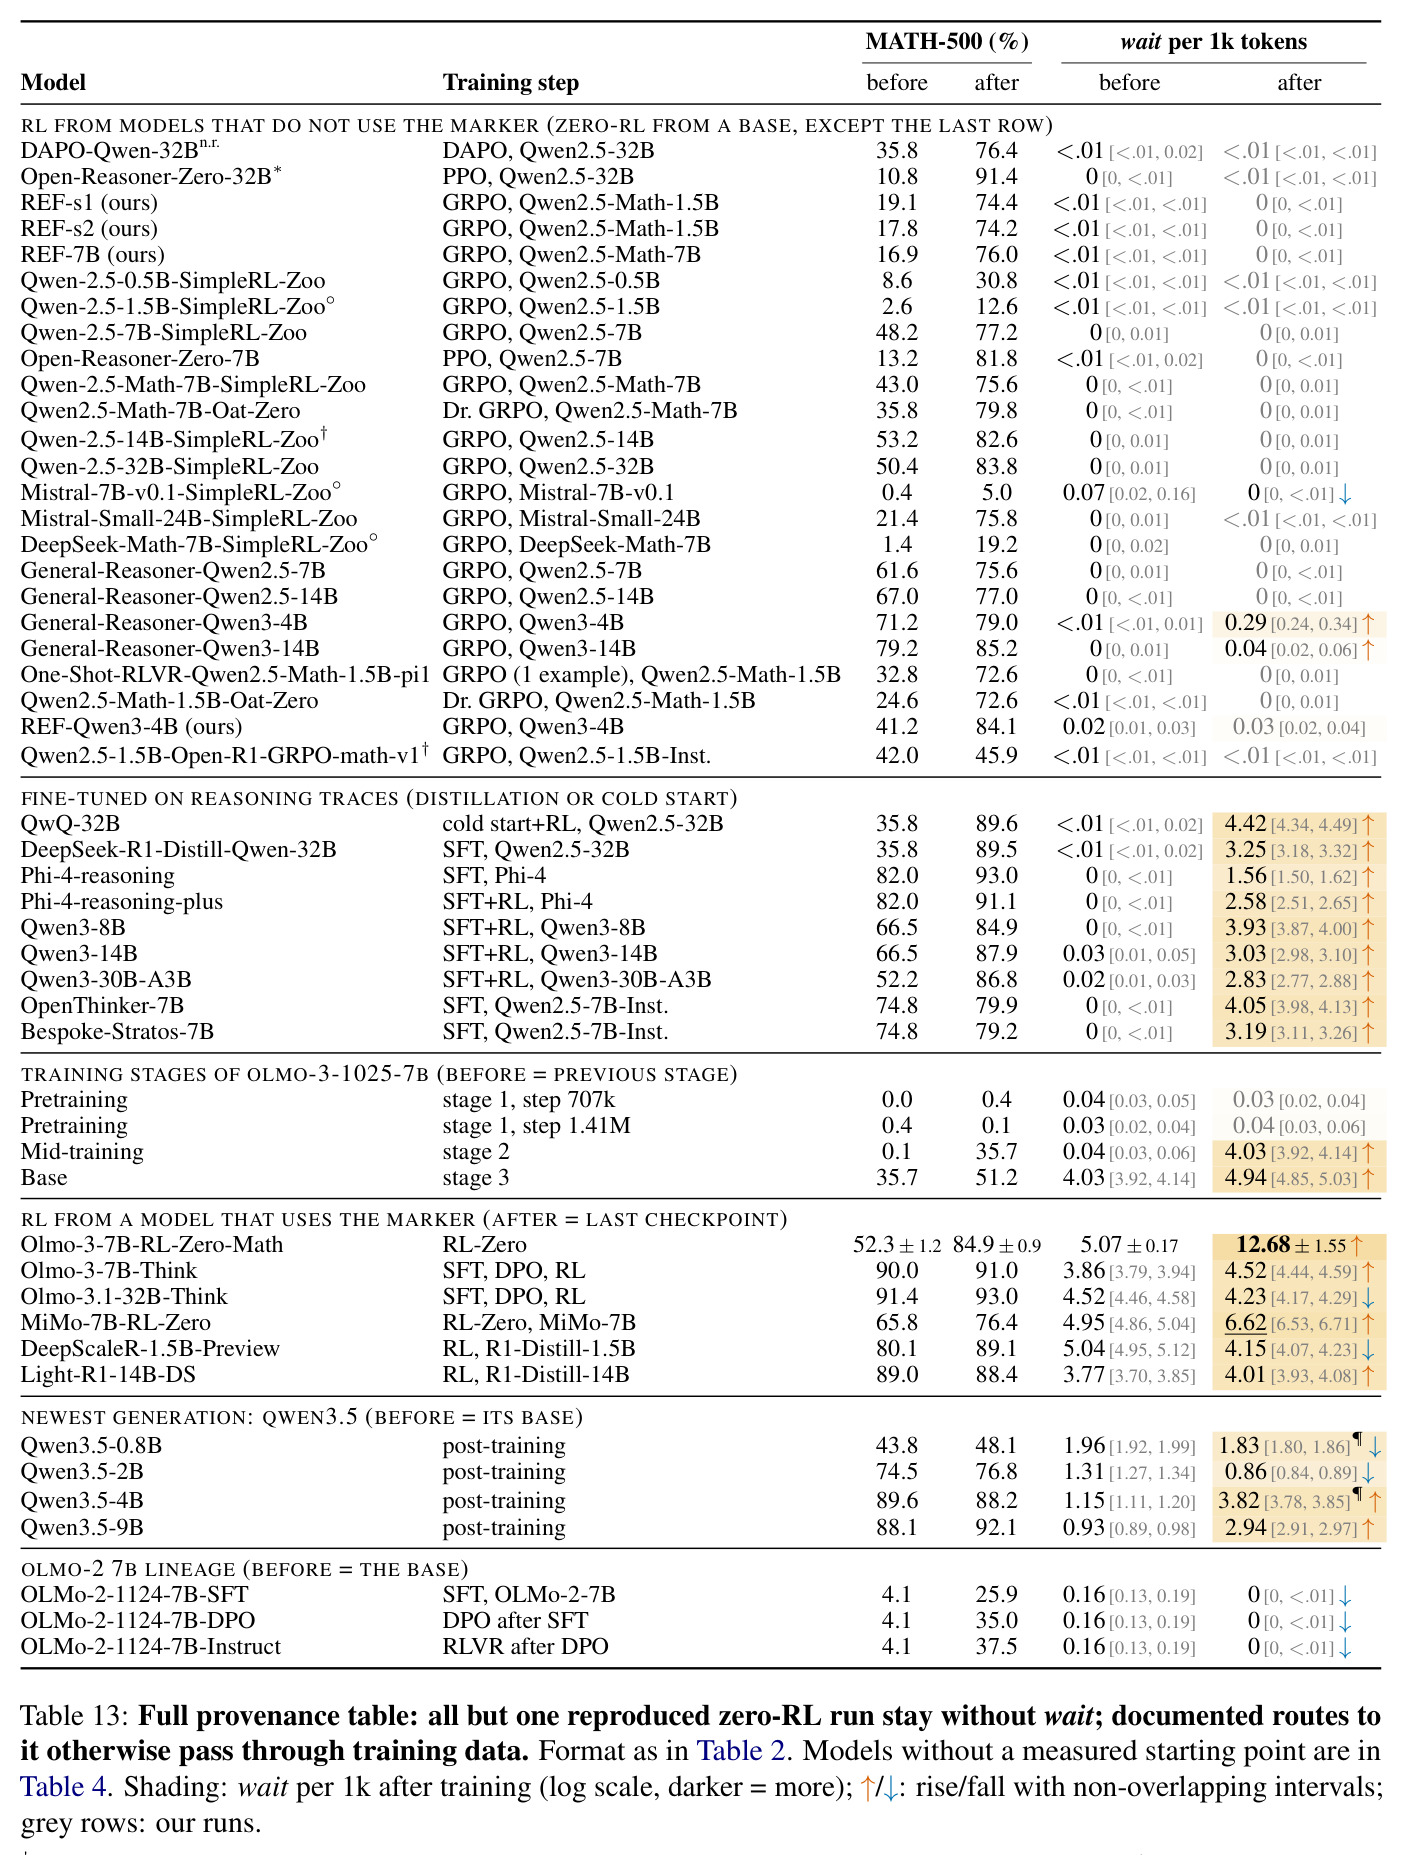
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MATH-500:从无标记 base 的 zero-RL(18 个运行) | 准确率提升中位数 / wait 频率 | 准确率中位数 +42.9 个百分点;17/18 运行 wait 95% 上界 <0.06/1k | 各 base 模型(ORZ-32B 10.8%、Qwen2.5-Math-7B 16.9%、Mistral-Small-24B 21.4%) | ORZ-32B +80.6、7B GRPO +59.1 个百分点,且标记保持缺席(median 0/1k) |
| MATH-500:OLMo-3 谱系逐阶段 | wait 每 1k token / 准确率 | 预训练 0.04 → mid-training 4.03 → base 4.94 → RL-Zero 12.68±1.55(峰值 17.0) | RL 之前的上一阶段 | 进入时点在 mid-training(+3.99/1k),RL-Zero 再放大约 2.6 倍;准确率 0.1→51.2→84.9% |
| MATH-500:在无标记 base 上用推理轨迹微调(14 个模型) | wait 采用率 | 13/14 模型 $\ge 0.5$/1k(中位数 3.54;R1-Distill-Llama-8B 4.8、QwQ-32B 4.42) | 无标记 base(<0.05/1k) | 从无到有,证明训练数据即可安装标记 |
| MATH-500:移植实验(SFT 植入 + 400 步 GRPO) | wait 频率 / 准确率 | wait 7.52 → 0 次(306 万 token);准确率 41.0% → 77.6% | SFT 后检查点(7.52/1k,41.0%) | 标记被配方完全抹除的同时准确率 +36.6 个百分点,增益不需要标记 |
| 注入错误警报测试(OLMo-3 RL-Zero) | 敏感度 d′ / 判断标准 c | 任意标记 $d'$ 0.57→1.09(CI [0.97, 1.24]),$c$ 0.11→−0.24;wait 命中 73.7%、虚警 25.4% | base 检查点(wait 命中 47.1%、虚警 19.9%) | 更敏感且更宽松:报错能力上升但无错也频繁拉响警报 |
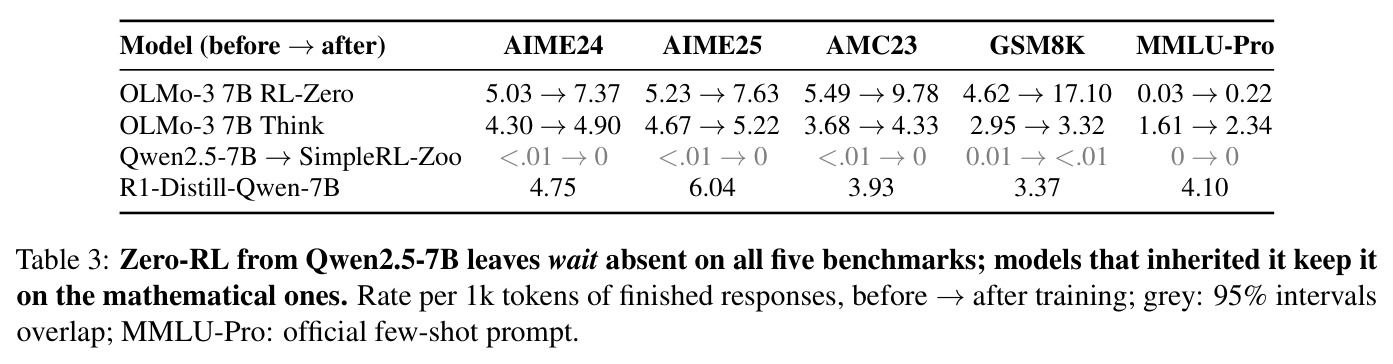
| AIME24/25、AMC23、GSM8K、MMLU-Pro(每 1k token 的 wait) | 标记频率 before→after | OLMo-3 RL-Zero 在 GSM8K 4.62→17.10、AIME24 5.03→7.37;MMLU-Pro 官方 few-shot 下仅 0.03→0.22 | Qwen2.5-7B→SimpleRL-Zoo 在五个基准全部 ≤0.01/1k | 继承者跨数学基准保留并放大标记,无标记者的 zero-RL 在所有基准保持缺席 |
局限与改进
作者承认的局限:溯源证据是观察性的,被比较的谱系在数据与配方两个维度同时不同,无法把变异归因于单一因素;zero-RL 结论依赖 Qwen2.5、Mistral、Qwen3 base 上的 18 次运行,且每个开源检查点序列只是单次训练运行,区间只覆盖评估采样方差而非训练方差;所有 RL 运行限于 0.5B–32B、结果奖励、英文数学——前沿规模 RL、其他领域、其他语言与过程奖励均未测试;测量捕捉的是词汇形式而非底层反思行为,模型可以不写 wait 而反思,清单外的标记形式会逃逸检测;盲审计是小样本共识标签(60 句、十位博士级标注者讨论定案),无独立双标注、未报告标注者间一致性,因此只作描述性用途,头版结论建立在无标签指标上。我的补充观察:其一,0.05/1k 的“近乎缺席”阈值与 D47a 复现门槛直接决定“1/18 例外”的计数,General-Reasoner 例外(0.29/1k)的机制未被解释;其二,警报实验只注入单一算术错误,“报错信号”的覆盖面有限,概念性错误与幻觉未测;其三,六条预注册假设中 H5(KL 与长度惩罚的驱动作用)与 H6(监控精度衰减)根本未运行,两个核心机制问题留空;其四,移植实验只有 512 与 64 两种种子剂量且都被抹除,无法刻画剂量—存留关系;其五,wait 频率对解码设置极端敏感(temperature 0.6 下最终检查点 76.5 次/1k 对 T=1.0 的 5.1),跨论文比较计数时极易被模板与解码差异误导。
独立分析的弱点
独立分析的弱点:第一,观察性溯源无法完全排除“标记潜在于 base”的假设——作者自己就用“latent”解释 Qwen3-14B(base 0.03/1k、RL 后 3.03/1k),而 Qwen3 报告只笼统提到中训练提高了 STEM/推理/合成数据占比,语料不公开使定年只能到“阶段”而不到“样本”;改进方向是对预训练语料做有针对性的 n-gram 审计,或构造只差推理数据的配对预训练运行。第二,标记清单是人为起点:Nemotron 用 but/perhaps 说明范式可以整体替换,固定清单会系统性漏检;改进方向是用 JSD 用法漂移做数据驱动的漂移词发现,先找词再套指标。第三,警报实验的单一算术错误注入使 $d'/c$ 只对“数值错误检测”这一种语义有效;改进方向是注入推理跳跃、单位错误、幻觉引用等多类错误,分别估计敏感度。第四,多数序列只有单种子,作者承认无法区分 base 与配方的贡献(Qwen3-4B GRPO 单种子例外即模糊);改进方向是关键配方至少三种子,报告种子间方差。第五,每题 2–8 的采样预算使稀有事件区间较宽,且 29.1% 回答触顶截断的运行(T=0.6 下)会混淆长度与频率;改进方向是扩大采样并对截断率分层报告。第六,全部结论限于英文数学:将溯源地图扩展到代码、科学问答与多语言,是检验“数据播种、配方改塑”普遍性的必要步骤。
未来方向
作者提出的方向:任何“aha moment”式报告都应注明 base 是否已写该标记及其频率;监控者必须在被读的具体检查点上校准标记读数——论文注册的“Calibrated Wait”干预(D50,在低熵步后屏蔽标记)未通过自己的判据,更好的按检查点校准机制仍待设计;标记的“源数据”与“配方”各自的角色(source vs recipe)依然开放。基于本文成果可延伸的研究:一是把溯源地图推广到前沿规模 RL、过程奖励、多语言与代码/科学推理域,检验结论的尺度与领域普适性;二是用激活修补等可解释性手段直接检验“标记→动作”的算子因果链,弥补 H4 插入试验只能得到不确定结论的缺口;三是建立数据驱动的反思标记词典发现流程,追踪标记形式在蒸馏谱系间的迁移(Nemotron 的 but/perhaps 已给出线索);四是把警报测试产品化为在线监控器:为每个检查点估计 $d'$ 与 $c$ 并动态调整阈值,以应对 Baker et al. (2025) 提出的标记类混淆攻击;五是系统比较其他配方(DPO、蒸馏、budget forcing、结构化推理模板)对标记存留的影响,把“配方决定存留”扩展成一张配方—标记相图;六是检验下游代价——更宽松的警报意味着更多无谓的重查 token,可研究按检查点校准能否同时省推理长度并保监控精度。
复现评估
复现条件相当好。代码、120 端点的溯源地图、无标签指标套件、注入错误协议与三个专家共识盲审计都在匿名仓库(anonymous.4open.science/r/wait-provenance)以 CC-BY-4.0 发布,预注册文件(DECISIONS.md,D50–D51)与每个假设的证伪条件一并公开;所有模型 checkpoints 与数据均为公开发布,遵守各自许可(个别 gated base 仅未使用)。分析层面的复现门槛很低:指标与警报测试只需要采样输出和标记形式清单,不需要模型内部访问,也不需要训练算力,在消费级硬件上数天内即可对 120 个端点重算全部指数。若要复现训练部分:自家 GRPO 在 Qwen2.5-Math-1.5B(两种子)与 7B、移植实验(512 条种子轨迹 SFT + 400 步 GRPO,3,072/8,192 token 上限与 YaRN 对照)属 1.5B–7B 级 RL,单机多卡可行;OLMo-3 谱系、32B 级运行与各发布模型直接加载公开检查点即可。主要注意点:必须对齐评估模板与解码设置——论文显示 Open-Reasoner-Zero 的 base 在其自家模板下仅 10.8%,且 wait 频率随 temperature 剧烈变化(0.6 时 76.5/1k 对 1.0 时 5.1/1k),不控制这些因素会得出完全不同的计数。总体难度:分析复现容易,训练复现中等。
论文图表
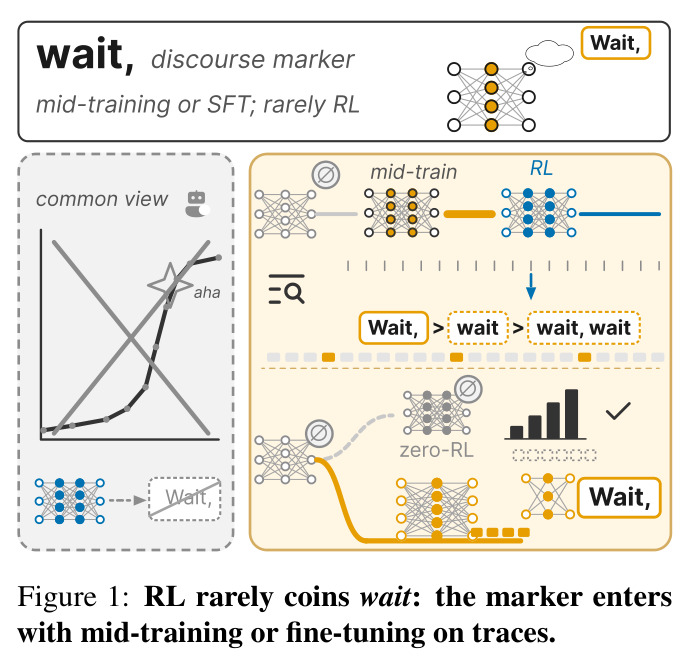
全文概览图:左上指出常见观点(wait 来自 mid-training 或 SFT、极少来自 RL),中间以 OLMo-3 为例展示 RL 后 wait 用法的膨胀与形态变化(Wait, > wait > wait, wait),下方对比 zero-RL 与训练数据两条路径:无标记 base 经 zero-RL 后 wait 保持缺席(∅),而 mid-training/轨迹微调会安装标记。
一张图浓缩了论文的核心论点“继承而非发明”,读者先看它即可把握全文的问题、结论与证据结构。