SplatLab:面向 3DGS 研究的自主科学发现系统 SplatLab: Autonomous Scientific Discovery for 3DGS Research
多智能体系统在 3DGS 子领域端到端自主复现、扩展并写论文,每个数字可溯源到训练日志
前置知识
3D Gaussian Splatting (3DGS)
3DGS 用数十万到数百万个各向异性高斯基元显式表示场景,每个高斯带位置、协方差、不透明度和球谐系数,通过可微光栅化(splatting)直接优化参数来拟合并实时渲染新视角。训练涉及致密化(分裂/克隆高斯)、周期性不透明度重置、剪枝等调度策略,这些机制的超参交互使复现对工程细节极其敏感,也正是 3DGS 论文常见的改进切入点。
SplatLab 的整个底座、九个 EVOLVE-BLOCK 钩子(致密化、正则、损失、渲染、剪枝、初始化、调度、不透明度、球谐)以及全部实验指标都构建在 3DGS 之上,不理解 3DGS 训练机制就无法理解系统变异的是什么。
Nerfstudio 插件与 SPLATIFY/NERFIFY
Nerfstudio 是模块化神经渲染框架,具体方法以插件(如 splatfacto)形式接入统一的 ns-train 训练入口。SPLATIFY/NERFIFY 是能把已发表论文自动转换成 Nerfstudio 插件、并验证其指标匹配论文头条数字的系统:NERFIFY 处理 NeRF 论文,SPLATIFY 用上下文无关文法在模块化模板上提供九个可组合的扩展钩子,产出的代码与专家手写实现相当。
SplatLab 的核心前提是「已验证复现骨干」:所有候选改进都变异这些已通过验证的插件,这是其每个数字可溯源、每个增益有固定参照的根基。
Elo 等级分与锦标赛选择
Elo 源自国际象棋评级:对局后按预期胜率 $E_i = 1/(1+10^{(R_j-R_i)/400})$ 与实际结果 $S_i$ 之差更新 $R_i \leftarrow R_i + K(S_i - E_i)$,赢家涨分、输家扣分。用锦标赛而非标量 fitness 排序候选,可以对无法通约的方案做两两比较,是进化搜索中常用的选择机制;初始分通常设为 1200,$K$ 控制更新步长。
SplatLab 把想法预排序(Stage 2)和 GPU 实验排序(Stage 4)都建成 Elo 锦标赛,并发明了级联加权 $w_s$ 与按 (B, L) 评估上下文条件化两个变体,是其选择机制的核心。
LLM 程序进化与 EVOLVE-BLOCK
FunSearch、AlphaEvolve 一类系统让 LLM 反复变异代码、由评估器打分、保留精英,形成程序进化循环。EVOLVE-BLOCK 是成对代码注释标记出的可修改区域:agent 只能改块内代码,块外的已验证实现保持冻结,从而把开放式搜索约束在结构化 diff 空间内,防止 LLM 重写整个代码库引入回归。
SplatLab 的变异空间(九钩子上的 EVOLVE-BLOCK)、八岛并行锦标赛与五种变异算子直接继承这条路线,论文明确以 AlphaEvolve 的标记机制为基础但改为作用于已验证插件。
PSNR / SSIM / LPIPS
新视角合成的三个标准指标:PSNR 基于逐像素 MSE 的对数量度(单位 dB,越高越好);SSIM 衡量结构相似性(0 到 1,越高越好);LPIPS 用深度网络特征距离逼近人类感知差异(越低越好)。3DGS 论文通常在 Mip-NeRF 360(九个无界场景)、LLFF(前向真实场景)等基准上报告,训练 30k 迭代是社区惯例。
SplatLab 的锦标赛裁判、证伪器攻击和 claim 绑定全部以这些实测指标为准,论文所有结论都用 dB 增益表述;理解指标含义才能判断 +0.18 dB 属于边缘、+3.78 dB 属于实质突破。
研究动机
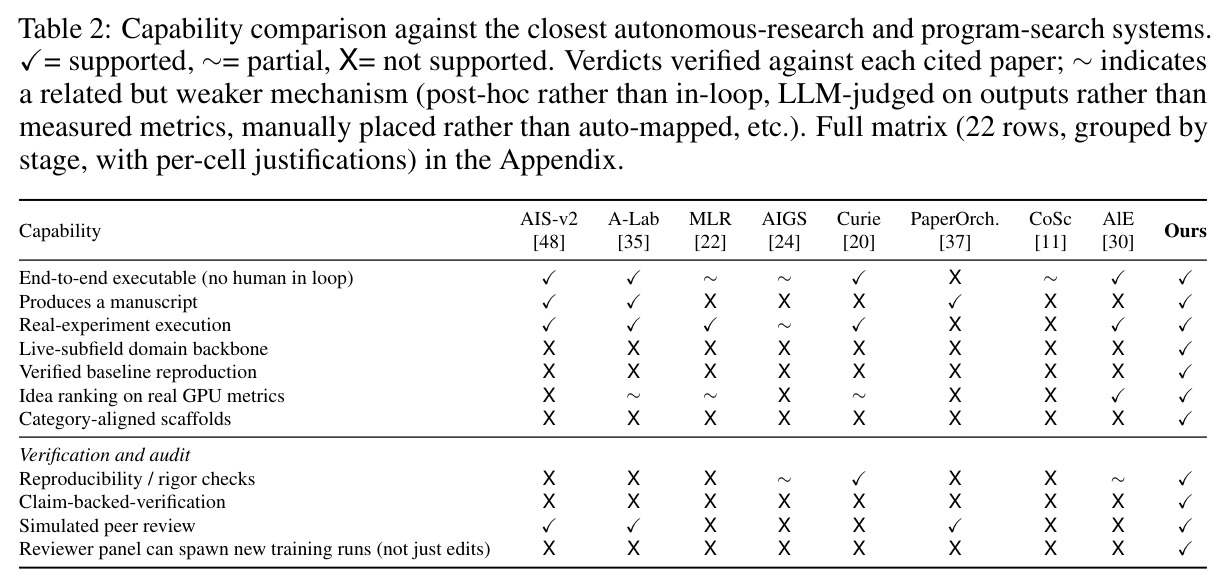
在 3D 高斯泼溅这样活跃的视觉子领域里,复现一篇已发表论文往往需要数周的专家工程——要正确处理致密化调度、不透明度重置、球谐激活和视角相关外观,而这些细节不会出现在通用编码 agent 收到的 prompt 里。实测数据相当残酷:PaperBench 显示,面对 20 篇 ICML 2024 Spotlight/Oral 论文,被评测的最强 agent 平均复现率仅 21.0%;在 30 篇 3DGS 论文复现基准上,当前前沿模型的成功率只有约 5%。此前的自主科研系统(AI Scientist v2、Agent Laboratory、AI Co-Scientist 等)要么在短 LaTeX 模板上编辑文字,要么对自由文本假设排序而不执行训练循环,要么建立在未经外部验证的 LLM 重实现之上:报告的指标可能无法追溯到磁盘上的真实测量,长时运行的 agent 随上下文膨胀而偏离目标,比较基线含糊不清。论文把四个共性缺口总结为:领域框架、已验证基线、全循环精炼、claim-to-log 绑定——且没有任何系统在活跃的计算机视觉子领域中被端到端演示过。
本文的目标是本文的目标是构建并端到端演示一个面向 3DGS 子领域的自主科研系统 SplatLab:给定一行研究 prompt、一个目标论文 URL,甚至完全不给输入($x = \varnothing$,由系统自行从文献中选题),它都能完成完整科研循环——复现已发表基线、提出扩展、在 Mip-NeRF 360 与 LLFF 上训练并消融、撰写论文手稿,并把手稿中的每一个报告数字绑定到磁盘上留有日志的训练运行。系统输出被形式化为 $P = (P_{tex}, P_{pdf}, L, C)$,其中 $P_{tex}$ 是 LaTeX 源码,$P_{pdf}$ 是编译 PDF,$L$ 把源码中每个数字映射到训练运行,$C$ 是产生这些数字的代码库。成功标准有二:一是生成的每篇手稿都要在 PSNR 上击败其复现目标(实测提升 +0.18 到 +3.78 dB);二是把「读、复现、扩展、训练、消融、写作」的科研周期从研究生的数月压缩到数天的自主算力。
与已有工作不同的是,本文的独特切入是「先收窄、再做强」:不试图提升通用 agent 的编程能力,而是论证自主科研的瓶颈在于缺少领域专用研究栈。作者选择单一活跃子领域 3DGS,先构建已验证的复现骨干——NERFIFY 把 NeRF 论文转成匹配专家代码的 Nerfstudio 插件,SPLATIFY 用上下文无关文法把该构造扩展到 3DGS 的九个可组合扩展钩子。任何进入实验阶段的候选都必须变异一个已被验证能编译、训练并达到目标论文头条指标的插件,从而让每个改进声明都有固定的外部参照,增益才能归因于所提机制而非重实现漂移。在此之上再叠加:结构化修改空间(七类 3DGS 新颖性类别包裹的 EVOLVE-BLOCK 标记,配跨代码库自动映射器)、真实 GPU PSNR 上的级联加权 Elo 排序、与选择耦合的运行中证伪器、以及封住幻觉通道的 claim-to-log 绑定。这与此前「在未验证的 agent 重实现上做无约束发现」的路线形成本质对照。
核心方法
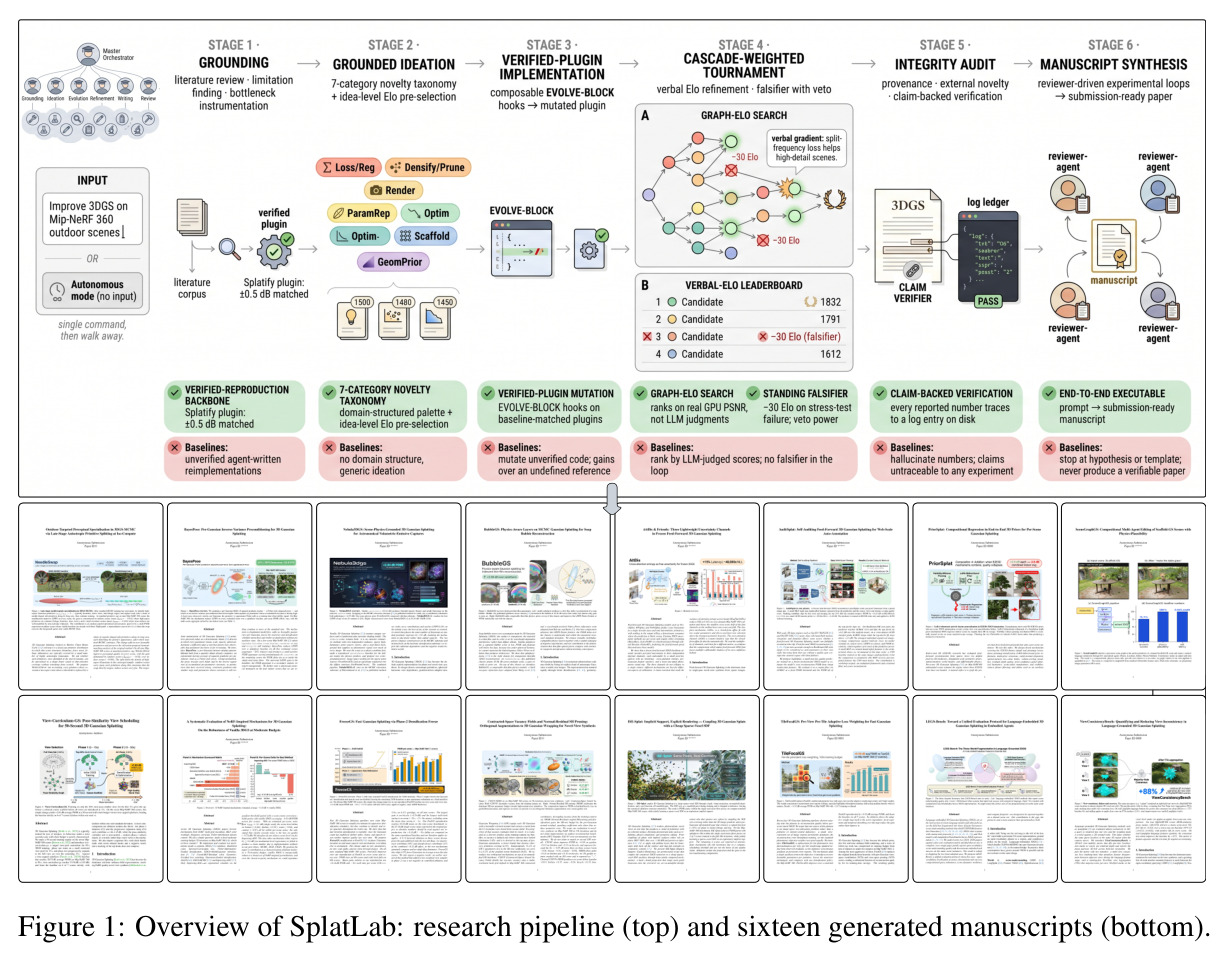
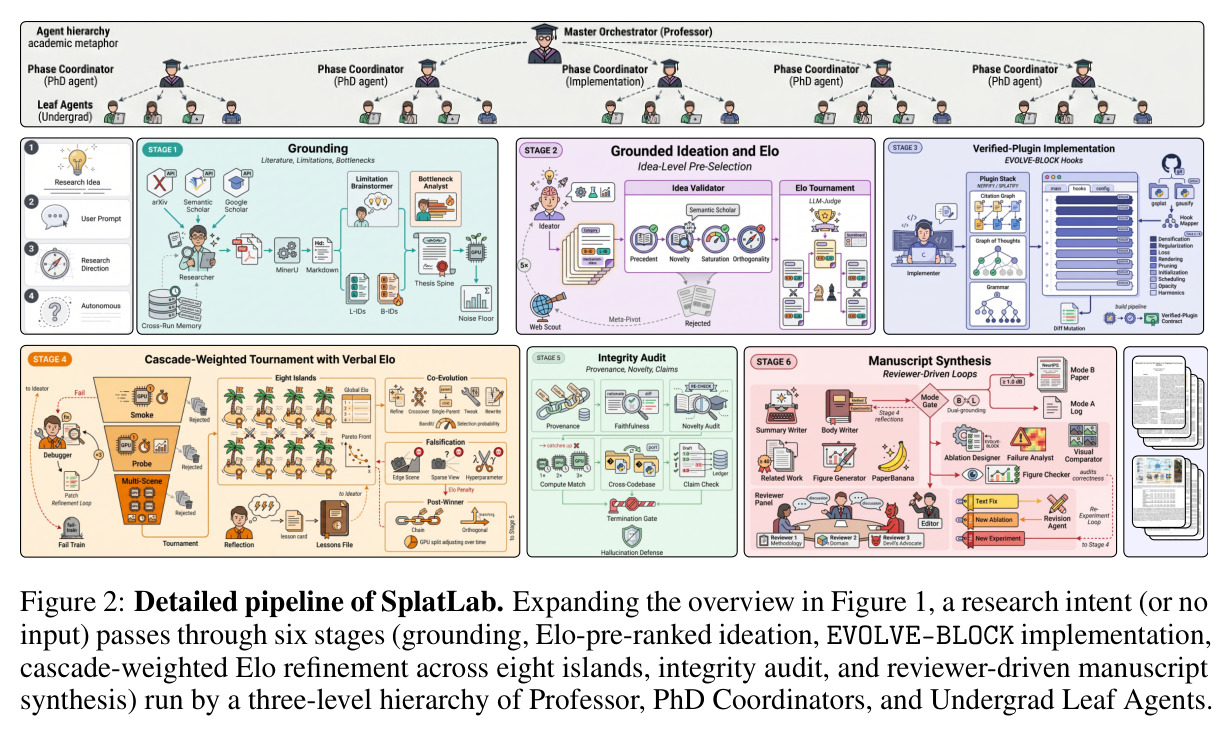
直觉上,SplatLab 把科研想象成「在一个可信底座上的受控进化」:底座是已验证的 3DGS 复现插件,进化的是围绕九个钩子的代码 diff,裁判是真实 GPU 上的 PSNR,书记员把每个数字记入实验账本。技术上,系统由 36 个 agent 组成的三层层级(Professor、PhD 协调者、Undergrad 叶子 agent)驱动六个阶段,且没有固定 DAG:master 可在证伪器否决、审计失败或审稿人要求补实验时回退到任意早期阶段。形式化地,给定输入 $x$(prompt、URL 或空),系统返回 $P = W(x; D)$,其中固定上下文 $D = (R, B, H, G)$ 包含 3DGS 文献语料 $R$、SPLATIFY 骨干 $B$、九个 EVOLVE-BLOCK 钩子 $H$ 和目标会议模板 $G$。六个阶段依次为:Grounding(文献阅读 + 底座瓶颈测量)、Grounded ideation(想法级 Elo 预排序)、Verified-plugin implementation(EVOLVE-BLOCK 变异)、Cascade-weighted tournament(八岛 Elo 锦标赛)、Integrity audit(六项完整性审计)与 Manuscript synthesis(审稿驱动的写作,可回流重做实验)。
核心创新是五项设计决策的组合,每一项都针对已有系统的具体失败模式。(i) 真实 GPU 指标上的接地 Elo:与 AI Co-Scientist 用模型打分排自由文本假设不同,SplatLab 在测得的 PSNR 上做级联加权、按 $(B, L)$(基准ID,缺陷ID)对条件化的 Elo 排序,并把 ReEvo 式「语言梯度」(LLM 对胜负原因的反省)回灌给 ideator 而非启发式变异器。(ii) 运行中证伪器:扩展 AIGS 的事后 FalsificationAgent 为常驻组件,每次攻击失败扣除 $\delta = 30$ Elo,把压力测试存活变成选择信号而非事后检查。(iii) Claim-backed 验证:每个进入草稿的数字必须绑定到有日志的实验,只要存在无据声明运行就不能终止——此前所有管道均无此绑定。(iv) 已验证复现骨干:所有候选变异 SPLATIFY 插件而非 agent 重写的代码,为每个报告增益提供固定参照。(v) 领域对齐修改空间:七类 3DGS 分类法 + 跨代码库自动映射器,使系统的 diff 空间与领域研究者的真实修改空间重合。
方法步骤详情
Stage 1 Grounding:文献路(arXiv/Semantic Scholar/Google Scholar 检索 + MinerU 解析 + 跨运行 RAG 论文库)由 Limitation Brainstormer 产出缺陷串 L-ID(如 L-127:不透明度重置破坏后期精炼稳定性),底座路(Bottleneck Analyst 剖析每 tile 损失、PSNR 轨迹、显存、梯度范数)产出瓶颈串 B-ID(如 B-04:garden 场景 25.65 dB 平台期),合成唯一脊柱 $\Gamma$。Stage 2:候选为五元组(机制、类别 $c \in \{1,\dots,7,\mathrm{open}\}$、L-ID、B-ID、预测增益 $\hat{\Delta}$),经 Precedent/Novelty(Tweak Trap 拦截纯调参)/Saturation/Orthogonality 四道检查后进入初始 1200 分的想法级 Elo 括号赛。Stage 3:Hook Mapper 把类别解析为九钩子子集并放置 EVOLVE-BLOCK,Implementer 在引用图、Graph of Thoughts 与 SPLATIFY 文法约束下生成结构化 diff,编译加 100 迭代冒烟测试通过才算履约。Stage 4:候选走 smoke(100 迭代)→probe(单场景全迭代)→多场景→全基准四级评估,Elo 按 $R_i \leftarrow R_i + K \cdot w_s \cdot (S_i - E_i)$ 更新($K = 32$,$w_s \in \{0.2, 0.5, 1.0\}$),幸存者分入八岛由多臂老虎机在 Refine/Crossover/Single-Parent/Tweak/Rewrite 五算子间选择变异,常驻证伪器沿边缘场景、稀疏视角、超参扰动三轴攻击(每次失败 $-30$ Elo)。Stage 5:六项审计(Provenance 内容哈希链、Faithfulness、Novelty、Compute match、跨代码库移植、Claim check)任一失败即终止为研究日志。Stage 6:五位写手并行成稿,三个审稿 agent(Methodology、Domain、Devil's Advocate)在 Editor 下可要求新训练运行回流 Stage 3–4,直到无人提出 New-Experiment 关切才终止。
技术新颖性
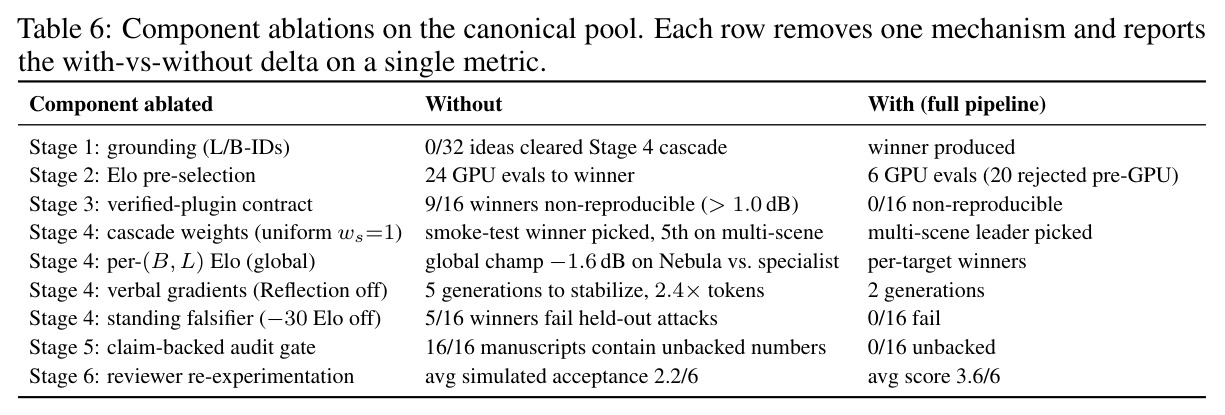
技术新颖性体现在四处「换轨」。第一,选择信号的物理层不同:FunSearch/AlphaEvolve 用标量 fitness 对个体排序,SplatLab 用按评估上下文 $(B, L)$ 条件化的 Elo 矩阵,且更新按级联深度 $w_s$ 加权,使 100 迭代冒烟赛的胜利不可能淹没多场景赛的失败——消融显示均匀权重会把冒烟赛冠军(多场景仅第 5 名)误选为赢家。第二,证伪从「事后附录」变成「选择压力」:$\delta = 30$ 的 Elo 罚分让抗攻击性直接参与繁殖决策,关闭了 5/16 冠军会败给 held-out 攻击的通道。第三,审稿从「终点」变成「闸门」:评审 panel 可派生新训练运行回流实验阶段,而非仅修改文字。第四,写作与测量的绑定是结构性而非提示性的:content-hash 链把数字锁到 (experiment ID, commit, config) 三元组,compute-match 审计把计算混淆的增益重分类,跨库移植审计标记代码库特定的增益。与 ReEvo 的区别是把语言梯度从变异器改道给 ideator;与 AI Co-Scientist 的区别是只给编译并训练过的插件发奖牌,不给自由文本假设发。
实验结果
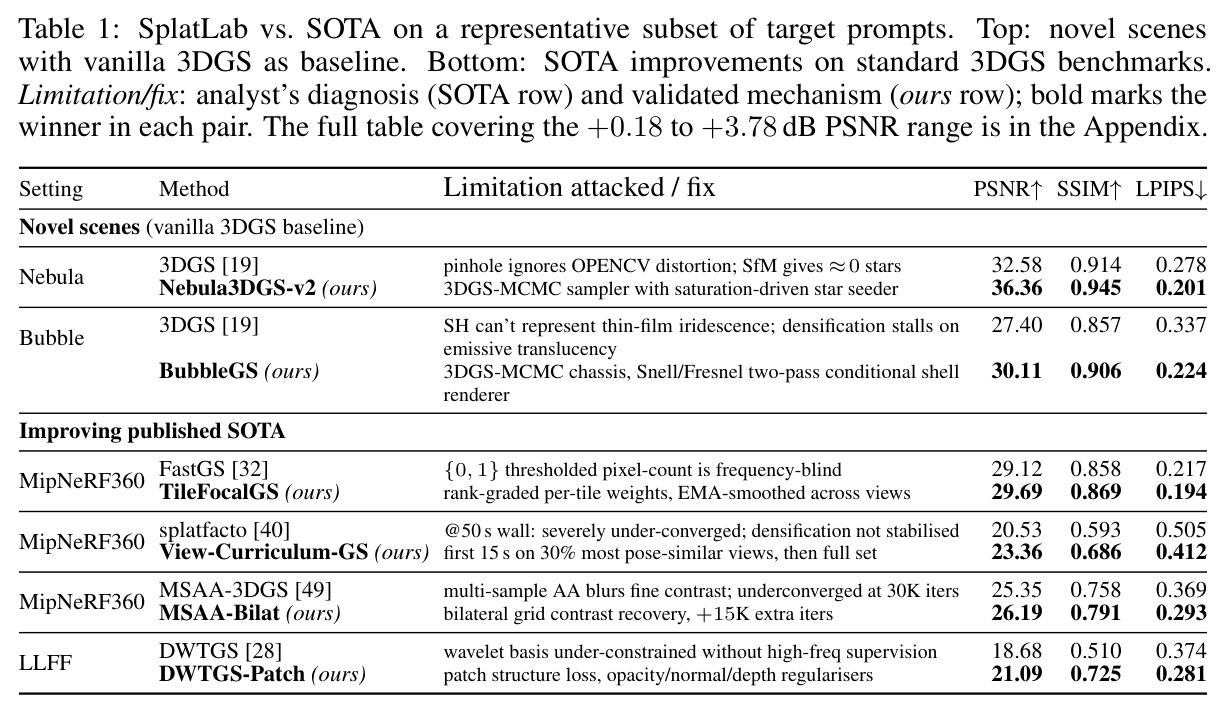
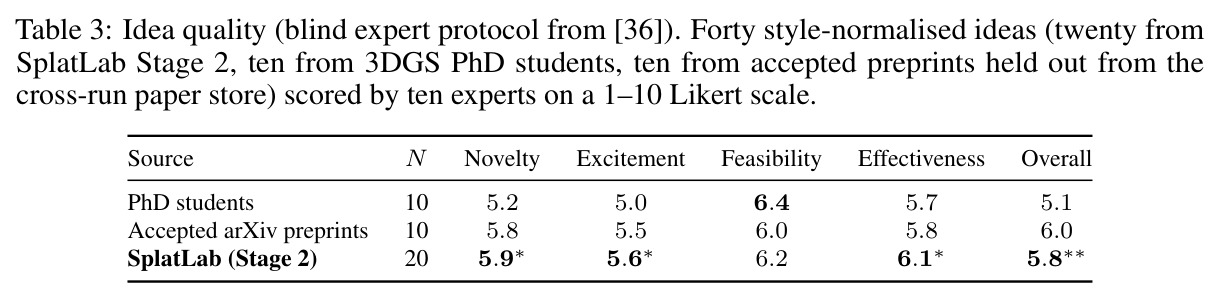
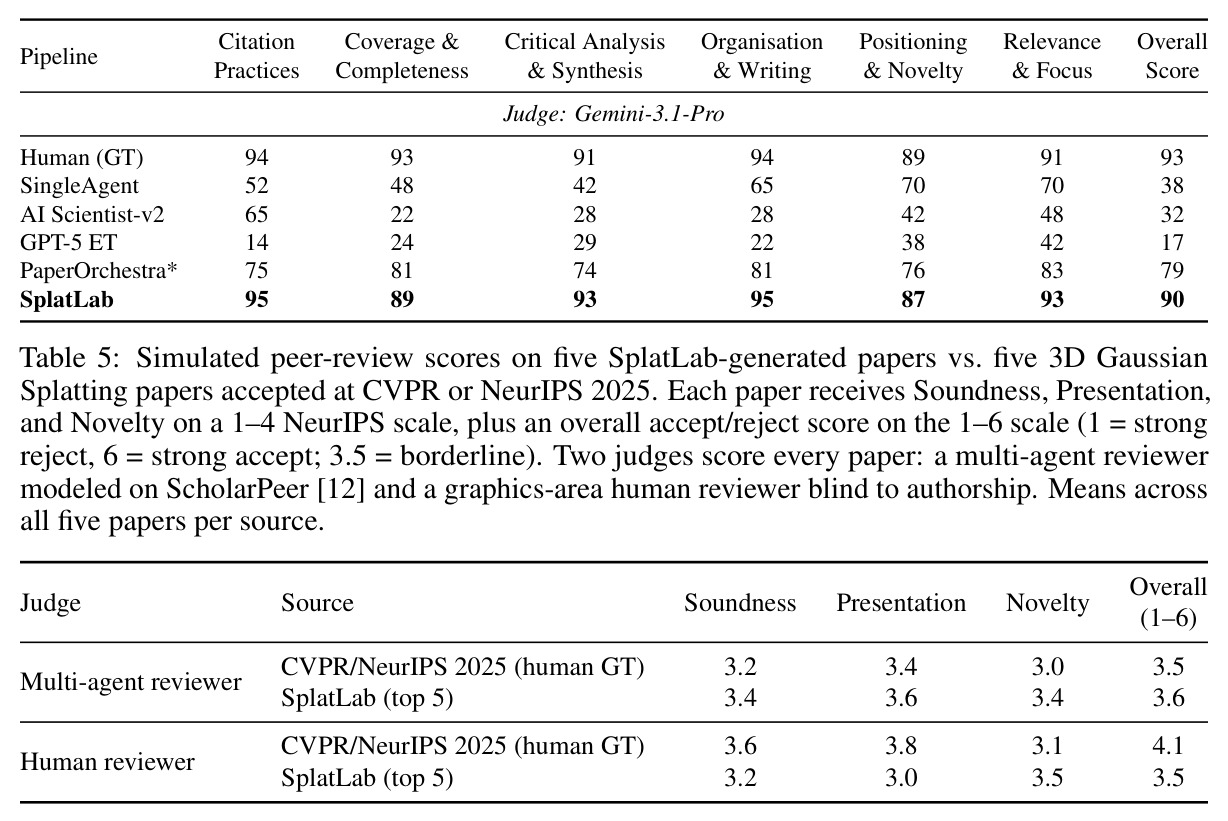
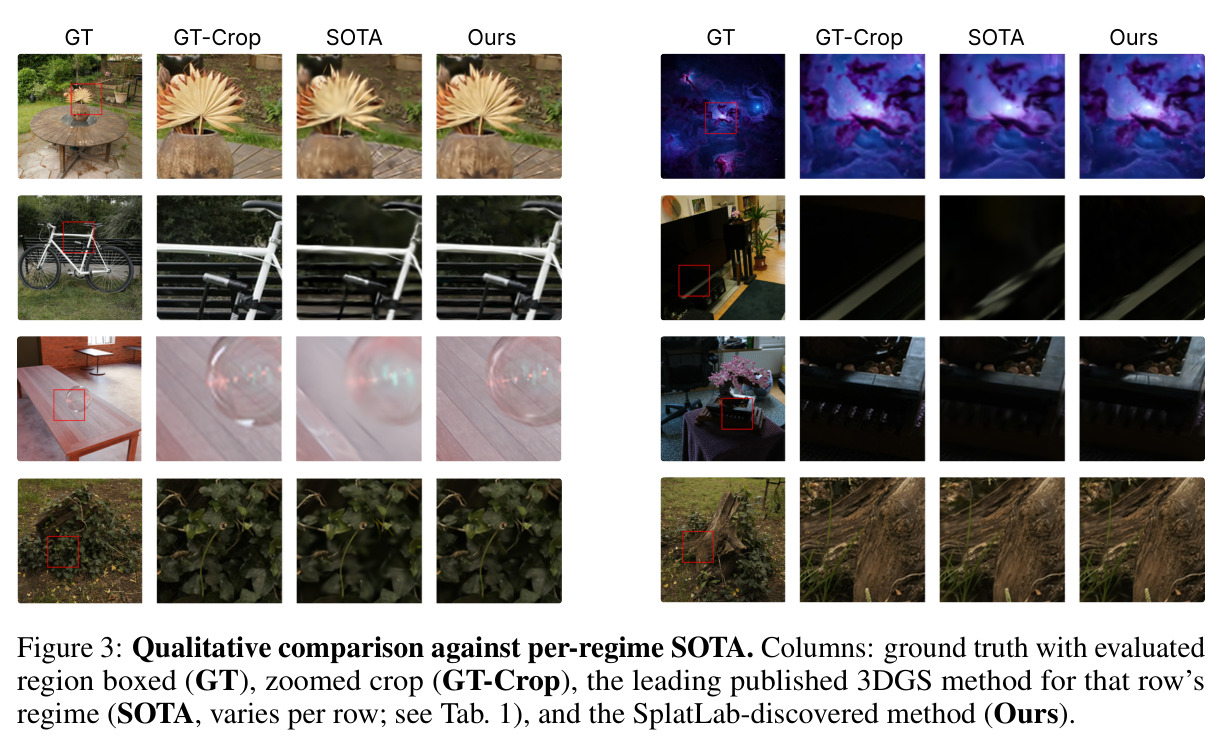
16 次运行共训练 198 个实验分支:5 个经验证阳性、5 个带限定声明的边缘结果、5 个非 PSNR 贡献、1 个记录在案的失败,且无一需要在派发后手工改码。方法对比(Table 1/Figure 3):星云场景上 Nebula3DGS-v2 把 vanilla 3DGS 从 32.58 提至 36.36 dB(+3.78 dB,SSIM 0.914→0.945,LPIPS 0.278→0.201),是 3DGS 首次涉足天文摄影域;BubbleGS 在 bubble 上 +2.71 dB(27.40→30.11);对已发表 SOTA 的改进:TileFocalGS 超 FastGS +0.57 dB(29.12→29.69),View-Curriculum-GS 在 50 秒墙钟设定下超 splatfacto +2.83 dB(20.53→23.36),MSAA-Bilat 超 MSAA-3DGS +0.84 dB(25.35→26.19),DWTGS-Patch 在 LLFF 超 DWTGS +2.41 dB(18.68→21.09)。GNS-AA 五种子重跑得 +0.23±0.09 dB,与原报告 +0.18 dB 一致,噪声内的改进被降级为边缘声明。想法盲测(Table 3):SplatLab 总体 5.8/10,高于 PhD 生 5.1,新颖性 5.9 为三组最高。手稿质量(Table 4):LLM 评审 90/100,接近人类论文的 93,远超 AI Scientist-v2 的 32 与 PaperOrchestra 的 79,人类复核与 LLM 判分一致性 $\rho = 0.87$。模拟评审(Table 5):多智能体评审给 SplatLab 3.6/6 略高于 CVPR/NeurIPS 2025 论文的 3.5/6;人类评审给已发表 4.1(clear accept)、SplatLab 3.5(borderline)——SplatLab 新颖性 3.5 反超 3.1,但 soundness 3.2 与 presentation 3.0 落后于 3.6/3.8。三篇手稿(AttDis & Friends、NeedleSwap、AuditSplat)被 CVPR 2026 workshop 接收为海报。消融(Table 6):去掉 claim 审计门 16/16 篇含无据数字(全管道 0/16);去掉证伪器 5/16 冠军败于 held-out 攻击;去掉 Elo 预选 GPU 评估从 6 次涨至 24 次;去掉审稿再实验环节模拟接受分从 3.6/6 跌至 2.2/6。成本:每 run 24–48 小时墙钟、约 113M API tokens、1000–1500 次 LLM 调用、2–36 GPU 小时、$150–250。分类法消融:去掉七类分类法后星云仍 +3.45 dB(vs +3.78),但 token 从 47.5M 涨到 85.5M(+80%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 天文摄影星云场景新视角合成(OOD) | PSNR (dB)↑ | Nebula3DGS-v2: 36.36(SSIM 0.945, LPIPS 0.201) | vanilla 3DGS: 32.58(SSIM 0.914, LPIPS 0.278) | +3.78 dB |
| Bubble 薄膜泡泡场景新视角合成(OOD) | PSNR (dB)↑ | BubbleGS: 30.11(SSIM 0.906, LPIPS 0.224) | vanilla 3DGS: 27.40(SSIM 0.857, LPIPS 0.337) | +2.71 dB |
| Mip-NeRF 360 频率自适应致密化 | PSNR (dB)↑ | TileFocalGS: 29.69(SSIM 0.869, LPIPS 0.194) | FastGS: 29.12(SSIM 0.858, LPIPS 0.217) | +0.57 dB |
| Mip-NeRF 360 50 秒墙钟欠训练设定 | PSNR (dB)↑ | View-Curriculum-GS: 23.36(SSIM 0.686, LPIPS 0.412) | splatfacto: 20.53(SSIM 0.593, LPIPS 0.505) | +2.83 dB |
| Mip-NeRF 360 抗锯齿渲染 | PSNR (dB)↑ | MSAA-Bilat: 26.19(SSIM 0.791, LPIPS 0.293) | MSAA-3DGS: 25.35(SSIM 0.758, LPIPS 0.369) | +0.84 dB |
| LLFF 稀疏视角小波 3DGS | PSNR (dB)↑ | DWTGS-Patch: 21.09(SSIM 0.725, LPIPS 0.281) | DWTGS: 18.68(SSIM 0.510, LPIPS 0.374) | +2.41 dB |
| 多种子鲁棒性(GNS-AA,5 seeds) | PSNR 增量 (dB) | +0.23 ± 0.09(GNS 25.95±0.07 vs GNS-AA 26.18±0.05) | 原单种子报告 +0.18 | 结论一致,噪声内增益如实降级为边缘声明 |
| 手稿写作质量(5 prompts 配对协议) | Multi-agent judge 总分(0–100) | SplatLab: 90 | 人类论文 93;PaperOrchestra 79;AI Scientist-v2 32;GPT-5 ET 17 | 较最强基线 +11 分,逼近人类水平 |
局限与改进
作者承认的局限有三:一是实验设计证明的是「端到端能力」而非等化搜索预算,各 run 的 GPU 预算差异很大(2–36 小时),没有做预算对齐的公平比较;二是七类分类法是领域特定的,迁移到新领域需要专家努力,跨域只在星云目标上做了单点对照(+3.78 vs +3.45 dB),3DGS 之外的运行仅以禁用 Stage 2 的形式放进附录;三是更广影响部分自我点出:验证骨干的每领域建造成本会把能力偏向预先工程化的子领域和资源充足的实验室,且审计若出 bug 反而可能掩盖幻觉。我补充几点观察:16 个 run 只产出 5 个经验证阳性(约 31% 命中率),探索效率仍然不高;人类评审显示生成论文的 soundness(3.2 vs 3.6)与 presentation(3.0 vs 3.8)明显落后,说明数字可溯源不等于论证与写作严密;两个评审(多智能体 3.6 vs 人类 3.5,且对已发表论文给出 3.5 vs 4.1 的分歧)方向相反,暴露了 LLM 评审对 AI 生成内容的固有偏好,Table 4 的 90 分绝对值需谨慎解读;最后,全部定量证据集中于渲染指标,对「科学发现」广度的衡量有限。
独立分析的弱点
独立看有几个结构性弱点。其一,单领域依赖:整个设计的杠杆来自 SPLATIFY/NERFIFY 预先建好的验证骨干,这意味着复制的最大成本不在算力而在每领域一次性的复现工程——换到分割、检测等其他子领域需要重新设计钩子分类法与底座,论文对此只以附录一笔带过;改进方向是研究骨干构建本身的部分自动化。其二,指标单一性:锦标赛与晋级几乎全押在 PSNR 上,虽有 Tweak Trap 过滤纯调参想法,但以单指标为 fitness 的进化仍有 Goodhart 风险;八岛的 Pareto front 只作用于 $(B, L)$ 维度,可引入速度、显存、鲁棒性等多目标选择。其三,评审环节的 LLM 偏差未被系统内校准:人类评审与多智能体评审结论分歧,系统自身无法发现这一点,可在 Stage 6 加入人类评审锚定样本。其四,5/16 的阳性率意味着大量 GPU 小时花在被淘汰分支上,改进方向是把 Stage 2 想法级 Elo 与早期 B-ID 测量更强耦合以提前剪枝,或引入 bandit 化的预算分配。其五,多种子验证只对 GNS-AA 一个方法做了 5 种子,其余改进多为 3–4 种子甚至单种子,+0.18 dB 量级的边际增益统计功效不足。
未来方向
作者在正文与结论中指向的方向包括:把七类分类法自动化或跨领域迁移(附录已含 3DGS 之外、禁用 Stage 2 的附加运行);建立社区规范——要求 AI 生成投稿显式标注并随附实验账本、劝阻批量投稿;以及把 Mode A 研究日志用于教育,训练假设形成、调试与证据批判能力。基于其成果可自然延伸的:第一,把验证骨干的建设本身自动化——让系统在观察大量复现失败模式后自动归纳钩子分类法,降低「每领域一次专家工程」的门槛;第二,多目标进化:把延迟、显存、跨设备泛化纳入 Elo 之外的评价轴,搜索效率-质量 Pareto 前沿;第三,统计严谨性升级:把强制多种子与配对显著性检验作为 Stage 5 审计项,覆盖所有边际增益;第四,跨 run 累积学习:跨运行论文库已单调增长,可进一步把 B-ID/L-ID 与成败案例训练成领域先验模型,提高 31% 的阳性命中率;第五,开放「发现空间地图」:用八岛 Elo 分布与 (B, L) 前沿可视化 3DGS 设计空间,反向指导人类研究者选题与定位未开垦区域。
复现评估
复现条件相当友好。系统、全部 16 篇手稿、实验账本与跨运行论文库开源在 seemandhar.github.io/splatlab;硬件只需 NVIDIA A6000(单卡即可),每 run 的 GPU 消耗 2–36 小时、24–48 小时墙钟预算;LLM 侧约 113M API tokens、1000–1500 次调用、$150–250 成本,一次完整复现的边际成本在数百美元量级。数据全部公开:Mip-NeRF 360 与 LLFF 是标准基准(每 8 帧留一测试、30k 迭代遵循既有协议),三个 OOD 场景(nebula/bubble/diamond)为作者自采并随系统发布。主要不确定性在于 LLM 栈的具体版本与 prompt 工程细节(论文称在附录),以及进化搜索的随机性——同配置多次运行可能选出不同赢家,复现者应关注账本与日志而非仅最终数字。总体难度评估:有 3DGS 训练经验的研究者复现单次 run 约 1–2 天,从零重建整套多智能体编排约需数周;若只想验证 Table 1 的某一配对,直接用发布的插件与账本重跑 30k 迭代即可,门槛很低。
论文图表
七个子维度(引用规范 95、覆盖完整性 89、批判分析 93、组织写作 95、定位新颖性 87、相关性聚焦 93、总分 90):SplatLab 全面领先所有基线,仅次于人类论文的 93;人类评审与 LLM 判分一致性 Spearman ρ=0.87、加权 κ=0.84,54/60 条评分依据被确认有文本支持。
写作质量是「论文产出」这一硬指标的量化:90 vs 人类 93 vs 最强基线 79,说明在给足接地材料后系统写作接近人类水平,且差距集中在定位与新颖性。