Foundation4D:面向自动驾驶的统一感知与三维重建基础模型 Foundation4D: Towards a unified perception and reconstruction model for autonomous vehicles
单一前馈模型统一深度估计、3D检测、语义占用与高斯重建,自预测位姿支撑视频级场景重建
前置知识
VGGT 与前馈 3D 几何重建
VGGT(Visual Geometry Grounded Transformer)是视觉几何基础模型:输入任意多张图像,一次前向传播即可联合回归相机内外参、深度图与点图(pointmap,即每个像素在公共坐标系下的 3D 坐标),无需传统 SfM 的逐场景迭代优化。「前馈」指推理只做一次网络前向,而非对每个新场景做优化。本文沿用 VGGT 的 DINOv2 ViT-L 编码器、DPT 解码头与相机/寄存器 token 设计,并加入 16 层时空聚合器。
Foundation4D 的骨架、token 机制与几何头全部继承自 VGGT,论文的消融基线也是改造后的 VGGT,不懂它就读不懂架构演进的链条。
3D 高斯泼溅(3DGS)
用各向异性 3D 高斯基元显式表示场景:每个高斯有中心 $\mu$、协方差 $\Sigma = R\,\mathrm{diag}(s^2)R^\top$(由尺度与旋转四元数构造)、不透明度和颜色,通过可微泼溅沿视线累积渲染出新视角图像。相比 NeRF 的隐式场,3DGS 渲染快且基元显式可编辑。本文高斯分支对每个源像素预测一个高斯,并按 Instant NuRec 的分层表示组织为静态高斯 + 演员绑定高斯 + 天空 cubemap。
本文第四个输出头就是可渲染的 3D Gaussians,理解高斯参数化与可微泼溅是读懂第 3.7 节方法和高斯重建实验的前提。
语义占用预测(Semantic Occupancy)
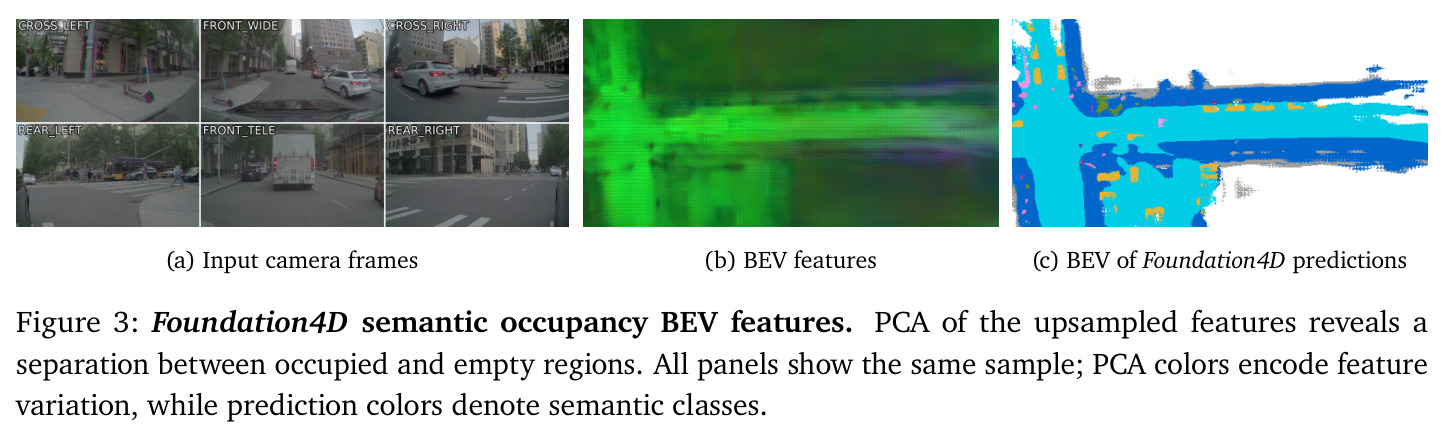
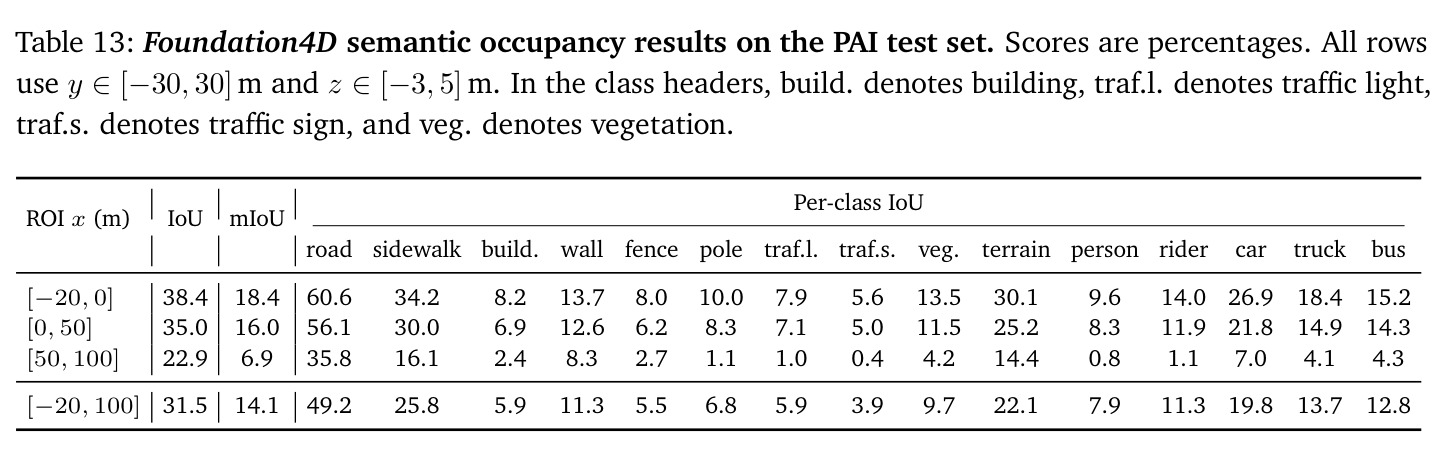
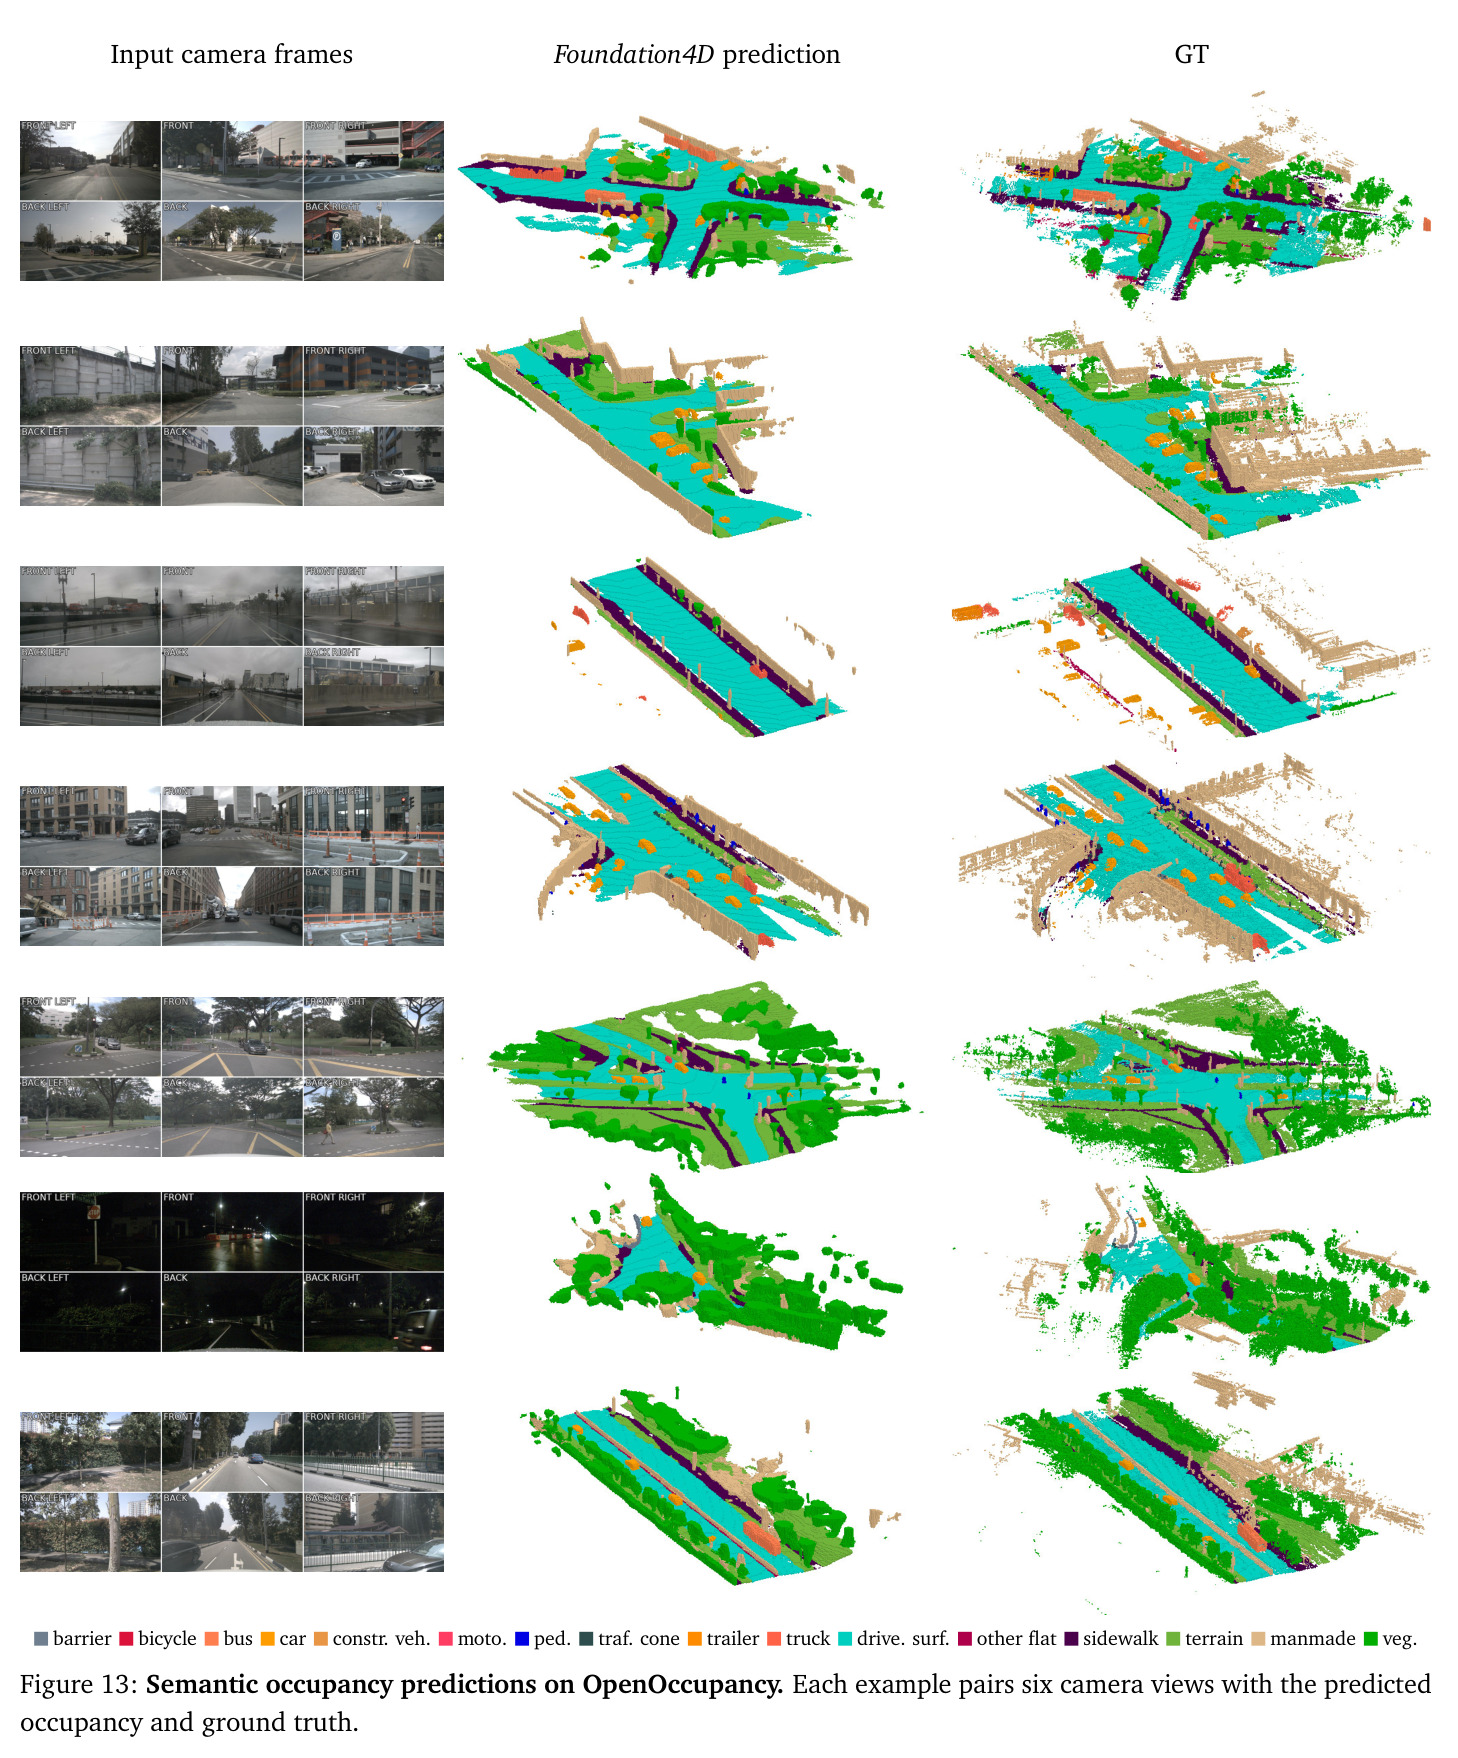
在以自车为中心的体素网格上预测每个体素是否被占据及其语义类别,要求补全可见表面之外的几何(遮挡补全),常用指标为 IoU 与逐类 mIoU。本文在 $[-20,100]\times[-30,30]\times[-3,5]$ m 范围以 0.2 m 分辨率输出,中间特征压缩为 BEV(鸟瞰)以控制显存。
占用是统一模型的三大感知任务之一,其 BEV 中间表征与体素头的设计直接决定多任务统一是否在显存上可行,也是 OpenOccupancy/PAI 评测的对象。
BEV(鸟瞰图)表示
把多相机图像特征投影聚合到自车坐标系俯视网格 $F_{BEV}\in\mathbb{R}^{V_x\times V_y\times C}$ 上的表征方式,是驾驶感知的主流中间表示。投影手段有 LSS(深度分布外积)、BEVFormer 式注意力与 Deformable DETR 式可变形采样等。本文占用分支用 Deformable DETR 启发的 BEV 投影:每个 BEV 格沿垂直支柱取 4 个参考点做可变形交叉注意力。
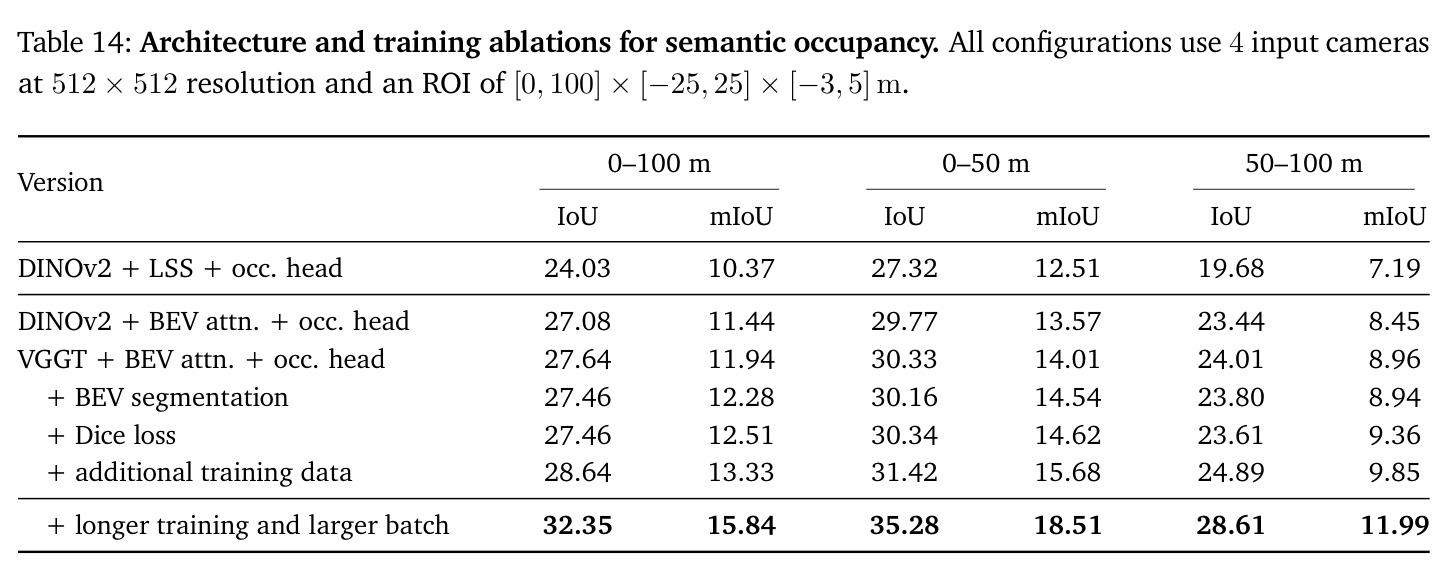
论文消融证明 BEV deformable attention 替代 LSS 使 IoU 从 24.03 提升到 27.08,是该头的关键设计;理解 BEV 才能理解占用分支为何省显存。
位姿图优化(PGO)与 Sim(3) 对齐
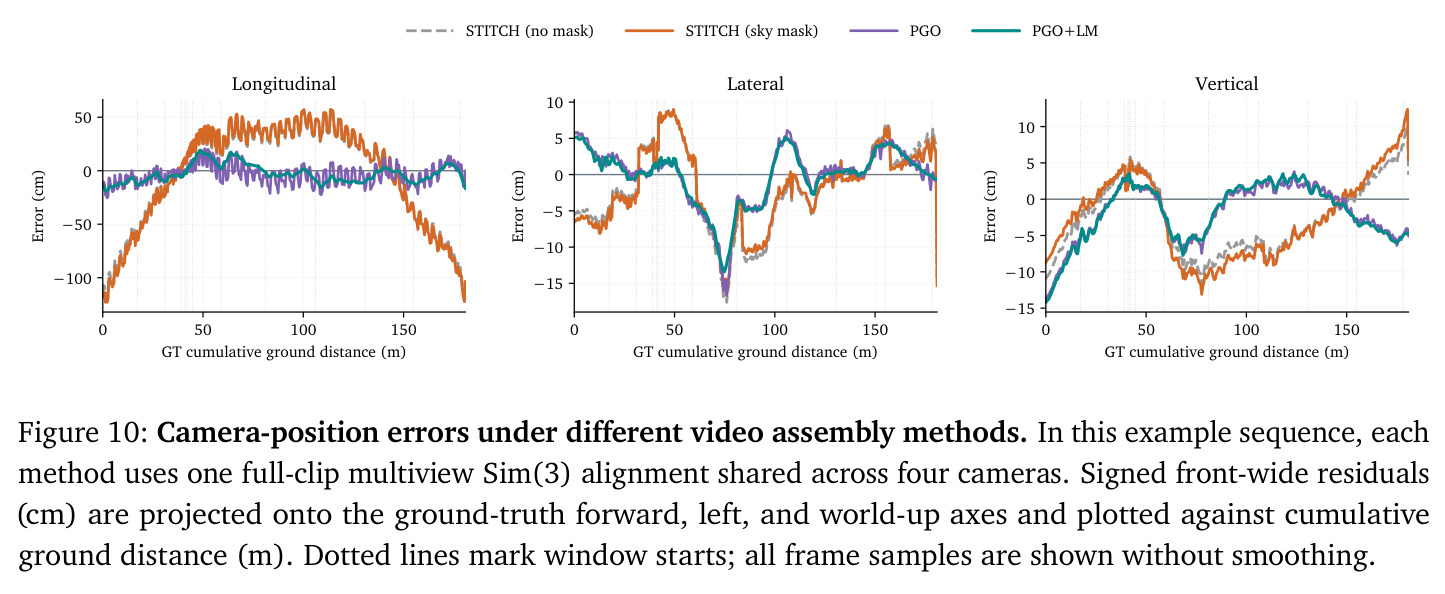
把相机位姿作为图节点、窗口内预测的相对位姿作为边因子,通过最小二乘 $\min\sum \omega_{ij}\|\log(R_i^\top R_j R_{ij}^{(k)})\|^2$ 联合求解全局一致轨迹;平移固定旋转后是线性最小二乘。Sim(3) 则是带尺度因子的相似变换,常用于把预测几何对齐到真值坐标系做评测。本文 PGO 在 SE(3) 上求解(固定度量尺度),并加入线性运动先验平滑速度。
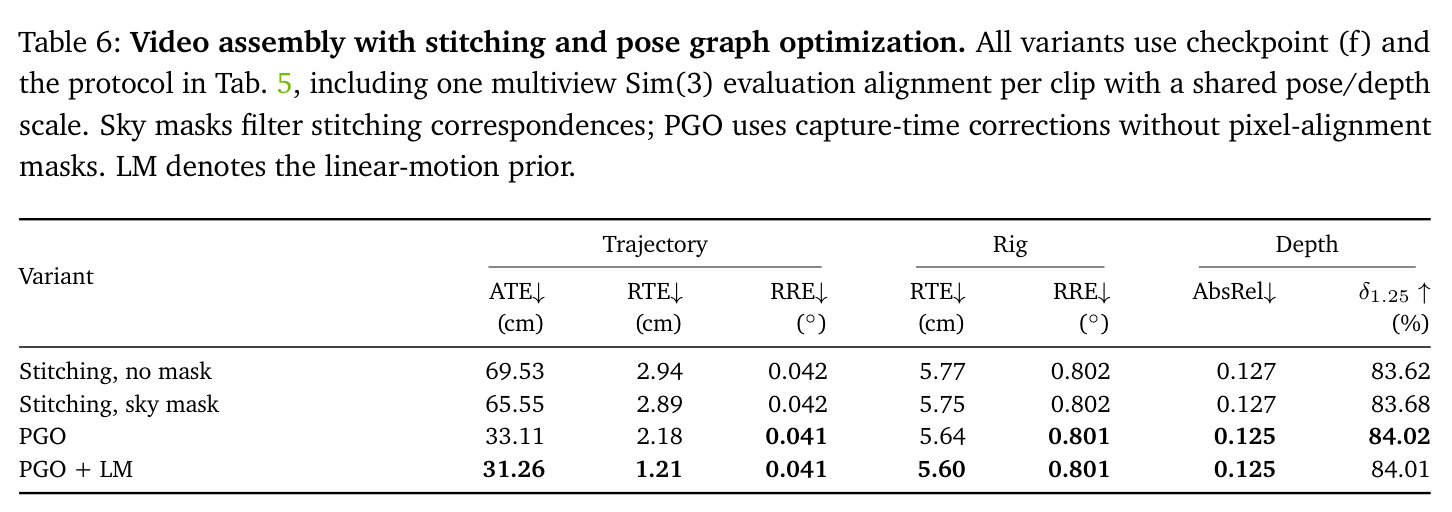
视频级推理是本文三大贡献之一,PGO+运动先验把轨迹 ATE 从 65.55 cm 降到 31.26 cm,是理解长视频组装机制的必备知识。
查询式 3D 检测(DETR3D/PETR 系)
以 DETR 为原型:用一组稀疏「物体查询」向量,经自注意力与从多视角图像采样的可变形交叉注意力迭代精炼,最后每个查询回归类别与 3D 包围盒(中心、尺寸、朝向、速度),训练时用匈牙利匹配做一对一分配、无需 NMS。本文检测头用 900 个锚定在可学习 3D 参考点上的查询、6 层宽 256 的解码器,并加 DN-DETR 式查询去噪与辅助 YOLOX 2D 头。
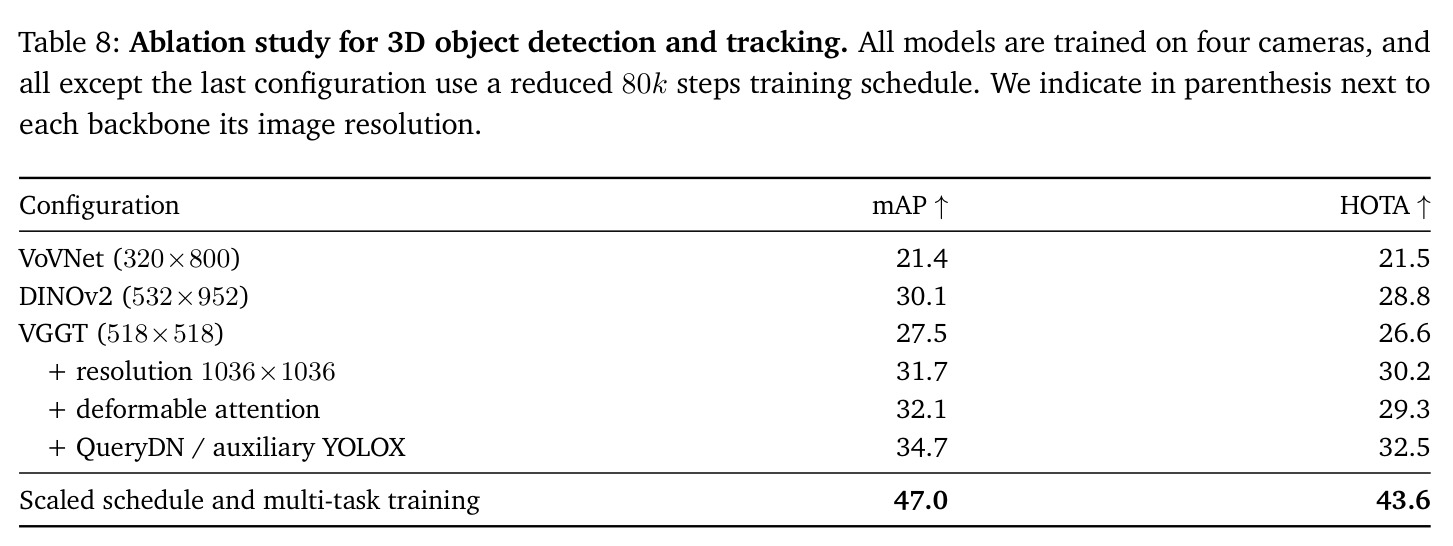
检测是统一模型的第二大任务,nuScenes 60.9 mAP 的结果直接由该头产出,其消融(Tab. 8)逐项验证了 deformable 采样与查询去噪的增益。
Kalman 滤波与 RTS 平滑
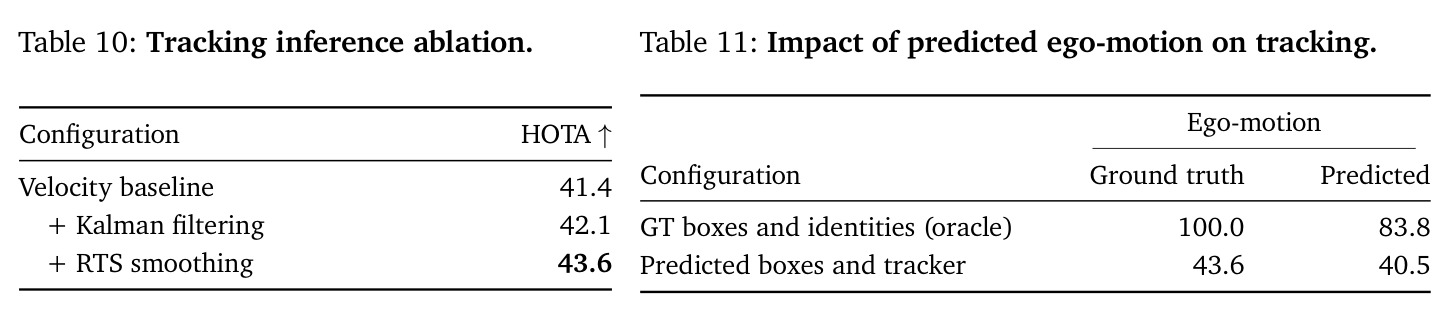
Kalman 滤波用恒速运动模型对目标状态(平面位置+速度)做「预测-更新」递推,融合运动先验与检测结果;Rauch–Tung–Striebel(RTS) smoother 是其离线版本,在正向滤波后再做一次后向遍历,使后续观测也能修正更早时刻的状态估计。本文离线跟踪器用模型预测的框位置+速度作为观测,Kalman 滤波贡献 +0.7 HOTA、RTS 平滑再贡献 +1.5 HOTA。
离线多目标跟踪是本文视频级管线的第三组件,理解这两个经典工具才能明白 HOTA 43.6 是如何从 41.4 的速度基线堆出来的。
研究动机
自动驾驶系统天然需要两类能力:理解当下场景(深度、3D 目标、占用)与重建过去场景用于仿真回放,但现有模型把两件事割裂开。感知一侧,UniAD、PARA-Drive、GeoUP 等多任务模型只输出结构化感知结果,不产生可渲染的外观;其中最接近的 GeoUP 虽统一了深度、检测与占用,却假设已知相机内参、相机-车体标定和真值自车位姿,无法在缺乏标定位姿的输入上工作。重建一侧,Instant NuRec 等前馈高斯模型可以免逐场景优化地渲染驾驶场景,但依赖真值自车位姿与真值演员轨迹,也不具备语义理解。几何基础模型 VGGT 虽能从多图联合回归相机与稠密几何,但其全局注意力随图像 token 总数二次增长,扩展到 6 相机 × 多时刻的长序列代价过高。数据层面,LiDAR 单帧稀疏、相机异步曝光与 rolling shutter 使稠密深度/占用标注难以与图像精确对齐(车辆运动会让跨时刻点云错位),且公开基准上几何、检测、占用各自为政,缺乏在同一批驾驶场景上的可比性。
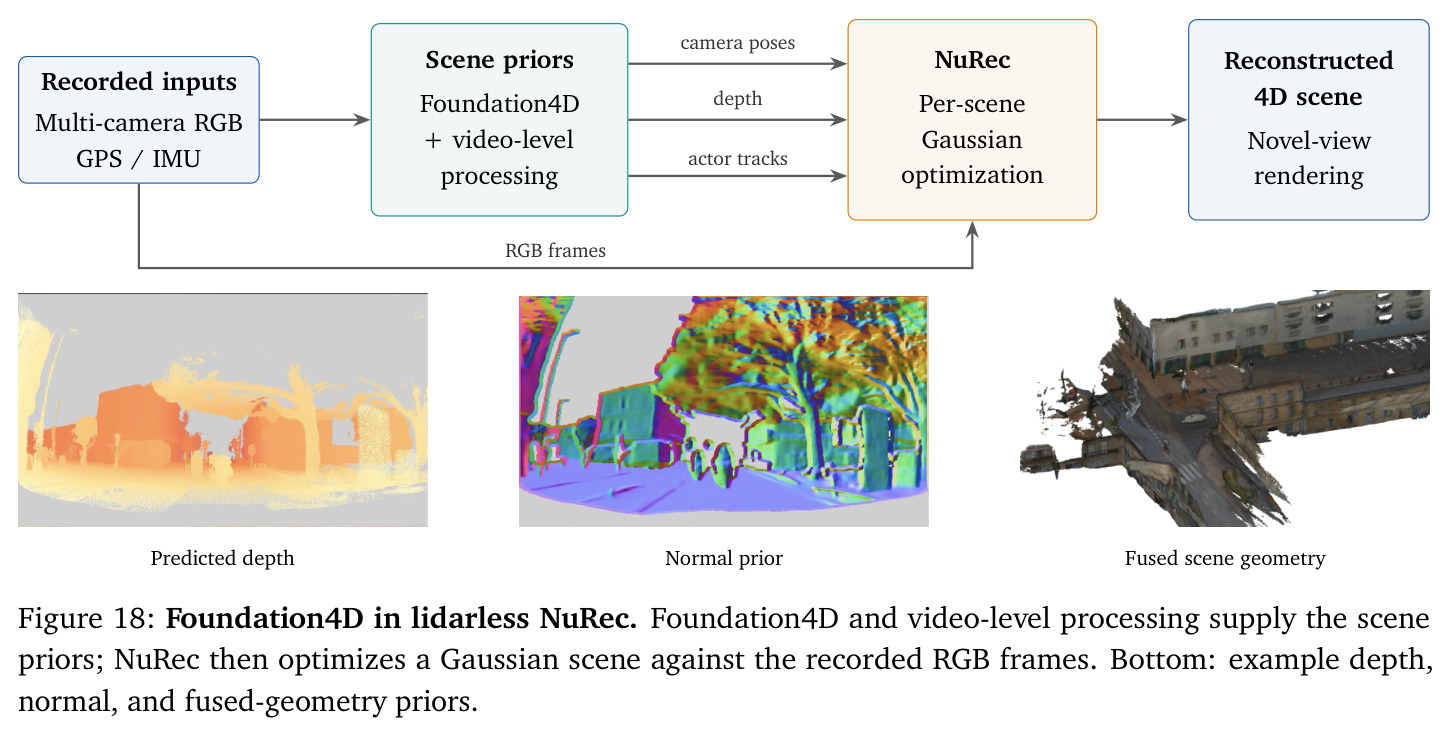
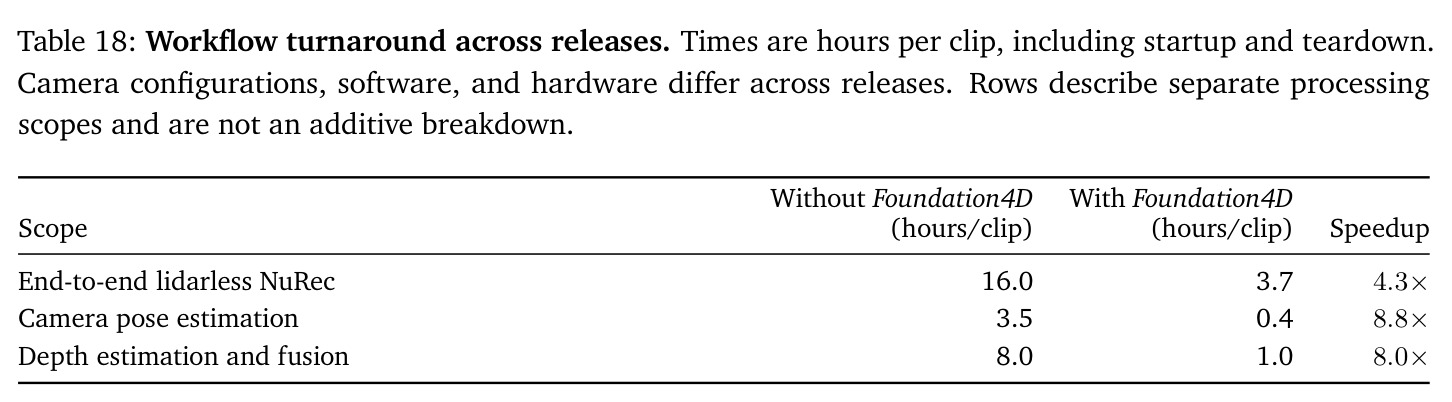
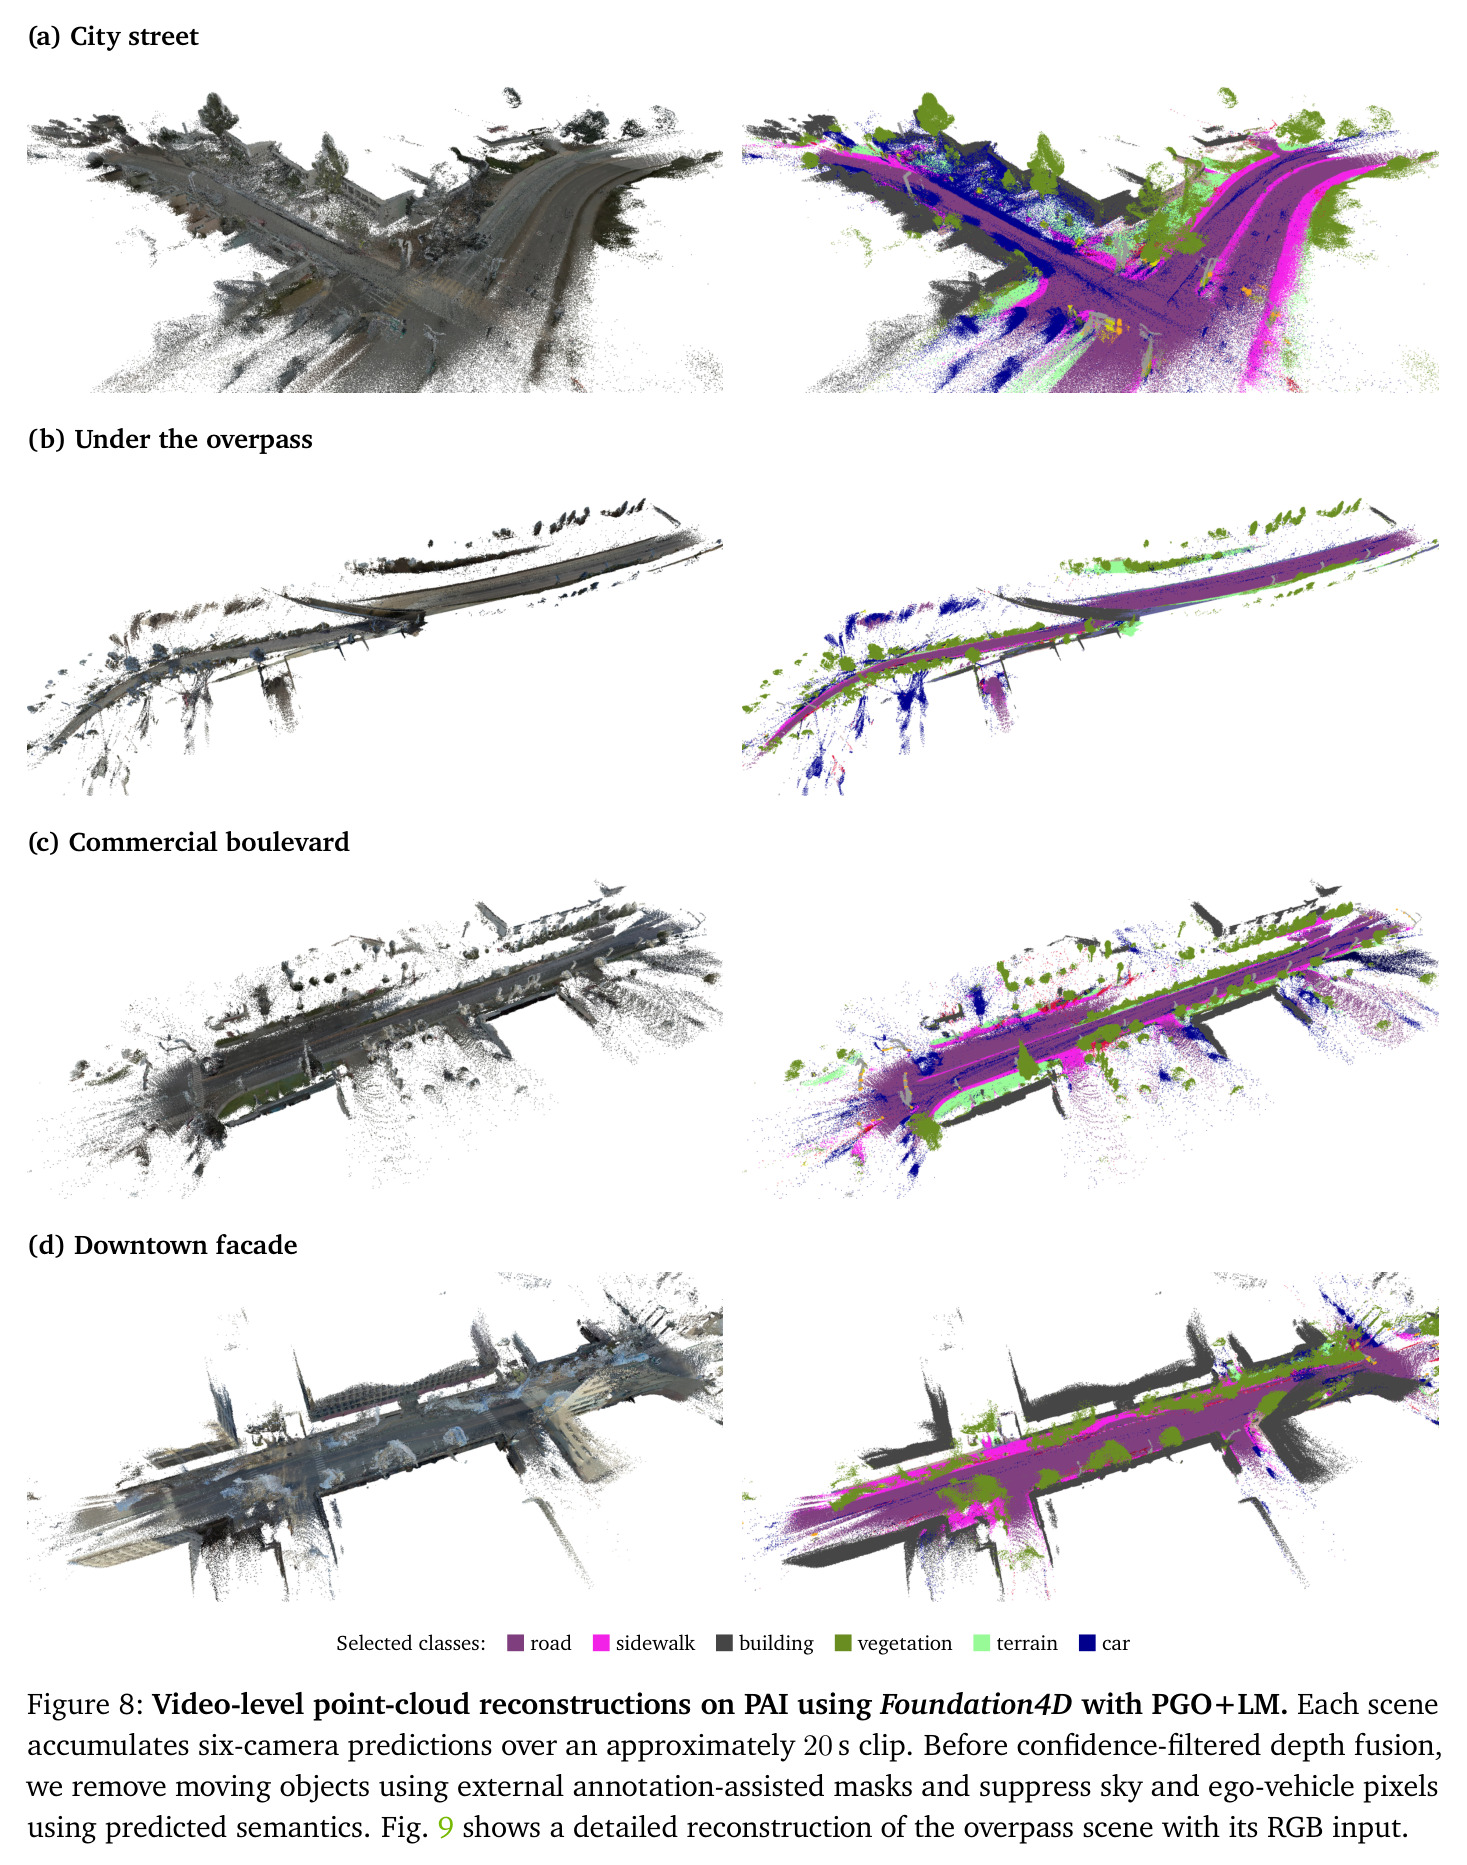
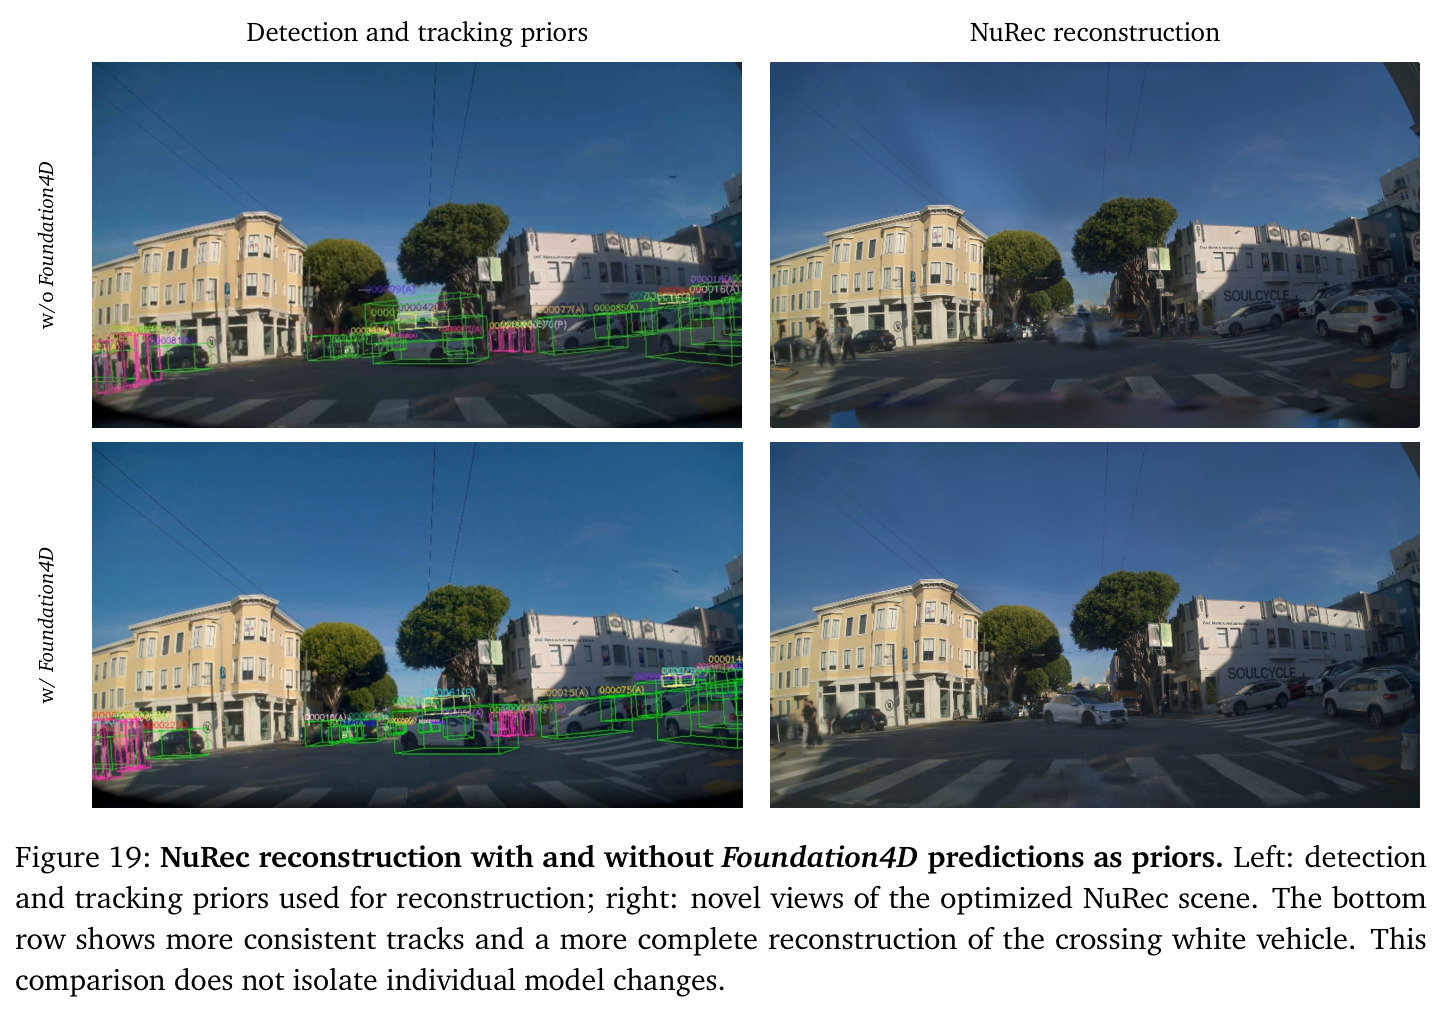
本文的目标是本文目标是构建统一前馈模型 Foundation4D:以共享的多相机视频表征为基础,单次前向同时输出(1)相机到车体静态标定 $T_{\text{rig}}$、自车运动轨迹 $T_{\text{ego}}$ 与度量深度/点图;(2)12 类 3D 包围盒与平面速度,检测范围 $[-108,150]\times[-108,108]\times[-3,5]$ m;(3)0.2 m 分辨率、覆盖前方 100 m 的语义占用;(4)可直接新视角渲染的静态/动态 3D 高斯与天空 cubemap。配套三项工作:其一,视频级推理管线,用重叠窗口(48 帧、5 帧重叠)的位姿图优化与离线多目标跟踪把窗口级预测组装成整段相机轨迹与目标轨迹;其二,能处理传感器时序、自车/演员运动与可见性的深度/占用自动标注管线;其三,发布 PAI-Foundation4D 基准,在 1,253 段同一批 PAI 驾驶片段上提供稠密深度与占用标注及统一评测协议。最终系统检验几何/检测/占用全部 7 种训练组合的迁移与干扰,并把预测的几何与轨迹作为 lidarless NuRec 重建先验,将单片段端到端处理从 16.0 小时压缩到 3.7 小时(4.3×)。
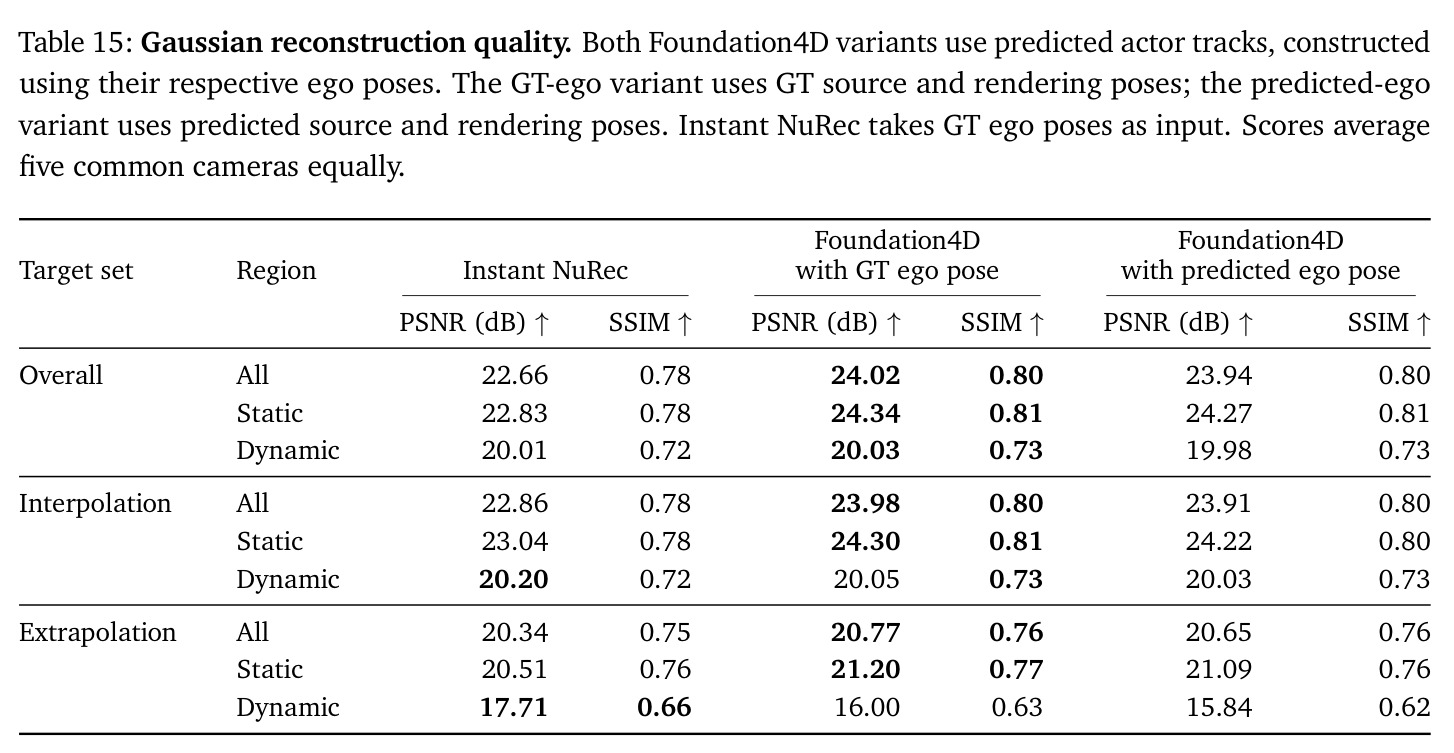
与已有工作不同的是,本文的独特切入是把「标定-运动分解」「感知-重建统一」「窗口-全局对齐」三条线拧到一个模型里。其一,显式把相机位姿因子分解为静态的相机到车体变换 $T_{\text{rig}}^c$ 与时变的参考相机轨迹 $T_{\text{ego}}(\tau)$,且全程以固定度量尺度监督窗口,使跨窗口的位姿能挂在同一张位姿图上做全局优化——这是 VGGT-Long/VGGT-SLAM 的局部-全局策略针对多相机异步驾驶视频的改造:每个相机在自己的真实曝光时刻接收轨迹修正。其二,与 GeoUP 依赖真值位姿、USR-Drive 假设已知位姿不同,Foundation4D 推理时用自预测的位姿与自组装的目标轨迹驱动高斯渲染,真正实现免外部几何先验的统一感知重建,并在 Gaussian 重建实验中验证预测位姿仅损失 0.08 dB PSNR(23.94 vs 24.02)。其三,它不满足于展示一个最优配置,而是把几何/检测/占用的全部 7 种训练组合都训了一遍,给出哪些任务互益(检测+几何+占用)、哪些互相挤占(占用上三任务反而不如几何+占用)的量化结论。
核心方法
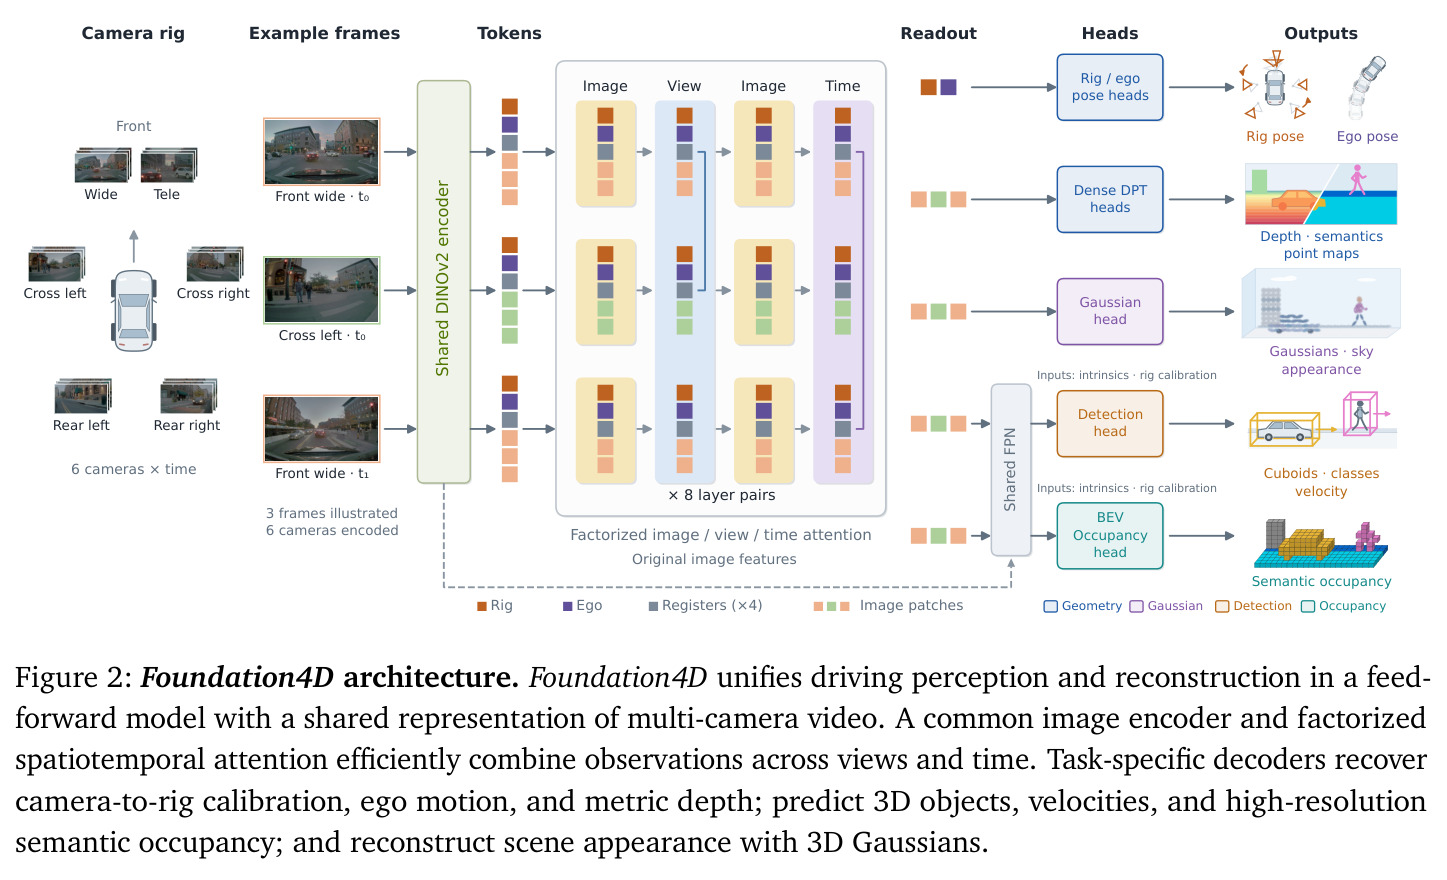
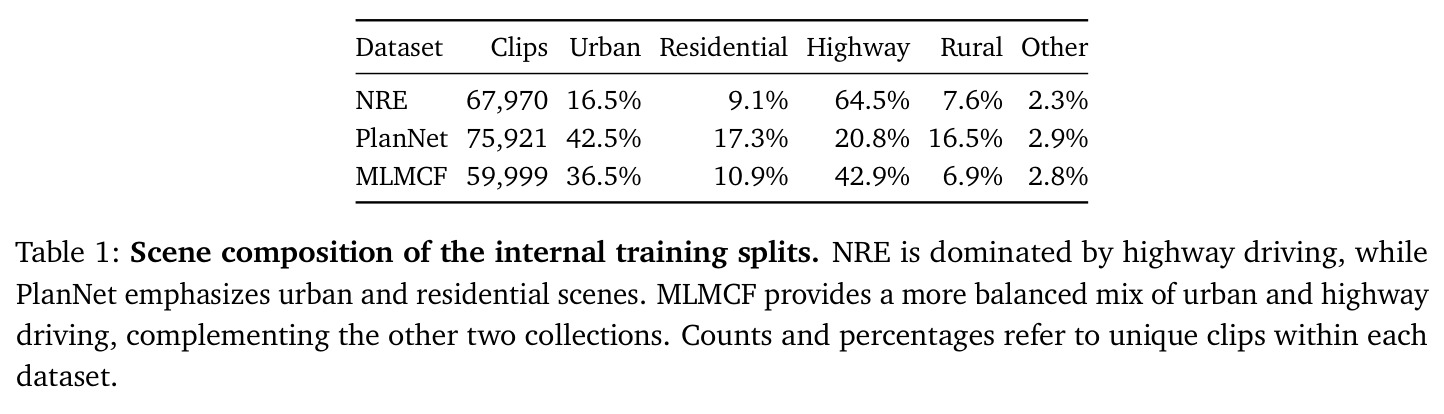
直觉上,深度、检测、占用和高斯重建需要的都是同一份「时空一致、度量尺度」的 3D 场景理解,与其各训一个网络重复扫描同样的观测,不如共享一套骨干特征再分头解码。技术路线:共享的 DINOv2 ViT-L/14(宽度 $d=1024$)独立编码 6 路 1036×1036 图像得到 74×74 patch 网格,双线性降采样到 37×37 后进入 16 层分解式时空聚合器——每层先做图像内自注意力,再交替做「固定时刻跨相机」或「固定相机跨时刻」的自注意力,避免对全部 token 的二次全局注意力;每个图像序列额外携带 1 个 rig token、1 个 ego token 和 4 个 register token。聚合输出与编码器全分辨率特征拼成宽 $2d$ 的上下文特征,供四个头共享:几何头(DPT 深度/辅助点图/2D 语义 + rig/ego 位姿回归)、检测头(DETR3D 式 900 查询 6 层 deformable 解码,共享 FPN 金字塔)、占用头(BEV deformable attention 投影 + 转置卷积上采样 + 通道-高度重排)与高斯头(逐像素 Gaussian 属性 + 天空 cubemap + 逐相机仿射色彩变换)。训练分三阶段:先短窗口(4 时刻、随机帧距≤8、约 170k 步)联合训练感知头;再扩到 8 时刻、帧距≤16(45k 步)并冻结图像编码器;最后冻结感知模型预热高斯头,再做 10k 步全头联合微调。预训练数据为三个内部数据集 NRE/PlanNet/MLMCF(约 6.8 万/7.6 万/6.0 万段、共约 695 小时),按 1:2:1 采样,在 64 张 H100 上用 BF16 + FlashAttention-3 + 自定义 RoPE CUDA 核训练,感知阶段约 18 天、高斯阶段约 9 天。
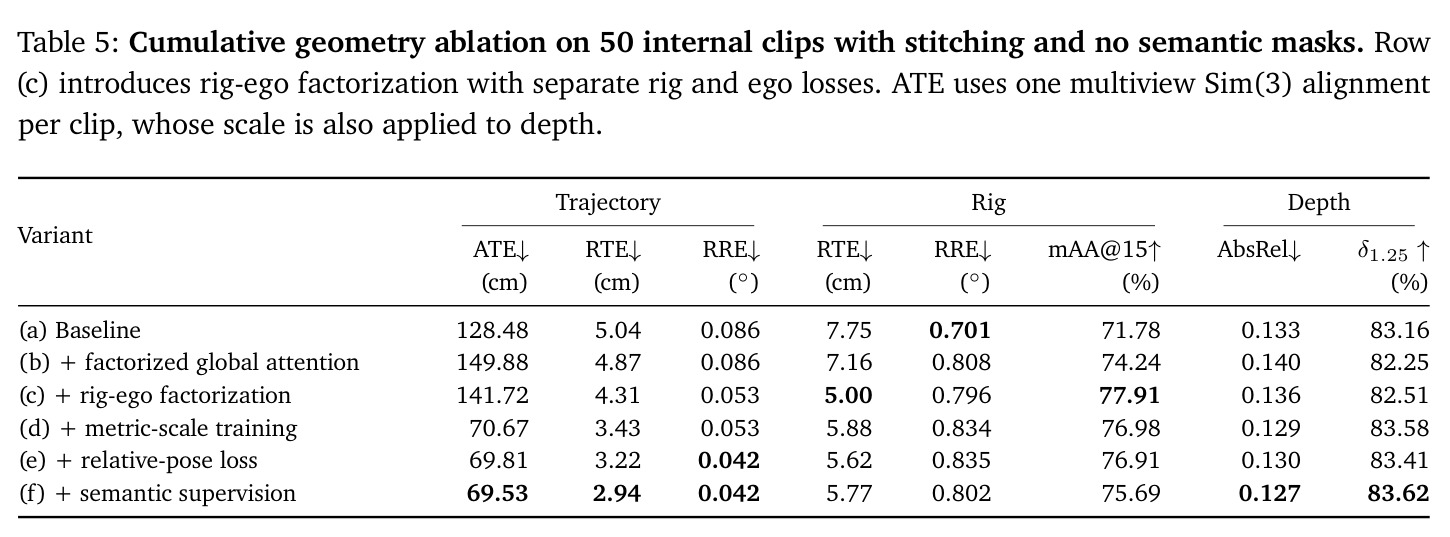
核心创新是把相机位姿写成固定 rig 变换与时变自车轨迹的乘积 $\mathbf{T}_{t,c}=\mathbf{T}_{\text{ego}}(\tau_{t,c})\,\mathbf{T}_{\text{rig}}^c$:rig 头从首时刻组的 rig-token 特征回归静态相机排布,ego 头从参考相机的 ego-token 全时间序列回归运动,二者按曝光时刻插值(平移线性、旋转最短弧球面插值)复合。这样静态标定与整车运动解耦,视频级 PGO 只需优化一条共享参考轨迹,再把修正按每台相机的真实采集时刻传播回去。与已有方法的本质区别有三:(1) GeoUP 把真值位姿作条件输入,Foundation4D 从图像直接回归位姿与标定,推理不依赖任何外部几何先验;(2) VGGT 的全局注意力对 token 总数二次增长,本文的分解注意力换得 8.5% 端到端加速并支撑 6 相机 × 48 时刻窗口;(3) 固定度量尺度训练让所有窗口共享同一物理单位,配合相对位姿损失 $\Delta\mathbf{T}_i^j=(\hat{\mathbf{T}}^j_{\text{ego}})^{-1}\hat{\mathbf{T}}^i_{\text{ego}}$ 监督,使窗口组装从「逐窗拼接的误差累积」升级为「全局联合优化」——消融显示仅度量尺度训练就把轨迹 ATE 从 141.72 cm 减半到 70.67 cm。
方法步骤详情
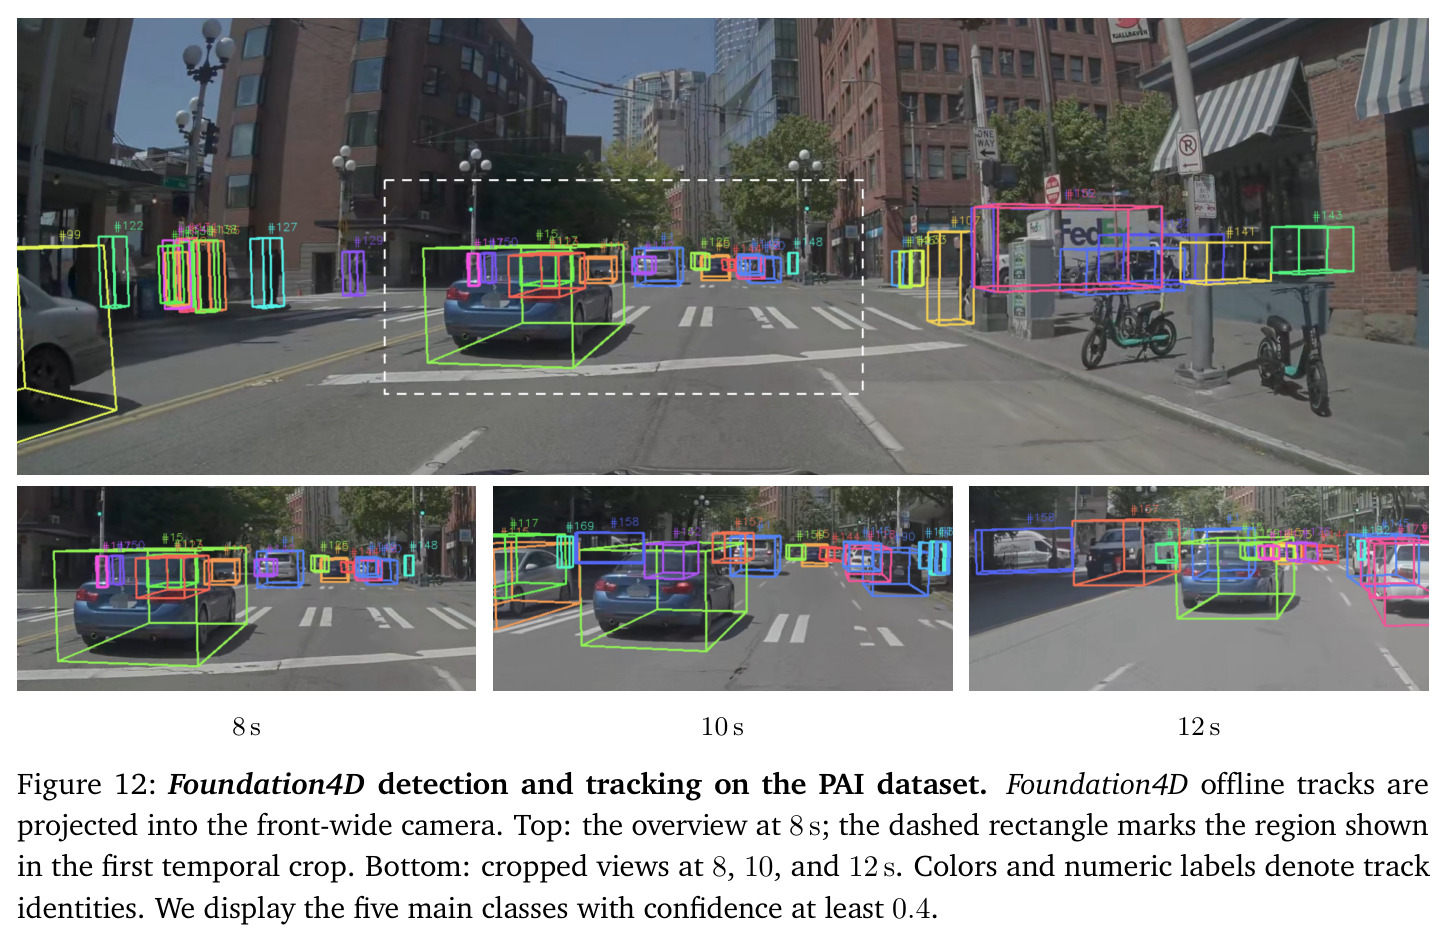
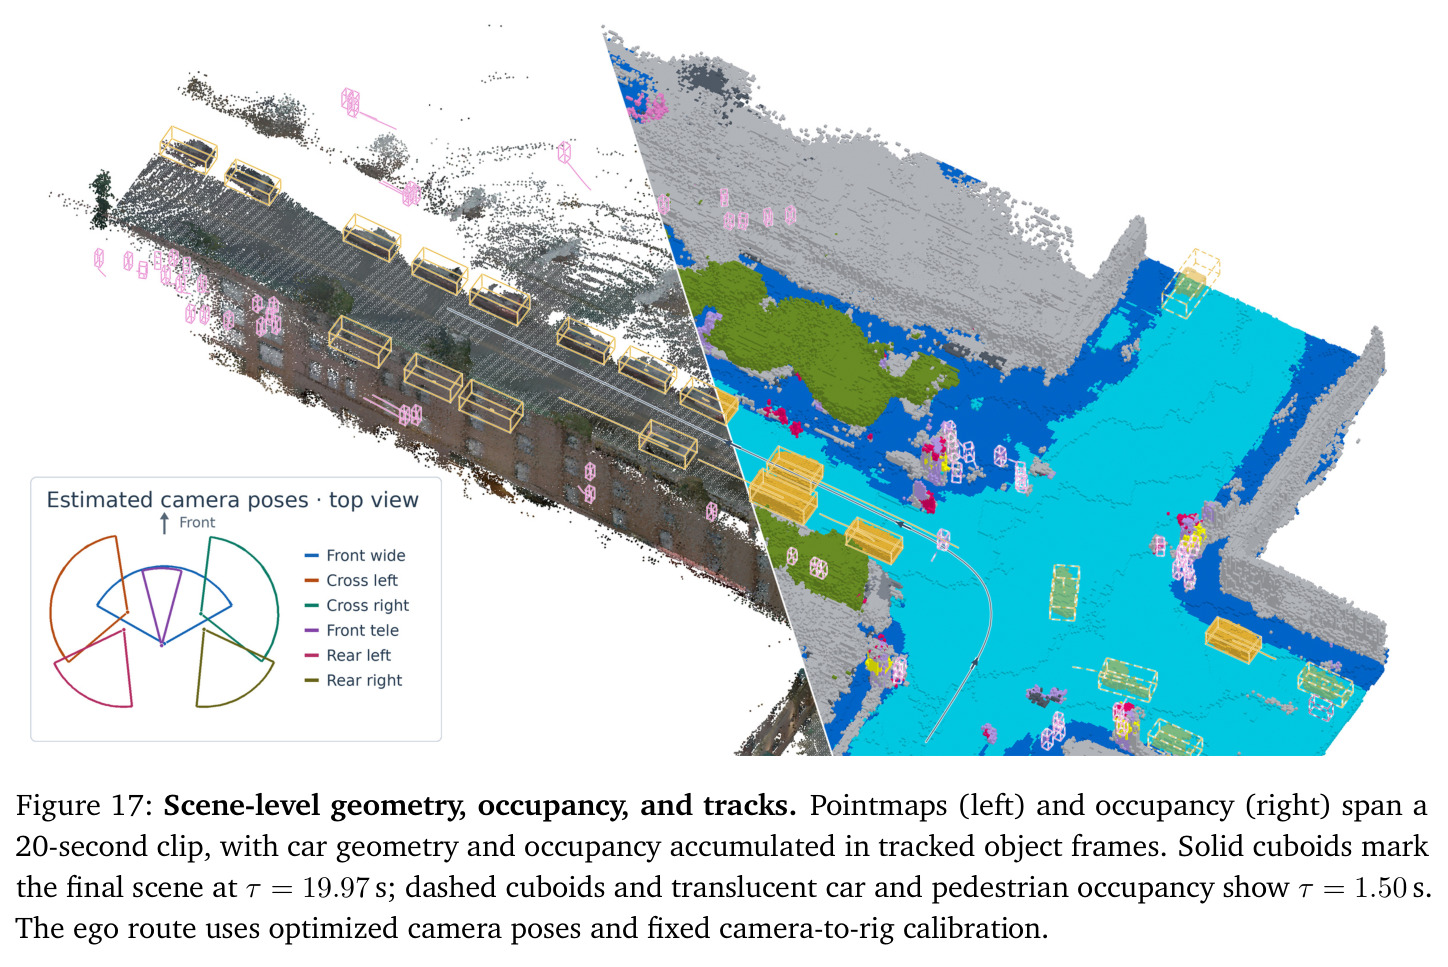
完整流程分八步。第一步输入组装:取 $T$ 个时刻 × 6 相机的 1036×1036 图像窗口。第二步编码聚合:DINOv2 输出 74×74 patch 特征,降采样到 37×37,连同 rig/ego/register token 经 16 层分解注意力,末层图像内与时间注意力输出沿通道拼接成 $2d$ 宽上下文特征。第三步几何解码:rig/ego 头回归世界到相机位姿(平移+四元数),按 $\mathbf{T}_{t,c}=\mathbf{T}_{\text{ego}}(\tau_{t,c})\mathbf{T}_{\text{rig}}^c$ 复合并按曝光时刻插值;DPT 头输出 518×518 度量深度、置信度、辅助点图与 21 类语义,最终点图由深度反投影 $\mathbf{p}(u)=\mathbf{R}\frac{d(u)}{[\mathbf{r}(u)]_z}\mathbf{r}(u)+\mathbf{t}$ 得到。第四步检测解码:900 个查询在共享 FPN 上经 6 层 deformable 交叉注意力,输出 12 类立方体的中心/尺寸/朝向/平面速度,训练用匈牙利匹配 + focal loss + 查询去噪 + 辅助 YOLOX 2D 头。第五步占用解码:每 BEV 格支柱上 4 个参考点经自注意力+deformable 交叉注意力聚成 BEV 特征,转置卷积上采样后通道-高度重排输出二值与语义体素 logits。第六步高斯解码:逐像素预测中心(深度反投影)、颜色残差、尺度、四元数、不透明度(乘语义掩码压掉天空/自车)与法线;渲染时按演员轨迹刚体变换动态高斯,可微泼溅后加天空 cubemap 与逐相机仿射变换合成图像,渲染损失 $\mathcal{L}_{\text{render}}=\mathcal{L}_{\text{RGB}}+0.2\mathcal{L}_{\text{LPIPS}}+0.1\mathcal{L}_{\text{inv-dist}}+2\mathcal{L}_{\text{opacity}}$。第七步联合优化:$\mathcal{L}=\lambda_{\text{geo}}\mathcal{L}_{\text{geo}}+\lambda_{\text{det}}\mathcal{L}_{\text{det}}+\lambda_{\text{occ}}\mathcal{L}_{\text{occ}}+\lambda_{\text{gs}}\mathcal{L}_{\text{gs}}$,联合微调权重 $(1,0.1,0.2,4)$。第八步视频级推理:48 帧窗口 5 帧重叠滑窗,深度置信度加权、剔除天空点的 Sim(3) 拼接,或以窗口内相对位姿为因子、带线性运动先验 $\lambda_{\text{motion}}=30$ 的 SE(3) 位姿图优化;检测框变换到世界系后由 Kalman 滤波 + 匈牙利关联 + 两阶段断轨重连 + RTS 平滑离线组轨。
技术新颖性
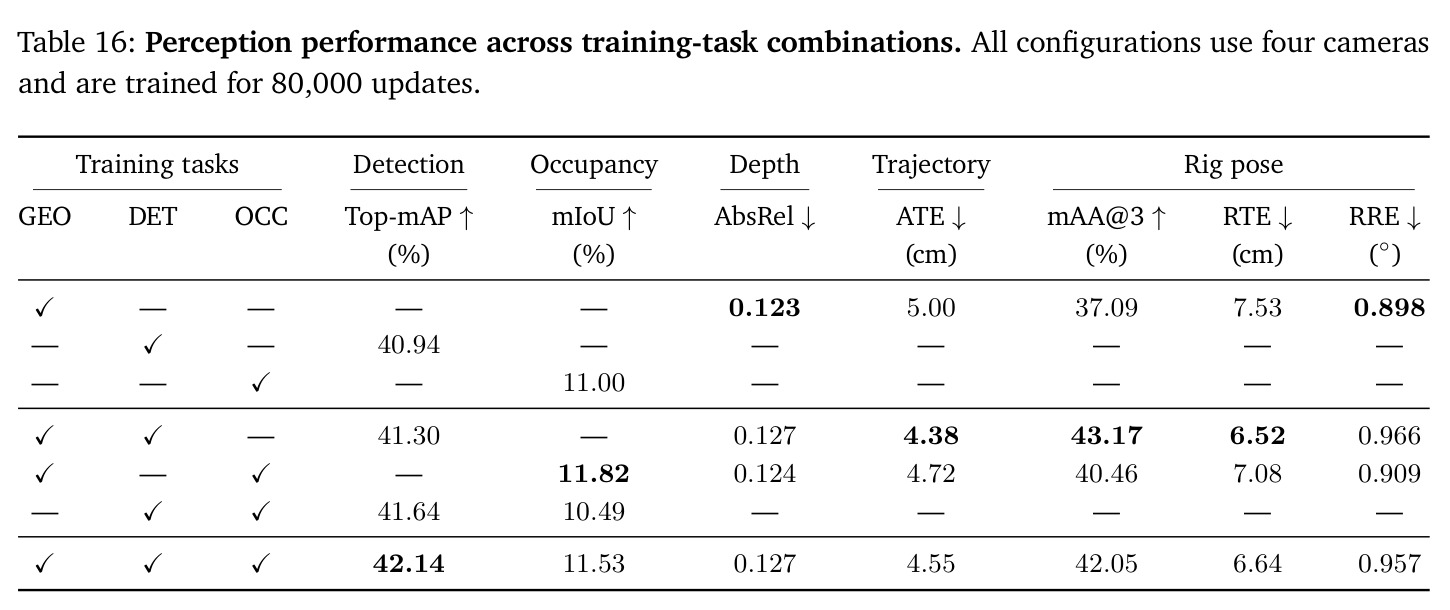
技术新颖性可拆成四点。第一,架构层面:把 VGGT 的全局注意力改为「图像内 → 跨相机/跨时间交替」的分解式注意力,配合 FlashAttention-3 与直接在 packed QKV 布局上做 2D RoPE 的自定义 CUDA 核,首次在 6 相机多时刻驾驶视频上跑通 VGGT 式统一训练,消融证实换来 8.5% 运行时下降,其轻微精度损失被后续设计弥补。第二,几何参数化:rig-ego 分解 + 首时刻组相对位姿 rig 监督是驾驶多相机场景的新设计,直击「标定静态、运动时变、多相机异步曝光」三者纠缠的问题,消融中该设计把 rig 平移误差从 7.75 降到 5.00 cm、rig mAA@15 提到 77.91%。第三,推理系统:把 SLAM 的位姿图思想嫁接到前馈预测上——窗口内相对位姿作为独立因子、多窗口共享节点、用参考相机采样间隔中位数加权的线性运动先验($\lambda_{\text{motion}}=30$)——让后续窗口能修正先前估计,ATE 相对天空掩码拼接几乎减半(65.55→33.11→31.26 cm);再用 Kalman+RTS 把跟踪 HOTA 从 41.4 提到 43.6。第四,任务协同实证:全部 7 种几何/检测/占用组合在同一初始化、同一 80k 步预算下训练,给出「检测受益于三任务联合(40.94→42.14 mAP)、占用最搭配几何(11.00→11.82 mIoU)、几何受益于检测(ATE 5.00→4.38 cm)」这类此前文献缺失的量化结论,而不只是报告一个最优配置。
实验结果
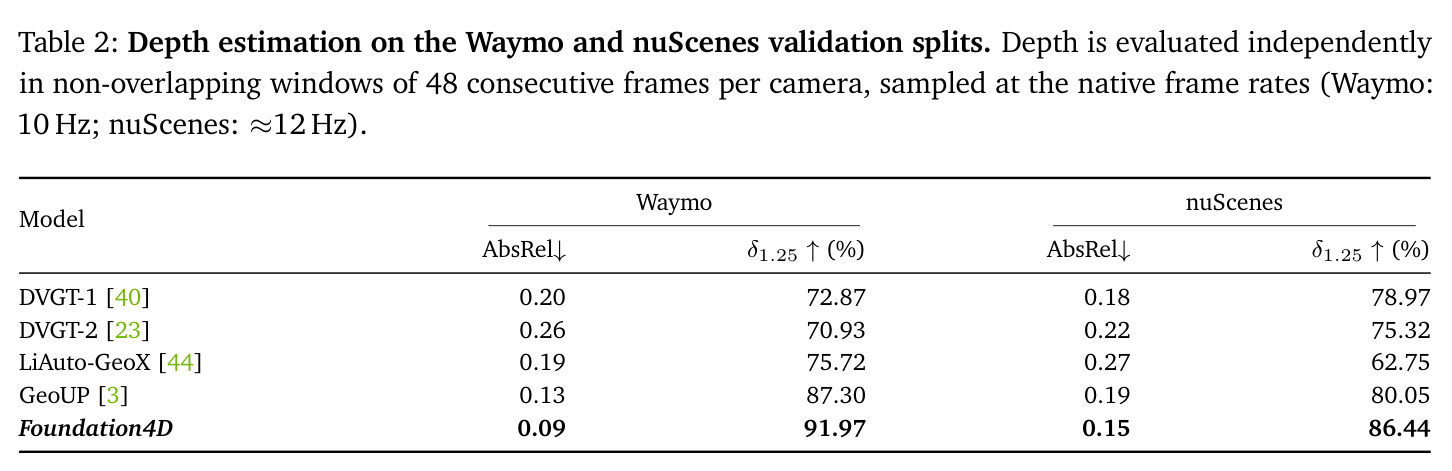
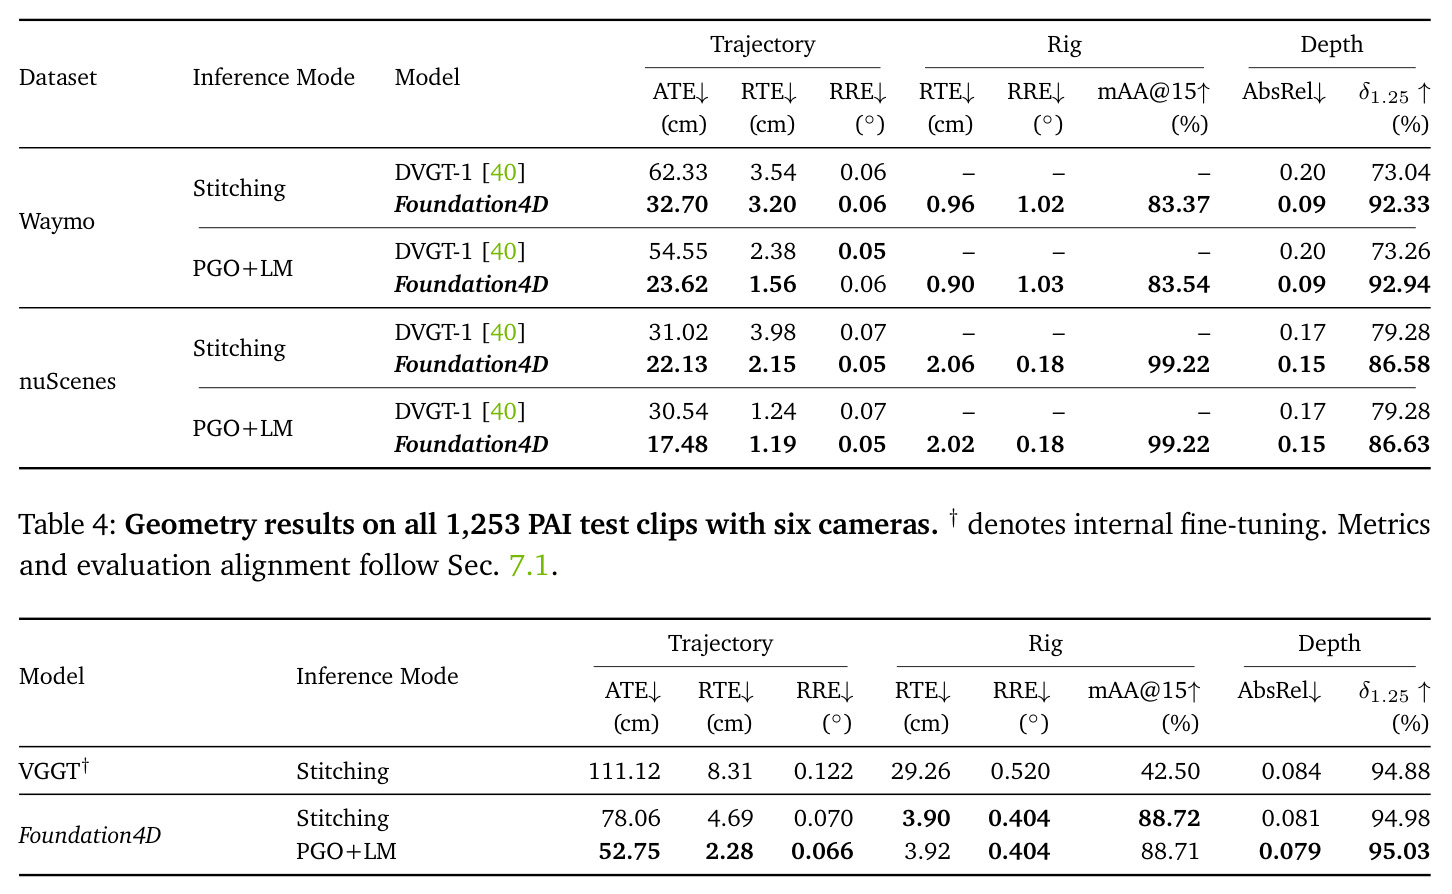
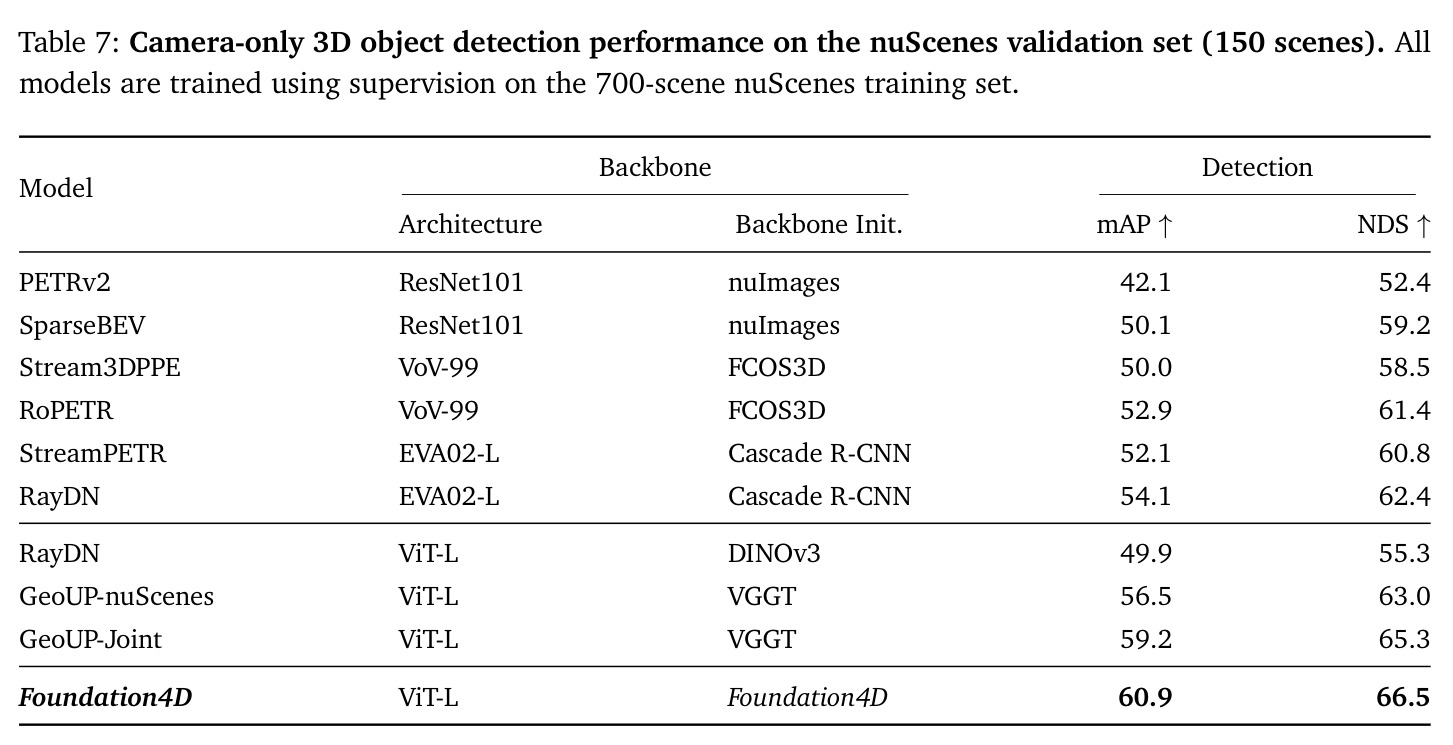
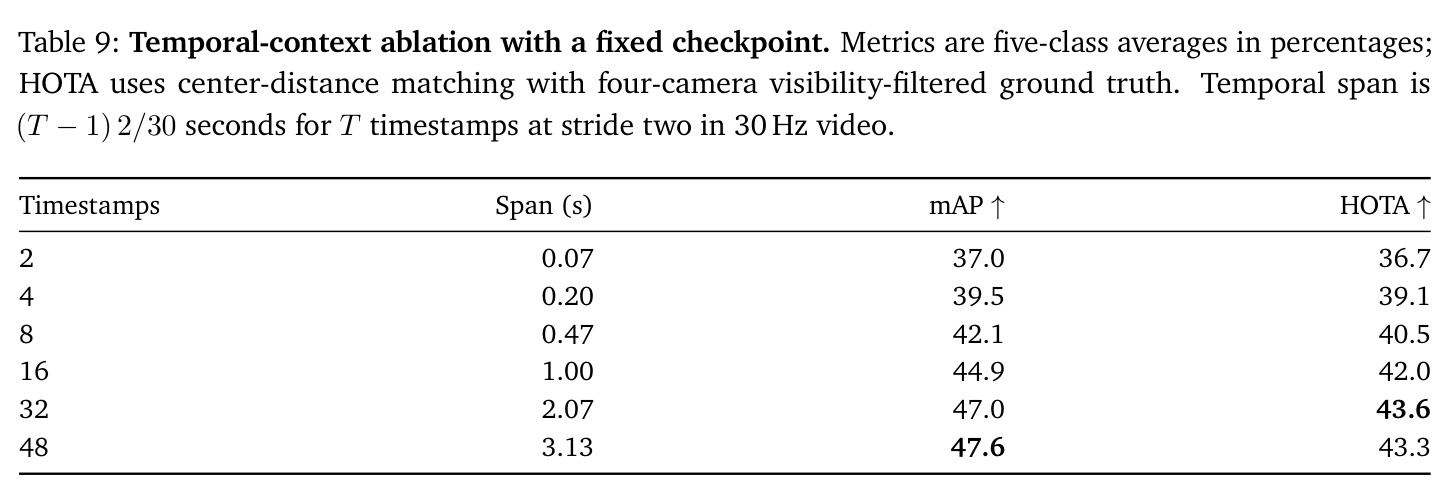
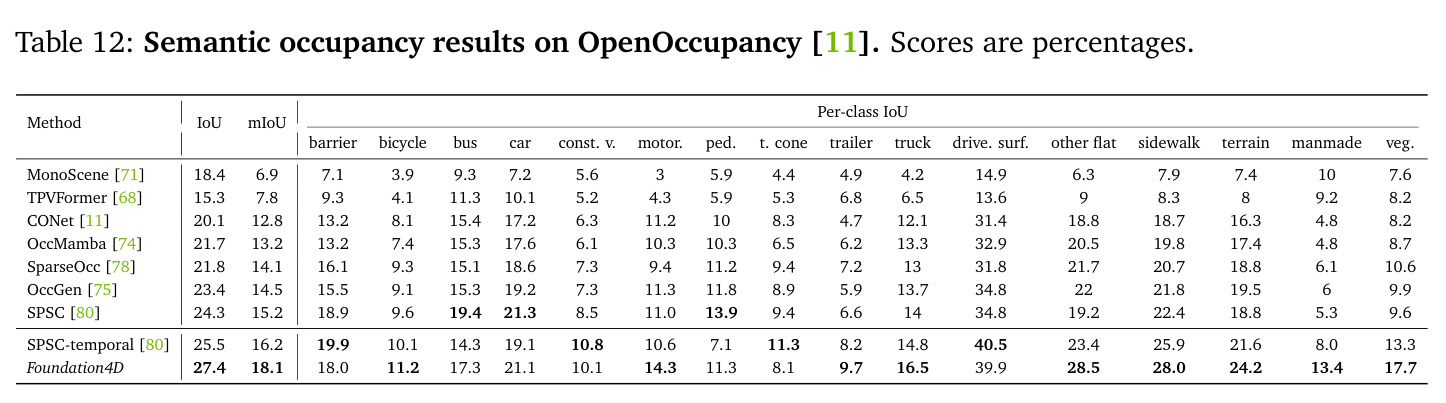
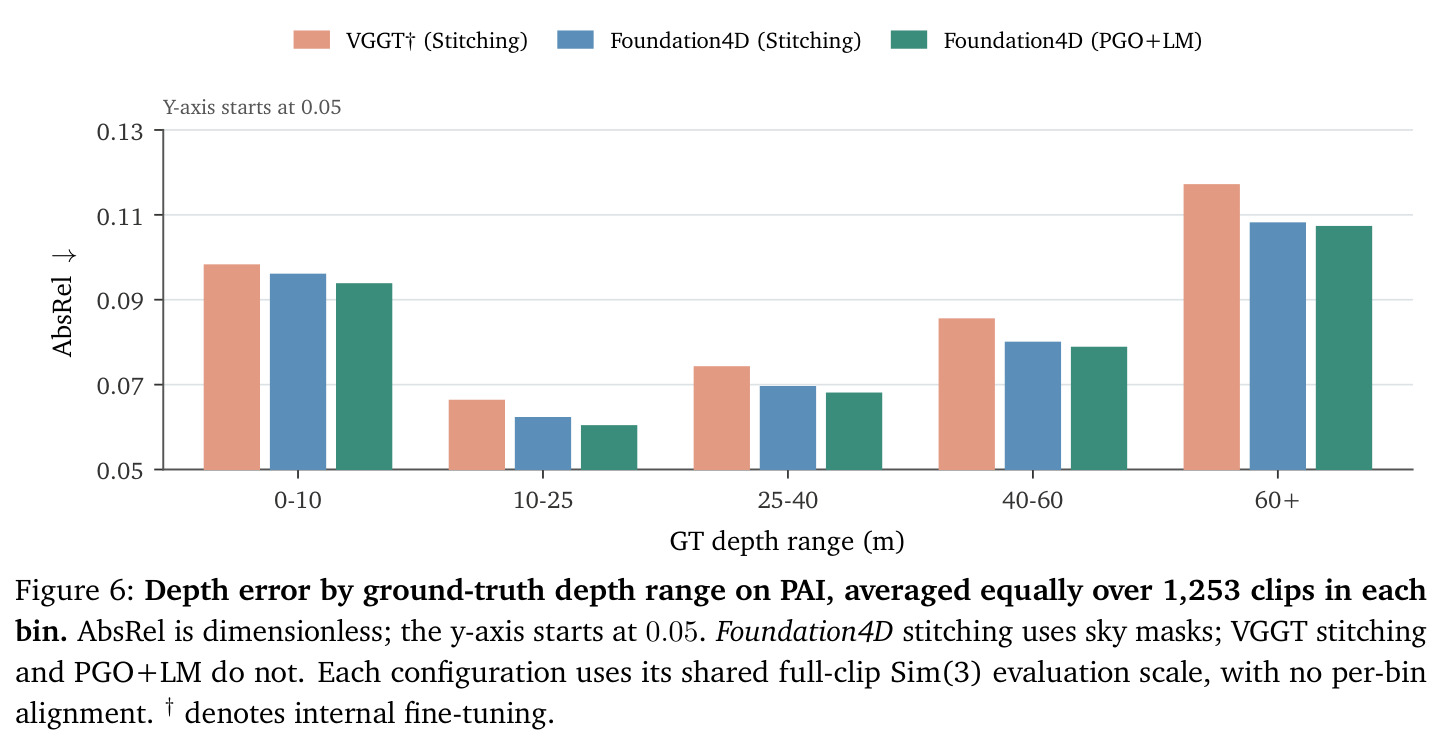
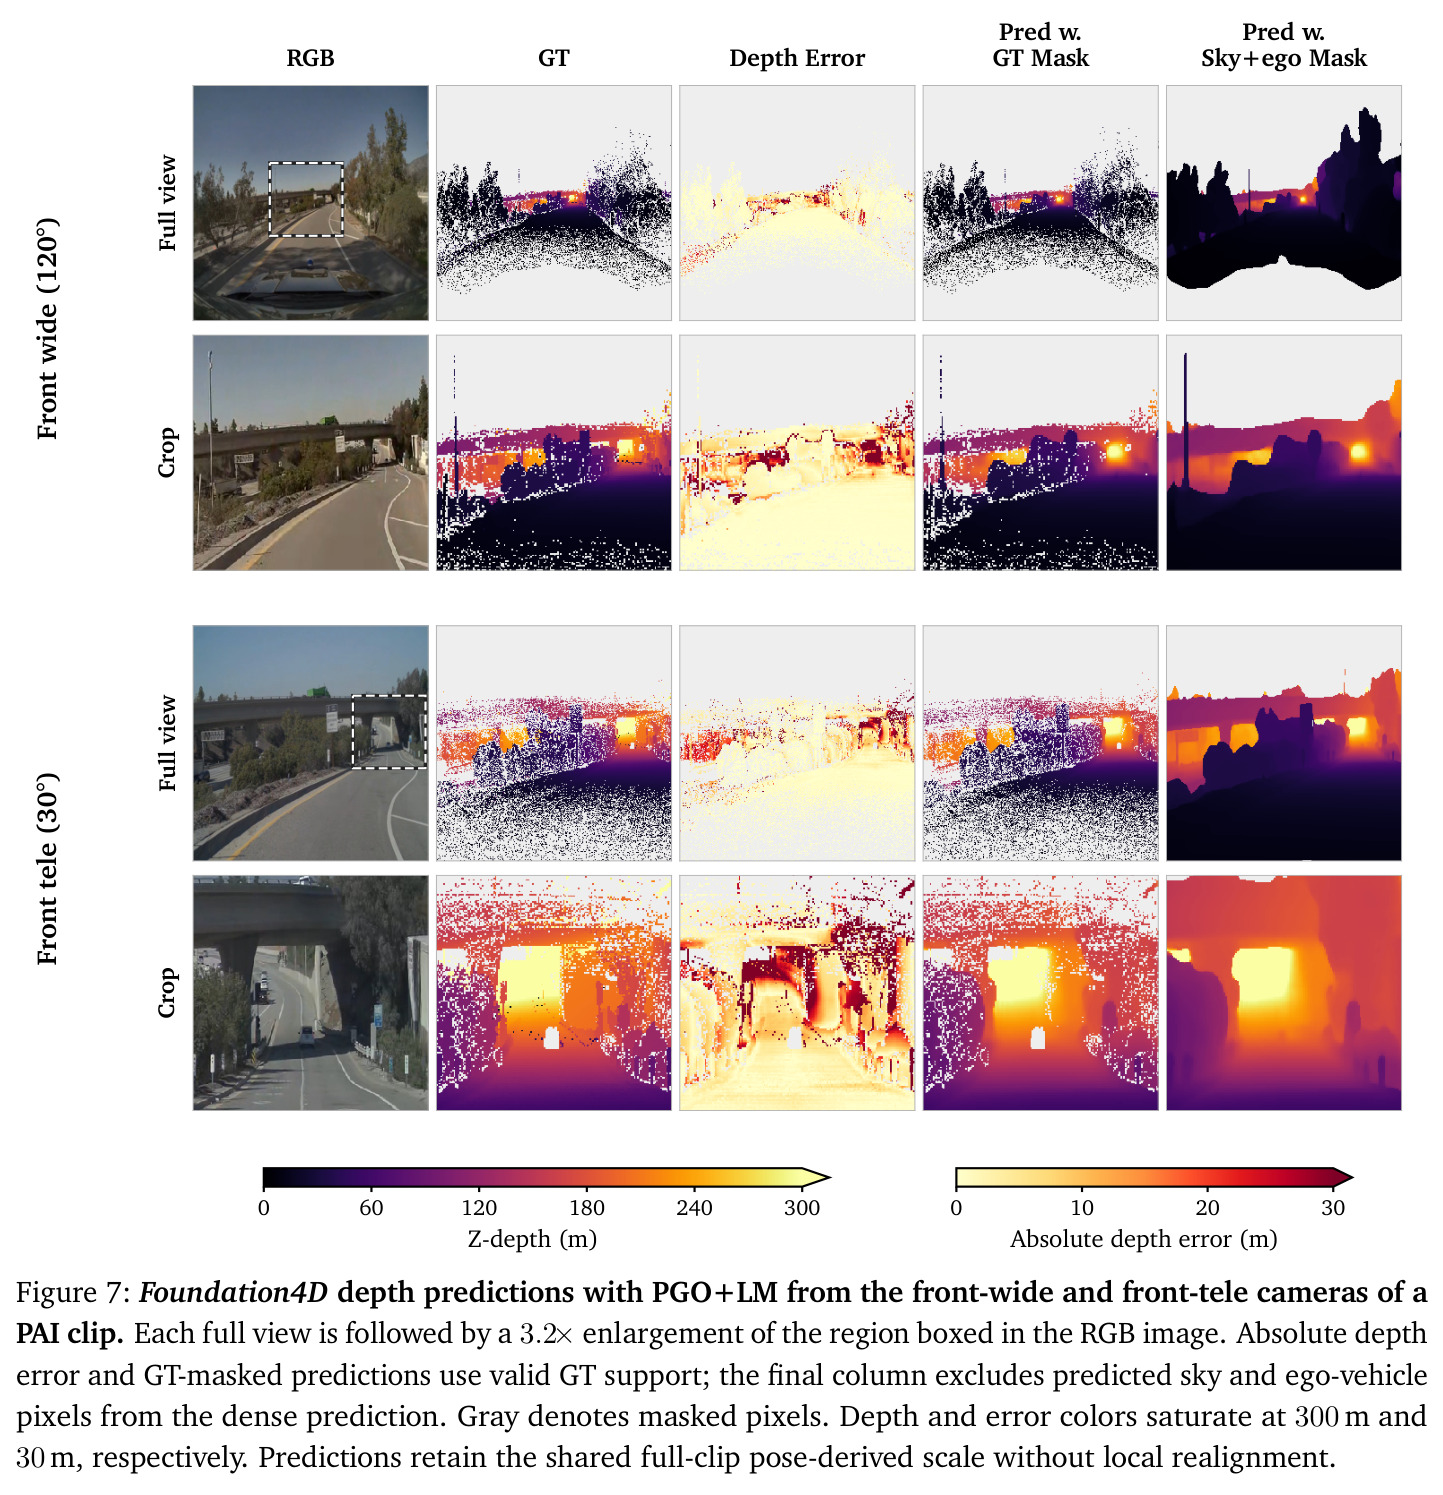
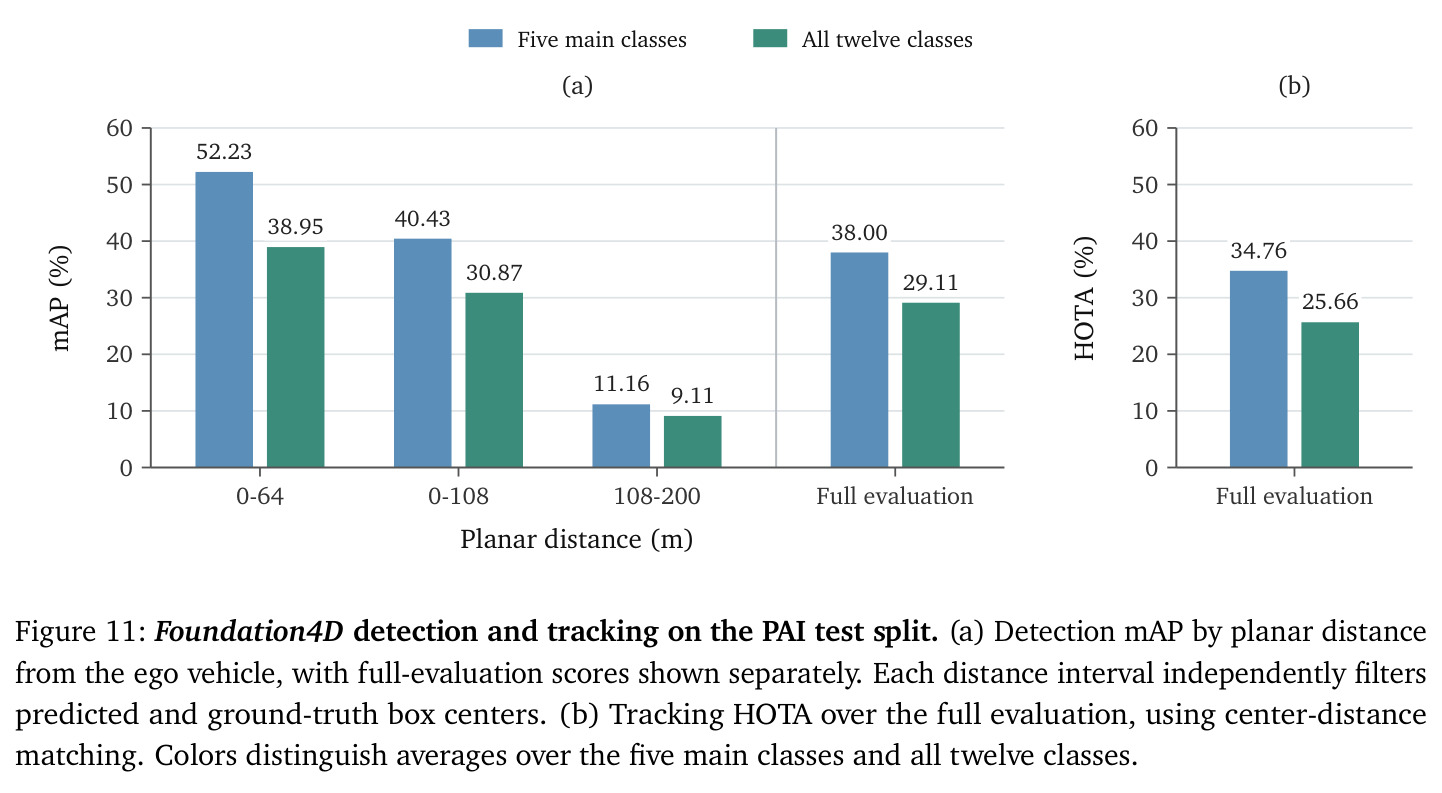
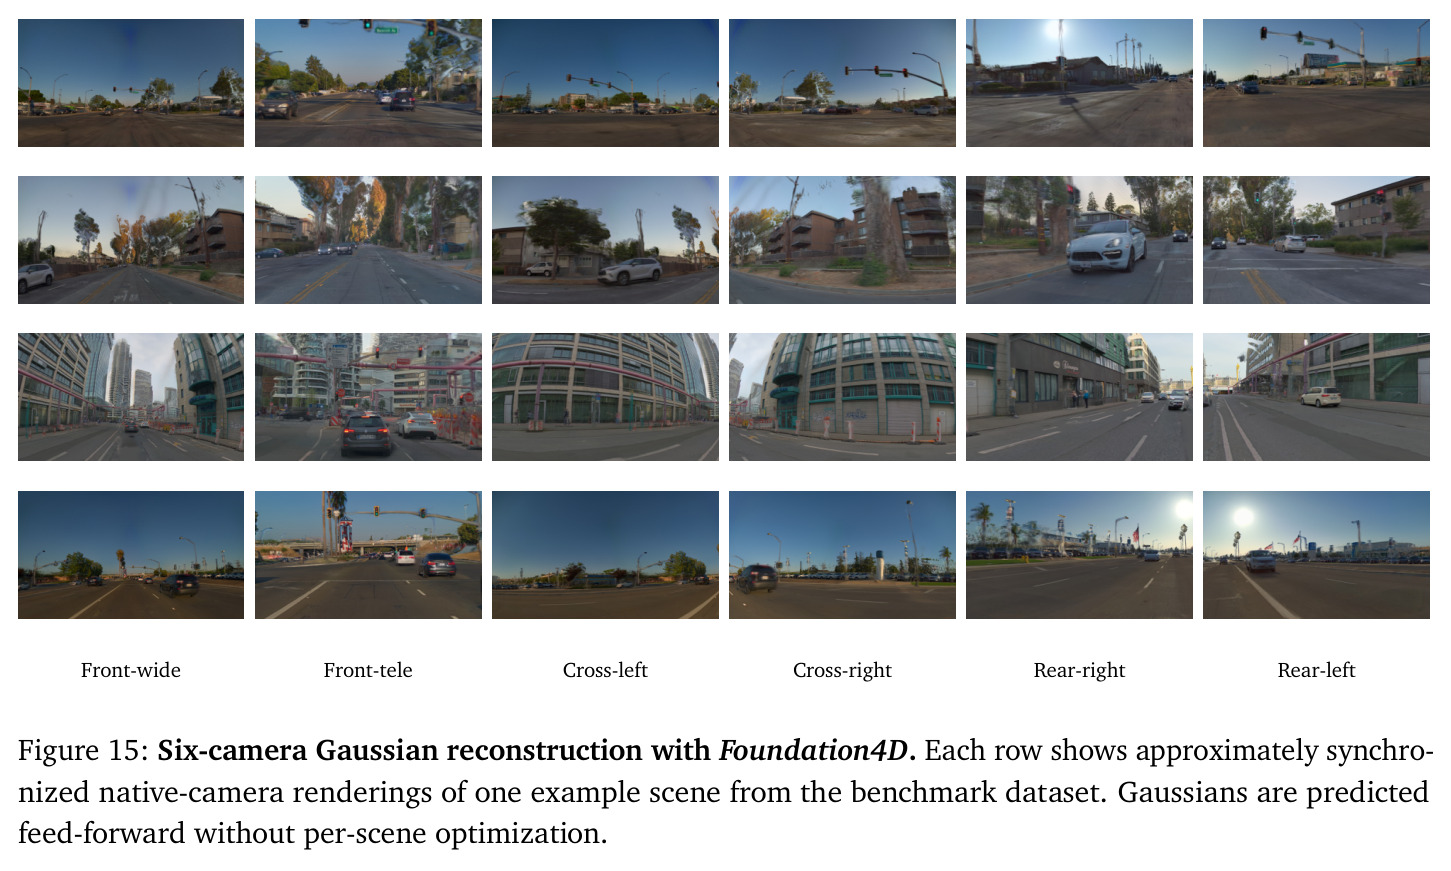
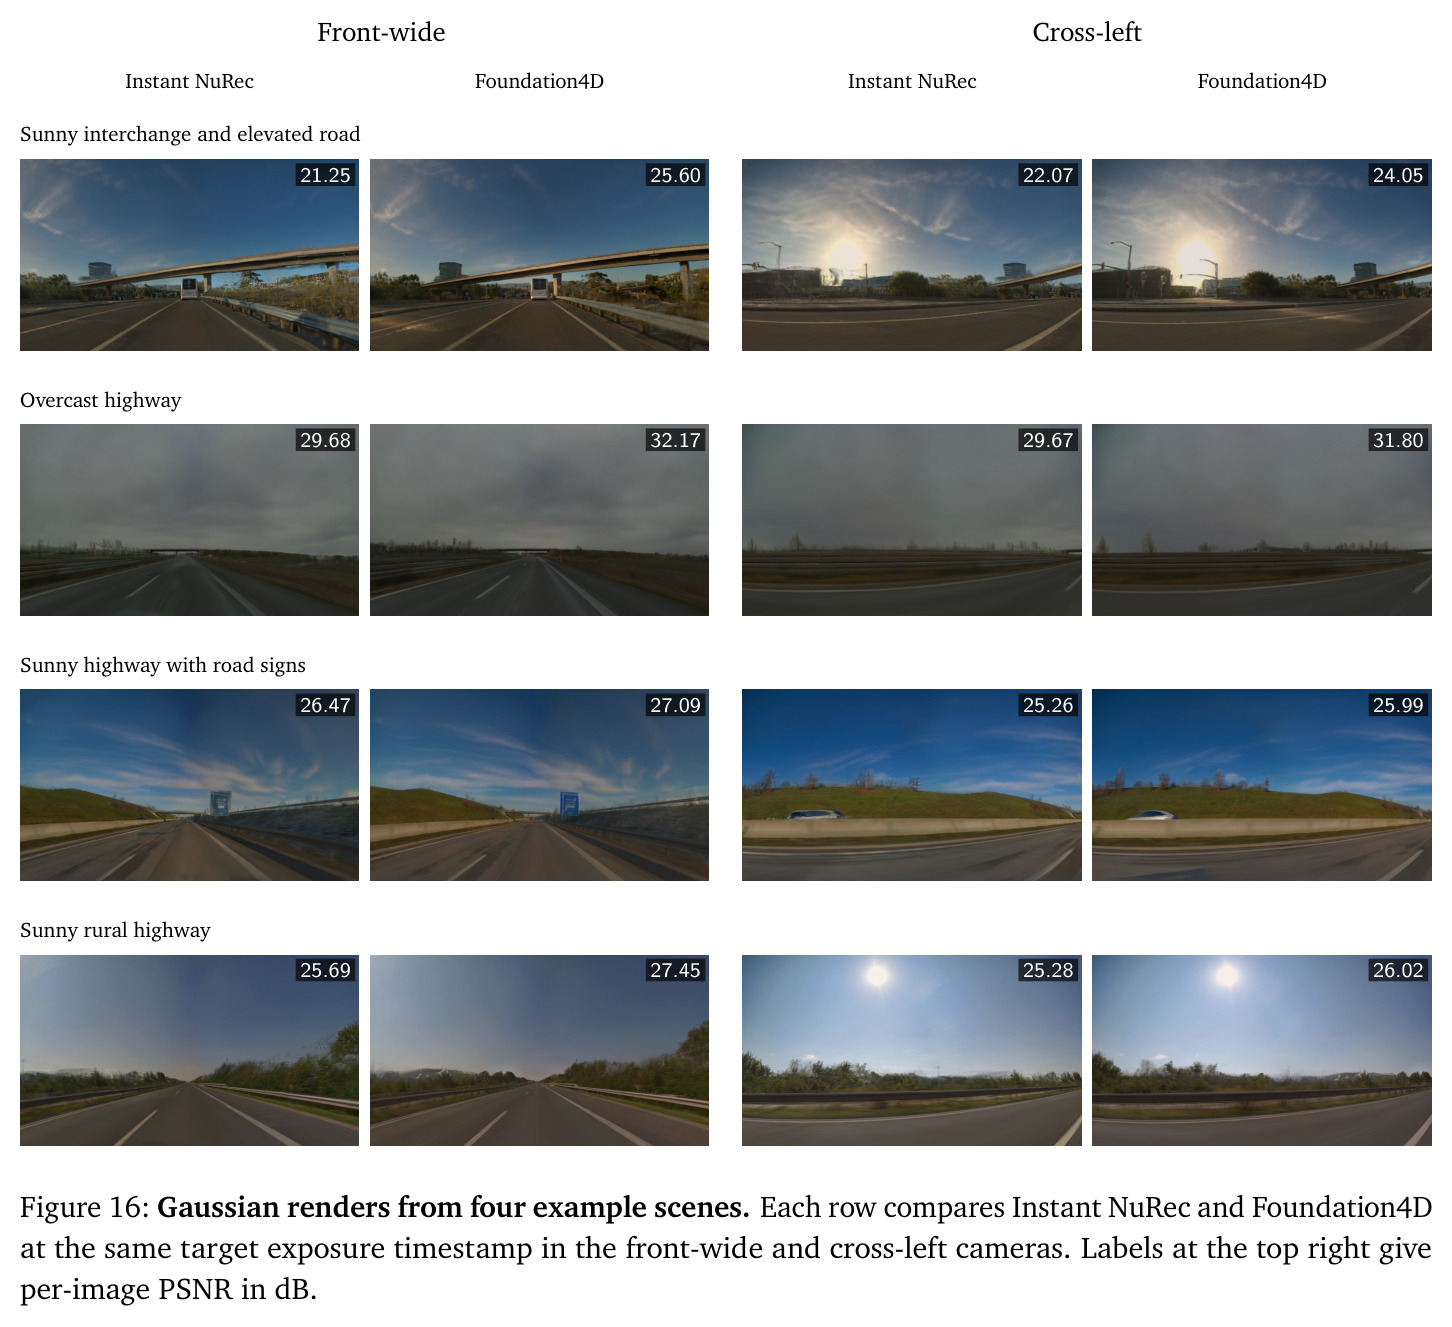
几何:基准微调后深度误差最低——Waymo AbsRel 0.09、$\delta_{1.25}$ 91.97%,nuScenes 0.15/86.44%,优于 GeoUP(0.13/0.19)等四个基线(Tab. 2);视频级 PGO+LM 把 Waymo ATE 从 DVGT-1 的 54.55 cm 降到 23.62 cm、nuScenes 从 30.54 降到 17.48 cm(相对降 29–57%),rig mAA@15 达 83.54%/99.22%(Tab. 3)。PAI 基准 1,253 段上:拼接 ATE 78.06 vs VGGT 的 111.12 cm,rig 平移误差降 86.7%(3.90 vs 29.26 cm),PGO+LM 进一步降到 52.75 cm(Tab. 4),远距离优势更大(>60 m AbsRel 相对改善 7.7–8.4%,Fig. 6)。消融:度量尺度训练贡献最大(ATE 141.72→70.67 cm),PGO 相对天空掩码拼接几乎减半 ATE(65.55→31.26 cm,Tab. 5、6)。检测:nuScenes 微调后 60.9 mAP / 66.5 NDS,超 GeoUP-Joint +1.7/+1.2(Tab. 7);PAI 全量五主类 38.00 mAP / 34.76 HOTA,64 m 内 mAP 52.23% 而 108–200 m 仅 11.16%(Fig. 11);推理窗口 2→32 时刻使 mAP +10.07、HOTA +6.89 无需重训(Tab. 9);Kalman+RTS 使 HOTA 41.4→43.6(Tab. 10),预测自车位姿替换真值仅掉 3.1(43.6→40.5,Tab. 11)。占用:OpenOccupancy 上 IoU 27.4 / mIoU 18.1,超 SPSC-temporal 的 25.5/16.2(Tab. 12);PAI 全 ROI 31.5/14.1,但 50–100 m 段 mIoU 跌至 6.9(Tab. 13);BEV deformable attention 替代 LSS 使 IoU 24.03→27.08(Tab. 14)。高斯重建:用完全自预测位姿与轨迹,总体 PSNR 23.94 dB / SSIM 0.80,反超依赖真值位姿的 Instant NuRec(22.66/0.78)+1.28 dB,静态区域增益显著,动态区域 PSNR 略低但 SSIM 更高(Tab. 15)。任务组合:三任务联合使检测 mAP 40.94→42.14,占用配几何 11.00→11.82,几何配检测 ATE 5.00→4.38 cm(Tab. 16)。下游:作为 lidarless NuRec 先验,端到端 16.0→3.7 小时(4.3×),位姿估计 8.8×、深度+融合 8.0× 加速(Tab. 18)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 深度估计 Waymo | AbsRel↓ / δ1.25↑ | 0.09 / 91.97% | GeoUP 0.13 / 87.30%(次优) | AbsRel 相对降低约 31%,δ1.25 提升 4.67 个百分点 |
| 深度估计 nuScenes | AbsRel↓ / δ1.25↑ | 0.15 / 86.44% | GeoUP 0.19 / 80.05%(次优) | AbsRel 相对降低约 21%,δ1.25 提升 6.39 个百分点 |
| nuScenes 环视 3D 检测 | mAP↑ / NDS↑ | 60.9 / 66.5 | GeoUP-Joint 59.2 / 65.3(次优) | +1.7 mAP / +1.2 NDS |
| 视频级轨迹估计 Waymo(PGO+LM) | ATE↓ (cm) | 23.62 | DVGT-1 54.55(同一推理系统) | 相对降低 56.7% |
| 视频级轨迹估计 nuScenes(PGO+LM) | ATE↓ (cm) | 17.48 | DVGT-1 30.54(同一推理系统) | 相对降低 42.8% |
| PAI 几何(1,253 段,PGO+LM) | ATE↓ / rig mAA@15↑ | 52.75 cm / 88.71% | 内部微调 VGGT(拼接)111.12 cm / 42.50% | ATE 降低 52.5%,rig mAA@15 提升逾一倍 |
| 语义占用 OpenOccupancy | IoU↑ / mIoU↑ | 27.4 / 18.1 | SPSC-temporal 25.5 / 16.2(次优) | +1.9 IoU / +1.9 mIoU |
| 高斯场景重建(内部 99 段基准) | PSNR↑ / SSIM↑(总体) | 23.94 dB / 0.80(自预测位姿+轨迹) | Instant NuRec 22.66 dB / 0.78(真值位姿) | +1.28 dB PSNR / +0.02 SSIM |
| lidarless NuRec 重建工作流 | 端到端耗时(小时/段) | 3.7 | 无 Foundation4D 16.0 | 4.3× 加速 |
局限与改进
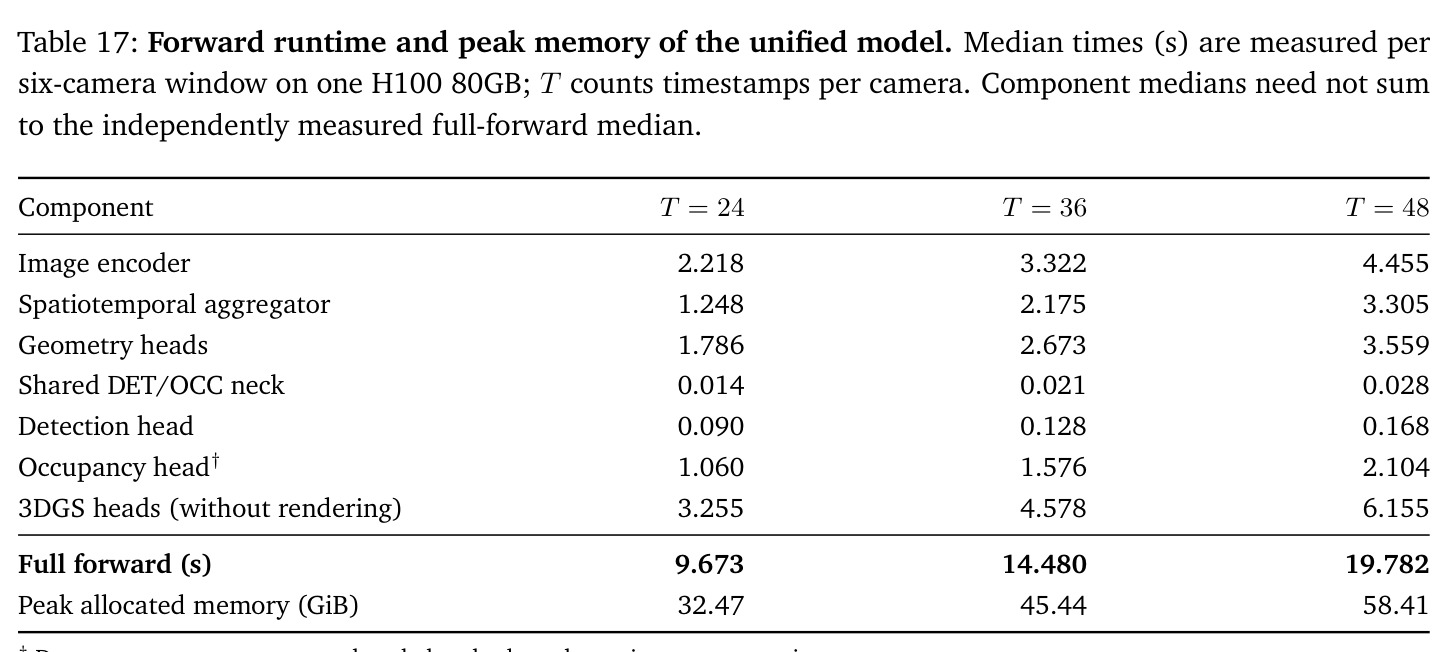
作者明确承认的局限:联合训练并非总是互益——几何+占用的占用 mIoU 为 11.82%,反而高于三任务联合的 11.53%,说明任务权重与数据采样策略仍未调优,而测试新配方的成本高昂(感知预训练约 18 天、高斯阶段再 9 天,64 张 H100);深度在远距离与物体边界处误差增大;异步曝光使 rig 监督可能把固定标定与帧间自车运动混在一起,轨迹插值无法消除这一歧义;拥挤和远距离场景的漏检与置信度波动导致轨迹碎片化;占用在远距离退化、稀有类易错、相邻帧预测抖动。我的补充观察:(1)推理开销巨大——6 相机 48 时刻单窗口前向 19.78 s、峰值显存 58.41 GiB,只适合离线分析,无法满足车载实时性,文中也没有给出在线流式方案;(2)高斯分支在动态目标的新视角外推上明显变弱(外推动态区域 PSNR 15.84 dB,甚至低于 Instant NuRec 的 17.71 dB),说明演员轨迹误差是动态重建瓶颈;(3)各基准的窗口划分、类别集、ROI 与匹配阈值互不相同(论文自己也强调 PAI mAP 不能与 nuScenes 直接对比),跨基准数字不可互比,社区横向比较有一定门槛;(4)占用采用 BEV 中间表征、高度维只在输出展开,可能牺牲了悬空/多层结构的建模能力。
独立分析的弱点
独立分析出的弱点与改进方向:(1)远距离感知塌陷——检测 108–200 m mAP 仅 11.16%、占用 50–100 m mIoU 仅 6.9%、深度 >60 m 仍是误差最大区间,改进方向是远焦-广角跨相机特征增强、按距离重加权的损失或专门的远程稀疏体素头。(2)任务干扰非单调——三任务联合反而不如 GEO+OCC 的占用 mIoU,方向是引入不确定性加权(Kendall 式)、GradNorm 类动态权重或梯度手术,并按任务分组做数据采样。(3)推理时延与显存——3DGS 头独占约 1/3 前向时间(T=48 时 6.155 s),可对高斯头做 token 剪枝/蒸馏,或改用滑动窗口缓存(DVGT-2 式)实现流式增量推理。(4)rig 监督歧义——异步相机下静态标定混入帧间运动,可在训练中显式建模逐相机曝光时刻差,或加入自监督重投影一致性约束。(5)跟踪碎片化——两阶段重连依赖固定 gap 阈值(24/50 帧),可改用学习式关联(MPNTrack/SUSHI 式消息传递)并与检测置信度联合优化。(6)动态外推渲染差——演员运动外推仅靠匀速轨迹插值,可加入短时未来运动预测头、可变形高斯或逐演员速度场。(7)训练与数据封闭——三个内部数据集不公开,社区只能复现微调而无法复现预训练,可在公开数据(Waymo/nuScenes/ZOD)上做开源复刻。
未来方向
作者提出的方向:改进多任务权重与数据采样以获得更一致的联合收益;研究感知与高斯头从头联合训练以及几何监督与渲染监督的相互作用;改善稀有类覆盖与时序一致性以抑制占用预测抖动;提升远距离深度与拥挤场景的跟踪稳定性。基于本文成果可自然延伸的研究:(1)流式化——把 PGO 的全局优化改为带缓存的增量位姿图,使模型可在线运行,衔接 DVGT-2 的滑窗思路,向车载部署靠拢;(2)与 SLAM 融合——当前 PGO 无闭环因子,可加入基于聚合器特征的闭环检测与重定位,支撑更大空间范围的地图构建;(3)占用-高斯统一——用语义高斯基元(GaussianFormer 式)替代 BEV 占用头,让一个表征同时服务渲染与占用监督,也可能缓解 0.2 m 分辨率与显存的矛盾;(4)蒸馏部署——参照 LiAuto-GeoX 把统一模型蒸馏成车载可用的紧凑学生网络;(5)利用 PAI 占用标签中的逐体素 3D 速度,做占用-预测联合任务,服务端到端规划;(6)把 Foundation4D 先验推广到更多下游重建表示(NeRF、网格、SDF)与仿真闭环测试,形成「感知即重建基础设施」的完整工具链。
复现评估
复现评估:数据方面,PAI 数据集与 PAI-Foundation4D 基准(1,253 段,含稠密深度、0.1 m 占用与逐体素速度标签)已发布,nuScenes/Waymo/OpenOccupancy 均为公开数据,论文对评测协议(48 帧窗口、整段单一 Sim(3) 对齐、距离分层、center-distance HOTA)描述完整。模型与代码方面,写作时未见随文开源的统一模型权重或训练代码;三个内部数据集 NRE/PlanNet/MLMCF(合计约 695 小时)不公开,完整预训练不可复现——需要 64 张 H100 训练 18+9 天。可行的复现路径:(a) 微调实验可承受——nuScenes 检测仅 10k 迭代(batch 32、lr 4.5e-4)、Waymo/nuScenes 几何微调 20k 迭代、OpenOccupancy 30k 迭代,单机 8 卡 H100 量级即可,但前提是作者开源 backbone 初始化;(b) 视频级推理系统完全无学习成分——IRLS Sim(3) 拼接、L-BFGS 位姿图、Kalman/RTS 均可按第 5 节公式直接实现;(c) 标注管线依赖内部语义分割模型(不公开)与 SAM 2(公开),占用标签只能近似复现。总体判断:基准与评测协议复现度高,模型本身复现度低、难度高,最佳起点是在公开基准上复现微调结果与推理系统。
论文图表
论文首页示例图:同一街景的多相机 RGB 输入与模型输出的 3D 检测框、稠密深度、语义占用、3D 高斯渲染并排展示,直观呈现「一个模型、多种互补场景表征」。
作为总览图,它一图定义了论文的全部输出空间与任务范围,让读者先建立「统一感知+重建」的整体印象再进入细节。
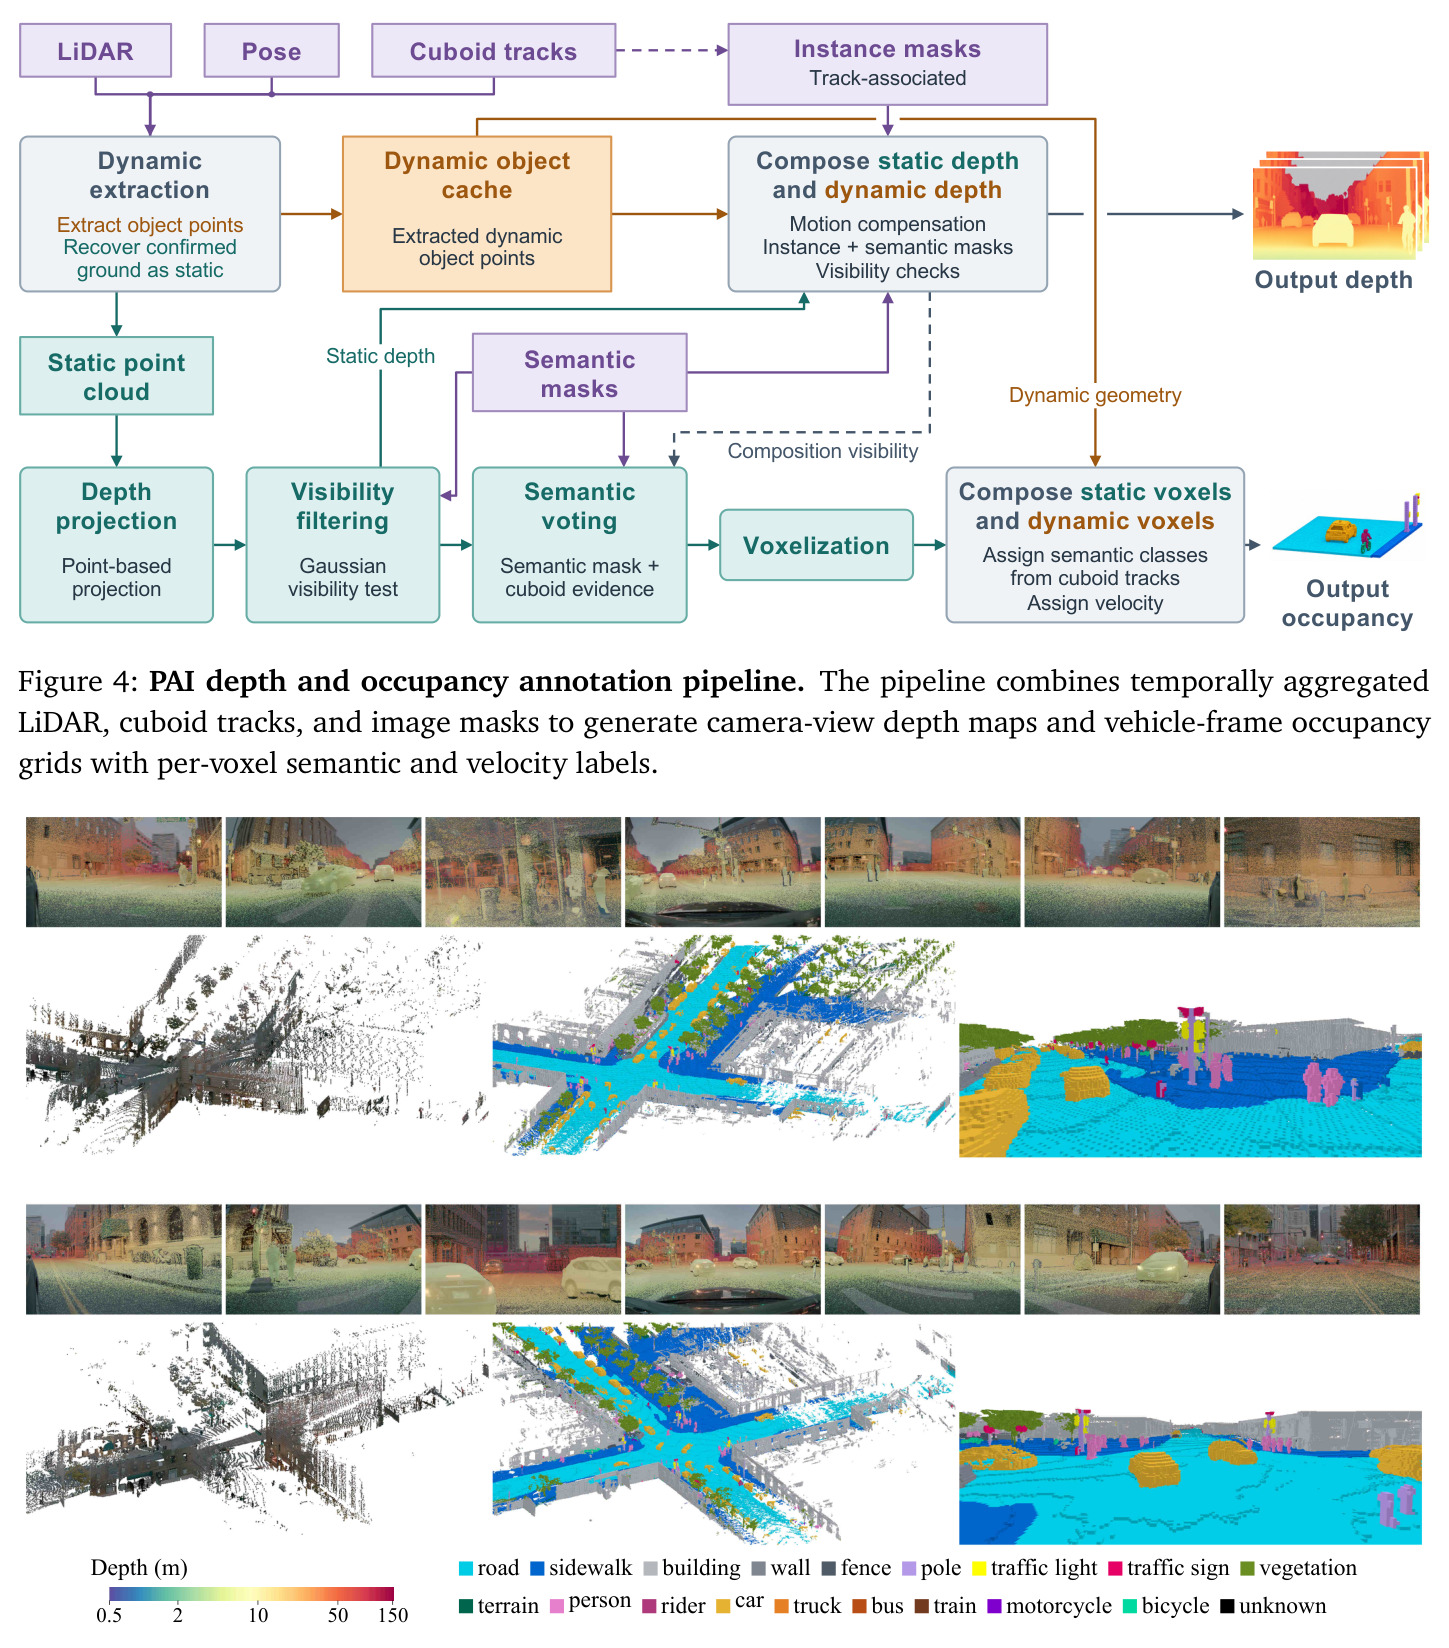
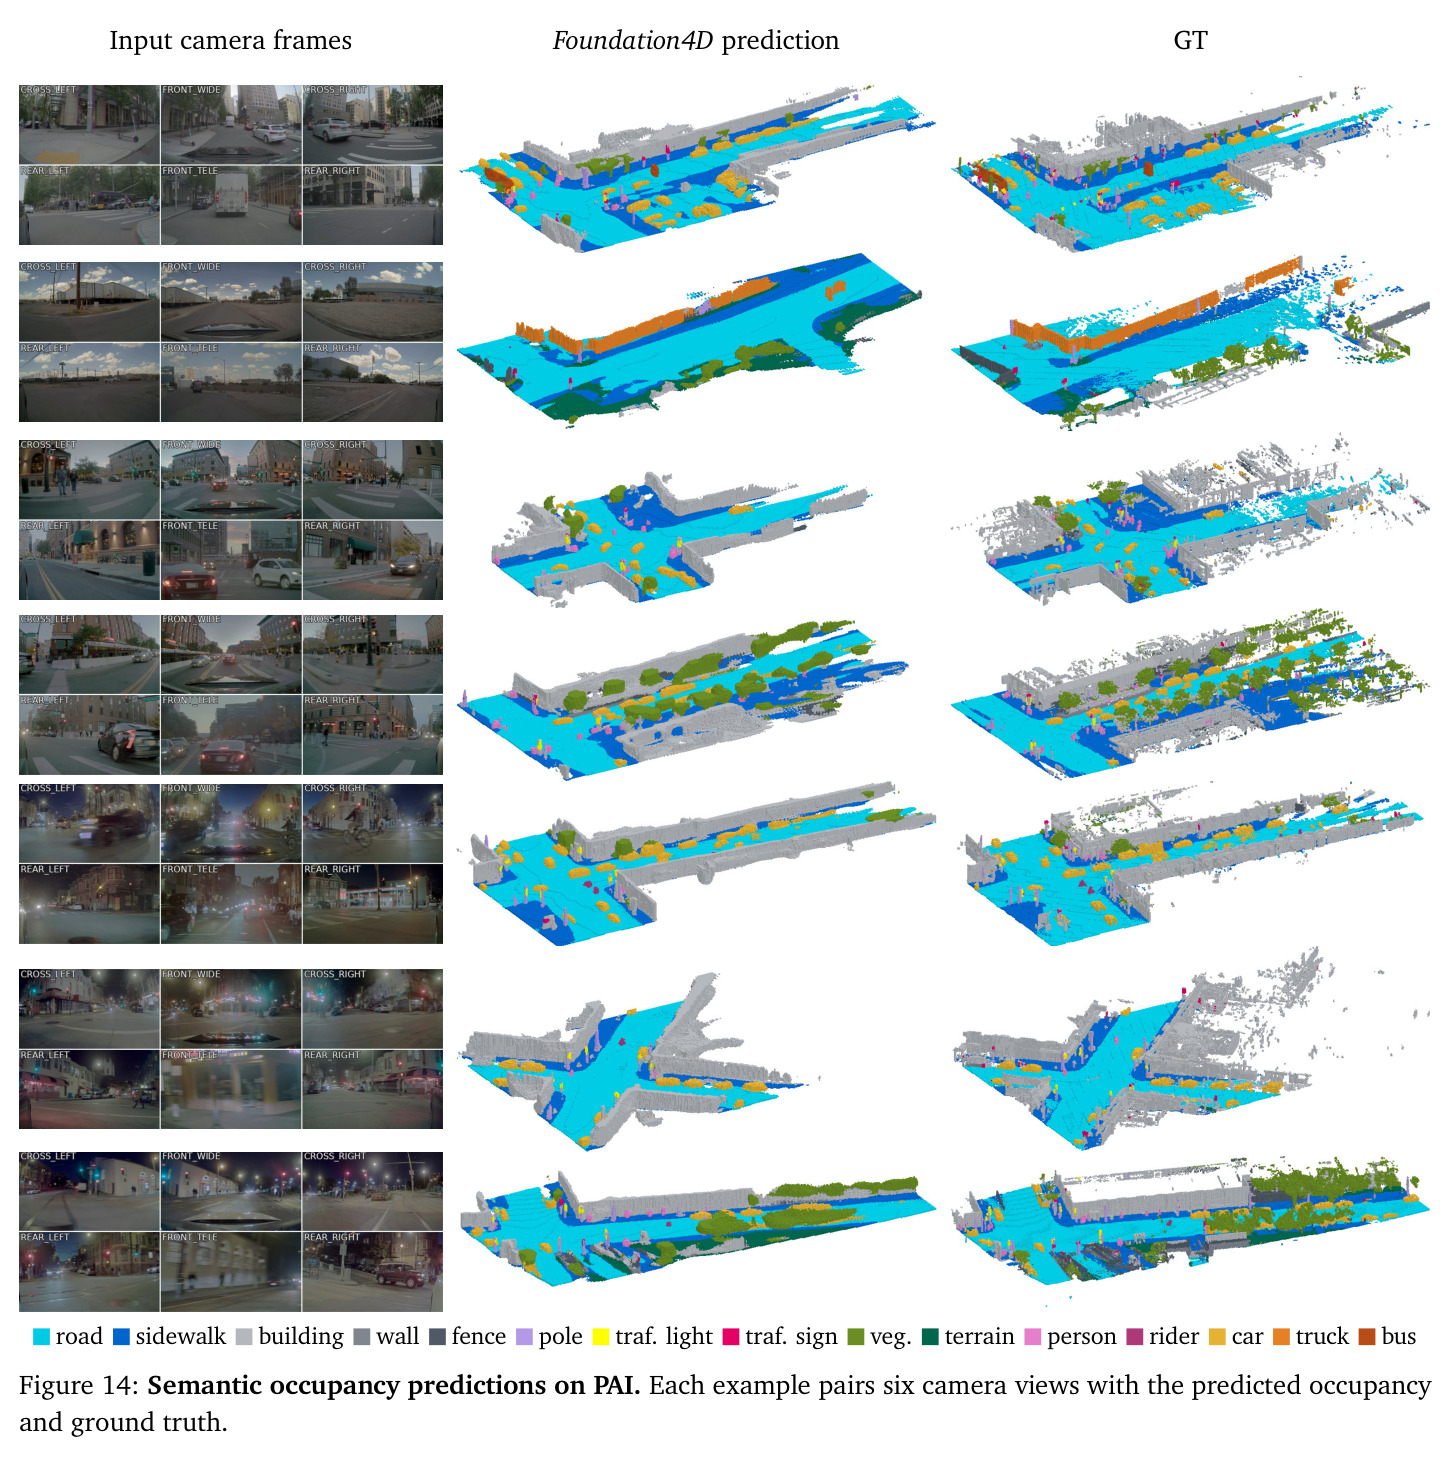
两段 PAI 样例的多相机深度叠加图、按 RGB 着色的反投影点云、语义占用侧视图与前视图,附 0.5–150 m 深度色标与全部语义类别图例。
直观展示标注的覆盖范围与质量,是判断 PAI-Foundation4D 基准标注水平的直接视觉证据。
整段视频级推理(DVGT-1 与本文接入同一视频推理系统,48 帧窗口 5 帧重叠):PGO+LM 下 Waymo ATE 23.62 vs 54.55 cm、nuScenes 17.48 vs 30.54 cm;rig mAA@15 达 83.54%/99.22%。
证明视频级组装管线的价值与 rig 标定估计能力,是与 DVGT-1 之间最公平的同系统对比。
真值框+真值 ID(oracle)下用预测位姿 HOTA 从 100.0 降至 83.8(隔离位姿引起的定位误差);完整管线从 43.6 降至 40.5(相对 -7.1%),说明跟踪管线对位姿误差稳健。
回答「不用真值位姿代价多大」这一实用问题,是模型自洽性(自预测位姿驱动跟踪)的关键验证。