TauIndianBankBench:面向流程与动作的印度银行业工具调用对话助手评测基准 TauIndianBankBench: Procedure-Aware, Action-Oriented Evaluation of Tool-Using Conversational Agents
在模拟印度银行中用动作检查补足终态检查,揪出跳过必经步骤却蒙混过关的客服模型
前置知识
τ-bench / τ²-bench 评测框架
τ-bench(Yao et al., 2025)把 LLM 放进客服场景:它与一个由另一个 LLM 扮演的模拟用户多轮对话,并在共享数据库上调用领域工具(航空、零售等),任务通过的判定是最终数据库与预期一致且必要信息已传达给用户。τ²-bench(Barres et al., 2026)加入双控制(模拟用户也能操作共享状态)与动作匹配(参考解中的调用须出现在会话里,先在部分电信任务上试用)。本文就是这一家族的一个新领域。
本文的会话协议、评分协议和数据格式都建立在 τ²-bench 框架上,不理解它就无法理解终态检查从哪里继承、动作检查到底扩展了什么。
金标准链与 Oracle 重放
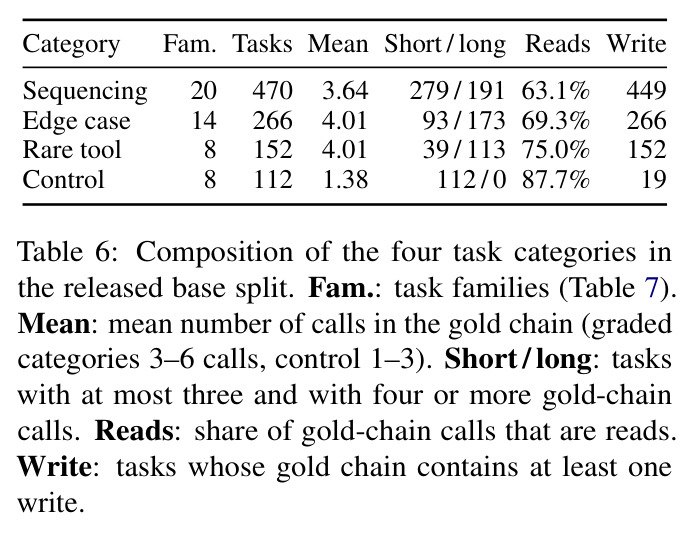
金标准链(gold chain)是解决某个请求的参考工具调用序列,本文中平均 3.54 个调用(1–6 个),每个调用带参数匹配规则:可指定只比较哪些参数、只比工具名,或比较全部参数但忽略运行相关标识符与自由文本。评分时在相同随机种子、相同初始银行状态上重放金链,得到预期的终态记录。
它是两套检查共同的参照物:终态检查靠重放它产生期望数据库,动作检查靠它定义什么是必经调用、什么是合法写操作。
终态检查(final-state check)
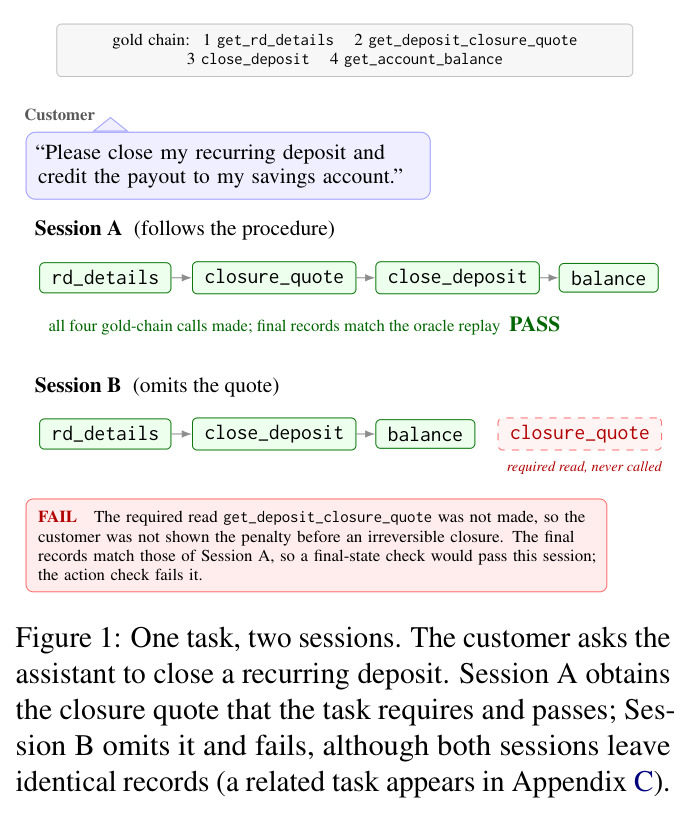
只看对话结束后的数据库:把会话最终记录与重放金链得到的预期记录各自归一化(剔除随机生成的引用、下载链接、自由文本便签,忽略按生成标识符索引的集合内顺序),再做哈希比对,内容一致才算通过。它只观察结果——只读调用不改变任何记录,因此被漏掉的读取步骤对它完全不可见。
这是 τ-bench 家族的传统判分方式,也是本文要批判的对象:论文用数据证明它系统性放行程序性违规。
写纯性(write purity)
动作检查的第二条规则:会话中出现的每个写调用必须能对应金链中的某个写调用(工具名与参数匹配)。关闭错误的存款、冻结客户没提名的卡片都判失败;即使助手事后撤销该改动也照样判负,因为改动生效期间客户已经受了影响。它同时封死了把所有可用工具挨个调一遍的暴力通过策略。
这是防止刷分与保护客户的关键机制,也是动作检查区别于 τ²-bench 原 action matching 的两大新增之一。
模拟用户与 pass$^k$
模拟客户由固定 LLM(本文用 MiniMax-M2.7,温度 0)扮演,持有人设、场景与分步指令(对助手不可见),逐步透露信息且从不点名工具。由于对话本身是随机的,同一任务可运行 k 次来估计 pass$^k$——即 k 次尝试全部通过的概率;本文的参考结果用单次尝试,另以第二次运行分析方差。
分数同时依赖助手与模拟器:这既是论文的复现协议(对比必须三要素一致),也是作者自己承认的首要局限。
研究动机
印度银行长期依赖 FAQ 页面和脚本化聊天机器人服务客户。LLM 助手理论上可以更快响应并真正执行请求(拦截卡片、购买存款、关闭账户),但前提是它既给出正确信息、又遵守银行书面规程。这些规程规定了必经步骤:关闭定期存款前必须先出具结清报价单,让客户在不可逆操作前看到违约金;为客户购买可能超出余额的存款前必须核对最低余额规则;拦截卡片前必须先查卡片状态。问题在于现有基准(τ-bench、τ²-bench 等)通常只检查对话结束后的最终数据库记录。而本文语料中 962/1000 个任务至少需要一个只读调用、114 个任务完全不需要写调用——大量必经步骤是读取,不会留下任何记录痕迹。一个跳过这些步骤的助手,最终记录依然正确,终态检查照样判过。正如论文引用的 reward hacking 研究(Skalse et al., 2022)所警示的:能被不干活满足的指标迟早会被钻空子。因此银行在训练模型前后,都无法用这类基准可靠衡量模型对流程的遵循程度。
本文的目标是本文要构建一个面向印度零售银行客服的动作导向基准 TauIndianBankBench,并用它量化开源模型遵循规程的真实水平。具体目标有四:(1) 搭建完整可执行的环境——944 个合成客户的数据库(账户、卡片、存款、贷款、standing instruction、交易历史)、34 个工具(33 个服务工具加 1 个人工转接)、24 份知识库文档与配套书面政策;(2) 从政策派生 1000 个任务(50 个任务族、四个难度类别),每个任务附带平均 3.54 个调用的金标准链;(3) 定义双重通过判据——终态检查加动作检查(所有必经调用出现、无未经请求的写操作),两者同时通过才计 1 分;(4) 给出可量化结论:证明终态检查单独使用会让每个模型的通过率虚高 6.5–12.0 个百分点,并提供 base(1000)/lite(200)/train(150)/test(50)四个数据划分,供领域适配的训练前后对比。
与已有工作不同的是,本文的切入角度是结果检查与过程检查之间的互补缺口。已有工作各占一角:AppWorld 检查未请求的额外改动(collateral damage)、Thinkingbox 拒绝业务工作流终态中的错误/缺失/多余效果,但它们只能看见代理改了什么,看不见不改变记录的必需步骤;JourneyBench 缺一个调用就计零分,但工具返回预生成响应,无法验证调用是否真的产生了正确记录;ToolSandbox 最接近,检查里程碑(含特定工具调用)和雷区,但里程碑按与预期会话的相似度给部分分、雷区要逐任务手写;ST-WebAgentBench、SOP-Bench、IntellAgent 做政策合规评分却不提供可执行的状态验证。本文把它们没有组合起来的几件事同时做到:共享数据库上的终态检查、要求政策规定读取必须发生的动作检查、封死乱写与全调一遍的写纯性;并通过数据依赖和客户分步指令让调用顺序成为设计出来的可检验约束。加上把印度监管明文规定的步骤(RBI 2016 KYC、利息 TDS、政府储蓄计划资格)转成必经步骤,填补了印度零售银行客服合规评测的空白。
核心方法
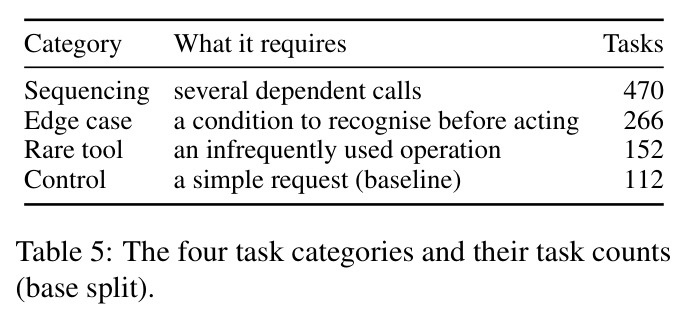
直觉上这像考驾照:只看你是否把车开到终点不够,还要看你有没有打转向灯、系安全带——不做这些动作也能到达终点,但那样的通过是假的。TauIndianBankBench 把这个直觉工程化为一次完整评测:在 τ²-bench 框架中,被测助手与一个由 MiniMax-M2.7(温度 0)扮演的模拟客户多轮对话,在合成银行数据库上调用 34 个工具中的若干个。每个任务预置一条金标准链(gold chain):解决该请求的参考工具调用序列,平均 3.54 个调用(1–6 个),并带参数匹配规则。评分完全确定性、无需 LLM 裁判:终态检查在相同种子的初始状态上重放金链得到预期记录,与会话最终记录各自归一化后做哈希比对;动作检查则扫描会话轨迹,要求金链中的每个调用——包括不改变任何记录的读取——都出现过,且任何不匹配金链写调用的写操作都导致失败。两项检查都通过才得 1 分,没有部分分:四个必经调用做了三个,与什么都不做同样得 0。任务分四类:sequencing(最多六个依赖调用)、edge case(先要识别异常条件)、rare tool(围绕罕用操作)、control(简单请求,作内部基线)。
核心创新是动作检查(action check),它在 τ²-bench 的 action matching 之上加了两条约束,直击终态检查的结构性盲区。第一,金链包含政策要求的读取:凡是书面政策规定的必经步骤——结清报价、最低余额规则、卡片状态查询——即使不改任何记录也必须出现在会话里。论文的标志性例子(Figure 1):会话 B 漏掉 get_deposit_closure_quote 直接结清定期存款,最终记录与会话 A 完全一致,终态检查会放行,但客户在不可逆结清前没看到违约金;动作检查判 B 失败。第二,写纯性:会话中每个写调用必须匹配金链中的某个写调用,关闭错误的存款或冻结客户没提的卡片都判负,哪怕事后撤销——因为改动生效期间客户已受影响;这也封死了把所有工具挨个调一遍的暴力通过法。与已有方法的本质区别:JourneyBench 要求严格但工具是假执行;ToolSandbox 给里程碑部分分;AppWorld 只查多余改动。本文是唯一同时做到真执行、必经读取、写纯性、严格通过/失败四点的设计,且两检查互不替代——对最强模型只有动作检查能抓住多数违规,对最弱模型只有终态检查能抓住多数错误。
方法步骤详情
任务构建:由 LLM 对着活环境起草任务,须过四道过滤器——同族首条消息多样性(任一首条消息在同族占比不超过 40% 且至少 8 条不同,防止模型靠识别任务族得分);分级任务金链至少 3 个调用;train/test 无重叠;金链重放必须通过双检查(保证每个发布任务可解且判据自洽)。会话协议:任务固定会话日期、指明登录客户但隐藏其档案,助手须用工具检索账户、卡片、产品;模拟客户持有人设与分步指令(对助手不可见),逐步透露信息、不点名工具、会要求补做跳过的步骤;会话以客户确认解决、助手结束或转人工终止,200 步上限或 10 次工具调用失败即 0 分。评分(Algorithm 1):先检查会话正常终止(AGENT_STOP 或 USER_STOP);动作检查验证金链每一项都在会话调用中找到匹配(MATCH 按工具名与指定参数比较,忽略运行相关标识符与自由文本字段),且每个写调用都须对应金链写调用;终态检查在相同种子上重放金链,NORM 归一化双方记录后哈希比对。可信度审计:独立重实现的评分器在 600 个录制会话与全部 705 对工具调用上与发布版判定一致;打包评分器重打 5000 个会话全部复现原分;裁判模型不计入发布分数且在分歧上总是给更低分。
技术新颖性
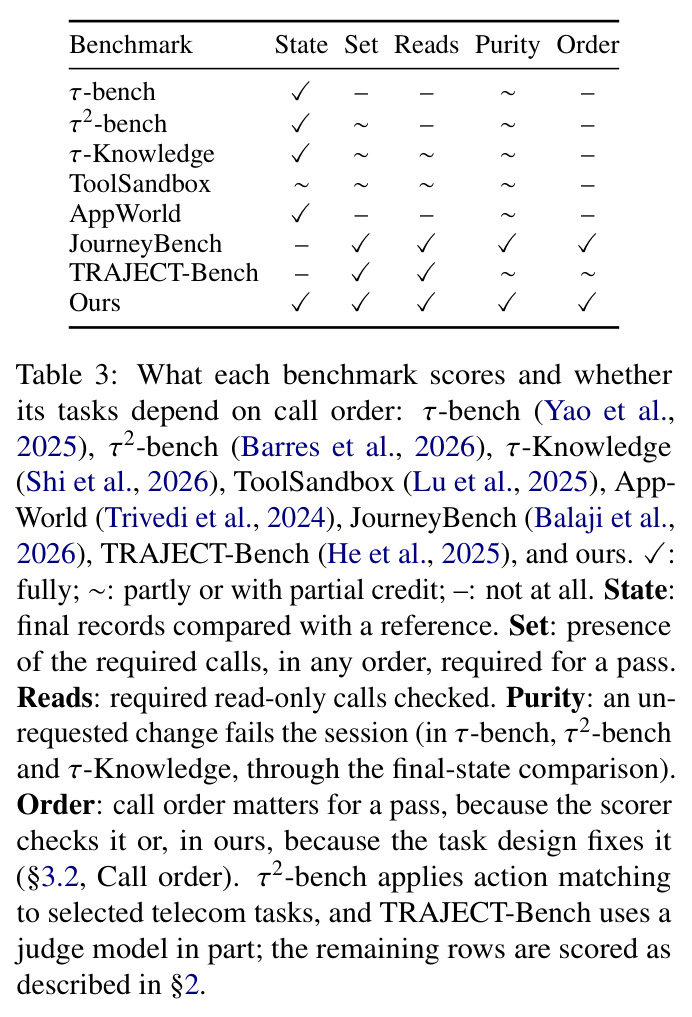
逐项对比(Table 3):τ-bench 只有终态检查;τ²-bench 在部分电信任务上做动作匹配,但不要求政策规定的读取、不查写纯性(靠终态比对间接兜底);τ-Knowledge 加入知识库检索;ToolSandbox 检查里程碑与雷区但给部分分、雷区需逐任务手写;AppWorld 查额外改动却看不见必需读取;JourneyBench 全序零分但工具返回预生成响应,无法验证记录正确性;TRAJECT-Bench 按参考轨迹评分但给相似度部分分。本文把五列(状态、集合、读取、纯性、顺序)全部打满:真执行加金链必经读取加写纯性加由任务设计固定的顺序约束,且全程确定性评分、无 LLM 裁判偏差——与 Zhu et al.(2025)的基准有效性清单对齐,并用两个证据自证效度:四个琐碎脚本代理全部 0 分,控制组通过率不随模型规模上升(说明分级类别考的是流程能力而非通用能力)。把印度监管条文转成可执行必经步骤,在金融评测中也是少见的合规视角。
实验结果
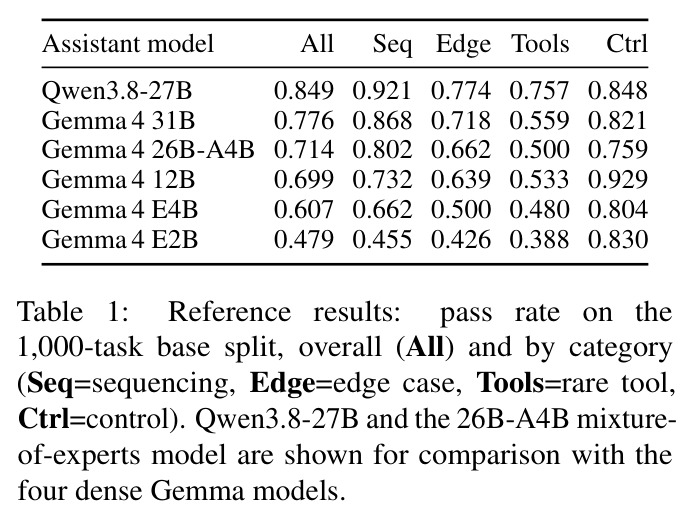
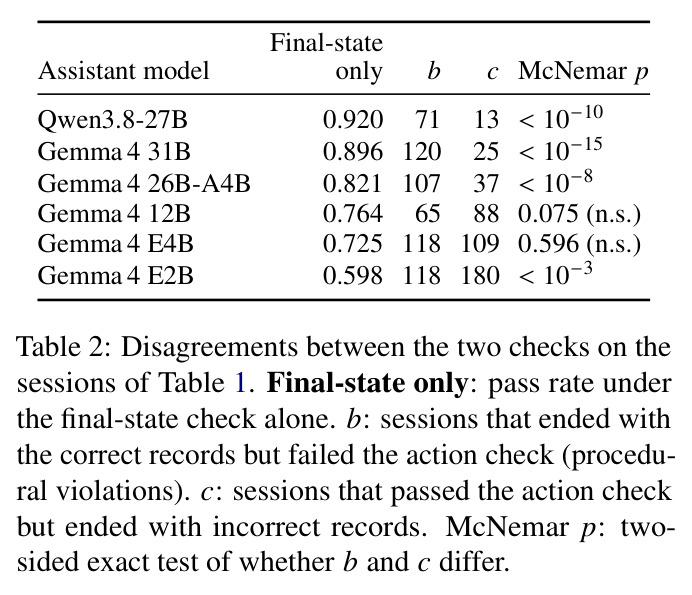
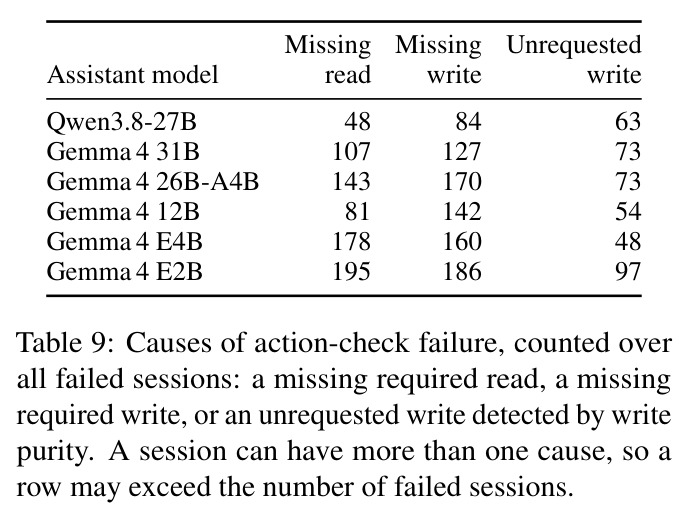
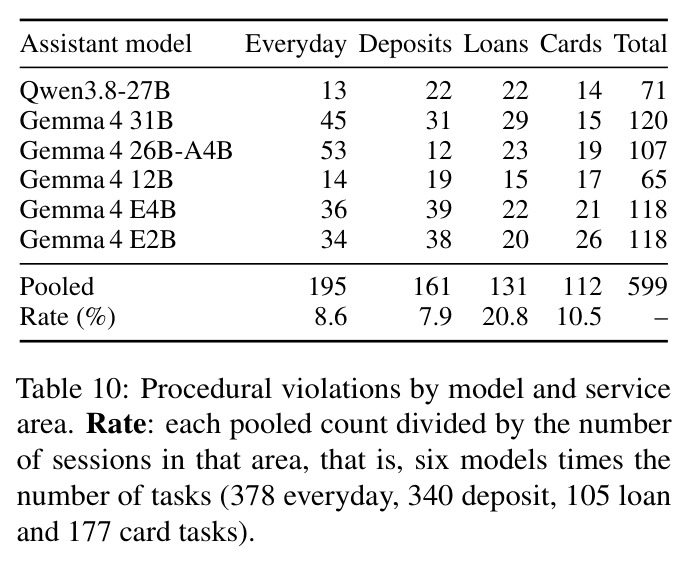
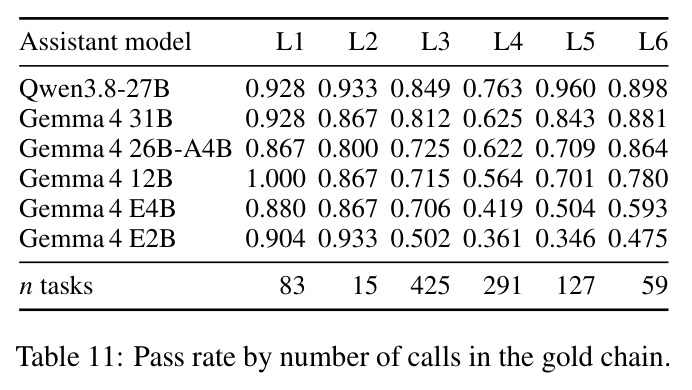
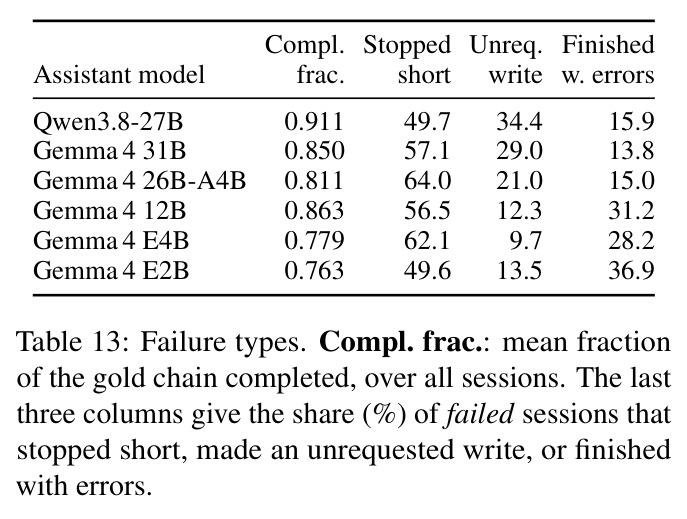
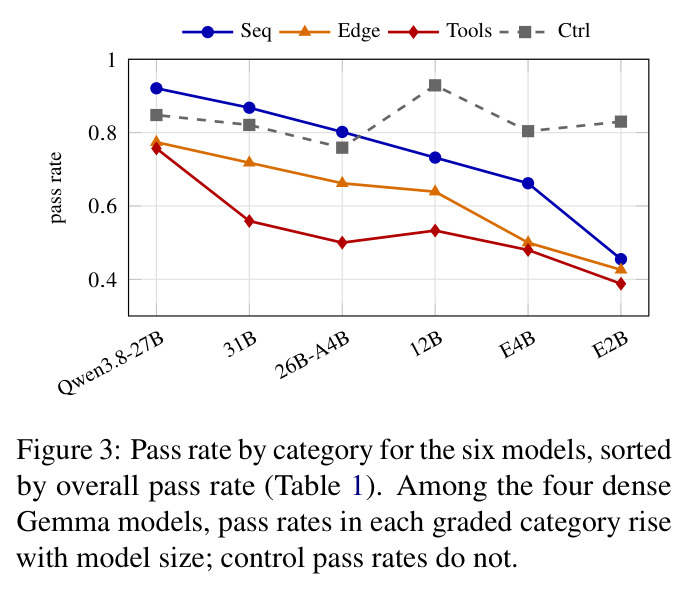
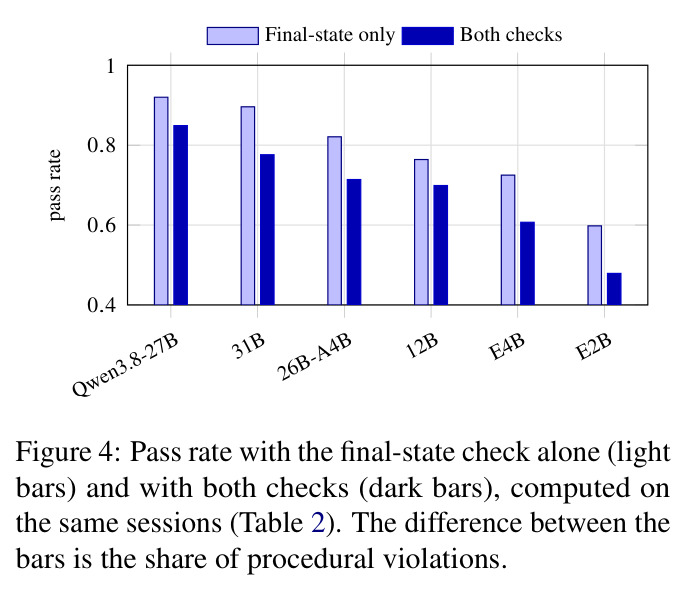
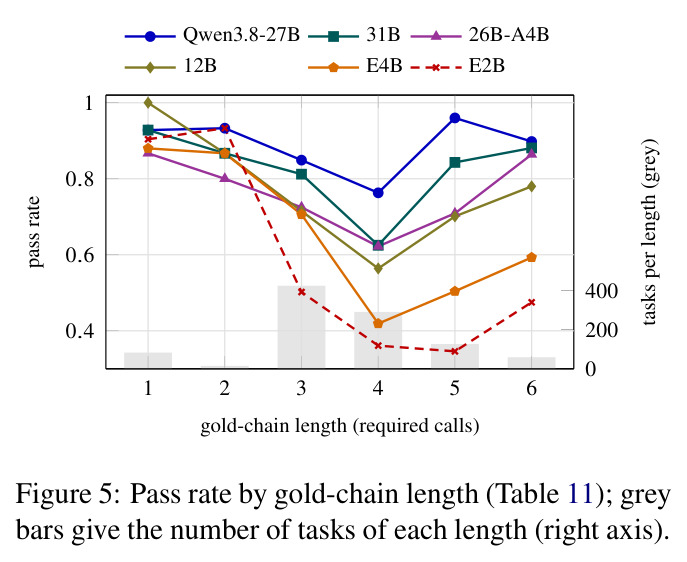
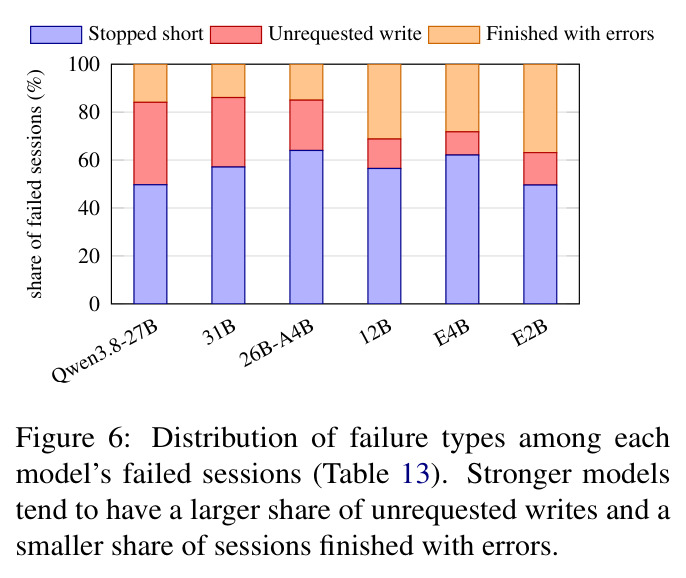
六模型在 1000 任务 base 划分上的参考结果(单次尝试,Wilson 95% 置信区间约 ±3 点):Qwen3.8-27B 以 0.849 居首;稠密 Gemma 4 严格随规模单调——31B 0.776 > 12B 0.699 > E4B 0.607 > E2B 0.479(每对 p<0.005),MoE 26B-A4B 0.714 介于其间。第一,终态检查单独使用时每个模型都被放行程序性违规,通过率虚高 6.5–12.0 个百分点(Qwen 0.920 对 0.849,E2B 0.598 对 0.479);失败原因中漏掉必需写在四个模型中最常见,未经请求写对 Qwen 最常见(63 次);贷款类任务违规率高达 20.8%(其余区域 7.9–10.5%),因为没有贷款工具是写操作,终态检查对该区域结构性失明。第二,两检查互补:三个最强模型中仅终态过而动作挂的会话远多于反向(71 对 13、120 对 25、107 对 37,均 p<10^-8);最弱的 E2B 反过来(118 对 180,p<10^-3),多数是调齐全部调用但记录错误;12B 与 E4B 无显著差异(p=0.075/0.596)。第三,类别区分度:sequencing 分离最大(0.455–0.921),rare tool 是全员最低分类别(Gemma 挤在 0.388–0.559,Qwen 领先 31B 0.198),edge case 介于其间(0.426–0.774)。第四,长度效应:四调用任务对除 E2B 外所有模型最难,强弱差距在五调用任务最大(0.614,单调用仅 0.024);E4B 短序列 0.810 跌至长序列 0.445,而三个最强模型波动不超过 0.086。第五,效度与稳定性:控制组(112 个简单任务)稠密 Gemma 在 0.804–0.929 无规模趋势、最高分是 12B(0.929);四个琐碎脚本代理全部 0 分;第二次运行各模型通过率变化不超过 2.7 点(但 14–26% 任务两次结果不同);平均金链完成率从 Qwen 的 0.911 递减到 E2B 的 0.763。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全量 base 1000 任务总通过率 | pass rate(双检查) | Qwen3.8-27B 0.849 | 最佳稠密 Gemma 4 31B 0.776 | +7.3 个百分点 |
| 终态检查单独评分 vs 双检查 | pass rate 差值 | 双检查 0.479–0.849(六模型) | 仅终态 0.598–0.920 | 单用终态虚高 6.5–12.0 个百分点 |
| Sequencing 多步依赖任务(470 个) | pass rate | Qwen3.8-27B 0.921 | Gemma 4 E2B 0.455 | 类别极差 46.6 点,区分度最大 |
| Edge case 边界条件任务(266 个) | pass rate | Qwen3.8-27B 0.774 | Gemma 4 E2B 0.426 | 全员低于各自 sequencing 成绩 |
| Rare tool 罕用工具任务(152 个) | pass rate | Qwen3.8-27B 0.757 | Gemma 4 E2B 0.388(Gemma 系挤在 0.388–0.559) | 全员最低分类别;Qwen 超 31B 达 0.198 |
| 贷款类任务程序性违规率 | 违规会话占比(六模型池化) | 20.8% | 其余三个服务区域 7.9–10.5% | 无贷款写工具导致终态检查对该区域盲视 |
| Control 简单请求(112 个) | pass rate | Gemma 4 12B 0.929(最高) | 稠密 Gemma 0.804–0.929,无规模趋势 | 反证分级类别衡量的是流程能力而非通用能力 |
局限与改进
作者承认四点:(1) 分数同时依赖助手与模拟客户(MiniMax-M2.7),模拟器自身错误率未测量,所有数字只在该模拟器下成立;(2) 数据全合成,边界情况频率反映生成分布而非真实银行流量;(3) v1.0.0 仅覆盖英语的印度零售银行,其他语言与领域留待后续;(4) 评估算力开销大——1000 场最多 200 步的双 LLM 多轮对话,估计 pass^k 还要乘以 k。我的补充观察:(1) 单一金链隐含唯一正确流程的假设,现实中某些只读步骤可有多种合法排列,尽管客户分步指令缓解了这一点,仍可能把合理变体判为失败;(2) 动作检查只验证调用出现与参数匹配,不验证助手是否把关键信息(违约金、利率)真的传达给客户——沟通断言由不计入分数的裁判覆盖,且一致率仅 87.5%;(3) 六个开源中小模型的选择使规模单调性等结论未必外推到前沿闭源模型;(4) 报告采用最确定性采样,但 14–26% 的任务在两次运行间翻转结果,单次尝试的排名稳健性有限。
独立分析的弱点
(1) 单一金链与流程多样性:真实银行流程常有等价变体(先查余额还是先查卡片状态不影响合规),当前判据可能惩罚合理策略——改进方向是把金链扩展为偏序/DAG,用图包含关系验证必经步骤。(2) 读取调用的参数验证较弱:MATCH 忽略自由文本与运行相关字段,理论上助手查询错误账户也可能匹配成功——改进方向是对读取增加返回值一致性抽查。(3) 沟通质量不计分:客户是否被告知违约金等关键信息只由不参与分数的裁判断言覆盖,调了工具但没告诉客户仍可得分——改进方向是把 communicate_info 断言纳入通过判据或单独报告沟通分。(4) 模拟客户单一:所有结论条件于 MiniMax-M2.7,而 Seshadri et al.(2026)已证明 LLM 模拟用户是人类用户的不可靠代理——改进方向是多模拟器集成并报告分数区间。(5) 英语单语:印度客服大量多语言场景缺位——改进方向是接入 Indic 语言任务(可借鉴 BhashaBench)。(6) 全量评估算力贵:lite 划分只有 200 任务且与 base 分数不可比,快速迭代困难——改进方向是提供分层子采样并给出估计精度下界。
未来方向
作者提出的方向:把基准扩展到其他语言与领域;利用 train(150)/test(50)划分做领域适配的训练前后测量;建议所有受监管领域的服务助手基准都报告动作检查。基于成果可延伸的方向:(1) 把金链从手工指定升级为从书面政策自动编译的可配置规格语言,政策改动即可重新生成判据;(2) 用 pass^k 与多次尝试系统分析可靠性与能力的权衡(目前仅有单次加一次复跑);(3) 引入 FraudBench 风格的对抗性客户,测试写纯性在诱导与压力下的鲁棒性(edge case 已有确认压力族但规模小);(4) 与过程级奖励结合——用金链做步骤级监督训练奖励模型或直接做 RL(呼应 Lightman et al. 2024);(5) 补齐贷款区域的写工具,消除终态检查在该区域的结构性盲区,并研究更多服务区域;(6) 引入非协作用户(Shim et al. 2026)测量流程遵循在用户不配合时的退化;(7) 把语音/多模态渠道纳入,因为印度客服 IVR 场景普遍。
复现评估
开源情况很好:代码在 github.com/npci/TauIndianBankBench,数据在 HuggingFace(NPCI/tau-indian-banking),以 τ²-bench 标准域形式发布,可对接任何 OpenAI 兼容端点。数据划分齐全(base/lite/train/test),附录给出完整任务 JSON 示例(rl_tlfdmat_0197)、评分伪代码(Algorithm 1)和全部 50 个任务族的金链模式。确定性方面做得扎实:评分器经独立重实现(600 会话、705 对调用完全一致)和 5000 会话重打双重审计,客户模拟器固定为 MiniMax-M2.7 温度 0 可复现。算力需求:被测模型均为开源权重(Gemma 4 E2B/E4B/12B/31B/26B-A4B、Qwen3.8-27B),单次 base 全量等于 1000 场最多 200 步的双模型推理对话;自托管 27B/31B 需要多卡,或走 API 承担推理费用。复现难度中等偏低:环境与评分确定、无需训练,主要成本是推理预算;建议开发期用 lite(200)划分、最终报告用 base。
论文图表
完整展示一个发布任务的 JSON 结构:老年客户想存 12 个月 20 万卢比定期但须先看按 7.3% 利率预测的到期值;user_scenario 含人设与对助手不可见的分步指令;金链五个调用(查余额→查利率卡→计算到期值→create_fd→再查余额),其中只有 create_fd 改记录;compare_args 限定两个调用的参数匹配字段,reward_basis 为 ACTION 与 DB。
让读者看到任务的真实数据格式:金链如何编码必经读取与参数匹配,是理解评测可复现性与实现自己任务的关键。