CulturalRiddles:多语言文化谜语基准 CulturalRiddles: A Multicultural Benchmark of Riddles
167位母语者共创62社区文化谜语基准,前沿模型在最难社区准确率不超过22%
前置知识
溯因推理(Abductive Reasoning)
溯因推理是从一组观察线索出发,推断出能最好解释所有线索的假设的推理方式。与演绎推理(结论必然成立)和归纳推理(从样本推规律)不同,溯因推理需要在多个候选解释中权衡选择。解谜语是典型场景:谜面给出多条线索,解题者要综合各线索找到唯一吻合的答案。
论文的核心论点是:文化理解不只是记住文化事实,而是在具体语境中运用事实进行溯因推理,谜语正是检验这种组合推理能力的天然载体。
Cohen's κ(Kappa 一致性系数)
Cohen's κ 衡量两个评分者之间扣除随机一致后的一致程度,定义为 $\kappa = (p_o - p_e)/(1 - p_e)$,其中 $p_o$ 是观察一致率,$p_e$ 是随机期望一致率。取值范围通常在 0 到 1 之间,0.6-0.8 表示相当好的一致性,0.8 以上接近完美一致。对有序评分(如 0-3 分)可用加权 κ。
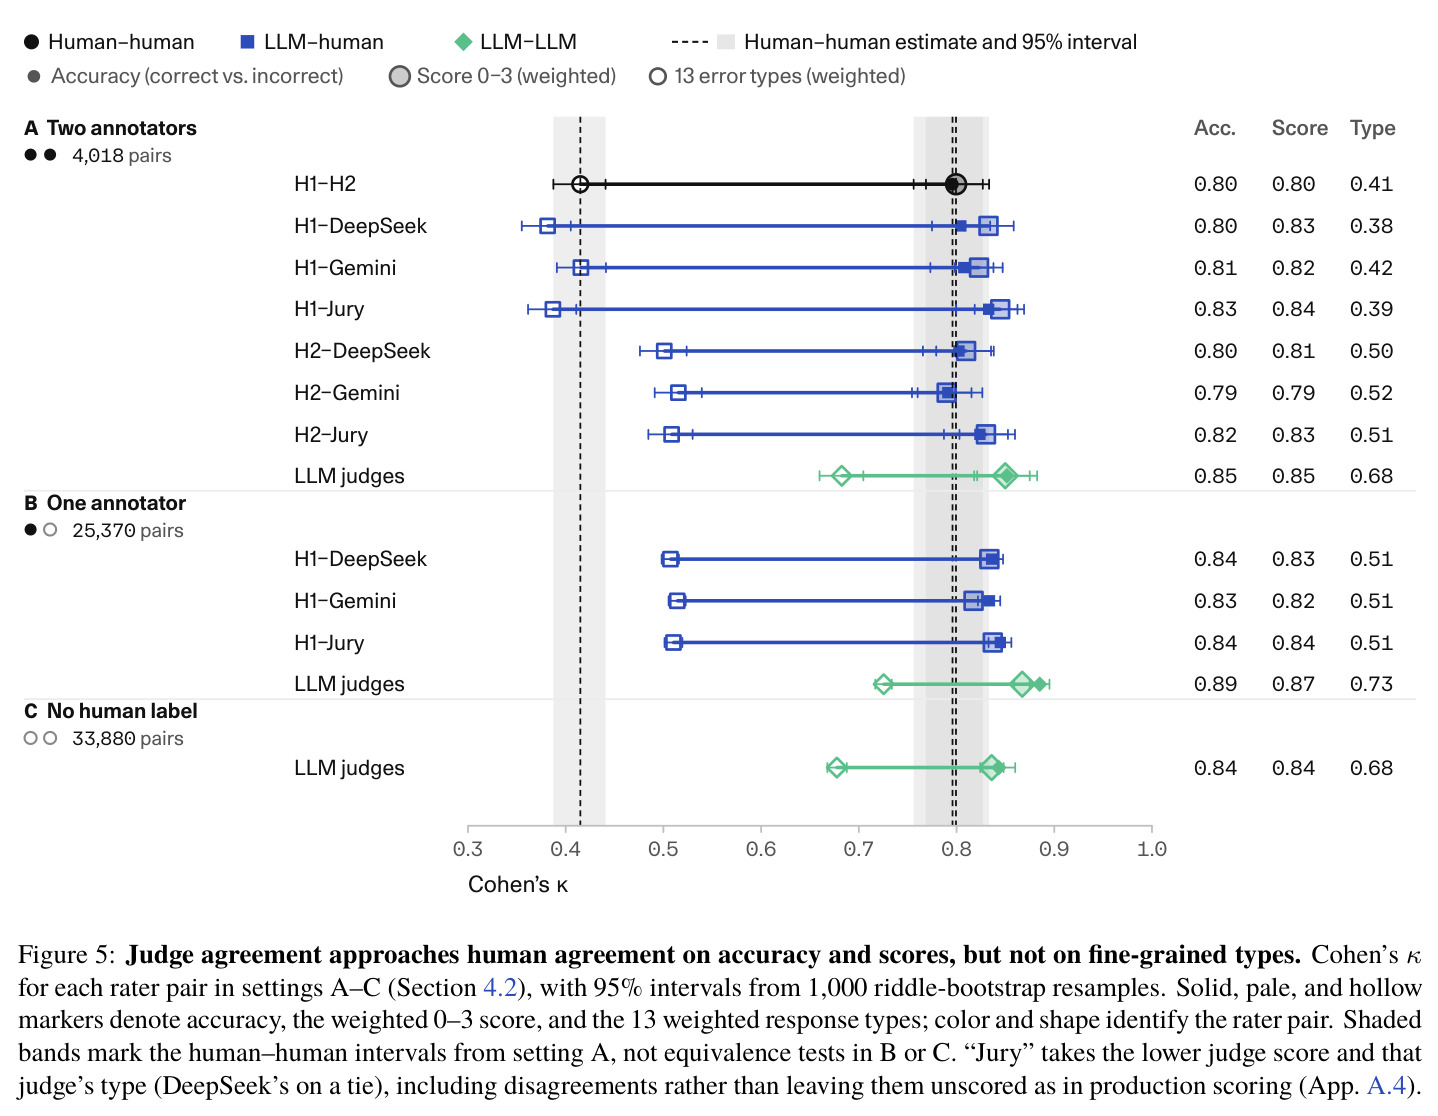
本文用 κ 验证 LLM 评审是否可靠:人类评审间准确率 κ=0.80,LLM 评审与人类 κ=0.79-0.84,这是论文声称「机器评审可替代人类」的关键证据。
交叉随机效应 Logistic 模型
一种统计模型,把回答正确与否建模为多个因素的叠加效应,每个因素(模型、谜题、语言、社区、主题)作为随机效应放在对数几率(log-odds)尺度上。方差分解可以量化每个因素对结果差异的贡献比例。交叉指各因素不必嵌套,例如同一语言可跨多个国家。
论文用它回答「困难来自哪里」:模型差异只占总方差 38%,谜题本身占基准方差的 60%,说明难度主要由谜题个体决定而非模型能力差异。
LLM 评审团(LLM Jury)
用多个 LLM 作为自动评分员,对开放式答案打分。本文采用双评审制:Gemini 3.5 Flash 和 DeepSeek V4.1 Flash 各自独立评分,只有两者给出的 0-3 分一致时才采纳该分数,分歧样本保持未评分。评审提示词在留出集上开发,并用 25,370 条人工标注样本验证其与人类的一致性。
开放式生成任务的评分不可能全靠人工,评审团是规模化评测的关键,但其偏见(如对强模型宽容)直接影响结论可信度。
语言资源水平
指一种语言在网络上可用文本量的多少,本文用 Common Crawl 页面数划分:高资源 ≥1000 万页,中资源 10 万-1000 万页,低资源 1 万-10 万页,极低资源 <1 万页。方言继承其宏观语言的计数。它近似反映该语言在 LLM 训练数据中的代表性。
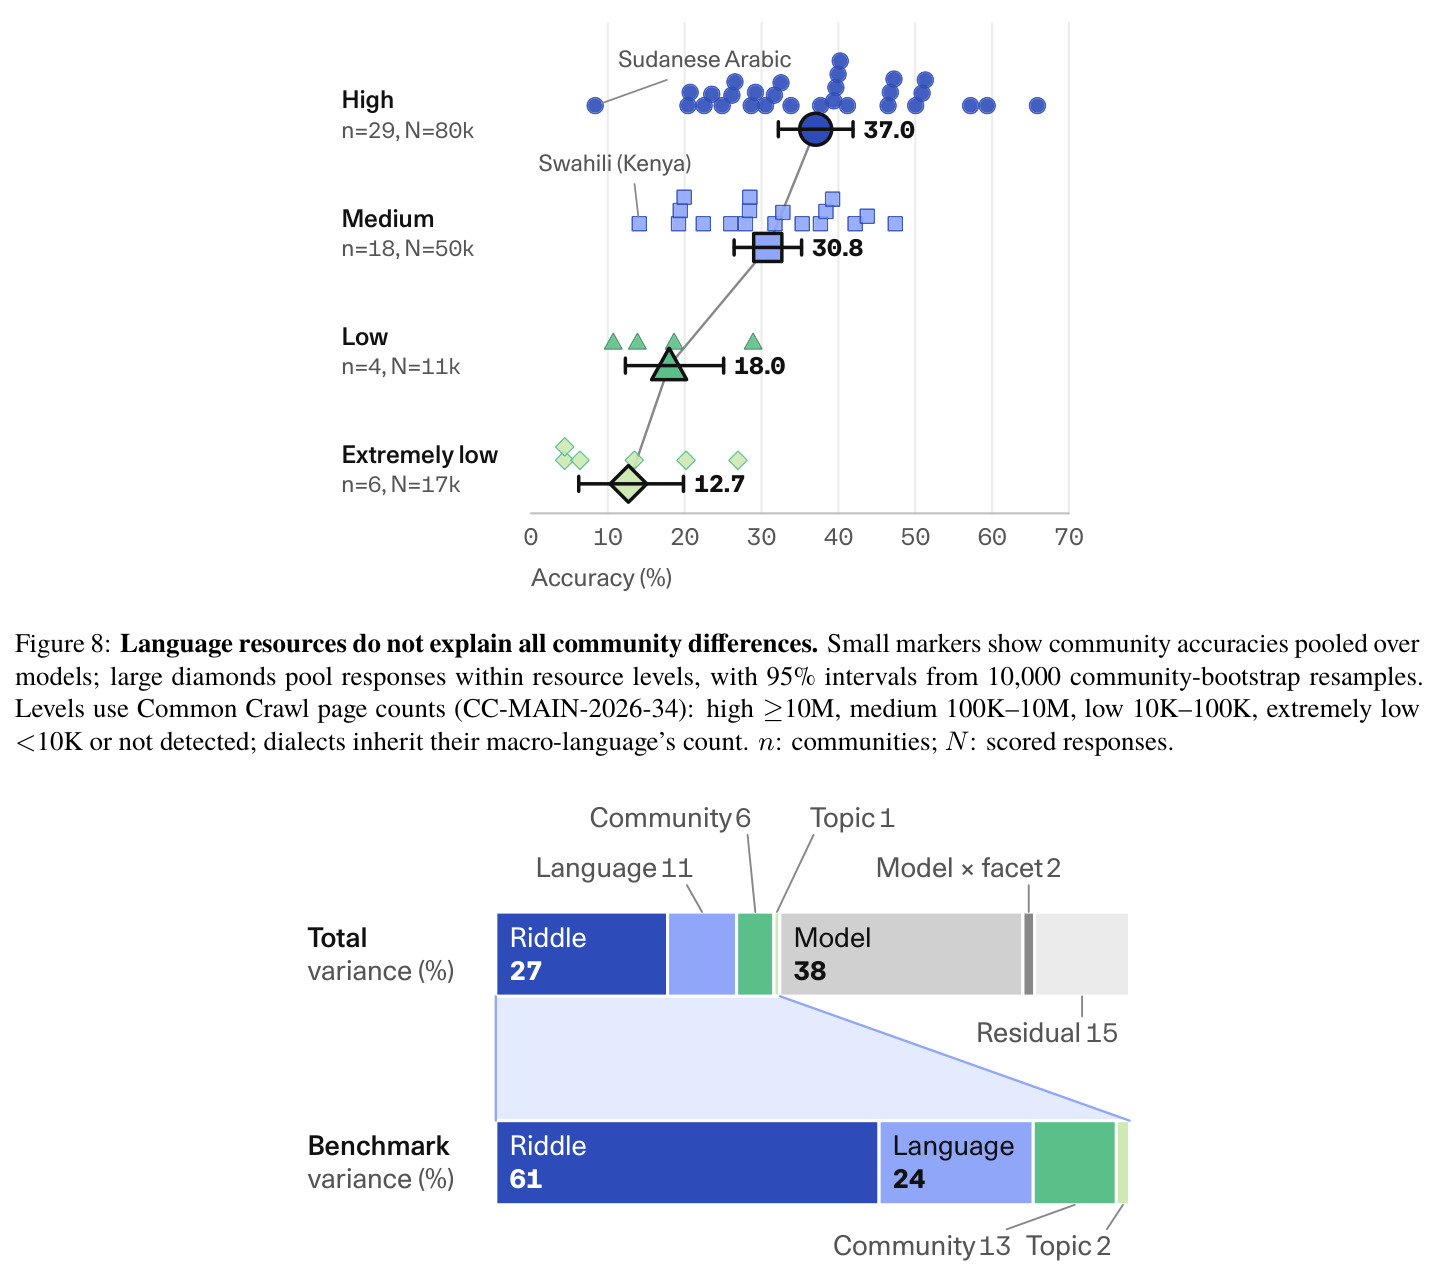
论文发现准确率随资源水平单调下降(高资源 37.0% 到极低资源 12.7%),但社区内部差异仍达 8-13 个百分点,说明资源不是唯一解释。
研究动机
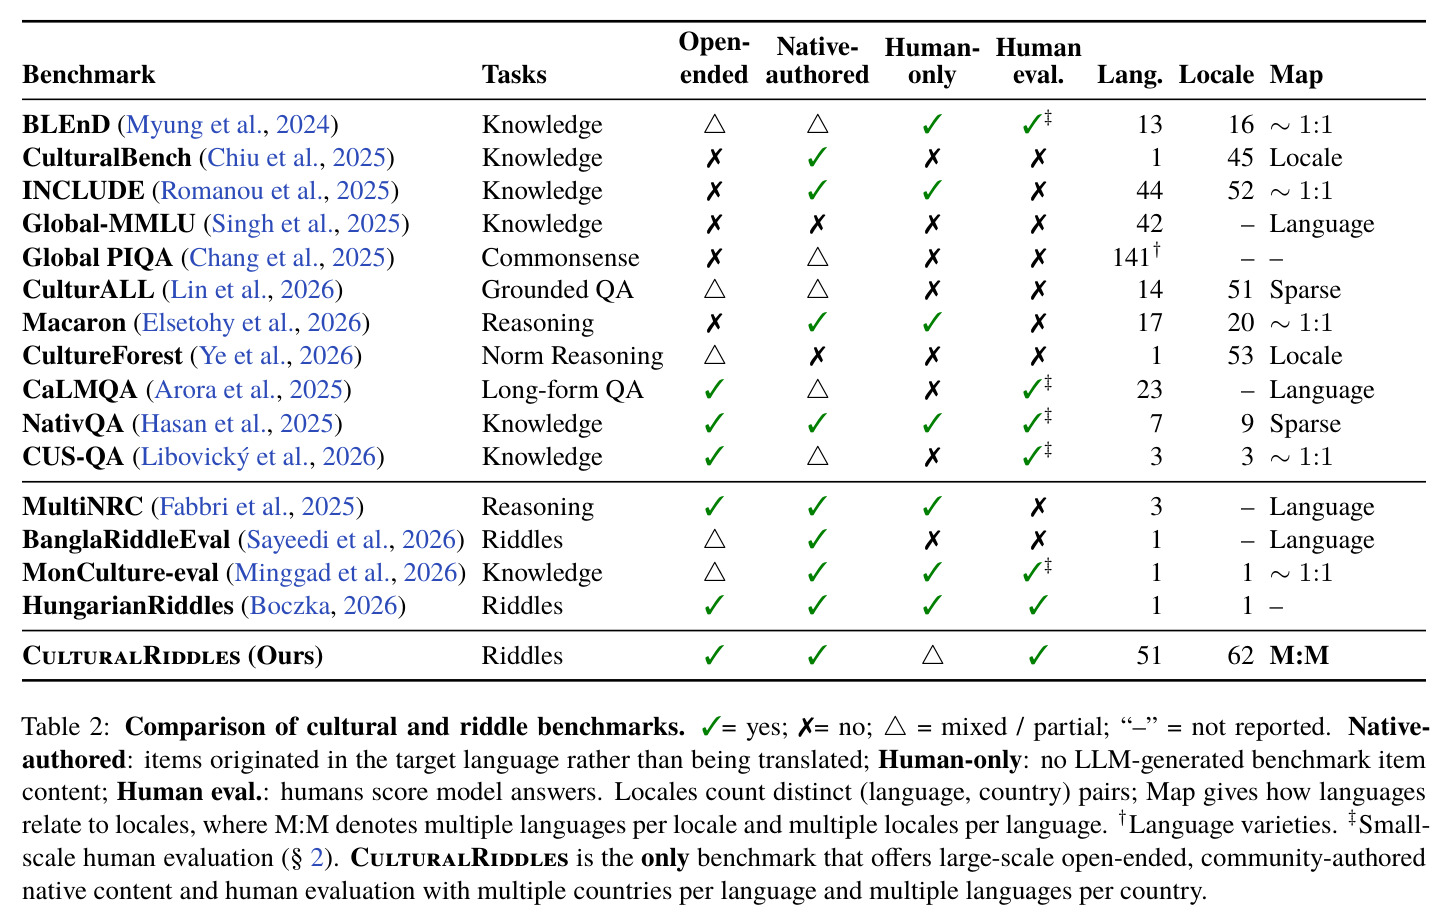
现有文化评测基准存在三个被论文逐一列举的缺陷。第一,覆盖面窄:BLEnD 覆盖 13 种语言 16 个地区,CulturalBench 只有 45 个地区且为翻译内容,多数基准假设语言与国家一一对应,无法表达「西班牙语分布在阿根廷、古巴、秘鲁、西班牙」这类多对多关系;Buginese、Mongondow、Lumasaba 这类语言从未出现在任何文化基准中。第二,考察方式偏事实回忆:Global-MMLU、INCLUDE 等基准多为选择题或封闭式问答,只测模型「知道什么」,不测「能否在语境中运用」,而随着模型知识增强,失败越来越来自选错解释而非缺知识。第三,评估协议薄弱:已有文化 QA 工作的人工评估规模很小,通常只有 120-700 条回答、不到 10 种语言;已有的文化谜语基准只覆盖 1-3 种语言,如 MultiNRC 无模型超过 50%,BanglaRiddleEval 最佳模型约 56% 对人类 83%,且依赖未验证的 LLM 评委或选择题格式,难以判断模型是真会解谜还是猜中选项。
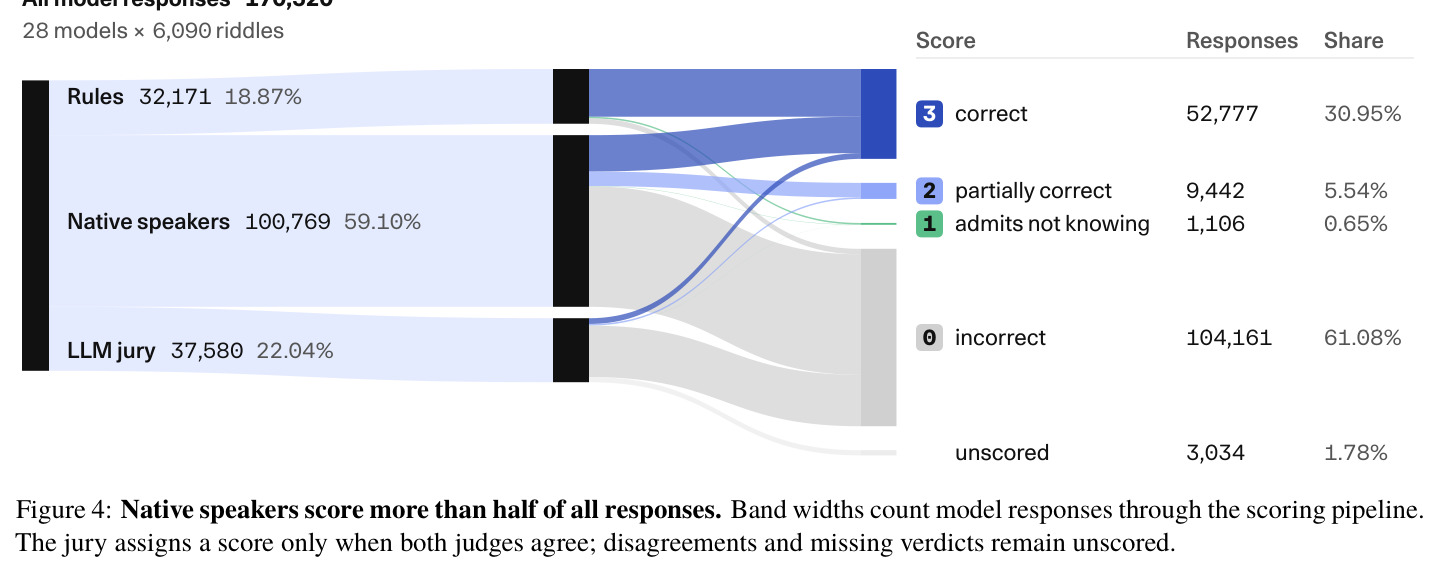
本文的目标是论文要构建一个由社区成员原创、覆盖广、质量经过验证、评估协议可靠的文化谜语基准。具体量化目标:6,191 条由 167 位母语者从零编写的原创谜语,覆盖 62 个「国家-语言」社区、51 种语言、45 个国家,每个社区目标 100 条(8 个共享主题各 10 条加 2 个社区自选主题各 10 条);每条谜语必须由非作者的本族语者验证可解性和答案正确性;评估 28 个模型配置(0.8B 到 1.6T 参数),产出 170,520 条回答,其中 59.10% 由本族语者人工标注(68,067 个独特答案、57 个社区、48 种语言),其余大部分由经过人工验证的 LLM 评审团打分,最终能定位模型的「文化盲区」并支持基准持续扩展。
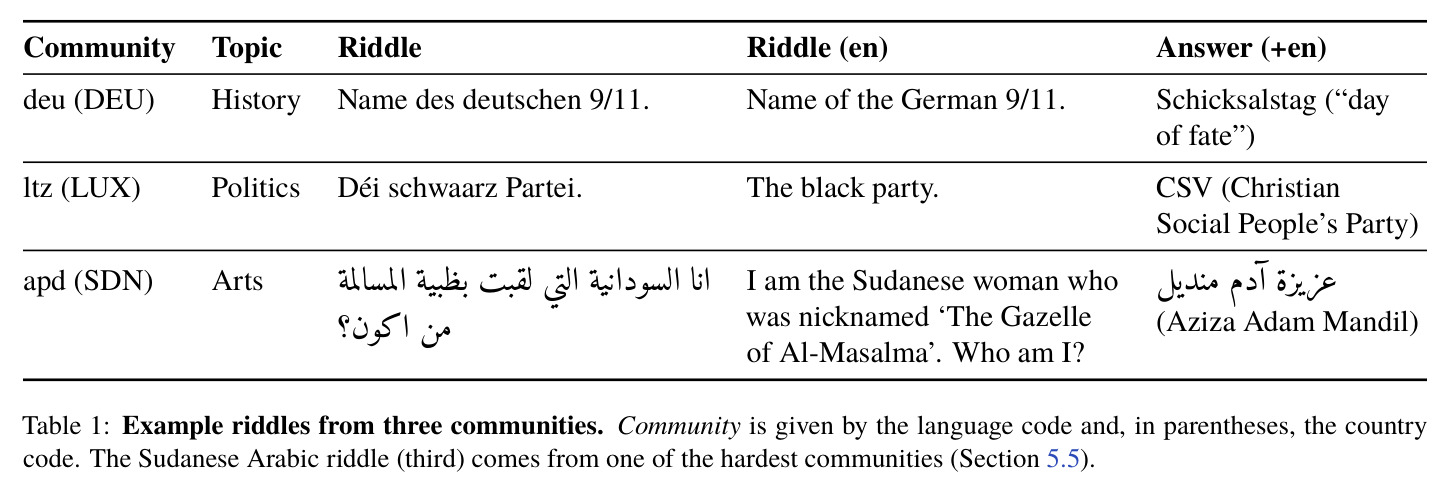
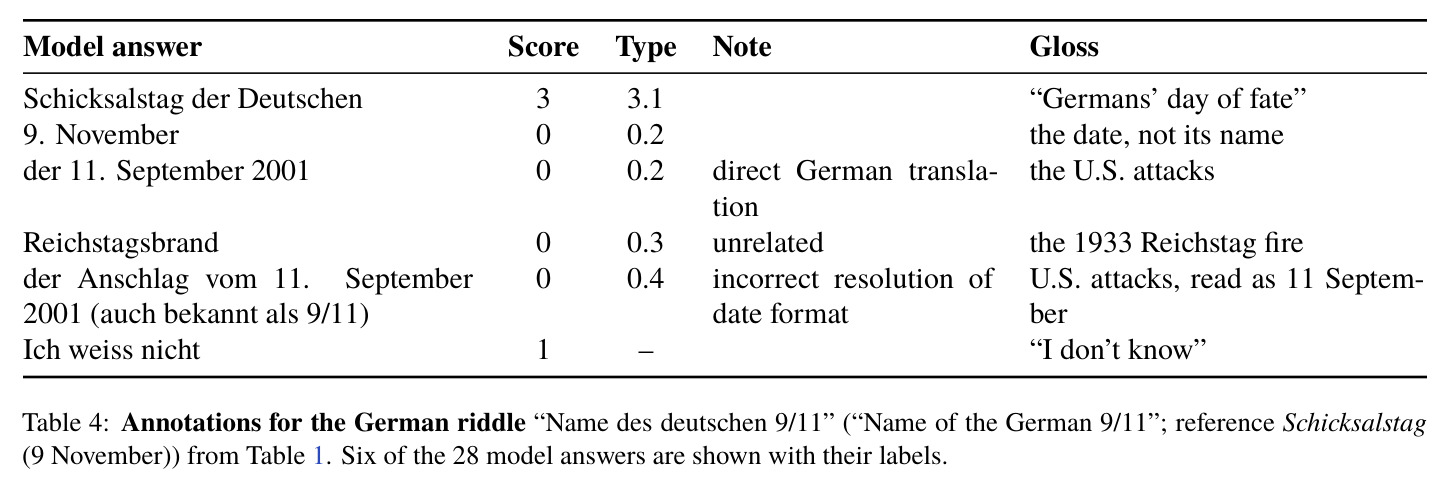
与已有工作不同的是,本文的独特切入有三点。其一,用谜语而非问答来测文化:解一条德国谜语「德国的 9/11 叫什么」需要按德语日期顺序理解线索、回忆 11 月 9 日的历史事件及其专名,这考察的是文化联想的权衡、组合与溯因,而非单纯事实检索,直接呼应「模型失败源于解释选择」的新观察。其二,坚持本族语者原创而非翻译:每条谜语都在目标语言中从零写就,保留翻译会丢失的文字游戏、集体记忆与地域知识,并允许多语言对多国家的复杂映射。其三,评估上做到当时最大规模的人机协同:先用规则筛掉精确匹配和弃答,再让本族语者标注超过一半的回答,LLM 评审的可靠性用人类一致性系数严格校准(准确率 κ=0.79-0.84,接近人类之间的 0.80),未决样本明确排除而非强行给分。
核心方法
整个工程像一场众包考古:先让每个文化社区自己「出土」谜语,再用三层漏斗给 17 万条模型回答定分。构建阶段,167 位本族语者以「国家-语言社区」为单位,用 6 个月写出 6,191 条原创谜语,每条含主题、间接谜面、本地语言的简短参考答案,可附提示;8 个共享主题(政治、历史、地理、艺术、体育、国家遗产、儿童世界、日常生活)保证跨文化可比,每个社区再自选 2 个「 wildcard 」主题捕捉本文化特有概念(124 个自选主题中食物占 27.4%、自然 15.3%、语言 13.7%、媒体 12.9%)。写作要求用同义词、间接描述、本地行话和昵称,使解题无法靠单次搜索完成;每条谜语须由另一位非作者的本族语者验证可解、线索无歧义、答案正确。评估阶段,28 个模型配置(0.8B-1.6T 参数,含闭源、开源权重、开源数据三类)用统一英文提示模板各答 6,090 条谜语一次,共 170,520 条回答,随后经规则、人类、评审团三条路径打分。
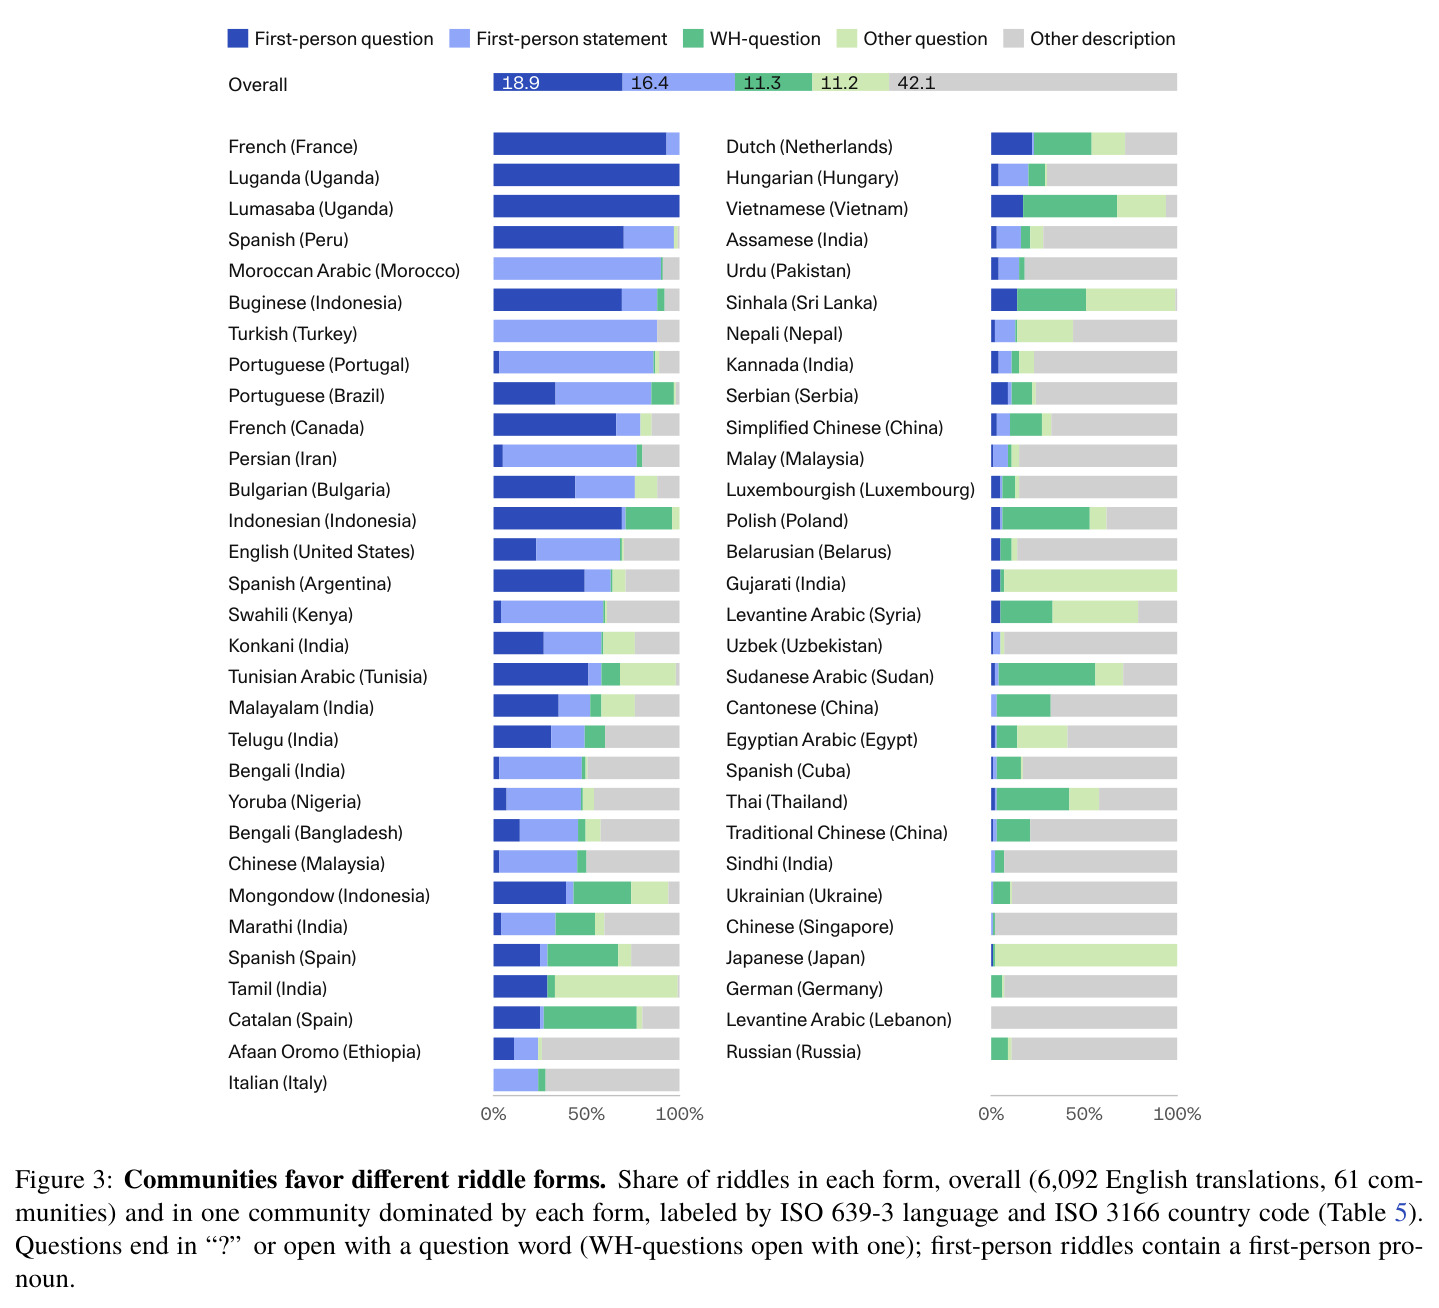
核心创新是把「文化理解」操作化为「文化线索的溯因求解」,并为此设计了一套防作弊、防幻觉的评估协议。与已有工作的本质区别有三:第一,数据是本族语者在本语言中原创的开放式谜语,不是翻译的选择题,谜面刻意利用文化内联想(如 98% 的 Luganda 谜语以第一人称问句结尾、98% 的日语谜语用短问句),答案正确与否由社区成员裁定,承认同一谜语可存在多个有效答案;第二,评分采用 0-3 四级量表(0 错误、1 承认不知道、2 部分正确、3 正确)加 13 种细分错误类型,弃答与瞎猜分开计分,避免了「惩罚弃答等于奖励乱猜」的经典评测缺陷;第三,每个回答按三条路径分流——规则(18.87%)、本族语者(59.10%)、双 LLM 评审(22.04%),评审只在两位评委分数一致时才生效,剩余 1.78% 明确不计入准确率,评审提示在人类标注集上验证到 κ 接近人类水平才投入使用。
方法步骤详情
第一步,招募与写作:通过社交媒体和私人网络招募自我认同某社区、掌握其语言、具备基础英语的志愿者,6 个月 167 人参与;写作者需在共享主题框架下从零创作,要求谜面间接、答案唯一(1-4 词),调查显示 97.4% 的人依赖个人知识经验、46.1% 用 AI 工具校准难度。第二步,验证:每条谜语由另一位本族语者核实可解性与答案正确性,8 条有害内容被移除,56 条附内容提示。第三步,模型作答:28 个配置用含国家和主题上下文的英文提示模板各答 6,090 条谜语一次,共 170,520 条回答。第四步,规则评分:大小写不敏感的精确匹配记 3 分(占全部回答 16.45%),空输出和占位符记 0 分,明确「我不知道」记 1 分。第五步,人工标注:本族语者为每条谜语出现频率最高的未评分答案打 0-3 分和错误类型,同一答案只标一次即可覆盖多个模型,68,067 个独特标签覆盖 100,769 条回答(59.10%),19 个社区双人复标得到 4,246 对样本。第六步,LLM 评审:Gemini 3.5 Flash 与 DeepSeek V4.1 Flash 隐藏模型名后评剩余回答(37,580 条,22.04%),仅双方分数一致才采纳,评审用三类集合验证到与人类 κ=0.79-0.84。
技术新颖性
相对已有技术,新颖性集中在评测基础设施而非模型本身。与 RiddleSense、BrainTeaser 等通用谜语基准相比,本文首次把谜语与文化绑定并做到 51 种语言规模,且不依赖选择题;与 MultiNRC、BanglaRiddleEval 等单语文化谜语工作相比,本文把 Boczka (2026) 的单语言试点扩展到 62 个社区,并补齐了其缺失的规模化人类评估。评分协议上有三个首创细节:一是用人类-人类一致性(κ=0.80)作为 LLM 评审的准入门槛,并发现评委分歧恰好标记人类也难判的样本(分歧样本中人类不一致率是对样本的 8.4 倍);二是量化精确匹配的失真——它漏掉约 47% 的最终正确答案,且人工复审带来的增益对弱模型更大(64-166% 相对提升),会系统性夸大模型间差距、改变排名;三是用交叉随机效应模型把难度归因分解到谜题(占基准方差 60%)、语言(24%)、社区(13%)、主题(2%),证明难度主要内嵌于谜题本身。此外还首创了谜语填字形式和「评测新模型仅需约 100 条人工复审」的成本估计。
实验结果
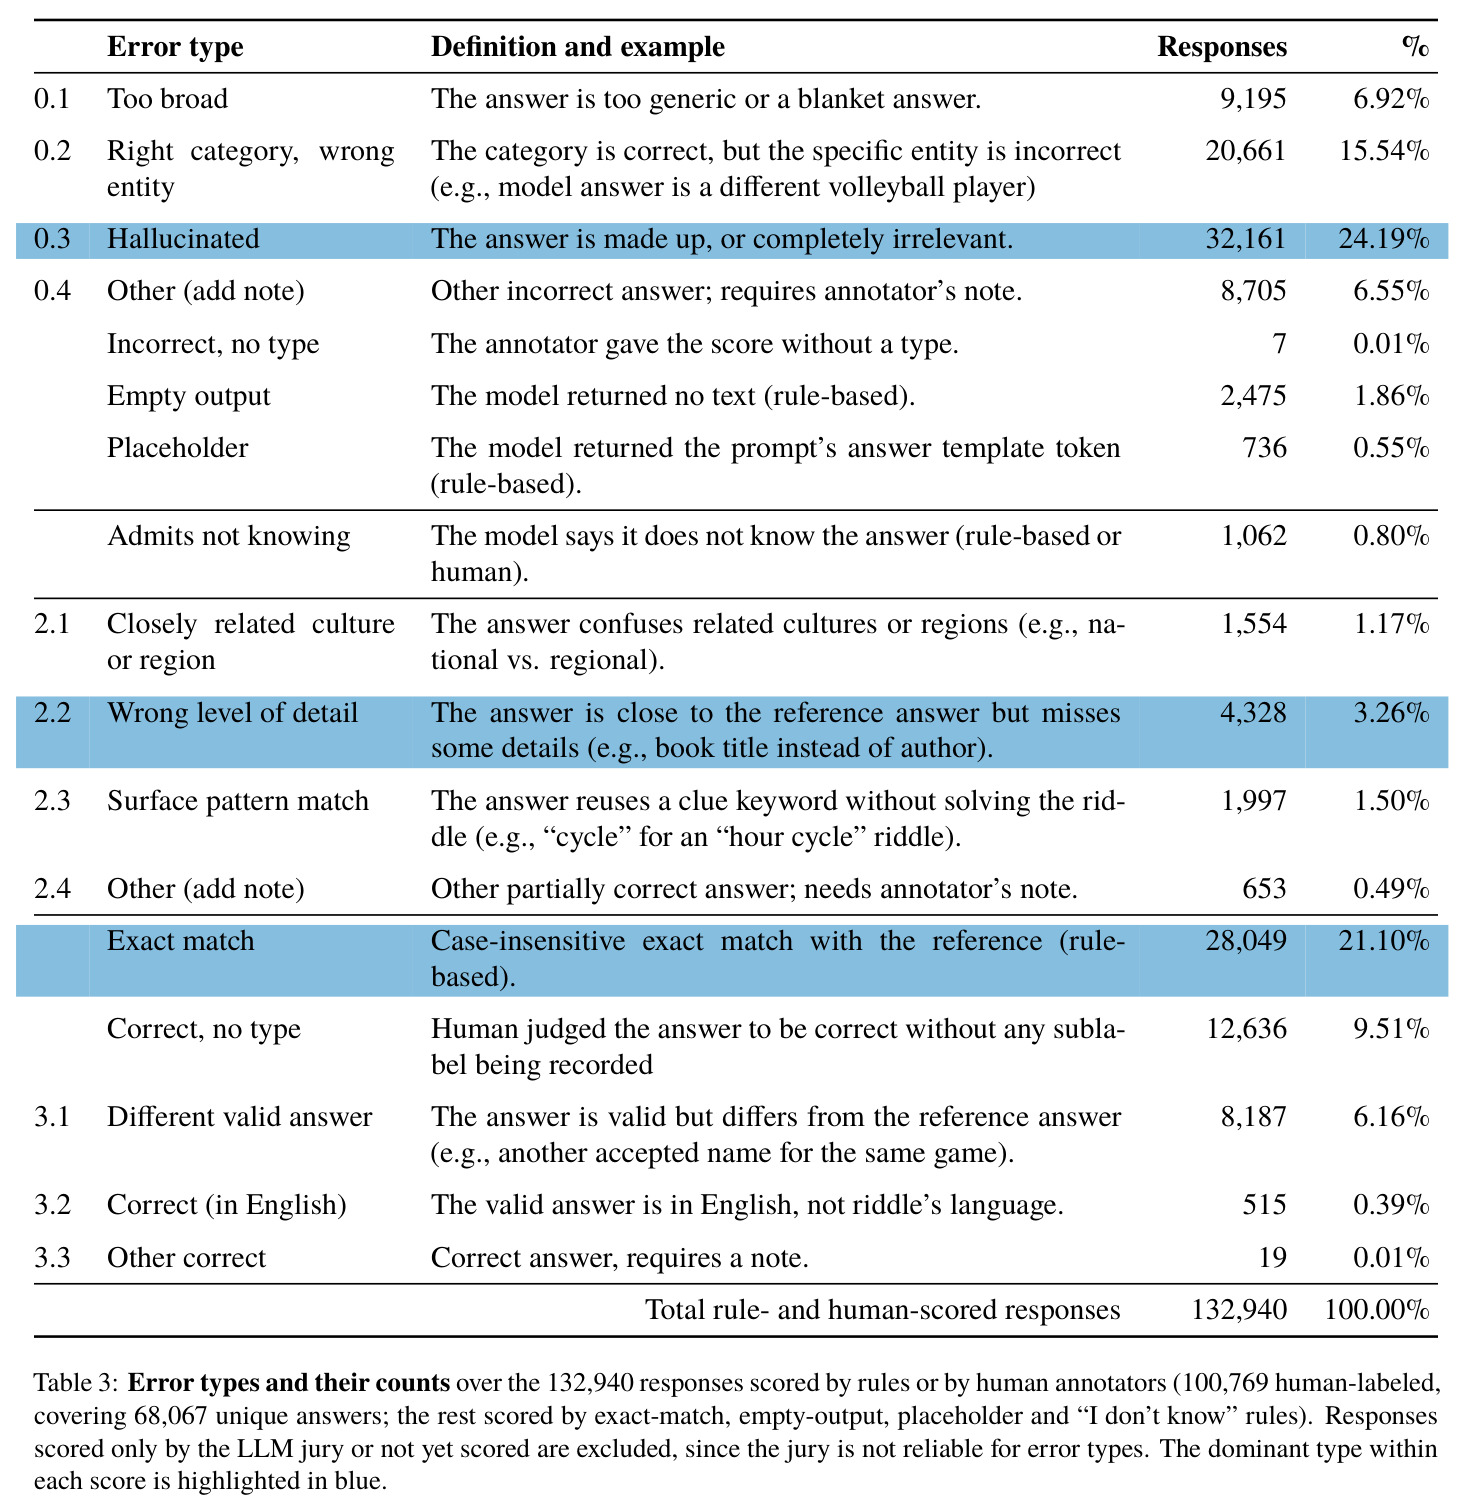
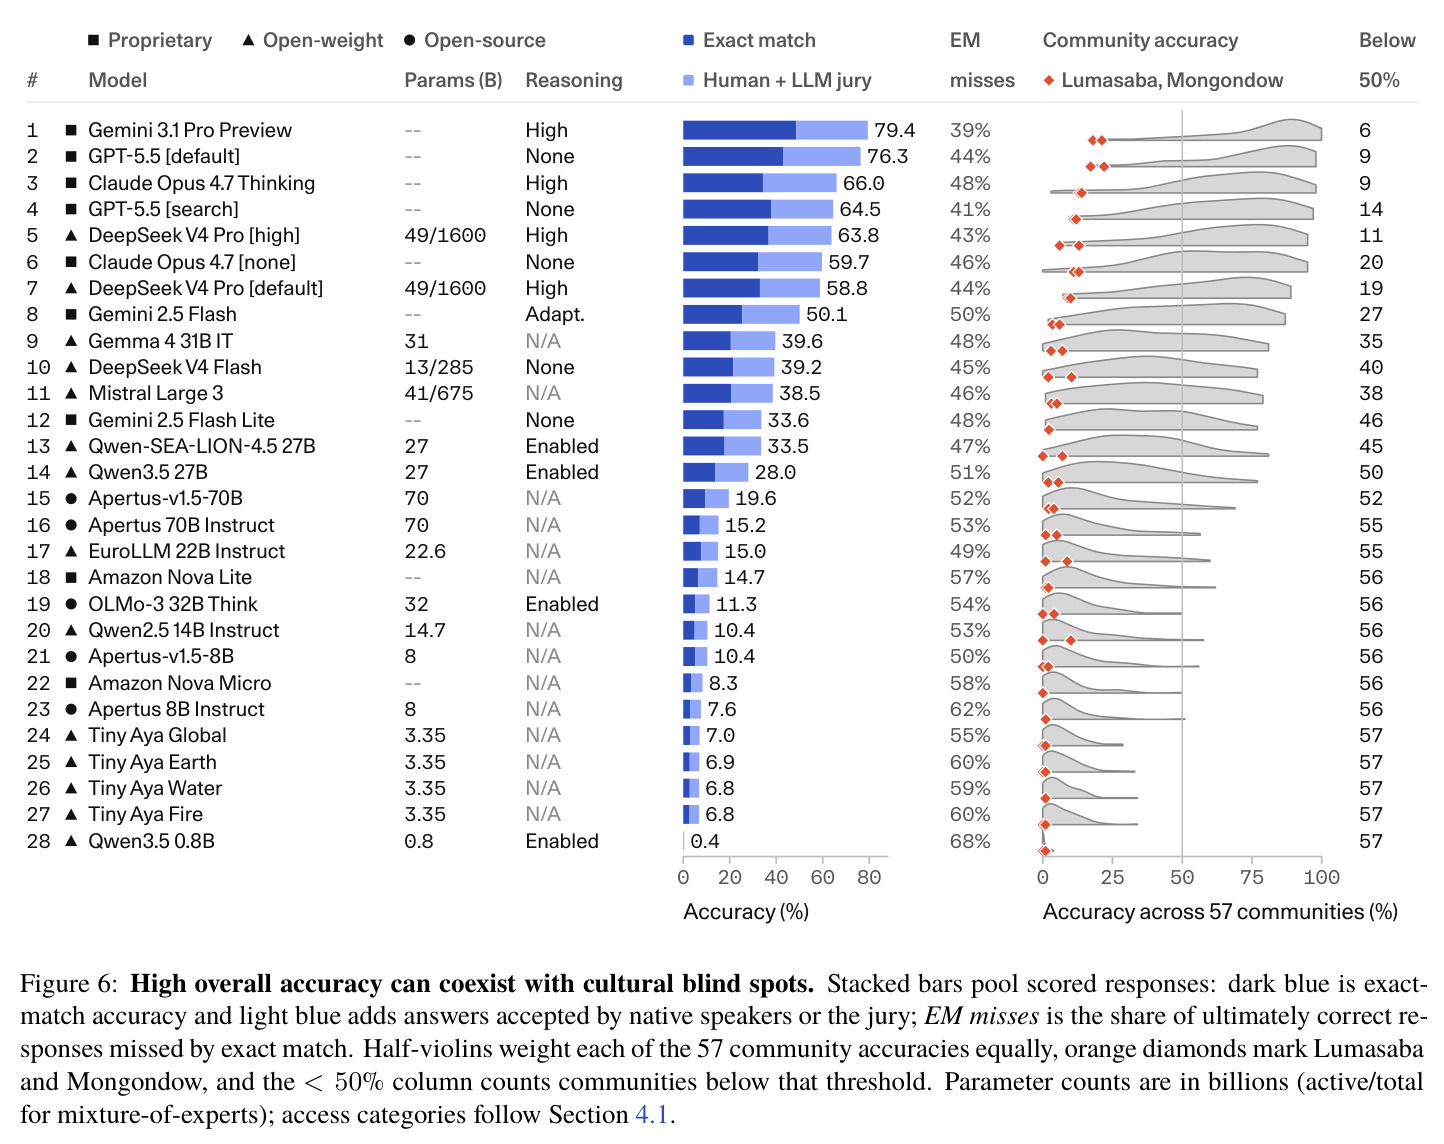
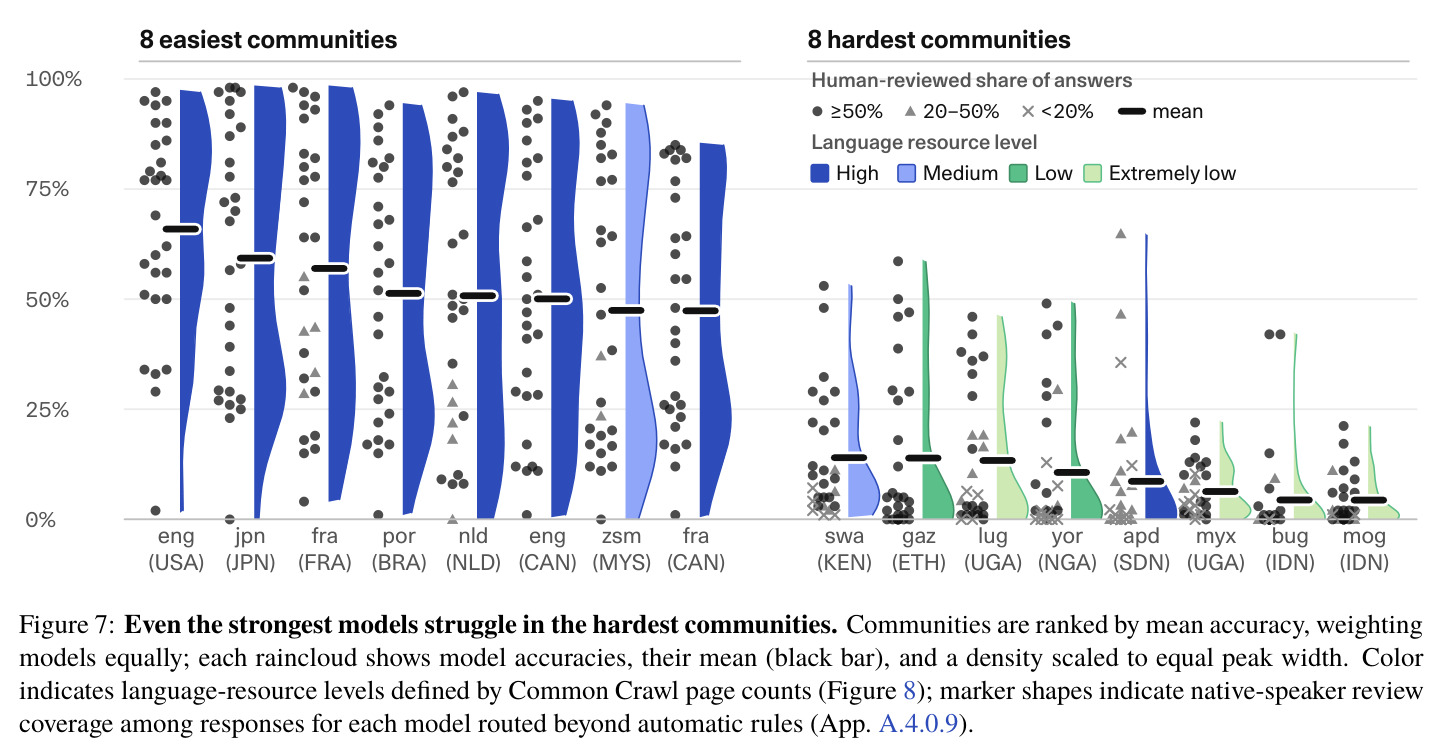
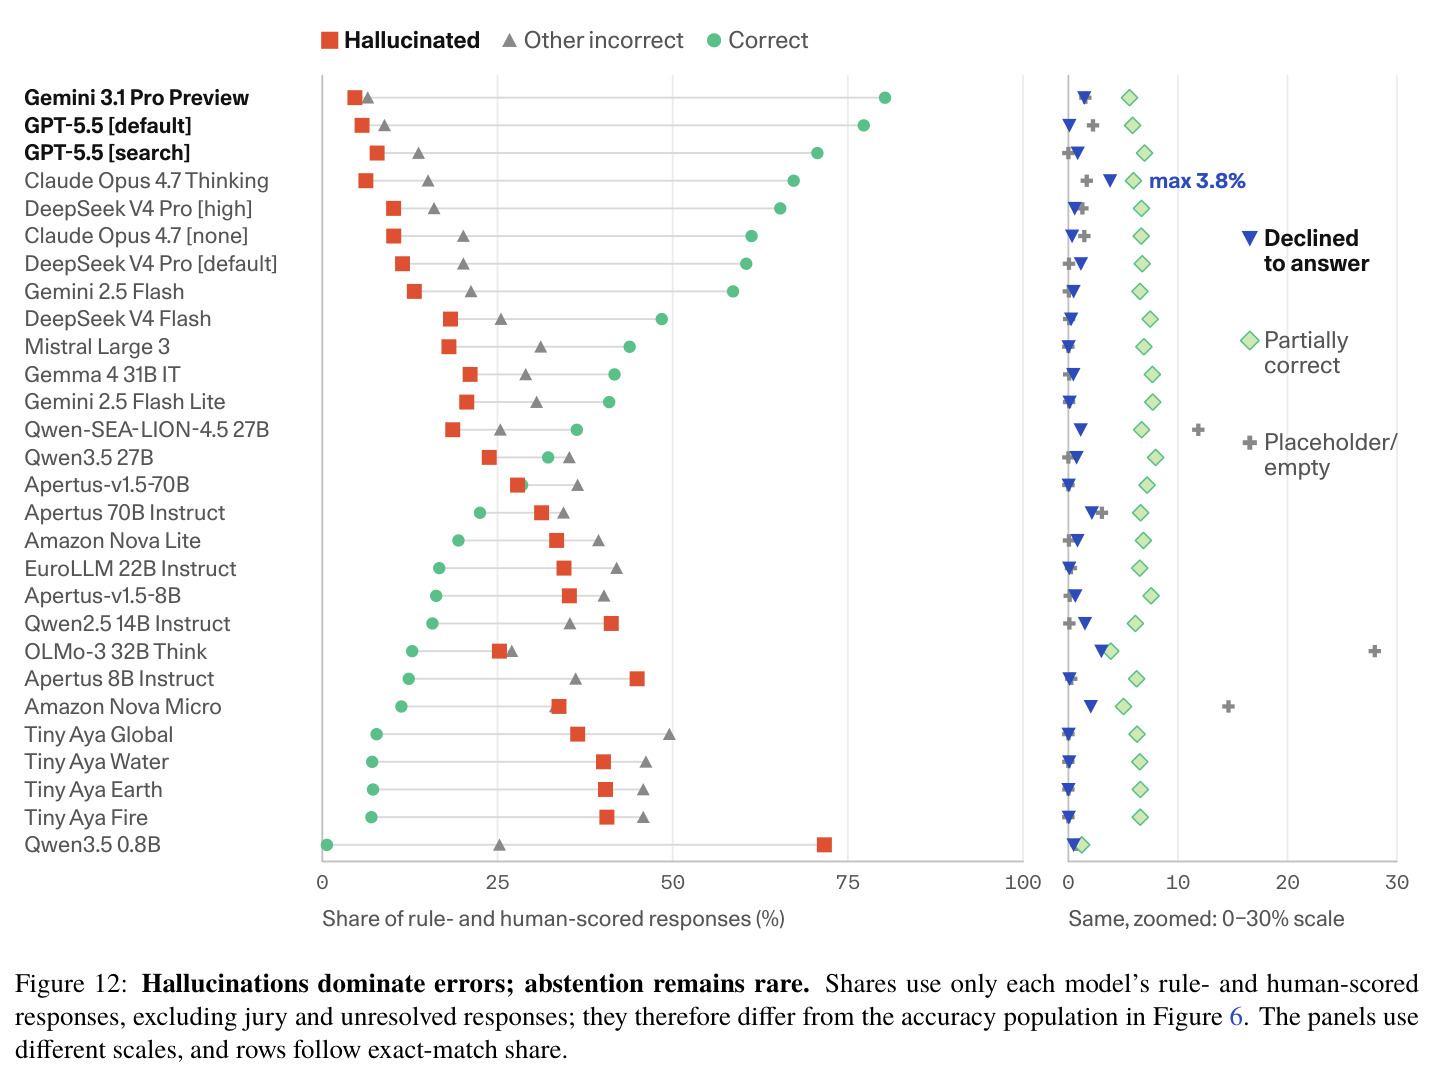
核心结果分五条。第一,前沿模型总体强但盲区大:Gemini 3.1 Pro Preview 以 79.4% 居首,GPT-5.5 76.3%、Claude Opus 4.7 Thinking 66.0%、最佳开源 DeepSeek V4 Pro [high] 63.8%;除头部配置和 Gemini 2.5 Flash(50.1%)外所有模型低于 40%,8B 及以下最高仅 10.4%。第二,文化盲区惊人:8 个最容易的社区(英语美国中位模型 73%)均值 47-66%,8 个最难的(斯瓦希里语肯尼亚、Afaan Oromo、Luganda、Yoruba、苏丹阿拉伯语、Lumasaba、Buginese、Mongondow)均值仅 4-14%,Lumasaba 和 Mongondow 上没有任何模型超过 22%;顶级模型在这 8 个社区平均只有 39-43%,约为总体的一半。第三,评估方式影响结论:精确匹配漏掉约 47% 的最终正确答案,人工加评审复审使每个模型准确率相对提升 64-166%(Claude Opus 4.7 Thinking 从第五升至第三)。第四,模型宁幻觉不弃答:规则加人工评定的 132,940 条回答中幻觉占 24.19%,承认不知道仅 0.80%,任何模型的弃答率上限也只有 3.81%。第五,归因与缓解:池化准确率按语言资源从高到极为 37.0%、30.8%、18.0%、12.7%;把 5 个最难社区谜语译成英语后 5 个模型准确率仅从 22.1% 升至 32.4%(+10.3pp,95% CI 7.6-13.0),只弥合约五分之一差距;同语同文字的社区间差距达 5-26pp(简体中文中国 28.5% 对华语新加坡 46.3%);思维链有效(Claude +6.3pp)而联网搜索有害(GPT-5.5 -11.8pp);区域适配模型在目标区域无显著额外优势;方差分解显示谜题解释基准方差 60%、语言 24%、模型交互不足 2%。评审团与人类一致性好(κ=0.79-0.84)但错误类型一致性弱(0.38-0.52,人类间 0.41),且评委对强模型偏宽容(联合接受 Gemini 3.1 Pro 被人类拒绝答案的 9.0%)。填字实验中交叉一致性从 53.0% 升至 60.1%(+7.2)而参考答案准确率仅 +1.6,说明模型会「自洽地填错」。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 62 社区开放作答综合准确率 | accuracy(score 3 占已评分回答比例) | 最佳 Gemini 3.1 Pro Preview 79.4%;最佳开源 DeepSeek V4 Pro [high] 63.8% | GPT-5.5 76.3%;除头部配置外 28 个配置中多数低于 40%,8B 以下最高 10.4% | 较最佳开源高 15.6pp;思维链带来 +5.0~6.3pp,联网搜索反而 -11.8pp |
| 最难社区(Lumasaba、Mongondow)准确率 | accuracy | 所有 28 个配置 ≤22% | 高资源社区(英语美国)中位模型达 73% | 8 个最难社区均值仅 4-14%,顶级模型在此也只有 39-43%,约为其总体准确率一半 |
| 最难社区谜语的英文翻译版(5 模型) | accuracy(配对比较) | 32.4% | 原文 22.1% | +10.3pp(95% CI 7.6-13.0),仅弥补对高资源社区差距的约五分之一 |
| 谜语填字形式(53 个网格、11 个配置) | 交叉一致性 / 网格放置率 | 交叉一致性 60.1%;GPT-6 Astra 网格放置率 88.3% | 长度匹配条件交叉一致性 53.0%;Gemini 3.7 Flash 网格输出仅 5.4% | +7.2pp(95% CI 4.8-9.6),但参考答案准确率仅 +1.6pp(CI -0.3~3.7) |
| LLM 评审团可靠性(vs 人类标注) | Cohen's κ(准确率) | 0.79-0.84(按设置 A/B 分层) | 人类-人类一致性 κ=0.80 | 接近人类水平,但错误类型 κ 仅 0.38-0.52(人类间 0.41),只能描述性使用 |
局限与改进
作者明确承认的局限:一是 3 个社区(含全部信德语标签,2.38% 回答为无效标注)缺乏有效人工标注,只能依赖评审团,斯瓦希里语(肯尼亚)与人类一致率偏低需要额外复审;二是 1.78% 的回答未获评分被排除在准确率之外;三是评委存在系统性偏见,对最强模型的错误更宽容、拒绝 25-29% 的「不同有效答案」,且错误类型一致性弱(κ≈0.41)只能作描述用途;四是「国家-语言社区」作为文化单元本身不完美,代际、地域性知识可能只有部分社区成员能解。我观察到的额外局限:每个模型对每条谜语只采样一次,无法衡量答案方差与提示敏感性;错误类型定义(幻觉 vs 类别对实体错)主观空间大;语言资源分级用 Common Crawl 页面数过于粗糙——苏丹阿拉伯语因继承阿拉伯语的高资源分类而无法解释其极差表现;6,090 条谜语中每社区仅约 100 条,社区级结论的统计功效有限;wildcard 主题因跨社区不可比,只参与局部分析。
独立分析的弱点
第一,评分漏斗的瓶颈仍在人类:规则加既有人类标签只能覆盖领先模型约 80% 的回答、中位模型 51%、小模型仅 2-13%,弱模型的回答多为独特错误,每次评测小模型都要重新动员本族语者,改进方向是为低资源语言训练专门的小型验证模型。第二,评委偏袒强模型会造成天花板压缩:评委联合接受了 Gemini 3.1 Pro 被人类拒绝的 9.0% 答案,若未来 frontier 模型输出更长更自信,误判比例可能上升,建议主指标中始终保留人工标注的黄金子集作校准锚。第三,谜题难度无法被特征解释(谜题特征只解释谜题层面方差的 3.1%),难以预测新谜语难度,也难以诊断模型缺事实还是误读线索——论文自己承认 final-answer 分数无法区分这两种失败,可引入中间推理步骤的探针式评估。第四,单次采样使「侥幸猜中」与「稳定掌握」无法区分,每社区仅约 100 条样本,社区排名置信区间可能宽到无法排序,建议多次采样并用自助法报告区间。第五,翻译实验排除了 41 条翻译含答案线索的谜语(38 条来自 Lumasaba),低资源社区的翻译质量本身是干扰变量,语言因素与文化因素的分离仍不干净。
未来方向
作者提出的方向:基准通过开放贡献流程持续生长,仓库提供谜语模板、自动格式检查和评审流程,欢迎新社区加入;用约 100-115 条/模型的人工复审成本持续追踪未来模型能否推进「文化前沿」;把错误类型协议打磨到可作正式指标的程度(目前 κ=0.41 只能描述)。基于本文成果可延伸的研究:一是把「缺事实 vs 误读线索」的诊断做实,例如给模型注入参考答案后再测推理,或对比模型在谜语与直接问答上的表现差;二是填字形式的拓展——交叉一致性 60.1% 对准确率仅 +1.6 的「自洽但错误」现象值得作为一致性度量单独研究;三是利用多对多的语言-国家映射系统研究「同语不同境」,如简体中文中国与华语新加坡 17.8pp 的差距究竟源于词汇、专名还是集体记忆;四是把 0-3 弃答感知量表推广到其他开放式文化评测,抑制「惩罚不知情」导致的系统性幻觉激励;五是对 24.19% 的幻觉率做细分,检验搜索增强为何把正确答案改错(39% 类别对实体错、25% 幻觉)。
复现评估
复现条件相当好。数据在 Hugging Face 以 CC-BY-4.0 发布(CohereLabsCommunity/CulturalRiddles),附带「不得用于训练或合成数据」的使用请求;评测与分析代码在 GitHub(Cohere-Labs-Community/CulturalRiddles)公开,含 6,191 条谜语全文、13 种错误类型定义、评审提示词与验证协议。算力门槛低:评估只需调用 28 个模型的 API 各答 6,090 条,单模型约 6 千次请求,学术预算可承受;两位评委(Gemini 3.5 Flash、DeepSeek V4.1 Flash)均为商用 API,成本可控。真正的瓶颈是人类标注:59.10% 的人工覆盖来自 167 位写作者加社区标注员的志愿劳动,外部团队复现完整人类评估几乎不可能,但可复现「规则 + 评审团」路径并抽样人工校验;新模型评测按论文第四节的三步漏斗(规则→复用既有人类标签→评审团)只需约 100-115 条人工复审即可达到领先模型同等协议,这是本文对复现性的最大贡献。统计代码(交叉随机效应模型、bootstrap 区间)依赖标准工具,中等难度。
论文图表
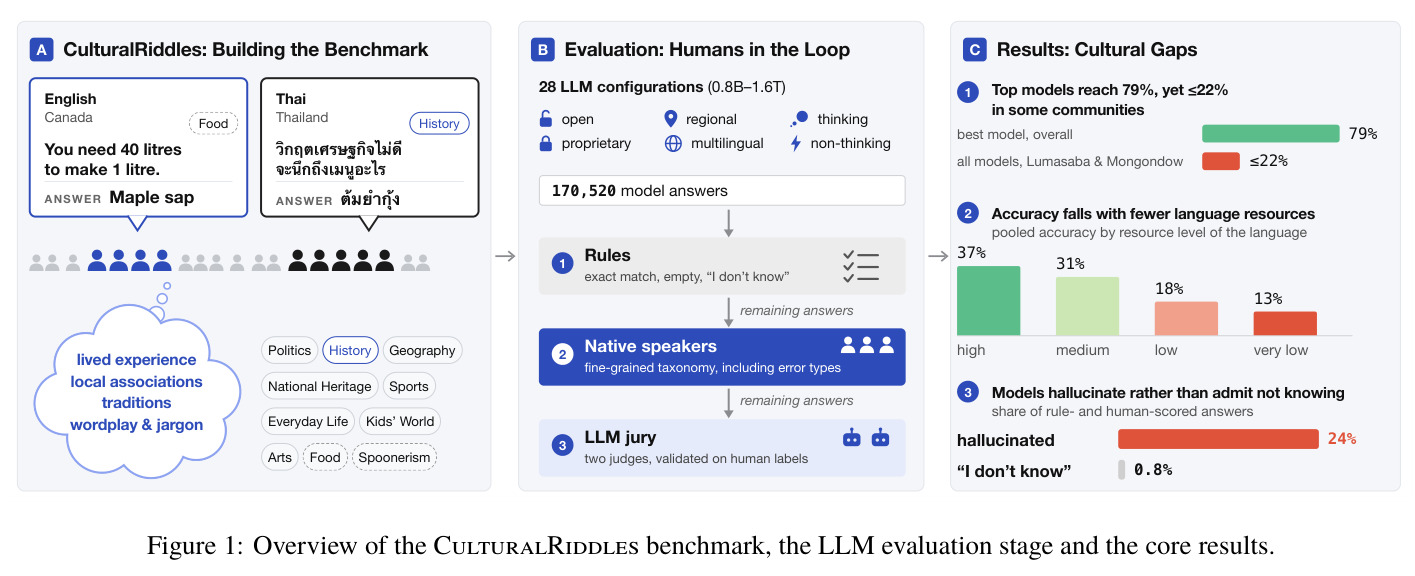
三栏总览图:A 栏展示基准构建(62 社区地图、16 类主题图标、28 个模型配置产生 170,520 条回答);B 栏展示评估流程(规则、本族语者、LLM 评审三路打分);C 栏展示核心结果(最佳模型总体 79%、最难社区 ≤22%,以及按语言资源分级的池化准确率 37%/31%/18%/13%)。
这是全文的路线图,一图看懂「数据从哪来、怎么评、结论是什么」,包含幻觉率 24% 对弃答率 0.8% 的关键对比,适合作为导读起点。
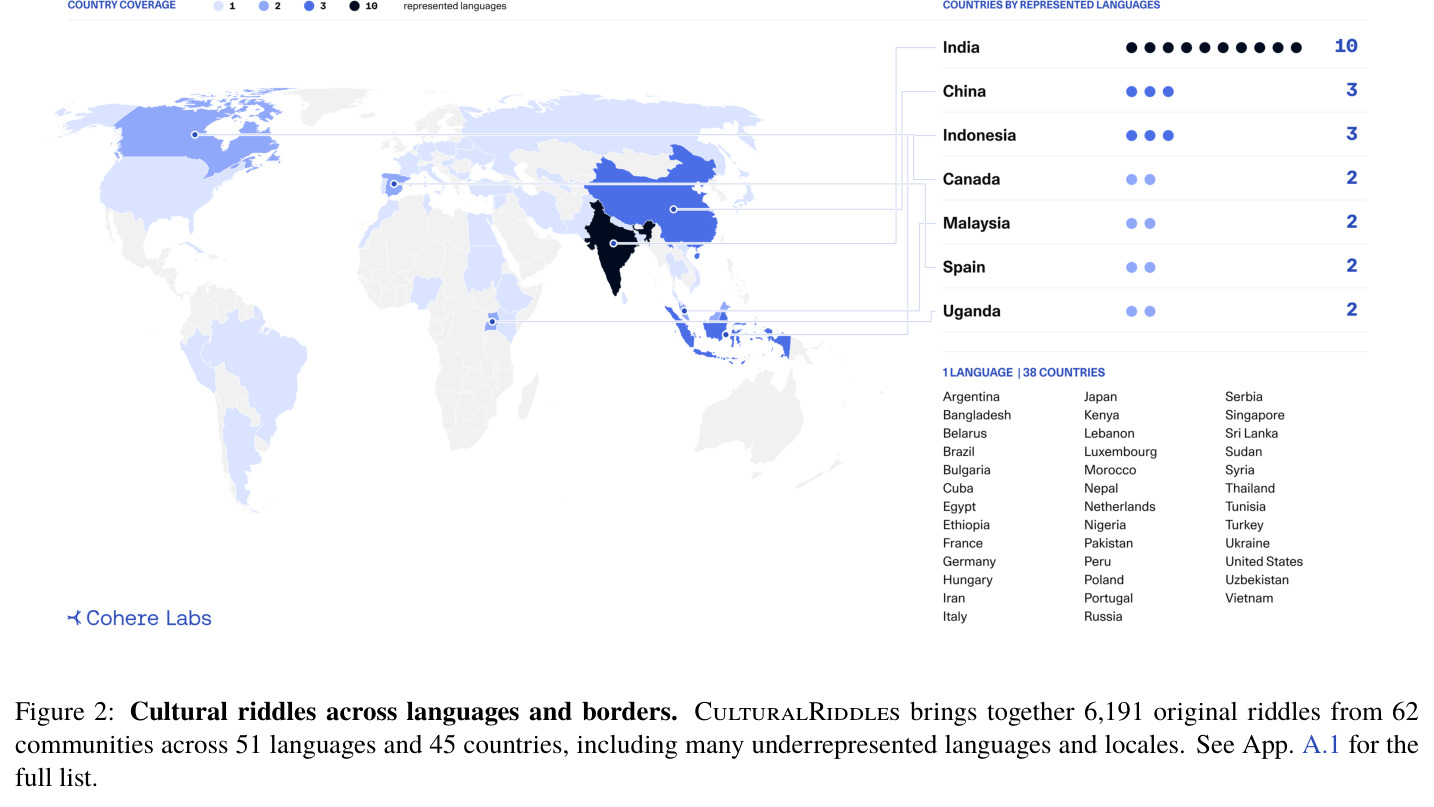
世界地图标注 62 个社区的谜语覆盖,突出 51 种语言、45 个国家的地理与语言分布,包括 Buginese、Mongondow 等首次进入文化基准的语言和乌干达、卢森堡、古巴等少被代表的地区。
可视化基准的覆盖广度与多对多映射(如印度的 10 种语言、西班牙语的 4 国分布),是 L1 论点的直观证据。