广义循环GRPO:跨空间、时间与时空区域的细粒度多模态理解与定位统一强化学习框架 Generalized CycleGRPO for Fine-Grained Multimodal Understanding and Grounding
区域→文本→区域的循环重构重叠作为免参考可验证奖励,让单一模型同时提升理解与定位
前置知识
GRPO(组相对策略优化)
GRPO 是大模型强化学习的主流算法:对同一提示采样一组回答,用组内奖励的均值和方差把每个回答归一化为相对优势 $A=(r-\mu)/(\sigma+\delta)$,再用 PPO 式裁剪重要性比更新策略,省去价值网络。本文用两级分组(N 条描述一组、同一父描述下 K 条定位轨迹一组),并对负优势启用 dual clipping(系数 $c=3$)。
本文的优化目标(Eq. 9–13)完全建立在两级组相对优势之上,不懂 GRPO 就无法理解奖励如何转化为参数更新,也读不懂消融实验的设计逻辑。
可验证奖励(RLVR)
可验证奖励指奖励不来自学习型奖励模型或人工偏好标注,而是来自可程序化验证的结果正确性,例如数学答案对错、代码测试通过、预测框与真值的 IoU 阈值。它规避了奖励模型被策略钻空子(reward hacking)的问题。
本文的核心主张是把『描述好不好』变成『拿这段描述能否把区域定位回去』这一几何上可验证的信号,是 RLVR 思想在区域-文本对应关系上的新实例。
区域理解与指代定位(互逆映射)
区域理解(region captioning):给定图像或视频中被指定的区域(掩码、框、时间区间),生成其内容描述;指代定位(referring localization):给定自由语言,输出对应的框、掩码或时间区间。二者是同一份区域-语言对应关系的互逆映射,此前通常用不同目标函数和标注来源分别训练。
全文的设计都围绕『让互逆映射互相监督』展开,必须先理解这两个任务以及两类标注的不对称性(文本标注昂贵、几何标注相对便宜),才能看懂动机。
IoU、tIoU 与 gIoU
IoU 是两个集合的交并比;tIoU 把集合换成时间区间,用重叠时长除以合并后的总时长(Eq. 14);gIoU 是指代分割基准(如 GRES、GroundingSuite)的主指标,综合考虑预测与目标的匹配质量。本文时空一致性函数还用到最大权一对一匹配上的支撑重叠 $S_{\text{ST}}$(Eq. 15)。
循环奖励的数值就是这些重叠度量,实验表格里的 gIoU/tIoU/TEC 全部建立在这些定义之上;不熟悉它们就无法读懂方法与结果。
循环一致性(Cycle Consistency)
源自无监督表示学习与图像翻译的思想:若 $A\to B$ 与 $B\to A$ 两个映射互逆,则复合 $A\to B\to A$ 应当复原输入。这个约束不需要成对标注就能提供监督信号,例如 CycleGAN 用它实现无配对图像转换。
本文把该思想落到单一多模态策略内部的 region→text→region 循环上,是理解『RL 阶段不需要参考 caption、不需要外部裁判』这一核心声明的前提。
SAMTok 离散掩码 token
SAMTok 把分割掩码经向量量化压缩为词表中的两个离散 token,使多模态大模型能在文本序列里直接『读入』和『写出』区域,无需外接分割头;训练时掩码 token 的一致性可作为几何 IoU 的高效代理。
空间实例化基于 SAMTok 初始化的 Qwen3-VL-4B,理解掩码如何进入 LLM 词表,才能理解空间循环如何实现以及防坐标泄漏为何重要。
时空证据与 V-STaR 评测
时空证据指模型输出『何时+何地』的结构化锚点:一组(时间戳,边界框)对。V-STaR 基准按答案准确率(What)、时间 IoU(When)、空间 IoU(Where)及两种链式顺序评分,汇总为 mAM 和 mLGM;TVGBench 则评测时间边界质量。
本文的时空实例化与 V-STaR/TVGBench 实验都建立在这个表示上,Eq. 15 的一对一匹配与 $\tau=3$ 秒时间门是读懂该部分设计的必要前置。
研究动机
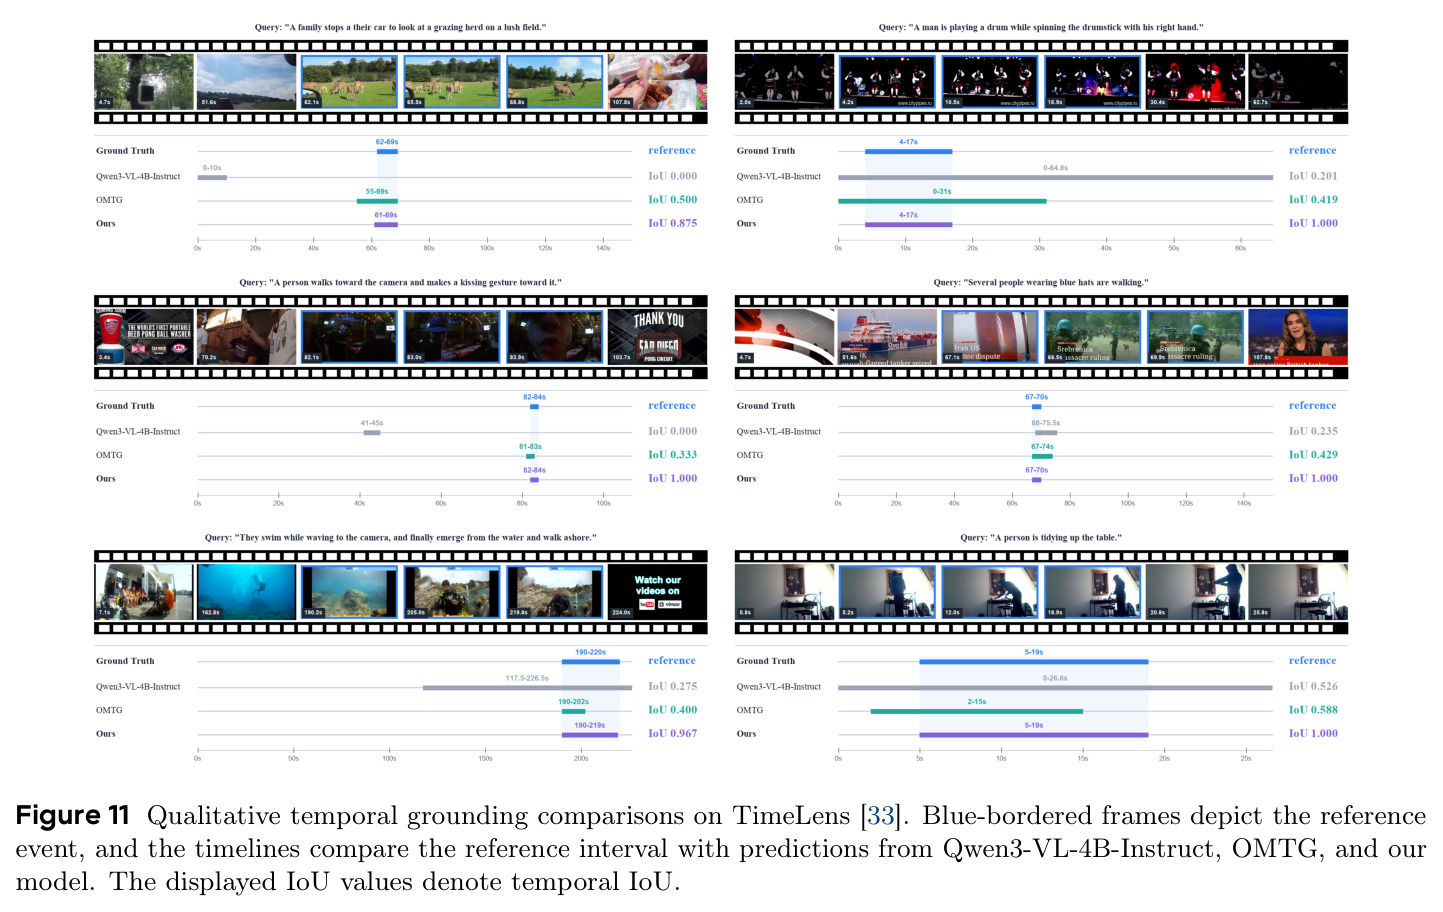
多模态大模型(MLLM)的细粒度能力由一对互逆映射构成:区域理解(给定掩码、框或时间区间,描述其内容)与指代定位(给定语言,找回该区域)。现有方法几乎都用不同的目标和标注分别训练这两个方向:区域理解依赖昂贵的文本标注(如 DAM 使用的 1.5M 区域-描述对),定位依赖几何标注(框、掩码、时间区间)。两套监督描述的是同一份对应关系,却互不约束:一段流畅的描述未必唯一指向其源区域——在视频里泛泛地说『一个男人在倒液体』,可以同时命中同一动作多次出现的所有区间;而一个强定位器也不会反哺生成它所消费的描述的模型。这个问题在重复事件场景尤其尖锐:参考文本相似度类指标(METEOR/CIDEr)只衡量与单一参考的相似,无法判断描述是否锁定了自己那次特定的发生,导致评测与训练两头都缺失对『区分性』的约束。
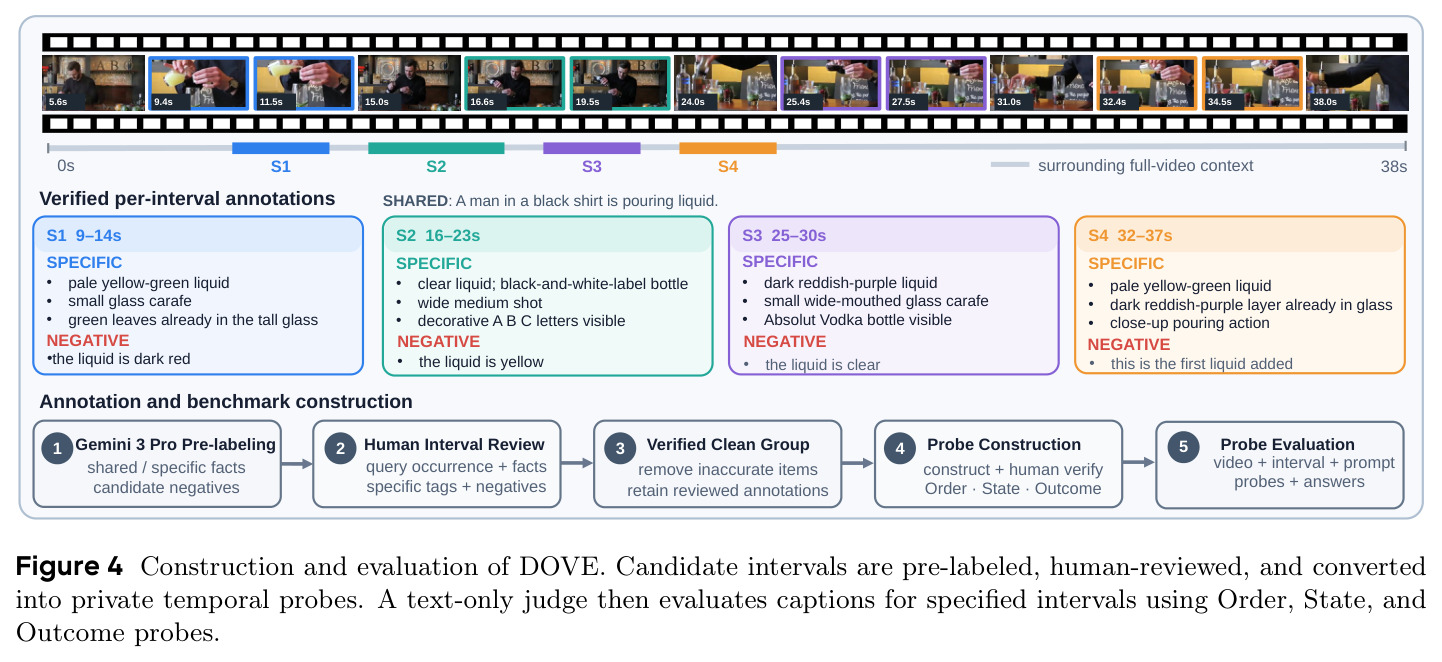
本文的目标是本文的目标是把 ECCV 版 CycleGRPO(仅限图像掩码/框)推广为几何无关的学习原则:将区域抽象为可度量空间 $\Omega$ 中的对象 $R$,只要求 $\Omega$ 提供(i)让 MLLM 能读写区域的序列化器,和(ii)有界一致性函数 $S_\Omega(R,\hat R)\in[0,1]$(重构重叠)。在此抽象下,同一个『区域→文本→区域』循环即可统一覆盖图像掩码/框(空间)、视频时间区间(时间)、以及带时间戳的框证据(时空)三种区域空间。训练侧的明确目标是:RL 阶段每个样本只含 $(X,R)$,不需要参考描述、外部 LLM 裁判或学习型奖励模型,同时优化理解与定位两个方向。评测侧,针对视频重复发生带来的盲区,作者提出 DOVE 基准,用同查询重复事件的对比组检验描述能否区分目标发生点,并以 Order/State/Outcome 三类探针的宏平均 TEC 汇总证据覆盖。
与已有工作不同的是,已有工作的切入角度大致分三类:(1) 区域描述 RL 依赖额外 critic 或 vision-free answerer 给生成描述打分,仍需外部评分器;(2) 指代定位 RL 用规则几何奖励,但只优化语言→区域单向;(3) Open-o3-Video 等时空证据方法从推理轨迹或配对证据标注学习,同样偏重语言→区域方向,没有把逆方向纳入训练信号。本文的独特之处在于让同一个策略先当描述器、再当自己的批评者:先为区域采样候选描述,再把每条描述定位回区域,用重构重叠这一几何可验证信号同时奖励两个方向。定位不再是冻结的打分模块,其轨迹本身也在组内被 GRPO 优化;理解侧则彻底摆脱参考文本。这种『单一策略内部的自评价闭环』与借助 teacher 模型或外部裁判的做法有本质区别,也是把 cycle consistency 首次推广到时间与时空区域空间的尝试。
核心方法
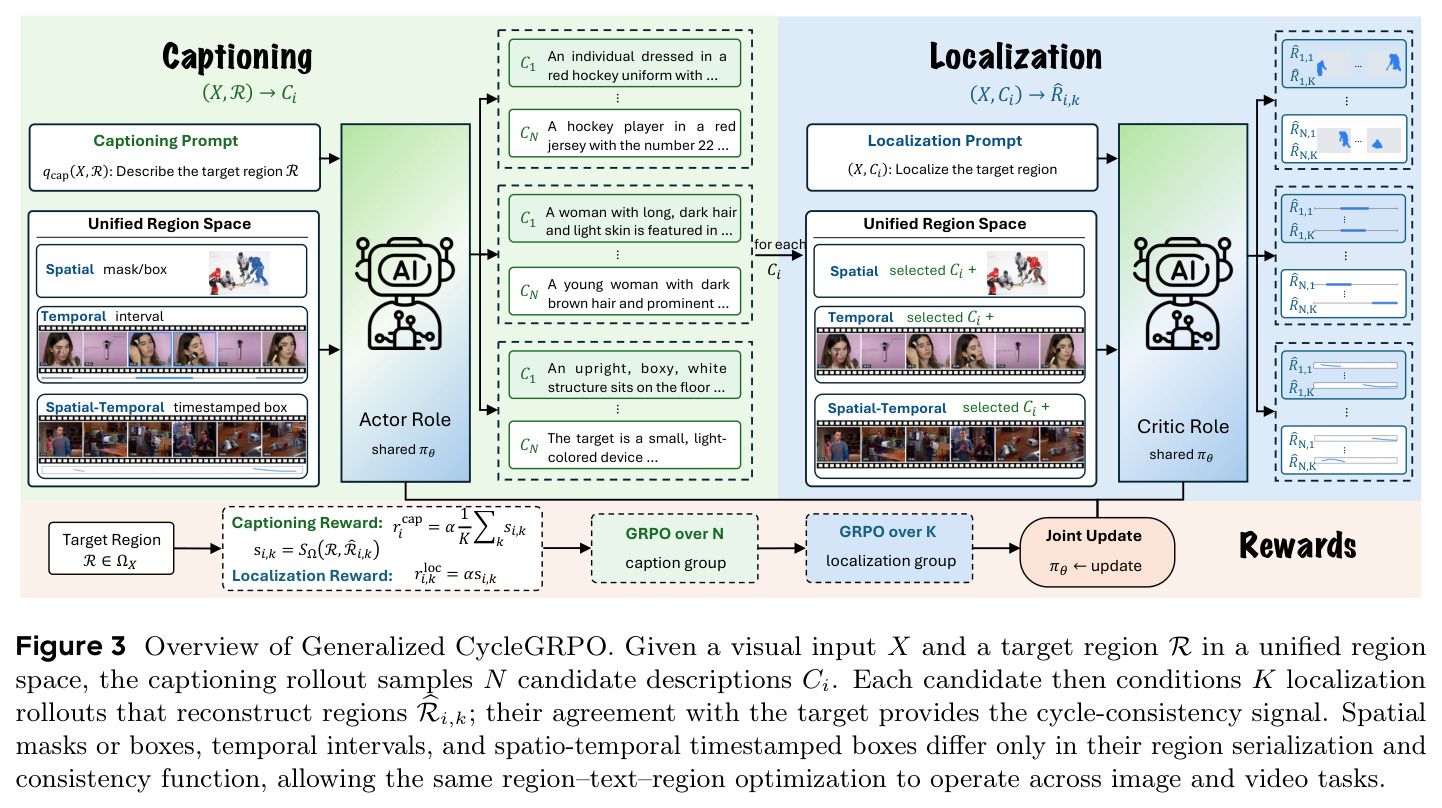
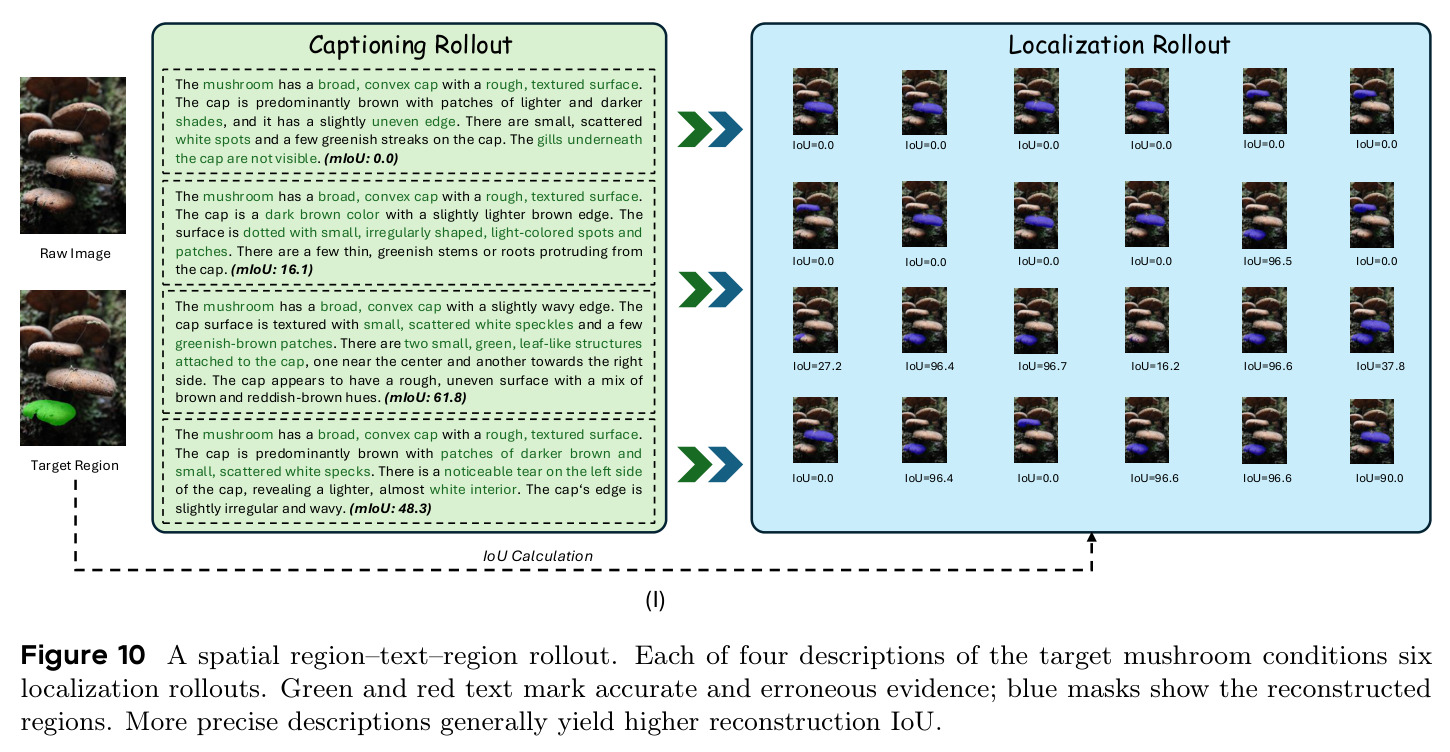
直觉上,『好的区域描述』应当忠实且可区分,检验标准很朴素:模型拿着这段描述,能否把原区域找回来?本文把这变成可计算的奖励。技术上,给定视觉输入 $X$ 与目标区域 $R\in\Omega_X$,同一个自回归策略 $\pi_\theta$ 用不同指令模板实现两个互逆映射:$f_\theta:(X,R)\mapsto C$(描述)与 $g_\theta:(X,C)\mapsto\hat R$(定位)。训练采用嵌套 rollout:先采 $N$ 条候选描述,每条再条件化 $K$ 次定位采样;用一致性 $s_{i,k}=S_\Omega(R,\hat R_{i,k})$ 与内层均值 $\bar{s}_i$ 构造两级奖励,分别在描述组与定位组内做组相对优势,最后以 $J_{\text{CycleGRPO}}=\lambda_{\text{cap}}J_{\text{cap}}+\lambda_{\text{loc}}J_{\text{loc}}$ 联合更新共享参数。其隐含逻辑是:幻觉描述会重构出无关区域,过度泛化的描述无法可靠回到指定区域,最大化 $\bar{s}_i$ 因此会隐式逼迫描述写出区分目标发生点的具体细节。
核心创新是『用区域重构评价描述,并用同一循环训练双向』:描述质量不再由参考文本相似度或外部裁判评分,而由模型自身把描述定位回源区域的重构重叠来度量——这是一个几何上可验证、零参考的奖励。与已有方法的本质区别有三点。其一,RL 阶段每个样本只含 $(X,R)$,无参考 caption、无外部 LLM judge、无奖励模型,监督瓶颈被直接移除。其二,定位不是冻结的评分器:内层 $K$ 条定位轨迹各自获得奖励 $r^{\text{loc}}_{i,k}=\alpha s_{i,k}+\Phi^{\text{loc}}$ 并在组内被优化,两个方向同时进步。其三,几何无关性:换区域空间只需换序列化器与一致性函数(掩码 token 一致性或解码 IoU、合并区间后的 tIoU、或带 $\tau=3$ 秒时间门的一对一匹配支撑重叠 $S_{\text{ST}}$),Eq. 4–13 完全不变。在视频场景中,只有当描述把目标区间(而非相似重现)重构回来才得分,这使时间区分性——事件的顺序、状态、结果线索——成为循环闭合的内在要求,而非附加的正则。
方法步骤详情
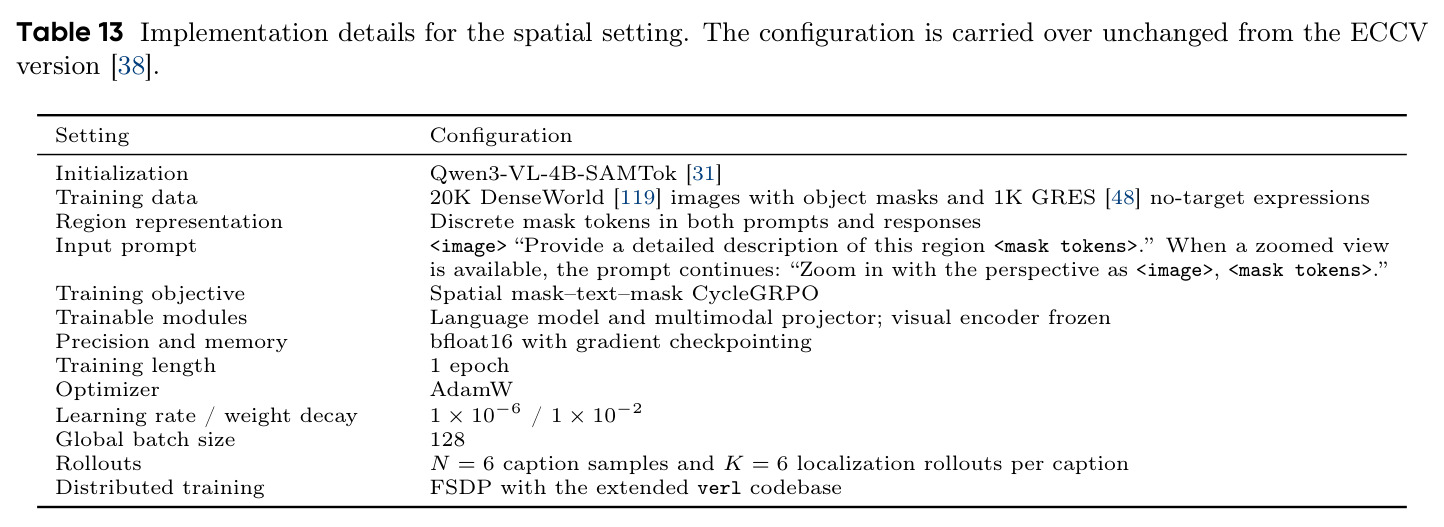
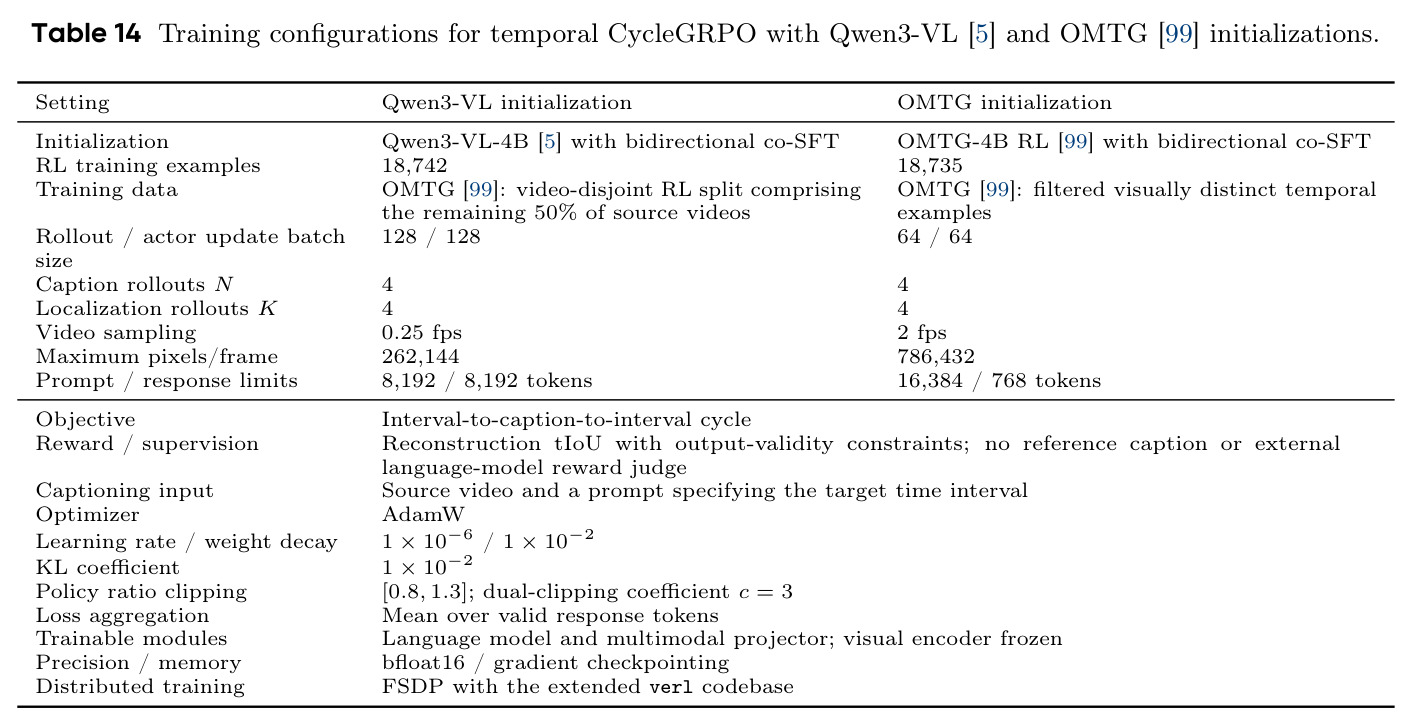
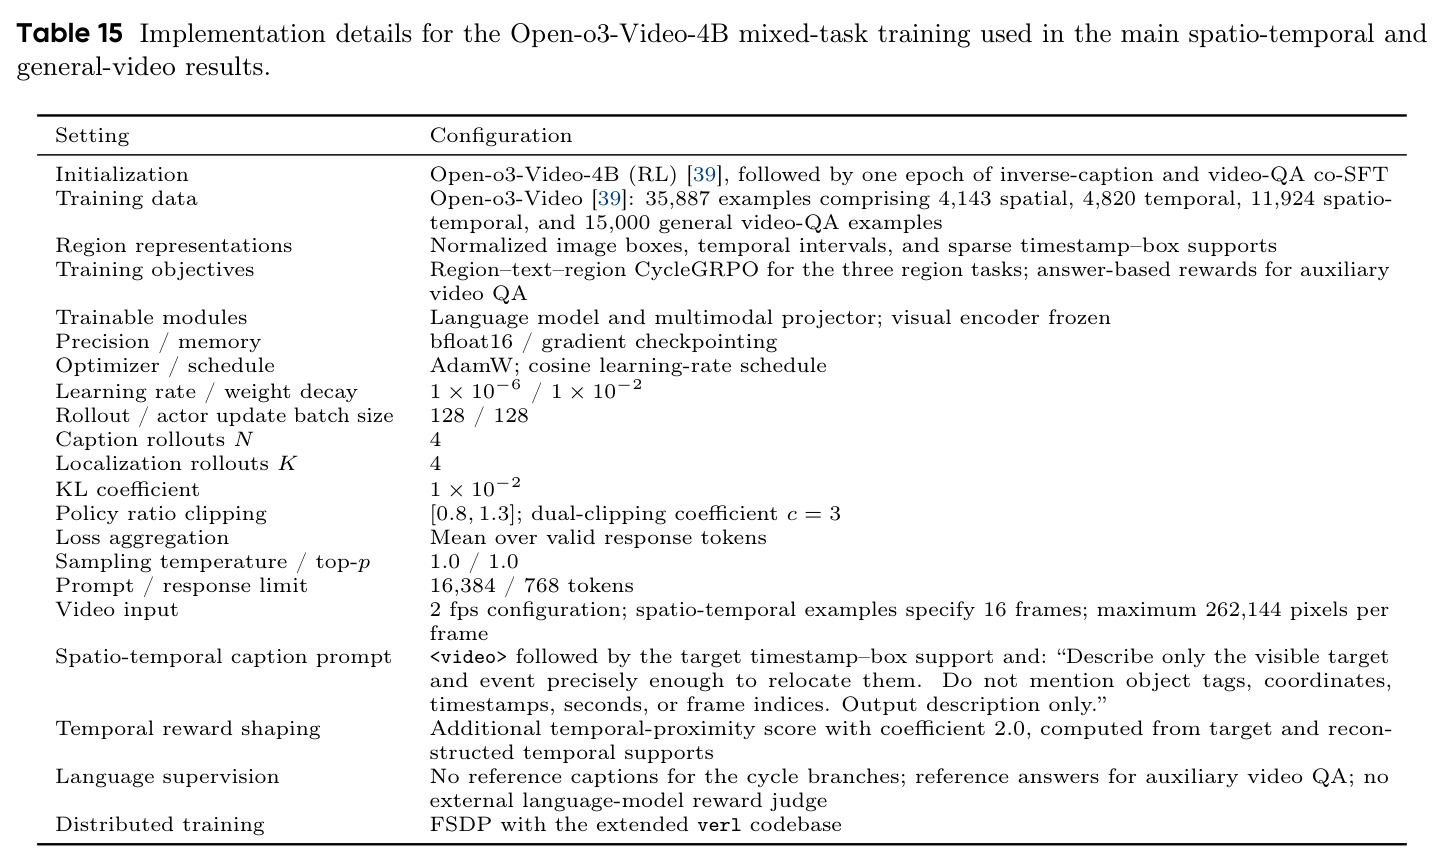
以时间任务为例:(1) 输入 $(X,R)$(区间栈),构造描述提示。(2) 采 $N$ 条描述 $C_i$(Eq. 4);惩罚显式时间戳并在定位提示构造前删除,防坐标泄漏。(3) 每条 $C_i$ 独立采 $K$ 条区间预测 $\hat R_{i,k}$(Eq. 5),多次平均估计描述锁回源区间的可靠性。(4) 计算一致性 $s_{i,k}=S_\Omega(R,\hat R_{i,k})$ 与均值 $\bar{s}_i$(Eq. 6):空间用掩码 token 一致性或解码 IoU;时间用合并区间后的 tIoU;时空用一对一匹配的支撑重叠,$|t_a-\hat t_b|>\tau{=}3$ 秒的配对权重置零(Eq. 15)。(5) 奖励 $r^{\text{cap}}_i=\alpha\bar{s}_i+\Phi^{\text{cap}}$、$r^{\text{loc}}_{i,k}=\alpha s_{i,k}+\Phi^{\text{loc}}$,$\Phi$ 仅含防泄漏、重复与序列化合法性等免参考检查;时间另有无效区间数的乘性门控,时空另加时间邻近整形。(6) 分组优势:$N$ 条描述一组(Eq. 9),同一父描述下 $K$ 条定位一组(Eq. 10)。(7) 优化:裁剪 $[0.8,1.3]$、负优势 dual-clip $c{=}3$、KL $10^{-2}$;两任务损失等权累积后一次 AdamW 更新(学习率 $10^{-6}$,视觉编码器冻结,verl+FSDP;空间 $N{=}K{=}6$,时间/时空 $N{=}K{=}4$)。
技术新颖性
技术新颖性可归纳为五点。(1) 统一抽象:首次把空间掩码/框、时间区间、时间戳空间证据纳入同一『区域-文本-区域』循环,区域空间 $\Omega$ 的序列化器与一致性函数是唯一需要更换的接口,学习规则跨域共享。(2) 嵌套 rollout:外层 $N$ 条描述、内层每条 $K$ 次定位,内层均值 $\bar{s}_i$ 度量的是描述定位的『可靠性』而非单次运气,直接对应『描述必须唯一确定源区域』的语义。(3) 双层组相对优势保持比较语义:描述在『能否闭合循环』上横向竞争,定位样本在『同一描述下谁的几何更准』上竞争,两组互不污染。(4) 时空一致性函数的算法细节:最大权一对一匹配加 $\tau=3$s 时间门、未匹配锚点计入并集,使『对的对象+错的时间』与『对的时间+错的框』都拿不到交集分数。(5) DOVE 是首个针对同视频同查询重复事件区分性的对比式基准,私有 Order/State/Outcome 探针加纯文本裁判,避免了参考匹配与整体打分的主观性。相对 ECCV 版的四点扩展(几何泛化、时间/时空实例化、DOVE、十余个基准验证)清晰划定了增量贡献。
实验结果
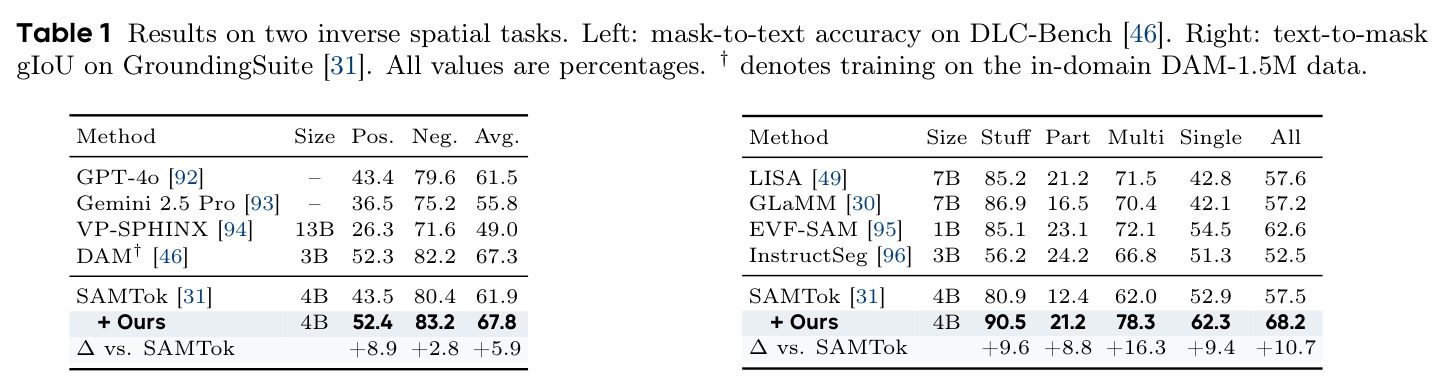
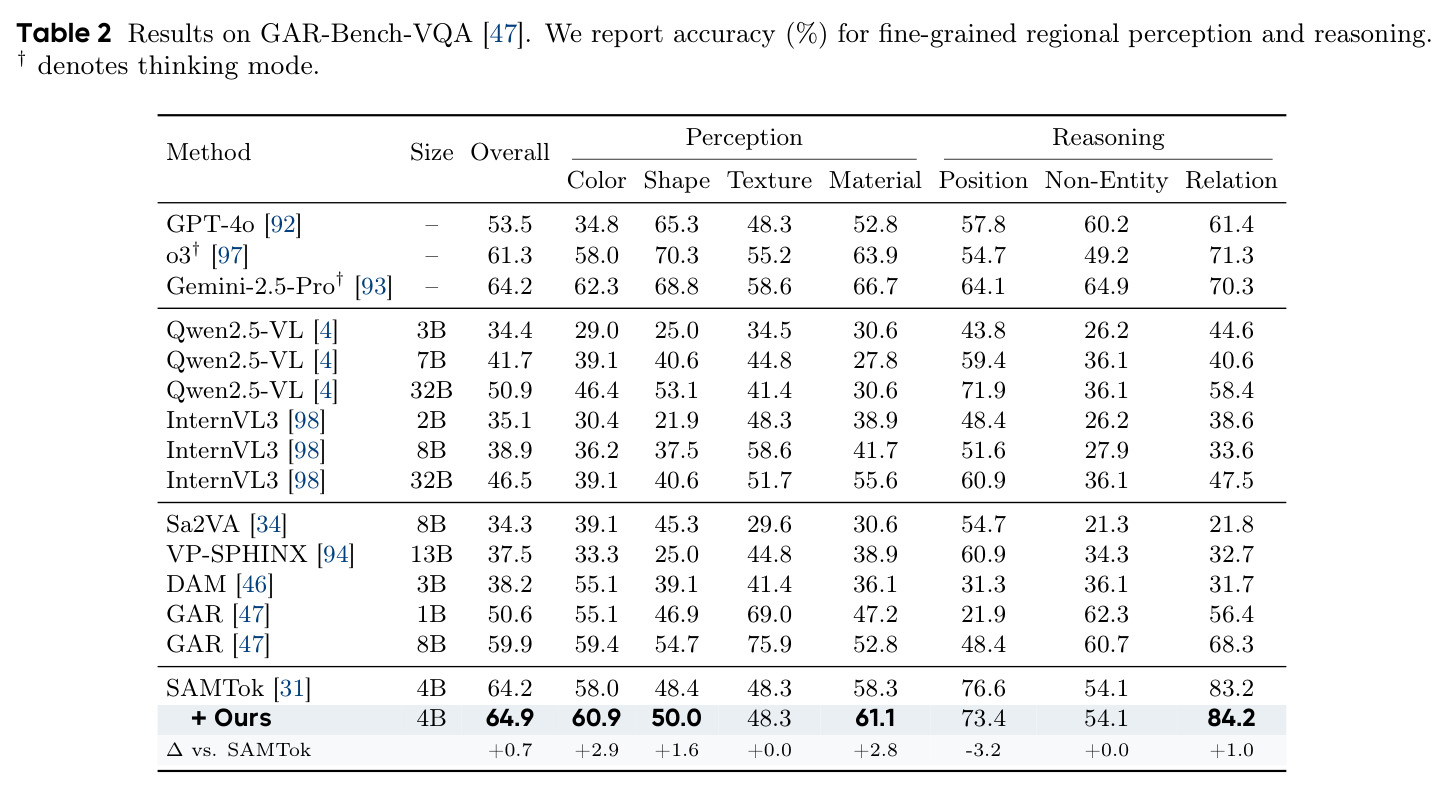
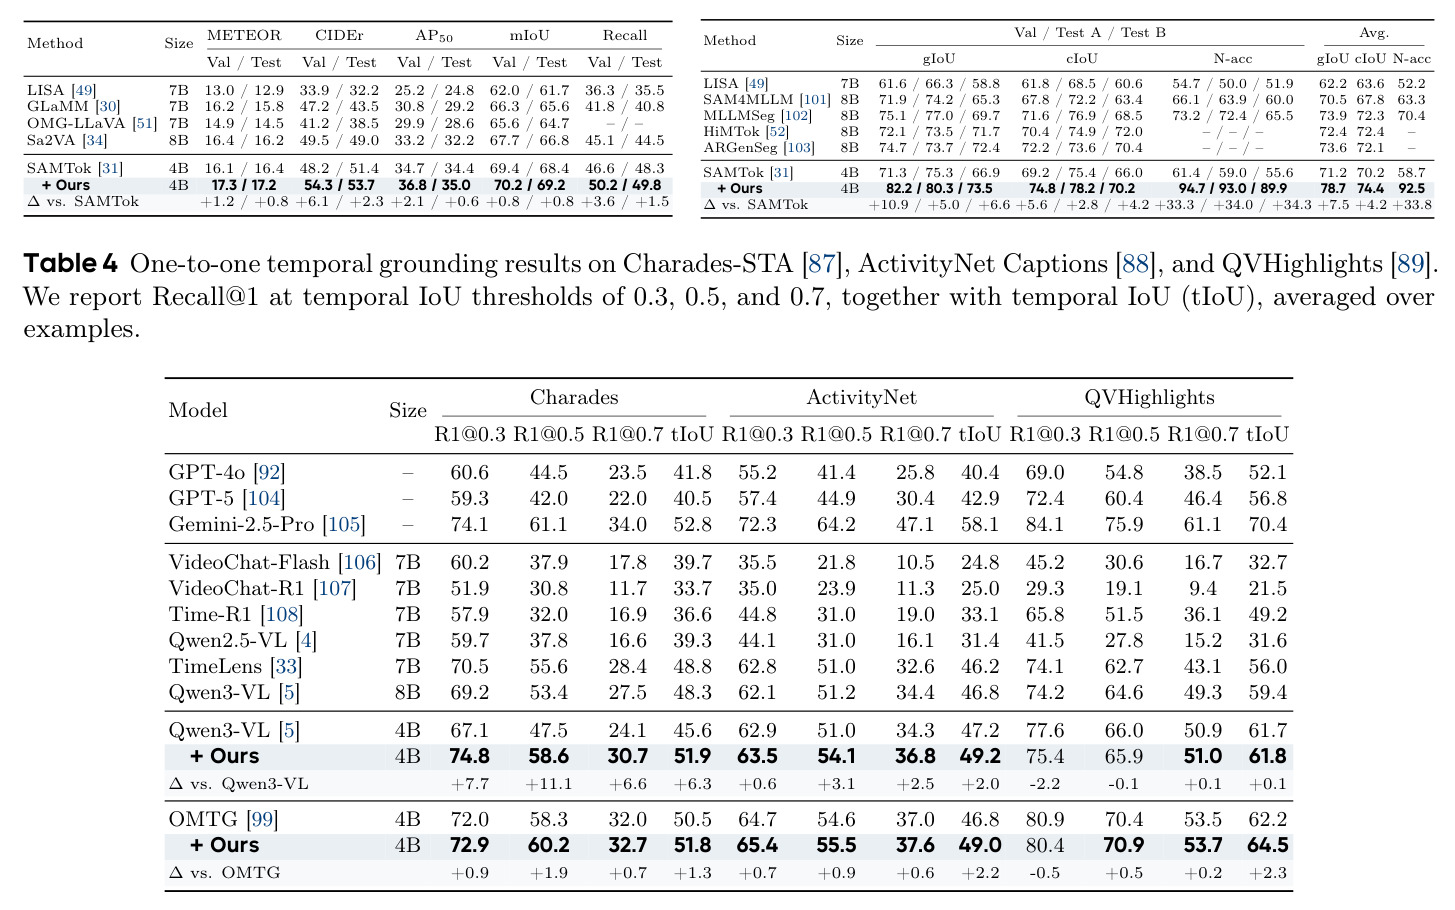
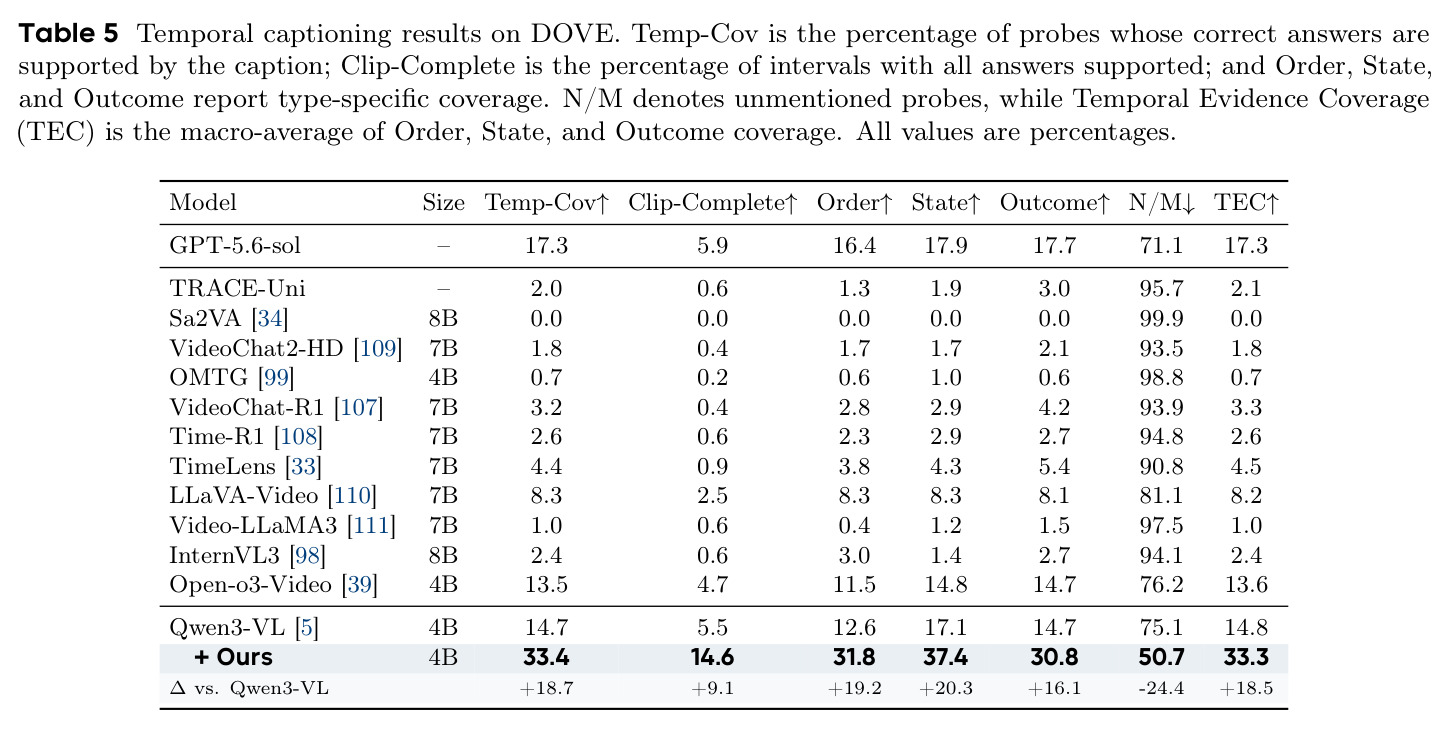
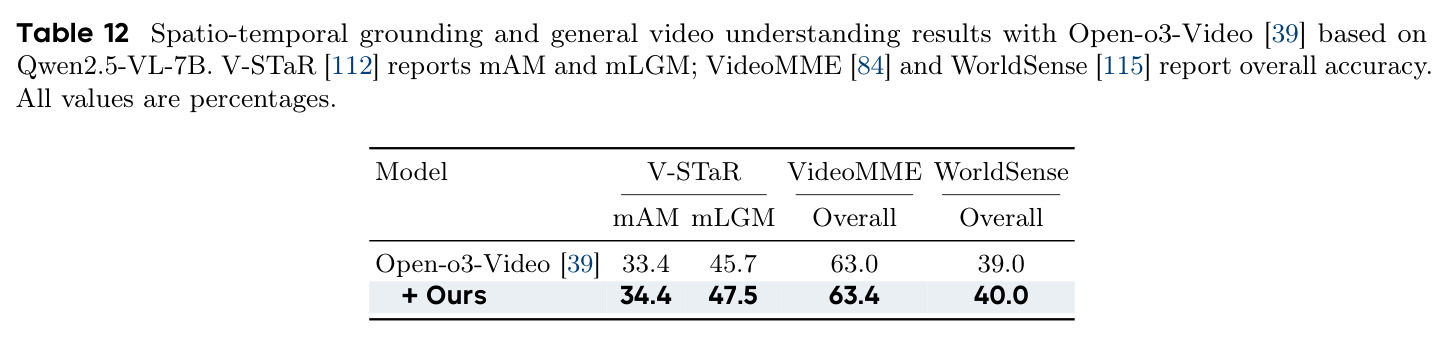
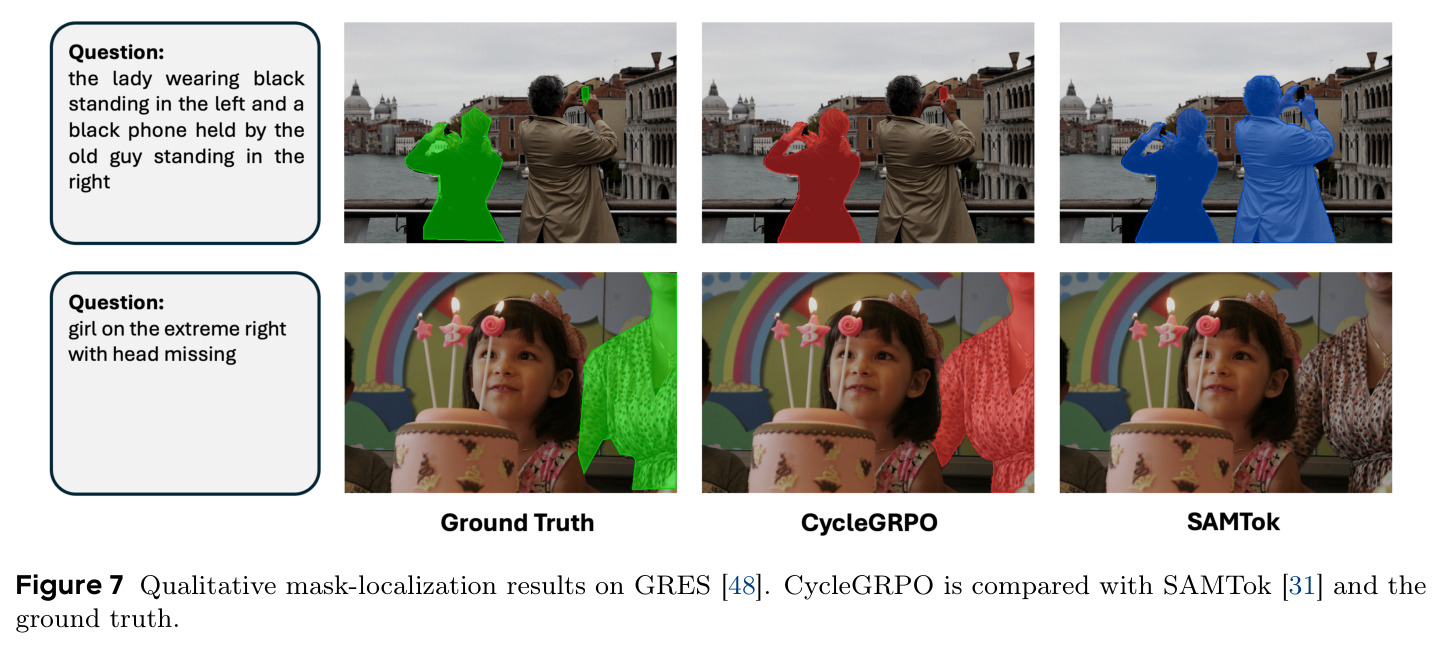
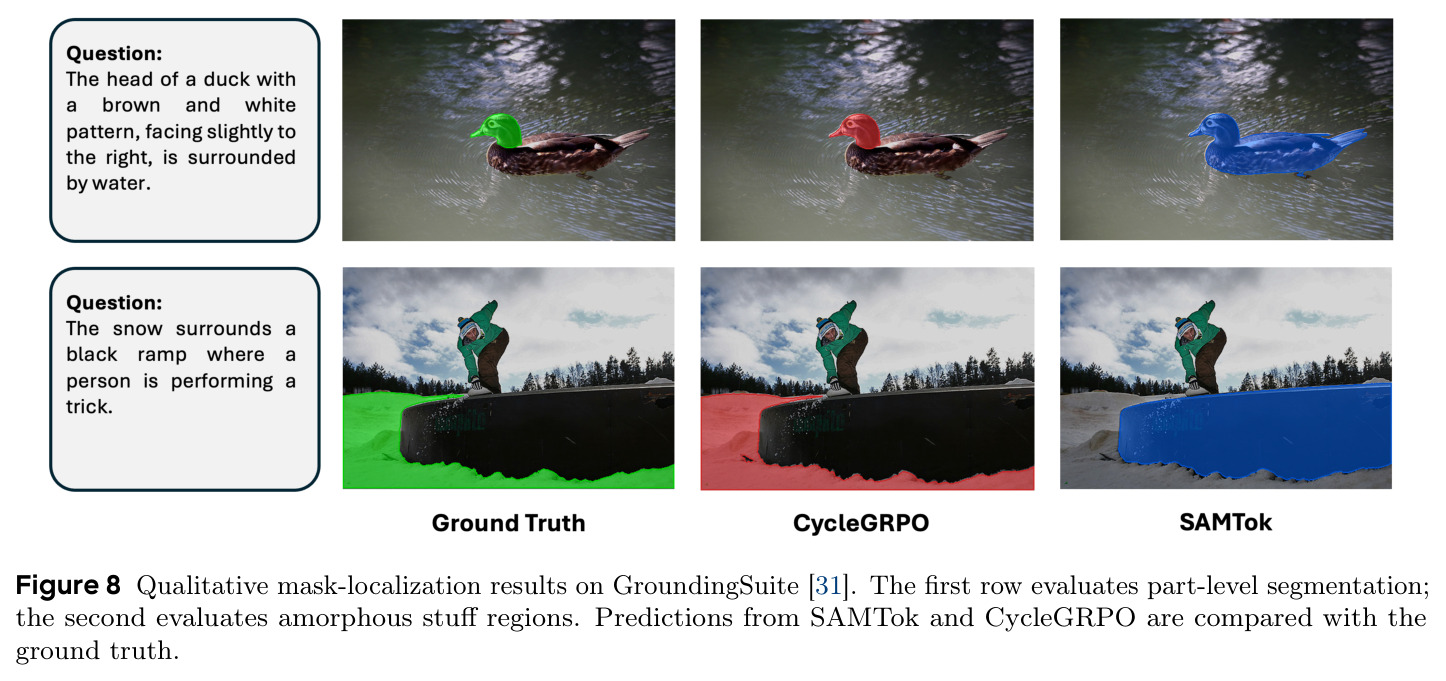
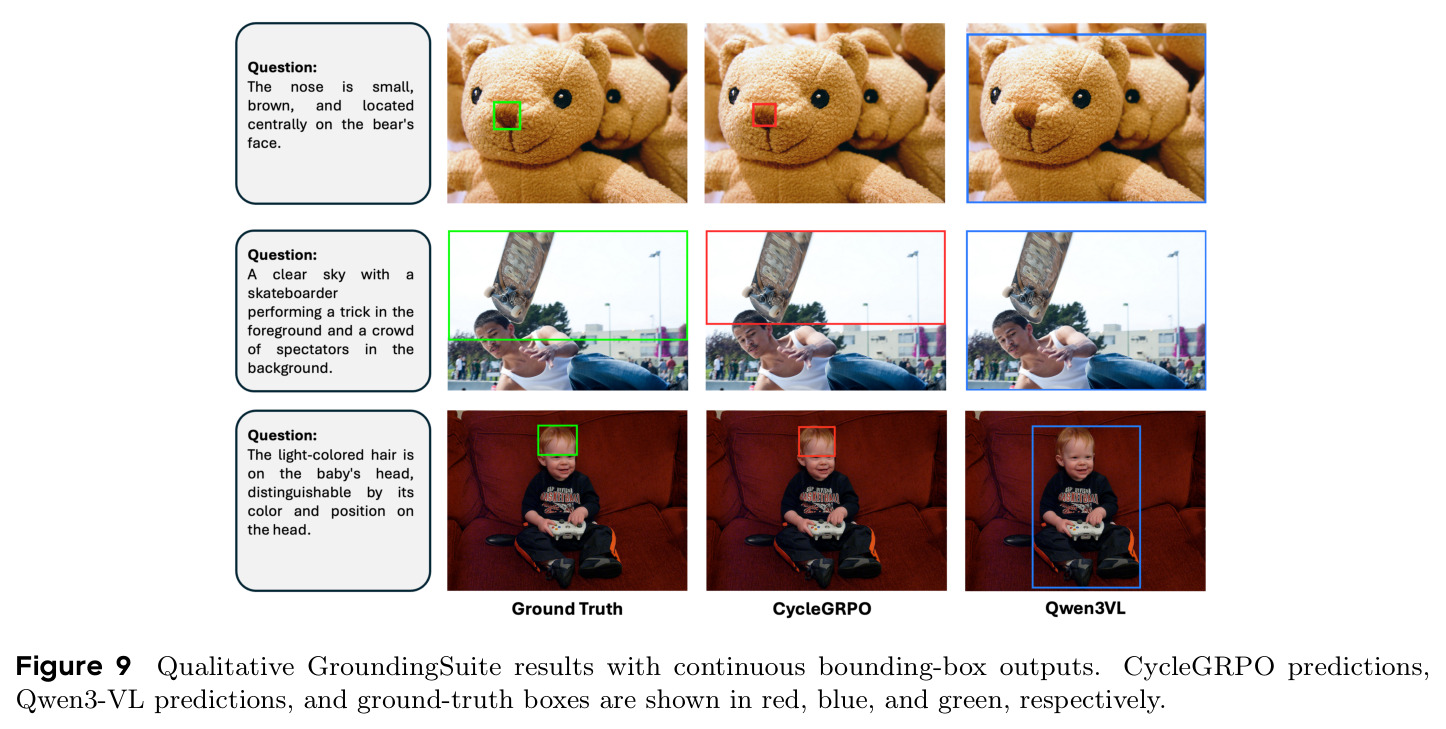
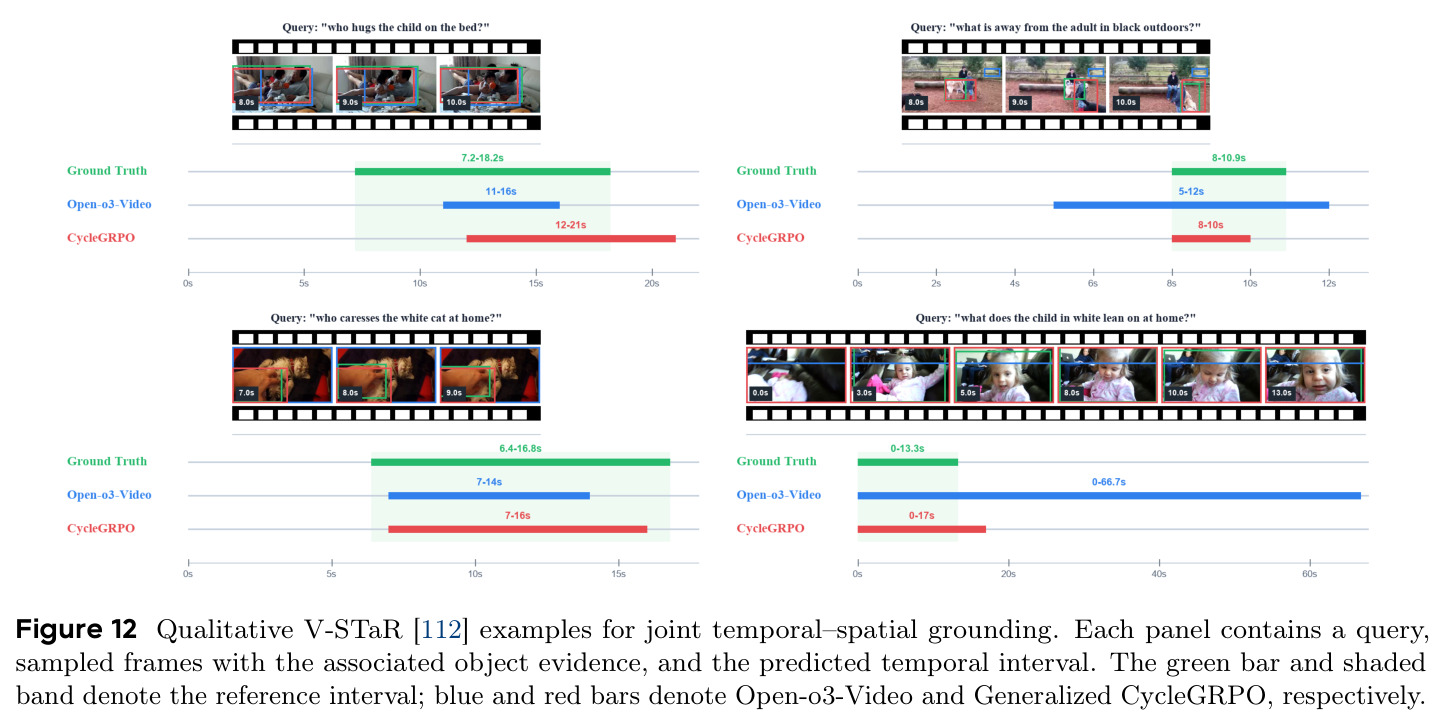
空间(SAMTok-4B):GroundingSuite gIoU 57.5%→68.2%(+10.7,多目标 +16.3);GRES gIoU 71.2%→78.7%、无目标拒绝 58.7%→92.5%;DLC-Bench 61.9%→67.8%(正探针 +8.9,超域内训练的 DAM 67.3%);GCG 十项全升(val CIDEr 48.2→54.3);GAR-Bench 64.2%→64.9% 但 position 回退 3.2。连续框跨骨干:Qwen3-VL-4B/8B 的 GroundingSuite 均 71.4%→74.1%,SAMTok-8B DLC-Bench 63.7%→68.1%。时间(Qwen3-VL 初始化):Charades tIoU 45.6%→51.9%(R1@0.5 47.5%→58.6%)、ActivityNet 47.2%→49.2%、QVHighlights 持平(R1@0.3 回退 2.2);OMTG-4B 初始化更均衡:三数据集 tIoU 50.5%→51.8%、46.8%→49.0%、62.2%→64.5%。DOVE 增益最大:TEC 14.8%→33.3%(95% CI 15.8–21.3)、N/M 75.1%→50.7%,超 Open-o3-Video-4B(13.6%)与 GPT-5.6-sol(17.3%)。时空(Open-o3-Video-4B):V-STaR mAM/mLGM 34.6/47.2→36.2/49.8(超 7B 版),TVGBench 21.1%→28.5%,VideoMME 61.0%→62.3%、WorldSense 39.3%→40.2%、VideoMMMU 58.0%→59.7%。消融:DOVE TEC 上 captioning-only 17.0%、localization-only 29.4%、完整循环 33.3%;时空五基准完整循环全部最优。
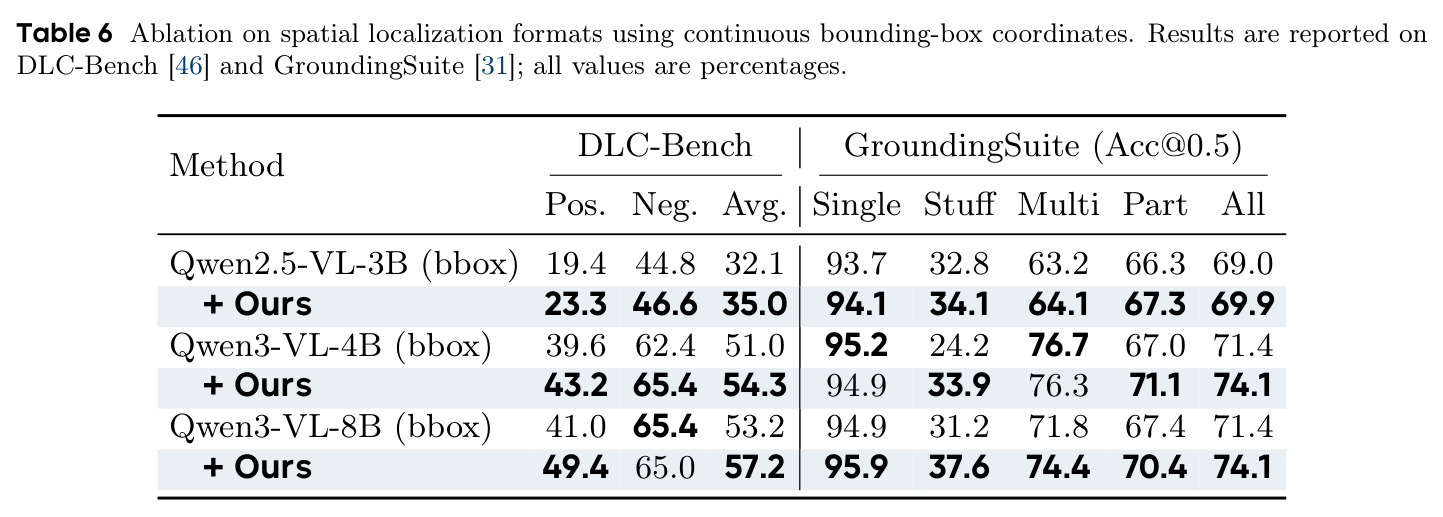
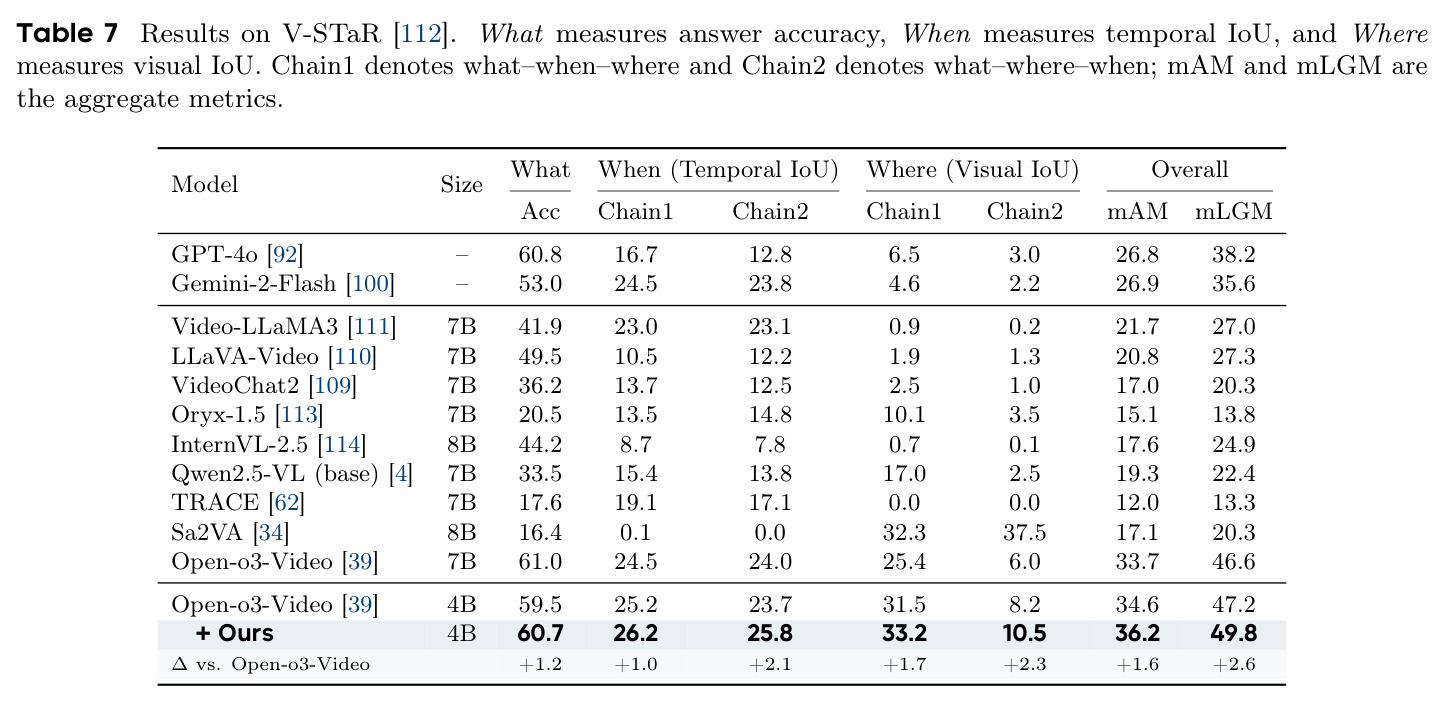
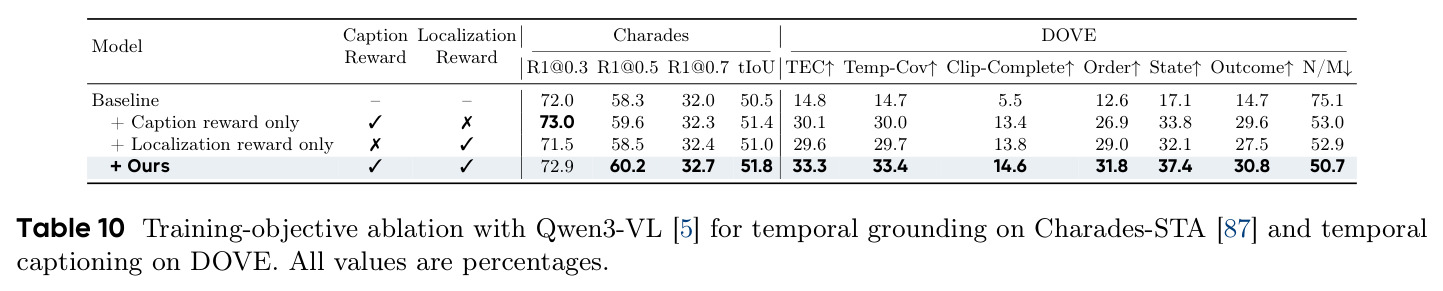
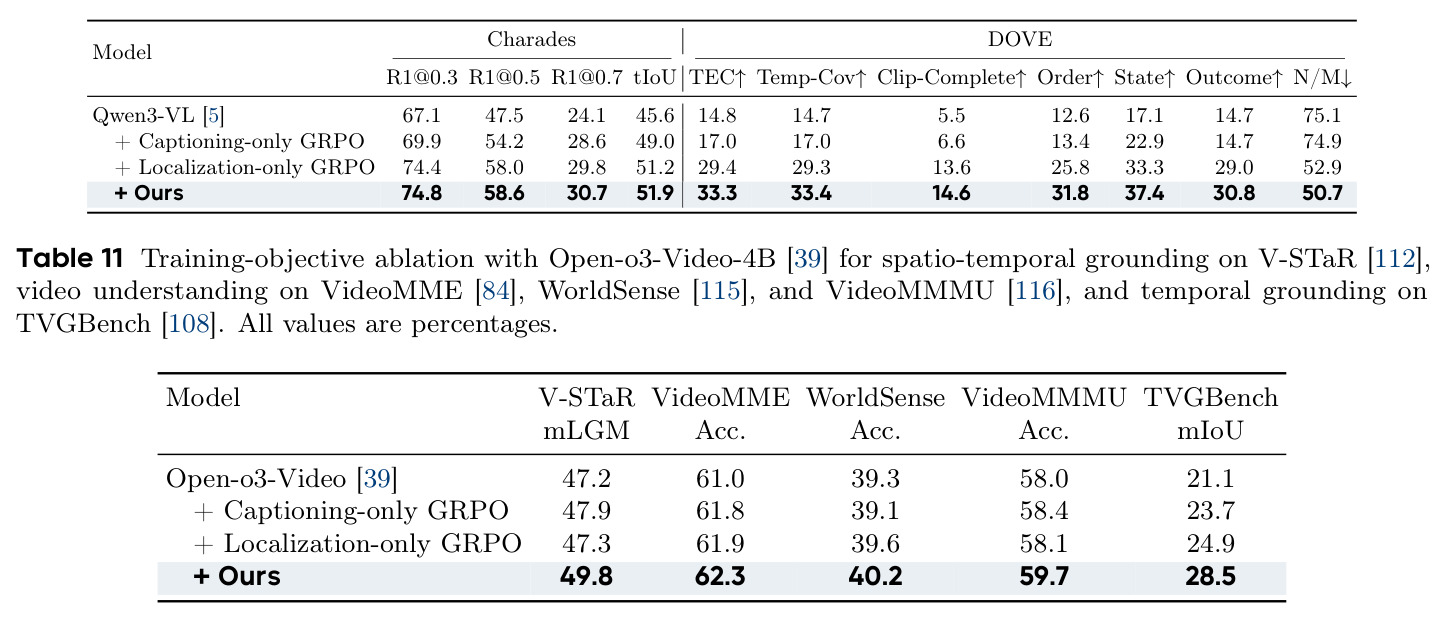
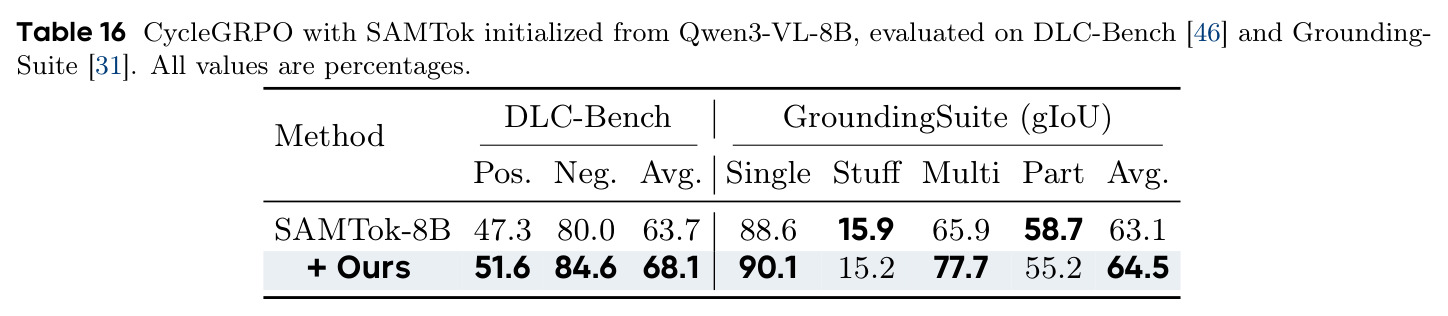
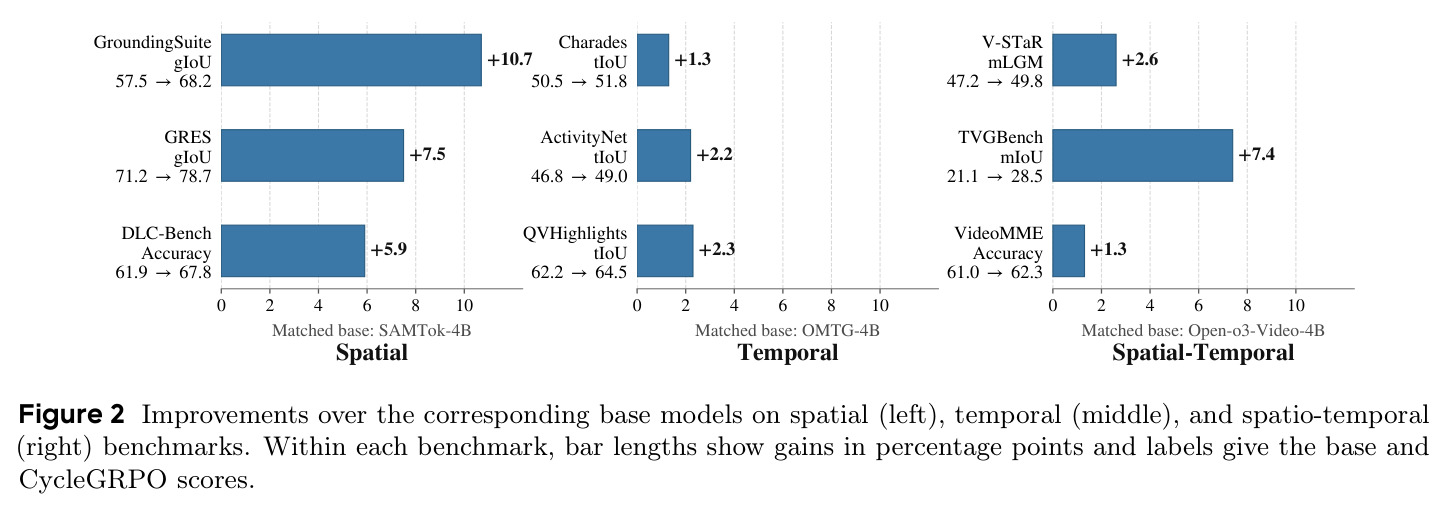
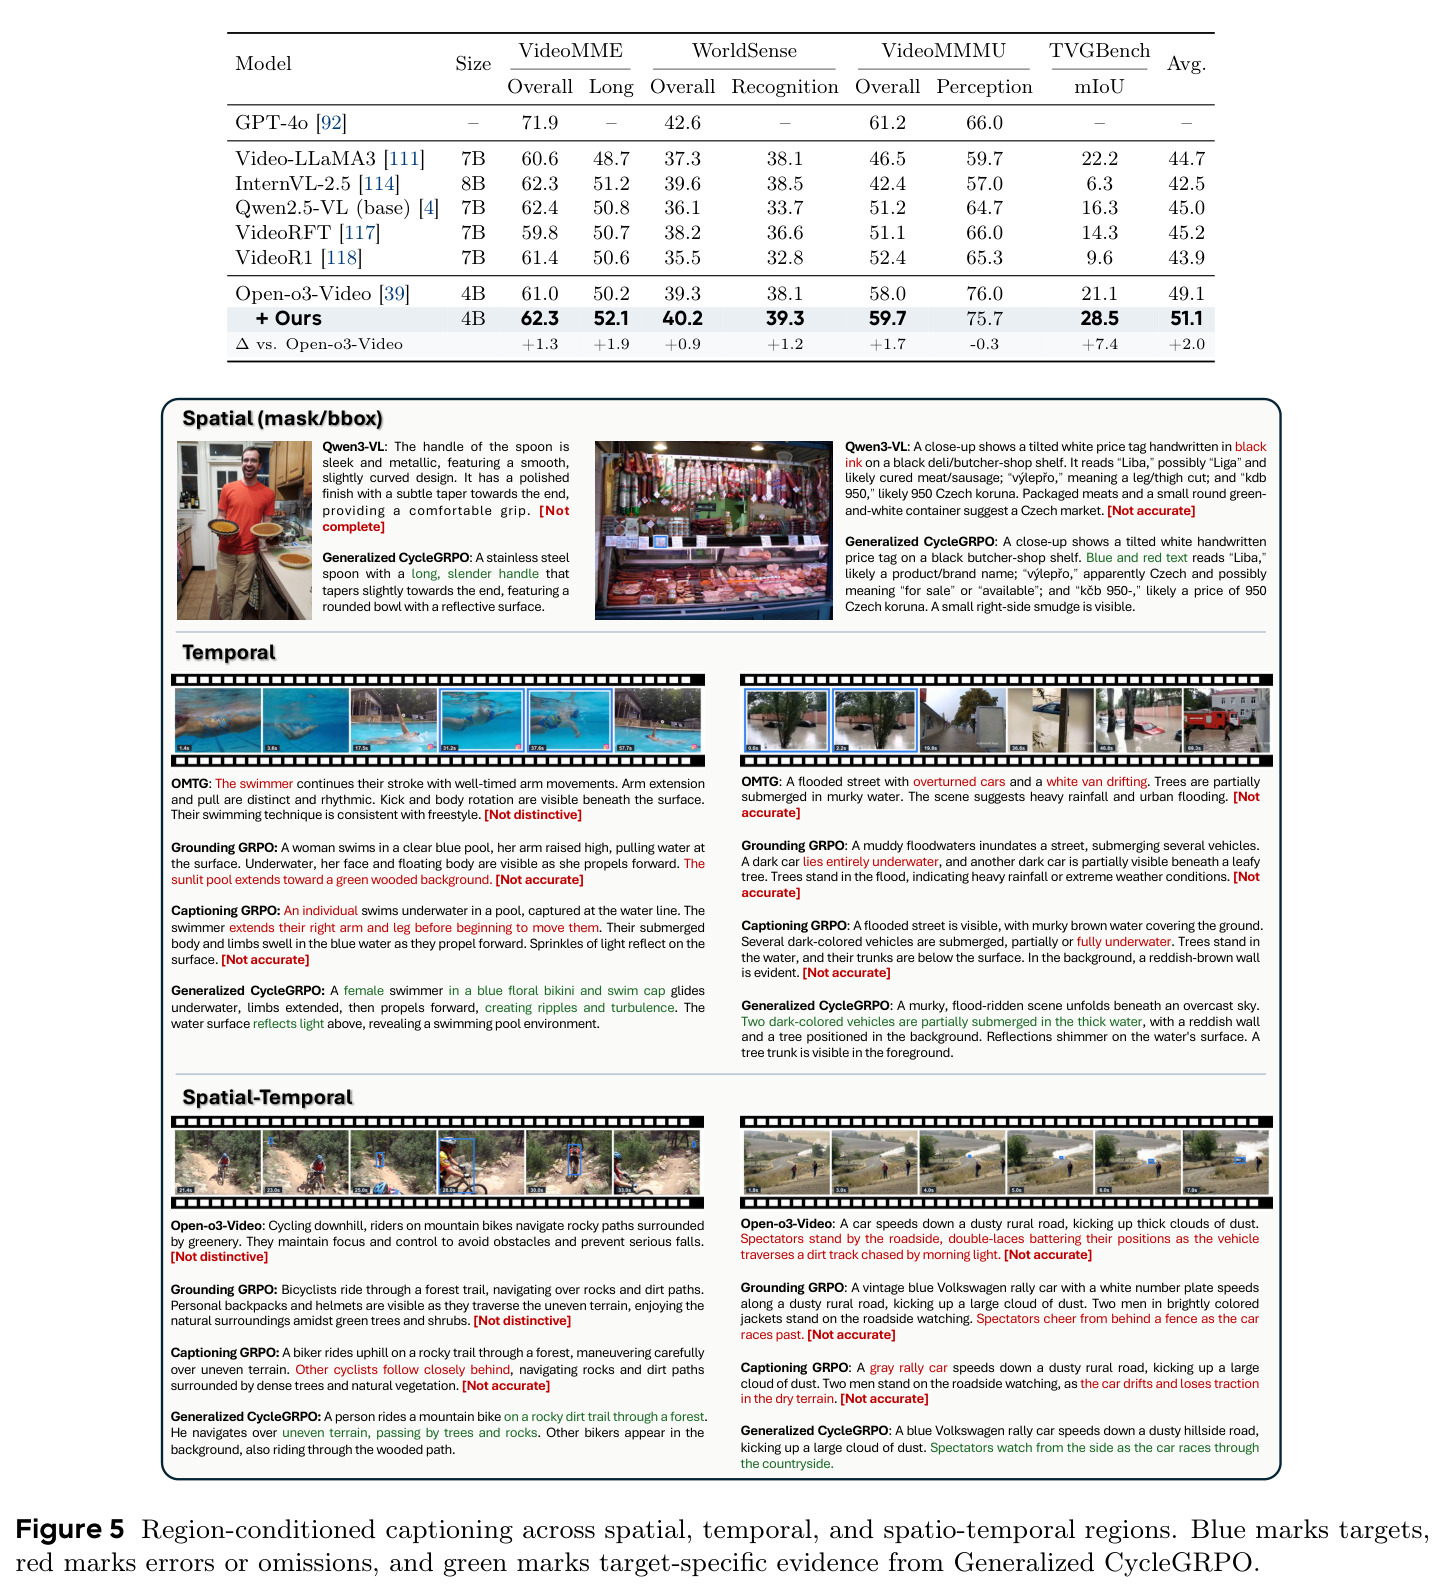
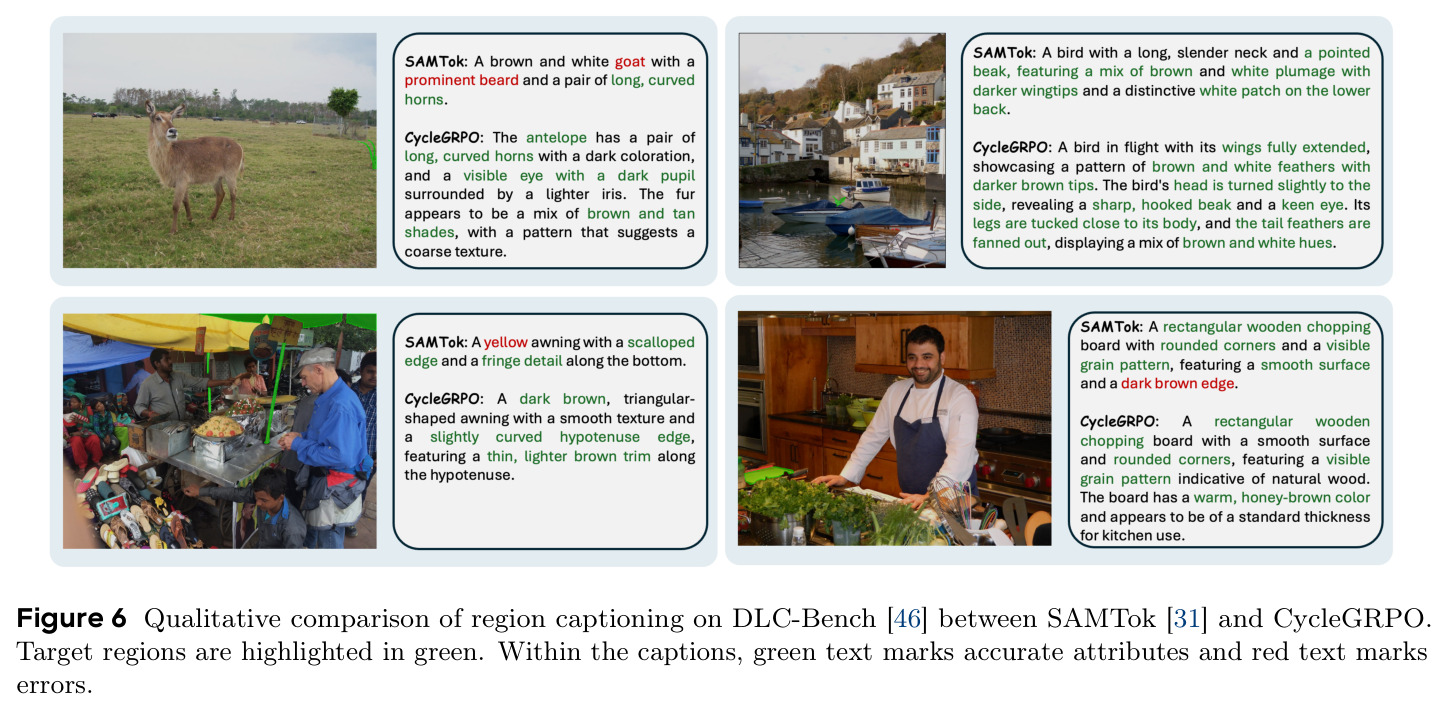
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 图像指代定位(GroundingSuite) | 总体 gIoU | 68.2% | SAMTok-4B 57.5% | +10.7 个百分点(Multi 子集 +16.3) |
| 广义指代分割(GRES 三划分平均) | gIoU | 78.7% | SAMTok-4B 71.2% | +7.5 个百分点;无目标 N-acc 58.7%→92.5%(+33.8) |
| 掩码描述(DLC-Bench) | 平均准确率 | 67.8% | SAMTok-4B 61.9%(DAM 67.3%) | +5.9 个百分点,正探针 +8.9 |
| 交错文本-掩码生成(GCG) | 验证集 CIDEr | 54.3 | SAMTok-4B 48.2 | +6.1,十项指标全部提升 |
| 区域级感知推理(GAR-Bench-VQA) | 总体准确率 | 64.9% | SAMTok-4B 64.2% | +0.7 个百分点(position 子项 -3.2 回退) |
| 时间定位(Charades-STA,Qwen3-VL-4B 初始化) | tIoU | 51.9% | Qwen3-VL-4B 45.6% | +6.3 个百分点(R1@0.5 +11.1) |
| 时间定位(ActivityNet,OMTG-4B 初始化) | tIoU | 49.0% | OMTG-4B 46.8% | +2.2 个百分点 |
| 时间定位(QVHighlights,OMTG-4B 初始化) | tIoU | 64.5% | OMTG-4B 62.2% | +2.3 个百分点 |
| 发生级视频描述(DOVE,Qwen3-VL-4B 初始化) | TEC(Order/State/Outcome 宏平均) | 33.3% | Qwen3-VL-4B 14.8%(GPT-5.6-sol 17.3%、Open-o3-Video-4B 13.6%) | +18.5 个百分点(95% CI 15.8–21.3) |
| 时空定位(V-STaR) | mLGM | 49.8% | Open-o3-Video-4B 47.2% | +2.6 个百分点,超过 7B 版的 46.6% |
| 时间定位(TVGBench) | mIoU | 28.5% | Open-o3-Video-4B 21.1% | +7.4 个百分点,超过全部开源基线 |
| 通用视频理解(VideoMME) | Overall 准确率 | 62.3% | Open-o3-Video-4B 61.0% | +1.3 个百分点 |
局限与改进
作者承认的局限:区域重构只是描述质量的代理,可重构不等于完整、流畅或无幻觉;防泄漏规则无法枚举所有隐式捷径;闭环假设初始策略双向基本可用,定位不可靠时描述侧收到噪声信号——这解释了收益随初始化和域波动;嵌套 $N\times K$ rollout 比单向 GRPO 更贵;DOVE 只覆盖给定区间内视觉可分辨的事件,不含音频、也不要求发现事件边界。我的补充观察:(1) DLC-Bench 正探针仅 52.4%,描述『区域内有什么』的绝对水平仍明显低于负探针的 83.2%;(2) GAR-Bench position 下降 3.2 个百分点(76.6%→73.4%)、VideoMMMU Perception 微降 0.3,循环目标与部分空间推理维度冲突;(3) 时空绝对增益小(mLGM +2.6),失败案例显示长视频尾部漏检、时间过宽与语义幻觉(海獭追火鸡被说成追鹿)仍存;(4) DOVE 判官是 Qwen2.5-72B 纯文本判定,可能引入裁判偏置,1223 条探针规模偏小;(5) GRES 无目标准确率 58.7%→92.5% 部分归功于训练混入 1K 无目标表达,并非纯循环效应。
独立分析的弱点
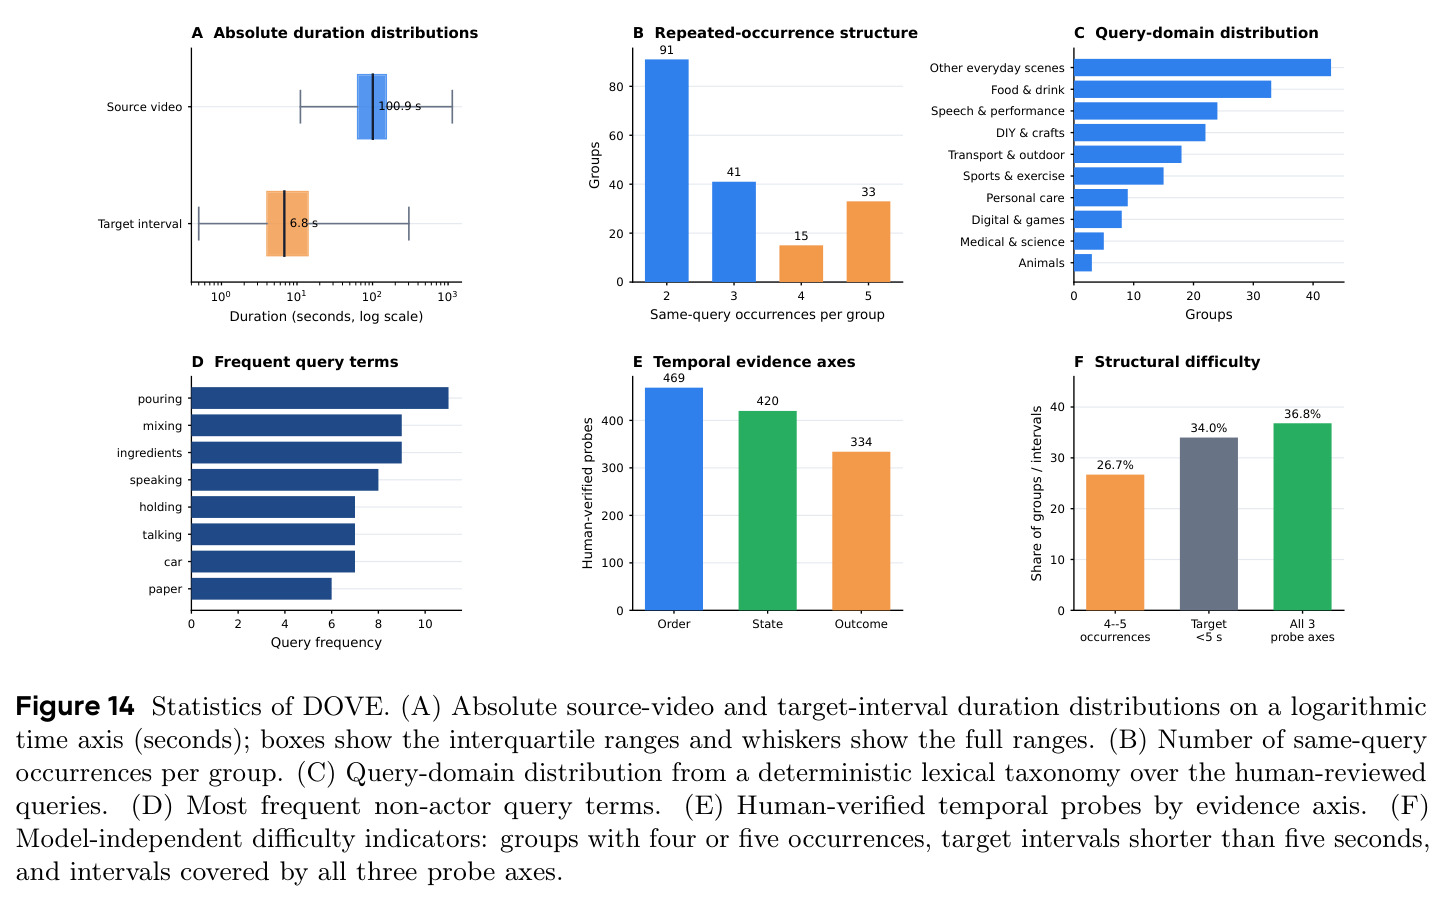
独立分析的弱点与改进方向:(1) 『可定位』与『正确』不等价——含事实错误但定位等价的描述可拿满重构奖励,几何重叠惩罚不了不改变定位结果的错误细节;可加轻量自验证探针或原子事实自一致性检查作辅助奖励。(2) 共适应与简码风险——描述器与定位器共享参数,可能收敛到『自己容易定位的私有简码』而牺牲人类可读性;GCG CIDEr 同步上升(48.2→54.3)部分缓解担忧,但缺人工可读性评估,建议定期人评或加流畅性正则。(3) 计算成本——空间 $N{=}K{=}6$ 意味着每样本约 36 次自回归生成,比单向 GRPO 贵一个量级;可用自适应 rollout 分配、内层轨迹复用与 KV-cache 共享摊薄。(4) 对初始策略的依赖造成跨域方差——Qwen3-VL 初始化在 QVHighlights 上 R1@0.3 从 77.6% 降到 75.4%;可先做定位增强 SFT 预热,或按『视觉可区分性』课程化筛选训练区间(OMTG 的离线筛选已暗示此路线)。(5) DOVE 规模小且判官单一——180 组、1223 探针、单一 72B 文本裁判;扩规模、多裁判与人工抽样校验可提高稳健性。
未来方向
作者提出的方向:在几何一致性之外补充免参考的语义覆盖、事实性与不确定性信号,同时保持框架的自评价性质;用自适应 rollout 分配、轨迹复用和蒸馏降低嵌套循环的训练成本;把同一原则推广到音视频事件、3D 区域与具身轨迹;把 DOVE 扩展到这些设定以及『描述+边界发现』的联合任务。基于本文成果可自然延伸的研究:(1) 3D 场景与具身导航中的区域-语言闭环,例如以 3D 边界框或占用网格作为区域空间 $\Omega$;(2) 把 TEC 式区分性探针反哺为训练时的奖励塑形,直接优化『区分同查询重复事件』而非只在评测时检查;(3) 与答案奖励的组合——本文在时空混合训练中 QA 用答案奖励、区域任务用循环奖励,二者的自适应加权与冲突分析值得深入研究;(4) 循环一致性与测试时扩展(自一致性投票)结合的在线自评价机制;(5) 长视频流式场景中的增量循环与事件边界自发现;(6) 把循环框架当作数据引擎——自动筛出『描述定位闭环失败』的样本作为难例挖掘来源,用于主动学习或课程训练。
复现评估
复现条件较好:模型、代码与 DOVE 基准均在项目页公开,训练代码基于扩展的 verl+FSDP;附录表 13–15 给出三种设置完整超参(AdamW $10^{-6}$、KL $10^{-2}$、裁剪 $[0.8,1.3]$、dual-clip $c{=}3$、bfloat16+梯度检查点、视觉编码器冻结、空间 $N{=}K{=}6$ 批 128,时间/时空 $N{=}K{=}4$ 批 64–128)。数据公开可得:空间 20K DenseWorld+1K GRES 无目标表达;时间 OMTG 约 18,742/18,735 条 RL 样本(含 VLM 离线筛选流程);时空 Open-o3-Video 35,887 条混合样本。算力为 4B 级策略的 GRPO 训练(多卡高端 GPU),空间设置沿用 ECCV 已发表配置、最易复现;评测协议(公开 prompt、冻结探针、固定 Qwen2.5-72B 裁判、按视频组配对 bootstrap 20,000 次)完全可复用。难度中高:开源大幅降低门槛,但嵌套 rollout 的显存调优与十余基准完整评测仍需可观算力与 RL 经验;从零重建 DOVE(Gemini 3 Pro 预标注+多轮人工审核)成本最高,直接用发布版即可。
论文图表
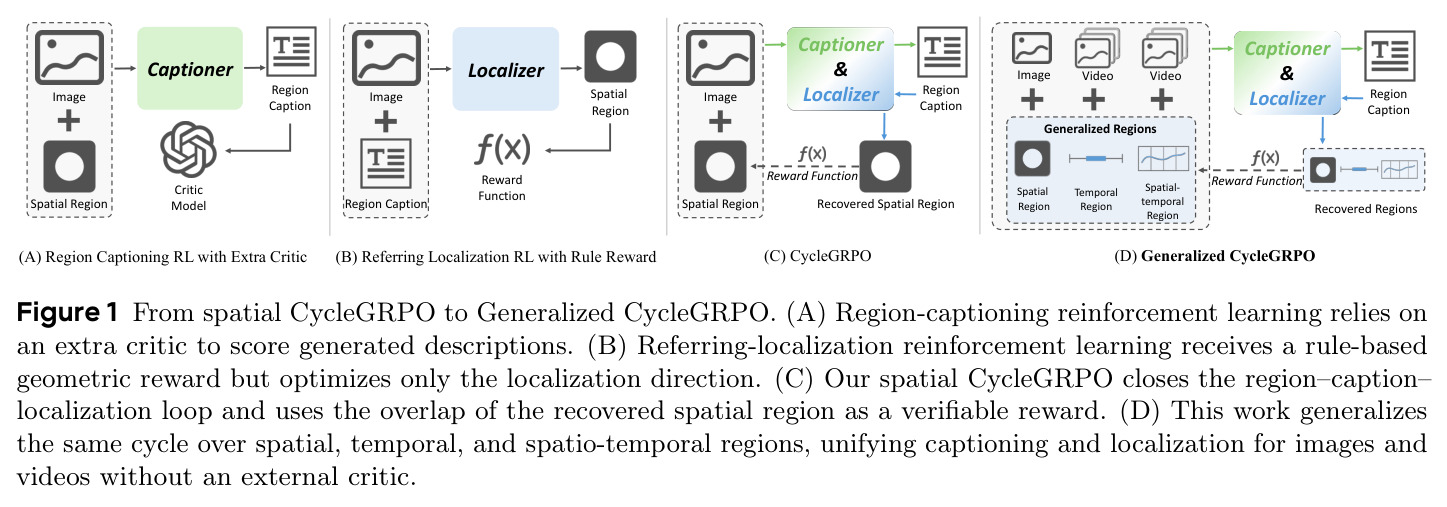
四栏对比训练范式:(A) 区域描述 RL 依赖额外 critic 给描述打分;(B) 指代定位 RL 用规则几何奖励但只优化语言→区域方向;(C) 本文 ECCV 版空间 CycleGRPO 闭合区域-描述-定位环,用重构区域的重叠作为可验证奖励;(D) 本文将其推广到空间、时间、时空三种区域空间,无需外部 critic。
一图看懂本文与先前两类范式的本质区别,以及『从会议版到期刊版』的贡献扩展脉络,是理解全文定位的起点。
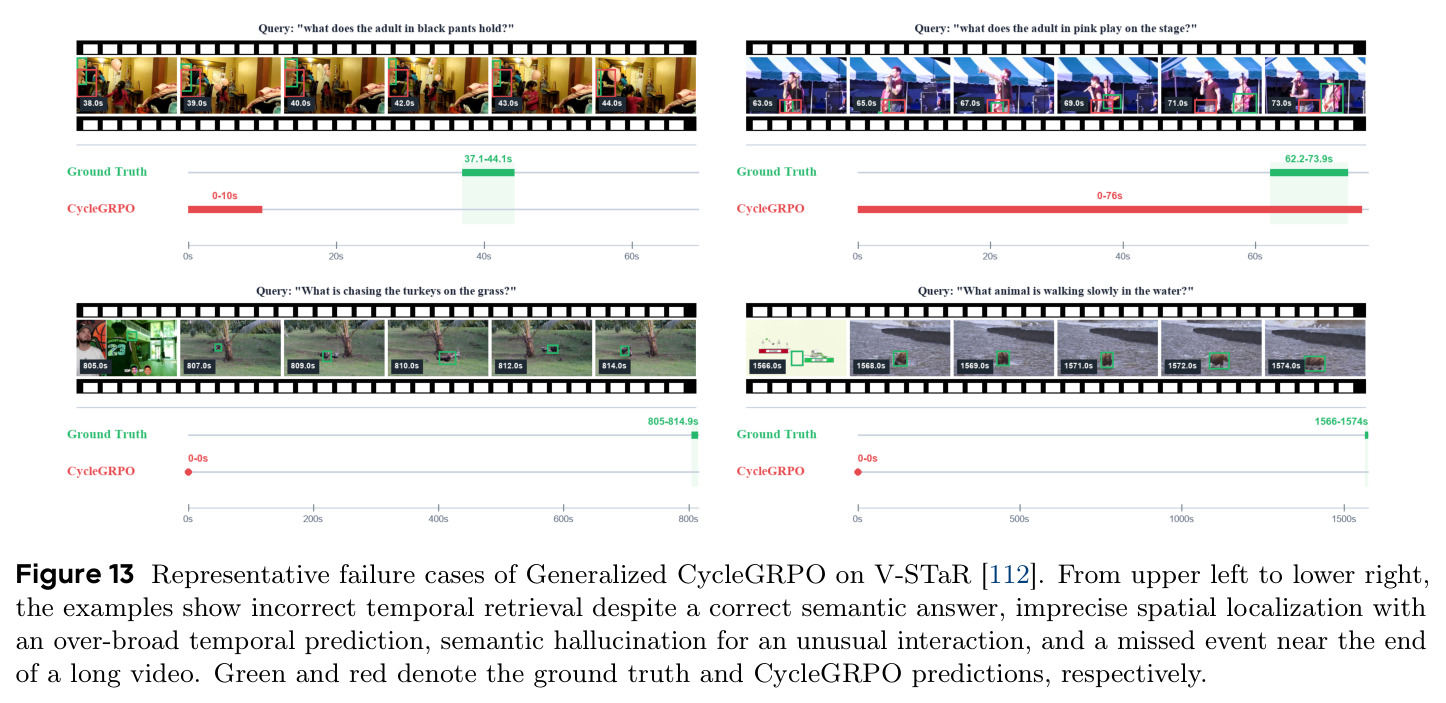
四类代表性失败:语义答案正确但时间检索错误(预测 0–10s,真值 37.1–44.1s);识别出红色电吉他却预测几乎整段视频且空间定位不准;语义幻觉(把海獭追两只火鸡说成一人追鹿);漏检长视频结尾出现的熊并错误断言无动物。
暴露聚合分数掩盖的残余缺陷——语义鲁棒性、细粒度空间定位与长程时间检索仍是难点,对判断方法适用边界非常重要。
左:GCG 上十项验证/测试指标全部提升(val CIDEr 48.2→54.3、mIoU 69.4→70.2、Recall 46.6→50.2、AP50 34.7→36.8)。右:GRES 平均 gIoU 71.2→78.7、cIoU 70.2→74.4,三个划分一致提升,无目标 N-acc 58.7→92.5(+33.8)。
证明语言质量与掩码定位同步提升、且循环训练显著改善『目标不存在时的拒绝』,这是单向训练难以同时做到的。
通用能力检查:VideoMME Overall/Long 61.0/50.2→62.3/52.1,WorldSense 39.3/38.1→40.2/39.3,VideoMMMU Overall 58.0→59.7(仅 Perception 76.0→75.7 微降),TVGBench mIoU 21.1→28.5 超全部开源基线,五列均值 49.1→51.1。
回应『时空增益是否以牺牲通用理解为代价』的疑虑:广义能力整体保持并小幅提升,TVGBench 的大幅提升还说明时间边界质量显著改善。
保持循环 rollout、只改奖励侧:仅 caption 奖励 Charades R1@0.3 最高(73.0)但严格阈值与 tIoU 落后,DOVE TEC 30.1;仅 localization 奖励 TEC 29.6;双侧奖励在 R1@0.5/0.7、tIoU(51.8)、TEC(33.3)、Clip-Complete(14.6)上最优。
隔离『双侧奖励』的贡献:理解与定位的奖励信号互补,完整目标在更严格指标上才显出优势,指导复现时的奖励设计。