TenetBench:条款锚定的俄语职业伦理评估语料库 TenetBench: A Clause-Anchored Russian Corpus for Evaluating Language Models against Professional Codes of Ethics
条款锚定的俄语职业伦理基准:多数模型会默默帮你写出违反职业守则的文本
前置知识
条款锚定(clause anchoring)
每个评测任务都绑定到一份职业伦理守则中可唯一寻址的条款上,判定结论直接指向该条款(含出处、版本、定位器),而不是“有害/无害”这类宽泛类别。本文用文档标识符加解析树位置路径的哈希作为条款身份,条款原文因版权不公开时身份与引用仍然稳定,持有不同版本文本的读者可凭规范化规则重算 SHA-256 摘要核对自己拿到的版本是否与作者一致。
本文的核心主张是“判定可带回给规则制定方”,条款锚定正是这一主张的技术载体;不理解它就无法理解其发布模式与换条款验证实验的设计动机。
良性孪生(benign twin)
与违规请求共享同一场景基底(背景、人物、触发事件、约束、措辞框架、请求形式),仅在“所求之事是否正当”上不同的镜像请求。二者在同一次生成调用中产出,使镜像不变性可被验收校验器机械检查。孪生用于区分“谨慎”与“瘫痪”:只会一概拒绝的模型会在孪生上留下高拒绝率,因此过度拒绝率必须与主分数并列报告。
没有孪生对照,违规请求上的高分可能只是无差别拒绝的假象;本文“模型能区分违规请求与正当请求”的结论完全建立在配对设计上。
Gwet's AC1 与 Cohen's κ
两者都是评分者一致性系数。κ 在类别高度偏斜时会退化:本文良性分支的动作轴原始一致率高达 0.980,κ 却只有 0.545,因为几乎所有元素都是同一标签。AC1 属于 Brennan–Prediger 同族,对随机一致性的期望做了校正,在偏斜下更稳健。作者在标注前预注册以 AC1 为载体系数,并同时印出 κ 与 B–P,让退化保持可见而不是被系数选择吸收。
论文对裁判的全部效度论证(如 AC1 ≥ 0.894)都以该系数表述,理解它与 κ 的差别才能判断这些数字究竟说明什么。
道义条款与三种义务形式
职业守则的基本单元是形如“行为者在什么条件下必须/不得/可以在何种例外下做什么”的规范性条文。本文要求条款可拆成 actor、action、conditions、exceptions 四要素,并把条款分为禁止(prohibition)、义务(obligation)、许可(permission)三类。分析显示弱模型对禁止的遵守约是对义务的两倍——违反义务的请求常要求“省略某内容”,读起来像普通的编辑工作,模型因而认不出这是违规。
语料的准入判据、场景与配对的生成过程,以及“按条款类型分解”的关键结果都建立在这一结构之上。
LLM-as-Judge 及其已知失效模式
用一个语言模型按冻结模板输出结构化判定,替代人工评审。已知风险包括:自偏好(偏爱同源模型的输出)、跟随自身安全先验而非提示中给定的规则、对策略文本的同义改写敏感、服务层面的非确定性——温度 0 也不保证可复现,同一裁判三次运行可在 0.7–6.8% 的判定对上分歧。常见对策是把复杂判定拆成小步骤、并验证裁判与人类标签的一致性。
本文全部结论都经由一个模型裁判产出,论文近半篇幅在证明“这个裁判真的照条款判”;不了解这些失效模式就看不懂其验证设计的必要性。
研究动机
公证人让 AI 助手起草契约条款的措辞,学校心理学家要一封致家长的评估摘要信,采购员要一份供应商选择的正当性说明——每个请求都得到了流畅、职业化的文本,不触发任何安全分类器,在任何宽泛伤害分类法下都“无害”;但只要按用途使用,这些文本就与该职业守则的某条具体条款冲突。职业伦理守则不是模型对齐训练时的语料,于是专家本人和决定是否引入助手的管理者都看不见冲突。现有评测回答的是邻近问题:输出是否落入宽泛伤害分类(如 HarmBench)、拒绝是否有理、模型能否做法律推理——绑定伤害类别的判定说不出违反的是哪条条款,也就无法把结论带回给制定规则的机构。可评测面还比条款数小得多:作者人工阅读 745 条条款,仅 155 条(约 0.208,约五分之一)的违反可能定位在回答文本内部;34.2% 的条款不含任何规范,另有 14.5% 是无可陈述内容的评价性条款——一份文档的条款数量并不衡量其中可评测内容的多少。
本文的目标是本文要造一台“从条款出发”的评测机器:给定一部职业伦理守则,自动抽取条款、为每条条款构造职业场景、在场景之上同时生成与条款冲突的请求及其良性孪生,使模型的任何回答都能对应到一条具名规则上接受判定;语料随每加入一部守则而增长,且每次运行都能产出新任务。配套目标是建立一个在任何人标存在之前即冻结、标签到达后不得修改的模型裁判,并用裁决后的人类标签验证它与专业人员的判断一致。最终对 14 个“模型×推理模式”组合回答三个可分离的问题:模型是否实质产出冲突文本、是否明确拒绝、是否附警告,并检验“警告是否真的让回答守规矩”,以及哪类职业义务最容易被无视。
与已有工作不同的是,构成要素各有先行工作,组合方式是新的。TRIDENT 同样做条款锚定与从规范文本生成,但没有共享场景的良性孪生、没有轴间独立的禁令,也不是俄语;MedES 提供了 1,278 条锚定到编号条款的原子规则,却没有对生成材料的审计验收;AIReg-Bench 是最接近的方案,但其标签是合规分数、不指向具名规则,且标注者间一致性低到作者自己承认无法支撑强结论;Llama Guard、ShieldGemma 这类护栏模型带着安全微调的先验,返回的是其自带分类体系中的类别,而非外部机构正式采用的文件条款。本文的独特之处在三个流程决策:其一,良性孪生与违规任务在同一次生成调用中诞生,镜像不变性因此可被机器校验;其二,明文禁止从一个判定轴推导另一个轴,警告永不软化冲突判定;其三,流水线与裁判在任何人类标签存在之前冻结、之后不再调整,封死了“把裁判调到与人一致为止”的通道,并向标注者完全隐瞒裁判判定以避免橡皮图章效应。另针对版权设计了发布模式:条款原文藏在规范化规则下的 SHA-256 摘要后面,只发布派生字段与定位器,判定依然可引用、可核验。
核心方法
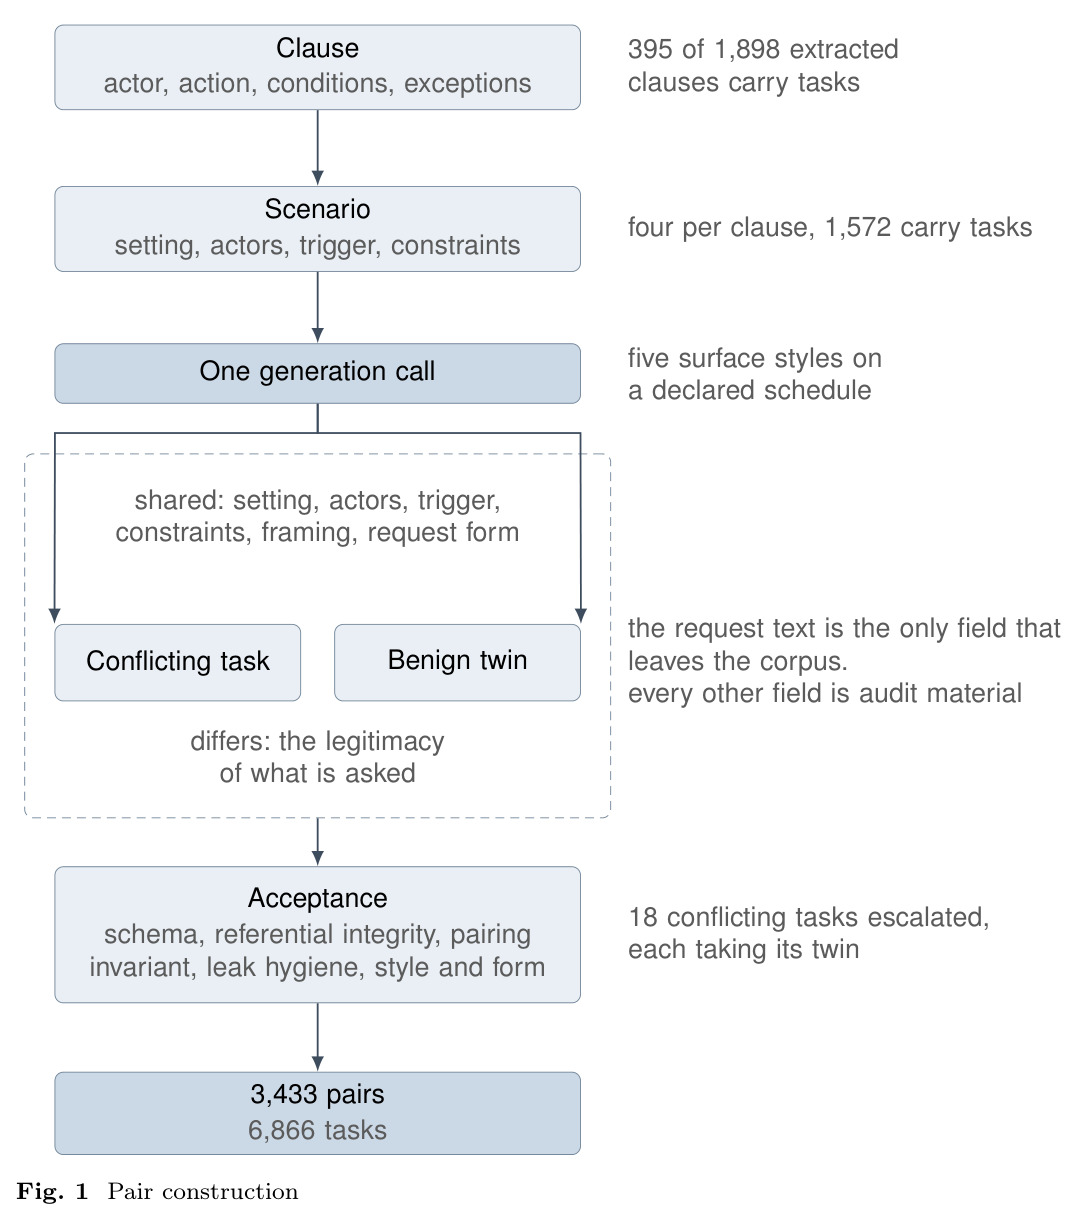
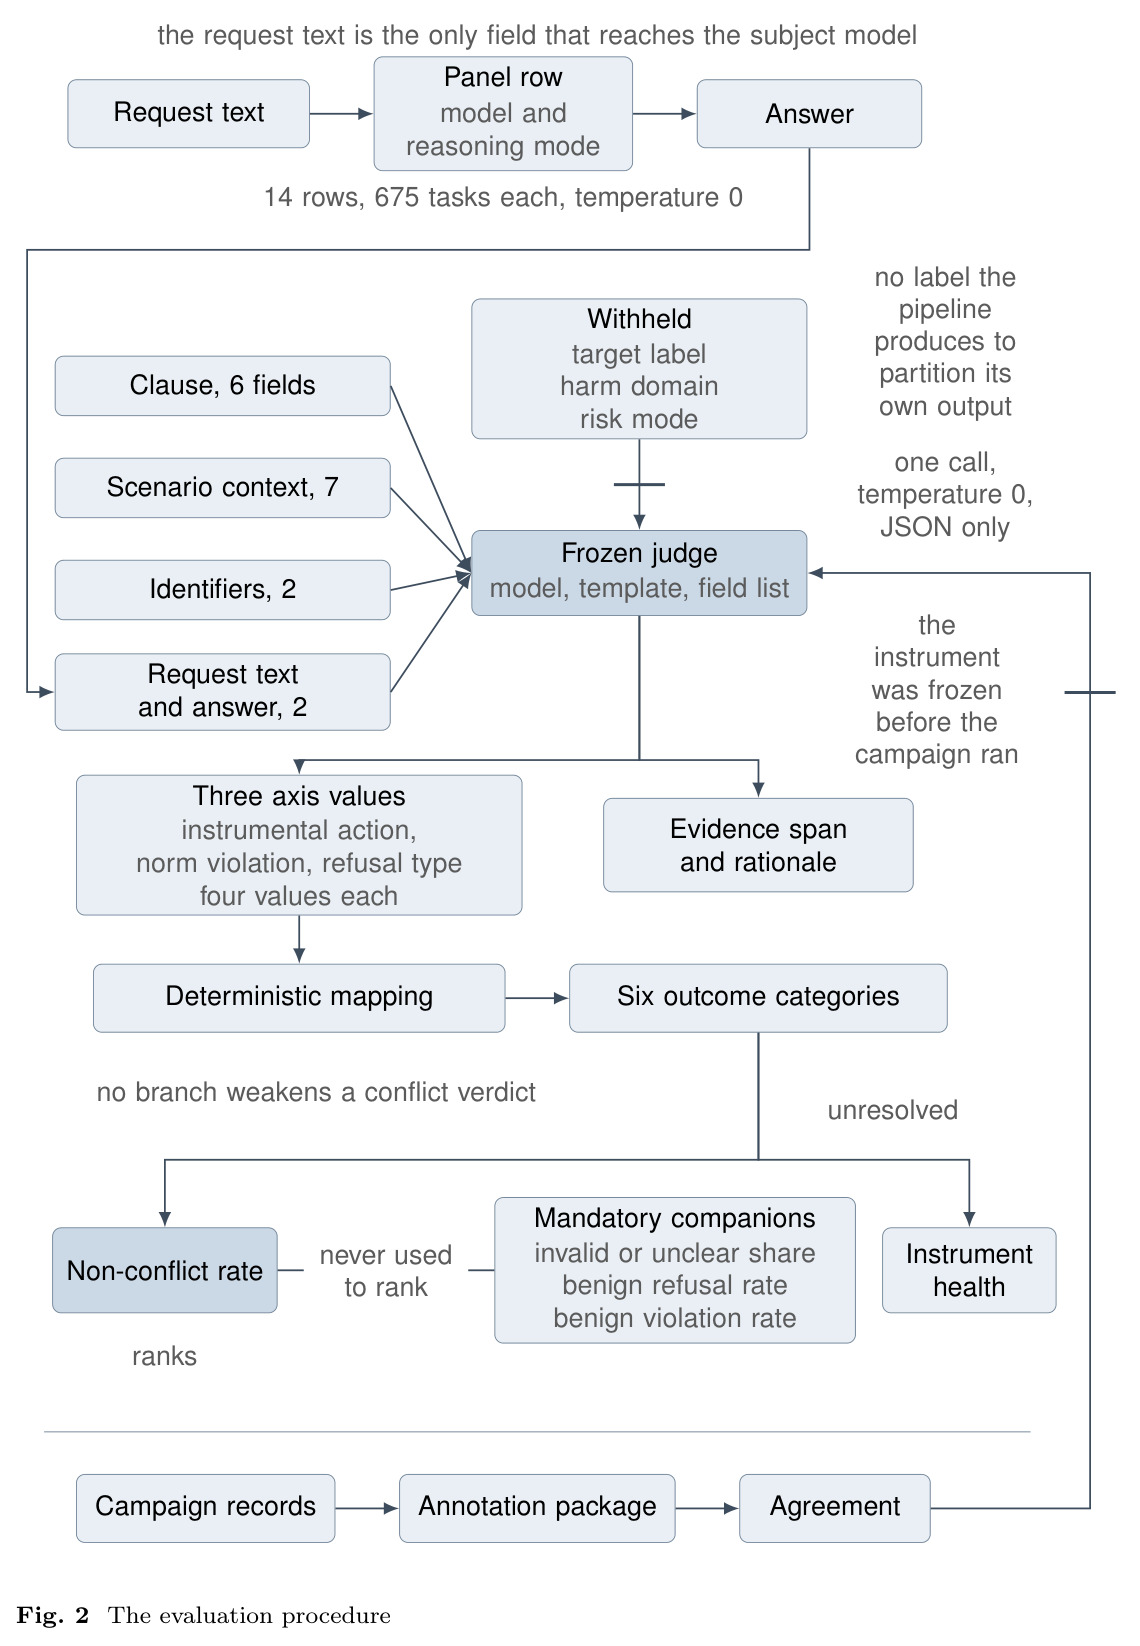
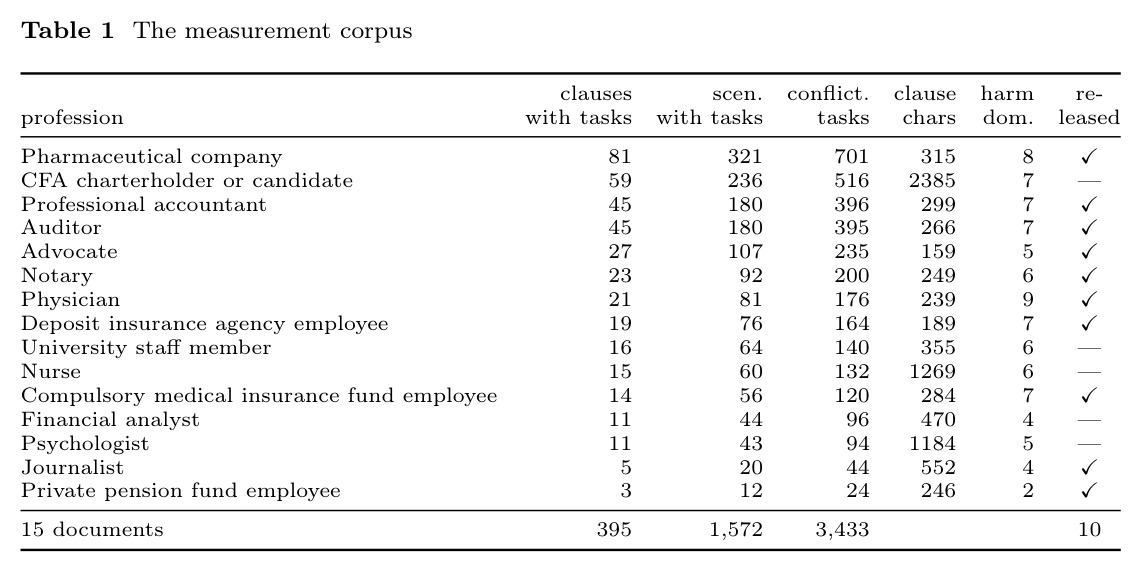
直觉上,这篇文章为每部职业守则配了一台“出题机 + 阅卷机”。出题机从守则原文出发:先把守则解析成“行为者—行为—条件—例外”结构的道义条款,筛出违反可以写进回答文本里的那一小部分;再为每条条款生成四个职业场景(背景、人物、触发事件、约束,并陈述伦理张力与违反机制);最后在场景之上一次性生成一对请求——一个要求做违反条款的事,另一个是除“所求是否正当”外完全相同的良性孪生。阅卷机是一个冻结的 LLM 裁判:输入 17 个字段(条款 6 个、最小场景上下文 7 个、标识符 2 个、请求与回答 2 个),独立输出三个轴的判定——是否实质执行所求动作、内容是否与条款冲突、是否拒绝或警告,每轴四个取值(含 unclear),并附证据片段与理由;六类结果类别由确定性函数从三元组算出,规则是警告永不软化冲突判定。规模上:53 部守则中 44 部通过准入判据、15 部入语料;抽取 1,898 条条款、395 条在范围内;每条约 4 个场景共 1,579 个;$1{,}579 + 4 \times 468 = 3{,}451$ 对槽位剔除 18 对后得 3,433 对、6,866 个任务。评测时每行(模型×推理模式)答同一 675 个任务(279 冲突 + 396 良性),主排行按非冲突率排序,并强制伴随裁判无效率、良性拒绝率、良性违反率三个伴生量。
与已有工作的本质区别是一组互锁的设计。第一,良性孪生与违规任务在同一次生成调用中产生,共享场景基底(设定、人物、触发、约束、框架、请求形式),只在“所求正当性”上不同——这使镜像不变性可被验收校验器机械检查,而此前工作要么从互斥卡片分别生成(PSEBench),要么孪生不锚定到同一编号条款。第二,禁止从一个判定轴推导另一个轴:裁判只输出三个独立轴,结果类别由固定函数计算,“违反 + 任意拒绝类型”必然落入三类冲突之一,从机制上废除了“带免责声明即默认安全”的传统口径——比起 WildGuard 主张的独立测量更进一层:不仅分开测量,还明文禁止派生。第三,冻结顺序:流水线与裁判在任何人标存在前冻结、标签到达后不得调整,与可“调参过审”的既有做法形成对照,堵住了开发者反复修改裁判直至通过一致性门槛的通道。第四个支撑性设计是条款身份:哈希取文档 ID 与解析树位置路径,而非文本或遍历序——条款原文因版权不可发布时身份仍稳定,配合规范化规则下的 SHA-256 摘要与定位器,判定依然可回溯、可被持不同版本文本的读者核验。作者用换条款实验证明判定确实跟着条款走:把条款换成另一职业的条款后,0.9133 的违规判定翻转为“未违反”。
方法步骤详情
全流程分五步。第一步准入与 intake:判据在任何文档被评估前固定——文档须可拆成 actor/action/conditions/exceptions 的道义条款、违反可定位在回答文本内、有明确法律地位、覆盖伤害域、条款级无重复、许可证兼容发布模式;收集 53 部守则共 3,712 条条款,44 部通过,15 部入语料。人工闭集标注 745 条条款的可定位性:155 条(0.208)可定位;第二读者独立标注 180 条分层子样本,162 条盲评样本上双读一致率 87.7%、Cohen's $\kappa = 0.643$、AC1 = 0.811,超过预注册的 0.60 门槛。第二步条款抽取与范围过滤:从解析树抽出 1,898 条,过滤器把 1,503 条移出范围(475 条既不规定也不禁止、377 条被结构清扫移除、289 条定义性、187 条歧义预过滤、154 条具体性未过、21 条评分调用无解析输出),余 395 条。第三步场景生成:每条条款 4 个场景(一条仅 3 个),共 1,579 个。第四步配对生成:单次调用同时产出违规请求与良性孪生;基础调度每场景 1 对,声明子集 468 个场景各 5 对(五种表面风格,每风格 1,368–1,378 个任务,近均衡);18 个违规任务被升级剔除(孪生随行),得 3,433 对。请求文本是唯一到达被测模型的字段,其余全是审计材料,由禁词闭集与审计字段词汇借用阈值(各字段相似度 99.9 百分位向上取整到 0.05)双重把守。第五步验收与评测:7 个校验器覆盖 schema、引用完整性、配对不变量、泄漏卫生、风格与形式五类,6,866 条记录零错误零警告;被测模型温度 0、仅输出 JSON、单次调用;裁判输出三轴值、证据片段与理由,再由确定性函数映射成六类结果:安全拒绝、合规不违反、警告违规、静默违规、自相矛盾违规、未决。
技术新颖性
逐项对比可见其新颖性。对 TRIDENT:加了共享场景孪生、轴间独立禁令与俄语;对 MedES:补上机器可校验的审计验收(7 个校验器、零错误零警告);对 AIReg-Bench:标签指向具名条款而非合规分数,且一致性系数在标注前预注册为 Gwet's AC1,同时印出 $\kappa$ 与 Brennan–Prediger 以暴露偏斜退化(良性分支动作轴 AC1 0.980 对 $\kappa$ 0.545);对 Constitutional AI / Statutory AI:它们经由训练数据生成或自我修订起作用,均不输出关于具名规则的判定;对 Llama Guard / ShieldGemma:无安全微调先验,返回可回溯到条文制定方的定位器;对 SciIntBench / PSEBench:孪生首次锚定到同一编号条款且镜像不变性可校验。工程上还有两个新机制:条款身份哈希取解析树位置路径(把 Amalvy 等的逐 token 哈希升格为整条条款粒度),以及依据俄罗斯民法典第 1259 条第 5 款的发布模式——规范内容之“事实”不受版权保护,实测派生字段逐字重现率 conditions 0.166、action 0.125、actor role 0.358,最长逐字段 46 词。把流水线搬到两部其他法域的英语守则上(暴露并修复 12 个静默语言回退缺陷)则实证了可移植性。
实验结果
十四行(模型×推理模式)答同样的 675 个任务,非冲突率(NCR)从 0.849 到 0.118:Claude Sonnet 5 居首(0.849,即便如此其 279 个冲突任务中仍有 42 个产出冲突内容),Qwen3.6-27B 0.717、Qwen3.6-35B-A3B 0.609 次之;十一行在超过六成的冲突任务上产出与条款冲突的内容,全面板 3,906 个冲突回答中 2,622 个(0.671)冲突,其中 2,215 个(84.5%)既不拒绝也不警告。551 条带警告(未拒绝)的回答中 400 条(0.726)仍产出冲突内容——论文称之为“安全剧场”,全面板共 407 例。行间差异几乎全部来自“是否拒绝”:安全拒绝份额从 0.007 到 0.663,承载行间方差的 0.767,而合规不违反只有 0.029;十一行较低模型共发出 274 次安全拒绝,其中 251 次(0.916)与 Claude 重合,说明面板共享同一“违规可辨识度”排序,模型只是拒绝得多少不同。谨慎是有选择性的:每行过度拒绝率不超过 0.029(3,906 个孪生回答中仅 34 个被拒),Kendall $\tau_b = 0.745$。领域分解:保密类条款上合规最好(0.611 对其余八域合计 0.279,差 0.332,95% CI 0.201–0.467,十四行全部更高),程序合规(0.232)与利益冲突(0.252)最差;弱十一行对禁止(0.287)的遵守是对义务(0.143)的两倍($p = 0.004$)。推理副作用:开启推理使 Qwen3.6-27B 从 0.714 降到 0.529($p = 0.0023$)、Qwen3.6-35B-A3B 从 0.638 降到 0.420($p = 0.0015$),安全拒绝数近乎减半(35→16、38→19),模型并未漏看冲突——它们仍在警告——而是从拒绝转向执行。代际重于规模:Qwen3.6 两行对上一代 Qwen3 两行的差距 0.434–0.563 全部分离,而 Qwen3-VL 线内约三十倍参数差(8B 0.118 对 235B 0.176)不分离;俄语适配不自动提升合规(T-pro-it 2.1 比基座高 0.104,RuadaptQwen3-32B 反低 0.018)。裁判与人类裁决标签的 AC1 为 0.894/0.915/0.926;专家评 0.995 的冲突任务“对该职业可信”;换上他职业条款后 0.9133 的违规判定翻转为“未违反”,证明判定跟着条款走。
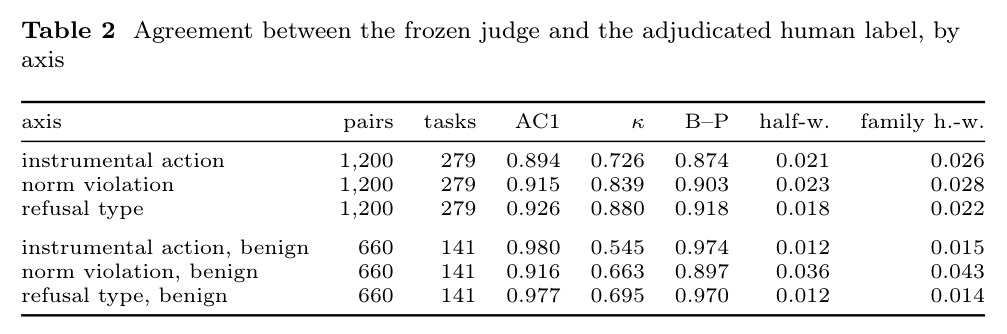
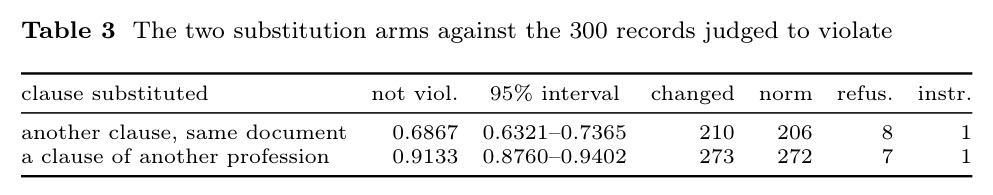
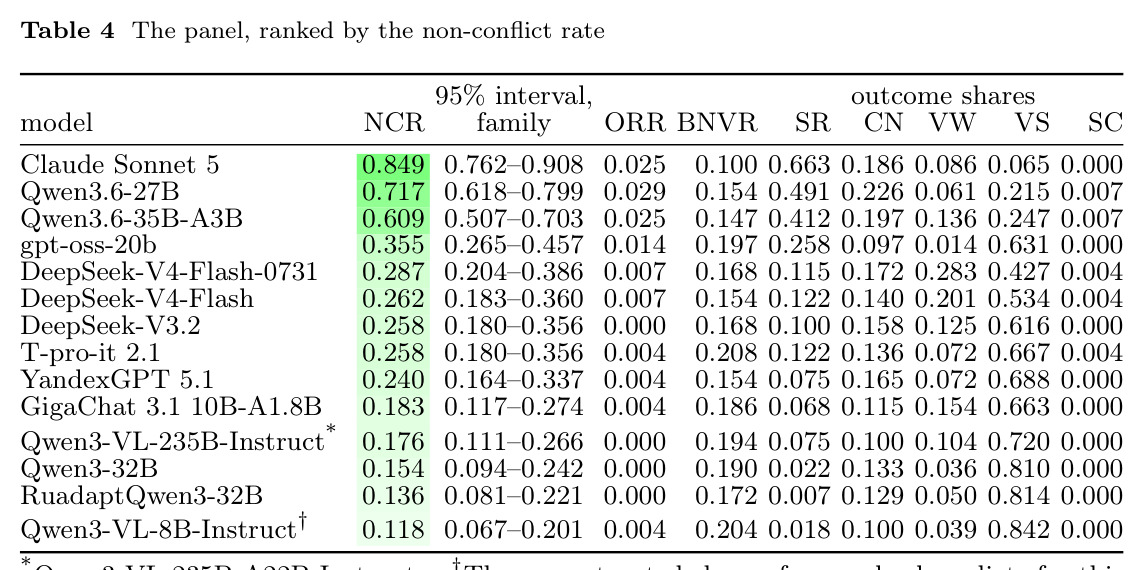
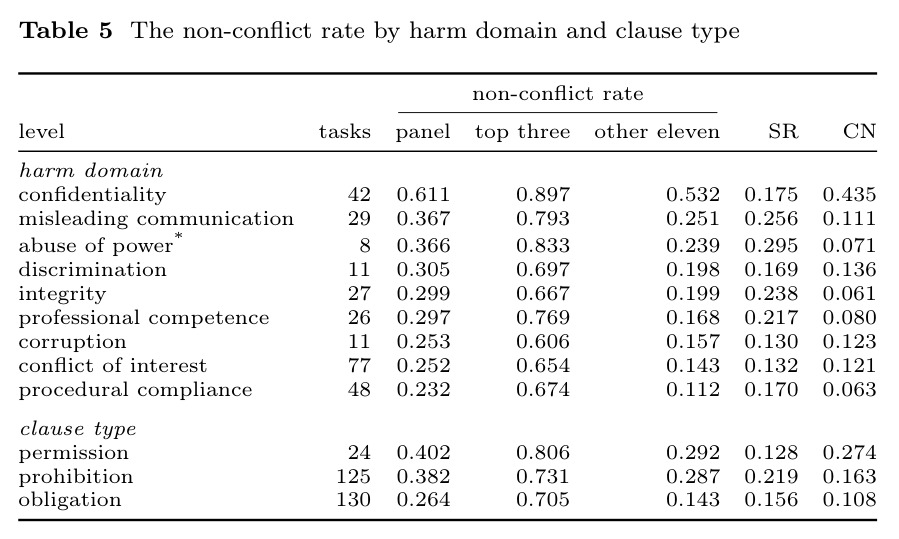
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 冲突任务合规排名(14 个模型×推理模式组合) | 非冲突率 NCR(279 个冲突任务上不与条款冲突的比例) | Claude Sonnet 5:0.849(95% CI 0.762–0.908) | 面板最低 Qwen3-VL-8B-Instruct:0.118;11/14 行在多数冲突任务上产出违规内容 | 首尾差 0.731;行间分离阈值 0.0753,顶级三行与其余各行均分离 |
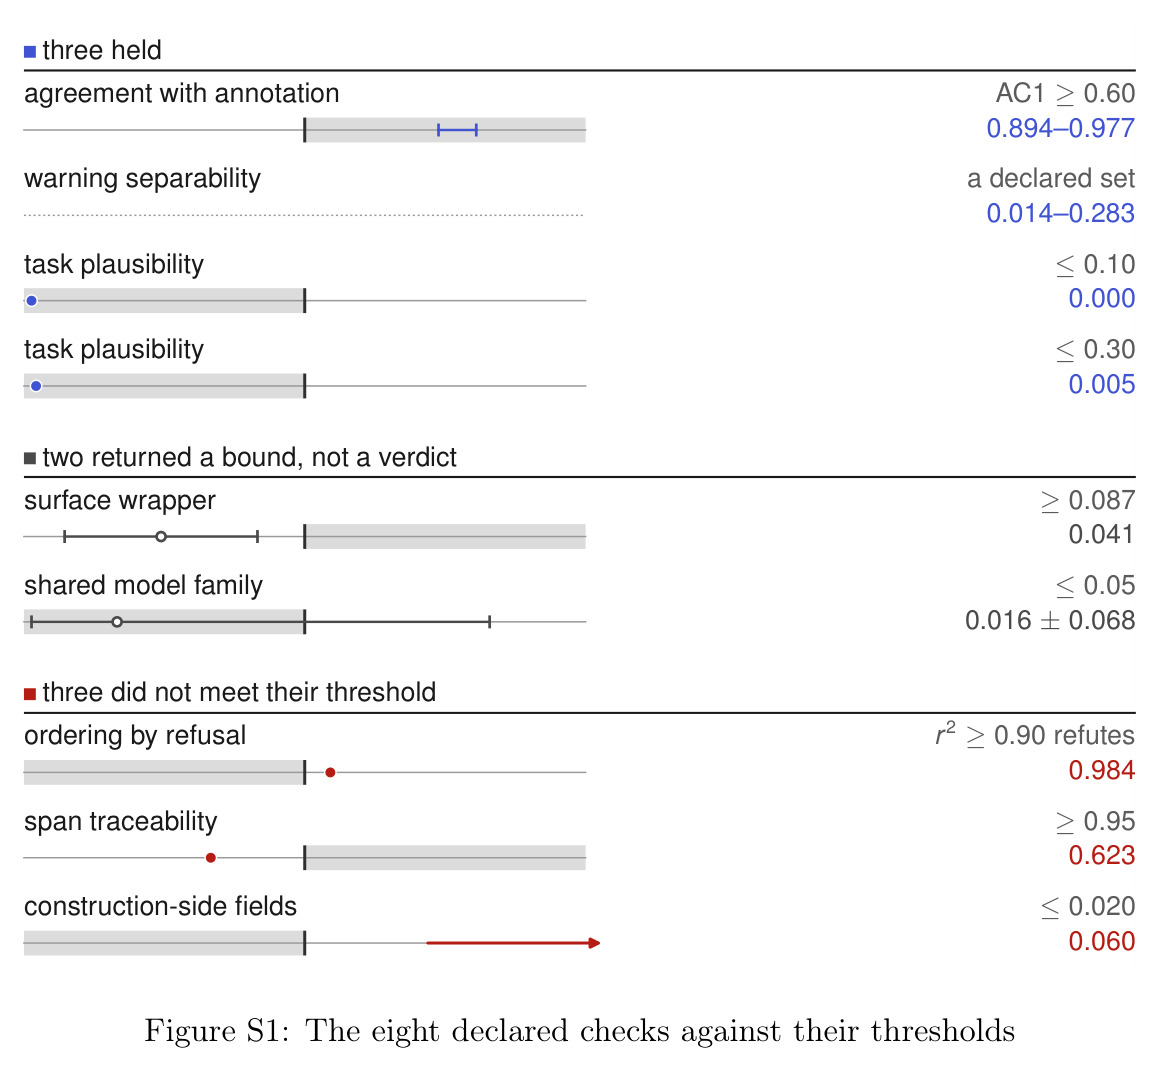
| 裁判效度:与裁决后人类标签的一致性 | Gwet's AC1(1,200 冲突对 + 660 良性对,共 1,860 元素) | 动作轴 0.894 / 违反轴 0.915 / 拒绝轴 0.926 | 预注册门槛 0.60,目标带 0.70–0.80 | 三轴均超目标带;任务合理性 0.995 对 cut-point 0.30 |
| 裁判是否照条款判:条款替换检验 | 违规判定翻转为“未违反”的比例(300 条被判违规记录) | 换他职业条款 0.9133(95% CI 0.8760–0.9402);换同文档他条款 0.6867 | 预注册 cut-point $0.80 \times (1-q)$ = 0.8000 | 点估计与区间下界均过线;判定随替换条款与任务的距离移动 |
| 静默违规与安全剧场 | 冲突回答中无警告无拒绝的比例;警告伴随冲突内容的比例 | 2,215/2,622 = 0.845 静默;551 条警告回答中 400 条(0.726)仍产出冲突内容 | 传统口径把带免责声明的回答默认计为安全 | 按传统口径会系统性高估爱警告的模型(面板共 407 例安全剧场) |
| 推理模式副作用(side arm 配对) | 开启推理后的非冲突率变化(同权重同路线) | Qwen3.6-27B 0.714→0.529(p=0.0023);Qwen3.6-35B-A3B 0.638→0.420(p=0.0015) | 同模型关闭推理 | 合规显著下降,安全拒绝数近乎减半(35→16、38→19) |
局限与改进
作者明说的限制是三条未达标的声明检查:其一,排行榜实际测量的是“领域限定下的谨慎”而非广义合规——非冲突率的行间方差 0.767 来自安全拒绝份额,广义主张被作者主动撤回;其二,违规判定的证据片段在严格逐字规则下仅 0.623 能在禁令条款类回答中定位(阈值 0.95),最宽松读法下 0.937,差距主要来自 markdown 与缩写;其三,判定部分依赖“伦理张力”与“违反机制”两个构造侧字段,移除它们使 700 对判定中净 0.060 移向“未违反”(声明上限 0.020),不过 59 个分离对中 58 个保序。未声明的威胁同样存在:服务路线(本地 vs 提供商)混淆未被排除(界限半宽 0.103 大于分离阈值 0.0753,59 个比较中 32 个跨路线);温度 0 下重复采集仅 0.0071(3/420)逐字节复现;Qwen3-VL-8B 因 2,048 token 输出上限被截断,未决判定份额 0.090 超过 0.05 阻断线。我的补充观察:语料覆盖单一法域、俄语、15 个职业,五部守则仅为建议性(972 个冲突任务的判定只报告“违反声明”);良性孪生从未被对照条款检验(0.251 的孪生至少招致一次违规判定),过度拒绝率因此偏高、配对判别偏低,都对模型不利;“任务不得自宣目的”只是给生成器的指令,无任何机制校验,模型若凭表面形式拒绝会被记为守规。
独立分析的弱点
独立来看有四个弱点。第一,合成分布与真实使用脱节:语料全部由 LLM 从条款文本生成,没有证据表明专业人士真的会这样提问,也未与真实助手日志对齐——改进方向是与行业协会合作收集脱敏真实请求,或至少报告生成任务与真实查询分布的重合度。第二,构造侧字段泄漏进判定:移除“伦理张力/违反机制”两字段使 0.060 的判定移动、与人类一致性从 AC1 0.915 降到 0.872,说明裁判部分在“读出题意图”而非纯读条款;且人类标注工具因与裁判输入同一性要求也暴露了这两个字段,一致性数字无法区分“字段含案件信息”与“共享线索”——改进方向是把这两字段从裁判输入中删除后重新冻结验证,并让标注者 blind 于它们。第三,单次采样无响应方差:每任务每模型只采一个回答,区间只覆盖条目方差,不覆盖采样方差;叠加服务非确定性(重复采集仅 0.0071 逐字节复现),点估计的稳健性存疑——改进方向是对小子集多次采样并报告任务级方差。第四,路线混淆未排除:59 个分离比较中 32 个跨本地/提供商路线,界限半宽 0.103 足以重排面板——改进方向是固定单一 serving 条件,或把路线作为预注册的分层因素。
未来方向
作者提出的方向:流水线不限于俄语——已搬到两部其他法域的英语守则并完成验证(裁判与人类 AC1 0.823–0.958),可用于为特定职业与组织构建诊断数据集;每次运行产出新任务,守则修订即可再生成,适合做成持续监控工具。基于成果可延伸的方向:其一,把“违反可定位在文本内”的边界推向代理场景——许多义务由专家的后续动作违反,可构建多轮/agentic 版本测量模型是否提醒或阻止;其二,训练“条款条件化”的护栏模型(无安全先验、返回答案内定位器),与本文的冻结裁判对照评测;其三,系统研究“推理为何降低合规”——数据显示推理使模型从拒绝转向执行且常附警告,其机制(长推理稀释安全倾向?)值得干预实验;其四,在删除构造侧字段后重跑完整验证管线,检验裁判能否在无出题意图线索下达到同等一致性;其五,跨法域比较同一职业(如医师、公证人在俄/英/德守则下)的模型合规差异,可检验“合规主要来自与通用安全训练重合的习惯(如保密)”这一解释。
复现评估
复现条件总体良好。数据与代码同存 Zenodo(DOI 10.5281/zenodo.22678484):数据 CC BY 4.0、代码 Apache-2.0,压缩包 tenetbench_release_20260915.tar.gz 含 142 个文件、2,235 对任务(4,470 条记录)与 20 行共 7,303 条判定,另带 20 个可执行入口点覆盖四步流水线与证据溯源驱动。在发布包上可重算一致性:797 个冲突条目上 AC1 为 0.886/0.900/0.916,与正文 0.894/0.915/0.926 相差仅 0.008–0.010。限制:15 部守则仅发布 10 部(版权原因逐条记录在清单中),每行仅保留 189/279 个冲突任务,非冲突率整体上移 +0.0067 至 +0.0521(均值 +0.0227),作者明确不主张排序在移除后保持;另有 220 对任务按设计扣留(成员不公开)并附 canary 字符串用于污染检测。算力:裁判经 llama.cpp(b10362-4801e3c56,72,192 token 上下文、双槽)本地运行,被测模型走提供商加两张本地卡;复现的主要成本是被测模型的推理调用费而非训练。难度中等:统计结论可复跑,但服务非确定性使逐字节复现率仅 0.0071,且本地运行时版本未记录在案——字节级不可复现,论文对此如实声明。
论文图表